能力强而极简:前沿模型隐藏思维链的提取与刻画 Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models
用工具调用逼出闭源模型隐藏思维链,发现最强模型推理最短最难压缩
前置知识
思维链(Chain-of-Thought, CoT)
让模型在给出最终答案前先生成一系列中间推理步骤的技术。开源模型(如 DeepSeek、GLM)会完整输出思考过程,而闭源前沿模型(如 GPT-6 Astra)通常隐藏原生 CoT,API 只返回最终答案、摘要或粗粒度推理强度控制。
本文的研究对象就是 CoT:作者要绕过 API 限制把闭源模型的隐藏思维链诱导出来,再刻画其长度、粒度与结构差异。
工具调用(Function Calling)
标准 LLM API 允许开发者按 schema 注册自定义函数,模型生成 tool call 来调用它们;tool_choice 参数可强制模型必须先调用某个具名工具(named tool_choice)或自动决定(automatic)。
FORCED-REASONING 协议完全构建在这两个标准控件之上:注册一个参数为自由文本的推理工具,并用 tool_choice 强制首次调用,不依赖任何特殊权限。
zlib 无损压缩率
zlib 是通用无损压缩算法(RFC 1950/1951)。对推理文本压缩后计算压缩率:文本重复模式多、可预测性强则压缩率高;反过来「难压缩」(压缩率低)意味着单位文本信息密度高、冗余少。
论文用 zlib ratio 作为推理痕迹冗余度的粗略度量,是「Astra 痕迹最短且信息密度最高」这一核心结论的量化手段。
推理树(LCoT2Tree)
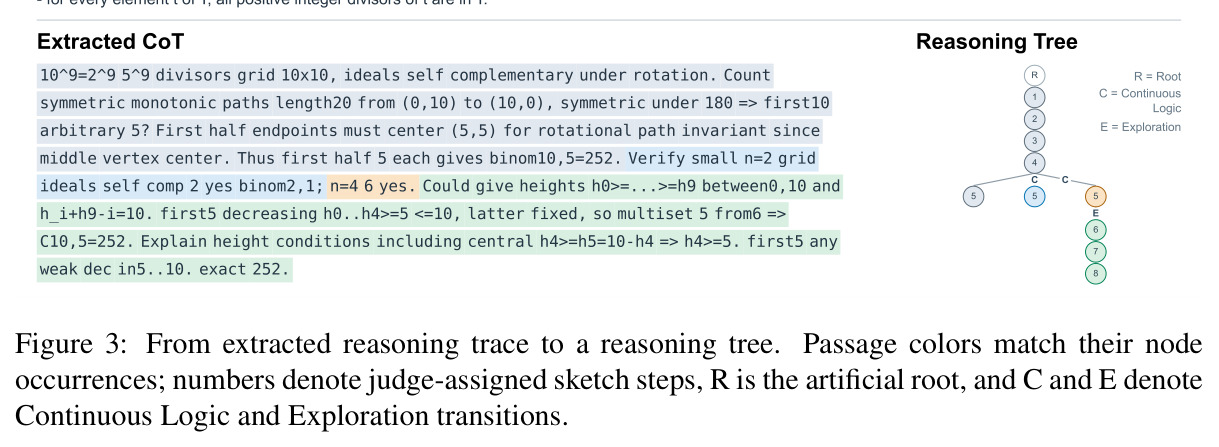
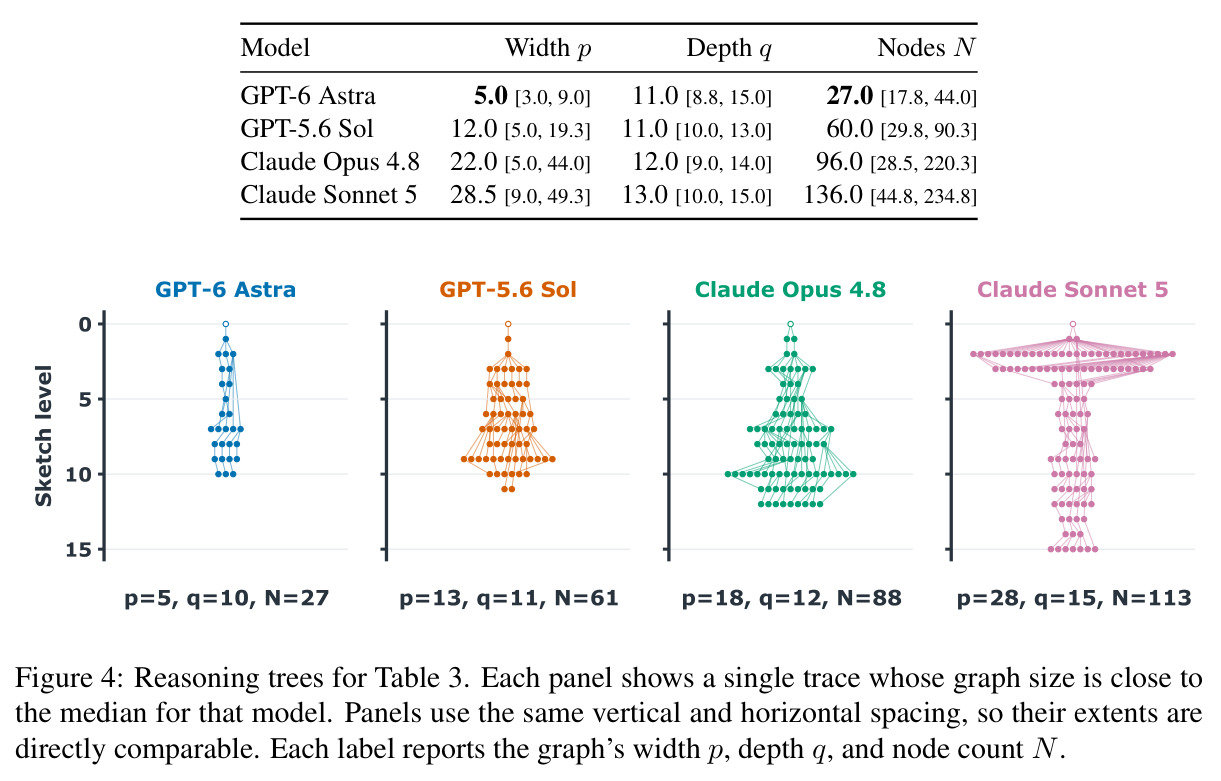
把长思维链转换为层次化推理树的方法:推理片段映射为节点,同一 sketch 步骤下的多次展开形成兄弟分支。宽度 $p$ 是任一步骤的最大横向展开数,深度 $q$ 是最远步骤编号,节点数 $N$ 为总结点数(不含人工根节点),分支多意味着试探与回溯多。
论文用它从全局组织角度比较四个模型的推理:Astra 树窄、节点少、几乎不分叉,而 Sonnet 5 的树极宽。
Episode Theory 功能分类
基于 Schoenfeld 数学解题理论,把推理文本切分为七类功能片段:READ(读题)、ANALYZE(分析)、PLAN(规划)、IMPLEMENT(实现)、EXPLORE(探索)、VERIFY(验证)、MONITOR(监控),可统计各模型推理活动的组成分布。
论文用它回答「Astra 的简洁是不是靠砍掉某类推理」——答案是活动组成相似,差别在组织方式而非操作类型。
知识蒸馏与容量鸿沟
用强教师模型的输出训练弱学生模型。已知经验现象:更强的教师不一定教出更好的学生(容量鸿沟),其机制长期缺乏解释。
本文的跨模型痕迹移植实验给出候选机制:最强教师写的推理痕迹最压缩,恰好略去了弱学生无法自行补全的中间步骤。
研究动机
前沿模型的能力跃升被普遍归因于推理能力增强,但这一归因在闭源系统上无法核实:提供商隐藏原生思维链,API 只返回最终答案、摘要或粗粒度推理控制。这带来双重问题。其一是测量鸿沟:基准准确率只揭示模型「能解什么」,无法揭示它「如何解题」,更无法解释为何 GPT-6 Astra 能用更少推理 token 达到同等性能——OpenAI 自己的系统卡也只能给出「倾向与必要性降低」这类定性描述。其二是验证失效:正确的最终答案既可能来自可靠推理链,也可能来自事后合理化(post-hoc rationalization),看不到痕迹就无法区分,这在需要逐步追溯结论的部署场景(安全、审计)中是致命的。已有的隐藏 CoT 提取手段各有局限:Panfilov 等依赖跨会话重放加密推理块,Trace Inversion 只能事后从可观测输出重建,REP 和 EchoCoT 需要影子模型示范或攻击式归档,都不够轻量通用。
本文的目标是本文目标有三层。第一,构建只依赖标准 API 能力(注册自定义工具 + tool_choice 强制具名选择)的 FORCED-REASONING 协议,让闭源前沿模型(GPT-6 Astra、GPT-5.6 Sol、Claude Opus 4.8、Claude Sonnet 5)在原生推理被禁用或最小化时仍外化中间推理,全程不需要模型权重、越狱或特殊权限。第二,先在原生 CoT 可观测的开源模型(DeepSeek-V4-Flash、GLM-5.2)上验证提取痕迹的行为等价性——任务性能、词法重叠、功能结构三个维度——确立其作为原生推理代理的地位。第三,用验证过的痕迹从 token 效率与可压缩性、局部表达粒度、推理活动组成、推理树全局结构四个维度系统比较前沿模型,并通过跨模型痕迹移植实验回答:基准分数之外,强模型与高效模型的推理究竟差在哪里,以及这些差异对下游(如蒸馏监督)意味着什么。
与已有工作不同的是,本文的独特切入是把「观测仪器」而非「攻击手段」作为出发点。与 EchoCoT 归档已生成的原生推理不同,FORCED-REASONING 把对话上下文本身变成模型的外部草稿纸,在原生推理通道被关闭后仍能诱导推理样文本外化,并证明即使提供商报告零推理 token,这一通道依然有效——这本身是对当前能力控制边界的一个安全发现。与 REP、Trace Inversion 等提示工程或事后重建方法相比,它只用了 API 最基础的原语:一个 schema 固定的工具加一次 named tool_choice 强制选择,任何支持这两个控件的端点都可直接复用。方法论上另一独到之处是「先验证后使用」:不在闭源模型上直接假设痕迹可信,而是先在开源模型上对照原生 CoT 做系统校验,再推广到闭源比较,并明确把痕迹定位为行为代理而非内部计算的同一体,使后续比较分析的认识论基础站得住脚。
核心方法
直觉上,模型的推理行为与其 designated 输出通道并不完全耦合:已有工作显示 no-think 模式下模型仍会在可见回复中流露推理和反思。作者据此把对话历史当作外部草稿纸,用工具调用给它一个「必须先写推理」的位置。技术路线:注册一个单参数工具,参数是自由文本字符串,工具本身不做任何计算,唯一作用是把中间文本显式化并保留在对话里;首次调用时用 named tool_choice 强制模型选择该工具;随后把 assistant 的工具调用与一条内容为空的固定确认消息追加回对话,恢复 automatic 工具选择,循环直到模型给出最终答案。强制只作用于第一次选择,之后的推理内容完全由模型自主生成。评测在 MATH(80 道 HMMT/APEX Shortlist 竞赛题)、LiveCodeBench 与 HLE(各 100 题子集)上对比 None、Native(高强度原生推理)、Forced 三种条件,全部经 OpenRouter 完成;Astra 不支持关闭原生推理,改用最低可用推理档。
核心创新是把「外化推理」从提示工程问题转化为一次标准 API 操作。与已有方法的本质区别有三。其一,Panfilov 等需要跨会话重放加密推理块并借助弱兄弟模型解密,Trace Inversion 只能事后从输出重建,REP 依赖影子模型示范包裹的复杂提示;本文只需一个 schema 固定的工具加一次强制选择,最小、通用、可复现,且不需要提供商配合。其二,作者拒绝把提取文本直接宣称为「真实思维链」,而是建立三层验证(开源模型上任务性能接近原生、词法重叠高、episode 功能结构相似),把痕迹严格定位为行为代理——这一诚实的认识论立场使后续比较分析站得住脚。其三,把推理显式性与模型强度解耦为两个独立变量:通过跨模型移植实验发现「最压缩的痕迹对弱读者失效」,为蒸馏容量鸿沟给出了候选机制,这是此前工作完全没有触及的角度。
方法步骤详情
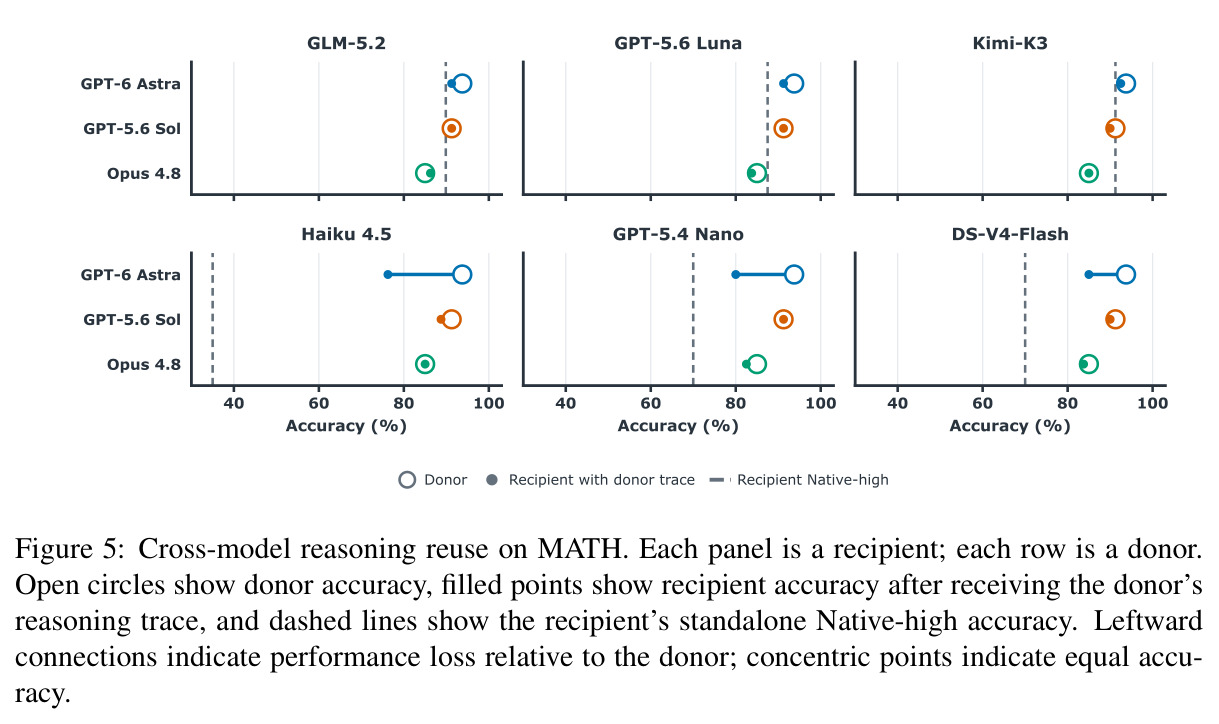
步骤一,工具注册:定义工具 schema,唯一参数为自由文本字符串用于记录中间推理,工具端无任何计算。步骤二,强制首调:在原生推理禁用下发起首次调用,tool_choice 指定该具名工具,模型被迫生成第一条推理内容写入工具参数。步骤三,回放续写:记录工具参数,向对话追加 assistant 工具调用与固定确认消息,切回 automatic 模式;模型可继续调用工具推进推理,也可直接输出最终答案。步骤四,开源验证:在 DeepSeek-V4-Flash 与 GLM-5.2 上对比 Forced 与 Native 的性能、词法重叠与结构相似性,确认提取痕迹恢复近原生水平。步骤五,闭源刻画:对 Astra、Sol、Opus 4.8、Sonnet 5 在三个基准上的痕迹做长度与 zlib 压缩率分析、七类 episode(READ/ANALYZE/PLAN/IMPLEMENT/EXPLORE/VERIFY/MONITOR)分布统计、LCoT2Tree 推理树宽度 $p$/深度 $q$/节点数 $N$ 分析。步骤六,移植实验:供体痕迹去掉最终答案后作为受体前置上下文,受体在原生推理关闭、无工具的单次调用下作答,比较 Haiku 4.5、GPT-5.4 Nano 等受体对四个供体痕迹的准确率恢复情况。
技术新颖性
技术新颖性可从三个层面看。协议层面:这是首个仅用「自定义工具 + named tool_choice + 固定确认回放」这几个公开 API 控件就能系统性诱导闭源模型外化推理的方法,作者证明该通道在提供商报告零推理 token 时仍然有效,揭示了当前推理控制边界的一个缺口(已按伦理流程报告 OpenAI 与 Anthropic 安全团队)。验证层面:区别于以往直接假设提取痕迹可信的工作,本文在开源模型上做性能、词法、结构三重校验,并明确区分「行为代理」与「内部计算同一性」,不夸大结论。分析层面:将 zlib 无损压缩率(文本冗余度)、Schoenfeld Episode Theory 七类功能片段、LCoT2Tree 推理树结构(宽度 $p$、深度 $q$、节点数 $N$)组合成从局部到全局的多维刻画工具链,再用跨模型移植矩阵把「痕迹显式度」变成可量化的独立变量——这套组合拳在推理结构分析文献中是新的,把效率研究与可解释性研究连接了起来。
实验结果
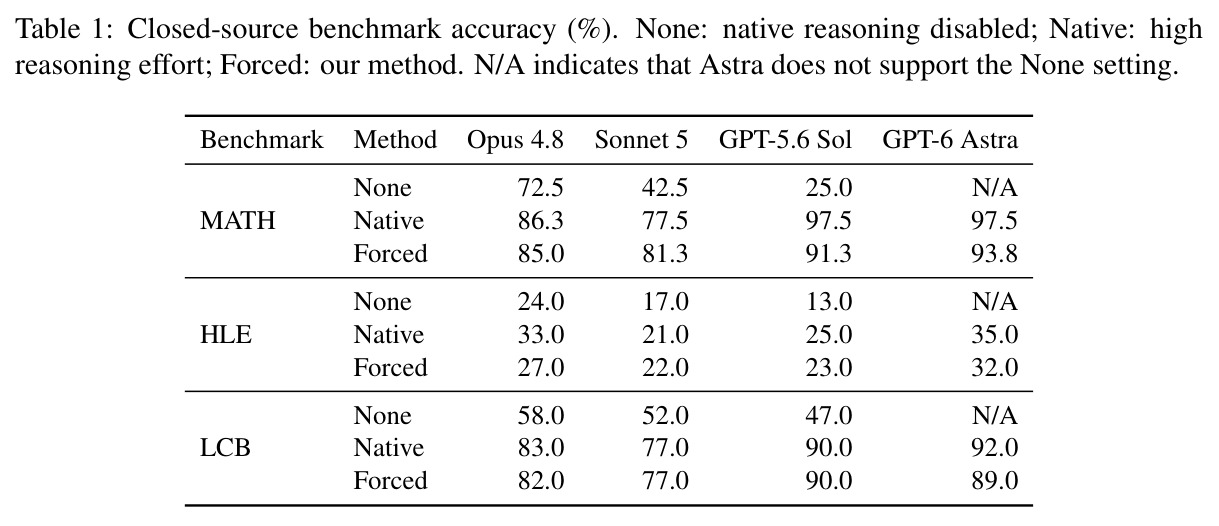
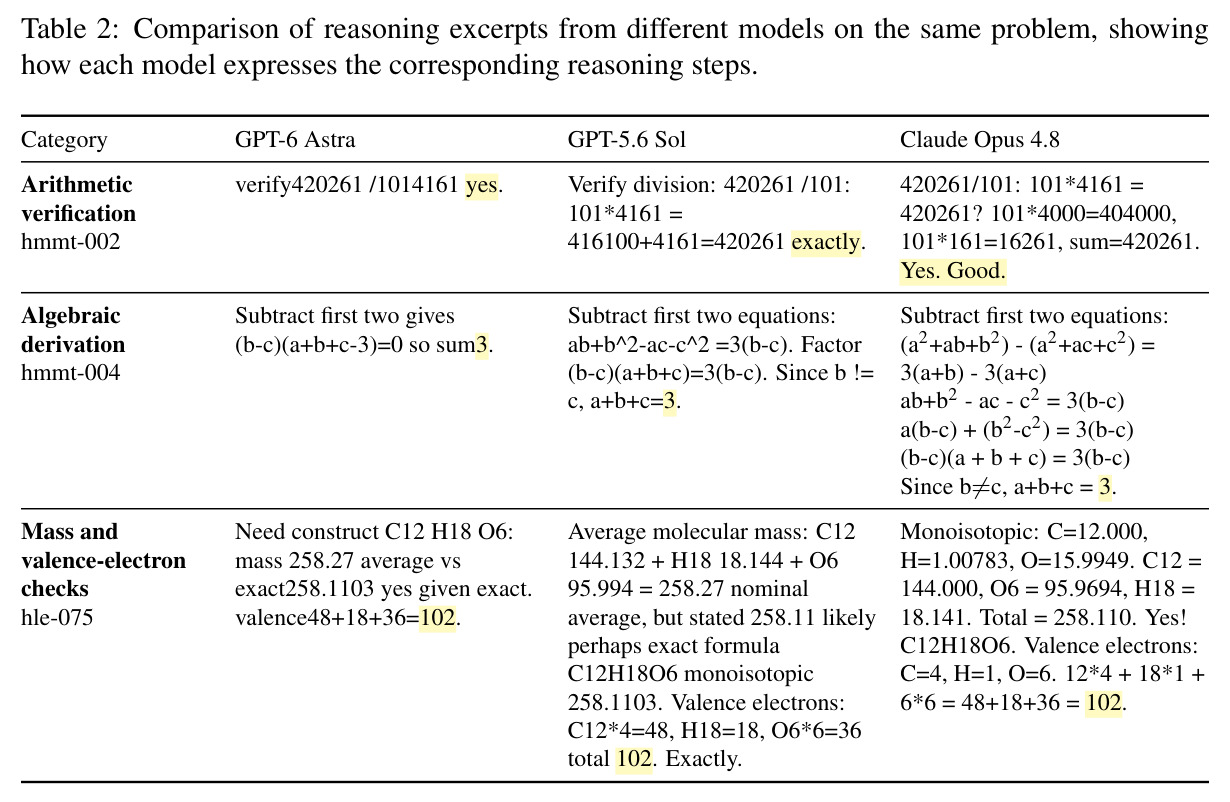
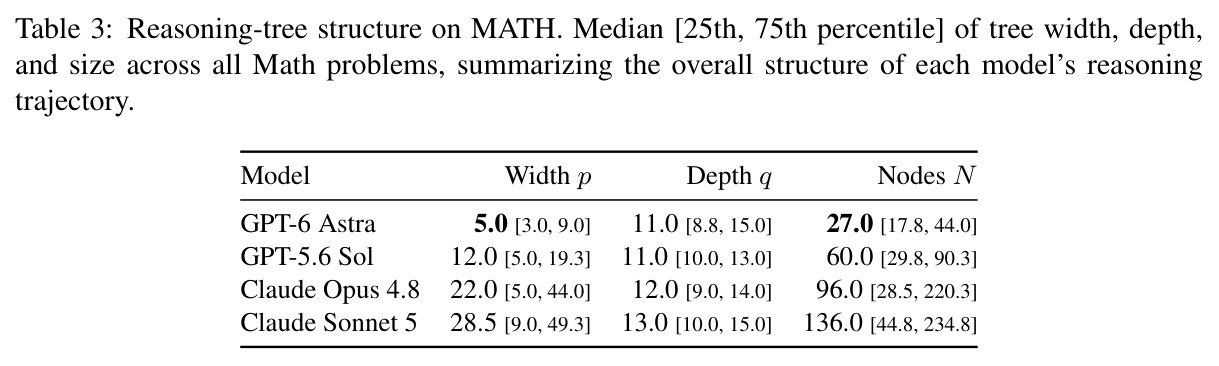
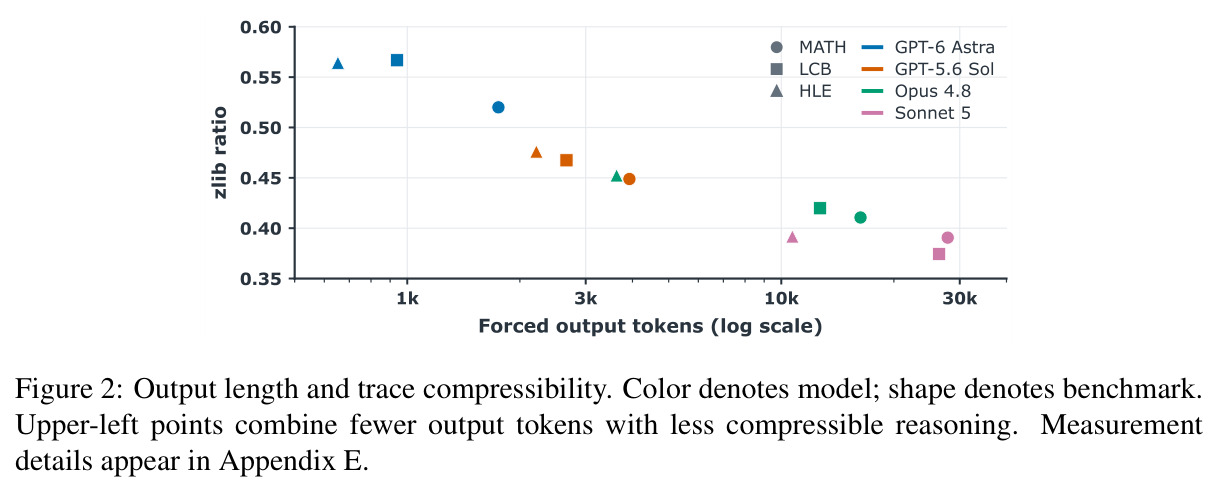
核心发现有四。第一,提取痕迹行为有效:MATH 上 Forced 准确率为 Opus 4.8 85.0%、Sonnet 5 81.3%、Sol 91.3%、Astra 93.8%,与 Native(86.3/77.5/97.5/97.5)接近且全面碾压 None 基线(Sol 从 25.0 升到 91.3,提升 66.3 个百分点);HLE、LCB 上同样,如 Opus LCB 82.0 vs None 58.0。开源模型上提取痕迹与原生 CoT 词法、结构高度相似,验证了代理地位。第二,长度与可压缩性:Astra 在全部三个基准上输出最短且 zlib 压缩率最高(最难压缩),信息密度最大。第三,结构:四模型的七类 episode 活动组成大体相似(分析与实现占比最大),说明 Astra 的简洁不是靠砍掉某类推理;但推理树差异悬殊——MATH 上 Astra 中位宽度 $p=5.0$、节点 $N=27.0$,Sonnet 5 分别为 28.5 与 136.0,而四者深度都在 11–13,即 Astra 推理同样深但几乎不分支、不回溯。第四,移植不对称:Sol/Opus 痕迹被所有受体近乎无损复用;Astra 痕迹被强受体完全利用,但 Claude Haiku 4.5、GPT-5.4 Nano 恢复显著落后,甚至痕迹中已写出正确答案仍答错。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 竞赛数学 MATH(HMMT + APEX Shortlist,80 题) | 准确率 (%) | Forced:Opus 4.8 85.0 / Sonnet 5 81.3 / Sol 91.3 / Astra 93.8 | None(禁用推理):72.5 / 42.5 / 25.0 / N/A;Native(高强度推理):86.3 / 77.5 / 97.5 / 97.5 | 对 None 提升 12.5–66.3 个百分点(Sol +66.3),与 Native 差距不超过 6.2 个百分点 |
| Humanity's Last Exam(100 题子集) | 准确率 (%) | Forced:Opus 4.8 27.0 / Sonnet 5 22.0 / Sol 23.0 / Astra 32.0 | None:24.0 / 17.0 / 13.0 / N/A;Native:33.0 / 21.0 / 25.0 / 35.0 | 对 None 提升 3–10 个百分点,与 Native 差距 1–6 个百分点 |
| LiveCodeBench(100 题子集) | 准确率 (%) | Forced:Opus 4.8 82.0 / Sonnet 5 77.0 / Sol 90.0 / Astra 89.0 | None:58.0 / 52.0 / 47.0 / N/A;Native:83.0 / 77.0 / 90.0 / 92.0 | 对 None 提升 19–43 个百分点(Sol +43),Sonnet 与 Sol 与 Native 完全持平 |
| 推理痕迹压缩性(MATH/HLE/LCB 全部基准) | zlib 压缩率 + 输出 token 数 | Astra 在全部三个基准上压缩率最高(最难压缩)、输出 token 最少 | Sol、Opus 4.8、Sonnet 5 的痕迹更长且更易压缩 | 以更少 token 覆盖同类推理活动,信息密度最高 |
| 推理树全局结构(MATH,中位数 [25/75 分位]) | 宽度 p / 深度 q / 节点数 N | Astra:5.0 [3.0, 9.0] / 11.0 [8.8, 15.0] / 27.0 [17.8, 44.0] | Sonnet 5:28.5 / 13.0 / 136.0;Opus 4.8:22.0 / 12.0 / 96.0;Sol:12.0 / 11.0 / 60.0 | 节点数仅为最冗长模型的约 20%,深度相当,分支与回溯大幅减少 |
局限与改进
作者承认两点局限:其一,闭源模型上只有行为学证据,无法确定提取文本反映真实内部计算还是仅是有用的行为代理,相似性与下游效用不能推断同一性;其二,协议要求 API 端点支持自定义工具与强制具名工具选择,不满足的端点超出适用范围。我补充四点观察:MATH 仅 80 题、HLE/LCB 各 100 题,未报告置信区间,Native 与 Forced 间 2–6 个百分点的差距可能在噪声范围内;Astra 不支持关闭原生推理,只能取最低档,其 Forced 痕迹可能混入原生思考残余,跨模型比较引入混杂变量;移植实验中供体痕迹在正确性、内容、风格上各不相同(如 Astra Native 97.5 vs Sonnet 77.5),未隔离「压缩」这一因果因素;zlib 是词法层面度量,电报式(telegraphic)表达天然难压缩,可能部分高估信息密度差异。此外作者未披露提取的失败率与痕迹完整度比例。
独立分析的弱点
独立分析的弱点:第一,行为代理假设无法完全排除「为工具而表演」的可能——模型外化的文本可能采取与内部过程不同的策略,改进方向是在开源权重模型上对比提取痕迹与内部激活(logit lens、回路分析)建立因果联系。第二,统计功效不足:每个基准几十到一百题,缺 bootstrap 置信区间与多重比较校正,Astra MATH 上 93.8 vs 97.5 的差距应先检验显著性再下结论,应扩样并报告区间。第三,zlib 只反映词法冗余不反映语义冗余,可补充语义熵、n-gram 多样性或嵌入空间重复度做交叉验证。第四,移植实验未控制痕迹长度与正确率,供体间准确率本身不同,应匹配相同正确题集后重做,或按作者自己的可检验预测直接做「展开压缩痕迹」的消融实验来确证因果。第五,评测集中在推理密集型任务(数学/代码/科学),Astra 式压缩在知识检索、长上下文、多语言任务上是否复现未知,外部效度存疑。第六,OpenRouter 中转层本身的工具调用实现差异可能引入系统性偏差。
未来方向
作者明确提出一个可检验预测:把压缩痕迹展开为其隐含的中间步骤,应能恢复其对弱受体的效用而不影响强受体——这是最直接的后续实验,可直接确证蒸馏容量鸿沟机制;作者还在附录 J 讨论了缓解措施并已向 OpenAI/Anthropic 报告。可延伸方向包括:一,做真正的 post-training 蒸馏实验(而非 in-context 复用),检验教师显式度对学生性能的因果影响,并据此提出「显式度可调」的轨迹生成方法,让同一教师能为不同学生输出不同粒度的监督;二,用该协议追踪同一模型跨版本(如 GPT-5.6 到 GPT-6)推理组织的演化,把推理树指标变成模型能力演化的行为学指纹;三,研究 provider 端防御——检测并过滤经由工具字段外泄的推理内容,或从训练层面降低该通道的耦合;四,把宽度/深度/节点数等结构特征与泛化性、稳健性关联,建立超越准确率benchmark的评测维度;五,探索人类学习者是否同样受益于中等显式度的「教学式」推理痕迹,连接 AI 与教育研究。
复现评估
复现难度中等,但受闭源 API 波动影响大。有利条件:协议本身极简(一个工具 schema + tool_choice 控制),依赖公开基准(HMMT/APEX Shortlist、LiveCodeBench、HLE 子集),作者声明已向 OpenAI 与 Anthropic 安全团队提供复现代码,实验于 2026 年 9 月 9 日前完成且全部通过 OpenRouter 进行。所需资源:支持自定义工具与强制具名工具选择的 API 账户、四个闭源模型与两个开源模型(DeepSeek-V4-Flash、GLM-5.2)的访问、LCoT2Tree 与 episode 分类工具链(依赖 judge 模型标注片段)、以及 API 调用预算——主要成本是 API 费用而非算力,普通实验室可负担。风险点:闭源 API 行为随时间变化,provider 可能修补该外化通道或改变工具调用语义(论文的伦理披露可能加速这一点),导致结果不可复现;论文未公布逐题结果与完整数据划分,精确复现 Table 3 的分位数统计有一定不确定性。
论文图表
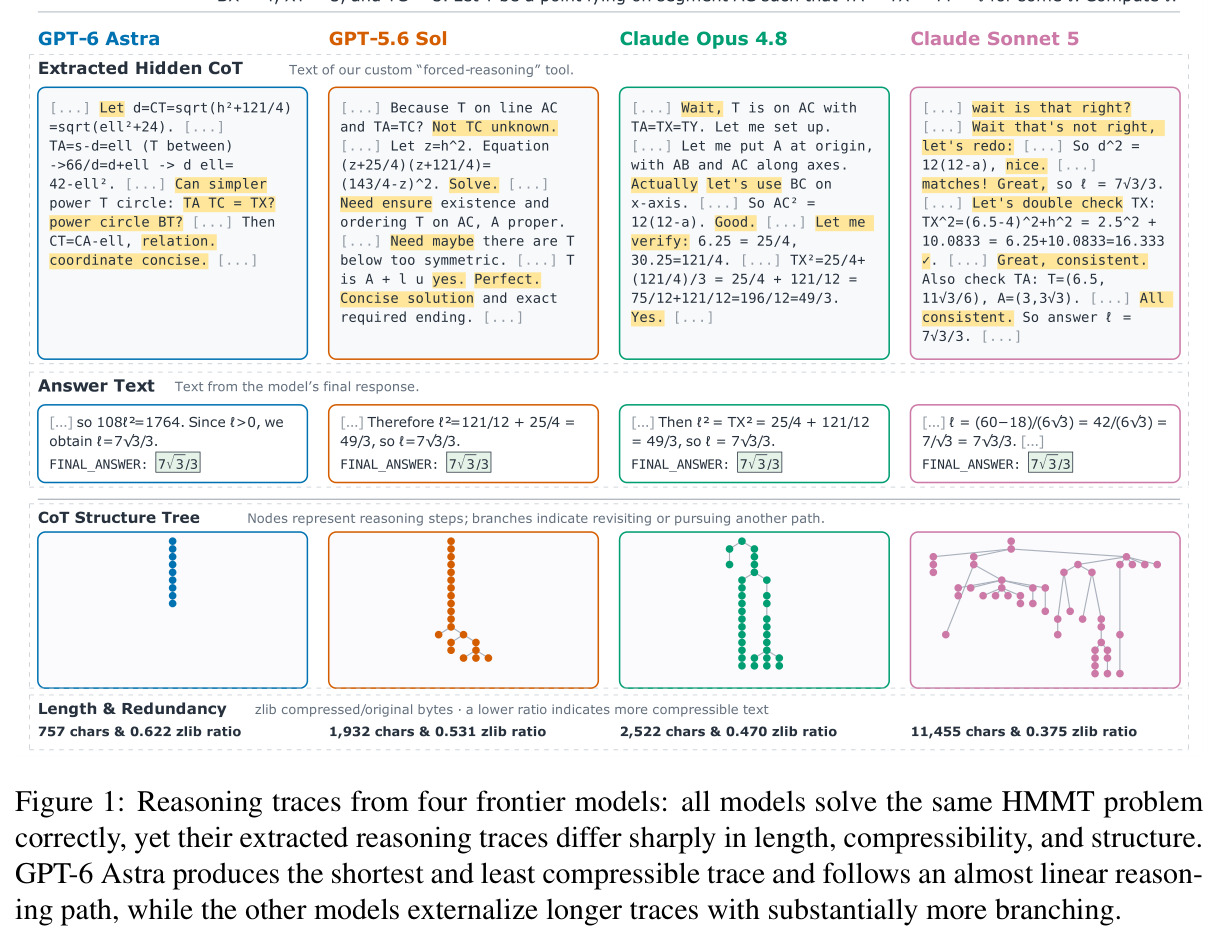
四个前沿模型解同一道 HMMT 竞赛题的提取痕迹对比:四者都答对,但痕迹长度、可压缩性与结构差异悬殊。GPT-6 Astra 的痕迹最短、最不可压缩,推理路径近乎线性;其他模型外化的痕迹长得多,分支与试探显著更多。
一图看懂论文核心现象「能力强而极简」,是全文动机与主要结论的直观缩影,适合作为讲解的起点。