GTR:门控Token循环实现高效稠密预测 GTR: Gated Token Recurrence for Efficient Dense Prediction
线性复杂度门控循环骨干配合极简蒸馏与定制CUDA核,六大稠密任务兼顾精度与边缘延迟
前置知识
Softmax注意力与二次复杂度
标准Transformer自注意力需对所有token对计算相似度矩阵并做softmax归一化,计算与显存随token数 $L$ 呈 $O(L^2)$ 增长。图像在stride-16下token数为 $L=HW/16^2$,1024×1024输入即约4096个token,高分辨率下开销急剧膨胀,是视觉骨干走向高分辨率与边缘设备的瓶颈。
本文全部动机就是用线性复杂度的循环token混合替代softmax注意力,理解这一复杂度对比才能明白GTR的设计取舍,以及延迟、显存随分辨率增长等实验的意义。
门控线性注意力(GLA)
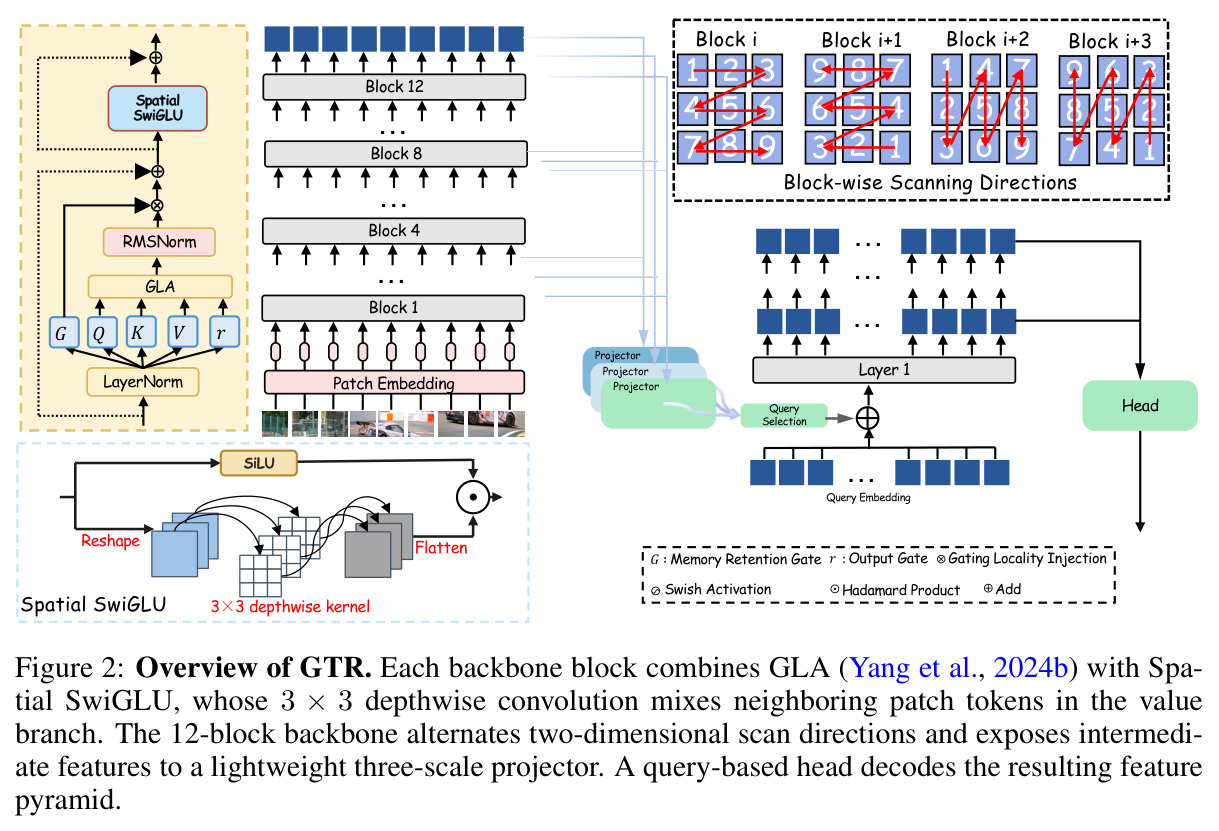
GLA把注意力改写为带遗忘门的RNN式递推:维护固定大小状态矩阵 $S_t$,按 $S_t=\mathrm{Diag}(\gamma_t)S_{t-1}+k_t^\top v_t$ 更新,输出 $o_t=d_k^{-1/2}q_tS_t$;$\gamma_t\in(0,1)$ 是数据相关的key侧保留门,控制历史信息衰减。状态大小与序列长度无关,故对token数线性复杂度。
GTR骨干就是GLA的key-only变体,四方向扫描、Spatial SwiGLU与定制CUDA核全部围绕这个递推展开,不懂GLA就看不懂方法章节。
Chunkwise(分块)并行
朴素RNN须逐token串行计算,GPU利用率低。chunkwise方法把序列切成固定长度块(如 $C=64$):块内摘要 $U_c$ 可对所有块并行计算,只有块边界隐状态 $S_{[c+1]}=\mathrm{Diag}(d_c)S_{[c]}+U_c$ 需轻量串行传递,在线性递推语义下获得硬件并行性。
论文2.3节与附录E.3的自定义CUDA算子正是基于这一公式做并行化与kernel融合,是其比FLA库快4倍的关键。
SwiGLU前馈块
SwiGLU是Transformer常用通道混合器:$Y=\mathrm{SiLU}(XW_g)\odot(XW_v)W_o$,用门控分支对值分支做逐元素调制。本文在值分支插入3×3深度卷积得到Spatial SwiGLU,使相邻patch在通道混合阶段直接交互,弥补单向扫描缺乏非因果局部建模的问题。
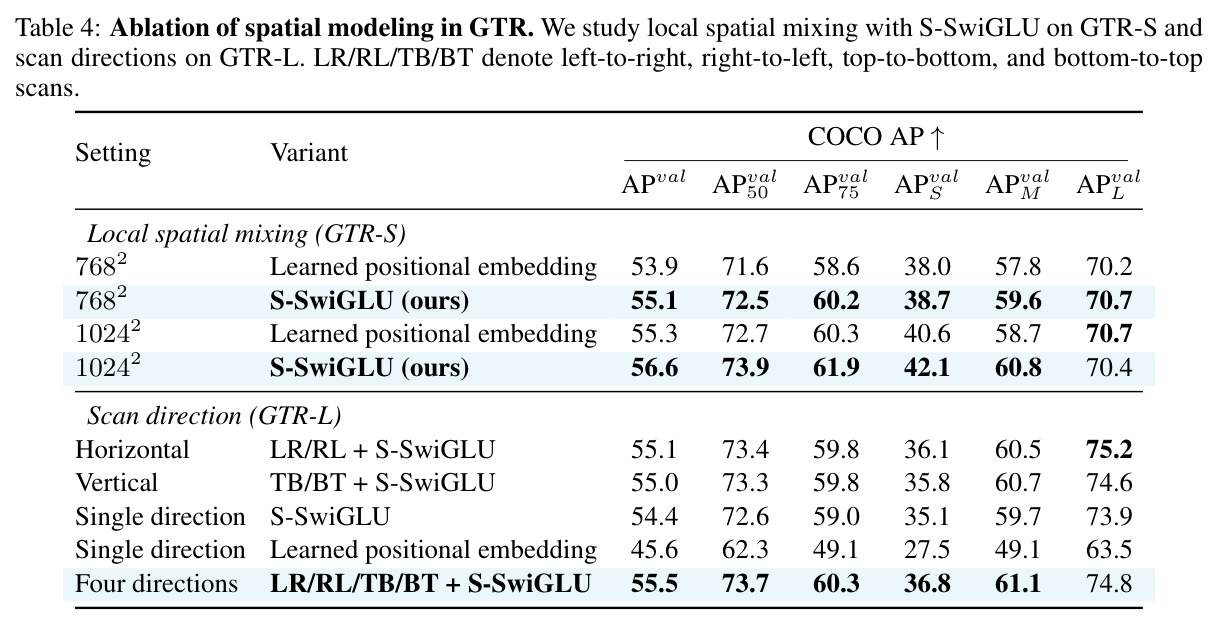
Spatial SwiGLU是GTR两大组件之一,消融显示它比可学习位置编码高1.2–1.3 AP且开销近乎为零,是论文核心贡献点。
DETR式查询检测
DETR把检测建模为集合预测:从图像特征生成固定数量object query,由解码器迭代精炼出类别与框,免去NMS。本文neck从骨干第4/8/12块构建stride 8/16/32三级金字塔,展平作解码器记忆,用300个query、4层解码器,训练时分3组查询。
GTR的检测头与全部延迟测量都基于这条DETR式管线,理解它才能读懂Table 1中延迟对比的协议口径。
跨架构知识蒸馏
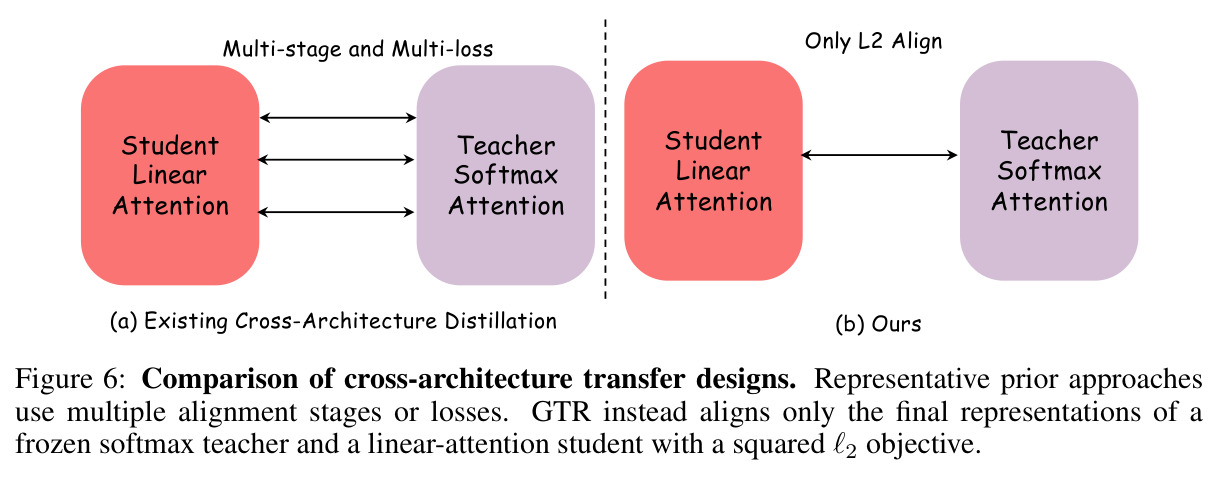
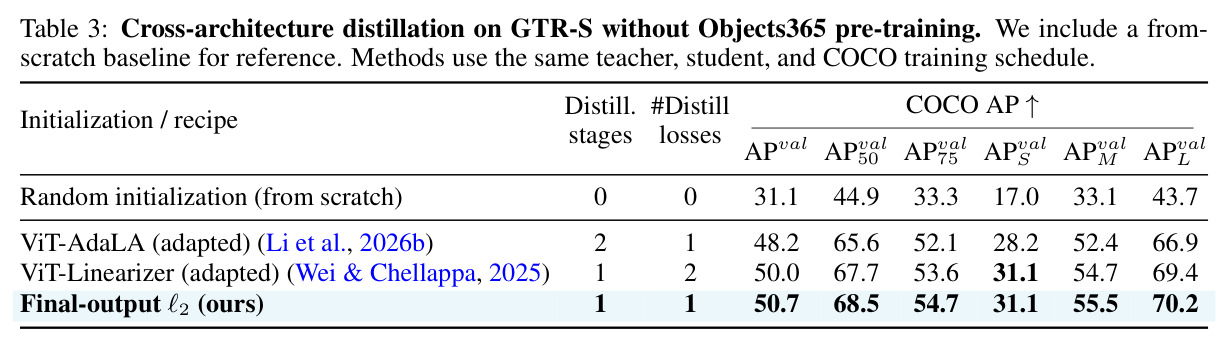
把softmax教师(如DINOv3)的知识迁移给结构不同的线性注意力学生。ViT-Linearizer用多层中间激活匹配加掩码预测,ViT-AdaLA先逐注意力模块对齐再整体对齐;GTR只用一个线性投影加平方ℓ2损失对齐最终patch token,单阶段单损失。
极简蒸馏是本文核心卖点之一,Table 3证明其单阶段单损失方案反而优于更复杂的多阶段方案。
研究动机
基于softmax自注意力的视觉骨干(如DINOv2/DINOv3、RF-DETR所用骨干)在稠密预测上精度很强,但注意力对token数的二次复杂度使其在高分辨率下代价失控:640×640输入在stride-16下已有1600个token,1024×1024则达到4096个,注意力的显存和计算随分辨率平方增长,这在车载、机器人等边缘设备上尤其致命。已有线性化尝试各有局限:EfficientViT主要面向语义分割,ViG把GLA引入检测与分割但采用块内双向建模,业界仍缺少一个在模型规模、算力、内存、延迟约束下,能同时覆盖目标检测、实例分割、姿态估计、旋转框检测、语义分割、单目深度估计六类任务,并真正把理论效率转化为边缘硬件实际收益的通用线性注意力骨干。此外,把二次教师蒸馏成线性学生的既有方案普遍依赖多阶段、多损失目标(如ViT-Linearizer的中层亲和匹配+掩码预测、ViT-AdaLA的逐注意力模块对齐),训练管线复杂、调参负担重且额外收益存疑。
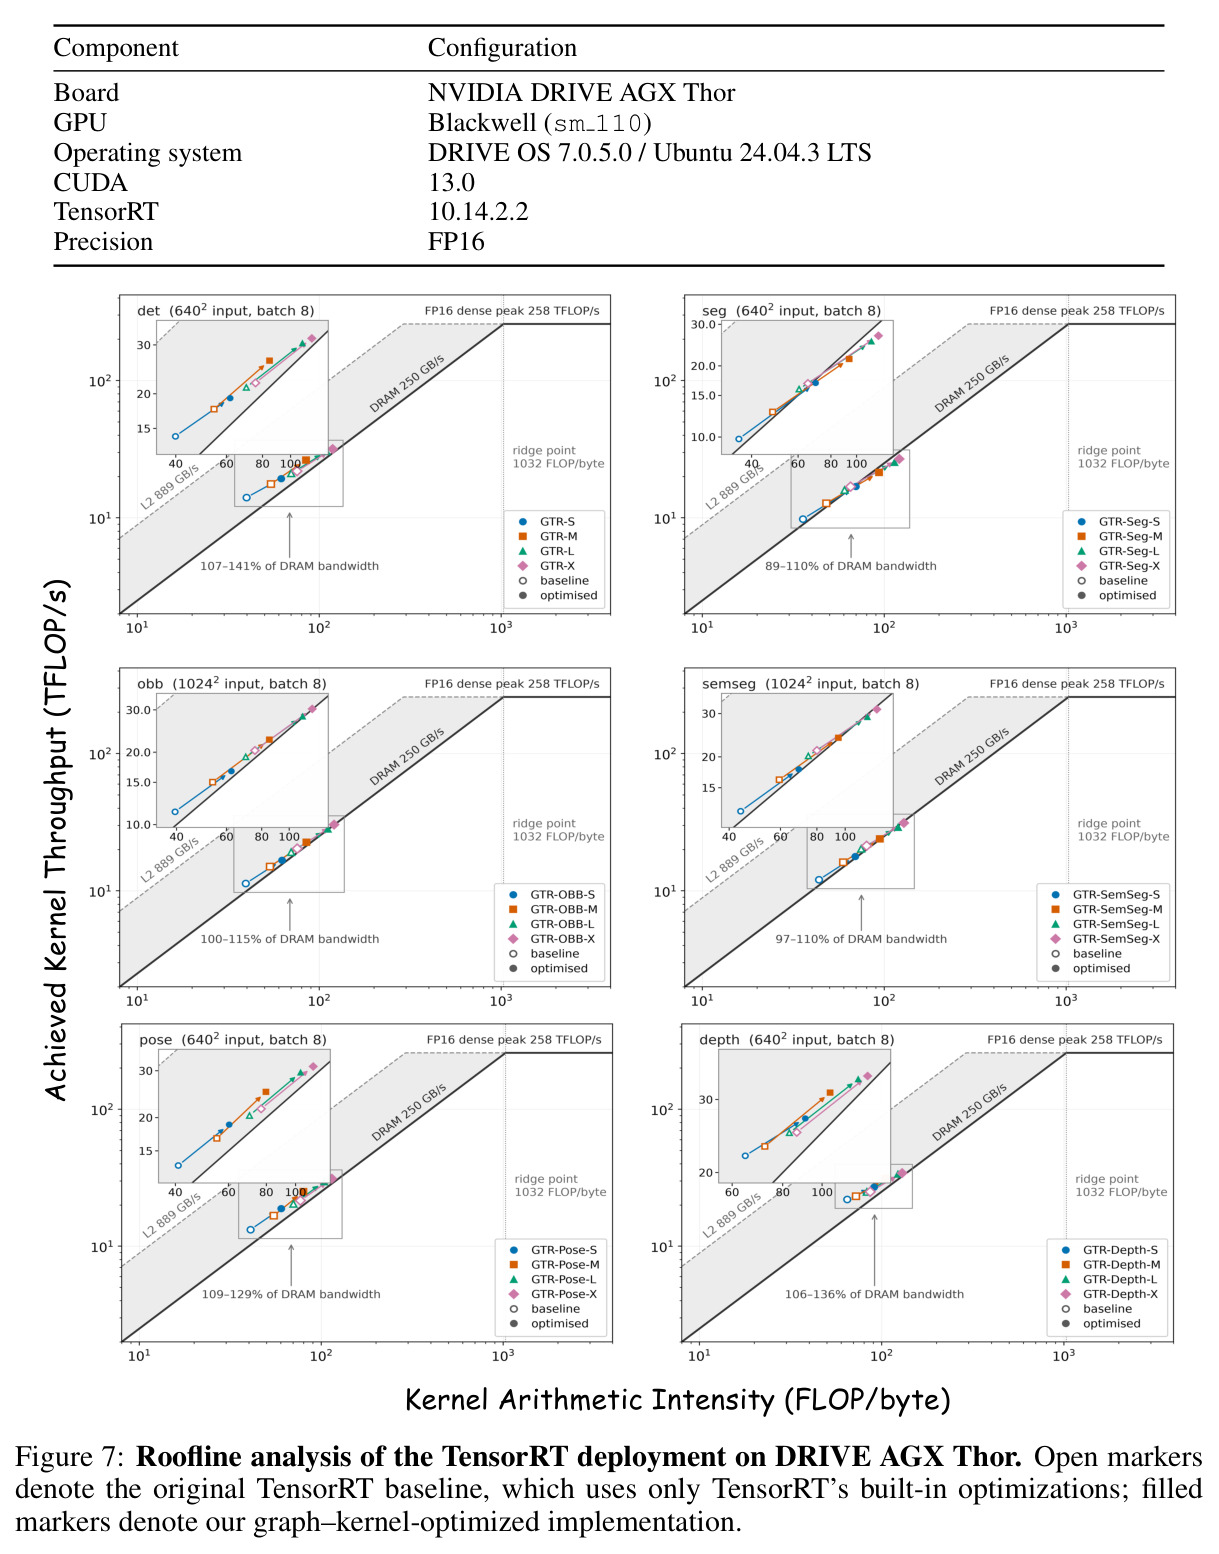
本文的目标是本文要回答一个中心问题:线性注意力能否支撑一个通用视觉骨干,使其在六大稠密预测任务上保持有竞争力的精度,同时把线性复杂度的理论优势转化为真实硬件上的低延迟?具体拆解为四点:其一,设计一个softmax-free、单尺度的循环骨干,参数量按S/M/L/X四档伸缩(12.1M至46.5M),可在固定patch网格上处理任意分辨率;其二,提出极简蒸馏方案,从检测特化的DINOv3教师迁移表征能力,不依赖掩码预测或中间层监督;其三,为GLA编写面向推理的专用chunkwise CUDA算子,把理论线性复杂度落实为RTX 4090上的毫秒级收益;其四,将整套模型集成进TensorRT并部署到NVIDIA DRIVE AGX Thor车规芯片,覆盖24个任务-规模组合,验证边缘实时可用性。
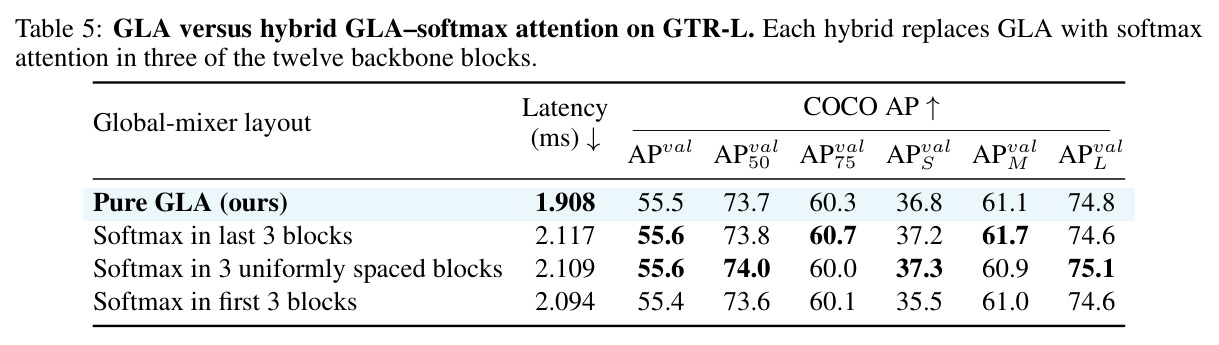
与已有工作不同的是,本文的独特切入角度有三点。架构上,它坚持全GLA同构设计,并用消融证明混入softmax注意力没有收益(Table 5:换入3个softmax块后AP仅在55.4–55.6之间波动而纯GLA为55.5,延迟却从1.908ms涨到2.094–2.117ms),这与MambaVision、SoLA-Vision等混合路线相反;同时把双向建模从每块内双向(ViG的做法)改为跨深度轮换四个扫描方向,并把局部性建模放进SwiGLU的值分支而非位置编码。训练上,它把跨架构蒸馏压缩到极致——仅对齐最终patch token、单一平方ℓ2损失、单阶段完成,却在同等条件下超过多阶段多损失的ViT-Linearizer与ViT-AdaLA。系统上,现有高效线性注意力kernel多服务于LLM服务器场景的Python/Triton栈,本文面向车规生产推理引擎做TensorRT图-核协同优化,用Roofline分析指导内存流量优化,填补了线性注意力在汽车级边缘部署上的空白。
核心方法
GTR的直觉是:用固定大小的循环状态以线性代价聚合全局上下文,用跨深度的方向轮换弥补单向扫描的视野缺陷,再用带深度卷积的通道混合器补上非因果的局部交互。技术路线为:输入图像经patch embedding得到stride-16的 $L=HW/16^2$ 个token,在12个结构相同的块中始终保持单尺度分辨率;每块先用key-only GLA沿一个方向完整扫描,扫描方向按左→右、右→左、上→下、下→上四方向在块间循环轮换,随后经Spatial SwiGLU做3×3深度卷积局部混合,全程不使用显式位置编码。做检测时,取第4/8/12块特征,双线性对齐后拼接并经轻量C2f融合成stride 8/16/32三级特征金字塔,送入DETR式解码器(300个query、4层、训练时3组查询共享参数)。骨干权重通过冻结的检测特化DINOv3教师做最终token对齐蒸馏获得,推理阶段用定制的chunkwise CUDA算子加速,并在TensorRT中做图-核融合部署。
核心创新是「方向轮换的key-only门控循环 + Spatial SwiGLU」组合。GLA每头维护状态 $S_t\in\mathbb{R}^{d_k\times d_v}$,按 $S_t=\mathrm{Diag}(\gamma_t)S_{t-1}+k_t^\top v_t$、$o_t=d_k^{-1/2}q_tS_t$ 递推,其中 $\gamma_t=\sigma(x_tW_\alpha^{(1)}W_\alpha^{(2)}+b_\alpha)^{1/\tau}$(秩16、$\tau=16$)是低秩数据相关保留门,GTR只用key侧衰减、value侧固定为1。与已有方法的本质区别有三:一是循环是因果的,单次扫描只能看到一个方向,GTR不让每块做双向(如ViG),而是让12块轮换四个扫描方向,使token沿深度逐步获得互补的二维上下文;二是GTR不加位置编码,而是把3×3深度卷积嵌入SwiGLU值分支:$Y=\mathrm{SiLU}(XW_g)\odot\mathrm{DWConv}_{3\times3}(XW_v)W_o$,以近乎零的开销提供非因果局部混合;三是蒸馏只优化 $\mathcal{L}_{\text{align}}=\frac{1}{L}\sum_{i=1}^{L}\|\phi(Y^i_{\text{stu}})-Y^i_{\text{tea}}\|_2^2$,不约束内部计算,让学生自由演化出适合自己的循环机制。
方法步骤详情
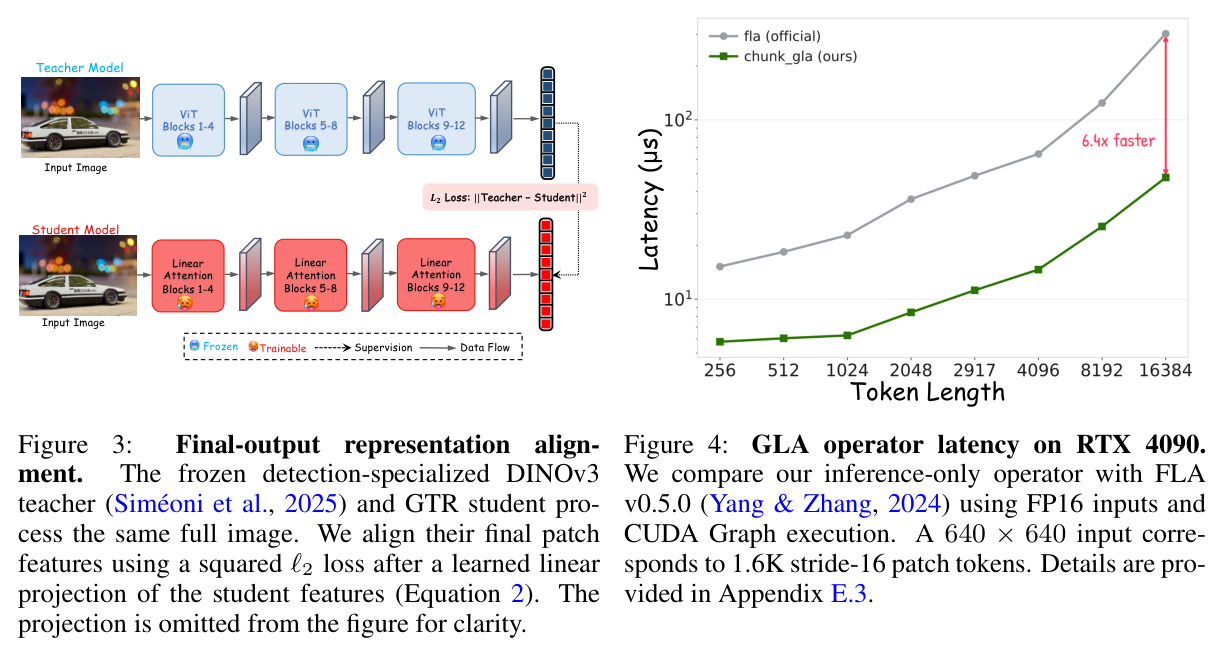
流程分五步。第一步蒸馏预训练:冻结检测特化DINOv3教师(ECTeacher-S管GTR-S,ECTeacher-B管M/L/X),师生输入同一全图,学生对最终 $L$ 个patch token做线性投影 $\phi$ 后与教师特征算平方ℓ2损失,在ImageNet-1K+COCO上以全局batch 2048、峰值学习率 $1.5\times10^{-3}$ 训练300轮,只更新GTR和投影层。第二步检测器预训练:蒸馏骨干初始化完整检测器,Objects365上训36轮(全局batch 128)。第三步COCO微调:加载除分类头外的全部检测器权重,640×640输入训30轮(全局batch 32)。第四步任务迁移:姿态、分割、旋转框检测、深度估计各接任务专属头并仅初始化骨干,如深度任务用Depth Anything 3伪标签的八源数据混合、以 $\lambda=0.5$ 的SiLog损失训练DPT式头部。第五步推理加速:CUDA算子按 $C=64$、$d_k=32$、$d_v=64$、FP16、零初态特化,先跨块并行算摘要 $U_c$,再串行传播边界态 $S_{[c+1]}=\mathrm{Diag}(d_c)S_{[c]}+U_c$,最后独立算各块输出并融合RMSNorm与输出门;车端经TensorRT图-核协同优化部署。
技术新颖性
新颖性体现在四个层面。架构层面:这是少数纯同构GLA视觉骨干,Table 5证明softmax混合无收益,反对了流行的混合注意力潮流;四方向跨深度轮换是相对ViG块内双向的新调度,Table 4显示收益稳定(55.5 vs 单向54.4 AP)。局部建模层面:把位置信息从token嵌入移到通道混合器值分支,768²/1024²分辨率下分别+1.2/+1.3 AP,且分辨率越高收益越大(1024²下小目标AP从40.6升至42.1)。训练层面:单阶段、单损失、仅最终token的蒸馏取得50.7 AP,胜过ViT-Linearizer两损失方案(50.0)与ViT-AdaLA两阶段方案(48.2),挑战了跨架构蒸馏必须复杂对齐的共识。系统层面:推理专用chunkwise kernel按GTR固定配置深度特化(FP16、零初态、无反向),用张量核心MMA加共享内存融合把FLA的串行状态tile并行化,1.6K token上取得4.0×加速,并把RMSNorm加输出门融合进输出epilogue,属于架构-内核-部署全栈协同设计。
实验结果
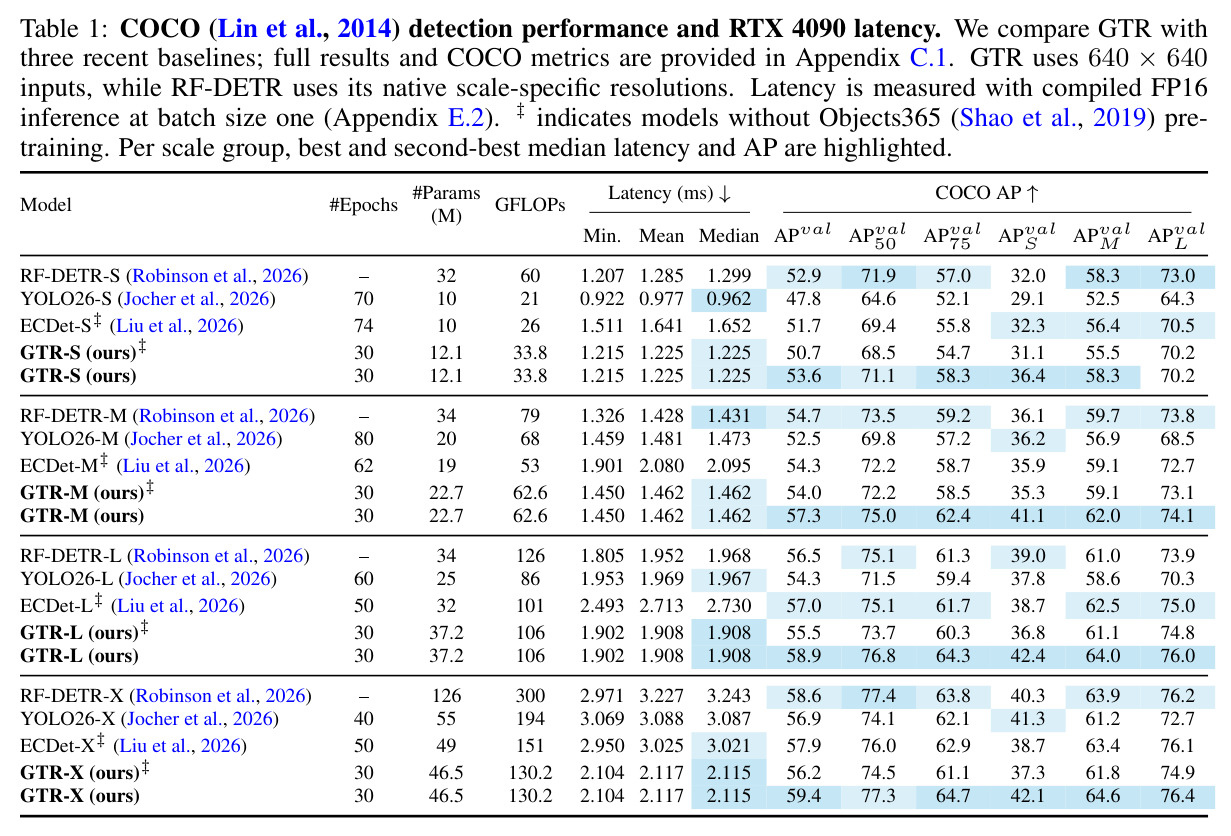
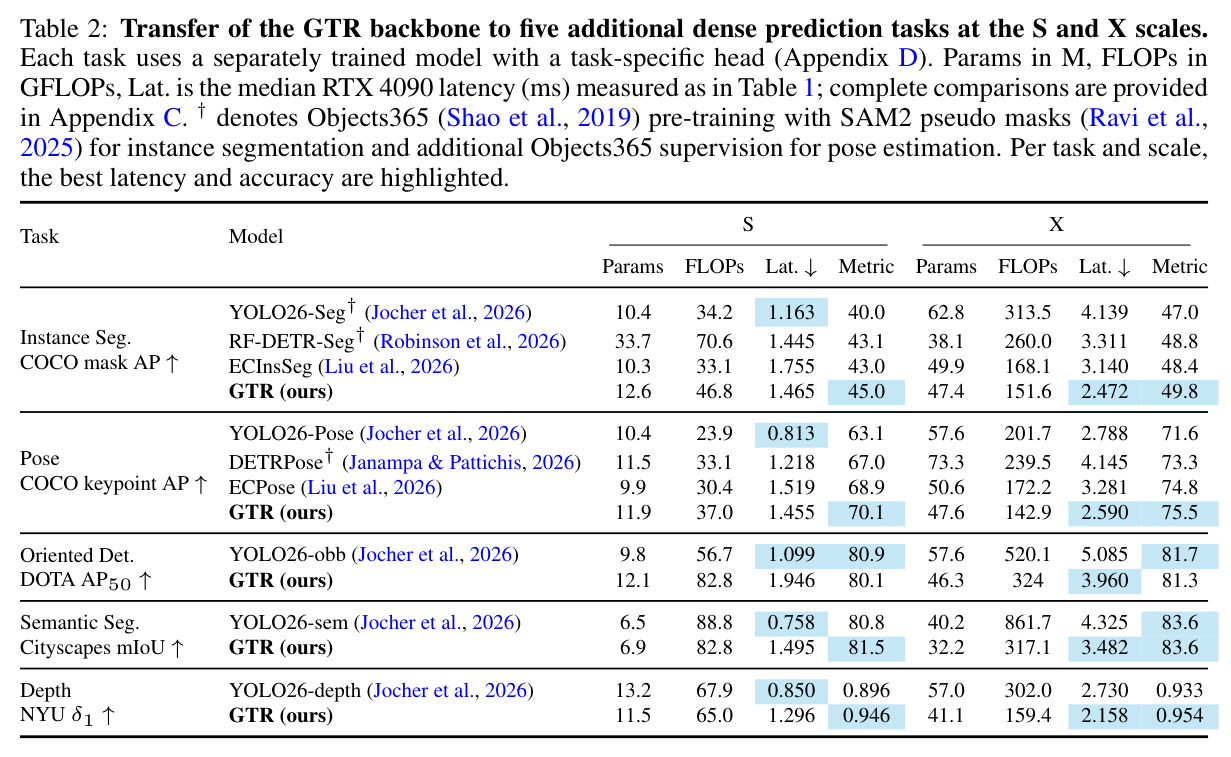
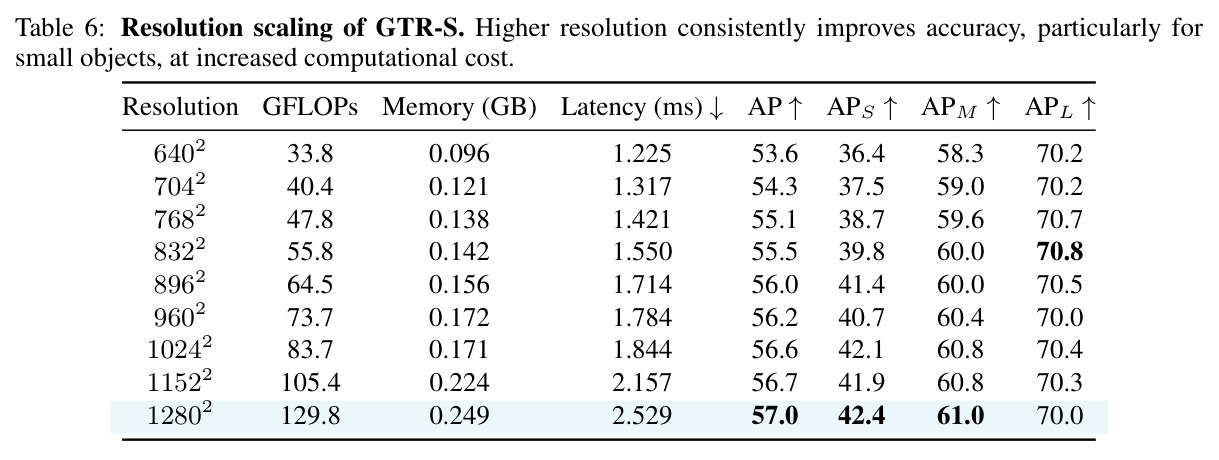
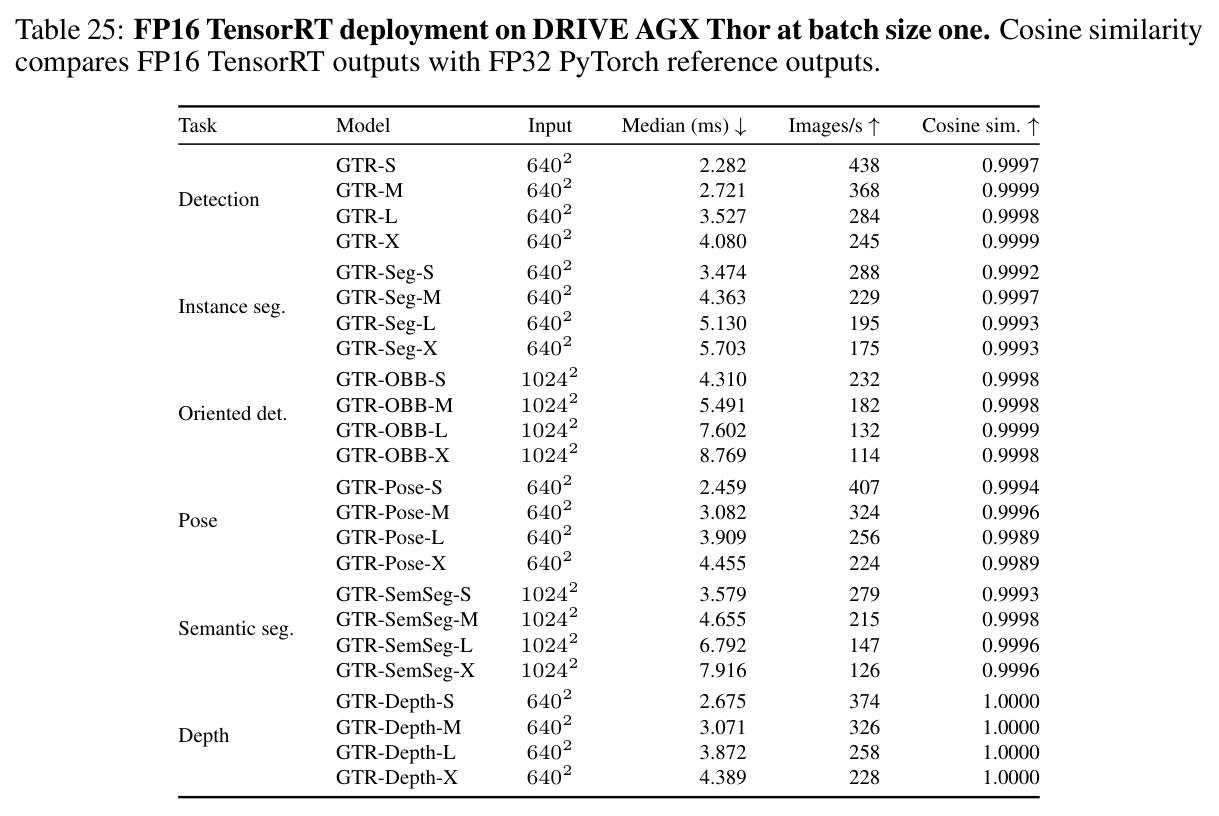
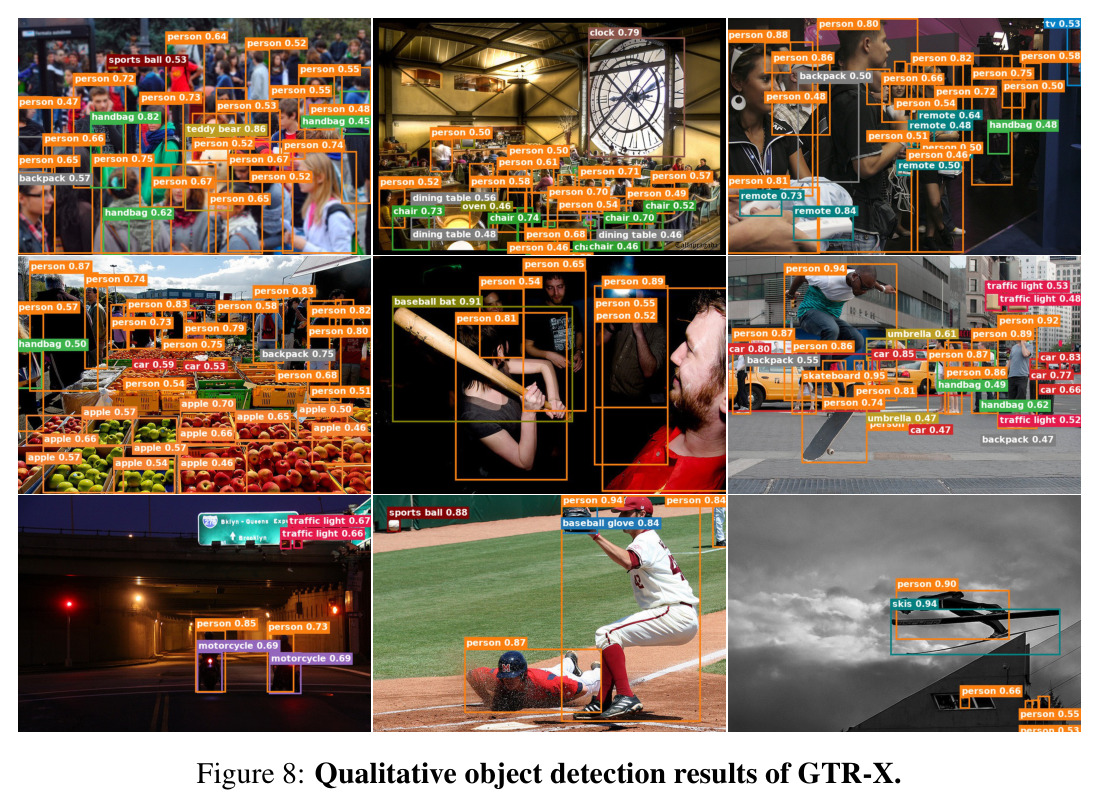
核心结果。(1) COCO检测(Table 1):带Objects365预训练的GTR-S/M/L/X达53.6/57.3/58.9/59.4 AP,四个规模组AP全部第一;GTR-L以1.908ms中位延迟拿下58.9 AP,优于RF-DETR-L(56.5 AP、1.968ms);GTR-X 59.4 AP@2.115ms对比RF-DETR-X的58.6 AP@3.243ms,快约35%且高0.8 AP。(2) 任务迁移(Table 2):实例分割45.0/49.8 mask AP且无需SAM2伪掩码;姿态70.1/75.5 keypoint AP双超ECPose且更快;DOTA 81.3 AP50略低于YOLO26x-obb(81.7)但快22%;Cityscapes 83.6 mIoU追平YOLO26x-sem且延迟低19.5%;NYU零样本深度 $\delta_1$ 达0.946/0.954,超YOLO26-depth的0.896/0.933。(3) 消融:极简蒸馏50.7 AP胜过ViT-Linearizer 50.0与ViT-AdaLA 48.2,从头训练仅31.1;纯GLA与混softmax精度持平但延迟低约10%;分辨率640²→1280²时token增4倍延迟仅增2.06倍。(4) 核与部署:专用算子比FLA快2.6/4.0/6.4×;Thor上24个配置batch-1延迟2.282–8.769ms,余弦相似度≥0.9989。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| COCO目标检测(GTR-L,带Objects365预训练) | COCO val2017 box AP / 中位延迟 | 58.9 AP @ 1.908 ms | RF-DETR-L:56.5 AP @ 1.968 ms | +2.4 AP 且延迟更低,同组精度与速度双赢 |
| COCO目标检测(GTR-X) | COCO val2017 box AP / 中位延迟 | 59.4 AP @ 2.115 ms | RF-DETR-X:58.6 AP @ 3.243 ms | +0.8 AP,延迟降低约35% |
| COCO实例分割(GTR-X,无SAM2伪掩码) | mask AP / 中位延迟 | 49.8 @ 2.472 ms | RF-DETR-Seg-X(用SAM2伪掩码):48.8 @ 3.311 ms | +1.0 mask AP,延迟降低25.3% |
| COCO人体姿态估计(GTR-X) | keypoint AP / 中位延迟 | 75.5 @ 2.590 ms | ECPose-X:74.8 @ 3.281 ms | +0.7 AP,延迟降低约21% |
| DOTA-v1.0旋转框检测(GTR-X) | AP50 / 中位延迟 | 81.3 @ 3.960 ms | YOLO26x-obb:81.7 @ 5.085 ms | AP低0.4但延迟降低22%,且比RTMDet-R-l高0.8 AP50 |
| Cityscapes语义分割(GTR-X) | mIoU / 中位延迟 | 83.6 @ 3.482 ms | YOLO26x-sem:83.6 @ 4.325 ms | 精度持平,延迟降低19.5%,参数少20.0%、FLOPs少63.2% |
| NYU Depth V2零样本单目深度(GTR-X) | δ1(AbsRel / RMSE) | 0.954(0.067 / 0.317)@ 2.158 ms | YOLO26x-depth:0.933(0.080 / 0.344)@ 2.730 ms | δ1 +0.021,AbsRel与RMSE全面更优,延迟降低约21% |
| GLA推理kernel(RTX 4090,1.6K token) | 相对FLA v0.5.0的加速比 | 4.0×(256/16.4K token为2.6×/6.4×) | FLA v0.5.0(1×基准) | 同精度下最高6.4倍加速 |
| 跨架构蒸馏对比(GTR-S,无Objects365) | COCO AP | 50.7(单阶段、单损失、仅最终token) | ViT-Linearizer 50.0(2损失)/ ViT-AdaLA 48.2(2阶段)/ 从头训练 31.1 | 以最简设计分别高出0.7和2.5 AP |
局限与改进
作者承认或可从数据读出的局限:其一,旋转框检测上GTR-X(81.3 AP50)略低于YOLO26x-obb(81.7),小规模GTR-S(80.1)也低于YOLO26s-obb(80.9),说明纯线性循环在需高精度角度回归的任务上尚未完全追平CNN系检测器;其二,语义分割小规模GTR-S延迟1.495ms明显高于YOLO26s-sem的0.758ms,极轻量场景吞吐有差距;其三,NYU深度成绩依赖六视角TTA加逐图log-affine对齐,完整评估的真实开销更高,且训练依赖DA3教师生成伪标签;其四,无Objects365预训练时AP全面下降(GTR-S 50.7 vs 53.6),显示对大规模检测预训练依赖较强。我的补充观察:循环的因果性使每块仍有方向偏差,四方向轮换收益已趋饱和(55.5 vs 水平双向55.1);蒸馏完全绑定DINOv3教师,教师偏置会传导给学生;推理kernel绑定batch-1与固定维度配置,其它设置需回退通用实现;论文未报告ImageNet分类结果,骨干通用表征能力缺少该维度佐证。
独立分析的弱点
独立分析的弱点及改进方向:(1) 单向因果扫描的信息不对称——块内靠后token能看到全部历史而靠前token只见部分,方向轮换只是缓解;可引入DeltaNet式delta rule更新、正反双状态融合,或让每块学习内容自适应的扫描方向。(2) 单尺度stride-16骨干对细粒度任务不友好——语义分割与深度估计需要stride-4/8细节,目前靠neck端插值弥补;可探索层级化多尺度GLA或浅层更小stride。(3) 蒸馏目标单一——仅对齐最终token在更强教师或更大模型下可能不足,可补充最后数层的多尺度对齐或关系蒸馏。(4) kernel工程耦合过高——绑定FP16、$C=64$、固定头维度与batch-1,缺INT8/FP8量化、可变分辨率与多batch支持;应开发训练-推理一体kernel并支持量化感知部署。(5) 车端算力边界——Thor上1024²输入的GTR-OBB-X已达8.769ms,逼近实时上限,更高帧率需与蒸馏、剪枝、量化协同。(6) 基线公平性依赖自测延迟——协议虽统一透明,但对不同模型的部署转换深度不同,仍可能引入难以察觉的偏差。
未来方向
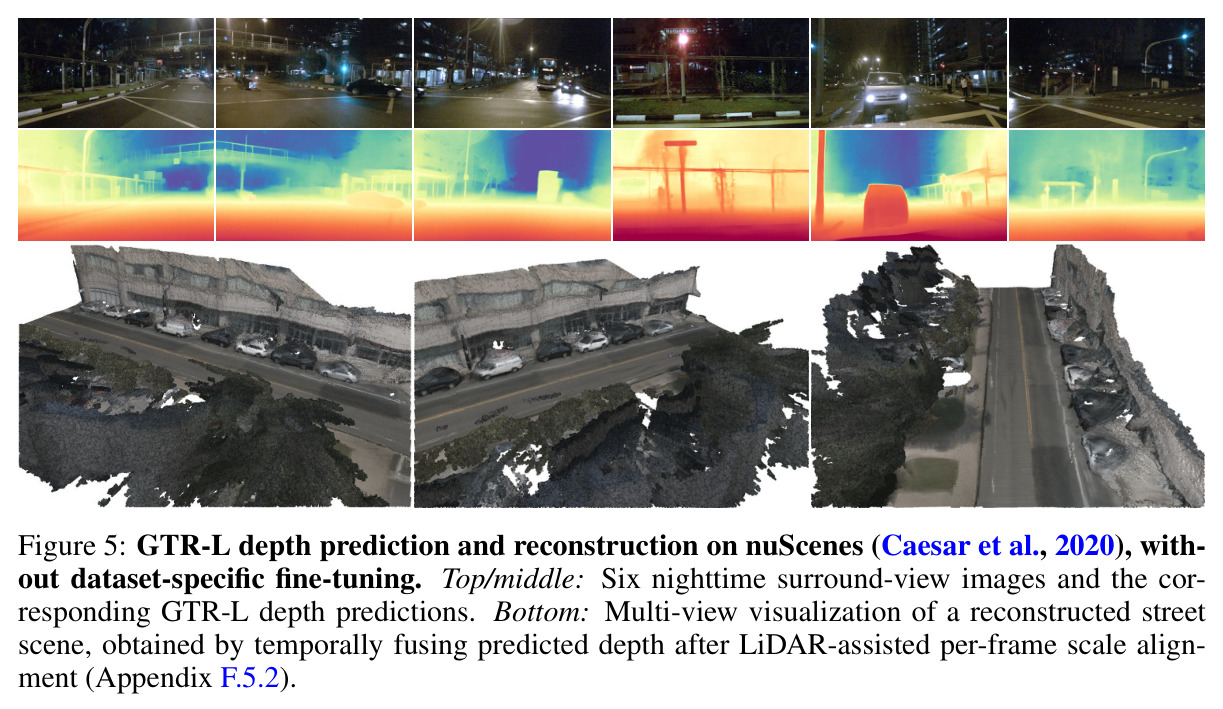
未来方向:作者层面,论文指出线性注意力可作为高分辨率稠密预测与边缘部署的有效替代,自然延伸是推向视频时序任务——nuScenes时序TSDF融合实验已证明单帧深度可跨帧融合,循环结构天然适合时序递推;此外可接入开放词汇检测、SAM式分割、BEV/占据栅格等3D感知头,并探索更强教师与更大规模。基于成果可延伸的研究:(1) 用可学习或内容自适应的扫描顺序替代固定四方向轮换,结合选择性状态空间机制做动态路由;(2) 分析保留门 $\gamma_t$ 学到的衰减谱与感受野/物体尺度的对应关系,做循环视觉模型的可解释性研究;(3) 检验极简蒸馏范式在LLM侧Transformer到线性RNN转换中是否同样成立;(4) 把chunkwise特化kernel思路推广到DeltaNet等更强更新规则,并扩展低精度数据类型以适配车规算力;(5) 高分辨率带来的小目标收益(AP_S +6.0)提示与遥感解译、文档OCR、工业质检等天然高分辨率场景结合;(6) 探索GLA与少量窗口softmax注意力的低成本混合,在长程依赖不足的极端场景下补充精确注意力。
复现评估
复现评估:论文提供Project Page与GitHub链接,超参披露非常完整——附录D给出六任务的优化器、学习率与调度(Tables 16–23),附录E.3给出CUDA kernel实现细节,附录E.2给出统一延迟测量协议(FP16、batch-1、torch.compile全图编译、CUDA Graph、中位数统计)。数据全部公开:ImageNet-1K、COCO、Objects365、Cityscapes、DOTA-v1.0、NYU及八个深度源,深度教师为公开的Depth Anything 3。算力门槛较高:8×A100训练,每规模需300轮蒸馏+36轮Objects365+30轮COCO再加各任务微调,六任务×四规模完整复现成本不菲;但只验证检测主线或用官方检查点推理时,单张RTX 4090即可复测延迟。难度评估:复现延迟基准较容易;从头复现全部训练属中高难度,主要工作量在Objects365预训练与多任务管线;Thor部署需车规硬件,普通实验室难验证,但24个配置余弦相似度≥0.9989的数值校验增强了可信度。
论文图表
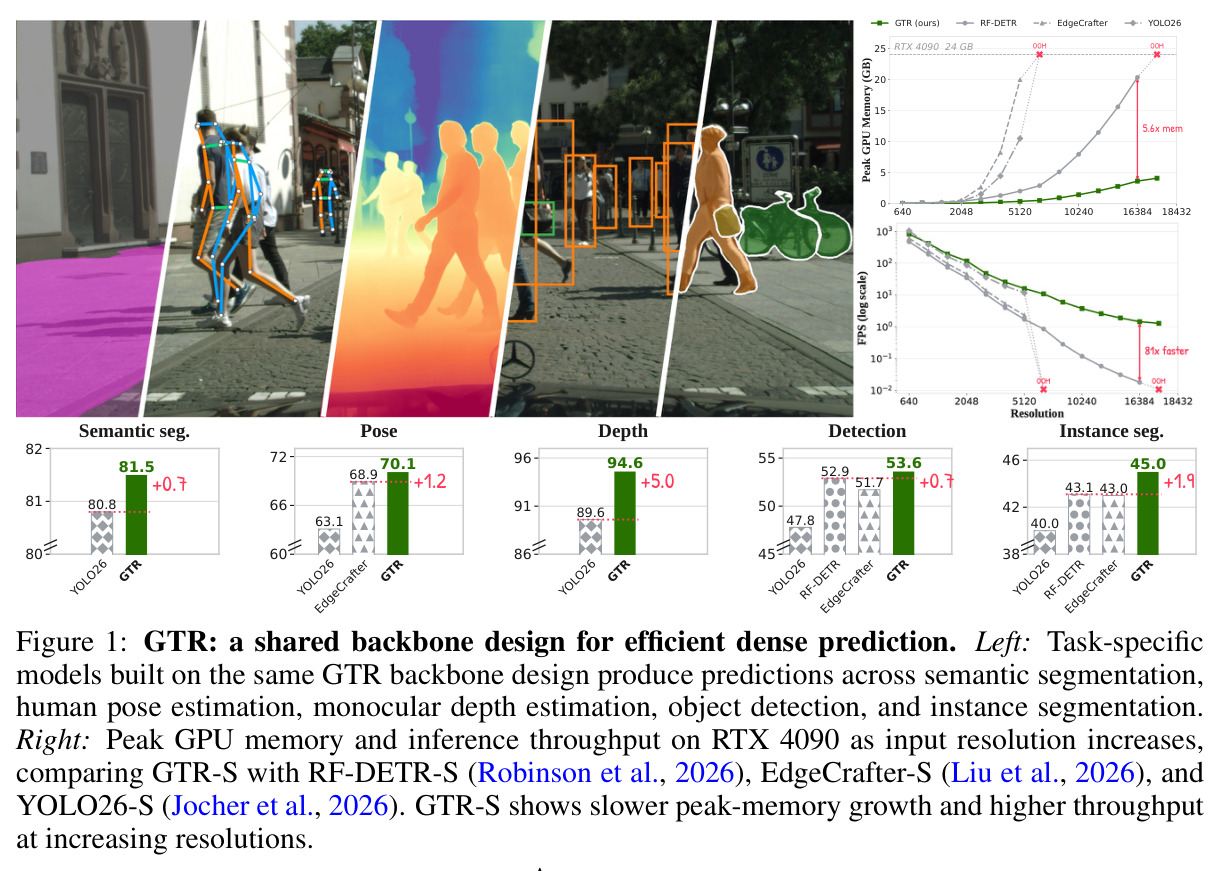
左图展示同一GTR骨干设计在语义分割、人体姿态估计、单目深度估计、目标检测与实例分割上的预测效果;右图展示RTX 4090上随输入分辨率增加,GTR-S与RF-DETR-S、EdgeCrafter-S、YOLO26-S的峰值显存与推理吞吐对比,GTR-S显存增长更慢、高分辨率下吞吐更高。
一图道出论文核心卖点:单一骨干通吃六任务,且线性复杂度在高分辨率下转化为实际的显存与吞吐优势,是全文论证的起点。