MemoryAthena:潜在记忆与生成记忆的自适应路由 MemoryAthena: Adaptive Routing over Latent and Generated Memories
用E锚定路由头在直接检索与两种生成记忆间选择性干预,QA均值37.65升至39.28
前置知识
检索增强生成(RAG)与 kNN-LM
RAG 在生成前从外部文档库检索相关文本拼入上下文;kNN-LM 维护一个非参数数据store,用当前隐状态做近邻检索,把检索到的分布与模型预测插值。两者共同点是:传给模型的都是存储中被原样取出的一项,不做任何改写。
本文把这两类方法与学习型记忆并列为'存储项原样进入模型'的既有范式,理解它们才能看懂'记忆可否被生成'这一问题为何新颖,以及表1/表2 中 RAG、kNN-LM 基线(如六任务 NLP 平均 76.48、71.34)的意义。
Engram 可寻址记忆
Engram(Cheng et al., 2026)把记忆放在骨干模型之外:一张基于因果 N-gram 查找的可寻址条件记忆表,按寻址规则 $m_t = M_\phi[\mathrm{canon}(x_{\le t})]$ 取出表示,再经轻量读取器映射后注入骨干。寻址、存储、读取三个角色相互独立、可分别修改。
MemoryAthena 的 E 通路就是对 Engram 的直接读取,GE 通路以检索到的 Engram 线索为条件做生成,理解该结构是理解三通路设计与'检索 vs 生成'对比的前提。
残差注入与记忆读取器
外部信息进入冻结骨干的常用方式:读取器把检索或生成的表示与当前隐状态 $h_t^\ell$ 一起映射为同维残差,按 $h_t^\ell \leftarrow h_t^\ell + r_t^\ell$ 加到指定层(本文为第 2、10 层)。骨干权重完全不动,只改变'喂给它的东西'。
三条通路的差异全部体现在残差 $e, g_{GE}, g_{GH}$ 的构造方式上,路由与插值 $r=e+\alpha(g-e)$ 也在残差层面操作,不懂残差注入就无法理解方法主体。
教师强制与反事实优势
教师强制指训练时把真实前缀逐位置喂给模型预测下一词元。本文据此让每条通路单独给出下一词元分布,定义反事实优势 $a_{s,t}=\log p_s(x_{t+1}|x_{\le t})-\log p_E(x_{t+1}|x_{\le t})$:'若当时走通路 s 而非 E,模型对真实未来的把握会好多少'。
这是路由头唯一的训练信号,完全不依赖下游任务标签;公式 (2)/(8) 与多未来位置聚合 $A_{s,t}$ 构成方法第三阶段的全部核心,是读懂训练流程的关键。
混合专家路由
MoE(Shazeer et al., 2017)训练门控网络,按输入在多个等价专家之间做对称选择或学习权重融合。本文场景不同:E 是现成的强基准,GE/GH 只是对它的候选修正,属于非对称的'准入式'路由——先判断要不要干预,再决定谁干预、以多强干预。
论文以 MoE 式路由为对照(普通硬路由 35.83、普通软融合 28.62,均逊于本文 39.28),理解两者的本质区别才能领会 E 锚定设计的动机与消融结论。
研究动机
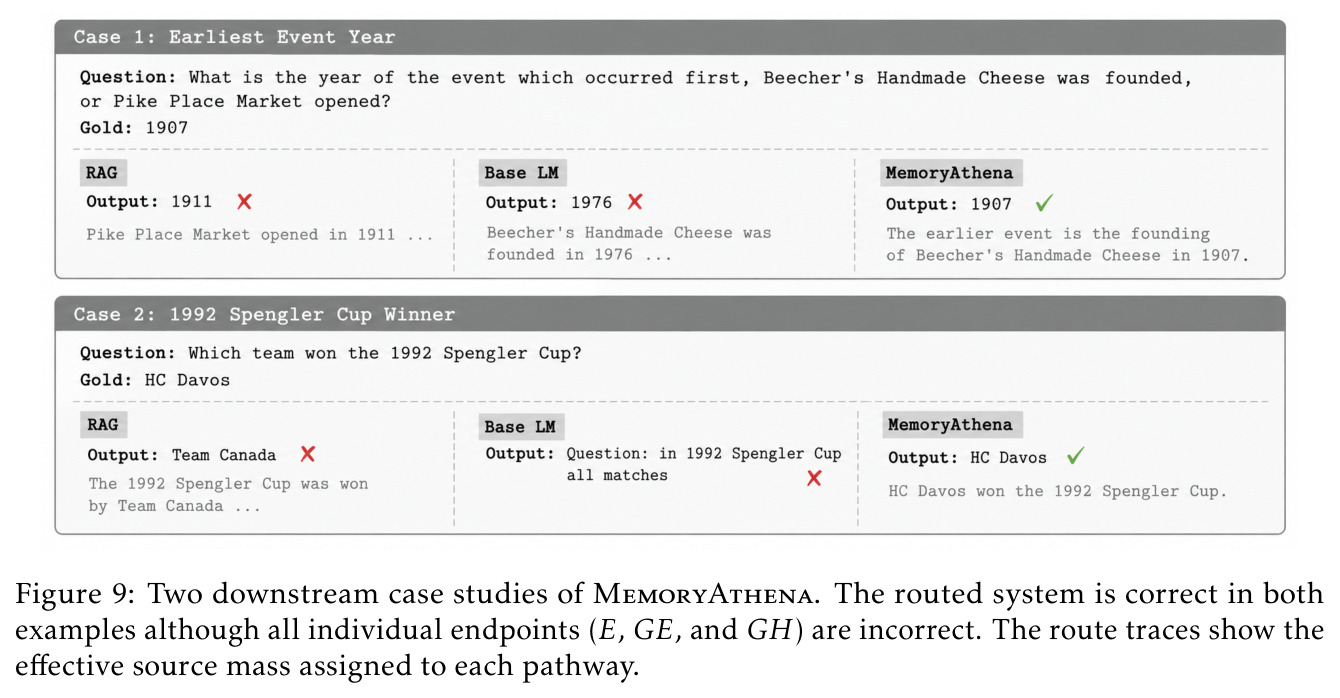
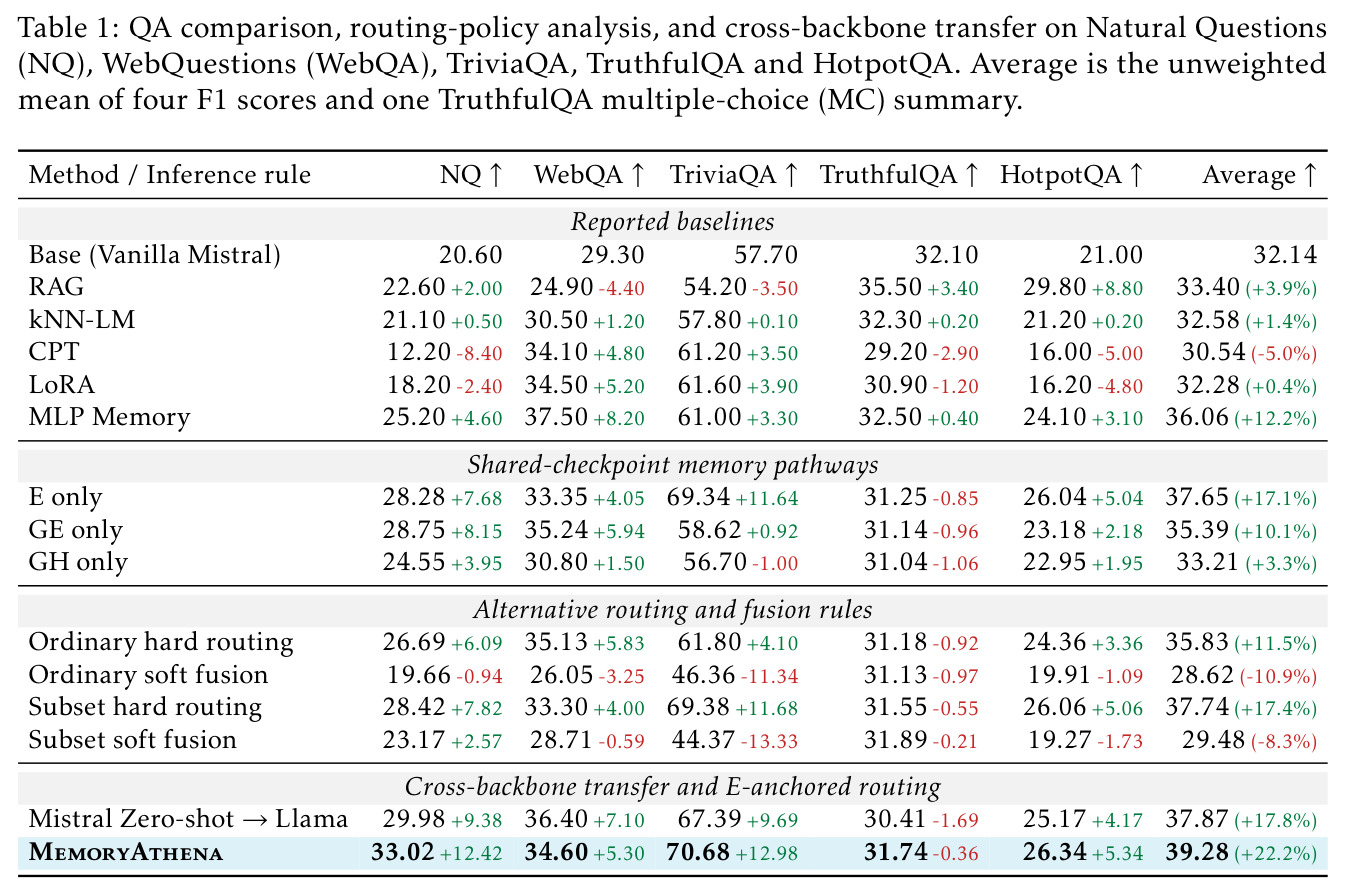
让语言模型用上参数之外的知识,现有三条主流路线:RAG 检索外部文本、kNN-LM 从非参数数据store取近邻样本、以及学习型记忆(MLP Memory、Engram 等)在推理时读取可训练表示。Li 等(2026)进一步把记忆系统拆成寻址、存储、读取三个可复用角色,使记忆可跨骨干模型迁移。但这些方法的共同点是:注入模型的表示永远是'查表得到的那一条',存储内容被原封不动传给模型。作者由此追问:有用的记忆是否一定要从存储中检索,能否由模型生成?这一问题有真实数据支撑:在 Vanilla Mistral 五个问答基准(NQ/WebQA/TriviaQA/TruthfulQA/HotpotQA)平均 32.14 分的基础上,直接检索路径 E 达到 37.65;但从 Engram 线索生成的 GE 在 WebQA 上把 33.35 提到 35.24,却在 TriviaQA(58.62 对 69.34)和 HotpotQA(23.18 对 26.04)明显掉分;完全不查记忆表的 GH 在全部五个 QA 指标上都弱于 E。也就是说,生成记忆'有时互补、有时干扰',不能一刀切替换直接检索。
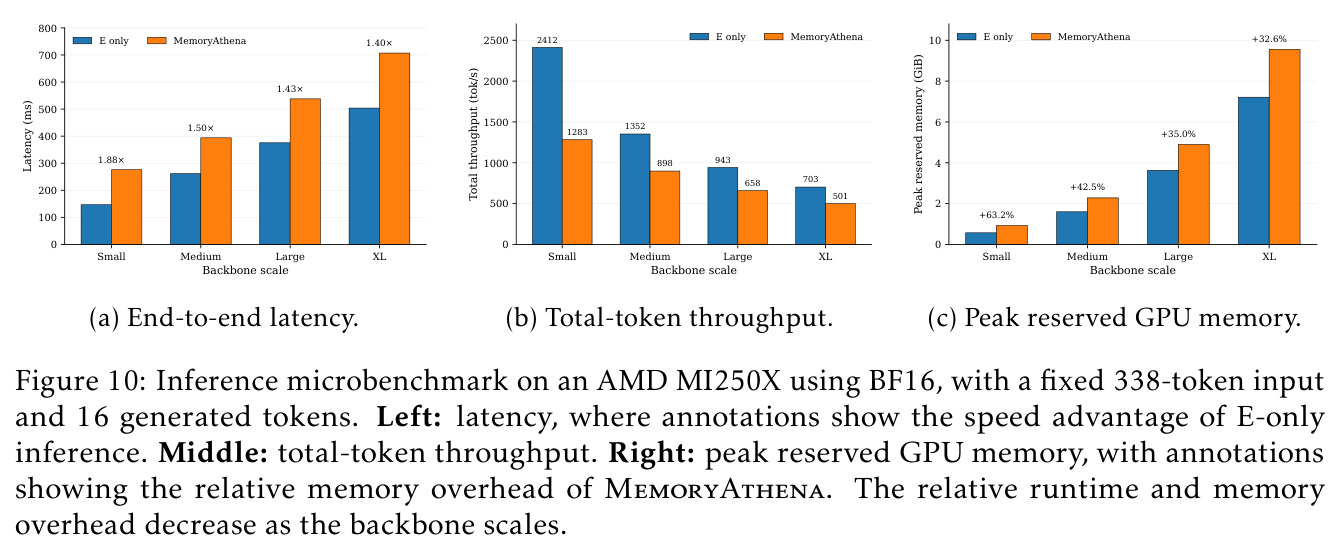
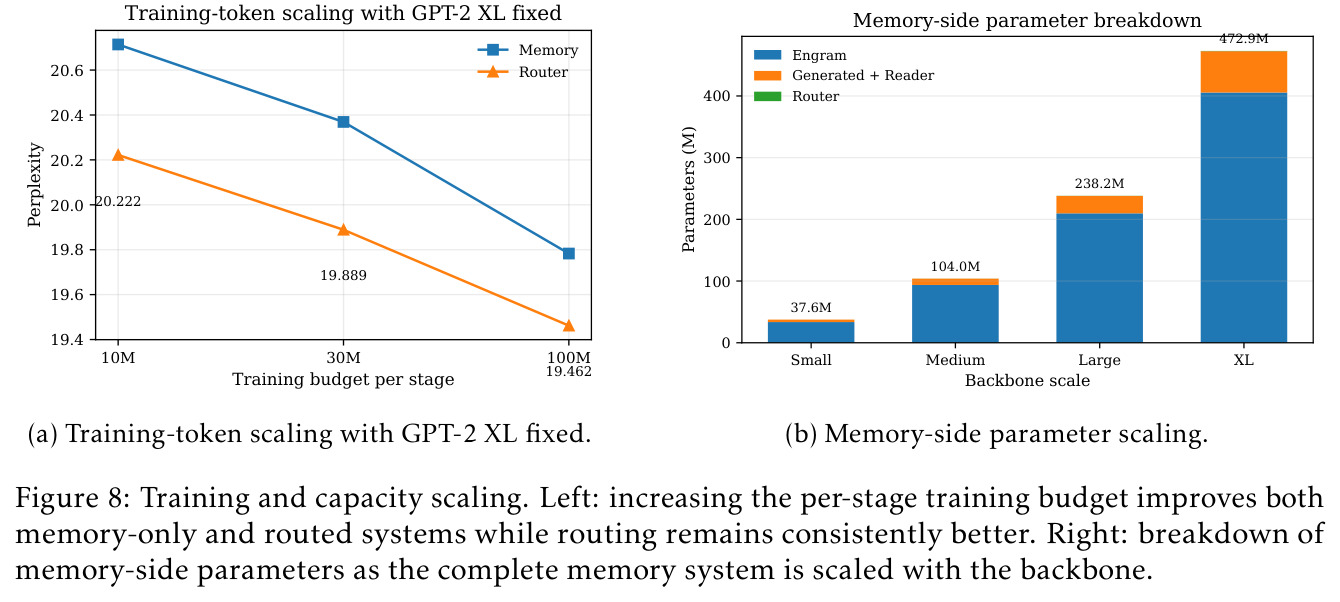
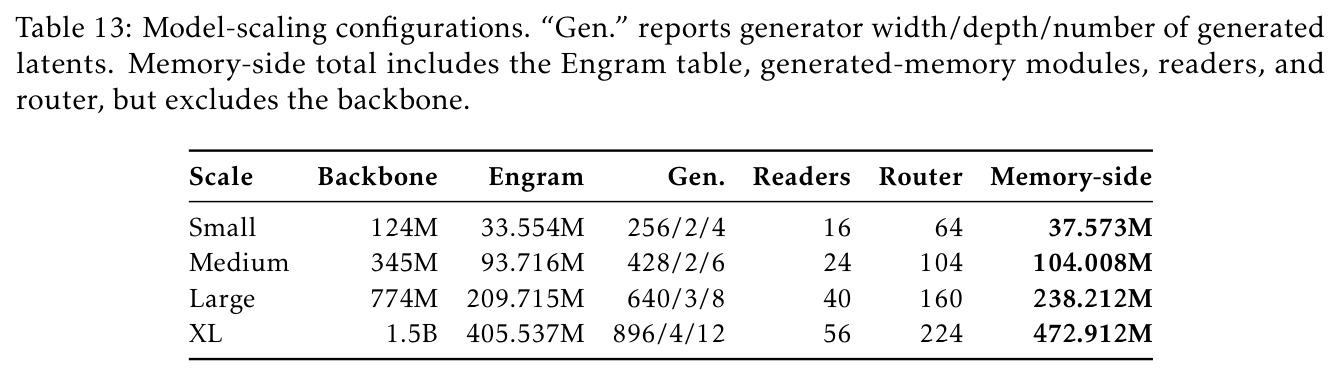
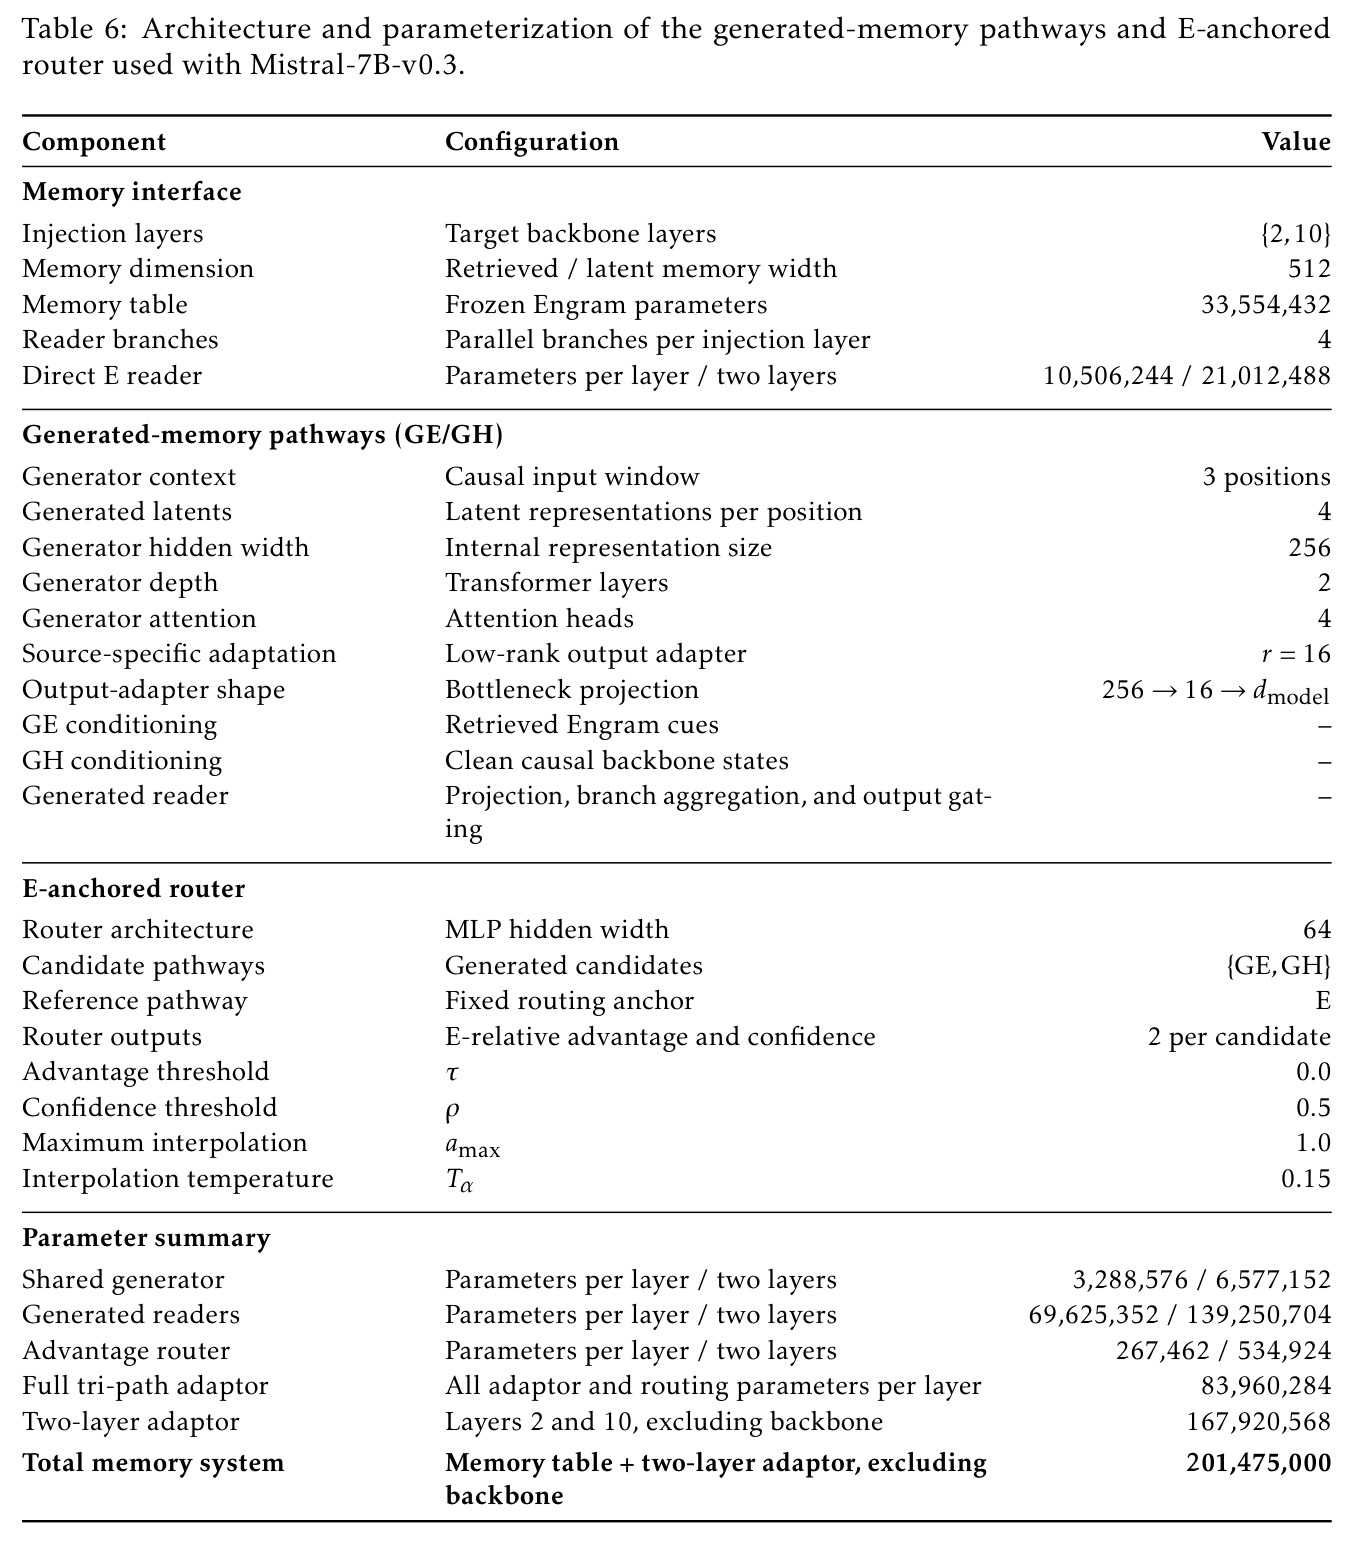
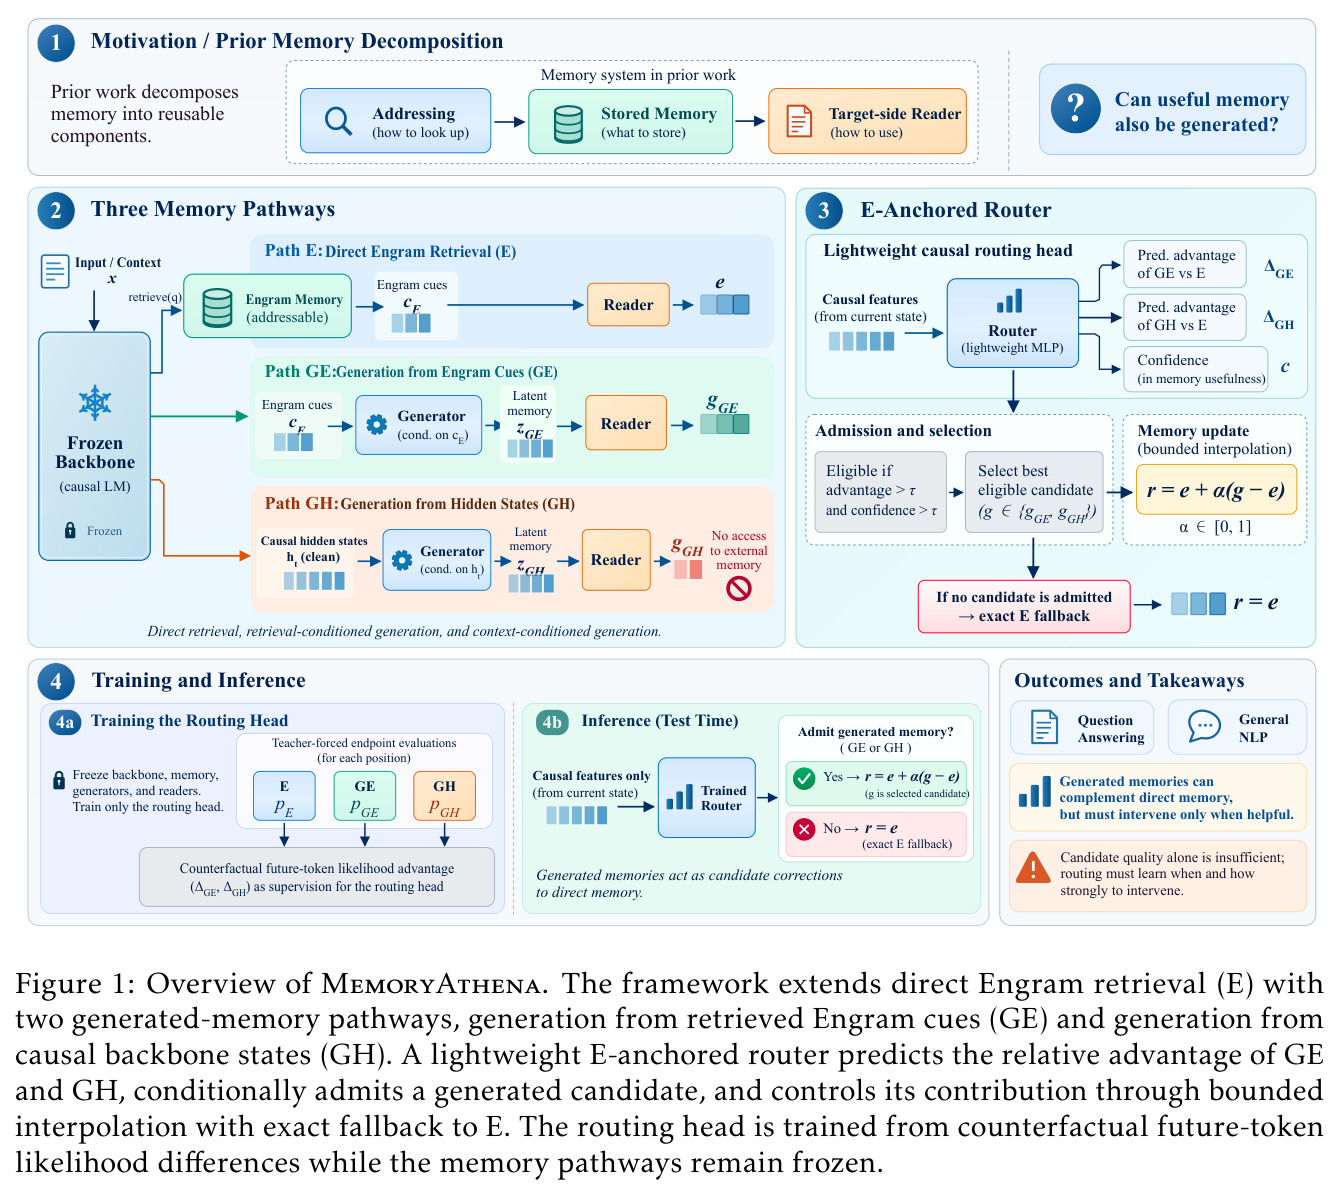
本文的目标是本文的目标是回答'记忆能否被生成'并给出可部署的系统方案:构建一个三通路记忆接口——直接 Engram 检索(E)、以检索到的 Engram 线索为条件生成潜在记忆(GE)、以及不查记忆表、仅由因果骨干隐状态生成(GH);然后在骨干、记忆、生成器、读取器全部冻结的前提下,只训练一个轻量因果路由头,学会'何时、选谁、以多强'让生成记忆对直接检索记忆进行干预。具体量化目标是同一 checkpoint 上超越 E 直接通路:问答五任务平均从 37.65 提升、通用 NLP 六任务平均从 76.73 提升,且拒绝生成候选时必须能精确回退到 E 以保证不劣化。整个记忆侧系统(不含冻结骨干)约 201M 参数,主骨干为 Mistral-7B-v0.3,记忆注入在第 2 和第 10 层。
与已有工作不同的是,已有工作的盲区在于:MoE 式条件路由把所有专家视为对等候选做对称选择,而记忆场景并非如此——E 已经是一条足够强的直接记忆基准,GE/GH 只是对它的候选修正。本文的独特切入是把'生成记忆'从'替换问题'改造成'条件干预问题':以 E 为显式锚点,仅当生成候选的预测相对优势与置信度双双越过阈值($\hat A > \tau$ 且 $\sigma(c) \ge \rho$)才准入,再用有界插值 $r = e + \alpha(g-e)$、$0 \le \alpha \le 1$ 控制干预强度,拒绝时精确还原 E。训练信号也不依赖下游任务标签,而是用各冻结通路在教师强制下的未来词元似然差(反事实优势)蒸馏路由头,把'如何构造记忆表示'与'何时使用记忆'解耦为两阶段学习。这种'读+生成'的记忆谱系、非对称准入路由与无标签反事实蒸馏的组合,在记忆系统文献中是全新的。
核心方法
核心直觉:存储的记忆条目不必是最终注入模型的表示,它也可以只是'底料',由神经接口结合当前上下文重构出更丰富的潜在记忆。技术上,MemoryAthena 在冻结骨干 $f_\theta$ 上做残差注入:Engram 按寻址规则检索 $m_t = M_\phi[\mathrm{canon}(x_{\le t})]$,读取器将检索结果与隐状态映射为残差注入 $h_t^\ell \leftarrow h_t^\ell + r_t^\ell$。三通路给出三种残差:直接读取 $e_t^\ell = R_E^\ell(h_t^\ell, m_t)$;以 Engram 线索为条件生成 $z_t^{\ell,E}$ 再映射为 $g_t^{\ell,GE}$;仅由关闭记忆注入的另一趟因果隐状态生成 $g_t^{\ell,GH}$。三者同处一个目标隐空间、挂同一冻结骨干。轻量路由头 $q$ 基于当前状态特征 $\phi_t^\ell$ 预测候选相对 E 的优势 $\hat A_{s,t}$ 与置信度 $c_{s,t}$,准入后按 $r_t^\ell = e_t^\ell + \alpha_t^\ell(g_t^{\ell,s^\star}-e_t^\ell)$ 有界插值。骨干为 Mistral-7B-v0.3,记忆注入第 2、10 层,四分支读取器,记忆侧约 201M 参数。
核心创新是'以 E 为锚的非对称路由'。与传统 MoE 在等价专家间对称选择不同,这里 E 是现成的强基准,问题转化为生成表示是否带来额外效用:路由头默认保留 E,只有当生成候选的预测优势 $\hat A_{s,t} > \tau$ 且置信度 $\sigma(c_{s,t}) \ge \rho$ 同时满足才准入,再选优势最大者做有界插值修正;无候选通过则 $\alpha=0$、$r=e$,精确回退直接通路,部署上天然安全。第二个创新是无需下游标签的路由训练:冻结一切组件后,在教师强制下比较三条通路的下一词元分布,定义反事实优势 $a_{s,t} = \log p_s(x_{t+1}|x_{\le t}) - \log p_E(x_{t+1}|x_{\le t})$,在多个未来位置聚合成 $A_{s,t}$ 作为监督目标,并以 $\mathrm{stopgrad}$ 保证只有轻量路由头 $q$ 被更新;未来词元只出现在训练目标里,推理时路由保持因果。这把'构造记忆'与'选择记忆'的学习彻底解耦:先学怎么造候选记忆,再学何时用它们。
方法步骤详情
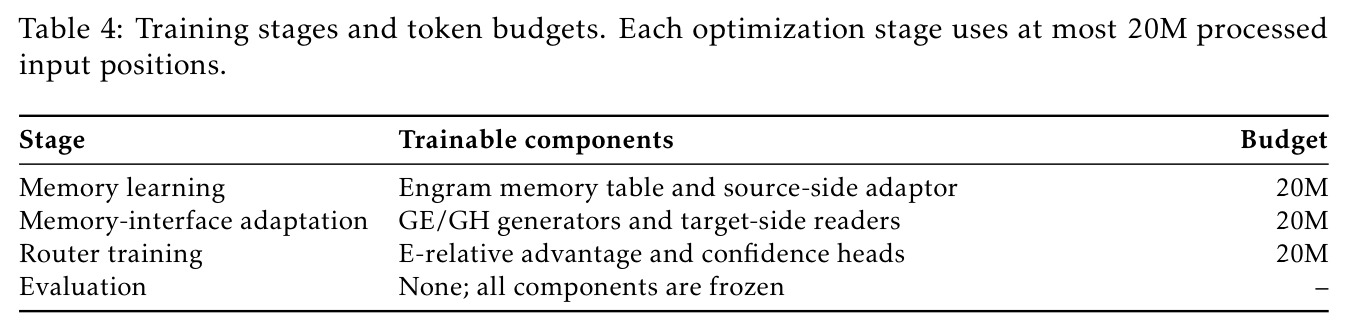
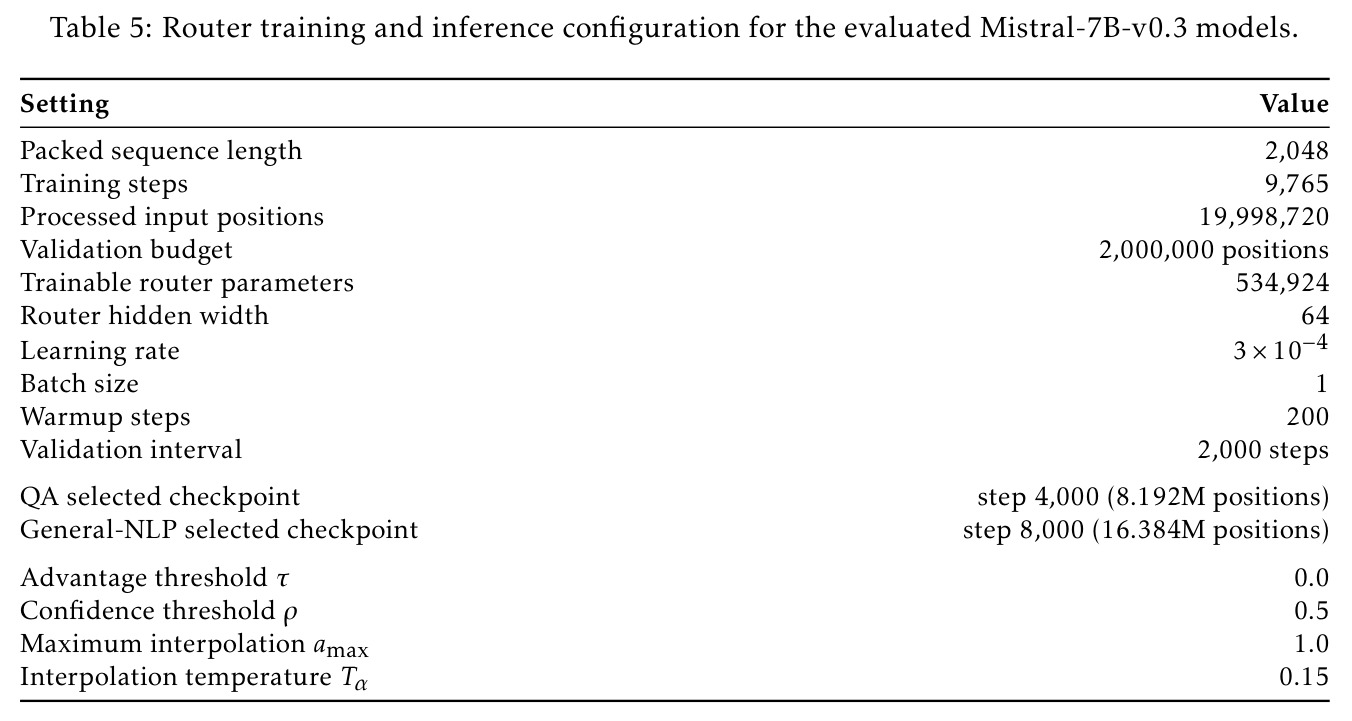
训练分三阶段。第一阶段:冻结源骨干,用因果语言建模目标训练可寻址 Engram 记忆表(源记忆来自 Llama-2-7B,供跨骨干迁移)。第二阶段:固定记忆与目标骨干 Mistral-7B-v0.3,适配记忆侧接口构造三通路——E 直接读取检索表示得 $e_t^\ell$;GE 以 Engram 线索 $c_E$ 为条件生成 $z_E$ 后经读取器映射;GH 从禁用记忆注入的因果隐状态生成 $z_H$ 再映射。第三阶段:全部冻结,只训轻量 MLP 路由头 $(\hat A_{s,t}, c_{s,t}) = q(\mathrm{stopgrad}(\phi_t^\ell))$,特征含隐状态与残差统计量,监督为多未来位置聚合的反事实优势 $A_{s,t}$。推理按 Algorithm 1:预测优势与置信度;准入集合 $C=\{s: \hat A_{s,t}>\tau \wedge \sigma(c_{s,t})\ge\rho\}$;为空则返回 $e$(精确回退);否则取 $s^\star=\arg\max_{s\in C}\hat A_{s,t}$,$\alpha = \mathrm{clip}((\hat A_{s^\star}-\tau)\sigma(c_{s^\star})/T_\alpha,0,1)$($T_\alpha=0.15$);输出 $r = e + \alpha(g_{s^\star}-e)$ 注入骨干。
技术新颖性
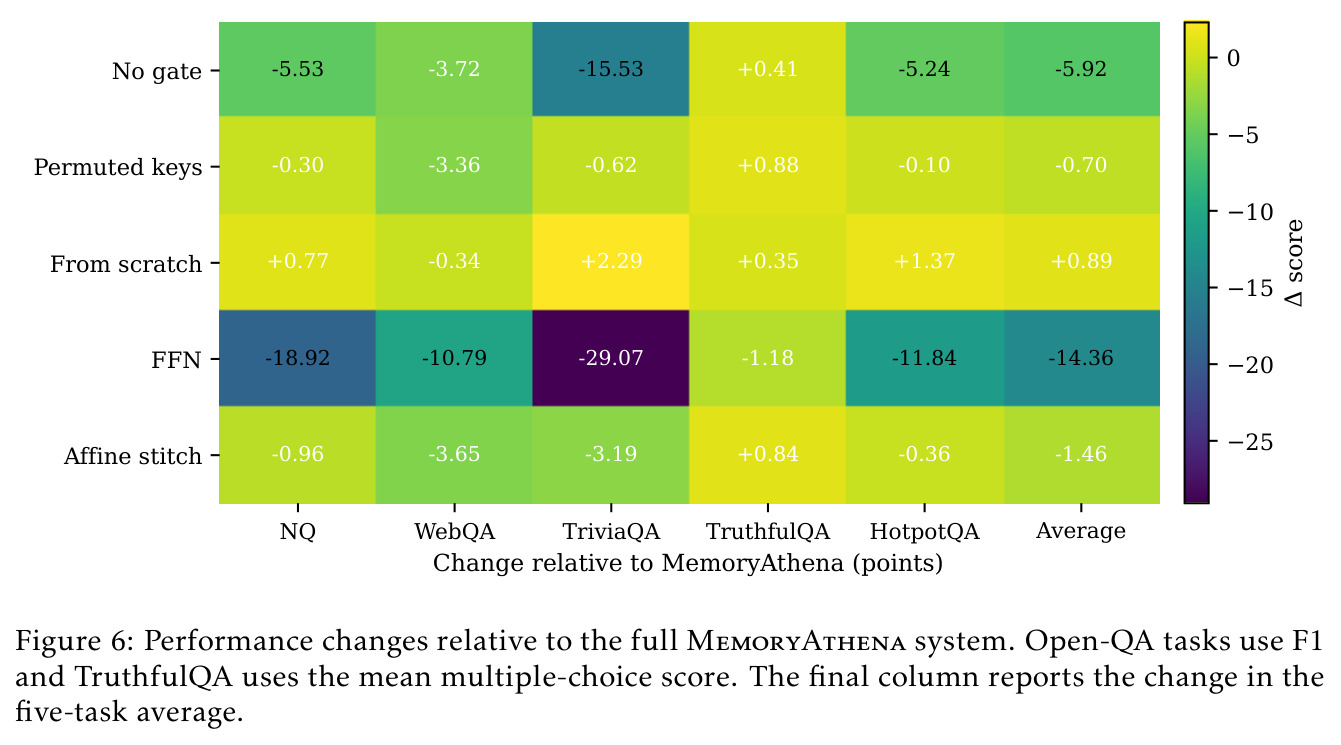
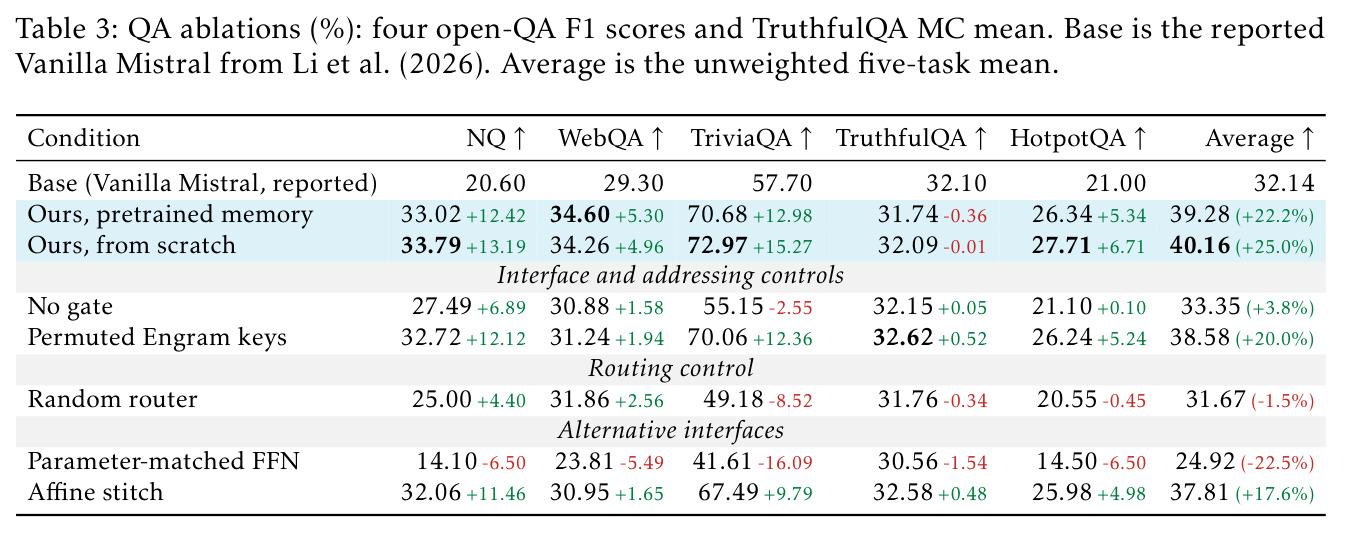
技术新颖性体现在四点。其一,问题层面:首次系统提出并验证'记忆可以被生成'——存储条目只作为索引或线索,最终注入的表示可由检索线索(GE)或纯上下文(GH)重构,把记忆接口从'读'扩展成'读+生成'的连续谱系。其二,路由范式:E 锚定的非对称准入路由区别于对称 MoE 与子集路由,通过 $\hat A>\tau$、$\sigma(c)\ge\rho$ 双门槛加有界插值实现'软干预、硬回退',拒绝即无损还原基线;实验中普通软融合跌至 28.62、子集软融合 29.48,反衬该设计的必要性。其三,监督信号:路由目标来自冻结通路间的未来词元似然差(反事实优势蒸馏),无需任何下游任务标注,且保持推理因果性。其四,效率与归因:整个记忆侧系统仅约 201M 参数,随机路由消融使五任务均值从 39.28 跌到 31.67,证明收益确实来自'学习到的选择性'而非多通路本身;从头训练记忆(40.16)甚至略超预训练记忆(39.28),说明关键在构造与选择机制而非初始化。
实验结果
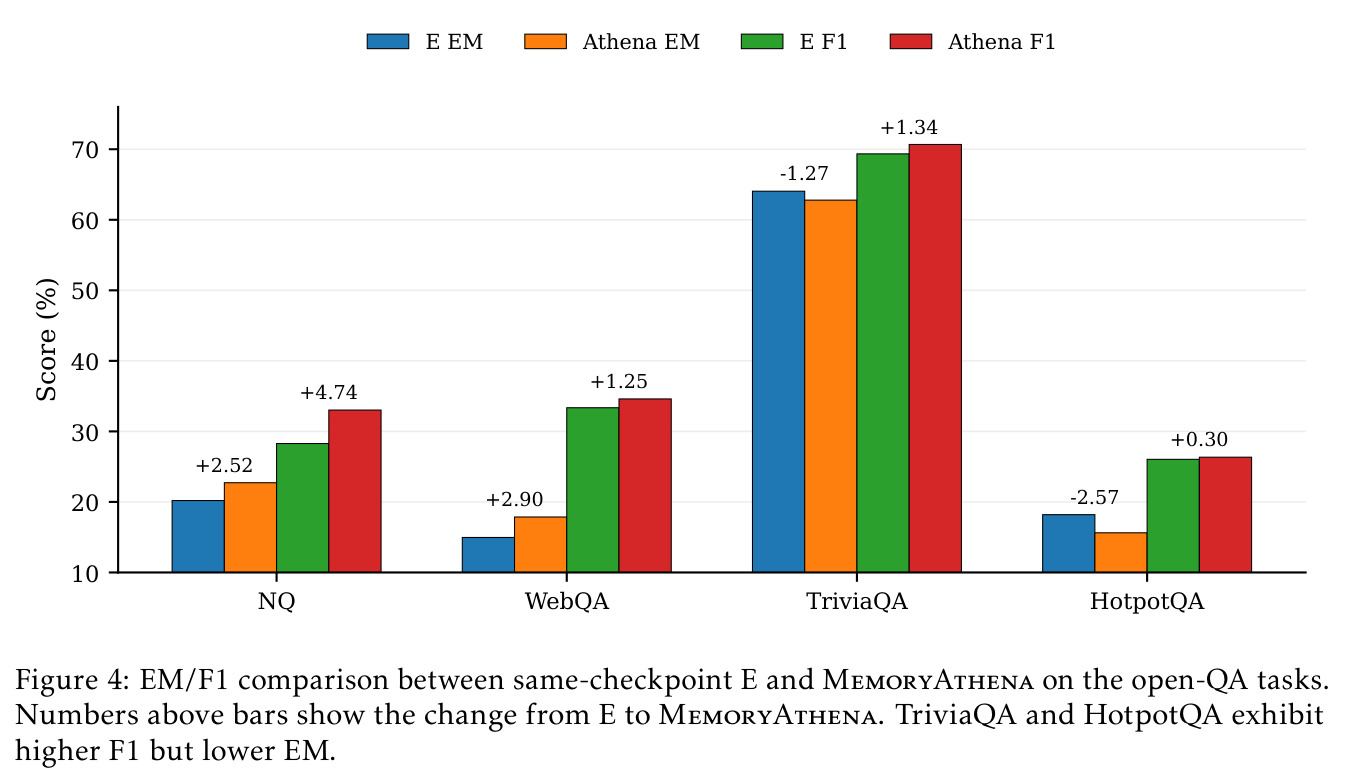
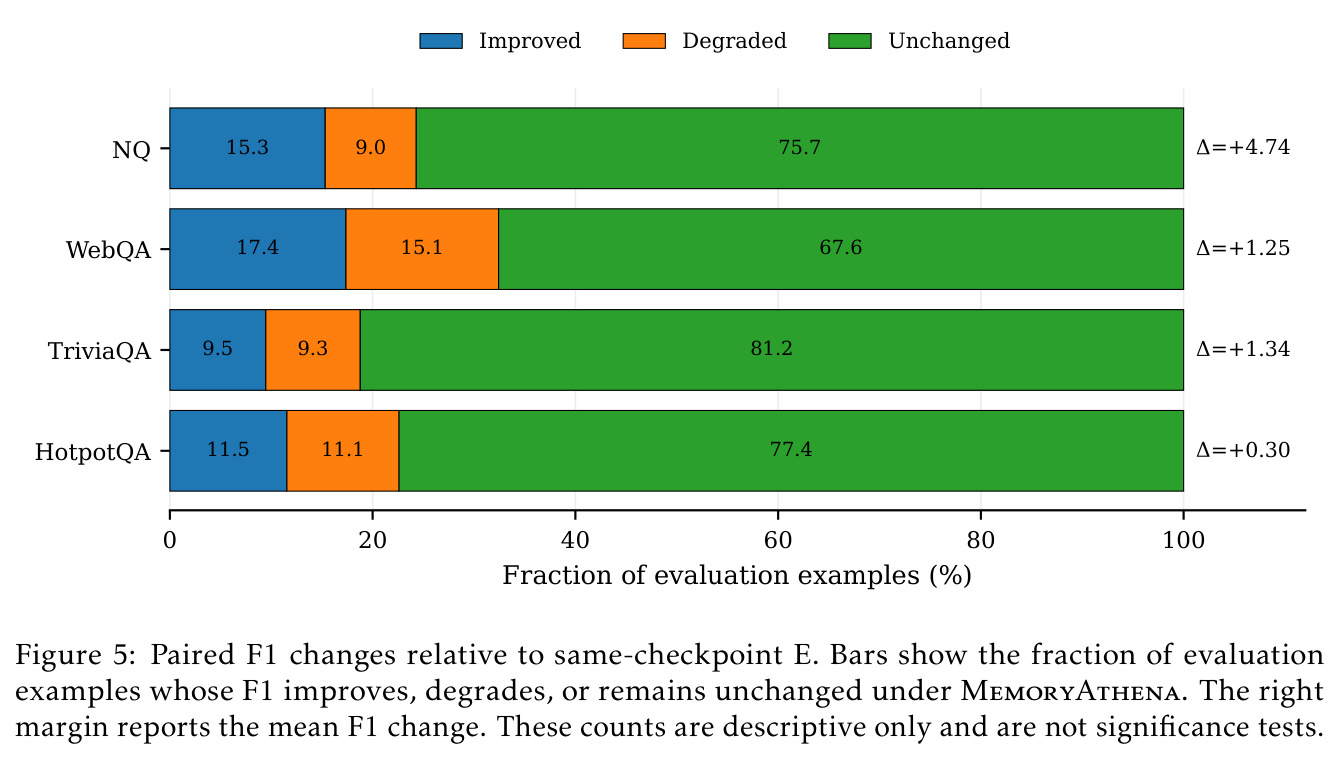
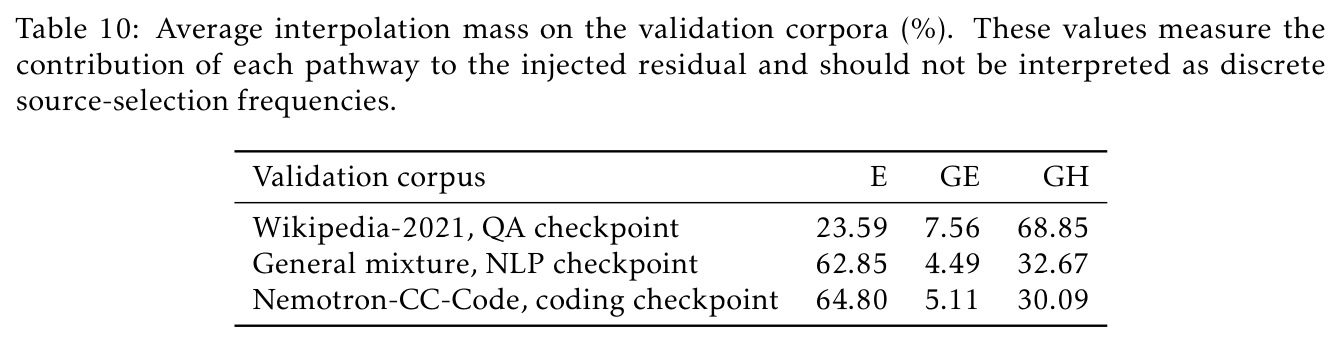
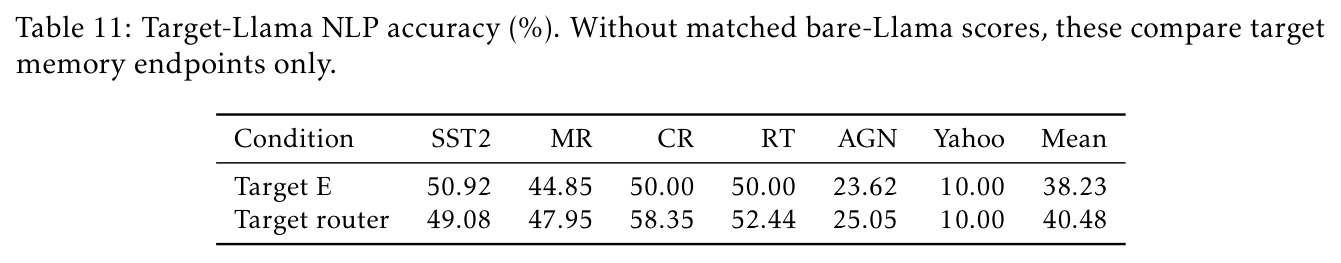
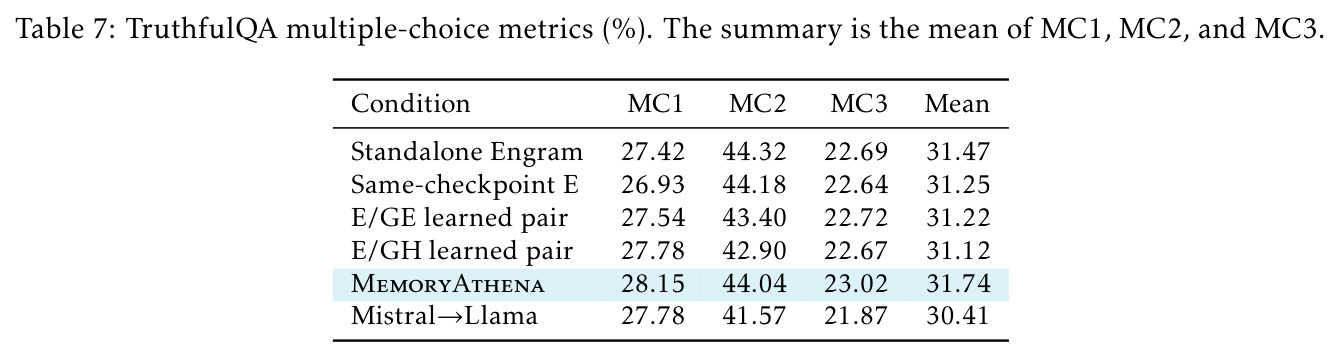
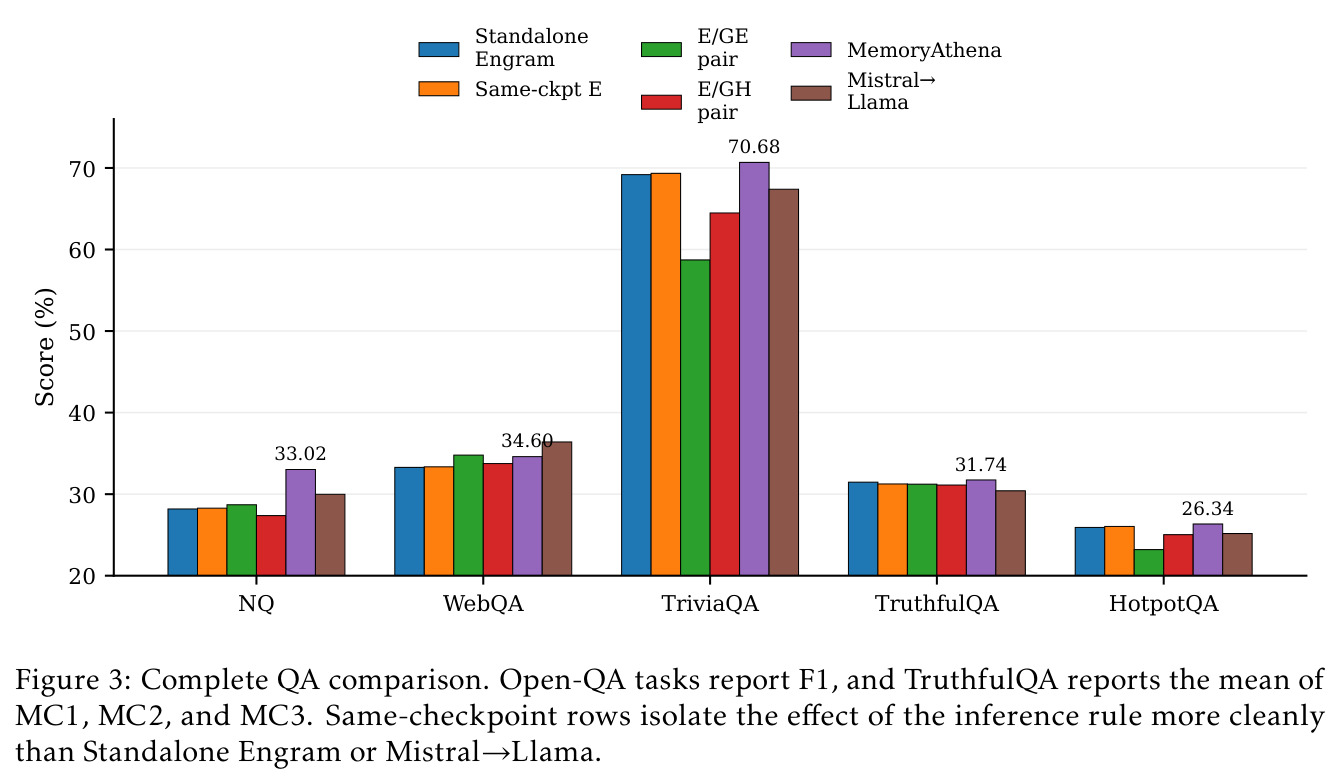
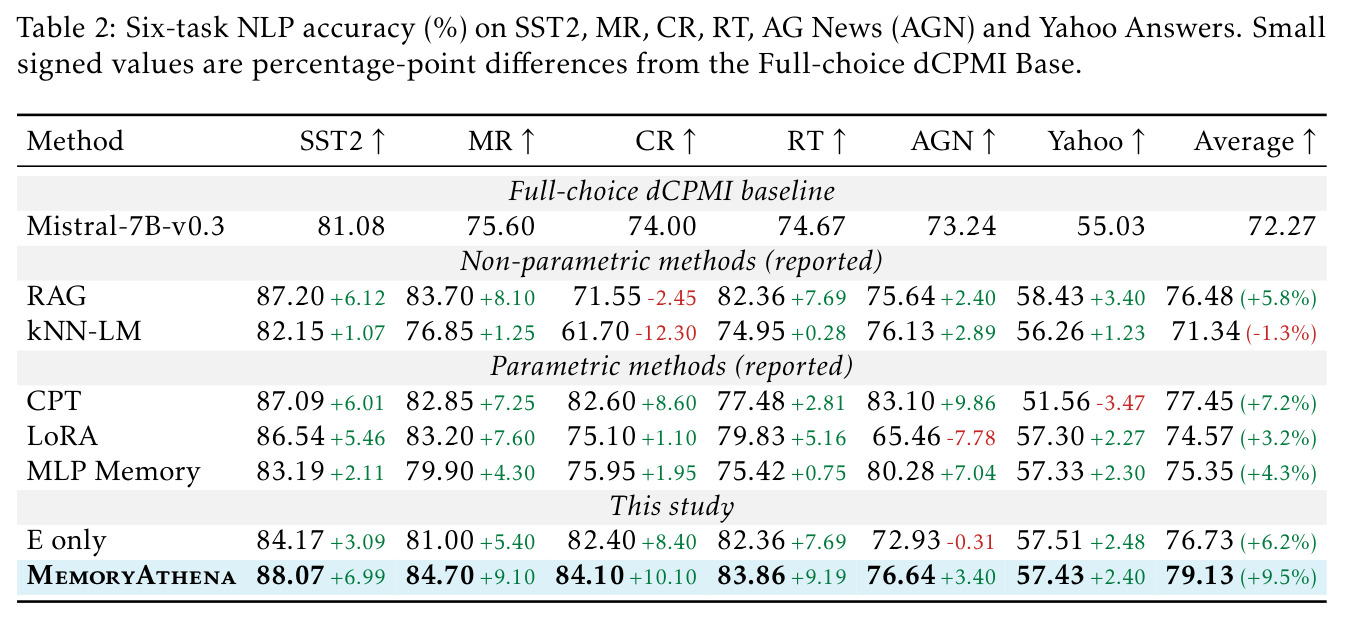
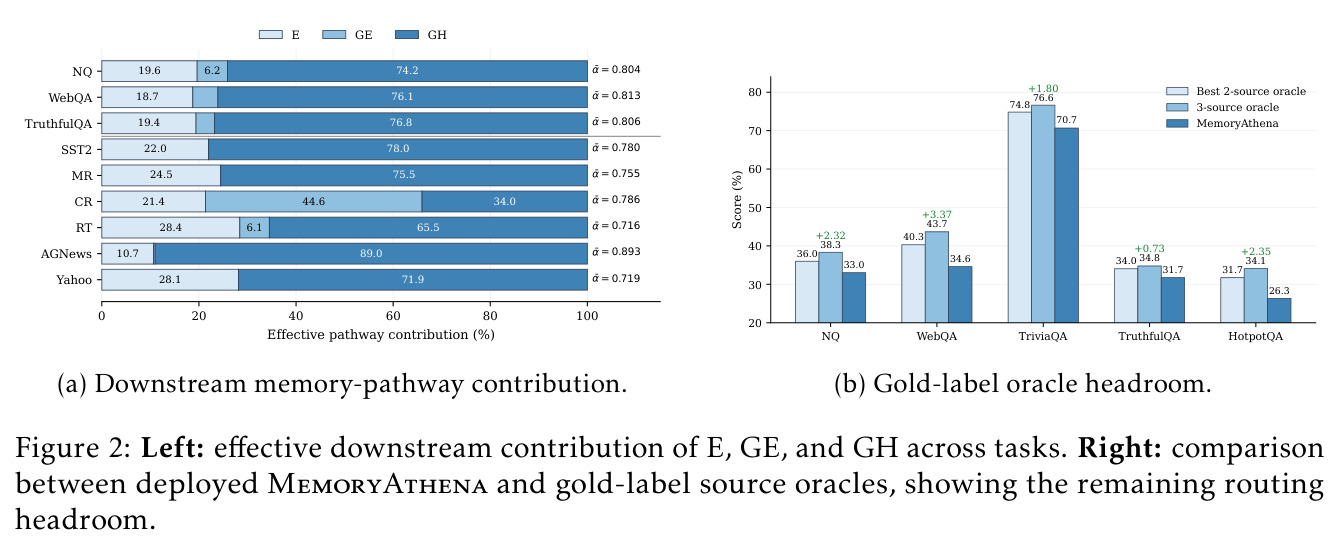
问答五任务(NQ/WebQA/TriviaQA/TruthfulQA/HotpotQA,四个 F1 加 TruthfulQA MC 的无权平均):MemoryAthena 达 NQ 33.02、WebQA 34.60、TriviaQA 70.68、TruthfulQA 31.74、HotpotQA 26.34,平均 39.28,较同一 checkpoint 的 E 直接通路(37.65)提升 1.63,五项指标全改善(NQ +4.74、WebQA +1.25、TriviaQA +1.34、TruthfulQA +0.49、HotpotQA +0.30),较 Vanilla Mistral(32.14)合计 +22.2%。路由对比证实选择性不可或缺:普通硬路由 35.83、软融合 28.62、子集硬路由 37.74、子集软融合 29.48 均逊于 E 锚定方案;跨骨干迁移(Mistral 记忆零样本→Llama)37.87。六任务 NLP 平均从 76.73 升至 79.13:SST2 88.07(+3.90)、MR 84.70(+3.70)、CR 84.10(+1.70)、RT 83.86(+1.50)、AGN 76.64(+3.71)、Yahoo 57.43(保守 $\tau=1$,微降 0.08)。消融(表3)显示收益来自学习到的选择性:随机路由跌至 31.67(TriviaQA 崩至 49.18)、去门控 33.35、参数对齐 FFN 仅 24.92;从头训练记忆 40.16 反超预训练记忆 39.28。图2a 显示 GH 在多数任务贡献 74%–89%、CR 上 GE 反占 44.60%;金标 oracle 表明部署路由仍有 3.04–9.07 分空间。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 问答五任务平均(NQ/WebQA/TriviaQA/TruthfulQA/HotpotQA) | 无权平均(4×F1 + TruthfulQA MC) | 39.28 | 同 checkpoint E only 37.65;Vanilla Mistral 32.14 | +1.63(较 E);+22.2%(较 Vanilla) |
| Natural Questions(NQ) | F1 | 33.02 | E only 28.28 | +4.74 |
| TriviaQA | F1 | 70.68 | E only 69.34;随机路由 49.18 | +1.34(较 E);路由消融中差距达 21.50 |
| WebQuestions(WebQA) | F1 | 34.60 | E only 33.35(GE only 反而 35.24) | +1.25 |
| 六任务 NLP 平均(SST2/MR/CR/RT/AGN/Yahoo) | 准确率 | 79.13 | E only 76.73;RAG 76.48;CPT 77.45 | +2.40(较 E);+9.5%(较 Mistral-7B-v0.3 基线 72.27) |
| SST2 | 准确率(%) | 88.07 | E only 84.17 | +3.90 |
| AG News | 准确率(%) | 76.64 | E only 72.93 | +3.71 |
| Yahoo Answers | 准确率(%) | 57.43(保守阈值 τ=1) | E only 57.51 | -0.08(唯一微降任务) |
局限与改进
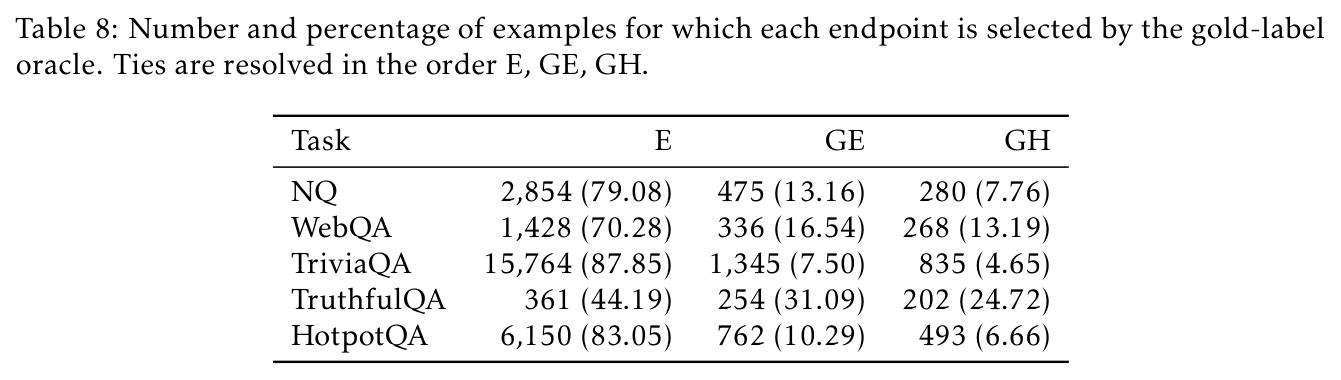
作者与笔者的局限分析。第一,路由上限远未触及:金标三源 oracle 比部署路由高 5.31(NQ)、9.07(WebQA)、5.94(TriviaQA)、3.04(TruthfulQA)、7.74(HotpotQA)分,说明效用估计与准入策略才是主要瓶颈。第二,部分任务收益为负或需特殊处理:TruthfulQA 上 MemoryAthena(31.74)仍低于 Vanilla Mistral 的 32.10;Yahoo 需保守阈值 $\tau=1$ 才勉强持平(57.43 对 E 的 57.51),说明 $\tau,\rho$ 与 $T_\alpha$ 需逐任务手调。第三,融合方式极其敏感:普通软融合 28.62、子集软融合 29.48 的崩溃提示迁移到新架构时风险不小。第四,评估集中在 7B 量级(Mistral-7B-v0.3 与 Llama-2-7B),未验证其他规模;作者也承认缺少不确定性估计与污染审计。第五,图2a 的通路占比是有效插值权重(E 始终保留 $1-\alpha$ 分量)而非词元级独占路由比例,解读时避免高估 GH 的主导地位。
独立分析的弱点
独立弱点分析:其一,路由头只依赖当前状态特征 $\phi_t^\ell$(隐状态与残差统计量),对'这次生成到底好不好'的判断是间接的,WebQA 上 9.07 分的 oracle 差距正源于此;改进方向是引入检索置信度、记忆条目年龄/命中频率等更强特征,或用小型辅助评估器在线给候选打分。其二,准入阈值与温度需任务级调参(五任务用 $\tau=0$,Yahoo 用 $\tau=1$),可改为在校验集上自动校准,或把阈值参数化为输入相关函数,消除逐任务手调。其三,优势目标来自教师强制下的似然差,存在曝光偏差,长自由生成场景未必成立;可用多步 rollout 或序列级优势替代。其四,GE/GH 生成器全程冻结,生成质量的上限被锁死,错误生成无法被纠正;可探索对生成器的轻量微调或多生成器集成。其五,软融合类基线崩溃(28.62)暴露了线性插值族的脆弱性,可研究分段门控或非对称残差形式。其六,TruthfulQA +0.49、Yahoo -0.08 这类 1 分以内的波动在无误差条的情况下难以判断显著性,应补充多次种子重复与置信区间。
未来方向
未来方向:作者在结论中明确指出,中心挑战是'更好地识别生成记忆何时有用、该用哪条通路、以多强干预',即改进效用估计与准入机制,而不是把生成记忆做得更强——金标 oracle 的 3.04–9.07 分差距就是直接的量化目标。在此基础上可延伸:(1)把词元级路由扩展为段落/任务级层级化决策,降低逐词元推理开销并稳定路由行为;(2)用强化学习或 DPO 式目标替代似然差蒸馏,直接以准入后的最终答案质量优化路由头;(3)让阈值 $\tau,\rho$ 与插值强度 $\alpha$ 可学习、输入自适应,消除 Yahoo 式的逐任务调参;(4)把三通路框架嫁接到 RAG——用生成记忆修正检索文本的表示而非替代检索本身;(5)扩大骨干规模(>7B)与记忆规模(目前记忆侧约 201M 参数),检验路由收益随规模的变化规律;(6)补齐污染审计与不确定性估计,并在更多语言与多语言任务上验证跨骨干迁移(当前 Mistral 记忆零样本到 Llama 已达 37.87,说明接口的可复用性值得深挖)。
复现评估
复现评估:开源情况良好——论文给出项目页、GitHub 代码仓库和 Hugging Face 模型集合三个链接,附录声称完整覆盖每条通路的架构、冻结边界、目标函数、准入规则、控制实验、样本量与 checkpoint 选择(附录 A/C/D/G),并附证据台账把每张表映射到对应产物、提供哈希以便追溯。但作者也坦承:哈希不等于不可变的启动环境,且缺少污染审计与不确定性估计。算力方面:骨干为 Mistral-7B-v0.3(Llama-2-7B 提供跨迁移源记忆),记忆侧系统约 201M 参数;训练分三阶段且骨干、记忆、生成器、读取器均冻结、只训路由头,第三方用单节点 7B 推理/轻量训练资源应可负担,但具体训练预算需自行查阅附录 D。数据方面:五个 QA 数据集与六个 NLP 分类数据集全部公开,主要成本在于 Engram 记忆表的训练与三通路接口适配的工程实现。总体复现难度中等:结果方向可信,但 1 分上下的差异需要自行做显著性验证。
论文图表