从模式识别器到个性化伴侣:大语言模型在心理健康领域的综述 From Pattern Recognizers to Personalized Companions: A Survey of Large Language Models in Mental Health
提出心理健康LLM三阶段演进框架:信息工具、共情对话者到纵向个性化伴侣
前置知识
大语言模型(LLM)与监督微调(SFT)
LLM 是在海量网络文本上预训练的 Transformer 生成模型,具备通用语言理解与生成能力;SFT 则在人工整理的指令-回应对上继续训练,让模型学会特定任务的格式与行为模式。综述中 SMILE、SoulChatCorpus、ESConv 等心理咨询对话语料正是用于 SFT,使通用模型学会咨询对话的结构、情感细腻度与治疗框架。
综述的技术主线(Phase I 到 Phase II 的跃迁)正是靠 SFT 把被动的分类器变成会对话的共情模型,不理解 SFT 就无法读懂各阶段的实现手段与代表工作。
参数高效微调(PEFT:LoRA/QLoRA)
PEFT 冻结预训练模型的绝大部分参数,只训练插入的低秩矩阵(LoRA)或其量化版本(QLoRA),以极小的显存与算力代价实现领域适配。综述提到 DepressLLM、PsyLite、MentalMAC 等轻量模型借此在有限资源下达到接近专家级的心理健康任务表现,FedMentalCare 更把 PEFT 用到端侧联邦训练以满足隐私约束。
它解释了心理健康这一非头部领域为何能以有限算力快速产出领域专用模型,也是理解隐私保护训练与轻量部署方案的技术前提。
RLHF 与偏好对齐(DPO/KTO/ORPO/GRPO)
在 SFT 之后,用人类偏好信号通过强化学习(如 PPO、GRPO)或免强化学习的直接偏好优化(DPO、KTO、ORPO)继续调整模型,使其更安全、更有用、更符合治疗原则。综述中 Psyche-R1 用 GRPO 增强困难案例上的推理能力,PsyLite 用 ORPO 对抗越狱攻击,多个工作通过奖励中间推理步骤来稳定训练并提升共情连贯性。
安全与临床对齐是心理健康 LLM 的生死线,理解 RL 对齐才能读懂综述关于行为塑造、安全机制分层(对齐/护栏/接地)的讨论。
思维链(CoT)推理
让模型在给出最终回应前显式生成中间推理步骤,模拟人类临床医生从观察到评估再到干预的思考链条,从而提高输出的可解释性与诊断可靠性。综述中 PsyLLM 将推理锚定在 CBT(认知行为疗法)与 PCT(个人中心疗法)等理论之上,Psy-Copilot 等框架把 CoT 嵌入复杂的干预规划流水线。
综述把可解释的临床推理列为 Phase III 智能体的核心能力,也是未来让模型先输出临床判断、再生成回应以便人类监督这一方案的技术基础。
检索增强生成(RAG)
在生成回应前,先从外部知识库(CBT 工作表、诊断标准、危机热线目录、用户历史对话)检索相关材料拼入上下文,使输出有据可依、减少幻觉。综述强调 RAG 在心理健康场景的首要价值是安全接地——确保高风险时刻给出经过验证的危机资源;高级实现还会根据用户情绪状态或对话意图动态调节检索内容。
RAG 是心理场景安全性的关键机制,被列为三大核心技术之一,也是未来严格遵循 CBT/ACT 等治疗手册协议的主要途径。
LLM 智能体五模块架构
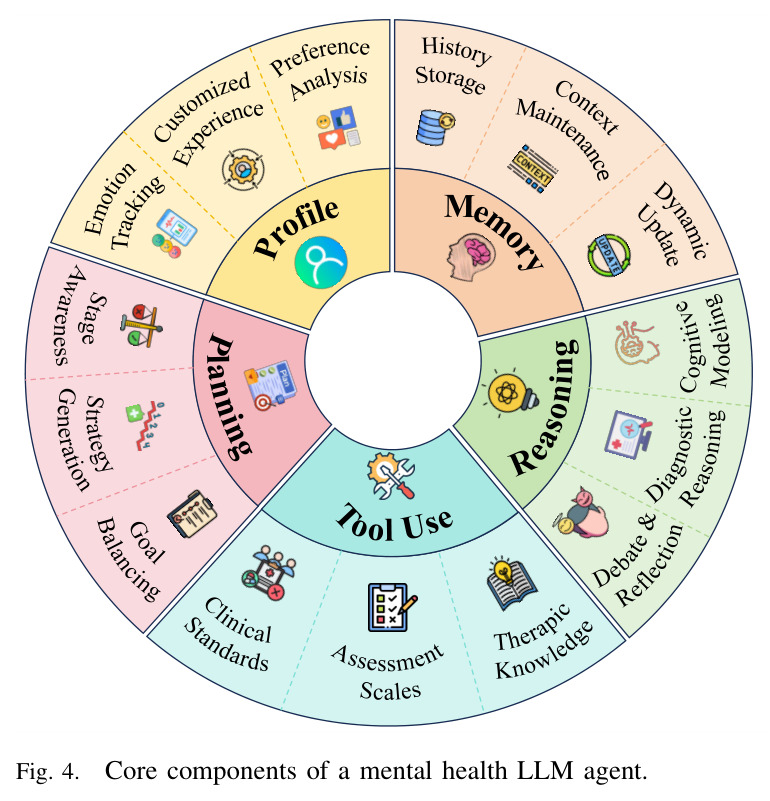
Profile(构建并维护动态用户画像,追踪情绪状态与人格特质)、Memory(跨会话记忆,含分层长短期结构、RAG 历史检索、模拟艾宾浩斯遗忘曲线、认知扭曲追踪)、Reasoning(结构化临床推理与多视角权衡)、Planning(分层目标分解、阶段对齐、动态话题引导)、Tool Use(检索临床指南与危机资源)五模块协同,构成有状态的认知智能体。
这是 Phase III 纵向个性化伴侣的实现蓝图,综述图 4 与第四节全部前沿方向(纵向参与、临床框架整合、多智能体、安全)都围绕这套组件展开。
CBT 与标准化心理量表(PHQ-9/GAD-7/WAI/CTRS)
CBT(认知行为疗法)是循证心理治疗流派,通过识别与重构认知扭曲来改善情绪;PHQ-9、GAD-7、BDI 是抑郁与焦虑严重程度的标准化量表,WAI(工作联盟量表)测量治疗联盟,CTRS(认知治疗-rating 量表)评估治疗质量与干预保真度。综述中它们既是数据标注的来源(如辅助评分),也是评测的锚点。
论文反复以治疗框架遵循度(CBT/MI 技术)和这些量表作为临床对齐的衡量方式,不懂量表就无法理解其评测协议与临床落地的讨论。
LLM-as-a-Judge 评估
用强大的 LLM 按照共情、连贯性、一致性、安全性、治疗联盟等属性给候选回应打分,替代昂贵的人工评估。综述指出其与人类评分者仅达到中等一致性(以 Cohen's $\kappa$ 等统计量衡量),可靠性随设置变化、校准不透明,因此只能作为实用但不完美的代理,需要专家评估的校验。
当前该领域评测高度依赖这一范式,综述据此批判现有评测并提出 Phase III 的四维评测协议,是理解第六节论证逻辑的前提。
多模态大模型(MLLM)
在文本之外融合语音韵律、面部表情、姿态甚至生理信号(脑电、心率)的模型,用于更全面的心理状态评估(如 MODMA 融合脑电与语音、AVEC 系列音视频抑郁检测、LQ-former 统一语义空间)与更丰富的共情干预(如 Empatheia 融合文本、语音与虚拟形象视频生成情感一致的反应)。
综述专节讨论其潜力与风险:非语言信号高度歧义、系统可能过拟合数据集伪影或依赖光照等虚假相关,这是理解其超越文本但保持审慎这一立场的基础。
研究动机
全球范围内抑郁、焦虑与孤独感的患病率在各类人群中持续上升,而传统心理健康服务体系长期受制于几大结构性障碍:专业资源稀缺且分布不均、治疗费用高昂、社会病耻感让患者羞于求助、隐私顾虑阻碍信息共享。综述引用 WHO 世界心理健康调查的证据指出,这些障碍使大量有需求者无法及时获得支持,干预往往被推迟到症状严重、结局恶化之后。与此同时,2021 至 2025 年间 LLM 心理健康研究呈爆炸式增长(综述收集的论文横跨 ACL Anthology、PubMed、arXiv、Web of Science 等来源,任务分布为心理治疗、诊断、教育、专业辅助四大类),但文献高度碎片化:已有综述分别只聚焦社交媒体疾病检测、单次会话心理治疗对话系统,或泛泛讨论生成式 AI 的应用,彼此割裂,缺乏一条能解释从检测、对话到智能体整个演进的统一叙事。结果是研究者难以判断某项技术处于什么阶段、哪些基础设施数据与评测是瓶颈、下一步真正的开放问题在哪里。
本文的目标是本文的目标是对快速膨胀的文献进行系统梳理,并围绕一个中心论题组织全部材料:LLM 在心理健康中的角色正经历三个日益复杂的阶段——Phase I 被动的信息工具与模式识别器(对静态文本做分类与风险评估)、Phase II 共情对话者(在单次无状态会话中进行即时互动)、Phase III 纵向个性化伴侣(具备记忆、画像、推理、规划与工具使用的有状态认知智能体)。在此框架下,综述系统回顾核心技术(领域预训练、SFT、RL 对齐、推理时策略、多模态融合)、智能体架构(Profile/Memory/Reasoning/Planning/Tool Use)、以及作为关键基础设施的数据集与评测基准如何协同支撑这条演进路径,最后给出从会话者到认知智能体、临床对齐与推理透明、仿真评测范式、人机共生与伦理部署四条未来路线,并开源 Awesome-Mental-Health-LLMs 资源库供社区使用。
与已有工作不同的是,本文的独特切入角度是发展阶段论:不同于以往按任务(检测/对话/应用)或按技术栈罗列文献的综述,它抓住无状态到有状态这一本质跃迁作为主轴,并用六项可操作判据(交互粒度、用户状态建模、跨会话能力、个性化持续性、记忆机制、系统自主性)把三阶段形式化成表格。这一视角带来两个前人综述不具备的解释力:其一,它能把表面上互不相干的基础设施演进——检测数据集让位于对话语料、对话语料正在让位于纵向合成数据,静态问答基准让位于动态仿真评测——统一解释为对三个阶段的支撑,从而揭示数据、模型、评测三条线的同构规律;其二,它明确断言领域当前的真正前沿不是训练出更会说话的模型,而是设计出能记住、能学习、能与用户长期协作的有状态认知架构,把 Memory 和 Planning 从工程配件提升为决定系统阶段性的核心组件,引导研究者把注意力从单轮回复质量转向跨会话治疗联盟。
核心方法
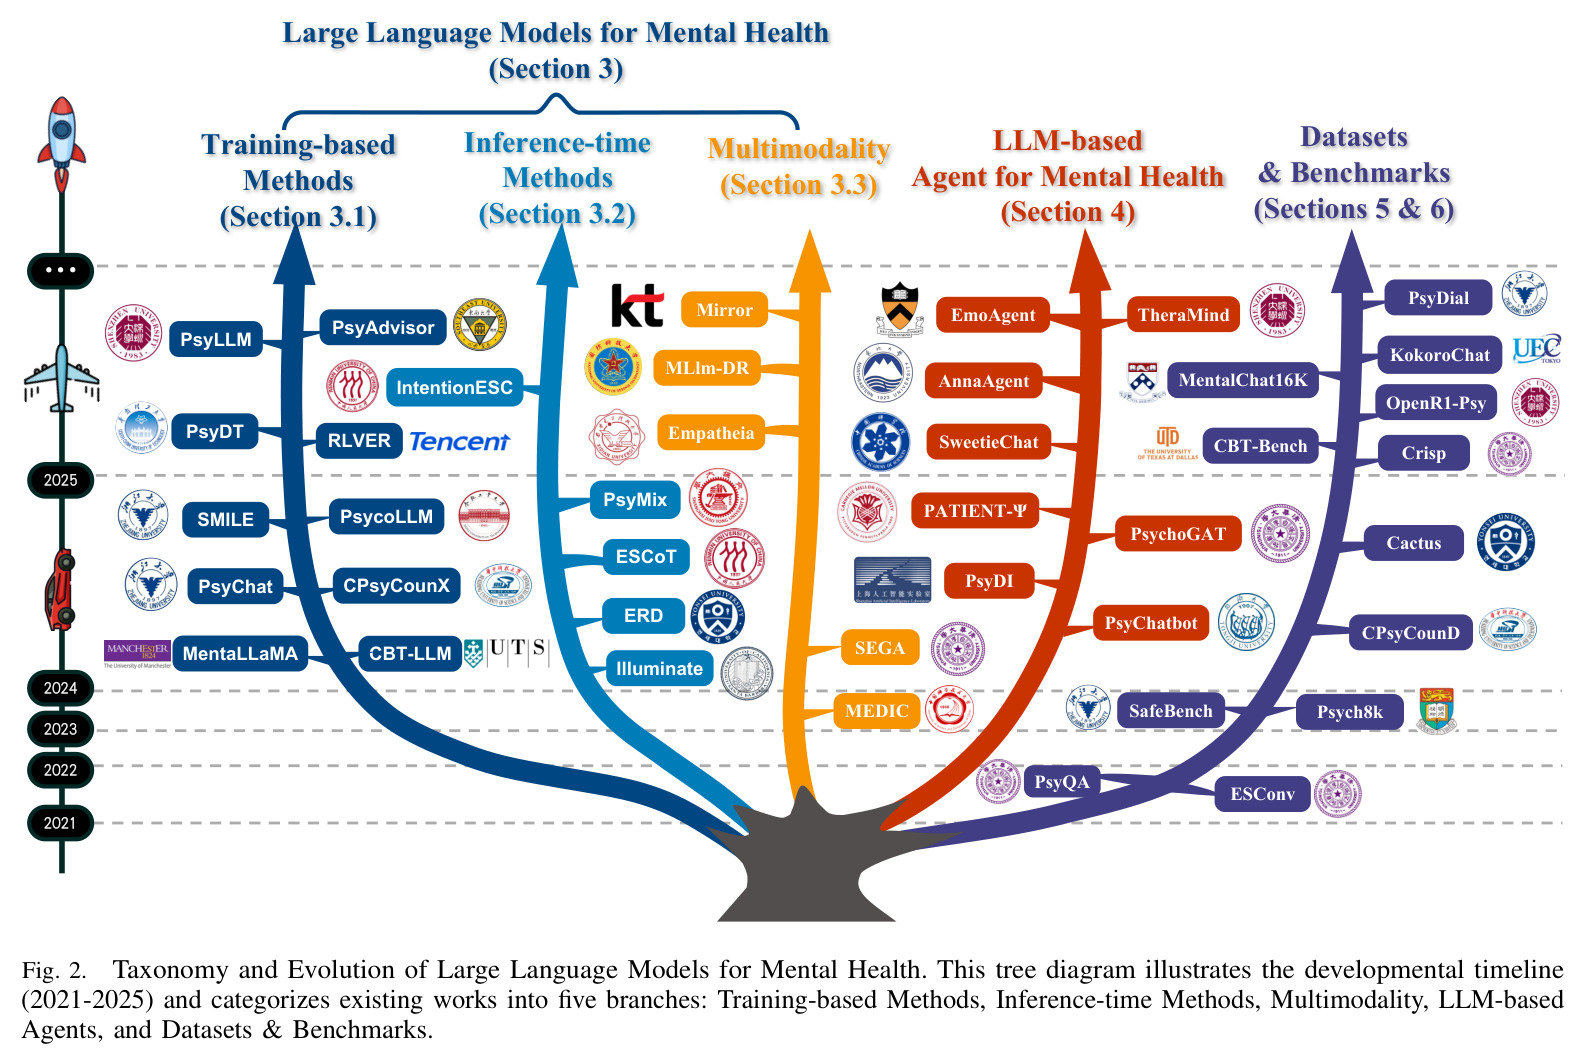
先说直觉:作者把 LLM 在心理健康中的角色比作一个助人者的成长历程——先学会看,即从社交媒体帖子中识别抑郁的语言标记、从论坛帖中评估自杀风险,这是被动的模式识别;再学会听与说,即在单次咨询对话中生成连贯、共情、临床上站得住脚的回应,这靠在专业对话语料上微调并对齐治疗框架实现;最终要学会陪伴,即记住用户数月乃至数年的状态变化、规划跨会话的治疗旅程、主动推进治疗目标,这需要彻底的架构转变。技术上综述沿四条主线组织证据:一是训练适配,包括领域继续预训练(ProMind-LLM 范式证明先做领域预训练可显著提升下游风险评佔的稳健性)、SFT(全参微调或 LoRA/QLoRA 等参数高效微调,依托 SMILE、SweetieChat 等对话生成框架)、RL 对齐(DPO/KTO/ORPO 偏好学习对齐专家咨询标准与安全要求,Psyche-R1 用 GRPO 强化困难案例推理);二是推理时策略,包括嵌入心理测量构念的提示工程、显式 CoT、以安全为首要目标的 RAG 接地;三是多模态融合,覆盖共情干预与临床评估两端;四是智能体化,用五模块架构实现状态性,支撑 Phase III。
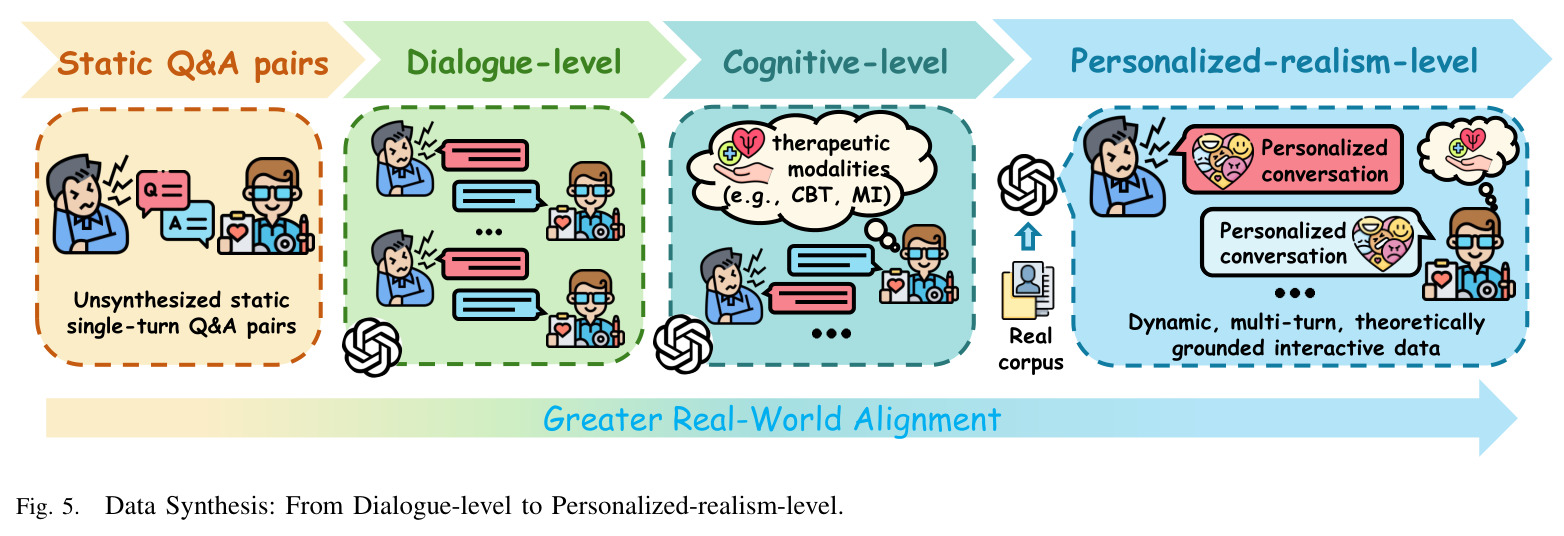
核心创新是三阶段框架加上六判据的操作化。Phase I 的特征是单轮交互、不建模用户状态、无跨会话能力、无个性化、无记忆、被动反应;Phase II 升级为多轮交互、会话内状态、上下文记忆、会话级个性化、交互式;Phase III 则追求纵向交互、持久用户状态、跨会话记忆、持久个性化与目标导向的自主性。与已有工作的本质区别在于:前者以任务或技术为纲,本文以系统的状态性与持续性为纲,并据此做出一个强判断——领域瓶颈已从模型能力转向架构能力,即从更好的对话模型转向有状态的认知架构。这一定位产生三个连锁推论:数据侧必须从静态标注走向纵向合成(对话级、认知级、个性化真实级三个层次);评测侧必须从静态基准走向动态仿真,提出纵向一致性、升级行为、危机处理、治疗联盟四维协议;安全侧必须区分对齐、护栏、接地三个控制层次,并承认表面安全不等于临床恰当。整个综述的章节组织(应用、技术、智能体、数据、评测)都由这张框架图串联。
方法步骤详情
综述按五步构建完整证据链。第一步划定四大应用支柱:诊断(对齐 DSM-5/ICD-11 分类,辅助 PHQ-9/GAD-7 评分,检测抑郁、焦虑与自杀风险)、心理治疗(交付 CBT/ACT 等干预、日常情感陪伴)、教育(生成虚拟病人供受训咨询师练习诊断访谈与危机管理)、专业辅助(自动生成会话摘要、提取临床主题、辅助制定治疗计划)。第二步拆解核心技术:领域预训练注入专业知识;SFT 分全参与 PEFT 两路,用 SMILE(55,165 段多轮对话)等语料教会模型咨询对话结构,同时指出 SFT 是双刃剑,可能限制灵活性并放大数据偏差;RL 对齐用模拟用户反馈或推理质量评估作为奖励信号。推理时策略包括把 BDI 等量表构念嵌入提示以产生可解释的证据式输出、CoT 显式化临床思路、RAG 检索 CBT 工作表与危机热线信息。多模态线覆盖共情干预(融合表情姿态识别阻抗并生成重构回应,Empatheia 的文本+语音+虚拟形象基准)与临床评估(图模型融合音视频线索预测抑郁严重度、LQ-former 生成可解释多模态解释)。第三步给出智能体五模块的输入输出:Profile 维护动态画像与人格类型;Memory 实现分层长短期记忆与历史检索;Reasoning 对齐 DSM/ICD 做结构化推理并生成可供人类监督的思维轨迹;Planning 把长期治疗目标分解为可执行的会话级动作并动态引导话题;Tool Use 检索临床指南与危机资源,甚至以语音时机等线索条件化检索。第四步梳理四大前沿:纵向参与(MusPsy 用多会话数据训练智能体学习来访者状态渐变、CA+ 用规划模块对齐每场会话与长期目标、iPET 以虚拟宠物范式培养情感依恋);临床框架整合(数据模仿如 CACTUS/PsyChatbot 的大规模 CBT 合成对话、流程引导如叙事疗法智能体按治疗阶段与反思层级规划、CAMI 对动机式访谈做话题探索规划);多智能体(AutoCBT 把 CBT 各阶段分配给协作子智能体、MAGI 用四个专门智能体执行 MINI 精神科访谈的分支逻辑、MIND 在用户内在世界之间展开魔鬼与向导的对话、Yang 等组装职业健康专家、HR 顾问与同伴的虚拟支持团队);安全(EmoAgent 引入守护模块实时监控干预、PsyLite 用 ORPO 对齐抗越狱、RHealthTwin 以 WHO 六项负责任 AI 原则为设计哲学)。第五步建立数据集三阶段演化与合成三层次(对话级、认知级、个性化真实级),以及评测三层级与四维协议。
技术新颖性
本文不提出新算法,其新颖性体现在框架价值与批判性洞见。其一,首次以记忆、状态、个性化、自主性等判据对系统分期并表格化(Table I),使任何新系统都能被快速精确地定位,这为领域提供了共有的坐标系。其二,揭示数据—模型—评测的三线同构规律:静态标签对应被动分类器与静态指标,会话语料对应共情模型与会话级属性评测,纵向合成数据对应认知智能体与轨迹级评测,这一同构视角让读者能据此预测领域下一步的基础设施需求。其三,对多模态给出少见的清醒批判:非语言信号本质歧义且高度依赖情境,多模态系统可能过拟合数据集特定伪影而非真实情绪意图,多模态性能提升未必转化为更临床恰当的共情支持;模型常假设可观察线索直接反映内部状态,但文化、人格与情境差异会引入偏倚,甚至依赖光照、背景噪声等与临床无关的虚假相关。其四,厘清安全机制的分层逻辑——对齐方法塑造回应风格与政策合规,护栏与监控模块过滤不安全输出,接地机制改善事实一致性——并指出即便自动化安全指标通过,系统仍可能产生虚假安慰、延迟升级、过度自信的伪临床推理这类表面安全但临床不当的行为,因此需要显式纳入临床情境、纵向动态与风险敏感决策标准的评测协议。
实验结果
作为综述,其结果是一系列系统化的量化观察与综合判断。第一,领域版图:心理治疗占论文的 58%,诊断 25%,教育 9%,专业辅助 8%,且 2021 至 2025 年(2025 统计至 11 月)论文量持续攀升,治疗类研究已绝对主导(Fig. 1)。第二,数据基础设施沿三阶段迁移:Phase I 检测数据从 CLP 的 1,746 条(Twitter)到 RSDD 116,484 与 UMD 1,556,194(Reddit)、SWDD 485 万条(微博),再到半监督的 MentalHelp 约 1,409 万条,规模跨越四个数量级;Phase II 对话语料从众包的 ESConv 1,053 段(平均 14.1 轮)扩展到合成主导格局——SoulChatCorpus 达 230 万条、AugESC 65k、SMILE 55,165 段;Phase III 纵向数据仍是最稀缺资源:MusPsy 仅 1,500 段多会话(平均 28.6 轮)、DiaCBT 540 段(平均 53 轮)、PsyDial 2,382 段(平均 37.8 轮)。第三,评测呈三层级:表层自动指标(BLEU、ROUGE、F1、Distinct-N)与治疗质量相关性差;连贯性与一致性等语义指标是建立信任的前提;共情、治疗联盟(WAI)、专业性等临床关系属性最关键,但高度依赖 LLM-as-a-Judge,而后者与人类专家仅中等一致(以 Cohen's κ 衡量),跨设置可靠性不稳定、校准不明。第四,临床验证严重不足:Table VII 显示代表性系统几乎全部只有自动指标或专家离线评估,在真实患者群体中的临床验证是例外而非常态,少数实例如 Therabot 的随机对照试验发表于 NEJM AI。第五,作者据此提出 Phase III 评测四维协议——纵向一致性、升级行为、危机处理、治疗联盟——并建议锚定 CTRS、PANAS、WAI 等经验证的临床量表,把评测从会话级推向轨迹级。
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文献任务分布统计(Fig. 1) | 论文占比 | 心理治疗 58%、诊断 25%、教育 9%、专业辅助 8% | 此前综述无统一定量统计 | 首次量化揭示治疗类研究的主导地位与 2021-2025 年的持续增长态势 |
| Phase I 检测数据规模对比(Table II) | 标注样本量 | MentalHelp 14,097,946 条(半监督 Reddit)、SWDD 4,854,421 条(微博) | 早期 CLP 数据集仅 1,746 条 | 检测数据规模提升约四个数量级,并扩展到多语言与可解释标注 |
| Phase II 对话数据规模对比(Table III) | 对话条数 | SoulChatCorpus 2,300,248 条(合成)、AugESC 65k 条 | 众包数据集 ESConv 仅 1,053 段(平均 14.1 轮) | 合成数据带来约三个数量级的扩容,但代价是真实世界保真度下降 |
| Phase III 纵向数据可得性(Table III) | 会话结构/平均轮数 | MusPsy 1,500 段多会话(28.6 轮)、DiaCBT 540 段(53 轮)、PsyDial 2,382 段(37.8 轮) | PsyQA 56k 条单轮问答 | 出现首批显式多会话语料,但总量与真实临床纵向轨迹的需求差距仍然巨大 |
| 临床验证现状盘点(Table VII) | 经真实患者临床验证的系统数量 | 极少数,如 Therabot 的随机对照试验(NEJM AI 2025) | 绝大多数系统仅有自动指标或专家离线评估 | 定性揭示领域最大的证据缺口,直接推动轨迹级四维评测协议的提出 |
局限与改进
作者明确承认的局限包括:合成数据缺乏结构保真度——生成对话局部连贯但纵向不一致、情绪动态过于平滑,用平滑轨迹取代了真实治疗的非线性模式(文中引述 RealCBT 对真实与 LLM 生成 CBT 会话情绪弧线的对比分析);由此带来分布偏移、回音室效应与文化同质化等系统性风险。评测端,LLM-as-a-Judge 与专家评分一致性有限、跨设置可靠性不稳定、校准不透明;真实临床环境评估受伦理、法律与隐私约束,难以开展大规模随机对照研究,导致绝大多数系统缺乏真实治疗条件下的有效性证据。多模态信号的临床效度不确定:模型常假设可观察线索直接反映内部状态,但文化、人格与情境差异会引入偏倚与误分类。我的补充观察有五点:一是三阶段框架是理想化的线性叙事,现实中检测与对话技术并行发展,部分混合系统难以干净归入某一阶段;二是六项判据均为定性描述,没有量化阈值,进入 Phase III 的判定存在主观空间;三是综述大量引用 2025-2026 年的 arXiv 预印本,同行评审证据的占比不明,若干结论的稳定性有待时间检验;四是对监管审批路径(如医疗器械认证)、健康经济学与支付方激励几乎未讨论,而这些恰是临床落地的硬约束;五是评测协议仍以文本交互为中心,对语音交付、虚拟形象等形态的评测标准着墨较少。
独立分析的弱点
独立分析可发现以下弱点。第一,框架可操作性不足:六项判据是定性的,缺少可测量的分级标准,不同作者可能对同一系统给出不同分期;改进方向是为每个判据设计量化探测任务,例如跨会话记忆一致性测试、用户状态保持探针、目标追踪测试,形成可自动执行的阶段认证基准。第二,用仿真评测仿真存在循环论证风险:作者主张的高保真 Patient Agent 生态本身效度未经验证,用未校准的模拟患者评测治疗智能体可能产生系统性偏误;应先用纵向真实临床数据(RealCBT、MusPsy 的来源数据)校准模拟器的情绪弧线与行为转换动态,验证通过后再用于评测。第三,纵向效果的证据链断裂:即使四维评测协议落地,WAI 与 PANAS 仍是代理指标,缺少以症状缓解为终点的长期随机对照试验;需要与临床机构合作建立预注册的对照研究模板。第四,多模态部分偏描述性:罗列了数据集与风险清单,但未给出信号效度的量化评估框架,如跨人群校准曲线与公平性分解,可引入计算精神医学中已有的效度验证方法论。第五,社会技术风险覆盖不足:对 AI 依赖与成瘾、数字鸿沟、弱势群体(未成年人、活跃自杀意念者)的特殊保护仅一笔带过,而这些恰是部署中最易出事故的场景,应发展面向高风险人群的临床红队测试协议。第六,跨文化适配缺乏方法论:只指出文化同质化风险,未给出文化特定量表嵌入、本地伦理规范注入模型的具体技术路线。
未来方向
作者提出四个方向。A)从会话者到认知智能体:突破基于上下文窗口的召回,发展能在数月乃至数年间存储、检索、更新用户信息的向量式或分层长期记忆系统,模拟人类治疗师与来访者关系的连续性;从被动应答转向主动治疗规划,为用户维护动态的心智理论(Theory of Mind),安排跨会话的 CBT 家庭作业与暴露练习。B)临床对齐与推理透明:用 CoT 打开黑箱,让模型先输出临床判断(风险评估、策略选择)再生成回应,以便人类监督;通过链接经验证临床手册的 RAG,从模仿治疗师的风格进阶到严格遵循 CBT、CST、ACT 等协议。C)评测革命:构建多样化、心理一致、可接受长期治疗的 Patient Agent 仿真生态,在安全可控环境中压力测试治疗智能体;把指标从 BLEU 类语言指标转向临床结局测量,如追踪模拟症状(PHQ-9 评分)的下降与治疗联盟(WAI)的提升,并按纵向一致性、升级行为、危机处理、治疗联盟四维展开。D)人机共生与伦理部署:设计混合照护模式——AI 承担常规监测、心理教育与会话间支持,复杂或高危个案及时升级给人类专家;确保模型对文化偏差鲁棒,能以专业标准处理保密突破等伦理困境。我的延伸方向:结合腕带设备的数字表型(综述已提及 DepGuard、MentalCare 等可穿戴工作)实现被动连续评估;用联邦学习(FedMentalCare)支撑隐私保护的纵向训练;建立面向监管科学的标准化证据生成框架,使仿真评测结果能被审批机构采信,弥合从论文到产品的鸿沟。
复现评估
作为综述,其可复用性极佳。作者维护开源资源库 Awesome-Mental-Health-LLMs,系统收录全部述及文献;Table II 至 Table V 逐项列出数据集的年份、来源平台、任务、是否含自述诊断(OSD)、规模、平均轮数与语言,绝大多数可公开获取(如 ESConv、PsyQA、SoulChatCorpus、EmpatheticDialogues、UMD、RSDD),覆盖英语、中文、日语、韩语、波斯语、西班牙语、德语等多种语言;SafeBench、CBT-Bench、ψ-Arena、PsychoGAT 等评测基准也随原论文开源。复现这项综述工作本身不需要任何算力,难度低:主要工作量在于按六项判据复现其分类体系,再按需挑选数据集与基准开展研究。使用时有两点提醒:一是部分引用为 arXiv 预印本,对应代码与数据未必全部开源,采用前需逐项核实;二是大量对话数据为 LLM 合成,直接用于训练会继承其结构保真度缺陷(纵向不一致、情绪动态平滑、文化同质化),建议训练与评测都搭配真实或众包临床语料(如 AnnoMI、EmpatheticExchanges、RealCBT、KokoroChat),并对合成与真实数据做分布差异检查。
论文图表
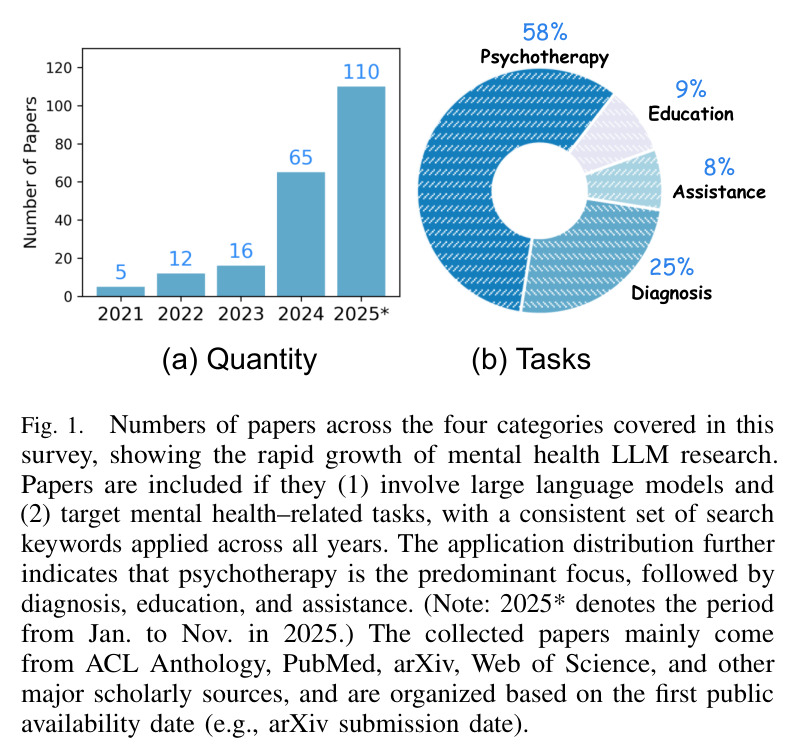
统计本综述收录论文的数量与任务分布:2021-2025 年(2025 仅统计 1-11 月)论文量快速增长;应用分布饼图显示心理治疗占 58%、诊断 25%、教育 9%、专业辅助 8%。论文纳入标准为同时涉及大语言模型并面向心理健康任务,来源包括 ACL Anthology、PubMed、arXiv、Web of Science 等,按首次公开日期组织。
用数据证明领域的爆发式增长与任务分布失衡,直接支撑需要一个统一演进框架的动机,也是三阶段叙事的实证起点。
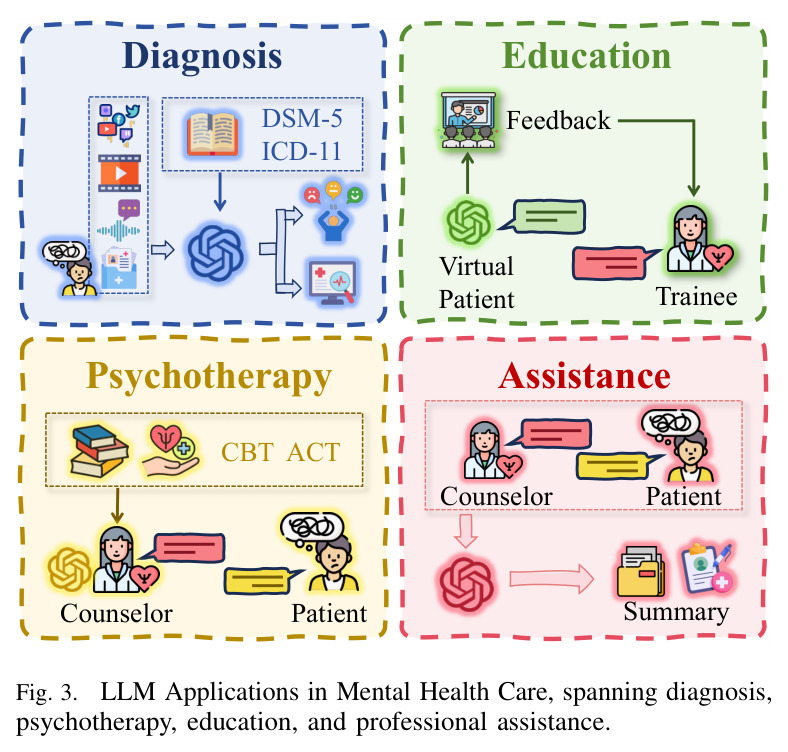
四大应用支柱示意图:诊断(对照 DSM-5/ICD-11 标准的心理状态评估)、心理治疗(CBT/ACT 等干预的咨询师-患者对话)、教育(虚拟病人供实习生练习)、专业辅助(会话摘要、治疗计划等临床工具)。
帮助读者在进入技术细节之前建立应用全景,理解三阶段框架在真实场景中的落点与价值。
以六项判据对比三阶段系统:交互粒度(单轮/多轮/纵向)、用户状态建模(无/会话级/持久)、跨会话能力(无/无/有)、个性化(无/会话级/持久)、记忆机制(无/上下文/长期)、自主性(被动反应/交互式/目标导向)。
整篇综述的框架基石,把三阶段论题操作化为可判定标准,任何新系统都可以用这张表快速定位自身所处阶段。
Phase I 检测类数据集汇总表,涵盖抑郁检测(RSDD 116,484、DR、DepSeverity、SWDD 4,854,421)、自杀检测(UMD 1,556,194、CSSRS-Suicide 15,755、SOS-HL-1K、SHINES)、压力与认知扭曲检测(Dreaddit、CAMS、C2D2、CDPR、KoACD)、双相风险(BD-Risk)等任务,逐项给出年份、来源平台、是否含自述诊断(OSD)、样本规模与语言,从 CLP 的 1,746 条到 MentalHelp 的 14,097,946 条。
完整呈现 Phase I 的数据版图与规模跨度,是理解检测模型训练基础、可解释性趋势与多语言覆盖的必备索引。
Phase II 与 Phase III 对话语料汇总表,包含 30 余个数据集:众包(EmpatheticDialogues 24,850 段/4.3 轮、ESConv 1,053 段/14.1 轮、KokoroChat 6,589 段/45.6 轮)、真实世界(PsyQA 56k、PsyChatbot 89k)、合成(SoulChatCorpus 2,300,248 条、SMILE 55,165 段、AugESC 65k)与纵向多会话(MusPsy 1,500 段/28.6 轮、DiaCBT 540 段/53 轮、PsyDial 2,382 段/37.8 轮),并标注平均轮数与语言。
直接体现数据从单轮问答到长多轮、再到多会话纵向语料的演进,是评估 Phase II 模型训练资源与 Phase III 数据瓶颈的核心参考。
其他心理健康资源汇总表:治疗师策略与来访者反应标注(Xinling 2,382 段/39.3 轮、Anno-MI 133 段/72.9 轮)、动机式访谈编码(BiMISC 80 段/108 轮、MI-TAGS、MIDAS 西班牙语)、认知重构(PATTERNREFRAME)、共情检测(EmpatheticExchanges)、有效社会支持(RedditESS)、心理操纵检测(MultiManip)、健康社会决定因素(SynthEHR-Eviction)、真实 CBT 情绪动态(RealCBT 76 段)等。
补全治疗过程建模与专业对齐所需的数据视角,这些细粒度的行为与策略标注是训练和评估模型临床技能的基础。
多模态数据集汇总表,分为面向交互的支持性对话(MEDIC、MESC、Mirror)与基于行为的状态检测(AVEC 2013/2018、WESAD、MODMA 脑电+语音、CMDC、WU3D、D-vlog、UBFC-Phys、PTSD-in-the-Wild 等)两类,逐项标注模态组合(视频、音频、文本、生理信号)、任务与语言。
支撑超越文本的多模态评估与干预方向;其模态组合信息也帮助读者分析伪相关与临床效度风险的来源。
评估指标双栏汇总:语言自动指标(Accuracy、Recall、Precision、F1、MAE、BERTScore、ROUGE、BLEU、Distinct-N)与以 LLM-as-a-Judge 或人工评估实现的心理健康属性(连贯性、共情、有用性、一致性、拟人度、适应性、方法性、情感联结、目标、安全性、专业性、个性化、调谐性、流畅性、引导性、治疗联盟),每项均列出关联研究。
提供该领域的评测词汇表,直接支撑三层级指标论述——表层自动指标与治疗质量相关性差,临床关系属性才是关键但难以规模化测量。
按 Expert(领域资质标注者评估)、Clinical(真实患者群体验证)、Automatic(自动指标)三列盘点 ChatCounselor、CPsyCounX、MeChat、CBT-LLM、MentaLLaMA、PsycoLLM、PsyAdvisor、KokoroChat、PsyDial、PsyLLM、TeenEmpath、Therabot、TheraMind、CACTUS 等代表性系统的验证设置,其中 Clinical 一列几乎空白。
一张表定性地揭示领域最大的证据缺口——绝大多数系统从未在真实患者群体中验证,这是评测差距论证的核心证据,也是四维评测协议提出的直接动因。