LatentPort:超越 KV 缓存——混合语言模型中循环记忆的跨模型迁移(4B→9B 混合状态交接,无需目标前缀重放) LatentPort: Beyond KV Cache - Cross-Model Transfer of Recurrent Memory in Hybrid Language Models: A 4B-to-9B Hybrid-State Handoff Without Target Prefix Replay
首次证明混合大模型的循环记忆可跨尺寸迁移:9B 不重读前缀即继承 4B 的活记忆并反超其续写质量。
前置知识
KV 缓存与注意力层状态
自回归推理时,每个注意力层为每个历史 token 缓存键(K)和值(V);生成新 token 只需计算当前 Q 与缓存 K/V 交互,避免重算整个前缀。K/V 带 RoPE 位置旋转、与 token 位置一一对应,跨模型复用需用学习到的线性映射把源模型 K/V '翻译'到目标表示空间,并处理位置编码的解旋转与再旋转。
本文的核心对照就是'仅翻译 KV'与'完整混合状态交接'的差距,理解 KV 缓存是理解'KV 之外还有不可忽视的状态'的前提。
混合注意力-循环架构
用少数全注意力层与多数线性循环层交替堆叠的架构(本文 Qwen3.5 为每 3 层 GDN + 1 层注意力,共 24/8)。注意力层保留按 token 索引的 KV,循环层保留固定形状的持续状态,推理成本随长度近线性。因此其推理缓存由两类性质完全不同的状态组成。
正因如此,'跨模型搬 KV'只搬走了一半状态;本文要回答的正是另一半(循环状态)能否也跨模型迁移。
Gated DeltaNet(GDN)与 delta 规则
一种门控线性循环层,把历史压缩进固定矩阵 $S_t$:先门控衰减 $\bar{S}_t=\alpha_t S_{t-1}$,再按 delta 规则写入 $S_t=\bar{S}_t+\beta_t(v_t-\bar{S}_t k_t)k_t^\top$,即'值减去按键检索到的旧值'的纠错式更新。每层状态形状 32×128×128。
GDN 持久状态是本文跨模型交接的核心对象,公式 (1)(2) 是理解'循环记忆里到底存了什么'的基础。
卷积历史状态
混合架构中 GDN 层通常前置一个短因果卷积(本文卷积核宽 4,每层缓冲 8192×4),保存最近几个 token 的局部特征历史,用于循环更新前平滑输入。它与循环矩阵同属持久状态,共同决定后续读数。
本文的'GDN 状态包'同时含循环矩阵、卷积历史和初始化语义;只搬循环矩阵不等于搬走全部 GDN 记忆,这直接影响结果解读。
Teacher forcing 与 NLL(nats/token)
评测时把真实文本的下一个词作为输入喂给模型,只要求预测已观察到的续写 token,而非自由生成。NLL(负对数似然)是每 token 平均对数损失,以自然对数单位 nat 计,越低越好;1 nat 约对应每 token 概率差 $e$ 倍。
本文所有主结论均以 teacher-forced NLL、超额 NLL 和成对 bootstrap 区间表述,且作者强调这只证明'保真度'而非自由生成质量。
Ridge 回归线性映射与 RoPE 解旋转
用带 L2 正则的线性回归 $\hat{S}_9=\mu_9+A(S_4-\mu_4)B^\top$,从配对状态数据最小二乘拟合源→目标变换,正则强度在验证集按张量误差选取。因 K/V 带 RoPE 旋转,映射前需按位置解旋转(除以 $\sin^2+\cos^2$ 因子)、映射后再旋转回去。
KV 翻译器与被对比的 GDN 学习映射都基于此;而'直接复制反而优于学习映射'是本文最反直觉的发现之一。
原生上下文恢复率 NCR
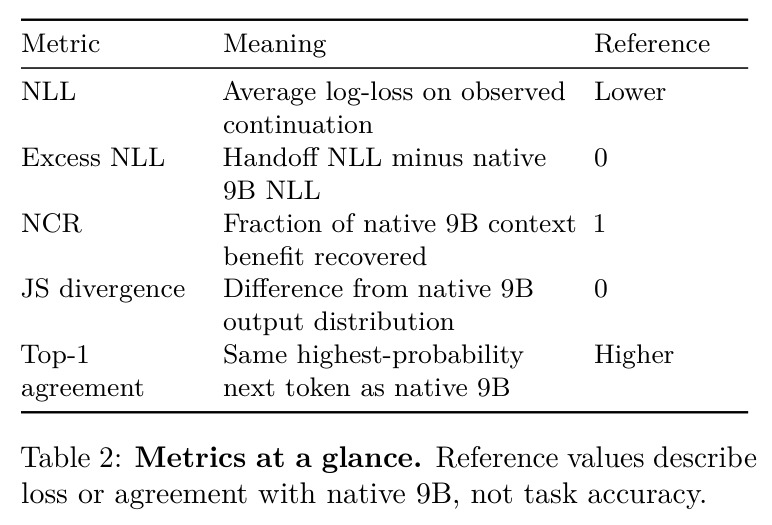
衡量交接恢复了多少'原生 9B 读前缀相对空状态带来的续写损失改善':$\mathrm{NCR}_c=(\ell_{\text{empty9B}}-\ell_c)/(\ell_{\text{empty9B}}-\ell_{\text{native9B}})$。0.918 表示恢复了 91.8% 的上下文收益;它是聚合 NLL 之比而非准确率,可越出 [0,1]。
论文的验收门槛(FULL_STATE 与 NEAR_NATIVE gate)直接以 NCR、超额 NLL 和 top-1 一致率定义,读懂它才能理解结论的精确边界。
成对文档 bootstrap 置信区间
以文档(而非 token)为统计单元,对 64 篇文档做 10,000 次有放回重采样,保持文档内各条件配对关系,取 95% 百分位区间,种子冻结。这样正确处理了同一文档内 token 高度相关的问题。
论文所有关键数字(如 0.7473 [0.6921, 0.8047])都是这种区间;图 3 特意强调这是文档级效应,不是 4096 个独立 token 复制。
研究动机
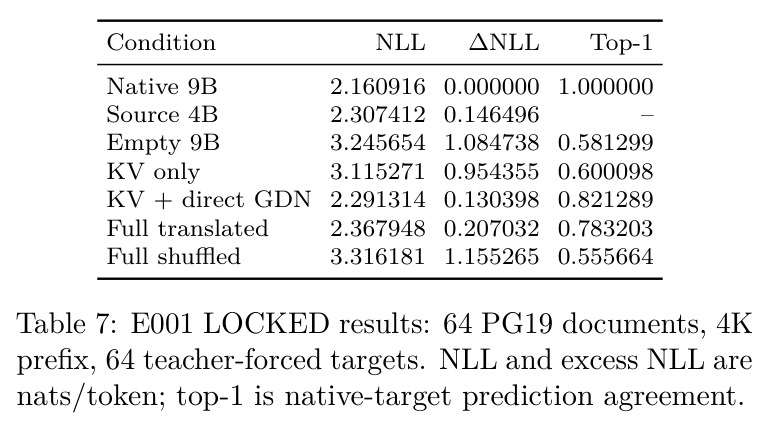
现代大模型服务中经常需要换模型:级联路由先用小模型粗筛、多智能体流水线在不同模型间传递上下文、模型升级后想无缝迁移旧会话。目前的标准做法是让接收方重读一遍历史前缀、重建推理状态,前缀越长代价越高。跨模型 KV 缓存翻译(如 Heo 等人的闭式线性映射、CacheBridge、Mixture-of-Translators)能在纯注意力模型上免去重读,但本文研究的 Qwen3.5 这类混合架构里,推理状态不止 KV:24 个 Gated DeltaNet 循环层还保存着每层 32×128×128 的循环矩阵和 8192×4 的卷积历史。只搬 KV 会把这些持久记忆全部丢掉——实验中仅翻译 KV 的 9B 在 PG19 续写上 NLL 为 3.115,几乎和空状态 9B 的 3.246 一样差,远逊于原生 9B 的 2.161,约 88% 的上下文收益没有恢复。而循环状态由源模型自己的投影和门控写入,接收方要用不同权重去读写:形状匹配只保证'能复制',不保证'复制了有用'。
本文的目标是本文要首次系统地回答:一个混合架构语言模型'活的'持久循环推理状态,能否在不重放历史前缀的前提下跨模型交接并被有效使用?具体拆成三个可检验的子问题:(1) 固定翻译 KV 后,GDN 持久状态包(循环矩阵+卷积历史+初始化语义)是否带来统计显著的额外收益(实验 1:64 篇 PG19 文档,4K 前缀,64 个 teacher-forced 目标);(2) 三个组件(K、R、C)各自应学习翻译还是直接复制(实验 2 的 $2^3$ 因子设计);(3) 在此基础上加一个极小的行为修正,交接后的 9B 能否在续写上击败继续推理的源 4B 并逼近原生 9B。作者为此预注册了量化门槛(FULL_STATE_HANDOFF 与更严的 NEAR_NATIVE_HANDOFF),用错误供体状态轮换做因果控制,并明确声明不证明自由生成等价或通用状态接口。
与已有工作不同的是,四条相关工作各有缺口:跨模型 KV 翻译只处理注意力缓存且多为同族全注意力模型(常需目标端上下文重放);StateBridge 等隐状态通信在共享权重的智能体间传连续消息,并不把状态装进接收方内置推理槽位;Engram 式外部记忆迁移搬运的是学习出来的外挂记忆而非特定输入后的内置缓存;Marconi、HYPIC、Tail-Replay、WriteSAE 等同模型循环缓存复用/编辑都不跨模型。本文的独特切入是四个条件的交集:不同尺寸(2,560 vs 4,096 隐藏宽度)、注意力-循环混合体、前缀条件化的内置持久状态、零目标前缀重放的实时接收。方法论上的另一独特之处是把交接当作受控干预来做:模型冻结、门槛预注册、盐化哈希冻结数据划分、错误供体对照、10,000 次成对文档 bootstrap,并保留声明账本与证据 SHA-256——这种'少 claim、强控制'的纪律在单作者小规模实验里非常罕见。
核心方法
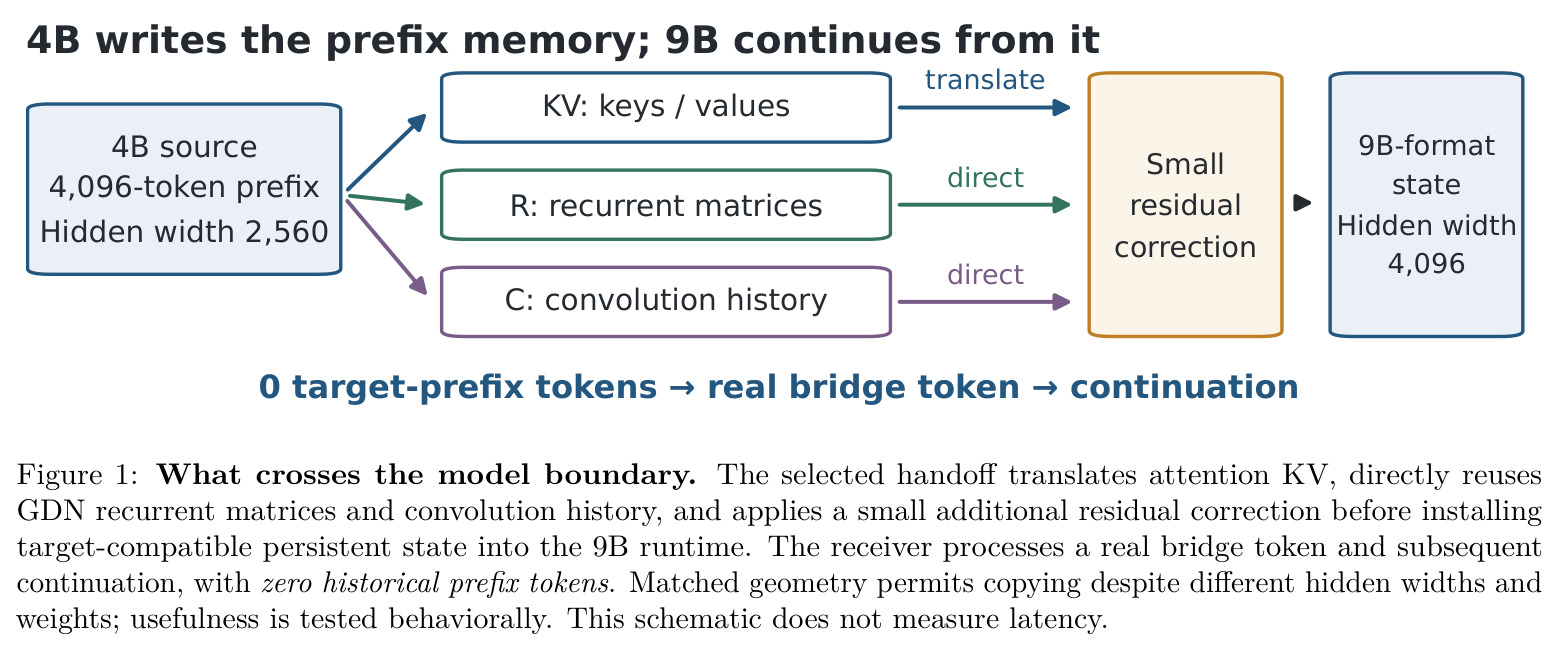
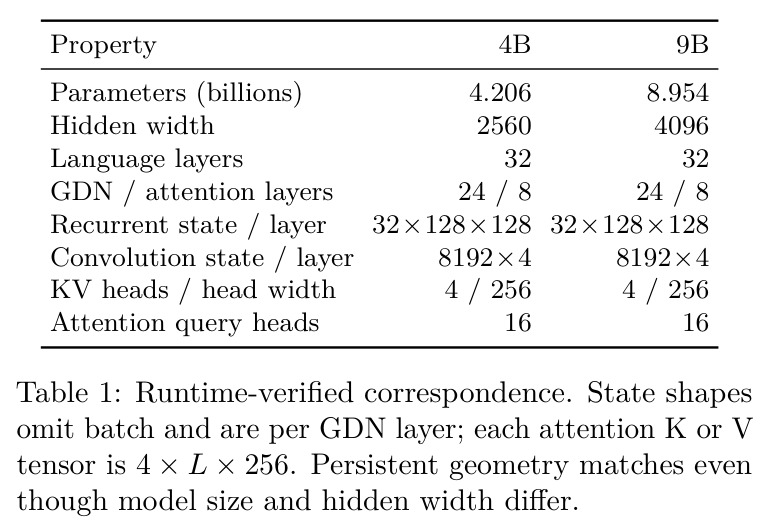
直觉:同一预训练家族的不同尺寸'兄弟'模型可能共享相似的持久状态坐标系,因为它们用同样配方学习相似的计算结构。作者先验证了前提:Qwen3.5-4B-Base 与 9B-Base 虽参数量 4.206B vs 8.954B、隐藏宽度 2,560 vs 4,096,但持久状态几何完全一致——同为 32 层(24 GDN + 8 注意力)、每层循环状态 32×128×128、卷积缓冲 8192×4、4 个 KV 头×256 宽,层/头索引一一对应,无需裁剪、填充或学习索引对齐。技术路线:4B 读 4,096 个历史 token 后写出状态包 $H_4=(K_4,R_4,C_4,m_4)$(K 含注意力键值,R 循环矩阵,C 卷积历史,m 元数据);注意力 KV 经逐层/逐头/逐角色的 ridge 映射翻译(先把 64 个 RoPE 旋转维度解旋转,映射后再旋转);GDN 组件按 8 种直通/翻译组合中验证最优者处理,胜出的是'翻译 KV + 直接复制 R 和 C'(TDD);再叠加一个 434,176 参数、恒等锚定的残差修正;最后把目标兼容状态装入 9B 全新缓存,9B 只读一个真实的桥接 token $x_{L+1}$ 即开始对 $x_{L+2:L+65}$ 共 64 个目标评分,全程零历史前缀重放。
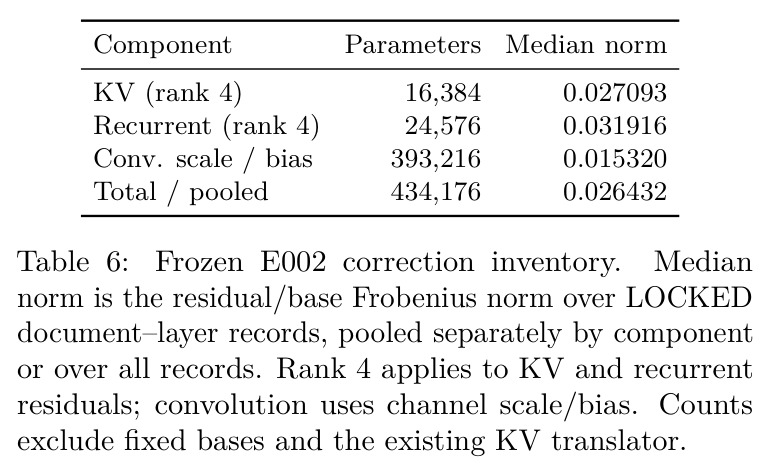
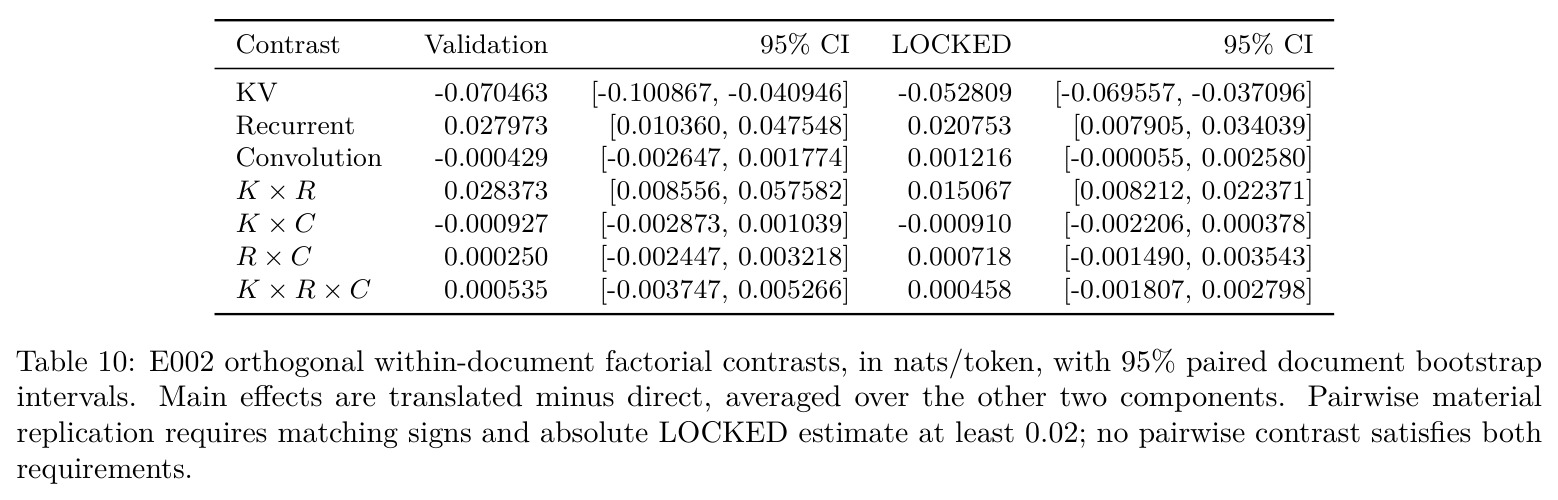
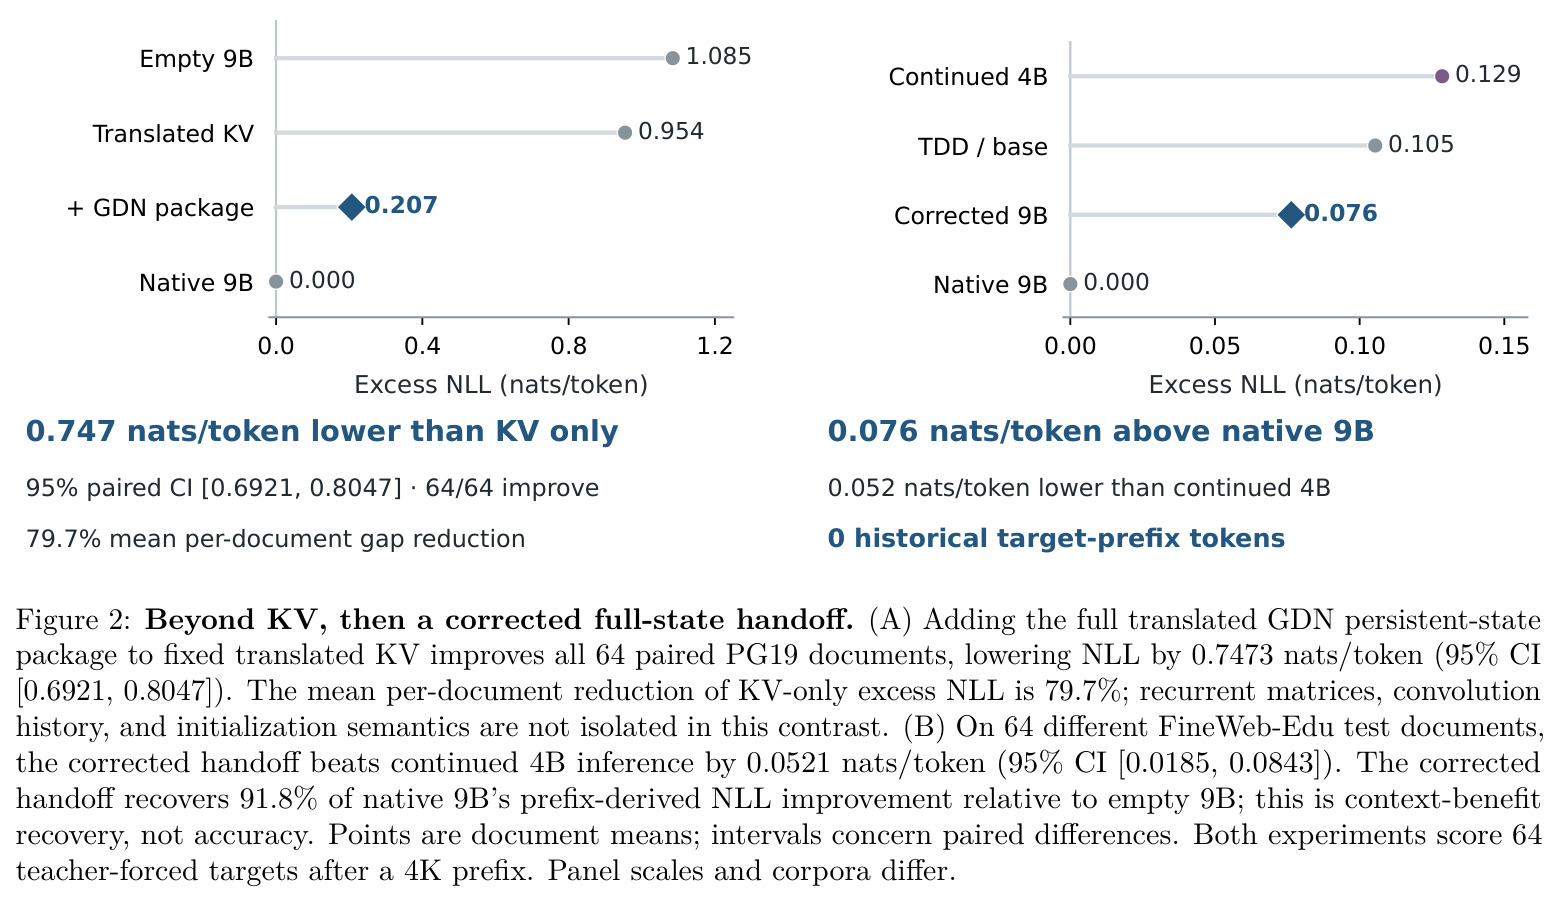
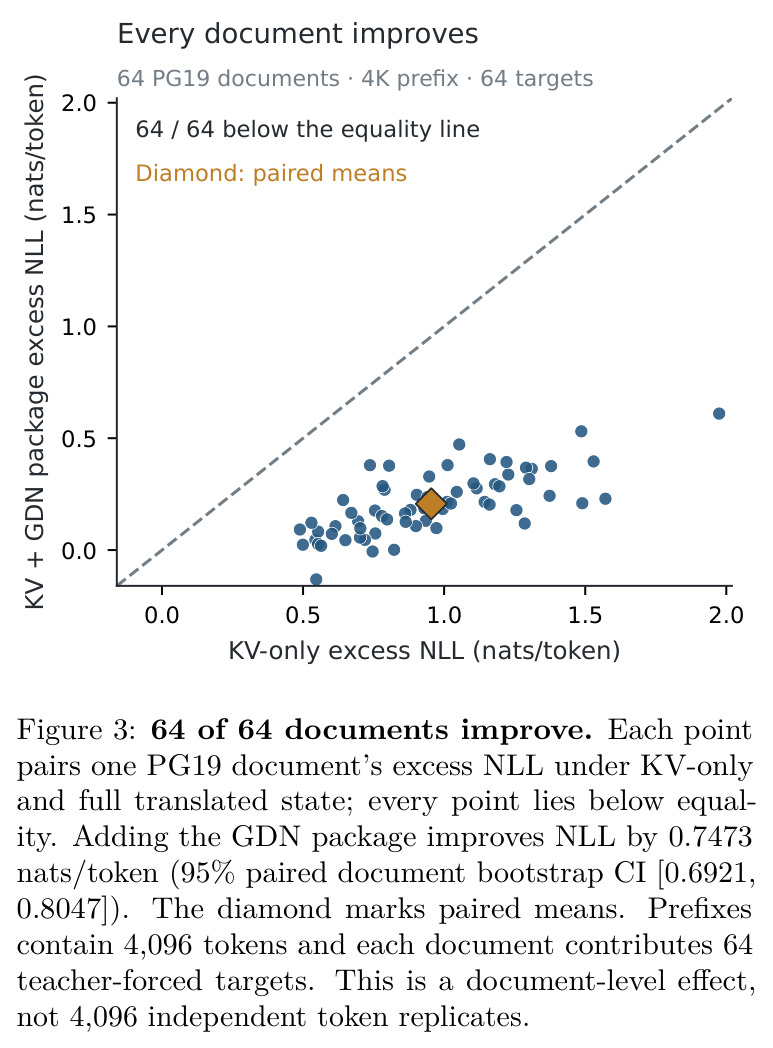
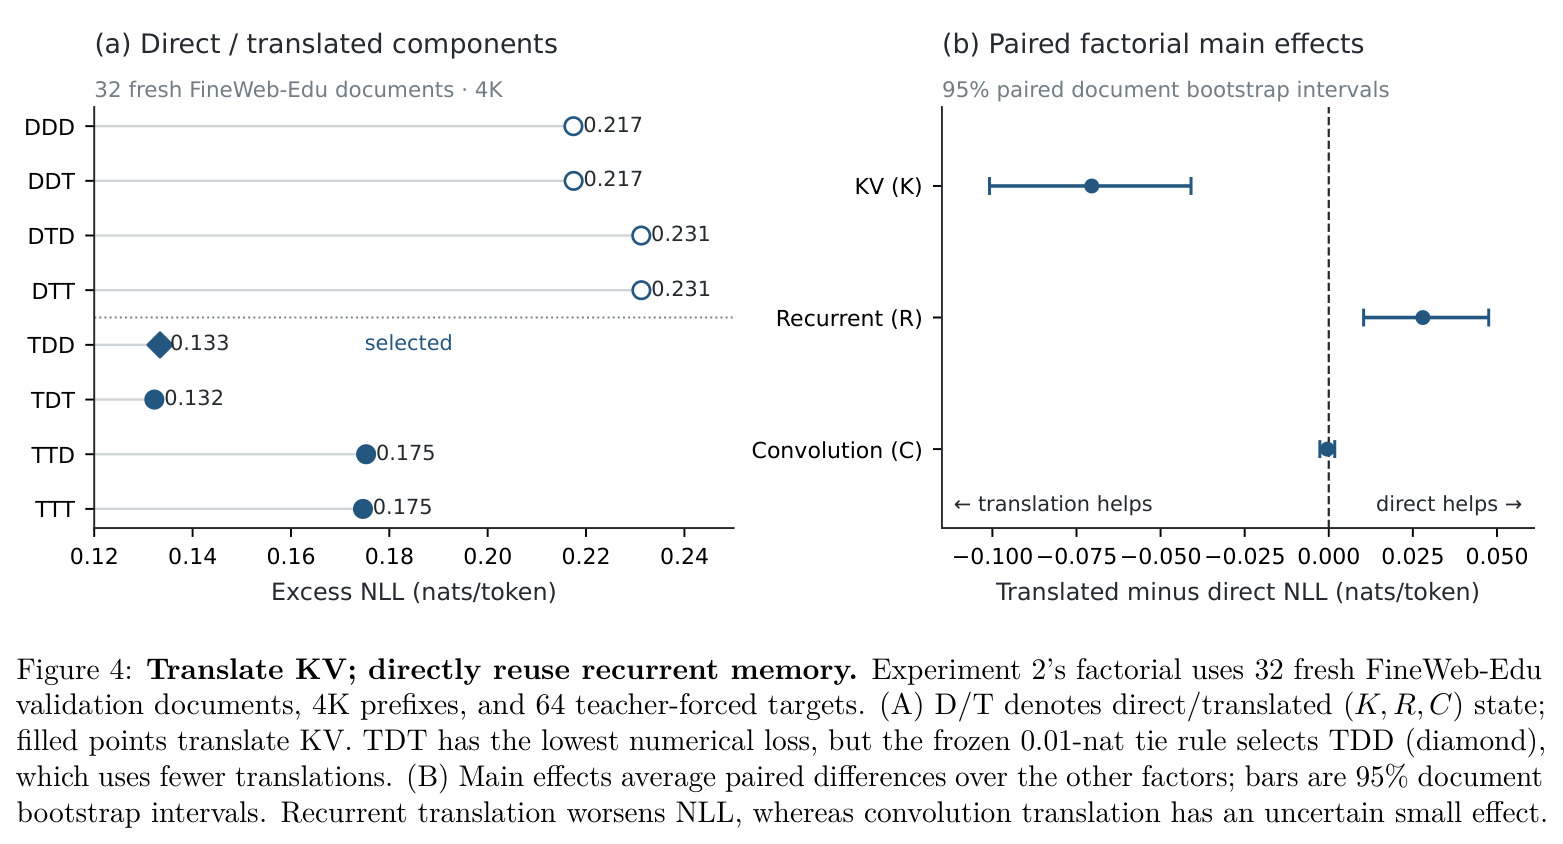
核心创新有三层。第一,把交接对象从 KV 扩展到完整混合持久状态,并用干预实验证明 GDN 状态包贡献了 KV 之外的 0.7473 nats/token(64/64 文档改善)——直接反驳'KV 就是全部可迁移推理状态'的默认假设。第二,发现'部分功能兼容':不同尺寸兄弟模型间,GDN 循环矩阵和卷积历史直接复制反而优于学习映射——实验 1 中直通复用比全翻译低 0.077 nats(2.291 vs 2.368),实验 2 因子分析显示循环翻译主效应 +0.0280(变差)而 KV 翻译 −0.0705(有益);更有说服力的是,学习循环映射的验证张量重建误差更低(0.5037 vs 直接复制的 0.6732),行为上却更差,说明张量重建误差不是交接质量的可靠代理,行为对齐才是。第三,修正器设计成恒等锚定:$X'=X+(XB)U^\top$,所有可训练输出零初始化,即从'直接复制'出发只学一个小偏差,并用对原生 9B 的全词表 KL 行为损失训练,而非拟合状态张量本身——这把'翻译问题'转化为'小残差学习问题'。
方法步骤详情
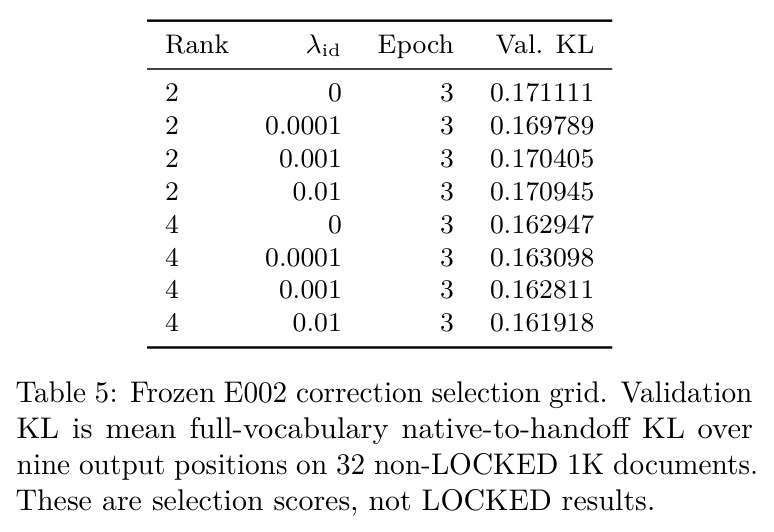
流程七步。(1) 同模型恢复校验:两模型各在 4 种长度、16 个上下文上做完整状态存取,要求 top-1 一致率 100%、最大 logit 差为 0,证明捕获-恢复无误——这是后续结论的前提。(2) 状态捕获:因发现分块与一次性 prefill 不等价(桥接 logit 最大差 0.125),每个校准检查点都用独立一次性 prefill 捕获,4K 前缀按 128-token 间隔取 1/4/16/64 检查点。(3) 拟合 KV 翻译器:128 篇 FineWeb-Edu 文档、1K 前缀,每层/KV头/角色各一个 ridge 映射,正则网格 $\{10^{-8},...,10^{2}\}$,按验证张量误差选参后冻结,共 54,525,952 个系数(约 322MB)。(4) 组件选择:32 篇新 4K 文档上跑 8 种 D/T 组合的因子设计,按平均超额 NLL 选优,0.01-nat 平局容忍内选更少翻译组件,选出 TDD。(5) 训练修正器:KV 用秩 4 残差(16,384 参数)、循环用跨头共享的秩 4 残差 $S'=S+U_LB_L^\top S+S B_RU_R^\top$(24,576)、卷积用逐通道缩放平移 $C'_{j,t}=C_{j,t}+a_jC_{j,t}+b_j$(393,216),共 434,176;基为固定 Gaussian-QR 正交基,AdamW 学习率 $10^{-3}$,损失为对原生 9B 的 9 个输出位置(桥接+8 个教师输入)全词表 KL 加恒等惩罚 0.01,至多 3 个 epoch。(6) 安装:全新缓存对象+确定性元数据;运行时守卫禁止只激活一个 GDN 组件。(7) 评测:桥接 token 后 64 个 teacher-forced 目标,10,000 次成对文档 bootstrap,种子冻结。
技术新颖性
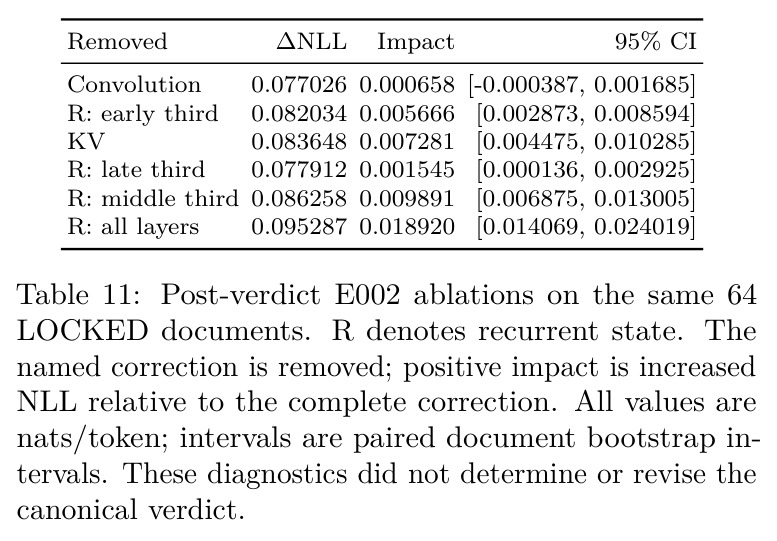
新颖性体现在'第一次+怎么做'。概念上,这是首个在无目标前缀重放条件下、把内置前缀条件化循环推理状态在不同尺寸混合 LLM 间交接的演示(作者做了文献核查并给出限定性声明);它与 KV 翻译、隐状态消息、外挂记忆迁移、同模型缓存复用四条既有路线都不同。实证上,'直接复制优于学习映射'是意外发现——暗示同配方预训练可能产生部分共享的持久状态功能坐标,但作者谨慎指出这不等于表征同一性,也不是正式的状态 ABI,共享预训练只是假设而非被分离的因素。方法论上,恒等锚定+零初始化+行为 KL 的修正器设计让 434,176 参数(1.90 MB,仅为目标模型 BF16 参数量的约 $10^{-4}$)就消除剩余原生差距的 27.5%;预注册门槛、冻结哈希划分、错误供体轮换,以及诚实区分主结论与事后诊断(组件移除消融明确标注为 post-verdict、无多重性校正、不得改写结论)的纪律,为系统+科学交叉实验提供了范式。
实验结果
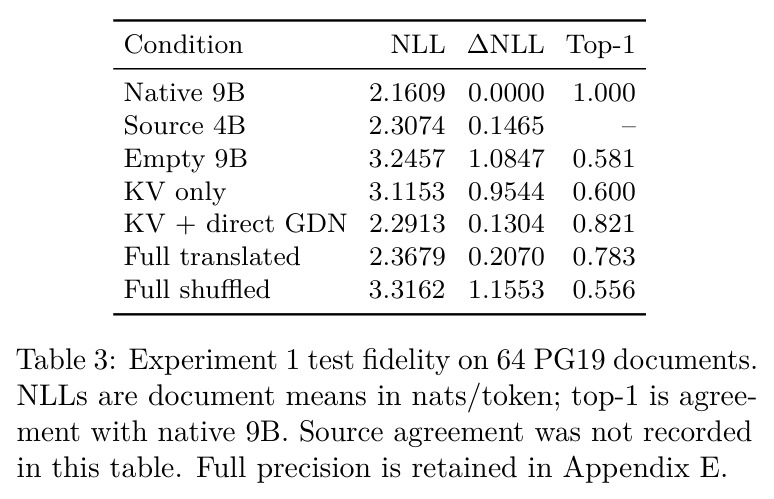
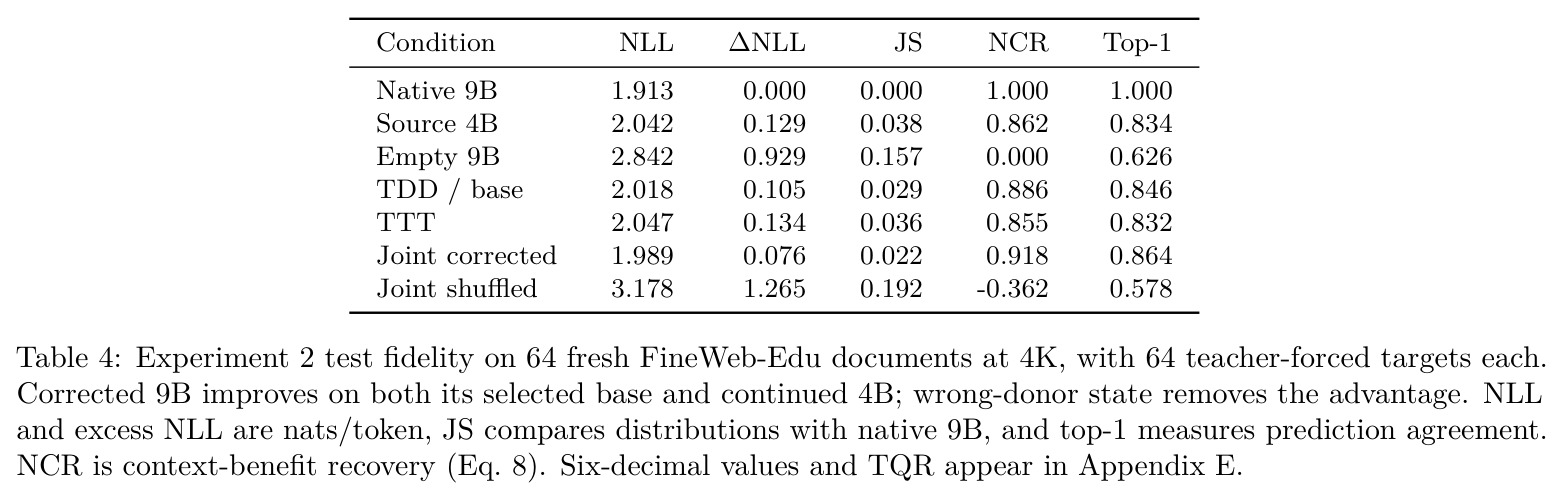
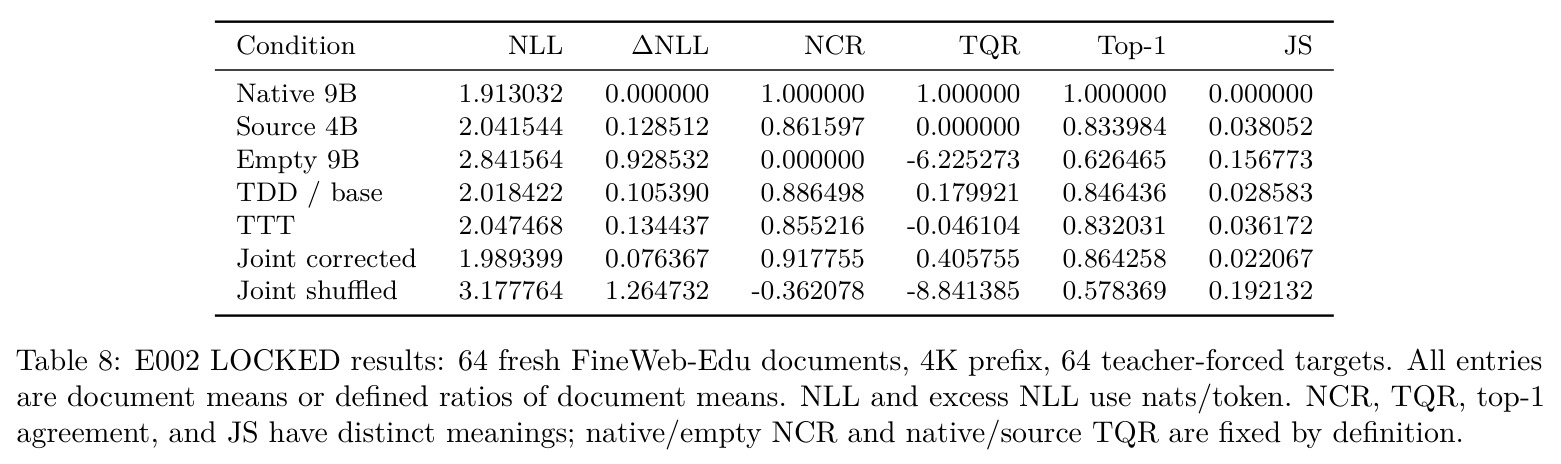
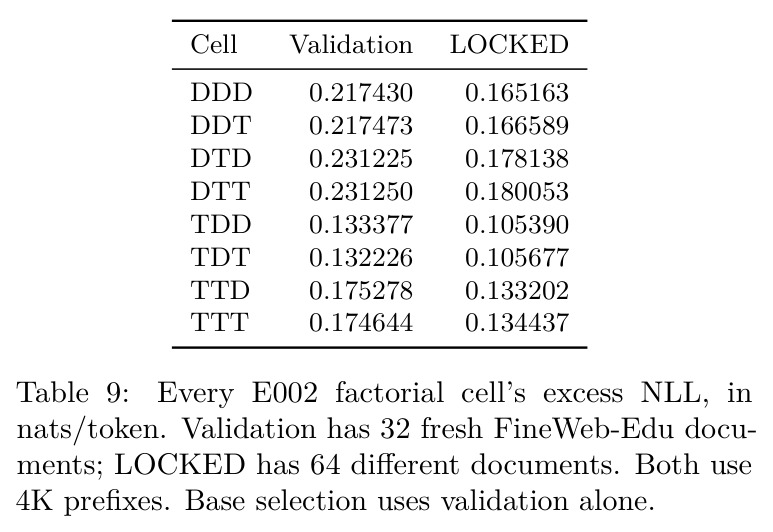
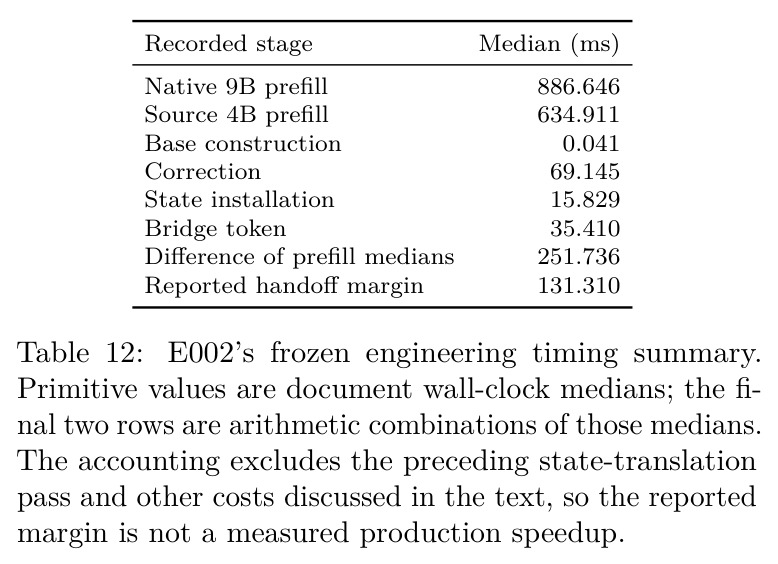
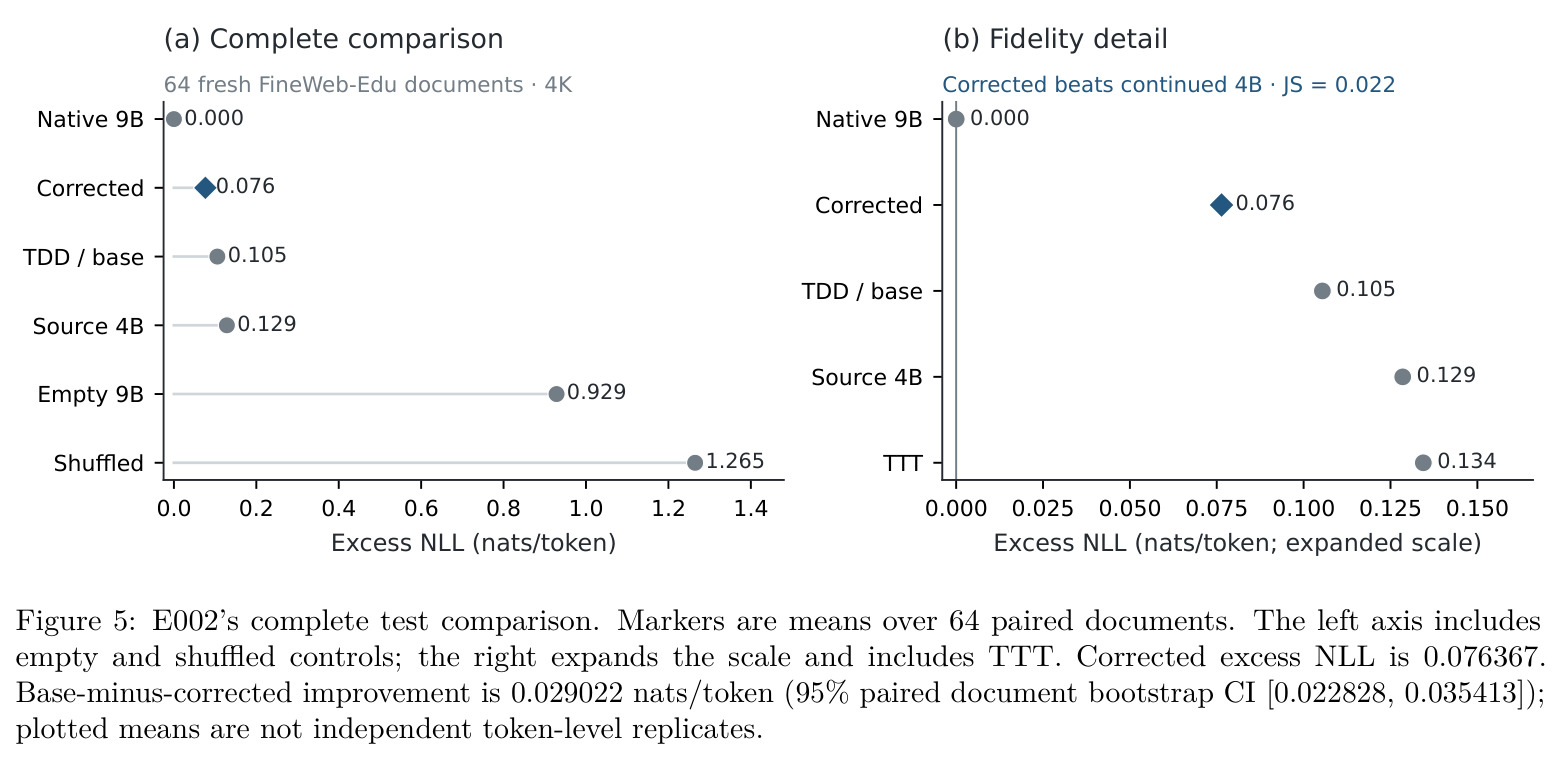
实验 1(64 篇 PG19,4K 前缀,64 目标):固定翻译 KV 后加入 GDN 状态包,NLL 从 3.115 降到 2.368,降低 0.7473 nats/token(95% CI [0.6921, 0.8047]),64/64 文档全部改善,KV-only 超额差距平均消除 79.7%(中位 80.2%);KV+直接 GDN 复用更好(NLL 2.291,超额外 0.130);错误供体全打乱恶化到 3.316(差于空 9B),证明续写确实依赖文档特定的 transferred 状态。实验 2(64 篇新 FineWeb-Edu,4K):因子分析主效应为 KV 翻译 −0.0705 [−0.1009, −0.0409](有益)、循环翻译 +0.0280 [0.0104, 0.0475](直接复制更好)、卷积 −0.0004(不确定);TDD 被选中,其锁定测试超额 NLL 0.105 对全翻译 TTT 的 0.134(差 CI [0.0170, 0.0418])。加修正器后:9B NLL 1.989,显著优于继续推理的 4B(2.042,差 −0.0521,CI [−0.0843, −0.0185]),距原生 9B(1.913)仅 0.076;JS 散度 0.022,NCR 0.918,top-1 一致率 0.864,中位残差范数仅 0.0264;打乱供体则恶化到 3.178(−1.188)。结论登记为 FULL_STATE_HANDOFF(通过:剩余差距消减 ≥25%、超额 ≤0.10、NCR ≥0.90 等),但更严的 NEAR_NATIVE 三项全未达标(0.076>0.05、NCR 0.918<0.95、top-1 0.864<0.90),16K 分支因此未运行。计时余量 131.310ms 未计入翻译通道成本,作者明确否认生产级加速。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PG19 4K 续写(实验1):KV 之上叠加 GDN 状态包 | ΔNLL(nats/token,成对文档) | 降低 0.7473(全翻译 NLL 2.368 vs KV-only 3.115) | 仅翻译 KV(KV-only,超额外 NLL 0.954) | 64/64 文档改善,平均消除 KV-only 超额差距的 79.7%(CI [0.6921, 0.8047]) |
| FineWeb-Edu 4K 续写(实验2):修正后 9B vs 继续推理 4B | NLL(nats/token) | 1.989(零目标前缀 token) | 继续推理的源 4B:2.042(读了全部 4K 前缀) | −0.0521 nats/token(CI [−0.0843, −0.0185]) |
| 实验2:修正后 9B vs 原生 9B | 超额 NLL / NCR / JS | 0.076 / 0.918 / 0.022 | TDD base(无修正):0.105 / 0.886 / 0.029 | 修正额外消除剩余原生差距 27.5%(CI [22.4%, 33.9%]),top-1 从 0.846 升至 0.864 |
| 实验2 因子:TDD(翻译KV+直通GDN)vs TTT(全翻译) | 超额 NLL(锁定测试,64 文档) | 0.105 | TTT 全翻译:0.134 | 直接复用 GDN 状态的优势在 held-out 成立(配对差 CI [0.0170, 0.0418]) |
| 实验2:正确供体 vs 打乱供体状态 | NLL(nats/token) | 1.989 | 打乱供体 3.178(差于空 9B 的 2.842) | −1.188(CI [−1.296, −1.085]),证明状态内容文档特异而非泛用先验 |
| 实验1:KV+直接 GDN 复用 vs 全学习翻译 | NLL(nats/token) | 2.291(超额外 0.130) | 全翻译状态:2.368(超额外 0.207) | −0.077 nats/token,尽管学习映射的张量重建误差更低(0.5037 vs 0.6732) |
局限与改进
作者明确承认:证据只覆盖一个方向(4B→9B)、一对几何完全匹配的 Base 模型、4K 前缀、每文档 64 个 teacher-forced 目标;近原生门槛失败,16K 分支未跑;无自由生成等价性、无下游任务、无通用状态接口;翻译器与修正器都绑定这一对模型;计时不含翻译开销、非端到端生产基准。实验 1 的主对比无法把循环矩阵、卷积历史与初始化语义三者分开。我补充几点:其一,修正器用原生 9B 在同分布文本上的输出做监督,带有向原生行为蒸馏的成分,跨域稳健性未知;其二,实验 2 的校准沿用实验 1 的 1K 文档而测试在 4K 新语料,域不匹配虽被明示,但也使'修正器到底学到了什么'难以解读(且循环翻译的对比还同时换了卷积翻译与评测域,存在混杂);其三,状态诊断显示修正后状态 Frobenius 误差在 256 步后仍有 0.365,'行为接近'与'状态一致'之间存在未解释的间隙;其四,单作者、64 篇文档的规模对亚组效应统计功效有限;其五,KV 翻译器 322MB 系数的存储与管线集成成本被推迟讨论。
独立分析的弱点
(1) teacher-forced 天花板:真实服务是自由生成,状态中的小误差可能复合放大——作者自己说真值输入会'稳定'续写;改进方向是滚动上下文的自由生成评测加分布漂移度量。(2) 兼容性来源不明:直接复用占优可能源于共享预训练数据/配方,能否迁移到不同家族完全未知;改进是构造几何匹配但独立训练的模型对做对照,分离'共享配方'与'共享数据'两个因素。(3) 主对比不分组件:实验 1 的'GDN 包'把 R、C、初始化语义捆在一起,且运行时守卫使 fresh-R/direct-C 等干预不可实施;改进是单独校验的分组件干预路径。(4) 修正器监督信号单域:仅用 1K FineWeb-Edu 校准文档训练,可能过拟合教育文本风格;改进是多语域训练加跨域评估,或改用分布无关的状态一致性目标。(5) 系统账目不完整:翻译通道(322MB、逐层逐头映射)不计入 131ms 余量,缺吞吐/TTFT/TBT 服务级指标;改进是端到端流水线基准与批量化翻译。(6) KV 翻译器庞大系数存储是部署瓶颈;可探索低秩共享、跨层参数共享或量化映射,把 54.5M 系数压到可用规模。
未来方向
作者提出的:最有决定性的两个后续是交接后的无约束自由生成测试(检验小状态误差是否复合放大)和在独立模型对上的复现(检验兼容性是否为 Qwen 兄弟特有),几何不匹配是更难的下一步;由此提出'状态 ABI'设计方向——刻意训练模型家族以保持跨尺寸的持久状态坐标兼容,为模型切换暴露稳定接口,并强调这需要自由生成检验和更多配对复现。基于本文成果可延伸的:9B→4B 反向交接(降尺寸场景对延迟更敏感,且状态'压缩'问题更有趣);把本文与 CacheBridge 式注意力敏感加权结合,统一 KV 与循环状态的翻译框架;用 WriteSAE 式稀疏字典定位'哪些循环坐标真正承载可迁移信息',从机制上回答直接复用为何有效;链式交接(4B→9B→4B)与异构多智能体协作中的状态交换协议;与推测解码/MTP 的交互;以及把 NCR/超额 NLL/预注册门槛这套协议发展成社区基准,系统比较不同翻译与修正方法。
复现评估
可复现性设计是本文亮点:全部使用官方 Base 检查点(记录仓库 revision 与 tokenizer 的 SHA-256),冻结的盐化哈希数据划分、随机种子(全局 2026090101/2026090106,bootstrap 2026083103/2026090103)、预注册门槛与验证脚本;论文附带声明账本、证据哈希(E001/E002 原始证据与修正张量的 SHA-256)、确定性图表脚本,提取脚本只读冻结证据、不做任何模型评估。算力门槛很低:单张 RTX 5090(32GB,消费级)完成全部实验;ridge 拟合是闭式解,修正器仅 434,176 参数、至多 3 个 epoch;主要开销是两模型在数百篇 4K 文档上的推理。难点不在算力而在工程纪律:必须精确实现 RoPE 解旋转(除以 $\sin^2+\cos^2$ 因子)、一次性 prefill 捕获、全新缓存安装与运行时守卫等细节(附录 C 给出完整网格与公式)。文中未给出公开代码仓库链接;若能拿到随附冻结证据与脚本,复现评测部分容易,从头复现训练与安装管线难度中等偏上。
论文图表
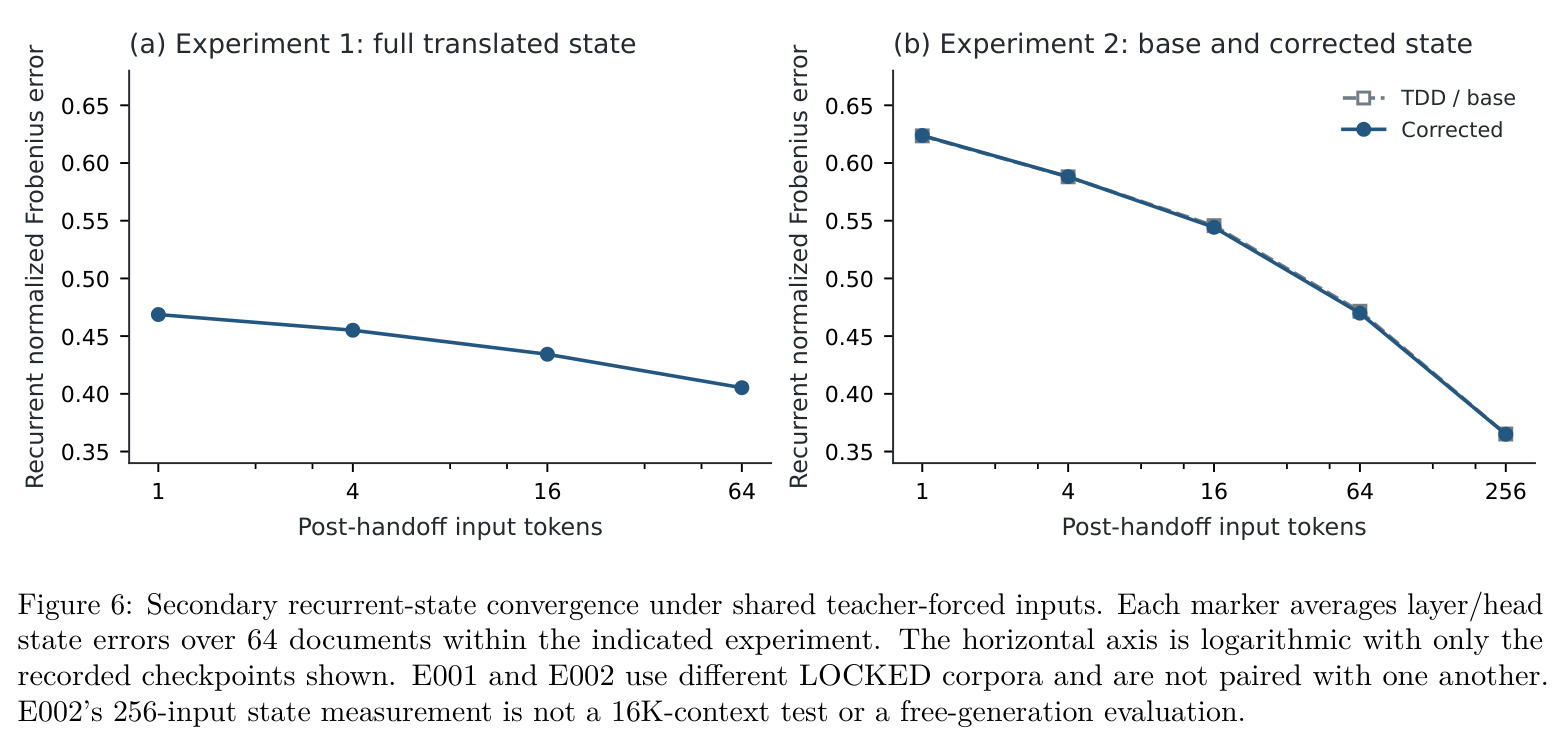
循环状态归一化 Frobenius 误差随交接后输入数(对数轴,1/4/16/64/256)的收敛:实验 1 全翻译从 0.4687 降至 0.4053(64 输入);实验 2 修正后从 0.6239 降至 0.3650(256 输入),余弦从 0.7778 升至 0.9266。图注说明两实验语料不同、不互相配对,且 256 输入不是 16K 上下文测试。
提醒读者'行为接近≠状态一致':共享教师输入与门控遗忘能缩小差距但不能完全恢复前缀信息;这是划定结论边界的重要次级证据,作者也明确状态距离不是成功门槛。