影响导向蒸馏:突破采样Token在线蒸馏的多样性瓶颈 Influence-Directed Distillation: Solving the Diversity Bottleneck in Sampled-Token On-Policy Distillation
用一阶局部熵影响定位压低多样性的更新,按师生分歧自适应收缩,保住蒸馏后的pass@k
前置知识
在线蒸馏(On-Policy Distillation, OPD)
一种后训练范式:学生模型自己 rollout 生成前缀 $h$,再在这些前缀上最小化学生分布 $p_\theta(\cdot|h)$ 与教师分布 $q(\cdot|h)$ 的反向 KL,即 $\mathbb{E}_{h\sim p_\theta}[D_{KL}(p_\theta\|q)]$。与用固定教师输出做监督的离线蒸馏不同,OPD 在学生自己会到达的状态上纠正学生,训练与推理分布一致。
本文全部讨论都建立在采样 token OPD 之上:理解它为什么便宜、以及它为什么会造成多样性失败,是读懂论文问题设定与动机的前提。
采样Token OPD(sampled-token OPD)
标准 OPD 需要教师对整个词表的分布来精确计算反向 KL,存储和计算开销巨大。采样 token OPD 利用了「反向 KL 是学生分布下的期望」这一事实:从学生分布 $p_\theta(\cdot|h)$ 采样一个 token $y$,只查询教师对该 token 的对数概率 $\log q(y|h)$,构成反向 KL 的单样本估计,每位置只需传递一个标量。
这正是论文要守住的效率底线:IDA-OPD 的全部设计都只允许使用采样 token 上的教师概率,不允许回到昂贵的 top-K/全词表教师分布。
pass@k 与无偏估计
pass@k 衡量对每个问题独立采样 $k$ 次时至少有一次答对的比例,是多样性敏感的指标:模型输出分布越塌缩、越集中在少数模式,pass@k 随 $k$ 增长的空间越小。本文采用 Chen et al. (2021) 的无偏估计器 $\text{pass@k}=\mathbb{E}_x[1-\binom{n-c_x}{k}/\binom{n}{k}]$,每题采 $n=128$ 个回答(温度 1.0、top-p 1.0)以降低方差。
论文的核心现象「多样性蒸馏失败」就定义为 pass@1 提升而 pass@k 停滞,所有主实验(表1、表2)与 pass@k 曲线(图3)都要用这个指标来解读。
策略熵(Policy Entropy)
策略在某状态输出分布的香农熵 $H(p)=-\sum_i p_i\log p_i$,衡量模型下一个 token 分布的「平坦程度」。熵高意味着探索性强、输出多样;熵快速收缩意味着分布过早尖锐化。近年 RL for reasoning 的工作(如 entropy mechanism、high-entropy forking tokens)表明策略熵与推理多样性、可探索的推理路径数量密切相关。
本文把多样性失败归因为「熵收缩」,全文的分析对象(一阶熵影响 $I_H$)、干预目标(阻止熵流失)与验证手段(训练熵曲线、token 熵直方图)都围绕策略熵展开。
优势与停止梯度(Advantage & stop-gradient)
在采样 token OPD 中,被采样 token 的优势定义为师生对数概率差 $A_y=\log q_y-\log p_y$:正值表示教师比学生更偏好该 token,应强化;负值则应抑制。损失写作 $\ell_y=-\text{sg}(A_y)\log p_\theta(y|h)$,其中 $\text{sg}(\cdot)$ 是停止梯度算子,把 $A_y$ 当作固定系数,只对学生自身的 $\log p_\theta$ 求导,从而保证单样本估计的无偏性。
IDA-OPD 的干预方式就是改写这个优势(乘上权重 $w_y$),而保持停止梯度结构不变;看懂损失函数里哪些量参与梯度、哪些被冻结,才能理解方法为什么「保号且不改方向」。
研究动机
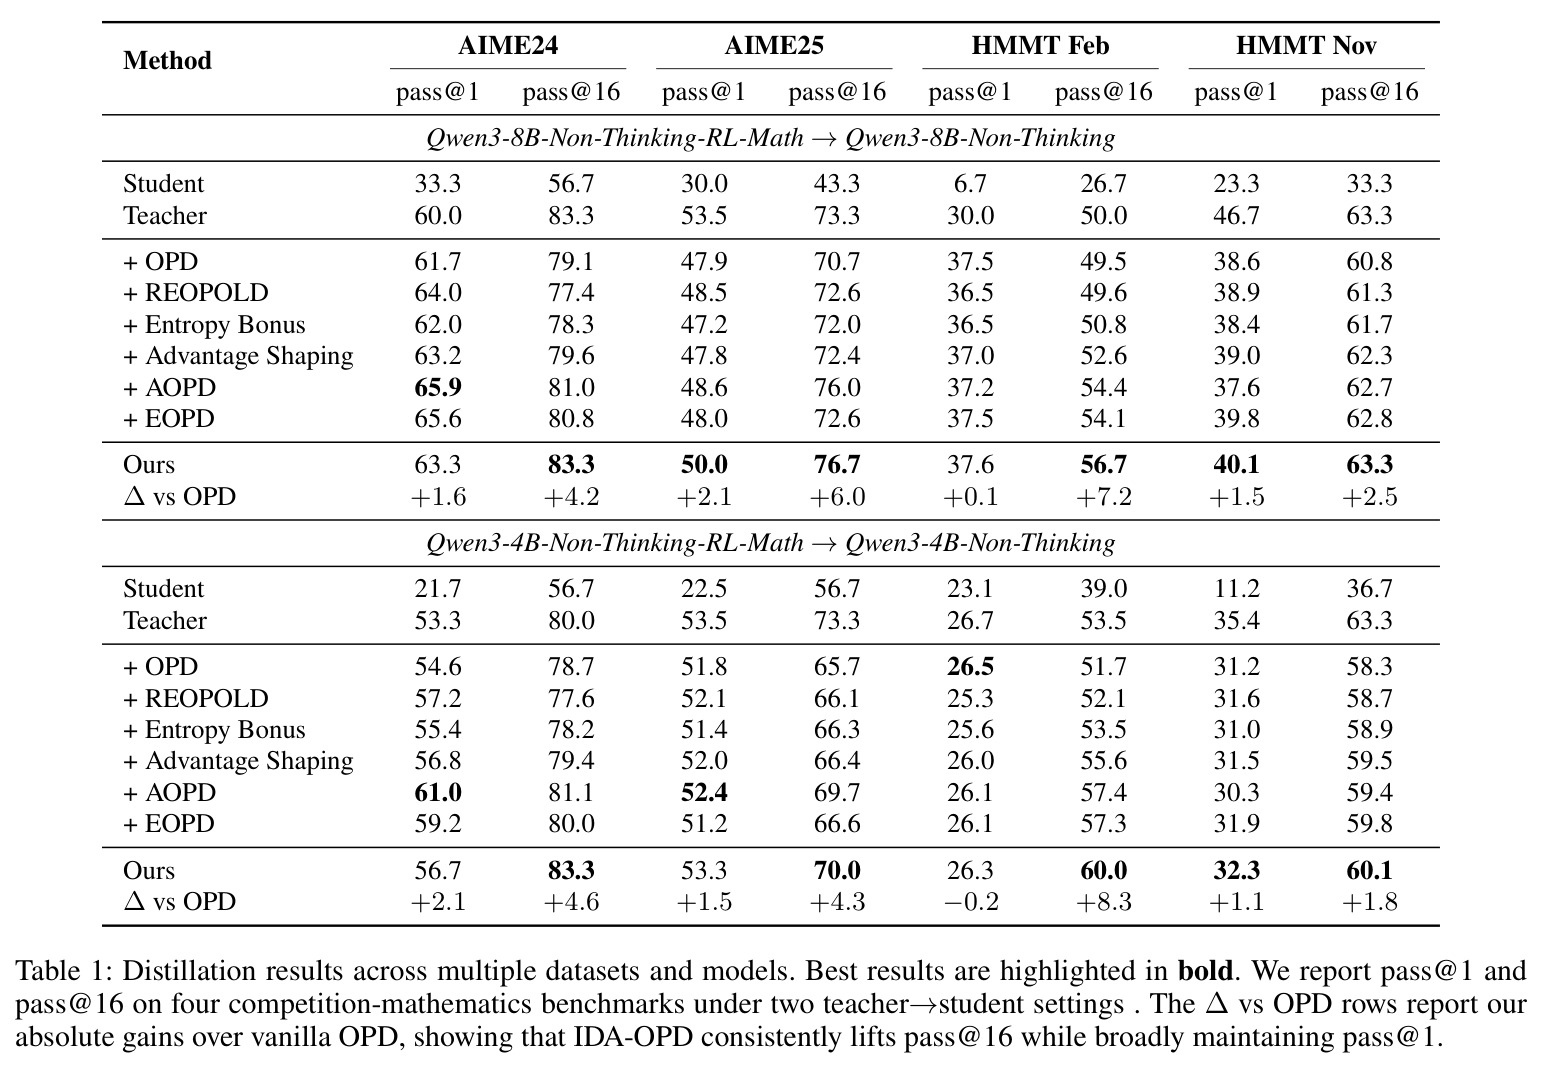
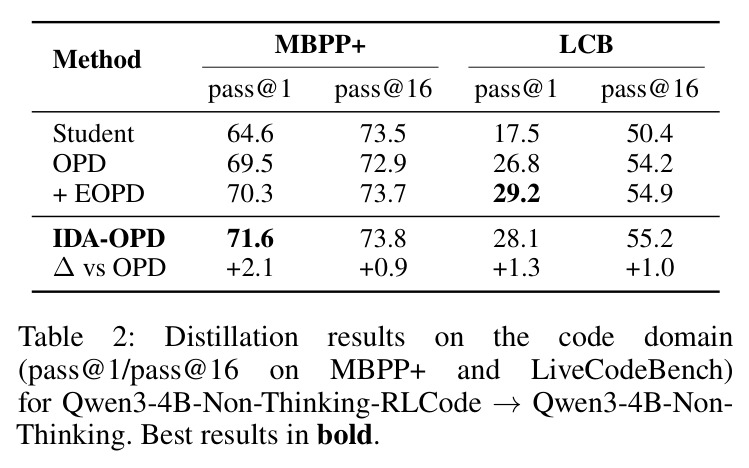
在线蒸馏(OPD)已成为 GLM-5、KiMi、Qwen3 等大规模系统后训练的关键组件,但标准形式要在学生访问的每个前缀上计算教师对整个词表的分布,以精确优化反向 KL $\mathbb{E}_{h\sim p_\theta}[D_{KL}(p_\theta\|q)]$,开销难以承受。采样 token OPD 只查询教师在被采样 token 上的对数概率,效率极高,却频繁遭遇「多样性蒸馏失败」:pass@1 提升而 pass@k 停滞。数据很具体:4B 设置下 OPD 在 AIME 2024 的 pass@16 停在 78.7%(教师 80.0%),AIME 2025 上 65.7%(教师 73.3%);代码域同理,OPD 在 MBPP+ 上 pass@16 72.9% 甚至低于学生自身的 73.5%。已有补救各有代价:教师知情方法(EOPD、AOPD)在高不确定性 token 处重新引入 top-K/全词表前向 KL,牺牲了采样 token OPD 的计算优势;学生侧方法(熵奖励、优势塑形、REOPOLD)全局抬熵,无法定位具体哪些更新在抽干多样性,性能差距始终未解决。
本文的目标是本文的目标非常克制而明确:在不使用任何全词表教师信息、只依赖教师对采样 token 的对数概率的前提下,保护学生的生成多样性。具体拆成两问:其一,能否找到一个廉价的逐 token 信号,预测「这一次参数更新会让学生局部熵上升还是下降」;其二,能否据此做选择性干预——原样保留抬熵的更新,只对压熵的更新按其「仍值得修正的程度」自适应缩放优势,从而在不丢教师关键修正信号的前提下阻断熵收缩。最终期望蒸馏学生的 pass@k 追平甚至超过教师(如 4B AIME 2024 上 83.3% 对教师的 80.0%),同时保持与原版 OPD 相当的 pass@1,且信息成本严格低于教师知情方法。
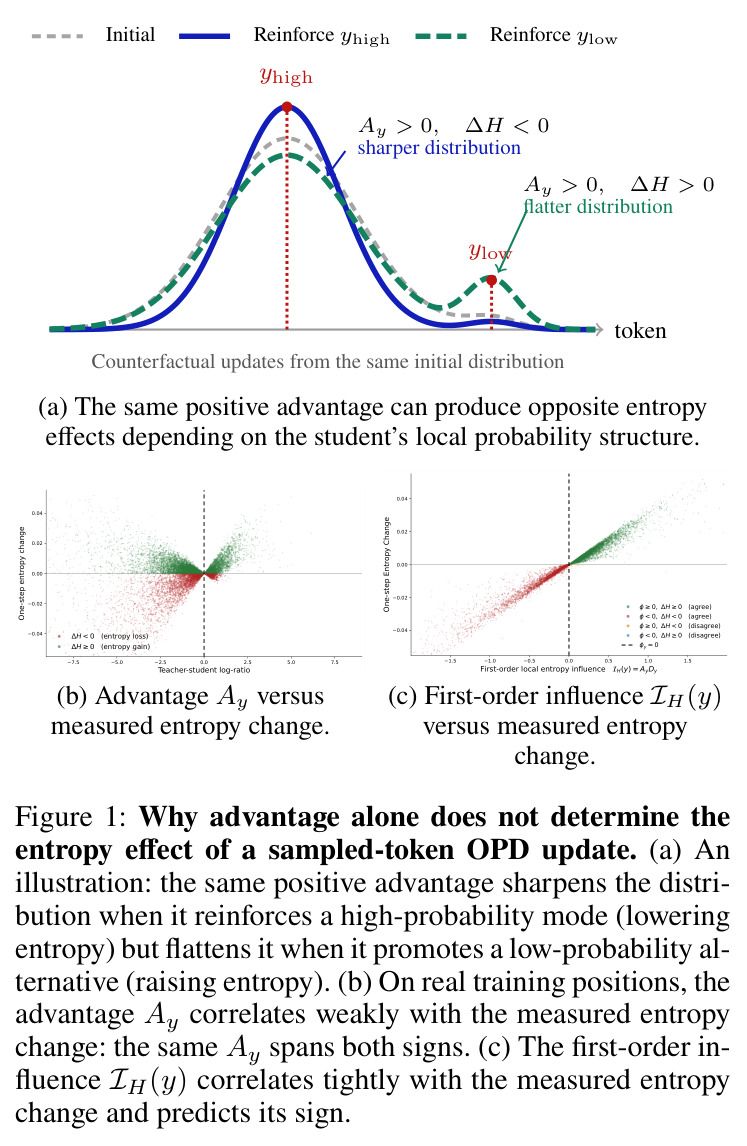
与已有工作不同的是,本文的独特切入是先做一个概念澄清再做归因。概念上,作者证明优势 $A_y$ 单独不能决定更新的熵效应:实测训练位置上,相同的 $A_y$ 可以产生符号相反、幅度悬殊的熵变化(图1b 呈双侧扇形)——强化已高概率的 token 使分布更尖(降熵),强化低概率 token 使分布更平(升熵)。于是通过一阶展开把熵变化解耦为 $A_y$ 与只依赖学生当前分布的因子 $D_y$ 的乘积 $I_H(y)$,其符号与实测熵变化高度一致。归因上,此前工作普遍假设最有害的熵损失来自师生分歧大的 token,但作者按归一化分歧 $\delta_y=(q_y-p_y)/(q_y+p_y)$ 分桶统计真实训练中的累积熵损失,发现收缩峰值出现在 $\delta_y\approx 0$ 的低分歧区:单个影响趋近于零、但数量极其庞大的高度对齐 token,聚合后才是熵坍缩的主因——这是一个此前被完全忽视的机制。
核心方法
直觉:同样正优势的更新,效果取决于学生局部概率结构——强化已高概率的 token 使分布更尖(降熵),强化低概率 token 使分布更平(升熵),熵效应须解耦两者。定理 1 在对数空间、步长 $\eta$ 的局部梯度步假设下推出 $\Delta H=\eta\cdot I_H(y)+O(\eta^2)$,其中一阶局部熵影响 $I_H(y)=A_yD_y$:$A_y=\log q_y-\log p_y$ 是师生对数概率差,$D_y$ 是仅由学生当前分布 $p=(p_i)_{i\in V}$ 与 $p_y$ 决定的熵方向因子(式 1)。IDA-OPD 据此干预:$I_H(y)\ge 0$ 的熵扩张更新原样保留;$I_H(y)<0$ 的熵收缩更新用分歧自适应权重 $w_y=|q_y-p_y|/(q_y+p_y)\in[0,1)$ 缩放优势,损失 $\ell_y=-\text{sg}(\tilde A_y)\log p_\theta(y|h)$,sg 为停止梯度。$w_y$ 在师生一致时趋近 0、分歧增大时趋近 1,天然实现「低价值处强衰减、关键修正处无损」。
核心创新分三层。诊断层:$I_H(y)$ 是首个免教师的熵方向信号,把更新的局部熵一阶效应解耦为教师学生差 $A_y$ 与学生侧因子 $D_y$ 之积;图1c 显示它对实测一步熵变化的预测远比 $A_y$ 准确——相同 $A_y$ 可产生反号熵变,而 $I_H$ 与实测符号、幅度都吻合。归因层:作者用真实优化器步统计累积熵损失随归一化分歧 $\delta_y$ 的分布(图2),发现收缩峰值在 $\delta_y\approx 0$——单个影响趋零、数量庞大的高度对齐 token 聚合后才是熵坍缩主因,推翻了「分歧大的 token 才是多样性杀手」的直觉。干预层:不用硬屏蔽(把所有 $I_H<0$ 更新置零会把 4B AIME24 pass@1 从 56.7 砸到 52.1,丢掉熵代价小但知识价值大的修正),而是用 $w_yA_y$ 软收缩;命题 1 证明 $A_y\to 0$ 时 $w_yA_y=O(A_y^2)$(近二次衰减)、$|A_y|\to\infty$ 时 $w_yA_y\to A_y$(无损保留),且保号、永不翻转教师修正方向。三者合成「用符号选位置、用分歧定强度」的方案。
方法步骤详情
共六步。第一步学生 rollout:采样前缀 $h$ 并从 $p_\theta(\cdot|h)$ 采样 token $y$,同原版。第二步算优势:只查询教师对 $y$ 的对数概率,得 $A_y=\log q_y-\log p_y$,不碰全词表教师分布。第三步算影响信号:复用前向已物化的学生 logits 计算仅依赖学生分布的熵方向因子 $D_y$,相乘得 $I_H(y)=A_yD_y$,其符号判定更新压熵还是扩熵。第四步算分歧权重:$w_y=|q_y-p_y|/(q_y+p_y)$,只需两个标量。第五步合成有效优势:$I_H(y)\ge 0$ 时 $\tilde A_y=A_y$,否则 $\tilde A_y=w_yA_y$:高分歧修正无损、低分歧压熵更新近二次衰减。第六步以 $\ell_y=-\text{sg}(\tilde A_y)\log p_\theta(y|h)$ 反向传播,停止梯度保证单样本估计无偏。每位置只传一个标量($O(L)$),$D_y$ 复用学生 logits,而 EOPD/AOPD 需 $O(L_{sel}K)$ 的 top-K 教师分布。
技术新颖性
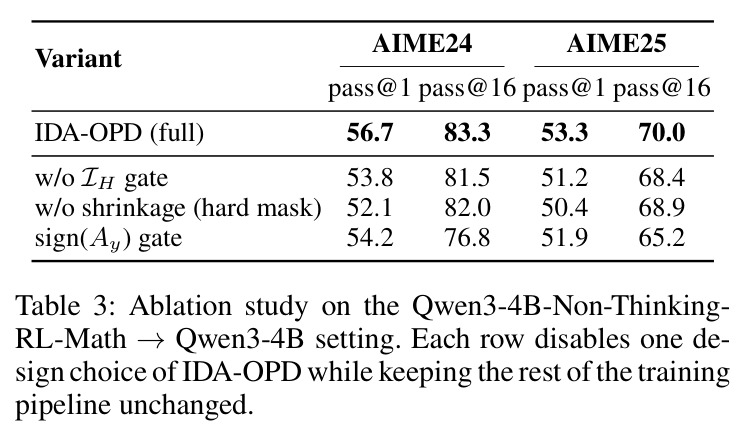
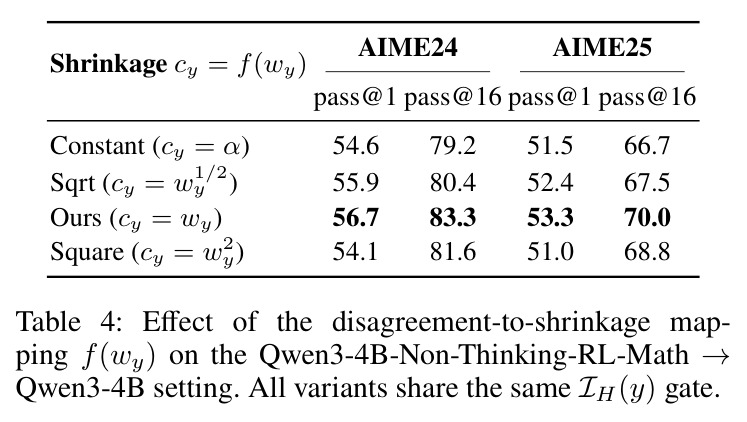
与最近邻工作的本质区别在「定位标准」与「干预强度」。定位上,TIP(token importance)、Token Teachability、Filter-Then-Reweight 以及 EOPD(高不确定性 token 加前向 KL 惩罚)、AOPD(在分歧区域解耦探索与模仿)都以师生分歧或不确定性大小挑选关键位置;IDA-OPD 改用带符号的 $I_H(y)$ 直接定位正在抽干多样性的位置,并实证发现这些位置集中在低分歧区——恰恰是分歧标准会漏掉的地方。干预上,熵奖励、优势塑形等学生侧方法全局抬熵、无法区分位置;IDA-OPD 只对 $I_H<0$ 的更新做分歧自适应软收缩。成本上,EOPD 和 AOPD 需要在选定位置重新引入完整或截断 top-K 教师分布,IDA-OPD 全程零额外教师查询,在同等采样 token 预算下于四个数学基准取得全局最高 pass@16。消融证明两个组件缺一不可且不可互替:换 $\text{sign}(A_y)$ 门控 pass@16 最差(76.8/65.2),因为优势符号不决定熵变符号。
实验结果
数学主实验(表1):4B 的 OPD pass@1 升至 54.6 但 pass@16 仅 78.7,落后教师 80.0(AIME24);IDA-OPD 四基准 pass@16 全部最高——AIME24 83.3(+4.6,超教师)、AIME25 70.0(+4.3)、HMMT Feb 60.0(+8.3)、HMMT Nov 60.1(+1.8),AIME25 pass@1 也升至 53.3(OPD 51.8)。8B 的 pass@16 再升 +4.2/+6.0/+7.2/+2.5,AIME25 76.7 超教师 73.3,并压过 AOPD/EOPD(AIME24 83.3 对 81.0/80.8)。代码域(表2):MBPP+ 71.6/73.8、LCB 28.1/55.2,均优于 OPD(69.5/72.9、26.8/54.2)。pass@k(图3)k≥8 后拉开 +4–5 点至 k=64。消融(表3):无门控 53.8/81.5、硬屏蔽 52.1/82.0、sign 门控 54.2/76.8,均劣于完整版 56.7/83.3;表4 显示线性收缩最优、Constant 最差。图4a 证实 $I_H$ 符号选择可控全局熵轨迹(IDA-OPD 高于 OPD);图4b 中 OPD 把约 74% token 堆进 0.0–0.1 低熵桶(教师 57%),IDA-OPD 约 55%。
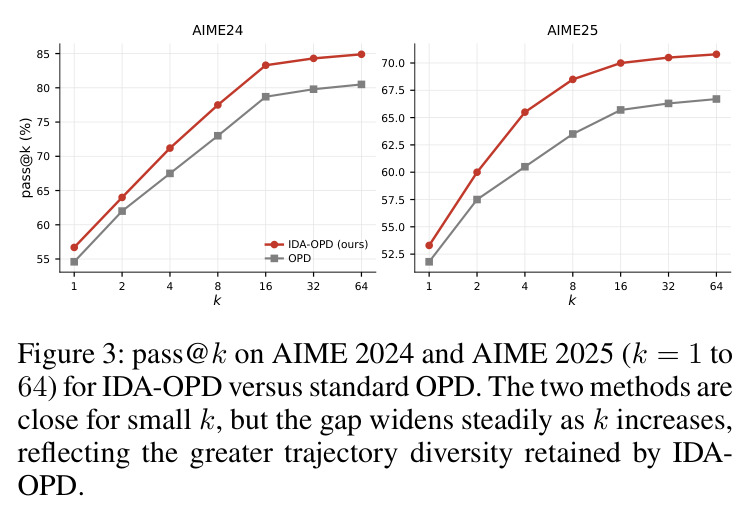
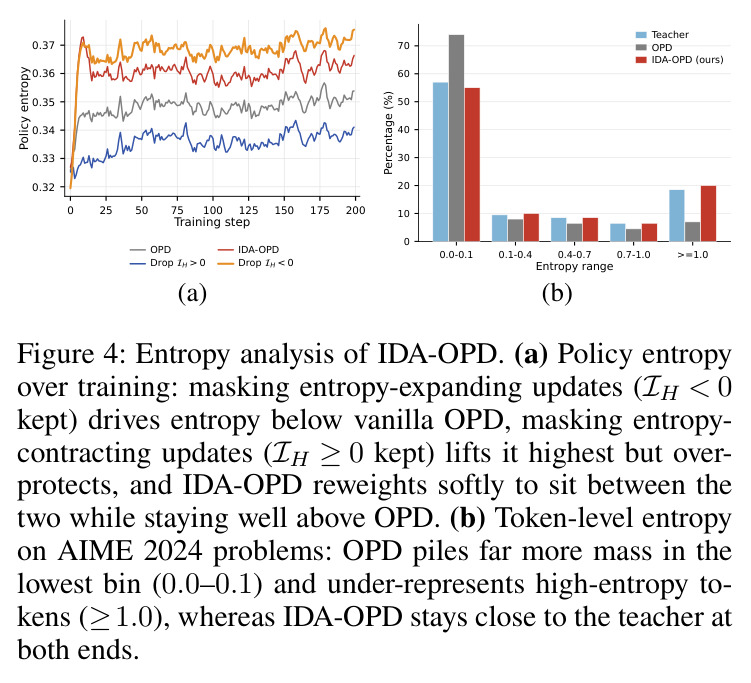
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2024(4B 数学蒸馏) | pass@16 | 83.3% | OPD 78.7% | +4.6,且超过教师的 80.0% |
| AIME 2025(4B 数学蒸馏) | pass@16 | 70.0% | OPD 65.7% | +4.3 |
| HMMT 2025 Feb(4B 数学蒸馏) | pass@16 | 60.0% | OPD 51.7% | +8.3 |
| HMMT 2025 Nov(4B 数学蒸馏) | pass@16 | 60.1% | OPD 58.3% | +1.8 |
| AIME 2024(8B 数学蒸馏) | pass@16 | 83.3% | OPD 79.1% | +4.2;教师为 83.3%,达到教师水平 |
| AIME 2025(8B 数学蒸馏) | pass@16 | 76.7% | OPD 70.7% | +6.0,且超过教师的 73.3% |
| HMMT 2025 Feb(8B 数学蒸馏) | pass@16 | 56.7% | OPD 49.5% | +7.2 |
| AIME 2024(4B 数学蒸馏) | pass@1 | 56.7% | OPD 54.6% | +2.1(多样性修复未牺牲准确率) |
| AIME 2024(8B 数学蒸馏,对比最强教师知情基线) | pass@16 | 83.3% | AOPD 81.0% / EOPD 80.8% | +2.3/+2.5,且无 top-K 教师分布成本 |
| MBPP+(4B 代码蒸馏) | pass@1 | 71.6% | OPD 69.5% | +2.1 |
| LiveCodeBench(4B 代码蒸馏) | pass@16 | 55.2% | OPD 54.2% | +1.0(OPD 的 pass@16 甚至低于学生的 50.4 修复趋势) |
局限与改进
作者承认的局限:定理 1 基于对数空间、单步梯度更新的理想化假设,真实训练是参数空间多步共享权重的 AdamW 优化,一阶代理只能靠经验验证——图4a 的全局熵轨迹对比(屏蔽升熵更新低于 OPD、屏蔽降熵更新最高、IDA-OPD 居中)正是为弥合这一间隙而做;诊断是一阶近似,$O(\eta^2)$ 项在分布极尖或步长大时不可忽略。我的观察:评测仅覆盖 Qwen3 系非思考模型、数学与代码两域、4B/8B 两规模,未测 thinking 长推理、多轮 agent 或更大模型;$w_y$ 用单样本师生概率估计真实分歧,低分歧区 $|q_y-p_y|$ 本身很小,估计噪声相对大,符号门控有随机误判风险;硬屏蔽把 pass@1 砸到 52.1 说明低分歧更新并非全无知识价值,线性映射只是四种手工形状中的最优,未搜索可学习参数化;论文未报告与 EOPD/AOPD 的训练墙钟时间实测(只有复杂度分析),也无超参敏感性分析;与跨 tokenizer、step-wise agent 等变体的兼容性未验证。
独立分析的弱点
独立来看有五个可攻击点。其一,单样本噪声:$A_y$ 与 $w_y$ 都来自单次采样,低分歧区 $|q_y-p_y|$ 接近噪声水平,$I_H$ 符号门控可能误判;可对低分歧 token 用 2–4 次采样或跨步 EMA 平滑 $p_y$、$q_y$ 的估计。其二,一阶近似有效域:学生分布接近 one-hot(正是要防止的情形)时 softmax Jacobian 线性化误差增大,可引入二阶修正项或按 $D_y$ 幅度自适应衰减干预强度。其三,$I_H$ 只保证方向不保证幅度,长期熵轨迹无理论控制,训练后期可结合熵目标带做闭环控制。其四,$w_y$ 与线性映射均为手工设计,表4 显示形状敏感(Square 使 pass@1 掉 2.6 点),可改为按域校准的小型可学习映射 $f_\phi(w_y)$。其五,图2 表明高分歧负尾($\delta_y\approx-1$)仍有次要熵损失簇,纯采样 token 信号对此无能为力;可设计混合策略,仅在检测到负尾熵流失时局部启用 top-K 教师信号。此外只在非思考短推理上验证,长思维链下熵动态是否同样由低分歧 token 主导需重新检验。
未来方向
作者暗示的方向:把影响导向选择推广到其他 OPD 变体——跨 tokenizer 蒸馏(SimCT)、多轮 agent、step-wise 蒸馏(SOD),这些场景同样依赖采样 token 估计、面临相同的熵收缩风险;并进一步在真实训练动态下刻画 $I_H$ 与全局熵轨迹的关系,把图4a 的经验证据升级为理论保证。基于本文成果可自然延伸:(1) 把 $I_H(y)$ 移植到 RL 阶段本身(GRPO/DAPO 的优势塑形),在奖励驱动训练中同样做「保探索、压无效锐化」的选择性干预,与 high-entropy forking token 研究互补;(2) 设计带熵预算的闭环控制器,让蒸馏全程把学生熵轨迹钉在教师附近而非事后修复;(3) 将 $\delta_y$ 权重扩展到序列级影响估计,识别整段高影响推理路径;(4) 研究蒸馏学生的熵结构对 best-of-n、树搜索等测试时扩展收益的影响,把 pass@k 增益转化为推理系统的采样效率提升;(5) 在教师能力远超学生的自蒸馏设定下检验 $w_y$ 度量是否需要重新标定。
复现评估
正文未提及开源代码(BiliBili 等机构作者),但无任何私有依赖。方法是在采样 token OPD 上加几行标量计算的轻量改动——$I_H$ 门控只需学生 logits 与师生两个对数概率,$w_y$ 只需两个概率——任何现成 GRPO/OPD 框架上一天内可实现。训练数据公开:数学用 DeepMath103K 难度 6 子集,代码用 Yang et al. (2026) 代码子集;教师是 GRPO 训练的 Qwen3-4B/8B-Non-Thinking(RL-Math/RLCode),需自训或找到 checkpoint。评测协议透明:AIME 2024/2025、HMMT 2025 Feb/Nov、MBPP+、LiveCodeBench,每题 $n=128$ 采样、温度 1.0、top-p 1.0,用 Chen et al. (2021) 无偏估计器算 pass@k;EOPD/AOPD 用官方实现。门槛主要是算力:4B/8B 的 RL 蒸馏加 128 样本评测需多卡 A100/H100 集群,个人难复现主表;但核心机制(图1 散点、图2 分桶统计)用小模型即可低成本验证。
论文图表
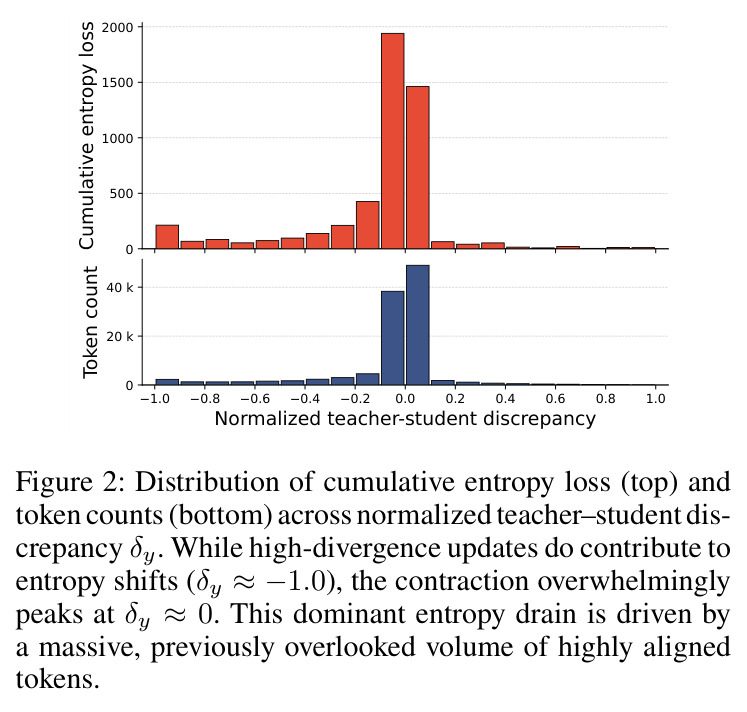
按归一化师生分歧 $\delta_y=(q_y-p_y)/(q_y+p_y)\in[-1,1]$ 分桶,统计真实优化器步下的累积熵损失(上)与 token 数量(下)。高分歧负尾($\delta_y\approx-1$)确实存在一个次要熵损失簇,但收缩的绝对峰值出现在低分歧区 $\delta_y\approx 0$;下方直方图显示该区域聚集了海量高度对齐的 token。
这张图完成关键归因:多样性失败的主因不是此前 assumed 的高分歧 token,而是无数个「单个影响趋零、聚合后主导」的低分歧压熵更新。它直接决定了干预必须对低分歧区强衰减、对高分歧区无损,即 $w_y$ 的设计依据。