段落边界并非空白:压缩深度作为层级结构的标志 Paragraph Boundaries Are Not White Space:Compression Depth as the Signature of Hierarchical Structure
固定词元只改段落坐标即可因果压缩注意力,而真实层级结构的签名是更深、随语料变化的压缩
前置知识
RoPE(旋转位置编码)
RoPE 把标量位置 $m$ 编码为对注意力中查询/键通道对的旋转:第 $k$ 对通道旋转角度 $m\theta_k$,$\theta_k=\text{base}^{-2(k-1)/d}$。由于注意力分数只依赖旋转角之差,它天然只编码相对位移 $m-n$,是最主流的位置编码方案。
本文的 hRoPE 就是把 RoPE 从单轴推广为段落/句子/词元三个独立的旋转通道组,各轴频率基准还要按语料分布单独标定,不理解标准 RoPE 的旋转机制就无法理解 hRoPE 的构造。
注意力的距离衰减与残差化
自注意力本身置换不变,顺序信息只能靠位置编码注入。在 RoPE 类模型中,对层和头取平均后的注意力 $\bar{A}(i,j)$ 随词元距离 $d(i,j)$ 呈指数衰减,取对数后 $\log\bar{A}(i,j)=\hat\beta_0+\hat\beta_1 d(i,j)+\epsilon$ 近似线性,减去拟合趋势即得残差 $D_{\text{eff}}(i,j)$。
全文所有测量都建立在『先扣除词元距离的主导趋势、再看残差 $D_{\text{eff}}$』之上;不懂距离衰减就无法理解为什么要做残差化,以及分箱合并为何会引入伪影。
反事实干预(fake-$p_1$ 介入)
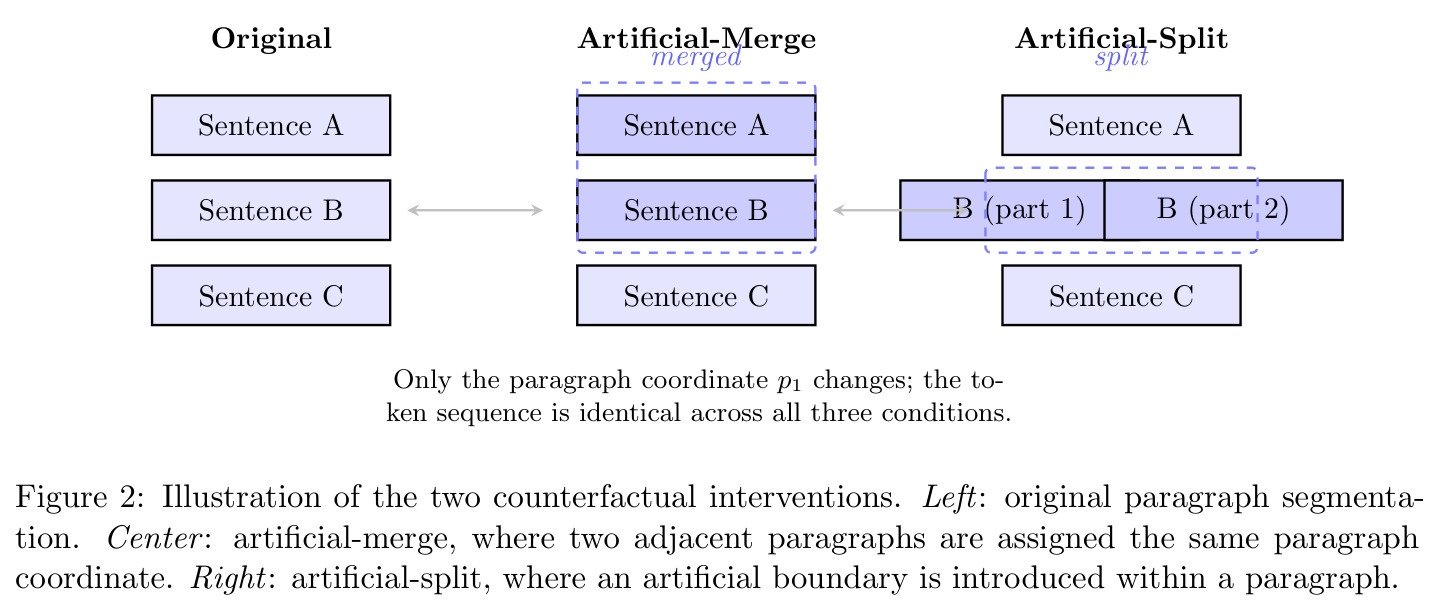
源自因果中介分析与激活修补的思想:固定其余一切(这里是整个词元序列与阅读顺序),只替换一个变量,观察结果的因果变化。本文的 fake-merge 给两个真段落赋同一 $p_1$,fake-split 在段内插入假边界,从而把『段落坐标本身』与『词元内容』彻底解耦。
这是全文的因果识别策略:注意力变化只能归因于 $p_1$ 的改变而非词汇内容,Layer I 的全部结论(阅读顺序不是层级位置的充分坐标)都由它支撑。
文档级聚类 Bootstrap
同一文档内的段落对不独立,逐点重采样会低估方差。聚类 Bootstrap 以文档为单元有放回重采样($B=4000$ 次),每次重采样内同时重算被比较的两个量(如 hrope 与 rand axial 的深度),再对配对差取 95% 区间,保留文档内相关结构。
论文几乎每个数字都带这种置信区间,且跨模型比较用『同一批重采样索引』的配对版本;不理解它就无法判断哪些差异显著、哪些(如 OpenWebText 的深度差)只是功效不足。
Jensen–Shannon 散度
两个分布 $q_1,q_2$ 的 JS 散度 $\text{JS}(q_1\|q_2)=\tfrac12\text{KL}(q_1\|m)+\tfrac12\text{KL}(q_2\|m)$($m$ 为混合分布),有界于 $\log 2$、对称且总能计算。本文把它归一化为段间词面分布相似度 $S(p,p+\delta)=1-\text{JS}/\log 2$,扣除段序打乱对照后拟合词汇持续性长度 $\lambda_{\text{struct}}$。
Layer III 的核心语料侧候选量 $\lambda_{\text{struct}}$ 完全由 JS 散度曲线导出,是检验『不用任何模型能否预测压缩深度』的基础。
研究动机
标准位置编码(RoPE、ALiBi 等)把位置表示成一维阅读顺序坐标:两个词元的关系由 $i$、$j$ 或差值 $i-j$ 决定。但文本是嵌套的——文档⊃段落⊃句子⊃词元,阅读顺序间隔相同的两个词元可能同句、同段异句、也可能跨段。作者给出组合论证:$n$ 个词元的序列共有 $2^{n-1}$ 种段落划分方式,一维阅读顺序对应指数多个层级结构,因此它不是层级位置的充分统计量。用引言的例子:对『This is what I love. You are the reason.』只改『You』的段落标签、不动任何词元,就能测到跨边界注意力的下降。由此引出本文的核心疑问:段界附近的注意力压缩,究竟是层级位置的因果效应,还是仅仅信息密度造成的?人 reading 直觉中『段界改变局部语境』这一点,是否以可测的几何形式存在于 Transformer 内部?
本文的目标是本文目标分三层。第一(Layer I):构造带显式层级坐标的 hRoPE,把段落/句子/词元索引放进互相独立、可单独操纵的旋转通道组,使『固定词元、只改段落坐标 $p_1$』的反事实介入成为可能,从而直接检验阅读顺序是否足以表示层级位置。第二(Layer II):在真实段落结构与密度匹配的随机对照之间,刻画段界附近注意力压缩的形状与深度,找出真正能区分二者的可复现签名——是压缩的存在、位置还是深度。第三(Layer III):检验纯语料统计量(完全不使用模型表示或注意力值)能否复现压缩深度的跨语料排序,即模型学到的『注意力几何』是否可由文本表面统计还原。
与已有工作不同的是,已有工作的切入点都不是因果检验:HIBERT、PermGen、HDT 等层级架构用高层结构提升生成或效率,从不问坐标本身是否因果地改变注意力;Wang et al. (2019) 把依存树位置编入注意力、LieRE 把 RoPE 推广为学习旋转,但都服务于任务指标;Cirrincione (2026) 做位置编码的几何理论、Di Sipio et al. (2025) 用广义相对论类比研究表示演化,都不做直接介入。本文的独特之处是把层级坐标当作实验变量:不比较困惑度、不追求性能,而是像做物理实验一样固定词元、单独摆弄 $p_1$,先证伪『阅读顺序是充分坐标』,再追问响应的形状是否被语料统计预判——这条『介入式测量』路线在层级表示文献里是缺失的。
核心方法
直觉:若模型真的『感受』段落边界,人为造假边界(段内分裂)应使注意力在假边界处抬升,人为抹掉真边界(两段合并)应使注意力塌向段内水平。技术上分三层。Layer I:训练 hRoPE 模型 $R_{\text{hier}}=R_1(p_1)\oplus R_2(p_2)\oplus R_3(p_3)$,每轴是独立对易的旋转通道组,可单独操纵;注意力先对层、头平均,再对对数注意力拟合线性距离趋势 $\log\bar{A}(i,j)=\hat\beta_0+\hat\beta_1 d(i,j)+\epsilon$,残差 $D_{\text{eff}}$ 即超出阅读顺序能解释的部分;以段内与真边界两个锚点归一化得 $\beta$,干预效应 $\Delta=\beta_{\text{observed}}-\beta_{\text{unmanipulated}}$。Layer II:用『精确距离』估计器把 $D_{\text{eff}}$ 对段落位移 $\Delta p_1$ 作同距离受控对比,得响应曲线 $U(\Delta p_1)$ 与顶点深度 $U^*$,并与随机对照配对比较。Layer III:与 $\lambda_{\text{struct}}$、段落长度、嵌入连贯性等纯语料量比较跨语料排序。
核心创新有二。其一,『坐标即变量』的实验设计:与 PermGen/HDT 等把层级坐标用于提升性能不同,本文的 hRoPE 是测量仪器——词元序列完全固定、只有 $p_1$ 变化,注意力仍系统性改变,直接证明阅读顺序不是层级位置的充分坐标。其二,『压缩深度而非压缩位置才是真结构的签名』:作者发现一个携带密度匹配随机标签的同构 $p_1$ 通道(rand axial)同样产生压缩,故压缩本身不能作为层级结构的证据;能区分真假结构的是压缩深度——真结构更深、且随语料可变,而随机对照的深度既浅又不随语料变化。配套的方法论创新是『精确距离估计器』:旧的距离分箱法因箱内距离失配产生了足以翻转 WikiText-2 符号的伪影(逐个 $d\in\{1,\dots,256\}$ 都压缩、合并后却『膨胀』$U\approx+0.11$),新估计器只在同一 $d$ 内对比、每格要求 $n\ge 2000$ 对,彻底消除伪影。
方法步骤详情
第一步,语料与坐标:WikiText-2(空行分段、正则分句)、OpenWebText(newspaper 抽取+FastText 过滤+LSH 去重)、Python 代码(file→block→line→token,块数按 95 分位 131 截断),统一 GPT-2 BPE。第二步,构造 hRoPE:每轴独立旋转通道组,频率基准按语料分布标定 $\text{base}_g=\left(\frac{S\cdot M_g}{2\pi}\right)^{D_g/(D_g-1)}$($S>1$),无学习参数。第三步,训练五个变体——flat、sent axial(仅 $p_2,p_3$)、hrope axial、rand axial($p_1$ 为每步重采样的密度匹配随机标签)、period axial($p_1:=\lfloor t/L\rfloor$,$L=132/102/64$)——统一 8 层、$d_{\text{model}}=512$、上下文 1024、5000 步、lr $3\times10^{-4}$,每语料 3 种子。第四步,fake-merge/fake-split 介入,计算 $\beta$、$\Delta$、$\beta_C$,配对文档聚类 Bootstrap($B=4000$)。第五步,压缩深度:对每个 $d\le 1024$ 以同 $d$ 的 $\Delta p_1=0$ 为基线求对比,保留 $n\ge 2000$ 的格,按对数加权合并,二次拟合取顶点 $U^*$。第六步,与 rand axial 配对比较深度。第七步,由 $S_{\text{exc}}(\delta)=S_{\text{real}}(\delta)-S_{\text{shuffle}}(\delta)$ 拟合 $\lambda_{\text{struct}}$,加段落长度与嵌入连贯性共 3 构造 8 量。第八步,hub 掩蔽探针与逐层逻辑回归探针。
技术新颖性
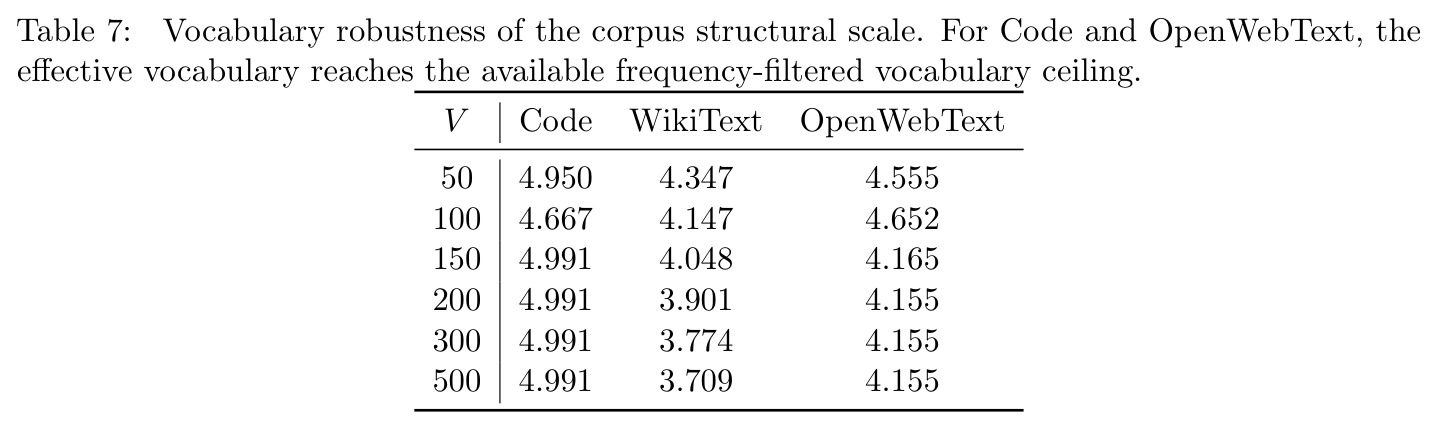
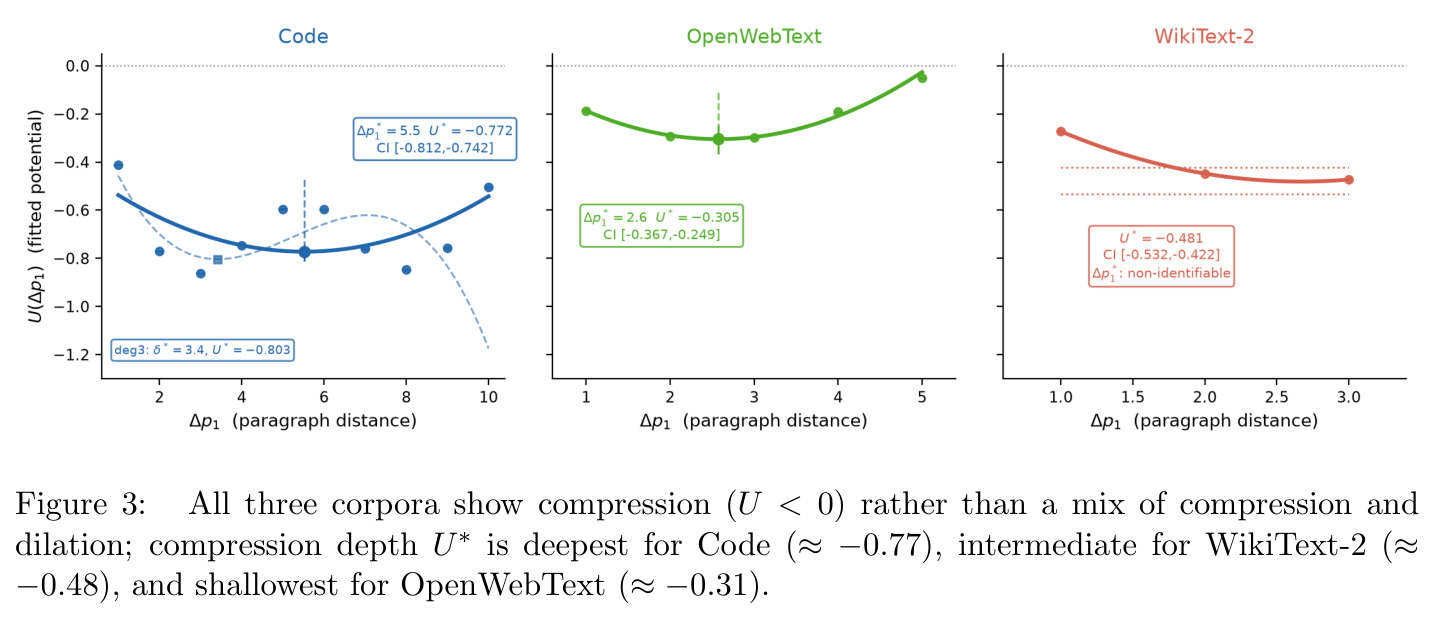
新颖性有四。第一,因果识别的干净度:以往层级表示工作以困惑度或下游指标评判,无法排除『多一个自由度就会这样』;本文用 rand axial(同构但无真实信息)与 period axial(近确定性的词元距离函数)双重对照,把『通道存在』与『通道内容』分离,再用 const0 替换证明模型对内容而非占位敏感——const0 比 real 差 0.30–0.34 nats,远贵于任何保留坐标的替换。第二,估计器的严谨:距离分箱伪影的发现与修正本身即贡献——当 $D_{\text{eff}}$ 对 $d$ 高度敏感($\hat\beta_1\approx-0.034$ 每单位距离)时,粗粒度控制足以翻转符号,精确距离协议以 $n\ge 2000$ 门槛消除伪影。第三,命题 5.1 证明任何『单调衰减吸引项+单调不减抑制项』的加性模型 $U(\Delta p_1)=-ae^{-\alpha\Delta p_1}+c(\Delta p_1)$ 严格递增、无内部极小值,排除一整类平凡解释。第四,把主测量量从位置换成深度:$\Delta p_1^*$ 在 WikiText-2 不可辨识、在 Code 对拟合阶数敏感(5.5 vs 3.4),而 $U^*$ 跨门槛稳定(约 0.1)。
实验结果
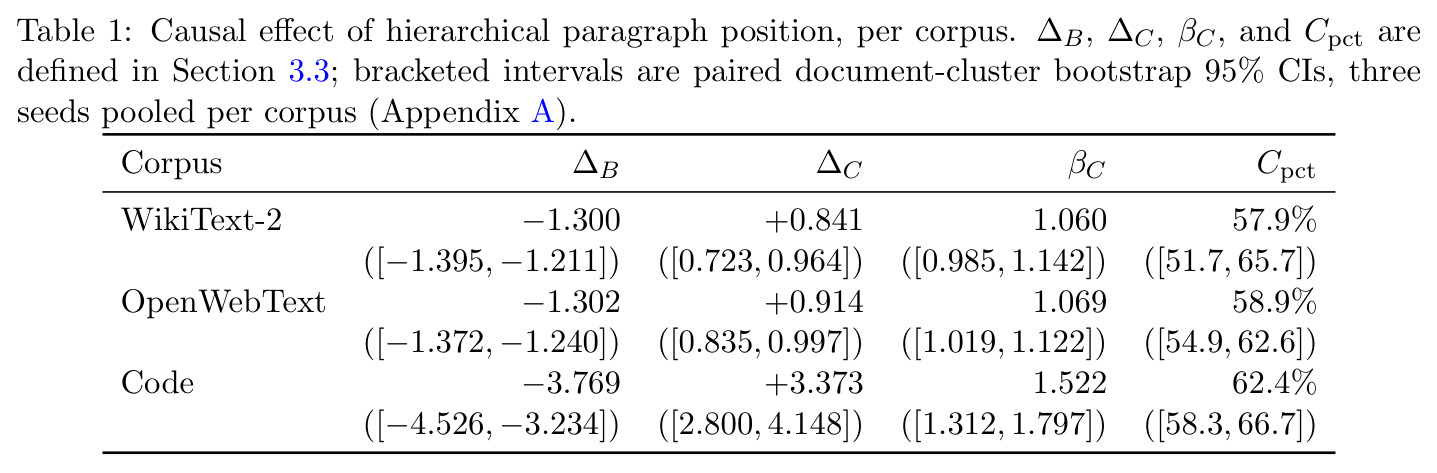
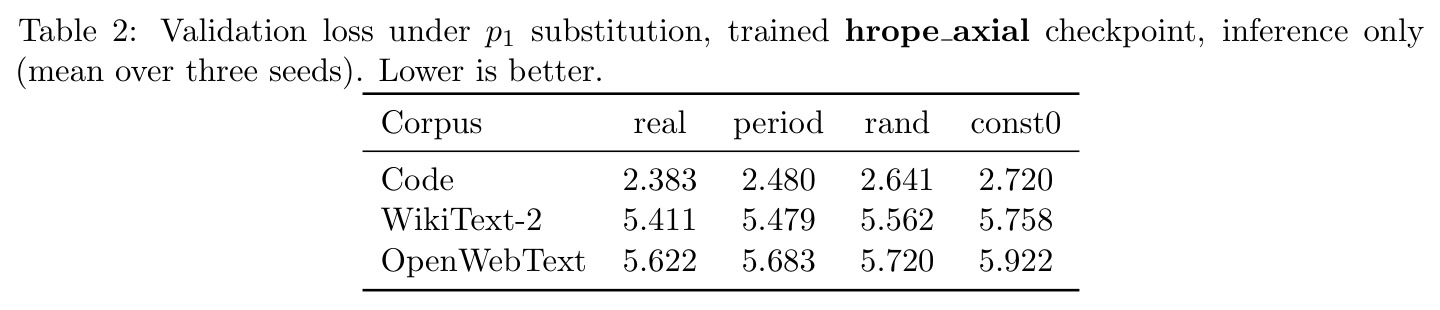
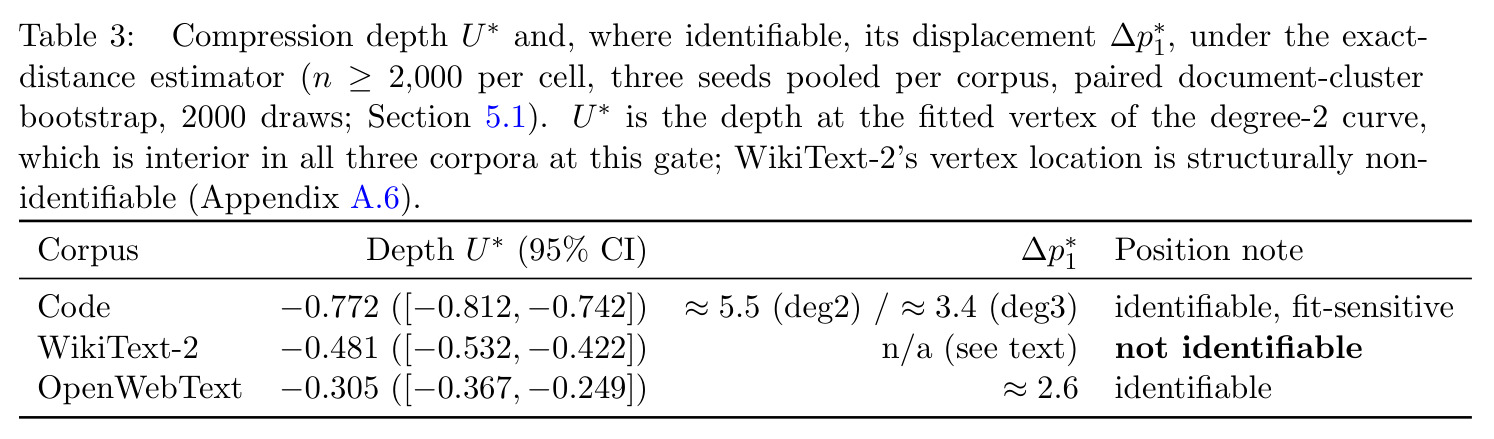
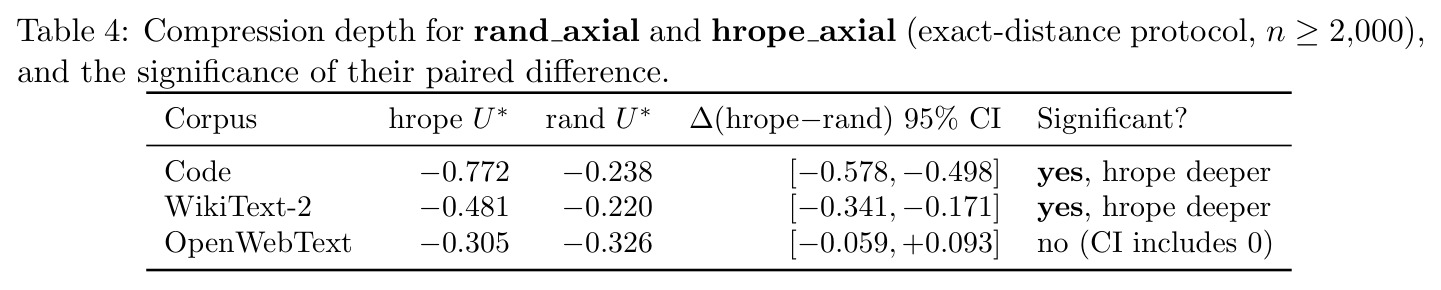
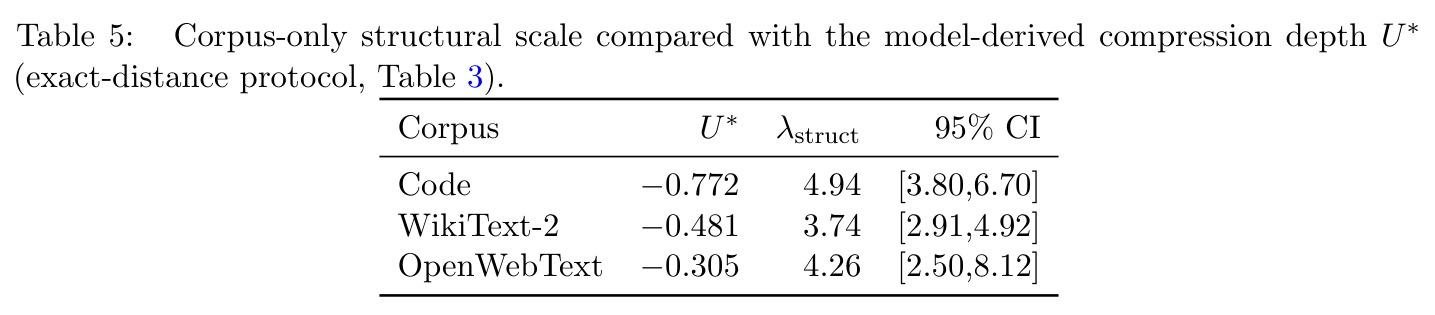
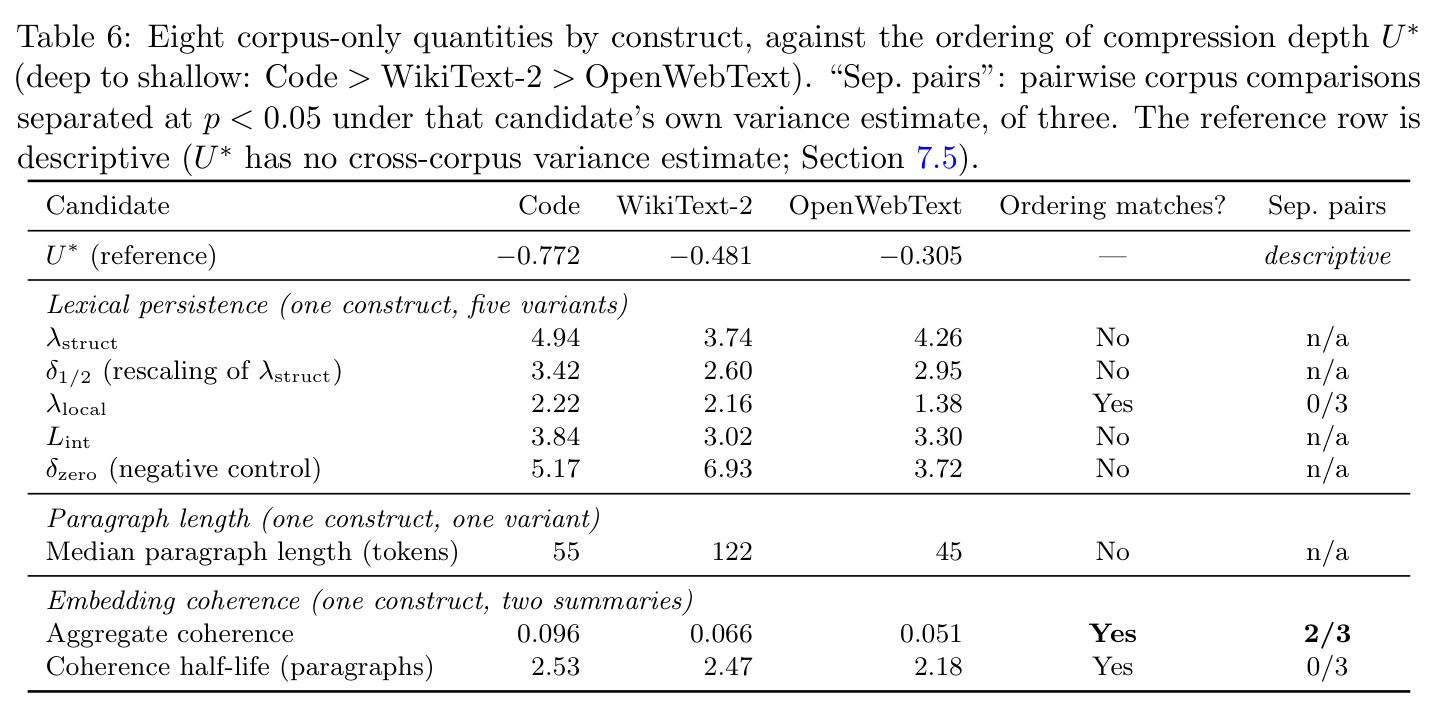
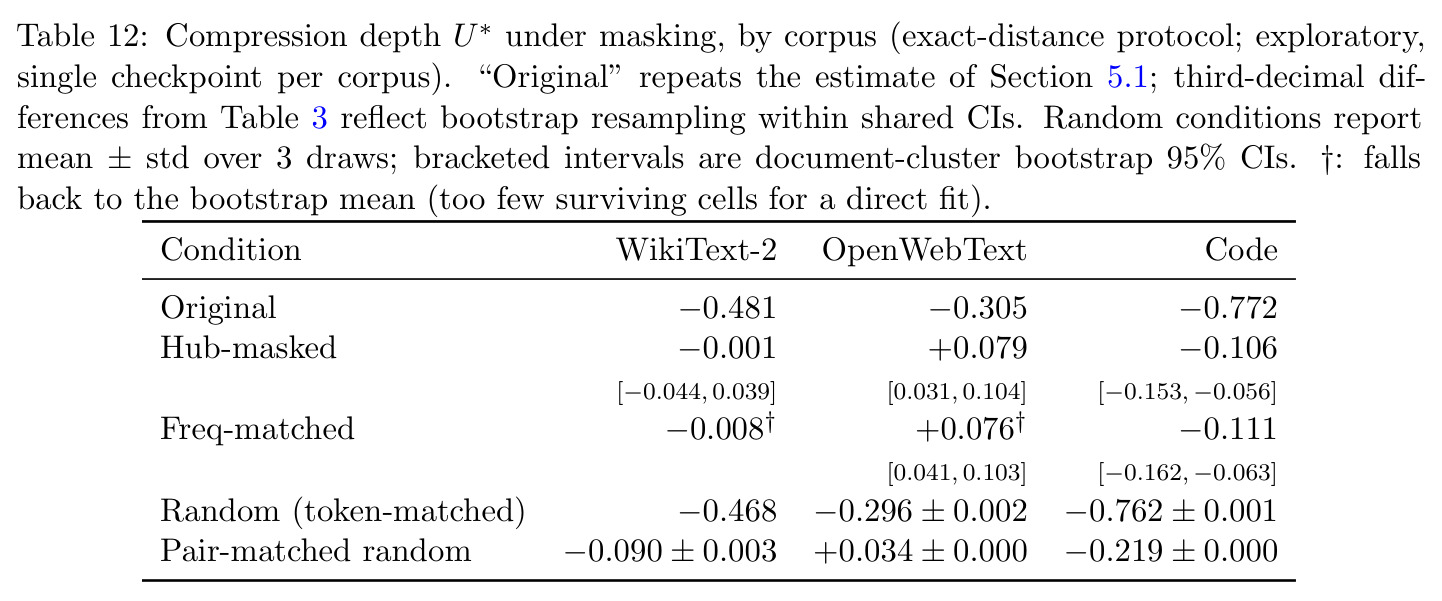
Layer I(表 1):无 $p_1$ 通道的 flat 与 sent axial 中 $\Delta B=\Delta C\approx 0$;hrope axial 中合并压缩、分裂膨胀:WikiText-2 $\Delta B=-1.300$、$\Delta C=+0.841$;OpenWebText $-1.302$/$+0.914$;Code $-3.769$/$+3.373$(均附显著 Bootstrap 区间);假边界归一化响应 $\beta_C$ 达 1.06–1.52,与真边界同量级;单例中 fake-split 使 $D_{\text{eff}}$ 下降 $\Delta=-3.105$。替换实验(表 2)中损失排序 real < period < rand < const0 在全部种子成立。Layer II(表 3/4):三语料只压缩不膨胀,$U^*$ 为 Code $-0.772$ [−0.812,−0.742]、WikiText-2 $-0.481$ [−0.532,−0.422]、OpenWebText $-0.305$ [−0.367,−0.249];rand axial 也压缩($-0.238/-0.220/-0.326$),配对差在 Code 与 WikiText-2 显著,OpenWebText 含零不可分辨;拐点 $\Delta p_1^*\approx 2.6$–5.5,且由命题 5.1 排除加性叠加解释。Layer III(表 5/6):8 个语料侧统计量无一复现 $U^*$ 排序(Code > WikiText-2 > OpenWebText):$\lambda_{\text{struct}}$(4.94/3.74/4.26)只对 Code 正确;嵌入连贯性最接近(0.096/0.066/0.051 排序吻合、3 对分开 2 对)。掩蔽实验(表 12):随机同数词元几乎不动 $U^*$(Code $-0.762$ vs $-0.772$),同体积随机对使其大变($-0.219$),hub 增量约 15 个百分点跨语料一致;Code 掩蔽后仍剩 $-0.106$ 残余,OpenWebText 被推过零。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 因果介入(fake-merge / fake-split,Layer I) | $\Delta B$ 与 $\Delta C$(配对文档聚类 Bootstrap 95% CI,3 种子) | hrope axial:WikiText-2 $\Delta B=-1.300$、$\Delta C=+0.841$;OpenWebText $-1.302$ / $+0.914$;Code $-3.769$ / $+3.373$;$\beta_C=1.06$–$1.52$ | flat 与 sent axial(无 $p_1$ 通道):$\Delta B=\Delta C\approx 0$;rand axial 同构随机通道:响应明显更弱 | 证明段落坐标是注意力的因果因子,且效应只出现在携带真实层级信息的通道,排除『任意自由度都会如此』的解释 |
| 压缩深度比较(真实 vs 随机结构,Layer II) | $U^*$(精确距离估计,$n\ge 2000$,配对差 95% CI) | hrope axial:Code $-0.772$、WikiText-2 $-0.481$、OpenWebText $-0.305$ | rand axial:$-0.238$、$-0.220$、$-0.326$ | Code/WikiText-2 中真结构显著更深(CI [−0.578,−0.498] 与 [−0.341,−0.171]);OpenWebText 差异不可分辨(CI 含零) |
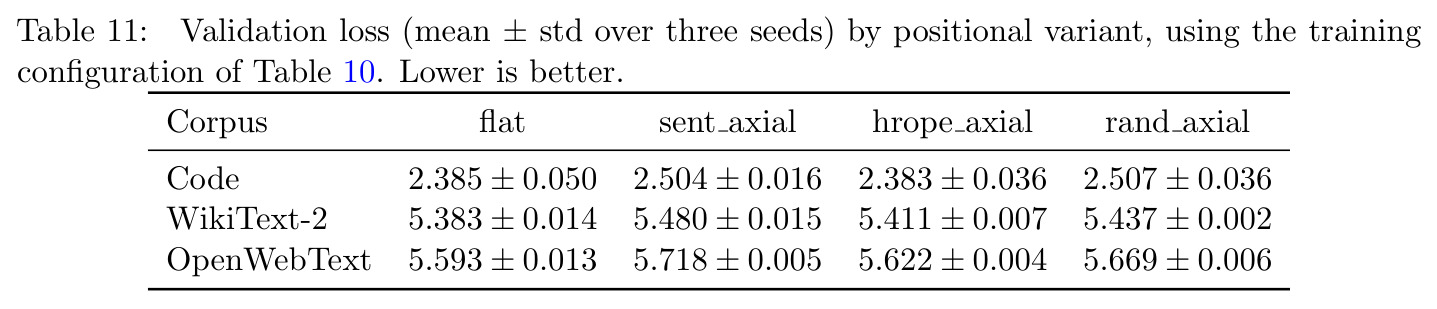
| $p_1$ 替换(推断期)验证损失 | nats,越低越好(3 种子均值) | real:Code 2.383 / WikiText-2 5.411 / OpenWebText 5.622 | period:2.480 / 5.479 / 5.683;rand:2.641 / 5.562 / 5.720;const0:2.720 / 5.758 / 5.922 | real < period < rand < const0 在每语料全部种子成立;const0 比 real 差 0.30–0.34 nats,说明模型区分坐标内容而非仅占位 |
| 语料侧统计量复现深度排序(Layer III) | 跨语料排序一致性(目标:Code > WikiText-2 > OpenWebText) | 聚合嵌入连贯性 0.096 / 0.066 / 0.051:排序吻合,3 对中分开 2 对(3 项构造中最接近者) | $\lambda_{\text{struct}}$(4.94/3.74/4.26)只对 Code 正确;段落中位长度 55/122/45 交换 Code 与 WikiText-2;词汇持续性 5 个变体全部失败 | 部分成功:没有任何语料-only 量完全复现排序,深度来源仍开放 |
| 语言建模代价(附录 C,seed 配对) | 验证损失(均值 ± 标准差,3 种子) | hrope axial:Code 2.383±0.036 / WikiText-2 5.411±0.007 / OpenWebText 5.622±0.004 | rand axial:2.507±0.036 / 5.437±0.002 / 5.669±0.006;flat:2.385±0.050 / 5.383±0.014 / 5.593±0.013 | hrope 在每个配对种子、每个语料都不贵于 rand;相对 flat 代价约 0.5%(WikiText-2/OpenWebText),Code 中与种子噪声不可分 |
局限与改进
作者明确承认:实验只用 8 层、$d_{\text{model}}=512$、5000 步的小模型,无下游任务指标,现象是否在生产规模存在未知;每格仅 3 种子,符号检验最小单侧 p 值 0.125,三种子结论只能是方向性证据;三个语料是选定而非抽样,跨语料排序只是描述性的;位置 $\Delta p_1^*$ 在 WikiText-2 结构性不可辨识(顶点随门槛 4.11→2.51 单调漂移)、在 Code 对拟合阶数敏感(5.5 vs 3.4);period 坐标在此协议下不可检验;命题 5.1 只排除加性叠加族,softmax 竞争等机制未检验。我补充的观察:OpenWebText 恰是自然文本中『深度签名失效』的案例——真结构与随机对照深度差不可分辨,实质性削弱中心主张的外推;段落定义因语料而异(空行 vs 代码块),单元异质性被继承进所有 Layer III 量;hub 掩蔽每语料只用单检查点、属探索性;句子层级因小位移处 $\Delta p_1$ 与 $d$ 纠缠而未讨论;$d\le 1024$ 的截断使远距离行为完全未知,而那里二者高度共线。
独立分析的弱点
弱点一:规模与外部效度。8 层 512 维玩具模型上成立的因果效应未必存在于数亿参数的真实 LLM,且未验证任何下游相关性;改进方向是先在 124M–1B 级模型和真实预训练设置下重复协议,再检验 $U^*$ 是否预测长文档任务表现。弱点二:统计功效不足。3 种子 + 3 语料使中心结论在 OpenWebText 上悬而未决,而这恰是自然文本排序的关键一环;改进方向是每格 10+ 种子、分析文档扩到数千,并做前瞻功效分析而非事后解释。弱点三:hRoPE 是测量仪器而非可用架构,它依赖真值段落标注;论文无法回答普通 Transformer 是否内隐表示段落(flat 的探针平衡准确率只到 0.61–0.68)。改进方向是在真实预训练检查点上做介导分析,或用换行/标点等弱监督边界近似 $p_1$。弱点四:机理空白——只排除了加性族,softmax 竞争、逐层逐头分解、电路级追踪都未做;hub 探针也只是单检查点的相关证据。弱点五:候选解释覆盖面窄:连贯性只用静态词向量余弦,未试主题模型、句向量模型或 LLM 一致性打分;改进方向是系统扫描数十个语料特征,用跨语料回归预测 $U^*$。
未来方向
作者提出或暗示的方向:把协议扩展到句子层级(需先解决小位移处 $\Delta p_1$ 与 $d$ 的纠缠);继续寻找决定语料依赖深度的量,嵌入连贯性是被明确推荐的后续主线;检验 softmax 竞争性归一化机制以解释非单调『势阱』;检验现象在更大规模、更长上下文中的存续($d>1024$ 因共线在本协议内不可测);为长文档位置编码设计提供层级诊断量。基于本文成果可延伸的:把压缩深度当作语料质量与文档切分合理性的无监督诊断指标(例如自动检测网页抓取中的段落切碎);在代码、多语、对话等结构更异的语料上复现排序,检验『结构化越强压缩越深』的猜想;与长上下文方法交叉——ALiBi、YaRN、Longformer 都假设标量距离衰减,层级坐标或能解释并改进这些衰减假设;反向利用因果链,用测得的 $U^*$ 监督可微边界预测器,实现端到端的『结构发现』闭环。
复现评估
可复现性总体较好,但文中未提供代码仓库链接。有利条件:模型极小(8 层、$d_{\text{model}}=512$、batch 16、5000 步、lr $3\times10^{-4}$、AdamW+warmup+余弦衰减,超参数见表 10),单张 GPU 可完成 5 变体 × 3 语料 × 3 种子训练;语料全部公开(WikiText-2、OpenWebText、Python 源码);预处理规则逐条给出(分句正则、Code 的 131 块截断、OpenWebText 的 newspaper+FastText+LSH 管线);统计协议描述到伪代码级($B=4000$ 文档聚类 Bootstrap、$n\ge 2000$ 精确距离门槛、配对共享重采样索引、二次/三次顶点拟合),且论文罕见地完整公开了一次已修正的方法学错误(分箱伪影及其机制),大幅降低踩坑风险。不利条件:分析管线繁琐且耦合(残差化、锚点归一化、8 个语料统计量、掩蔽协议),OpenWebText 需处理约 17GB、8M 文档的抽取去重,工程量不小。估计熟悉 PyTorch 的工程师用 1–2 周、单张 24GB GPU 可复现主结果。
论文图表
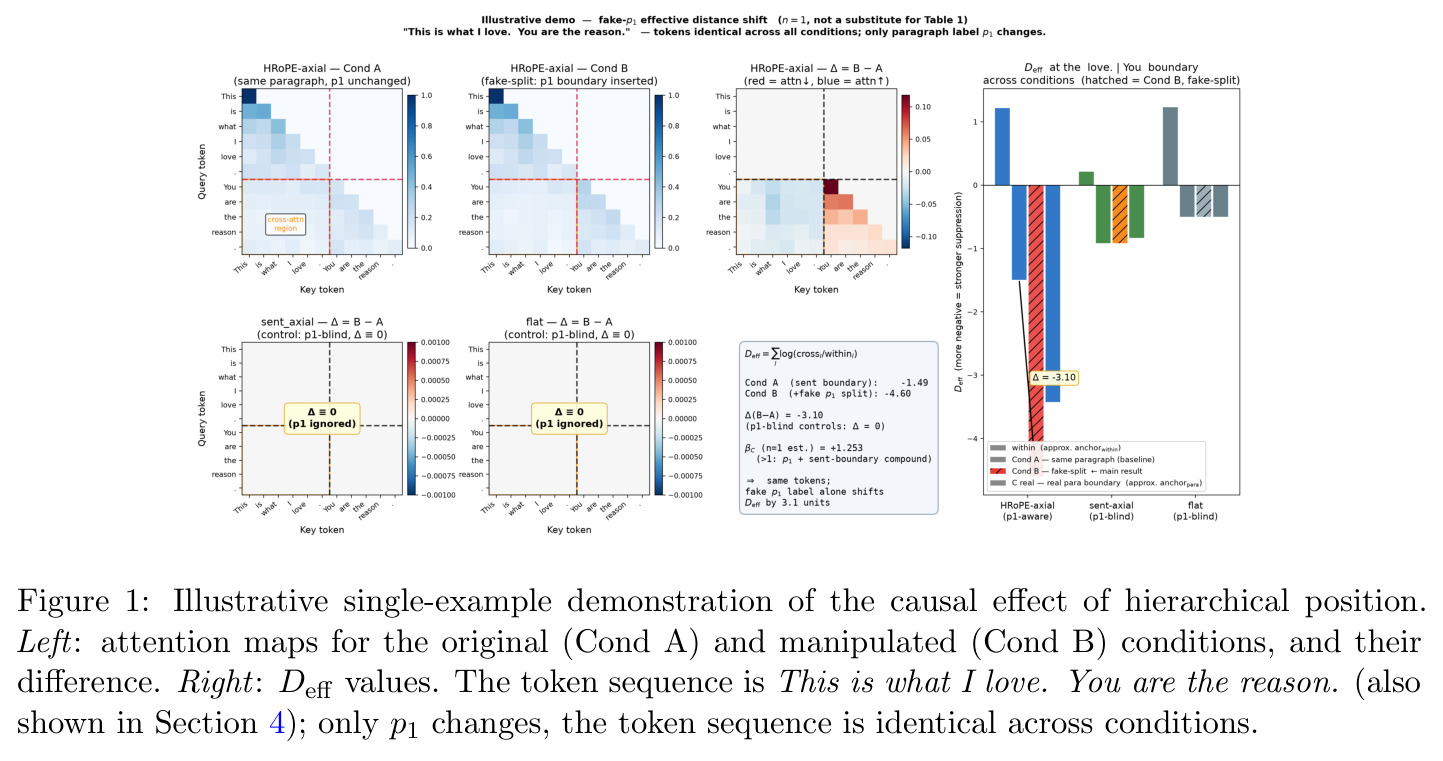
以单句对『This is what I love. You are the reason.』展示 fake-split 介入:左侧为原始条件(Cond A)与操纵条件(Cond B)的注意力图及二者之差,右侧为 $D_{\text{eff}}$ 值。两个条件的词元序列完全相同,只有 $p_1$ 改变;hrope axial 中注意力从『You』向第一句回看的分量集中下降($\Delta=-3.105$),而无 $p_1$ 通道的对照模型没有变化。
这是全文因果论证的直观起点:一张图同时展示了『只有坐标变了』和『注意力确实变了』,把抽象的反事实介入变成可视证据,引言与 4.1 节都依赖它建立读者直觉。