通过方向分解解析Transformer的表征演化 Disentangling Representation Evolution in Transformers through Directional Decomposition
层更新可分解为平行与垂直分量:平行冗余可删甚至利于训练,垂直关键而脆弱
前置知识
残差流(Residual Stream)
Transformer 中每层不替换隐状态,而是叠加一个学习到的更新:$z_{l+1} = z_l + \Delta_l$。隐状态像一条贯穿所有层的共享工作区,注意力和 MLP 子层都往里写入信息。残差连接保证了深层网络的梯度流动与跨层信息传递,也是 ReZero、LayerScale、DeepNet 等架构缩放机制的作用对象。
本文的第一个分解位点就是残差空间:把子层更新 $\Delta$ 相对进入该层的隐状态 $z$ 做正交分解。不理解残差流的加法结构,就无法理解全文的测量与干预实验。
正交分解(平行/垂直分量)
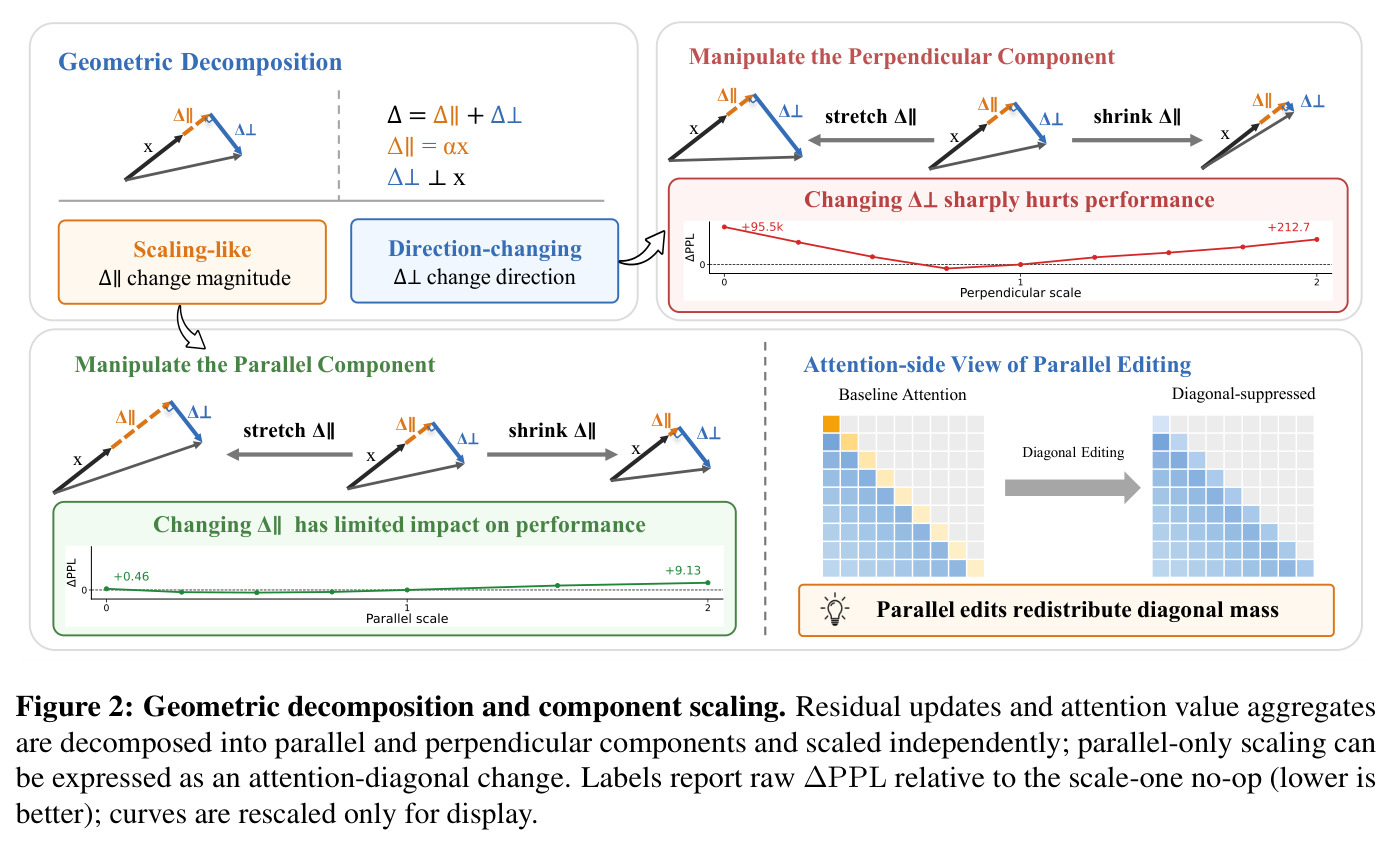
给定参考向量 $z$ 和更新 $\Delta$,可唯一分解为 $\Delta_\parallel = \frac{\Delta \cdot z}{\|z\|^2} z = \alpha z$ 与 $\Delta_\perp = \Delta - \Delta_\parallel$。平行分量只改变幅度(相当于把 $z$ 缩放 $1+\alpha$ 倍),垂直分量落在 $(d-1)$ 维正交子空间中,代表方向改变,即语义转向。
$\Delta_\parallel$ 与 $\Delta_\perp$ 是全文的核心变量:所有敏感性测量、分量缩放干预、压缩误差分解都建立在这对分量的几何直觉之上。
注意力值聚合与自注意力对角线
查询 token $t$ 的注意力输出是值向量的加权和 $o_t = \sum_{s \le t} A_{ts} v_s$,其中对角项 $d_t = A_{tt} v_t$ 是 token 对自身值向量的自消息,与 $v_t$ 共线;其余部分是跨 token 上下文聚合。注意力权重长期集中在对角线(自指路径)是普遍现象,与 attention sink 研究相关。
论文最关键的值空间分解就是把 $o_t$ 拆成自消息 $d_t$ 与非自聚合 $c_t$、只干预后者。不懂自注意力对角结构,就无法理解 exclude-self 编辑为何近乎无损。
后训练压缩(量化与剪枝)
量化把权重压到低位(如 4-bit AWQ),剪枝把部分权重置零(如 Wanda 的非结构化、4:8、2:4 稀疏模式)。两者都会使压缩后模型的激活更新 $\Delta_{\text{comp}}$ 偏离原模型的 $\Delta_{\text{base}}$,产生误差 $e = \Delta_{\text{comp}} - \Delta_{\text{base}}$,其大小传统上用 L2 范数衡量。
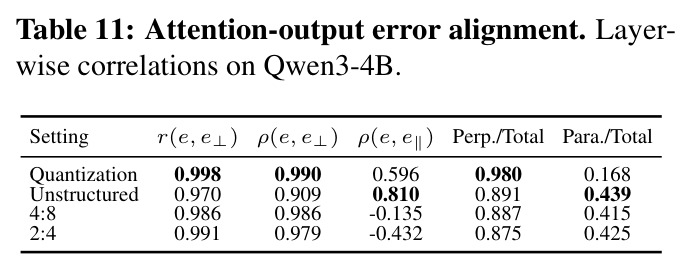
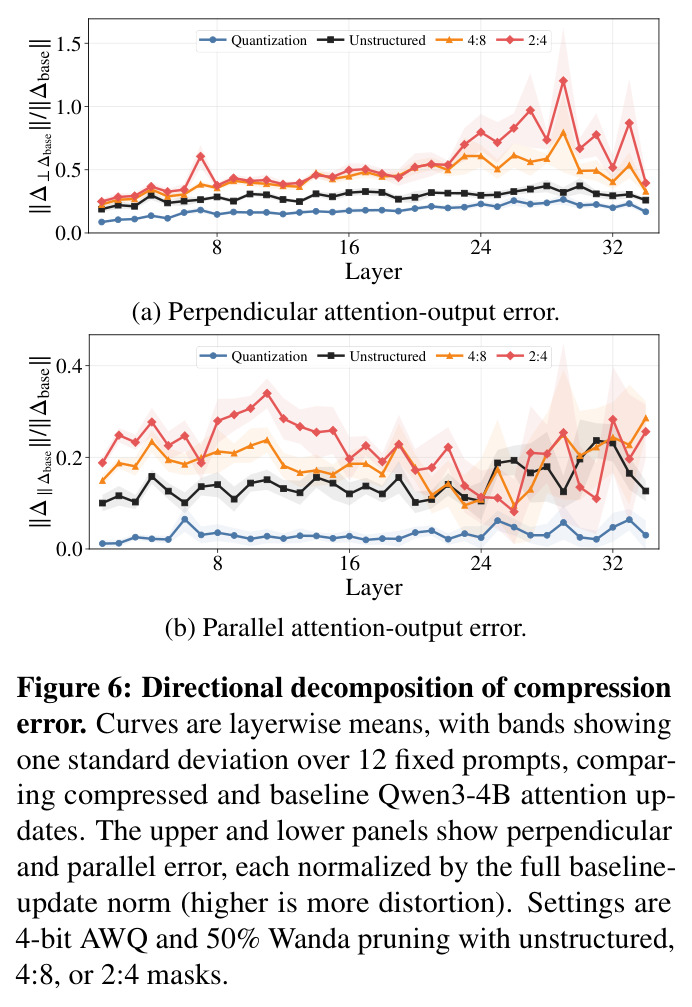
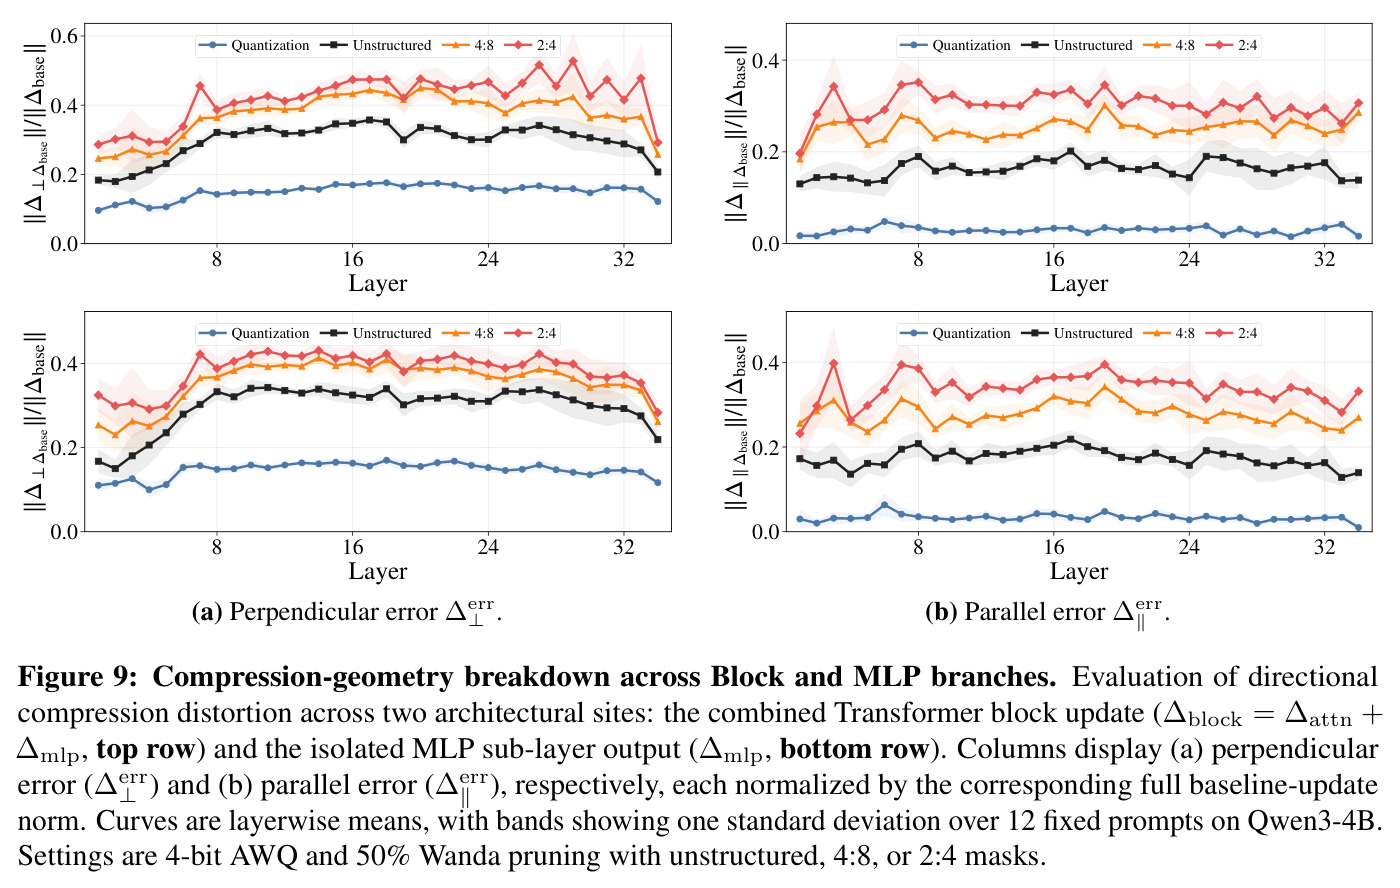
压缩诊断是论文三大应用之一:把误差 $e$ 分解为平行/垂直分量后发现,垂直误差才是预测压缩后质量退化的判别性指标,这直接解释了各向同性 L2 目标的失效。
困惑度与零样本/长上下文评测
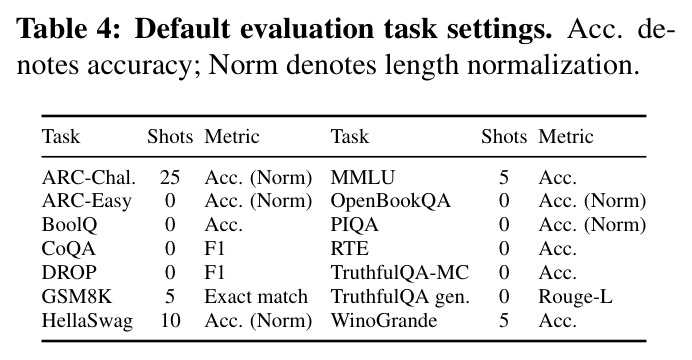
困惑度(PPL)衡量语言模型对文本的预测质量,越低越好;零样本评测在 OBQA、PIQA、WinoGrande、ARC-Challenge、HellaSwag、BoolQ、RTE 等任务上测准确率。长上下文能力用 RULER 套件(13 个检索与推理任务,上下文最长 12k)评估,是检验编辑是否破坏长程能力的关键。
所有干预实验都用 PPL 变量($\Delta$PPL)、七任务平均准确率和 RULER 分数来量化平行/垂直分量的行为敏感性,读懂实验表必须先熟悉这些指标。
研究动机
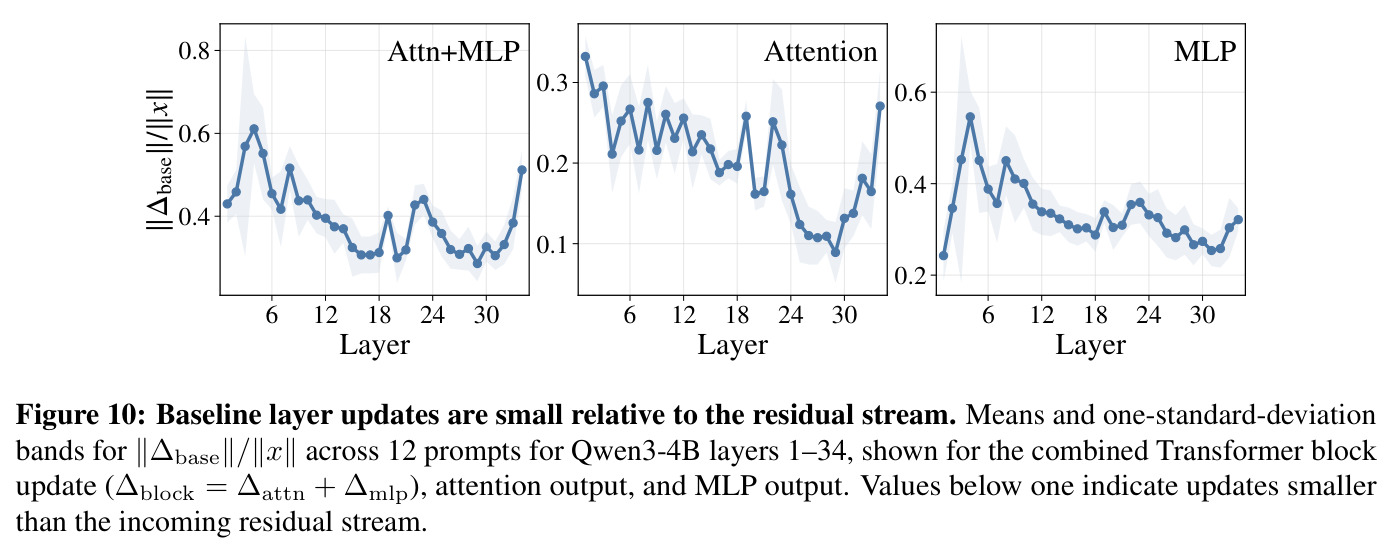
Transformer 的每个残差更新 $\Delta$ 在几何上同时承担两种角色:沿输入方向的平行分量 $\Delta_\parallel$ 只做标量缩放——而残差流用零参数就能提供这种缩放;垂直分量 $\Delta_\perp$ 才真正改变方向。矛盾在于,高度参数化的注意力和 MLP 子层却持续分配大量容量产生平行分量:Figure 1 显示在 Qwen3-4B-Instruct-2507 和 Qwen3-30B-A3B 的多个采样层上,生成过程中累积更新的范数比 $\|\Delta_\parallel\| / \|\Delta_\perp\|$ 持续大于 1,即平行分量占主导。这些分量究竟是能力所必需还是功能冗余?现有研究无法回答:一方面,量化与剪枝普遍以各向同性 L2 误差 $\min \|\Delta - \hat{\Delta}\|_2^2$ 为目标,默认所有方向的扰动同等有害,导致全局 L2 误差相近的压缩方法在下游保真度上差距悬殊;另一方面,标准自注意力把跨 token 信息混合与自我表征放大纠缠在一起,参数容量疑似被浪费在冗余的平行缩放上,但删掉它会怎样无人系统测量过。
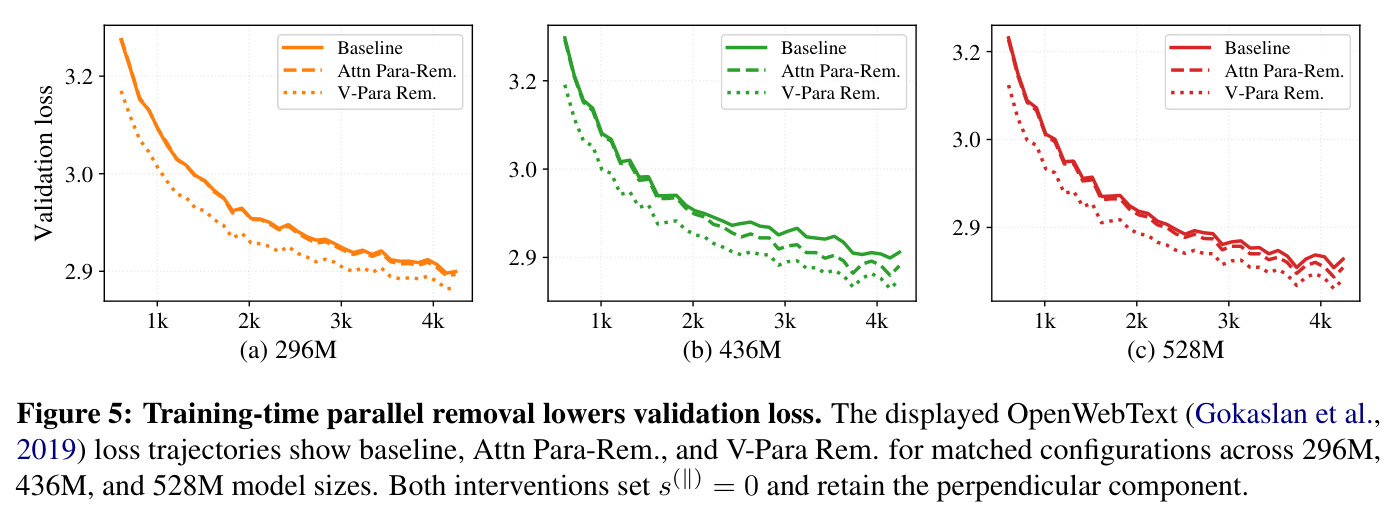
本文的目标是本文要建立一个统一的方向分解分析框架,把表征演化拆成两个正交角色——平行分量负责幅度调制、垂直分量负责语义转向——并通过定向干预实验回答三个递进的问题:第一,在残差空间和注意力值空间中,平行与垂直分量各自对模型行为有多重要,缩放或删除它们分别引起多大的性能变化?第二,这种方向几何能否解释压缩模型的质量差异,即垂直误差是否比各向同性 L2 误差更能预测量化/剪枝后的退化?第三,既然平行分量疑似冗余,能否在从零预训练时主动抑制注意力的平行更新,把容量引导向垂直的上下文转向,从而降低验证损失、提升下游泛化?最终目标是把更新方向与推理时编辑鲁棒性、压缩诊断、训练时干预三条线索串成一个连贯的几何故事。
与已有工作不同的是,本文的独特切入有三点。第一,视角新颖:以往残差流研究关注分支幅度缩放(ReZero、LayerScale、DeepNet)和秩坍塌等训练稳定性问题,本文研究的是学习到的更新本身的方向几何——更新是强化输入方向还是转向正交语义子空间——并用行为干预而非纯观测来检验其功能角色。第二,分解位点创新:除残差空间外,本文提出在注意力值空间内部做分解,以查询 token 自己的值向量 $v_t$ 为参考方向。这一位点很重要,因为残差空间做不到:输出投影 $W_O$ 会把值聚合混入残差流,掩盖 token 的自指结构;而在值空间可以把聚合拆成自消息 $d_t = A_{tt} v_t$ 与跨 token 聚合 $c_t$,第一次把自-directed 值流从方向变化的上下文信息中解耦出来。第三,贯穿模型全生命周期:同一个方向几何被用于推理时编辑、压缩误差诊断、预训练归纳偏置三件事,并与 Exclusive Self-Attention(XSA)、gated attention 等新架构形成互证。
核心方法
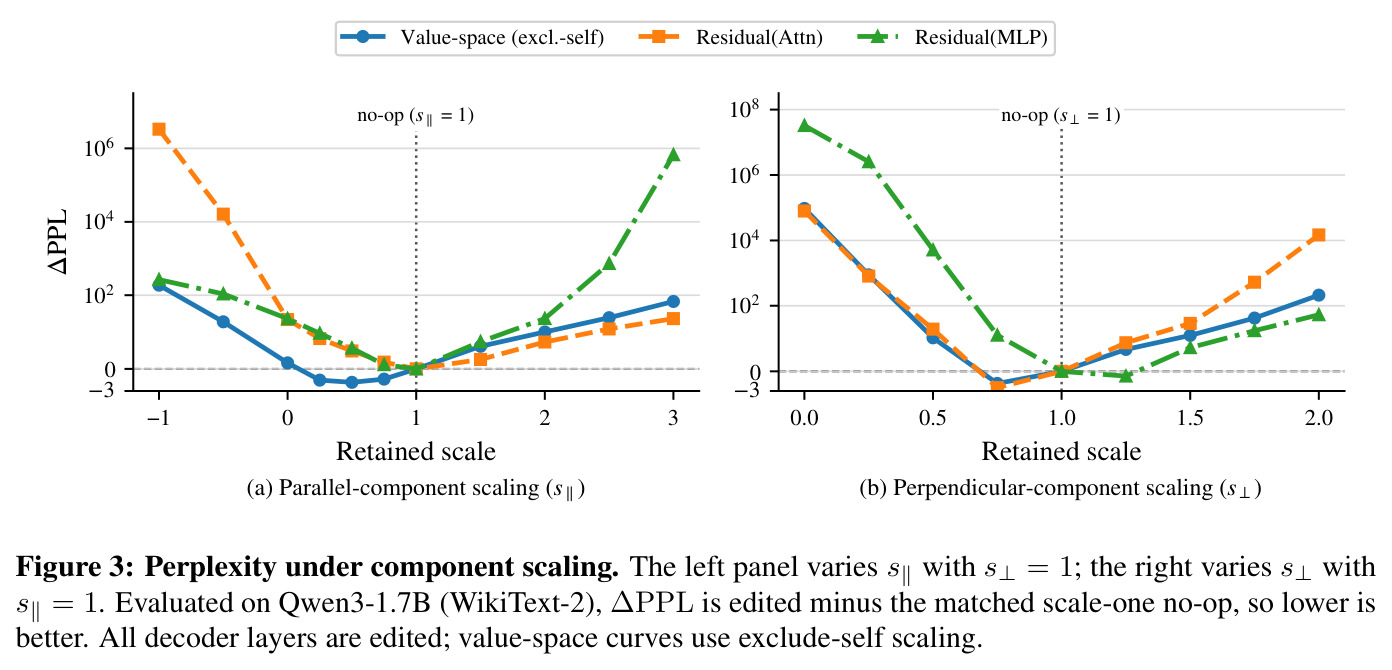
先说直觉:任何层更新都是油门和方向盘的组合——平行分量 $\Delta_\parallel$ 像油门,只增减表征幅度不改变去向;垂直分量 $\Delta_\perp$ 像方向盘,把表征推入正交的新语义子空间。技术上,对参考向量 $z$ 和更新 $\Delta$ 做正交分解:$\Delta_\parallel = \frac{\Delta \cdot z}{\|z\|^2} z = \alpha z$,$\Delta_\perp = \Delta - \Delta_\parallel$;代回残差加法得 $z_{l+1} = (1 + \alpha_{lt}) z_{lt} + \Delta_{lt,\perp}$,即平行分量把入层表征缩放 $(1+\alpha)$。分解在两个互补位点进行:残差空间($\Delta$ 为子层更新,$z$ 为入层隐状态)和注意力值空间($\Delta$ 为输出投影前的聚合 $o_t = \sum_{s \le t} A_{ts} v_s$,参考为 token 自身值 $v_t$)。随后用统一的分量缩放干预 $\hat{y}_t = s_\parallel y_{t,\parallel} + s_\perp y_{t,\perp}$,在冻结权重的前向传播中通过 hook 独立扫描 $s_\parallel$、$s_\perp$,用 WikiText-2 PPL、七个零样本任务和 RULER 长上下文基准测量行为敏感性。
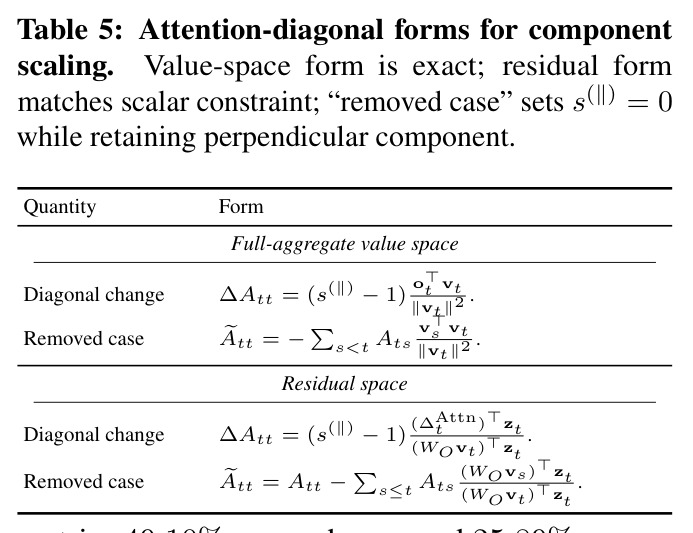
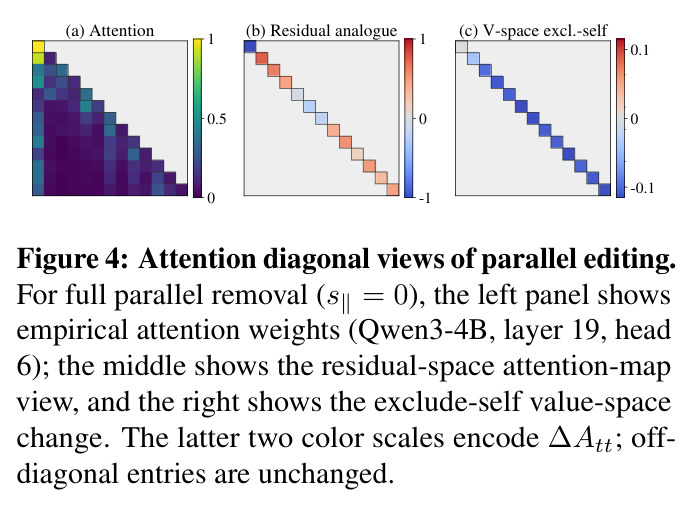
核心创新是 exclude-self 值空间分解。朴素做法把整个值聚合 $o_t$ 相对 $v_t$ 分解,平行移除时会不可避免地把 token 自身的身份载体 $d_t = A_{tt} v_t$(与 $v_t$ 共线)连同跨 token 信息一起清零,造成严重退化——naive 值空间移除掉 8 到 10 个点正是这个原因。本文的关键一步是把聚合解耦为 $o_t = d_t + c_t$($d_t$ 为自消息,$c_t = \sum_{s<t} A_{ts} v_s$ 为非自聚合),只对 $c_t$ 做平行/垂直缩放并原样恢复 $d_t$:$\hat{o}_t^{\text{excl}} = d_t + s_\parallel c_{t,\parallel} + s_\perp c_{t,\perp}$。它既不遮蔽自注意力边、也不重归一化注意力行,干净地隔离出真正的问题:跨 token 上下文的幅度调制是否冗余。与已有方法的本质区别:XSA 等门控注意力是改架构重新训练,本文是事后分析工具加轻量前向 hook;论文还证明这类平行编辑等价于注意力矩阵对角线的闭式修改 $\Delta A_{tt} = (s_\parallel - 1) o_t^\top v_t / \|v_t\|^2$,把张量操作与注意力图直观联系起来。
方法步骤详情
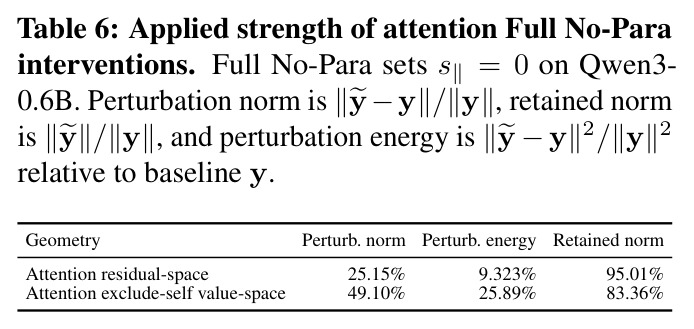
方法六步。一、观测:逐 token、逐层计算残差平行比率 $r_{lt} = |\alpha_{lt}| \|z_{lt}\| / \|\Delta_{lt,\perp}\|$,确认平行分量跨深度持续且常占主导(Figure 1)。二、选位点:残差空间分别对注意力输出、MLP 输出、整块累积更新分解;值空间先把 $o_t$ 拆成 $d_t + c_t$,再对 $c_t$ 相对 $v_t$ 分解。三、干预:前向 hook 替换目标张量,应用 $\hat{y}_t = s_\parallel y_{t,\parallel} + s_\perp y_{t,\perp}$,在 Qwen3、Llama-3、Gemma-3 上分别扫 $s_\parallel$(固定 $s_\perp=1$)与 $s_\perp$(固定 $s_\parallel=1$),测 WikiText-2 的 $\Delta$PPL。四、下游验证:对 $s_\parallel = 0$ 和 $0.5$ 两档,跑七个零样本任务及 13 任务 RULER(4k 到 12k)。五、机制审计:推导干预的注意力对角线闭式形式(Table 5),审计 post-$W_O$ 输出扰动(Table 6)。六、外延:把压缩误差 $e = \Delta_{\text{comp}} - \Delta_{\text{base}}$ 分解为 $e_\parallel$、$e_\perp$ 检验其与压缩质量的相关;在 296M 到 2.7B 从零预训练时施加 $s_\parallel = 0$(约 104.9B token、200K 步、8 张 H100),对比验证损失与下游准确率。
技术新颖性
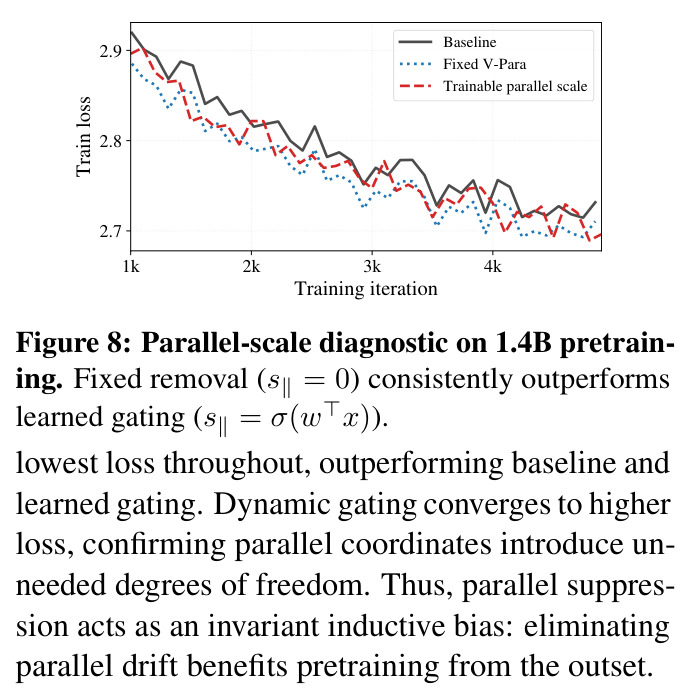
技术新颖性有四。其一,方法论上首次把表征演化形式化为方向几何问题并提出行为敏感性检验范式:不问更新里有什么,而问删掉某方向分量后模型会怎样,比观测性的余弦诊断更有因果力。其二,exclude-self 分解揭示值空间与残差空间在平行容忍度上的巨大鸿沟:同一类平行缩放编辑在值空间近乎无损、在残差 MLP 上迅速崩溃,证明鲁棒性不是平行性的抽象属性而取决于位点与保留物——此前无人刻画过这一结构。其三,对角线闭式形式(Table 5、式 12)把干预压缩为注意力对角元上的标量修改,给出最小 Frobenius 范数算子实现,支撑 Figure 4 的机制可视化。其四,应用链完整:垂直误差与压缩质量的层间相关 $r \ge 0.97$、占比 87.5% 到 98.0%,统计上解释了各向同性 L2 目标为何失效;预训练时抑制平行分量作为归纳偏置,与 gated attention、QK normalization 等新架构互证;Figure 8 显示固定移除优于可学习门控 $s_\parallel = \sigma(w^\top x)$,说明平行坐标是多余自由度而非需要学习的量。
实验结果
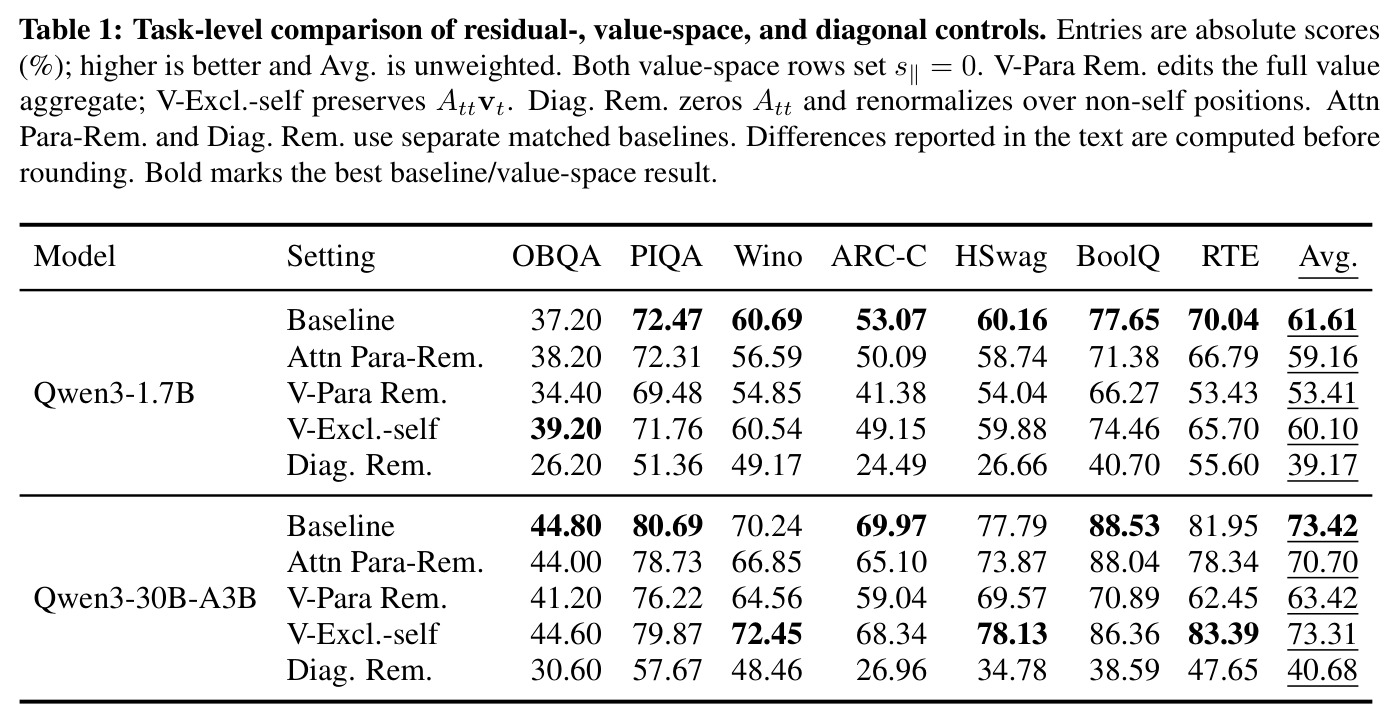
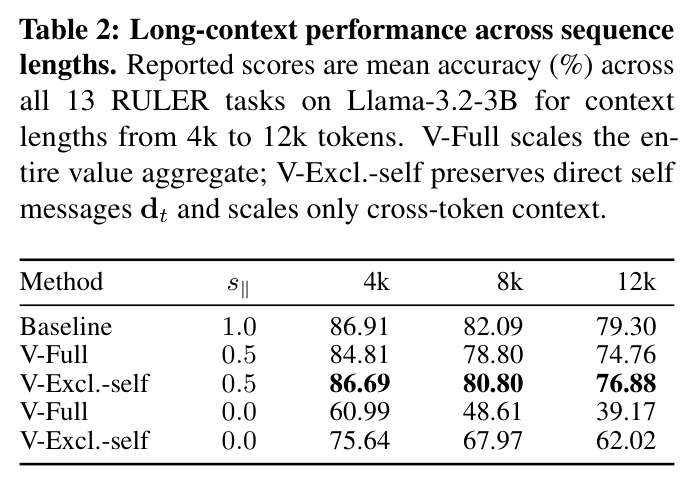
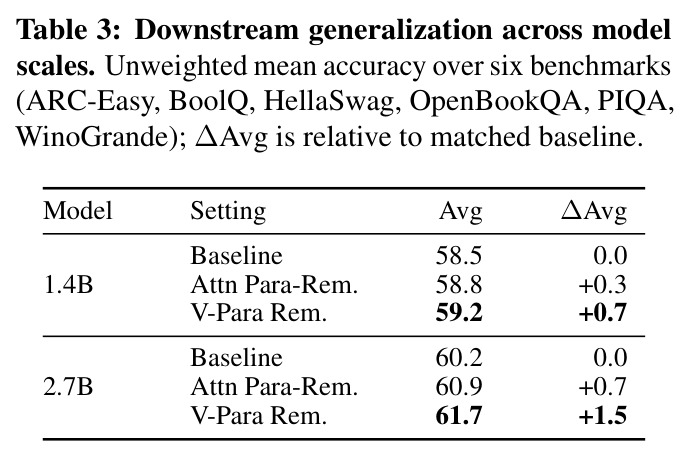
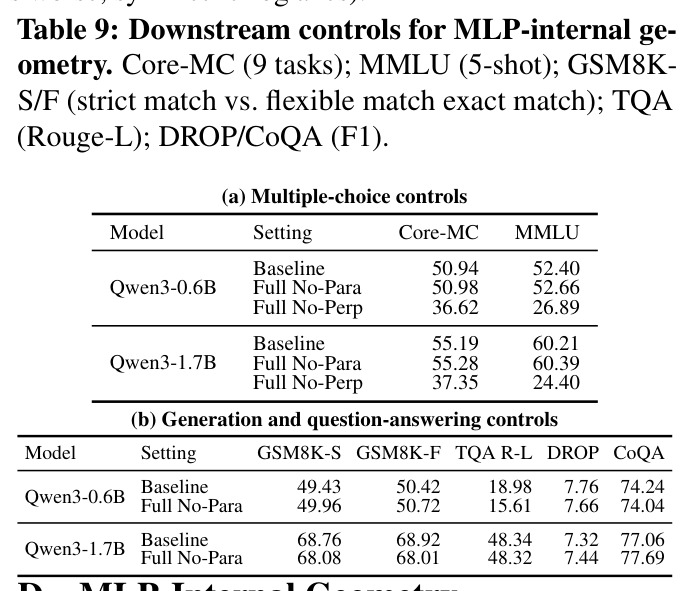
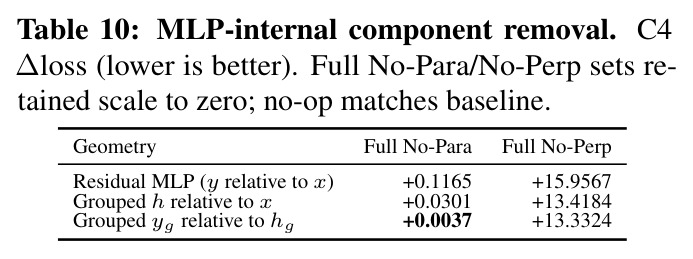
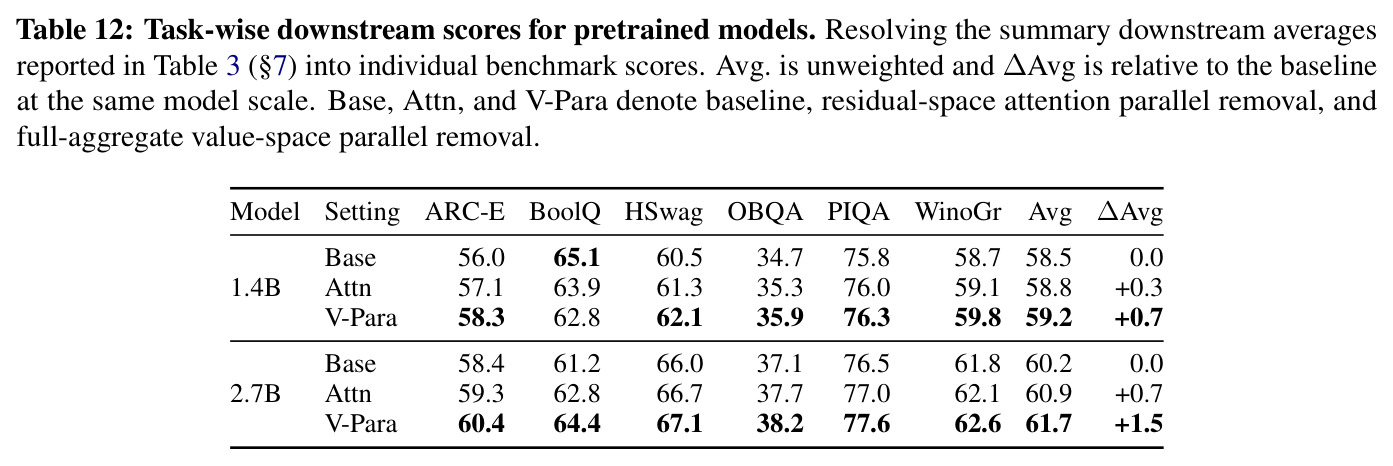
实验分四块。一、干预敏感性(Figure 3):垂直缩放极端脆弱,$s_\perp$ 稍偏离 1 即 PPL 陡升,完全移除时爆炸数个数量级——值空间与残差注意力达数万点、残差 MLP 达百万点;平行缩放有宽容忍带:值空间 exclude-self 在 $s_\parallel \in [0,1]$ 内 PPL 变化不足 1 点、至 scale 3 最多 1.3 点,残差 MLP 则迅速崩溃,形成值空间优于残差注意力优于残差 MLP 的位点层级。二、下游与长上下文(Table 1、2):Qwen3-1.7B 七任务平均 61.61,exclude-self 移除后仍达 60.10(仅降 1.5 点),30B-A3B 上 73.42 对 73.31;naive 全聚合移除掉 8 到 10 点,对角线硬移除崩至 39.17/40.68。RULER 上 $s_\parallel=0.5$ 与基线仅差 0.2 到 2.4 点;完全移除时全聚合编辑掉 26 到 40 点(86.91 降至 39.17@12k),exclude-self 保住 75.64@4k、62.02@12k。关键反转在 Table 6:exclude-self 对 post-$W_O$ 输出扰动达 49.10%(残差仅 25.15%)却更稳——稳定性取决于自身份路由的结构保持而非扰动幅度。三、压缩诊断(Figure 6、Table 11):垂直误差把四种压缩体制排成 AWQ、非结构化、4:8、2:4 的严格次序,与总误差相关 $r \ge 0.97$(量化达 0.998)、占总误差 87.5% 到 98.0%;平行误差交缠、相关低至 $-0.432$。四、预训练干预(Figure 5、Table 3):296M 到 2.7B 验证损失一致下降,下游 1.4B 提 0.7 点、2.7B 提 1.5 点;MLP 内部分解(Table 10)显示 No-Para 最多 +0.12 而 No-Perp 超过 +13.3;开销极低(Table 7:prefill 低于 2.5%、decode 低于 1.0%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本七任务平均(Qwen3-1.7B,并行移除 $s_\parallel=0$) | 平均准确率 (%) | V-Excl.-self:60.10 | 未编辑 61.61;V-Para Rem. 53.41;Attn Para-Rem. 59.16;Diag. Rem. 39.17 | 仅降 1.5 点近乎无损,比 naive 值空间移除少损 8.3 点、比对角线硬移除少损 20.9 点 |
| 零样本七任务平均(Qwen3-30B-A3B MoE) | 平均准确率 (%) | V-Excl.-self:73.31 | 未编辑 73.42 | 差距仅 0.11 点,完全移除所有跨 token 平行聚合仍几乎无损 |
| 长上下文 RULER 13 任务(Llama-3.2-3B,4k/12k) | 平均准确率 (%) | V-Excl.-self $s_\parallel=0$:75.64(4k)/ 62.02(12k);$s_\parallel=0.5$:86.69 / 76.88 | 未编辑 86.91 / 79.30;V-Full $s_\parallel=0$:60.99 / 39.17 | 完全移除时比全聚合编辑高 14.7 至 22.9 点 |
| 从零预训练下游六任务(1.4B / 2.7B,FineWeb) | 平均准确率 (%) | V-Para Rem.:59.2(1.4B)/ 61.7(2.7B) | 标准预训练 58.5 / 60.2 | +0.7 / +1.5 点,残差空间变体亦 +0.3 / +0.7 点 |
| 压缩误差方向分解(Qwen3-4B,4-bit AWQ) | 误差与方向分量的层间相关 $r$ | $r(e, e_\perp) = 0.998$,垂直误差占总误差 98.0% | 平行分量 $r(e, e_\parallel) = 0.596$;4:8 与 2:4 下低至 $-0.135$ / $-0.432$ | 垂直误差是压缩质量的判别性指标,平行误差无判别力 |
| MLP 内部平行/垂直移除(Qwen3-0.6B,C4 固定损失) | $\Delta$loss(越低越好) | Full No-Para:+0.0037 至 +0.1165 | Full No-Perp:+13.3324 至 +15.9567 | 两个数量级以上的方向不对称,且深入 MLP 内部激活仍成立 |
局限与改进
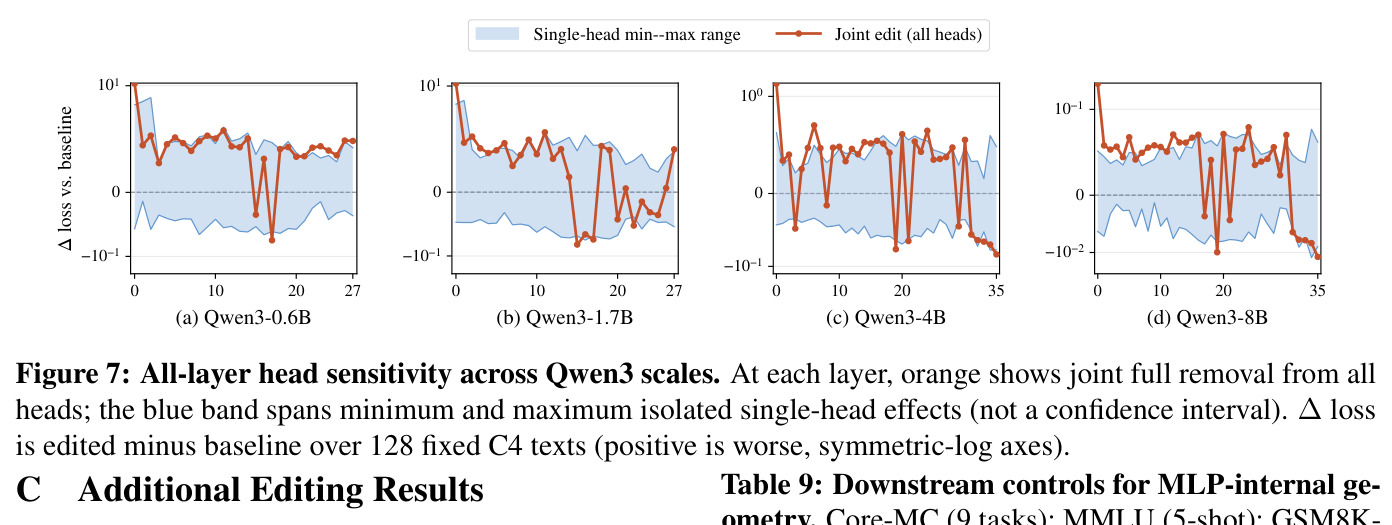
作者承认的局限:实验只覆盖 decoder-only 语言模型、特定任务与压缩/训练设置;同一几何图像在其他架构和训练制度下有待验证;这些编辑目前主要作为分析工具,实用化还需验证。我的补充观察:第一,平行冗余有明显的尺度依赖——Table 8 中大模型几乎无损(Gemma-3-12B +0.1、Qwen3-4B $-0.2$),小模型损失可观(Gemma-3-1B-IT $-5.3$、Qwen3-0.6B $-4.8$、1.7B $-3.2$),说明小容量模型可能确实在用平行分量携带信息。第二,残差空间的平行分量不能删(Residual(MLP) 极脆弱),说明平行等于可冗余幅度调制的叙事只对值空间成立,理论图景不完备。第三,压缩诊断本质是层间相关性证据,垂直误差导致退化的因果机制主要靠推理干预间接支持。第四,预训练收益(+0.7/+1.5 点)虽跨任务一致但幅度不大,且最大只验证到 2.7B、约 105B token。第五,值空间分解只以 token 自身 value 这一个一维方向为参考,而 Figure 7 显示不同注意力头携带方向相反的平行分量,更细的子空间结构未被刻画。
独立分析的弱点
独立分析有四个弱点。第一,理论解释不完全对称:值空间平行冗余依赖保留自消息 $d_t$ 的前提,而残差空间平行分量承载跨层必需计算、MLP 分支尤其脆弱;说明平行等于冗余是位点依赖现象,但对残差 MLP 为何脆弱论文只给现象学描述(Appendix D),缺少机理解释。改进方向:对 MLP 内部 carrier $h = \phi(W_{gate} x) \odot W_{up} x$ 的平行分量做跨层因果追踪,定位其携带的信息类型。第二,小模型失效:0.6B 到 1.7B 模型在 $s_\parallel = 0.5$ 下掉 3 到 5 点,限制端侧应用,也提示冗余结论可能是大模型过参数化的副产品。改进方向:利用 Figure 7 的头级敏感性做按层/头选择性移除,而非全层均匀处理。第三,训练干预实用性存疑:预训练收益要求训练和评测全程保持 $s_\parallel = 0$,产物不是标准 Transformer,训练后恢复标准注意力可能存在失配。改进方向:探索训练时抑制、部署时恢复,或固化为门控注意力架构。第四,压缩诊断未落地为算法:论文只证明垂直误差是好的诊断指标,未提出以 $\|e_\perp\|$ 为目标的方向感知量化/剪枝方法。改进方向:把垂直误差写进 AWQ/Wanda 的优化目标做对照。
未来方向
作者提出的方向:把方向几何推广到其他架构与训练制度;把层级几何与下游行为更直接关联;把编辑工具转化为实用训练或推理方法,并为 gated attention、QK normalization 等解耦上下文路由与幅度调制的新架构提供原则性支撑。基于本文成果还可延伸:其一,方向感知压缩——把垂直误差作为压缩目标或早停指标,替代或补充各向同性 L2,直接回应欧氏距离无法预测行为损失的论断;其二,机制可解释性——作者把垂直子空间描述为承载事实与语法区分的正交坐标,可用 probing 或因果干预刻画 $\Delta_\perp$ 编码的语义特征,并与 attention sink、induction head 等已知电路对齐;其三,规模外推——测量 $s_\parallel$ 容忍带宽度随模型规模的变化,建立平行冗余度的 scaling law;其四,训练动力学——Figure 8 显示固定移除优于可学习门控,可研究平行抑制与学习率、warmup 的交互,或设计早期允许、后期抑制的 curriculum;其五,在 128k 以上超长上下文与注意力汇现象下检验值空间分解的稳定性,并探索与 FlashAttention 类内核的结合。
复现评估
复现条件总体友好但分层明显。开源情况:代码已在项目仓库公开;评测模型(Qwen3 系列 0.6B 到 30B-A3B、Llama-3.2-3B、Gemma-3)均为公开权重;数据集(OpenWebText、FineWeb-100BT、WikiText-2、C4)与评测框架(lm-evaluation-harness、RULER)均为标准公开资源。推理侧实验(分量缩放、压缩诊断、头级敏感性)只需前向 hook,实测开销 prefill 低于 2.5%、decode 低于 1.0%,单张 RTX 6000 Ada(BF16)即可,普通实验室数天内可复现 Figure 3、4 与 Table 1、2、6 的核心数字。压缩部分依赖开源的 AWQ 与 Wanda,4-bit 量化单卡可完成,垂直误差与压缩质量的相关性也易验证。门槛最高的是预训练干预:1.4B/2.7B 用 FineWeb-100BT 训练约 104.9B token、200K 步、batch 256、8 张 H100(BF16),估算需数百到上千 GPU 时,只有算力充足的团队能完整复现 Table 3;296M 到 528M 规模(Figure 5)则相对便宜。总体看,核心结论(方向不对称、exclude-self 近乎无损、垂直误差判别压缩质量)单卡即可验证,工程难度中等;需对照附录 A、B 中各干预命名的定义及 Table 5 的闭式形式。
论文图表
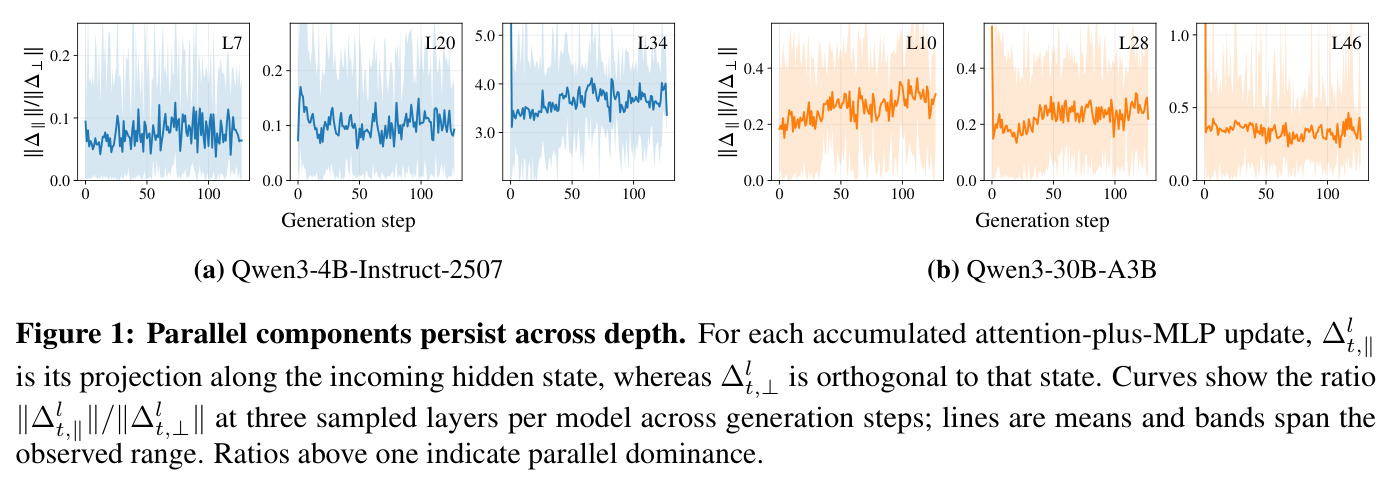
展示 Qwen3-4B-Instruct-2507 与 Qwen3-30B-A3B 在三个采样层(如 L7/L20/L34 与 L10/L28/L46)上,累积 attention 加 MLP 更新的平行/垂直范数比 $\|\Delta_{lt,\parallel}\| / \|\Delta_{lt,\perp}\|$ 随生成步数的变化;曲线为均值、带状区域为观测范围,比率大于 1 表示平行分量占主导。
这是全文的出发点观测:证明高度参数化的子层持续产生大量与输入方向平行的更新,直接引出平行分量是否行为必需这一核心研究问题。
RTX 6000 Ada(BF16)上分解加缩放实现的墙钟开销:prefill 从 0.6B 的 2.47% 降至 14B 的 1.11%,静态图 decode 为 0.83% 到 0.25%,0.7B 训练为 3.39%。
证明方向分解工程上几乎零成本、无需定制硬件即可部署,回应分析工具是否实用化的疑问。
Gemma-3-1B/12B、Llama-3.2-3B、Qwen3-0.6B/1.7B/4B/8B 在 $s_\parallel=0.5$ 下的 RULER-4k 得分变化:大模型几乎持平(Gemma-3-12B +0.1、Llama-3.2-3B $-0.2$、Qwen3-4B $-0.2$、8B $-0.5$),小模型退化明显(Gemma-3-1B-IT $-5.3$、Qwen3-0.6B $-4.8$、1.7B $-3.2$)。
检验值空间平行容忍的跨家族普适性,同时暴露模型规模依赖这一重要边界条件,是评估结论适用范围的关键表。