Gricea:面向对话式AI研究的开放科学平台 Gricea: An Open Science Platform for Conversational AI Research
把对话式AI用户实验表示为可运行、可检视、可复用的研究工件,让研究得以复现与累积。
前置知识
受控用户实验(Controlled Human-Subject Study)
通过将真实参与者分配到不同实验条件(如不同的系统提示词、界面布局或底层模型),在其他因素保持恒定的前提下分离自变量的因果效应,再用问卷、行为日志、任务产物等测量因变量。它是 HCI 与社会科学建立因果结论的标准方法,也是研究'对话式AI如何影响人'的主要工具。
本文的全部动机与评估都围绕'能否忠实表示、复现和扩展这类受控实验'展开;不理解条件分配与测量的含义,就无法理解 Gricea 为什么要把整个实验表示成可执行的对象。
组间设计与组内设计(Between/Within-Subjects)
组间设计把不同参与者分到不同条件,条件间互不污染但需要更多被试;组内设计让同一参与者依次体验多个条件,统计功效更高,但必须用顺序平衡(counterbalancing)抵消练习与疲劳效应。两种设计可以混合使用,配合分支与随机化逻辑实现。
Gricea 的分支、加权随机化与组内路由节点正是这两种设计的执行机制;评估中参与者出错的最高频位置恰好就是这些节点。
RAG(检索增强生成)
在 LLM 生成回答前,先从文档集合中检索相关片段并注入上下文,使回答有据可依。检索策略、引用约束、上下文过滤、注入对立证据等都属于可被实验操纵的变量。Gricea 还支持把整套 RAG 语料作为 Community Document Collections 随研究一起共享。
论文把'情境与接地(Context & Grounding)'列为对话式AI实验六大操纵维度之一,检索配置是被反复操纵又最常在论文中缺失报告的内容。
有向图与可视化节点编程
把程序逻辑表示为节点(操作)与边(控制流)组成的有向图,用户在画布上连线而非写代码;执行引擎按图结构遍历节点。PromptChainer、ChainForge 等 LLM 编排工具以及 oTree、jsPsych 等实验框架都采用了这一思路的变体。
Gricea 用 Study Flow 与 Task Flow 两层有向图定义整个实验,'作者画布上的图'与'运行时执行的程序'是同一份序列化定义,这是平台的核心抽象。
开放科学与可复现性
开放科学主张公开材料、数据与方法,使他人能够检验和复用研究成果;可复现性要求他人能重建出相同的实验条件。对涉及 LLM 的研究还必须记录模型版本、提示词与配置,因为模型行为会随版本漂移,同名模型并不构成等价条件。
作者发现 29 篇 CUI 2026 人因实验论文中 28 篇存在阻碍忠实复现的信息缺口,Gricea 的立论正建立在'发表不等于可复现'这一开放科学缺口之上。
研究动机
对话式AI正在成为信息获取与日常工作的默认界面,但理解它对人的影响需要在真实任务情境下做大规模受控实验,而现有做法处处受阻。其一,实验条件分散在提示词、界面代码、检索管线、问卷工具与部署脚本中,论文发表后他人难以还原参与者真正经历了什么:作者对 CUI 2026 全文的检查显示,29 篇含参与者实验的论文中有 28 篇存在报告缺失——最常见的是问卷题目或访谈措辞缺失(21 篇)、完整的 agent 提示词与接地输入缺失(15 篇)、刺激材料缺失(11 篇)。其二,搭建成本高昂:受访研究者描述自己'手动编码所有东西'耗时数周;不会编程的人则'只能花钱请人搭建'。其三,商业系统不可控:模型行为随版本漂移,同样的提示词与模型名并不构成等价条件,界面或检索策略的悄悄变更也会改变被试所处环境。结果是个别研究沦为孤立的一次性实现,后续研究者只能凭论文文字重新猜测并重建交互,复现、扩展与知识累积都无从谈起。
本文的目标是本文的目标是构建名为 Gricea 的开放科学平台,把对话式AI受控实验整体表示为'可配置、可部署的研究工件',让研究者能够运行、检视、分享和复用。具体要同时做到五点(对应文中设计准则 D1–D5):把呈现给被试的完整交互条件(而不只是孤立的提示词或界面截图)显式表示出来;同时支持实验流程与任务内交互行为并保持二者角色分明;用无代码画布把非系统背景研究者的搭建门槛降到最低;把每个已发布版本连同提示词、任务参数、图结构、材料保存为不可变工件,并与交互记录绑定以便审计;通过新节点类型扩展支持聊天、语音、编程、多用户等新任务与模态。最终愿景是让单个研究成为社区可以检视、fork、改造、叠加的资源,使研究发现像开源代码一样累积成集体知识。
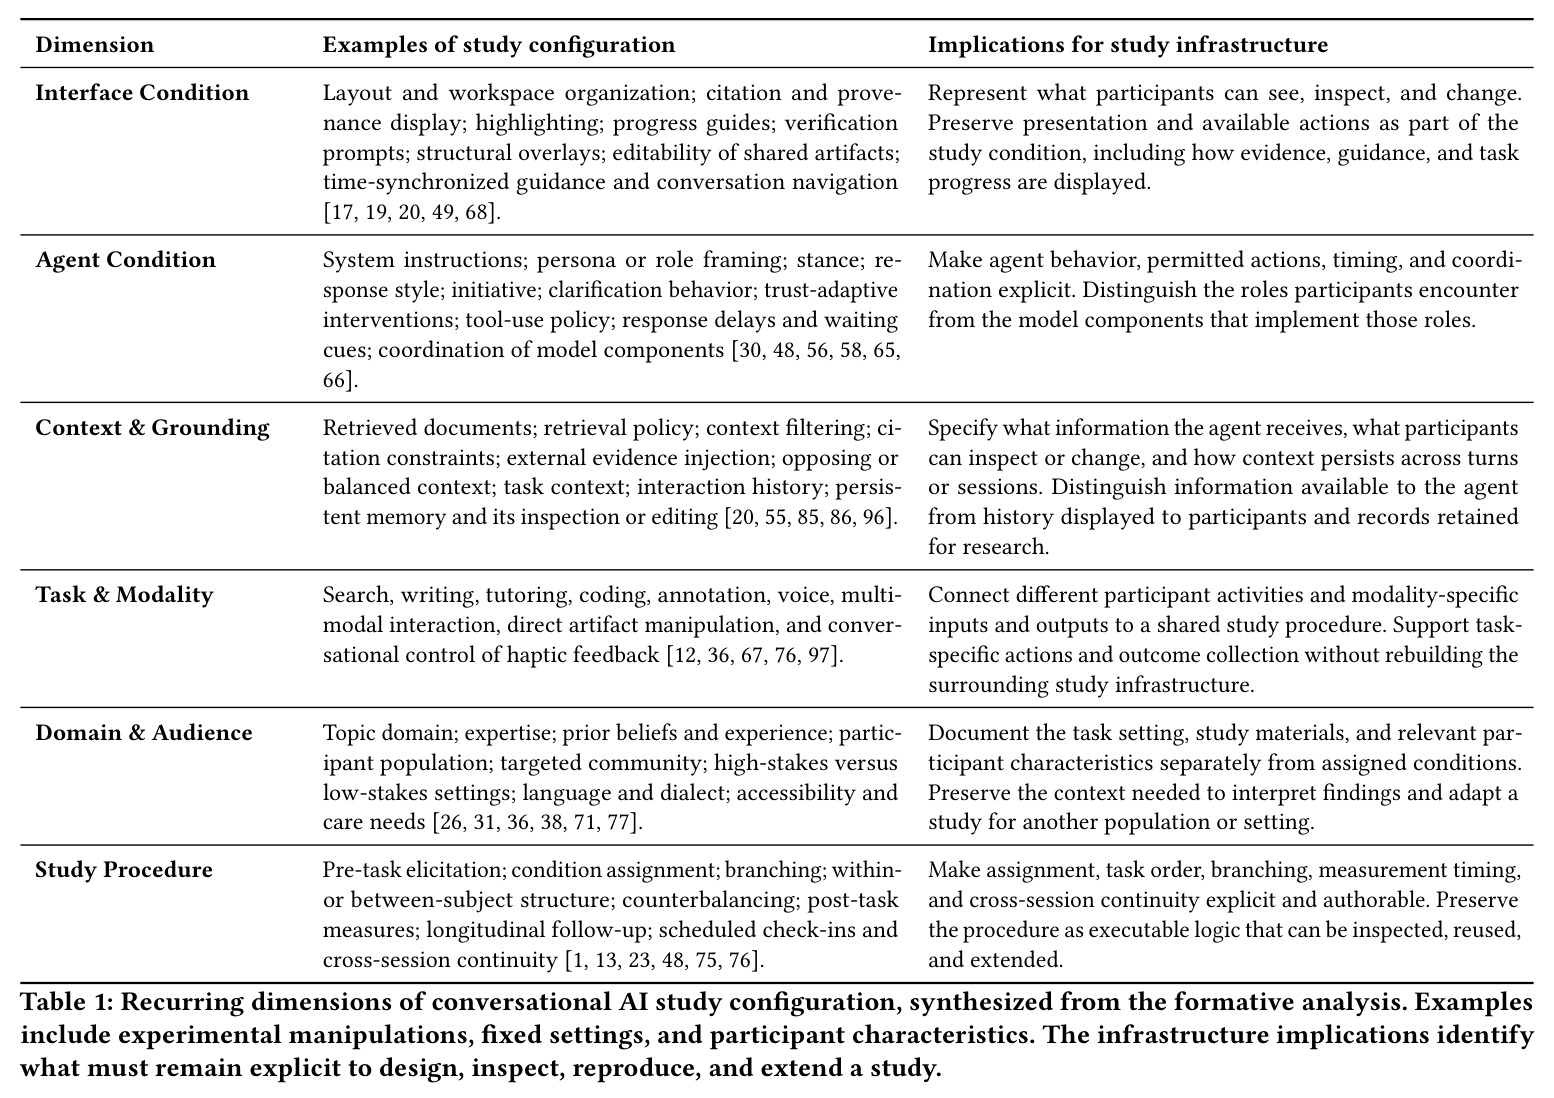
与已有工作不同的是,本文的独特切入在表示层而非工具清单层。作者先从 100 篇候选论文中筛出 57 篇做形成性设计空间分析,提炼出对话式AI实验的六个操纵维度(界面条件、Agent条件、情境与接地、任务与模态、领域与受众、实验流程),并据此主张:真正的实验对象是'被配置的交互条件'这一整体,因此表示必须同时覆盖宏观实验流程与微观任务行为。与 oTree、Empirica、jsPsych 等通用实验框架相比,Gricea 把 agent 行为、RAG 接地、界面脚手架当作一等公民;与聚焦群组动力学的 Deliberate Lab 相比,它面向更广的对话式AI设计空间;与报告清单、OSF 附录等事后保存方式相比,它让'研究者检视的表示 = 运行时执行的定义 = 发布后可 fork 的工件'三者合一,从机制上避免了论文描述与实际实现之间的二次翻译。这种'表示即执行即工件'的耦合立场是本文最重要的差异化贡献。
核心方法
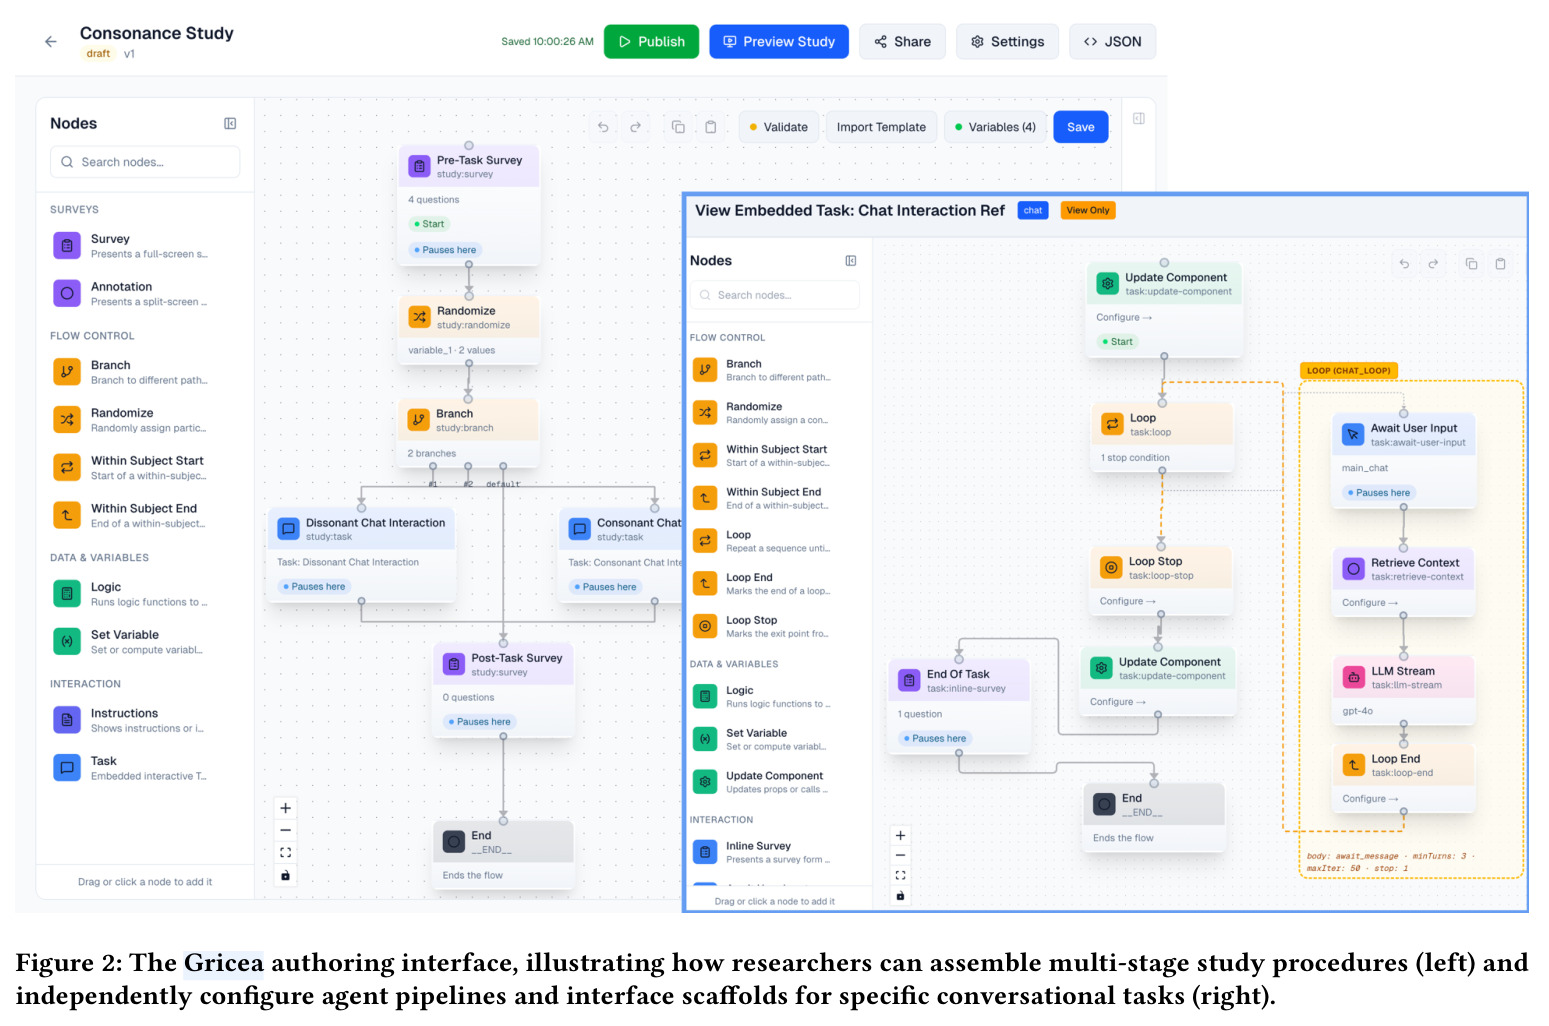
直觉上,Gricea 想让'设计一个实验'像画流程图:一张图管流程,另一张图管对话。技术上它把整个实验表示为有向图的组合:Study Flow 图编码宏观流程,包含指导语、前测问卷、任务入口、后测、完成等阶段节点,以及分支、加权随机化、组内排序等控制节点;每个交互阶段内嵌一个 Task Flow 图,其节点代表 LLM 推理调用、检索与上下文注入、实时语音、循环、参与者输入、界面组件更新等运行时操作;Logic Nodes 提供变量赋值与条件控制,把实验分配变量传导到任务配置上。系统分三层解耦:研究者端可视化画布负责创作与预览;参与者端运行时在浏览器渲染界面、在服务端执行已发布的图逻辑并记录交互事件;发布层负责校验、版本化与社区共享。发布时系统校验图定义并锁定为不可变的 Study Version,运行时直接执行这份定义,后续修改只能在新草稿中进行。
核心创新是'一份表示,三重身份':研究者检视的图、运行时执行的程序、发表后可复用可 fork 的工件是同一个序列化对象,从机制上消除了'论文描述'与'实际实现'之间的翻译损耗。第二点是 Study Flow 与 Task Flow 的'分离而耦合':宏观流程(何时分配条件、何时测量)与微观行为(agent 怎么回应、界面怎么变化)各自独立编辑,又通过共享变量显式连接——前测答案可以配置 agent 的人设,任务内的行为可以触发后续测量分支。这使研究者可以只改 agent 行为而保留实验流程,或只改实验设计而保留对话任务,并在同一画布上分辨'哪些被操纵、哪些保持恒定'。第三点是可复现性成为工件的内在属性而非附加文档:每个发布版本不可变,交互记录(点击、滚动深度、输入计时、文本编辑次数,乃至语音录音、遮蔽会话回放、眼动数据)都绑定到确切的 Study Version,审计者看到的配置就是被试实际遭遇的条件。
方法步骤详情
使用 Gricea 的完整流程分四步。第一步创作:研究者在无代码画布上搭建 Study Flow——添加指导语、前测/后测问卷、任务入口、分支与随机化节点;再为每个任务配置 Task Flow——系统提示词、检索上下文、模型参数、工具开关、界面布局与脚手架、模态专属设置;变量节点把条件分配结果接到任务配置上,使'实验操纵如何影响被试所见'在图上可见。第二步预览与校验:研究者以参与者身份试跑可编辑草稿,平台做结构化校验,帮助确认'我想的设计 = 系统将执行的行为';确认后发布,系统锁定图结构、提示词、配置状态与运行时绑定,生成不可变 Study Version。第三步执行与记录:参与者运行时按 Study Flow 推进流程,进入任务时调用对应 Task Flow,浏览器渲染界面并提交操作,服务端按图执行模型调用与界面更新;埋点层按研究配置记录时间戳、点击、焦点、滚动深度、输入计时、编辑次数,可选语音录音、遮蔽会话回放、屏幕录制、文件上传轨迹与眼动数据,全部关联到会话及其版本。第四步复用:他人通过链接以参与者身份体验研究、检视图逻辑,然后 fork 出可编辑草稿,仅改动目标参数(例如只换 RAG 文档库)而保留其余设计,再发布自己的版本;完整研究或局部节点可存为社区模板与文档集合。
技术新颖性
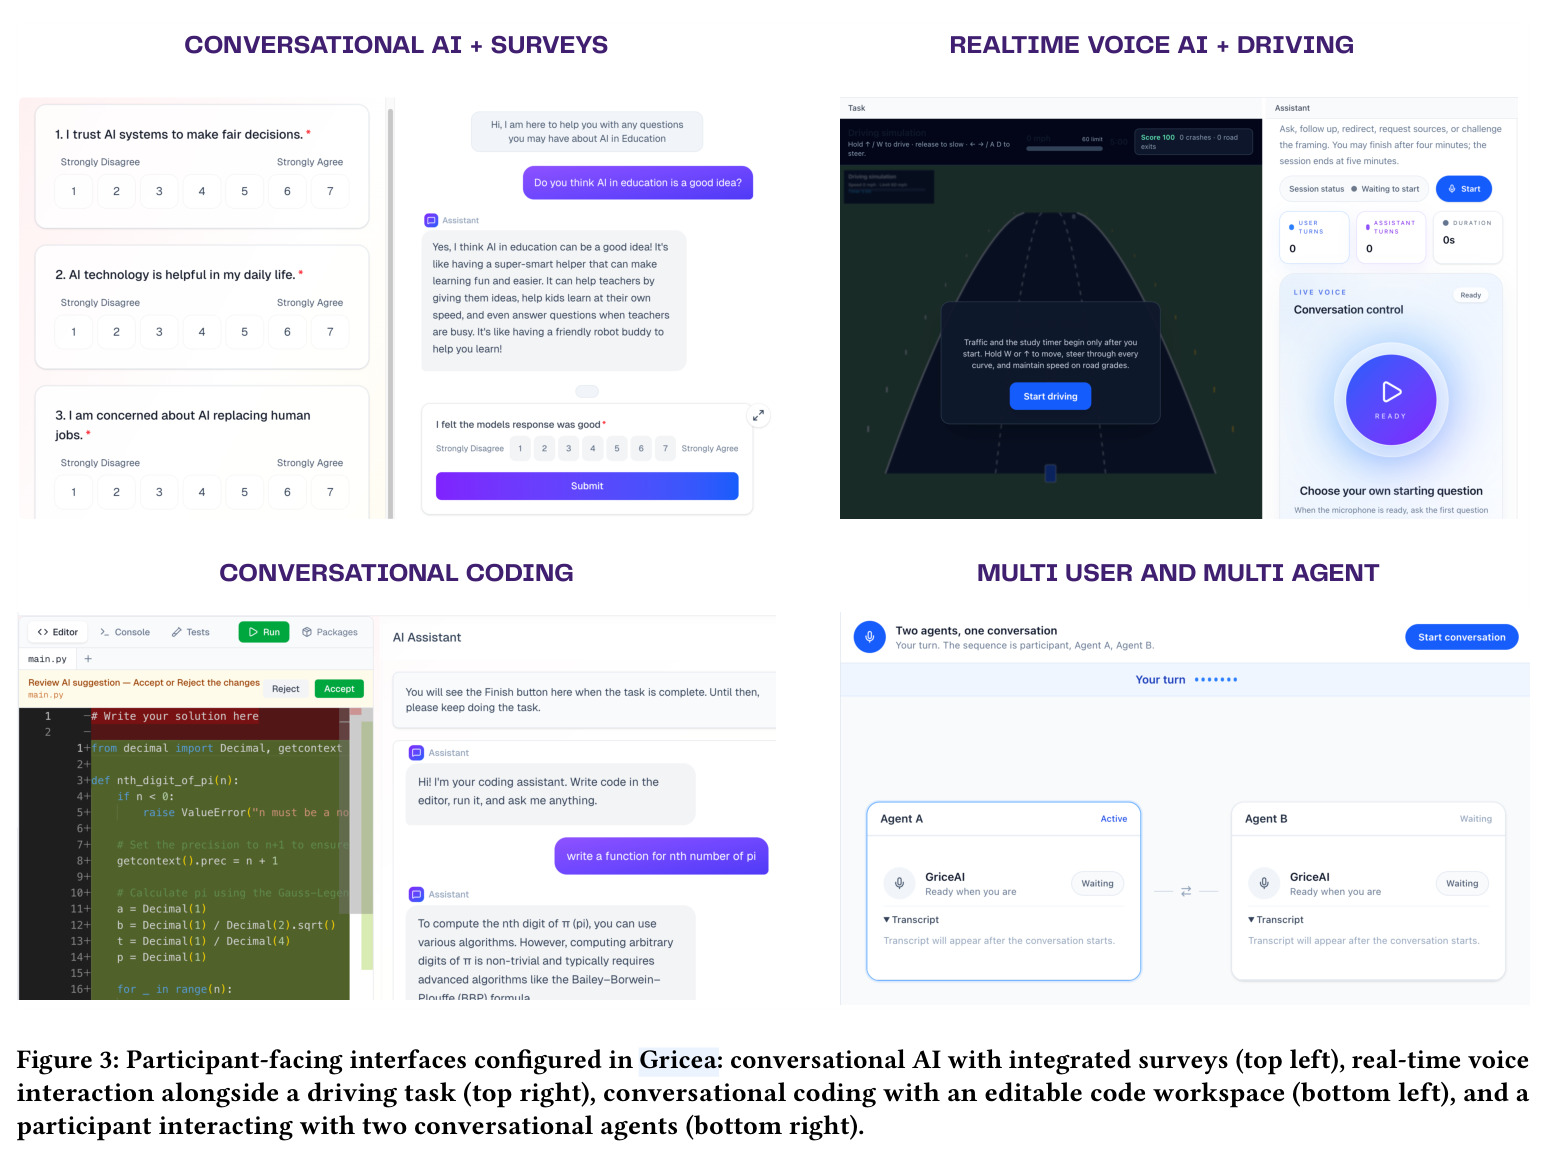
技术新颖性体现在四个方面。一是表示的完备性有实证依据:六维度设计空间(表1)来自对 57 篇论文的系统编码(研究类型、变量、被试数、流程阶段、系统组件、分析方法等),因此抽象不是拍脑袋,而是覆盖了界面、agent、接地、任务、受众、流程的真实操纵范围。二是双重图抽象与既有工具正交:PromptChainer、ChainForge 面向提示词工程,oTree/jsPsych 面向行为实验,Deliberate Lab 面向群组实验,而 Gricea 把实验分配与对话任务逻辑放进同一个可执行表示并保持二者边界,这一'分离而耦合'的结构在文献中尚无系统实现。三是版本-数据绑定机制:交互记录与不可变 Study Version 关联,使设计-实现保真度(design-to-implementation fidelity)变得可检查——一个结构上合法的组内流程也可能歪曲本意的组间比较,只有把配置与执行记录放在一起才能发现这类偏离。四是扩展模型:新任务以节点类型接入,声明可配置属性与交互事件后即自动获得流程控制、发布与埋点能力,无需重建外围基础设施,保证了聊天、语音+驾驶、结对编程、多用户多 agent 等异质界面共享同一套研究机制。
实验结果
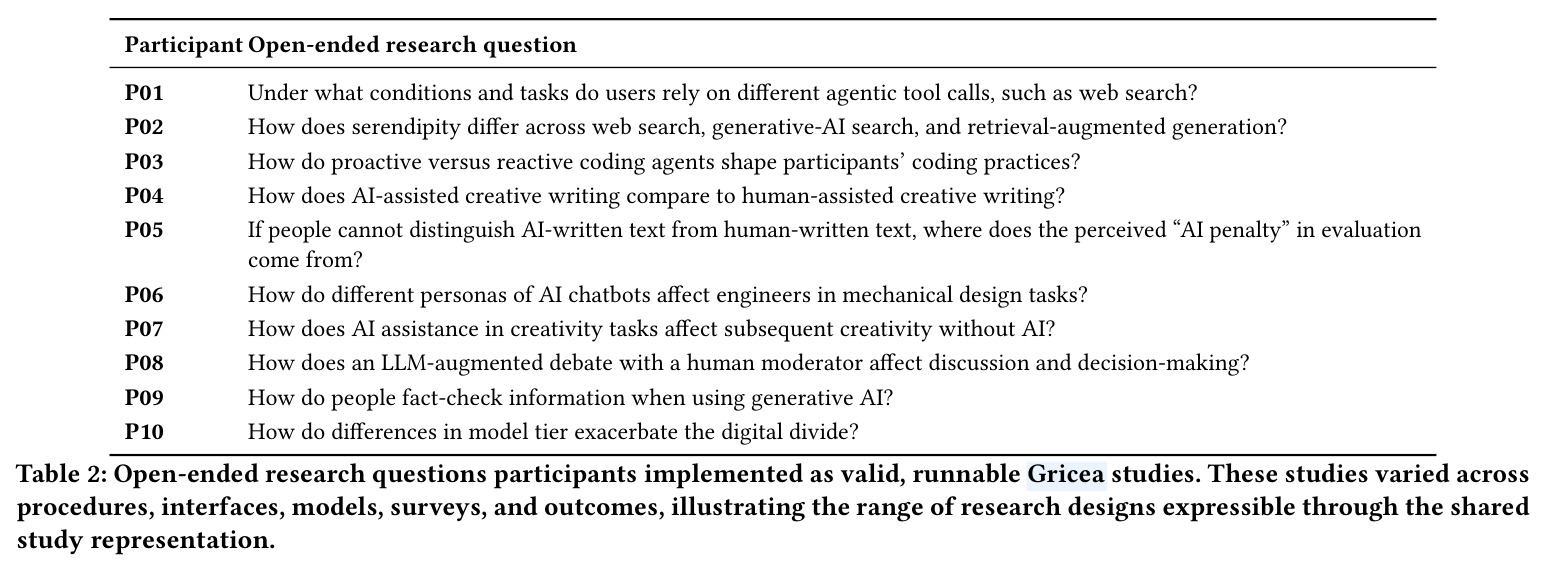
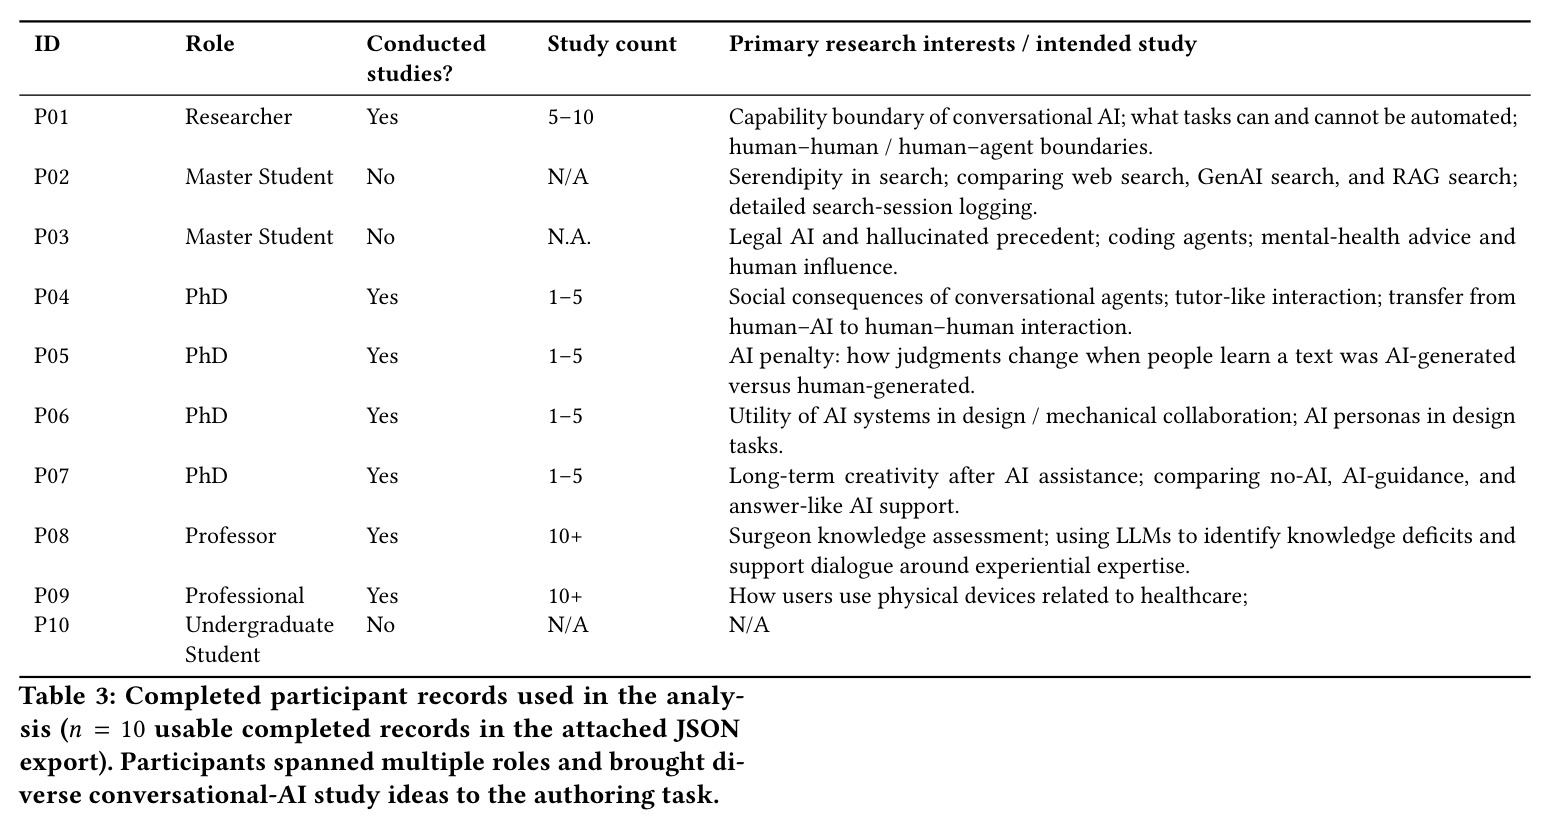
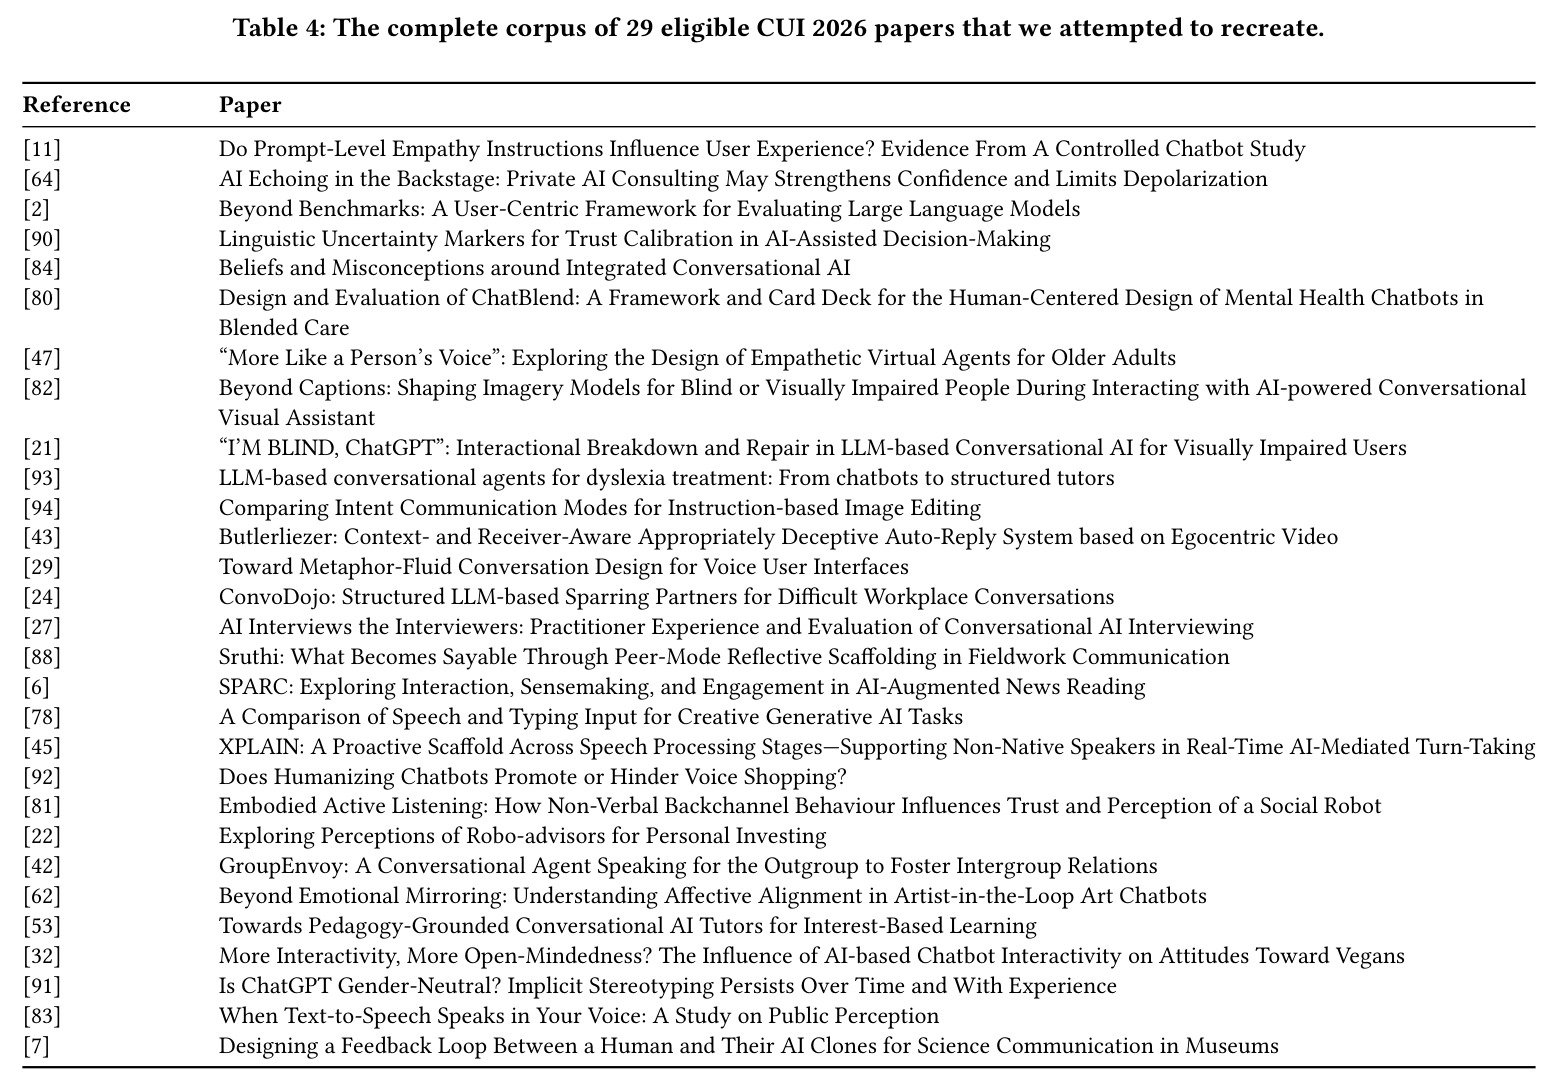
评估分两部分。复现研究(RQ1/RQ3):从 37 篇 CUI 2026 全文中筛出 29 篇含参与者实验的论文(均不在形成性语料内),涵盖实时对话、预录刺激、多模态界面、群组交互与具身 agent。研究团队从论文及附录提取配置并在 Gricea 中重建,结果 27/29(约93%)可复现:10 篇完整复现、17 篇部分复现;其余 2 篇因访谈与问卷材料不可得而失败。同时 28/29(约96%)的论文存在缺失信息:问卷题目或访谈措辞缺失 21 篇、agent 提示词与接地输入缺失 15 篇、刺激材料缺失 11 篇;另有 14 篇依赖外部硬件或系统(机器人、语音克隆管线、线下群组协调)只能部分复现——缺口本身反过来印证了平台的必要性。用户研究(RQ2/RQ4):$N=10$ 名跨学科参与者(4 名博士、2 名硕士生、2 名业界人士、1 名教授、1 名本科生;中位年龄 25–34 岁),在 90 分钟会话中先在指导下完成固定任务(AI 在争议议题上的立场对感知信任的影响),再独立实现自选研究问题。10 人全部产出有效可运行的研究,覆盖 agentic 工具调用、跨搜索范式的意外发现、主动 vs 被动编程 agent、AI 披露惩罚、机械设计人设、双语音 agent 辩论、事实核查行为、模型分层与数字鸿沟等异质题目。量表结果(7 分制):向同事推荐意愿 $M=6.8, SE=0.13$;对他人可靠复现所发布研究的信心 $M=5.9, SE=0.37$;总体易用性 $M=6.1, SE=0.31$;表达力匹配度 $M=5.5, SE=0.40$。P8 估计用 Gricea 可节省'至少 3–6 个月工作量和约 25,000 美元'。摩擦集中在变量与分支逻辑、Study Flow 到 Task Flow 的概念切换以及较高的学习曲线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 复现已发表研究设计(29 篇 CUI 2026 人因实验论文) | 可复现论文数(完整/部分) | 27/29 复现(10 篇完整 + 17 篇部分,约 93%) | 传统流程依赖论文文本重建:28/29 篇存在关键信息缺失,多数研究无法忠实重建 | 把不可复现的研究变成可检视、可执行、可 fork 的工件,并精确定位 2 篇因材料缺失确不可复现 |
| 无代码研究创作(用户研究,N=10) | 向同事推荐意愿(7 分制) | $M=6.8, SE=0.13$ | 现状为自建系统:受访者报告手工编码耗时数周,不会编程者无法自行开展实验 | P8 估计节省至少 3–6 个月工作量与约 25,000 美元;不会编程的 P9 首次能独立搭建研究 |
| 复现信心评估 | 对他人可靠复现所发布研究的信心(7 分制) | $M=5.9, SE=0.37$ | 论文发表后实现细节失散,复现无从保证(28/29 篇存在报告缺口) | 不可变版本与交互记录绑定使配置可审计,为复现提供共同参照系 |
| 研究设计表达力 | 实现自选研究设计的匹配度(7 分制) | $M=5.5, SE=0.40$;10/10 参与者产出有效可运行研究 | 通用实验框架(oTree/jsPsych 等)缺乏对对话式AI任务的一等支持 | 支持聊天+问卷、实时语音+驾驶、结对编程、多用户多 agent 等跨模态界面 |
局限与改进
作者承认三层局限:其一,创作研究仅 $N=10$ 人、单次 90 分钟实验室会话,样本无法覆盖未来用户群体的全部研究实践;其二,评估只触及平台意在支持的方法子空间——重构的在线组件无法覆盖参与式共同设计工作坊、被试自有设备与辅助技术的现场观察、具身 agent 的物理行为等需要线下协调的情形;其三,已发表研究评估限于 CUI 2026 一个会议,不覆盖完整的社会科学实验谱系。我的补充观察有五点:第一,复现由作者团队自行提取与重建,没有独立团队盲测,'93% 可复现'存在自我实现风险,且分母是'有足够细节的 29 篇',已经过滤掉最不可复现的研究;第二,论文未报告平台在大规模真实部署下的性能、成本与运维数据,LLM 调用费用、并发能力、隐私合规仅在临床 PII 场景被一处顺带提及;第三,社区价值(模板复用、跨研究综合、集体知识累积)目前是愿景论证而非实证,完全依赖未来采用;第四,与 Deliberate Lab、ReVISit 等最近邻系统没有对照实验,易用性与时间节省无法归因到具体机制;第五,平台锁定风险未被讨论——实验资产沉淀在 Gricea 的私有表示中,缺乏标准化互操作导出路径。
独立分析的弱点
弱点一:高自由度带来的方法学摩擦已被数据证实——参与者最难掌握分支与随机化节点(P4 称其'令人困惑')、动态插入提示词的变量机制(P1),以及从宏观 Study Flow 切入微观 Task Flow 的概念跳变(P2 称'细节太多,社会科学工作者需要抽象掉复杂性')。改进方向:提供面向常见实验设计的'设计模式'模板(组间/组内/混合),并在画布上对变量未定义、分支不可达等问题做 lint 级实时校验。弱点二:早期 ideation 阶段无支持,P1 指出'研究设计还不具体时用不上 Gricea',而 ideation 恰是决定研究质量与混淆控制的关键阶段。改进:接入可对话的研究设计副驾驶,从模糊问题出发生成候选变量、条件与混淆因子清单。弱点三:统计分析缺位——平台管到数据采集为止,分析仍要外接工具,削弱了'全生命周期工件'的承诺。改进:与 Tea 等声明式统计系统桥接,把假设与检验也纳入版本化工件。弱点四:复现评估的方法学强度不足(作者自评、单一会议、单一团队)。改进:招募多个外部团队对同一篇论文做独立盲重建,报告重建一致性指标,这才是对'可复现'声明的真正检验。
未来方向
作者明确提出三个方向:一是集成 AI copilot,从高层研究问题出发提出初始 Study Flow/Task Flow 配置,或对现有工件提出修改建议,所有提案保留在共享表示内、须经研究者检视、校验与预览后才能发布;二是增加方法学脚手架,帮助研究者在 ideation 期头脑风暴并识别潜在混淆因子,回应'Gricea 目前最适合研究问题已清晰时使用'(P1、P10)的反馈;三是支持 AI 参与者模拟,用模拟被试在正式招募前预演实验路径、检查交互行为、开展先导研究,进一步降低人因实验成本。基于已有成果还可自然延伸:把表示扩展到决策辅助、交互式可视化、教育界面与协作工具等同样具有'分配+测量+响应式任务'结构的在线研究;在社区层面用相互连接的工件追踪假设演化、定位未解决的比较、跨研究综合效应——判断哪些结论针对同一配置、哪些来自有意扩展;以及支持 agent 主导的创作工作流:作者 agent 检索前作、提出受控变异、解释配置变化,人类审核后合入,同时严格区分'帮助做研究的 agent'与'作为实验刺激一部分的 agent'这两类角色。
复现评估
复现难度评估:这是一篇平台/系统论文,核心贡献是系统而非算法。论文未明确声明 Gricea 本身已开源,其主张的复现路径依赖平台机制:已发布研究通过可分享链接提供可执行工件,社区模板与 RAG 文档集合可复用,fork 即可独立复制。评估材料的透明度较高:附录 A.1(表3)给出 10 名参与者的角色、研究经验与选题,附录 A.2(表4)完整列出 29 篇复现语料,复现判定标准(完整 vs 部分 vs 外部依赖 vs 报告缺口)也有明确定义,第三方理论上可以据此重复该复现研究。算力门槛低:平台是 Web 系统,主要外部依赖是 LLM API 调用,无需训练模型;但若想从头重建等价平台,需要实现可视化编辑器、图执行引擎、版本化发布与多模态运行时(聊天、实时语音、代码工作区、多用户协调),属于团队级工程量。总体判断:复现'用 Gricea 做实验'容易(取决于平台对外的可用性),复现'Gricea 系统本身'困难,复现其评估研究难度中等(协议清晰,但需自备平台实例并招募多样化参与者)。
论文图表
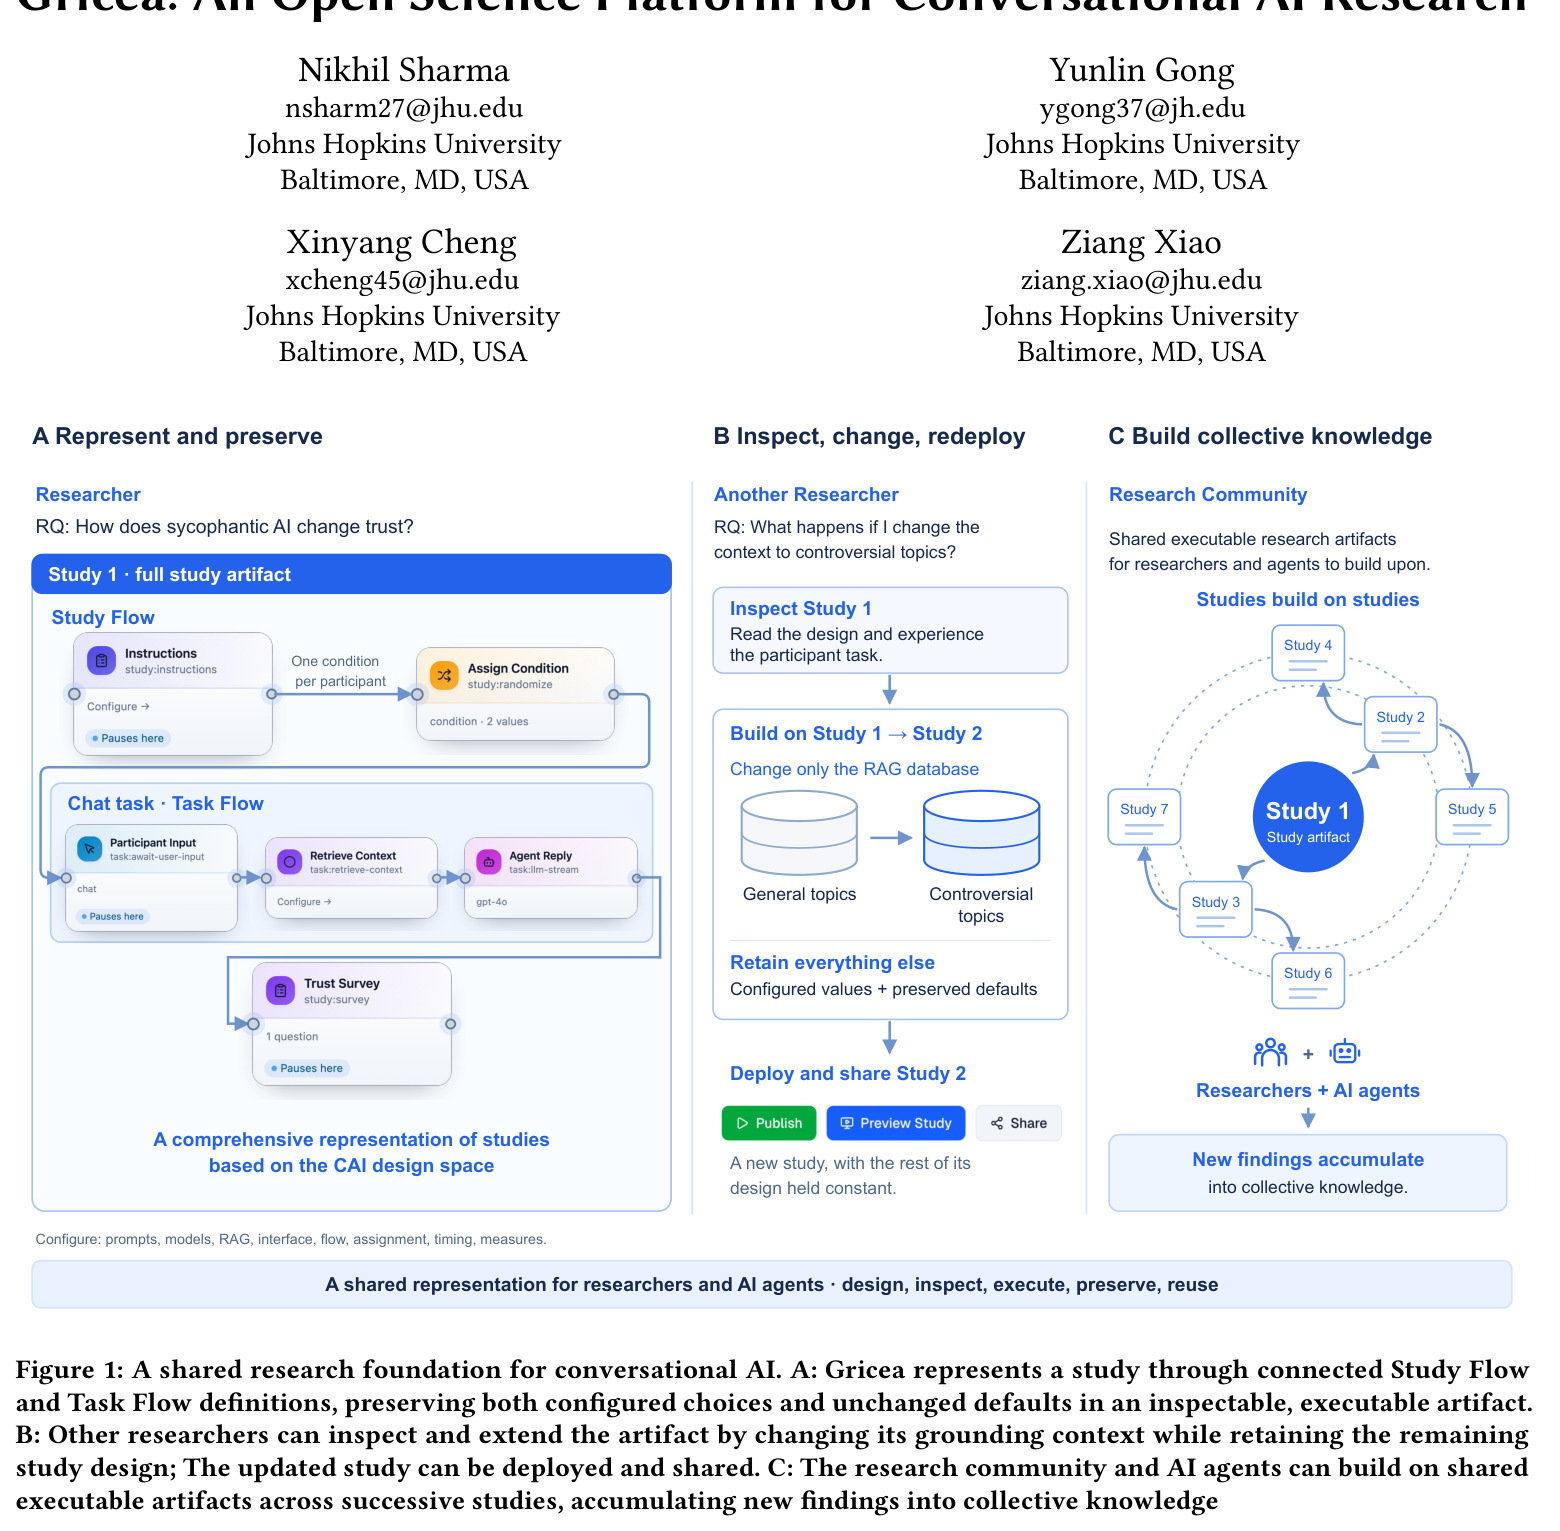
三联概念图。A 部分(表示与保留):Gricea 通过相连的 Study Flow 与 Task Flow 定义表示一项研究,在可检视、可执行的工件中同时保存被配置的选择与未改动的默认值,例如'谄媚性AI如何改变信任'的研究问题连同其完整研究工件。B 部分(检视、修改、再部署):另一位研究者读取原研究的设计与被试任务,只更换 RAG 数据库(从一般话题换成争议话题)、保留其余一切,得到新研究并可部署分享。C 部分(构建集体知识):研究社区与 AI agent 在 Study 1 到 Study 7 的链条上相互构建,使新发现累积为集体知识。
这张图一页概括了全文的论点与复用循环(表示→保留→检视→只改一处→再部署→跨研究累积),是理解 Gricea 愿景、'工件链'复用模式以及 Figure 1 中 A/B/C 三个叙事阶段的总纲,读懂它才能理解后文所有设计决策的服务对象。