面向干细胞显微镜的保持约束式 Cellpose-SAM 训练后量化 Retention-Constrained Post-Training Quantization of Cellpose-SAM for Stem Cell Microscopy
提出预登记保持协议评估量化方案,混合W4/W8达6.76×压缩且176场零灾难失败
前置知识
训练后量化(Post-Training Quantization, PTQ)
PTQ 是在已训练完成的 FP32 模型上直接做低比特压缩的技术族,不需要额外的标注训练数据或重新训练。权重从 FP32(32位)压到 INT8(W8)甚至 INT4/INT2(W4/W2),通常按张量或分组(如 group size 64)计算缩放因子;记号 W8A16 表示权重8位、激活16位,W4A16-G64 表示4位权重按64一组量化。它最贴合实验室 CPU 与边缘设备的部署姿态,因为可在发布后的检查点上直接操作。
本文比较的全部方案(W8A16、W4A16-G64、混合W4/W8、三值W2)都是 PTQ 变体,理解位宽记号与分组量化是读懂所有实验表的前提。
Cellpose-SAM 与流积分解码器
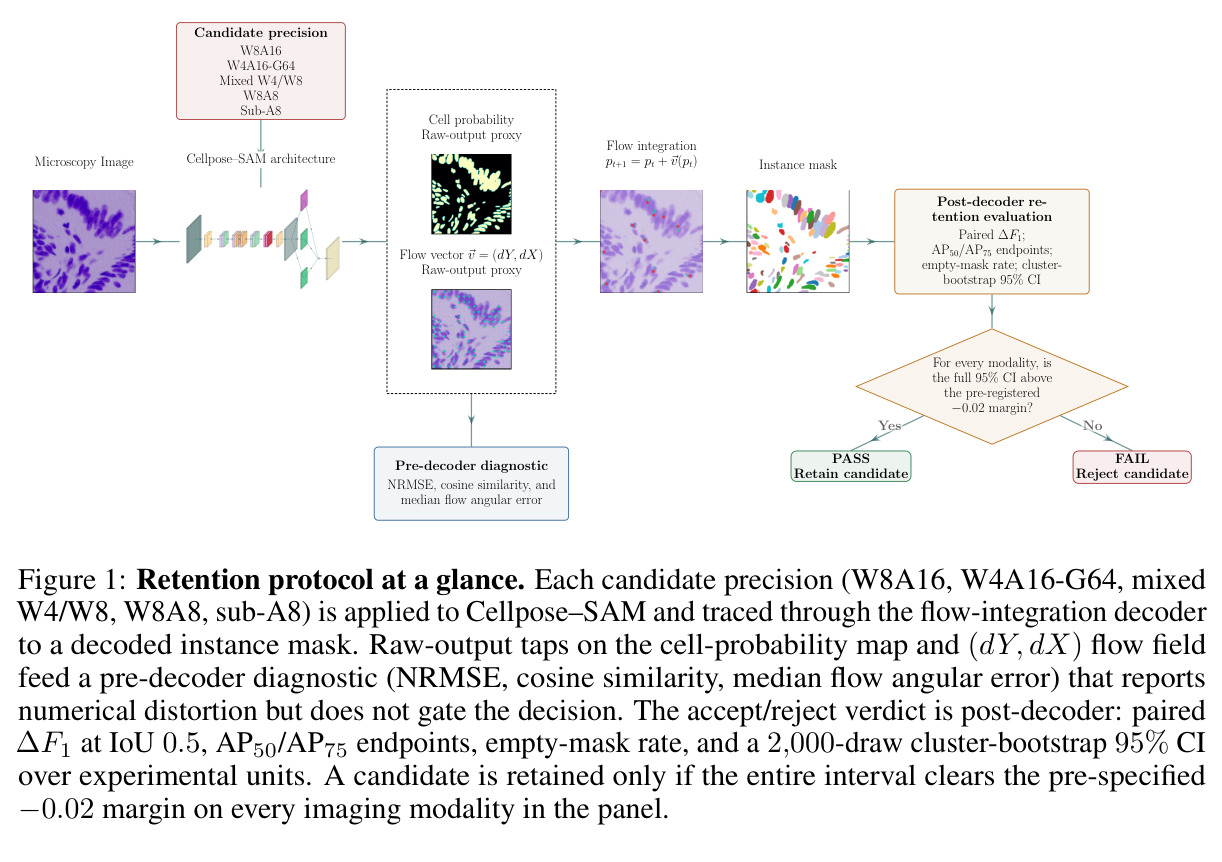
Cellpose-SAM 是把 Segment-Anything 视觉编码器与 Cellpose 的动力学流积分解码器结合的分割基础模型,约3.05亿参数(cpsam_v2 检查点,FP32 存储1162.07 MiB)。它对输入图像输出逐像素的 $dY$、$dX$ 流向量场和细胞概率通道,再通过动力学播种与流积分($p_{t+1} = p_t + \vec{v}(p_t)$)把像素归聚成实例掩码,无需提示点或框即可跨成像模态泛化。
论文评估的就是这个模型的量化版本,判定发生在流积分解码之后的实例掩码层面,理解解码器结构才能明白为什么激活低比特会导致范畴性失败。
簇自助法(Cluster Bootstrap)与置信区间
自助法通过有放回重抽样估计统计量的不确定性;当数据存在聚类结构(同一张源图像切出的多个 tile 相互不独立)时,应以聚类为单位整体重抽样,即簇自助法。本文以107个实验单元(BBBC 场逐场计数,NIST tile 按源图像聚合)为重抽样原子,做2000次抽样构造95%百分位置信区间,用于量化均值变化 $\Delta\mathrm{F}_1$ 的不确定性。
整篇论文的保留判定规则建立在簇自助置信区间上——只有整个CI高于−0.02裕度才算通过,不理解它就无法理解判定的统计含义。
实例分割评估指标(IoU、instance F1、AP50/AP75)
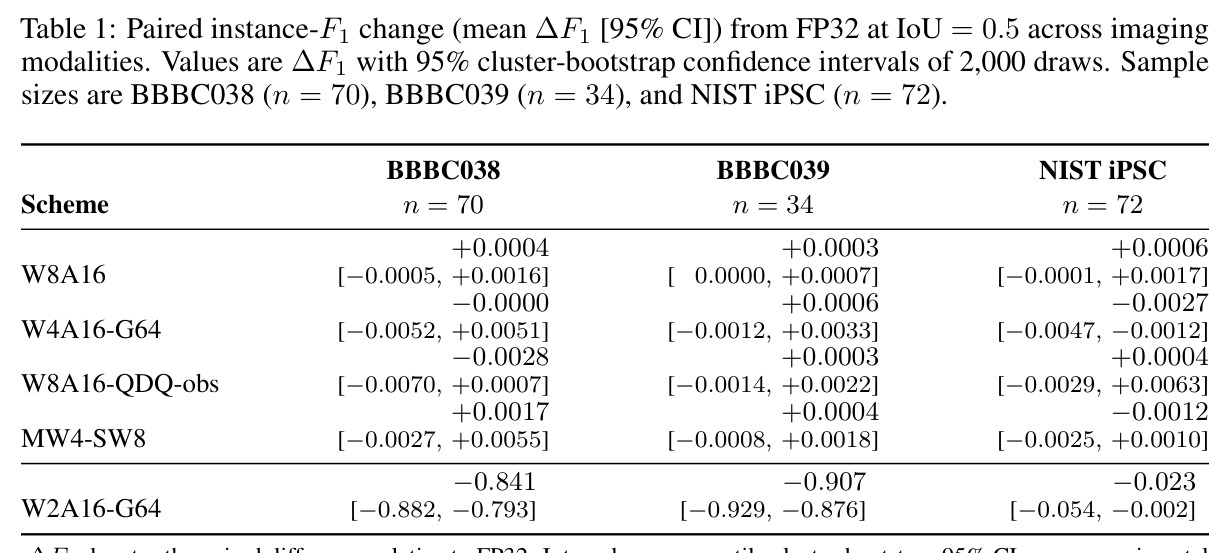
IoU(交并比)衡量预测掩码与参考掩码的重叠程度;instance F1 在 IoU 阈值(本文取 $\text{IoU}=0.5$)下把匹配上的实例视为真阳性,综合精确率与召回率。AP50/AP75 是以0.5和0.75为阈值的平均精度端点,对定位质量更敏感。配对 $\Delta\mathrm{F}_1$ 指同一张图上压缩模型相对 FP32 参考的 F1 差值,能消去数据本身带来的方差。
论文的判定指标是配对 ΔF1 加 AP 端点,表中所有数字都是这些指标相对 FP32 的变化量,是理解 Table 1 与 Table 2 的钥匙。
灵敏度引导混合精度与 rule-of-three 上界
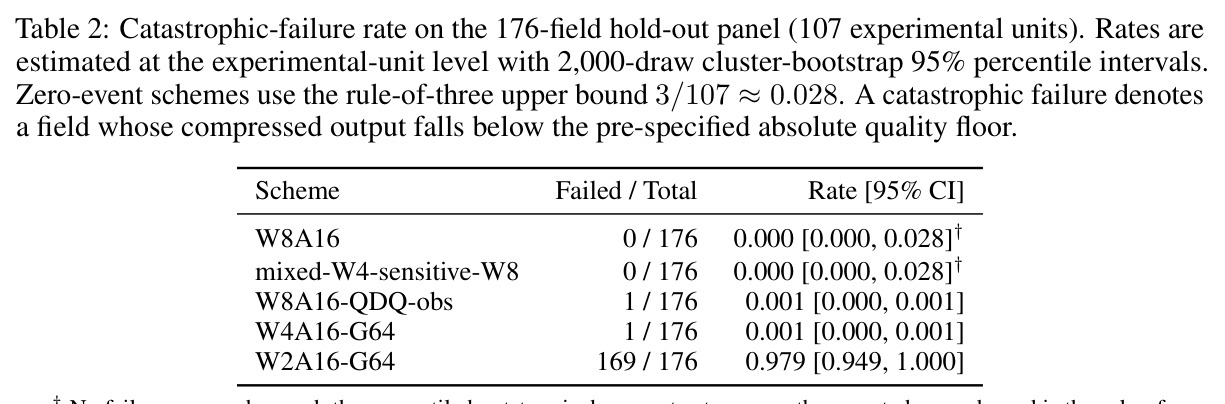
混合精度量化对不同算子分配不同位宽:通过逐算子扰动(把单个 Linear/Conv2d 从 W8 换成 W4 观察指标退化)找出对量化最敏感的算子,仅对它们保留高位宽,其余用低位宽。rule-of-three 是零事件样本的统计上界:若 $n$ 个单元中未观察到失败,失败率的95%置信上界约为 $3/n$,本文即 $3/107 \approx 0.028$,用于替代退化成 [0,0] 的百分位自助区间。
本文最优方案 MW4-SW8 的构造依赖灵敏度分析,而 0/176 失败的表述依赖 rule-of-three,两者都是读懂结论与局限的关键工具。
研究动机
诱导多能干细胞(iPSC)培养的纵向显微分析——密度计数、集落形态描述、汇合度估计——正日益依赖 Cellpose-SAM 这类分割基础模型,但约305M参数的 FP32 检查点(权重存储1162.07 MiB)对实验室工作台、培养箱旁成像站和小型制造车间常见的 CPU 与边缘硬件是沉重负载,而这些场合因物理位置、验证成本或受监管环境控制往往没有 GPU 加速器。压缩因此不是优化而是部署刚需。然而现有压缩评估实践存在两个具体问题:其一,用单一标量精度(如平均 AP)排序方案可能掩盖模态级灾难——一个在荧光核图像上良好、在相差或明场上崩溃的方案,平均分仍可能可观;其二,医学图像分析社区(Maier-Hein 2018、Reinke 2024)早已指出逐像素代理指标与合并报告的陷阱,但压缩领域普遍缺少可让独立审查者重新推导的判定流程,这在受监管的干细胞释放测试场景中不可接受。
本文的目标是本文的目标不是提出新的量化算法,而是建立一套部署导向的预登记保持协议(pre-specified retention protocol),回答一个受监管工作流真正关心的问题:在我实际运行的成像模态上、在我能辩护的裕度下,哪些压缩方案可以安全部署,并留下独立审查者可复现的审计轨迹。协议由四个要素构成:(i)判定标准定义在下游任务指标上——IoU=0.5 的配对 instance F1 加 AP50/AP75 端点,而非输出张量代理;(ii)裕度固定为相对 FP32 平均变化不低于 $-0.02$,且在任何保留集数据被检查之前预先确定;(iii)对每个(方案,成像模态)组合给出独立判定,用2000次抽样的簇自助95%置信区间,保证一个模态上的通过不能掩盖另一个模态上的失败;(iv)发布审计工件,让下游用户可在自己的数据上重新推导判定结论。
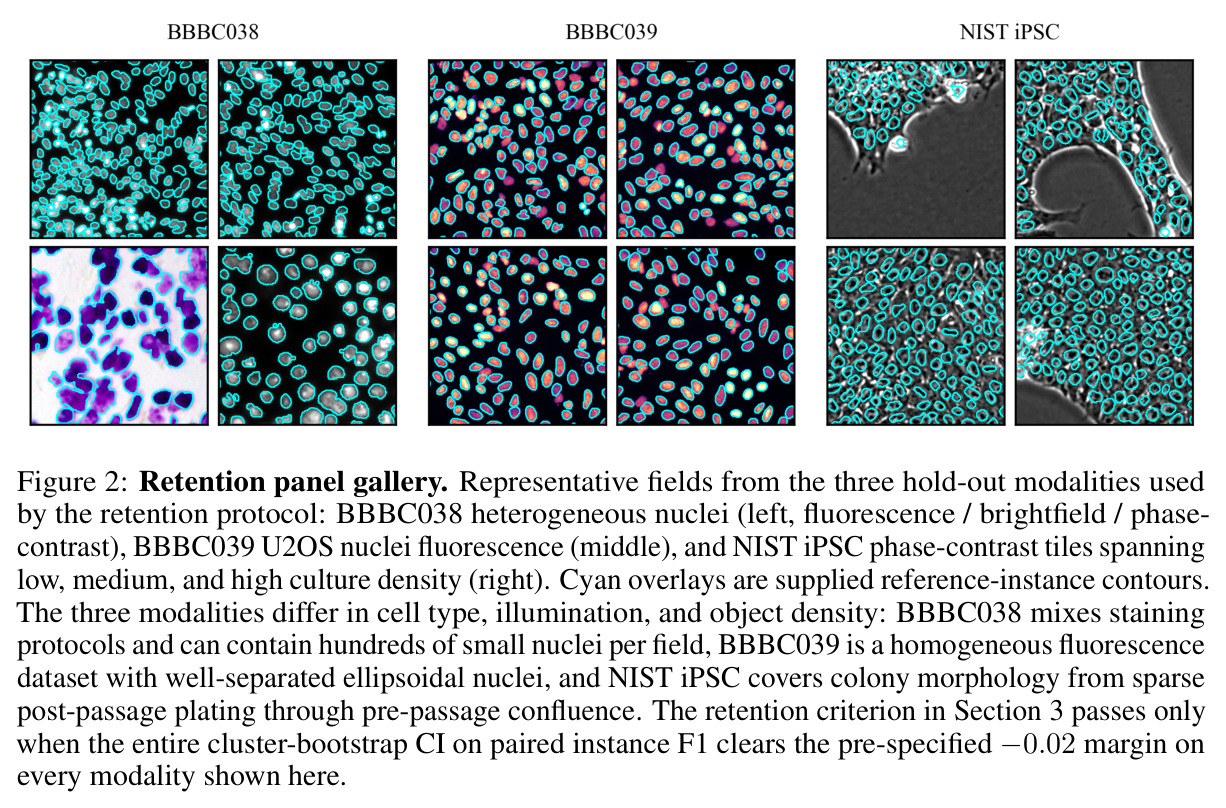
与已有工作不同的是,本文的独特切入角度是把压缩文献惯用的精度-压缩比单一权衡,重构为受监管干细胞成像中的审计式保留判定问题。与 AdaRound、BRECQ、GPTQ、AWQ 等追求极低比特的方法不同,作者把预注册(Nosek 2018)与可复现性报告(Pineau 2021)的规范移植到模型压缩验收:构建分层176场保留面板覆盖三种模态(BBBC038 n=70 核染色混合荧光/明场/相差,BBBC039 n=34 U2OS 荧光核,NIST iPSC n=72 跨低/中/高培养密度),以107个实验单元为重抽样原子,用整条CI必须高于 $-0.02$ 裕度的保守规则取代点估计比较。它还同时报告灾难性失败率——压缩输出跌破绝对质量下限的场占比——并用 rule-of-three 上界诚实区分在该样本量下未观察到失败与失败率为零,这两点在压缩论文中都属罕见。
核心方法
直觉上,一个量化方案是否安全,不取决于它平均掉了多少数值误差,而取决于每个真实成像模态上最坏情况的统计证据是否仍越过可辩护的下限。技术路线分四步。第一步固定评估对象:Cellpose-SAM(cpsam_v2,约305M参数,FP32 存储1162.07 MiB),输出逐像素 $dY$、$dX$ 流向量与细胞概率通道,经动力学流积分解码为实例掩码。第二步构建分层176场保留面板(BBBC038 n=70、BBBC039 n=34、NIST iPSC n=72),与灵敏度分析、比特分配、校准所用的开发集严格不相交;样本量按 Varoquaux & Colliot (2022) 与 Islam (2018) 启发式设计,目标CI宽度约4%;簇自助以107个实验单元为重抽样原子,正确处理 NIST tile 间的不独立性。第三步对每个候选精度(W8A16、W4A16-G64、混合W4/W8、校准W8A16-QDQ-obs、三值W2A16-G64)计算配对 $\Delta\mathrm{F}_1$ 的2000次簇自助95%CI,整条区间高于 $-0.02$ 裕度才判通过。第四步补充灾难失败率与机制诊断(NRMSE、检查点级损伤定位、位扫描),形成可审计的判定包。
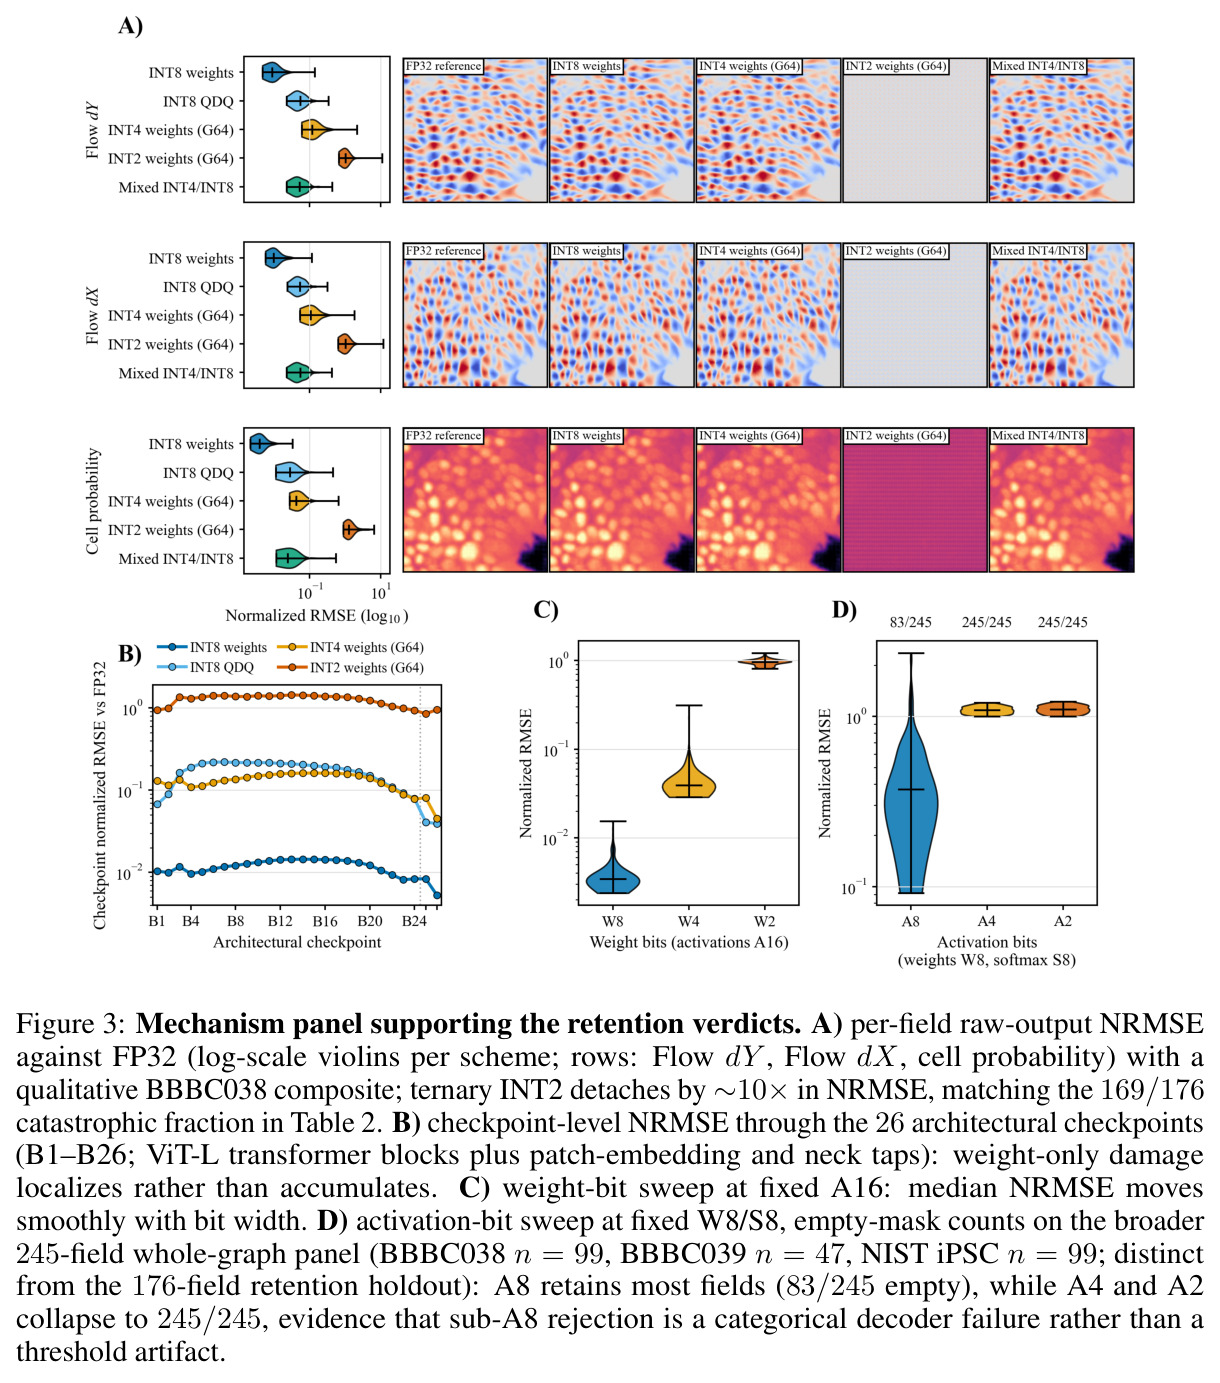
核心创新是保持约束的判定框架:把压缩方案的验收从输出张量层面的数值保真(NRMSE、余弦相似度等代理指标),移到解码后任务层面的配对下游指标,并用预登记裕度与逐模态CI门控。原始输出诊断——细胞概率图与 $(dY,dX)$ 流场上的 NRMSE、余弦相似度、中位流角误差——只作为诊断性证据报告数值畸变发生在哪里,但明确不参与门控,这直接回应了医学图像分析社区对逐像素代理误导性的批评。第二个关键设计是簇自助:以实验单元而非场为重抽样原子,使同一源图像切出的 NIST tile 被整体重抽样,避免伪独立导致的CI过窄。第三个设计是失败率的双重报告:零事件时百分位自助退化,改用 rule-of-three 上界 $3/107 \approx 0.028$,把最强声明限定为在该样本量下未观察到失败而非失败率为零。保留与拒绝因此都有明确的统计语义:任何模态上整条CI跌破裕度即 FAIL,一个模态的通过无法掩盖另一个模态的失败。
方法步骤详情
步骤一(面板构建与预登记):组装176个留出场——BBBC038 70场(跨荧光/明场/相差)、BBBC039 34场(U2OS 荧光核)、NIST iPSC 72场(低/中/高密度,聚合自3张源图像,共107个实验单元);$-0.02$ 裕度在任何保留集评估前固定。步骤二(候选压缩):实现权重仅 W8A16、W4A16-G64(组大小64)、三值 W2A16-G64、带激活 QDQ 仪表的权重打包 W8A16-QDQ-obs,以及灵敏度引导混合方案——在开发集上对100个合格 Linear/Conv2d 算子做逐算子 W4 扰动,把最敏感的4个算子(blocks.0.mlp.lin2、blocks.23.attn.qkv、neck.2、out)保留在 INT8,其余用 W4。步骤三(诊断测量):每场记录原始输出的 NRMSE/余弦相似度/中位流角误差,以及26个架构检查点(B1–B26)处的 NRMSE。步骤四(保持判定):对每个(方案,模态)计算 IoU=0.5 配对 $\Delta\mathrm{F}_1$、AP50/AP75 端点与空掩码率,做2000次簇自助;整条95%CI高于 $-0.02$ 判 PASS,否则 FAIL,并报告实验单元级灾难失败率CI。
技术新颖性
技术新颖性不在量化算法而在评估科学。现有PTQ文献以困惑度或平均精度排序方案,本文首次把预注册、分层判定与审计工件发布整合为压缩验收协议:裕度先行、逐(方案,模态)判定、rule-of-three 处理零事件,三者的组合为压缩部署提供了统计学上诚实的表达。混合方案本身(4个INT8例外)是标准灵敏度分析的工程化应用,但把它嵌入压缩-保持联合判定并与 0/176 失败绑定,形成 6.76× 压缩下与 W8A16 并列的最强保持,是新的实证结论。机制分析(Figure 3)同样有独立价值:26个检查点的 NRMSE 显示权重仅量化损伤局部化而非累积;权重位扫描显示中位 NRMSE 随位宽平滑移动;激活位扫描显示 A8 时245场整图面板尚有83场空掩码、A4 与 A2 时245/245全部空掩码——证明亚 A8 是解码器的范畴性失败而非阈值伪影。这类把统计判定与张量级、编码块级物理印记对应起来的证据链,在压缩评估论文中几乎未见。
实验结果
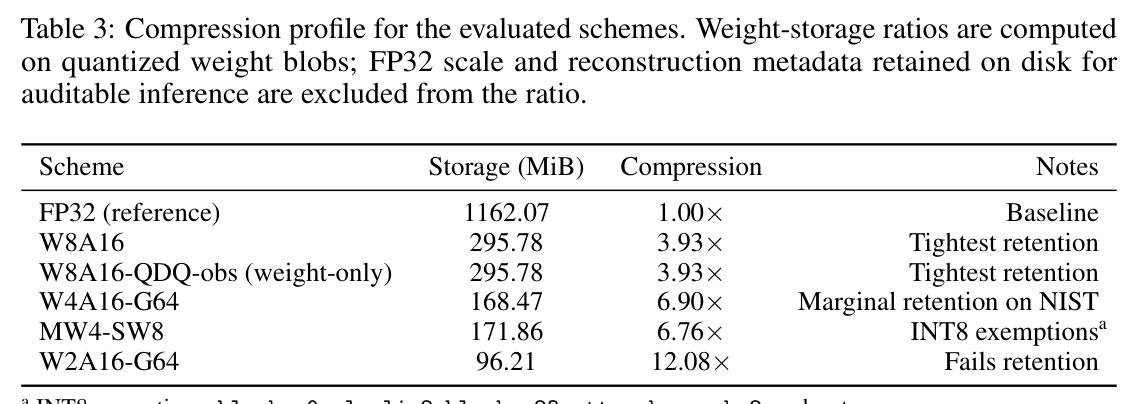
核心结果由三张表构成。Table 1(配对 $\Delta\mathrm{F}_1$ 及2000次簇自助95%CI):W8A16 三模态 $\{+0.0004, +0.0003, +0.0006\}$,CI 全落在 $[-0.001, +0.002]$ 内;W4A16-G64 为 $\{-0.0000, +0.0006, -0.0027\}$;W8A16-QDQ-obs 为 $\{-0.0028, +0.0003, +0.0004\}$;混合 MW4-SW8 为 $\{+0.0017, +0.0004, -0.0012\}$,四者所有模态均通过 $-0.02$ 裕度。三值 W2A16-G64 灾难失败:BBBC038 上 $-0.841\,[-0.882, -0.793]$、BBBC039 上 $-0.907\,[-0.929, -0.876]$;NIST 臂因 FP32 本身下限受限仅 $-0.023\,[-0.054, -0.002]$。Table 2(灾难失败率,107实验单元):W8A16 与混合方案均 0/176(rule-of-three 上界 $3/107 \approx 0.028$);QDQ-obs 与 W4A16-G64 各 1/176;三值 169/176,率 $0.979\,[0.949, 1.000]$。Table 3(压缩比):W8A16 3.93×(295.78 MiB)、W4A16-G64 6.90×(168.47 MiB)、混合 6.76×(171.86 MiB)、三值 12.08×(96.21 MiB)。结论:混合方案以 6.76× 压缩与 W8A16 并列最强保持,是面板首选;三值在任何压缩优势下都不可用。
局限与改进
作者承认三点局限:判定仅覆盖面板模态,不能外推到3D体显微、长时间间隔延时相差或非核染色等不同统计特性的模态;$-0.02$ 裕度适合可吸收有限每模态 F1 下降的监测流水线,监管释放测试需要更紧裕度,协议可扩展但判定不可移植;通过的比特宽度与算子选择是 Cellpose-SAM 无提示流积分解码器的属性,不能直接迁移到掩码 token 或 U-Net 解码器,可移植的是协议本身。我的补充观察:NIST iPSC 臂聚合自仅3张源图像且 FP32 在高密度下本身不可靠(AP@0.75/0.90 逼近下限),该臂的通过只证明协议能正确标记下限受限模态,不证明压缩保持了 iPSC 检测质量;表格只报告权重存储压缩比,未测 CPU 端推理延迟、内存带宽或吞吐,而这恰是实验室部署叙事的核心指标;W4A16-G64 与 QDQ-obs 各自那1例失败场未被个案剖析;此外未与 GPTQ/AWQ 等现代PTQ配方对比,也没有多检查点或多种子的稳健性数据。
独立分析的弱点
第一,NIST 模态的实验单元仅3张源图像,簇自助在该臂的有效样本极小,CI 宽度与 rule-of-three 上界0.028的置信力都建立在这一脆弱的原子数上;改进方向是纳入多来源 iPSC 数据集(如细胞疗法制造方的图像)扩大实验单元数。第二,FP32 参考在高密度 iPSC 上本身不可靠,使所有方案在该臂的判定缺少真正参照,保持结论是必要非充分;改进方向是按作者自己的建议构造 FP32 能检出实例的 NIST 类比臂。第三,评估止于统计判定,缺部署侧证据:INT8 与 INT4 权重在真实 CPU(如支持 VNNI 的 AVX-512)上的端到端延迟与吞吐差异完全未测;改进方向是补齐推理基准,否则 6.76× 存储收益无法直接换算为运维收益。第四,灾难失败依赖一个预指定绝对质量下限,论文未给出其数值定义,也未对下限选择做敏感性分析;改进方向是公布定义并展示判定随下限变化的稳健性。第五,单一检查点、单次评估,无检查点间或种子间方差,W4A16 与 QDQ-obs 的1例失败究竟是孤立噪声还是系统性边缘行为的线索,无从判断。
未来方向
作者提出的方向:协议本身是可移植元素——为具体下游用途选择保持目标、构建覆盖部署相关分布轴的分层面板、定义物理上有意义的实验单元、建立审计工件发布路径;更换解码器、模态或裕度时,比特选择应重新推导而非继承。基于本文成果可延伸的研究:把保持协议扩展到量化感知训练(QAT)与结构化剪枝,检验同一裕度框架能否同样淘汰激进压缩;利用 Figure 3B 损伤局部化的发现,把逐块 NRMSE 作为代价模型做混合精度自动搜索(如整数规划分配 W4/W8);研究流积分解码器对激活量化的鲁棒性来源,解释 A8 与 A4 之间的范畴性分界;把审计工件做成可验证发布(注册报告加面板哈希锁定),对接 GxP 类监管流程;最后在真实延时培养数据上做前瞻验证,量化压缩对传代决策时机与释放测试计数的影响,这才能闭合从统计判定到临床/生产后果的证据链。
复现评估
可复现性基础较好:面板全部来自公开数据(BBBC038、BBBC039、NIST iPSC),方案均为标准 PTQ 实现(权重打包+分组量化+QDQ 仪表),混合方案的4个 INT8 例外算子(blocks.0.mlp.lin2、blocks.23.attn.qkv、neck.2、out)被显式列出,Table 3 说明了 FP32 scale 与重建元数据保留在盘但不计入压缩比,论文还承诺发布审计工件使下游用户可在自有数据上重新推导判定。不足是正文未给出代码或权重链接、簇自助实现细节、灾难失败下限的数值定义,以及开发集规模与校准样本量。算力门槛低:PTQ 与评估在单卡 GPU 或多核 CPU 上即可完成,主要计算成本是2000次自助重抽样乘以176场的掩码解码。总体复现难度中等:数据公开、协议描述完整,但需要自行实现量化流水线与统计代码,并仔细对齐107个实验单元的重抽样定义。
论文图表