TAPe+ML:面向多任务计算机视觉的紧凑结构化表示 TAPe+ML: A Compact Structured Representation for Multi-Task Computer Vision
用预结构化的 TAPe 表示替代原始像素,以不足 10 万参数统一实现分类、检测与分割
前置知识
像素张量表示与卷积网络(CNN)
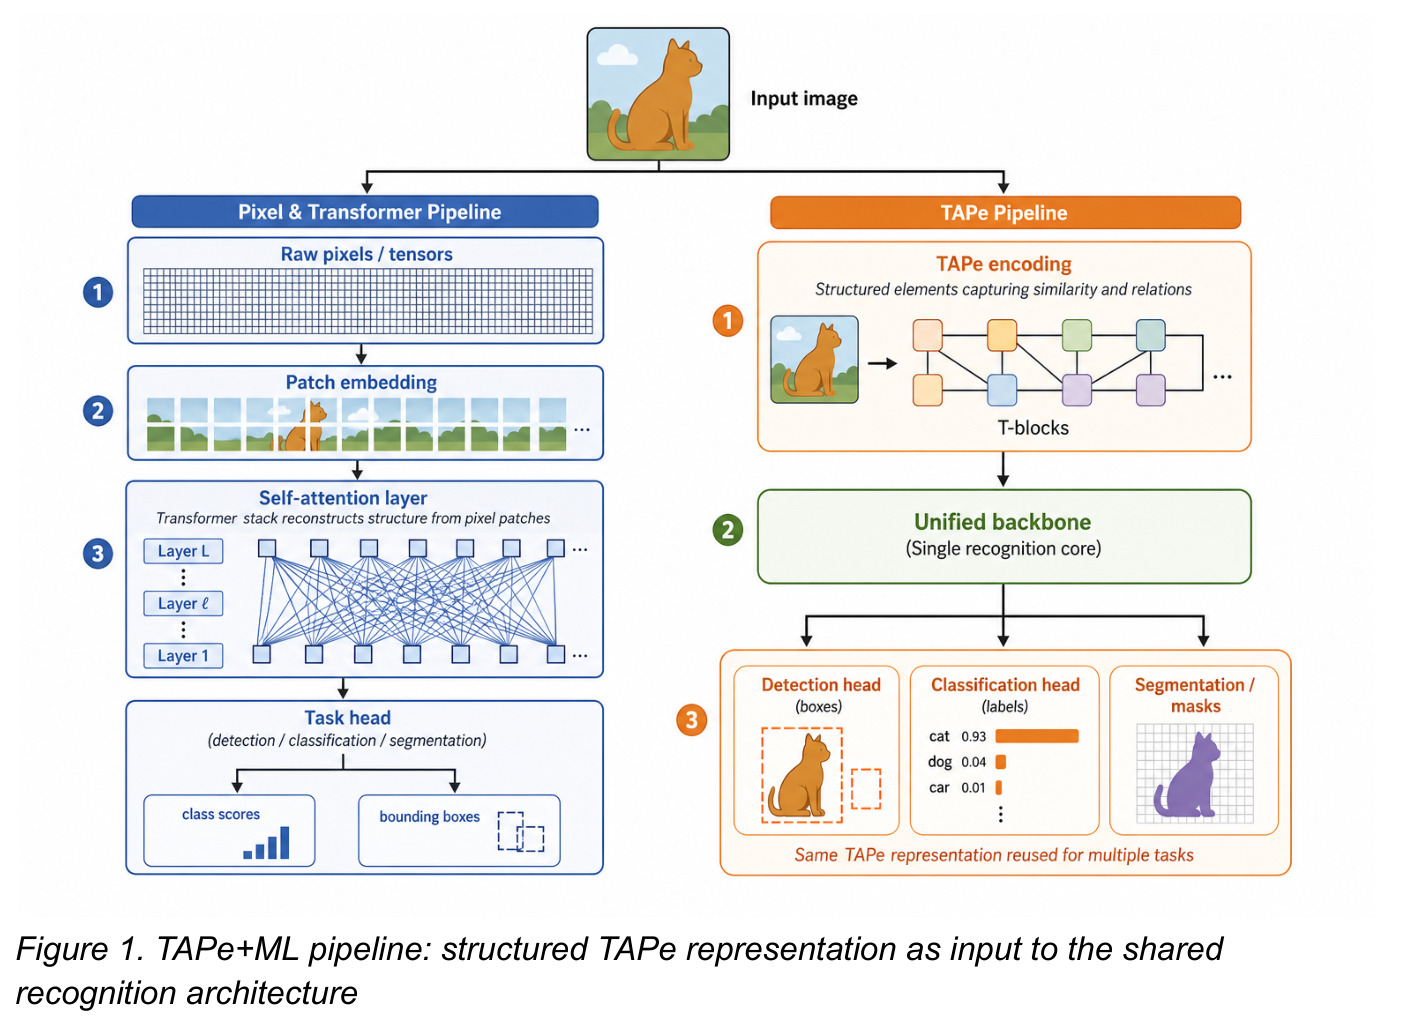
现代视觉模型把图像读成 $H\times W\times 3$ 的数值张量,每个像素 $I(x,y)$ 只存局部亮度或颜色。CNN 用层层堆叠的卷积核在像素上滑动,逐层提取边缘、纹理等特征并扩大感受野,模型需要自己从原始数值中重建图像结构(轮廓、形状、物体归属)之后才能解决目标任务。
本文全部出发点是批判这种表示:它让模型同时承担重建结构完成任务两个负担。理解像素张量的冗余与无结构,才能理解 TAPe 为何能把参数压到 10 万以下还能保持精度。
Vision Transformer 与全局自注意力
ViT 把图像切成 patch 序列,通过自注意力 $\mathrm{Attention}(Q,K,V)=\mathrm{softmax}(QK^\top/\sqrt{d})V$ 让任意两个 patch 直接交互以建模全局依赖,代价是平方复杂度和对大规模预训练的强依赖,DINOv2 这类基础模型用了 1.42 亿张图像。
论文的核心论断之一是:一旦相关结构已嵌入输入表示(TAPe),全局注意力就不再必要,因此 TAPe+ML 完全抛弃了 transformer。理解自注意力解决什么问题,才能评估这一论断的分量。
mAP 与 IoU 评价体系
IoU(交并比)衡量预测框与真实框的重叠程度;mAP50 是 IoU$\ge$0.5 时各类别平均精度的均值,mAP50-95 是 IoU 从 0.5 到 0.95 以 0.05 步长取 10 档阈值的平均,对定位精度敏感得多。实例分割用掩码版本的 Mask AP。
检测与分割实验的全部结论都建立在这套指标上;论文关于小目标紧框精度受限的局限性讨论,正是围绕 mAP50-95 中最严格的 IoU 区间展开的。
k-means 聚类与原型分类
k-means 迭代地把样本分配到最近簇心并更新簇心,最小化 $\sum_i \|x_i-\mu_{c(i)}\|^2$。原型分类用簇心作为类别的代表点,新样本按与原型的距离判类,无需训练带参数的线性分类层,也不需要梯度下降和学习率。
TAPe+ML v3 的分类组件完全去梯度化:类别由 TAPe 空间中的 k-means 原型匹配决定,每类可有多个原型。这是论文消除学习率超参依赖、并额外获得约 3 个百分点提升的关键设计。
自监督学习(DINO/iBot)
不用人工标签,通过构造预文本任务学习视觉表征:DINO 用教师-学生自蒸馏使不同视图的表征一致,iBot 在此基础上增加掩码 patch 预测。此类方法通常需要海量数据,如 DINOv2 用 1.42 亿张图才学到强表征。
论文用了一个方法学上很干净的对照实验:保持 DINO/iBot 架构不变,只把输入从像素换成 TAPe 数据,iBot 损失从约 2.46(12 万张图仍不收敛)降到 0.406(仅 9 千张图),这是支撑 TAPe 表示有效性的独立证据。
分布偏移(OOD)与领域自适应
训练分布与部署分布不一致导致性能骤降的现象,例如在 COCO(人、车、动物等日常场景)上训练的模型遇到工业传送带矿石图像时失效。应对策略按改动范围分为只调输出头、重建骨干内部表征、从头训练三档。
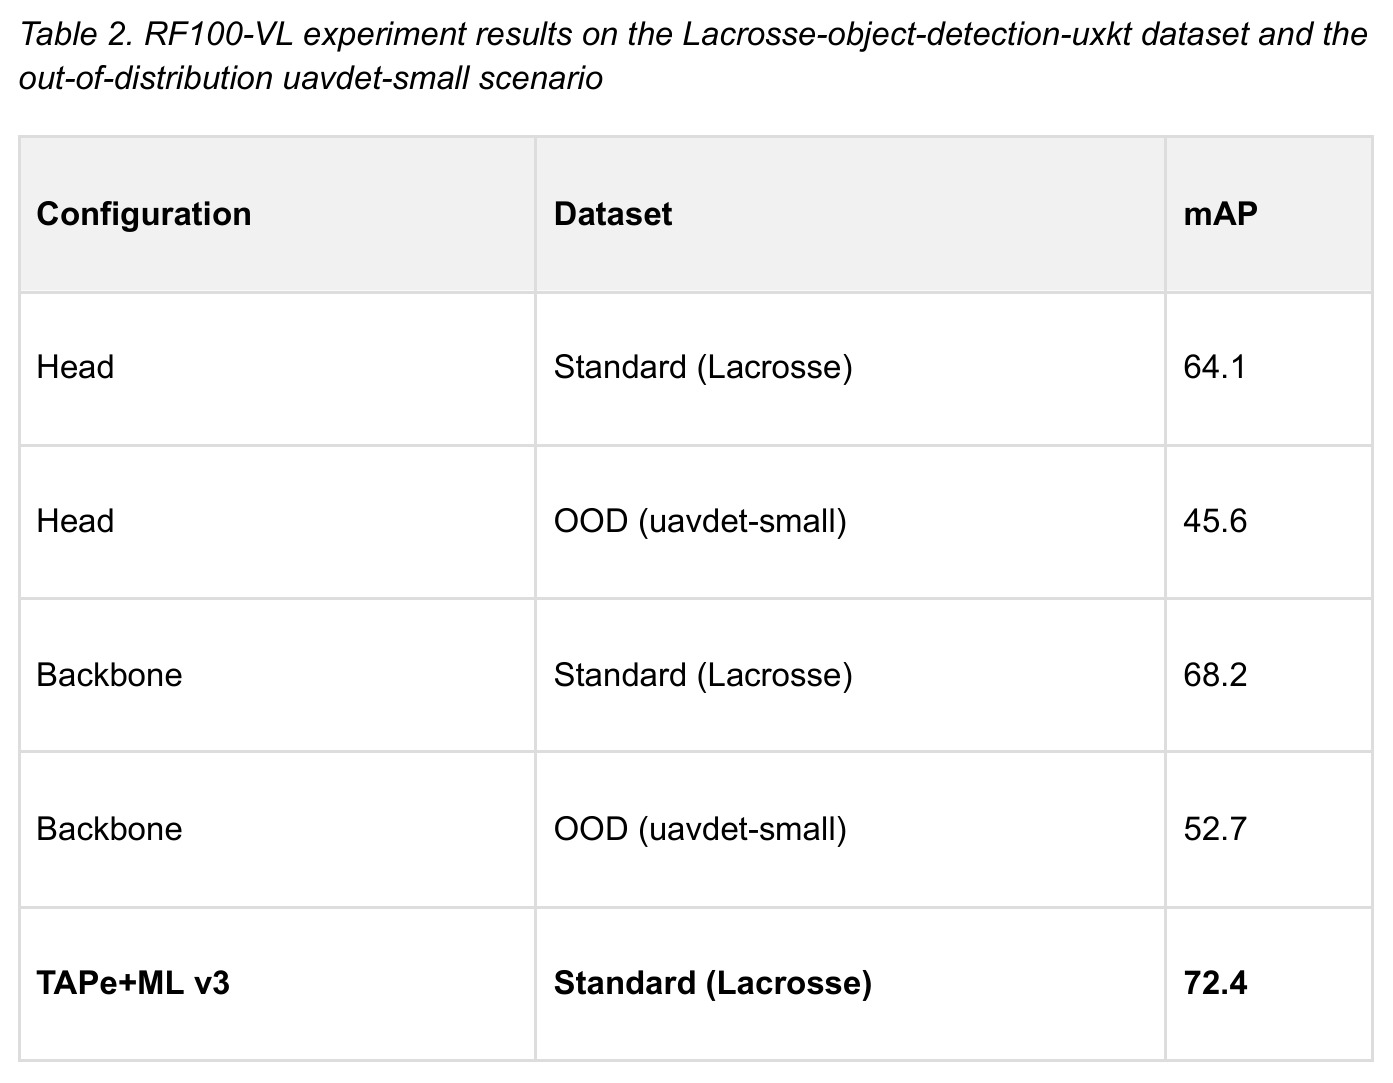
工业试点与 RF100-VL 实验都是 OOD 场景,论文提出的 head-only / backbone adaptation / from-scratch 三种适配模式正是针对它的分级解决方案,COCO 偏置概念也是由此引出的核心消融结论。
研究动机
工业界的计算机视觉往往由彼此独立的模型堆叠而成:一个骨干负责分类、另一个负责检测、第三个负责分割,输入输出格式与基础设施互不相通,大公司通常要维护 5-10 条流水线。即便是 YOLO、RF-DETR 这类一体化检测器也未能真正统一:各任务并行训练,分割不会反哺检测,RF-DETR 2XL 还依赖一个在 ImageNet 上预训练的巨型骨干来支撑整体运行。更深层的问题在像素表示本身:像素只存局部亮度或颜色,模型被迫同时做两件事——从本质上任意的数字重建图像结构,以及解决目标任务。论文给出的数字很直观:DINOv2 需要 1.42 亿张图像训练,正是因为像素天然不稳定;COCO 把面积小于 $32^2$ 像素的目标定义为小目标,而一个 30×50 像素的 RGB 区域含 1500 个像素,8 位编码下有 $256^{4500}$ 种原始取值组合,模型必须见过海量视觉变体才能归纳出稳定规则。其结果是数据、标注与算力成本居高不下,小参数量模型在 ImageNet-1k、COCO 级别基准上几乎没有竞争力,而头部模型的参数量已膨胀到 1B-7B 量级。
本文的目标是论文想验证一个反主流的假设:如果在识别阶段之前就提供一个结构化的感知表示,让视觉元素之间的相似与差异关系在输入层面已经明确定义,那么下游识别模型可以缩小几个数量级而性能不降反升。具体拆成四个可检验的目标。第一,用单一的 TAPe 感知空间加共享识别核心,统一覆盖分类、检测、实例分割三类任务,替代各自为政的骨干网络与流水线。第二,在 ImageNet-1k、COCO、LVIS、RF100-VL 等标准基准上,以不足 10 万参数的系统达到甚至超越 RF-DETR 2XL(126.9M 参数)等强基线。第三,大幅压缩数据需求:新类别只需约 20 张标注图、一分钟内完成重训,并配套 auto-annotate 半自动标注机制(10-15 张种子图起步)进一步降低落地门槛。第四,在真实 OOD 场景——传送带矿石堵塞检测的工业试点——中验证跨域迁移能力,证明紧凑架构的价值不只在学术基准上成立,而是能迁移到与 COCO 分布完全不同的生产环境。
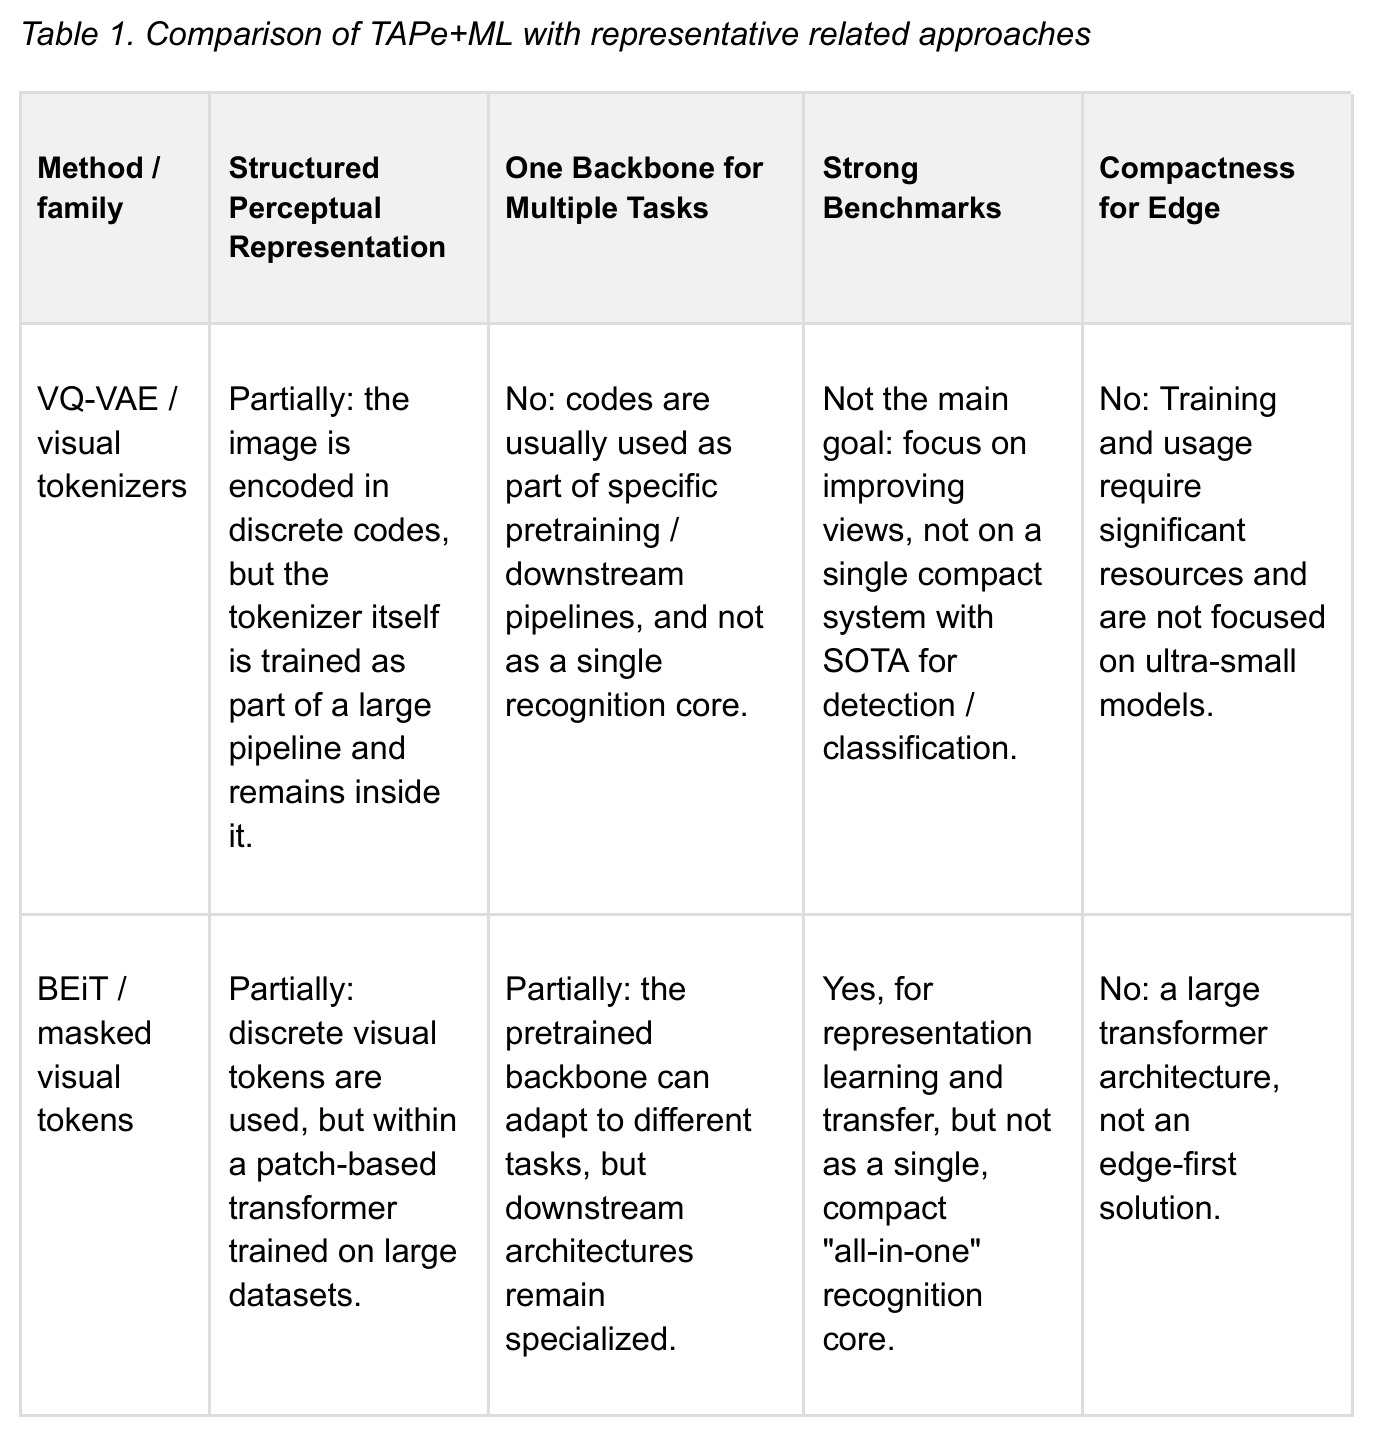
与已有工作不同的是,现有路线各占一角而未合拢:VQ-VAE、BEiT 类学习型 tokenizer 把图像变成离散 token,但 tokenizer 本身嵌在大型流水线里训练,表示仍是大模型的一部分;MobileNet 类轻量网络压缩单任务模型,却不建立统一感知空间;YOLO 与 RF-DETR 靠大骨干和像素级密集训练换取质量。本文的独特切入是把智能从模型参数迁移到表示与组织层面:TAPe 不是又一个学出来的嵌入,而更像一个感知编解码器(perception codec)——图像在进入任何神经网络之前已被编码为 T-bits 及其关系图 $G(I)=(\{t_1,\dots,t_K\},E)$,语义结构显式存在,且构建过程本身不经神经网络训练。它与深度学习之前的手工描述子(HOG、Sobel/Canny、光流、直方图)有血缘关系,但目标是跨任务共享的通用感知层而非单任务描述子。作者的研究姿态也是反常识的:不问如何把模型做大,而问什么样的输入空间能让识别问题本身变简单;模型紧凑不是设计目标,而是唯一能与这种数据协同的结构带来的自然结果。
核心方法
整体上,TAPe+ML v3 是把视觉理解的大部分工作前置到表示层,让识别只需几个极小的模块协作完成。技术上分两层。底层是 TAPe 表示:图像 $I$ 被映射为 $G(I)=(\{t_1,\dots,t_K\},E)$,每个 T-bit $t_i$ 不是单个像素,而是按 TAPe 规则选出的最有信息量且相互关联的像素子集 $R_i\subset\Omega$ 及其上的函数,$E$ 是 T-bit 之间的关系边,且 $K\ll HW$,索引体积比像素描述小几个数量级。TAPe 构建算法专有,论文只给出三条性质:局部变换不变、语义稳定、简洁可比(索引距离直接对应语义距离,可直接做相似性检索)。上层是识别系统:一个协调器调度三个专用子模型——背景模型把 Bag-of-Words 形式的 TAPe 表示中的几何分段标记为背景或前景,构建 2D 几何图元并合并成轮廓;指针模型用 TAPe patch 的局部关联定位候选目标,替代全局自注意力;原型聚类模型在 TAPe 空间跑 k-means 生成类原型,推理时按原型匹配判类。整个协调器加子模型系统的总参数不足 10 万。
核心创新有二。其一是表示层面:用结构化 T-bits 替代像素张量,把重建图像结构的工作在输入前完成。作者称之为对离散像素陷阱的解法——相关关系已嵌入输入,模型无需再猜测 patch 之间的联系,这正是能抛弃 transformer 的原因;T-bits 之于 TAPe+ML,如同像素之于 CNN,是感知语言的基本原子。其二是架构层面:从 v1 的单体端到端检测器改为协调器加小专业子模型的组合,检测被分解为背景过滤、目标定位、原型匹配三个简单子任务,每个模块只需几千至几万参数;协调器还能按损失收敛情况自动伸缩子模型实例(COCO 上部署 3 层原型聚类、2 个指针实例,背景模型最大,因为大部分判别工作发生在那里)。与已有方法的本质区别在于:统一的不是骨干网络,而是输入空间本身——框、类别、掩码都从同一个 TAPe 关系结构推导,共享单一多组件损失,分割训练自动训练检测,反之亦然:掩码比真实边界宽几个像素对 IoU 损失不足百分之一但对框影响大,故分割给了检测更精确的几何监督;人被护栏切成多个区段时,分割的多区域信息又提示检测器仍画一个框。
方法步骤详情
图像编码为 T-bits 及关系图,携带几何位置描述。第二步,协调器把 Bag-of-Words 形式的表示交给背景模型:构建 2D 几何图元掩码并合并为物体轮廓,用轮廓法线判断朝向与内部是否存在,输出样条描述过滤无趣区域,假阴性降至零。第三步,指针模型以 TAPe patch 局部关联定位候选目标,不用全局自注意力。第四步,原型聚类模型将目标对应的 TAPe 元素与 k-means 类原型匹配,类别由 TAPe 空间几何结构决定;无反向传播、无学习率,较梯度分类头提升约 3 个百分点。第五步,分割子模型三阶段工作:(1) 用上下文机制标出潜在边界,恢复有意义的弱边缘、不把影子当边界;(2) 折线合并为多边形,不闭合则丢弃;(3) 布尔运算合并轮廓内部使每对象分段最少,掩码拓扑正确、孔洞只在真实存在时出现;训练时中间层挂辅助头分阶段优化,推理留最终轮廓,掩码不绑定类别。第六步,按域差距选 head-only、backbone adaptation 或 from-scratch 模式适配新任务,并用 auto-annotate(10-15 张种子图起步,自动标注加人工审核)迭代扩展数据。
技术新颖性
技术新颖性体现在四个反潮流设计。第一,表示先于学习:主流表征学习(VQ-VAE、BEiT、DINOv2)靠海量数据学出嵌入,TAPe 的结构是构造出来的而非学出来的,论文将其定位为感知编解码器,并给出对照证据——保持 DINO/iBot 架构不变、只把输入换成 TAPe 数据,iBot 损失在 9k 图像上就从像素版的约 2.46(12 万张图仍不收敛)降到 0.406,说明表示本身极大降低了自监督学习难度。第二,分类去梯度化:现代架构几乎都用梯度下降训练最后分类层并依赖学习率调度,TAPe+ML v3 改用 TAPe 空间中的 k-means 原型匹配,消融显示反而提升约 3 个百分点。第三,模块化协调替代单体网络:检测被分解为三个简单子模型的编排,参数预算压缩三个数量级,还能按损失收敛情况自动增减子模型。第四,分割与检测共享单一损失互相喂养,掩码构造不绑定类别;训练用 LVIS 精细掩码做正样本、panoptic COCO 做负样本(LVIS 是联邦标注集,未标注不等于背景),仅 5000 张图即完成边界形成。需指出,TAPe 核心算法专有未公开,这些主张的可验证性因此打了折扣。
实验结果
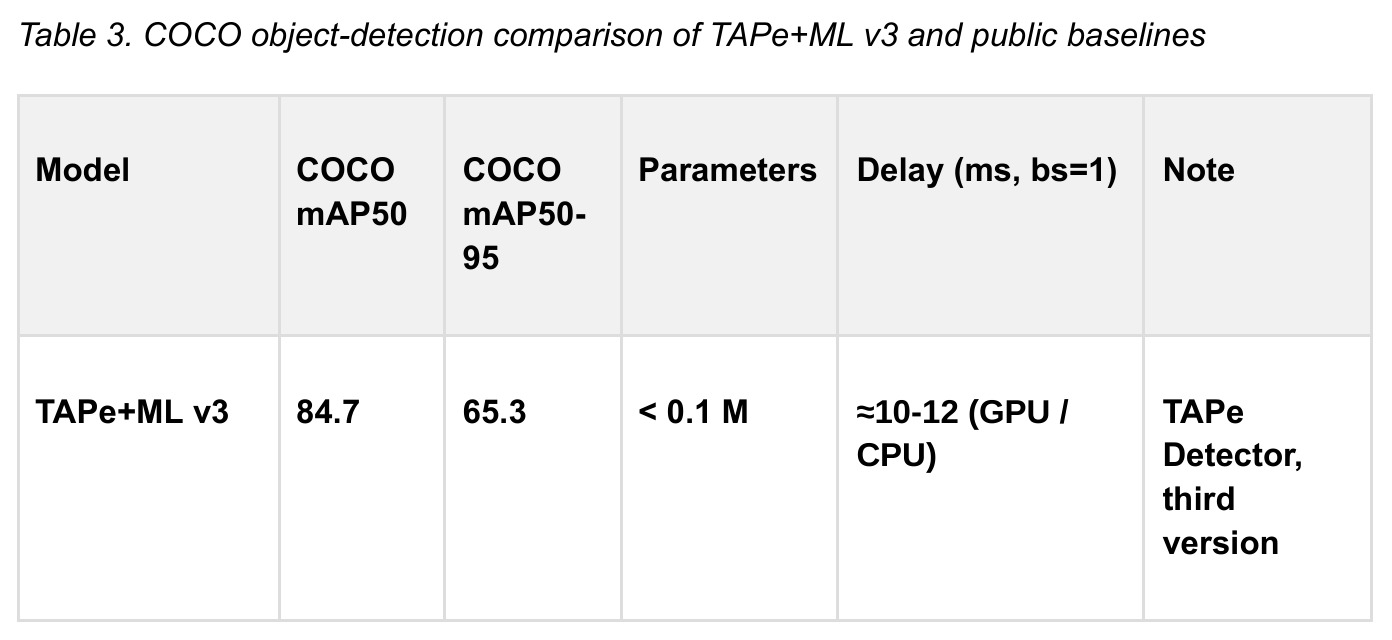
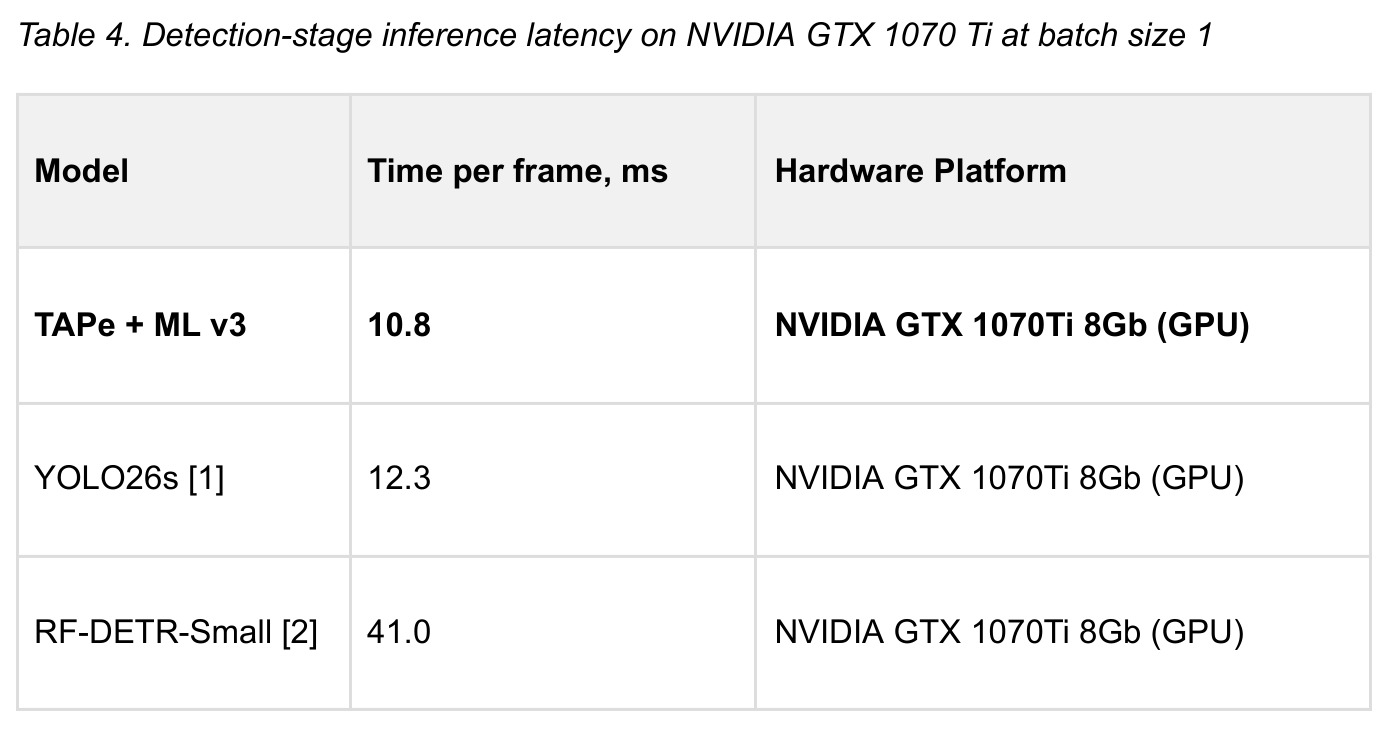
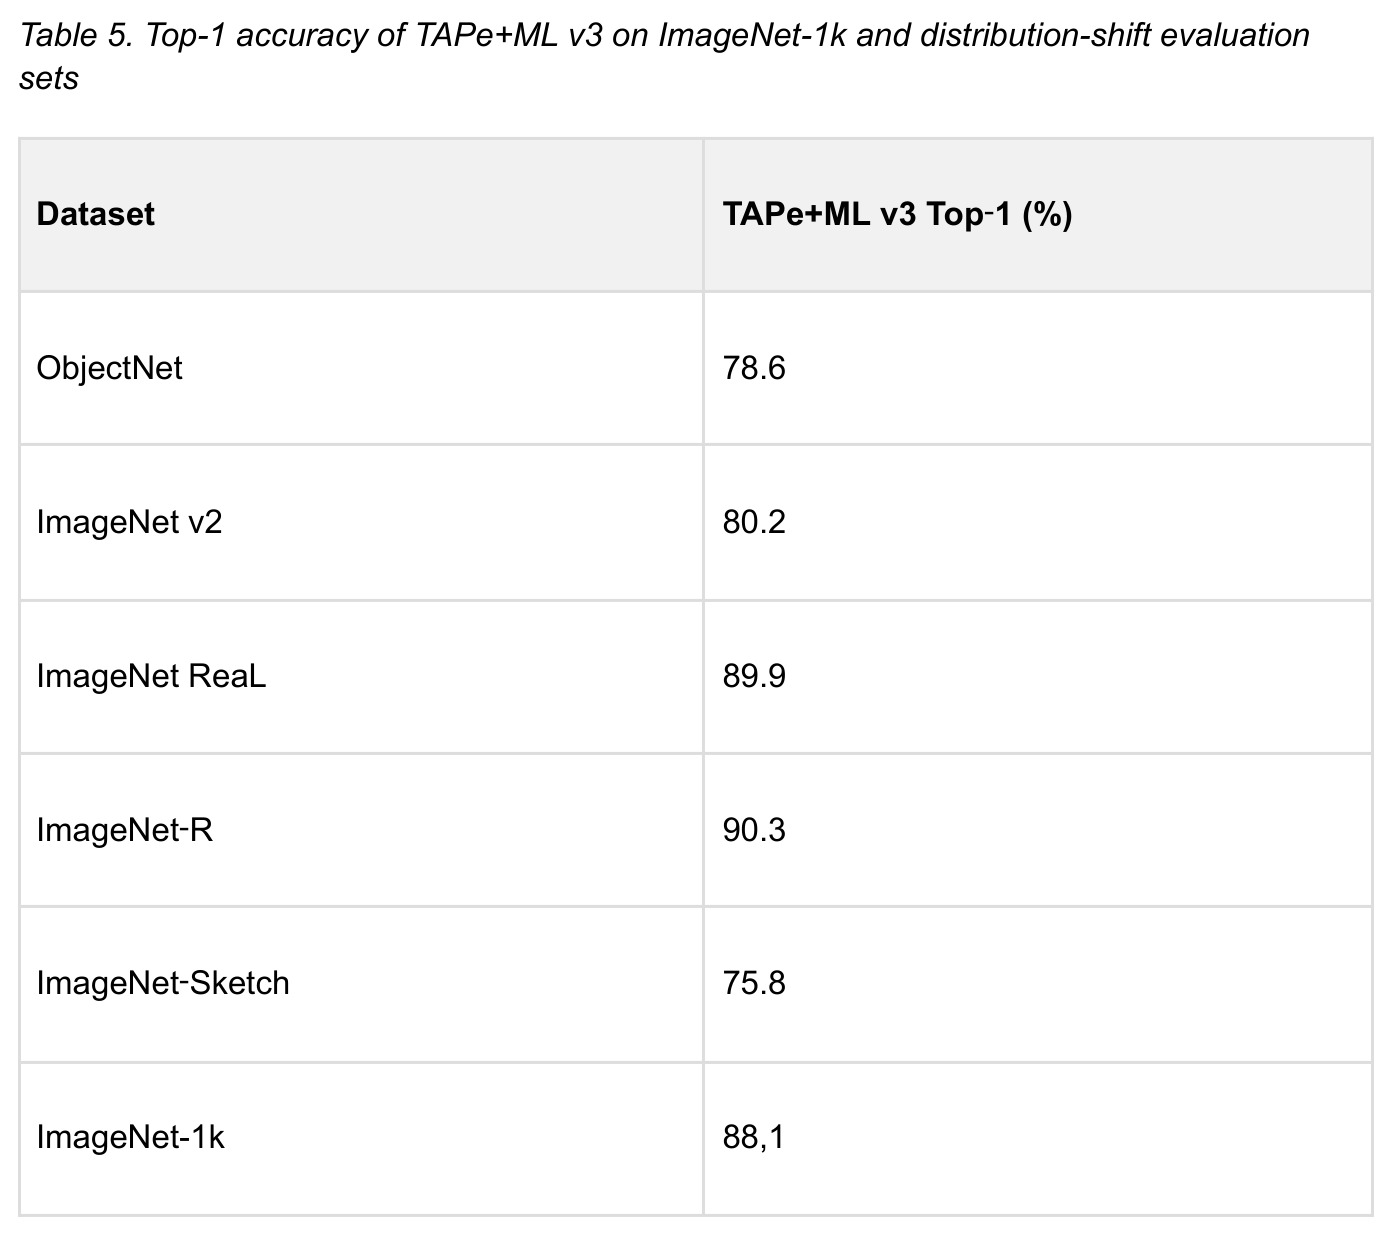
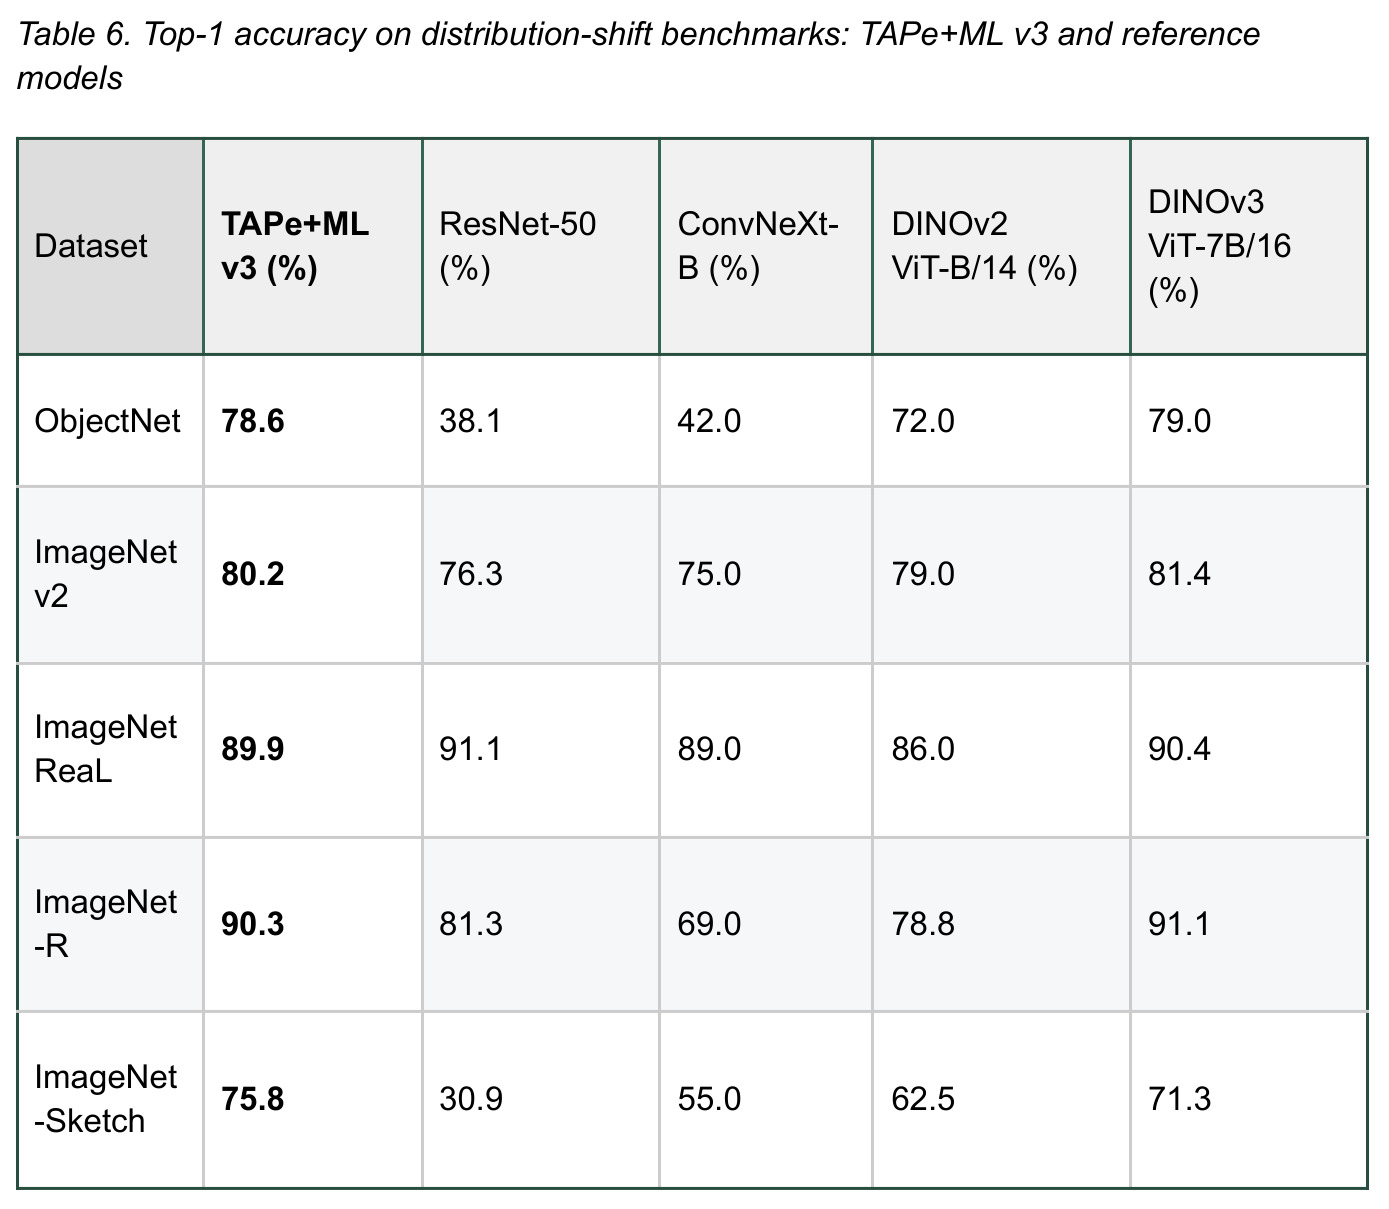
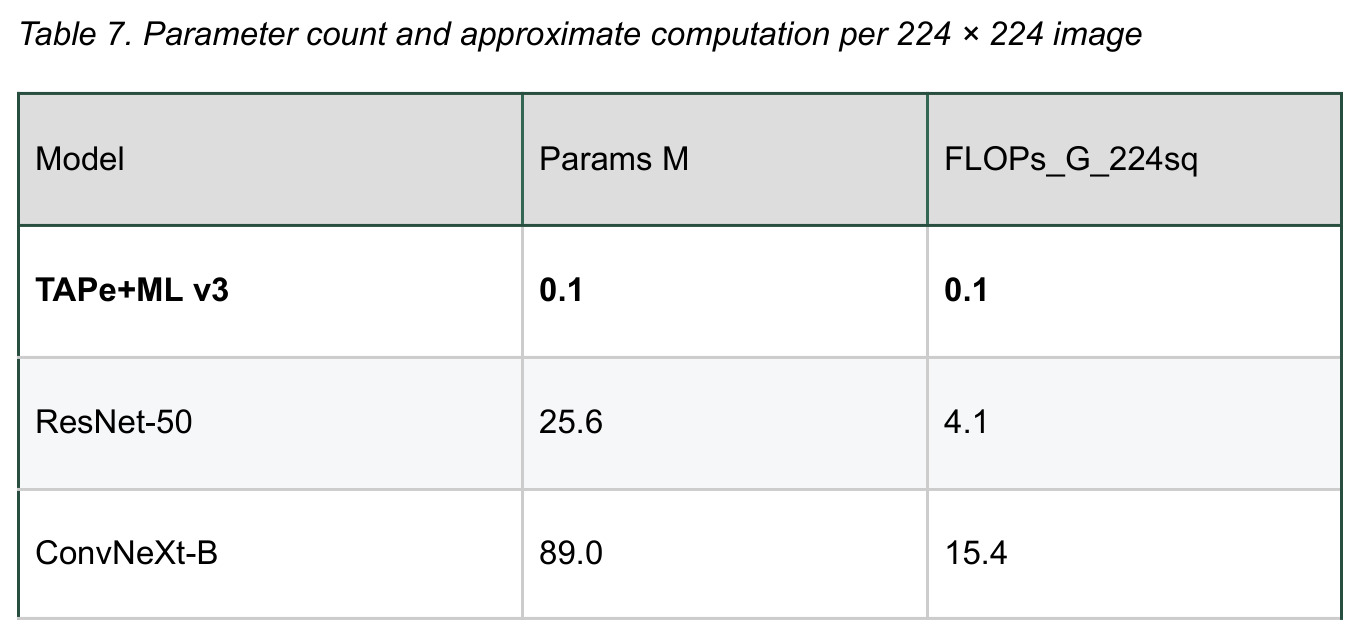
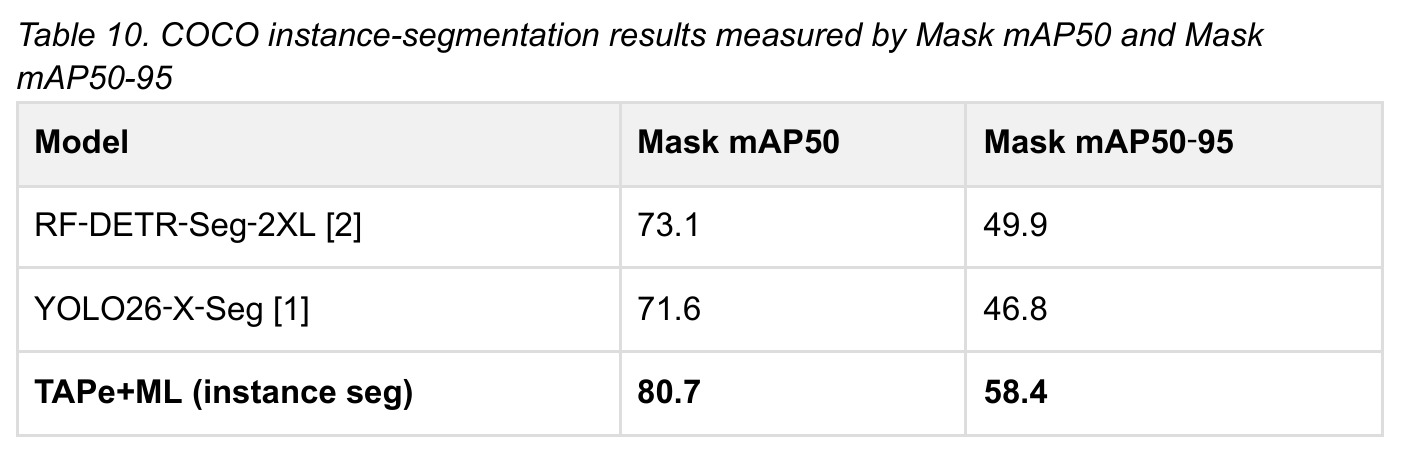
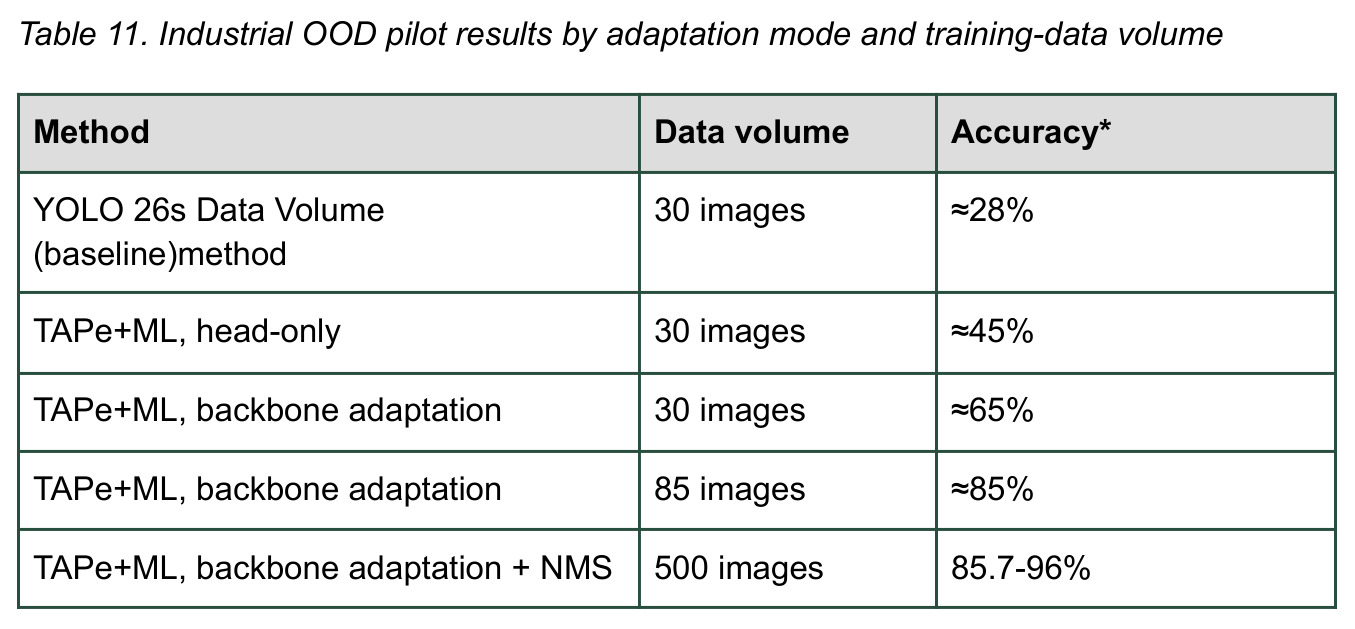
分类:ImageNet-1k Top-1 88.1%(从头训练、<0.1M 参数、0.1 GFLOPs),五个分布偏移集 75.8-90.3%,Sketch 与 ObjectNet 接近或超过 7B 的 DINOv3。表示对照:同一 3 层 CNN 在 Imagenette 10% 数据上,TAPe 输入 92% 对像素 47%。检测:COCO mAP50/mAP50-95 84.7%/65.3%,超 RF-DETR-2XL(60.1,126.9M 参数)三个数量级的参数差;延迟 10.8 ms/帧快于 YOLO26s;oracle 分类 87.3%,误差主要在框定位;RF100-VL 68.3% 对 63.2%。分割:COCO Mask AP50/AP50-95 80.7/58.4,高于 RF-DETR-Seg-2XL 的 49.9;LVIS 掩码覆盖率 97-98.2%、AP@75 72-74%,远超 YOLO 零样本的 44%/21%;全流水线约 12 ms。迁移:新类约 20 图、1 分钟重训;Lacrosse 上 head/backbone/v3 为 64.1/68.2/72.4,OOD 的 uavdet-small 上 45.6/52.7/58.5;工业矿石试点 30 图下 YOLO26s 约 28%、head-only 45%、backbone adaptation 65%,500 图加 NMS 达 85.7-96%。视频:TAPe 索引 1 小时视频仅 10-11 秒、<1 MB,DINOv2 需 5220 秒、9.7 MB。消融:背景子模型两层过滤后对象保留 98%;无梯度分类 +3pp;iBot 损失换 TAPe 输入从 2.46 降至 0.406(9k 图)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-1k 图像分类 | Top-1 准确率 | 88.1%(<0.1M 参数、约 0.1 GFLOPs、从头训练) | DINOv3 ViT-7B/16 约 88.4%(约 7B 参数) | 精度相当(差 0.3pp),参数少约 7 万倍、计算少约 125 倍 |
| COCO 目标检测(val2017) | mAP50 / mAP50-95 | 84.7% / 65.3%(<0.1M 参数) | RF-DETR-2XL 78.5% / 60.1%(126.9M 参数);YOLO11-M 64.1% / 48.6%(20.1M) | mAP50 +6.2pp、mAP50-95 +5.2pp,参数少约三个数量级 |
| COCO 实例分割 | Mask mAP50 / Mask mAP50-95 | 80.7% / 58.4% | RF-DETR-Seg-2XL 73.1% / 49.9%;YOLO26-X-Seg 71.6% / 46.8% | Mask AP50 +7.6pp、Mask AP50-95 +8.5pp,且参数与计算低一个量级 |
| LVIS 掩码质量(约 2.5 万张验证图) | 掩码覆盖率 / AP@75(IoU≥0.75)/ 平均 Mask IoU | 约 98.2% / 约 74% / 0.856(附加训练后) | YOLO(LVIS 零样本)约 44% / 约 21% / 0.135 | 覆盖率 +54pp、AP@75 +53pp、平均 Mask IoU 提升 6 倍以上 |
| Imagenette 分类(表示对照实验) | 验证准确率(同 3 层 CNN、10% 数据、无增强) | 92%(TAPe 输入) | 47%(原始像素输入) | 近 2 倍(+45pp),唯一变量是输入表示 |
| 工业 OOD 矿石堵塞检测 | 准确率(IoU≥0.5 且 Top-1 分类正确) | 约 65%(30 图,backbone adaptation);500 图 + NMS 达 85.7-96% | YOLO26s 约 28%(同样 30 图) | 小样本下 +37pp,约为基线的 2.3 倍 |
| 视频场景检测(Interstellar 片段) | 索引耗时 / 索引大小 / 聚类耗时 | 10-11 秒 / <1 MB / 约 1 秒 | DINOv2 ViT-B/14 约 5220 秒 / 约 9.7 MB / 约 21.5 秒 | 索引快约 500 倍、体积小约 10 倍,且场景划分最稳定 |
局限与改进
作者承认四点局限。(1) 小目标紧框精度:mAP50-95 中最严格的 IoU 区间要求预测框与真值高度贴合,小目标上定位仍困难,归因于 COCO 分布中小目标代表性不足。(2) COCO 偏置:骨干在 COCO 类视觉世界上形成,迁移到 OOD 任务时仅调 head 明显不足,必须做 backbone adaptation,而这需要额外数据与算力预算。(3) TAPe 形式化不足:完整数学与算法规范属专有 know-how 未公开,只能给出输入输出层面的性质描述。(4) 不覆盖 3D 视觉与完整视频任务(跟踪、时序一致性)。我的补充观察:其一,可复现性是最大问题——核心表示是黑盒,结果无法被社区独立验证。其二,数字一致性存疑:工业试点正文说 30 图 65%、500 图 85.7-96%,结论部分却写约 20 图达 82.3%。其三,延迟对比硬件不统一:RF-DETR 官方数字来自 T4,自测在 GTX 1070 Ti。其四,参数小于 100k 的惊人数字部分源于把表示构建成本移出了模型参数统计。其五,外部基线未在同协议下重训,LVIS 的覆盖率/AP@75 也是非标准口径。
独立分析的弱点
弱点一:TAPe 表示完全专有且未形式化,核心贡献无法被独立审查,也无法与其他表示学习方法做受控比较。改进方向:公开 T-bits 构建的形式化定义、统计性质或可复现的退化版实现。弱点二:表示构建成本未计入账本——0.1 GFLOPs 大概率只统计识别网络,TAPe 编码的 FLOPs、内存与能耗未单独报告,端到端效率优势可能被高估;应报告端到端资源账本。弱点三:基线对比协议不严格——YOLO/RF-DETR 数字取自官方表格(T4 硬件),与自测的 GTX 1070 Ti 不同机;LVIS 中 44% 对 97% 的悬殊差距受置信度阈值等细节影响;应同机同协议重测。弱点四:统一感知核心只在静态图像单帧任务上验证,没有视频时序、3D、密集预测的证据,而 TAPe 的语义稳定性恰恰更适合视频。弱点五:小样本声明(20 图/类)未与专门的少样本检测方法对标。弱点六:ImageNet-1k 88.1% 从头训练且 0.1M 参数与学界常识强烈冲突,需要完整配方、多种子误差棒和第三方复现支持。弱点七:协调器按损失收敛情况增删子模型的调度规则只有定性描述,缺乏与 NAS 方法的比较。
未来方向
作者方向:(1) 把 TAPe 推广到视频与时序数据——论文已论证其语义稳定性适合视频,下一步是带跟踪与时序一致性的完整视频检测;(2) 深化统一识别核心,覆盖更多识别任务;(3) 完善 OOD 适配体系,让 backbone adaptation 更自动化;(4) TAPe 的完整形式化与公开。基于成果可延伸:(1) TAPe 作为通用自监督输入空间——iBot 损失从 2.46 降到 0.406 的结果值得在 DINOv2/v3 规模上系统验证,可能催生新预训练方向;(2) 混合架构:可测试 TAPe 加轻量 transformer 或状态空间模型的组合,量化表示与架构的分工边界;(3) 把 auto-annotate 循环与主动学习理论结合,给出标注成本-性能的量化权衡曲线;(4) 持续学习:新类 20 图、1 分钟重训暗示原型可在线更新,可研究 TAPe 空间中的类增量学习;(5) 针对小目标 mAP50-95 短板,引入多尺度 TAPe patch 或边界感知的框回归损失;(6) 在 COCO、LVIS 等公开竞赛上提交同一系统,用外部裁判消除自证问题。
复现评估
复现难度极高,对外部研究者几乎不可行。论文未提供代码开源承诺,仅给出项目页与联系邮箱;核心 TAPe 编码算法被明确声明为专有 know-how,完整数学与算法规范不在本文范围内——即便复刻了协调器加子模型架构,没有 TAPe 编码器也无法重现任何结果。数据层面均为公开集(ImageNet-1k、COCO train2017/val2017、LVIS、panoptic COCO、RF100-VL 的 Lacrosse 与 uavdet-small、Imagenette、MNIST);训练超参部分披露(工业试点:15 epochs、batch 64、OneCycleLR 峰值 1e-4、第 5 轮后连续 3 轮无提升早停),但主实验的完整配方、TAPe 索引构建的资源开销、各子模型的内部结构均未给出。算力方面论文暗示需求很低——推理与视频实验用 GTX 1070 Ti 8GB 和至强 E5 老服务器,训练总算力未报告。综合来看,这是一份技术展示性质的工业论文,核心组件闭源,独立验证只能等待作者公开 TAPe 或第三方同等条件复测;读者应将其结论视为待验证的主张而非已确立的事实。
论文图表
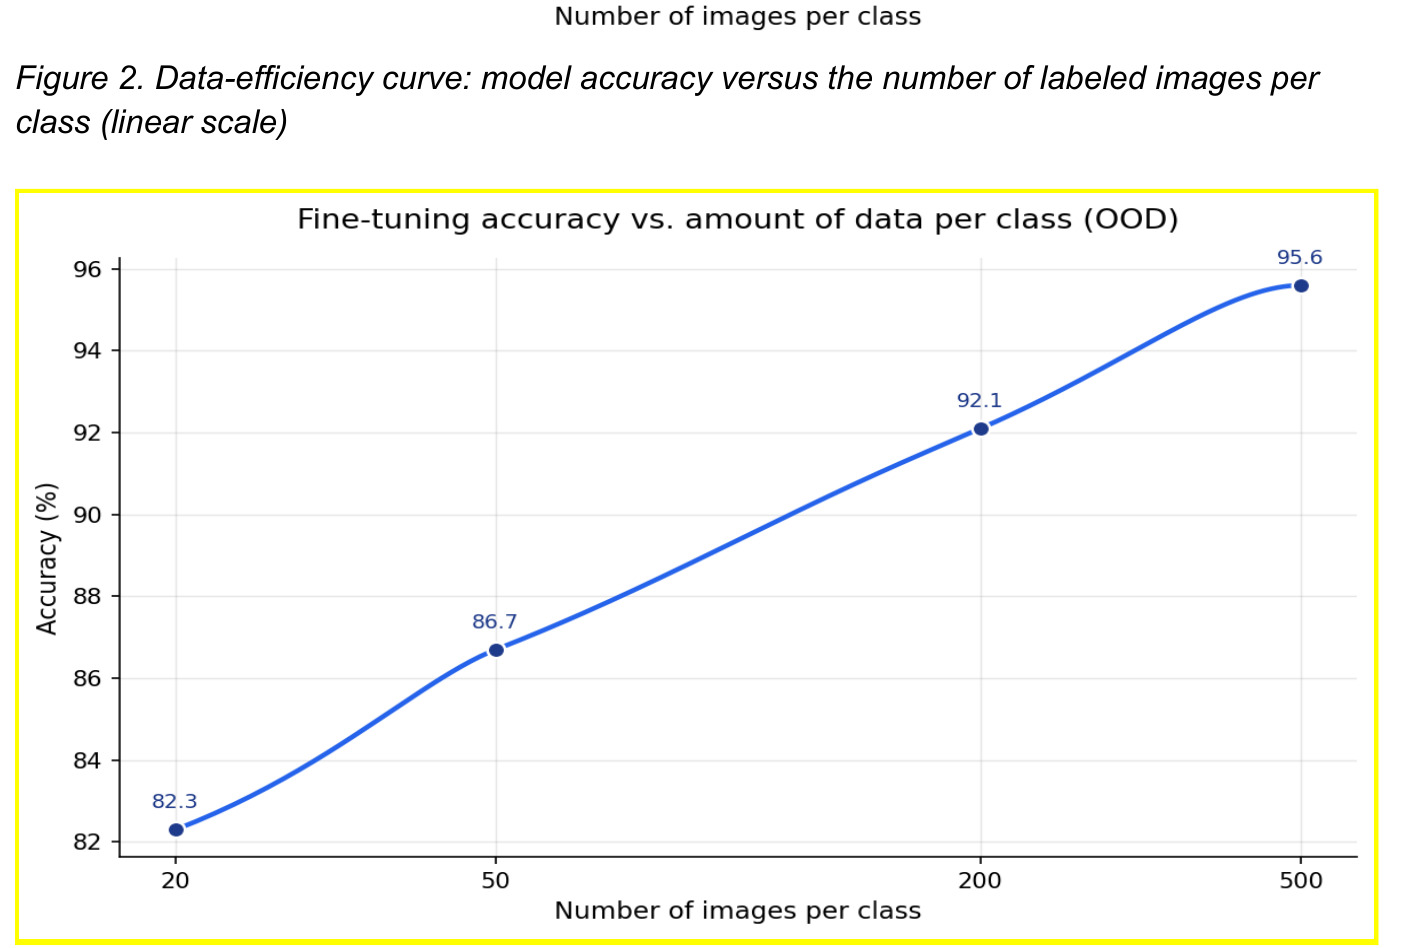
线性坐标下的数据效率曲线:横轴为每类标注图像数量(20→50→200→500 张),纵轴为模型准确率,展示 TAPe+ML 在极少标注量下即可达到较高精度。
直接支撑论文三大动机之一的数据与标注成本问题:几十张图而非几千张图即可学会新任务,是 TAPe 表示结构化价值的最直观证据。
与 Figure 2 相同的数据效率曲线,但横轴改为对数坐标,更清晰地展示低数据区间(20-50 张图)内的陡峭增益与高数据区间的边际递减。
对数视角凸显小样本区间的行为——这正是工业落最关心的区间,与工业试点中 30-85 张图的结果互相印证。
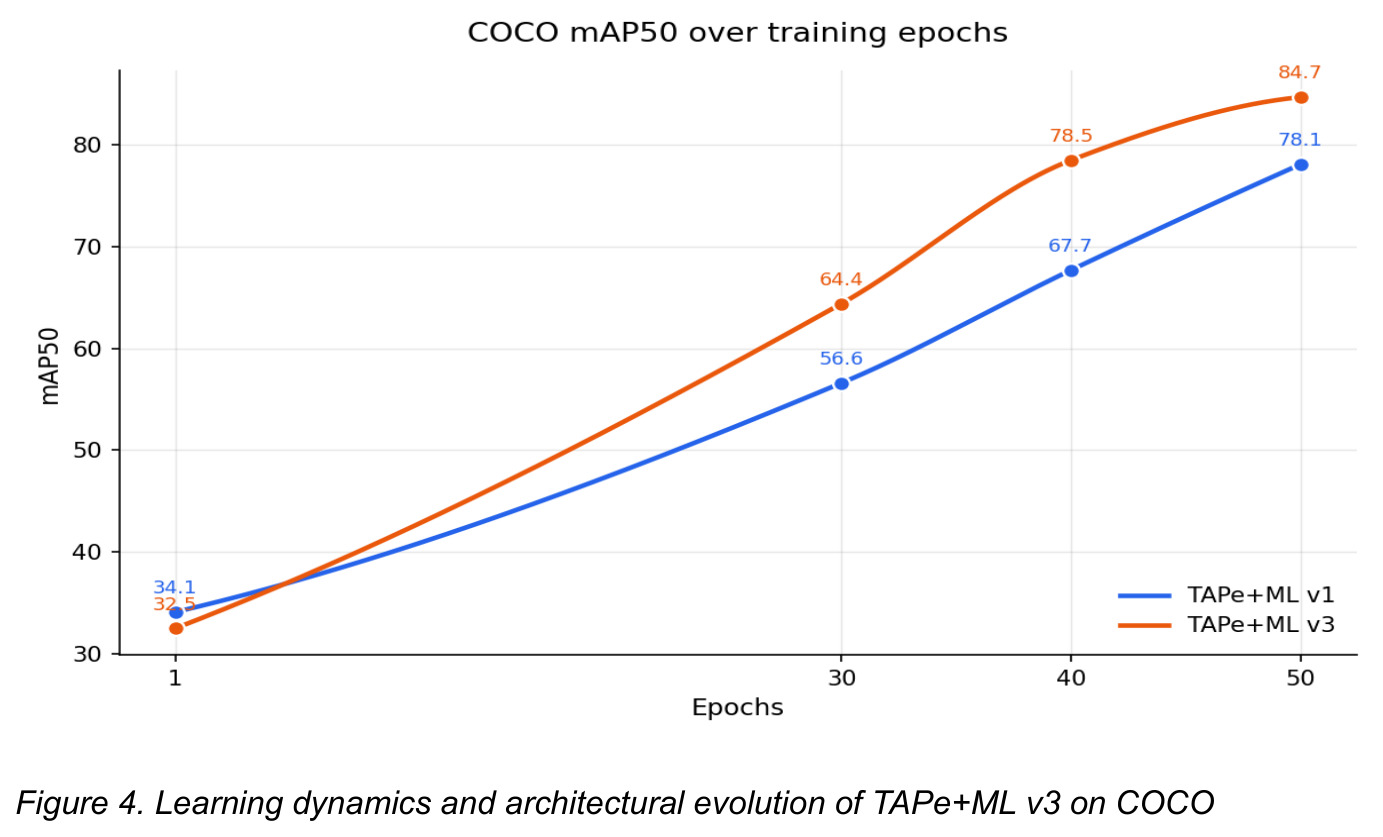
展示 COCO 上 TAPe+ML 从早期版本到 v3 的学习动态与架构演进:质心方案(约 115k 参数)→ 添加高质量 TAPe 属性 → iBot 式自监督训练嵌入 → 抛弃 transformer 改用 TAPe patch 局部关联 → 加入边界分割与无梯度 k-means 分类,对应 mAP50-95 的逐步提升。
说明最终性能是多个架构决策累积的结果而非单点改进,帮助读者把第 6 章的消融结论(协调器、无梯度分类、分割联合训练)与最终 65.3% 的成绩对应起来。
标准 COCO 实例分割指标对比:TAPe+ML Mask mAP50 80.7 / mAP50-95 58.4,高于 RF-DETR-Seg-2XL 的 73.1/49.9 和 YOLO26-X-Seg 的 71.6/46.8。
用社区标准口径(而非 Table 8 的自定覆盖率口径)验证分割优势,直接回应公平性质疑,是与 Mask DINO、Co-DETR 等非实时模型对话的桥梁。
工业矿石堵塞检测(二分类)结果:YOLO26s 基线 30 图约 28%;TAPe+ML head-only 30 图约 45%;backbone adaptation 30 图约 65%;backbone adaptation 85 图约 85%;backbone adaptation + NMS 500 图 85.7-96%(一类约 100%,另一类约 90%)。
落地价值最强的证据链:同一小样本预算下三种适配模式的阶梯式提升清晰呈现 COCO 偏置效应,也验证了真实 OOD 场景中 TAPe 迁移能力优于通用检测基线。