Paint-Anything:面向图像生成与编辑的任意颜色统一控制 Paint-Anything: Unified Any-Color Control for Image Generation and Editing
以十六进制色码为统一提示接口,微调单个模型同时实现精确颜色生成与编辑
前置知识
流匹配(Flow Matching)
一类生成模型的训练目标,学习噪声到数据的直线传输路径:对干净潜变量 $z_0$ 采样高斯噪声 $\epsilon$ 与时间步 $t$,构造插值 $z_t = (1-t)z_0 + t\epsilon$,训练网络预测速度场 $v^\star = \epsilon - z_0$,用均方误差约束;推理时从纯噪声出发沿预测速度积分得到图像。
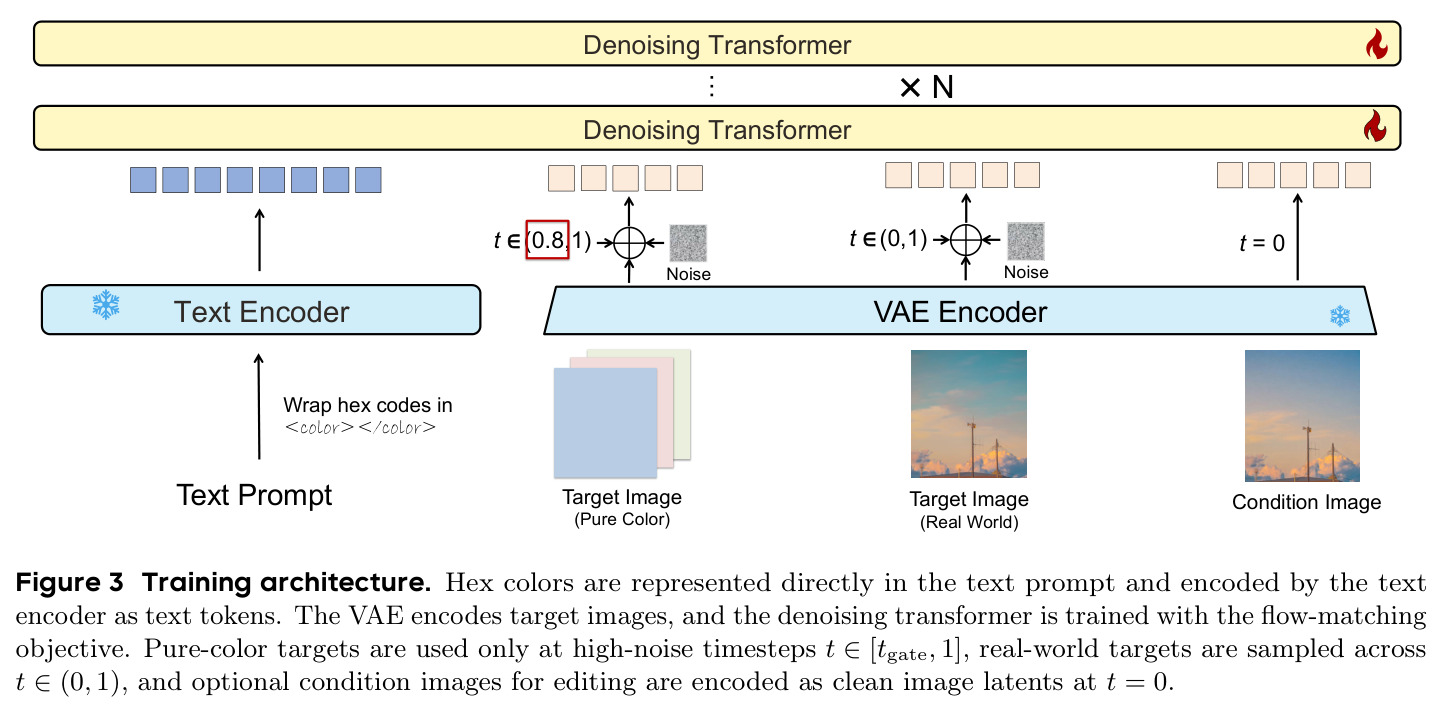
本文的生成与编辑训练完全建立在流匹配目标上,三种数据流的联合损失由它派生,纯色锚点的时间步门控也依赖对 $t$ 语义($t=1$ 为纯噪声、$t=0$ 为干净图)的理解。
潜空间扩散与冻结组件
现代文生图模型通常先用 VAE 编码器把图像压缩到低维潜空间 $z_0 = E_{vae}(I)$,去噪 Transformer 只在潜空间工作;文本编码器把提示词映射为 token 嵌入序列作为条件。微调时常冻结 VAE 与文本编码器,只更新去噪主干。
理解纯色锚点为何只作用于高噪声时间步、编辑样本的源图如何以干净条件潜变量 $z_c$ 拼接进序列,都需要潜空间扩散的框架知识;冻结文本编码器也是引入 标签包裹这一设计的直接原因。
CIELAB 感知颜色空间
CIE 提出的近似感知均匀的颜色空间:$L$ 表示亮度,$a$、$b$ 分别表示绿-红与蓝-黄分量。两种颜色在 Lab 空间的欧氏距离比 RGB 空间更接近人眼感知差异,是配色、色差度量(如 CIEDE2000)的标准工作空间。
论文从真实图像提取物体主色时在 CIELAB 中做聚类,正是为了避开 RGB 距离与人类感知不一致的问题;理解这一点才能明白数据管线的颜色标注为何可靠。
MeanShift 聚类
基于密度的聚类算法:每个点沿着核密度估计的梯度方向不断漂移,最终收敛到密度峰值,聚簇个数由数据分布自动决定,无需像 K-means 那样预设簇数 $K$,适合簇数未知且形状不规则的数据。
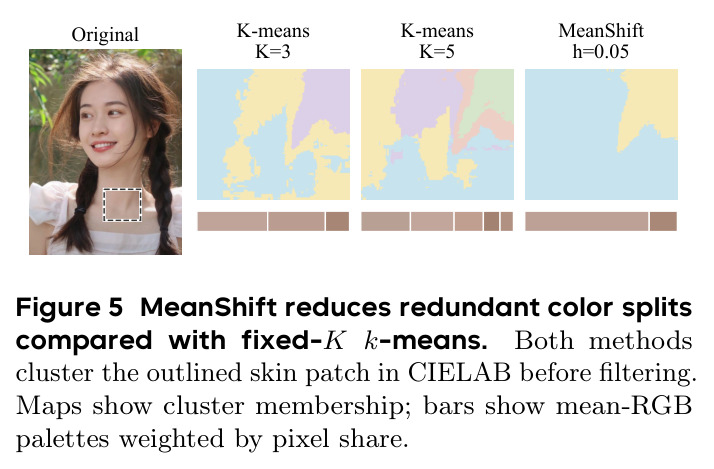
物体的主色数量因物体而异,固定 $K$ 的 K-means 会把阴影渐变拆成多个冗余颜色簇;论文把 MeanShift 引入 CIELAB 主色标注正是数据管线的关键改进之一(Figure 5)。
SAM3 分割模型
Segment Anything 系列的分割模型,可根据文本提示或框/点输入对图像中的指定物体生成高质量像素级掩码,能够把目标物体从复杂背景中精确抠出,是开放词汇分割的代表工作。
它同时支撑训练与评测两端:数据管线用 SAM3 掩码圈定物体像素来统计主色,ACBench 评测用 SAM3 分割生成图或源图中的目标物体来计算颜色误差,分割失败直接记 0 分。
LoRA 与全量微调
LoRA 冻结原权重 $W$,在旁边加低秩增量 $\Delta W = BA$(秩 $r \ll d$)只训练极少量参数,省显存但表达能力受限;全量微调更新去噪 Transformer 全部权重,通常效果更好但需要更多显存与算力。
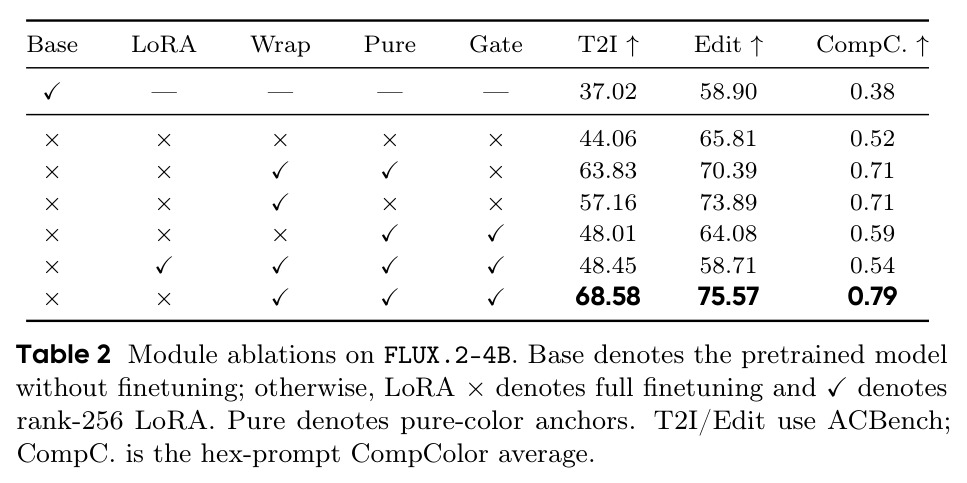
消融实验显示全量微调显著优于 rank-256 LoRA(ACBench-T2I 68.58 对 48.45),这直接决定复现本文结果所需的算力配置和预期收益。
研究动机
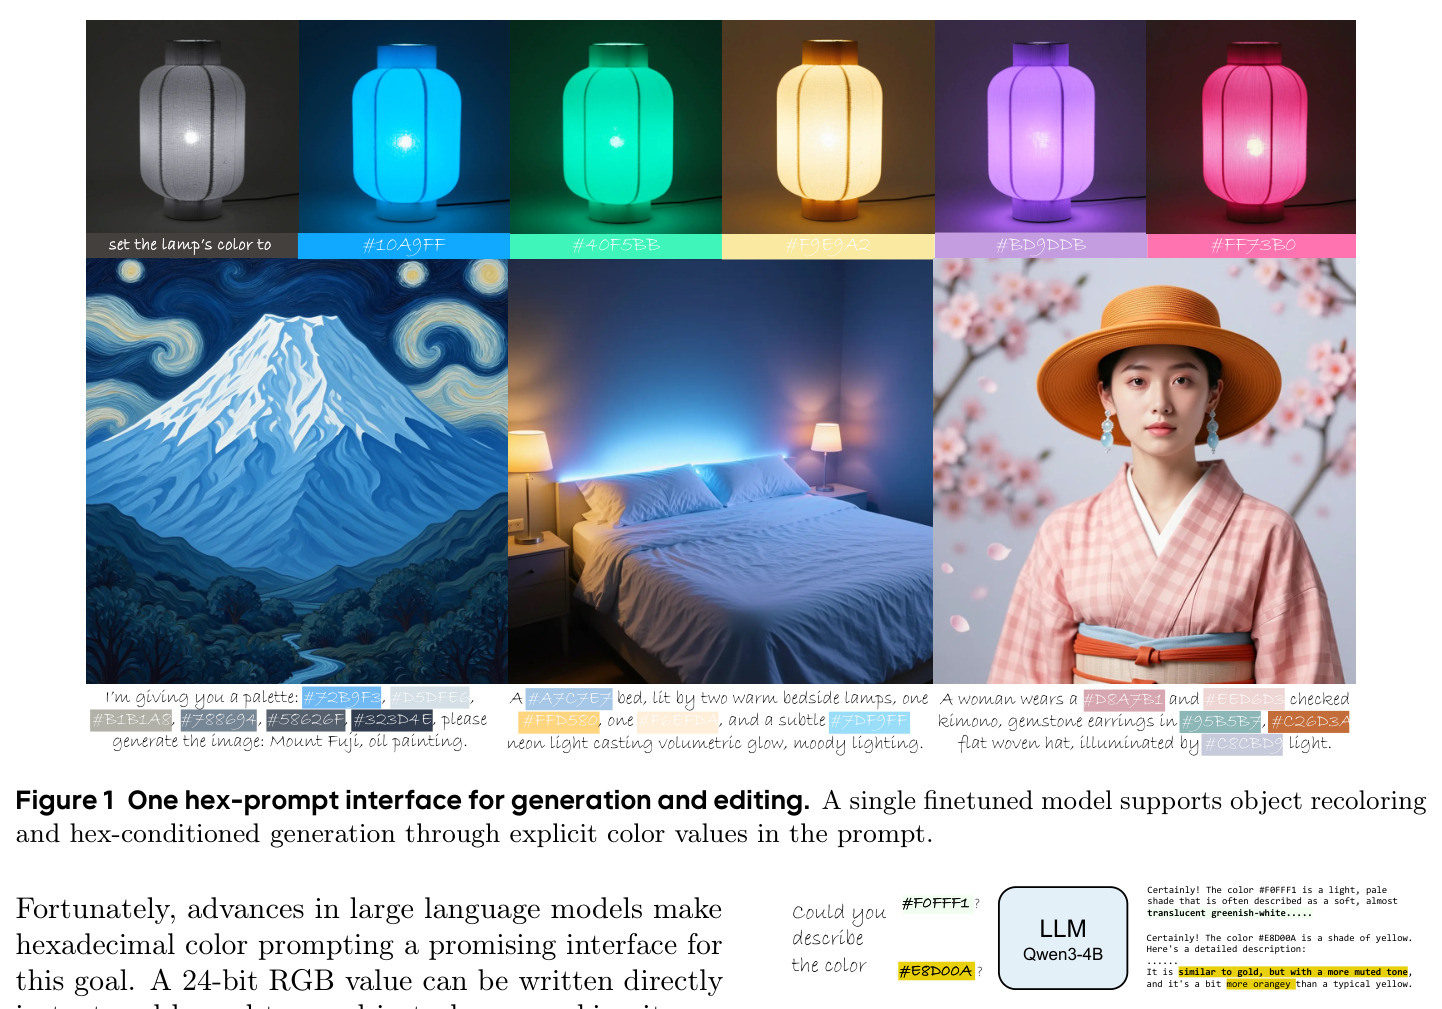
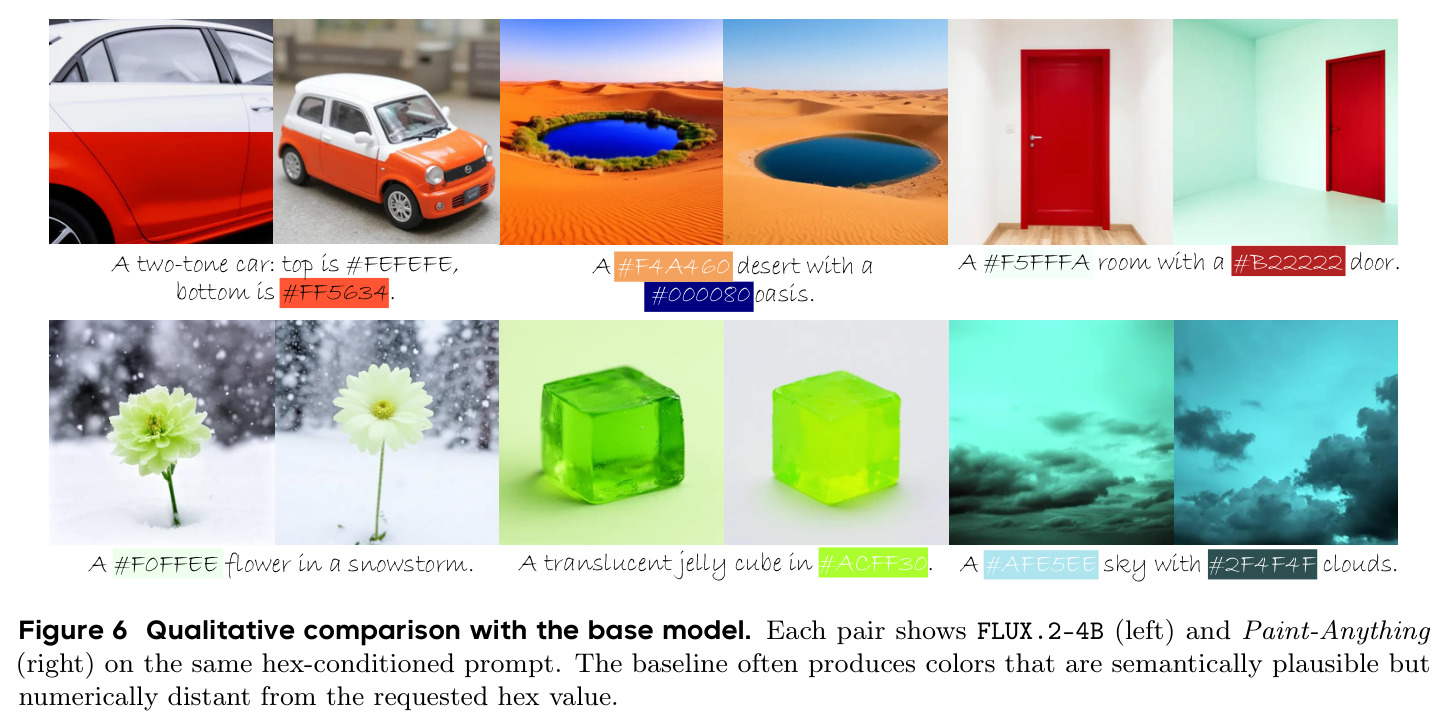
品牌设计、电商上架等专业场景要求把物体颜色精确到 24 位十六进制色值——比如把 logo 渲染成品牌蓝 #1B365D,或把商品图换成新系列的指定红色,而不是模糊地说“蓝色”。现有颜色控制方法大致分两类:一类为颜色定制专门模块或可学习颜色 token(如 NumColor 学数值颜色嵌入、ColorPeel 学颜色 token),另一类用免训练的推理期干预(采样引导、attention/value 操纵、颜色对齐目标)。这些设计或难以扩展到任意颜色、或难以迁移到新架构、或推理代价高昂,导致任意色生成、上色、编辑长期被当成三个独立问题而非一种原生的提示遵循能力。更根本的是,基座模型读不懂裸十六进制串:CompColor 上 FLUX.2-4B 用颜色词的平均分是 0.72,换成 hex 提示直接跌到 0.38,说明词到色码之间存在巨大的语义鸿沟。
本文的目标是本文的目标是让颜色指定完全发生在文本提示内部:用户在提示中写下 #AABBCC 这样的显式色码,单个微调后的模型就能同时完成两类任务——按色码生成包含指定颜色物体的图像,以及对给定图像中的物体精确改色。方法上刻意不引入任何专用颜色编码器、中间布局表示或推理期控制器,保持提示接口的原生性;为此构建 Paint-500K 数据集提供物体级十六进制监督(40 万条 T2I + 10 万条编辑配对),并提出 Any Color Benchmark(ACBench):ACBench-T2I 含 1000 条生成提示,ACBench-Edit 含 500 条真实图改色提示,以物体分割区域的颜色平均绝对误差(MAE)量化对请求 hex 值的保真度。
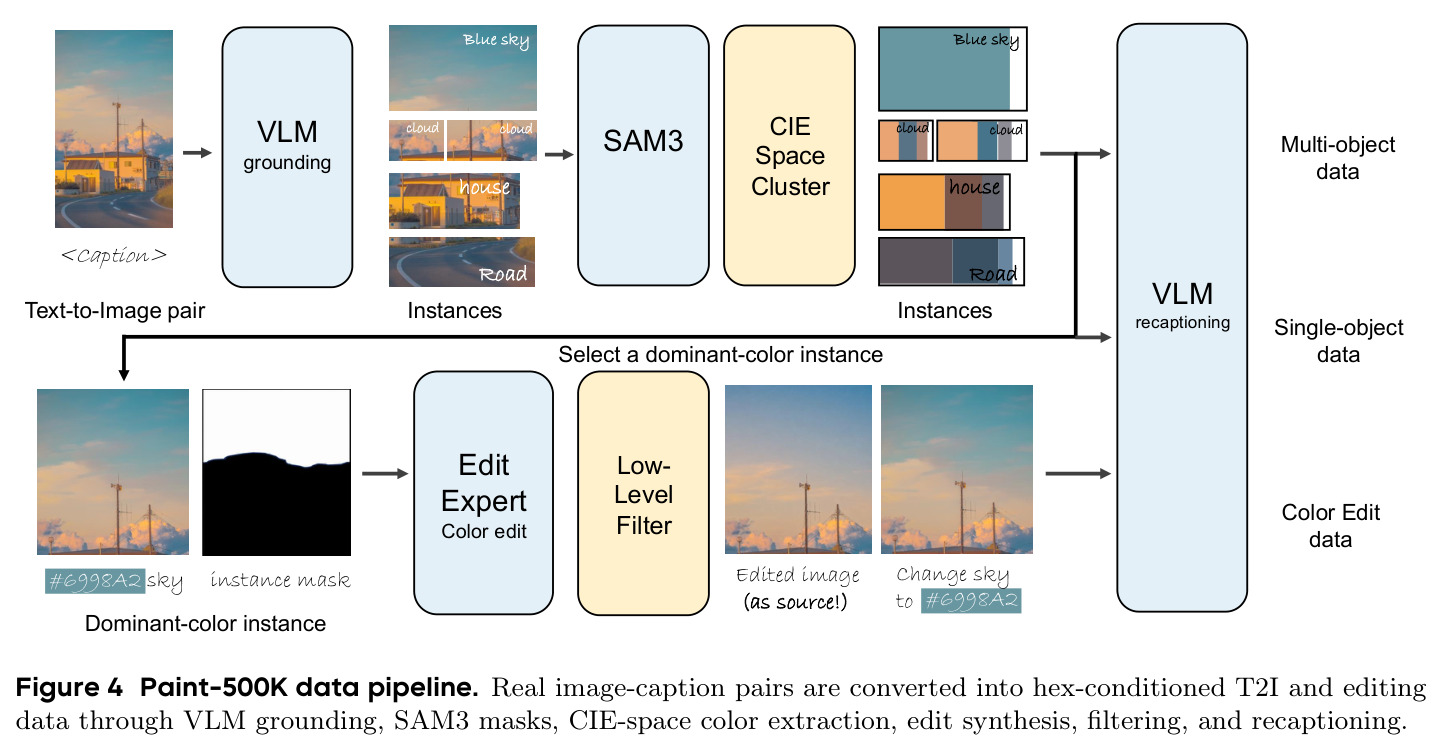
与已有工作不同的是,本文的独特切入是一组朴素观察:Figure 2 显示连 Qwen3-4B 这样的小型语言模型都能把 #F0FFF1、#E8D00A 解析成合理的颜色语义描述,说明 hex 串天然适合充当提示内的数值颜色接口。于是作者不去设计新的控制通路,而是把问题转化为数据问题:用 VLM 物体定位、SAM3 分割、CIELAB MeanShift 聚类把真实图文对改写成物体级 hex 标注;再针对“真实图的颜色标签因阴影只能是近似值”这一噪声难题,补上纯色锚点——hex 与纯色图像一一对应的干净监督样本,并首创性地只在去噪轨迹的高噪声段时间步 $t \in [t_{gate}, 1]$ 启用它们,让低噪声阶段的训练专心面向自然图像,从而在不牺牲编辑保真度的前提下获得精确的 hex 到 RGB 接地。
核心方法
Paint-Anything 建立在整流流(rectified-flow)文生图模型之上,实验中同时微调 FLUX.2-klein-base-4B 与 Z-Image Base 两个骨干,冻结文本编码器与 VAE,只更新去噪 Transformer。整体分三步:第一,把所有颜色以 #HEX 标签显式包裹进提示,让冻结的文本编码器在输入端看到明确的颜色片段;第二,用数据管线把真实图文对转化为物体级 hex 监督,得到 40 万条 T2I 样本(10 万单物体 + 30 万多物体)和 10 万条编辑配对,合成 Paint-500K;第三,训练时三种数据流共用流匹配目标,联合损失 $\mathcal{L} = \lambda_{t2i}\mathcal{L}_{t2i} + \lambda_{edit}\mathcal{L}_{edit} + \lambda_{rgb}\mathcal{L}_{rgb}$,其中纯色锚点只在 $t \sim U(t_{gate}, 1)$($t_{gate}=0.8$)的高噪声段采样,真实图样本在 $t \sim U(0,1)$ 全程采样,共训 4000 步。
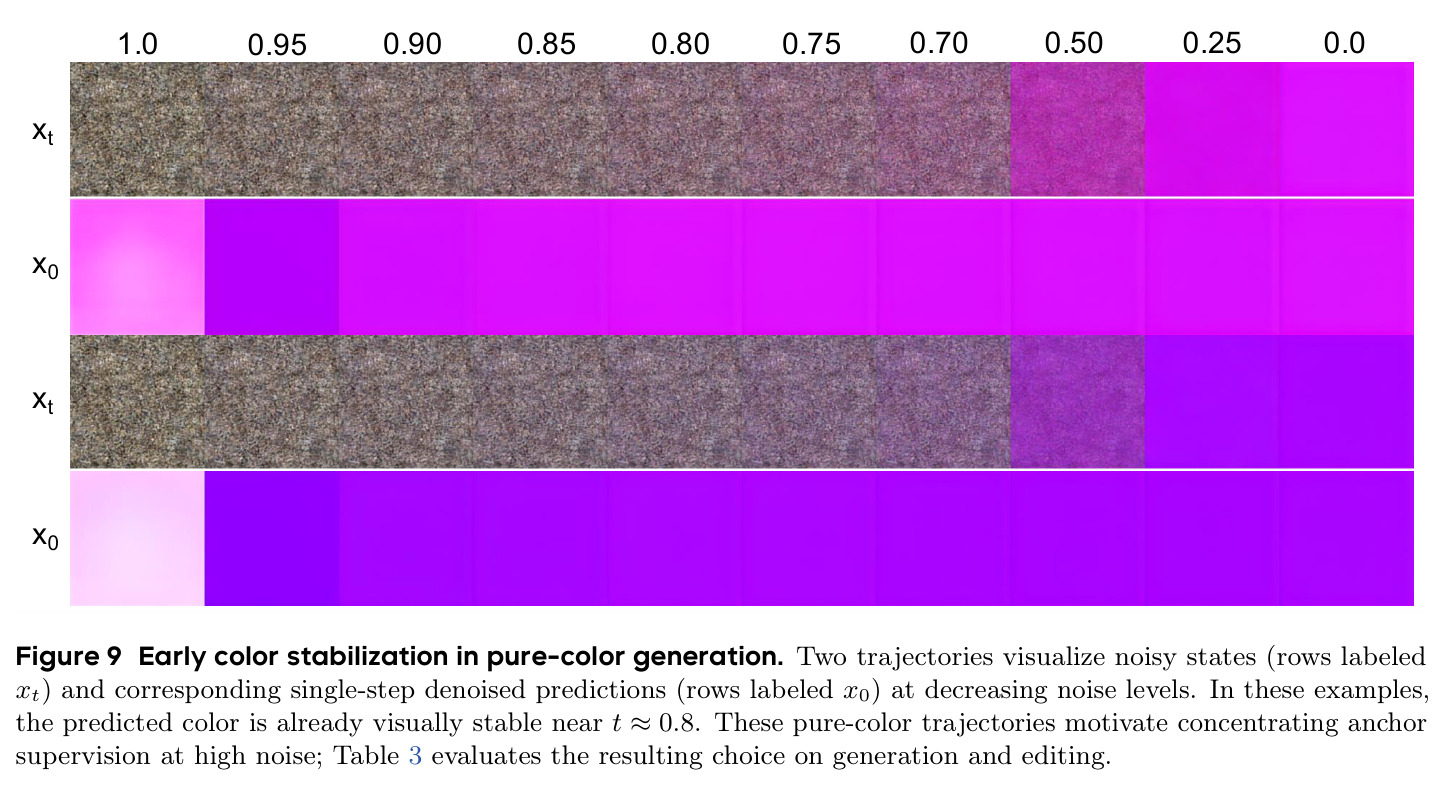
核心创新有两点。其一是提示原生的 hex 接口:颜色作为普通文本 token 进入冻结文本编码器,无需专用颜色编码器或含边界框的中间布局表示,生成与编辑共用同一语法,这与 NumColor 的数值颜色嵌入、BBQ-to-Image 的边界框结构化提示以及各类推理期引导方法形成本质区别——颜色控制不再是附加通路,而是提示遵循能力本身。其二是时间步门控的纯色锚点:真实图的物体颜色标签受阴影影响只是近似值,纯色样本提供了 hex 到 RGB 统计的精确映射,但消融显示若全程不加门控地训练锚点,Edit 分数会从 75.57 掉到 70.39;受“纯色生成轨迹中颜色在早期(高噪声段)即已稳定”的观察启发,把锚点约束在 $t \geq 0.8$ 的高噪声段,让底层颜色接地与高层语义、细节学习在时间轴上解耦,T2I 与 Edit 因此分别再提升 4.75 和 5.18 分。
方法步骤详情
第一步构建 T2I 数据:VLM 从高质量真实图文对中识别与描述相关的物体并给出边界框,SAM3 生成物体掩码,在 CIELAB 空间做 MeanShift 聚类提取主色,按像素覆盖率过滤并取最大保留簇的 sRGB hex 作为该物体标签,最后由 VLM 改写描述、用 #HEX 把色码绑定到对应名词短语,产出 40 万条样本(多物体教组合绑定,单物体裁剪强化直接颜色感知)。第二步合成编辑数据:用预训练编辑模型把每张单物体图改色作为源图,原始照片作为目标图,配上“把它改回 #HEX”的指令——只有源图是生成的,目标不带生成伪影;经场景保持、改色有效性、指令一致性三重过滤得 10 万对。第三步训练:目标图过 VAE 得 $z_0$,编辑样本额外把源图编码为干净条件潜变量 $z_c$ 与含噪目标 $z_t$ 序列拼接;按 $z_t = (1-t)z_0 + t\epsilon$、$v^\star = \epsilon - z_0$ 做流匹配回归;4 张 GPU、4000 步、全局 batch 72、Adam、学习率 $2\times10^{-5}$。
技术新颖性
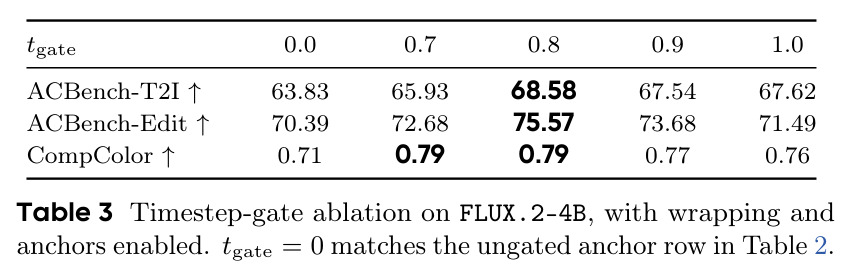
技术新颖性体现在四个层面:(1) 统一接口的证明——论文论证物体级 hex 监督本身就足以让单模型同时获得生成与编辑两种颜色能力,无需任何架构改动或推理期控制器,这在同类工作中是首次以统一语法覆盖两个任务;(2) 时间步门控锚点——把干净监督(纯色)与带噪监督(真实图)分配到去噪轨迹的不同区段,是训练配方层面的新设计,Table 3 显示 $t_{gate}=0.8$ 最优且 0.7~0.9 均稳健;(3) 数据管线工程——把 MeanShift 引入 CIELAB 物体主色标注以自适应簇数(Figure 5),避免固定 K 的 K-means 把阴影渐变拆成冗余色;编辑对只生成源图、保留真实照片做目标,规避生成伪影污染标签;(4) 评测设计——ACBench 首次以物体级 hex 保真度统一衡量 T2I 与编辑,MAE≤16 满分、≥64 零分的分段线性打分 $s = 100\cdot\max(0, 1-\max(0, (MAE-16)/48))$ 兼顾严格性与对自然外观变化的容错。
实验结果
主结果(Table 1):微调后的 FLUX.2-4B 在 ACBench-T2I 达 68.58(Single 72.67 / Two 64.49),比基座 37.02 提升 85.3%;ACBench-Edit 达 75.57,比基座 58.90 提升 28.3%。8B 微调模型反超 56B 的 FLUX.2-dev(T2I 高 16.88 分、Edit 高 6.70 分),同配方也让 Z-Image Base 从 33.45 涨到 53.77,证明跨骨干通用。对比颜色专用方法,超过最强基线 ColorWave(T2I 46.54)22.04 分、ColorBind/Edit(Edit 60.38)15.19 分。CompColor 上 hex 提示平均分从 0.38 翻倍至 0.79,颜色词提示也从 0.72 升至 0.79,说明微调反而增强了原有组合颜色绑定。消融(Table 2/3):无锚点的裸 hex 微调仅 44.06/65.81,加标签包裹升至 57.16/73.89,再加无门控锚点 T2I 升至 63.83 但 Edit 降到 70.39;门控 $t_{gate}=0.8$ 取得最优 68.58/75.57/0.79,且 0.7~0.9 区间不敏感;全量微调显著优于 rank-256 LoRA(68.58 vs 48.45)。GenColorBench NCU 与人偏好研究同样排名第一。
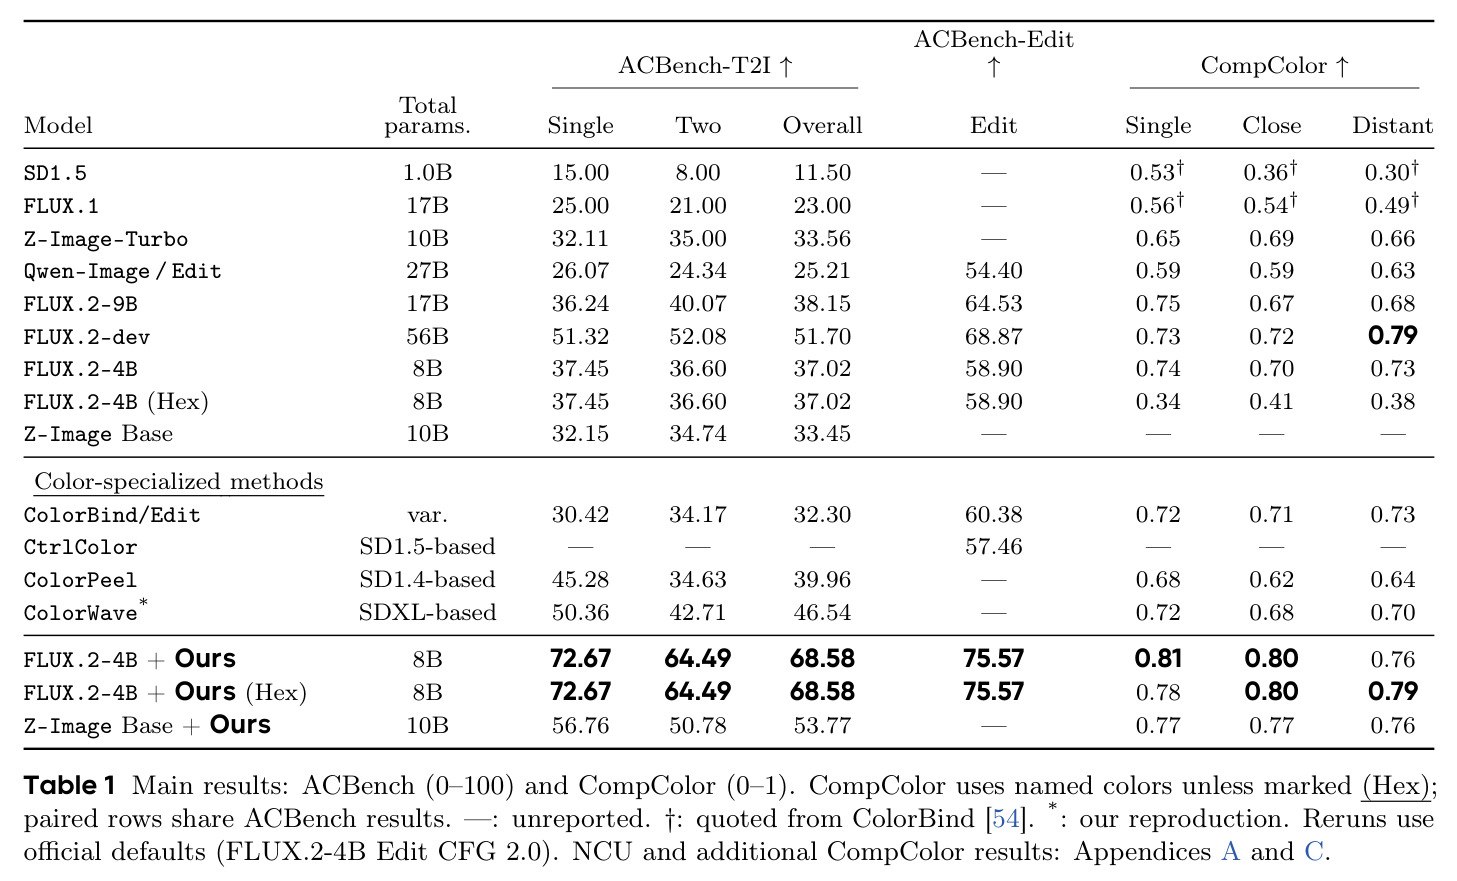
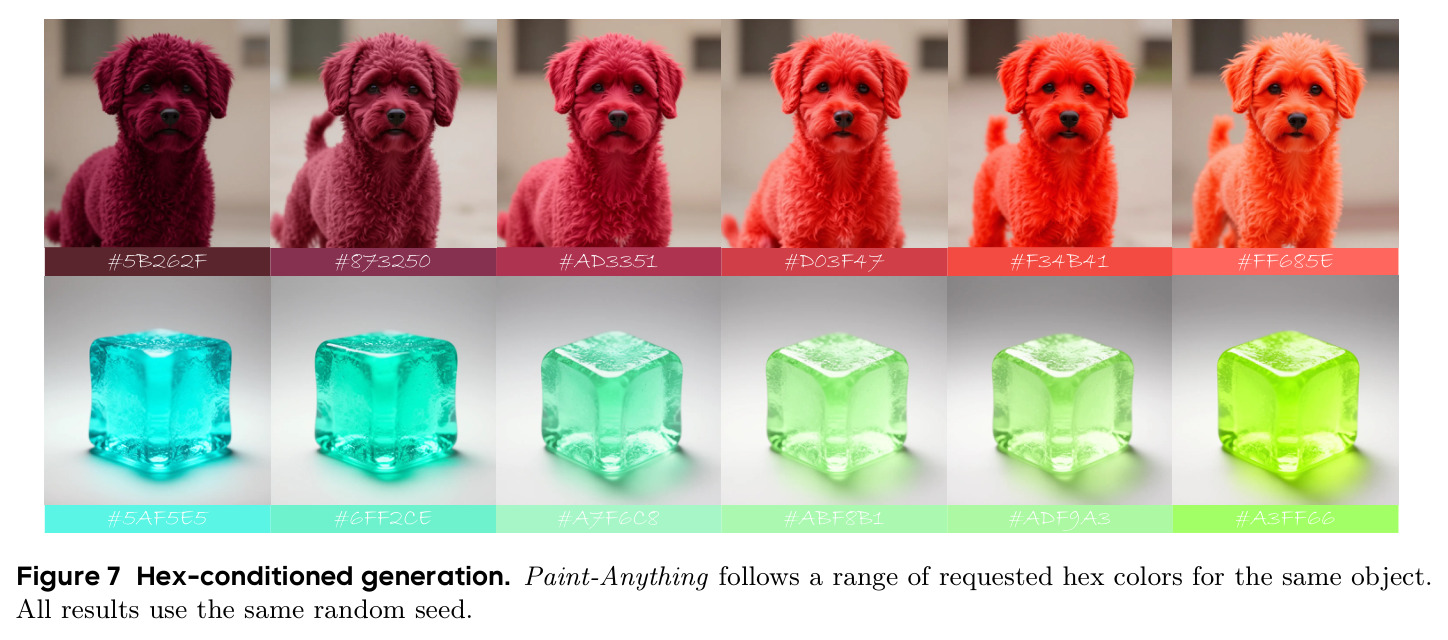
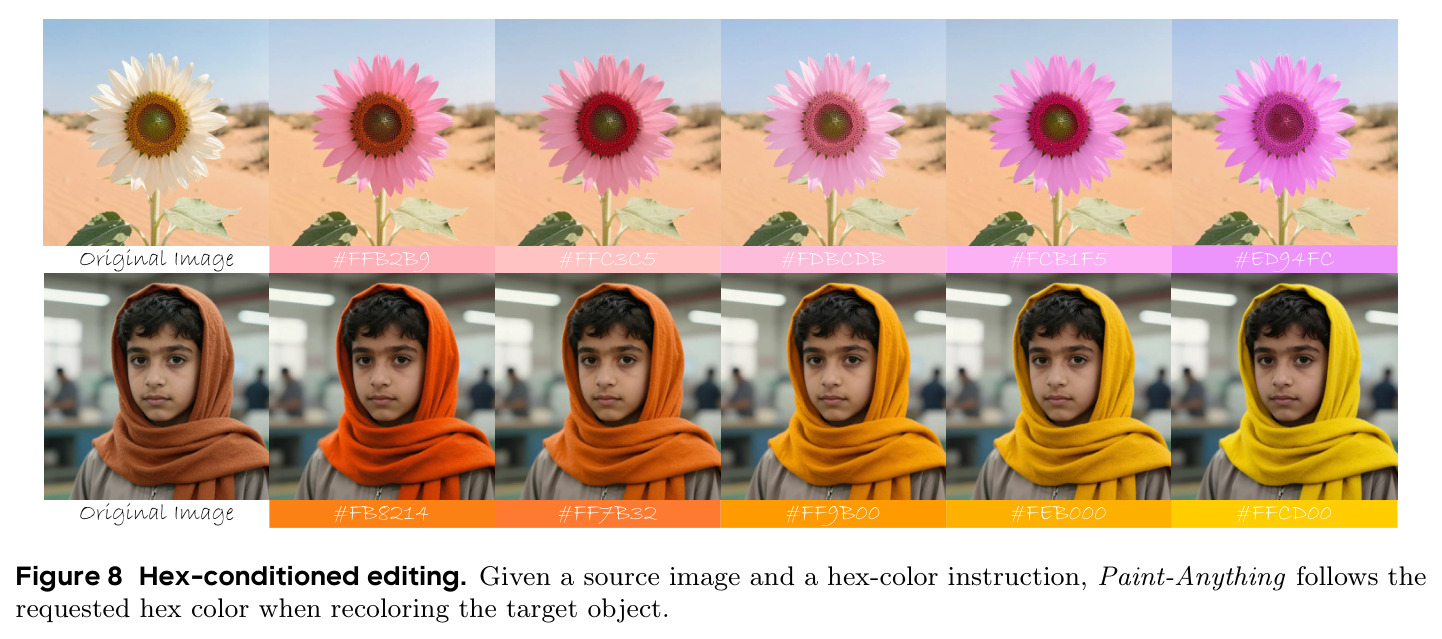
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图物体级 hex 颜色保真 | ACBench-T2I Overall(0-100) | 68.58 | FLUX.2-4B 基座 37.02 | +31.56 分(+85.3%) |
| 图像改色编辑 | ACBench-Edit(0-100) | 75.57 | FLUX.2-4B 基座 58.90 | +16.67 分(+28.3%) |
| 组合颜色绑定(hex 提示) | CompColor 平均分(0-1) | 0.79 | FLUX.2-4B 基座 0.38 | 提升逾一倍 |
| 对比更大规模通用模型 | ACBench-T2I | 68.58(8B 微调模型) | FLUX.2-dev 51.70(56B) | +16.88 分 |
| 对比专用改色系统 | ACBench-Edit | 75.57 | ColorBind/Edit 60.38 | +15.19 分 |
| 第二骨干验证 | ACBench-T2I | 53.77(Z-Image Base + Ours) | Z-Image Base 33.45 | +20.32 分 |
局限与改进
作者明确承认训练数据不含调色板级(palette)监督,因此 Figure 1 中“给一组色码生成整体配色图像”这类多色协调场景覆盖不足,未来需专门补充。我自己的观察还有五点:其一,评测与训练都依赖 SAM3 分割,定位失败直接记 0 分,颜色误差与分割误差纠缠在一起,指标可能系统性低估或高估真实颜色能力;其二,T2I 每条提示只生成一张图、单种子,未报告方差,分段线性打分的 16/64 分界也偏经验设定;其三,“物体主色”本身存在歧义——阴影、高光、渐变与花纹物体没有唯一正确答案,MeanShift 取最大簇的做法对这类物体可能系统性失准;其四,编辑对的源图由预训练编辑模型合成,存在循环依赖,改色质量受该模型上限约束;其五,论文未报告微调后模型在通用画质、非颜色提示遵循上是否有回退,且仅在两个骨干上验证。
独立分析的弱点
弱点一:真实图标签只是近似色。阴影与光照使同一物体对应一片 RGB 值,取最大聚类簇只是启发式答案,在强阴影或高光场景标签噪声更大。改进方向:引入本征图像分解(分离 albedo 与 shading)或重光照模型提取材质本色,或对标签按簇内方差加权降低不可靠样本权重。弱点二:纯色锚点只覆盖 hex 到纯色的底层映射,高噪声门控的区间选择($t_{gate}=0.8$)靠网格搜索获得,缺乏原理性解释。可探索按噪声调度自适应加权锚点损失,或把锚点推广为颜色直方图、渐变、双色锚点以覆盖更复杂颜色结构。弱点三:编辑数据由旧编辑模型合成,只覆盖单物体整体改色,无法处理局部区域改色、渐变改色等指令,且源图伪影可能被模型模仿。可用真实前后照数据或多轮自举(用当前模型重新合成再过滤)扩充。弱点四:MAE 评测与分割质量绑定,建议并行报告基于检测框区域统计的颜色指标与 CIEDE2000 感知色差,并对每条提示多种子取平均以降低偶然性。弱点五:全量微调的显存门槛高,可研究更大秩 LoRA 配合锚点课程学习,在消费级算力上逼近全量微调效果。
未来方向
作者在结论中提出两个方向:加入调色板级(palette-specific)监督,让模型一次遵循多色配色方案(如 Figure 1 展示的富士山油画场景);把统一的 hex 接口扩展到更广的颜色控制任务族,包括局部重着色、渐变与图案。基于本文成果还可自然延伸:把“时间步门控锚点”抽象为数值属性接地的通用配方,用于位置、尺寸、数量等其他数值化提示的精确遵循;扩展到视频生成与编辑中的时序一致改色;结合 3D 生成做材质级颜色与 PBR 参数控制;把 ACBench 式的物体级属性评测推广到文字渲染、纹理等细粒度属性;探索 hex 接口与设计工具的闭环,让设计稿色板直接批量驱动商品图生成与改色,这正是论文开头品牌设计场景的落地路径。
复现评估
复现难度中等偏上。有利条件:骨干 FLUX.2-klein-base-4B 与 Z-Image Base 均已开源;训练成本非常低——仅 4 张 GPU、4000 步、全局 batch 72、Adam、学习率 $2\times10^{-5}$,单次实验在数小时内可完成;ACBench 的构成(1000 条 T2I:500 单物体 + 500 双物体;500 条编辑提示)与打分公式(SAM3 分割后按掩码算 MAE,$s = 100\cdot\max(0,1-\max(0,(MAE-16)/48))$)在正文和附录中完整给出,自建评测集可行。主要障碍:Paint-500K 来自内部数据集未公开,分布差异可能显著影响结果;管线依赖 VLM 标注模板、SAM3、预训练编辑模型等多个组件,细节分散在附录 D/F 但关键模型未必可得;论文未提及代码或权重发布计划。若用同量级开源图文数据按附录配置重建管线,工程上可行,但完全对齐论文数字需要原始数据分布。
论文图表
动机探针实验:让 Qwen3-4B 描述 #F0FFF1 和 #E8D00A,模型给出“接近金但更柔和偏橙的暗黄”等合理颜色语义,说明 4B 级小模型即可解析裸 hex 串。
这是全文的立论起点:hex 天然可被语言模型理解,因此可以做提示原生的数值颜色接口,无需专门的颜色编码器。