手指当腿用:学习拟人机械手的自支撑运动与操作 Fingers as Legs: Learning Self-Supported Locomotion and Manipulation with an Anthropomorphic Hand
让818克五指机械手用指尖学走路,无线爬行、翻正、按键、推物一体
前置知识
PPO(近端策略优化)
一种 on-policy 深度强化学习算法,通过截断重要性采样的代理目标函数限制每次策略更新幅度,训练稳定且易于大规模并行。本文用它训练前馈 Actor/Critic 多层感知机(512-256-128,ELU 激活),在 4096 个并行环境中迭代 8000 次以上,配合 GAE($\lambda=0.95$)和自适应学习率。
本文所有爬行、翻正、按键、推物策略都用同一套 PPO 流程训练,不理解 PPO 就无法理解 Table 3 的训练设置和奖励权重如何转化为策略。
Sim-to-real 与域随机化
仿真中训练的策略部署到真实硬件时因模型误差而失效,解决方法是在训练时随机化摩擦、增益、延迟、负载等参数,并尽量用真实硬件测量校准仿真参数,让策略对不确定性鲁棒。本文用关节频率扫描测得刚度标定系数 18.7±2.5 倍、指尖动摩擦 0.88、闭环延迟约 19ms 等校准仿真。
本文的 sim-to-real 依赖'硬件测量校准 + 域随机化'双管齐下,Table 2 的每个标定数字都是仿真可信度的来源,是复现的关键。
支撑多边形与步态
腿式机器人静态稳定要求重心投影落在所有足端触点围成的支撑多边形内;步态则规定各腿摆动/支撑的时序。本文中五根 unequal 指尖构成支撑多边形,抬指按键或跨步时其余触点必须维持平衡,掌心倾斜还使身体坐标系不是水平参考。
整篇论文的核心矛盾就是'同一批手指既要移动身体、又要支撑自重、还要操作环境',支撑多边形概念是理解 footprint 目标和自支撑操作的前提。
位置控制器与低通滤波
与力矩控制不同,位置控制直接跟踪关节目标角度,关节不可回驱(non-backdrivable)。本文完全保留 WUJI 手出厂位置控制器,策略只输出关节目标增量 $\Delta q_{targ} = \alpha_q \tanh(a_t)$,指令经固件 3Hz 低通滤波器平滑,仿真中用一节指令延迟加同款滤波复现该通道。
本文方法不用改装硬件,靠学习适配既有位置控制接口,这是'保留出厂控制器'这一卖点的技术基础。
Isaac Lab 大规模并行仿真
NVIDIA 推出的 GPU 加速机器人学习框架,可在单卡上并行运行数千个物理环境。本文物理以 200Hz 运行、每 4 步执行一次 50Hz 策略动作,4096 个环境并行采样,使每轮 PPO 更新使用 24 步 × 4096 环境的数据。
没有大规模并行仿真,12 个随机种子 × 7 种奖励配置的消融实验在算力和时间上都不现实。
奖励塑形与消融分析
通过设计奖励项引导策略学到期望行为;再通过逐项移除或缩放奖励、在固定随机种子集合上对比统计量,量化每个奖励项的因果贡献。本文用 12 种子配对实验加 95% 置信区间报告 footprint/lift/direction 各自的作用。
论文 Section VI 的核心是'哪个奖励项真正有用'的统计分析,读懂它需要掌握种子配对消融的实验方法论。
研究动机
移动操作机器人的经典形态是'机械臂 + 底盘/四足':机械手自己不会走路,必须由一个昂贵的移动平台运送到工位。设想一个更省事的方案——把一只会自己爬行的机械手放进受限空间(如大型机器人附近的狭窄开口旁),它自己爬到控制面板前按键、推物,再爬回来被回收。这样就不需要独立的移动机构。但让一只手用手指走路并不容易:此前研究要么把六个完全相同的 DLR Hand II 手指模块当六足(DLR-Crawler),要么专门设计左右对称、可翻转的专用手,这些方法都依赖对称形态——左右镜像损失、数据增强或等变策略在四足上很好用,可真实拟人手有对掌拇指、四指长短不一,没有任何镜像对称性可用;每个指尖可达范围不同,掌心着地时身体还带一个固定倾角,身体坐标系不是水平参考;而且当一根手指抬起来跨步或按键时,剩下的接触点必须独自维持全手平衡。也就是说,现有腿式移动与操作技术无法直接移植到'不对称五指手'上。
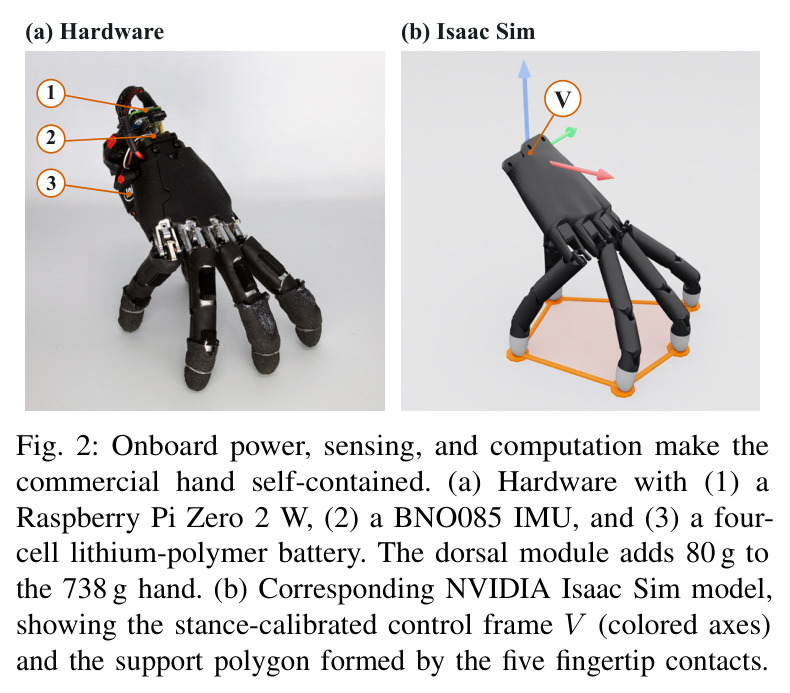
本文的目标是本文要证明:一台市售拟人手(WUJI 右手,738g,20 个驱动关节,完全保留出厂手指运动学和位置控制接口)加装 80g 背部模块(Raspberry Pi Zero 2 W、BNO085 IMU、四芯锂电池,整机 818g)后,用强化学习就能同时学会四件事——无绳指尖爬行(在 14 种室内外表面演示,从地毯、硬木到草坪、碎石)、接受平面速度和偏航率指令的转向与 IMU 闭环航向控制、跌倒后自主翻正恢复爬行姿态、以及自支撑操作:不看键盘凭本体感觉连续按下方向键(打通 Sokoban 关卡)、在头顶相机视觉反馈下把 41.4g 立方体推到指定目标。关键约束是同一批手指既移动身体、又支撑自重、又与环境交互,且不改动任何手指硬件。
与已有工作不同的是,本文的切入点不是重新设计对称手指或可重构肢体,而是让奖励'迁就'手的不对称形态:以仿真中 4 秒沉降得到的名义站姿为基准,给每根指尖分配自己的足迹目标 $p_j^*$,构成 footprint 目标;再定义一个站姿标定控制坐标系 $V$,通过 $q_V = q_B \otimes q_{off}$ 消除掌心标称倾斜,让指令和运动都在这个'名义水平'坐标系里表达。方法层面与四足社区主流的周期性步态奖励(Walk These Ways、周期奖励组合)形成对照:本文锚定的是'位置'而非'时间',每根指头何时抬、抬多高、落哪里全部交给策略自己学。评估层面则用 12 种子配对消融,把贡献与 Isaac Lab ANYmal-D stock 奖励的两种适配版本(raw 与 tuned)严格对比,而不是只报一个最终数字。
核心方法
整体思路是'市售位置控制手 + 硬件校准仿真 + 站姿中心化奖励'三件套。硬件上 WUJI 右手 20 个关节(每指 4 个)不可回驱,指令经固件 3Hz 低通滤波,限流 1.0A;80g 背板带 Raspberry Pi Zero 2 W、BNO085 IMU 和锂电池,整机 818g,500Hz 串口驱动加 50Hz ONNX 策略推理,游戏手柄走 2.4GHz 链路,安全监督器监控通信、电气与姿态。观测是所有策略共享的 46 维输入:20 个关节角(相对固定参考)、掌心系重力单位向量与角速度、上一步裁剪后的策略输出,各留 8 步历史并归一化;动作经 $\Delta q_{targ} = \alpha_q \tanh(a_t)$ 变成关节目标增量(爬行/翻正、键盘、推物分别为 0.060/0.028/0.040 rad)。训练在 Isaac Lab 用 PPO:4096 环境、20s 回合、物理 200Hz 控制 50Hz、Actor 512-256-128 ELU,8000 次迭代加 5000 次载荷/接触自适应。仿真先按硬件测量校准(刚度放大 18.7±2.5 倍、动摩擦 0.88、延迟约 19ms、3Hz 滤波),再叠加摩擦、增益、载荷质心随机化。爬行、翻正、按键、推物为四个独立策略,共享校准仿真、本体感觉历史和支撑保持奖励。
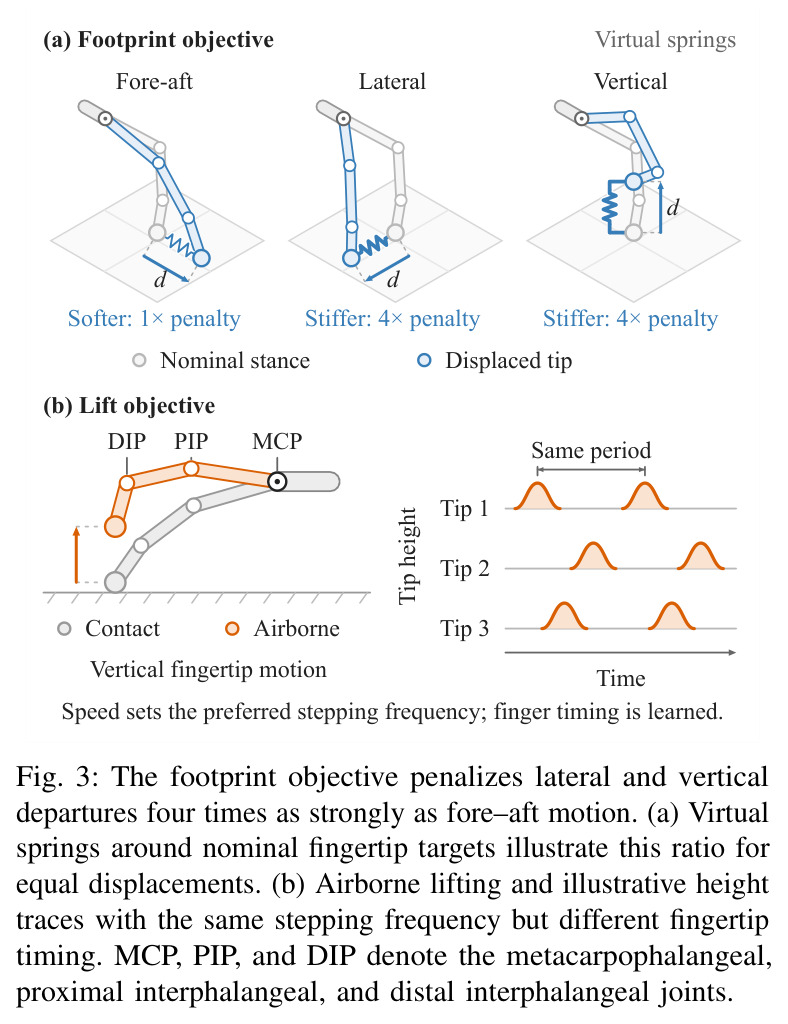
核心创新是把奖励锚定在'手自己的站姿'上,而非照搬四足定时步态。其一,footprint 目标:以沉降 4s 得到的名义站姿位置 $p_j^*$(每环境首次评估时捕获并固定)为每根指尖构造虚拟弹簧能量 $\bar{r}_{fp} = \sum_{j=1}^{5}(p_j - p_j^*)^\top W (p_j - p_j^*)$,$W = \mathrm{diag}(0.25, 1, 1)$、$\lambda_{fp} = -30$——前后弹簧软 4 倍给跨步留空间,横向竖向硬 4 倍压住乱动;目标随身体移动但不规定落脚序列与时序。其二,站姿标定系 $V$:由 $q_V = q_B \otimes q_{off}$ 消除掌心名义倾斜且随根旋转——stock 的 flat-orientation 惩罚在名义站姿处恰好为零、与航向无关,做不到这一点。其三,lift 目标用复指数滑动平均 $z_{j,t} = (1-\alpha_\tau) z_{j,t-1} + \alpha_\tau u_{j,t} e^{-i\varphi_t}$ 提取指尖竖向振荡包络,仅在指尖离地(<0.15N)且指令速度 ≥0.02 m/s 时生效,踏步频率 1→3.5Hz 随指令速度线性上升,'哪根指头何时抬'交给策略;另有 direction 目标惩罚离地指尖的逆向平面速度。与已有方法的本质区别:四足方法依赖左右镜像对称(镜像损失/等变策略),对对掌拇指与不等长手指完全不适用,本文改为'每指一个目标'的形态适配设计。
方法步骤详情
第一步,硬件标定仿真:关节频率扫描得刚度系数 15-22 倍(均值 18.7±2.5),带载指尖拖拽测动摩擦 0.88,定时指令响应得延迟约 19ms,屈曲/外展斜坡测滤波后关节速度 2.8/2.5 rad/s,轨迹对比定 3Hz 滤波截止。第二步,观测与动作:46 维通用输入(各 8 步历史)加任务专属输入——键盘任务有请求键 one-hot(4 维)和按压指尖在 $V$ 系位置(3 维),推物任务有物体根相对位置、速度与到目标向量(各 3 维,均 $V$ 系);动作是 20 维关节目标增量。第三步,训练爬行:PPO 8000 迭代,课程先只跟踪平面速度(+1.0)、18000 步后引入偏航(+0.5),lift 权重从 6.25 几何衰减到 0.625;终止条件为掌触地、横滚 >35°、俯仰 >30°;再加 5000 迭代域随机化(摩擦 [0.30,1.30]、增益 [0.78,1.22]、80g 载荷质心 ±10/15mm、掌质量/质心/IMU 偏置)。第四步,任务策略:翻正从侧躺随机朝向起步,惩罚倾斜、奖励达到爬行站高与关节姿态;键盘奖励接近、按压深度、正确键与支撑,物理 USB 事件只评分不进 Actor;推物奖励接近、推向目标并保持,仿真用 60Hz 相机模型(1-3 步延迟、3% 丢包、2mm 噪声)。第五步,部署:直立检测器(倾角 <10° 且角速度 <4 rad/s 持续 0.5s)触发 1.5s 平滑斜坡进入爬行姿态,之后手柄指令控制,全程无线。
技术新颖性
技术新颖性体现在四个层面。其一,形态适配的奖励设计:footprint 目标是'每根手指一个目标'的空间锚定,天然容纳不等长手指和对掌拇指,绕开了需要镜像对称的整套方法(对称性损失、等变网络、数据增强),这是与四足奖励迁移工作的根本差异。其二,坐标系设计:站姿标定系 $V$ 与 stock 基线的 flat-orientation 惩罚有微妙但关键的区别——后者在名义站姿处为零、与航向无关,只惩罚任意倾角,而 $V$ 系把'倾斜的参考系'本身翻转掉,使指令语义(前进/左转)在倾斜站姿下依然正确。其三,'锚定位置而非时间':不预设足端轨迹或接触时序表(区别于 Walk These Ways 的参数化接触时刻表和周期奖励组合),步频只是被 lift 目标温和地与指令速度挂钩。其四,诚实的评估实践:奖励权重在硬件活动前固定、消融前不再调参,tuned stock 基线的筛选种子与其报告种子部分重叠也被如实披露,所有对比给出 12 种子的 95% 置信区间,还专门设计了'非指甲参与率'和'最差指尖着地倾斜'来区分' participation 高但用指甲尖站着'的假象。
实验结果
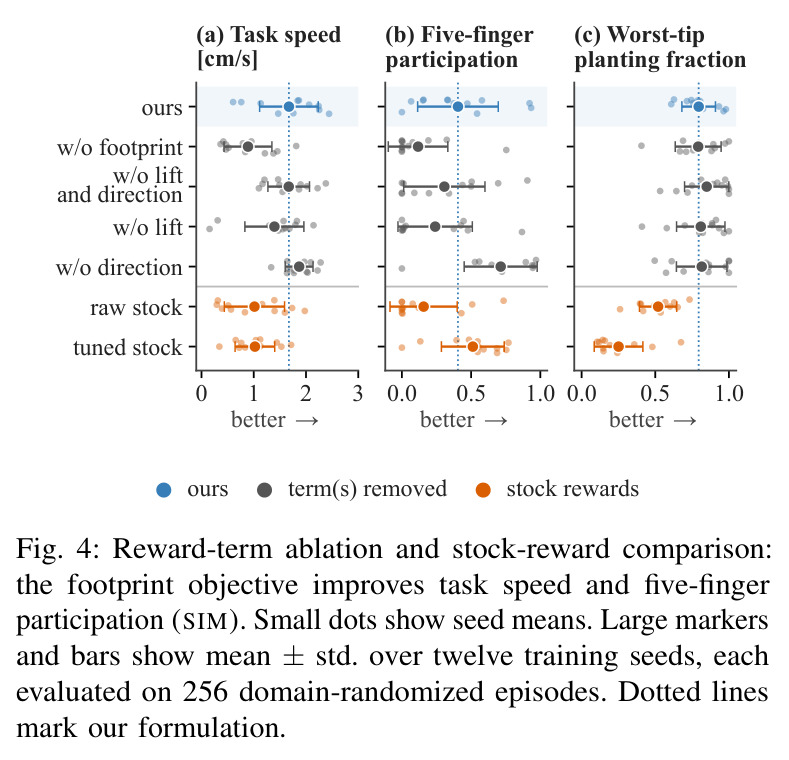
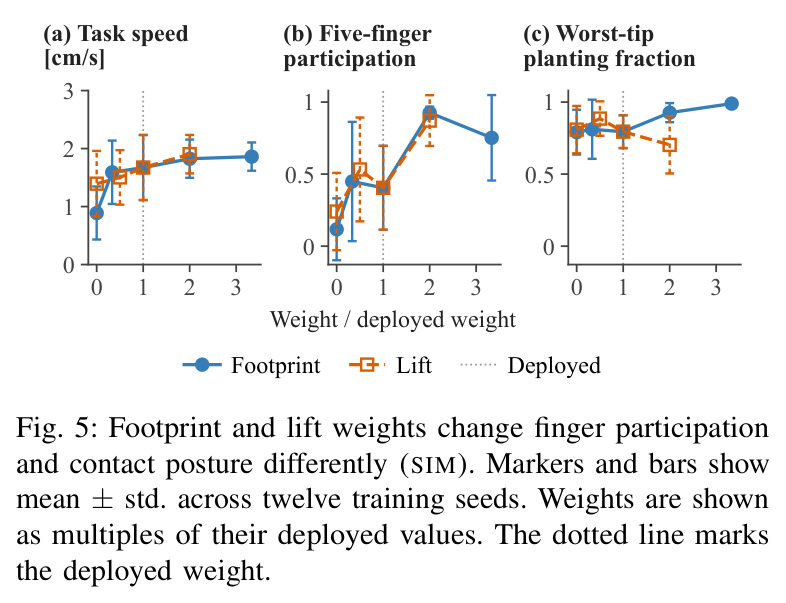
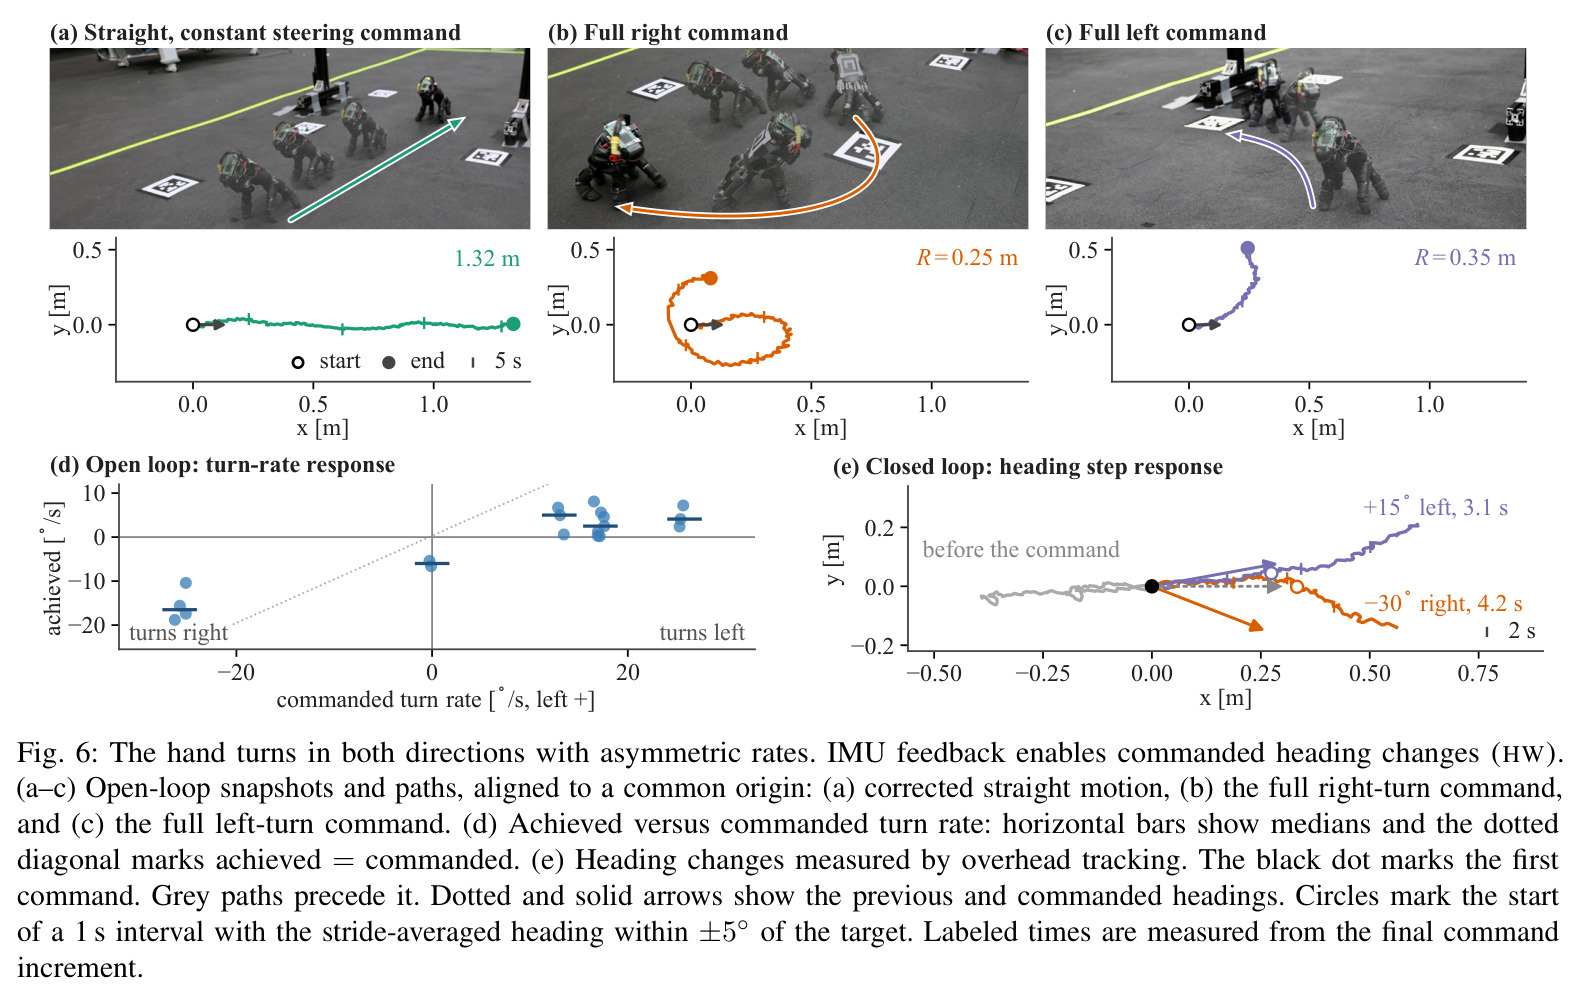
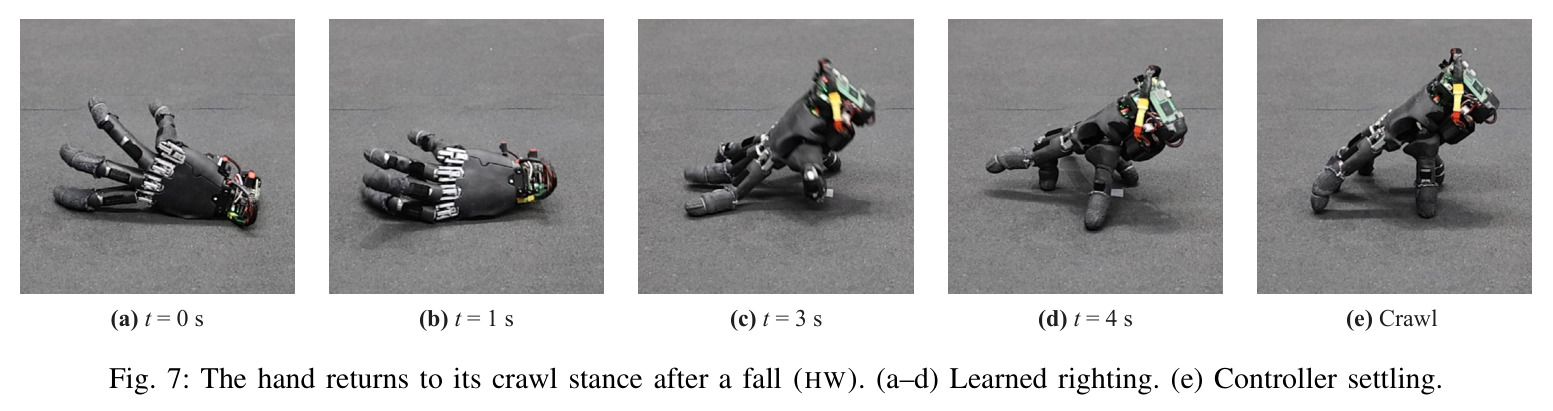
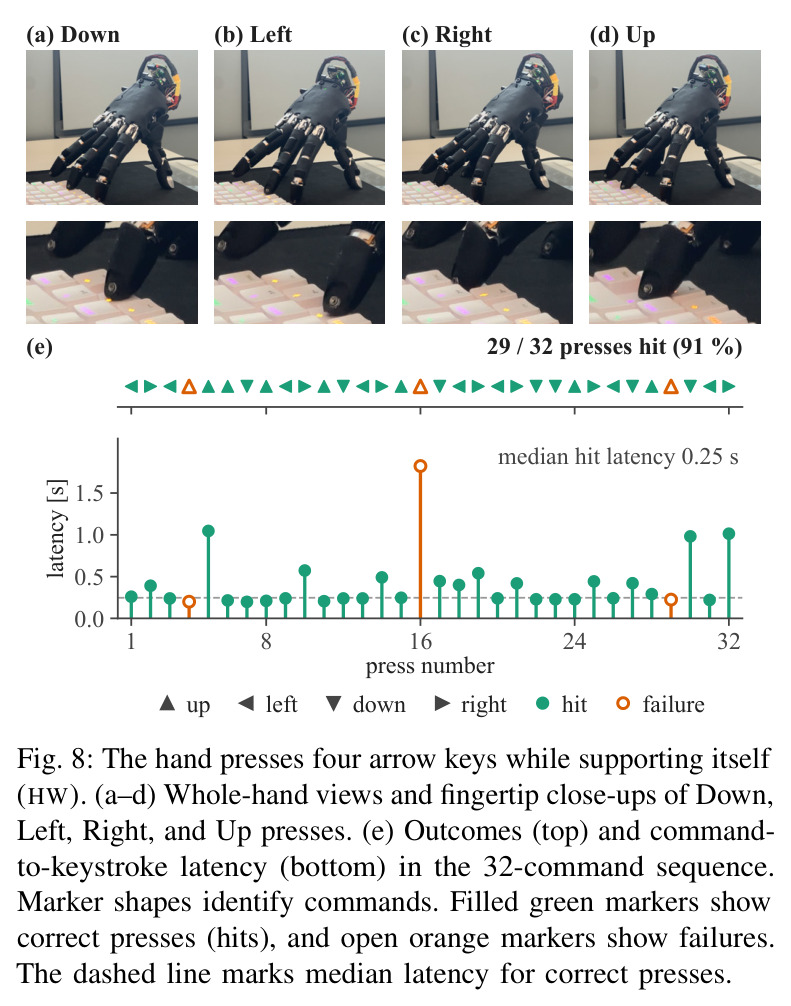
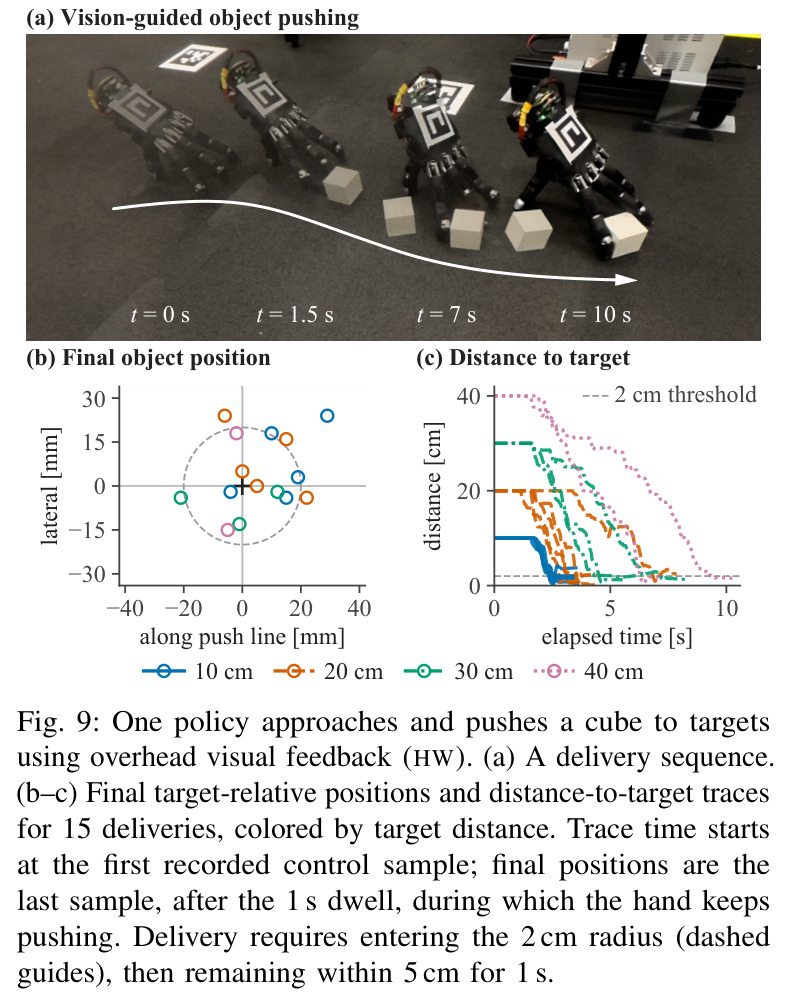
仿真消融(12 种子、每种子 256 回合)显示本文奖励全面优于 stock:比 tuned stock 快 0.65 cm/s [95% CI +0.26, +1.02](10/12 种子更快),非指甲参与率高 0.35 [+0.18, +0.53]——tuned stock 参与率虽不低但每个种子都用更多指甲着地。逐项消融中 footprint 贡献最明确:移除后速度降 0.79 cm/s [+0.37, +1.19]、接触倾角向指甲侧偏 8.8° [+1.4, +15.9];移除 direction 反而使五指参与率升 0.31,速度效应不确定。权重扫描中 footprint 加倍的指着地率比 lift 加倍高 0.22 [+0.11, +0.33]。硬件上爬行覆盖 14 种表面(定性演示),平均速度 0.093 m/s,开环右漂约 6°/s,右/左转半径 0.25/0.35m;IMU 闭环 ±15° 航向阶跃 3.1s/4.2s 达成,30° 右转成功而左转欠达。翻正硬件 21/25(84%),仿真 28/32、中位 6.1s、关节误差 0.004 rad。盲按键盘 32 条指令命中 29 次(91%),中位延迟 0.25s,最大倾角 7.7°,3 次失败全是 Up 键误触 Right Shift;同一接口打通 Sokoban 9 步与 12 步最优解。视觉推物(40mm、41.4g 立方体)15 次投放(10-40cm)最终误差均值 17mm(5-37mm),不足边长一半。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 仿真爬行速度(奖励对比,12 种子) | 任务速度(指令方向进度,域随机化回合均值) | 本文 footprint+lift+direction formulation | raw / tuned stock(ANYmal-D 平地速度跟踪奖励适配,tuned 经 24 组权重筛选) | 比 tuned stock 快 0.65 cm/s [+0.26, +1.02],10/12 种子更快 |
| 接触姿态质量(仿真) | 非指甲参与率 / 最差指尖着地倾斜 | 非指甲参与率高 0.35 [+0.18, +0.53];footprint 移除使倾角向指甲侧偏 8.8° [+1.4, +15.9] | tuned stock(参与率高但指甲着地更多) | 参与率与姿态需联合评估,本文 formulation 两者兼得 |
| 无绳爬行与转向(硬件) | 路径速度 / 转弯半径 / 航向阶跃 | 0.093 m/s;右转 R=0.25m、左转 R=0.35m;±15° 阶跃 3.1s/4.2s 达成 | 开环无指令漂移约 6°/s 向右 | 常值修正即可直线行驶;IMU 闭环双向转向;30° 左转欠达 |
| 跌倒自主翻正(硬件 / 仿真) | 成功率、恢复时间 | 硬件 21/25(84%);仿真 28/32,中位 6.1s,关节误差 0.004 rad | 无(新能力演示) | 4 次失败均为手指互相卡挂导致停滞 |
| 无视觉键盘按键(硬件) | 正确率、指令到击键延迟 | 29/32 命中(91%),中位延迟 0.25s,最大倾角 7.7° | 无(能力演示) | 3 次失败均为 Up 键误触 Right Shift;可解 Sokoban 9/12 步关卡 |
| 视觉引导推物(硬件) | 最终目标误差(进入 2cm 后保持 5cm 内 1s 判定投放) | 15 次投放(10-40cm 目标距),均值 17mm(5-37mm) | 无(能力演示) | 误差不足立方体边长(40mm)一半 |
局限与改进
作者坦承的局限:14 种表面的爬行只是定性演示、配套补充视频,没有逐表面的系统性指标;转向明显不对称(左转率饱和、30° 左转因抵消 6°/s 右漂的偏置叠加而超出训练范围欠达);键盘需要操作员用试按手动对齐四个名义键位,策略不跟踪手相对键盘的平移,错位必须人工重新校准(3 次失败即源于此);推物依赖固定在头顶的相机做手和物体的跟踪,工作空间被相机视野限定,键盘按压也不用视觉。我自己的观察:四个任务是四个独立策略而非统一的 loco-manipulation 策略,任务间没有迁移或共享结构的学习被验证;direction 目标的贡献被自己的消融证伪(移除后参与率反而升),说明奖励设计仍有冗余;'参与率'指标本身依赖 64° 倾角阈值判定指甲侧/指腹侧,分类器比较粗糙;此外整个系统只有一个右手、没有抓取/拾起能力,操纵仍是推和按;延迟方面 0.25s 的按键延迟对实时交互偏慢。
独立分析的弱点
第一,开环右漂 6°/s 暴露仿真与硬件之间未建模的不对称(可能是手指装配误差或地面不均),目前靠 IMU 闭环加常值偏置兜底,改进方向是在线估计并自适应漂移项。第二,四个任务是四个独立策略,换任务需重训 8000 次 PPO 迭代且动作尺度各异(0.060/0.028/0.040 rad),可训练条件化统一策略或至少验证共享底层支撑技能的迁移。第三,键盘对齐完全依赖人工试按,3 次失败全是系统性按压点偏移(Up 键触发 Right Shift),机载 Pi 完全可以加微型相机或触觉做粗对齐。第四,Fig. 5 显示部署权重偏保守:footprint 加倍后速度变化不确定但着地率持续改善,且 lift/direction 的贡献在统计上难以与 footprint 区分(移除 direction 甚至提升参与率),可用更可分离的指标(如步频谱分析)或因果归因方法重新评估。第五,非指甲参与率依赖 64° 倾角阈值这一硬编码启发式,换指尖形状或材料即失效,可用可学习的接触形态表征替代。第六,操作仅限按压与推动、没有抓取,而支撑与抓取的耦合才是移动操作真正的难点;0.25s 的按键延迟对实时交互也偏慢。
未来方向
作者提出的方向:(1) 扩大可指令航向范围,解决左转欠达问题;(2) 集成机载感知——视觉配准自动完成键盘对齐、机载手/物体跟踪让推物摆脱头顶相机工作空间的限制;(3) 终极愿景是让更大的机器人把这种自走手投放到受限空间、让它操作为人类设计的控制和物体界面、再回收。基于本文成果可以延伸的方向:其一,统一 loco-manipulation 策略——把爬行、翻正、按键、推物合成一个多任务策略,验证 footprint 奖励是否是可共享的底层'支撑技能';其二,双手机协作——两只自走手配合搬运,支撑多边形和协调步态都会更有趣;其三,把仿真标定流程(Table 2 的五项测量)做成通用工具链,推广到其他位置控制手;其四,与触觉传感结合,让按压深度控制从开环深度奖励变成闭环力控,消除误触相邻键的问题;其五,在可形变地面(沙地、软垫)上系统量化 14 种表面性能,把定性演示变成 benchmark;其六,探索无对掌拇指的更简形态(四指无拇指)下 footprint 奖励是否仍然成立,检验方法的形态普适性。
复现评估
复现难度中等偏上但信息完备。有利面:论文给出全部关键参数——PPO 超参(γ=0.99、GAE λ=0.95、熵系数 0.005、自适应学习率起始 1e-3、clip 0.2)、4096 环境、20s 回合、物理 200Hz/控制 50Hz、8000+5000 迭代、完整奖励权重(Table 3)、硬件标定流程(Table 2 的频率扫描/带载拖拽/定时响应)、观测 8 步历史、动作变换 $\Delta q_{targ} = \alpha_q \tanh(a_t)$ 及各任务尺度、部署栈(500Hz 串口、50Hz ONNX)。若只复现仿真部分的奖励消融(Fig. 4/5),有 Isaac Lab 和一块高端 GPU(A100/4090 级)即可,论文信息足够;但 12 种子 × 7 配置的完整消融算力可观,且论文未提及开源代码。硬件复现更难:依赖特定市售 WUJI 右手(738g)及其固件位置控制接口,难以替代;还需复刻 80g 背板(Pi Zero 2 W、BNO085、4S 锂电)、overhead 跟踪相机、物理键盘 USB 事件采集与手柄链路,整个 818g 平台与标定流程工作量以月计。
论文图表
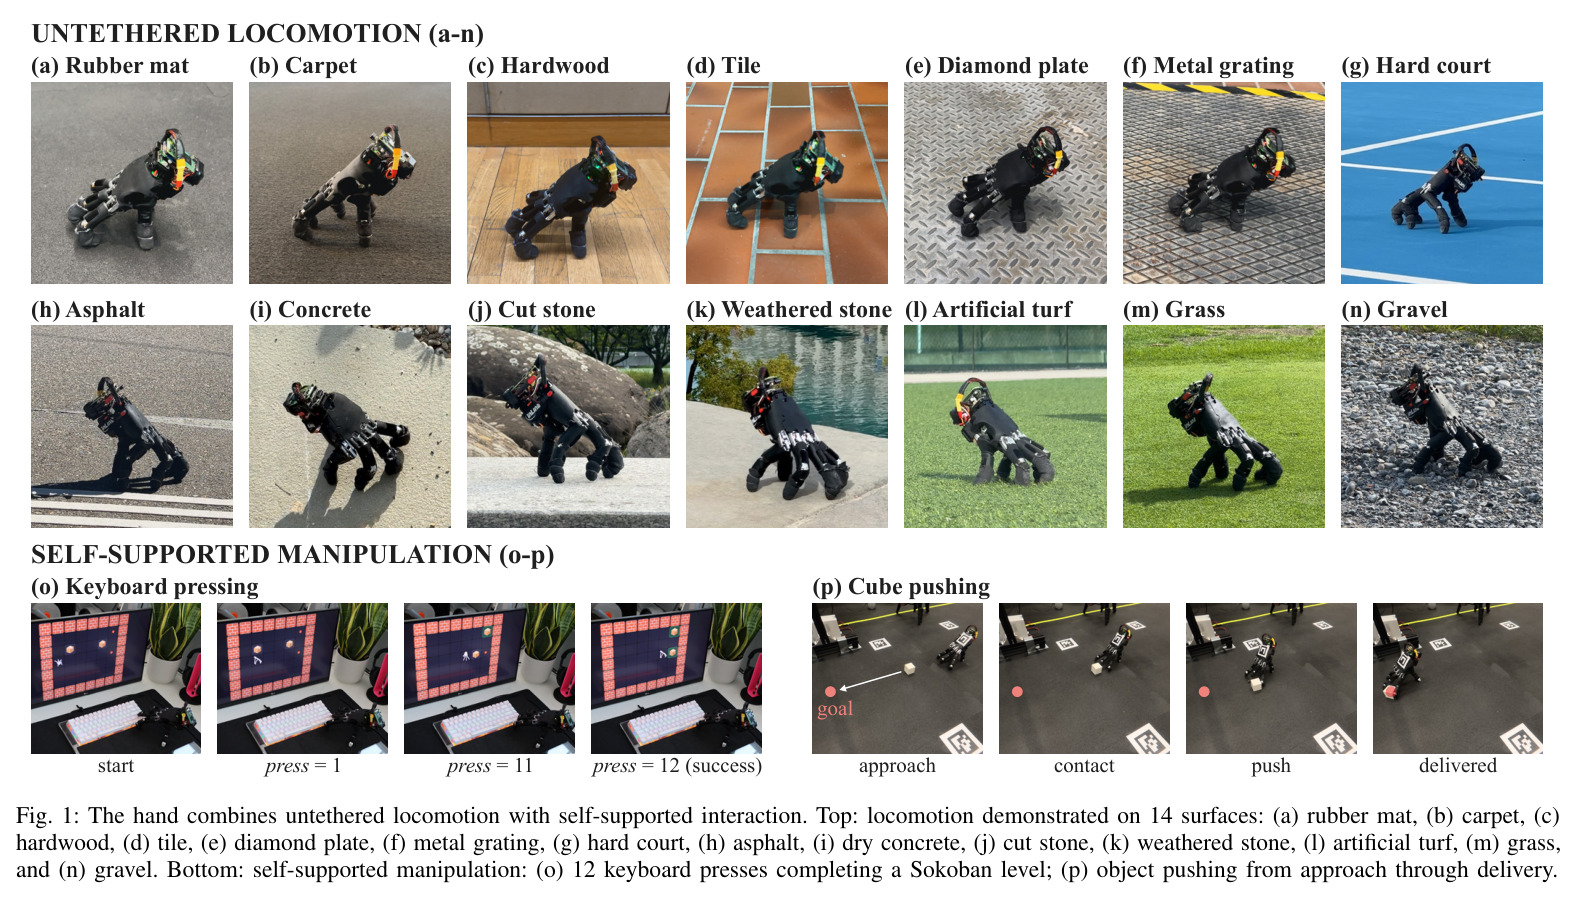
首图双联画:上半部分展示无绳爬行的 14 种表面——橡胶垫、地毯、硬木、瓷砖、花纹钢板、金属格栅、硬地球场、沥青、混凝土、切石、风化石、人造草坪、草地和碎石;下半部分展示自支撑操作——(o) 12 次键盘按压打通 Sokoban 关卡的帧序列(approach → contact → push → delivered),(p) 推物任务从接近、接触到送达的过程。
一图看懂论文的全部主张:同一只未经改装的拟人手,既能在 14 种真实表面上用指尖走路,又能在支撑自重的同时按键和推物,这是论文标题'手指当腿用'的直观证据。
列出每个策略在 46 维通用本体感觉观测之外额外接收的任务专属输入:Crawl/Recovery 接收 V 系平面指令(2 维)和偏航率指令(1 维);Keyboard 接收请求键指示(4 维 one-hot)和按压指尖在 V 系位置(3 维);Pushing 接收根相对物体位置(3 维)、世界系物体速度(3 维)、物体到目标向量(3 维),均 expressed in V。
是理解各策略输入接口和'所有位置都在站姿标定系 V 中表达'这一方法学决策的关键参考,复现时必须严格对照。
五项硬件测量及其标定流程:关节刚度标定系数 15-22 倍(均值 18.7±2.5,关节频率扫描)、动摩擦系数 0.88(范围 0.80-0.97,三次带载指尖拖拽)、闭环延迟约 19ms(定时指令响应)、滤波后关节速度 2.8/2.5 rad/s(屈曲/外展斜坡)、指令滤波截止 3Hz(轨迹对比)。
sim-to-real 成功的基石:每个仿真参数都有对应的物理测量程序,这种'测量驱动校准'的可复现方法论是本文区别于纯域随机化工作的亮点。
部署爬行策略的完整训练配置:4096 并行环境、20s 回合、Actor 512/256/128 ELU(输入 392/输出 20)、50Hz 控制、8000+5000 次 PPO 迭代、平面/偏航跟踪系数 +1.0/+0.5、目标项权重 λfp=-30、λlift 6.25→0.625、λdir=-0.5、 undesired contact -1.0、vz -2.0、ωxy -0.05、action rate -0.01、力矩/关节加速度正则、以及摩擦 [0.30,1.30]、增益 [0.78,1.22]、80g 载荷质心 ±10/15mm 的域随机化范围和 PPO 超参(γ=0.99、λ=0.95、熵 0.005、自适应学习率起始 1e-3)。
复现训练的唯一权威参考:所有奖励权重、课程安排(18000 步引入偏航、lift 权重衰减日程)和随机化范围都在此表中,没有它无法重建仿真实验。