扩散语言模型中用于有界状态推理的寄存器令牌 Register Tokens for Bounded-State Reasoning in Diffusion Language Models
用少量固定位置的连续寄存器令牌,让扩散语言模型在清除已生成文本后继续推理。
前置知识
掩码扩散语言模型 (dLLM)
一类通过迭代去噪生成文本的语言模型。训练时把部分 token 替换为 [mask],模型在双向注意力下预测被掩码位置的原 token,损失为 $\mathcal{L}_{\text{mask}}(\theta) = -\mathbb{E}_{t,(c,y_0),y_t}[\sum_{k\in M_t}\log p_\theta(y_k^0\mid c\oplus y_t)]$。推理时从全掩码块出发,每步并行预测所有掩码位置、保留高置信预测、其余重新掩码,迭代至全部解出。LLaDA-8B 与 Dream-7B 是代表性开源模型。
寄存器机制完全建立在 dLLM 的双向注意力与分块去噪之上:不懂 dLLM 如何生成与续块,就无法理解寄存器为何既可写又可读。
寄存器令牌 (register tokens)
在提示词中固定位置预留的少量专用 token(数量 $R$,主实验为 4 个,位置 $r_1,\dots,r_R$)。每生成完一个块后,模型对「提示词+已完成块」做一次干净前向传播,把寄存器位置的最后一层隐状态($R\times d$ 张量)存下来;下一块用这些连续向量覆盖对应位置的输入嵌入。概念源自 ViT 的 register token,但此处存的是随推理演化、会被覆盖重写的状态。
它是全文的核心载体:训练目标、防捷径设计、消融与可解释性分析全部围绕寄存器的写入与读取展开。
注意力汇聚与可写全局状态
BERT 的 [CLS]、ViT 的 register 以及自回归模型的 attention sink 都表明固定早期位置会聚合全局序列信息。但在因果解码中这些位置是只读的——后续 token 只能读不能写;dLLM 的双向注意力使固定位置在去噪过程中既可读也可写,为「学习式携带状态」提供了天然机制。
解释了为什么寄存器方案偏偏在 dLLM 中成立,而自回归模型只能用 Memento 式 KV 携带等变通手段。
diffu-GRPO
把策略优化方法 GRPO 适配到离散扩散模型的目标(来自 d1 工作):用扩散去噪似然估计器计算 token 级当前-旧策略似然比 $\rho_{g,k,i}$,配合组内基线优势 $A_g$、clip 与参考 KL 惩罚 $\beta D_{g,k,i}$ 做更新,从而用强化学习提升 dLLM 的推理能力。
论文 4.6 节把寄存器嵌入分块版 GRPO,用 RL 进一步打磨携带状态,是方法闭环的最后一块拼图。
互信息下界 (命题 1)
在全掩码、提示被屏蔽的续写块上,预测损失满足 $\mathbb{E}[-\log p_\theta(Y_j\mid r,\ell)] \ge H(Y_j\mid r,\ell) = H(Y_j\mid \ell) - I(Y_j; r\mid \ell)$。忽略寄存器的贝叶斯最优预测器损失为 $H(Y_j\mid\ell)$,因此模型要更好就必须让寄存器 $r$ 与目标 token 携带互信息 $I(Y_j; r\mid \ell)$。
它从理论上说明为什么必须用提示屏蔽加全掩码两招堵住捷径,否则训练退化为完全不依赖寄存器。
研究动机
扩散语言模型在一个固定大小的窗口(chunk)内通过迭代去噪生成文本,当要生成的内容超过窗口长度 $C$ 时,标准做法是把新的全掩码块拼接到不断增长的上下文后面,注意力开销随总生成长度二次增长。要让推理跨越多个块,现有方法都必须保留之前生成的文本:d1 等工作通过在推理轨迹上做监督微调和强化学习提升 dLLM 推理,但先前生成文本始终留在上下文中;Markovian Thinking 只保留每个块的最后几个生成 token,AutoCompressors、LLMLingua 等自动压缩方法把先前生成压成摘要,但纯文本载体受其 token 表达能力限制;Memento 虽保留连续 KV 状态却依赖自回归结构。此外还有训练层面的隐患:分块训练时,新块可以直接注意提示词、或利用自身已解出的未掩码 token 来预测被掩码位置,从而完全绕过任何携带状态,使携带信道得不到学习信号。如何在已生成文本被清除后仅凭固定大小的状态继续推理,此前缺乏系统研究。
本文的目标是本文提出并研究「有界状态多块推理」设定:模型在固定大小窗口内生成文本,早期块的信息必须经由一个有界表示(而非可见文本)传递下去;无论生成多少块,活跃窗口与携带状态的大小都保持恒定。具体目标是把少量固定位置的寄存器 token 训练成连续的携带信道:模型把推理进度写入寄存器隐状态,清除已生成文本,然后仅凭提示词加寄存器值继续解码。论文系统回答四个问题——连续寄存器能否胜过离散文本携带与重建式压缩基线、在哪些任务(数学/代码)上收益最大、能否用强化学习进一步打磨携带状态、寄存器是否真的编码了可线性解码的任务状态。
与已有工作不同的是,本文的独特切入是利用 dLLM 双向注意力使固定位置「既可读又可写」的性质。BERT 的 [CLS]、ViT 的 register 与自回归模型的 attention sink 都表明固定早期位置会聚合全局信息,但在因果解码中这些位置只读——后来的 token 只能读不能写;而 dLLM 的寄存器位置在去噪过程中天然可写可读。与最近的相关工作相比:Recurrent Memory Transformer 在文本段间传递记忆但结构不同;Gisting、ICAE、Activation Beacon 等压缩的是输入上下文而非推理进度;Coconut 把隐状态回灌为连续输入但用作潜推理步序列;并行的 MetaState 围绕冻结扩散 LM 加循环连续记忆、Reasoning with Latent Tokens 利用仍被掩码的位置做潜计算——本文寄存器则在已完成文本被真正移除后跨块持久存在,并把训练设计重心放在迫使跨块信息必须经过寄存器上。
核心方法
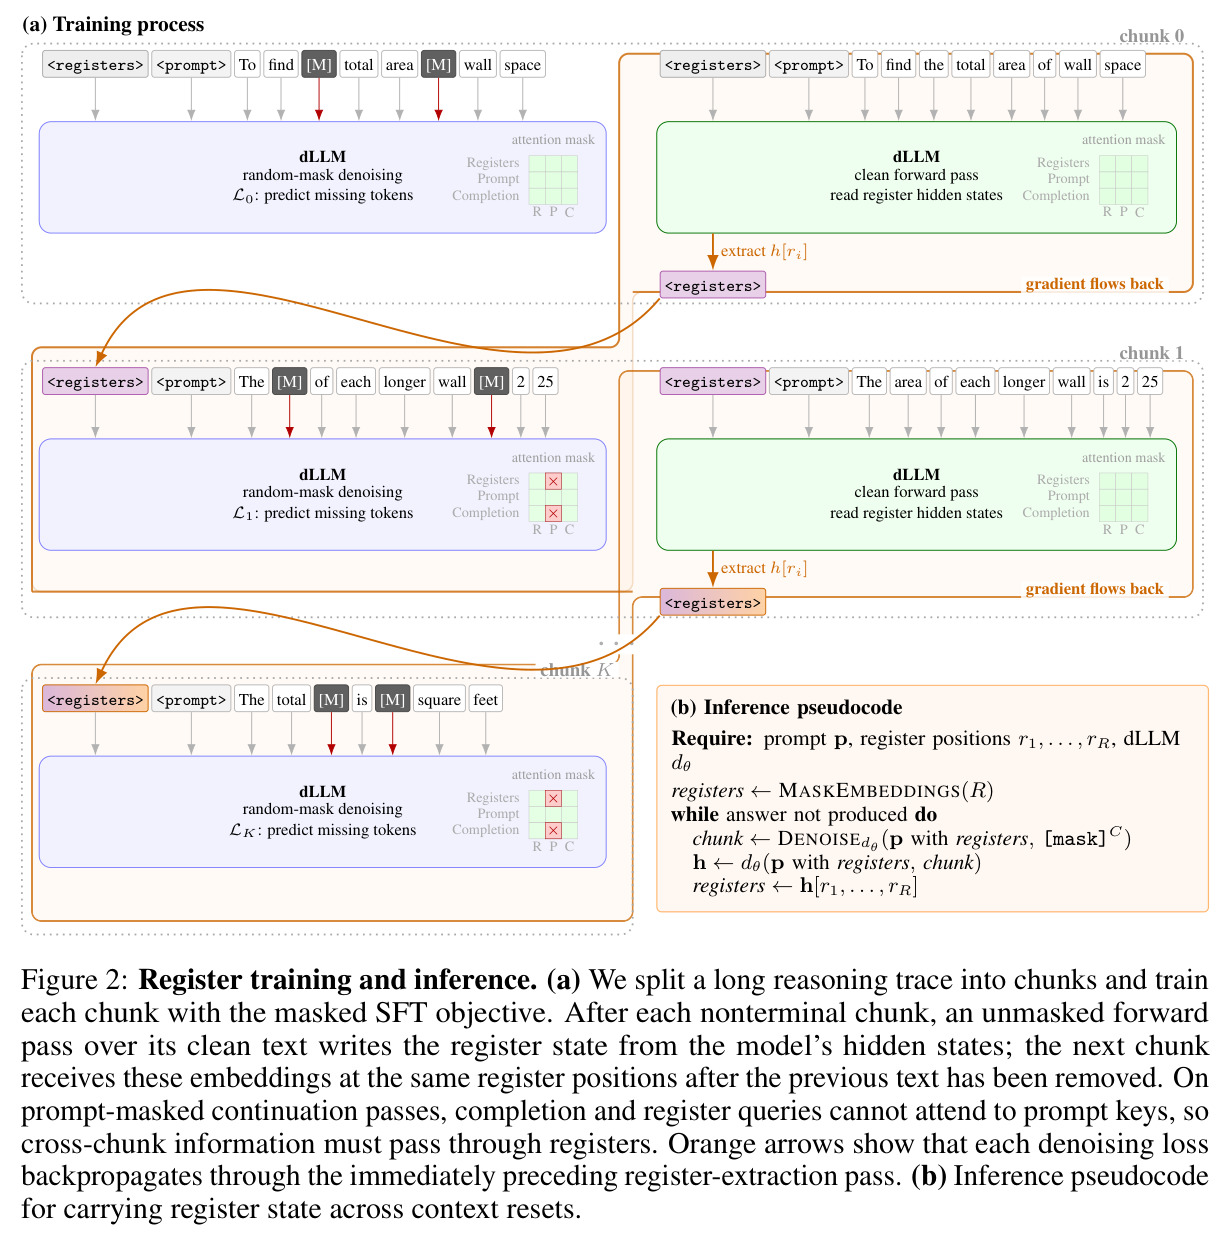
直觉上,与其让模型记住全部已生成文本,不如训练它把「推理进行到哪一步」压缩进少数几个连续槽位。技术路线分推理与训练两侧。推理侧:在提示词中预留 $R$ 个固定寄存器位置 $r_1,\dots,r_R$(主实验 $R=4$);每去噪完一个至多 $C$ token 的块,就对「提示词+已完成块」额外跑一次干净前向传播,读取寄存器位置的最后一层隐状态得到 $R\times d$ 张量;随后清除已生成文本,把保存的向量作为输入嵌入放回相同寄存器位置,从「提示词+携带状态」继续去噪下一块,循环直至产出答案。训练侧:把长推理轨迹切成 $t=(t_0,\dots,t_K)$,每块用掩码扩散目标训练;对每个续写块,先对干净的前一块做前向传播提取寄存器状态,且该提取前向保持在计算图中,使去噪损失的梯度能回流到寄存器写入,而供后续复用的状态被 detach,保证训练内存不随块数增长。主实验在 LLaDA-8B-Base 与 Dream-7B-Base 上用 6 万条 OpenMathInstruct-2 + OpenCodeInstruct 混合数据训练,数学 $C=128$、代码 $C=64$,8 个数学块或 16 个代码块合计 1024 token 预算。
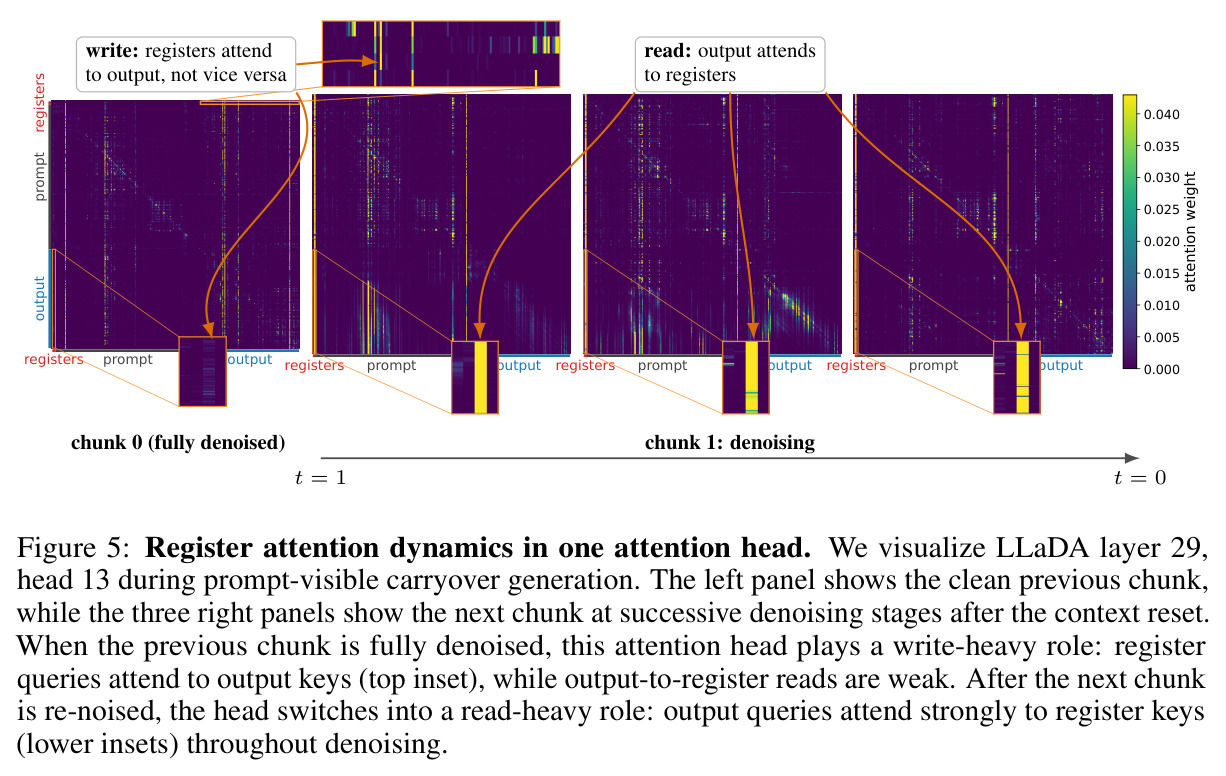
核心创新是「写入-读取协议」与配套的堵捷径设计。天真的训练会让寄存器闲置:续写块只要注意提示词就能重新解题,或靠块内未掩码的 completion token 推断被掩码位置,两条捷径都让携带状态失去学习信号。论文用两个机制封死它们。其一,以每条轨迹一次采样的概率 $p_{\text{prompt}}$ 施加提示屏蔽注意力掩码——completion 与寄存器位置既不能直接读提示词 key,也不能经由已注意提示词的寄存器中转读取,跨块信息只能走寄存器。其二,每块做 $M=4$ 个去噪 pass,第 1 个 pass 掩掉全部 completion token,其余从 $t\sim U[10^{-3},1]$ 采样,逼模型从携带状态补全整段。命题 1 给出信息论刻画:在全掩码加提示屏蔽的 pass 上 $\mathbb{E}[-\log p_\theta(Y_j\mid r,\ell)] \ge H(Y_j\mid \ell) - I(Y_j; r\mid \ell)$,寄存器必须携带互信息才能击败忽略它的贝叶斯最优预测器。与离散文本携带的本质区别:寄存器是专为继续推理训练的连续信道,信息密度远高于等数量的离散 token 摘录。
方法步骤详情
完整流程如下。第一步数据切分:取 OpenMathInstruct-2 与 OpenCodeInstruct 共 6 万条样本,把推理轨迹切成至多 $C$ token 的块(数学 $C=128$、代码 $C=64$)。第二步 chunk 0 训练:首块用标准掩码 SFT、双向注意力,与推理时无先前状态一致。第三步续写块($k>0$):先用当前参数对「提示词+干净的 $t_{k-1}$」做前向传播读出寄存器隐状态;随后每块跑 $M=4$ 个去噪 pass,每个 pass 独立做优化器步并重算前面的寄存器写入——pass 1 全掩码 completion,pass 2–4 以 $t\sim U[10^{-3},1]$ 随机掩码,其中以概率 $p_{\text{prompt}}$(每轨迹采样一次)的 pass 追加提示屏蔽;每次去噪损失都反传穿过紧邻的寄存器提取前向,供更晚块复用的状态则 detach。第四步推理:寄存器初始化为掩码嵌入,循环「去噪当前块 → 干净前向提取 $h[r_1,\dots,r_R]$ → 清除已生成文本 → 回填寄存器位置」,直至输出答案。第五步可选 RL:chunked diffu-GRPO 沿分块携带协议采样 rollout,按前缀首次答对的块定义组内优势,更早状态 stop-gradient。第六步对照基线:全序列 SFT(无携带)、离散文本(携带上一块最后 4 个 token id)、记忆 token(同布局但加 $\lambda=0.05$ 的块重建损失)。
技术新颖性
技术新颖性体现在五个层面。概念上,把 ViT 式静态 register 改造成存「跨块演化的推理状态」的读写槽:dLLM 双向注意力让固定位置在解码中既可写又可读,这是自回归模型不具备的自由度。与压缩系工作(Gisting、AutoCompressors、ICAE、Activation Beacon)不同,寄存器压缩的不是输入上下文而是模型自己的中间推理进度,且旧文本被真正删除而非被压缩副本替代。与结构上最接近的 Recurrent Memory Transformer 相比,这是在双向离散扩散 LM 上以固定槽位实现段间递归携带;与潜推理系(Coconut、pause tokens)不同,寄存器是有界记忆通道而非一串潜推理步。训练机制上的新颖点:梯度穿越寄存器写入但 detach 更早状态的有界内存设计;提示屏蔽+全掩码 pass 组合并用命题 1 的互信息下界 $H(Y_j\mid\ell)-I(Y_j;r\mid\ell)$ 论证其必要性;chunked diffu-GRPO 把携带状态纳入 RL 信用分配,而离散文本携带没有可微状态路径。此外,小规模从零训练实验发现写入/读取协议不会从任务损失自发涌现(读者不看空槽、写者得不到梯度的协调失败),需辅助监督打破僵局——这一负面结果本身也有方法论价值。
实验结果
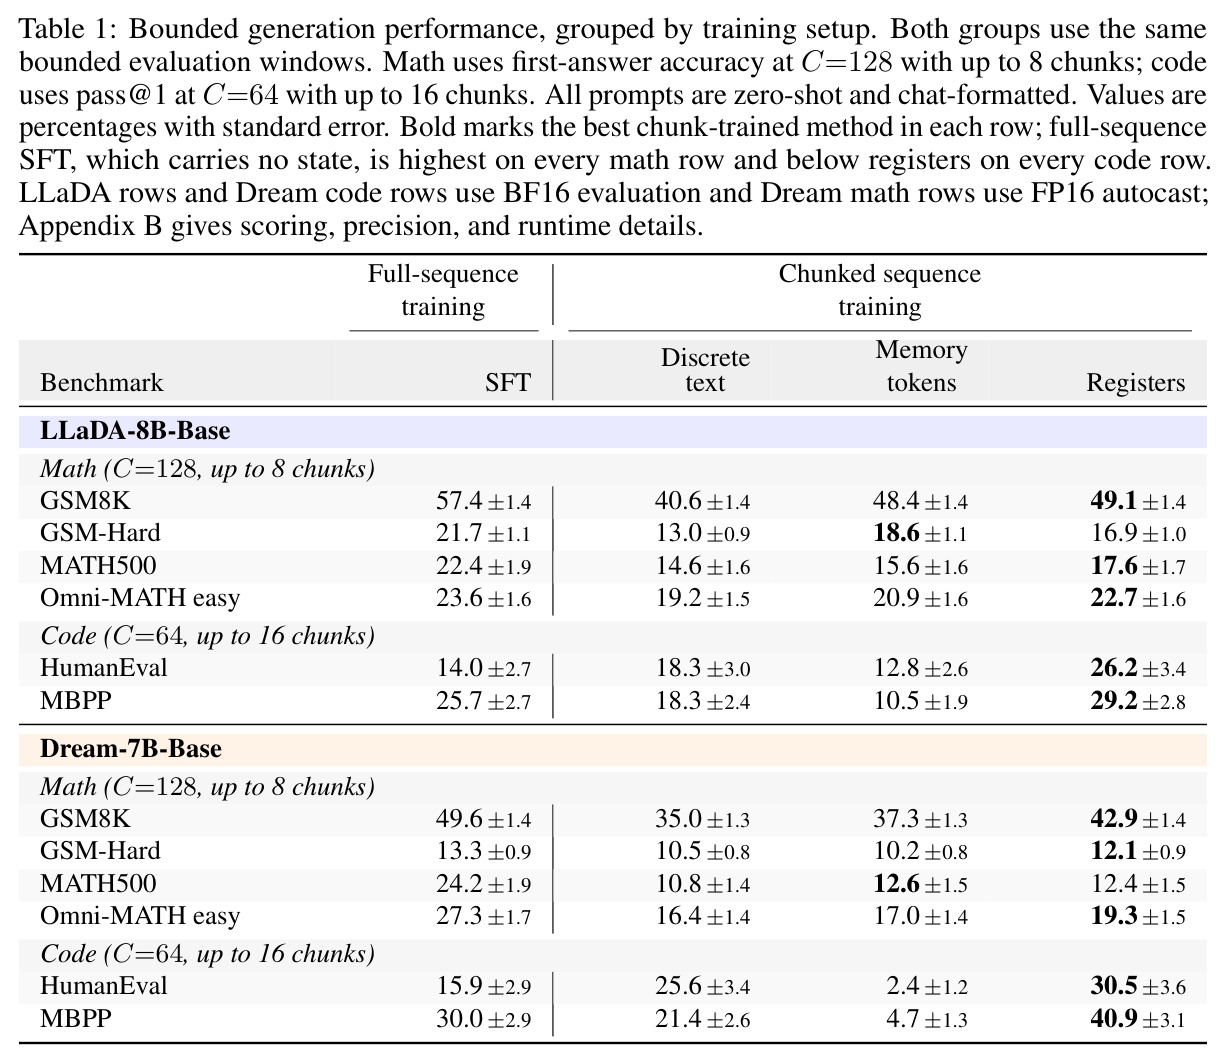
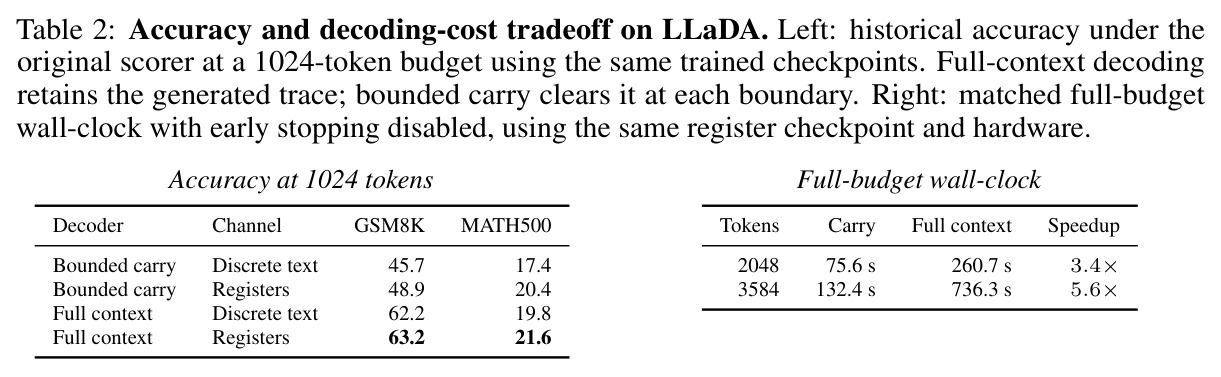
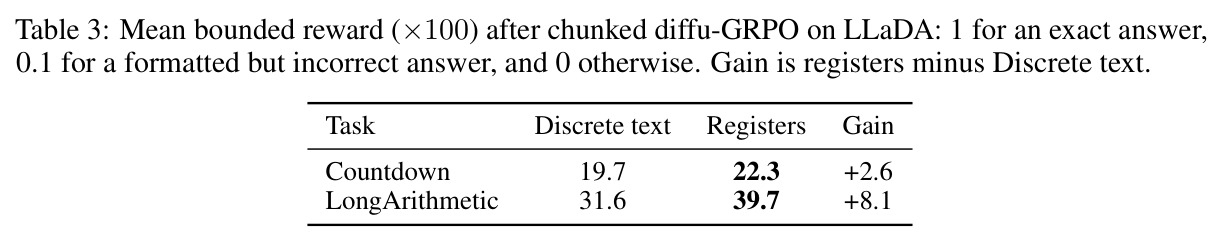
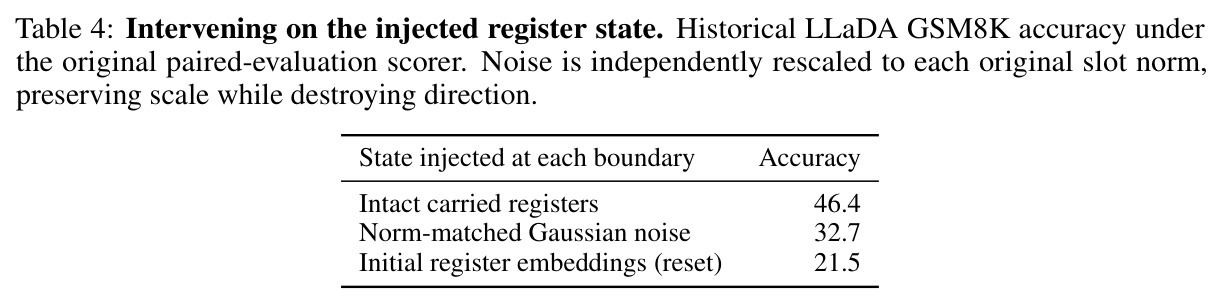
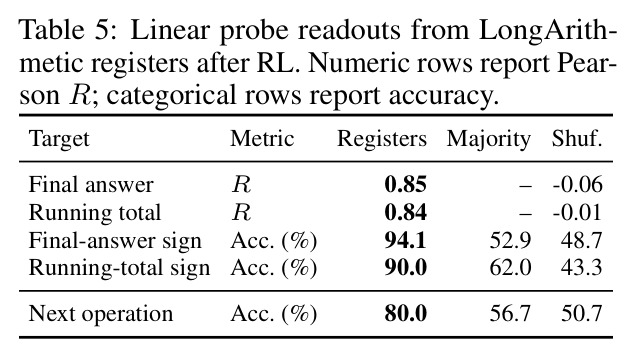
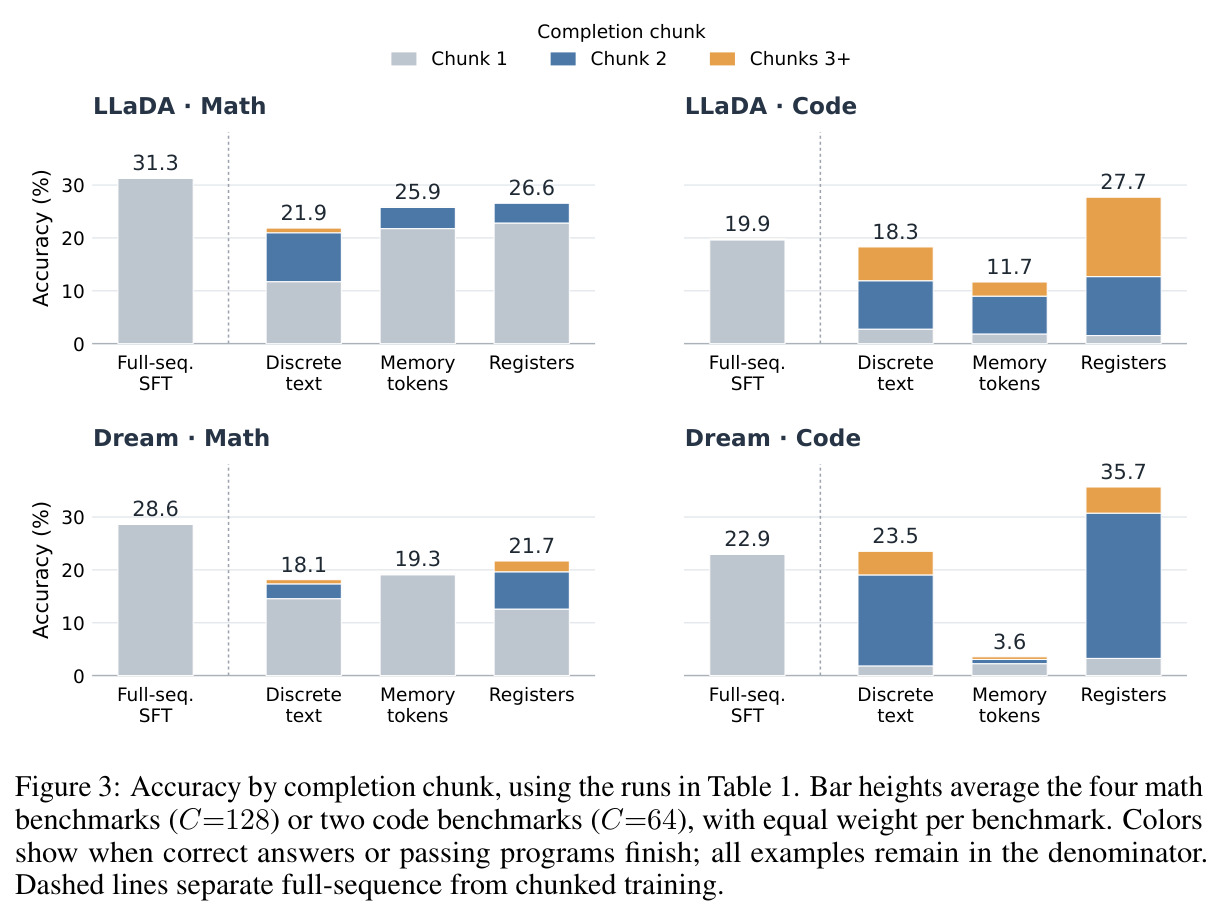
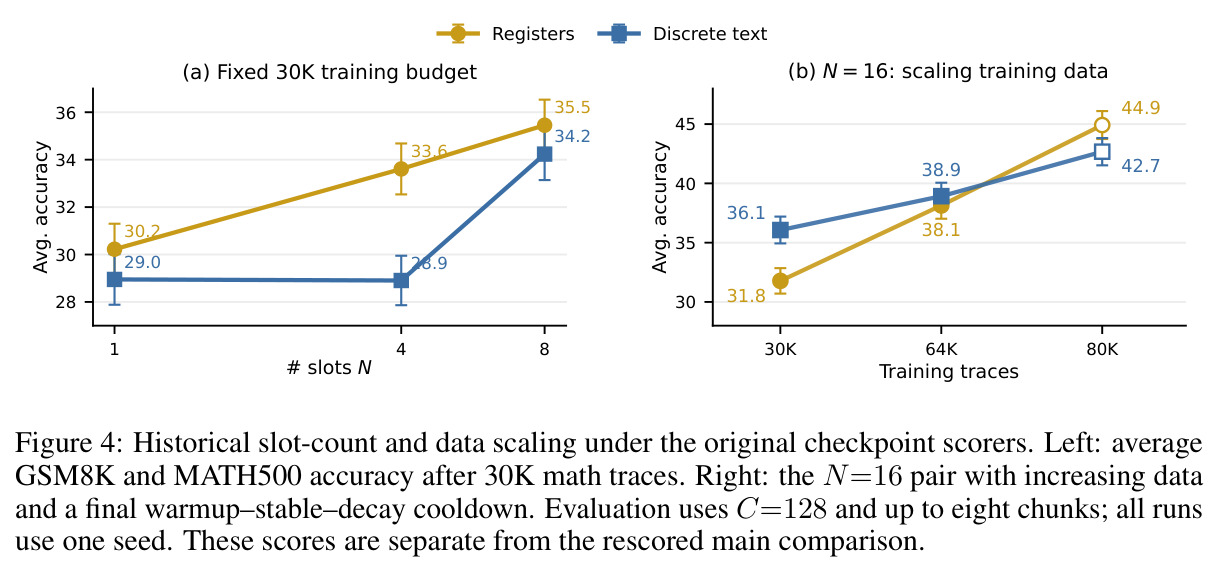
主对比见表 1:在 LLaDA-8B-Base 与 Dream-7B-Base 上,寄存器在全部 12 行击败离散文本携带、在 10/12 行领先两个携带基线。数学($C=128$、最多 8 块、first-answer accuracy):LLaDA GSM8K 寄存器 49.1 vs 离散文本 40.6(+8.5)、记忆 token 48.4、全序列 SFT 57.4;Dream GSM8K 42.9 vs 35.0(+8.0)。代码($C=64$、最多 16 块、pass@1):寄存器全部领先且超过无携带的全序列 SFT——LLaDA HumanEval 26.2 vs 14.0(+12.2)、MBPP 29.2 vs 25.7;Dream HumanEval 30.5 vs 15.9(+14.6)、MBPP 40.9 vs 21.4(最大增益 +19.5)。意外发现:全序列 SFT 在全部 8 行 $C=128$ 数学界领先,尽管训练补全仅约 3.7% 能装进 128 token,其正确答案全部落在第 1 块。Fig. 3 显示寄存器代码成功中 26.2/27.7(LLaDA)与 32.4/35.7(Dream)的分数来自跨块完成的程序;Table 2 显示 1024 token 预算下有界携带不如全上下文准(48.9 vs 63.2)但墙钟快 3.4–5.6 倍、寄存器更新仅约 1.6% 开销;Fig. 4 槽数消融中寄存器在 $N=1/4/8$ 分别 +1.3/+4.7/+1.2,$N=16$ 起步落后(31.8 vs 36.1)、80K 冷却后反超(44.9 vs 42.7);Table 3 RL 后寄存器在 Countdown +2.6、LongArithmetic +8.1。可解释性:Table 4 干预实验中匹配范数高斯噪声掉 13.7 分、重置再掉 11.2 分;Table 5 线性探针解码最终答案 $R=0.85$、运行总和 $R=0.84$、下一运算 80.0%(多数基线 56.7%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GSM8K 数学(LLaDA-8B-Base,C=128) | first-answer accuracy (%) | 49.1(寄存器) | 40.6(离散文本携带) | +8.5 分 |
| GSM8K 数学(Dream-7B-Base,C=128) | first-answer accuracy (%) | 42.9(寄存器) | 35.0(离散文本携带) | +8.0 分 |
| MBPP 代码(Dream-7B-Base,C=64) | pass@1 (%) | 40.9(寄存器) | 21.4(离散文本携带) | +19.5 分 |
| HumanEval 代码(LLaDA-8B-Base,C=64) | pass@1 (%) | 26.2(寄存器) | 14.0(全序列 SFT,无携带) | +12.2 分 |
| HumanEval 代码(Dream-7B-Base,C=64) | pass@1 (%) | 30.5(寄存器) | 25.6(离散文本携带) | +4.9 分;超全序列 SFT +14.6 |
| LongArithmetic RL(LLaDA,chunked diffu-GRPO) | mean bounded reward ×100 | 39.7(寄存器) | 31.6(离散文本携带) | +8.1 |
| Countdown RL(LLaDA,chunked diffu-GRPO) | mean bounded reward ×100 | 22.3(寄存器) | 19.7(离散文本携带) | +2.6 |
| LLaDA 生成 3584 token 墙钟(禁用早停) | 秒 | 132.4s(有界寄存器携带) | 736.3s(全上下文) | 5.6× 加速(2048 token 时为 3.4×) |
局限与改进
作者明确承认的局限:寄存器不能替代全上下文解码——1024 token 视野下保留全轨迹更准(GSM8K 63.2 vs 48.9),计时研究也未报告峰值内存与超骨干上下文的表现;全序列 SFT 在全部 8 行 $C=128$ 数学界领先,寄存器相对无携带 SFT 的增益只出现在代码;$C=64$ 短窗口对照中离散文本在 GSM8K 与 GSM-Hard 反超 SFT 而寄存器仍低于 SFT,说明携带收益同时依赖延续行为与状态表示;连续与离散槽位只匹配数量不匹配容量,且两者提示屏蔽概率不同;掩码策略与去噪 pass 数未单独消融;多数 SFT 对比只用一个 seed,并非每个数值领先都显著;BF16/FP16 精度差异被记录但存在;LLaDA-Instruct 试点显示基础模型配方会劣化指令微调初始化。我的补充观察:数学评测的 first-answer 规则让大多数样本在第 1 块就定胜负(重置实验平均仅掉 3.8 分),对持续推理能力的度量偏弱;可解释性证据最强的是状态显式的 LongArithmetic,能否推广到开放推理未知;Table 4 沿用旧评分器与主表不可直接比较效应量。
独立分析的弱点
第一,训练配方超参多且关键成分未系统消融:$M=4$ 个去噪 pass、$p_{\text{prompt}}$、记忆 token 的 $\lambda=0.05$ 都是直接设定值,改进方向是网格消融并给出成本-收益曲线。第二,$N=16$ 大槽位寄存器起步落后离散文本(30K 轨迹时 31.8 vs 36.1),要靠加数据和冷却调度才在 80K 反超(44.9 vs 42.7),说明寄存器优化难度高;可引入针对槽位的初始化、课程学习或辅助监督加速收敛。第三,从零训练时写入/读取协议不会自发涌现,辅助监督跨种子不稳定(作者自称存在性证明而非配方);改进是全程用边界真值监督,或先在小模型上预训练读写协议再迁移。第四,数学 first-answer 评分低估跨块能力——重置实验平均只掉 3.8 分,说明携带效应在数学上被评分规则稀释;可改用强制多块或 last-answer 评分。第五,单一 seed 与 BF16/FP16 精度混杂削弱统计效力,应多种子并统一精度。第六,干预实验缺少作者自己指出的跨样本交换与逐槽置换控制。第七,寄存器与离散槽位容量不对等使比较天然偏向连续信道,可做等容量扫描;指令模型不兼容,需为 instruct 初始化调整配方。
未来方向
作者提出的方向:其一,把同一写入/读取协议改造成学习式长上下文压缩器——让寄存器吸收长输入提示或整个文档,成为 dLLM 上替代 KV-cache 截断或全注意力的训练式方案;其二,利用块内已并行解码的众多位置,把寄存器作为跨块存活的共享协调信道,支持更激进的并行解码调度而不失全局一致性;其三,做多块梯度展开或用中间任务信号辅助监督寄存器,实现奖励信用回传更远的长视野 RL;其四,扩展到更大模型、更多领域与更长视野以检验有界状态机制的普适性。基于本文成果还可自然延伸:寄存器与 KV cache 的混合管理策略(保留少数持久槽位、丢弃其余缓存);跨任务可迁移的通用寄存器库与「技能槽」组合;用探针信号做正则或对寄存器状态做可控编辑(steering);理论上刻画寄存器容量上界及 $I(Y_j;r\mid\ell)$ 的可达区域;把 chunked diffu-GRPO 与过程奖励模型结合,让每块的寄存器写入直接得分。
复现评估
复现条件较好。代码承诺开源于 github.com/lbertge/dllm-registers-reasoning,训练混合数据与已发布 checkpoint 放在作者的 HuggingFace collection;底座 LLaDA-8B-Base 与 Dream-7B-Base 均为公开权重,训练数据 OpenMathInstruct-2 与 OpenCodeInstruct 公开可下载。算力方面论文未给出确切 GPU 配置,仅致谢 Modal 提供计算支持;按 8B/7B 模型、6 万条样本、每块 4 个去噪 pass 且梯度需穿过寄存器提取前向估算,SFT 约需多卡 A100/H100 数天量级,chunked diffu-GRPO 需再叠加 rollout 开销,但寄存器状态 detach 保证训练内存不随块数增长。评测协议(first-answer、pass@1、$C=128/64$、最多 8/16 块)在附录 B 有详细说明;复现须注意三处坑:数学与代码用不同精度(BF16/FP16)、历史消融沿用旧评分器与主表不可直接对比、连续与离散基线的提示屏蔽概率不同。总体难度中等偏高:拥有 4–8 张高端 GPU 的团队可在数天内复现主表,RL 部分门槛更高。
论文图表
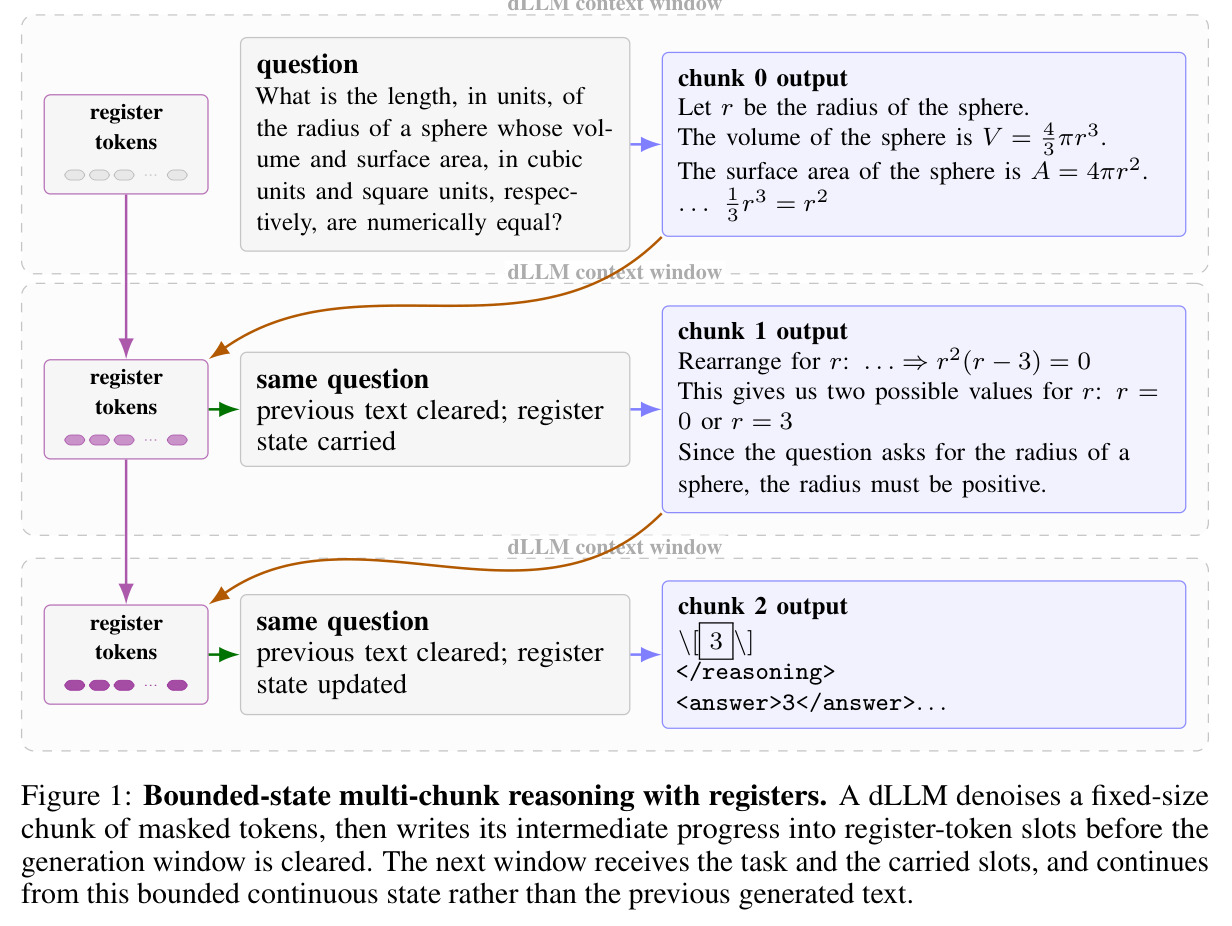
三个 dLLM 上下文窗口的示意图:chunk 0 在提示词旁的寄存器槽下去噪出球体体积问题的解答开头;块输出被清除而寄存器状态保留;chunk 1 基于同一问题加携带状态继续推理并更新寄存器;chunk 2 输出最终答案 <answer>3</answer>。全程活跃窗口与携带状态大小恒定。
一图看懂论文的核心设定:固定窗口加连续携带状态如何替代不断增长的可见上下文,是理解全文的入口。