诱饵方向优化:针对大模型拒绝消融的事后防御 Decoy Direction Optimization: A Post-Hoc Defense Against LLM Abliteration
在MLP神经元注入拒绝正交诱饵信号,污染攻击者的对比估计器,2分钟低成本防住拒绝消融攻击
前置知识
拒绝特征消融(RFA / abliteration)
RFA 是一类免训练白盒攻击:开源模型的拒绝行为常由残差流中的低维方向介导,攻击者用有害/安全提示收集激活,估计差异均值方向 $\hat{d}_\ell$,再在推理时投影 $h_\ell\leftarrow(I-\hat{d}_\ell\hat{d}_\ell^\top)h_\ell$,即可让模型在保持生成能力的同时不再拒绝有害请求。该攻击零成本、全自动、无需专业知识,社区已公开托管数千个如此去审查的模型变体,构成平台侧的真实安全风险。
DDO 的全部设计与理论都围绕'如何让这类对比估计失效'展开,不懂攻击机制就无法理解防御的动机与评价方式。
差异均值(DIM)估计器
DIM 是 RFA 的标准估计器:对同一层激活分别求有害与安全提示的均值 $d_\ell=\mathbb{E}[h_\ell|\mathrm{harm}]-\mathbb{E}[h_\ell|\mathrm{safe}]$,归一化后作为拒绝方向。它本质是一个对比统计量——对比信号中什么成分占主导,它就指向什么。DDO 正是利用这一点:注入大幅值诱饵,让 DIM 指向无害的正交方向,攻击者消融的只是诱饵。
DDO 的混淆损失 $\mathcal{L}_{confusion}$(可微自 RFA 模拟器)与谱重叠界(Theorem 1/2)都是针对该估计器构建的。
SwiGLU MLP 神经元
现代 LLM 的 MLP 多为 SwiGLU/GeGLU 结构:输入 $\tilde{x}$ 经 $W_{gate}$、$W_{up}$ 两路投影,以 $\mathrm{silu}(W_{gate}\tilde{x})\odot(W_{up}\tilde{x})$ 门控组合,再由 $W_{down}$ 写回残差流。每个中间维对应一个神经元,其 $W_{down}$ 列范数近似衡量该单元对残差更新的贡献,可据此挑选'低影响'单元做编辑以减少能力损失。
DDO 的诱饵就是通过改写少量 SwiGLU 神经元的行列权重实现的,其非线性门控 $g_\beta(a)=\beta a^2\sigma(\beta a)$ 是防御有效性的关键来源。
ASR 与 ASR-效用联合评估
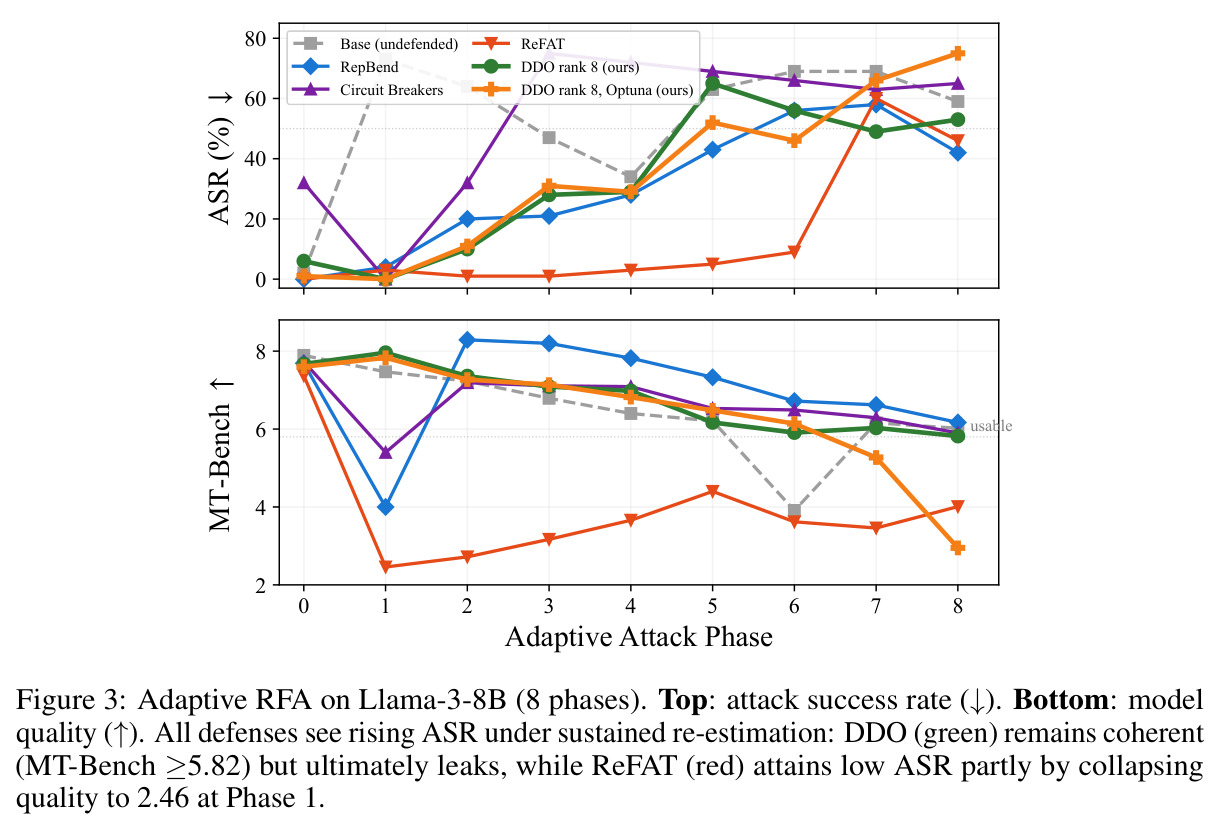
ASR 衡量攻击或防御效果:向模型发送有害提示,模型顺从回答即记一次成功。本文对每个配置取 HarmBench 分类器、LlamaGuard-2、StrongREJECT 三个裁判的平均,并联合报告 MMLU、MT-Bench、XSTest——因为单纯毁掉模型也能压低 ASR,例如 ReFAT 在自适应攻击第 1 阶段就是靠生成质量崩塌(MT-Bench 2.46)换取低 ASR。
读懂本文所有表格(Table 2/3/5)必须同时看 ASR 与效用两列,否则会把'摆烂式防御'误判为鲁棒。
Heretic 与自适应多阶段攻击
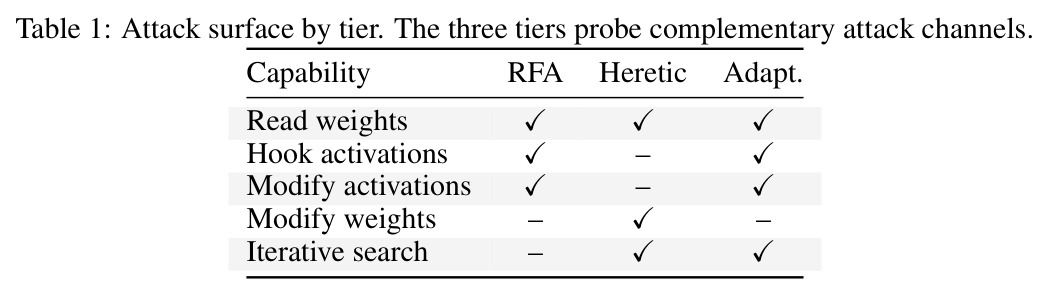
Heretic 是全自动权重级去审查工具:用 Optuna 搜索消融方向 $\hat{d}$ 与逐层强度 $\alpha^{(\ell)}$,对注意力 $W_o$ 与 MLP $W_{down}$ 做低秩投影,本文报告 200 次试验中的最大 ASR(H-200)。自适应多阶段 RFA 则允许攻击者在已消融模型上每轮重新估计 DIM,并对历史方向做正交化后累计消融,rank 至多为阶段数 $t$。
两者与标准 RFA 共同构成论文的三档攻击阶梯(Table 1),是检验 DDO 相对训练型防御真实水平的试金石。
残差流
残差流是 Transformer 各层的信息主干 $h_\ell\in\mathbb{R}^d$,注意力与 MLP 的输出逐层叠加其上。机制可解释性研究发现,拒绝等行为常由其中的低维子空间介导。RFA 的方向投影与 DDO 的诱饵写入(经 $W_{down}$ 列直接写回残差流)都作用在这个空间。
理解'投影掉一个方向为何能移除拒绝'以及'写入正交方向为何能保护拒绝',都需要残差流这一基础图像。
研究动机
开源权重大模型的安全护栏极其脆弱:Refusal Feature Ablation(RFA,俗称 abliteration)只需在残差流上估计有害与安全提示激活的差异均值(DIM)方向并投影掉,就能在几乎不损失能力的前提下剥离拒绝行为,攻击成功率(ASR)普遍超过 85%,且对攻击者零成本、完全自动化,公开社区已托管数千个此类去审查变体,带来 CBRN 能力提升、网络攻击内容生成、CSAM 等风险。现有防御几乎全是训练时干预:Circuit Breakers、LAT、ReFAT、RepBend、Triplet 等需要对每个新 checkpoint 做安全微调,每配置消耗 1–15 个 A100 小时,还常需方法专属训练数据、对抗样本流水线和大量超参扫描;部分方法还以严重过拒绝为代价(LAT 在 Llama-3 上 XSTest 仅 20.8%,ReFAT 60.4%)。面对开源模型数月级的迭代节奏,逐 checkpoint 重训练难以持续,且这些防御对自适应多阶段 RFA 和 Heretic 权重级攻击此前缺乏系统评估。
本文的目标是本文目标是构建一种事后的权重编辑防御:不对基座模型做任何梯度微调,不需要方法专属的安全训练数据,只需一个小型通用探针集(128 条有害 + 128 条安全提示)和单张 A100 GPU,在约 2 分钟内完成一次优化配置,把标准 RFA 的 ASR 压到 10% 以下,同时保持模型能力(MMLU、MT-Bench)与良性合规率(XSTest)几乎不变。防御需全部编译进权重、无任何架构或推理开销,并在更强的攻击阶梯下依然有效:包括自适应多阶段 RFA(最多 8 轮重估计)、Heretic 自动化权重级攻击(200 次 Optuna 试验),以及 GCG/PAIR/AutoDAN 等提示级越狱,并与六个训练型防御在相同协议下正面对比,最终在六个模型家族上验证泛化性。
与已有工作不同的是,已有防御的共同思路是'加固拒绝特征本身'——用表示重路由、对抗训练等方式让拒绝机制更难移除,但这必须逐 checkpoint 做昂贵的安全微调。本文的独特切入是反过来攻击攻击者的估计器:对比式攻击(DIM 估计)的好坏完全取决于它采集到的有害-安全对比信号,因此与其隐藏真实拒绝回路,不如主动在 MLP 神经元中注入大幅值、与拒绝方向正交的非线性诱饵信号,使攻击者估计出的'拒绝方向'实际指向无害诱饵,投影掉的只是诱饵而非真正的安全机制。作者用子空间重叠的谱界(Theorem 1/2)形式化这一直觉,并导出'有效诱饵秩'与能量分配原则(Corollary 3)。这是首个无需基座微调、可事后部署、带理论保证的 abliteration 防御。
核心方法
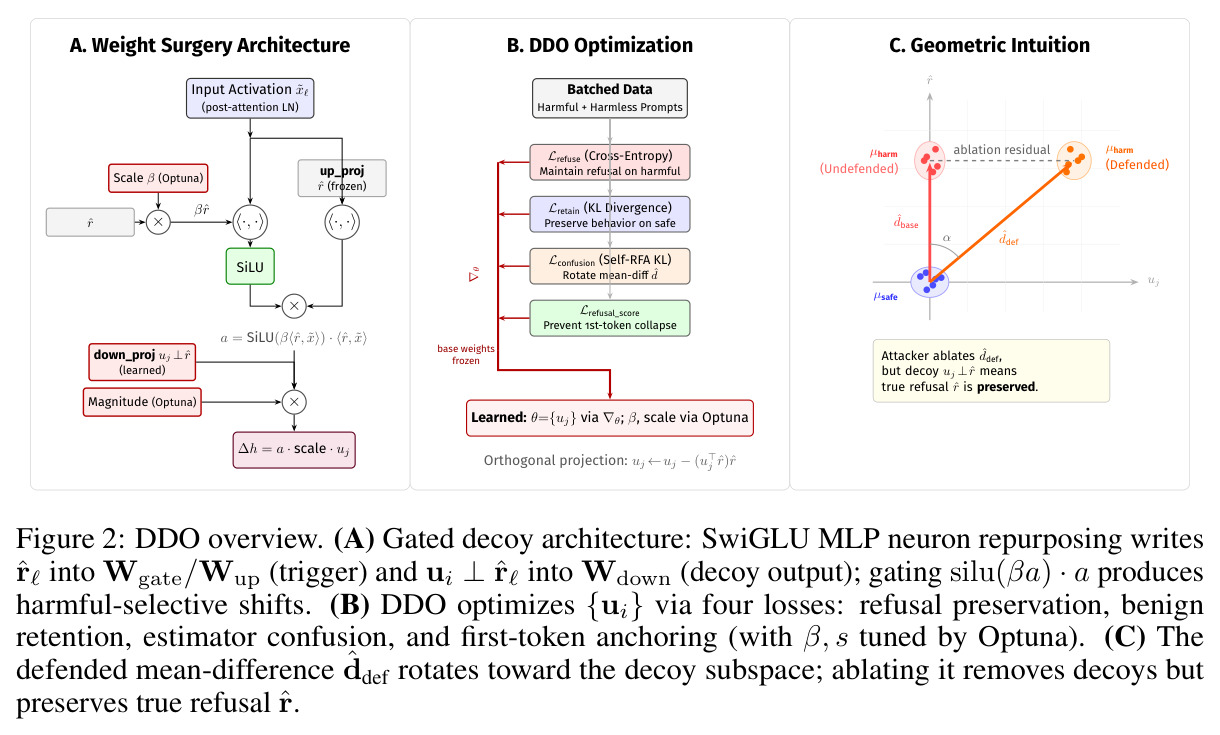
DDO 的直觉是:对比攻击的成败取决于攻击者能看到的对比信号。DDO 把少量低影响 SwiGLU/GeGLU 神经元改造成'门控读写映射'——在有害提示上读取拒绝坐标、写入与拒绝正交的大幅值残差偏移,使 DIM 估计被诱饵主导。技术路线分四步:(i) 在 128 有害+128 安全探针上用 DIM 逐层估计拒绝方向 $\hat{r}_\ell$;(ii) 每个目标层选 $n$ 个影响最小的神经元($W_{down}$ 列范数最小者);(iii) 在 $W_{up}$、$W_{gate}$ 的行写入拒绝对齐触发器,在 $W_{down}$ 列写入正交诱饵方向 $u_i\perp\hat{r}_\ell$,再以四项复合损失 $\mathcal{L}$ 对 $\{u_i\}$ 做梯度优化(基座权重全冻结),标量增益 $\beta, s$ 经 Optuna 贝叶斯搜索;(iv) 以 replace 或 additive 模式把参数编译进权重,并放置在因果拒绝区或其上游层。全部编辑折入权重,零架构与运行时开销,单张 A100 约 2 分钟完成一个配置,比训练型基线每配置便宜 30–450 倍。
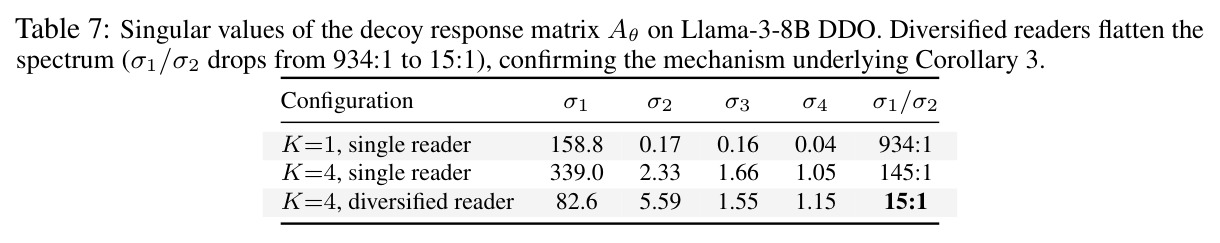
核心创新是'欺骗估计器而非隐藏特征'。训练型防御通过梯度训练重塑表示几何,让拒绝更弥散、更难移除;DDO 则完全冻结基座权重,主动工程化有害-安全对比:诱饵经 SwiGLU 非线性门控产生随提示变化的响应 $g_\beta(a)=a\,\mathrm{silu}(\beta a)\approx\beta a^2$($a=\langle\hat{r}_\ell,\tilde{x}_\ell\rangle$ 为拒绝坐标),天然偏向大幅值的有害提示激活,从而把 DIM 估计的均值差旋转到诱饵子空间。理论上,Theorem 1 给出一般子空间重叠界 $\|\Pi_R\Pi_k(C)\|_{op}\le\|\Pi_RC\|_{op}/\sigma_k(C)$;Theorem 2 在正交诱饵下细化为 $\rho_R/(\sigma_k(A_\theta)-\rho)$;Corollary 3 证明固定能量 $\|A_\theta\|_F\le B$ 时 $\sigma_k\le B/\sqrt{k}$,揭示强度-秩权衡并指导多读取器(rank $K$)设计。
方法步骤详情
第一步,方向估计:在 128 有害+128 安全探针的 post-attention LayerNorm 激活 $\tilde{x}_\ell$ 上做 DIM,得到逐层拒绝方向 $\hat{r}_\ell$。第二步,神经元选择:每层取 $W_{down}$ 列范数最小的 $n$ 个低影响单元。第三步,权重手术:对选中单元写 $w_{up,i}\leftarrow\hat{r}_\ell^\top$、$w_{gate,i}\leftarrow\beta\hat{r}_\ell^\top$、$w_{down,i}\leftarrow s\,u_i$($u_i\perp\hat{r}_\ell$,由高斯采样投影正交化初始化),诱饵贡献 $\delta_i=s\,g_\beta(a_\ell)\,u_i$。第四步,梯度优化:最小化四项损失 $\mathcal{L}$——拒绝交叉熵、对冻结基座的安全提示 KL、可微自 RFA 混淆损失(重估 DIM、消融、最小化消融前后 logits 的 KL)与首 token 锚定({I,Sorry,cannot} 对 {Sure,Here} 的 logit 边际);每步后将 $u_i$ 重投影回 $\hat{r}_\ell^\perp$、Gram-Schmidt 正交化并归一化,$\beta,s$ 由 Optuna 调优。第五步,可选 rank $K$:把 $n$ 个单元分成 $K$ 组,配扰动读取器 $(\hat{r}_\ell+\gamma z_{\ell,g})/\|\cdot\|_2$。第六步,编译部署:按模型选 replace/additive 模式,编辑放在因果拒绝区或其上游,最后可选正交去偏(投影掉过拒绝方向 $\hat{v}$)修复过拒绝。
技术新颖性
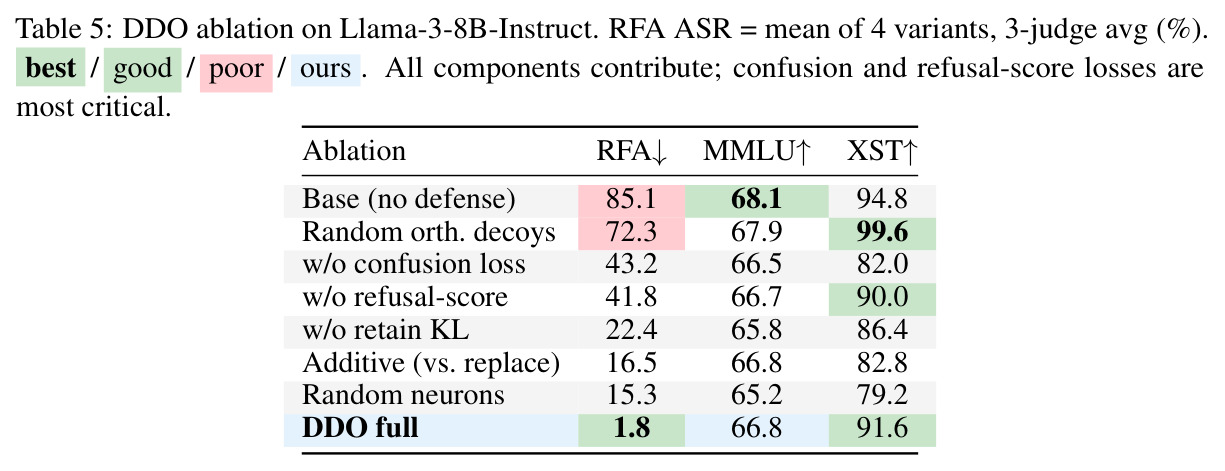
技术新颖性有四点。其一,视角新:首个针对 abliteration 的无微调事后防御,把攻防从'特征隐藏'转移到'估计器污染',所有编辑编译进权重、零架构与推理开销。其二,可证明的谱理论:一般对比攻击的子空间重叠界(Theorem 1)、正交诱饵下的重叠界(Theorem 2)、有效诱饵秩 $r_{eff}(\varepsilon)$ 与固定能量下最优谱分配(Corollary 3,$\sigma_k\le B/\sqrt{k}$),为诱饵设计与攻击预算解读提供量化原则,而多数权重编辑工作只有经验结果。其三,机制细节系统化:低影响神经元选择(随机神经元 ASR 15.3% vs 精选 1.8%)、首 token 锚定损失(防'Sure...其实我不能'式退化)、编译模式与层放置的模型特异结论(replace 适合 Yi/Llama-3/GLM-4,additive 适合 Gemma-2/Qwen3/Mistral)。其四,跨架构验证:8 种事后机制 × 7 模型的消融显示 DDO 是唯一在所有架构上稳定 <10% ASR 的单一机制。
实验结果
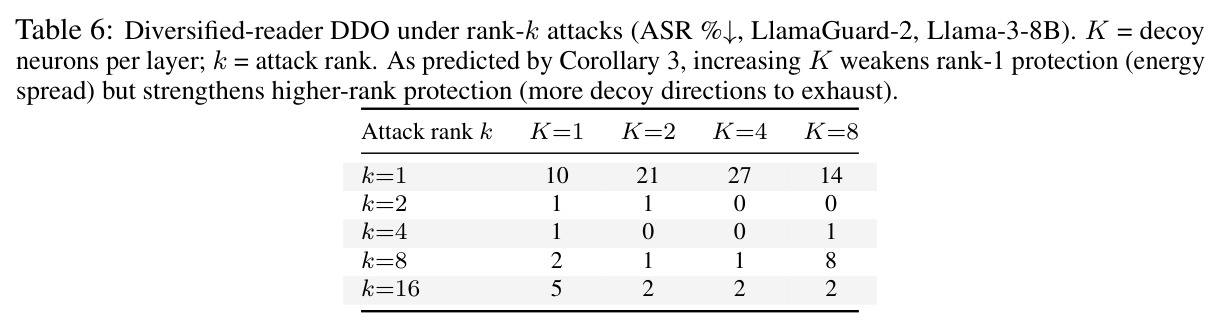
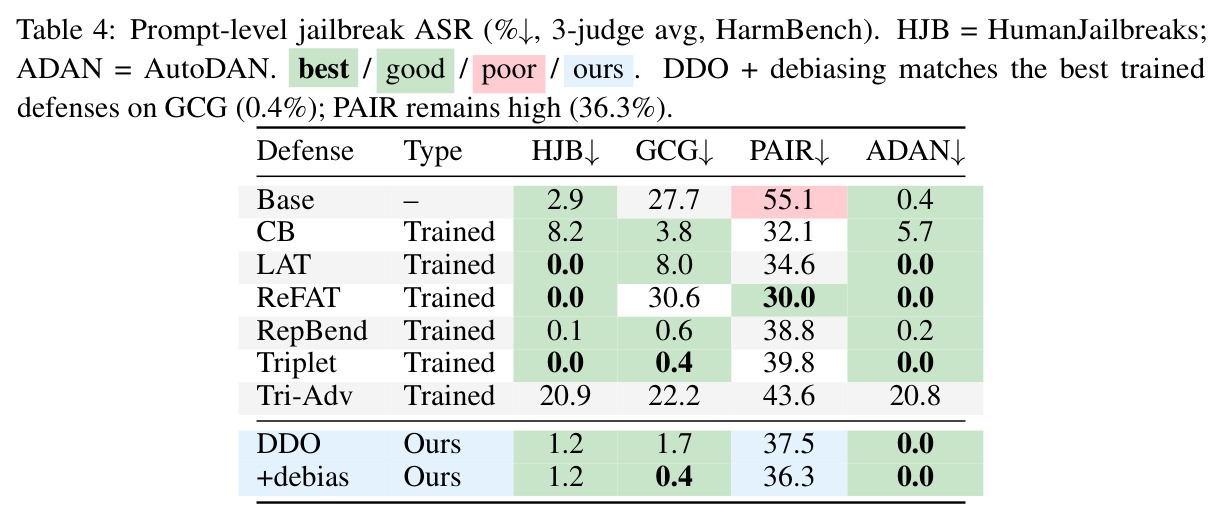
主实验在 Llama-3-8B-Instruct:标准 RFA 平均 ASR 从基线 85.1% 降到 DDO 1.8%,加正交去偏后 1.0%,与最强训练基线相当(Circuit Breakers 1.1%、RepBend 4.8%)而成本低 30–450 倍;能力保持 MMLU 66.8(基线 68.1)、MT-Bench 7.38(7.89)、XSTest 91.6%(去偏后 99.2%),远优于 LAT 20.8%、ReFAT 60.4% 的过拒绝。Heretic 权重攻击把 ASR 从 88.7% 压到 18%,但逊于 RepBend 的 1.3%。自适应 8 阶段 RFA 最坏 ASR:DDO(rank 8) 65%,与 RepBend 58%、ReFAT 60% 同档,优于 CB 75%,Phase 8 时 MT-Bench 保持 5.82,ReFAT 则在 Phase 1 靠质量崩塌(2.46)换低 ASR。跨模型六个家族全部 <10%(Yi 5.0%、Qwen3 8.0%、Gemma-2 0.0%、Mistral 0.0%、GLM-4 2.0%),DirectRequest 合规率大降(Yi 27%→5%、Mistral 41%→6%、GLM-4 26%→0.3%)。提示级攻击:GCG 0.4%、HumanJailbreaks 1.2%,但语义攻击 PAIR 仍 36.3%。消融证实各组件贡献:随机诱饵仅降到 72.3%,去混淆损失 43.2%、去首 token 损失 41.8%、去 retain KL 22.4%、随机神经元 15.3%、完整 DDO 1.8%;多读取器权衡亦符合理论($K$ 从 1→4:rank-1 ASR 10%→27%、rank-16 ASR 5%→2%),抗撤销攻击 ASR 稳定在 6–12%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 标准 RFA 防御(Llama-3-8B-Instruct,4 变体平均) | ASR (%) | 1.8(DDO)/ 1.0(DDO+去偏) | 85.1(无防御基线);最强训练基线 Circuit Breakers 1.1 | 相对基线降 83.3 个百分点,与训练防御持平但成本低 30–450 倍 |
| Heretic 权重级攻击(200 试验) | H-200 ASR (%) | 18.0 | 88.7(基线);RepBend 1.3 | 降低 70.7 个百分点,但仍落后 RepBend 16.7 个百分点 |
| 自适应多阶段 RFA(8 阶段) | 最坏 ASR (%) / Phase 8 MT-Bench | 65 / 5.82 | RepBend 58 / 6.17;ReFAT 60(MT-Bench 崩至 4.01);CB 75 | 与最强训练防御同档,且全程保持可用生成质量 |
| 跨模型泛化(6 家族标准 RFA) | 平均 ASR (%) | Yi 5.0、Qwen3 8.0、Gemma-2 0.0、Mistral 0.0、GLM-4 2.0 | 各模型基线 66.5–90.7 | 全部 <10%,每配置约 2 分钟 vs 基线 1–15 A100 小时 |
| 过拒绝(XSTest) | 良性合规率 (%) | 91.6(+去偏 99.2) | 94.8(基线);LAT 20.8、ReFAT 60.4 | 在保持防御效果的同时避免训练防御常见的过拒绝 |
| 提示级越狱 GCG | ASR (%) | 0.4(DDO+去偏) | 27.7(基线);Circuit Breakers 3.8 | 匹配最佳训练防御;但 PAIR 36.3% 无优势 |
| 防御成本 | A100 墙钟时间/配置 | 约 2 分钟(含 Optuna 约 10 分钟) | 训练型防御 1–15 小时 | 30–450 倍加速,基座权重全程冻结 |
局限与改进
作者承认并实验证实的局限:持续自适应重估计仍是所有防御的难题,8 阶段后 DDO 最坏 ASR 达 65%,谱界只对固定对比攻击成立,有效诱饵秩仅是解读自适应阶段的诊断量而非保证;对 Heretic 权重级攻击存在明显差距(18% vs RepBend 1.3%),作者归因于闭式编辑比梯度训练形成的拒绝分布更易定位;部分模型会加剧过拒绝,需额外的正交去偏修复;对语义级攻击 PAIR(36.3%)无帮助,需输入侧分类器互补。我的补充观察:威胁模型明确排除梯度微调攻击者,一个有算力做安全微调的对手原则上可绕过任何闭式编辑;防御依赖 $\hat{r}_\ell$ 估计质量,若拒绝几何高度多维或分布式(如概念锥),单层少量诱饵可能不足;rank-16 SVD 攻击下单读取器 ASR 升至 39%,高秩保护要以牺牲 rank-1 强度为代价;评估依赖 GPT-4o/HarmBench/LlamaGuard-2/StrongREJECT 等裁判,ASR 判定本身带噪声;诱饵能量分配($K$ 的选择)需要预判攻击者的秩预算,实际中难以先验确定。
独立分析的弱点
第一,自适应多阶段攻击下最终会被攻破(最坏 65% ASR):改进方向是按 Corollary 3 的能量分配原则扩大有效诱饵秩,结合多读取器与多层协同布饵,或加入检测-响应机制,在发现重估计行为时动态重配置诱饵。第二,Heretic 类权重级攻击可恢复到 18%,因为闭式编辑集中于少量神经元易被定位:改进方向是把诱饵扩散到更多参数与层(作者已提出),或与极轻量安全微调混合,使拒绝更弥散。第三,过拒绝副作用需要独立的去偏后处理,流水线脆弱:改进方向是把过拒绝方向的投影惩罚并入主损失端到端优化。第四,编辑高度集中于选定神经元,可能被'DDO 撤销'类启发式定向清除(实测 ASR 6–12%):改进方向是随机化编辑位置、随机化读取器扰动 $\gamma$ 与跨层冗余部署,提高定位成本。第五,诱饵依赖 128+128 探针分布,对分布外有害类别的 DIM 估计可能失准:改进方向是扩大探针多样性或部署后在线校准方向。第六,理论假设 $u_i$ 严格正交于真实拒绝子空间且残差 $\rho$ 小,实际只能近似满足;且成本优势对照口径是'每配置',计入大规模评估后总开销并不低。
未来方向
作者提出的方向:研究把拒绝行为更弥散地分布到参数中的事后编辑,提升对权重级攻击的鲁棒性;与 Llama Guard 等推理时护栏组合,评估互补保护。基于成果可延伸:把有效诱饵秩 $r_{eff}(\varepsilon)$ 与多读取器设计推广为自适应防御,根据观察到的攻击阶段在线分配诱饵能量;把谱分析扩展到多维拒绝子空间(概念锥、多重中介方向)与 rank-$k$ SVD 对比攻击的理论刻画;构建面向开源发布平台的自动化'加固-攻击-评估'智能体流水线(2 分钟反馈回路天然适合 agent 驱动的迭代硬化);在更大规模前沿模型和多语言场景验证;从机制上解释 DDO 为何连带抑制 GCG(ASR 0.4%)而完全不防 PAIR;以及把 DDO 与安全卸载、概念擦除等后训练干预统一进一个对比估计的谱理论框架,形成通用的事后模型加固理论。
复现评估
复现条件较好:代码已开源(github.com/aashiqmuhamed/defending-against-abliteration),六个主评估模型(Llama-3-8B-Instruct、Yi-1.5-9B、Qwen3-8B、Gemma-2-9B、Mistral-7B、GLM-4-9B)与六个训练基线(CB/LAT/ReFAT/RepBend/Triplet/Triplet-Adv)均用公开 checkpoint。核心防御非常轻量:128+128 通用探针、单张 A100 约 2 分钟一个配置,附 Optuna 约 10 分钟;附录 F.2–F.18 给出逐模型超参与配置。真正昂贵的是评估侧:需在 JailbreakBench/HarmBench/XSTest/MMLU/MT-Bench 上生成,并用 HarmBench 分类器、LlamaGuard-2、StrongREJECT(GPT-4o)三裁判打分,自适应 8 阶段、Heretic 200 试验与 8 机制×7 模型扫描都需要大量推理与 API 调用。总体而言,复现核心主张难度中低,完整对齐全部表格需要可观算力与评审成本。
论文图表
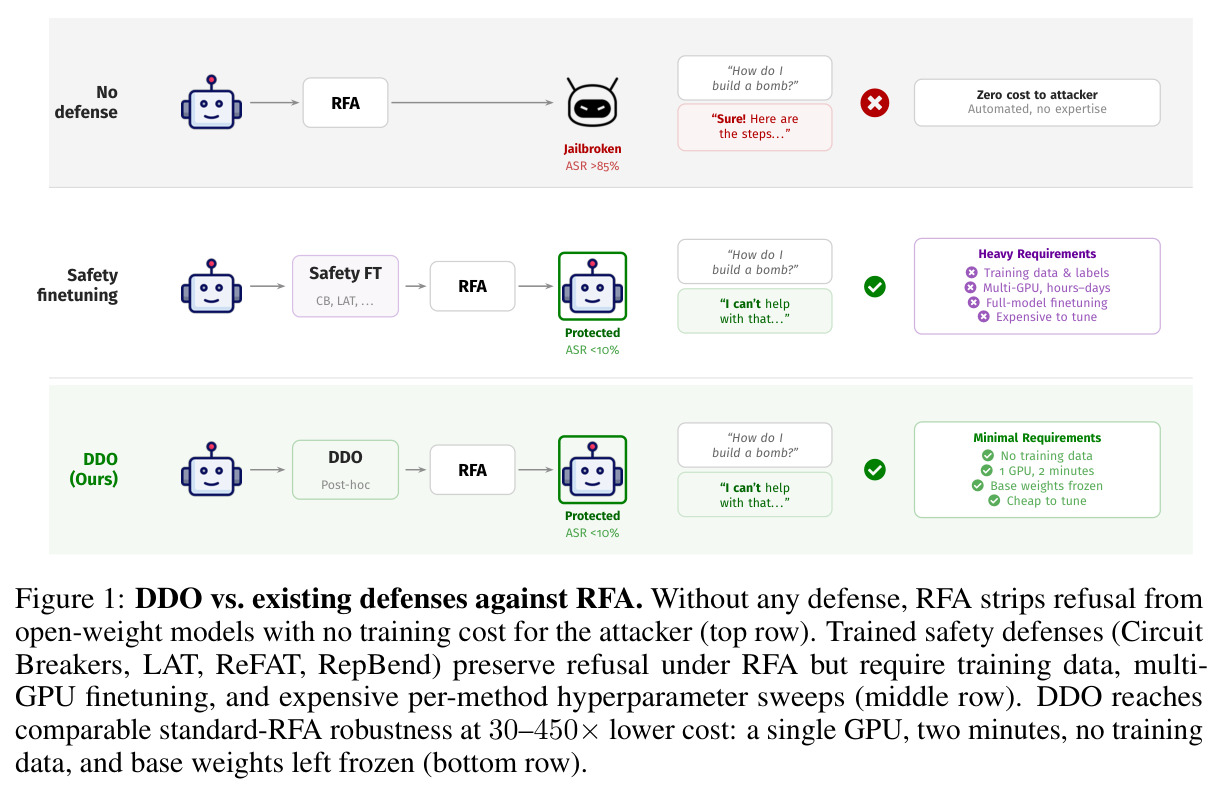
三行对比示意:无防御时 RFA 以零成本越狱(ASR>85%);训练型防御(Circuit Breakers、LAT 等)能保住拒绝(ASR<10%)但需要训练数据与标签、多 GPU 全模型微调、数小时到数天;DDO 只需单 GPU、2 分钟、无训练数据、基座权重冻结,同样把 ASR 压到 <10%,每配置成本比训练基线低 30–450 倍。
一张图概括论文的核心卖点——在同等标准 RFA 鲁棒性下相对训练型防御的数量级成本与部署优势,是理解研究动机的最佳入口。