贝尔曼策略优化(BPO):从策略镜像下降推导的免评论员 RLVR 方法 Bellman Policy Optimization
用贝尔曼方程把 PMD 改写为免评论员的轨迹级目标,AIME 平均准确率超 GRPO 11 个百分点
前置知识
RLVR(可验证奖励的强化学习)
对 LLM 生成的完整响应,由任务相关的确定性验证器(如数学答案比对器)给出一个终端奖励 $R(x,y)$,再用策略梯度类算法优化期望奖励 $\mathbb{E}[R]$。与 RLHF 依赖学习出来的奖励模型不同,RLVR 的奖励客观、无奖励 hacking 风险,是训练推理模型(如 DeepSeek-R1、Qwen3)的主流范式。
本文的全部理论框架都建立在终端奖励型 RLVR 的 episodic MDP 之上,中间步奖励为零、只有响应结束才打分,这是贝尔曼 telescoping 能成立的前提。
GRPO(组相对策略优化)
对每个 prompt 独立采样一组 $G$ 个响应,用组内归一化优势 $\hat{A}_i=(R_i-\mathrm{mean})/\mathrm{std}$ 代替价值模型,再套用 PPO 式裁剪目标:$-\min(r_t\hat{A}_i, \mathrm{clip}(r_t,1-\epsilon_{low},1+\epsilon_{high})\hat{A}_i)$,其中 $r_t=\pi(y_t|s_t)/\mu(y_t|s_t)$ 是 token 级重要性采样比率。
BPO 的最终损失刻意保留了 GRPO 的优势归一化、掩码和裁剪结构,只把重要性比率 $r_t$ 换成失配修正权重 $\omega_t$,理解 GRPO 才能看清 BPO 改了什么。
策略镜像下降(PMD)
在每个状态求解 $\max_{\pi} \mathbb{E}_{y\sim\pi}[f(s,y)] - \frac{1}{\eta}D_{\mathrm{KL}}(\pi(\cdot|s)\|\mu(\cdot|s))$ 的策略迭代框架,有闭式解 $\pi^+(y|s)=\mu(y|s)\exp(\eta f(s,y))/Z$,即在行为策略上按优势指数加权、用 KL 项控制步长。它是许多现代 RL 算法的理论母体,收敛性质优于普通策略梯度。
BPO 直接从 PMD 出发:本文要解决的核心问题是 PMD 更新需要逐状态估计 $f=A^\mu$,而 BPO 给出了与 PMD 同解的免评论员改写。
优势函数与贝尔曼方程
优势 $A^\pi(s_t,y_t)=Q^\pi(s_t,y_t)-V^\pi(s_t)$ 衡量动作相对平均水平的好坏;贝尔曼方程给出 $A^\pi(s_t,y_t)=V^\pi(s_{t+1})-V^\pi(s_t)$。对中间奖励为零、终端奖励为 $R(x,y)$ 的自回归生成,沿轨迹求和时所有中间价值相互抵消(telescoping):$\sum_t A^\mu(s_t,y_t)=R(x,y)-V^\mu(x)$。
这个 telescoping 恒等式是全文的枢纽:它把逐 token 的优势估计问题消解成只依赖终端奖励和初始价值的轨迹级量,是免评论员改写的数学基础。
KL 散度与二元 KL 近似
$D_{\mathrm{KL}}(\pi\|\mu)$ 度量两个策略的距离,但精确计算需要整个词表的 logits,代价高。二元 KL 只看选中的那个 token,把动作空间二分为“生成它/不生成它”两个伯努利分布再算 KL:$D^{\mathrm{bin}}_{\mathrm{KL}}=\pi\log\frac{\pi}{\mu}+(1-\pi)\log\frac{1-\pi}{1-\mu}$,它是全 KL 的下界,只需当前 token 的两个概率。
BPO 用二元 KL 替换轨迹残差中的全 KL 后,一个关键恒等式(式27)使梯度化简为互补概率比 $(1-\mu)/(1-\pi)$,这正是失配修正权重的来源。
重要性采样与 PPO 裁剪
rollout 用行为策略 $\mu$ 生成、训练的是当前策略 $\pi$,二者因 minibatch 多轮更新和推理引擎数值差异而不一致,需要用比率 $r_t=\pi/\mu$ 做重要性修正。PPO 通过 $\mathrm{clip}(r_t,1-\epsilon_{low},1+\epsilon_{high})$ 限制单步更新幅度,防止比率跑飞导致训练崩溃。
比率失真正是 GRPO 系方法不稳定的根源之一;BPO 用有界的 $\omega_t$ 替代 $r_t$,理解重要性采样才能明白这一替换为什么能改善训练动态。
研究动机
RLVR 已成为提升 LLM 推理能力的主流路线:验证器对整条响应给出终端奖励,GRPO 及其变体对每个 prompt 采样一组响应、组内归一化优势 $\hat{A}_i=(R_i-\mathrm{mean}\{R_j\})/\mathrm{std}\{R_j\}$,再用 PPO 式裁剪的 token 级重要性比率 $r_t=\pi(y_t|s_t)/\mu(y_t|s_t)$ 做策略梯度,因免训练价值模型而支撑了大规模推理训练。但这类方法有两个具体问题:其一,理论上更干净的 PMD 更新 $\pi^+\propto\mu\exp(\eta A^\mu)$ 需要在每个中间状态 $s_t=(x,y_{<t})$ 估计优势 $A^\mu(s_t,y_t)$,通常要训练独立的价值模型,既增加内存与计算开销,学到的价值在推理任务上还常常不准(文中引用[22]);其二,rollout 与训练策略之间因 8 次 minibatch 更新和引擎数值差异而失配,重要性比率在训练过程中失真,裁剪机制也只能部分缓解。如何在不训练评论员的前提下获得与 PMD 同等理论保证的策略更新,是本文要解决的核心问题。
本文的目标是本文的具体目标是:把经典 PMD 更新改写成一个完全不依赖中间状态价值估计的轨迹级目标,并严格证明两者有相同的最优解。具体拆成三件事:第一,对终端奖励型自回归生成,利用贝尔曼方程把逐 token 优势沿轨迹 telescoping 成“终端奖励减初始价值”,使目标只含验证器直接给出的 $R(x,y)$ 和可用组采样均值估计的 $V^\mu(x)$;第二,在这个等价形式上通过一系列有明确动机的近似(线性化、组归一化、二元 KL、加性平滑),推导出可直接落地的 token 级损失,用新的失配修正权重 $\omega_t$ 替换 GRPO 的重要性采样比率;第三,在 Qwen3-30B-A3B-Base 上与 GRPO-ClipHigher、GSPO、CISPO、DPPO 在只改 policy loss 的受控设置下对比,目标是超过最强基线 CISPO 的 47.4% 平均准确率,并在 AIME 2024–2026 上验证有效性。
与已有工作不同的是,本文的独特切入是把 PMD 的逐状态最优性条件整体搬到轨迹层面,走“理论等价优先、再近似落地”的路线。已有工作([11,23-25])用似然比重参数化奖励与价值做直接对齐,但未给出与 PMD 更新的严格等价;GRPO 系改进(GSPO 改比率粒度、CISPO 改裁剪对象、DPPO 引入二元 KL)都是围绕重要性比率打补丁。本文从 PMD 最优性条件 $\log\pi^+-\log\mu-\eta A^\mu+D_{\mathrm{KL}}(\mu\|\pi^+)=0$ 出发,用 $\mathbb{E}_{\mu}[A^\mu]=0$ 消去配分函数 $\log Z_\mu(s_t)$,再沿轨迹求和——贝尔曼 telescoping $\sum_t A^\mu=R(x,y)-V^\mu(x)$ 把中间量全部消掉,得到轨迹残差 $\delta=0$ 的完整刻画;必要性证明用鞅论证:token 级残差在 rollout 策略下构成鞅,长度有界 $T_{\max}$,终值为零即推出逐项为零。实践端再与二元 KL 结合导出平滑互补概率比权重,形成与现有方法截然不同的推导链。
核心方法
直觉上,PMD 每到一个状态都要问“这个 token 比平均好多少”,需要逐状态价值估计;而 RLVR 只在响应末尾打一次分。本文的直觉是:贝尔曼方程保证累积优势恰好等于终端奖励减初始价值($\sum_t A^\mu=R(x,y)-V^\mu(x)$),于是 PMD 的逐状态更新条件沿轨迹求和后只剩 $R(x,y)$ 与 $V^\mu(x)$ 两个量——前者由验证器免费给出,后者可用同组采样的平均奖励估计。技术路线三步:(1) 以 $f=A^\mu$ 实例化 PMD,得闭式解 $\pi^+(y_t|s_t)=\mu\exp(\eta A^\mu)/Z_\mu$;(2) 推导无评论员目标 $\min_\pi\mathbb{E}[\varphi(x)\delta^2/(2\eta)]$,其中 $\delta=\eta(R-V^\mu(x))-\sum_t[\log\frac{\pi}{\mu}+D_{\mathrm{KL}}(\mu\|\pi)](s_t)$,并证明它与原 PMD 同解;(3) 经线性化、组估计、二元 KL 近似与加性平滑,得到实用的 BPO 损失(式14)。
核心创新有二。第一是定理 1:无评论员轨迹级目标与优势式 PMD 在“rollout 可达状态上诱导相同完成分布”的意义下有唯一相同最优解,且对任意正权重 $\varphi$ 成立——把“免评论员”从工程近似提升为严格等价,是 GRPO/GSPO/CISPO/DPPO 都不具备的理论保证。第二是失配修正权重:借助恒等式 $\nabla[\log\pi+D^{\mathrm{bin}}_{\mathrm{KL}}(\mu\|\pi;y)]=(1-\mu)/(1-\pi)$,BPO 用 $\omega_t=\frac{1+\epsilon-\mu_t}{1+\epsilon-\pi_t}$(平滑互补概率比)取代重要性比率 $r_t=\pi/\mu$。本质区别在语义:$r_t$ 是两策略给该 token 的概率之比,$\mu$ 接近零时会爆炸;$\omega_t$ 度量“生成 vs 不生成该 token”这一二分类上的失配,天然有界、只需两个标量。这与 GSPO(序列级比率)、CISPO(裁剪并保留重要性权重)、DPPO(显式二元 KL 正则)均有本质不同。
方法步骤详情
推导三步加实践四步。推导:Step1 以 $A^\mu$ 实例化 PMD 得解 $\pi^+=\mu\exp(\eta A^\mu)/Z_\mu$;Step2 由最优性条件取 $\mathbb{E}_\mu$ 期望,用 $\mathbb{E}_\mu[A^\mu]=0$ 消去 $\log Z_\mu=D_{\mathrm{KL}}(\mu\|\pi^+)$,沿轨迹 telescoping 得 $\delta=0$,据此构造目标(18);Step3 证明必要性:token 级残差在 $\mu$ 下构成鞅,终值为零加长度有界推出逐项为零。实践:Step1 在 $\pi=\mu$ 处线性化,$\delta/\eta$ 换成 $R-V^\mu(x)$;Step2 组均值估 $V^\mu(x)$、取 $\varphi=1/\mathrm{std}\{R_j\}$;Step3 二元 KL 替换全 KL,恒等式给出 $(1-\mu)/(1-\pi)$,平滑为 $\omega_t=(1+\epsilon-\mu_t)/(1+\epsilon-\pi_t)$;Step4 加掩码 $M_t$ 与上限 $C=3.0$,最终 $L_{\mathrm{BPO}}=-\hat{A}_iM_t\min(\mathrm{sg}(\omega_t),C)\log\pi$。
技术新颖性
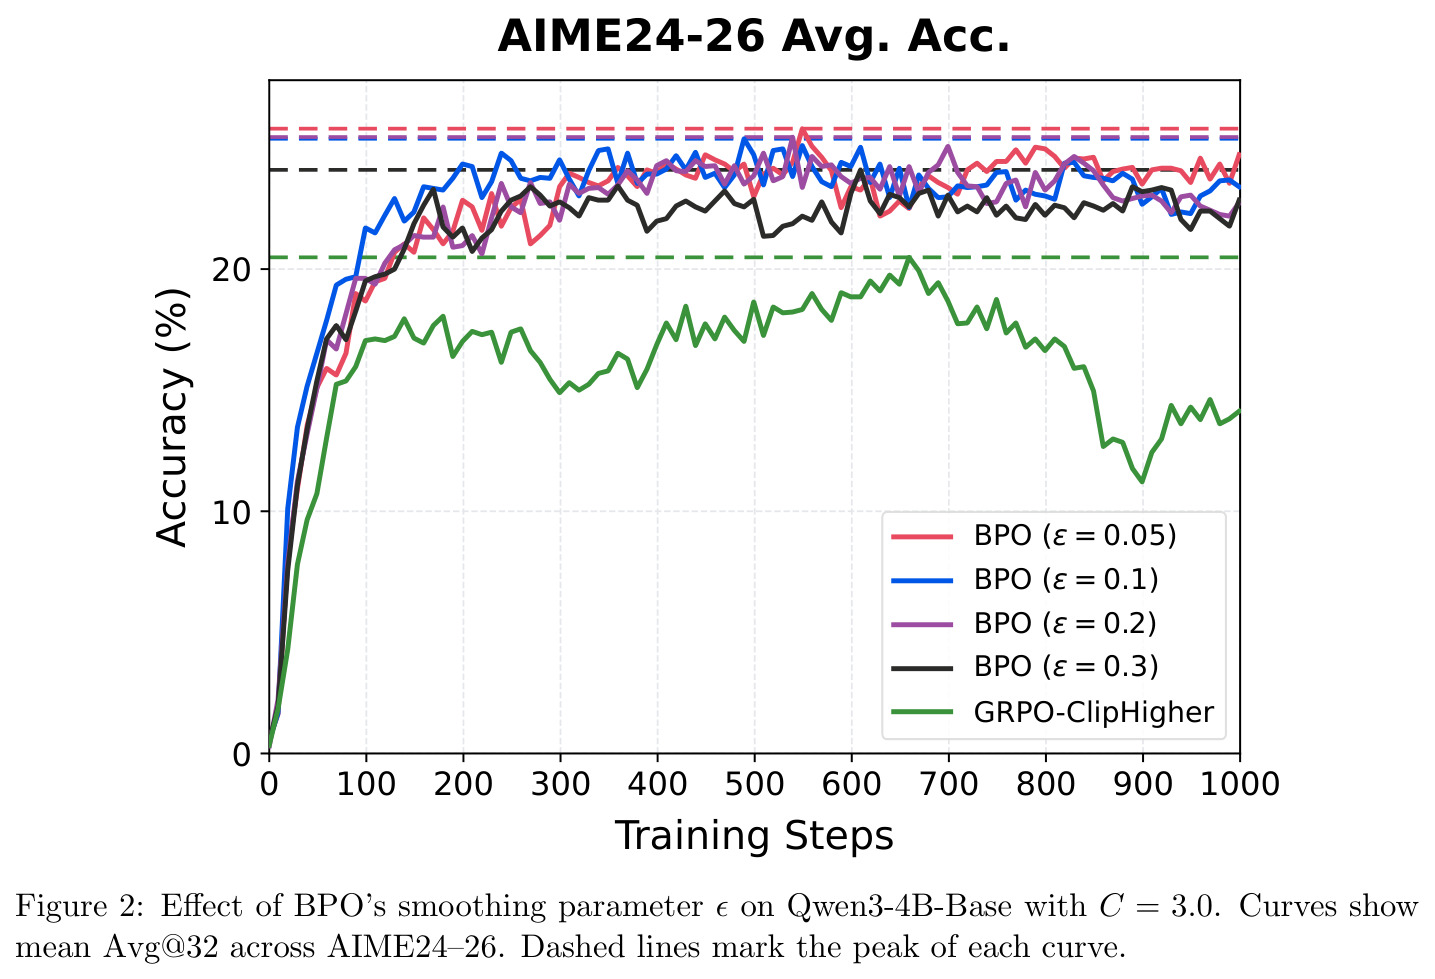
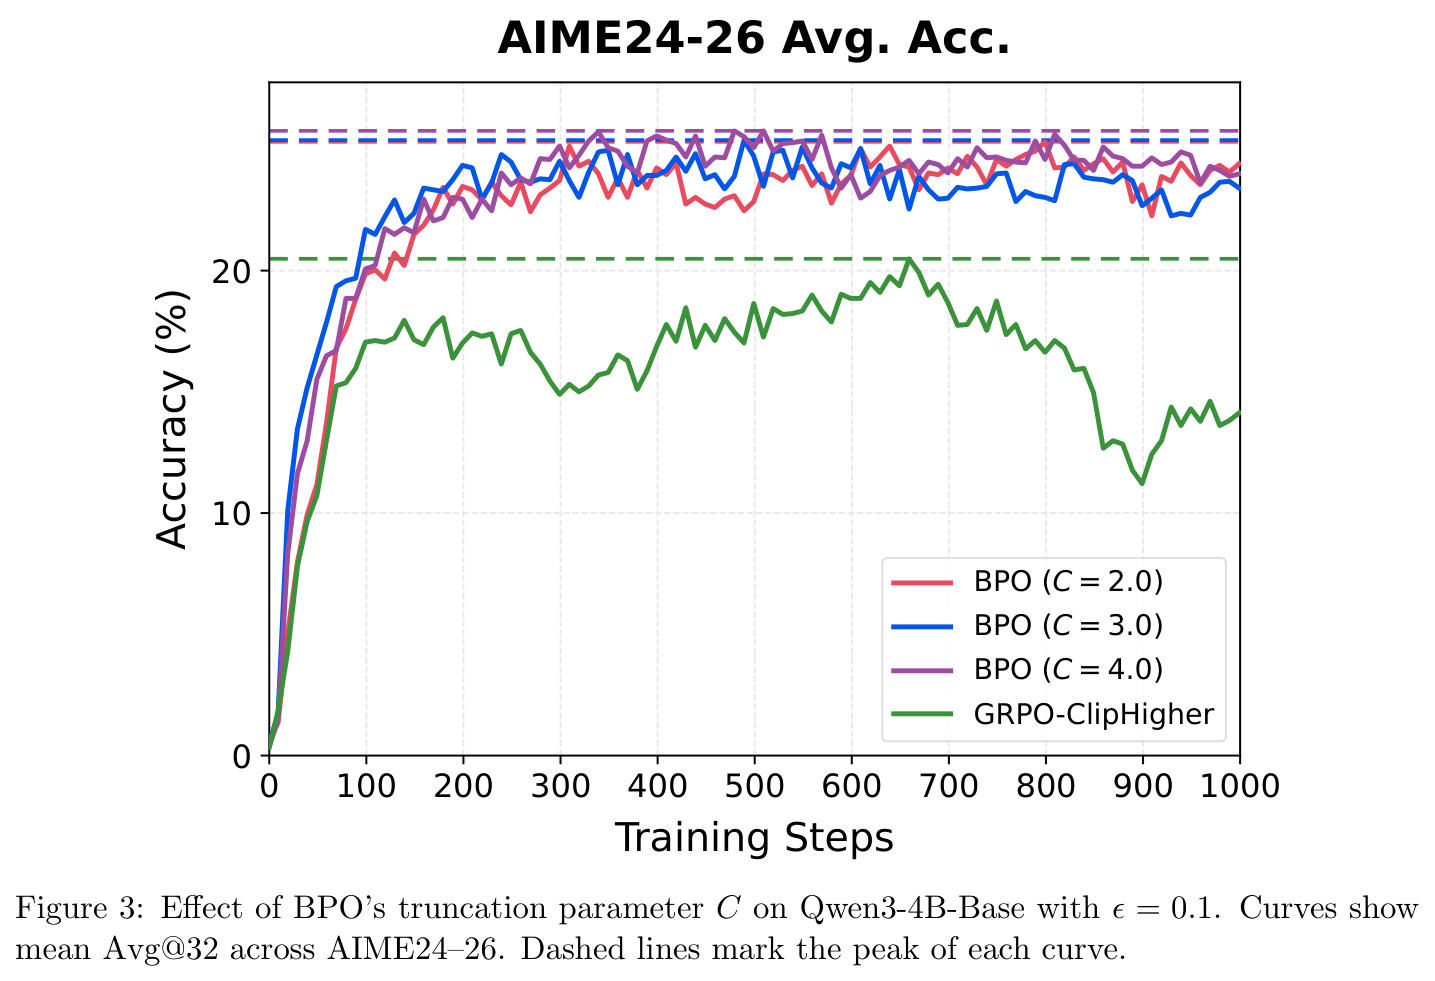
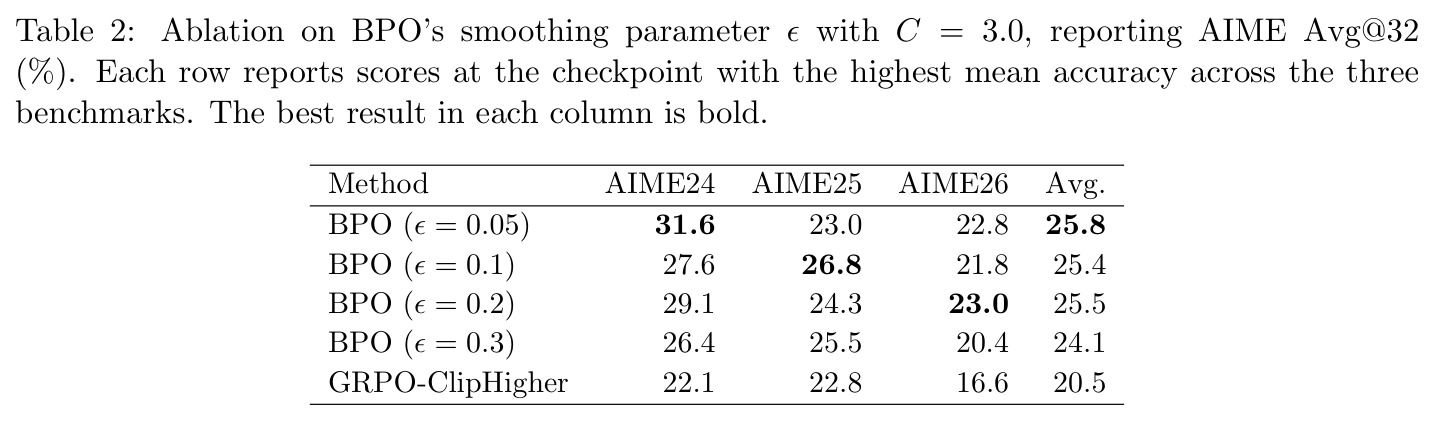
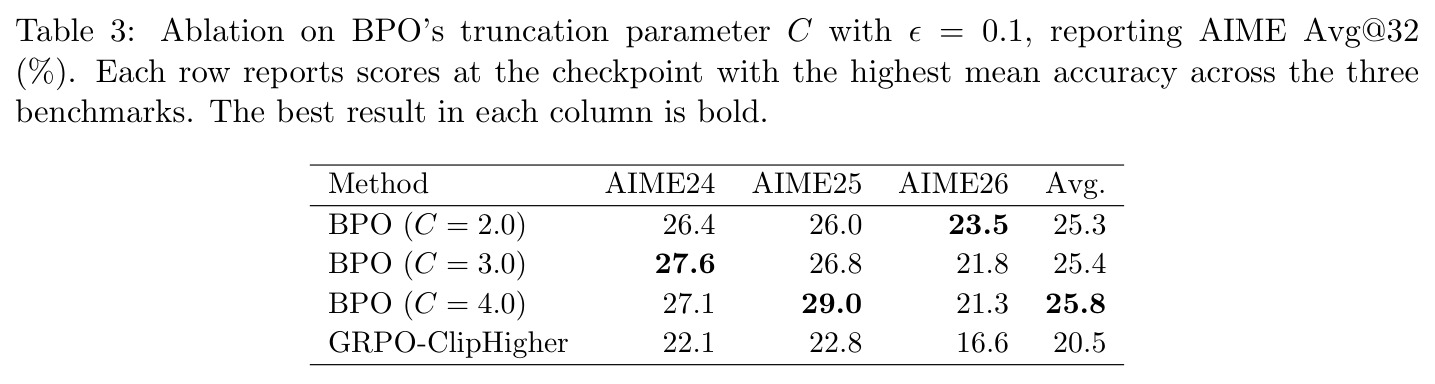
技术新颖性体现在三个层面。理论层面:这是首个证明轨迹级残差目标与 PMD 完全同解的工作(定理1),等价性对所有正权重 $\varphi$ 成立,证明用的鞅论证干净利落;相比之下,GRPO 系的裁剪目标没有这种“与某个规范目标同解”的理论刻画。算法层面:平滑互补概率比 $\omega=(1+\epsilon-\mu)/(1+\epsilon-\pi)$ 是全新的 token 权重族——不需要序列级似然(区别于 GSPO 的序列比率),不需要累积裁剪权重(区别于 CISPO),也比 DPPO 更简洁:DPPO 的梯度含 $\log\pi$ 与 $1/(1-\pi)$ 两个分开的项,BPO 把二者合并成单一乘性权重,可直接嵌进 GRPO 代码骨架,只替换比率一项,迁移成本极低。工程层面:BPO 保留 GRPO 的优势归一化与掩码结构,超参只有 $\epsilon=0.1$ 和 $C=3.0$ 两个,附录 C 在 Qwen3-4B-Base 上的消融表明性能对超参在较宽范围内不敏感,实用性较强。
实验结果
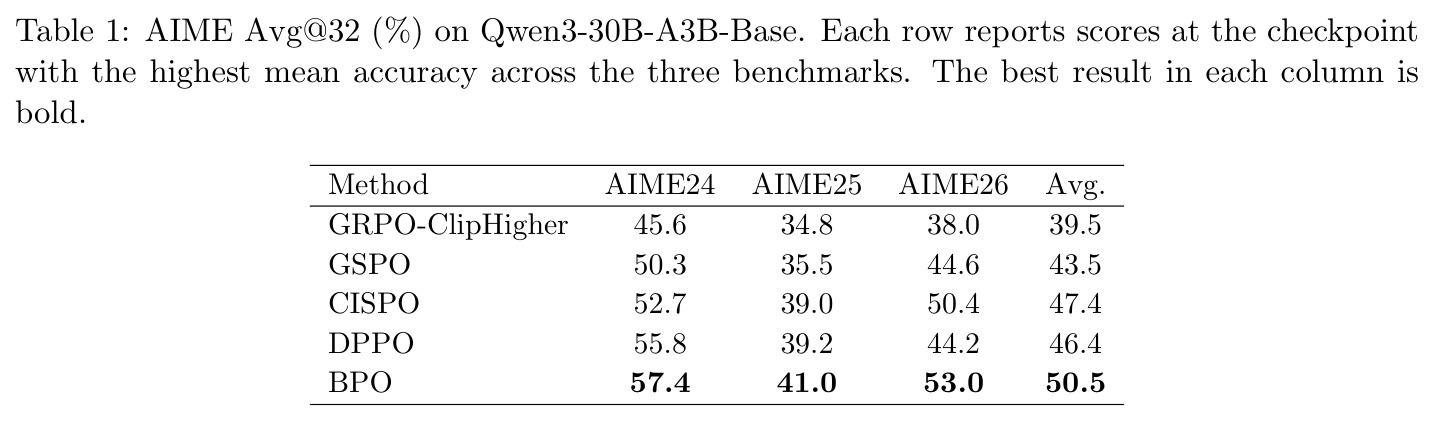
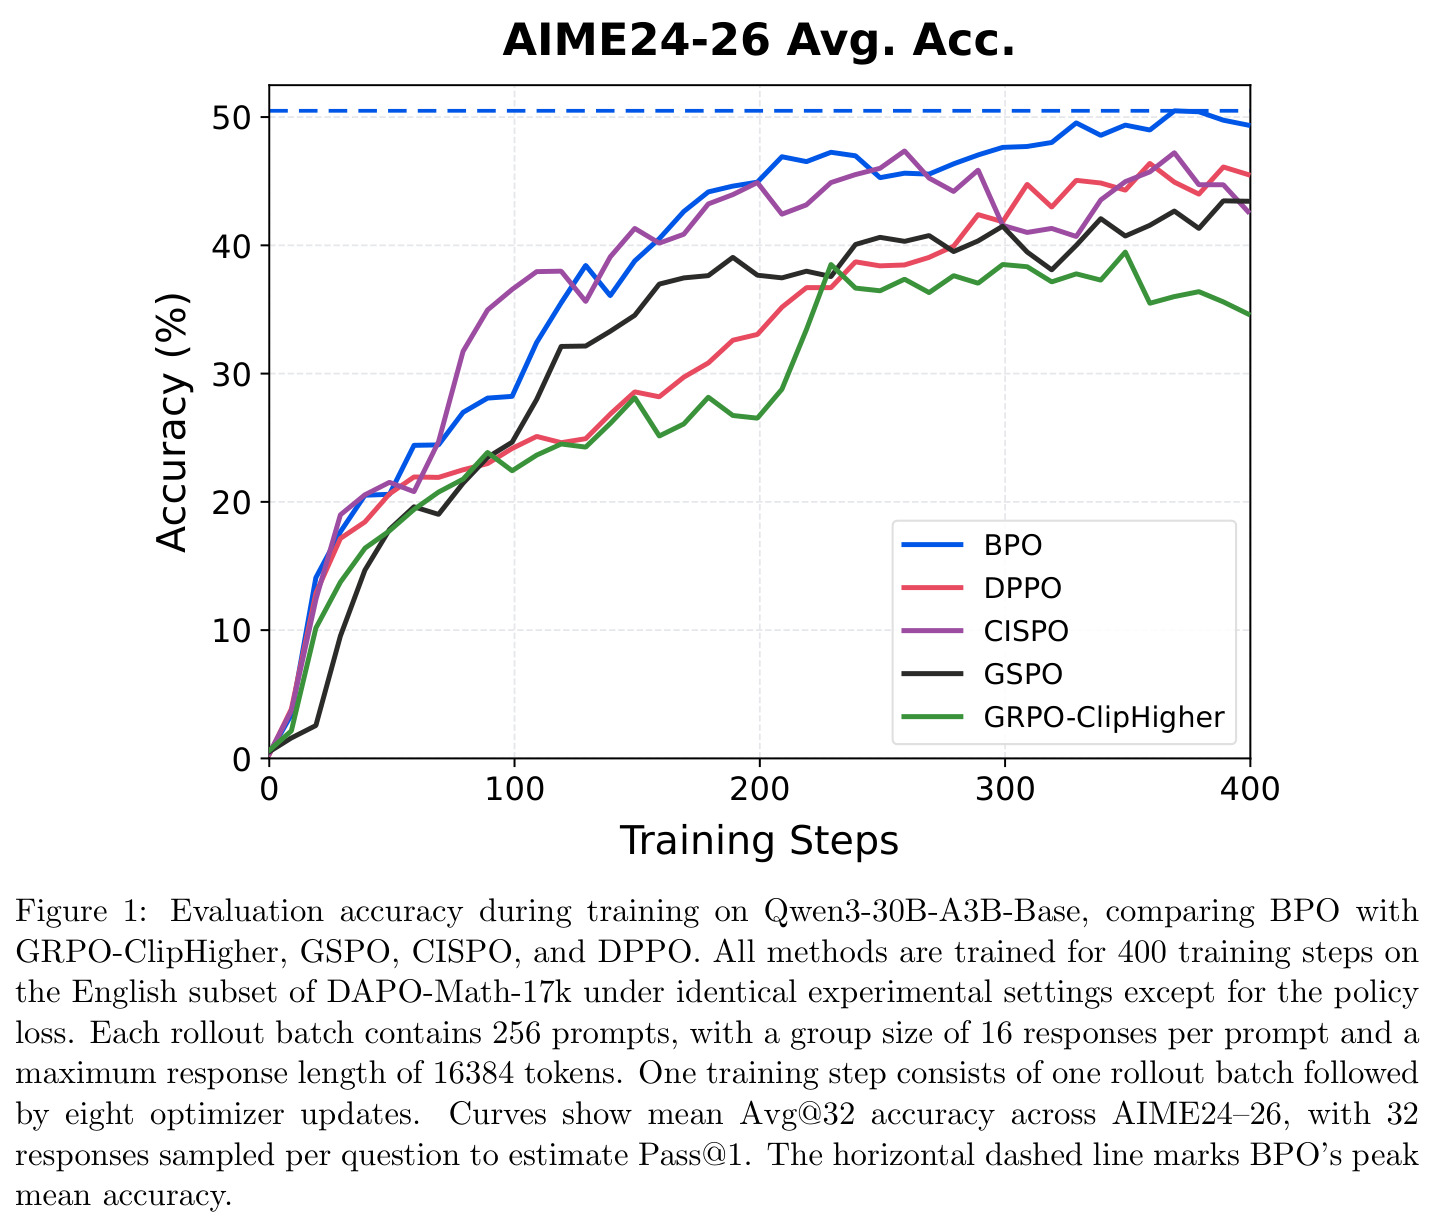
主实验在 Qwen3-30B-A3B-Base 上进行:DAPO-Math-17k 英文子集训练 400 步(每步 1 个 rollout batch 加 8 次优化器更新,共 3200 次更新),每批 256 prompts × 16 响应,最大响应 16384 tokens,各方法仅替换 policy loss 并统一使用 R3,BPO 取 $\epsilon=0.1$、$C=3.0$。AIME 2024/2025/2026 的 Avg@32 结果:BPO 达 57.4/41.0/53.0、平均 50.5%;最强基线 CISPO 平均 47.4%,DPPO 46.4%,GSPO 43.5%,GRPO-ClipHigher 39.5%。BPO 相对四者分别提升 11.0、7.0、3.1、4.1 个百分点,且三个基准全部第一(如 AIME24 超 DPPO 的 55.8 达 57.4,AIME26 超 CISPO 的 50.4 达 53.0)。训练动态上(Figure 1)BPO 上升更快更稳,训练结束时保持 49.4%,高于末期最强基线 DPPO 的 45.5%。Qwen3-4B-Base 消融表明 $\epsilon$ 与 $C$ 对性能不敏感。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(AIME 2024) | Avg@32 Pass@1 (%) | 57.4 | GRPO-ClipHigher 45.6 / CISPO 52.7 / DPPO 55.8 | 较 GRPO-ClipHigher +11.8,较最强基线 DPPO +1.6 |
| 数学推理(AIME 2025) | Avg@32 Pass@1 (%) | 41.0 | GRPO-ClipHigher 34.8 / CISPO 39.0 / GSPO 35.5 | 较 GRPO-ClipHigher +6.2,较最强基线 CISPO +2.0 |
| 数学推理(AIME 2026) | Avg@32 Pass@1 (%) | 53.0 | GRPO-ClipHigher 38.0 / CISPO 50.4 / GSPO 44.6 | 较 GRPO-ClipHigher +15.0,较最强基线 CISPO +2.6 |
| 数学推理(AIME 2024–2026 平均) | Avg@32 Pass@1 (%) | 50.5 | GRPO-ClipHigher 39.5 / GSPO 43.5 / CISPO 47.4 / DPPO 46.4 | 较四个基线分别 +11.0 / +7.0 / +3.1 / +4.1 个百分点 |
局限与改进
局限性方面:作者只在数学推理(DAPO-Math-17k)上验证,未覆盖代码生成、agent 工具调用或通用偏好任务;主结果只报 Qwen3-30B-A3B-Base 一个模型(Qwen3-4B-Base 仅用于超参消融),跨模型泛化性存疑。理论保证在近似链条后会打折:定理 1 针对的是含完整 KL、精确 $V^\mu(x)$ 与 $\varphi(x)$ 的目标(18),而实际损失经过线性化、组估计、二元 KL(仅为全 KL 的下界)与平滑裁剪四重近似,严格等价不再成立,文中也未量化近似造成的最优性差距。框架假设终端奖励、确定性验证器与 $|R|\le1$,无法直接处理过程奖励或多轮交互中的延迟稀疏奖励。组归一化沿用 GRPO,全对/全错组(std 为零)的处理未说明。训练仅 400 步,长期稳定性(熵塌缩、奖励 hacking、长度爆炸)未考察;正文未提供开源代码或权重链接。
独立分析的弱点
独立分析几点弱点。(1) 二元 KL 只约束“选中 token vs 其补集”的二分类,丢弃补集内部分布信息,高熵分布上 $\omega_t$ 可能系统性低估真实失配——可对 top-$k$ token 分桶算 KL,或周期性插入全 KL 修正。(2) 加性平滑 $\epsilon=0.1$ 在 $\pi_t\to1$ 时把权重压向约 $(1-\mu)/\epsilon$,引入有偏梯度但未量化偏差阶——可推导偏差-方差权衡界并自适应调 $\epsilon$。(3) 线性化在 $|R-V^\mu(x)|$ 大(组内奖励两极分化)时误差与信号同阶——可用二阶项或对高方差组降权。(4) 理论等价以 rollout 可达状态为口径,而每步 8 次 minibatch 更新使 $\mu$ 持续漂移,累积偏差未分析——可结合 R3 数据复用率实证拆解。(5) 仅在数学域、MoE 架构加 R3 上验证,$\omega$ 在代码生成长重复序列、密集模型上的行为未知。
未来方向
作者提出的延伸:附录 C 已展示 $\epsilon$、$C$ 的超参鲁棒性,自然方向是把 BPO 推广到更大模型规模、代码与 agent 任务,并考察与非 R3 基础设施的兼容性。基于本文成果可延伸的研究:(1) 把贝尔曼 telescoping 推广到过程奖励或每步有奖励的设置——残差将含中间奖励项 $\sum_t r_t$,值得推导新的轨迹级形式;(2) 把二元 KL 近似纳入定理 1 的等价性证明,量化近似引入的最优性差距上界,让理论闭环;(3) 统一 $\omega$ 与 CISPO/GSPO 的权重设计空间,研究“什么性质的 token 权重能同时保证稳定与样本高效”;(4) 失配修正权重天然适合 off-policy 度更高的场景,可与经验回放、异步 rollout 结合提升数据效率;(5) 分析组归一化与 $\varphi=1/\mathrm{std}$ 在奖励退化组(全对/全错)上的行为,提出更稳健的组加权方案;(6) 把 BPO 用于 RLHF 通用偏好优化,检验可验证奖励之外的迁移能力。
复现评估
复现评估:正文与摘要均未给出开源代码或模型权重链接,复现需自行实现。有利因素:方法改动极小(在 GRPO 基础上把 $r_t$ 换成 $\min(\mathrm{sg}(\omega_t),C)$),实现细节披露充分——$\epsilon=0.1$、$C=3.0$、组大小 16、每步 8 个 512 条的 minibatch、R3、最大 16384 tokens、400 步训练;训练数据 DAPO-Math-17k 与评测集 AIME24–26 均公开可得。不利因素:算力门槛很高——Qwen3-30B-A3B 是 MoE 模型,每步需 4096 条长至 16K token 的 rollout,共 3200 次优化器更新,估计需要多机 H100/A100 集群、数千 GPU 时;rollout-router replay 等 infra 细节依赖内部实现,可能影响复现精度。建议路径:先在 Qwen3-4B-Base(作者消融所用规模)上以小规模复现“BPO 优于 GRPO-ClipHigher”的相对排序,验证 $\omega$ 权重的增益后再扩展到 30B。总体复现难度:中高。
论文图表