当智能体慢下来:基于每Token Elo分析的LLM智能体测试时策略解读 When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
提出每token Elo指标:智能体测试时收益递减终不如独立采样,人类超线性,拐点指导算力分配
前置知识
测试时扩展
指在推理阶段通过投入更多算力提升输出质量的方法总称,包括重复采样、思维链延长、迭代修订、树搜索等。对推理模型其回报可度量:重复采样的性能近似随算力对数线性增长。而智能体的测试时策略更复杂:它会调用工具、接收环境反馈、修订方案、回溯并自行决定何时停止,属于自适应策略。
本文的核心问题正是:智能体这种自适应策略相比无记忆的重复采样,能否把额外算力更高效地兑换成性能,因此必须先理解这两种测试时计算模式的区别。
Elo 评分与 Bradley–Terry 模型
Bradley–Terry 模型为每个参赛者估计一个标量实力值 $r$,两者对局的期望胜率满足 $E[y_{pq}] = 1/(1+10^{-(r_p-r_q)/400})$,Elo 评分即实力差的函数,相差 400 分对应十倍胜率差距。模型只需成对胜负结果即可拟合,通常用 minorization–maximization(MM)迭代求最大似然解。
本文把'某智能体在某 token 预算检查点'当作一个选手,用 Bradley–Terry 模型把任务内的分数排序聚合成跨任务可比的 Elo 评分,这是全部分析的数学基石。
独立采样参考线
把同一问题独立求解 $n$ 次并保留最优称为 best-of-$n$。论文定理 3.1 证明:若每次尝试分数独立同分布,best-of-$n$ 与 best-of-$m$ 的总体 Elo 差恰为 $400\log_{10}(n/m)$,即每十倍算力收益恒定 400 Elo。这条斜率与分数分布无关,是一条'免费'的基准线。
智能体自 Elo 曲线斜率一旦低于 400 Elo/十倍,意味着继续延长会话还不如重新独立采样;这一定义直接支撑了缩放拐点的定义与算力分配规则。
开放式任务与中间提交评分
指没有已知最优解、允许反复提交候选解、且每次提交都获得确定性连续分数的任务,如 FrontierCS 算法研究题、AtCoder 启发式竞赛(ALE-Bench)、GPU 核优化(FlashInfer-Bench)和机器学习研究任务(MLS-Bench)。它们使会话内的进展全程可观测。
只有能对中间解实时打分的任务,才能画出'最优解分数随 token 预算变化'的轨迹,这是 Elo-per-token 分析的数据前提;SWE-bench 这类一次性判分的基准不适用。
研究动机
评测 LLM 智能体如何随测试时算力扩展,一直缺少合适的度量。以 SWE-bench 为代表的标准基准只在智能体提交后给出一次通过/不通过的判定,整条轨迹被丢弃,无法观察解在长会话中如何演化。而 GPU 核优化、启发式竞赛等开放式任务虽能给每次提交一个连续分数,但原始分数跨任务单位不同、任务内又非线性:例如 FrontierCS 的 26 圆装箱分数是单位正方形内 26 个互不相交圆的半径之和,从 1 提到 2 很容易,而 AlphaEvolve 从 2.634 提到 2.635 就刷新了纪录;同理从 80% 提到 81% 的难度也远超从 50% 提到 60%。作者为四个智能体系统在四个基准上投入了每组合 5 条会话、每条最高 1 亿 token 的算力,却发现没有现成方法能回答核心问题:智能体的测试时策略究竟以多快的效率把多花的 token 兑换成性能,它比盲目重复采样更快还是更慢。
本文的目标是本文的目标是建立一把能把不同智能体、不同任务、不同 token 预算乃至人类选手放在同一尺度上的度量框架,用以刻画智能体性能随测试时算力的扩展曲线。具体拆成三点:一是定义每 token Elo(Elo-per-token)指标,在开放式任务上按 token 预算追踪最优解并聚合为跨任务可比的 Elo 评分;二是给出独立采样(best-of-$n$)的理论参考线(400 Elo/十倍算力),用于判断智能体策略是否真正比重复采样更高效;三是利用曲线斜率的穿越点定义'缩放拐点',指导固定总预算在会话深度(单会话长度)与会话数量(并行重试)之间的最优分配。
与已有工作不同的是,已有评估要么给最终产物打分——SWE-bench 的终局判定、Chatbot Arena 对固定预算下单轮回复的偏好投票、竞赛平台给终局成绩的 Elo——要么像最接近的并行工作 EdgeBench 那样对原始性能随挂钟时间拟合 log-sigmoid 曲线,但后者没有任何参考基线,无法判断饱和究竟是策略失效还是任务上限所致。本文的独特之处在于被评分的单位是'某系统在某 token 预算',拟合结果因此是随预算变化的函数而非一次性的系统排名;且评分只依赖任务内排序,历史人类提交记录经同一评测器重判后,可与智能体会话进入同一场锦标赛直接对局;再叠加独立采样 400 Elo/十倍这条分布无关的参考线,实测曲线斜率对参考线的偏离就有了明确的'赚了还是亏了'的语义。
核心方法
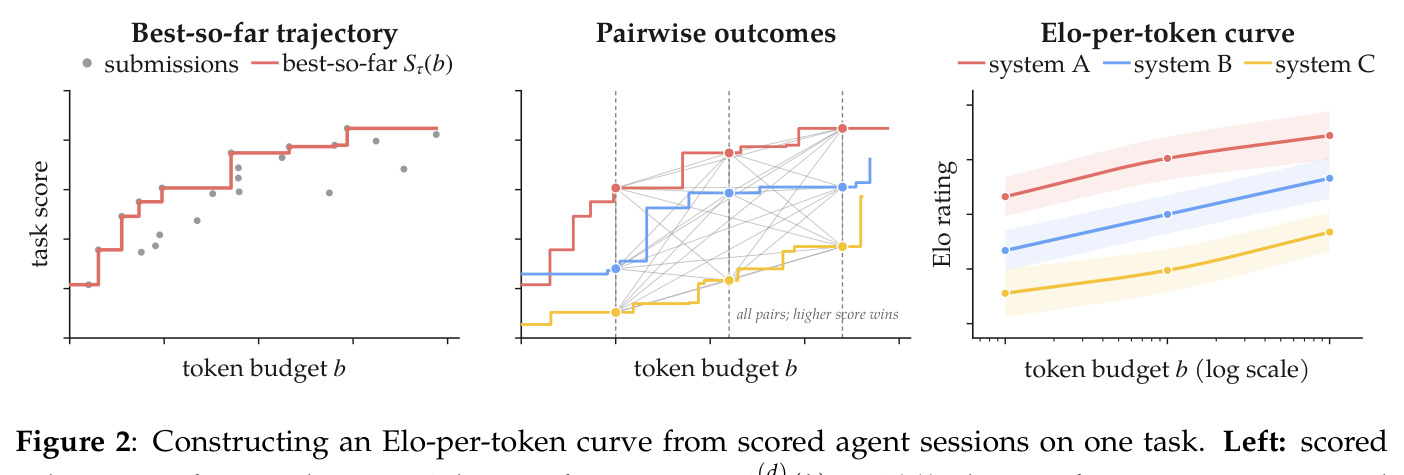
直觉上,论文把'智能体随算力变强了多少'变成一场锦标赛:在同一任务内,把不同系统、不同 token 预算检查点上的最优解分数两两比较,分数高者胜,再用 Bradley–Terry 模型把胜负聚合成 Elo。技术上分四步:(1) 记录每条会话中每次提交的分数 $s_i$ 与累计 token 数 $b_i$,得到轨迹 $\tau=\{(s_i,b_i)\}_i$;(2) 对每个预算 $b$ 计算迄今最优分数 $S_\tau^{(d)}(b)=\max\{s_i: b_i\le b\}$;(3) 在任务内对所有跨选手(系统×预算检查点)的分数对构造胜负记录,跨任务汇集后用 MM 迭代拟合 Bradley–Terry 模型,最低预算选手锚定为 1000;(4) 把拟合的 Elo 对 $\log_{10} b$ 作图得到每 token Elo 曲线,与 400 Elo/十倍的独立采样参考线比较斜率,进而求出缩放拐点 $b_{\text{inf}}$ 并据此分配算力。整个框架不要求会话串行生成,单智能体、并行采样、自修改系统都在适用范围内。
核心创新是'评分而非打分'(rate, not score):不直接比较原始分数,只利用任务内的排序信息,因此天然跨任务可比、对分数的非线性免疫。第二个关键是对被评对象的重定义——过去 Elo 评的是终局产物(最终解、竞赛成绩、固定预算回复),这里评的是'系统×预算检查点',Elo 从排名变成预算的函数。第三是理论保障:定理 3.1 证明独立采样的总体 Elo 增量恰为 $400\log_{10}(n/m)$,与分数分布无关,这条免费参考线让'智能体策略是否比盲目采样高效'变成可检验的经验问题。此外,自 Elo 只保留同系统跨会话的对局、剔除同会话对局(后者因最优分数随预算单调不减而胜负注定,只会贡献确定性的向上漂移而非证据),从而干净地隔离出系统自身的扩展形状。
方法步骤详情
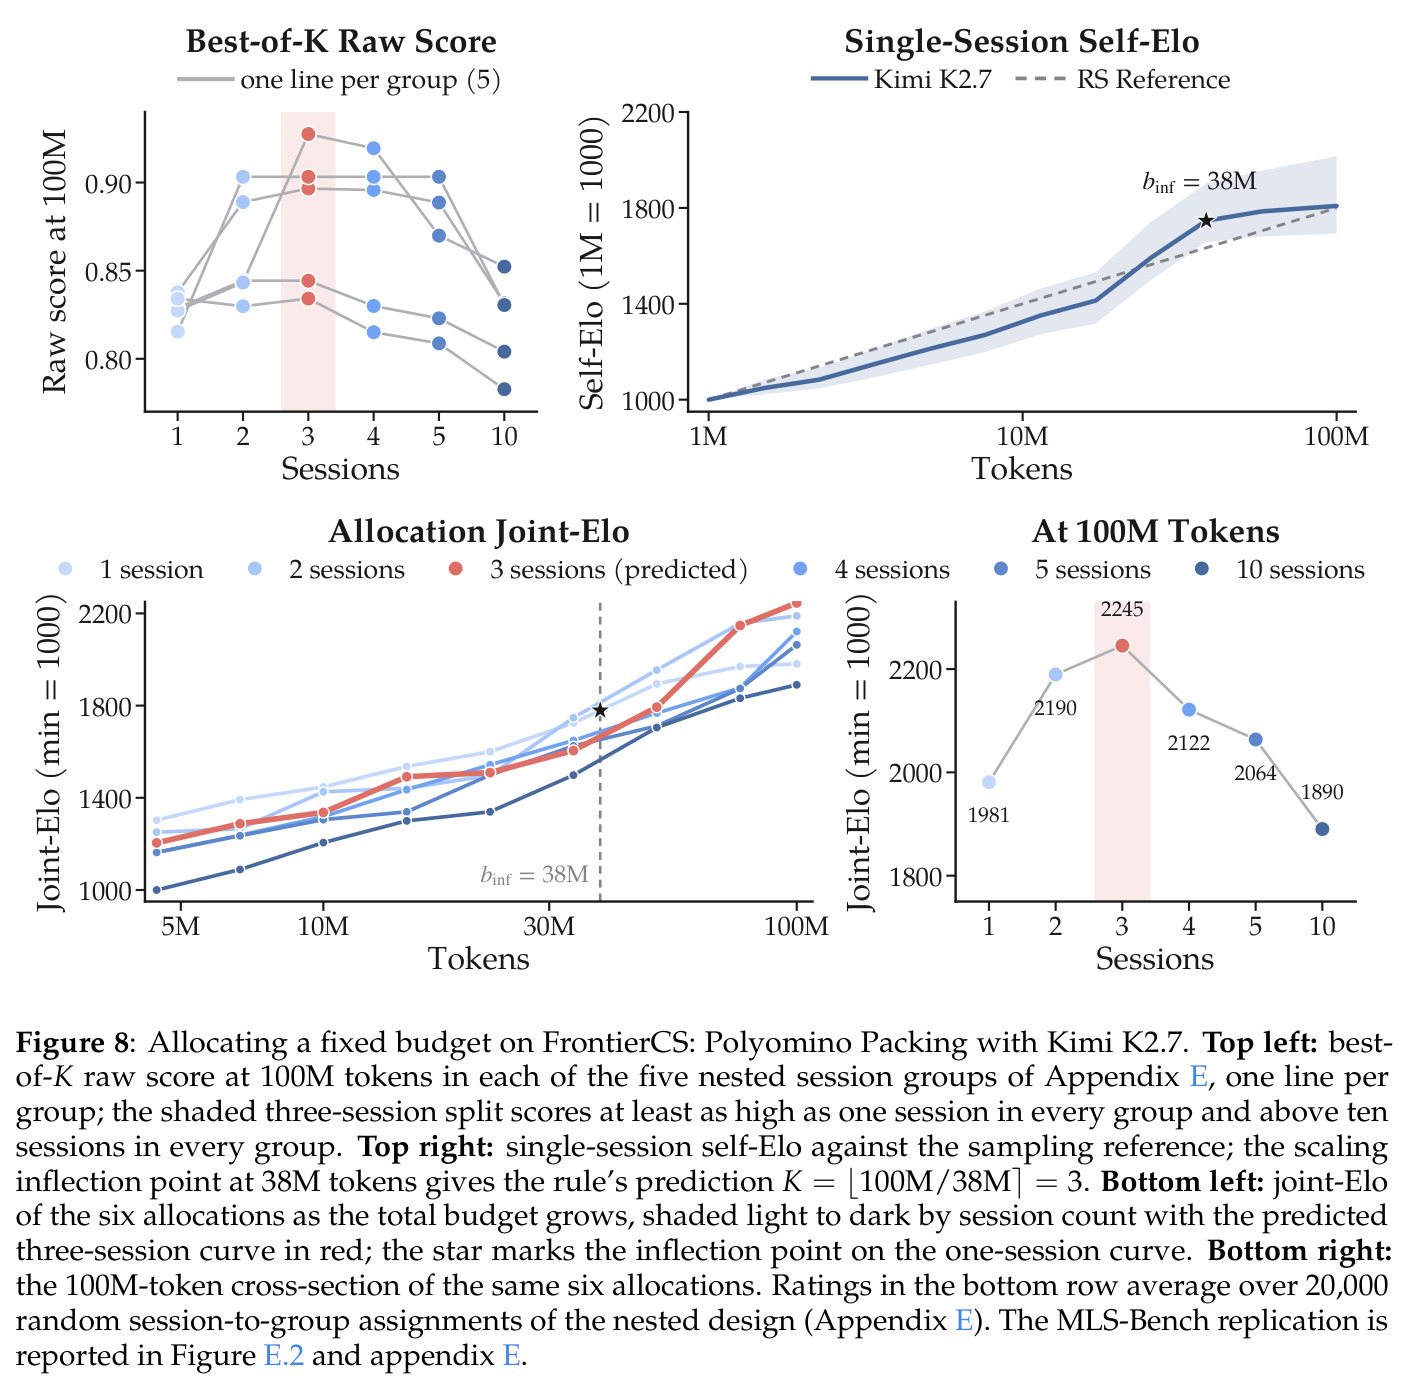
第一步,数据采集:在四个基准的 14 个问题上,每个智能体-任务各跑 5 条独立会话,每条目标 1 亿 token,记录每次提交的分数与累计 token(含缓存输入),提前退出则从原上下文续跑。第二步,构造最优轨迹:按 $S_\tau^{(d)}(b)=\max\{s_i:b_i\le b\}$ 得到每条会话的最优分数-预算曲线。第三步,构造对局:在任务内把不同选手(系统×检查点)的最优分数两两比较,高分得 1、平局 0.5、低分得 0。第四步,拟合:跨任务汇集对局,用 Bradley–Terry 的 MM 迭代做最大似然估计,最低预算选手锚定 1000;自 Elo 只保留同系统跨会话对局,joint-Elo 保留全部。第五步,不确定性:按智能体-任务单元对完整会话自助重采样并重拟合,得逐点 95% 置信区间。第六步,斜率与拐点:在相邻 5 个检查点上把自 Elo 对 $\log_{10}b$ 回归得局部斜率,拐点 $b_{\text{inf}}=\sup\{b: dr/d\log_{10}b>400\}$。第七步,分配:总预算 $B$ 下取 $K=\max\{1,\lfloor B/b_{\text{inf}}\rceil\}$ 条并行会话,各自跑到 $b_{\text{inf}}$,聚合用量达 $B$ 即停并取最优解。
技术新颖性
与已有工作的本质区别有三层。度量层面:此前的智能体评测在固定预算处比较准确率,EdgeBench 虽拟合形状却无参照系;Elo-per-token 首次让智能体、采样基线、人类选手同台竞技,并把边际收益(多一个 token 值多少 Elo)变成可估计的量。理论层面:论文给出三个定理——独立采样参考(定理 3.1)、拐点后 harness 失效(定理 6.1:若继续会话的渐近斜率低于 $s_{\text{ref}}$,从拐点状态冻结后做独立采样终将获得更大的 Elo 增益)、拐点分配(定理 6.2:$B=K\cdot b_{\text{inf}}$ 时 $K$ 会话比单会话多得 $400\log_{10}K$ Elo)——把经验观察升级为可操作的分配规则。机制层面:粘滞盆地模型(定理 7.1)在高斯假设下证明 $\lim_{T\to\infty}\Pr(M_{cT}>M_T)=1/2$,即会话越长、常数倍的深度增加越不划算,为'长会话为何终会失速'给出第一个形式化解释。
实验结果
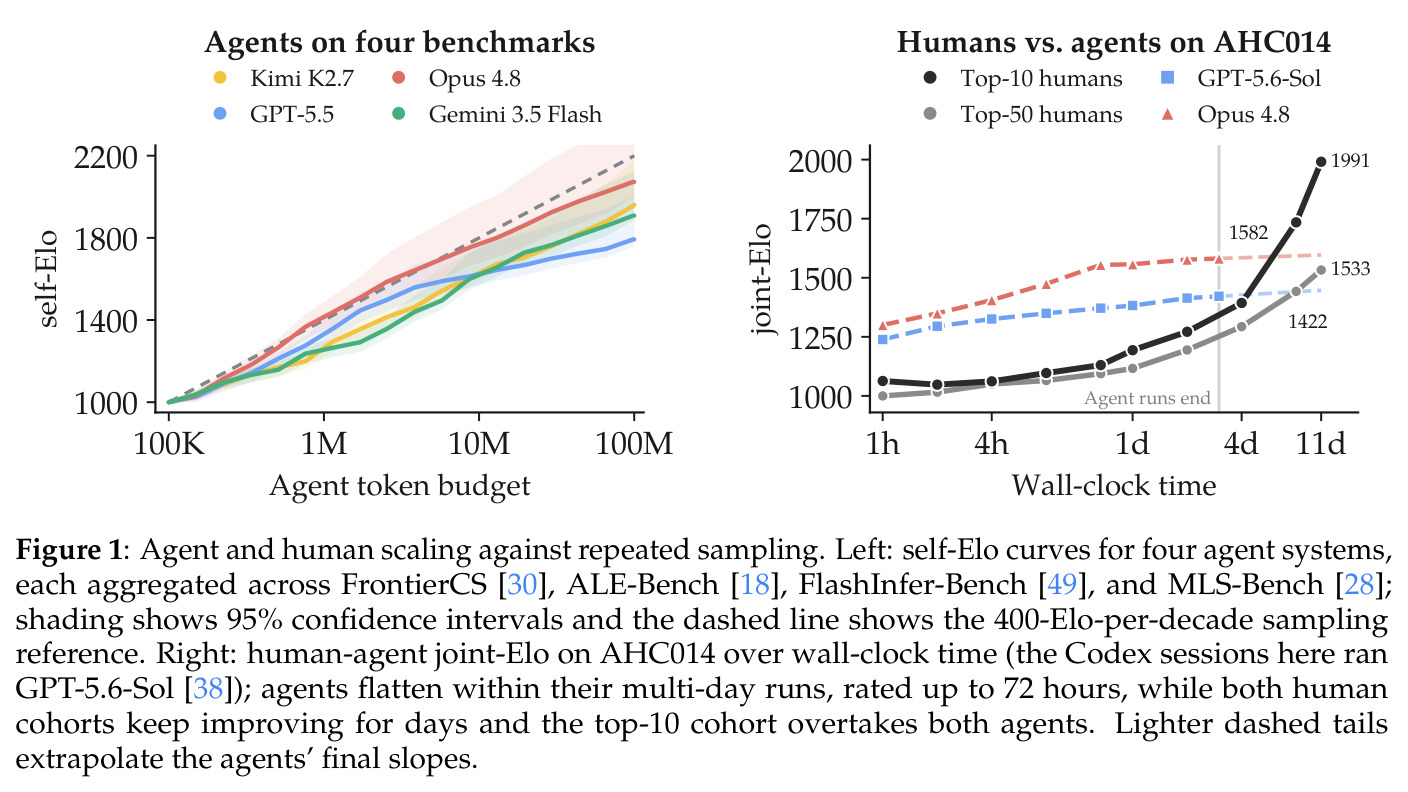
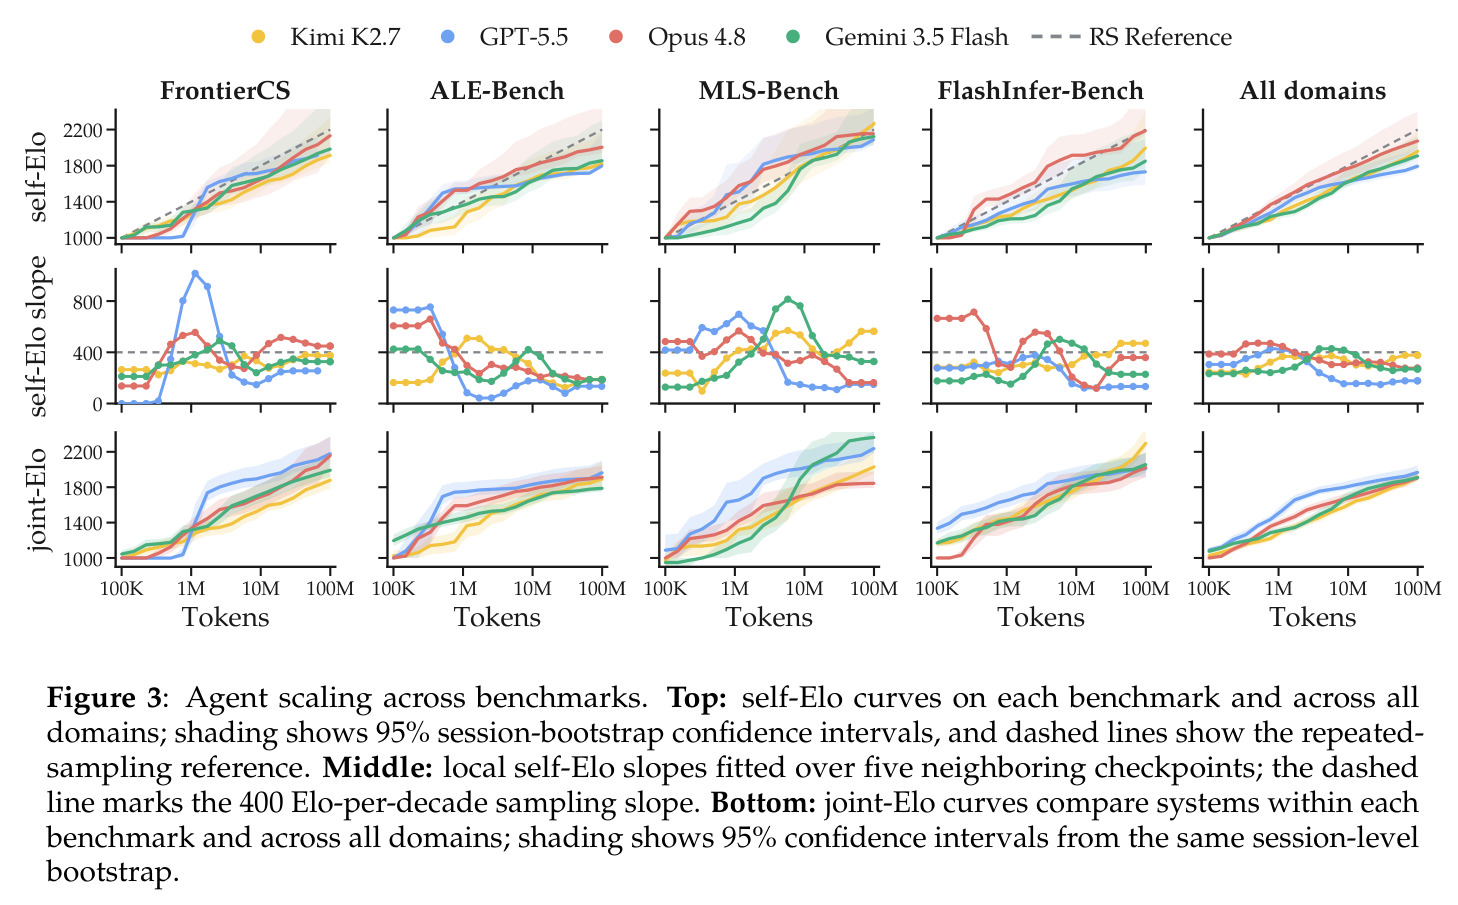
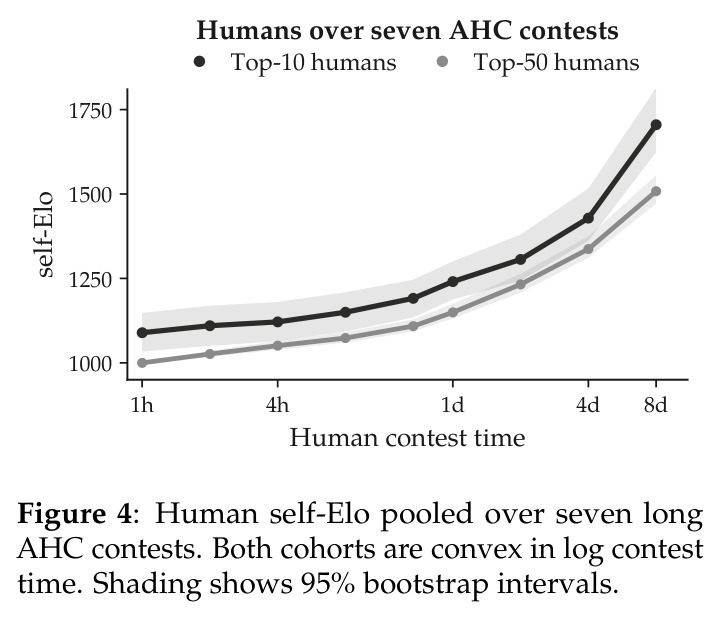
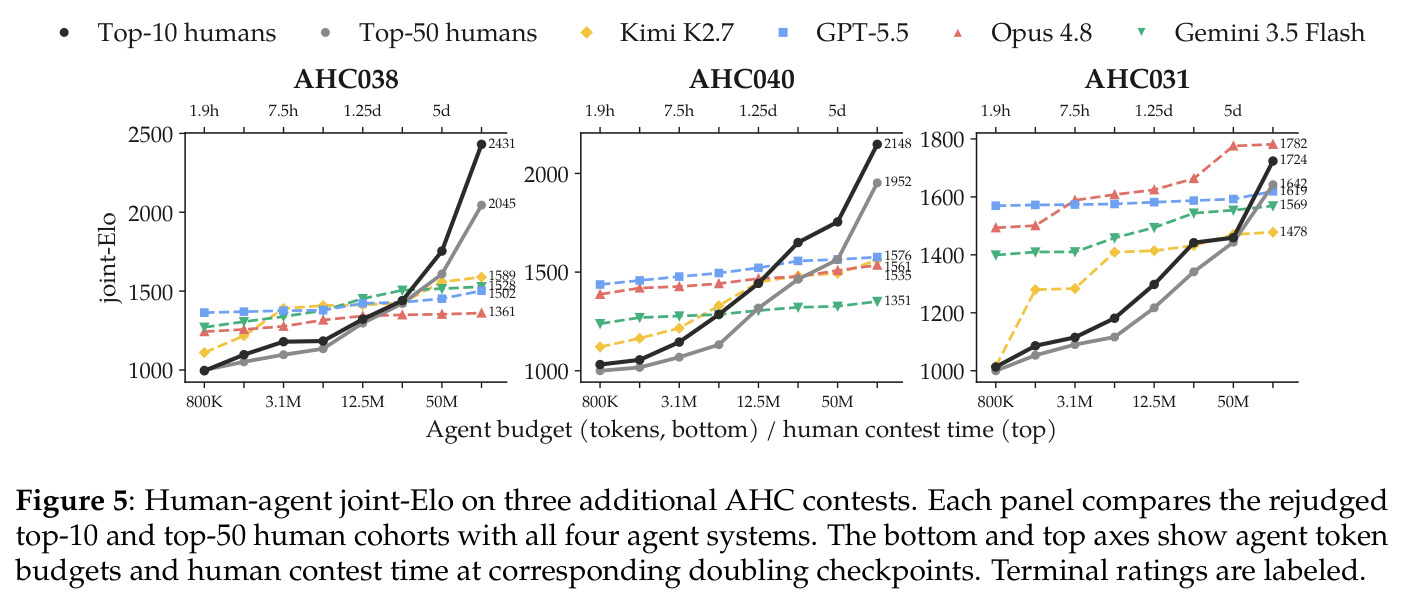
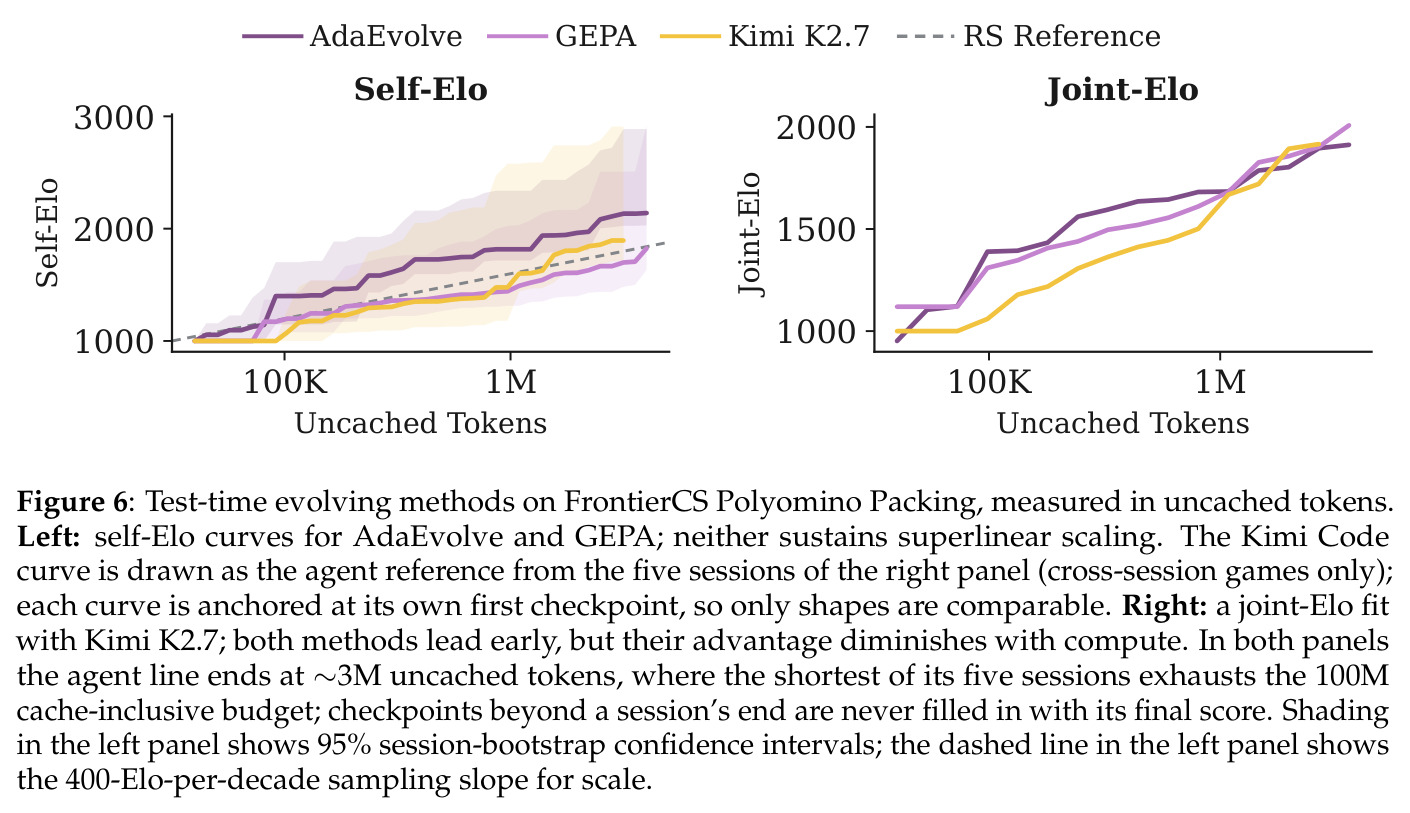
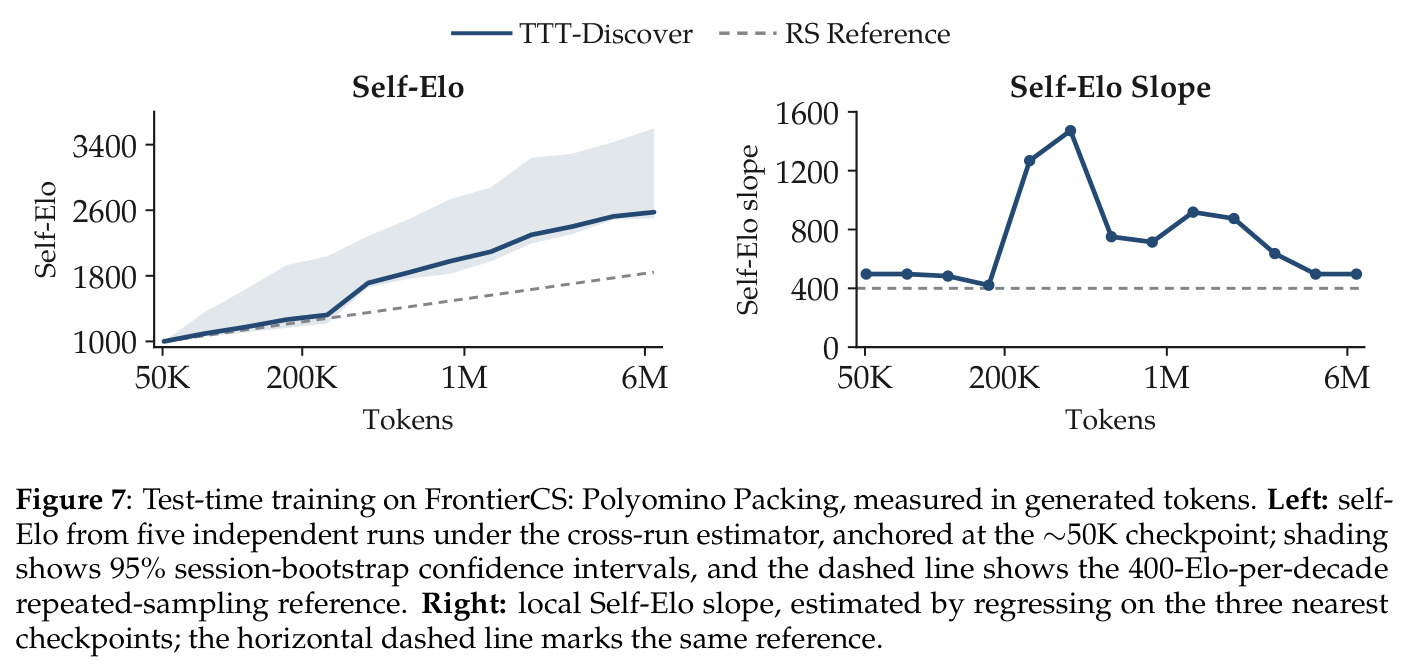
实验覆盖四个基准(FrontierCS、ALE-Bench、MLS-Bench、FlashInfer-Bench)的 14 个问题与四个智能体(Kimi Code/K2.7、Codex/GPT-5.5、Claude Code/Opus 4.8、Gemini CLI/3.5 Flash),每组合 5 条会话、目标 1 亿 token。发现一:所有系统随算力提升但边际收益递减——图 3 的全域自 Elo 中,四系统在大预算处斜率全部跌破独立采样的 400 Elo/十倍参考线,曲线在对数算力轴上呈凹形。发现二:人类相反——七场 10–14 天 AHC 的 Top-10/Top-50 自 Elo 在对数竞赛时间上呈凸形(图 4);本地复刻的 AHC014 上,GPT-5.6-Sol 与 Opus 4.8 的多日会话在 72 小时内趋平,Top-10 人类数日内反超;AHC038/040/031 复现同样格局(图 5)。发现三:专用策略救不了形状——图 6 中 AdaEvolve 在约 10 万 uncached token 处领先 Kimi 超 300 Elo、GEPA 起步最强,但 Kimi 约 1M token 后追平,最后检查点三者相差约 20 Elo;图 7 的 TTT-Discover(gpt-oss-20b)同样先快后慢。发现四:拐点可兑现——Kimi K2.7 在 Polyomino Packing 拐点为 3800 万 token,预测 $K=3$;图 8 显示 1 亿 token 时三会话分配比单长会话高 264 joint-Elo、比十短会话高 355 joint-Elo,在 $K\in\{1,2,3,4,5,10\}$ 中最优,MLS-Bench 复制实验同样双胜两端。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FrontierCS Polyomino Packing(1 亿 token 总预算分配,Kimi K2.7) | joint-Elo(2 万次随机会话-组分配平均) | 拐点规则预测的 3 会话并行分配 | 单条 1 亿 token 长会话 / 10 条 1 千万 token 短会话 | +264 Elo / +355 Elo,在 K∈{1,2,3,4,5,10} 中最优 |
| 四基准 14 题(FrontierCS/ALE-Bench/MLS-Bench/FlashInfer-Bench) | 自 Elo 局部斜率(Elo/十倍 token) | 大预算处四个系统的斜率全部低于 400 | 独立采样参考线(恒为 400 Elo/十倍) | 斜率从早期高于 400 跌至低于 400,后期相对基线为负增益 |
| AHC014 人机对齐复刻(本地评测器) | joint-Elo(挂钟时间轴,最长评级至 72 小时) | GPT-5.6-Sol 与 Opus 4.8 多日会话先快后平 | 历史 Top-10 人类选手(同一评测器重判) | Top-10 人类在数日内反超两个智能体系统 |
| 七场 AHC(10–14 天)人类自 Elo | 自 Elo 曲线形状(对数竞赛时间,1h–8d) | 人类 Top-10/Top-50 均呈凸形(超线性) | 独立采样对数线性参考(400 Elo/十倍) | 人类是唯一持续超线性扩展的一方,后期每翻倍时间收益更大 |
| Polyomino Packing 测试时进化(AdaEvolve/GEPA,uncached token 计量) | joint-Elo 对 Kimi K2.7(各 5 次独立运行,4M uncached token 对齐) | AdaEvolve 在约 100K uncached token 处领先超 300 Elo,GEPA 起步最强 | Kimi Code/K2.7 裸智能体会话 | 优势短暂:约 1M token 后被追平,最后检查点三者相差约 20 Elo |
| Polyomino Packing 测试时训练(TTT-Discover,gpt-oss-20b) | 自 Elo 局部斜率(5 次独立运行,6.6M rollout tokens) | 先高于 400 参考斜率,随后回落向参考线 | 400 Elo/十倍独立采样参考 | 无可持续超越:在线参数更新也逃逸不出收益递减 |
局限与改进
作者明确承认:拐点无法从领域级曲线预测——Kimi K2.7 的 FrontierCS 域曲线斜率穿越点与 Polyomino 单题 3800 万 token 的拐点不重合,MLS-Bench 复制实验同样错位,从任务属性或早期统计量预测拐点仍是未解问题;粘滞盆地只是一个高斯假设下的解释性模型,论文并未直接检验真实会话是否陷入算法'盆地'。我自己还观察到:其一,只有 14 个问题、四个编码类智能体,结论对 Web 智能体、无确定性评测器任务的普适性未知;其二,缓存计入的 token 记账会让曲线在横轴上水平平移,论文论证了渐近比例关系,但早期阶段的'先快后慢'仍可能部分受记账方式影响;其三,AHC 人类数据是历史记录,硬件、工具与训练条件与当代智能体不可同日而语,人机超线性对比存在混杂;其四,自 Elo 各系统独立拟合、绝对水平不可跨系统比较,只能比较形状;其五,1 亿 token×5 会话×多系统的算力成本极高,限制了问题覆盖面与独立复现。
独立分析的弱点
第一,粘滞盆地假说缺乏直接证据:论文只给出高斯模型下的极限定理,没有从真实轨迹中检测'盆地切换'。改进方向:对会话中的提交做算法聚类或代码 diff 聚类,统计长预算会话中根本性换思路的次数,直接验证锁定效应。第二,拐点估计有统计风险:斜率用相邻 5 个检查点回归,检查点稀疏时拐点方差大,而定理 6.2 的全部收益都押在拐点估计上。改进方向:报告拐点置信区间,并用序贯检验在线更新 $K$。第三,分配规则限定等分且会话间零通信,浪费了'用已结束会话的摘要暖启动新会话'的机会。改进方向:允许不等分或跨会话共享失败摘要,检验能否既保住 400 斜率又高于纯采样。第四,400 Elo/十倍参考假设各尝试成本相同、分数独立连续,而智能体各步 token 成本高度不均、会话内强相关,独立同分布前提并不严格成立,参考线的实际意义在早期预算段可能偏乐观。
未来方向
作者提出两个方向:一是预测任务级拐点——能否从任务属性或会话早期统计量预测拐点而无需跑完整曲线,他们已证明领域级曲线不够用,这是最有价值的问题;二是把'盆地逃逸/方案重估'变成 harness 设计原则,例如显式的回溯、多样性强制或定期重开思路的机制。基于本文成果还可延伸:其一,用拐点分配作为训练信号,教会模型自己判断'何时放弃当前思路',把会话级的元决策内化到模型权重中;其二,把并行会话与轻量跨会话记忆结合,检验能否既保留采样斜率又继承前期知识,缩小与人类持续学习的差距;其三,把框架搬到机器学习工程之外——Web 任务、科学发现等分数带噪声的场景需要先解决排序噪声下的 Bradley–Terry 拟合;其四,研究拐点位置与模型规模、上下文管理策略(压缩频率、记忆机制)的标度关系,论文附录 F.3 的 Qwen3.5 规模扫描可以作为一个起点。
复现评估
复现条件中等偏难。有利面:代码已在 github.com/agent-tts/Agent-TTS-Code 开源;AHC 历史提交数据在 AtCoder 公开,作者用本地评测器复刻了 AHC014/031/038/040 的原始目标,使人类与智能体在同一分数尺度上重判;TTT 实验用的是开放权重的 gpt-oss-20b;四个基准均有确定性自动评测器,无需人工评审或 LLM 评审。困难面:主体实验需要四个前沿智能体系统(K2.7、GPT-5.5、Opus 4.8、Gemini 3.5 Flash)在 14 个问题上各跑 5 条 1 亿 token 会话,仅主实验就涉及数百亿 token 的 API 费用;拐点分配实验还需再跑 $K\in\{1,2,3,4,5,10\}$ 六种分配加 MLS-Bench 复制。低成本复现路径:只做 Polyomino Packing 单任务的分配实验,或用开放权重模型加本地评测器替代前沿 API,优先验证'斜率先升后降'与'拐点分配双胜'这两个核心定性结论。
论文图表