为氛围设计智能体赋能可控的创造性探索 Enabling Creative Exploration for Vibe Design Agents
把设计方向变成显式中间决策,让UI智能体在固定解码设置下探索多样方案
前置知识
Verbalized Sampling (VS)
一种推理时(inference-time)方法:不再让模型一次只给一个答案,而是要求它列出多个代表性候选,并为每个候选附上概率式的典型性分数。其动机是对齐后的模型分布被后训练压得过尖,倾向输出原型化答案;VS 通过显式展开响应分布来缓解这种典型性偏差。分数并非校准概率,只适合当作可归一化的操作权重使用。
本文架构的候选提议阶段直接建立在 VS 的启发机制之上,理解 VS 才能明白为什么提议-选择两级结构能带来更广的设计覆盖。
解码温度与典型性偏差
温度 $\tau$ 缩放 softmax 分布:低温使高概率 token 更占优,输出保守且重复;高温增加随机性,但对整段输出一视同仁地注入噪声。RLHF/DPO 等偏好优化会进一步压窄分布,导致 minority 偏好被抑制、重复请求返回相似的常规模式,即典型性偏差。
论文的核心批评是 token 级温度无法区分美学决策与语法敏感代码,理解这一纠缠才能体会显式中间规范的必要性。
结构化设计规范
本文提出的中介表示:主题规范把种子色、明暗模式、标题/正文字体、圆角等互锁属性打包成一个完整方向;资产规范则是一条描述主体、构图与视觉风格的图像生成提示词。选中规范即一次性提交全部属性,作为下游生成器的条件指令。
规范是探索与实现之间的接口,也是整篇论文的控制点概念;所有实验都是围绕对这两个干预点的开关展开的。
LLM-as-Judge 成对比较
用一个更强的模型(本文为 Gemini 3.1 Pro,内部名 AutoRater)按多维度 UI rubric 对成对输出打分,报告胜/负/平及胜负比。该方式可规模化,但存在位置偏差、冗长偏差、自家族偏差等已知问题,只能作为描述性证据而非人类偏好替代。
论文的离线质量结论几乎全部来自 LLM judge,需要清楚其能力边界才能正确解读胜负比数字。
在线 A/B 实验与置信区间
把用户随机分为对照组与实验组,比较任务完成率、延迟、导出、反馈等平台指标,并报告相对变化的 95% 置信区间;区间包含 0 即统计上不显著。样本量与指标稀疏度决定结论强度。
论文用 30 余万任务的 A/B 实验评估干预的真实产品影响,只有掌握显著性判断才能区分「观察到提升」与「证明有效」。
研究动机
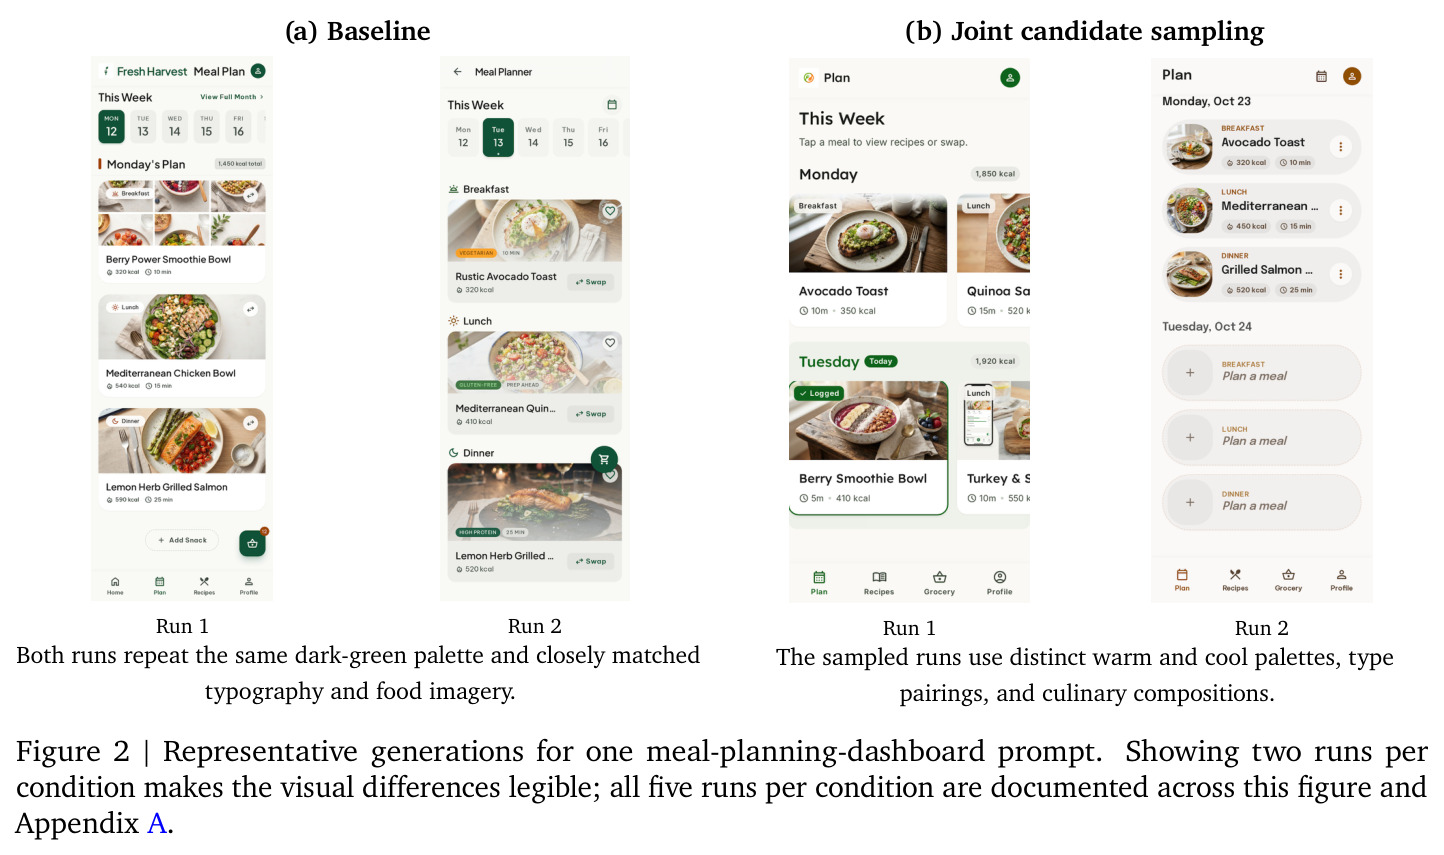
氛围设计智能体(如 Lovable、v0、Bolt、Replit Agent、Google Stitch 等)把自然语言需求变成渲染界面和前端代码,但一个有用的设计智能体不应只产出一张合法页面,还应帮助用户在多个连贯方向之间探索。现有做法无法选择性控制探索:把 token 级温度调高会同时扰动美学决策(配色、字体、排版)和语法敏感的代码生成,导致「想要更狂野的视觉、却换来更多坏代码」;低温则反复产出熟悉的常规 UI 模式。作者指出偏好优化(RLHF/DPO)带来的典型性偏差使重复请求返回相似的保守设计,而「要有创意」这类高层指令又不提供任何运行时可检查、可调节的显式分布,探索程度完全不可控。
本文的目标是本文目标是在不触碰下游解码设置的前提下,把「设计方向」变成推理管线中一个显式、可独立调节的中间决策:由提议阶段生成多个结构化设计规范(UI 主题或视觉资产提示词)并附典型性分数,由外部选择器按可调温度采样其中一个,再让固定配置的下游生成器按选定规范实现界面。同时建立一套分层评估:用 168 个 prompt 的离线成对实验度量选择覆盖与渲染变化,用 Gemini 3.1 Pro 评审度量偏好,并用超过 30 万任务的真实产品 A/B 实验度量使用行为变化,三类结果分开报告、不互相简化。
与已有工作不同的是,现有 UI 生成研究(截图转代码基准、交互正确性、分层构建、精修系统)几乎都聚焦保真度与正确性,而非重复运行下的探索广度;多样性研究则停留在文本层面——训练时的多样性偏好目标需要偏好数据且改变质量权衡,VS 等推理时方法也未与结构化 UI 表示结合。本文的独特切入是:把 VS 的「列候选+自报分数」机制落到结构化设计规范上,把设计方向作为探索与实现之间的显式接口,首次在该场景同时完成离线受控实验与 309,870 任务规模的商业部署 A/B 评估,并诚实地把覆盖度、视觉变化、评审偏好与线上行为作为四个独立结果呈现,拒绝给出单一「最优温度」。
核心方法
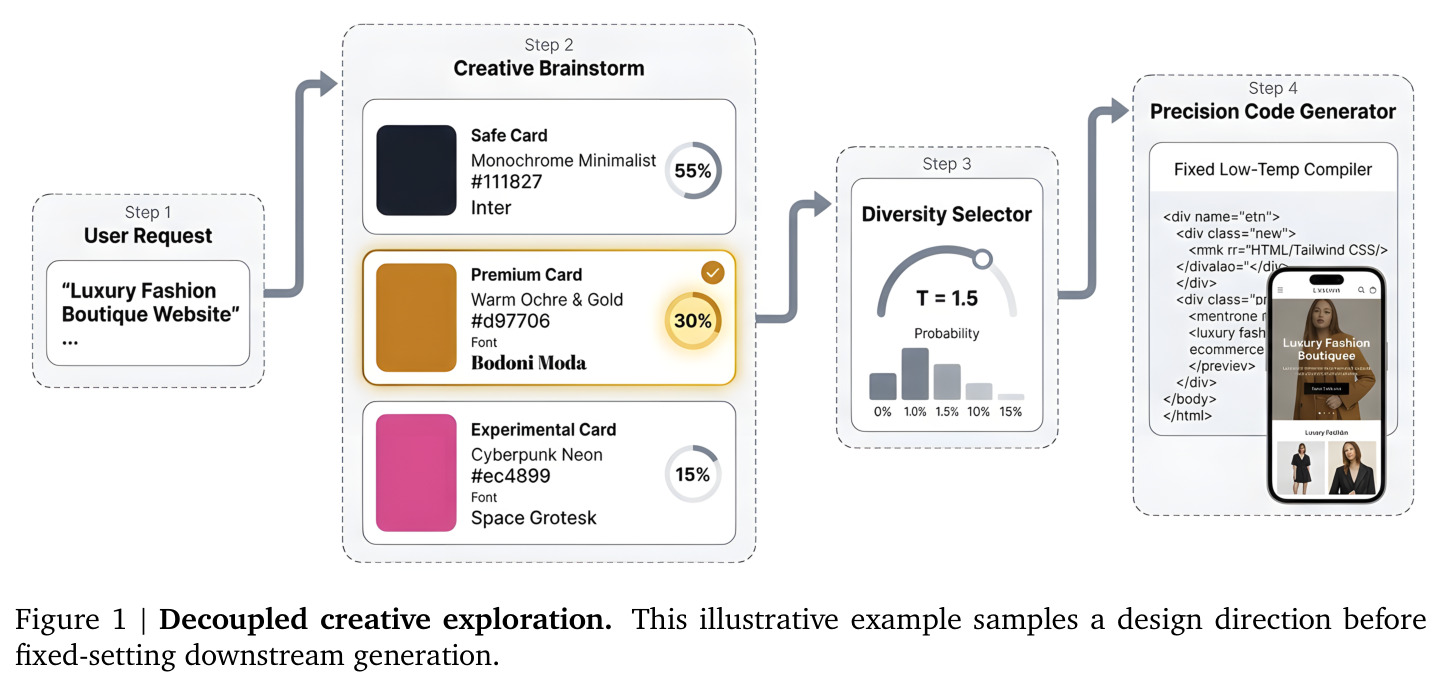
直觉上,论文把「决定往哪个方向设计」和「如何把方向实现成代码」彻底拆开:前者需要多样性,后者需要确定性。技术路线是一个四阶段推理架构:(1) 用户请求作为任务规范被保留;(2) 提议阶段用 VS 风格的 pre-pass 生成 $K=3$ 个 prompt 兼容的候选方向,分别锚定为 Safe(常规高典型性)、Premium(视觉精致)和 Experimental(低典型性),每个候选包含结构化规范、简短理由和自评典型性分数;主题候选绑定种子色、明暗模式、标题/正文与圆角,资产候选是一条描述主体、构图与风格的图像提示词;(3) 外部选择器把非负分数归一化为权重 $\hat{p}_k$,再按候选级温度缩放采样;(4) 下游生成器接收「原始请求+选中规范」,在所有条件下完全相同的解码设置中生成设计系统、代码和页面配图。主题采样与资产采样作为两个独立干预分别开启评估。
核心创新是把设计方向从隐式的 token 分布抽出来,变成一个可检查、可加压的显式中间对象。与调温度的本质区别在于:温度噪声无差别地打击美学与语法,而规范选择只改变「 pursuing 哪个设计」,下游解码固定,代码语法稳定性不受影响。规范本身把互锁属性(配色+明暗+字体+圆角)捆绑成完整方向,保证变化是连贯的设计概念而非零散 token 抖动。选择策略在提议集合内做温度缩放:$q_k(\tau) = \frac{\hat{p}_k^{1/\tau}}{\sum_{j=1}^{K} \hat{p}_j^{1/\tau}}$,$\tau<1$ 更偏向高权重方向,$\tau>1$ 放大小众方向的机会,$\tau=1$ 即按自评分权重直接采样;关键限制是温度只能改变集合内的几率,不能引入未被提议的方向。自评分数被明确当作操作权重而非校准概率,避免对提示数字的概率含义过度解读。
方法步骤详情
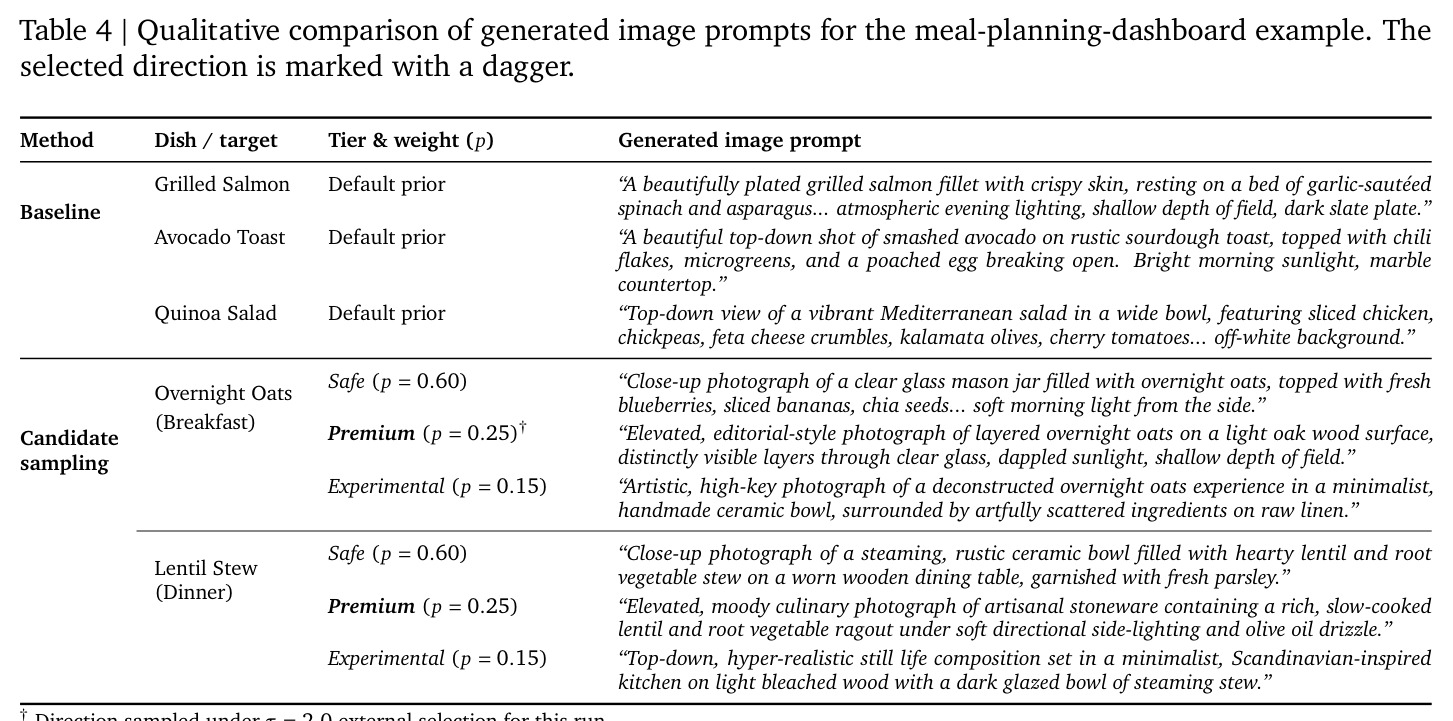
第一步,提议:输入用户 UI 请求,模型(Gemini 3 Flash)输出 $K=3$ 个候选,每个含规范、理由和典型性分数;主题规范记录种子色、亮/暗模式、标题与正文字体、圆角程度,资产规范是完整图像生成提示词(如案例中「玻璃罐隔夜燕麦、柔侧光」与「浅橡木桌面、斑驳阳光的杂志式构图」两个方向)。第二步,清洗与归一化:丢弃缺失、负数、非数值分数,非负分数归一化为 $\hat{p}_k$;若无有效分数则重新提示一次,仍失败则回退到基线路径(不采样、直接生成)。第三步,选择:对正权重候选施加 $q_k(\tau)=\hat{p}_k^{1/\tau}/\sum_j \hat{p}_j^{1/\tau}$ 采样,实验扫描 $\tau\in\{0.5,1,1.5,2,5\}$,产品默认主题 1.5、资产 2.0;零权重候选永不入选,另有精确均匀的 $1/K$ 策略作为备选。第四步,条件生成:Gemini 3 Flash 按选中主题生成设计系统与代码(被指令保持所选配色/字体/明暗/圆角),Nano Banana 2 按选中提示词生成页内配图;全部阶段解码设置固定,与基线唯一差异是多了提议与选择两级。
技术新颖性
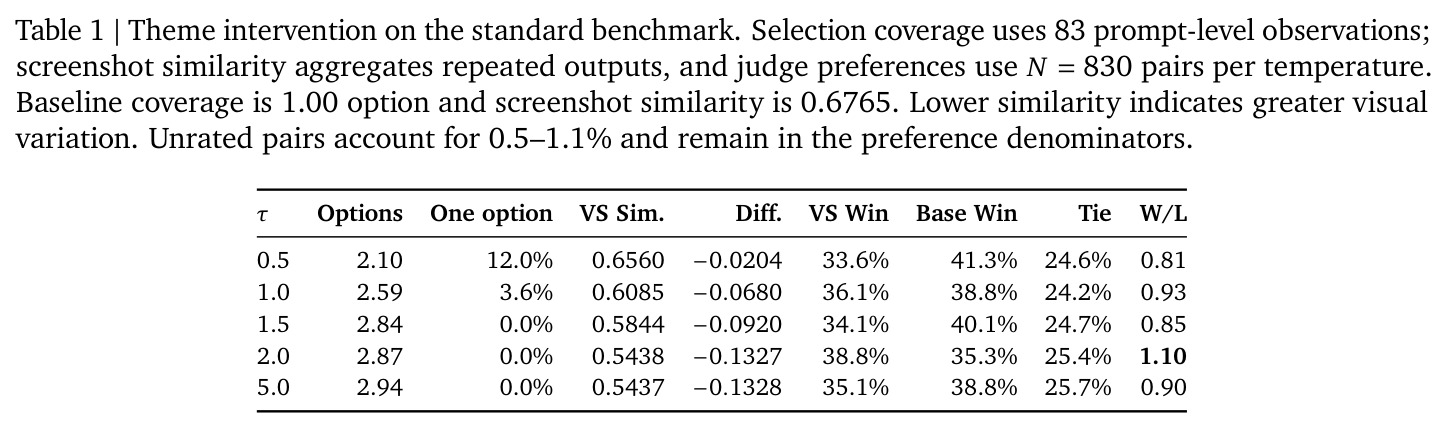
相对已有工作的三点新颖性:其一,把 VS 从「文本响应多样性工具」改造成「结构化设计规范提议器」,并以外部温度化选择器替代让模型自己输出分布,使探索强度成为一个运行时旋钮——这不同于分布提示(多响应联合枚举)也不同于训练时多样性偏好目标(需要重训且改变质量权衡)。其二,规范级条件化把互锁的设计属性作为整体提交,避免 token 级变化产生不连贯的混搭;这继承了 UI 生成系统中「中间表示+反馈」的价值,但服务于探索而非保真。其三,评估设计本身的方法学贡献:把选择覆盖、截图/DOM 结构相似度、LLM 评审偏好、线上行为四类度量分开报告,明确承认覆盖与偏好不单调联动(如 $\tau=2.0$ 与 $5.0$ 截图相似度几乎相同但评审胜负比从 1.10 反转为 0.90),并主动报告了不显著的导出提升,这与常见的选择性汇报形成对照。
实验结果
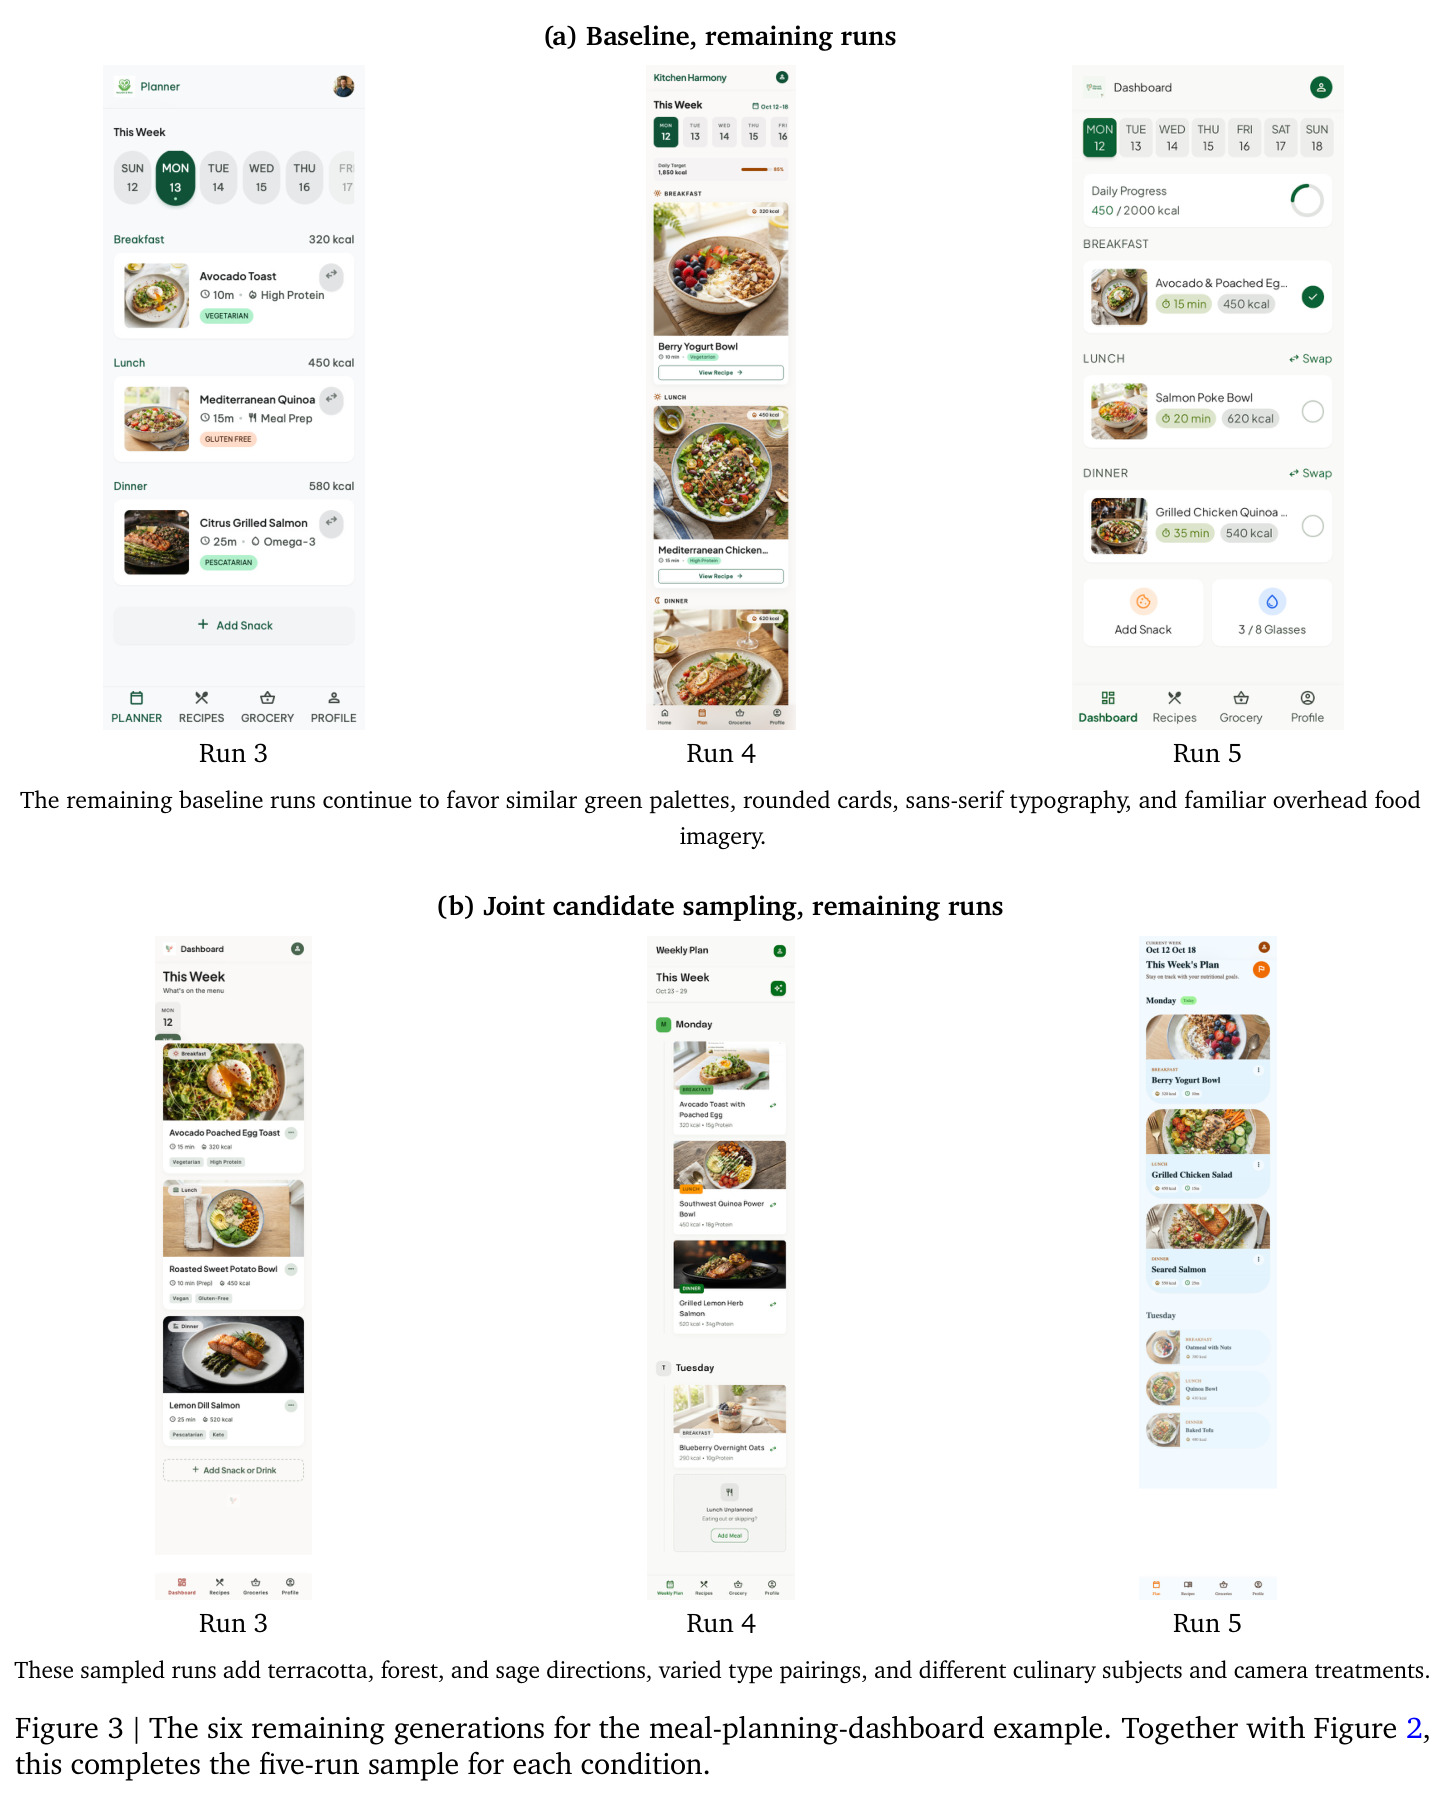
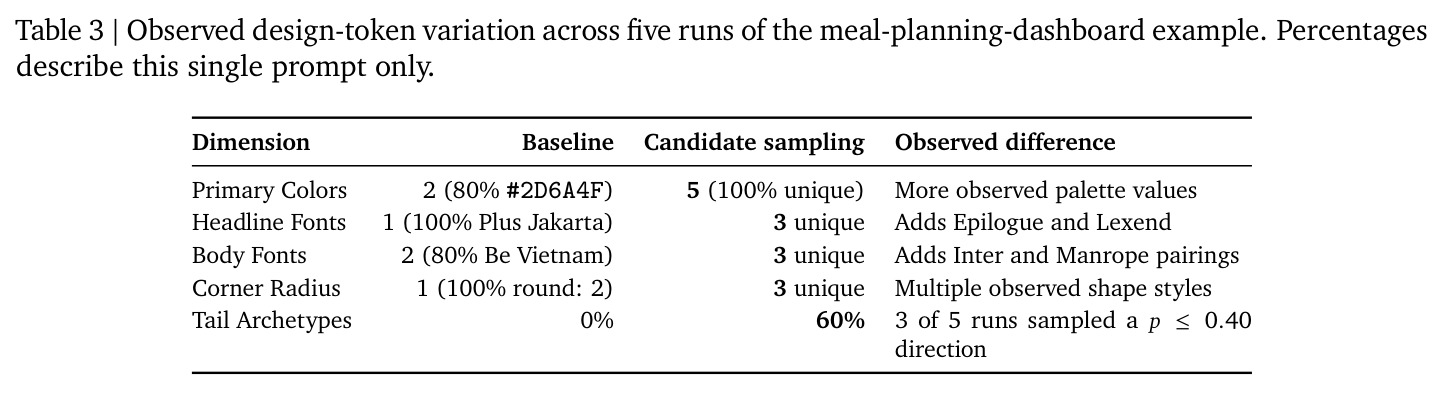
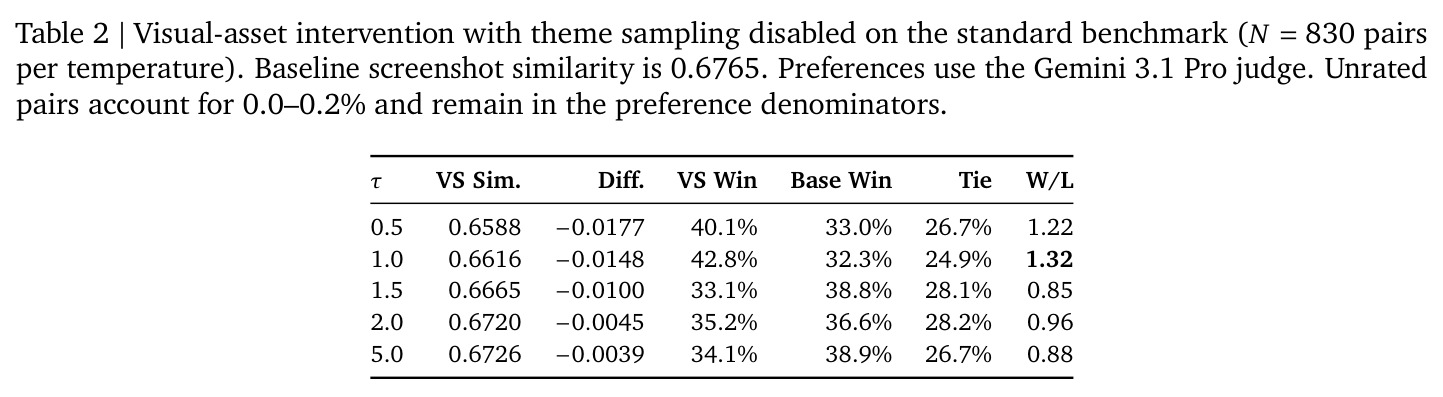
主题干预(标准基准,830 对/温度,覆盖度 83 个 prompt 级观测):基线五次重复只出现 1.00 个主题选项,候选选择把它提升到 2.10–2.94,$\tau\ge1.5$ 时所有 prompt 都出现多于一个选项;截图嵌入相似度从基线 0.6765 降到 $\tau=2.0$ 的 0.5438(差异 −0.1327),渲染变化显著变宽。评审偏好呈非单调:$\tau=2.0$ 最优,胜/负比 1.10(VS 38.8% vs 基线 35.3%),而 $\tau=5.0$ 在相似度几乎不变(0.5437)时反转为 0.90,说明变化幅度与评审质量不单调同步。资产干预(同规模):胜/负比在 $\tau=1.0$ 达到 1.32(42.8% vs 32.3%),但整屏相似度仅从 0.6765 微降至 0.6616——评审偏好可以在整屏变化极小的情况下改变。跨套件与视口:复杂资产基准峰值移到 $\tau=1.5$(1.19),桌面端复杂资产在 $\tau=1.0$ 达 2.43(56.7% vs 23.3%),提示最佳设置不跨套件迁移。DOM 相似度:基线 0.8779 vs 干预 0.7935–0.8339,结构有共享模式也有改变。在线 A/B(309,870 任务:对照 155,338 vs 实验 154,532;505,940 屏):60 秒内完成率 49.9%→48.2%(相对 −3.47%,CI [−5.83%,−1.11%]),任务成功率 97.95%→97.80%(−0.15%,CI [−0.30%,−0.01%]);导出 1.06%→1.15%(+8.23%,CI [−13.03%,+29.48%] 含零,不显著);负反馈事件 73→50(−31.51%,CI [−62.02%,−1.00%]),正负比约 3.8:1→5.7:1;修正交互 38.8%→41.6%(+7.08%,CI [+1.38%,+12.77%],基于 3,624/3,589 个评估对话子集)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 主题选择覆盖(标准基准,5 次重复/83 prompts) | 平均出现主题选项数 | 2.10–2.94(τ=0.5–5.0) | 1.00 | 覆盖最多提升 2.94 倍;τ≥1.5 时无一 prompt 只出一个选项 |
| 主题干预渲染变化(标准基准) | 截图嵌入余弦相似度(越低越多样) | 0.5438(τ=2.0) | 0.6765 | −0.1327,视觉分离显著扩大 |
| 主题干预评审偏好(Gemini 3.1 Pro,N=830 对) | 胜/负比 | 1.10 @τ=2.0(38.8% vs 35.3%) | 1.00(同分布对照) | +10%,但 τ=5.0 反转为 0.90,非单调 |
| 资产干预评审偏好(主题采样关闭,N=830 对) | 胜/负比 | 1.32 @τ=1.0(42.8% vs 32.3%) | 1.00 | +32%,整屏相似度仅 −0.0148(0.6765→0.6616) |
| 线上负反馈(309,870 任务 A/B) | 负反馈事件数 | 50 | 73 | 相对 −31.51%(95% CI [−62.02%, −1.00%]),正负比 3.8:1→5.7:1 |
| 线上修正交互(评估对话子集 3,624/3,589) | 含修正交互的对话比例 | 41.6%(1,492/3,589) | 38.8%(1,407/3,624) | 相对 +7.08%(CI [+1.38%, +12.77%]),解读为更多用户引导但归因未知 |
| 线上运营成本 | 60 秒内完成任务占比 / 任务成功率 | 48.2% / 97.80% | 49.9% / 97.95% | 相对 −3.47%(CI [−5.83%,−1.11%])与 −0.15%(CI [−0.30%,−0.01%]),为可测量的代价 |
| 线上代码导出 | 每生成屏幕的导出率 | 1.15% | 1.06% | 相对 +8.23%,但 CI [−13.03%, +29.48%] 含零,统计不确定 |
局限与改进
作者明确承认的局限:实验比较的是「提议+选择」整合管线与基线,未能把典型性权重的贡献与「多候选提议本身」的贡献分离,也缺少与无权重均匀选择、原始 VS、纯温度对照的比较;归档记录未说明候选集是否在温度与重复间复用,覆盖度统计的「选项身份」是持久规范还是层级标签也不明;离线聚合缺少 prompt 聚类不确定度,LLM judge 有位置/冗长/自家族偏差,导出区间含零,自愿反馈仅 351/335 条评分无法代表全体用户,A/B 快照未记录治疗配置、暴露日期与估计器细节,无法独立重建;专有 prompt、生成物与评审记录均未发布,单一模型与单一 UI 管线限制可移植性。我的补充观察:$K=3$ 固定的 Safe/Premium/Experimental 层级标签可能锚定多样性上限,候选支撑完全由提议阶段决定且稳定性未经检验;产品默认(主题 1.5、资产 2.0)与离线最优(2.0 与 1.0)不一致,实践者难以取舍;修正交互上升既可能是「更多引导」也可能是「更不满意的返工」,论文自己也承认无法归因;全程无盲评人类专业设计师参与,美学方向结论悬空。
独立分析的弱点
弱点一:归因不完整——管线同时引入多候选提议、典型性权重和温度化选择三个变化,无法回答「多样性到底来自哪里」,改进方向是按作者建议补齐 2×2 消融(有无权重 × 多候选/单候选),并用固定种子冻结候选集,使温度只作用于选择环节。弱点二:覆盖度度量的语义模糊——「三个选项出现几个」不等于「三个不同渲染设计」,建议对跨重复的规范做语义去重(如规范嵌入聚类)后再统计真正独特的设计数。弱点三:评审与人类脱节——Gemini 3.1 Pro 的偏好可能与设计师判断背离(作者引用的 Human Creativity Benchmark 正强调美学方向上的专业分歧),建议加入盲评设计师面板并保留评分分布而非多数标签。弱点四:线上修正指标 (+7.08%) 归因缺失,建议对话级分类(审美修正 vs 需求未满足 vs 功能错误)后再解读,否则「负反馈下降+修正上升」可能同源于输出更跳、需要更多来回。弱点五:运营成本非零(60 秒完成率相对 −3.47%),提议 pre-pass 的额外延迟未单独拆分,建议报告每阶段延迟并考虑缓存提议结果。弱点六:候选稳定性——重复 pre-pass 与同义改写下候选支撑是否一致未验证,低典型性候选可能被系统性遗漏,建议做提议分布的稳定性审计。
未来方向
作者提出的方向:确认性研究应冻结 prompt 清单、候选集、模型版本、种子、渲染器与排除规则,纳入均匀选择、无权重启发、源忠实 VS 与 token 温度等对照,保留无效与未评分样本于分母并报告 prompt 聚类不确定度;按 Human Creativity Benchmark 把符合性与执行和美学方向分开,引入盲评专业设计师并保留其分歧;补充浏览器端任务测试与无障碍检查;跨模型家族、prompt 领域、语言与无障碍受限任务复现。基于本文成果可延伸的:把候选 K、层级词表与选择温度做成随用户反馈在线自适应的策略(论文只测了固定策略);用校准后的分数(而非原始自评分)驱动选择;把同一「规范提议-选择-条件生成」模式迁移到其他纠缠生成任务(文档版式、幻灯片、游戏关卡、营销素材),探索规范接口的通用性;在候选阶段引入显式品牌/无障碍/隐私约束作为硬过滤;以及研究探索广度与用户工作阶段(头脑风暴 vs 收尾交付)的匹配策略。
复现评估
复现难度:中等偏高,且完整复现不可能。论文未开源任何代码、prompt 集(83 条标准 + 85 条复杂基准均为专有)、生成物、评审记录(AutoRater)、渲染器状态与可执行分析,A/B 快照的估计器与治疗配置也未文档化,线上部分对外部研究者完全不可复现。离线部分理论上可重建:需要 Gemini 3 Flash API(提议+生成)、Nano Banana 2(页内图像)与 Gemini 3.1 Pro(评审),按第 2 节公式实现归一化与 $q_k(\tau)=\hat{p}_k^{1/\tau}/\sum_j\hat{p}_j^{1/\tau}$ 采样即可;主要成本在自建可比拟的 prompt 套件与多 rubric 评审器、每温度 830+425 对的生成与评审调用量,以及截图嵌入相似度管线;论文也提醒归档记录无法确认候选集跨温度复用,独立复现应固定种子。总体判断:架构思想可以借鉴复用,但论文报告的数字本身应视为内部报告的描述性结果而非可验证基准。
论文图表