Lightning Weave:通过能力组合提升推理模型的精度-效率前沿 Lightning Weave: Improving the Accuracy-Efficiency Frontier of Reasoning Models through Capability Composition
将精度与效率专精模型的策略偏移离线组合进单个学生模型,同时提升准确率并减少推理token
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
一种蒸馏范式:学生在自己生成的轨迹上接受教师监督。与离线蒸馏(学生在固定数据集上模仿教师输出)不同,OPD 让教师对学生的每个生成 token 状态给出完整的 token 概率分布,学生最小化到该分布的 KL 散度 $\mathcal{L}=\mathbb{E}_{x,\hat{y}\sim\pi_\theta}\sum_t D_{KL}(\pi_\theta(\cdot|s_t)\|\pi_T(\cdot|s_t))$。训练状态始终落在学生自身分布上,避免了离线蒸馏的分布偏移与曝光偏差,且监督稠密(每个 token 都有信号而非仅序列级奖励)。
Lightning Weave 的训练目标本质上就是在缓存的学生状态上向构造出的目标分布做 KL 蒸馏,OPD 是理解其损失函数(式 6 与式 11)的直接基础。
DOPD 与策略偏移(anchor pair)
Direct On-Policy Distillation 把'专精模型学到了什么'表示为一对检查点 $(\pi^- , \pi^+)$(pre-anchor 到 post-anchor)的对数概率比:序列级偏移 $\Delta(\hat{y}|x)=\log\frac{\pi^+(\hat{y}|x)}{\pi^-(\hat{y}|x)}=\sum_t r_\Delta(a_t|s_t)$,其中 token 级偏移 $r_\Delta(a|s)=\log\frac{\pi^+(a|s)}{\pi^-(a|s)}$ 充当密集奖励。它编码的是后训练引入的行为'变化'而非模型端点,因此天然剥离两个模型共享的通用能力。
本文对'能力'的定义就是这种偏移,anchor pair 是整个方法的基本输入单元;读懂偏移表示才能理解为什么能力组合可以跨模型族、跨分词器进行。
KL 散度与指数倾斜分布
KL 散度 $D_{KL}(p\|q)=\sum_a p(a)\log\frac{p(a)}{q(a)}$ 度量分布差异,非对称且非负,常作蒸馏损失。指数倾斜指用 $\exp(r(a)/\alpha)$ 乘以基础分布再归一化:$q(a)\propto\pi_b(a)\exp(r(a)/\alpha)$。由 Gibbs 不等式可证它恰是'最大化期望奖励 $r$ 减去 $\alpha$ 倍到 $\pi_b$ 的 KL'这一凹目标的唯一解,$\alpha$ 越小倾斜越强、目标离行为策略越远。
Tilted-Target DOPD 的单 anchor 目标 $q$ 与多 anchor 组合目标 $q_w$ 都是倾斜分布;论文的全部理论性质(目标等价性、唯一性、不动点)都由这一变分恒等式(Lemma A.1)推出。
精度-效率前沿与 AES 指标
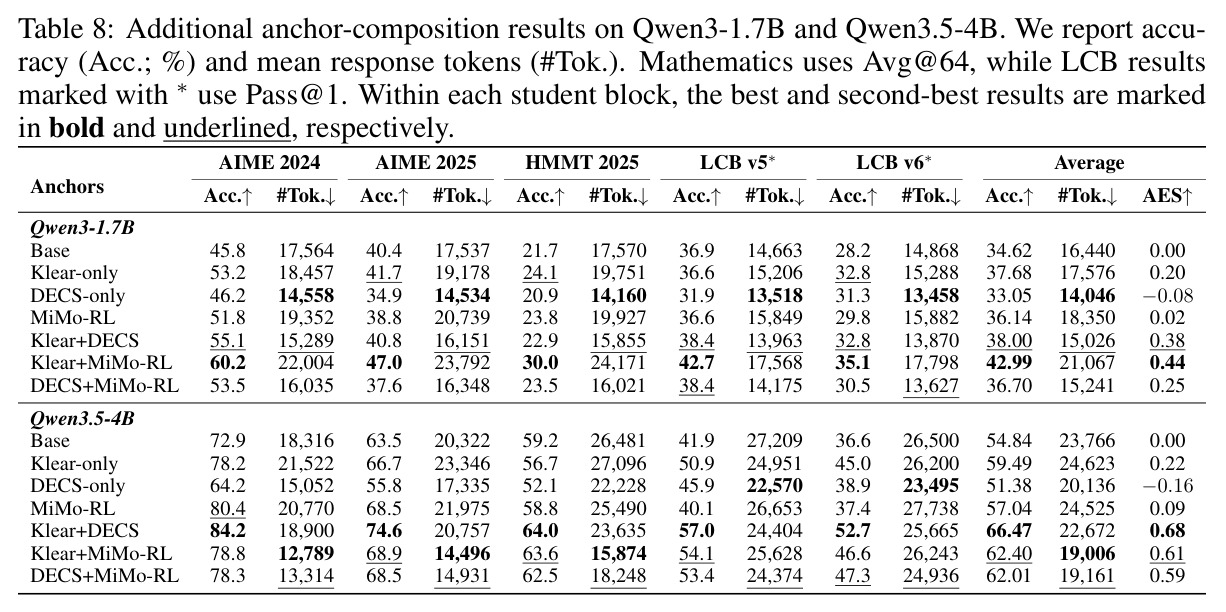
高效推理的目标不是单点指标而是前沿:给定推理预算下能取得的最高准确率。AES(Accuracy–Efficiency Score)将其压缩为一个标量:对每个基准计算 token 相对减少量 $\Delta_{L,k}=(L_{base,k}-L_k)/L_{base,k}$ 与准确率相对变化 $\Delta_{A,k}=(A_k-A_{base,k})/A_{base,k}$,精度不降时 $AES=\Delta_L+3|\Delta_A|$,精度下降时 $AES=\Delta_L-5|\Delta_A|$(对精度损失重罚),再对 5 个基准取平均。
论文用 AES 判断一个方法是否真正'同时'改善了精度与效率:DECS-only 等 token 很省但掉精度的方法 AES 为负,Lightning Weave 在全部五个骨干上取得最高 AES。
离线缓存蒸馏(offline score caching)
在线蒸馏需要在训练全程同时服务教师(本文中是最多 $2K$ 个 anchor 模型)来对学生的最新轨迹打分,算力开销大。离线方案(如 Lightning OPD)先用初始学生一次性采样轨迹并缓存各 anchor 的逐 token 评分,之后训练阶段只需学生模型参与。代价是缓存状态来自行为策略分布,学生偏离后评分即过时(off-policy)。
Lightning Weave 的高效正来自'每个 anchor 对只打分一次'的离线设计;理解朴素缓存目标为何丢失不动点、Tilted-Target 如何修复它,是把握本文核心理论贡献的关键。
参数空间模型合并(model merging / interpolation)
直接对多个模型的权重做插值或任务算术运算,如 $\theta=\lambda\theta_1+(1-\lambda)\theta_2$(论文基线 MI 取 $\lambda=0.8$)。它要求被合并模型同源、参数空间对齐,否则插值会破坏模型功能,因此难以跨模型族或跨分词器使用。
模型合并是'能力整合'的另一条主流路线,也是本文的重要基线;对比状态级策略偏移组合与参数级合并,才能理解 Lightning Weave 解耦参数兼容性这一卖点的价值。
研究动机
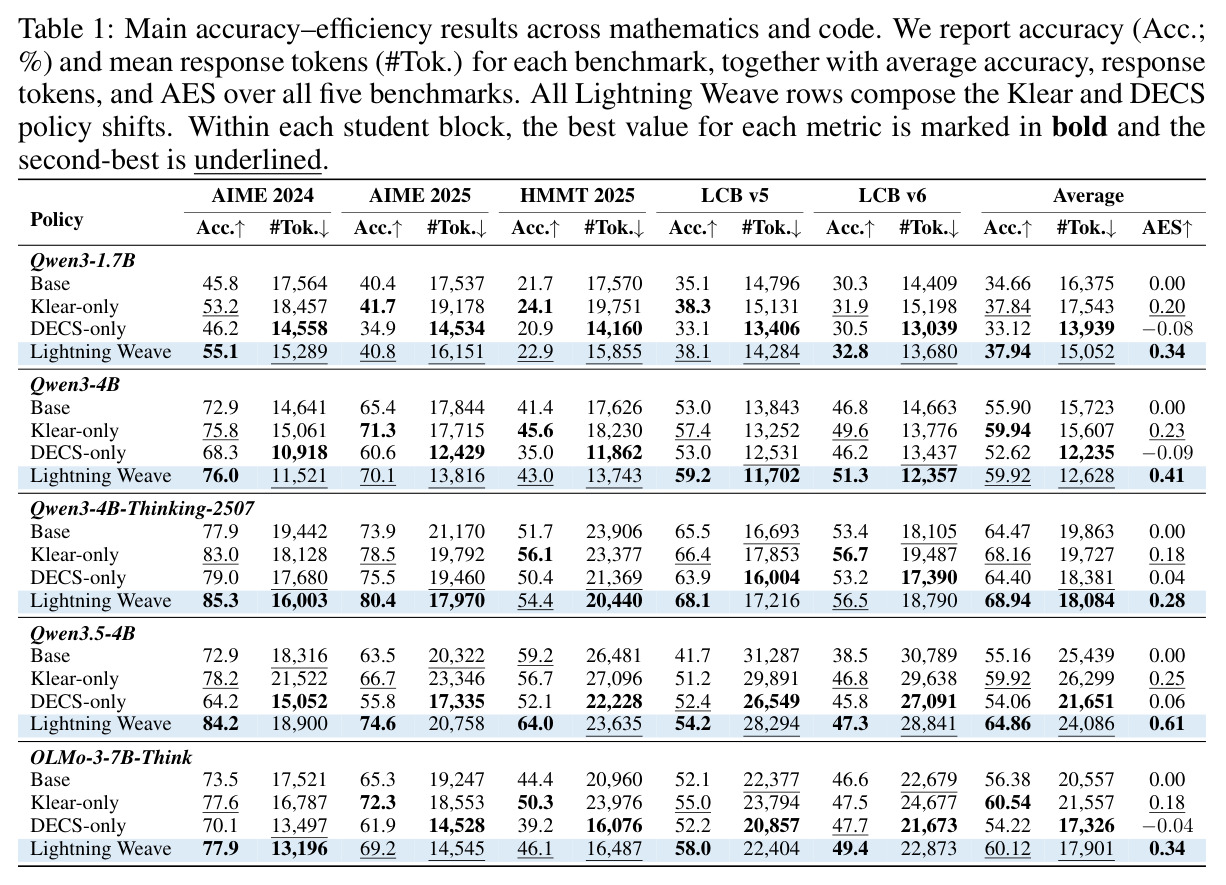
大型推理模型在复杂数学与代码任务上表现强劲,但依赖冗长的思维链:在本文评测协议下,Qwen3.5-4B 在 HMMT 2025 上平均每题生成 26,481 个响应 token,在 LiveCodeBench v5 上高达 31,287 个,直接推高推理延迟与成本。高效推理的核心难点在于精度与效率两个目标偏好不同的推理行为:激进缩短思维链会砍掉有益探索、损害准确率。现有专精模型恰好呈现这种割裂——精度导向的 Klear 在提升准确率的同时让响应变长(Qwen3-1.7B 的平均响应 token 从 16,375 增至 17,543);效率导向的 DECS 虽把 token 压到 13,939,却使 Qwen3-4B 的平均准确率从 55.90% 跌至 52.62%,AES 为 −0.09。也就是说,同时改善精度与效率这一高效推理的核心诉求,与单独后训练得到的单点能力之间存在结构性矛盾。
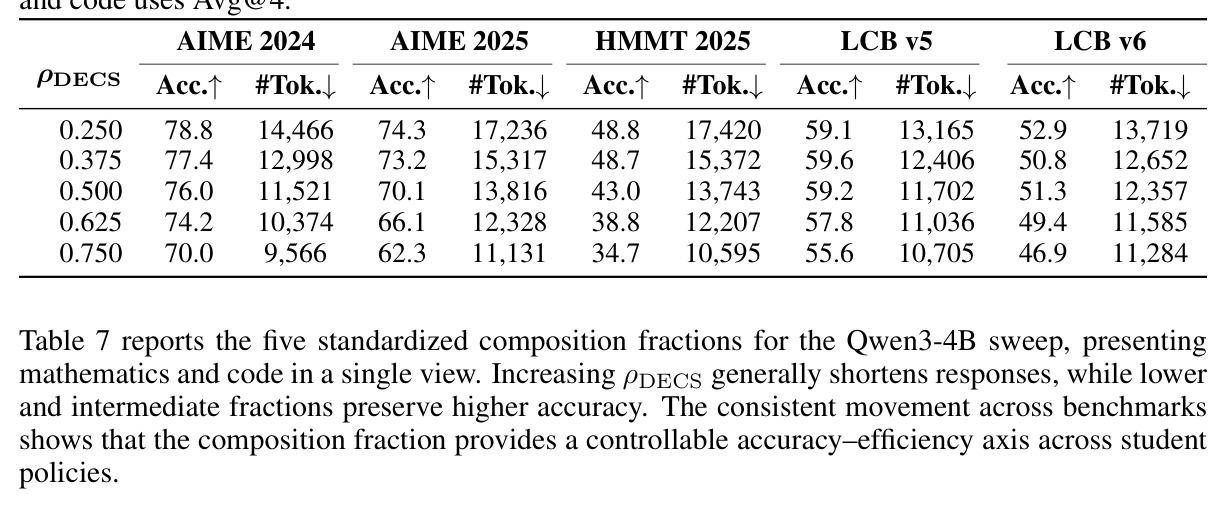
本文的目标是本文试图回答一个中心问题:通过独立后训练学到的能力,能否被提取并组合到一个学生模型中,从而同时提升其准确率与推理效率?具体做法是从头训练改为复用现成的专精模型:精度导向的 anchor 对 Qwen3-8B-Base→Klear-Reasoner-8B,与效率导向的 anchor 对 DeepSeek-R1-Distill-Qwen-1.5B→DECS-1.5B。论文希望把二者各自的行为变化以策略蒸馏的方式迁移给任意学生(如 Qwen3-4B、Qwen3.5-4B、OLMo-3-7B-Think),使学生在 AIME 2024/2025、HMMT 2025、LiveCodeBench v5/v6 五个基准上平均准确率显著提升、平均响应 token 同时下降;并通过调节两个能力的相对强度 $w$,得到一族工作点,勾勒出可控的精度-效率 Pareto 前沿。
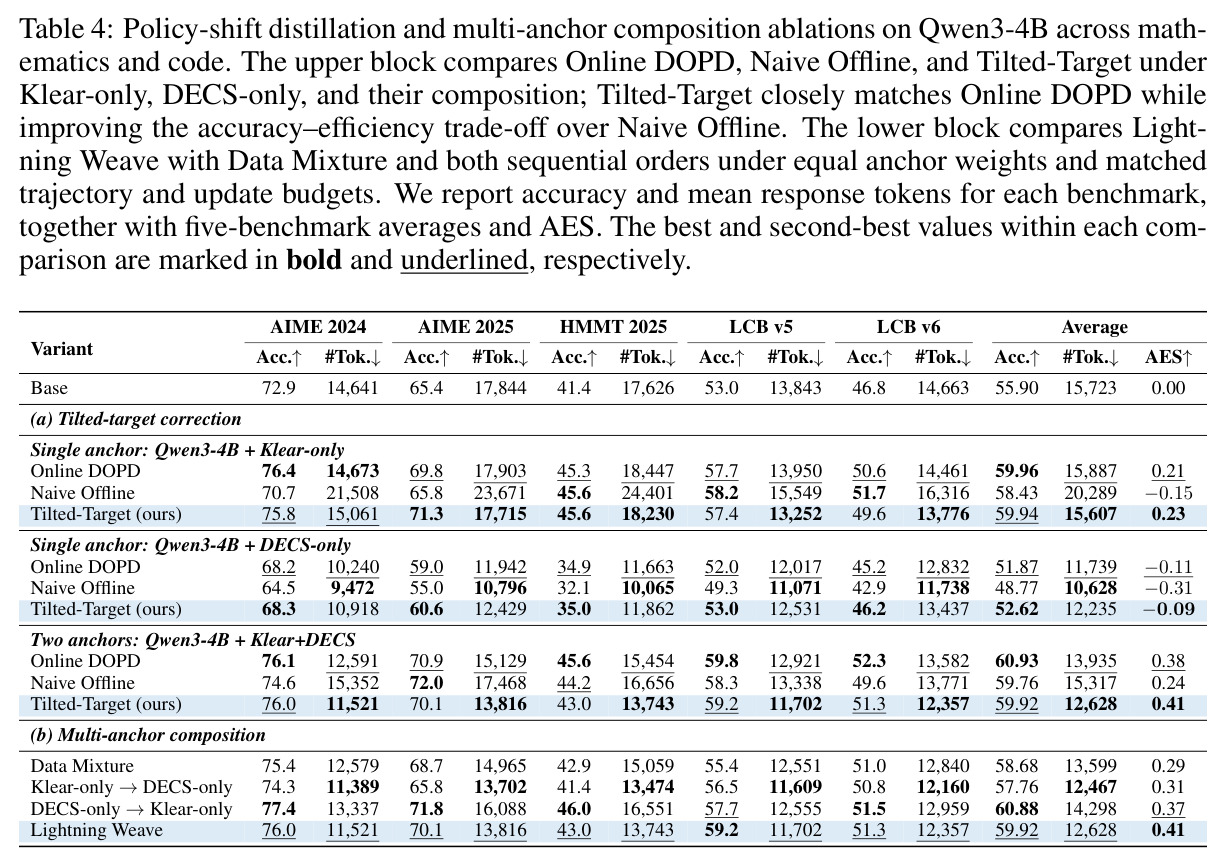
与已有工作不同的是,已有能力整合路线各有局限:参数空间模型合并(如模型插值 MI)要求被合并模型参数兼容、通常同源同构;多教师在线策略蒸馏需要在训练全程同时服务多个教师,代价随 anchor 数量增长;数据混合与顺序蒸馏则分别受制于混合稀释与强烈的顺序敏感性——Table 4 显示 Klear→DECS 与 DECS→Klear 两种顺序的 AES 分别为 0.31 和 0.37,结果由最后施加的 anchor 主导。本文的独特切入是把'能力'重新定义为预训练检查点到后训练检查点的 token 级对数概率比,即策略偏移 $r(a|s)=\log\frac{\pi_+(a|s)}{\pi_-(a|s)}$:它只编码后训练引入的行为变化、天然剥离共享的基础能力;由于是作用在分布上的标量函数而非参数,它可以在共享学生 token 状态上对齐、加权组合,且与参数兼容性完全解耦——这使跨模型族、跨规模、跨分词器的能力迁移成为可能。
核心方法
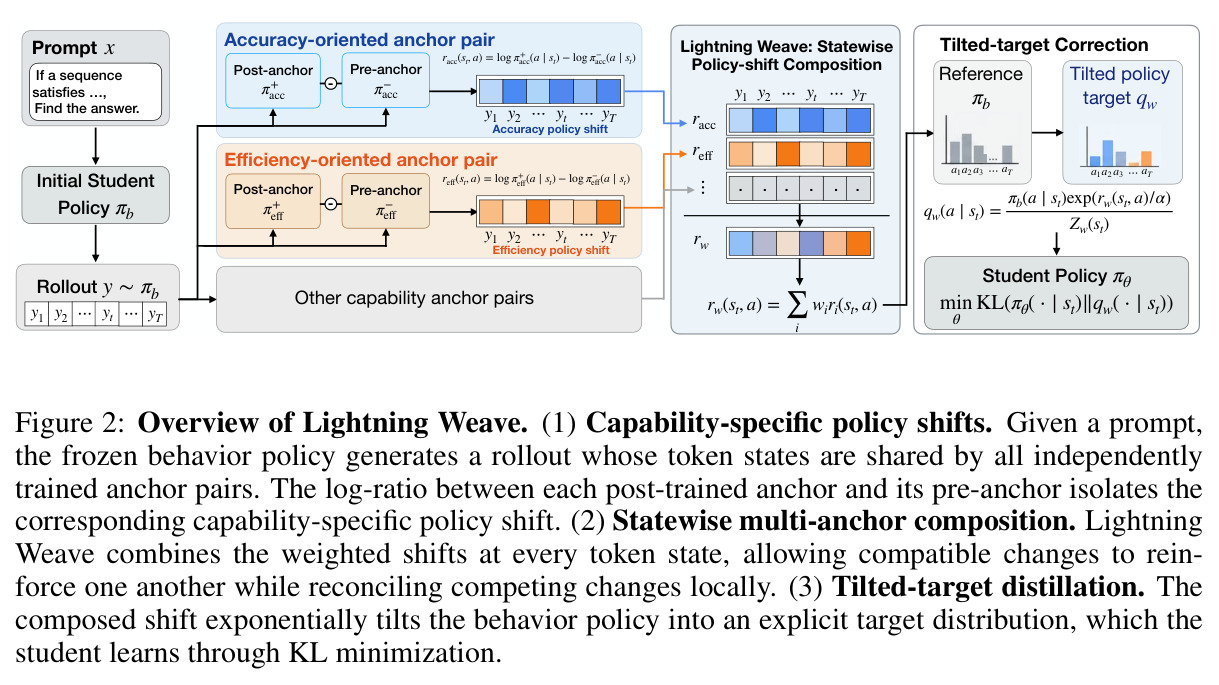
直觉上,一个专精模型'学到了什么',等价于它相对训练前检查点的行为变化,而不是它的绝对策略。Lightning Weave 把这一变化表示为 anchor pair($\pi^-$→$\pi^+$)的 token 级 log-ratio $r_i(a|s)$。整个流程是离线三段式:(1) 行为策略 $\pi_b$(初始学生)对每个 prompt 采样 4 条响应并缓存全部 token 状态;(2) 各 anchor 对在同一批缓存状态上各打分一次,得到各自的能力偏移 $r_i$;(3) 把加权组合偏移 $r_w=\sum_i w_i r_i$ 指数倾斜到冻结的行为策略上,构造显式目标分布 $q_w(a|s)\propto\pi_b(a|s)\exp(r_w(a|s)/\alpha)$,学生通过最小化到 $q_w$ 的 KL 散度学习。此后所有优化只需学生模型本身参与,不再需要在线服务任何 anchor——这使能力组合变成低成本、可重复的离线训练,也为扫权重画前沿提供了便利(缓存可跨配置复用)。
核心创新有两点。其一是'先组合偏移、再构造目标':与 sample mixing(每条样本仅由一个 anchor 监督)或教师分布的算术混合不同,本文在 log 空间先对偏移加权求和,所得目标等价于围绕同一学生先验的相对策略变化乘积 $q_w\propto\pi_b\prod_i(\pi_+^i/\pi_-^i)^{w_i/\alpha}$(式 10):支持同一动作的 anchor 相互指数加强,冲突的变化在每个 token 状态上按权重局部化解。其二是 Tilted-Target DOPD:直接在缓存轨迹上复用 DOPD 的采样 token 目标不具备不动点——学生偏离行为策略后,缓存动作估计的正则项不再等于真实 KL,学生到达预期解后梯度仍不为零(附录反例中残余梯度 $\log 3-20/9\neq 0$),训练会继续推学生偏离目标。Tilted-Target 把缓存偏移变成显式目标 $q$ 并最小化学生到 $q$ 的 KL(式 6),由恒等式 (7) 可证损失与梯度在 $\pi_\theta=q$ 处精确归零,离线训练因此稳定收敛到良定义的策略目标。
方法步骤详情
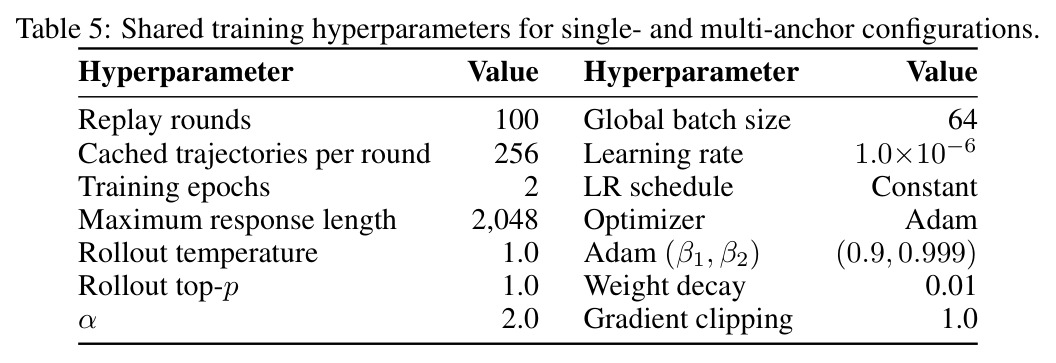
流程分六步。第一步,选定 anchor 对:精度导向为 Qwen3-8B-Base→Klear-Reasoner-8B,效率导向为 R1-Distill-Qwen-1.5B→DECS-1.5B,扩展实验加入 MiMo-7B-Base→MiMo-7B-RL-0530。第二步,行为策略采样缓存:对数学(Skywork-OR1-RL-Data)与代码(KlearReasoner-CodeSub-15K)各 3,200 个 prompt,每条在温度 1、上限 2,048 token 下生成 4 条响应,共 12,800 条轨迹。第三步,anchor 打分:各 anchor 对在相同缓存状态上计算 log-ratio $r_i$;跨分词器时按字节级字符串投影对齐,仅保留候选仍为 anchor 原子 token 的位置(93.8–100% 通过)。第四步,状态级组合:$r_w=\sum_i w_i r_i$,等权 $w_i=1/K$。第五步,构造有限候选目标:保留 16 个缓存候选行为概率,其余词表质量归并为 'other' 结果(残余偏移置零),按式 (31) 指数倾斜。第六步,学生训练:用平方 log 残差损失(式 32)拟合,Adam、batch 64、学习率 $10^{-6}$、$\alpha=2.0$、回放 2 epoch 共 400 次更新;调节 $\rho_{DECS}\in[0.25,0.75]$ 即得不同工作点。
技术新颖性
新颖性体现在三个层面。能力表示上,用前后检查点的 log 概率比定义能力,迁移的是'变化量'而非'端点':天然剥离两模型共享的通用知识,也不需要参数兼容——学生横跨 Qwen3-1.7B/4B/4B-Thinking、Qwen3.5-4B 与 OLMo-3-7B-Think,anchor 来自 8B 与 1.5B 模型,甚至跨分词器(字节级对齐),这是参数合并路线做不到的。组合机制上,乘积形式的目标(式 25)配合 Corollary A.9 的置换不变性与状态基线不变性,说明组合在数学上是良构的;成对赔率分解(式 28)精确刻画了 anchor 间的一致(指数加强)与冲突(加权抵消)如何作用于任意两个动作的赔率比。训练机制上,Tilted-Target 为离线缓存蒸馏补上显式不动点与目标等价性证明(Lemma A.1、Proposition A.2、Corollary A.3/A.4),修复了 Lightning OPD 式缓存方案的理论缺口;实现的有限候选代理损失(式 32)在候选+残余空间仍保持零损失、零梯度不动点。'偏移组合+离线缓存+单学生训练'的结合在多教师蒸馏文献中没有先例。
实验结果
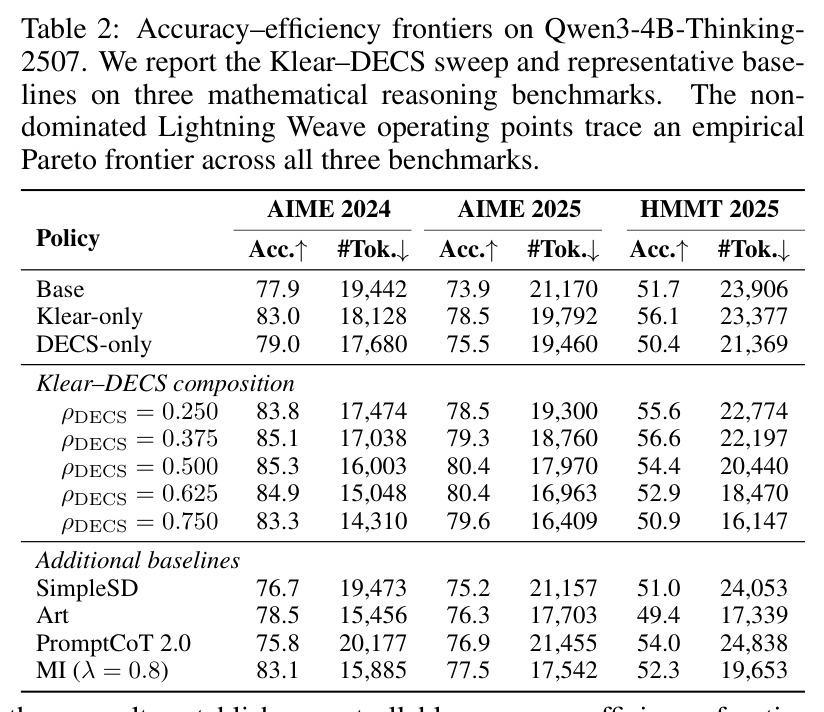
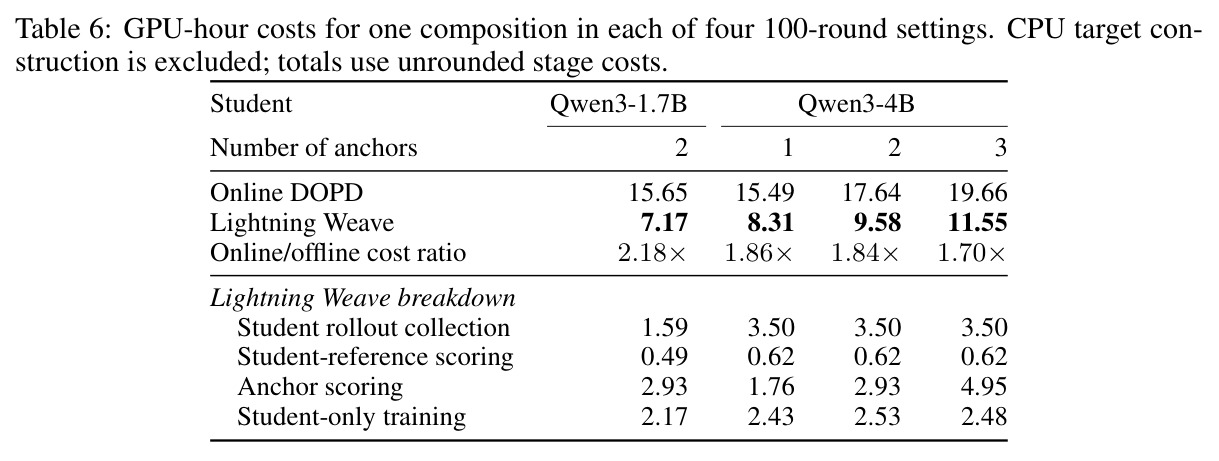
Table 1 在 5 个学生 × 5 个基准上系统验证。Qwen3-4B:平均准确率 55.90%→59.92%(+4.02 点),平均 token −19.7%,AES 0.41 全场最高(Klear-only 0.23、DECS-only −0.09)。增益最大的是 Qwen3.5-4B:平均准确率 55.16%→64.86%(+9.70 点)、token −5.3%,其中 HMMT 2025 59.2%→64.0%(token −10.7%),LCB v5 41.7%→54.2%(+12.5 点)。Qwen3-4B-Thinking-2507 平均 +4.5 点、token −9.0%;OLMo-3-7B-Think +3.74 点、−12.9%——五个骨干全部取得最高 AES。Table 2 前沿实验:$\rho_{DECS}=0.625$ 在 AIME 2024 达 84.9%@15,048 token,超过全部外部基线(SimpleSD 76.7%、Art 78.5%、PromptCoT 2.0 75.8%、模型插值 83.1%);图 3(c) 显示各 token 预算下均领先,紧预算优势最大。Table 3:Klear+MiMo-RL 平均精度最高(64.38%)但 token 增至 18,577,三 anchor 组合取得最高 AES 0.42。Table 4 消融:Tilted-Target 与 Online DOPD 相当,比 Naive Offline 高 1.51/3.85 点(Klear/DECS),双 anchor 下 token 再省 17.6%;优于 Data Mixture 与顺序敏感的顺序组合。Table 6:单次组合 GPU 时降 1.70–2.18×,五种组合摊销省 4.58×。图 4、5 的案例研究定性印证组合同时保留正确行为与短响应。
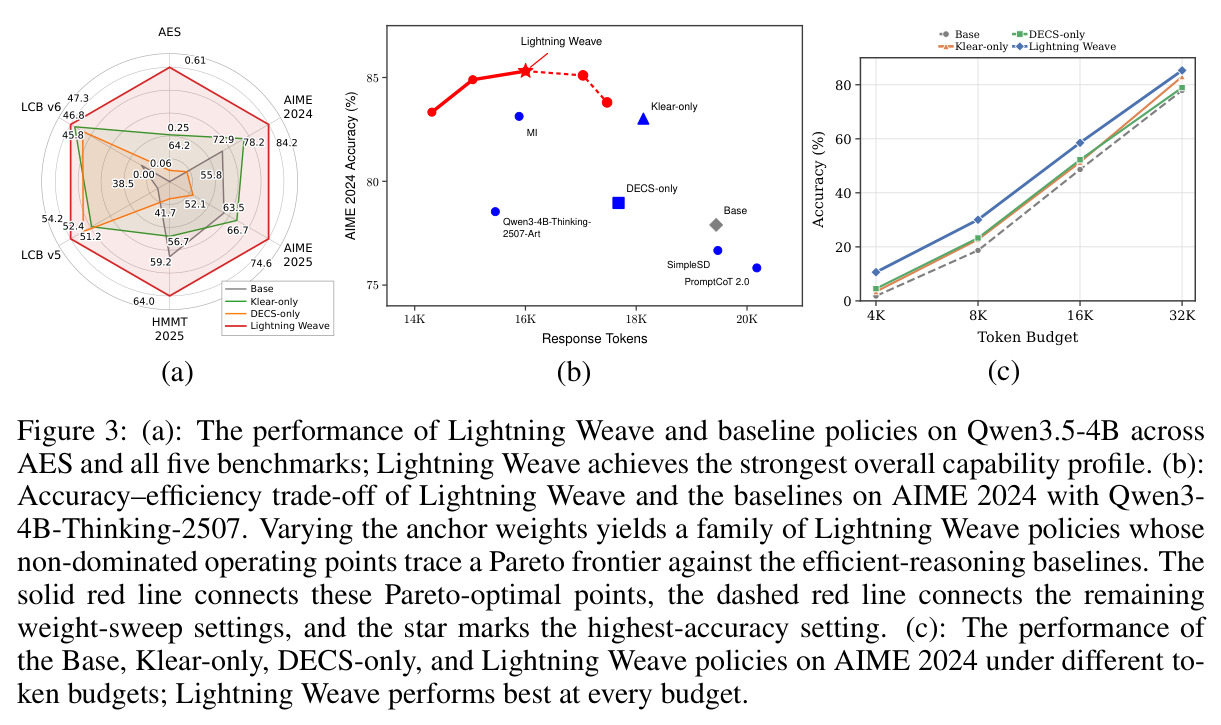
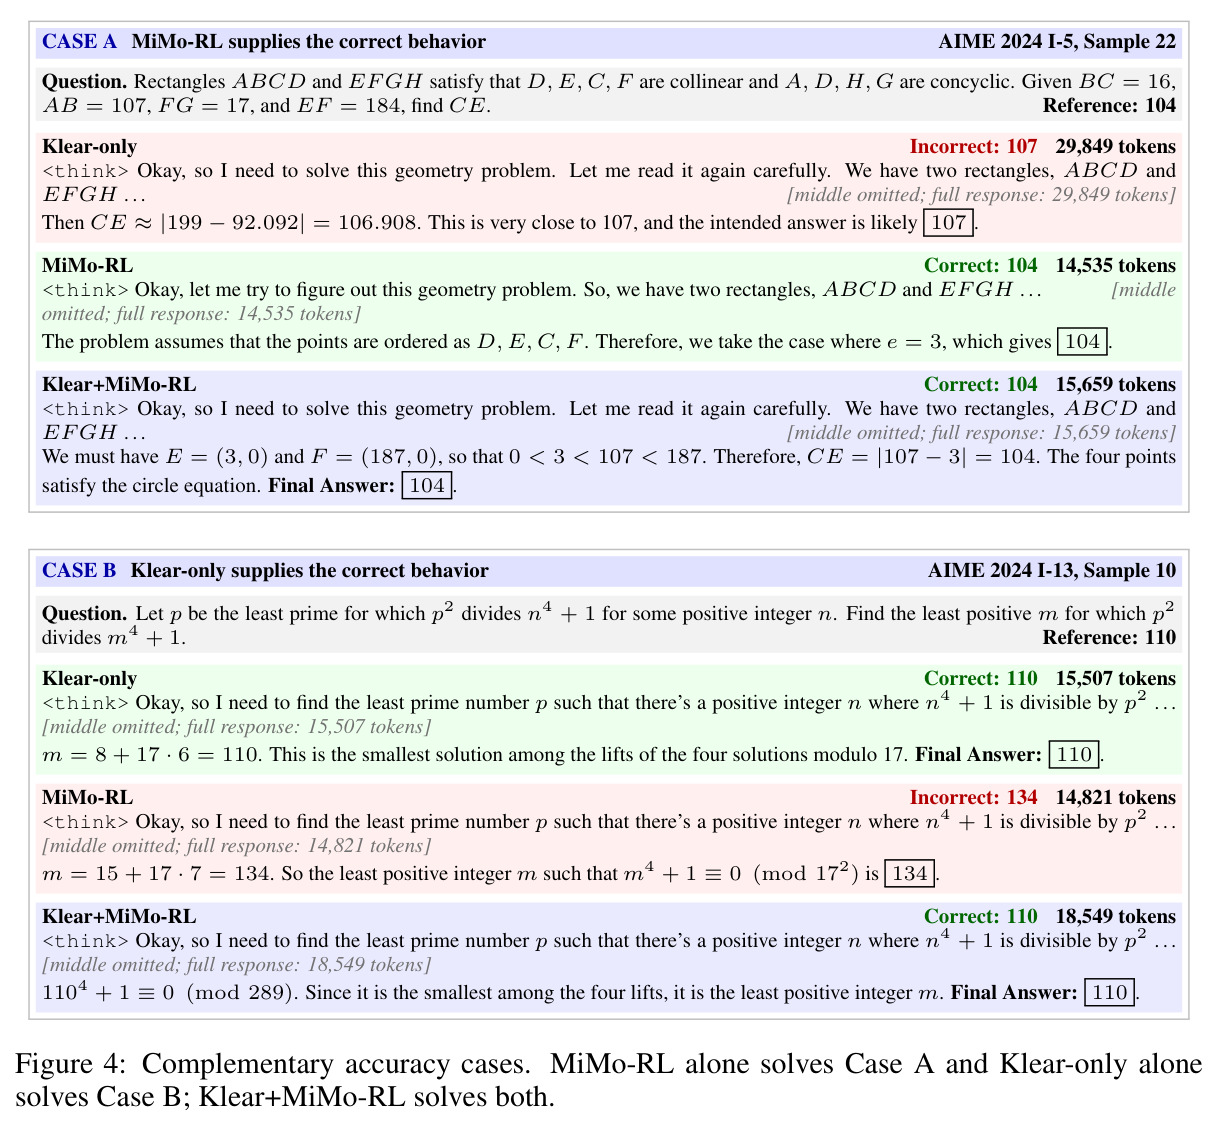
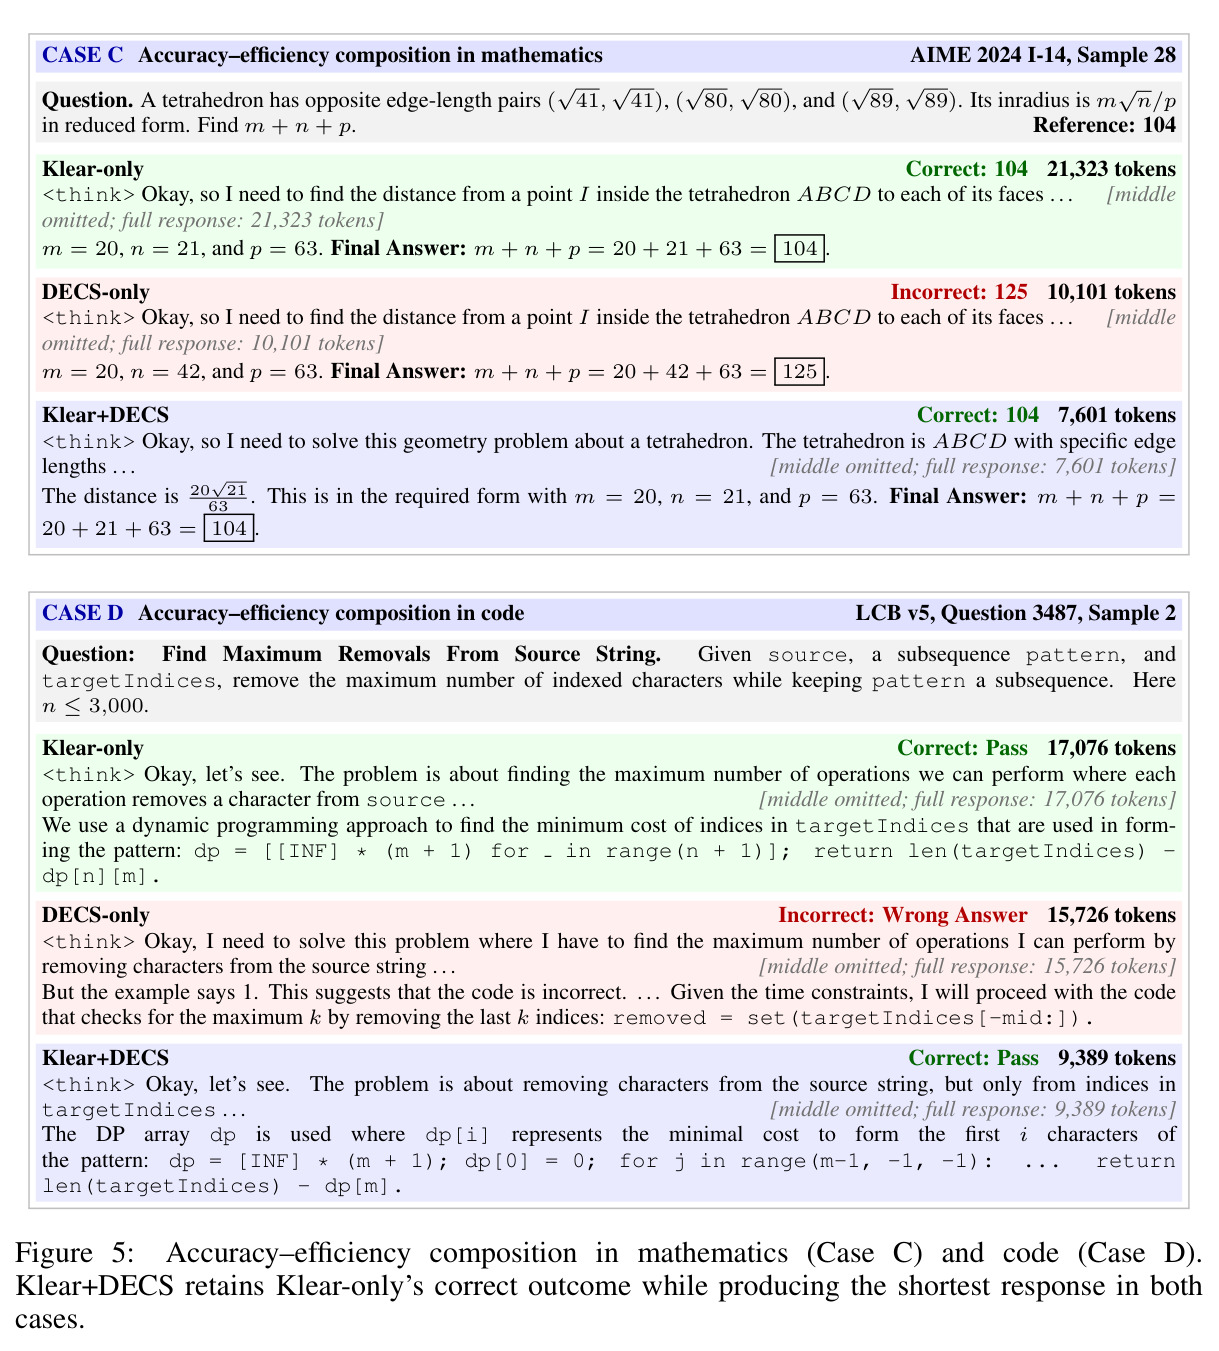
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学+代码五基准平均(Qwen3-4B) | 平均准确率 / 平均响应token / AES | 59.92% / 12,628 / 0.41 | Base 55.90% / 15,723 / 0.00 | +4.02 点准确率,token −19.7% |
| 数学+代码五基准平均(Qwen3.5-4B) | 平均准确率 / 平均响应token / AES | 64.86% / 24,086 / 0.61 | Base 55.16% / 25,439 / 0.00 | +9.70 点准确率,token −5.3% |
| HMMT 2025(Qwen3.5-4B) | 准确率 (Avg@64) | 64.0% @ 23,635 token | Base 59.2% @ 26,481 token | +4.8 点且 token −10.7% |
| LiveCodeBench v5(Qwen3.5-4B) | 准确率 (Avg@4) | 54.2% @ 28,294 token | Base 41.7% @ 31,287 token | +12.5 点且 token −9.6% |
| AIME 2024(Qwen3-4B) | 准确率 (Avg@64) | 76.0% @ 11,521 token | Base 72.9% @ 14,641 token | +3.1 点且 token −21.3% |
| AIME 2024(Qwen3-4B-Thinking-2507,ρ_DECS=0.625) | 准确率 (Avg@64) | 84.9% @ 15,048 token | 最佳外部基线 MI(λ=0.8) 83.1% @ 15,885 token | +1.8 点且 token 更少,超过全部外部基线 |
| 训练成本(Qwen3-4B 双 anchor,8×H100) | 单次组合 GPU 时 | 9.58 GPU 时(离线) | Online DOPD 17.64 GPU 时 | 降低 1.84×;五种组合摊销后节省 4.58× |
| 双 anchor 离线训练稳定性(Qwen3-4B,Klear+DECS) | 平均准确率 / token | Tilted-Target 59.92% / 12,628 | Naive Offline 59.76% / 15,317 | 精度相当但 token 少 17.6%,且无需在线服务 4 个 anchor 模型 |
局限与改进
作者承认三点局限:其一,受算力所限实验均在 10B 以下模型上进行,收益能否迁移到大模型未知;其二,方法假设能同时拿到表现出目标能力的后训练模型及其对应 pre-anchor,成对检查点在新任务上未必可得;其三,效率收益仍小于专为高效推理优化的方法(如 Qwen3-4B 上 DECS-only 把 token 压到 10,918,LW 为 11,521,但 DECS 掉精度)。我补充几点观察:权重 $w$ 与 $\alpha$ 需逐点训练扫描才能刻画前沿,实际部署中用户往往只需要某个特定预算的单个点;实现的有限候选目标(top-16 + other)与平方 log 残差损失只是全词表 KL 的代理,作者自己说明它不继承全分布目标等价性(Remark A.11);每个配置仅训练一次、报告最终检查点,缺乏种子间方差与显著性检验;缓存状态来自行为策略分布,学生大幅漂移后的离线近似质量没有理论保证;最后,组合效果依赖 anchor 的质量与任务匹配度——DECS-only 在多个学生上 AES 为负,提示效率能力的迁移本身可能有害,anchor 配对需要谨慎设计。
独立分析的弱点
独立分析以下弱点。第一,对成对检查点的强依赖:闭源模型或无法重放 pre-anchor 的专精模型无法提取偏移。改进方向:用正-负对比模型对近似偏移,或从偏好数据反演等效奖励。第二,可控性以多次训练为代价:每个权重配置都是一次完整训练,扫描 5 个点即 5 次训练。改进:训练以目标 token 预算为条件的权重预测器,或利用不同 $w$ 共享缓存与 anchor 评分的性质做低成本微调。第三,统计严谨性不足:单种子、最终检查点报告,AES 差异(如 0.41 vs 0.38)可能落在噪声内。改进:多种子均值±方差。第四,有限候选近似(top-16 + other)在候选集外偏移非零时有偏。改进:利用 softmax 平移不变性在全词表 logits 上直接加偏移实现精确目标。第五,效率只看 token 数这一粗糙代理,未测延迟、吞吐与 KV 内存,token 减少不必然转化为实际加速。改进:引入成本感知偏移与系统级指标。第六,域泛化未验证:数学与代码之外的 agent、长上下文任务待考。第七,方法隐含假设各能力可加且与基础能力正交,对强耦合能力可能相互抵消,需要理论刻画可组合性条件。
未来方向
作者提出的方向:把 Lightning Weave 扩展到 10B 以上更大模型与更多架构;把能力组合推广到新领域,尤其是 agentic 推理与工具使用任务。基于本文成果可自然延伸:其一,组合更多维度的能力——事实性、安全性、多语言、格式遵循等,只要存在对应成对检查点即可纳入统一框架,三 anchor 实验(AES 0.42)已显示加法式扩展的可行性;其二,把组合后的学生作为 RL 的初始化,在组合偏移之上继续强化学习,可能突破单纯蒸馏带来的精度上限;其三,理论侧量化缓存状态分布的 off-policy 偏差,引入重要性加权或周期性重采样,以支持学生更大幅度的策略移动;其四,序列级一致性:当前组合在 token 状态上独立进行,可以研究带序列级约束的组合目标,避免逐 token 局部调和在序列层面产生不连贯的推理风格;其五,自动 anchor 发现:以学生在验证集上的短板为信号,自动搜索与加权 anchor 对,减少人工配对和权重扫描的人工成本;其六,与推理时系统优化(投机解码、KV 压缩、预算控制)正交叠加,进一步压低实际部署成本。
复现评估
复现条件较为友好。论文声明代码将很快发布(写作时点尚未公开)。全部模型均为公开权重:学生(Qwen3 系列、Qwen3.5-4B、OLMo-3-7B-Think)与 anchor(Klear-Reasoner-8B、DECS-1.5B、MiMo-7B-RL-0530)。训练数据公开且规模小:数学与代码各 3,200 prompt,每 prompt 采样 4 条、共 12,800 条缓存轨迹,回放 2 epoch 仅 400 次更新。算力需求低:8×H100 单节点、bf16,单次组合 7–12 GPU 时,比在线 DOPD 省 1.70–2.18×。超参与评估协议完整公开(Table 5 及 B.5–B.8:数学 Avg@64 温度 0.6、代码 Avg@4、AES 公式、提示与答案抽取规则)。难点在工程:跨分词器字节级对齐与有限候选目标构造(B.4)实现较繁琐;评估需对每道数学题采样 64 次、上限 32K token,推理开销不小;官方实现基于 Slime + Megatron-Core/FSDP。总体复现难度:中等——组件齐全、成本低,但需搭建多模型批量打分基础设施。
论文图表
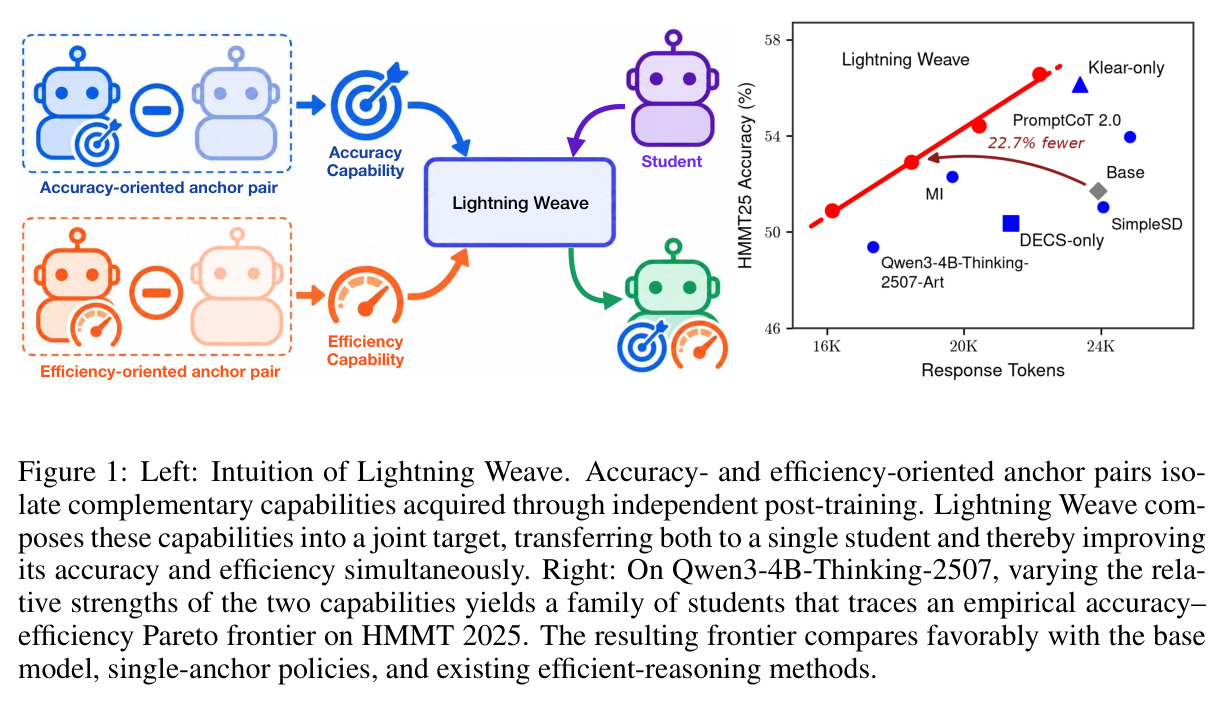
左半部分给出方法直觉:精度导向与效率导向的 anchor 对分别隔离出互补能力,Lightning Weave 把二者组合成一个联合目标迁移给学生,使精度与效率同时提升。右半部分展示在 Qwen3-4B-Thinking-2507 上调节两个 anchor 的相对强度,得到一族学生在 HMMT 2025 上的精度-token 分布,其非支配点勾勒出优于基座模型、单 anchor 策略和现有高效推理方法的 Pareto 前沿。
一图总览论文的问题设定(精度与效率割裂)、核心思路(能力组合)与主结果(可控 Pareto 前沿),是读者建立全局理解的最佳入口。
在 Qwen3-4B 上引入 MiMo-RL 作为第三个(精度导向)anchor,测试单 anchor、双 anchor、三 anchor 的全部组合。Klear+MiMo-RL 平均精度最高(64.38%)但 token 涨到 18,577;DECS+MiMo-RL 精度升且 token 降;三 anchor 组合 Klear+DECS+MiMo-RL 以 62.50%/14,875 取得最高 AES 0.42。
证明框架可扩展到任意数量的 anchor:加入第三个 anchor 会把工作点推向其对应能力方向,说明组合是系统性的而非两模型特调。