跨模态上下文学习的趋同涌现 Convergent Emergence of In-Context Learning Across Modalities
六大模态的自回归模型均自发涌现少样本ICL,五个模态逐任务收益正相关,部分支持趋同涌现假说
前置知识
少样本上下文学习
模型在提示中看到 $n$ 个输入-输出示例 $(I_1,O_1),\dots,(I_n,O_n)$ 后,不更新任何参数,直接对新输入 $I_{n+1}$ 预测 $f(I_{n+1})$ 的能力。关键是模型必须从示例中推断出隐含映射 $f$,而非简单沿用输出分布或复制。本文特指涌现式ICL:模型从未被显式训练过该能力,区别于在少样本提示上元训练的 meta-ICL。
这是全文研究对象,所有实验设计和统计检验都围绕一个判定展开:模型性能提升是否真正来源于对输入-输出配对的利用,而非输出分布适应。
下一词元预测与能力涌现
自回归模型通过在大规模序列数据上学习下一词元映射 $\pi(x_1,\dots,x_t)\to x_{t+1}$ 训练。ICL 等高级能力并未被显式监督,却在此过程中自发出现。由于语言模型是从下一词元预测中免费获得ICL的,一个自然的问题是:这个副产物是否必须局限于人类语言数据。
论文的核心假设正是:如果ICL是下一词元预测在充分丰富的结构化序列上的普遍副产物,它应当在任何模态都涌现,且各模态共享同一机制。
derangement 标签打乱对照
将示例中的输出按置换 $\rho$ 重新配对构造对照提示 $Q_n$,且不是均匀采样,而是从最多256个随机置换中挑选让未变输出数 $\sum_i \mathbb{1}[O_i=O_{\rho(i)}]$ 最小的那个,最大限度破坏配对。它保持输出多重集、输入分布与提示格式不变,只摧毁输入-输出对应关系。clean 与 deranged 的准确率差 $\Delta_n$(式4)因此度量模型对配对本身的利用程度。
这是判定各模态是否出现真ICL的关键对照,也是跨模态相关性分析所用的逐任务效应统计量 $\Delta_n$ 的来源。
输出可辨识性
从函数类 $\mathcal{F}$ 均匀抽取目标函数 $f$ 时,需保证与 $f$ 在 $n$ 个示例上一致的任何对手函数 $g$ 大概率在查询点 $I_{n+1}$ 上也与 $f$ 一致,否则评估会冤枉推理正确的模型。作者用 union bound 推导歧义概率上界:在 $m=2^8=256$ 的输入空间上,$n=8$ 时歧义概率降至 $1\%$ 以下,$n=64$ 时约为 $3\times10^{-5}$。
它保证 clean 条件下答错主要归因于模型未能利用示例,而非任务本身信息不足,使各模态间的阴性结果可信。
柏拉图表示假说
Huh 等人(2024)提出:不同模态的模型随规模增长,其内部表示会趋向对世界的共同柏拉图式刻画。后续工作在表示几何层面(如最近邻结构)提供了部分支持。本文作者将这一问题从表示层面推进到能力层面:如果表示收敛,那么同一抽象任务在各模态的ICL难度排序是否也收敛。
这是论文动机的直接理论来源——趋同涌现假说可视为柏拉图表示假说在任务难度曲线上的对应版本。
条件交换检验与 Holm 校正
原假设是每个任务内 clean/deranged 两个准确率标签可交换:排除零差后,枚举全部 $2^m$ 种符号分配,计算观察到均值差不小于实测值的比例,得到精确单侧 p 值;再对六个模态用 Holm 方法做多重比较校正。跨模态相关则对 15 个模态对各做 $B=10^6$ 次任务标签置换检验。
论文两大结论(ICL跨模态涌现、效应结构趋同)分别建立在这两类检验上,理解它们才能正确解读 Table 3 的 p 值与 Figure 2 的相关矩阵。
研究动机
ICL 自 Brown 等人(2020)在 GPT-3 上被发现以来,几乎所有研究都在人类语言文本训练的模型中进行,这使我们无法区分哪些性质是下一词元预测的普遍现象、哪些只是语言数据的特例。而非语言领域恰恰最需要 ICL:基因组、蛋白质、时间序列等任务难以用自然语言指令表述,少样本示例是除梯度更新外唯一的条件化手段,直接关系到基因组生成、价格预测等高风险应用能否用上提示技术。已有跨模态证据零散且各自为战:Bai 等(2024)在视觉序列预训练模型、Breslow 等(2026)在基因组模型 Evo2、Skild AI(2026)在机器人基础模型中分别报告了 ICL 痕迹,而音乐、棋类、整数序列、时间序列等模态几乎没有正反两方面证据,更没有任何工作把它们放在同一套任务上用同一统计标准比较过。
本文的目标是本文要系统回答两个问题。Q1:在不做任何 ICL 显式训练的前提下,ICL 是否会在语言之外的模态自然涌现——即 ICL 是人类语言的特例,还是任何足够丰富的结构化序列上下一个词元预测的普遍副产物?Q2:若 ICL 在多个模态都涌现,这些能力是各模态特化、互不重叠的(分歧),还是共享同一底层基底(趋同)——具体可操作化为:同一抽象任务在各模态是否一致地更容易或更难从正确的输入-输出配对中获益。为此作者提出趋同涌现假说并设计受控框架检验:若单一机制支撑各模态的 ICL,那么逐任务的 clean-minus-deranged 效应应在不同模态间呈正相关。
与已有工作不同的是,本文的独特切入是共享抽象任务套件加跨模态编码的受控设计。此前跨模态 ICL 证据要么只覆盖单一模态,要么各模态使用自己的原生任务、难度根本无法对齐。本文把同一组 100 个 8-bit 函数 $f:\{0,1\}^8\to\{0,1\}^8$ 通过模态特定编码映射 $\phi_M$ 实例化到六种模态,使配对收益在任务层面严格可比;同时用两个手段排除混淆——每试次随机重采样符号映射(防止模型利用预训练中对 0/1、特定核苷酸的先验),以及 derangement 标签打乱对照(剥离输出分布适应和格式捷径这两类假性ICL)。作者还严格把研究对象限定为涌现式而非 meta-ICL:所有模型都未接受过少样本提示训练,使结论关乎预训练本身的性质。这把表示趋同(柏拉图假说)的研究范式推进到了任务难度曲线趋同的能力层面。
核心方法
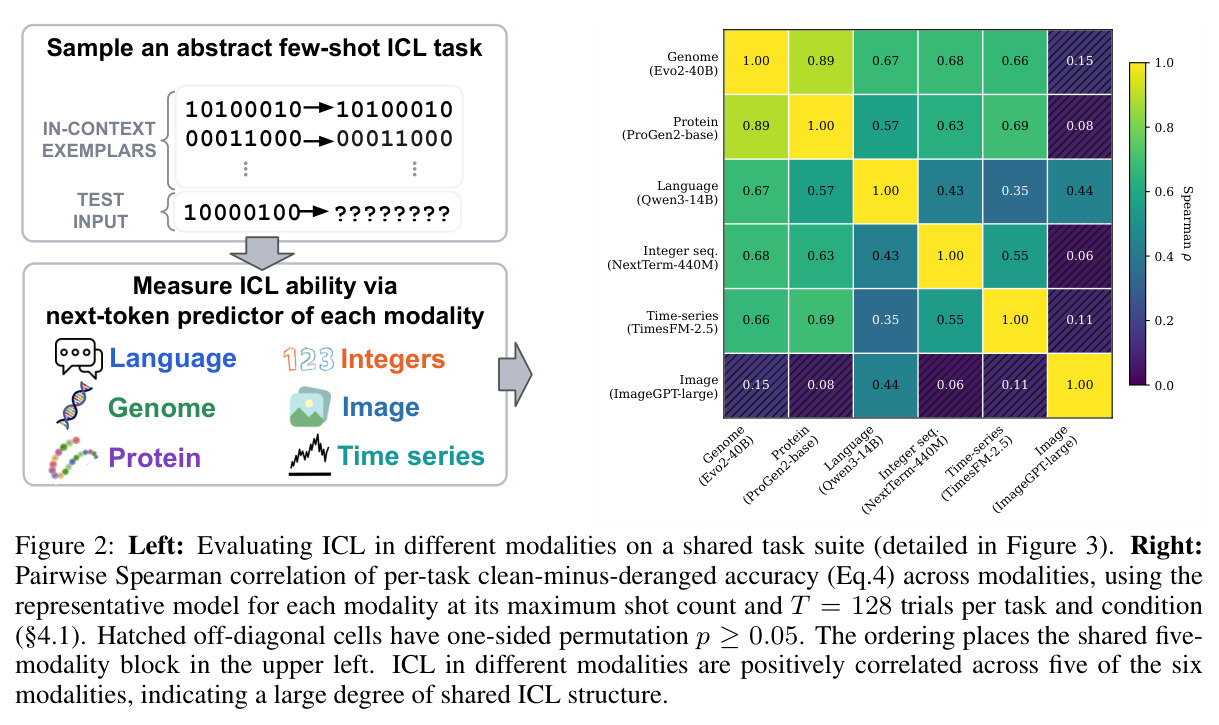
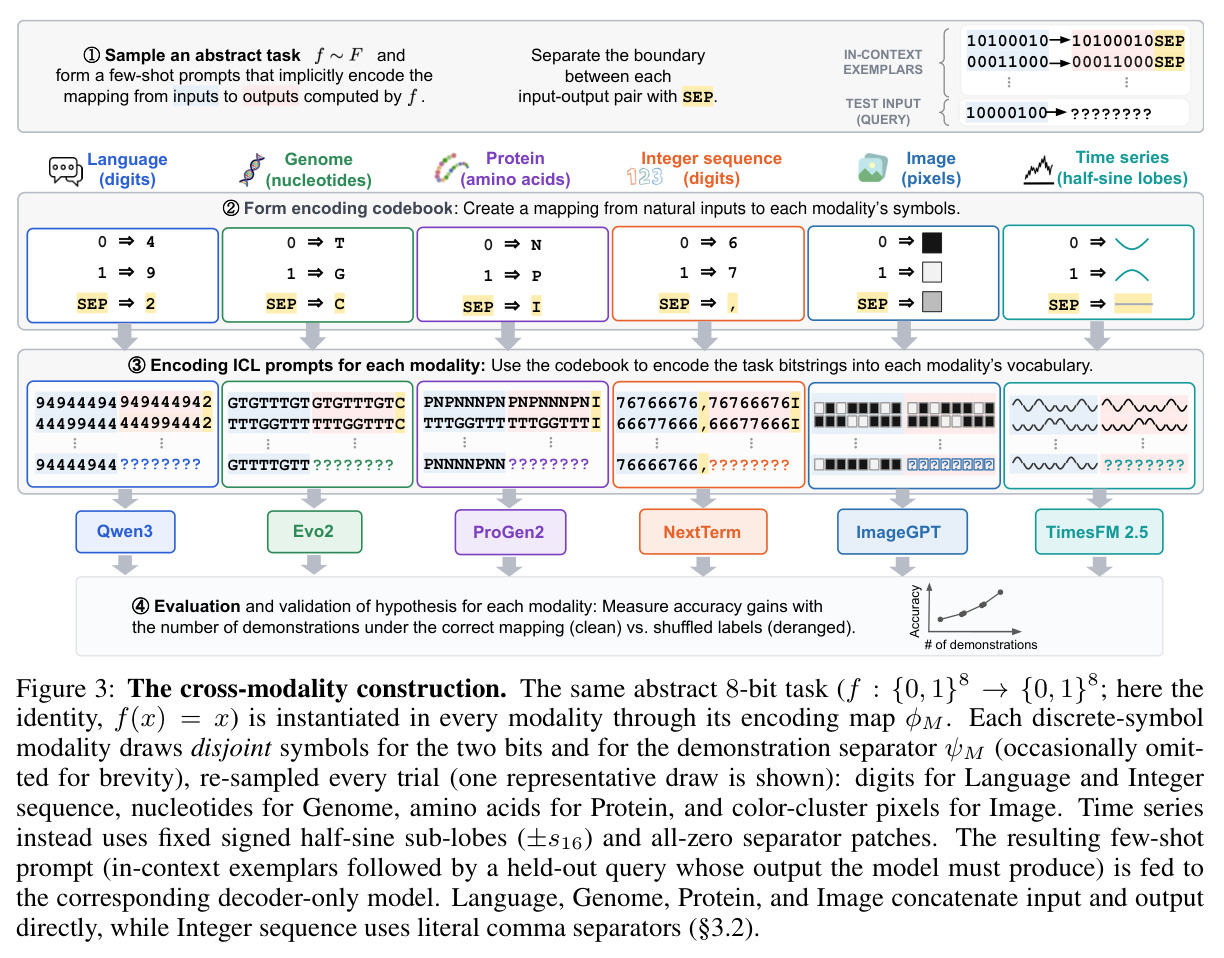
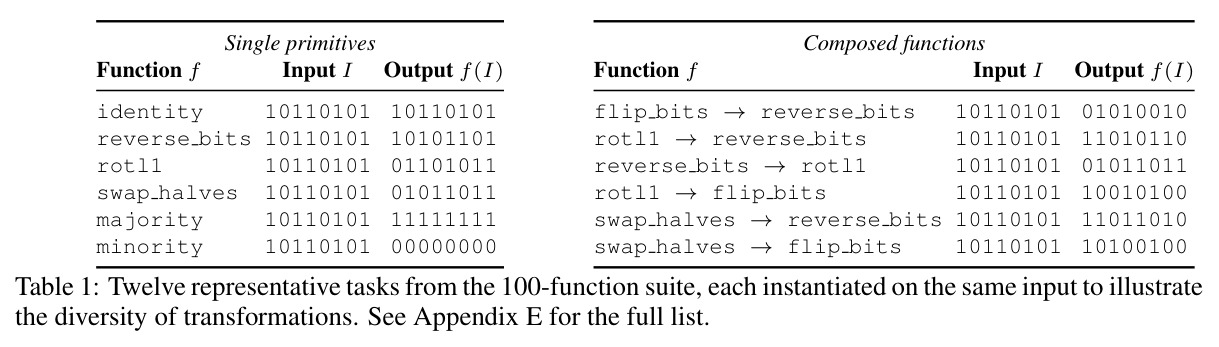
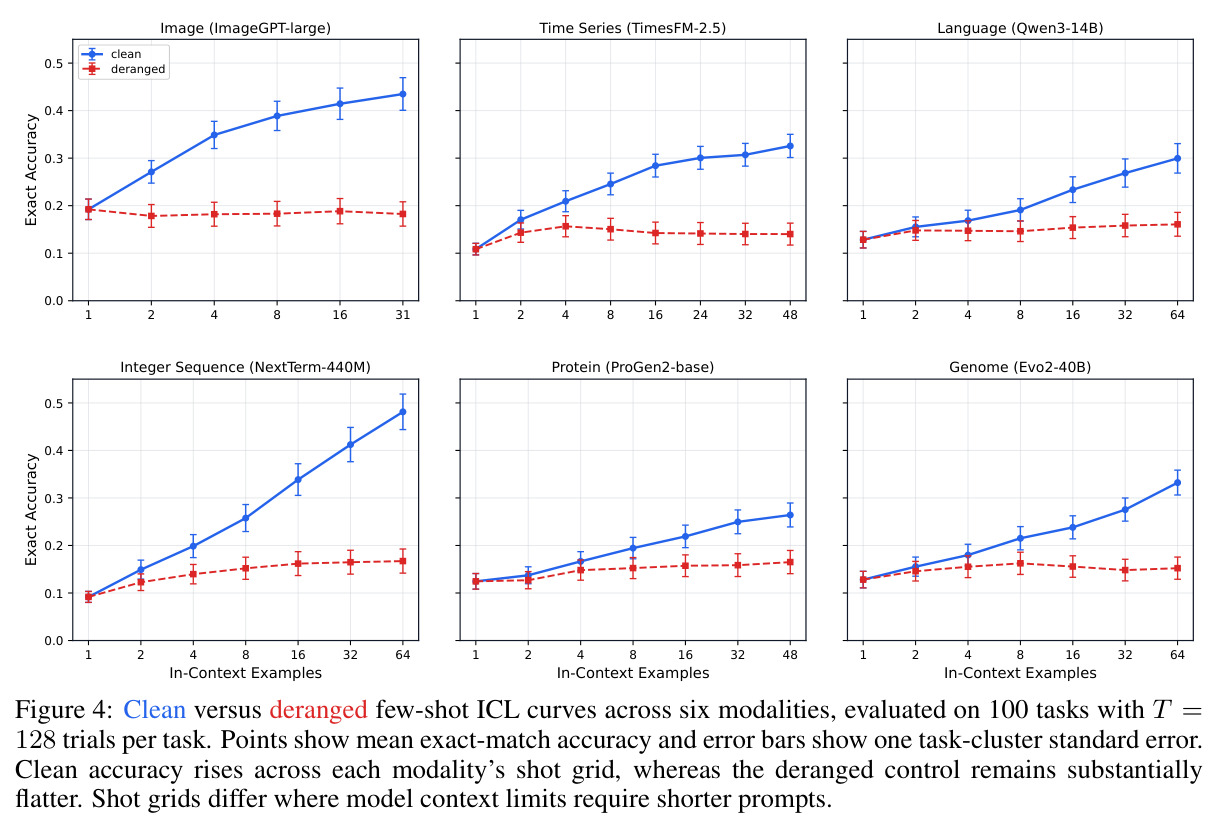
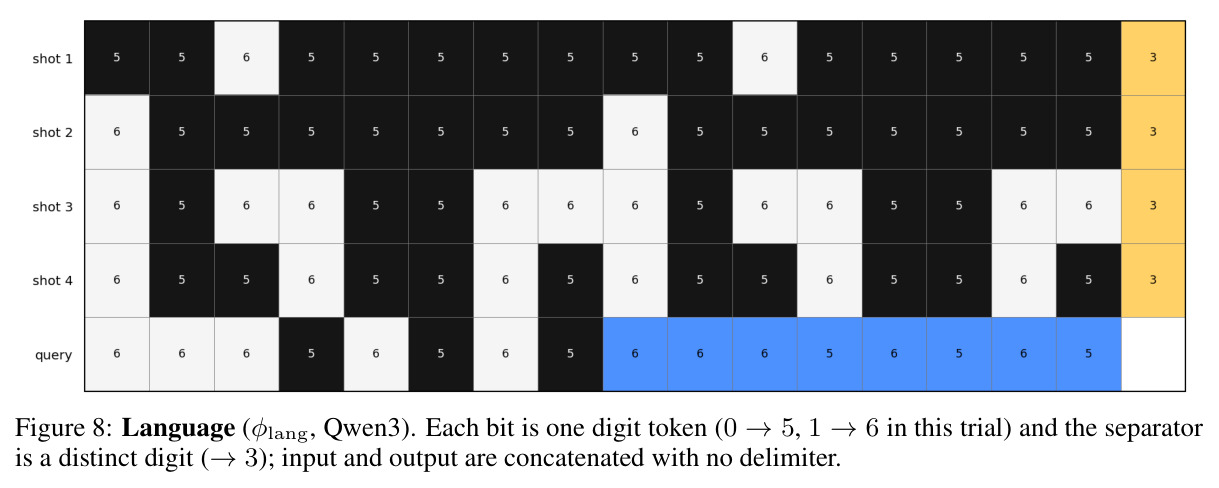
直觉上,如果 ICL 是下一词元预测的普遍副产物,那么在语言之外任何结构丰富的序列上训练的自回归模型,也应能从提示示例中推断抽象映射 $f$。技术路线分四步。第一步,构造共享任务套件:100 个确定性函数 $f:\{0,1\}^8\to\{0,1\}^8$(30 个单原始函数加 70 个按 $(f\to g)(x)=g(f(x))$ 复合的函数),覆盖恒等、位反转、旋转、奇偶填充、半段掩码等多种语义。第二步,跨模态编码:用可解码映射 $\phi_M$ 把 bit 串转为各模态符号——语言(Qwen3)用随机数字、基因组(Evo2)用随机核苷酸、蛋白质(ProGen2)用随机氨基酸、整数序列(NextTerm)用随机数字加逗号分隔、图像(ImageGPT)用 512 色簇像素的 16 像素横条、时间序列(TimesFM)用正负半正弦子瓣——并按 $prompt_M=\phi_M(I_1)\circ\phi_M(O_1)\circ\psi_M\circ\cdots\circ\phi_M(I_{n+1})$(式3)拼接。第三步,对照评估:每个(模型,shot 数)格子各跑 clean($P_n$)与 deranged($Q_n$)两种条件各 $T=128$ 试次,exact-match 打分。第四步,统计推断:用 $\Delta_n=\frac{1}{|\mathcal{F}|}\sum_f(X_{f,\mathrm{clean},n}-X_{f,\mathrm{deranged},n})$(式4)算逐任务配对效应,在最大 shot 数做单侧条件交换检验并 Holm 校正,再把 100 个任务的效应向量做跨模态 Spearman 相关以检验趋同假说。
核心创新是同一抽象函数的跨模态配对收益比较,与已有工作的本质区别有三点。其一,任务对齐:不在各模态用各自的自然任务,而是同一 bit 函数套件经 $\phi_M$ 编码,使得A任务在模态A比模态B更受益这类陈述有意义;同时共享套件排除了模型靠预训练记忆作答的混淆,因为这些少样本任务对多数模态是分布外的。其二,因果对照:derangement 把准确率拆成输出分布/格式适应与配对利用两部分——只有 clean 显著高于 deranged 且超过随机水平,才判定为真 ICL。其三,先验控制:离散符号模态每试次重新随机抽取两个符号代表 0/1 及第三个不相交符号作分隔符 $\psi_M$,语言模态刻意避开 0/1 而用随机数字编码,防止 Qwen3 直接调用预训练学过的 bit 操作知识。作者还推导了输出可辨识性的 union bound($n\ge8$ 时歧义概率不超过 $1\%$),确保答错可归因于模型而非任务歧义。最后用逐任务效应的跨模态相关性(而非聚合准确率)来操作化趋同,使假说可被定量证伪。
方法步骤详情
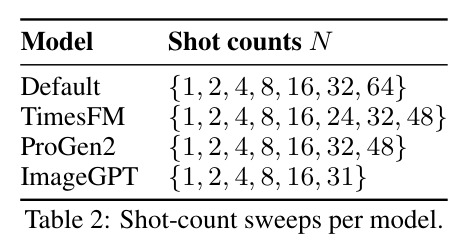
具体流程如下。(1) 任务与试次采样:从 100 个函数中取任务 $f$,每格 $T=128$ 个试次,每试次均匀无放回抽 $n$ 个演示对 $(I_i,f(I_i))$ 及查询 $I_{n+1}$。shot 网格默认 $\{1,2,4,8,16,32,64\}$,TimesFM 与 ProGen2 因上下文限制用 $\{1,\dots,48\}$、ImageGPT 用 $\{1,\dots,31\}$(Table 2)。(2) 符号编码:离散符号模态每试次随机抽两个符号代表 0 和 1、第三个不相交符号作分隔符——语言/整数序列用数字(后者加逗号分隔符)、基因组用核苷酸、蛋白质用氨基酸(前置序列起始 token)、图像用色簇像素(每演示占一行 32 像素:16 像素分隔 + 8 像素输入 + 8 像素输出);时间序列固定用 $\pm s_{16}$ 半正弦子瓣($s_L[k]=\sin\pi k/(L-1)$)、两 bit 填一个 32 步 patch、全零 patch 作分隔,预测时对原序列与取反序列的预测取平均以强制符号翻转不变性。(3) 解码与打分:Qwen3/Evo2/NextTerm 对原生词表贪心解码;ImageGPT/ProGen2 在两个 bit 符号的 logits 间受限贪心并自回归回馈;TimesFM 输出点预测后向 $\pm s_{16}$ 投影解码;结果解码回 8-bit 与 $O_{n+1}$ 精确匹配,格式错误记为错。(4) deranged 对照:采样至多 256 个置换,选未变输出最少的置换构造 $Q_n$,同法评估同一目标 $O_{n+1}$。(5) 统计推断:每模态在 $n_{\max}$ 处做单侧 within-task 条件交换检验(排除零差后枚举符号分配),六模态 Holm 校正;15 个模态对各用 $B=10^6$ 次置换检验效应排名正相关的显著性;另按 $k=7$ 个行为语义簇(附录 I)汇总每簇效应。
技术新颖性
技术新颖性体现在四个层面。测量学上,首次提出跨模态配对收益相关性作为能力趋同的操作化定义,把柏拉图表示假说从内部表示几何推广到外部任务难度轮廓;效应指标 $\Delta_n$ 是 within-task 配对差,比跨组比较灵敏得多。对照设计上,derangement 不是均匀随机置换,而是从最多 256 个候选中选未变输出最少的一个,最大化破坏配对的程度,避免对照过弱而高估 ICL;配合输出可辨识性 bound($m=256$、99 个函数平均成对汉明距离约 244.45、最小 16,$n=8$ 时界达 0.991)排除任务歧义。覆盖面上,把此前孤立的视觉(ImageGPT)、基因组(Evo2)证据扩展到六个模态,新增整数序列、时间序列、蛋白质三个首次被系统检验的模态,并主动构造阴性对照——棋类用 ChessGPT-50M 的骑士走法-复位编码(4-bit),音乐用自训练 Musicroll-50M 的钢琴卷帘编码。统计上用精确条件交换检验加 Holm 校正控制六重检验的家族错误率,用任务聚类自助法给配对差配备 95% 置信区间,严谨度高于以往单模型单报告的跨模态研究。
实验结果
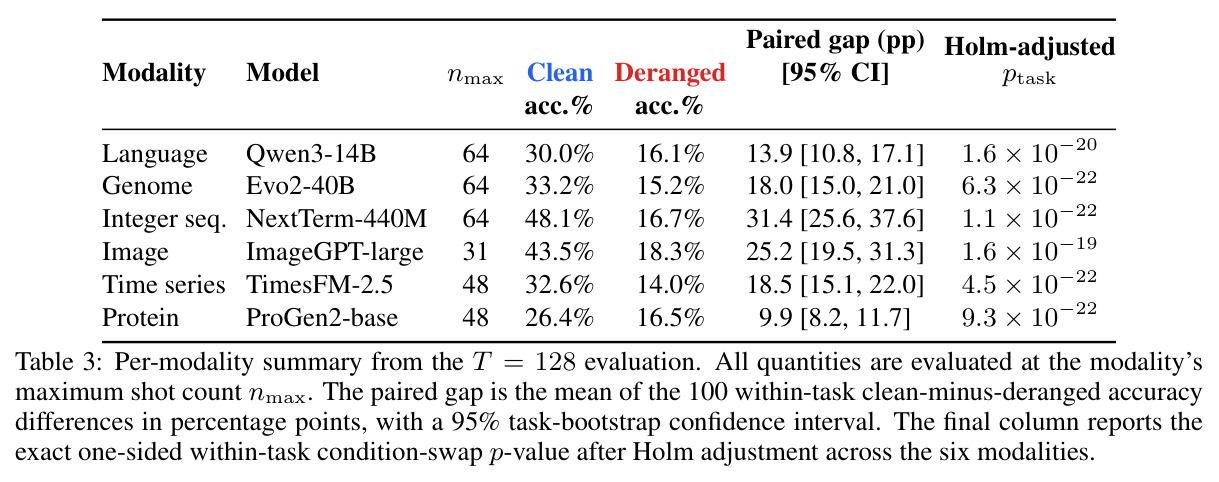
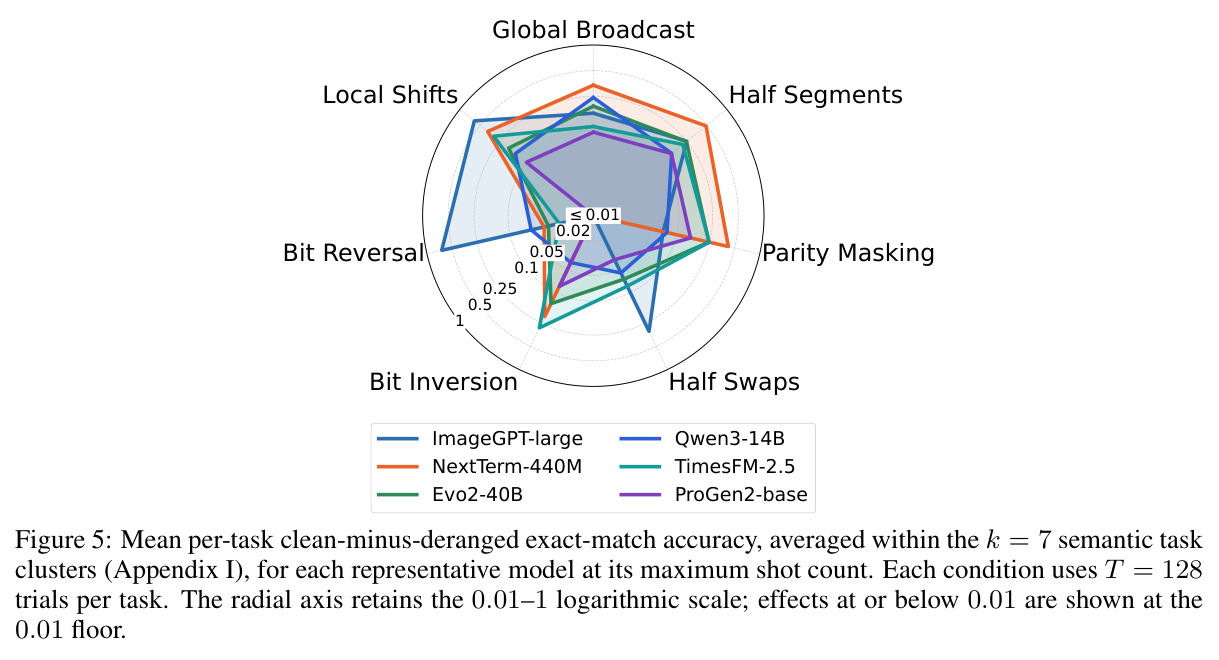
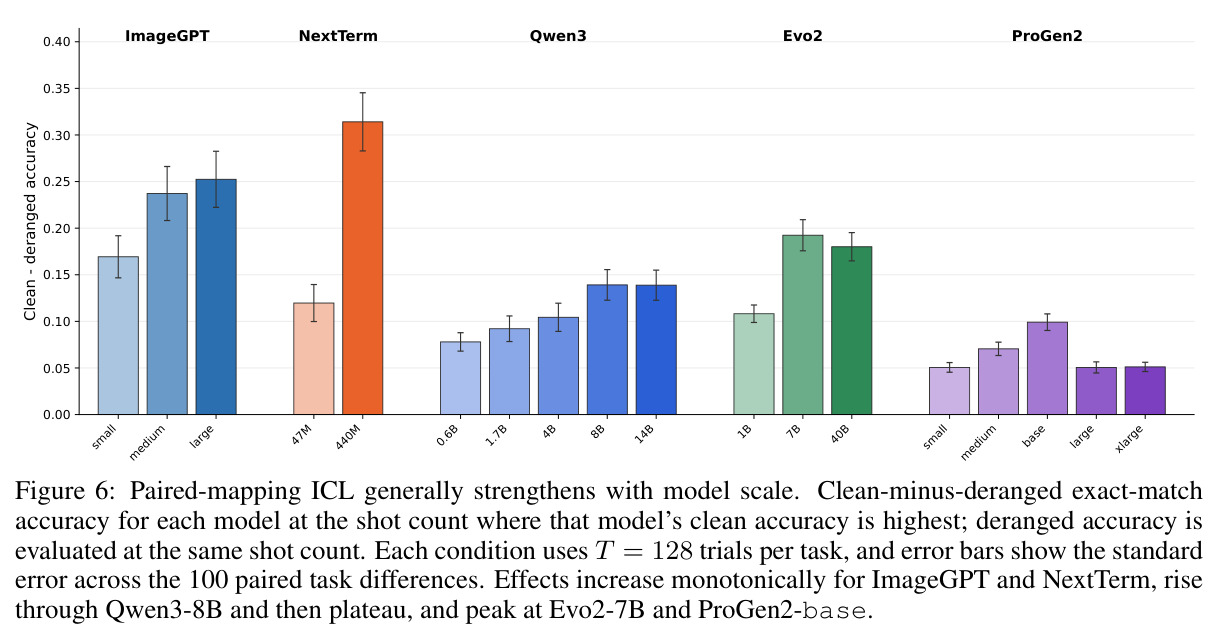
论文有四个核心发现。(1) ICL 在全部六个模态涌现(Figure 4、Table 3):clean 准确率随 shot 数上升而 deranged 对照明显更平坦。在各模态最大 shot 数下,clean-minus-deranged 配对差从蛋白质的 9.9 个百分点到整数序列的 31.4 个百分点,六模态单侧条件交换检验全部显著(Holm 校正后 $p$ 在 $10^{-19}$ 到 $10^{-22}$ 量级)。绝对 clean 准确率为:NextTerm-440M 48.1%($n{=}64$)、ImageGPT-large 43.5%($n{=}31$)、Evo2-40B 33.2%($n{=}64$)、TimesFM-2.5 32.6%($n{=}48$)、Qwen3-14B 30.0%($n{=}64$)、ProGen2-base 26.4%($n{=}48$),deranged 均落在 14–18.3%。输出可辨识性 bound 保证 $n\ge8$ 时歧义低于 1%,效应可归因于模型。(2) 效应结构大体趋同(Figure 2 右):五个非图像模态两两 Spearman $\rho=0.35\text{–}0.89$,其中基因组-蛋白质最高($\rho=0.89$,符合 DNA 与氨基酸序列的生物学对应);ImageGPT 与基因组/蛋白质/整数序列/时间序列仅 $\rho=0.06\text{–}0.15$,但与语言达 $\rho=0.44$,说明其 ICL 结构更特异。(3) 规模大体有益但不保证(Figure 6):ImageGPT 与 NextTerm 效应随参数量单调上升,Qwen3 升至 8B 后在 14B 平台,Evo2 在 7B 达峰而非 40B,ProGen2 在 base(764M)达峰后 large/xlarge 反而下降。(4) 涌现并非自动(Figure 7):ChessGPT-50M 骑士走法编码下 clean-deranged 差为 $-0.0016$($p=0.640$,无效应);Musicroll-50M 仅在 $n=32$ 出现微小效应 0.0107($p=0.00349$,Holm 后 0.0174),比最小正向模态效应(ProGen2 的 0.0991)还小 9.3 倍。语义簇分析(Figure 5,$k=7$)进一步显示各模态能力形状不同:ImageGPT 支配位反转(0.66)与局部移位(0.61)且半段交换异常好,NextTerm/Evo2/ProGen2 峰值在半段操作,Qwen3 峰值在全局广播,TimesFM 峰值在局部移位。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 少样本配对 ICL(语言,Qwen3-14B,n=64) | clean−deranged exact-match 配对差(百分点) | +13.9 pp(clean 30.0% vs deranged 16.1%) | derangement 标签打乱对照 16.1% | 13.9 pp,95% CI [10.8, 17.1],Holm 校正 p=1.6×10⁻²⁰ |
| 少样本配对 ICL(基因组,Evo2-40B,n=64) | clean−deranged exact-match 配对差(百分点) | +18.0 pp(clean 33.2% vs deranged 15.2%) | derangement 标签打乱对照 15.2% | 18.0 pp,95% CI [15.0, 21.0],Holm 校正 p=6.3×10⁻²² |
| 少样本配对 ICL(整数序列,NextTerm-440M,n=64) | clean−deranged exact-match 配对差(百分点) | +31.4 pp(clean 48.1% vs deranged 16.7%) | derangement 标签打乱对照 16.7% | 31.4 pp,95% CI [25.6, 37.6],Holm 校正 p=1.1×10⁻²²(六模态中最强) |
| 少样本配对 ICL(图像,ImageGPT-large,n=31) | clean−deranged exact-match 配对差(百分点) | +25.2 pp(clean 43.5% vs deranged 18.3%) | derangement 标签打乱对照 18.3% | 25.2 pp,95% CI [19.5, 31.3],Holm 校正 p=1.6×10⁻¹⁹(但效应轮廓与其他模态弱相关) |
| 少样本配对 ICL(时间序列,TimesFM-2.5,n=48) | clean−deranged exact-match 配对差(百分点) | +18.5 pp(clean 32.6% vs deranged 14.0%) | derangement 标签打乱对照 14.0% | 18.5 pp,95% CI [15.1, 22.0],Holm 校正 p=4.5×10⁻²² |
| 少样本配对 ICL(蛋白质,ProGen2-base,n=48) | clean−deranged exact-match 配对差(百分点) | +9.9 pp(clean 26.4% vs deranged 16.5%) | derangement 标签打乱对照 16.5% | 9.9 pp,95% CI [8.2, 11.7],Holm 校正 p=9.3×10⁻²²(正向模态中最弱) |
| 跨模态效应相关性(基因组-蛋白质) | 逐任务配对效应的 Spearman ρ | ρ = 0.89 | 15 对模态平均约 0.35–0.7(非图像模态间) | 全场最高相关,对应 DNA 与氨基酸序列的生物学关系 |
| 跨模态效应相关性(图像 vs 其他四模态) | 逐任务配对效应的 Spearman ρ | ρ = 0.06–0.15(仅与语言 0.44) | 五个非图像模态间 ρ = 0.35–0.89 | 反例:ICL 涌现不等于效应结构趋同 |
| 阴性对照(棋类,ChessGPT-50M,n=8;音乐,Musicroll-50M,n=32) | clean−deranged exact-match 配对差 | 棋 −0.0016(p=0.640);音乐 +0.0107(p=0.00349,Holm 后 0.0174) | 六个正向模态最小效应 0.0991 | 无可靠效应/效应比最小正向模态小 9.3 倍:结构化数据不保证涌现 ICL |
局限与改进
作者承认的局限:(1) 证明否定很难——chess 无效应、music 仅微弱效应只能作为弱证据,可能只是提示或编码方式不对,作者建议未来用贝叶斯先验更新来处理阴性结果;(2) 无法跨模态比较绝对 ICL 强度,因为各模态预训练先验不同(ImageGPT 的光栅编码与数据增强利于移位/反转任务、NextTerm 的 OEIS 先验利于数值操作),先验效应在模态内部分受控、跨模态完全不受控;(3) 任务全部确定性,未覆盖真实世界带噪的回归/分类任务;(4) 任务难度被当作同质的函数袋,未显式建模难度标度。我自己的观察:(5) 绝对准确率仍低(26–48%,即便在 48–64 shot),说明 8-bit 随机符号任务对大模型依然困难,且最大 shot 受上下文限制截断,效应可能尚未饱和;(6) 效应相关只证明难度排序共通,不能证明机制相同——不同模态可能用不同算法达到相似难度轮廓,缺乏机制层面的证据(如电路分析);(7) 每模态只用一个代表模型做相关分析,效应可能掺杂模型特定因素,作者自己也列出 NextTerm 两个 checkpoint 在规模、词表、架构、语料上同时不同、无法归因的异常;(8) TimesFM(含合成时间序列)与 OEIS(含函数归纳式数据)部分违反预训练数据非为 ICL 而设的准入准则,可能高估这两个模态的涌现程度;(9) derangement 的择优选择本身非均匀,作者承认未测试这对对照曲线形状的影响。
独立分析的弱点
(1) 绝对性能天花板低:即便 64 shot,最强模态 clean 也只有 48.1%,说明该套件目前测量的是 ICL 的存在性而非实用能力。改进方向:把任务从 8-bit 扩展到 16/32-bit 并观察效应随长度的衰减曲线,或先在无 ICL 目标的合成数据上系统训练中间规模模型,建立涌现阈值与数据丰富度的关系参考。(2) 单代表模型的相关分析脆弱:Figure 2 的 ρ 值可能被单一 checkpoint 的特异先验污染(ProGen2 效应在 base 后骤降、两个 NextTerm checkpoint 混杂多因素等异常都是作者承认的信号)。改进:每模态取 3–5 个模型构建效应矩阵,先报告模态内一致性再计算跨模态相关。(3) 先验混杂未真正解决:ImageGPT 的像素/数据增强先验、TimesFM 的合成序列训练都可能塑造其效应轮廓,这恰是图像模态脱离趋同群的最可能解释。改进:把作者针对语言设计的随机符号编码推广为各模态的防污染编码(如图像用非自然色簇排列),或在同一 transformer 上做受控多模态混合预训练以解耦先验与模态。(4) 阴性对照证据强度有限:chess 只测了 4-bit 且模型仅 50.9M 参数,Musicroll-50M 只训练 1B token,二者算力与上下文远小于正向模态,无法区分是模态本身不能涌现 ICL 还是 elicitation 不够。改进:扩大对照模型规模、系统筛查多种编码(作者对 chess 已试四种布局),或在训练过程中跟踪 ICL 涌现轨迹以获得更灵敏的检测。
未来方向
作者明确提出的方向:(1) 用贝叶斯框架对某模态是否存在 ICL 设先验并根据失败 elicitation 证据更新,化解证明否定之难;(2) 设计能控制跨模态先验效应的方法,使绝对 ICL 强度可比,甚至借此迈向跨模型智能比较;(3) 把任务套件扩展到带噪回归与分类任务;(4) 显式难度标度——设计带标量难度参数的任务生成器,测量 ICL 随复杂度的退化,并研究输出熵、Kolmogorov 式复杂度等度量与经验难度的相关性(优于事后相关性分析);(5) 建立能在训练前预测 ICL 涌现规模与模态的理论,指导需要训练多久、在什么数据上训练;(6) 解释开放异常——ProGen2 效应在 base 后骤降、NextTerm 与 Evo2 的 deranged 曲线形状差异(前者单调上升、后者 8 shot 后回落)、两个 NextTerm checkpoint 的巨大差距。基于本文成果可延伸的方向:把逐任务效应轮廓当作模型能力指纹,检验聚合基准分是否掩盖能力差异(结论已暗示这一点);将效应相关与表示几何对齐度直接关联,检验柏拉图表示假说的行为对应物;在基因组设计、价格预测等高风险场景验证少样本提示的实用迁移价值。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/N8python/shared-emergence-icl-modalities),含复现主结果与配对检验的评估命令和模型标识符。六个正向模态全部使用公开 checkpoint:Qwen3-14B、Evo2-40B、NextTerm-440M(HuggingFace N8Programs/NextTerm-440M,另有 47M 版)、ImageGPT-large、TimesFM 2.5 200M、ProGen2-base;棋类对照用公开的 50.9M Chess-GPT Lichess checkpoint。文档完备:100 个任务全表(附录 E)、30 个原始函数(附录 D)、7 语义簇聚类全流程(附录 I:方向不变轨道合并→自定义编辑距离高斯核→经典 MDS→k-means)、每模态提示渲染示例(附录 F)、chess/music 编码细节(附录 G)、NextTerm 与音乐模型架构及训练细节(附录 H)。需要自行训练的只有 Musicroll-50M/Music-50M(约 24,000 个 MIDI、1B token、双节点数据并行、Muon+AdamW 混合优化)和 OEIS 语料的 NextTerm 模型,需中等算力。纯评估的计算量主要是推理:每模态 100 任务 × 128 试次 × 2 条件 × 7 档 shot 约 18 万次前向,但单条上下文很短(最多几十个 token 或 4 个时间序列 patch),单卡数小时到数天可完成。统计协议(精确条件交换检验、Holm 校正、$10^6$ 次置换检验)在正文和代码中均有精确说明。总体复现难度中等偏低。
论文图表
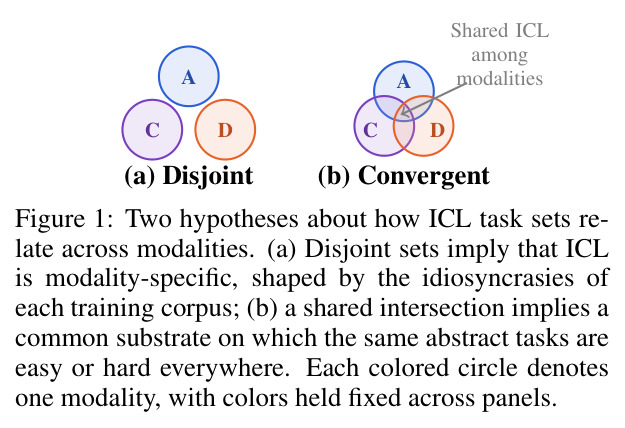
两个韦恩图对比两种假设:(a) 不相交假设——各模态的 ICL 任务能力集合互不重叠,由各自训练语料的特异性塑形;(b) 趋同假设——各模态能力集存在共同交集,同一抽象任务在各处都同样容易或困难。每个彩色圆代表一个模态。
这张示意图定义了全文要检验的核心对立假设(分歧 vs 趋同),是理解论文问题表述和结论解释框架的钥匙。