ZGCM-1:面向数学与智能体搜索的全开源高效基础模型 ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
7B全开源模型靠深度思考加工具调用双引擎与极致训练效率,在数学和智能体搜索上比肩大型前沿模型。
前置知识
滑动窗口注意力(SWA)与混合注意力
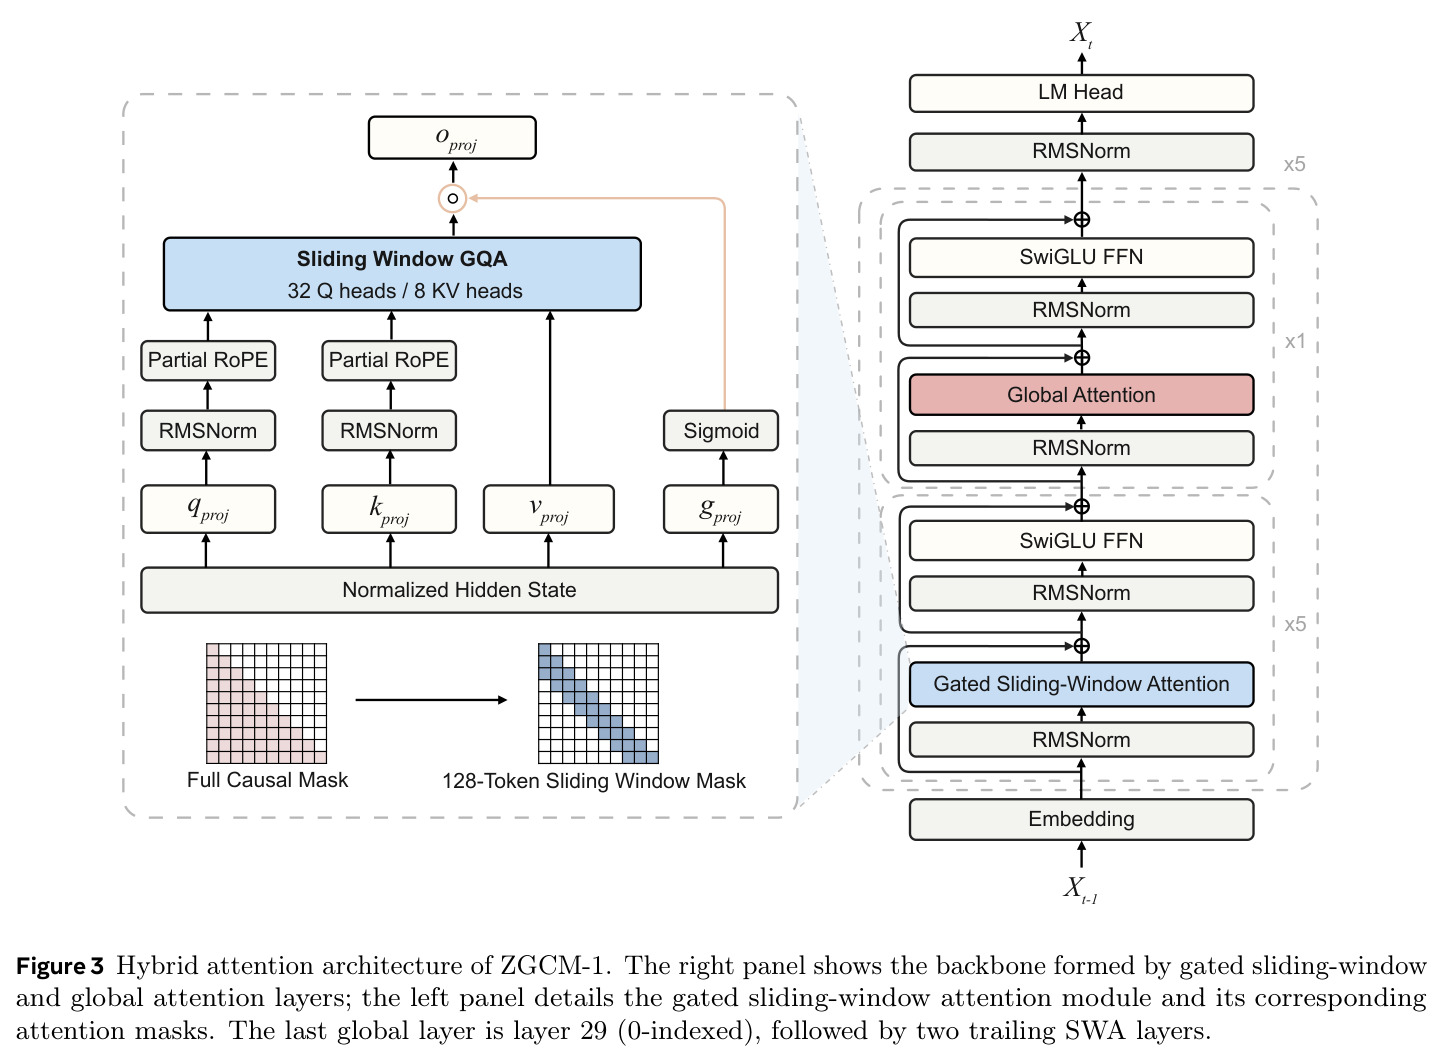
让每个 token 只与相邻 128 个 token 计算注意力,使 KV 缓存保持恒定大小;再每隔若干层插入一个全局注意力层保证长程信息流动。ZGCM-1 采用 5 层局部对 1 层全局的交错比例(27 层门控 SWA + 5 层全局),全局层位于第 6/12/18/24/30 层。
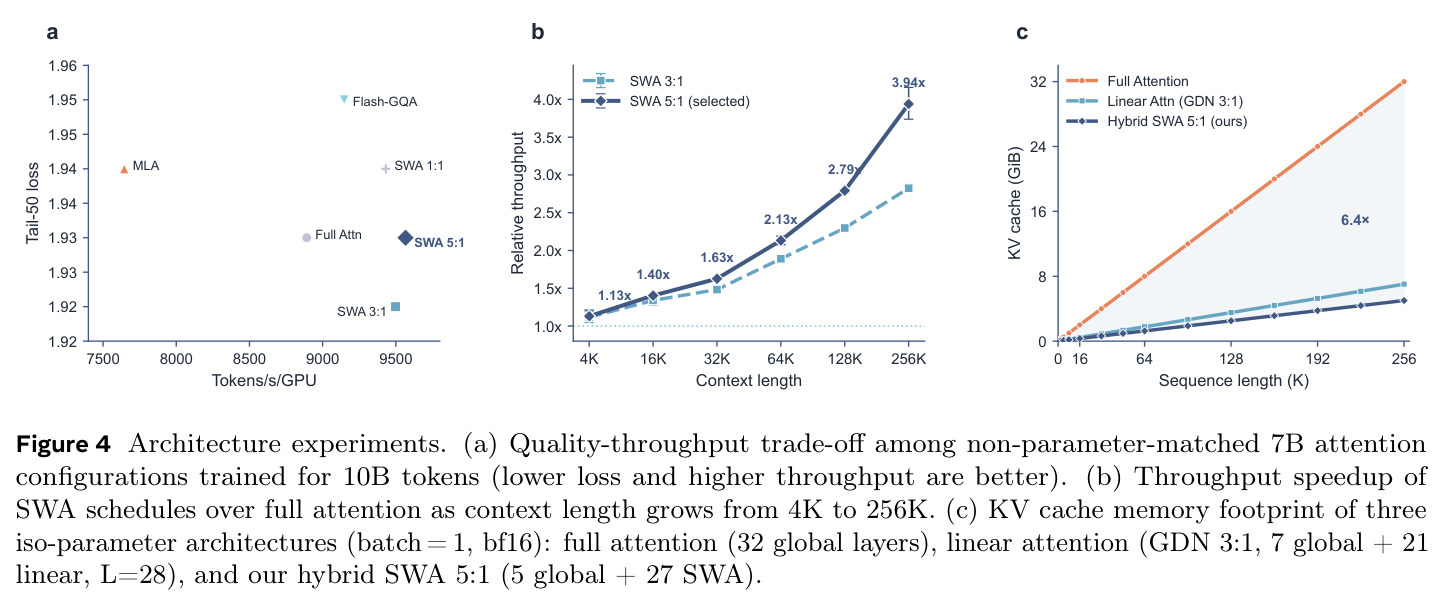
论文的架构章节与全部效率结论(3.94 倍吞吐、6.4 倍 KV 缩减)都建立在 SWA 与全局比例的取舍之上,不懂 SWA 无法理解架构实验。
FP8 混合精度训练与 TWEO
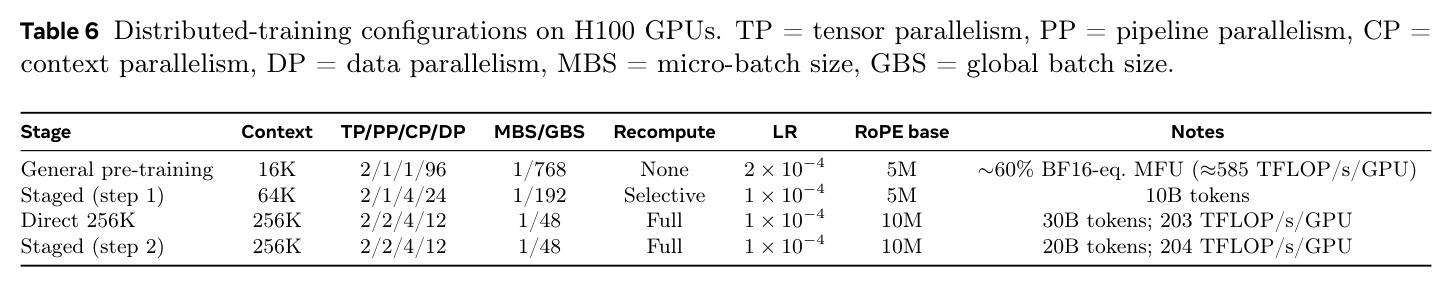
FP8 用 8 位浮点执行矩阵乘法(前向 E4M3、反向 E5M2),按 1024 步历史最大值更新缩放因子;TWEO 是抑制中间激活异常值的正则化手段,防止 FP8 训练数值发散。二者结合使预训练稳定维持在约 585 TFLOP/s/GPU(约 60% BF16 等效 MFU)。
4.2 倍预训练加速中 FP8 贡献约 1.5 倍,而其稳定性机制(Finding 2)是论文系统-算法协同设计的关键论据。
Muon 优化器
一种对矩阵参数做谱缩放更新的优化器:动量 0.9、谱范数缩放、五步 Newton-Schulz 迭代,标量参数仍用 Adam;学习率 2e-4、权重衰减 0.1。论文实测其对 AdamW 有约 1.8 倍的步数-损失效率,SFT 阶段采用逐层 Muon 变体。
Muon 是 4.2 倍加速中最大的单项因子(1.8 倍),也是复现训练稳定性与超参配置的核心。
MDP 中间训练(MDP Mid-Training)
把智能体交互轨迹重构为马尔可夫决策过程式样本:任务描述、交互历史与当前环境反馈构成状态 $s_t$,模型在原始 next-token 目标下预测合适的下一动作 $a_t$。与复现完整轨迹相比,它提供状态条件下逐步决策的密集监督,且仍在全序列因果语言建模目标内完成。
这是本文中期训练最核心的方法创新,是理解 ZGCM-1 智能体能力为何能在预训练阶段就形成的钥匙。
GRPO(组相对策略优化)
一种免价值网络的强化学习算法:每个问题采样一组回答,用组内奖励的相对差异构造优势函数;配合动态采样过滤零方差组、参考策略 KL 正则控制漂移、温和长度惩罚抑制超长截断噪声。本文 rollout 允许 65,536 个新生成 token、总上下文 98,304。
后训练阶段数学与代码的增益全部来自这一算法,其采样规模(384 或 3072 条轨迹/步)决定了长推理训练的可行性。
think/no-think 混合微调
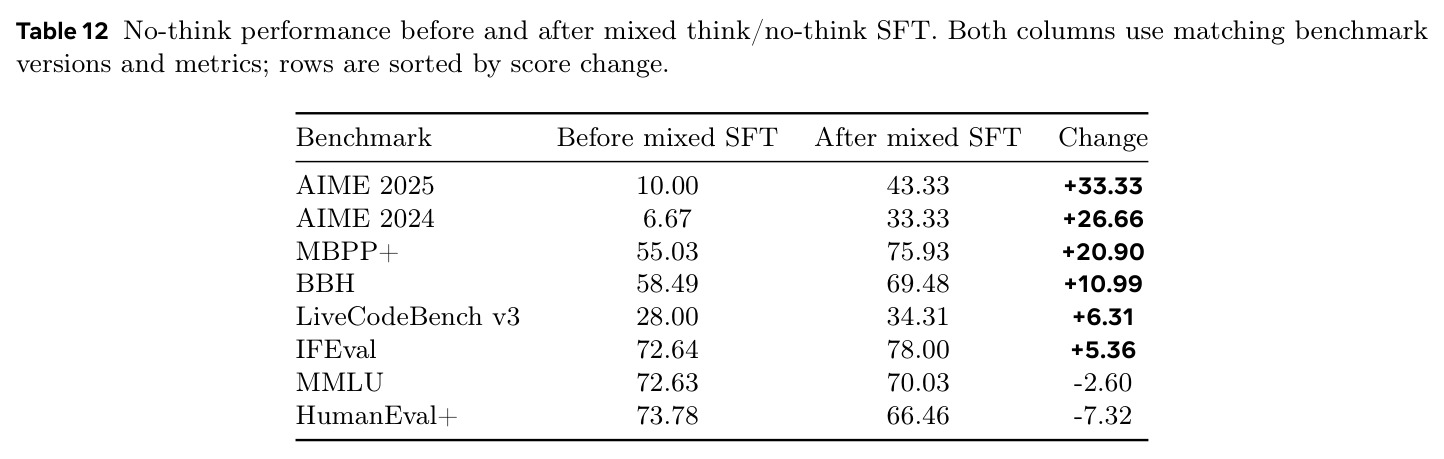
同一套权重同时学习两种模式:带显式推理链的 think 样本与直接给出答案的 no-think 样本,由系统提示或运行时预算切换。论文发现 think 监督正向迁移到 no-think:AIME 2025 从 10.00% 升至 43.33%,但 HumanEval+ 反降 7.32。
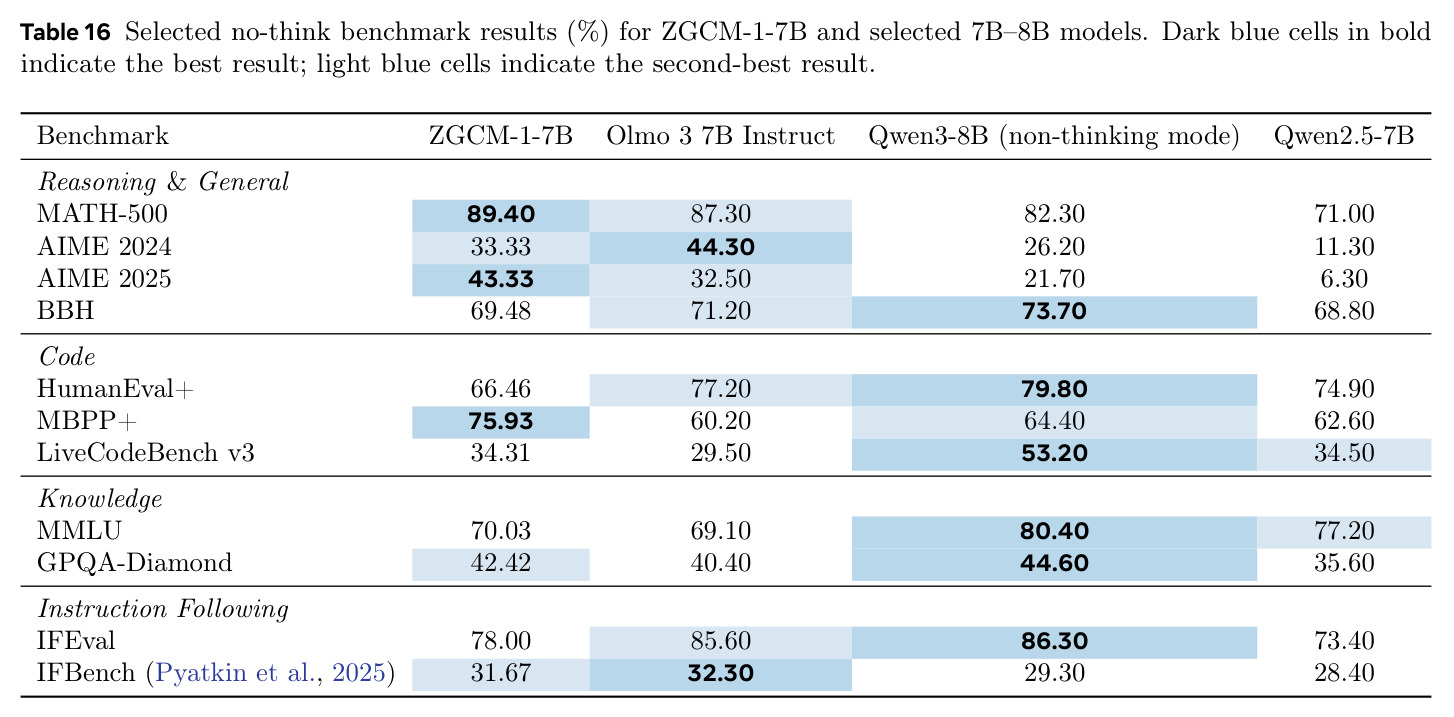
论文评测分 think 与 no-think 两种模式报告(Table 2 与 Table 16),不理解该机制就无法解读结果表。
研究动机
前沿级推理与深度智能体搜索长期被视为千亿参数系统的专属领地。以 Qwen3-235B-A22B、Kimi-K2、GLM-5.1 为代表的前沿模型依赖海量算力,训练动辄上万卡时,把算力受限的高校与个人研究者挡在门外——这构成第一重'规模壁垒'。第二重是'透明度壁垒':多数有竞争力的模型只开放权重而非完全开源,上游数据过滤配方、中期训练课程、长上下文扩展日程、多轮智能体轨迹等关键环节仍是黑箱。例如 DeepSeek-R1-0528-Qwen3-8B 这类蒸馏模型虽在 AIME 2024 达 83.33%,但其教师模型与数据管线均不公开,研究者既不能复现也难以做受控实验,无法系统研究训练动力学与紧凑模型的容量极限,导致开源生态在推理与智能体方向持续落后于闭源系统。
本文的目标是本文要在完全透明的开放科学范式下,从零训练一个 7.39B 的稠密基础模型 ZGCM-1,并证明其核心论题:紧凑模型虽受静态参数容量约束,但可以通过'深思熟虑的内部推理 + 主动的外部工具调用'双引擎突破这一限制——不靠被动记忆开放网络,而是在 256K 上下文中自主检索网络证据、操作终端、分析去符号化的二进制程序。具体目标有三:(1) 构建端到端高效开源训练管线,在学术级算力下把 16K 预训练时间-损失相对 BF16/AdamW 基线加速约 4.2 倍;(2) 在数学推理与智能体搜索上与数量级更大的前沿模型正面竞争;(3) 公开预训练、中期训练、后训练全部阶段权重、中间检查点、训练代码、分阶段数据配方、W&B 日志与评测套件。
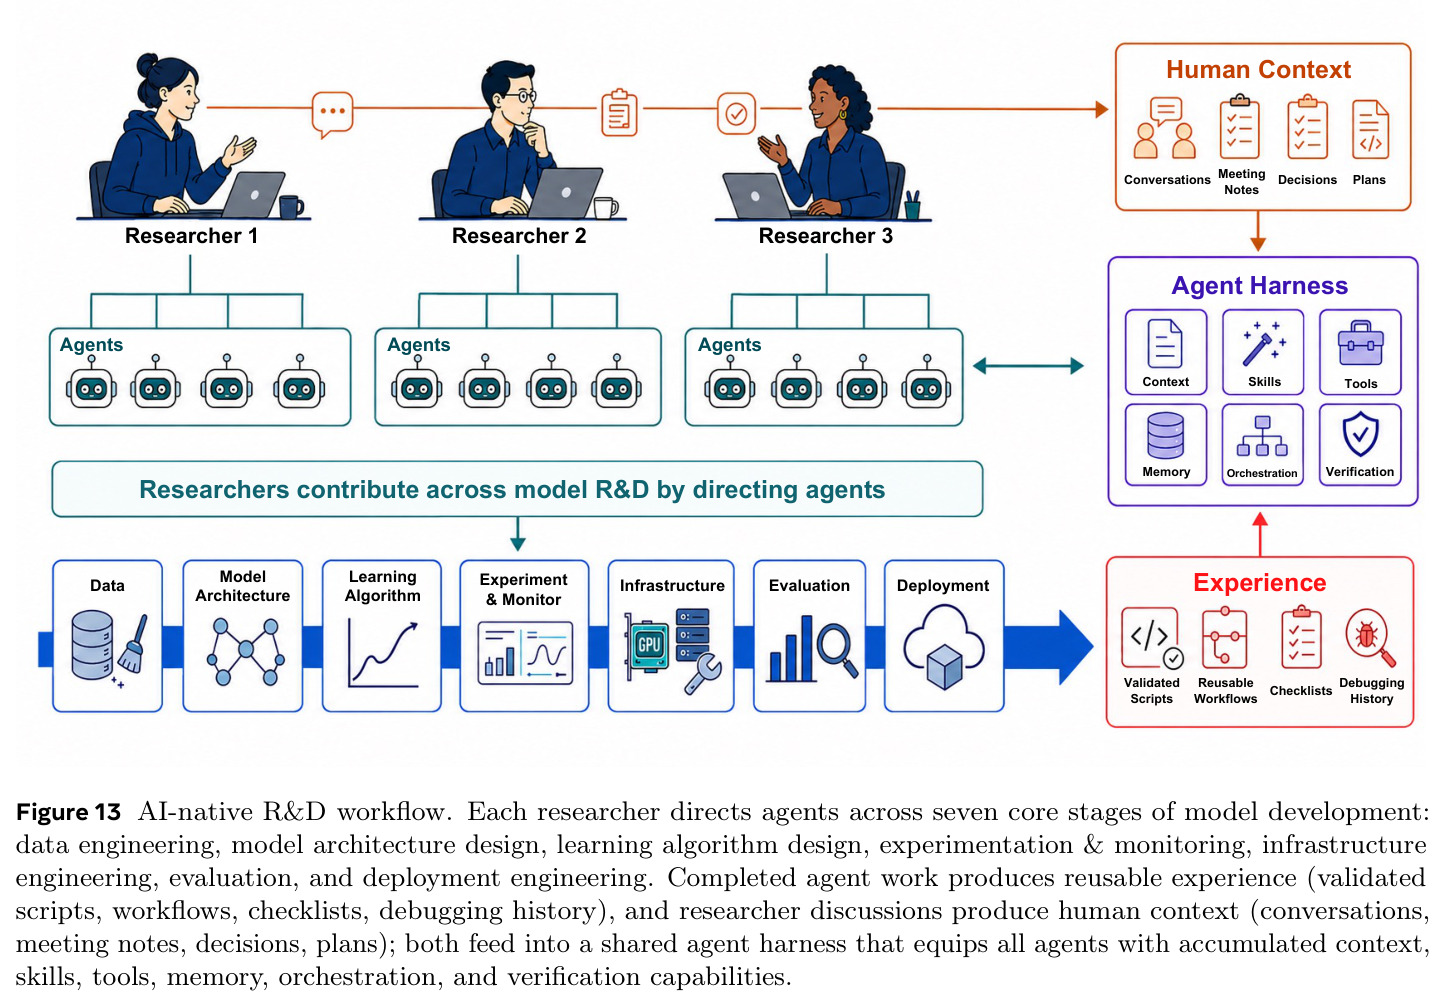
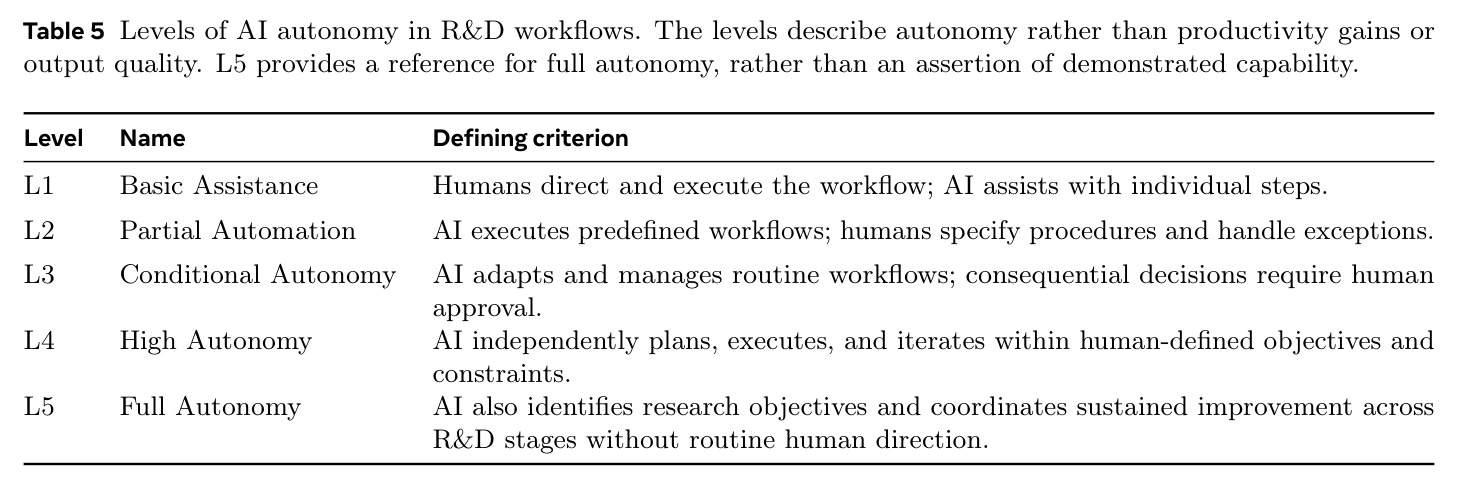
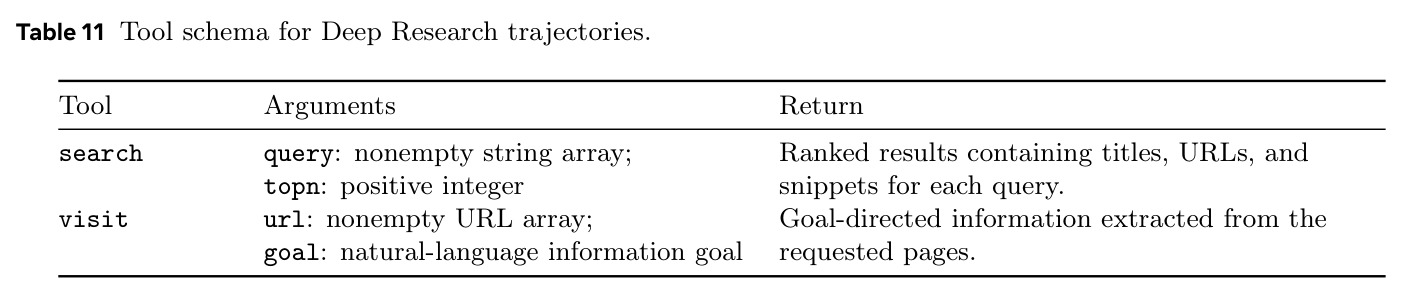
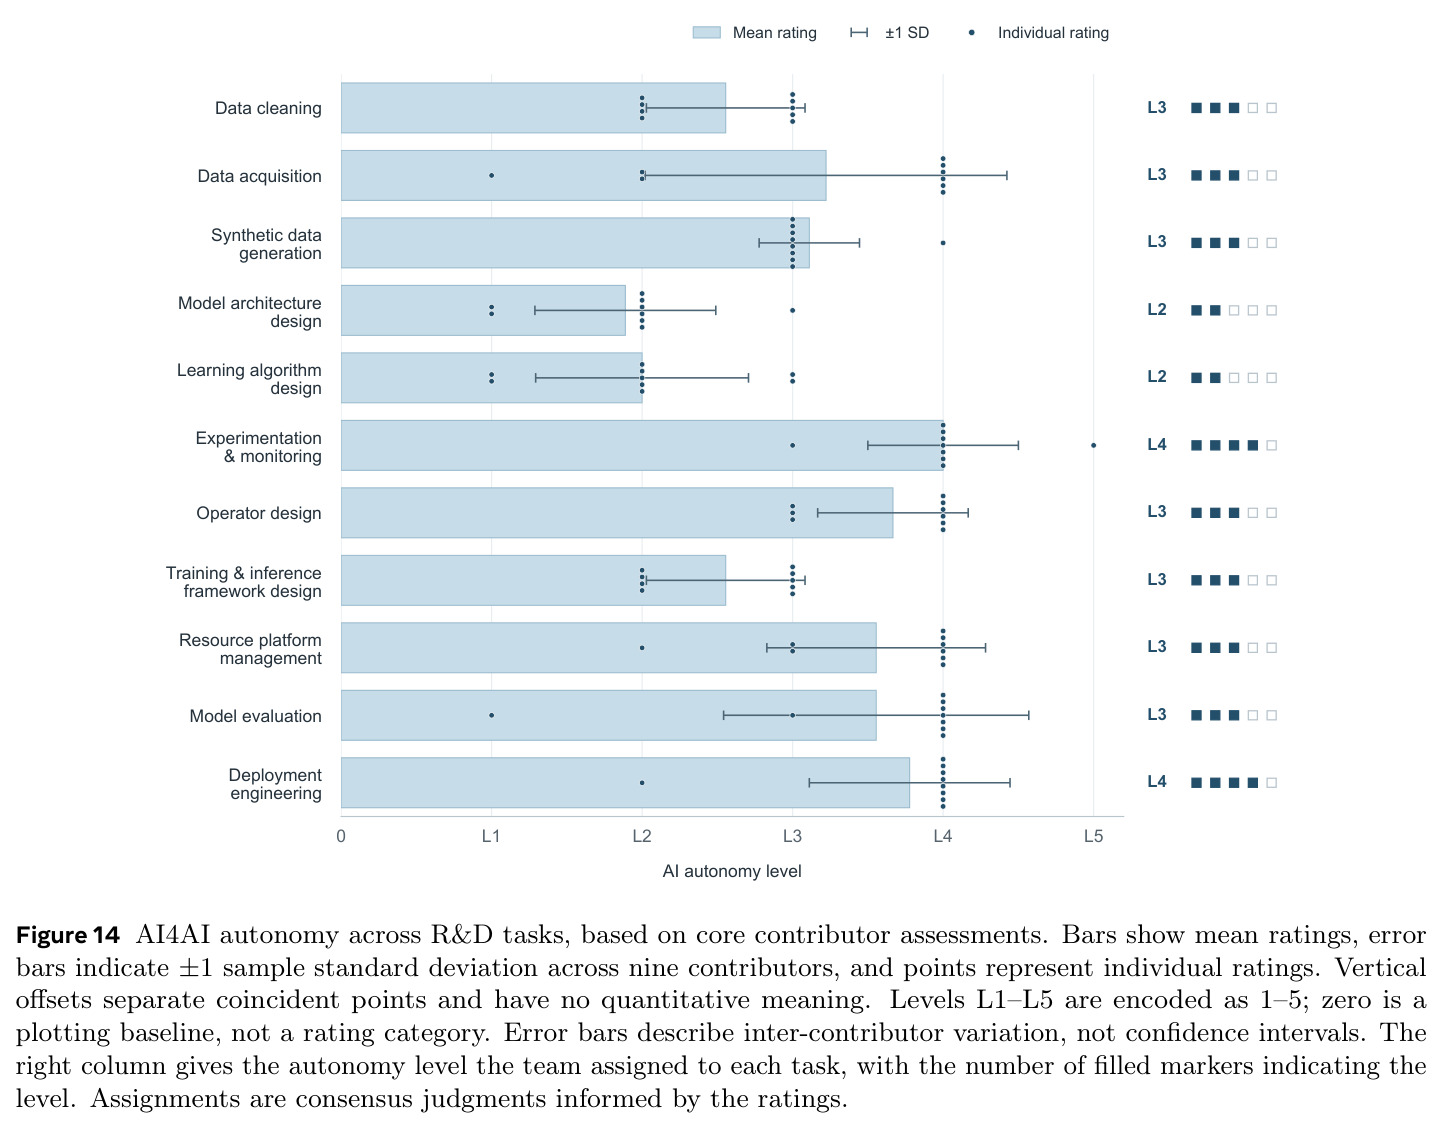
与已有工作不同的是,本文的独特切入是三条线同时展开。其一,把'知识外置'作为设计公理:7B 参数不用于记忆网页内容,而用于承载慢思考与主动求索能力,知识本身留在模型之外按需获取,这直接决定了架构(256K 混合注意力)、中期训练(智能体轨迹进入预训练语料)与后训练(深度研究/软件工程/终端三支数据)的取舍。其二,把交互轨迹重构为 MDP 状态-动作转移,在全序列因果语言模型目标内部注入逐步决策监督,而不是像常见做法那样把智能体数据推迟到 SFT/RL 阶段。其三,首次在基础模型技术报告中对'AI 原生研发'给出量化自评:九名核心成员按 L1-L5 五级量表对 11 类任务打分(共 99 份评分),坦承架构与学习算法设计仅达 L2、从未超过 L3,而实验监控与部署工程已达 L4;同时以 8 条经验发现公开全部教训而非只报喜。
核心方法
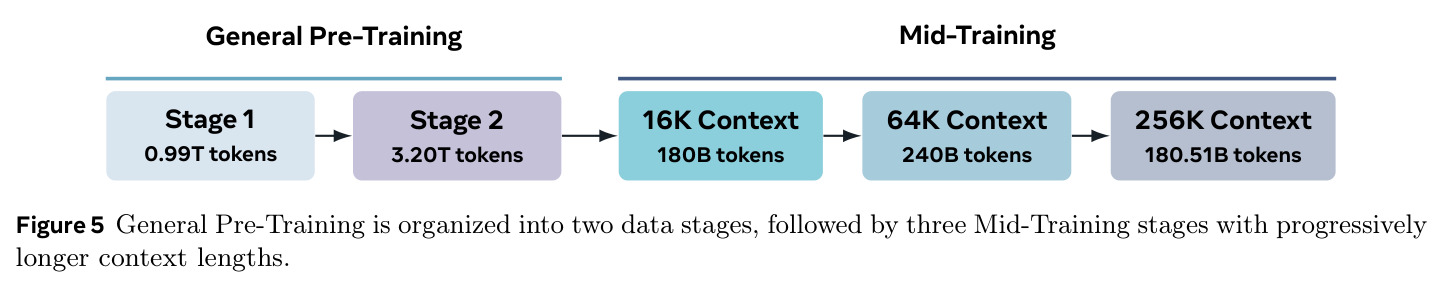
ZGCM-1 是一条四段式全栈管线。第一段架构与系统协同设计:32 层、7.39B 参数的 decoder-only Transformer(隐藏维 4096、SwiGLU 中间维 11008、GQA 32 查询头/8 KV 头、部分 RoPE 比例 0.33),以 5:1 比例交错 128-token 门控滑动窗口注意力(27 层)与全局注意力(5 层);矩阵参数用 Muon、标量用 Adam,矩阵乘用混合 FP8 加 TWEO 异常值抑制,在 H100 上稳定跑到约 585 TFLOP/s/GPU(约 60% BF16 等效 MFU)。第二段通用预训练:0.99T token 的课程式 Stage 1 加 3.20T 的 Stage 2。第三段中期训练:600.51B token 按 16K、64K、256K 三阶段渐进扩窗,混入重构为 MDP 的智能体轨迹。第四段后训练:492 万条 SFT 数据(激进质量剪枝约 50%)加 GRPO 混合强化学习。整条管线使 16K 预训练时间-损失加速约 4.2 倍,并通过 AI 原生研发流程让智能体参与数据处理、实验、评估与部署全周期。
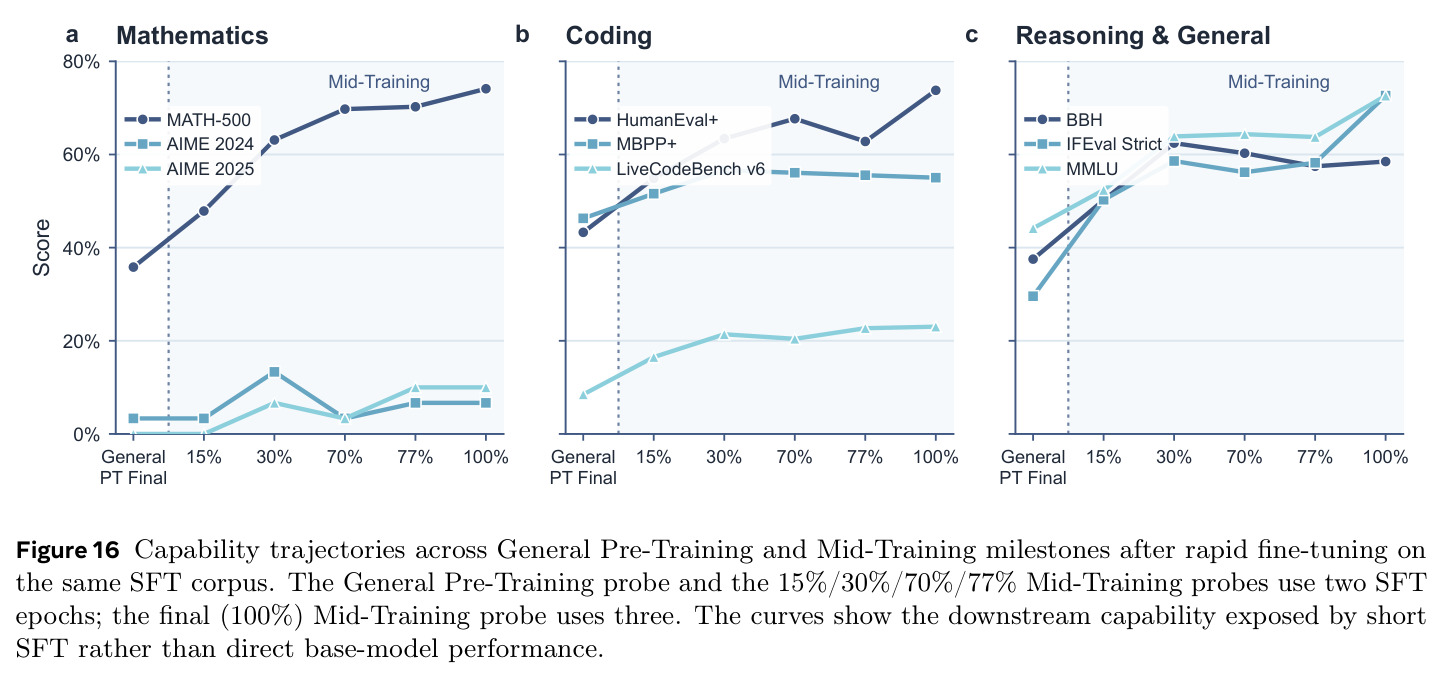
核心创新是把'小模型如何变强'的答案从堆参数转向双引擎机制。作者的前提是:7B 模型无法被动记住开放网络,但参数可以承载两件事——慢思考(长链推理)与主动求索(工具使用)。这带来两个本质区别。其一,中期训练把交互轨迹改写为 MDP 单步决策样本:任务描述加交互历史加环境反馈构成状态 $s_t$,模型在全序列因果目标下预测下一动作 $a_t$,使逐步决策监督直接进入预训练,而非像既有工作只在后训练稀疏地学智能体行为。其二,实验证明长上下文智能体能力应在中间训练阶段打下根基:短 SFT 探针显示中期训练把 MATH-500 从 35.83% 提到 74.12%、IFEval Strict 从 29.57% 提到 72.64%,且后训练只需中等长度 SFT 数据即可激活 256K 行为(Finding 7),绕开了收集 256K 长推理轨迹的高昂成本。配套的 5:1 门控 SWA、FP8+Muon+TWEO 让这一切在学术算力下可行。
方法步骤详情
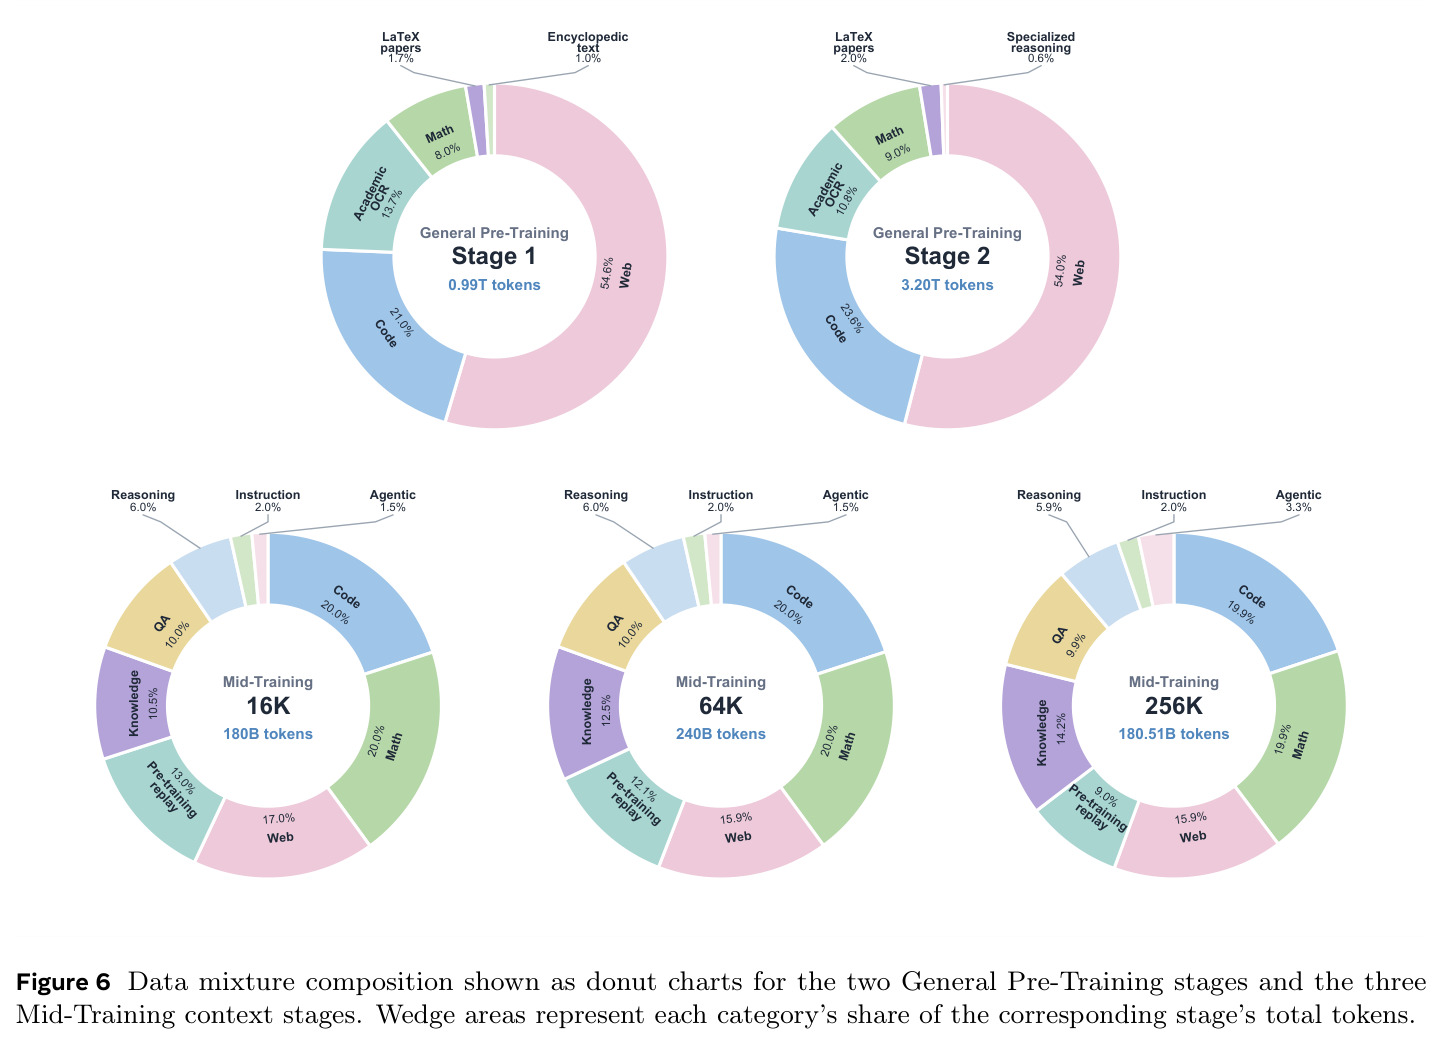
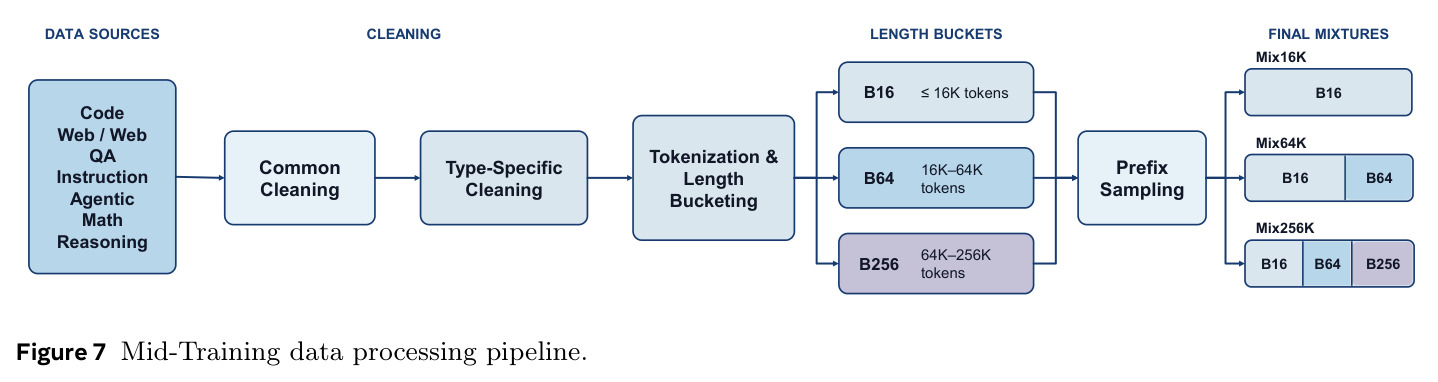
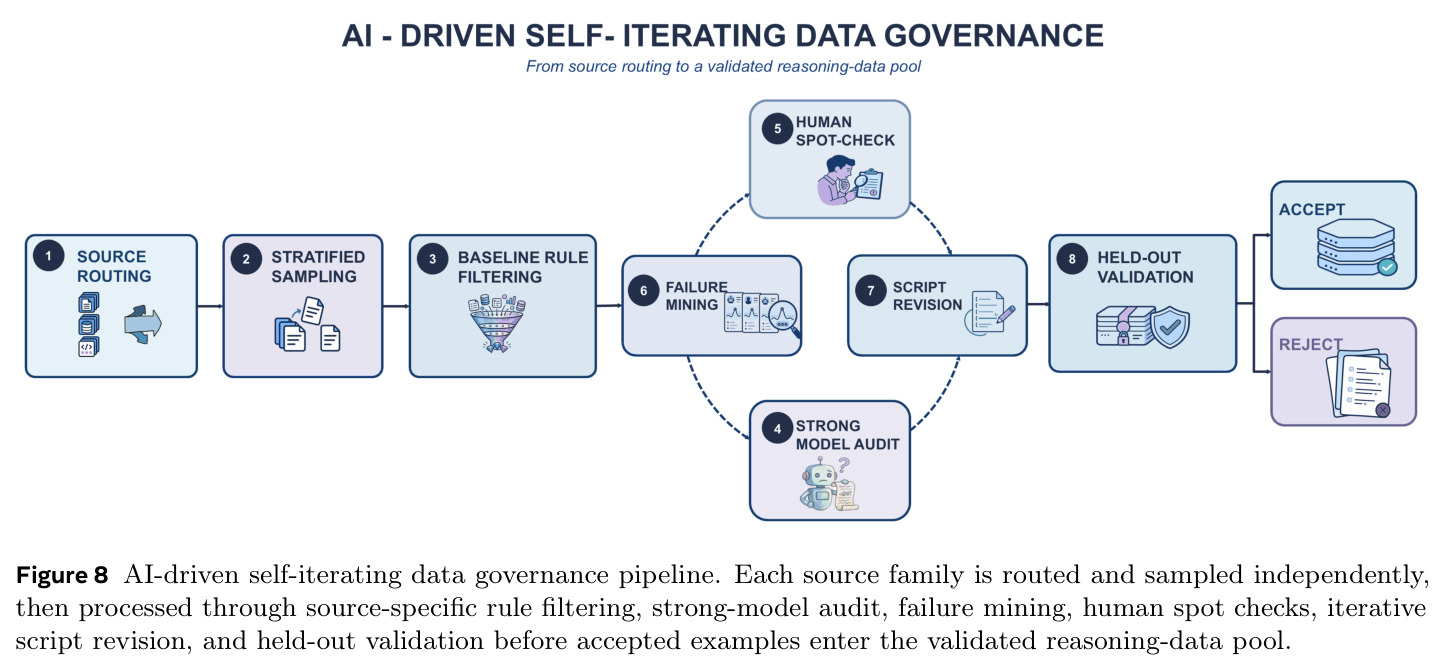
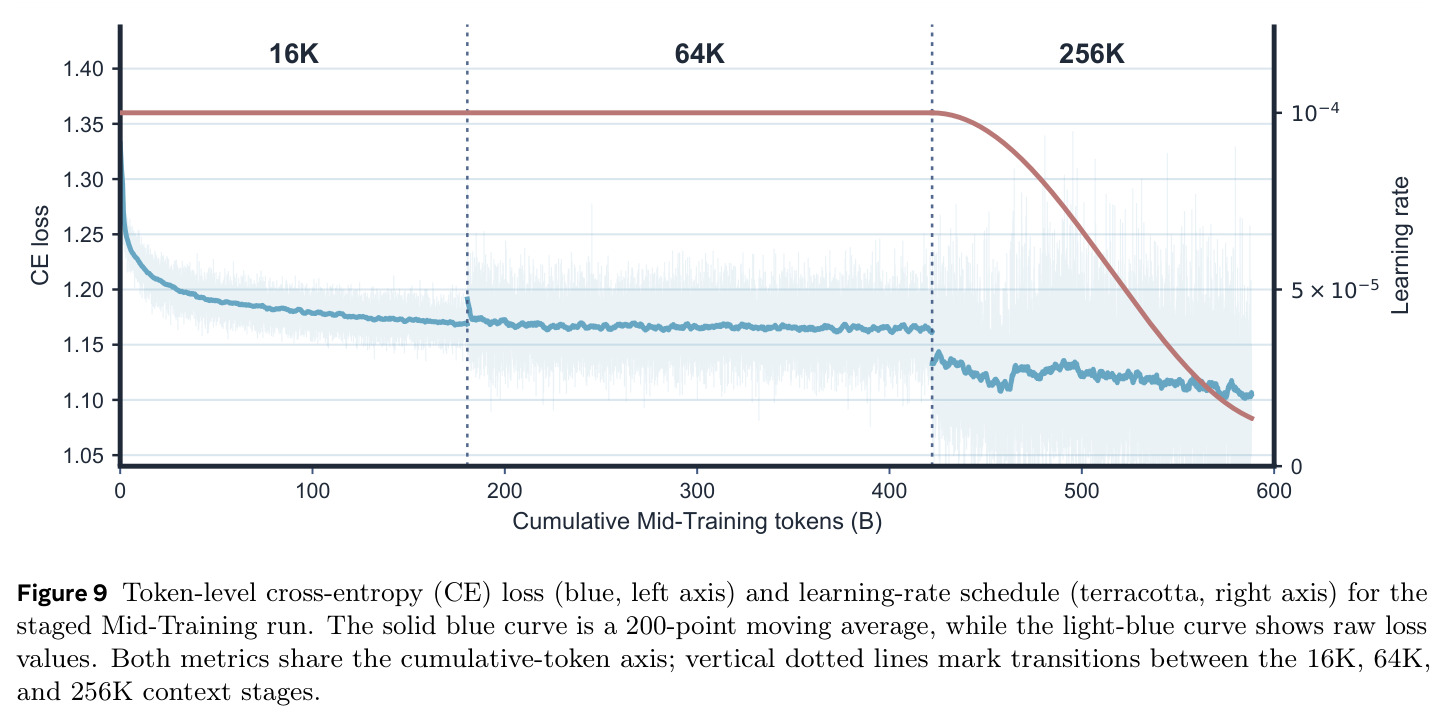
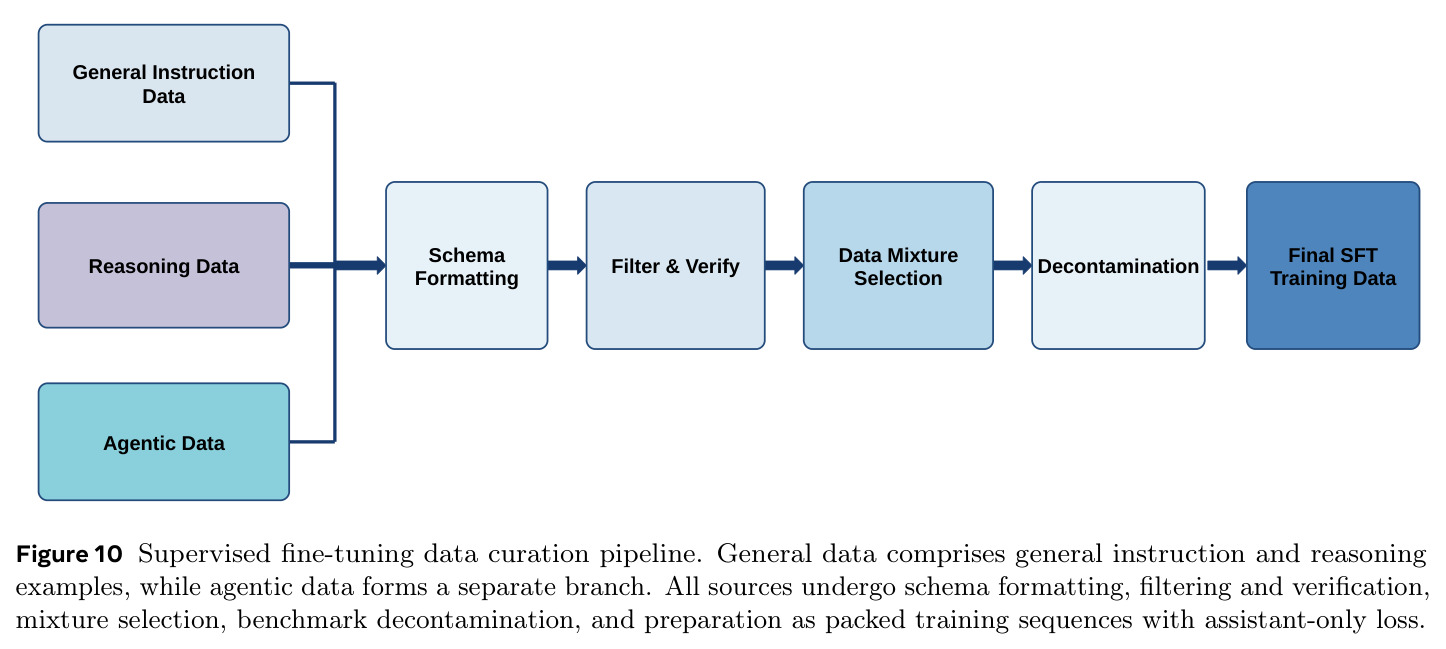
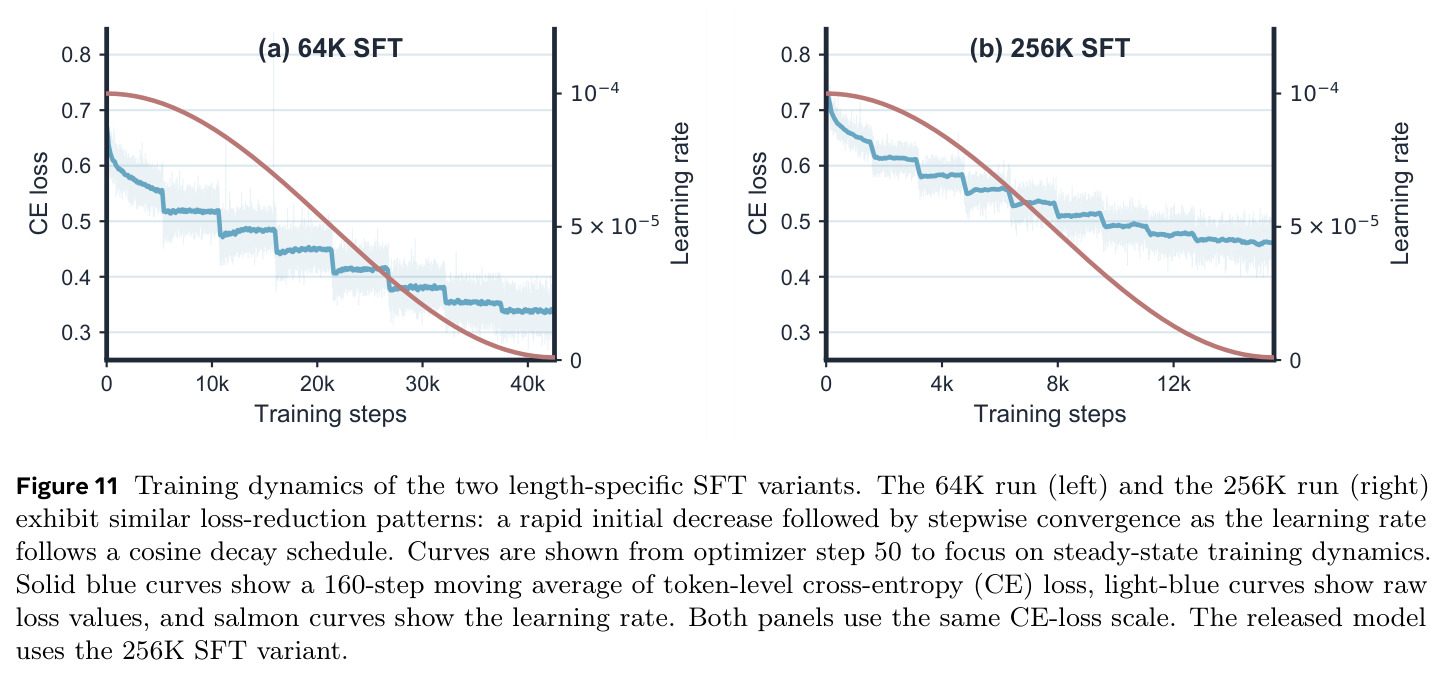
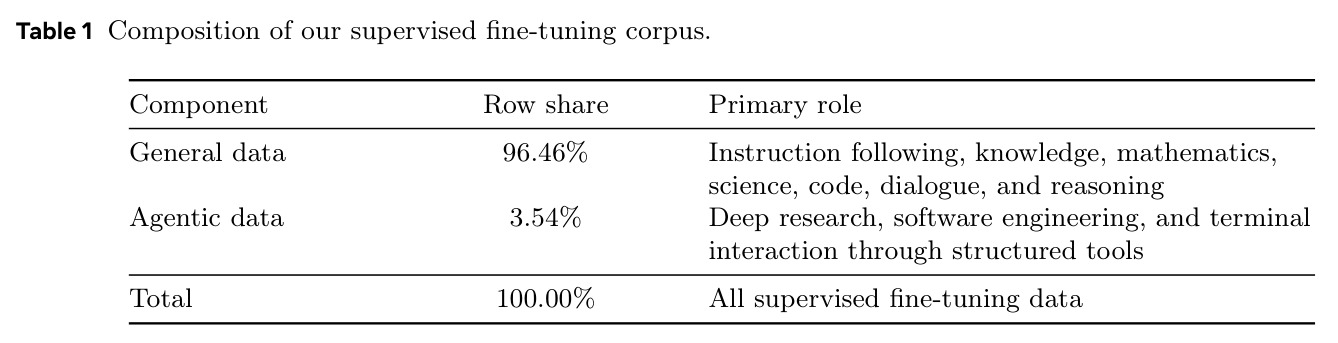
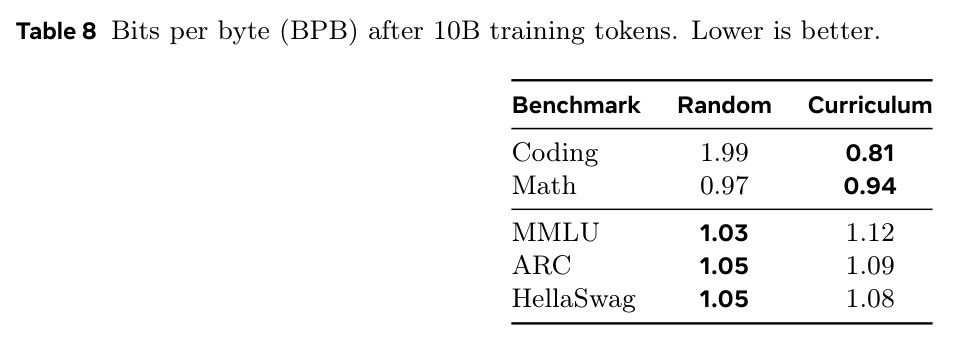
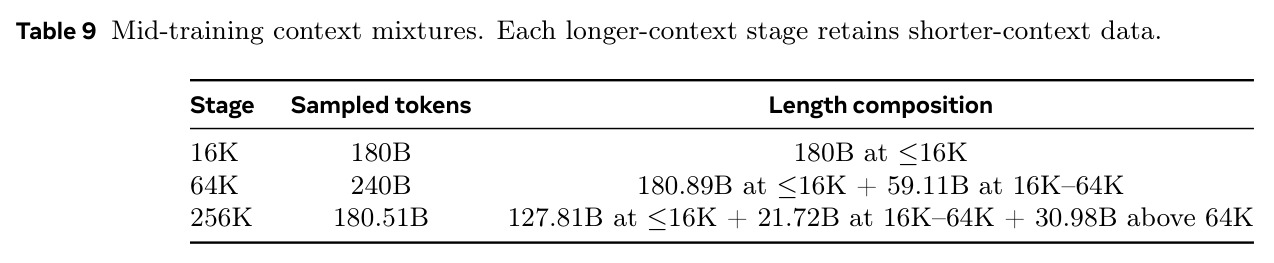
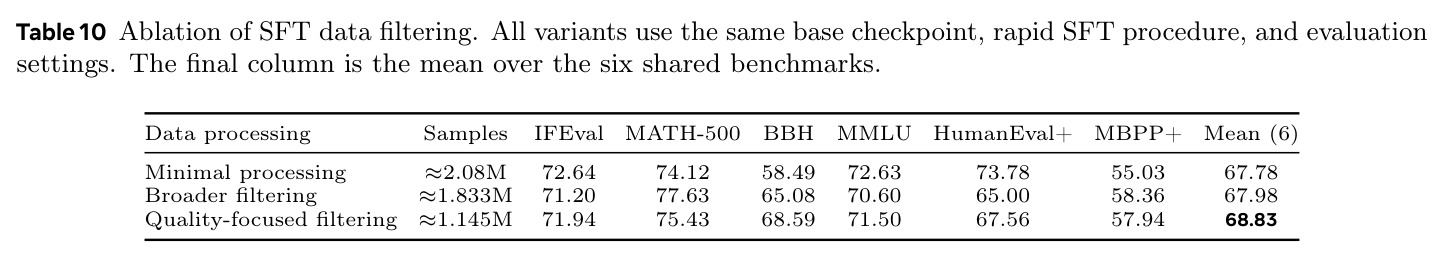
流程分五步。第一步配方搜索:用 0.3B 代理模型跑约 30B token,以损失与知识/代码/数学评测信号迭代调整混合比。第二步通用预训练:Stage 1(0.99T)按词汇复杂度对通用文本由易到难排序,代码与数学独立交错(编码 BPB 从 1.99 降至 0.81);Stage 2(3.20T)提高代码与数学占比并引入专门推理数据。第三步中期训练:从 2.86T 去重池采样 600.51B,依次在 16K(180B)、64K(240B)、256K(180.51B)上下文训练,智能体数据占比从 1.5% 增至 3.3%,交互轨迹重构为 MDP 状态-动作对,每步约 12.6M token;分段路线最终损失 1.16 优于直上 256K 的 1.19。第四步 SFT:492 万条样本经分层质量过滤,剪掉约 50% 反而更优(六基准均值 67.78 升至 68.83),think/no-think 混合、assistant-only 损失、通用与智能体数据联合交错。第五步 GRPO:数学用答案对错二值奖励、代码用通过测试比例,配合 KL 正则与温和长度惩罚。
技术新颖性
技术新颖性体现在四点。(1) 注意力配置由受控实验选出:同预算 10B token、8 张 H100 下横评全注意力、Flash-GQA、MLA 与 1:1/3:1/5:1 三种 SWA——SWA 5:1 吞吐最高(9,566 token/s/GPU)且尾损失 1.93 与全注意力持平,加速比随上下文从 4K 的 1.13 倍增至 256K 的 3.94 倍;KV 缓存 5.0 GiB 优于线性注意力 GDN 3:1 的 7.0 GiB 与全注意力的 32.0 GiB。(2) 效率增益按可分离因子显式分解:SWA 1.4 倍、FP8 1.5 倍、Muon 1.8 倍、Pre-LN 1.1 倍,相乘约 4.2 倍,每个因子可独立检验。(3) MDP 中期训练在不放弃全序列因果目标的前提下叠加步级监督,兼顾全轨迹上下文与局部决策密度。(4) 公开 8 条带数据支撑的经验发现——课程排序对代码/数学失效、SFT 质量胜过数量、长 CoT 过量损害指令遵循、think 训练正向迁移 no-think 等——这种连负结果与 trade-off 都完整披露的写法在技术报告中少见。
实验结果
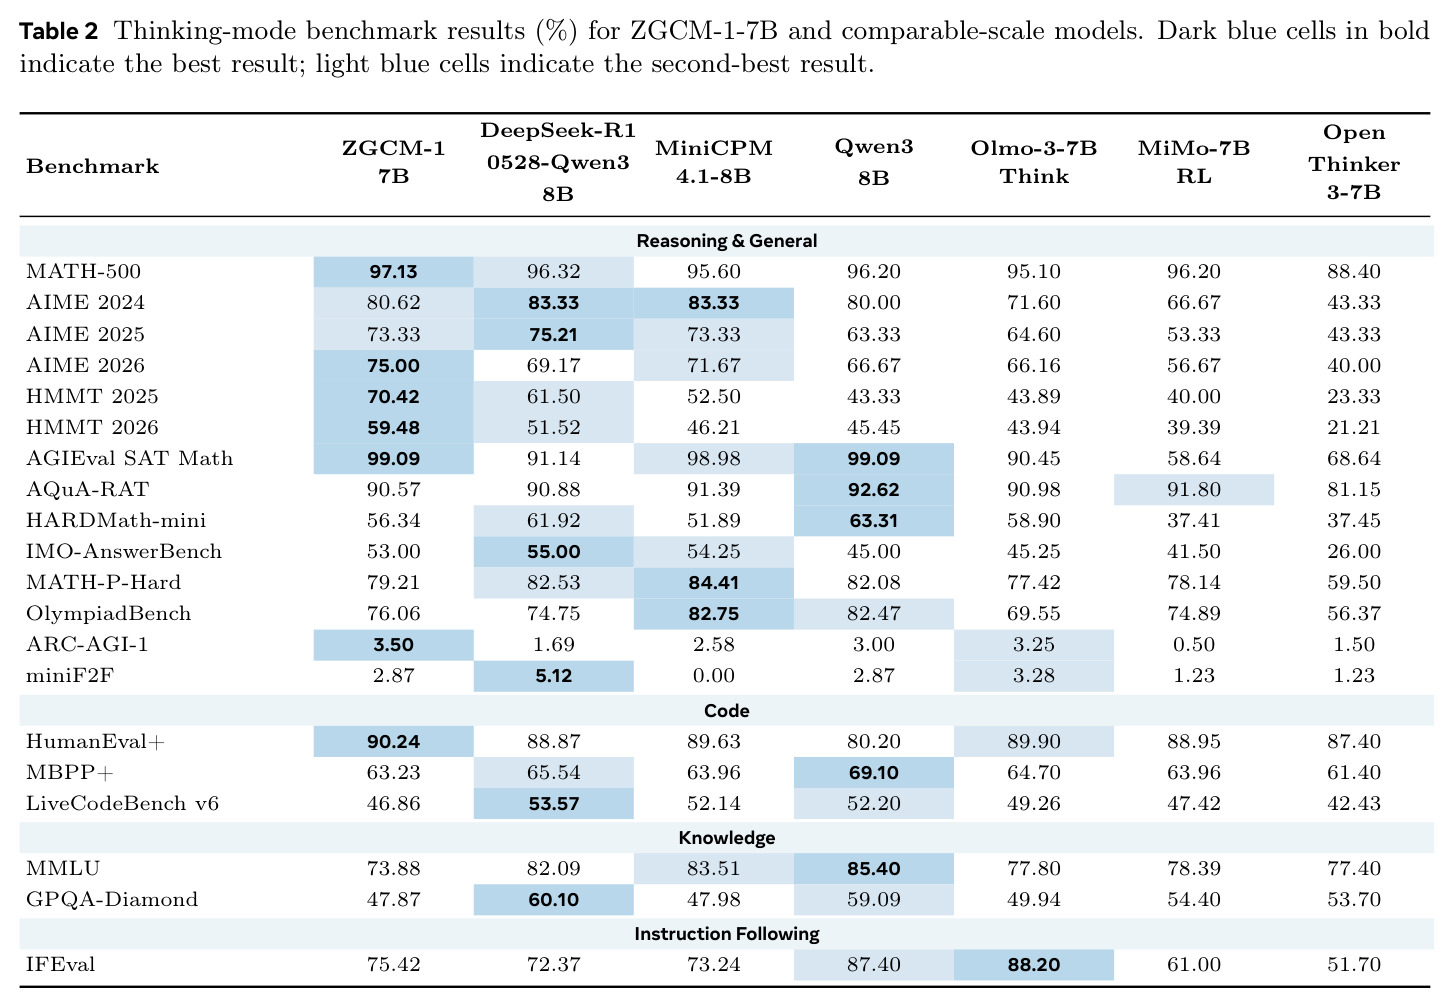
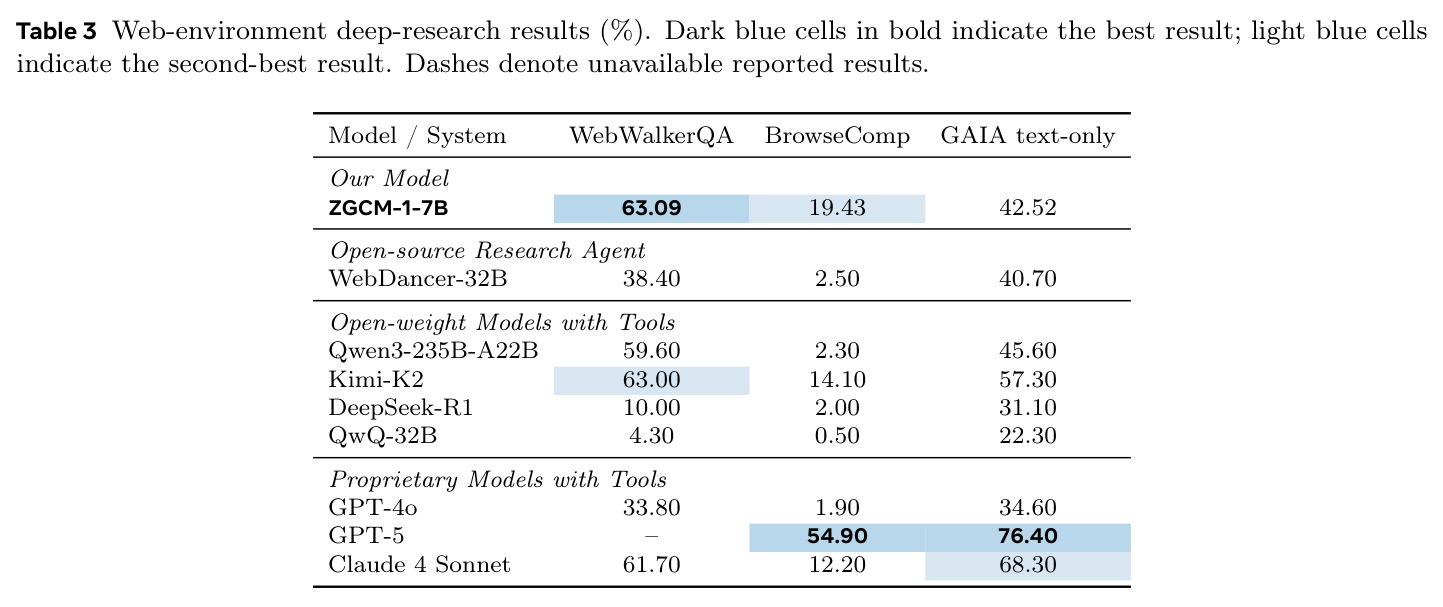
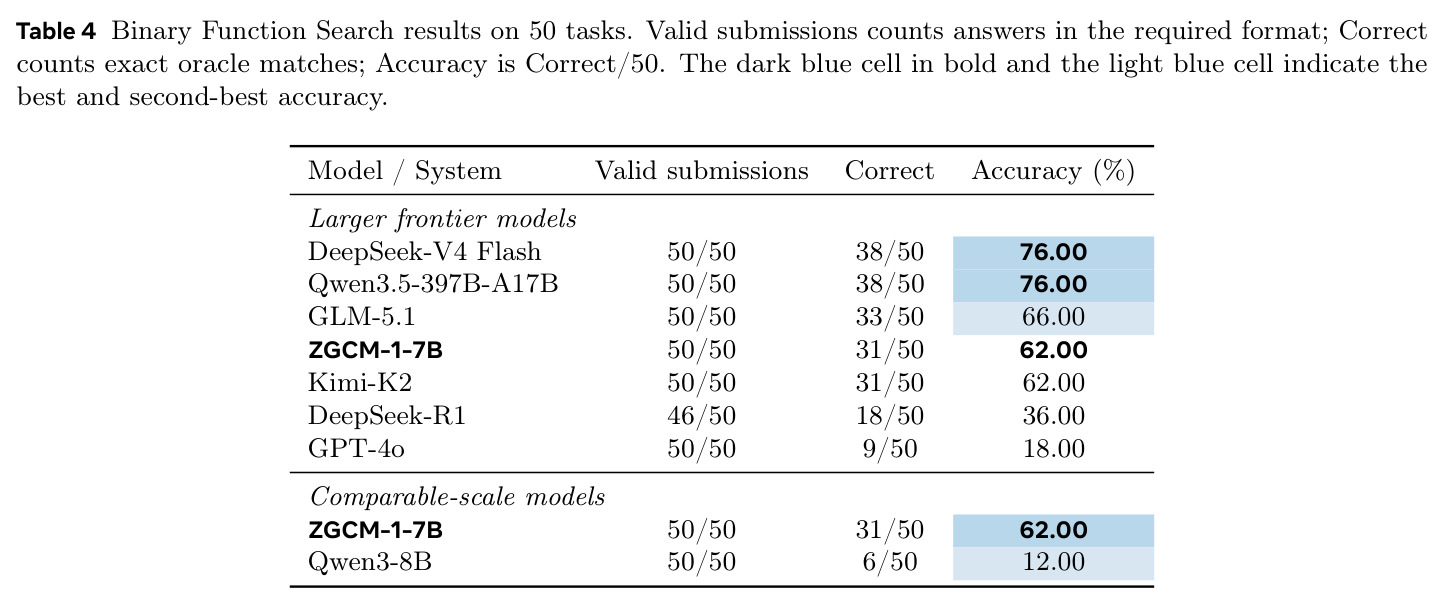
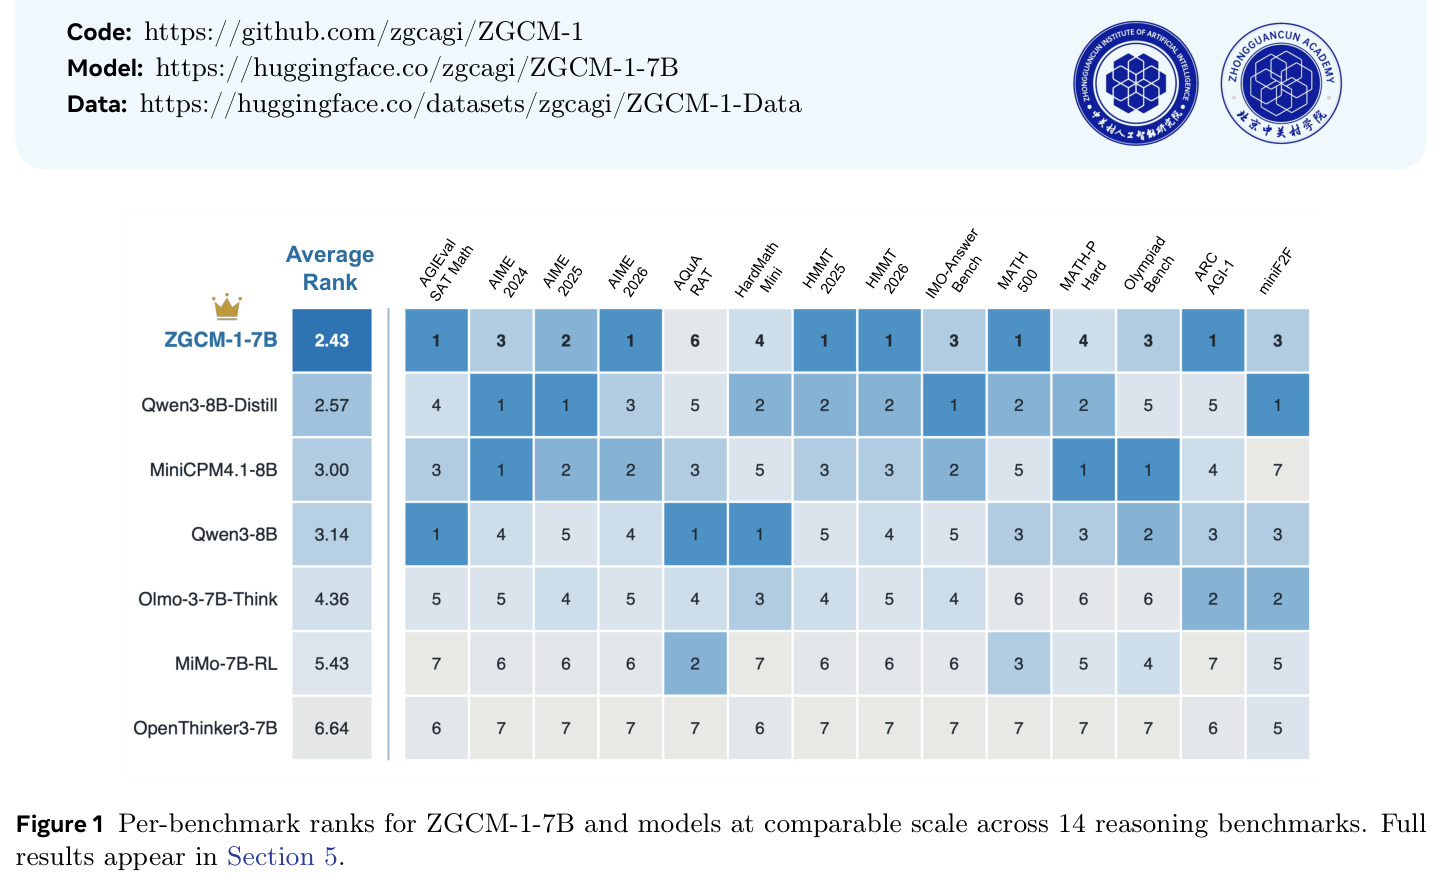
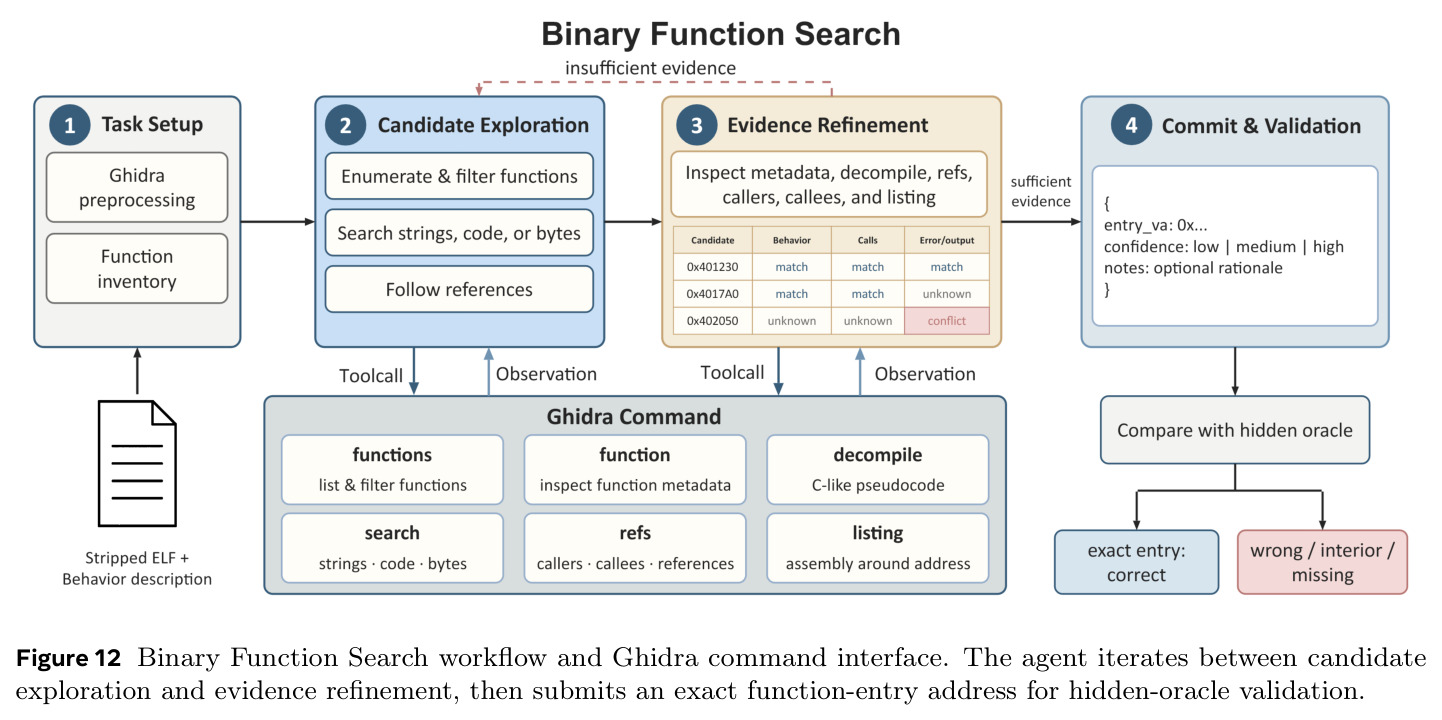
核心结论:ZGCM-1-7B 在 7B-8B 档 14 项推理基准平均第一。数学上 AIME 2026 得 75.00%(同档次优 71.67%)、MATH-500 97.13%、HMMT 2025 70.42%(次优仅 61.50%);AIME 2024/2025 与最强 R1 蒸馏 8B 互有胜负。HumanEval+ 90.24% 最佳,但知识任务落后:MMLU 73.88%(Olmo-3 为 85.40%)、GPQA 47.87%(R1 蒸馏 60.10%)。智能体侧比肩数十倍大的模型:WebWalkerQA 63.09% 超 Kimi-K2(63.00%)与 Claude 4 Sonnet(61.70%);BrowseComp 19.43% 远超 Kimi-K2 的 14.10%。Binary Function Search 50 任务命中 62%(31/50),是 Qwen3-8B(12%)的 5 倍多、逼近 GLM-5.1 的 66%。效率上 16K 预训练时间-损失加速约 4.2 倍;ACE 最强为数学 98.18%、最弱为指令遵循 49.74%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2026 竞赛数学 | pass@1(%,32 次运行均值) | 75.00 | Qwen3-8B 71.67;DeepSeek-R1-0528-Qwen3-8B 69.17 | +3.33 / +5.83 个百分点 |
| HMMT 2025 竞赛数学 | pass@1(%) | 70.42 | DeepSeek-R1-0528-Qwen3-8B 61.50 | +8.92 个百分点 |
| MATH-500 | pass@1(%) | 97.13 | MiniCPM4.1-8B 96.32 | +0.81 个百分点 |
| WebWalkerQA 开放网页深度研究 | 准确率(%) | 63.09 | Kimi-K2 63.00;Claude 4 Sonnet 61.70;Qwen3-235B-A22B 59.60 | +0.09 / +1.39 / +3.49 个百分点 |
| BrowseComp 深度网页搜索 | 准确率(%) | 19.43 | Kimi-K2 14.10;Claude 4 Sonnet 12.20 | +5.33 / +7.23 个百分点 |
| Binary Function Search 二进制函数定位 | 精确地址命中率(%,50 题) | 62.00 | Qwen3-8B 12.00;GPT-4o 18.00;GLM-5.1 66.00 | 对同规模 +50.00 个百分点;对 GLM-5.1 落后 4.00 个百分点 |
| 16K 预训练时间-损失 | 相对加速比 | 约 4.2 倍 | OLMo 3 风格 7B BF16/AdamW 基线 | SWA 1.4 倍 × FP8 1.5 倍 × Muon 1.8 倍 × Pre-LN 1.1 倍 |
| 256K 上下文推理 KV 缓存 | 显存(GiB,batch=1,bf16) | 5.0 | 全注意力 32.0;GDN 3:1 线性注意力 7.0 | 6.4 倍缩减 |
| SFT 数据质量剪枝消融 | 六基准平均分 | 68.83(仅保留 1.145M 高质量样本) | 最简处理全量 2.08M 样本得 67.78 | 样本少 44.9% 而均值 +1.05 |
局限与改进
作者承认四条局限:(1) 参数知识边界——纯闭卷、依赖记忆的任务天然落后于巨型模型,MMLU 73.88 对 Olmo-3 的 85.40、GPQA 47.87 对 R1 蒸馏的 60.10;(2) 推理冗长与指令遵循互相牵制,重推理监督诱发冗长偏置,ACE 指令类别仅 49.74%;(3) 通用软件与终端智能体尚幼稚——SWE-bench Verified Mini50 仅解 2/50(4.0%),Terminal-Bench 2.0 仅 2/89(2.25%);(4) 环境与协议脆弱,严重依赖 schema 对齐与稳定反馈。我的补充观察:miniF2F 仅 2.87%、ARC-AGI-1 仅 3.50%,形式化证明与抽象推理几乎未解决;BFS 评测仅 50 题,统计功效有限;Web 结果依赖搜索 API 与裁判模型(Qwen3-30B-A3B),跨论文可比性存疑;RL 章节只给配置而未报告消融增益数字;AI4AI 的 99 份评分是主观序数判断;no-think 模式下 HumanEval+ 因混合训练反降 7.32 个点。
独立分析的弱点
独立分析出的弱点与改进方向:(1) 知识型任务短板——7.39B 参数上限决定 MMLU/GPQA 差距,可加入教师蒸馏或把检索前移进预训练;(2) 形式化定理证明近乎空白(miniF2F 2.87%),应接入 Lean/Isabelle 执行器反馈做专用 RL;(3) 仓库级软件工程(4.0%)与终端任务(2.25%)暴露交互式 RL 的缺失——目前 RL 增益集中在数学/代码单域结果奖励,需在可执行沙箱内做多轮端到端 RL;(4) think 到 no-think 迁移有代价(HumanEval+ -7.32、MMLU -2.60),混合配比需 ACE 式诊断信号自动闭环校准;(5) 4.2 倍加速是四因子相乘的估计而非单一受控 A/B,Pre-LN 的 1.1 倍仅来自探索性 7B 证据;(6) FP8 稳定性依赖 TWEO,缺少去掉 TWEO 的失败模式分析;(7) BFS 评测仅 50 题且未报方差,应扩到数百题并给置信区间;(8) Web 深度研究结果强依赖第三方搜索 API 时效与行为,需报告重跑稳定性。
未来方向
作者提出四个方向:(1) 把混合 SWA、Muon 优化与 MDP 中期训练配方推广到稀疏 MoE 骨干,在保持低推理 FLOPs 的同时扩大参数容量与领域专精;(2) 从 token 级 SFT 与结果奖励转向真实执行沙箱(终端、网页、编译器)内的多轮交互式端到端 RL,直指其最弱的 SWE/Terminal 能力;(3) 统一预训练表征与在线自主检索,使模型在检测到参数不确定性时动态触发搜索子程序,正面回应闭卷知识边界;(4) 把 AI4AI 智能体体系从集群运维、数据治理、原子评测扩展到自主假设提出、自动内核优化与闭环合成环境设计。基于其成果还可延伸:用 ACE 的 183 项原子能力做自动课程生成,让 SFT 数据配比由诊断信号闭环驱动;把 BFS 的 11,767 题池与 Ghidra 工具链发展为二进制分析领域的标准智能体基准;利用其公开的全阶段检查点与 W&B 日志,系统研究'MDP 中期训练对下游 RL 可塑性的因果贡献'这类社区长期缺乏数据的问题。
复现评估
复现友好度在同类工作中属最高档:GitHub(zgcagi/ZGCM-1)与 HuggingFace 公开预训练、中期训练、后训练三阶段权重、中间检查点、训练代码与配置、分阶段数据集与配方、W&B 遥测日志和全部评测 harness,Binary Function Search 数据集(11,767 题、529 项目)承诺公开。评测协议高度透明:think 模式温度 1.0、top-p 1.0、非智能体基准报 32 次 pass@1 均值,附录 C 完整给出 Web 研究与 BFS 的交互协议(Serper 搜索 + Jina Reader 抽取 + Qwen3-30B-A3B 裁判;Ghidra gcmd 六动作接口)。算力方面:架构对比实验 8 张 H100 即可复现;中期训练与 SFT 规模中等(每步约 12.6M token,SFT 仅 19.46B 打包 token);但完整 4.19T token 预训练需要大规模 H100 集群,学术团队难以整体重跑。总体难度评估:推理复现容易(权重开放),架构与配方级复现中等,全量预训练复现困难。
论文图表
左半部分对比 7B 规模与前沿模型在推理与智能体基准上的得分(MATH-500 97.1、AIME 2026 75.0、BrowseComp 19.4、BFS 62.0 等),右半部分概括四大技术亮点:FP8+Muon+TWEO 约 4.2 倍加速、混合注意力、MDP 中期训练、AI 原生研发。
论文的导读图,同时给出性能主张与四条技术路线的全景,是建立全文框架的入口。
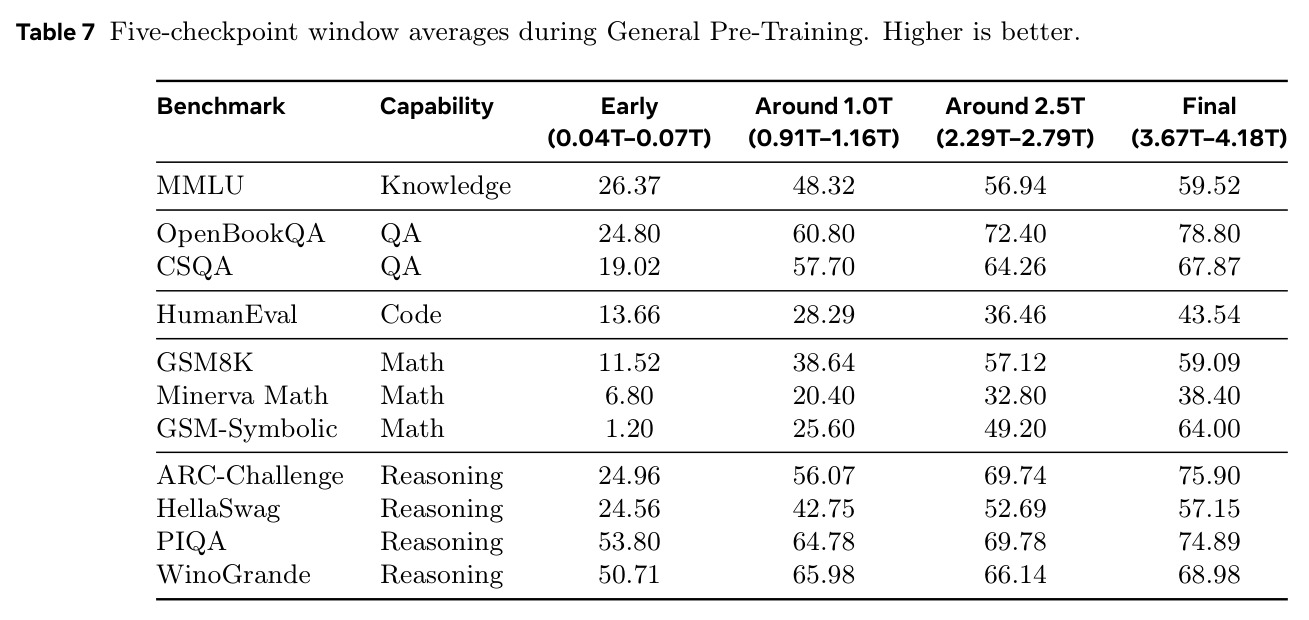
对 0.04T 至 4.19T 累计 token 的 54 个基座检查点直接评测:MMLU 从 26.37% 升至 59.52%、GSM-Symbolic 从 1.20% 升至 64.00%、HumanEval 从 13.66% 升至 43.54%;多数增益在 2.5T 前到来,代码与难数学在后期持续提升,呈领域非同步动态。
支撑'通用预训练边际收益不均、需要能力导向中期训练'的动机论证。
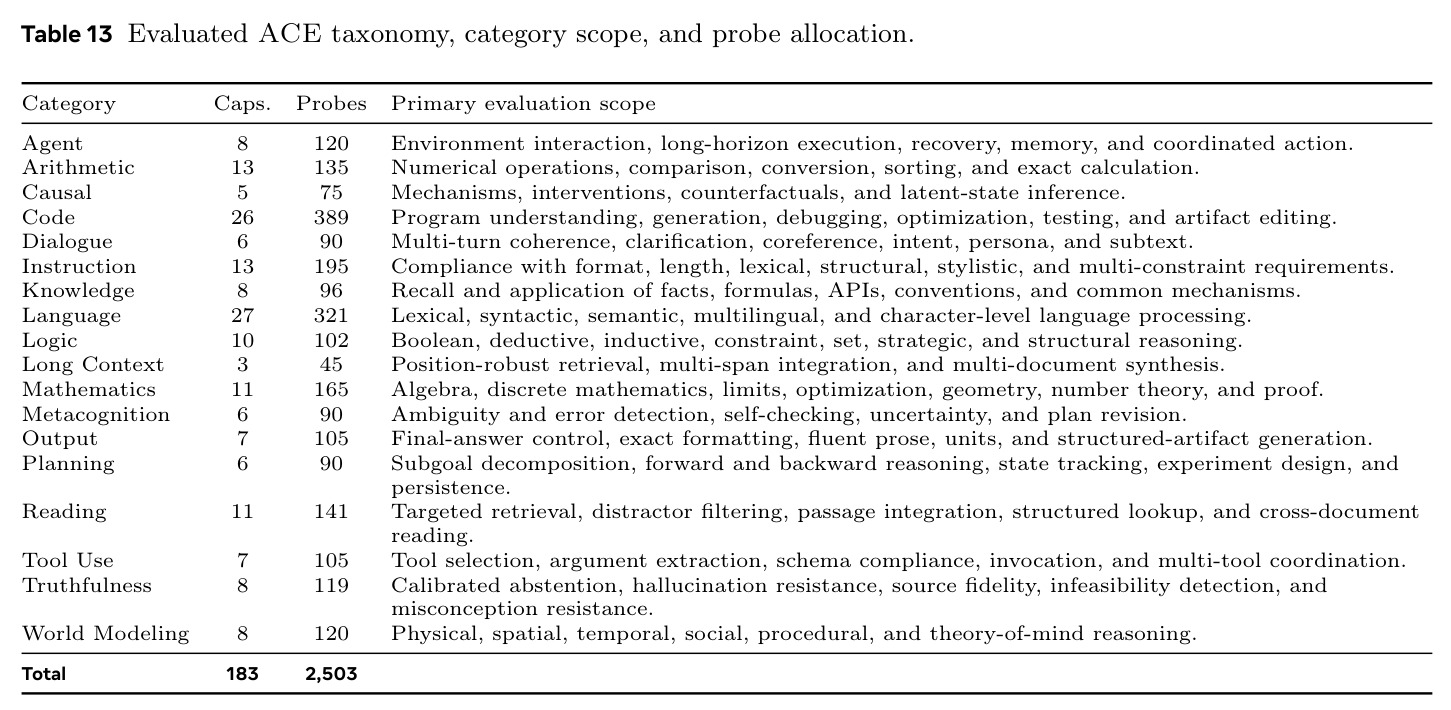
ACE 原子能力评测热力图(18 类别):ZGCM-7B 最强项为数学 98.18%、规划 97.78%、逻辑 96.08%、因果 96.00%、阅读 95.04%;最弱为指令遵循 49.74%、真实性 68.91%、代码 72.24%、语言 79.75%;相对 Qwen3-8B-256K 长上下文高 31.11 个百分点、算术高 20.74。
给出比聚合基准更细粒度的能力画像,精确定位与前沿模型的差距集中在哪里。