Dynin-Robotics:全模态统一扩散视觉-语言-动作模型 Dynin-Robotics: Omnimodal Unified Diffusion Vision-Language-Action Model
单一掩码扩散骨干统一动作、世界模型、目标态与任务理解四目标,支持推理组合与29倍加速
前置知识
视觉-语言-动作模型(VLA)
将自然语言指令与视觉观测映射为机器人动作的多模态基础模型。主流路线有二:VLM-based(如 RT-2、OpenVLA、π0 系列,在视觉-语言骨干上接动作专家或动作 token 头)与视频/世界模型驱动(如 Mimic-Video,用视频生成模型辅助控制)。策略通常一次预测 H 步动作块(action chunk),以恒定频率滚动重规划执行。
本文正是在 VLA 框架内工作,对比对象全是 π0.5、OpenVLA-OFT、Mimic-Video 等代表性 VLA,理解它们的输入输出接口与建模范式才能看懂实验设计和 Table 1 的能力对比。
掩码扩散语言模型(Masked Diffusion LM)
与自回归模型从左到右逐 token 生成不同,掩码扩散模型把部分 token 替换为 [MASK],用双向 Transformer 在可见上下文条件下并行预测所有被掩码位置,逐步提交高置信度 token、保留低置信度位置继续细化(迭代去噪)。代表工作有 MDLM、LLaDA、Dream,天然支持双向上下文、并行解码和灵活的生成顺序。
本文整套方法建立在掩码扩散的"改可见上下文=换任务"机制上:文本、图像、动作都在同一套 [MASK] 去噪接口下生成,这是理解其统一目标设计与六种推理组合的前提。
动作分块与离散化(Action Chunking & Binning)
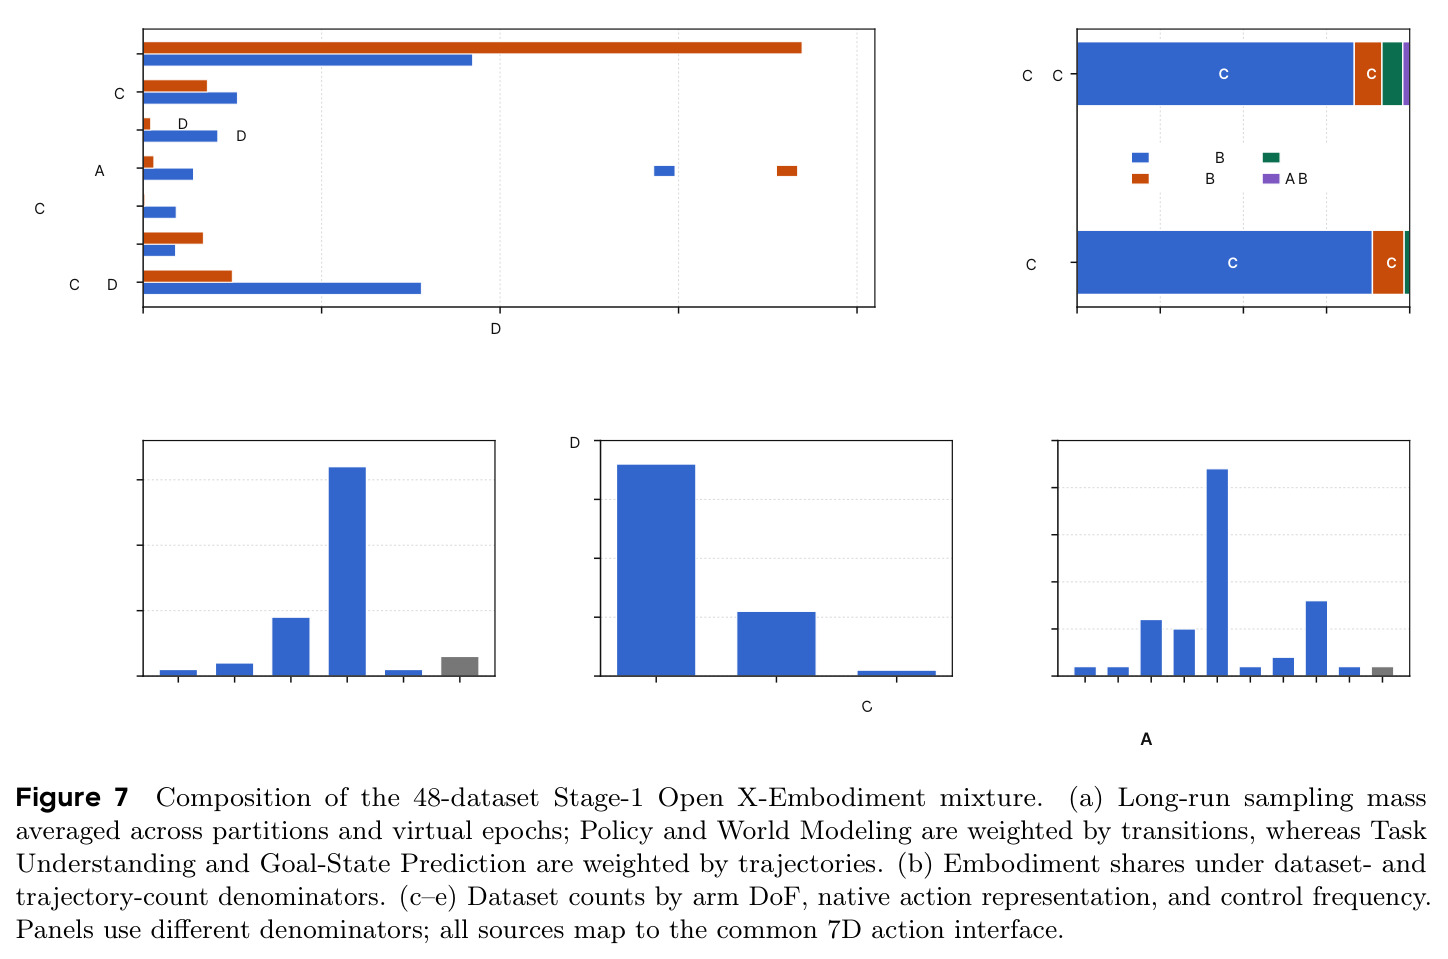
机器人策略通常一次预测未来 H 步动作(本文 H=5、7 自由度,共 35 个标量),再滚动重规划。连续动作需离散化才能进入语言模型式骨干:对每个通道做鲁棒分位数归一化到 $[-1,1]$,再均匀分箱成 $B_A$ 个 bin 并映射到保留 token 段,生成后逆量化回连续控制。
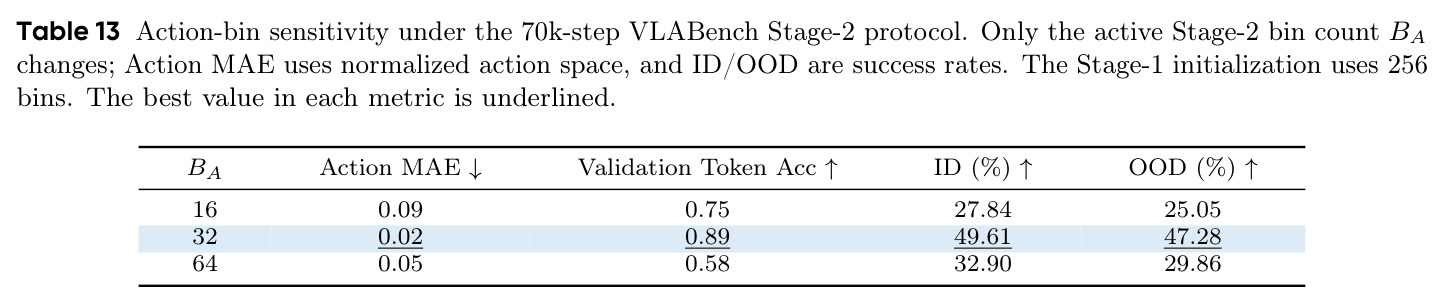
论文用多个公式严格定义了这套量化/逆量化流程,且 bin 数 $B_A$ 的选择(16/32/64)会使 VLABench 成功率在 27.8%~49.6% 间剧烈变化,是理解方法细节与超参消融的关键。
世界模型与目标状态预测
世界模型预测"执行某动作后环境会变成什么样"(动作条件的下一帧视觉);目标状态预测预测"任务完成时画面应该长什么样"(终态图像)。前者刻画动作依赖的局部动态,后者提供任务语义的视觉终点,二者都可作为控制时的附加条件或候选项评估信号。
本文把这两个预测与策略学习、任务理解统一进同一个掩码扩散模型,并在推理时以多种方式组合它们(目标引导、联合去噪、候选重排),这正是全文的核心卖点与主要实验对象。
测试时扩展(Test-time Scaling)
不改变模型参数,通过在推理阶段分配更多计算来提升性能:例如先生成目标图像再解码动作、采样多个动作候选并用世界模型能量打分重排、或将动作与未来帧联合去噪。代价是推理吞吐下降,需要在成功率与延迟之间权衡。
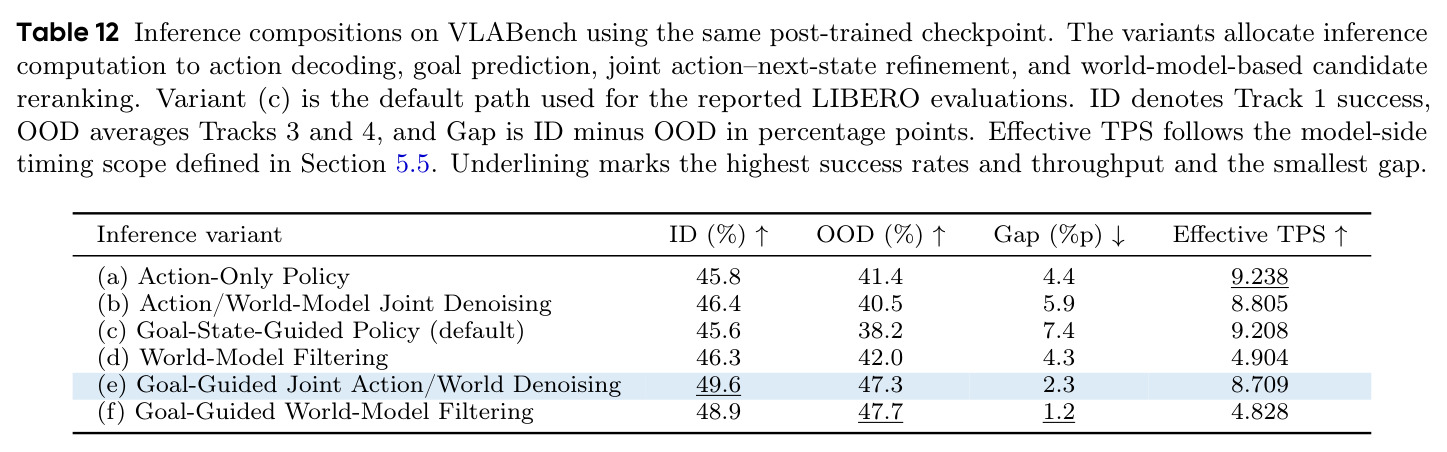
本文的 6 种推理组合就是测试时扩展的具体实例,Table 12 逐一量化了每种组合的成功率收益与有效吞吐成本(如过滤组合吞吐降约 44.6% 换 0.4 点 OOD 提升),是结论的核心部分。
研究动机
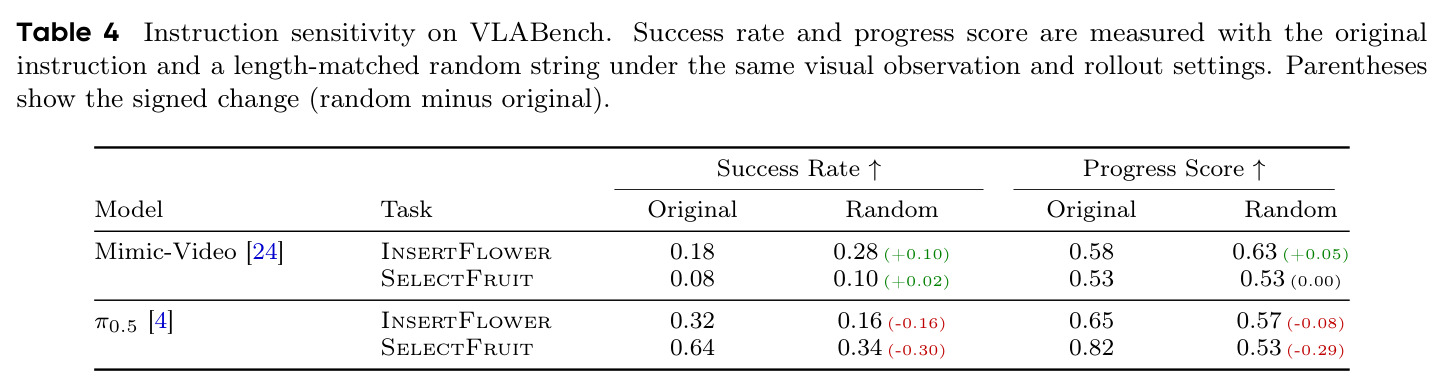
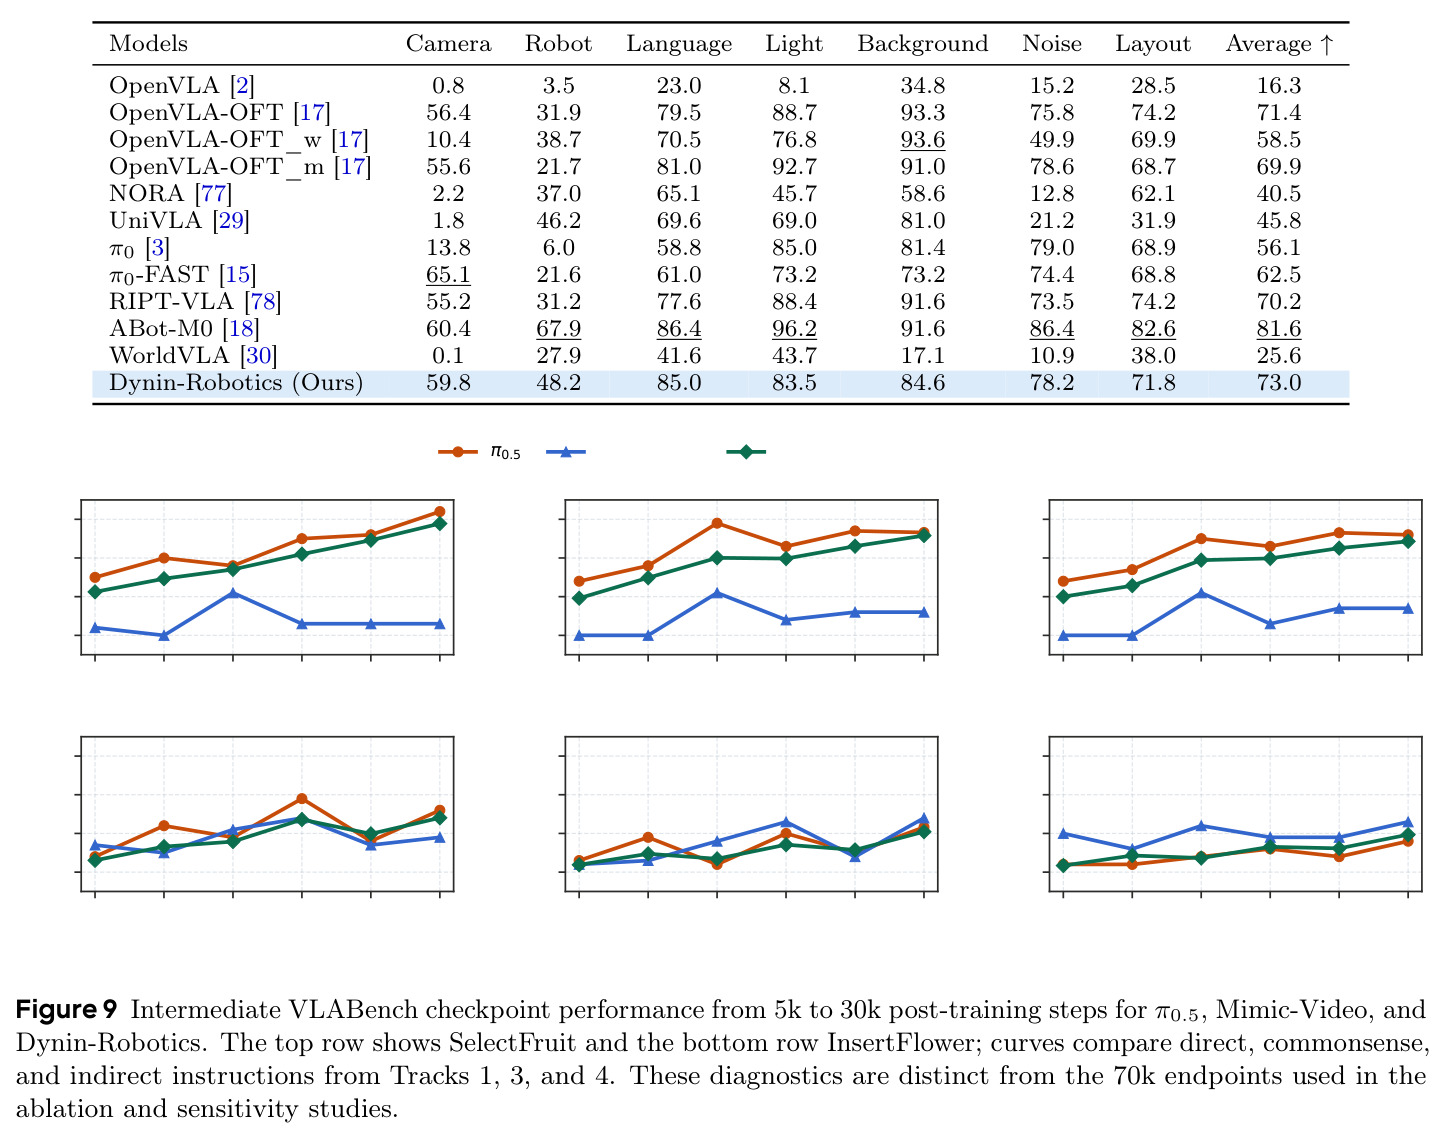
现有 VLA 分两大阵营,监督来源不同且行为差异显著。作者用 VLABench 的 SelectFruit(跨物体/布局按指令选水果)和 InsertFlower(抓取-对齐-插入)对比 π0.5 与 Mimic-Video:SelectFruit 上 π0.5 各指令轨道全面领先,InsertFlower 上 Mimic-Video 在间接语义指令(Track 4)下更有竞争力。指令敏感性更截然相反:把指令换成等长随机字符串后,π0.5 成功率暴跌 16 和 30 个百分点(0.32→0.16、0.64→0.34),Mimic-Video 反而 +10 和 +2(0.18→0.28、0.08→0.10)。这说明 VLM-based 策略重度依赖语言条件化、视频生成式策略依赖视觉预测,二者是互补的监督信号,但现有方法各自只取一头。此外掩码扩散式 VLA 的迭代去噪解码很慢(基线解码器仅 9.2 有效 TPS,约 3.8 秒生成一个动作块),制约实际部署。
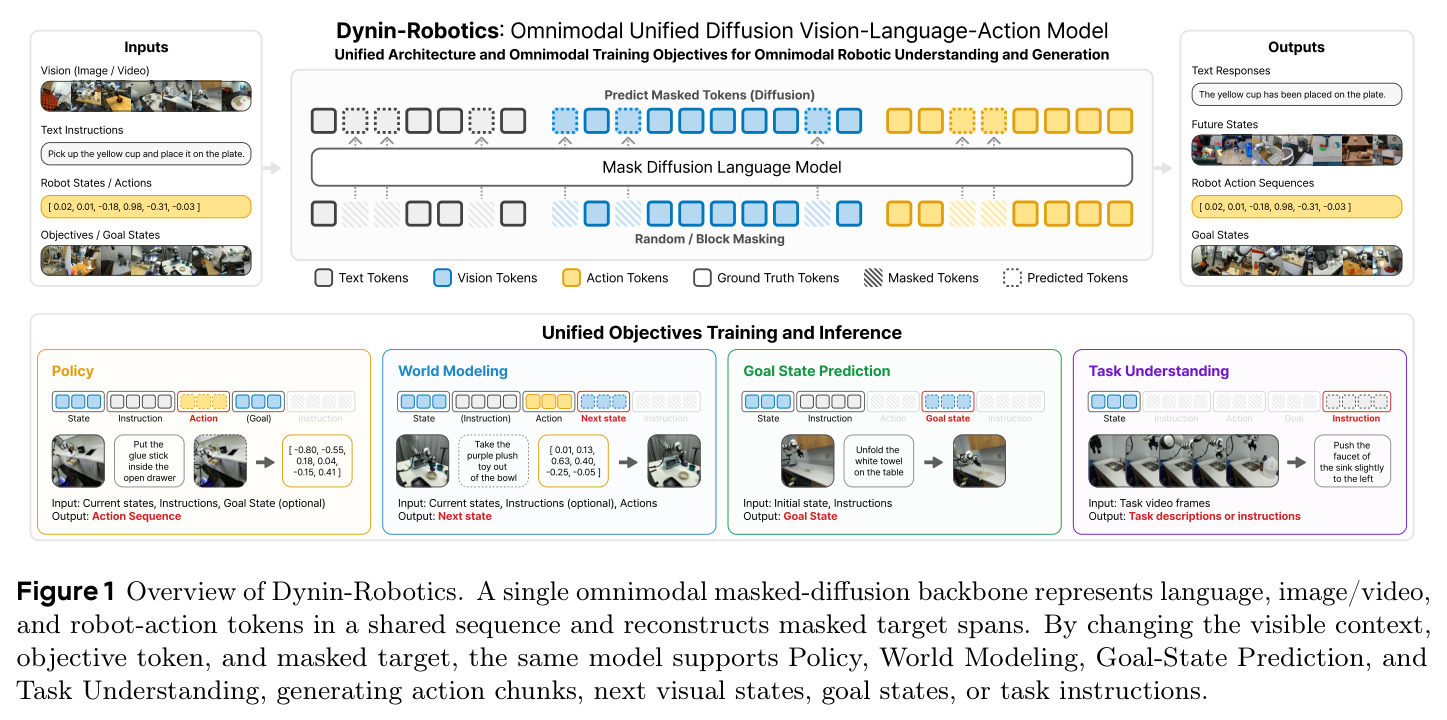
本文的目标是本文的目标是构建一个统一的视觉-语言-动作基础模型 Dynin-Robotics:把语言指令、视觉观测、目标图像、机器人动作统一表示为同一离散 token 空间中的类型化序列,在单一全模态掩码扩散骨干 Dynin-Omni 上,通过改变可见上下文与掩码目标,用同一套参数同时学习四个互补目标——Policy(动作预测)、World Modeling(动作条件下一帧预测)、Goal-State Prediction(终态目标图像生成)、Task Understanding(轨迹帧到指令重建)。在此之上,作者希望同一模型在推理时能以多种方式组合这些预测(目标引导两阶段解码、动作-下一帧联合去噪、世界模型候选重排等共六种),实现测试时扩展;并通过块并行解码与 dInfer 推理栈优化把动作生成加速到可部署水平;最终在 LIBERO、零样本 LIBERO-Plus、VLABench 和真实 Franka Research 3 平台上验证统一建模不会牺牲策略性能。
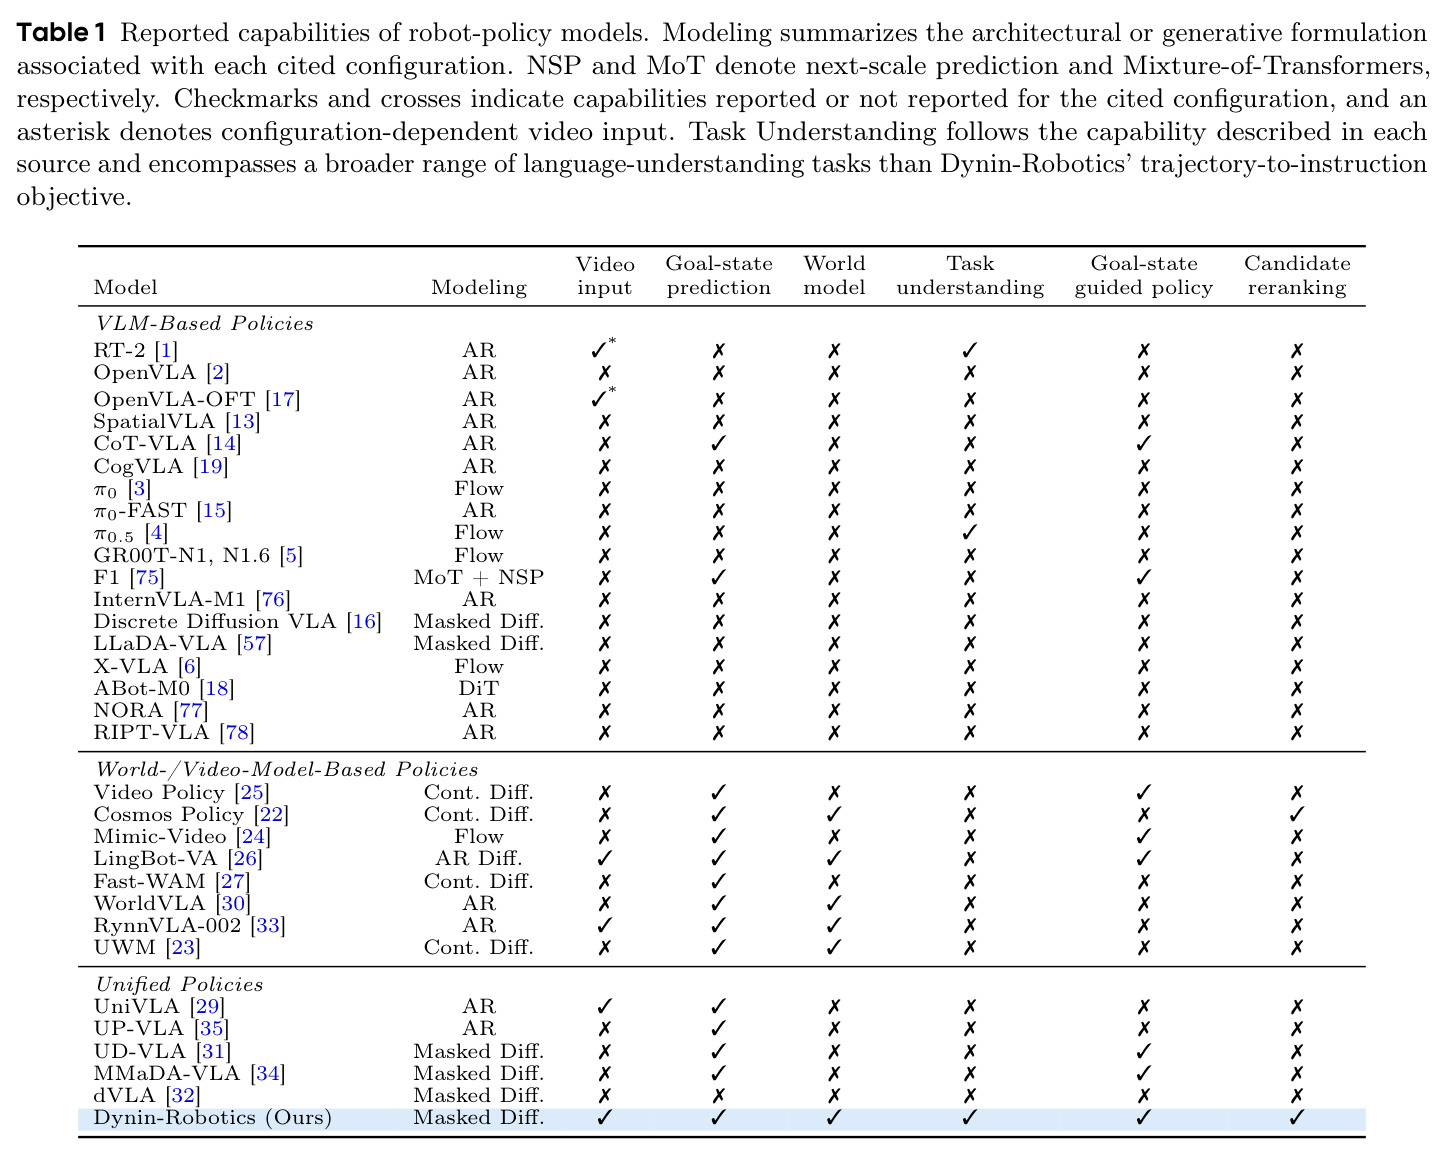
与已有工作不同的是,本文的独特切入是不做"VLM 骨干 + 动作专家"或"视频生成器 + 动作专家"的外挂式拼接,而是把整条机器人轨迹——指令、观测、动作、下一帧、目标图像、可选传感器流——当作同一序列里的不同类型 span,让"换任务"退化为"选择哪些 span 可见、哪些 span 被掩码"这一掩码扩散天然支持的操作。四个训练目标因此共享同一骨干、同一嵌入、同一分类预测头;推理时还能构造训练中不存在的"复合掩码"(如同时掩码动作 span 和下一帧 span,复用训练过的目标标记做联合去噪)。论文 Table 1 的能力矩阵显示:VLM-based 策略(π0、OpenVLA 等)几乎不具备目标态预测与世界模型能力,世界模型系(Cosmos Policy、UWM 等)缺乏任务理解与目标引导,已有统一模型(UniVLA、UD-VLA、MMaDA-VLA、dVLA)最多覆盖两三项——本文是唯一在视频输入、目标态预测、世界模型、任务理解、目标引导策略、候选重排六个能力上全部打勾的模型。
核心方法
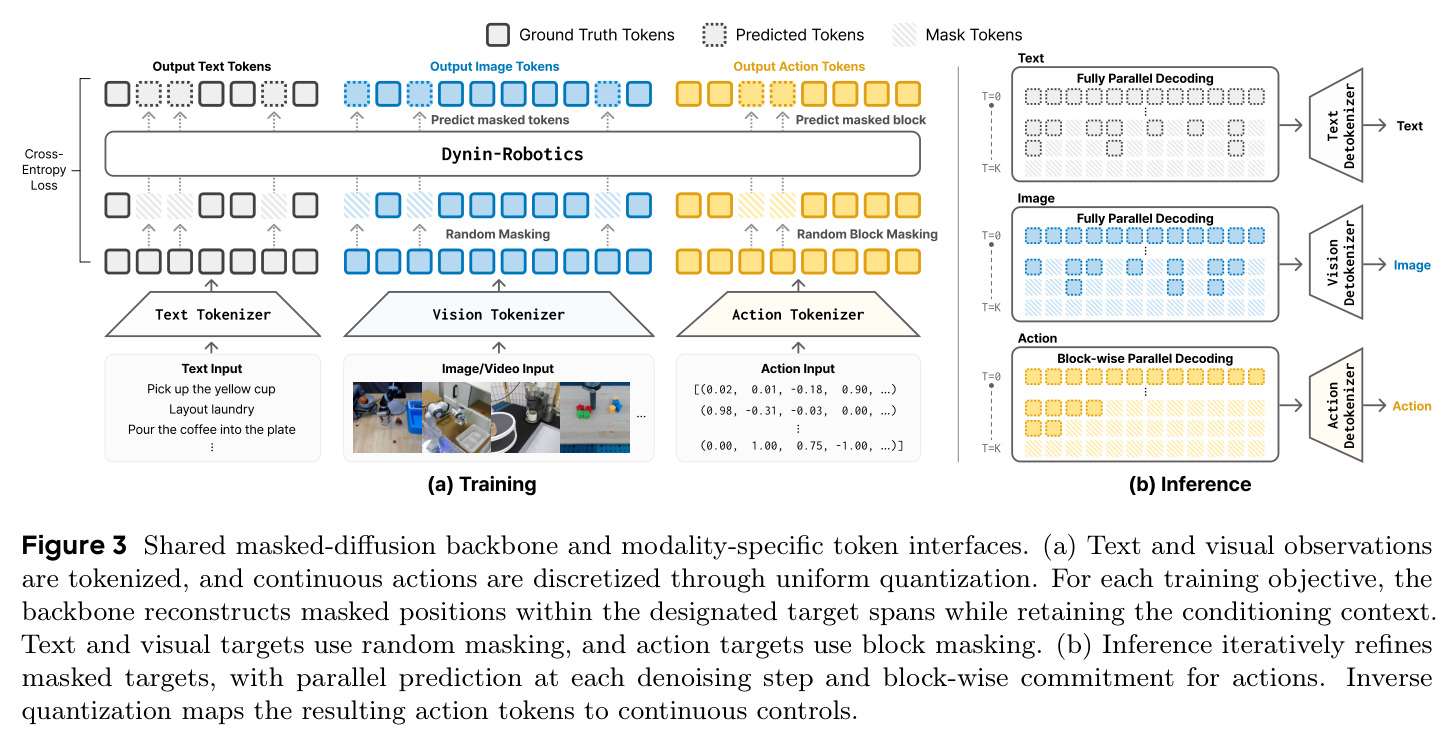
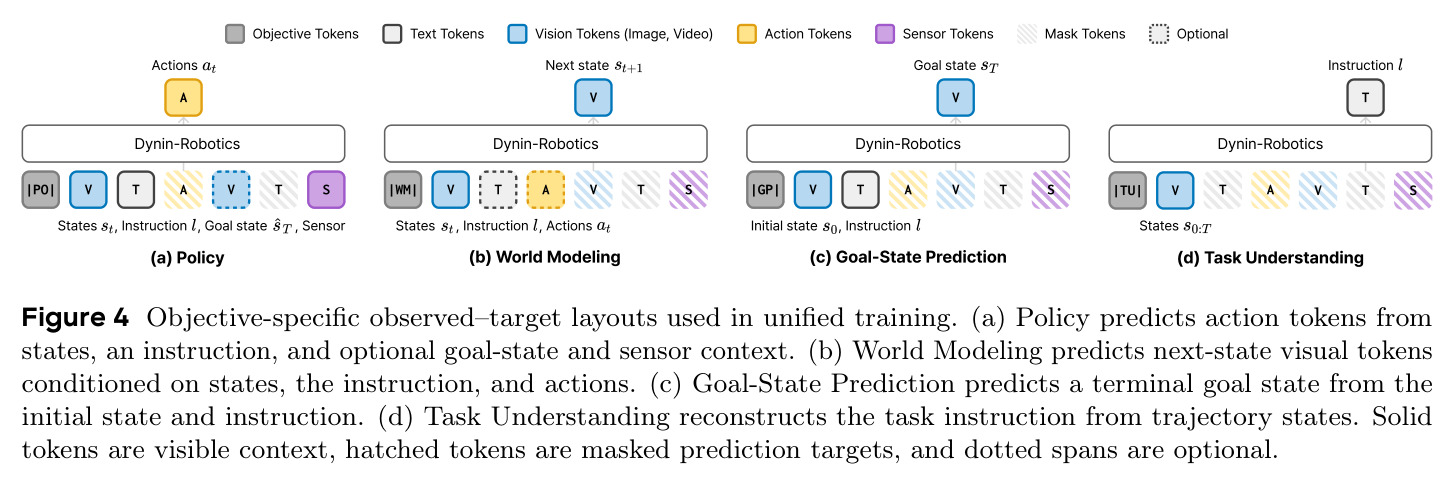
直觉上,让一个模型同时学会"该做什么动作"(Policy)、"做了之后世界会怎样"(World Modeling)、"任务终点长什么样"(Goal-State Prediction)和"这段视频在讲什么任务"(Task Understanding),四种知识共享同一离散表示,推理时互相补位。技术上模型继承 Dynin-Omni:文本、图像/视频帧(共享 MAGViT-v2 tokenizer)均表示为离散 token,由单一双向 Transformer 与统一分类预测头处理;本文为动作新增保留 token 段,把 7 维末端控制按通道做 1%/99% 分位归一化后均匀分箱(Stage-1 用 $B_A=256$)。每个样本按目标 $o$ 序列化为类型化 span 拼接(观测、指令、动作、下一帧、目标图像、可选传感器与元数据),只在目标 span 内加掩码,用逆掩码率加权、按目标长度归一化的交叉熵 $\mathcal{L}_{\mathrm{MDM}}$ 训练;Stage-1 的 Policy 目标额外带期望-bin MAE 辅助损失($\beta=0.2$)。
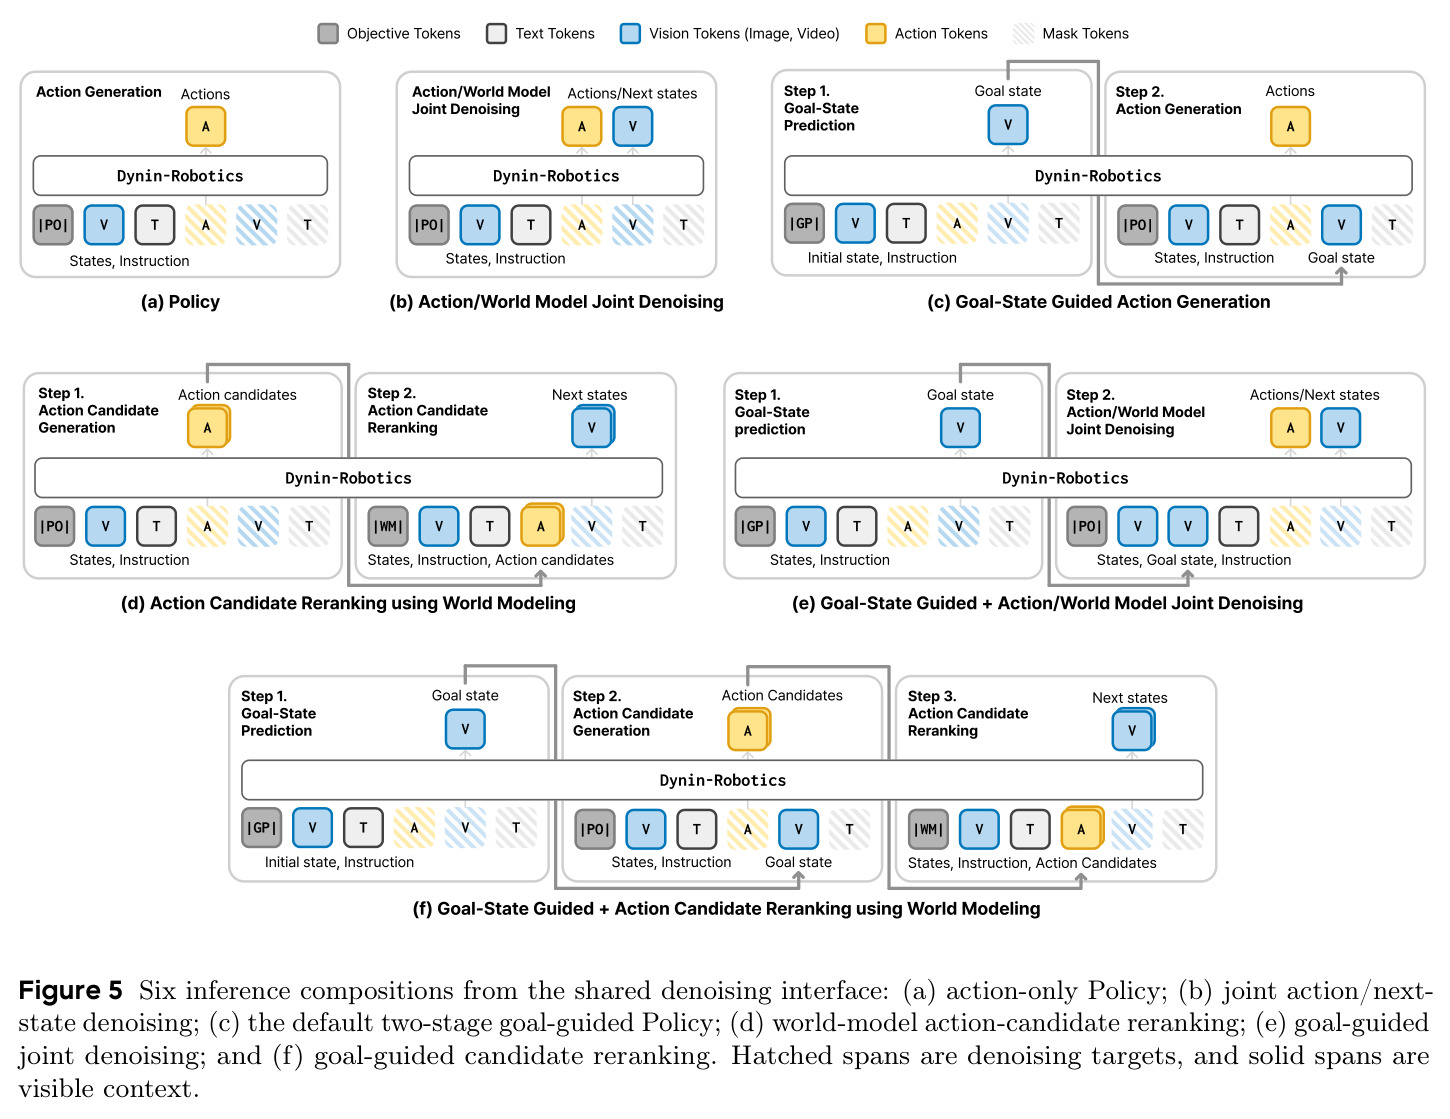
核心创新是"目标条件化掩码":同一组参数下,四个目标只是同一条件去噪查询 $p_\theta(x_{I_o} \mid x_{C_o}, o)$ 的四种配置,区别仅在可见 span、目标 span 和目标标记。这与 VLM+动作专家或视频生成器+专家有本质区别:换任务不需要新模块或新损失,只改序列布局;文本/视觉目标用随机掩码,动作用时间主序连续块掩码。第二个创新是推理组合:推理期可构造训练时未见过的复合掩码(如同时掩码动作与下一帧 span 做联合去噪),或用固定参考帧上的世界模型能量加策略先验给候选打分,仅当能量领先至少 $\delta$ 且总分更优时才替换,由此派生六种推理路径与测试时扩展。第三个创新是学习型 remasking 控制器:冻结骨干,用 PPO 只训练"每步重掩码几个 token、重掩哪些位置"的轻量控制器,把环境回报与去噪开销写进同一目标。
方法步骤详情
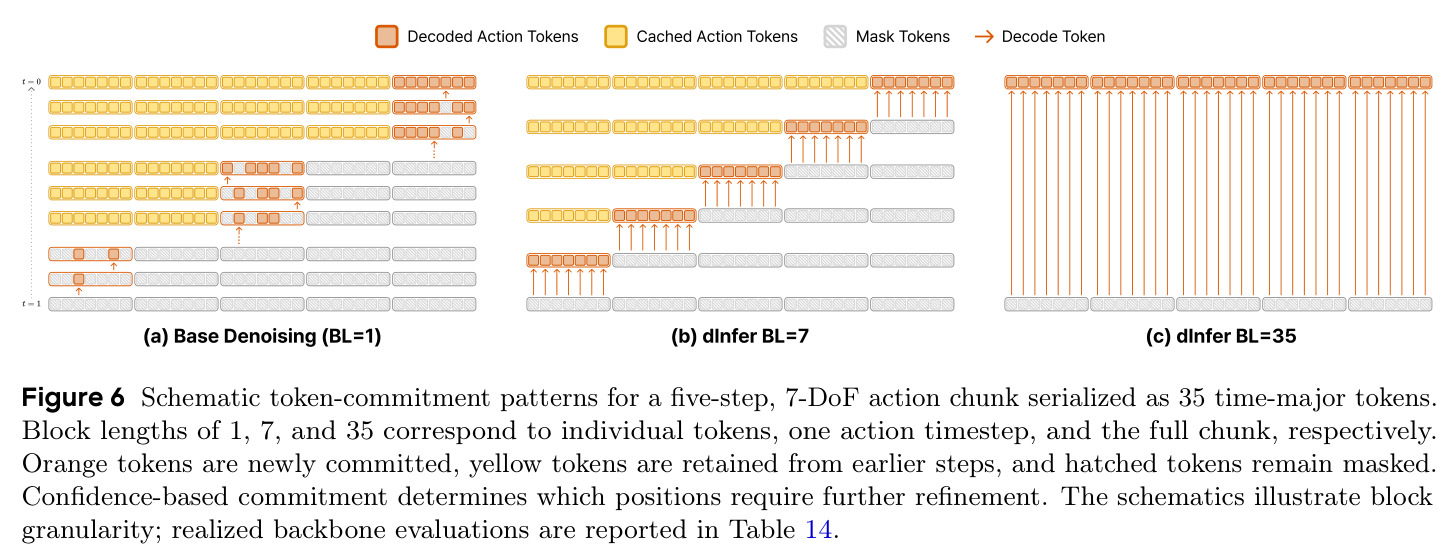
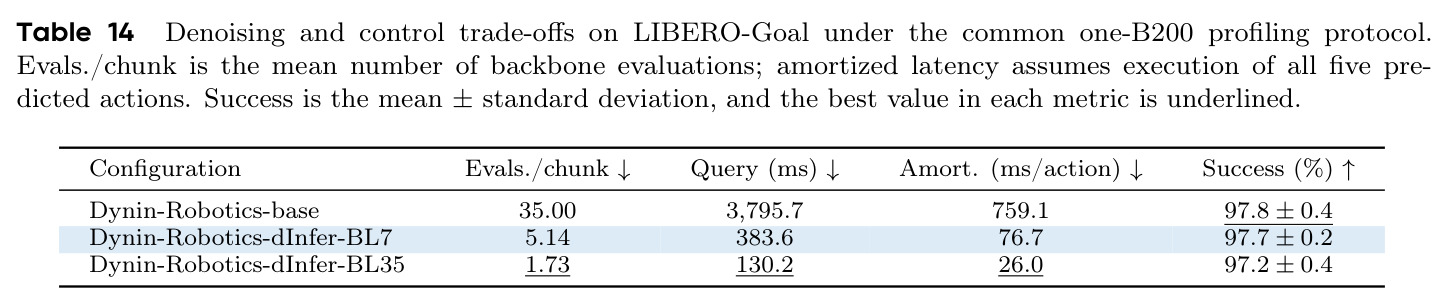
第一步,token 化:文本/视觉用冻结的语言与 MAGViT-v2 tokenizer 编码,7 维动作经鲁棒分位归一化后均匀分箱映射进保留 token 段,展开成 35 个时间主序 token。第二步,统一训练四目标:Policy、World Modeling、Goal-State Prediction、Task Understanding 按各自模板构造样本,只在目标 span 内掩码。第三步,Stage-1 持续预训练:48 个 OXE 数据集、约 133 万条轨迹映射到统一 7 维接口,数据平衡分组后 32 卡轮转采样,两段共 27.6k 次优化器更新,第二段转为 policy 中心调度。第四步,Stage-2 域适配:对 LIBERO、VLABench、Franka 分别后训练,重算动作统计并按域选 $B_A$(VLABench 用 32)。第五步,推理:默认"先目标态预测、后动作去噪"两阶段,另有联合去噪、候选重排等共 6 种组合。第六步,加速:置信度块提交配合 dInfer 缓存,每块骨干评估从 35 次降到 5.14 或 1.73 次。
技术新颖性
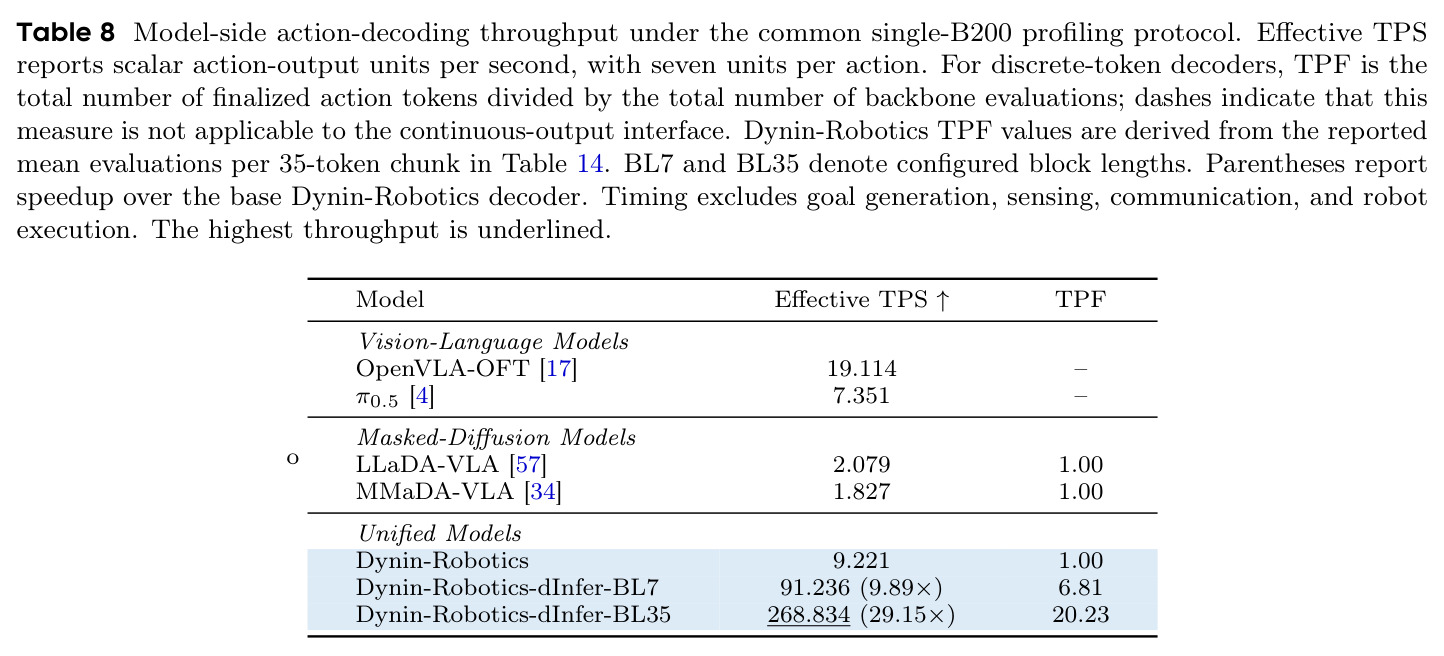
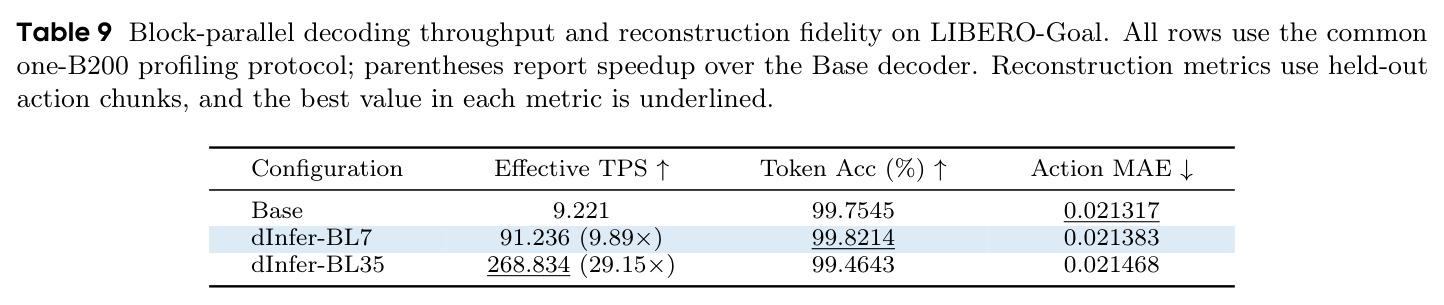
技术新颖性有四层。其一,把全模态掩码扩散骨干(Dynin-Omni 原面向文本/图像/语音)扩展到机器人轨迹,动作作为可去噪 token 块进入共享词表——与只把扩散用于动作解码的 Discrete Diffusion VLA、LLaDA-VLA 不同,也与 UD-VLA、MMaDA-VLA 的"动作+视觉联合去噪"不同,本文把理解方向(轨迹→指令)与终态预测(目标图像)也纳入同一接口。其二,推理期复合掩码:联合去噪和候选重排不是新训练的能力,而是拼装已训练的目标标记与目标 span 在推理时构造的查询,使消融能干净分离监督与推理的贡献。其三,块并行解码配合 dInfer 工程栈,把 35-token 块的骨干评估从 35 次降到 1.73 次,实现 29.15 倍模型侧吞吐提升,token 精度仅从 99.75% 降至 99.46%。其四,用 PPO 训练 remasking 控制器,把"每步接受多少 token"变成可学习的效率-回报权衡,在离散扩散 VLA 中较少见。相比 Table 1 中所有已有系统,本文是唯一六项能力全覆盖的实现。
实验结果
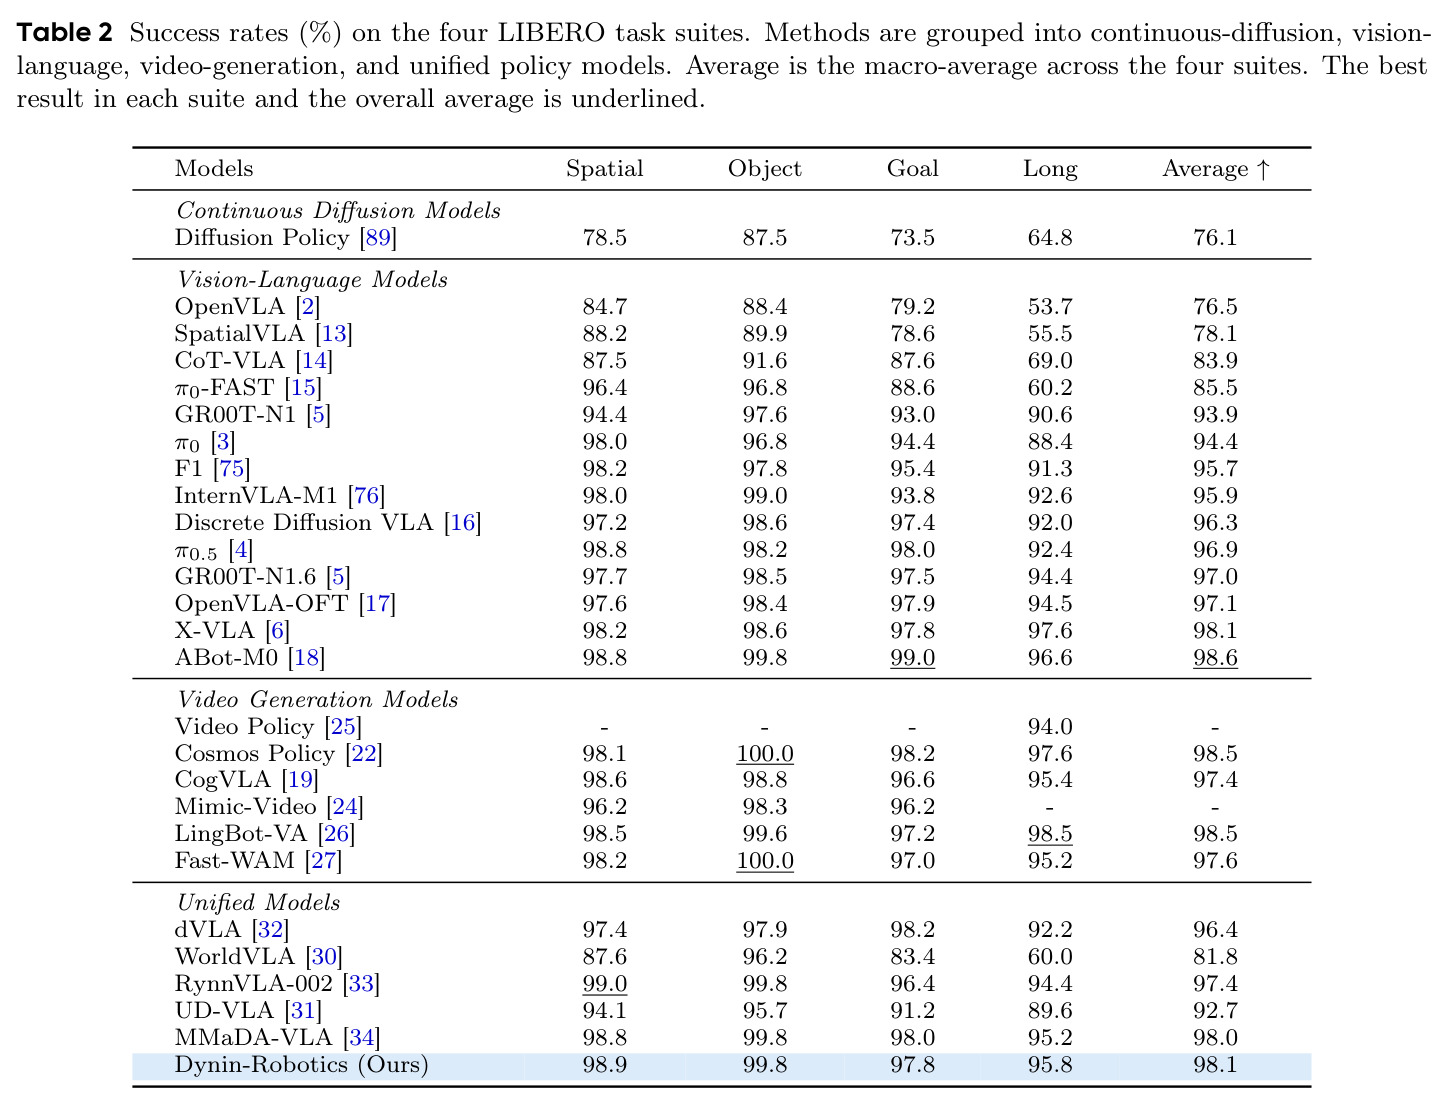
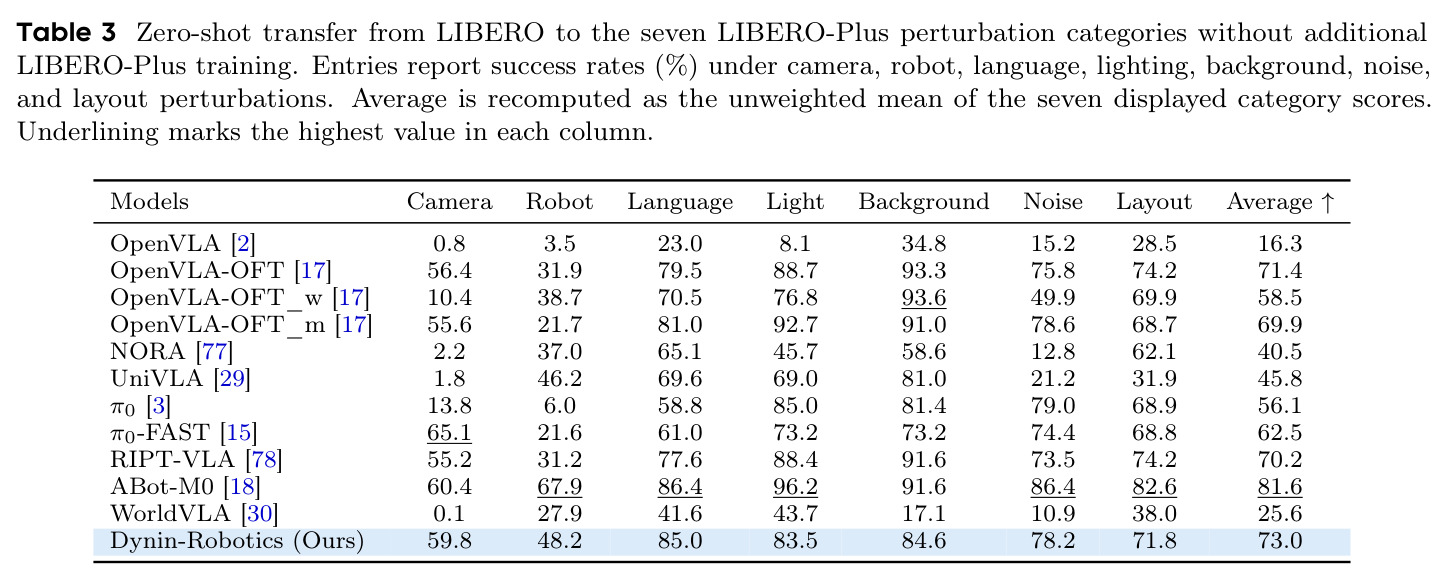
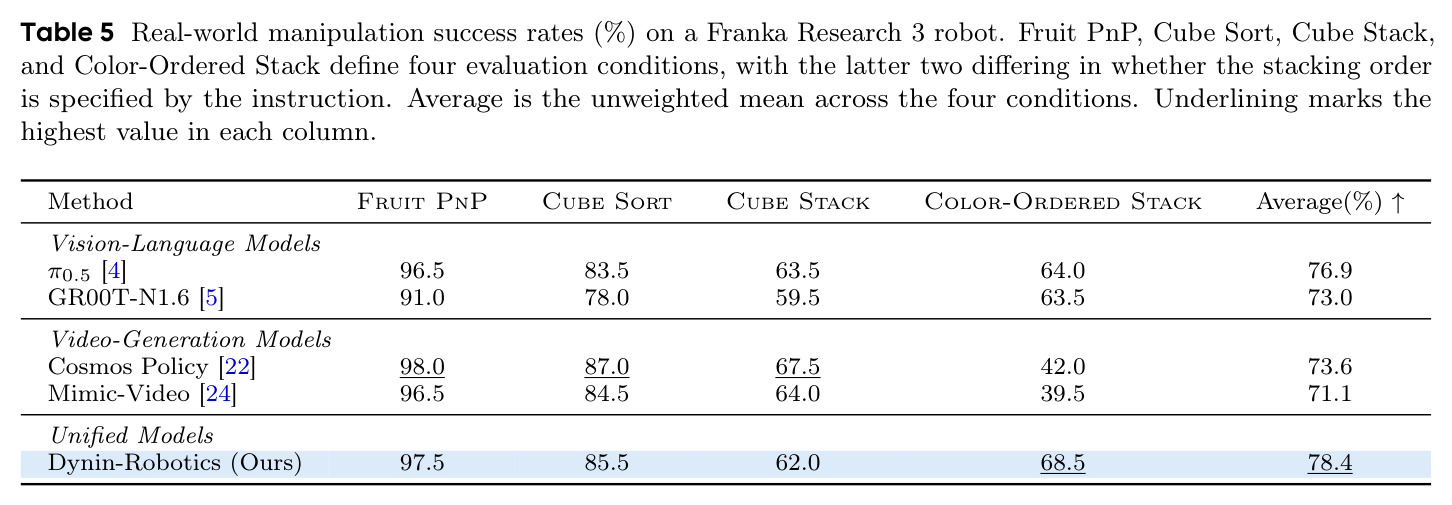
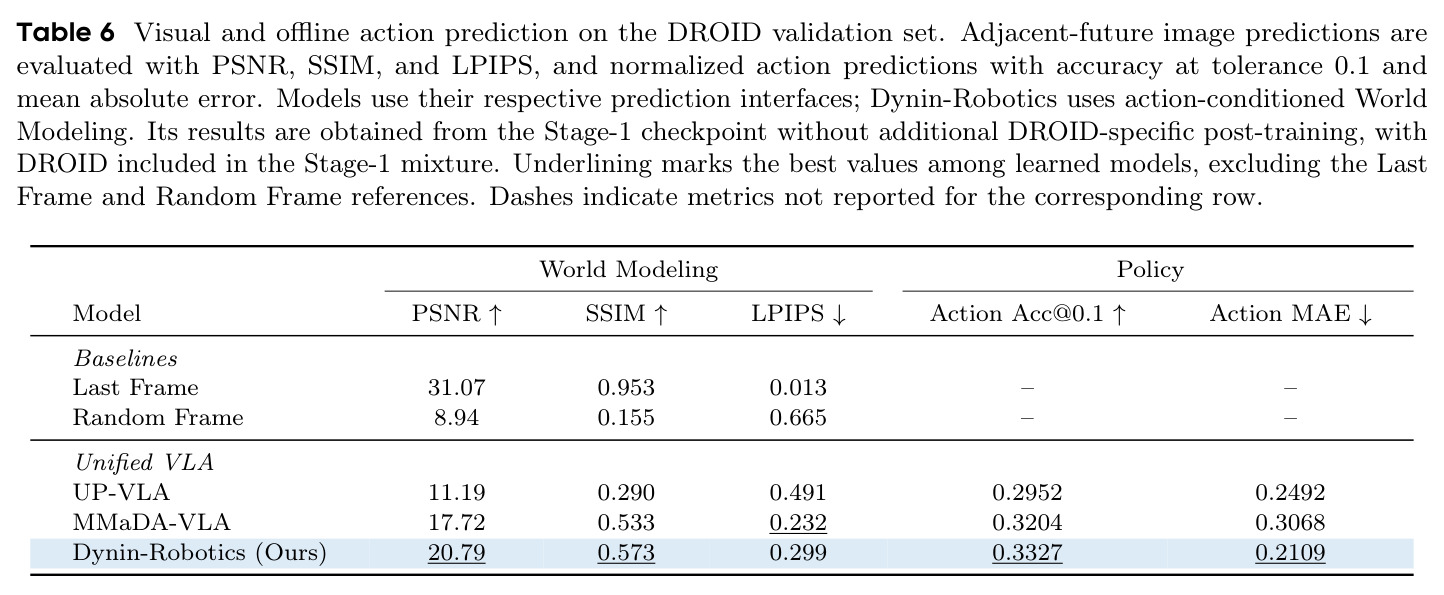
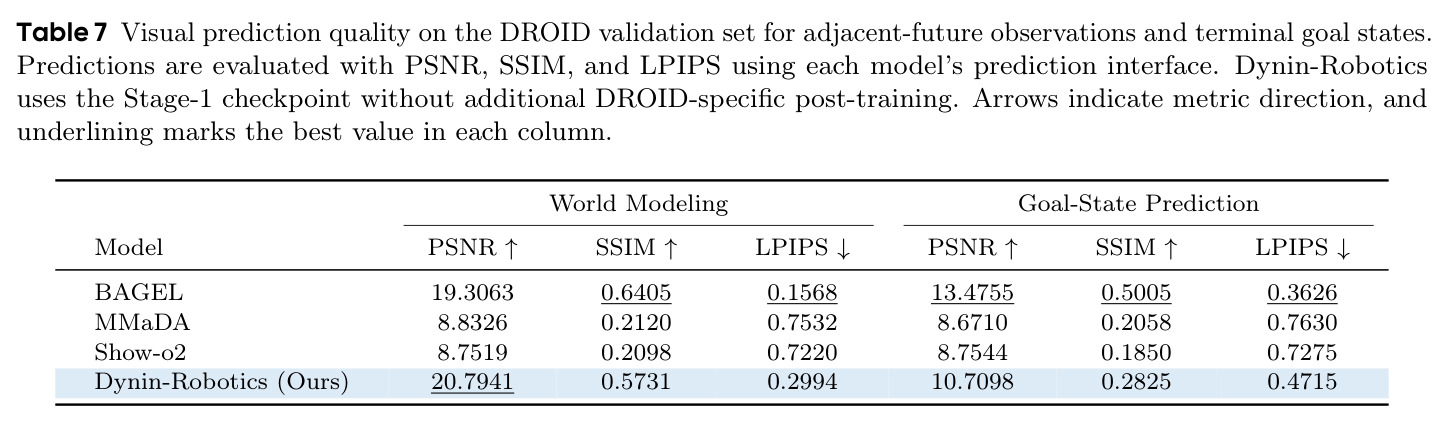
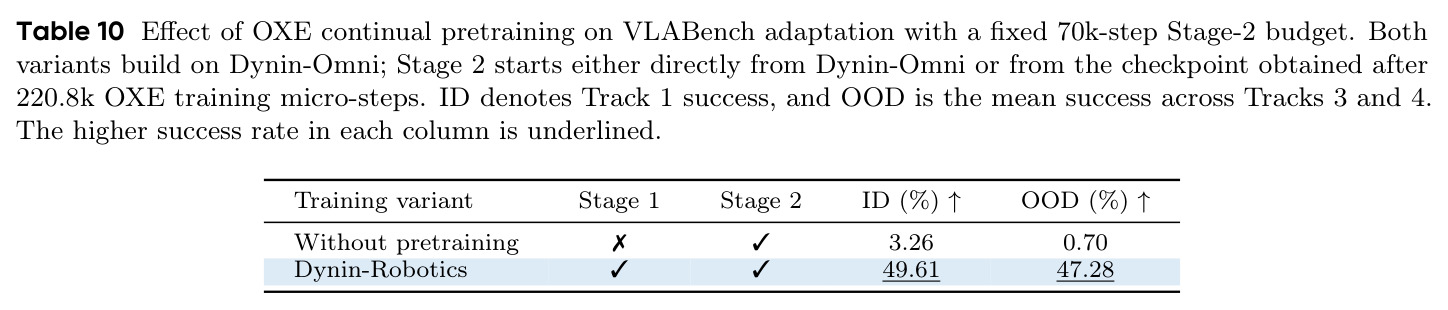
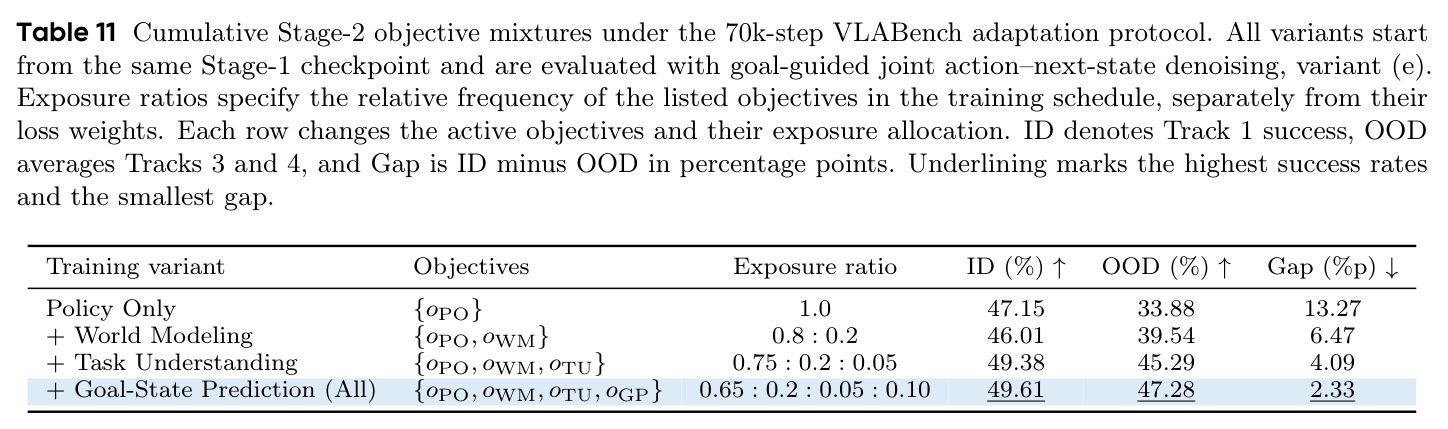
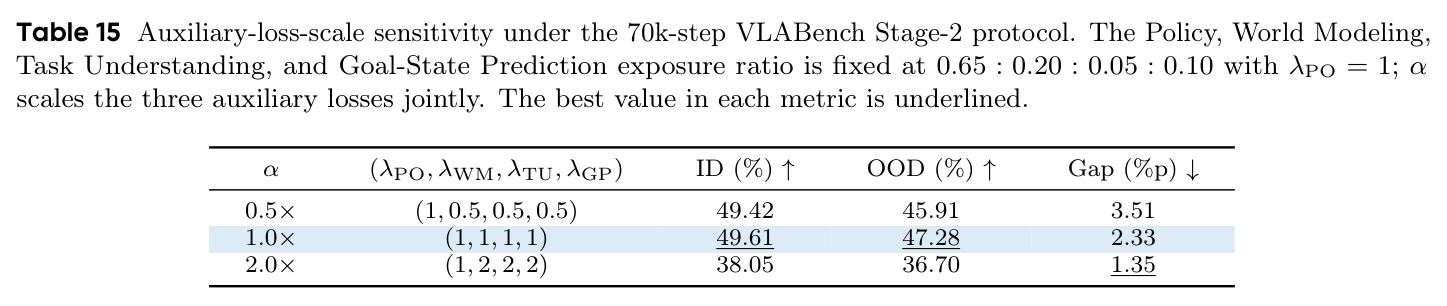
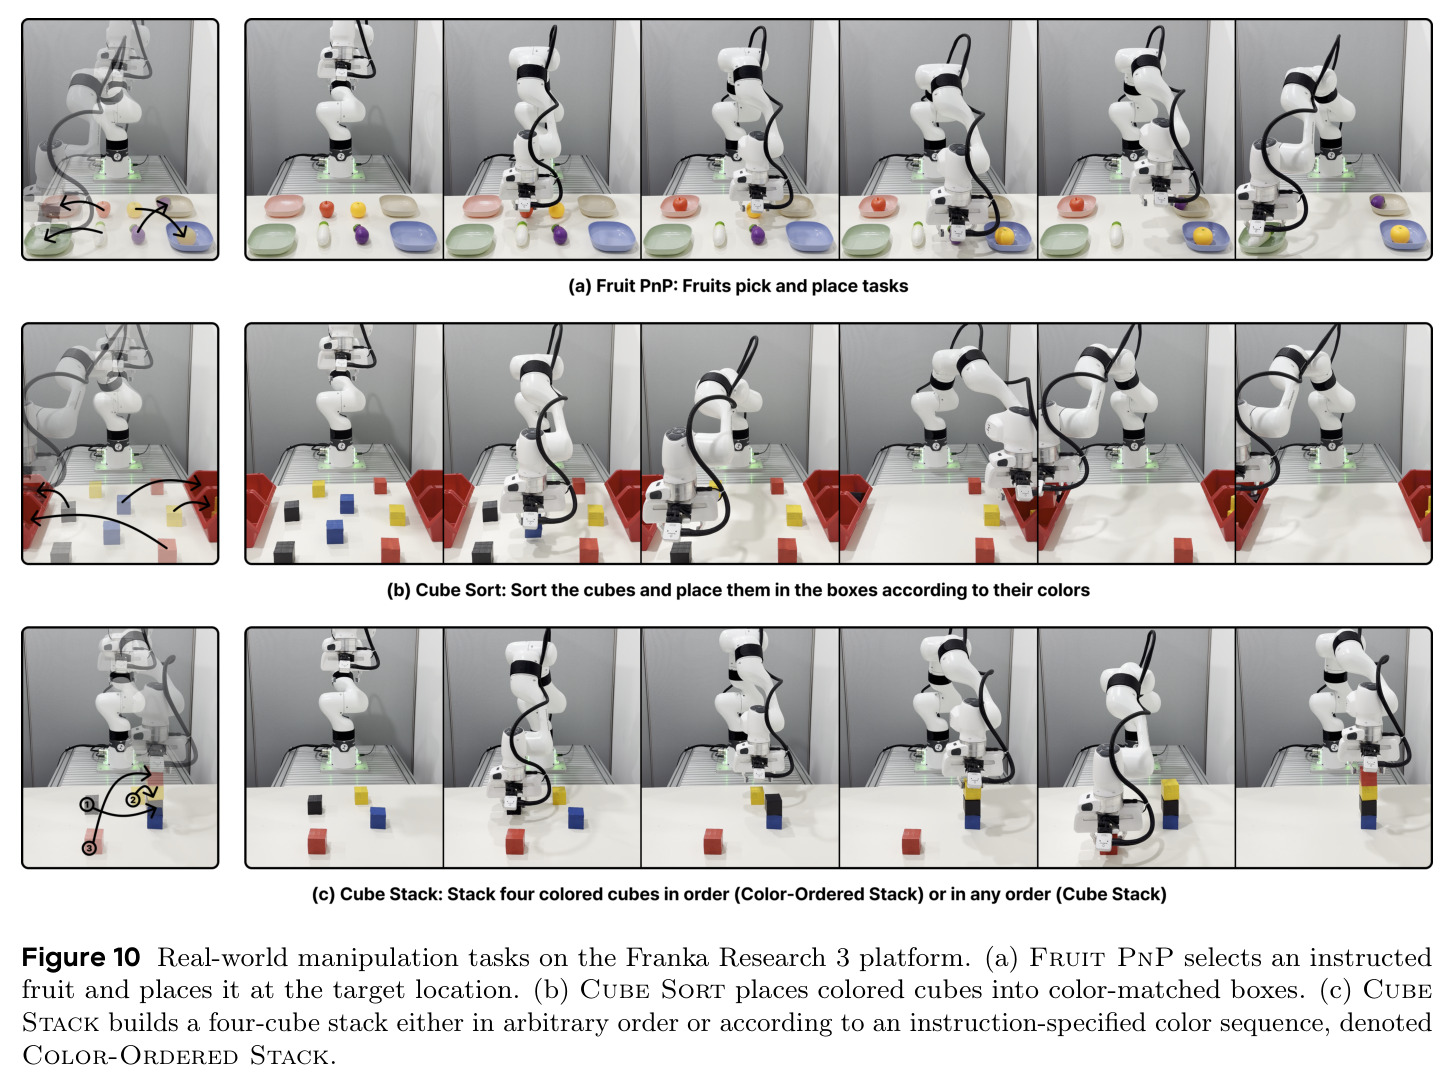
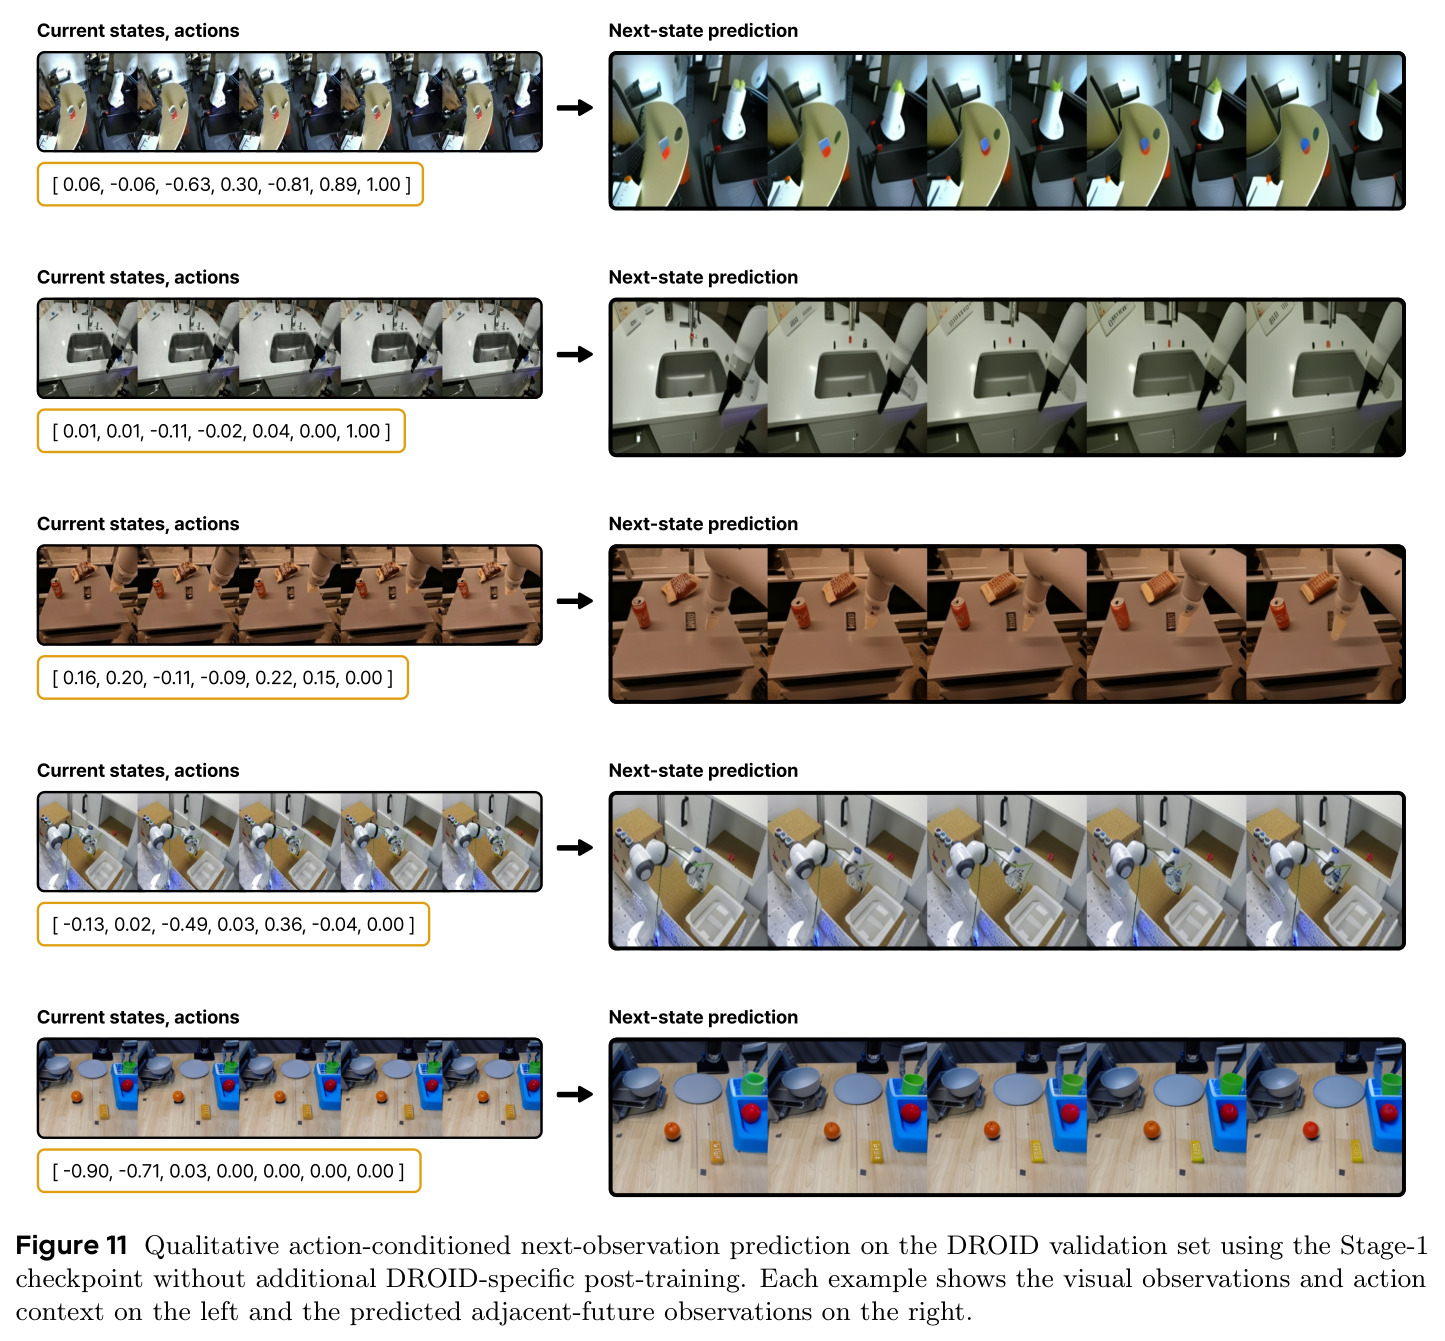
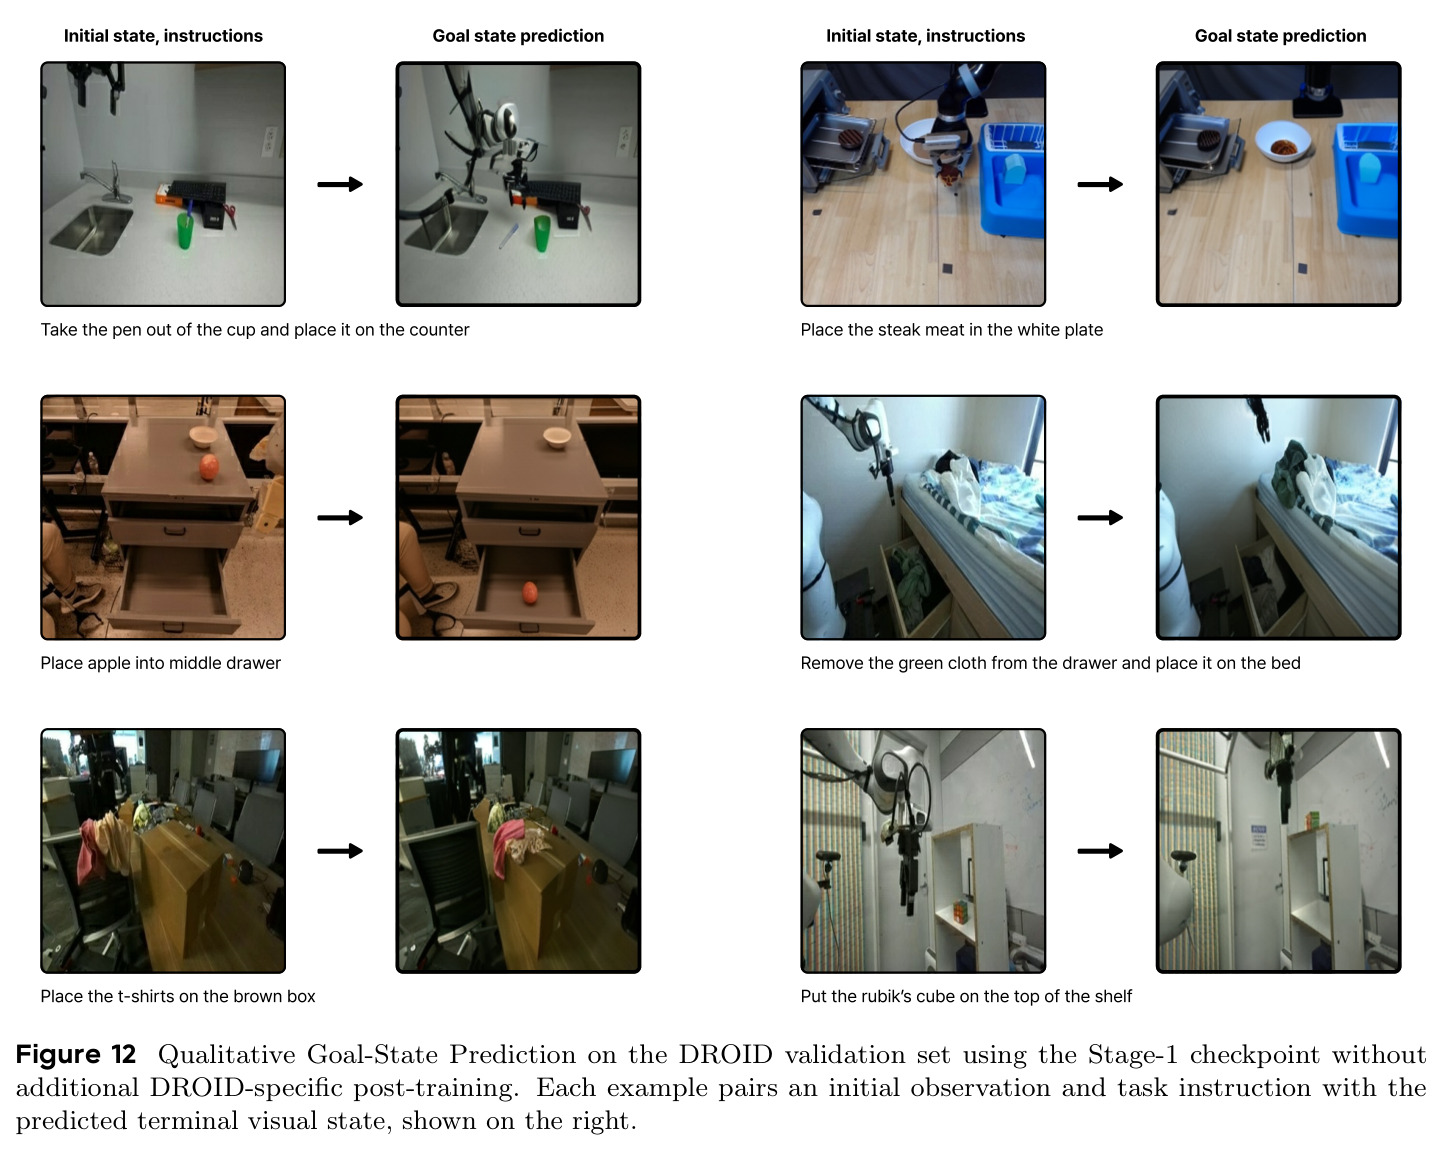
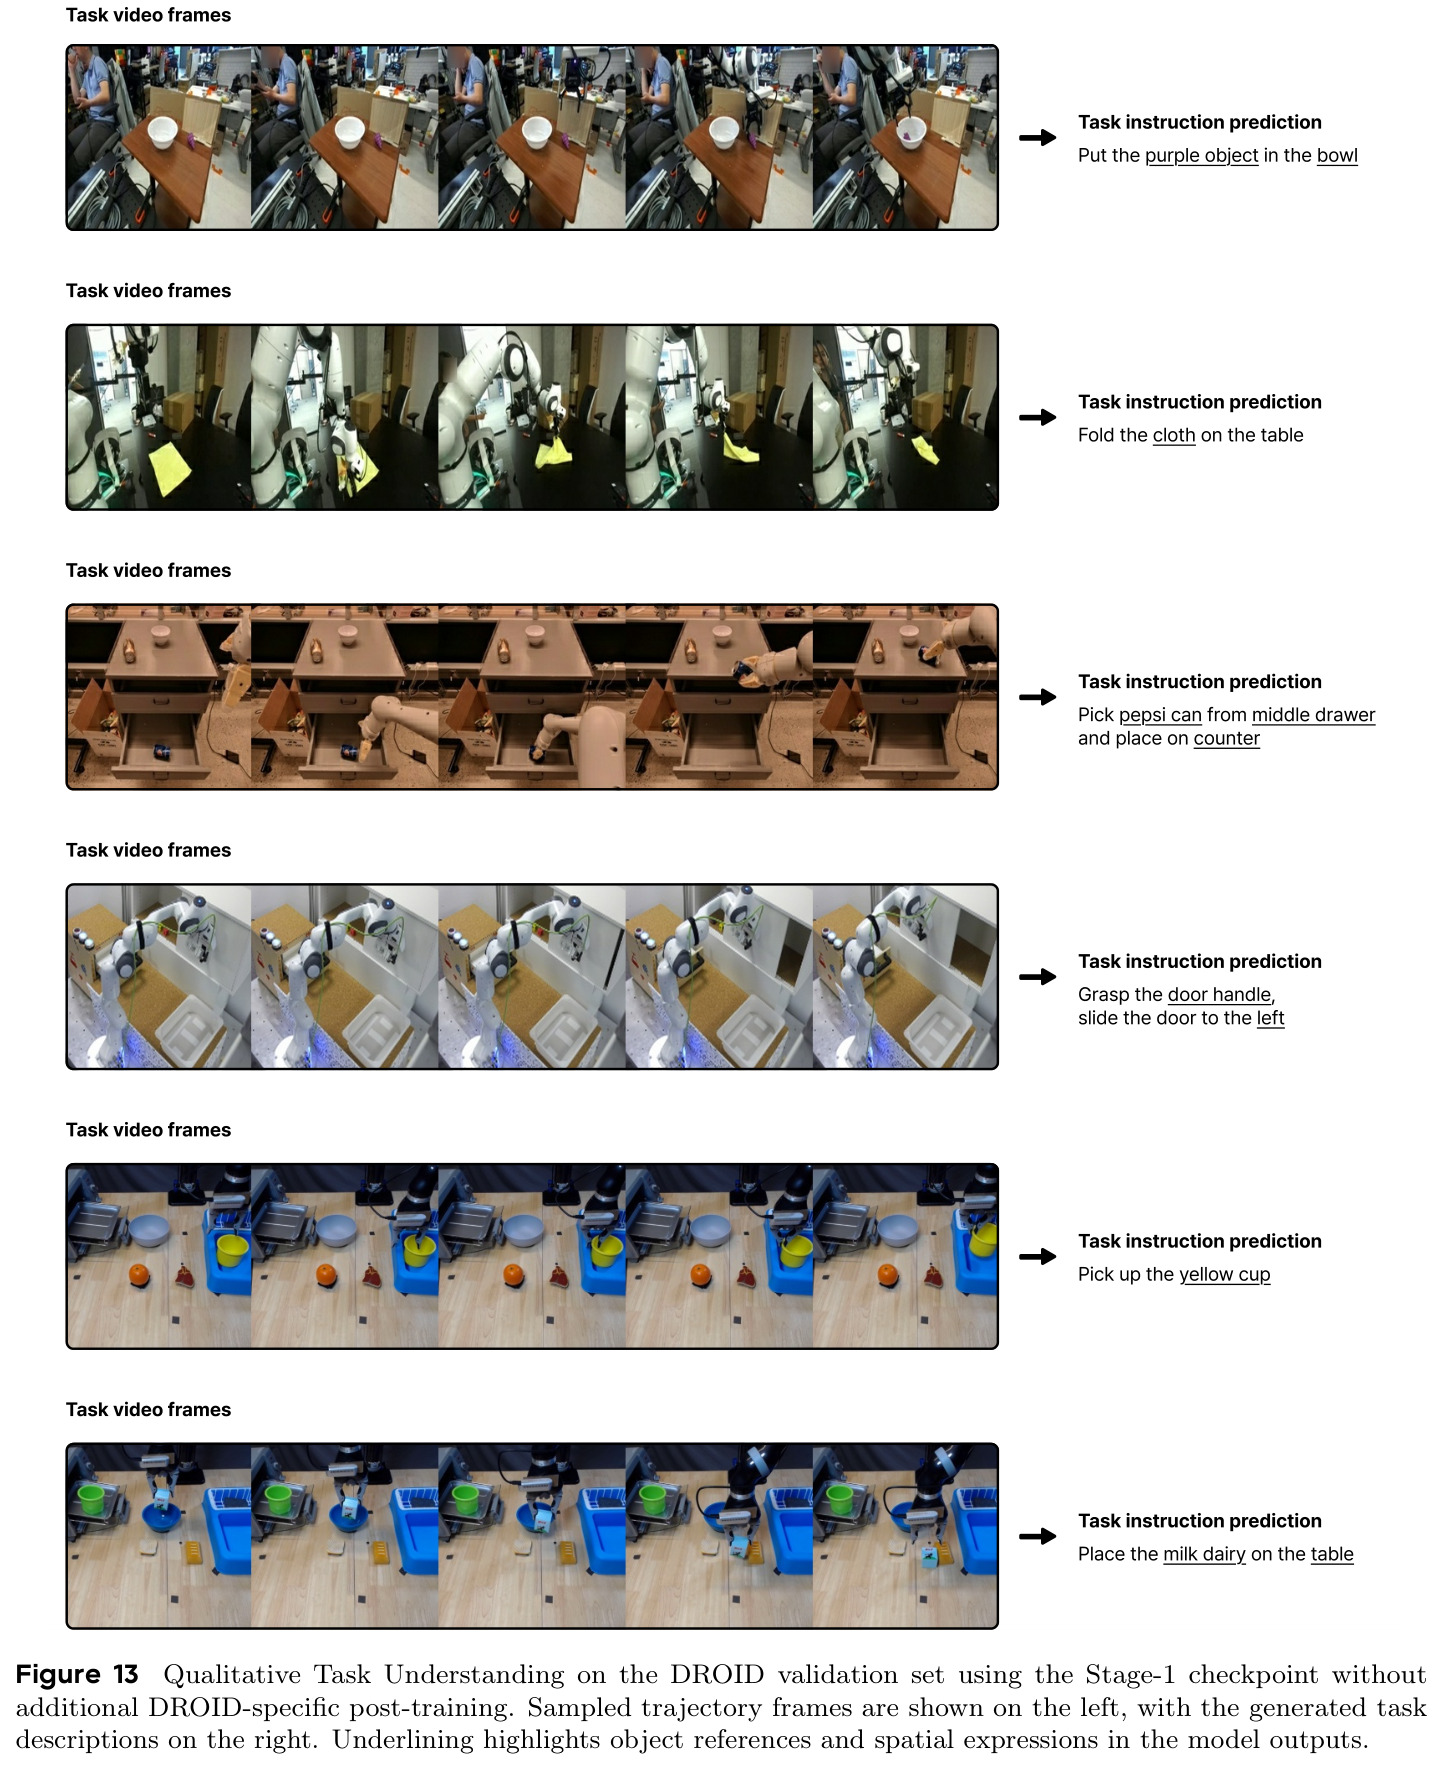
LIBERO 宏平均 98.1%(距 ABot-M0 仅 0.5 点,长程 95.8% 最弱);LIBERO-Plus 零样本 73.0%(ABot-M0 81.6%),Robot 扰动 48.2% 最脆弱;真机 Franka 平均 78.4% 最高(π0.5 76.9%),Color-Ordered Stack 68.5% 领先 π0.5 达 4.5 点。预测输出:世界建模 PSNR 20.79 学习模型最高,动作 Acc@0.1 0.3327、MAE 0.2109 均最佳,但 Last Frame 复制(31.07)整图更强,目标态 PSNR 10.71 亦低于 BAGEL(13.48)。消融:有 OXE 预训练 ID 49.61%/OOD 47.28%,无则仅 3.26%/0.70%;全四目标混合使 OOD 33.88%→47.28%、gap 缩至 2.33;固定 checkpoint 时组合 (e) 达 49.6%/47.3%(action-only 45.8%/41.4%),单独用辅助路径反而更差。加速后 BL35 吞吐提升 29.15 倍,成功率仅降 0.6 点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO 四套件 | 成功率宏平均 (%) | 98.1 | ABot-M0 98.6;X-VLA 98.1;π0.5 96.9 | 与 X-VLA 持平,比 π0.5 +1.2,距最高 ABot-M0 -0.5 |
| LIBERO-Plus 零样本迁移 | 七类扰动成功率平均 (%) | 73.0 | OpenVLA-OFT 71.4;RIPT-VLA 70.2;ABot-M0 81.6 | 比 OpenVLA-OFT +1.6,比 ABot-M0 -8.6 |
| 真机 Franka Research 3 四条件操作 | 成功率平均 (%) | 78.4 | π0.5 76.9;Cosmos Policy 73.6;GR00T-N1.6 73.0 | 比最强基线 π0.5 +1.5,Color-Ordered Stack 上 +4.5 |
| DROID 动作条件下一帧预测 | PSNR (dB) / SSIM | 20.79 / 0.573 | MMaDA-VLA 17.72 / 0.533;Last Frame 31.07 / 0.953 | 学习模型中最高(+3.07 dB),但低于帧复制基线 |
| DROID 离线动作预测 | Acc@0.1 ↑ / MAE ↓ | 0.3327 / 0.2109 | MMaDA-VLA 0.3204 / 0.3068;UP-VLA 0.2952 / 0.2492 | 两项均为学习模型最佳 |
| VLABench 移位指令 (Track 3+4) | OOD 成功率 (%) | 47.28 | Policy-only 后训练 33.88 | +13.40,gap 从 13.27 缩至 2.33 |
| VLABench 适配(有无 OXE 预训练) | ID / OOD 成功率 (%) | 49.61 / 47.28 | 无预训练直接 Stage-2:3.26 / 0.70 | 约 15~46 倍提升 |
| 模型侧动作解码吞吐 | 有效 TPS(7-DoF token/秒) | 268.834(BL35 + dInfer) | 自身基线解码器 9.221;π0.5 7.351;LLaDA-VLA 2.079 | 较自身基线 29.15×,较 π0.5 约 36.6× |
局限与改进
作者承认的局限:相邻帧预测在整图指标上低于 Last Frame 复制(20.79/0.573/0.299 对 31.07/0.953/0.013),未超 persistence;Task Understanding 只有定性展示;真机只覆盖一台 Franka 与单一工作区;World Modeling 只评估相邻一帧;RL 控制器贡献未与其余后训练选择分离。我的观察:一是各下游域各自单独 Stage-2(重算统计、调 bin、选调度),"统一模型"实为一族域适配检查点,DROID 评估用未适配的 Stage-1,与策略评估口径不同;二是 LIBERO 报告用的默认路径 (c) 在 VLABench 消融中 OOD(38.2%)反而低于 action-only(41.4%),基准协议与最优组合 (e) 不一致,结论对推理配置敏感;三是 $B_A$ 从 16→32→64 使成功率 27.84→49.61→32.90 剧烈非单调,量化是脆弱超参且机制未解释;四是候选重排吞吐近乎砍半(9.238→4.828 TPS)只换 0.4 点 OOD,测试时扩展性价比有限。
独立分析的弱点
弱点一:视觉生成质量是短板,目标态 PSNR 仅 10.71(BAGEL 13.48)、下一帧被帧复制全面压制,错误的目标想象可能误导动作解码;改进方向是外接连续扩散解码器、引入残差量化,并改用动作相关区域指标评估。弱点二:推理组合收益不一致且缺乏选择准则,goal 引导单独用使 OOD 从 41.4% 降到 38.2%,与联合去噪结合才升到 47.3%;改进方向是训练轻量路由器按任务特征自动选推理路径。弱点三:离散化脆弱,$B_A=16$ 或 64 使成功率暴跌约 20 点,Stage-1(256 bins)与 Stage-2(32 bins)bin 映射不一致是隐患;改进方向是采用 RVQ/FSQ 等 learned tokenizer。弱点四:测试时扩展成本高,world-model 过滤吞吐降 44.6% 只换 0.4 点 OOD;改进方向是候选剪枝、共享 KV 缓存批量打分、能量早停。弱点五:泛化边界,LIBERO-Plus 的 Robot 扰动仅 48.2%,真机只验证结构化桌面任务;改进方向是跨本体训练与扰动增广。
未来方向
作者提出的方向:把视觉动态评估扩展到更长时域(多帧 rollout 一致性而非单帧指标);量化轨迹到语言生成的准确率(目前只有定性样例);扩展到更多本体与传感器模态——力/扭矩、触觉的 token 接口已预留但未激活训练。基于本文成果可延伸:第一,激活传感器接口做力/触觉条件策略,接触丰富任务(真机最弱的 Cube Stack 仅 62.0%)可能直接受益;第二,把 RL remasking 控制器与六种推理组合的选择统一成"推理时计算分配"策略,学习何时调用目标预测、何时过滤候选,把 Table 12 的手动权衡变成自适应决策;第三,探索统一的多域 Stage-2(当前每域单独适配),配合域元数据实现单检查点多域部署;第四,将目标态生成与 3D 表示或场景图结合,缓解"同一指令多种合法终态"导致的 2D 像素预测模糊;第五,从理论上解释 $B_A=32$ 的最优性,形成新域 bin 选择原则;第六,利用世界模型做推理时的扰动想象与恢复,针对 LIBERO-Plus 暴露的 Robot/Light 弱项。
复现评估
开源情况:论文标注 Project Page、Code、Model 链接,并发布 220k 微步的 Stage-1 checkpoint;底座 Dynin-Omni 亦是公开工作。Stage-1 的 48 个 OXE 数据集与 LIBERO/VLABench/LIBERO-Plus 基准均公开,真机 Franka 训练数据开放程度未说明。训练细节披露充分:量化公式、损失权重($\beta=0.2$、两段 $\lambda$ 比例)、AdamW 超参(峰值 lr $2\times10^{-5}$ 等)、数据流水线与 profiling 协议全部写明,属工程可复现风格。算力门槛:Stage-1 是 32 rank × 27.6k 次优化器更新的大规模持续预训练且依赖 Dynin-Omni 底座,完整复现需多卡集群;但从公开 Stage-1 出发做 Stage-2 域适配单机即可,推理与消融实验只需单卡 B200/A100 级 GPU。总体:完整复现 Stage-1 难度中高,域适配与消融复现难度中等。
论文图表
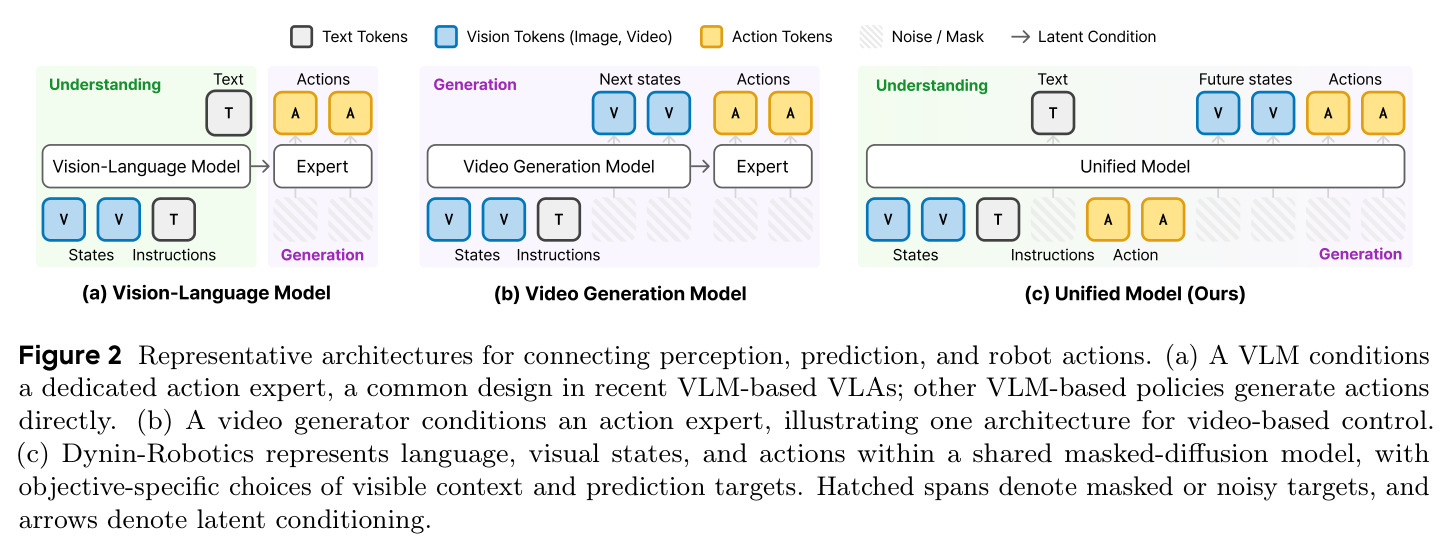
三类架构对比图:(a) VLM 条件化动作专家(RT-2/π0 等 VLM-based VLA 的常见设计);(b) 视频生成器条件化动作专家(Mimic-Video 等视频驱动策略);(c) 本文的统一模型,语言、视觉状态、动作在同一个掩码扩散模型内表示,斜线阴影 span 表示被掩码/加噪的目标,箭头表示潜在条件化。
直观呈现本文与两大主流范式的架构级差异,是 Related Work 与动机部分的核心示意。
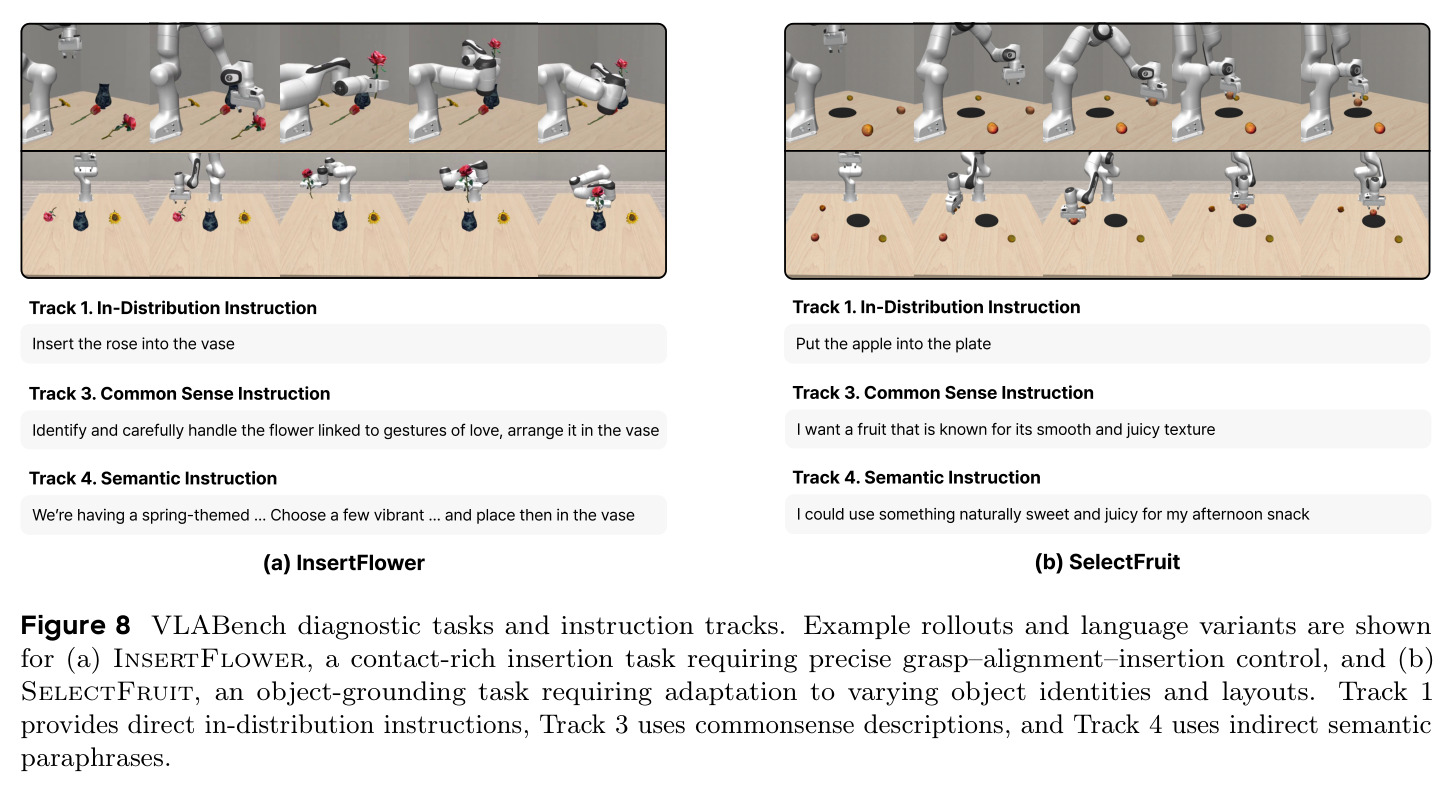
两个诊断任务及三种指令轨道示例:(a) InsertFlower(把玫瑰插入花瓶,需要抓取-对准-插入的接触 rich 控制);(b) SelectFruit(按功能选水果放入盘子)。Track 1 是直接分布内指令,Track 3 是常识描述(如"与爱的手势相关的花"),Track 4 是间接语义转述(如"下午想要自然甜美的零食")。
理解动机部分 π0.5 与 Mimic-Video 诊断结论以及 OOD 指令含义的必要背景。