SVEET:仅需轻松适配的流式视频编辑框架 Streaming Video Editing with Easy Adaptation
仅在双向扩散模型上训练控制分支,零样本迁移至流式骨干实现15 FPS实时视频编辑
前置知识
双向 vs 因果(流式)视频扩散模型
双向模型去噪时联合处理整段视频的所有帧,信息可前后自由流动,适合离线高质量生成;因果流式模型按分块自回归地生成,第 $k$ 块只依赖之前的块和累积的 KV 缓存,即 $p_\theta(z)=\prod_k p_\theta(z_k|z_{<k},c)$,天然支持直播、实时交互等低延迟场景。
本文的核心命题就是把在双向模型上学到的编辑能力迁移到因果模型上,不理解两者在信息流和特征分布上的差异就无法理解迁移为什么会失败、ODT 为什么有效。
VACE 控制分支
Wan-VACE 在冻结的视频 DiT 主干之外加一个独立辅助控制分支,通过 Video Condition Unit(VCU)编码源视频、参考图、掩码等多模态条件,把中间特征加性注入主干各对应块,从而在不破坏预训练生成先验的情况下实现统一的可控视频生成与编辑。
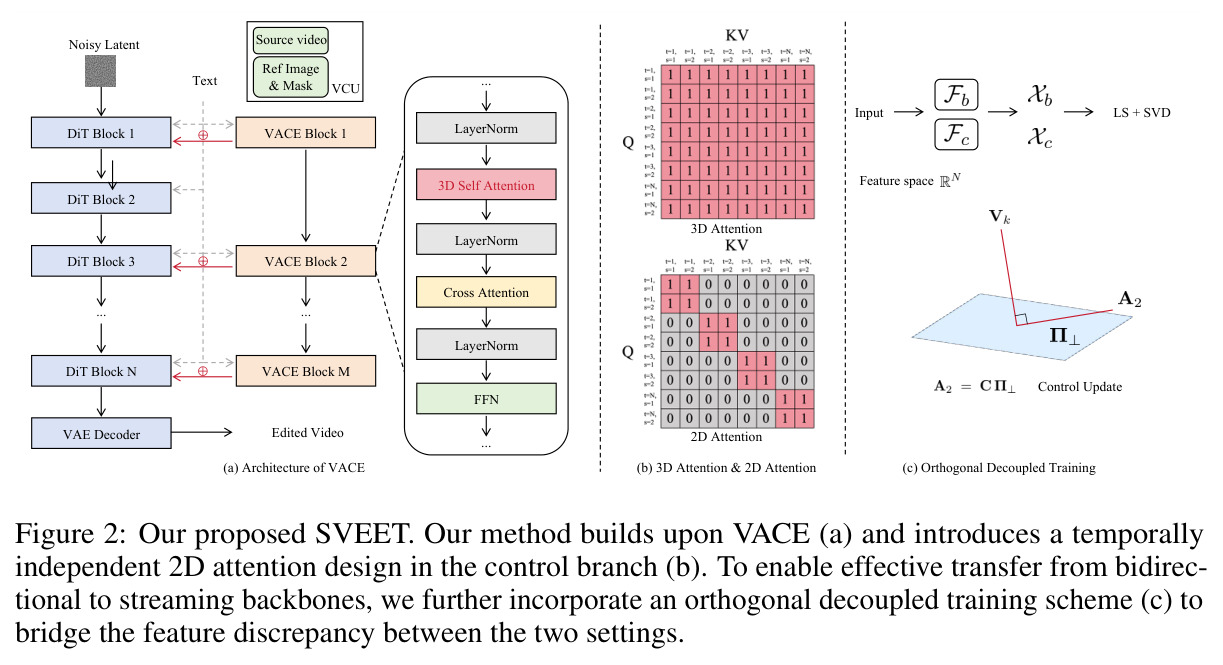
SVEET 的架构直接建立在 VACE 之上,只是把控制分支的 3D 时空注意力换成时间独立的 2D 注意力,读懂 VACE 才能准确理解本文的架构改动点。
奇异值分解(SVD)与正交投影
对矩阵做分解 $A=U\Sigma V^\top$,右奇异向量构成行空间的一组正交基,奇异值衡量各方向能量。取前 $k$ 个右奇异向量 $V_k$ 可构造正交投影算子 $\Pi_\perp=I-V_kV_k^\top$,把任意更新约束到该主子空间的正交补上,满足 $\Pi_\perp V_k=0$。
ODT 的全部核心操作都基于它:用 SVD 找出双向到因果特征差异的主方向,再把控制分支的参数更新约束到正交补空间以避免两个优化目标互相干扰。
LoRA 低秩适配
LoRA 冻结原权重 $W$,只学习低秩增量,实践中把可训练更新 $C$ 参数化为秩 $r$ 的矩阵对插入到注意力和 FFN 的线性层中,可训练参数量远小于全量微调,且天然适合做子空间投影约束。
SVEET 用秩 128 的 LoRA 训练控制分支的 q/k/v/o/ffn.0/ffn.2 层,ODT 的正交约束正是通过把 LoRA 更新投影到 $\Pi_\perp$ 上实现的。
KV 缓存与因果注意力
自回归生成时,模型把已生成分块的 key/value 缓存下来,新块去噪只需 $z_k^{(t-1)}=F_\theta(z_k^{(t)},\mathrm{KV}_{<k},c,t)$,避免重复计算。若条件编码分支引入跨帧依赖,就需要额外的时序 KV 缓存,随视频长度线性增长。
2D 时间独立注意力使控制分支逐帧独立计算、无需任何额外 KV 缓存,这是控制信号与流式推理兼容、不拖慢骨干的关键设计。
研究动机
现有 DiT 视频编辑方法(HunyuanVideo、Wan 等系列)全部依赖双向全序列处理:去噪时每一帧都能看到未来帧,这与直播风格迁移、在线补全等需要逐帧因果生成的流式应用根本冲突。要获得流式编辑能力,最直接的办法是从头训练或重训练一个流式编辑模型,但代价极其高昂——按近期流式蒸馏工作(Self Forcing、Causal Forcing、Causal Forcing++ 等)的报告,仅流式蒸馏就需要约 128 个 H100 GPU 日,还要合成数千对 ODE 样本,叠加控制信号后成本进一步攀升。而已有的实时视频生成工作主要面向文生视频而非编辑,开源的实时编辑方案(SDEdit+CF、StreamDiffusionV2、Daydream+CF、LiveEdit)在编辑忠实度和结构保持上都明显不足,例如风格迁移任务上最好的 LiveEdit 的 VLM 编辑准确率也只有 5.87(满分 10)。
本文的目标是本文提出一个明确的问题:能否只在预训练双向视频扩散模型上训练,就把学到的编辑能力直接、零样本地迁移到流式骨干上,完全不需要重新训练或蒸馏流式模型?具体目标是构造这样一个框架:在冻结的双向骨干(Wan2.1-1.3B-VACE)上学习视频编辑控制,然后把控制分支直接挂到同样冻结的流式骨干(Causal Forcing)上,在风格迁移、视频补全、深度转视频三类代表性任务上达到超过现有实时编辑方法的质量,同时在单张 H100 上实现 15 FPS 的无辅助加速实时推理,从而用极低的训练成本(单卡 A100 训 10 个 epoch)桥接离线编辑与流式应用。
与已有工作不同的是,独特之处在于『不做流式训练』的零样本迁移视角。作者先系统地对比三种代表性架构——微调主干参数的 Wan-Fun、带完整 3D 时空注意力的 VACE、用 2D 帧独立注意力的 VACE——在双向到流式迁移中的表现:Wan-Fun 几乎完全失败,3D VACE 只保留部分能力且时序行为不稳定,2D VACE 迁移最可靠。由此归纳出两条流式兼容控制的普适原则:骨干特征解耦(控制学习必须与双向骨干解耦)和条件帧独立(源视频编码必须逐帧进行、不引入跨帧依赖)。相比直接为流式场景设计模型或做昂贵蒸馏,本文把问题转化为『特征空间对齐』,用 SVD 找出双向与因果骨干间的差异子空间并正交规避,这条受模型合并 task vector 思想启发的路线在视频编辑迁移中是首次出现。
核心方法
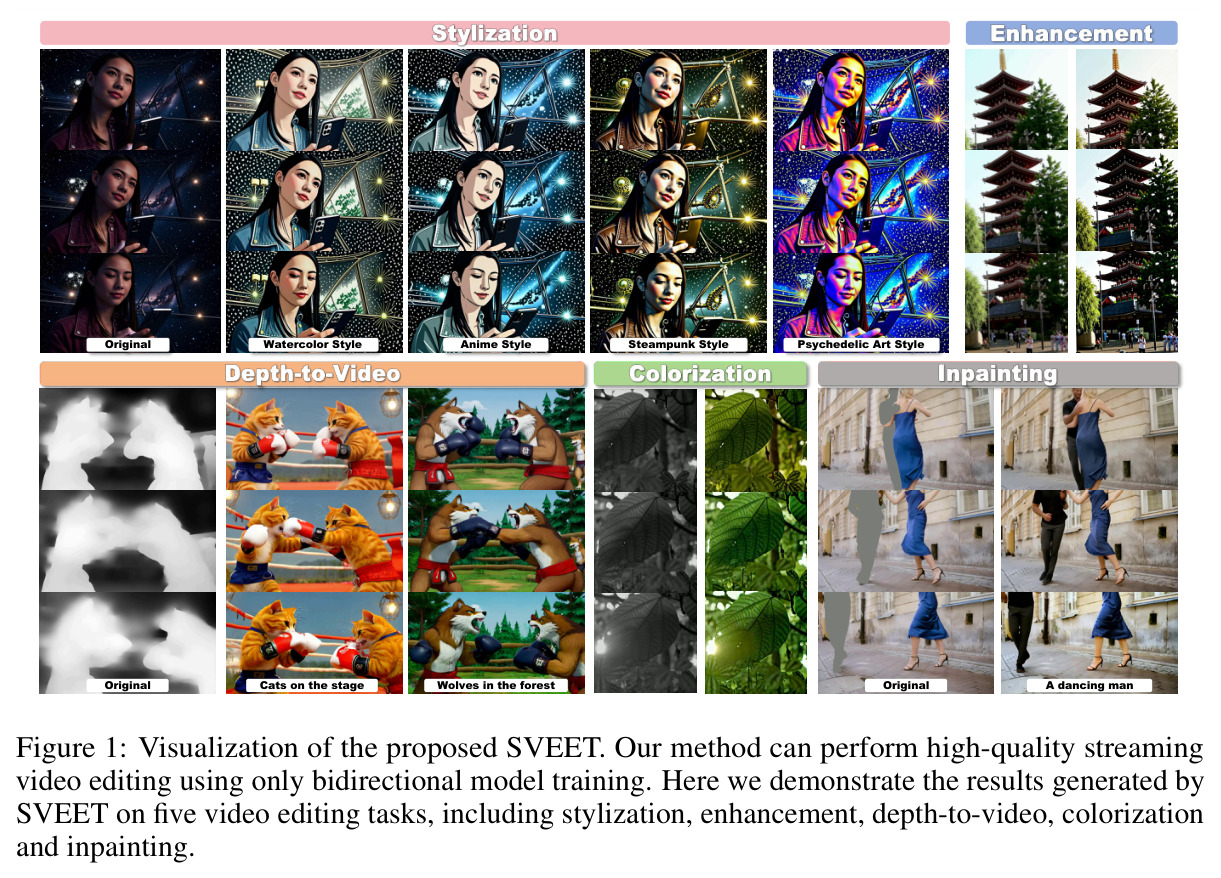
直觉上,控制信号的提取和生成因果性是两个正交的需求:控制分支只需要逐帧编码源视频条件,时序连贯性可以完全交给流式骨干的自回归历史来维持。技术上 SVEET 由两部分组成。第一是时间独立控制分支:基于 VACE 架构改造,把控制分支原来的 3D 时空自注意力替换为逐帧独立的 2D 空间注意力,注意力掩码定义为 $M_{(t,s),(t',s')}=1$ 当且仅当 $t=t'$,否则为 0,保证第 $t$ 帧的条件编码只依赖该帧本身,推理时控制分支无需任何 key/value 缓存。第二是正交解耦训练(ODT):用 SVD 提取双向骨干到流式骨干的特征差异主方向,把控制分支的 LoRA 更新约束在正交补空间,显式强制『视频可控性』与『模型因果性』两个优化方向正交。整个训练在单张 A100 (80GB) 上、81 帧 480×832 输入、每任务 10 个 epoch 即可完成,部署时控制分支直接接到冻结流式骨干上,单张 H100 达 15 FPS。
核心创新是『正交解耦』地处理控制学习与因果适配的冲突:控制分支在双向骨干 $F_b$ 上训练、却部署在特征分布不同的因果骨干 $F_c$ 上,直接迁移会因特征失配而退化。ODT 的做法是:用 500 余对校准样本把相同输入分别喂给两个骨干,在第 $\ell$ 块记录隐状态 $X_b^{(\ell)},X_c^{(\ell)}$,用岭回归 $W_1^{(\ell)}=\arg\min_W\|WX_b^{(\ell)}-X_c^{(\ell)}\|_F^2+\lambda\|W\|_F^2$ 求双向到因果的线性映射;残差 $A_1^{(\ell)}=W_1^{(\ell)}-I$ 捕获把双向表示变为因果表示的更新方向。对其做 thin SVD,取前 $k$ 个右奇异向量张成差异子空间,构造正交投影 $\Pi_\perp^{(\ell)}=I-V_kV_k^\top$,把控制更新约束为 $A_2^{(\ell)}=C^{(\ell)}\Pi_\perp^{(\ell)}$。这样控制学习不再占用因果适配所需的主方向,两目标互不干扰、推理时兼容。
方法步骤详情
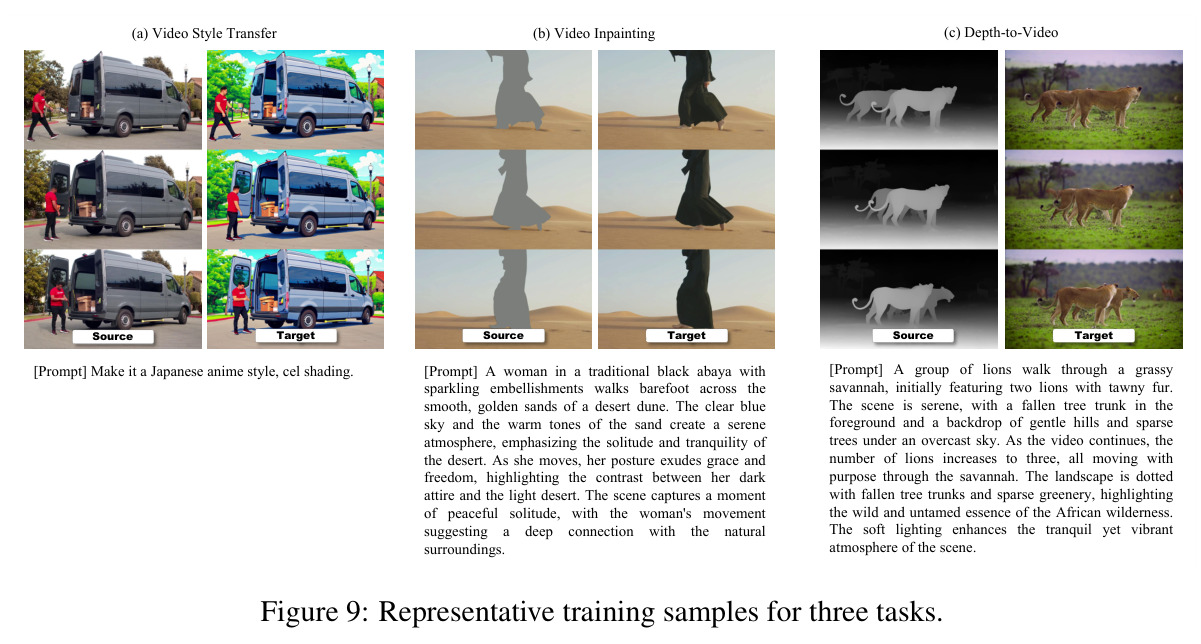
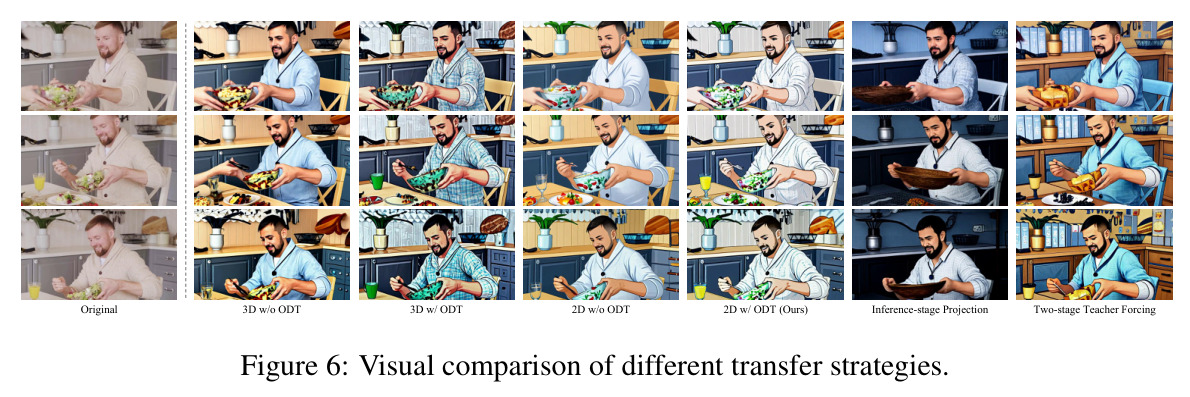
流程五步。第一步,对照实验定位原则:在 Wan-Fun、3D 注意力 VACE、2D 注意力 VACE 上做双向到流式迁移,Wan-Fun 几乎完全失败、3D VACE 部分保留且时序不稳、2D VACE 最可靠,由此归纳骨干特征解耦(P1)与条件帧独立(P2)。第二步,搭架构:基于 Wan2.1-1.3B-VACE,把控制分支的时空自注意力换成逐帧 2D 空间注意力(掩码 $M_{(t,s),(t',s')}=\mathbb{1}[t=t']$),冻结两个骨干全部参数,只在控制分支 q/k/v/o/ffn 层插入秩 128 LoRA。第三步,建投影:用 500+ 校准样本对每个 DiT 块做岭回归与 SVD,按累积谱能量 80% 逐层自适应选秩,预计算并冻结 $\Pi_\perp^{(\ell)}$。第四步,训练:AdamW、学习率 $5\times10^{-5}$、权重衰减 $10^{-2}$、batch size 1、81 帧 480×832、单卡 A100 80GB 训 10 个 epoch;三个任务数据分别来自 Ditto(约 13K 对)、VPData(补全 6K+、深度转视频约 7K,深度用 Video-Depth-Anything 提取)。第五步,零样本部署:控制分支直接接到冻结 Causal Forcing 骨干,不微调不蒸馏,逐帧算条件、无额外 KV 缓存,单张 H100 达 15 FPS。
技术新颖性
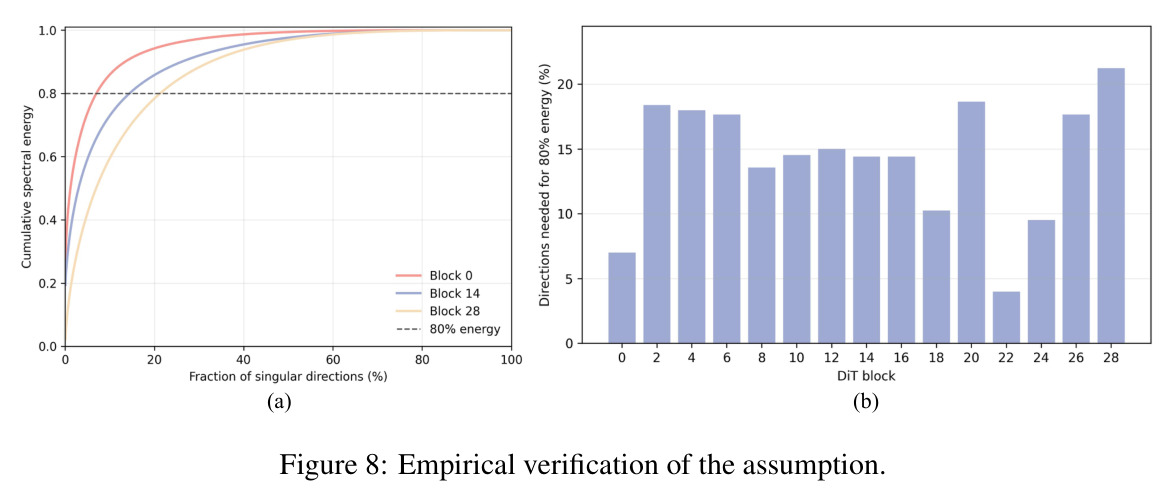
新颖性有三点。其一,这是首个研究『双向到流式视频编辑能力迁移、且不重训练或蒸馏流式骨干』的工作,把流式编辑从『重新训练』范式(约 128 个 H100 GPU 日)转变为『特征对齐』范式(单卡 A100 十个 epoch)。其二,时间独立 2D 注意力有清晰的实证动机链:作者先用三种结构的对照迁移实验验证 3D 注意力会退化,再据此改造 VACE,而非凭经验设计。其三,ODT 借鉴模型合并的 task vector 干扰分析与可组合扩散模型理论,给出两条定理:定理 1 证明把 $\Delta W_2$ 投影到 $\Delta W_1$ 主子空间正交补后,干扰被尾部能量约束,$\|E_1\|_2\le\sigma_{k+1}(XP)\|\Delta W_2\|_2$;定理 2 证明复合误差 $E_{\text{comp}}=\langle\Delta W_1,H_W\Delta W_2\rangle+o(\cdot)$ 被尾部奇异值约束。附录 A 实证显示每个 DiT 块只需 4%–21% 的方向即可解释 80% 谱能量,支撑差异低秩假设。
实验结果
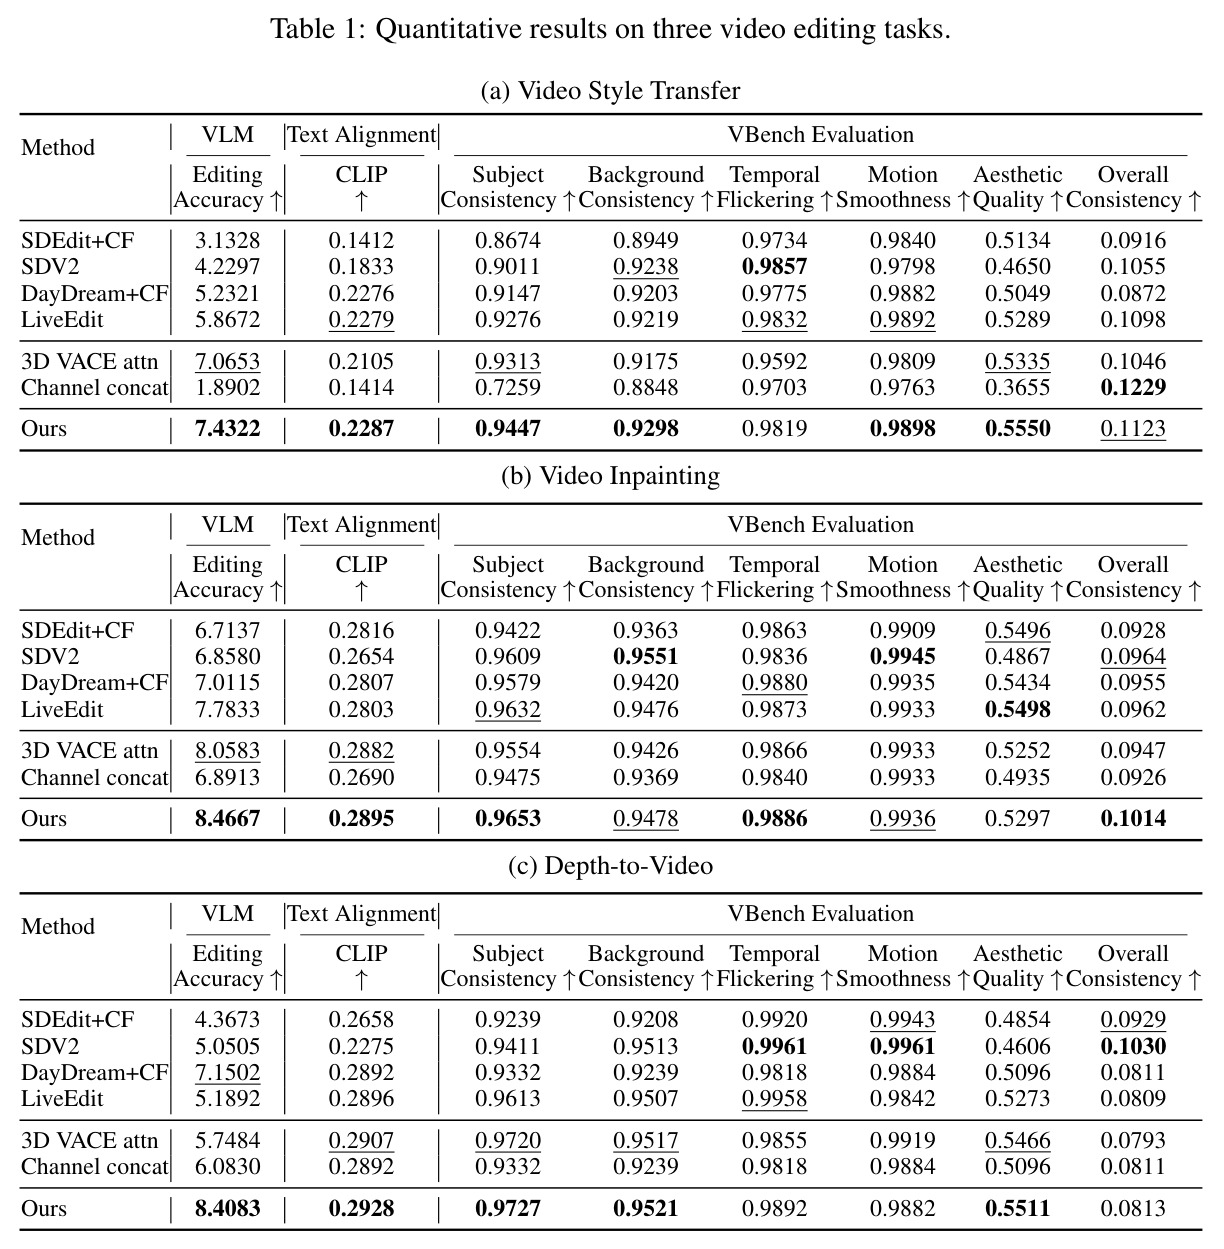
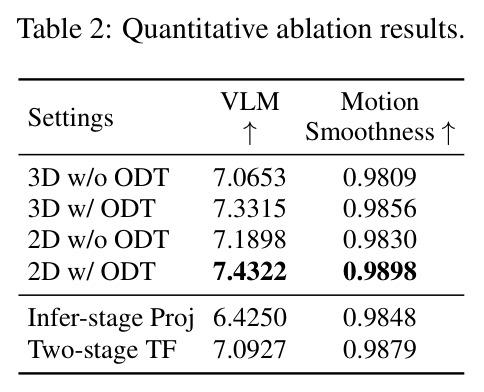
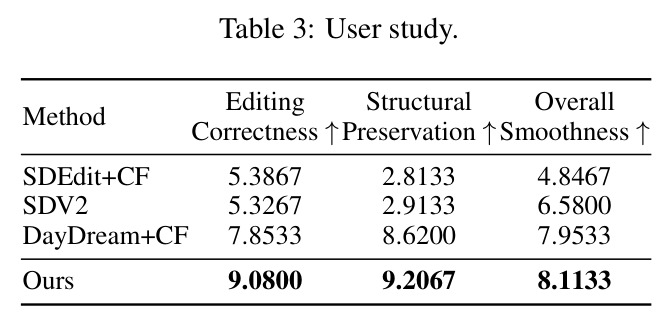
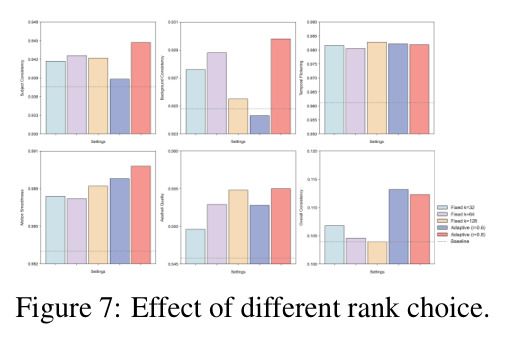
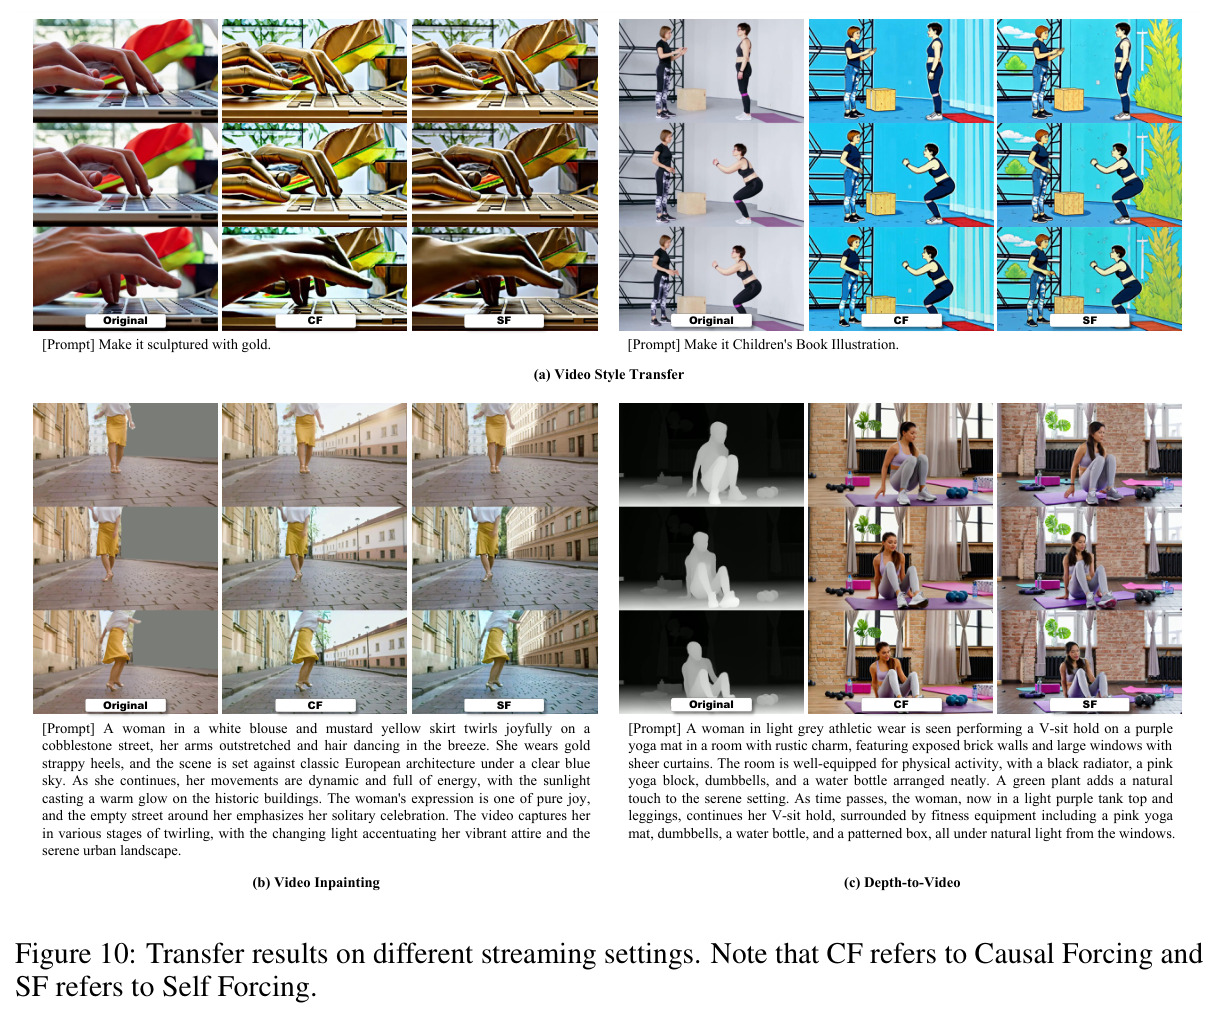
结果分四块。(1) 主实验(Table 1):三任务全面领先。风格迁移 VLM 编辑准确率 7.4322,显著高于 LiveEdit 5.8672、DayDream+CF 5.2321、StreamDiffusionV2 4.2297、SDEdit+CF 3.1328;补全 8.4667 对 LiveEdit 7.7833;深度转视频 8.4083 对 DayDream+CF 7.1502、3D 注意力对照 5.7484;三任务 CLIP-T 同步最优(0.2287/0.2895/0.2928),VBench 各项基本第一(主体一致性最高 0.9727、美学 0.5550);单张 H100 无加速 15 FPS。(2) 消融(Table 2):2D+ODT 最好(VLM 7.4322、平滑度 0.9898),3D+ODT 7.3315、2D 无 ODT 7.1898、3D 无 ODT 7.0653,推理期投影 6.4250 且结构漂移严重,两阶段教师强制 7.0927 且需适配骨干,证明两个组件互补。(3) 用户研究(Table 3):10 人评 15 视频,本文编辑正确性 9.08、结构保持 9.2067、流畅度 8.1133,全面优于 DayDream+CF。(4) 秩与迁移性:自适应 80% 谱能量优于固定秩 32/64/128;同一控制分支可零改动迁移到 Self Forcing 骨干(Fig 10)。
局限与改进
作者自己承认方法『仍然依赖底层双向编辑模型的能力』——若 VACE 本身不擅长某类编辑,迁移后同样不会,且把该范式扩展到更广任务和更异构骨干仍是未来工作。我的补充观察:(1) 每个任务单独训练一个控制分支(风格/补全/深度各一套 LoRA),没有展示统一多任务分支,工程成本随任务数线性增长;(2) ODT 需要一次性构造 500+ 样本校准集并对每个 DiT 块做岭回归和 SVD,更换流式骨干必须重算投影矩阵;(3) 实验固定在 480×832 分辨率、81 帧和 1.3B 参数规模,未验证更大模型、更高分辨率和任意长度视频;(4) 理论分析假设 Hessian 近似对角且基于线性化模型,而真实 DiT 强非线性,误差界可能偏松,论文也仅以非正式(informal)形式陈述;(5) 用户研究仅 10 人 15 个视频,测试集每任务 80–120 样本,规模偏小。
独立分析的弱点
独立分析四个弱点。第一,控制分支按任务割裂:风格迁移、补全、深度转视频各训一套 LoRA,实际产品需要任务路由或统一分支,改进方向是引入任务指令编码器或多任务混合训练并保留 ODT 约束,验证统一分支下正交子空间是否仍然成立。第二,校准开销与骨干对耦合:ODT 的投影 $\Pi_\perp$ 依赖特定的双向-流式骨干组合,从 Causal Forcing 换到未来新骨干需要重跑校准与 SVD,可研究骨干无关的通用差异子空间、在线自适应估计或增量校准。第三,评估规模与指标相关性存疑:每任务测试集仅 80–120 个视频、用户研究 10 人,且 VBench 与编辑质量的相关性不一致——例如补全任务上通道拼接的 VBench 分数与 SDEdit+CF 接近,但 VLM 编辑分数(6.89 对 6.71)与人眼观感差距明显,建议补充大规模人评和真实下游应用评测。第四,分辨率与帧数固定在 480×832/81 帧,直播场景需要任意长度与更高分辨率,控制分支逐帧编码理论上外推性好,但论文未实测,可补充长视频压力测试。此外 15 FPS 仅在 H100 上报告,消费级 GPU 的可用性未知。
未来方向
作者明确提出两个方向:把该迁移范式扩展到更广的编辑任务(目前只验证风格迁移、补全、深度转视频三类)和更多异构骨干架构。基于本文成果还可以延伸:(1) 构建统一控制分支,用一套 LoRA 同时服务多任务,结合编辑指令实现『任意指令流式编辑』;(2) 把 ODT 的正交子空间思想推广到其他双向到因果的迁移场景,例如可控文生视频、姿态驱动实时虚拟人、交互式世界模型;(3) 研究投影矩阵的轻量化更新与跨骨干复用,用元学习或谱结构先验减少每次换骨干的重校准成本;(4) 利用控制分支逐帧计算、无额外缓存的天性,与前端推理流水线(如 StreamDiffusion 式系统优化)融合,在消费级硬件上逼近实时;(5) 理论上放宽 Hessian 对角假设,给出实际 DiT 中复合误差的实证测量,并研究差异子空间随模型规模和训练时长的缩放规律。
复现评估
复现条件较为友好。代码方面论文摘要声明随文开源。数据方面三个训练集均来自公开资源:风格迁移从 Ditto 数据集采样 26 种风格、每风格约 500 段共约 13K 训练对;补全与深度转视频从 VPData 采样(6K+/约 7K);深度条件用开源的 Video-Depth-Anything 提取,训练与评测用同一深度流水线保证一致;测试集为不相交的 120(风格)/80(补全)/80(深度)个留出样本。算力方面训练只需单卡 A100 80GB、每任务 10 个 epoch、batch size 1,属于学术实验室可负担范围;ODT 额外需要 500+ 校准样本的骨干前向收集与逐层 SVD,开销可控。推理达到 15 FPS 需单张 H100,其他 GPU 未报告。主要不确定性在于 LoRA 秩 128、80% 能量阈值等超参对其他骨干/任务的敏感性,以及复现者能否拿到与作者一致的 VACE 与 Causal Forcing 权重版本。
论文图表
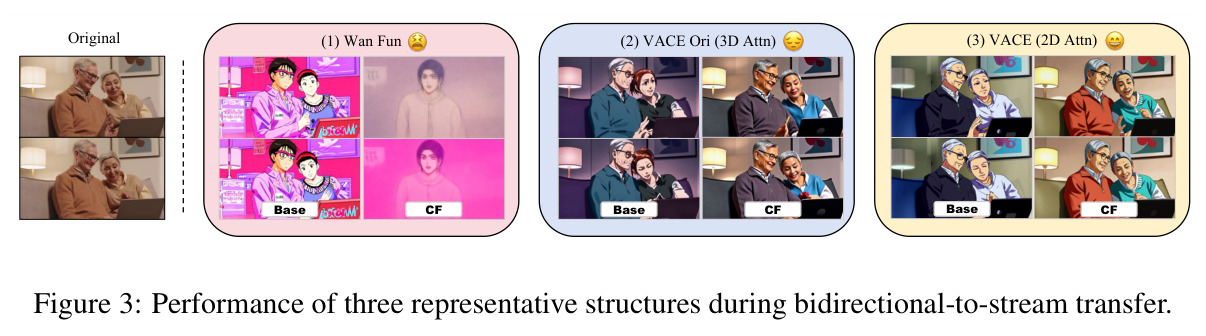
对比 Wan Fun(微调主干参数)、VACE 3D 注意力、VACE 2D 注意力三种结构在 Base(双向)与 CF(Causal Forcing 流式)两种设置下的编辑效果,展示 Wan Fun 迁移后几乎完全失败、3D 注意力只保留部分能力且时序不稳、2D 注意力迁移最可靠。
这是提出两条设计原则(骨干特征解耦、条件帧独立)的实证依据,是全文动机链的起点,解释了为什么方法长成这个样子。
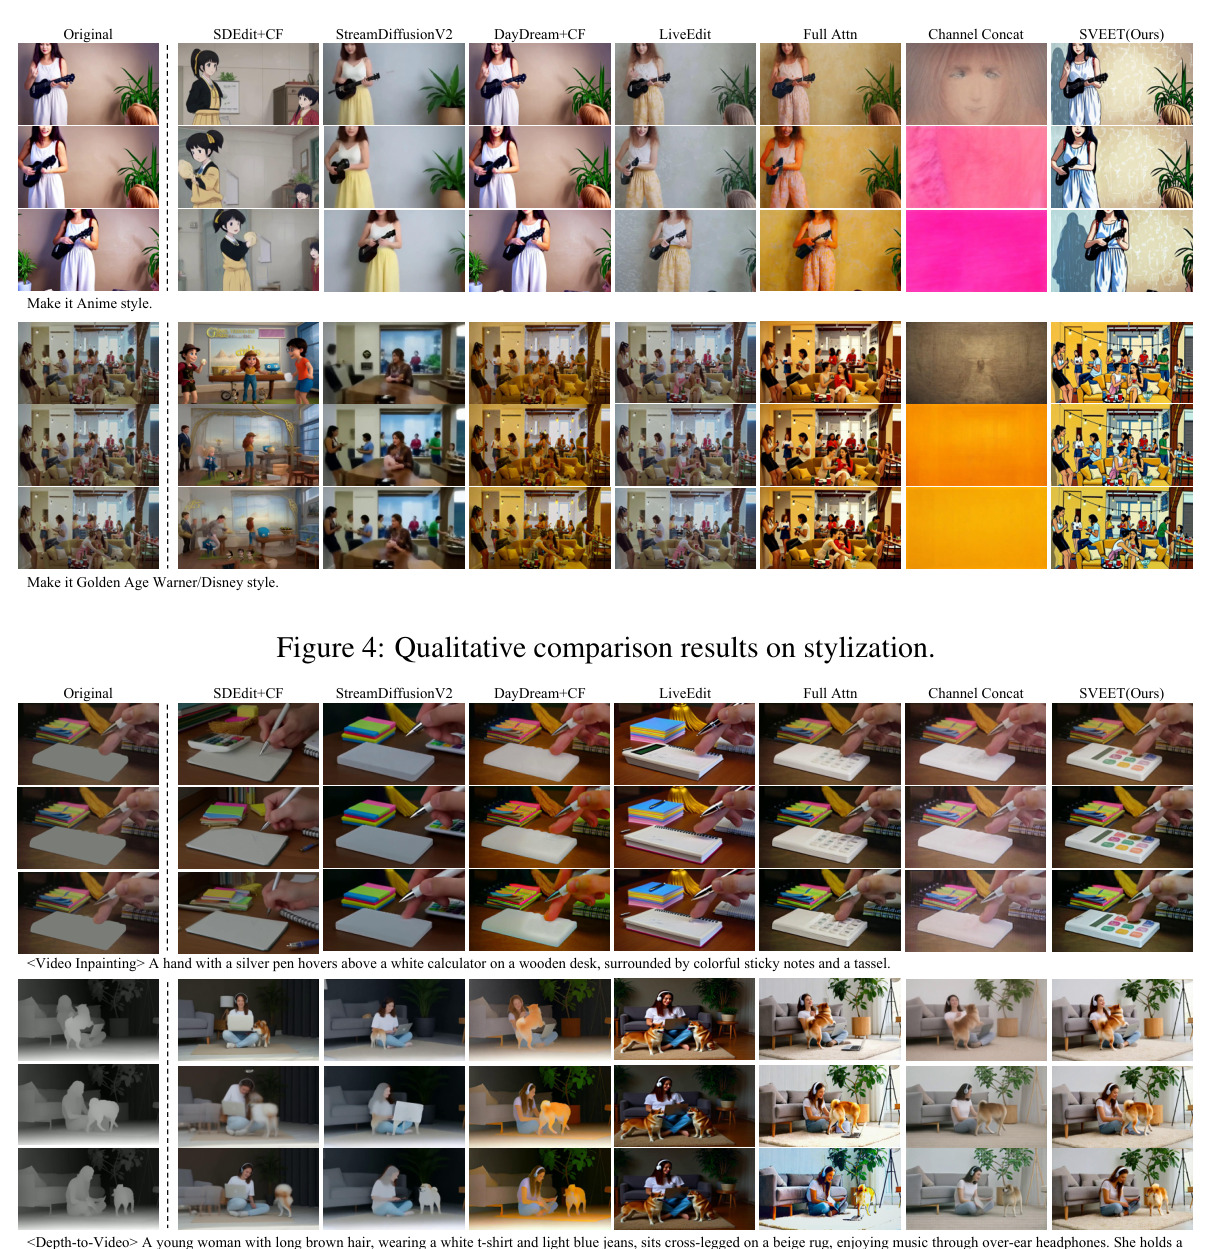
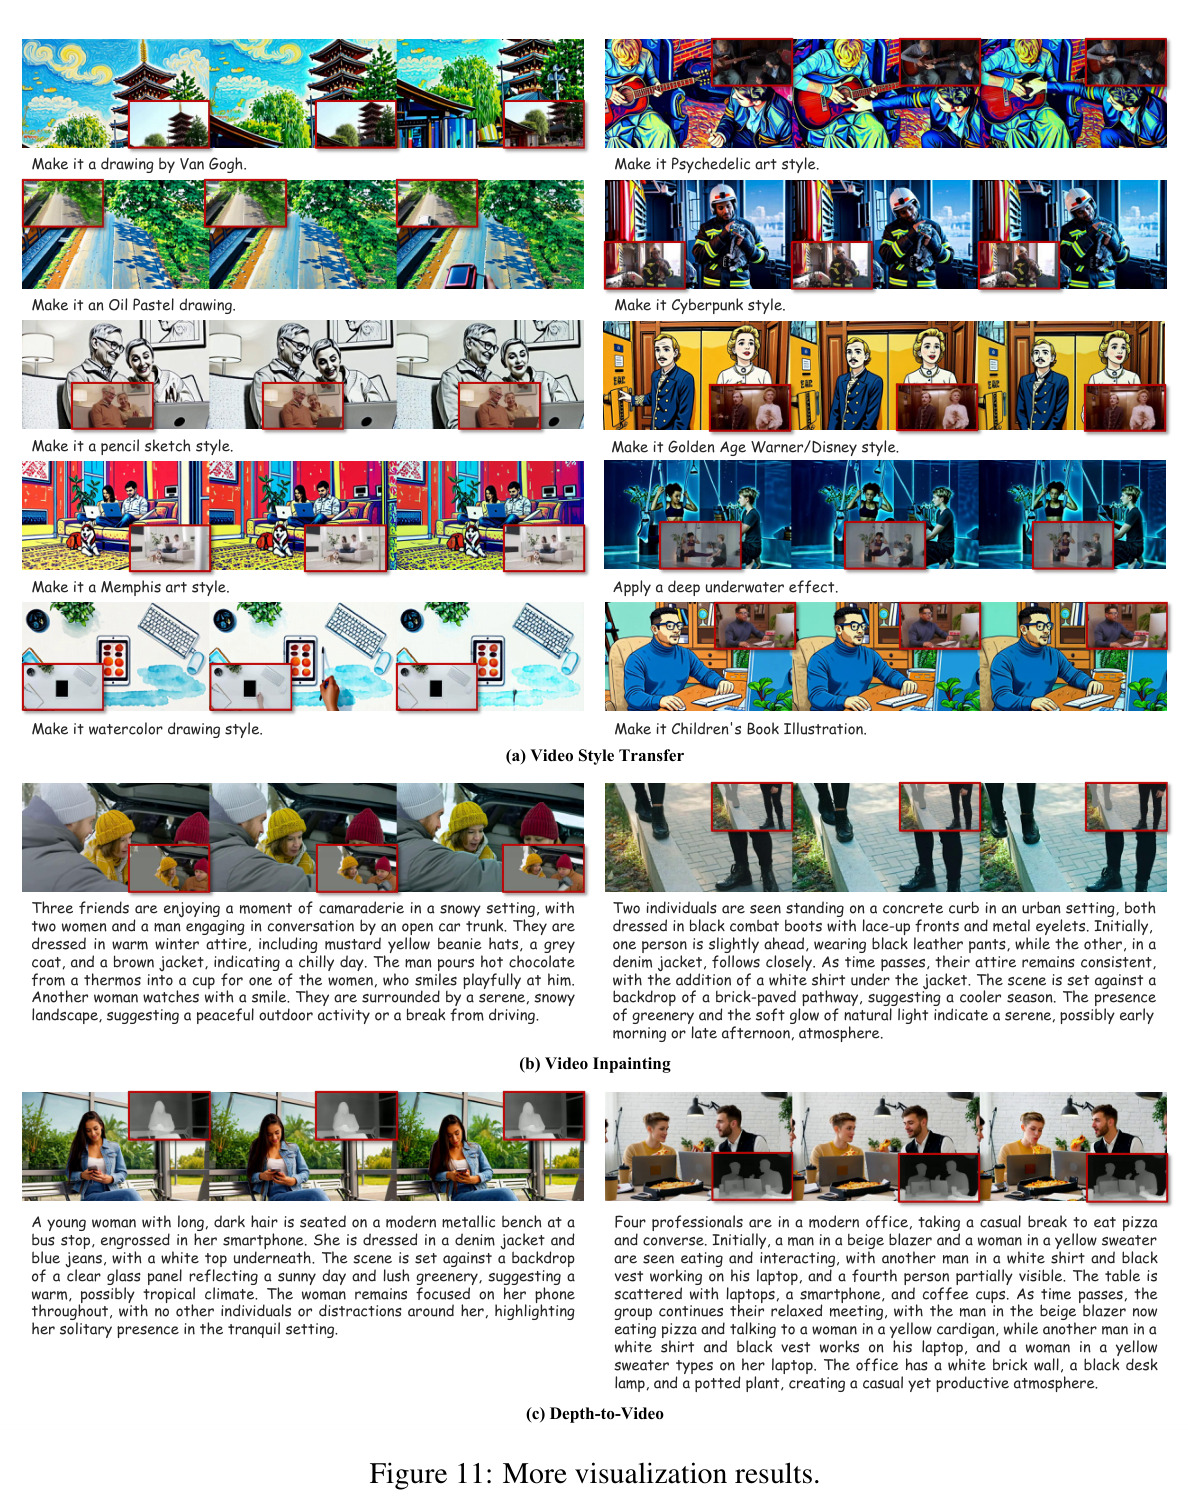
补全任务(银笔悬停在计算器上方等场景的掩码重建)和深度转视频任务(戴耳机女子、柴犬等深度条件重建)与各基线的视觉对比,本文输出质量与时序稳定性最好。
覆盖另两个主任务,验证方法不只在风格迁移有效,在结构条件驱动的任务上同样领先。