Benchmark Radar:面向 AI 基准与评估的活数据库和搜索引擎 Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation
汇聚1283条基准记录与12916条分数观测的可检索评估证据平台
前置知识
BM25F 字段加权词法检索
经典 BM25 的多字段扩展,用于结构化文档检索。它对标题、摘要、描述等字段分别统计词频并加权融合,基础打分为 $\text{score}(q,d)=\sum_{t\in q}\text{IDF}(t)\cdot\frac{f(t,d)(k_1+1)}{f(t,d)+k_1(1-b+b\,|d|/\text{avgdl})}$,其中 $f(t,d)$ 是词 $t$ 在文档 $d$ 中的频次,$k_1$ 控制词频饱和速度、$b$ 控制文档长度归一化强度。Benchmark Radar 在此基础上对基准名称与短语匹配施加有界增益,并保持来源归属不影响排序。
论文的核心检索机制就是 BM25F。理解字段加权与有界增益,才能明白搜索结果如何排序、为什么结果页要暴露匹配/缺失词、所在字段与分数构成,也才能理解作者承认的「词法匹配会漏掉改述与改名任务」这一限制的根源。
帕累托前沿 (Pareto Frontier)
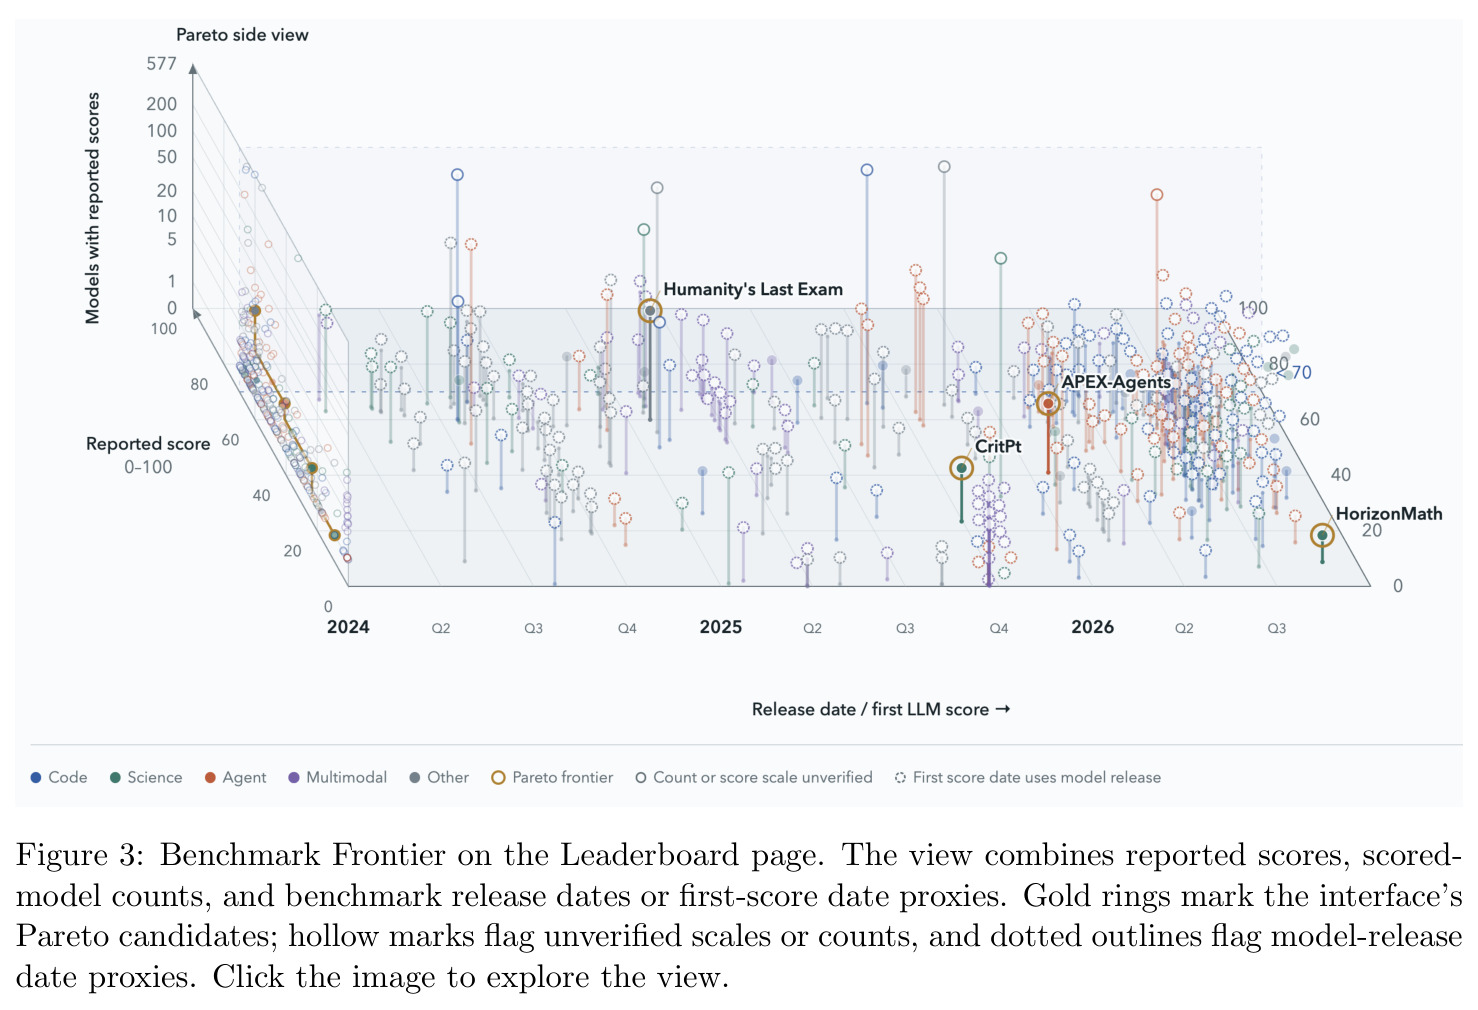
多目标优化中的概念:当多个目标无法同时达到最优时,若某个解不能在不损害任何一个目标的前提下改进另一个目标,它就位于帕累托前沿上。本文的排行榜页把「报告分数高」与「被测模型数量多(使用广)」两个维度组合,用金圈标出位于前沿的候选基准,其余记录则存在被支配关系。
图 3 的 Benchmark Frontier 视图完全建立在这个概念上。不理解帕累托最优,就无法读懂系统如何帮助读者在「分数」与「使用广度」之间挑选候选基准,也无法理解金圈、空心标记与虚线轮廓各自的可信度含义。
基准饱和度 (Benchmark Saturation)
当一个基准上模型分数普遍逼近上限、头部模型差距缩小、对能力提升失去区分度时,称该基准饱和。Akhtar 等人对 60 个语言模型基准的系统研究给出了饱和的形式化定义,发现近半数基准已饱和且饱和概率随基准年龄上升,并与专家策划(而非测试数据保密)正相关。
饱和既是论文的动机之一(旧基准失效需要持续发现新基准),也是产品的 Saturation 视图所服务的核心问题。理解饱和才能明白为什么系统要保留完整分数历史,让读者自行判断一条记录是否接近天花板。
源记录 vs. 发现观测
源记录(source record)是一个贡献来源中的一条基准条目,含名称、标识符、工件链接、分数与引用,即使没有分数或日期也保留在目录中;发现观测(discovery observation)是每日采集到的一次提及、发布或更新记录。二者严格分离:观测通过 DOI、arXiv ID、仓库 URL 等精确标识符链接到论文、仓库、数据集等工件,但绝不计入 1,283 条的目录总数。
这是全文最重要的簿记区分:「先保留记录再比较测量」原则、目录与发现历史分离、跨源工件匹配(6,546 个工件中仅 59 个有多源观测)等设计与结论都建立其上,混淆两者会系统性误读论文所有统计数字。
研究动机
评测开发者和大模型团队实际要回答三个问题:哪些评估与我的目标能力相关、去哪里拿到基准的数据集与代码、报告的分数到底在什么设置下测得。现实是这些信息散落在论文服务器(arXiv)、代码托管(GitHub)、数据集平台(Hugging Face Hub)、厂商发布、博客与基准目录等多个独立资源里。现有基础设施各有分工:LLM Stats 提供基准描述与模型结果,OpenCompass 提供评测平台与基准注册表,Artificial Analysis 提供商业模型评测与方法学说明,但把一个新发布的基准与其任务材料、以及它后来在模型卡和技术报告中的使用串联起来,仍要人工跨多个站点检索。更麻烦的是分数本身不可比:Akhtar 等人对 60 个语言模型基准的系统研究发现近半数已饱和且随基准年龄上升;MMLU、GPQA、SWE-bench、FinanceBench 等基准测的能力、提示、数据划分与评分规则各不相同,跨基准聚合分数容易掩盖评测设置差异,让「分数进步」与「能力进步」混为一谈。
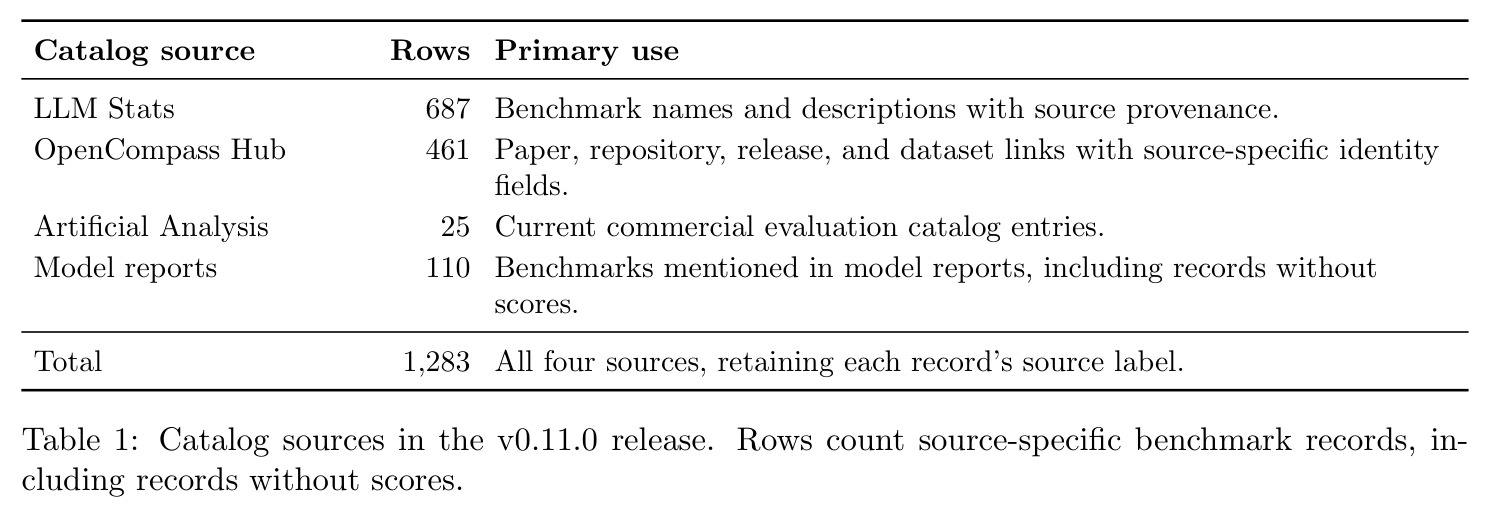
本文的目标是本文要为 AI 基准与评估建一个「活的」数据库和搜索引擎 Benchmark Radar,目标分四层。其一,每日自动发现新的基准论文、代码仓库、数据集与版本发布:接 37 个来源(13 个直连连接器加 24 个第一方研究/工程 feed),形成带日期的发现历史。其二,维护一个可搜索的基准目录,v0.11.0 版含 1,283 条源记录,并收录模型卡与技术报告中的基准提及和 12,916 条数值分数观测。其三,保留来源身份与引用,使读者能从一条分数下钻到论文、仓库、数据集与模型报告原文,审查候选基准及其评测证据,而不是只看聚合数字。其四,交付完整产品形态:带排行榜与帕累托前沿视图的 web 仪表盘、饱和度与趋势视图、每日简报与归档、可下载证据、CLI 离线查询,以及一次可复现的全目录普查审计。
与已有工作不同的是,本文的独特切入是「先保留记录、再比较测量」的证据观,与把多来源分数混排进一张排行榜的常规做法相反。系统为每个来源保留独立记录——即使它没有分数、日期或引用也不删除——用经过人工审核的身份链接关联相关记录,同时保留各自的测量。每日发现的提及/发布观测与基准目录严格分离,11,068 条观测绝不混入 1,283 条记录,防止提及热度伪装成基准数量。分类体系上,能力域做单选主类,而交互范式与输入模态作为可重叠的侧面(facet)记录,使「作为 agent 运行的仓库解题基准」同时可见于编码与智能体两个口径。再配合精确标识符把观测链到工件、贯穿 web/导出/CLI 的同一套稳定基准 ID,最后用一次无任何过滤的全目录普查量化证据可用性——这套组合是把评测基础设施当作可审计测量系统来做,而非又一个展示层。
核心方法
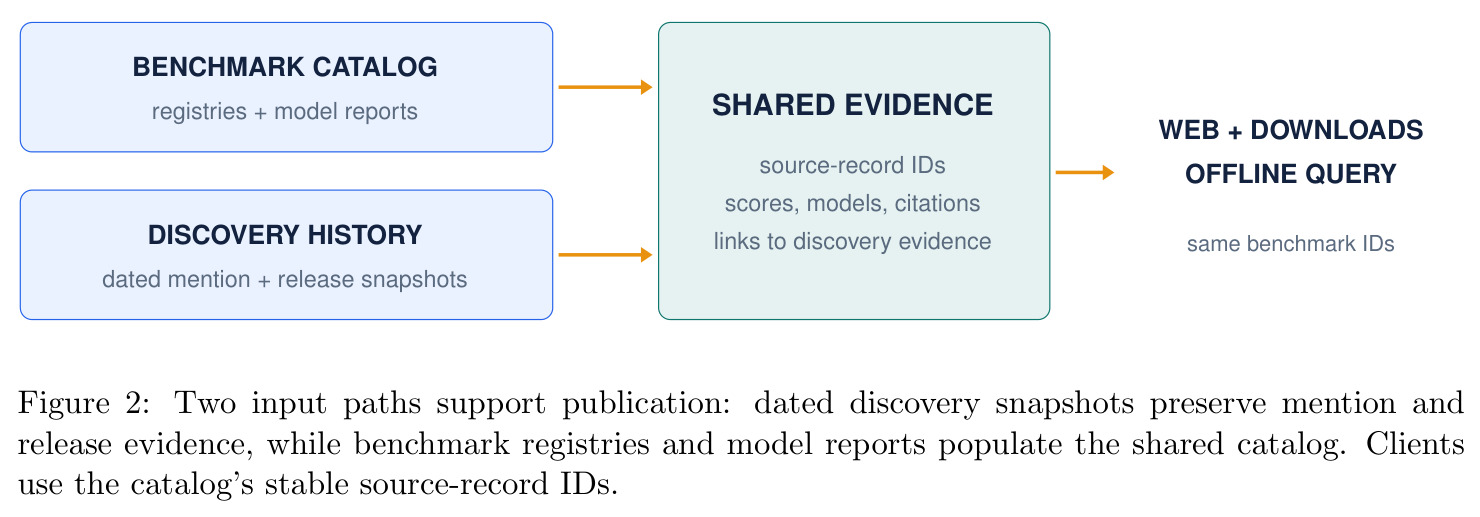
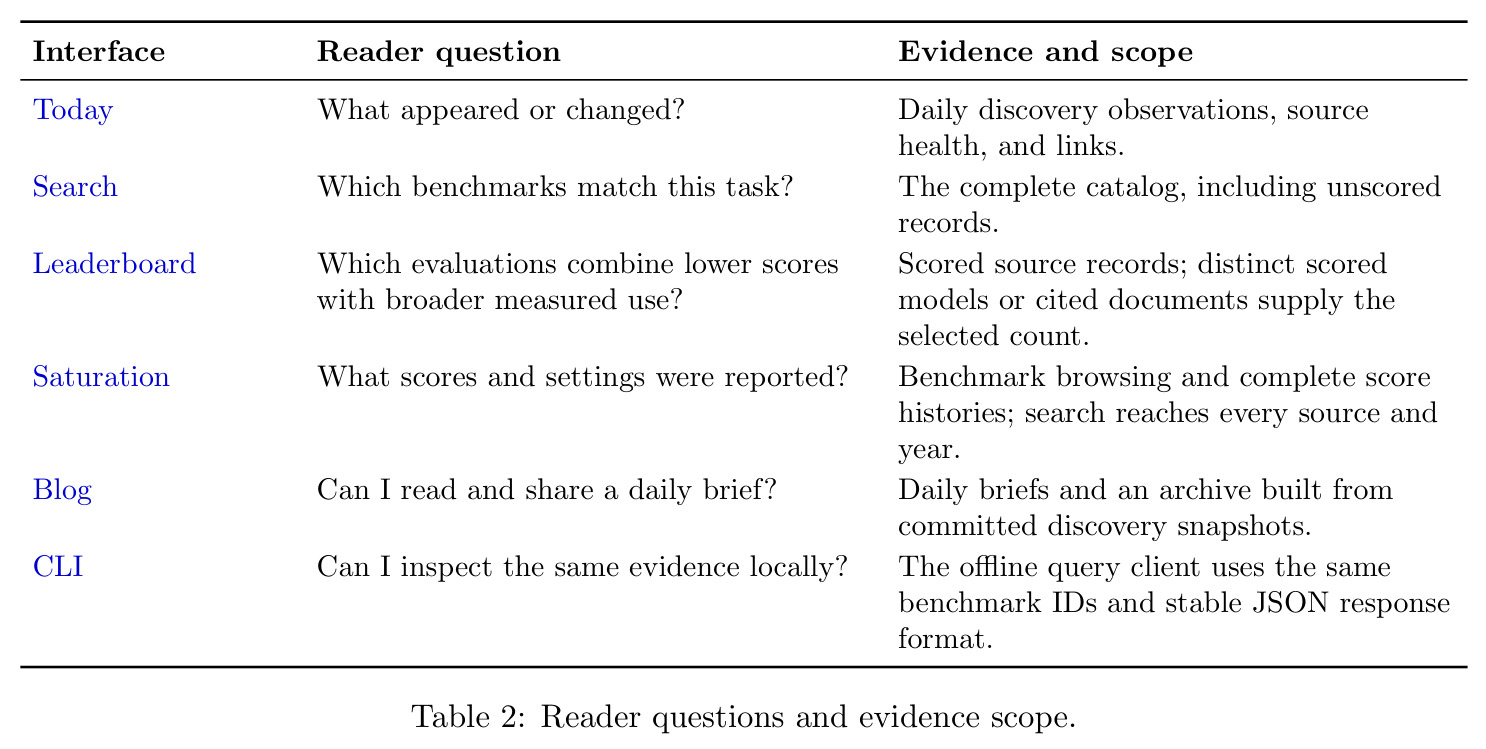
系统改编 BuilderPulse 的每日公开来源采集方式,两条输入路径汇入共享证据层。目录路径在 v0.11.0 收录 1,283 条源记录:LLM Stats 687 条(基准名称、描述与来源溯源)、OpenCompass Hub 461 条(论文/仓库/发布/数据集链接与来源专属身份字段)、Artificial Analysis 25 条(商业评测目录条目)、模型报告 110 条(模型卡、技术报告、系统卡与发布博文中的基准提及,含无分数记录)。发现路径每次运行扫描 48 小时窗口,经 13 个直连连接器与 24 个第一方 feed 采集,记录各源计数与错误、剔除未来日期的行,并要求核心源(arXiv、Hugging Face Hub、GitHub Search)健康后才能发布快照。检索层用 BM25F 字段加权词法评分,对名称与短语匹配施加有界增益,每个结果暴露匹配/缺失词、出现字段与分数构成;同一查询服务以相同 JSON 响应格式支撑 web、HTTP 与 CLI 三种入口。
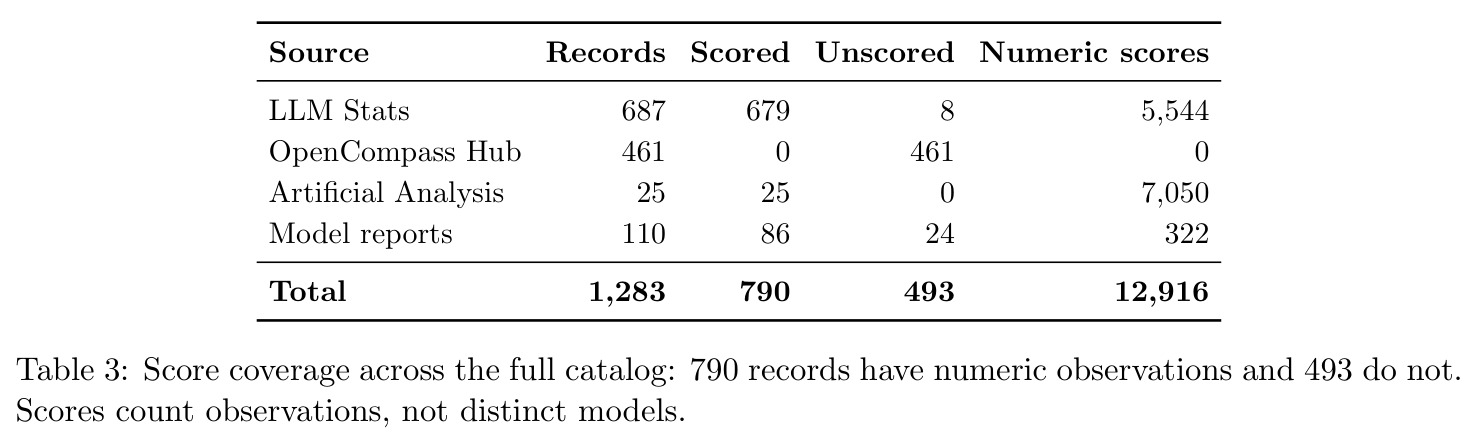
核心原则是「先保留记录,再比较测量」,簿记规则决定后续一切分析的可信度。第一,没有分数、日期或引用的记录仍保留在目录中(493 条),使证据缺口本身成为可度量的对象;经人工审核的身份链接把相关记录连接起来但不合并测量,尊重不同来源对同一基准的独立报告。第二,发现观测与目录计数严格分离:46 个快照累计的 11,068 条观测不计入 1,283 条基准记录,防止「提及热度」伪装成「基准数量」。第三,分类体系区分单选的 Level 1 能力域与可重叠的 facets(交互范式、模态):345 条 agentic 记录中只有 128 条主类是「智能体与工具使用」、117 条在「编码与软件工程」下,单轴分类方案会把这些记录从智能体统计中隐藏。第四,普查按观测 ID、来源模型 ID、文档 ID 去重计数,重复观测不产生额外模型或文档;要做百分比尺度汇总,必须满足声明的百分比单位、已知分数方向和 0–100 数值范围三条判据。
方法步骤详情
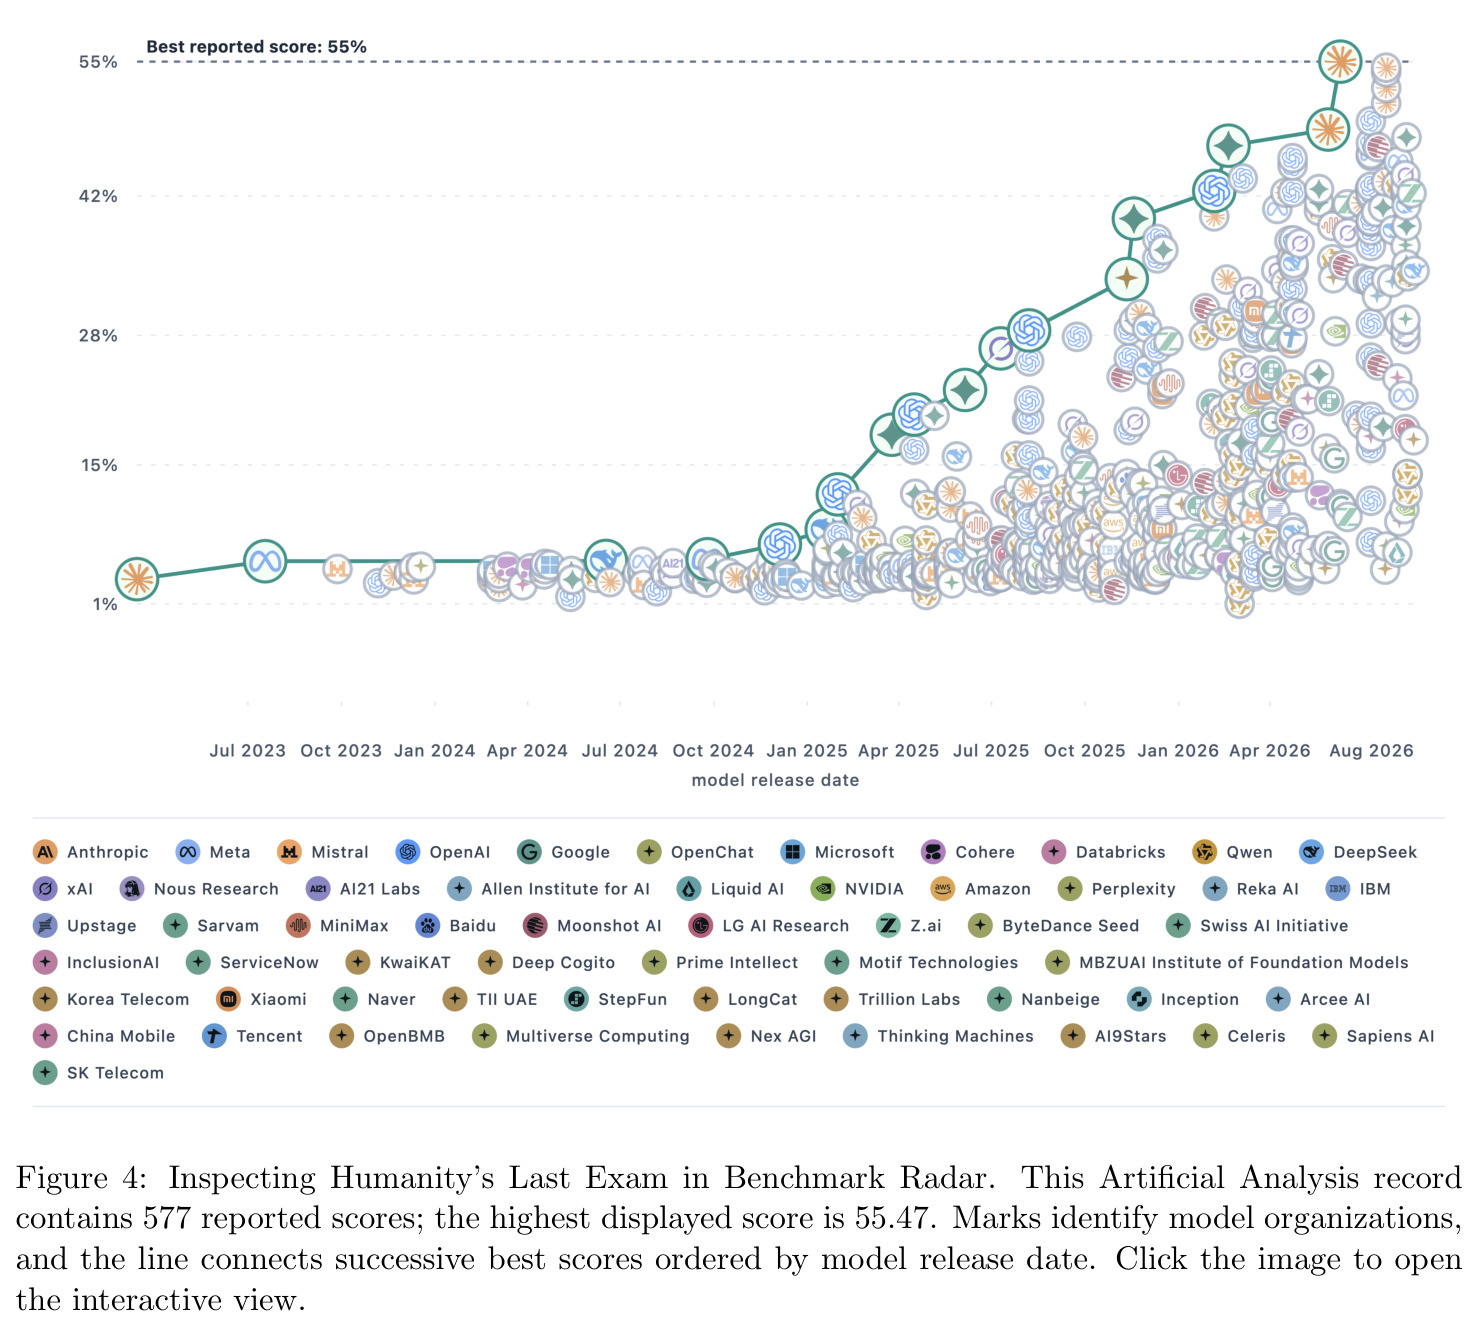
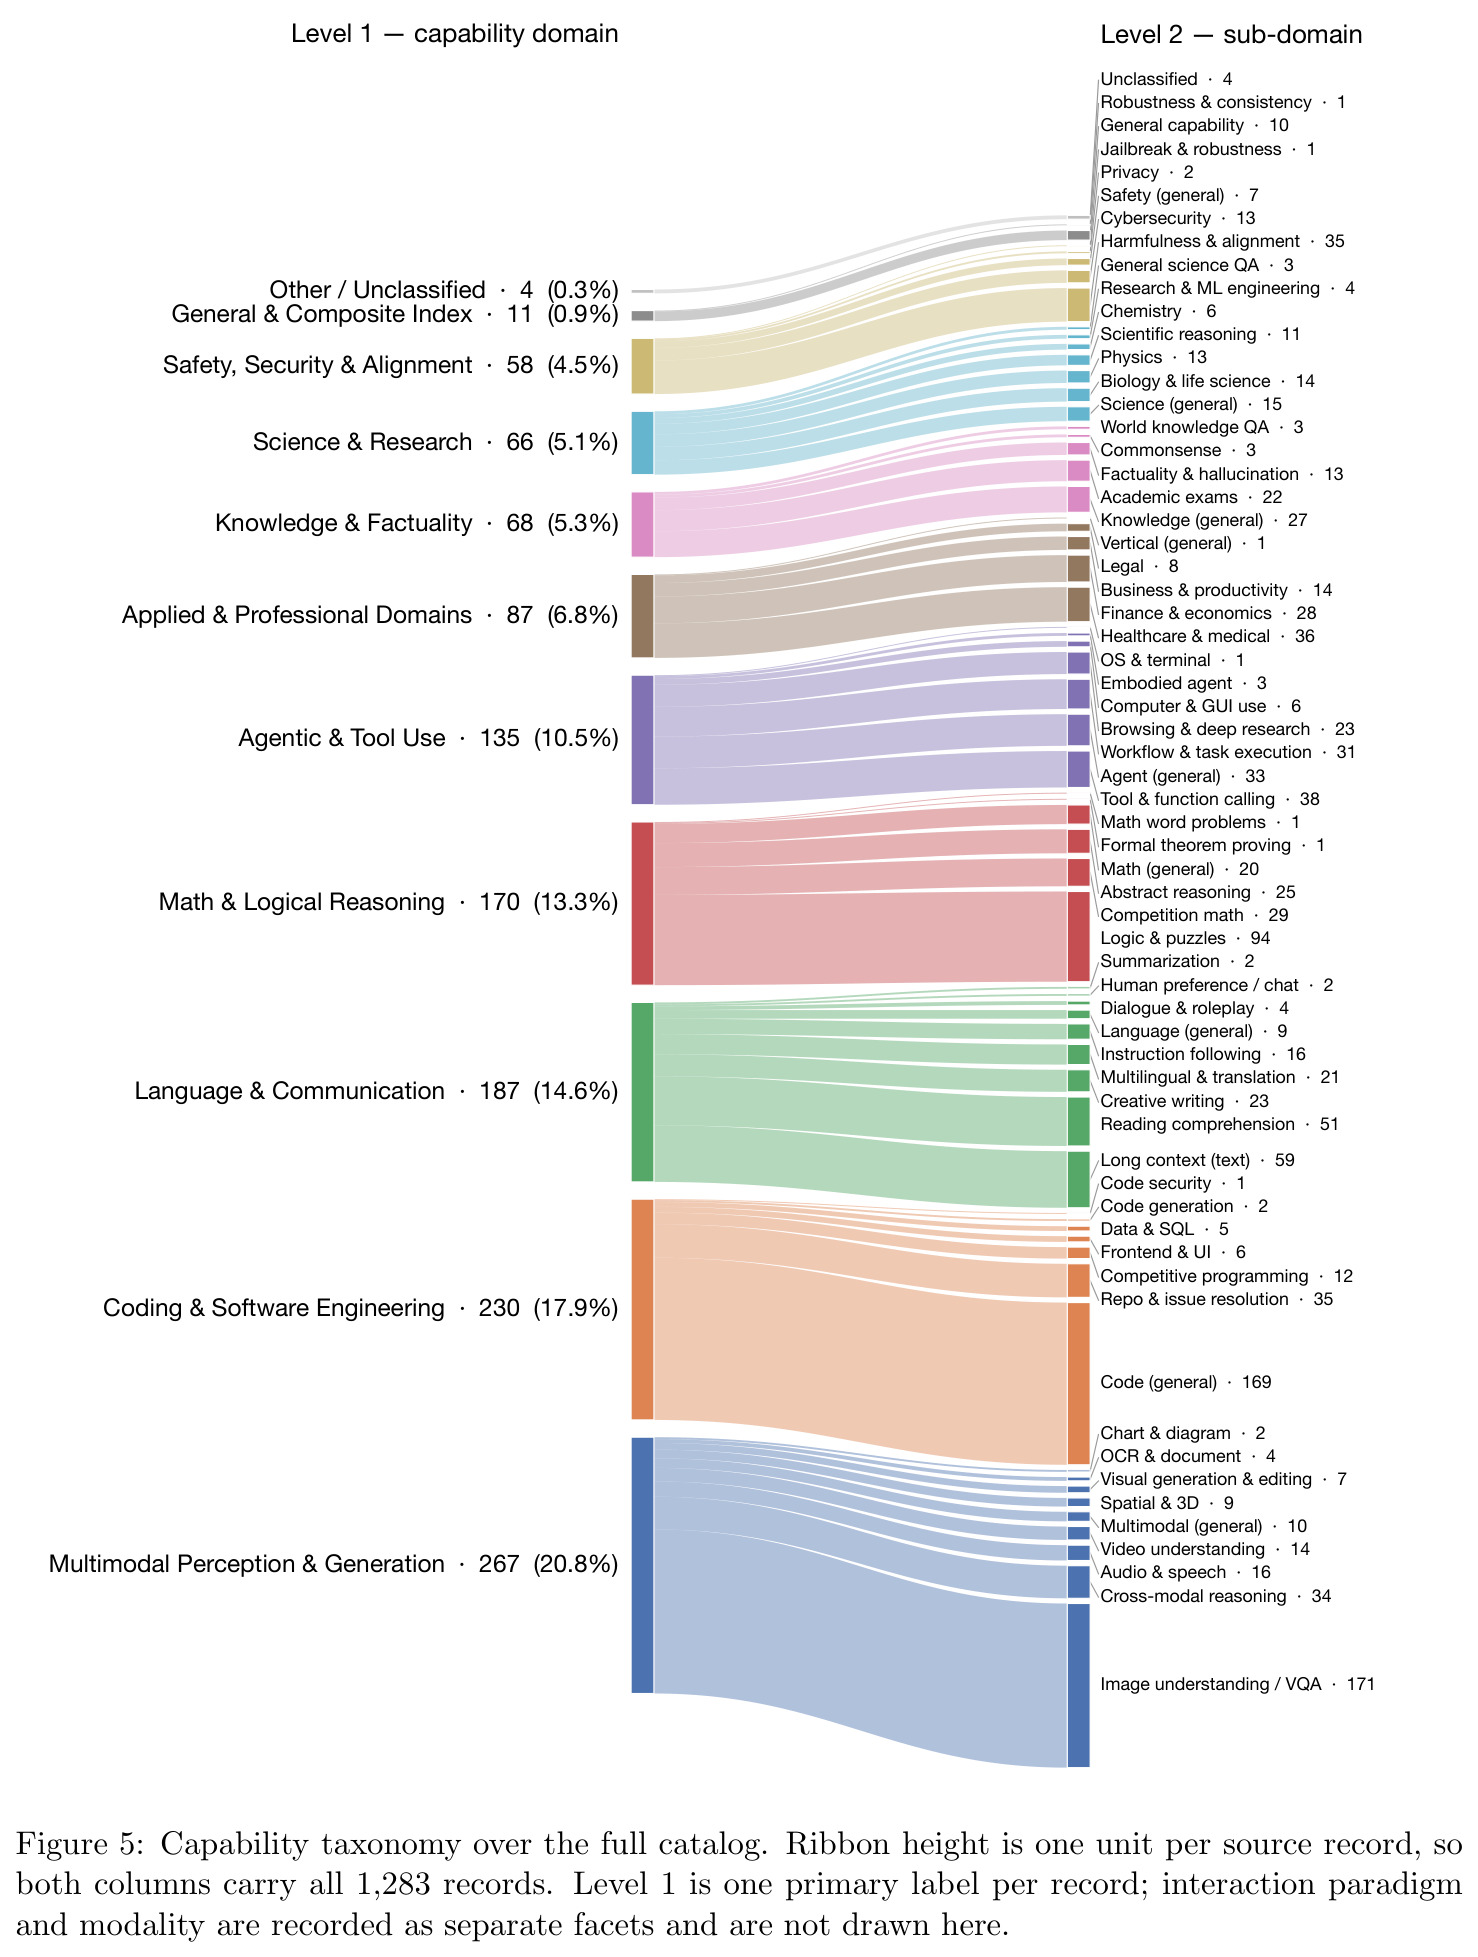
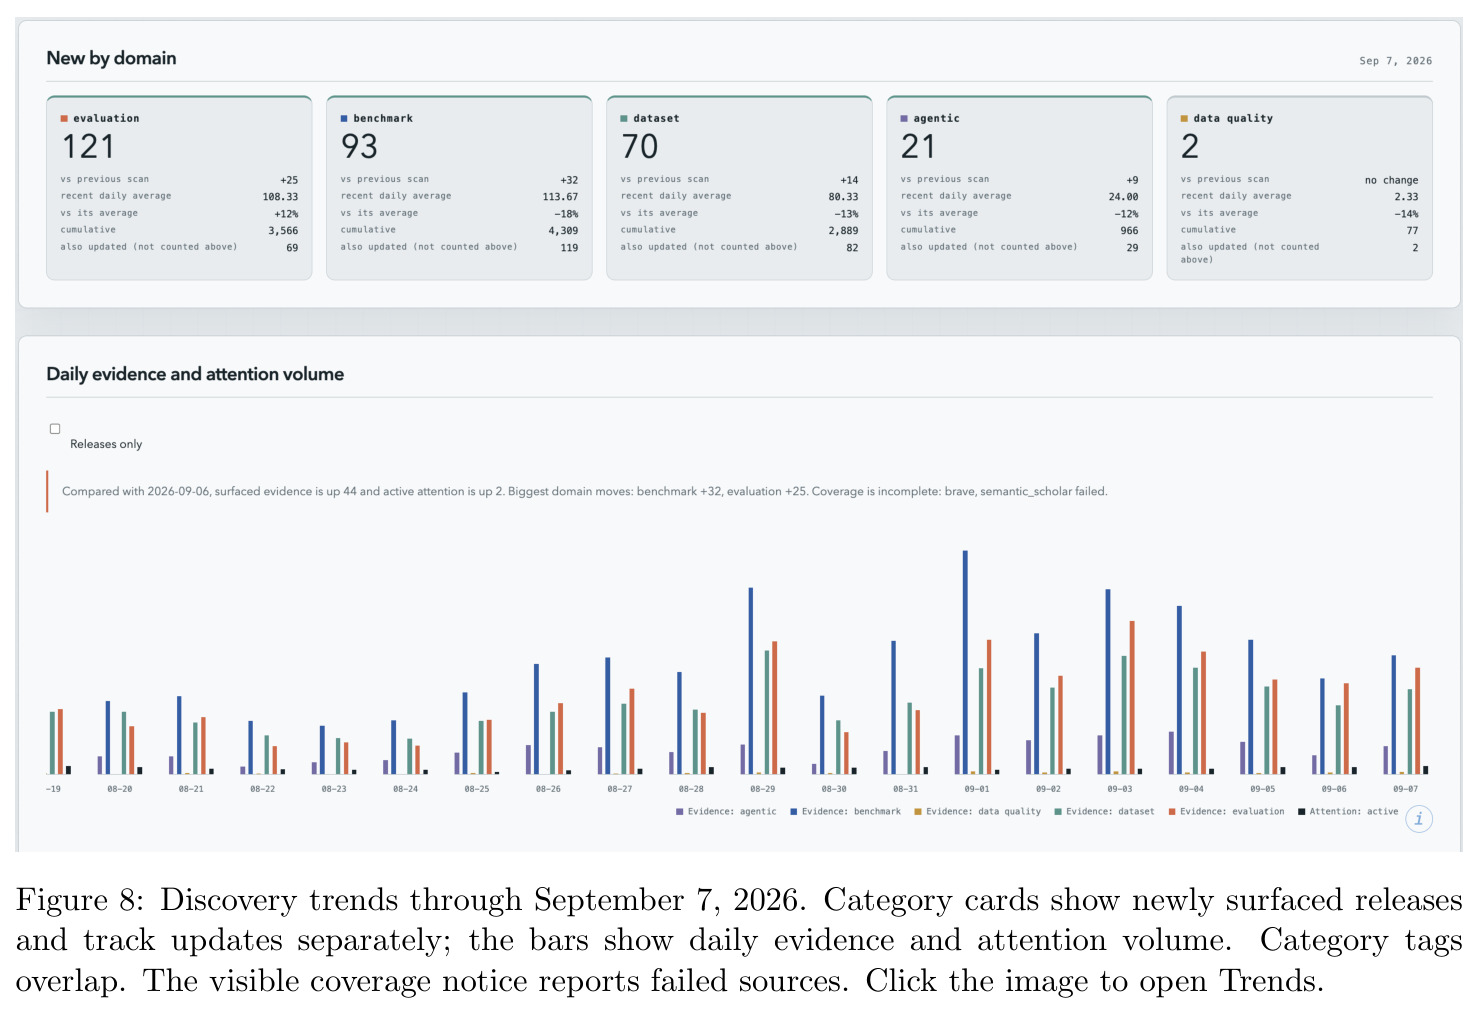
全流程五步。① 每日发现:每次运行对 37 个来源扫描 48 小时窗口,输出带日期快照(含各源计数、错误与覆盖通知),截至 2026-09-07 共 46 个快照、11,068 条观测、6,546 个工件,工件靠 DOI、arXiv ID、仓库 URL 等精确标识符链接。② 目录构建:把 4 个来源的名称、标识符、工件链接、分数观测、模型身份与被引文档规范化到公共字段,生成带稳定源记录 ID 的 1,283 条记录。③ 索引与检索:对完整目录建 BM25F 索引(来源归属不参与排序),统一查询服务向 CLI 与 HTTP 提供相同响应格式,结果暴露匹配/缺失词与分数构成,供分析者或 agent 迭代查询并下钻证据。④ 证据呈现:排行榜把报告分数、打分模型数与发布日期组合成帕累托前沿(金圈为候选、空心为未验证尺度、虚线为日期代理);单记录页展示完整分数历史,如 Humanity's Last Exam 一条 Artificial Analysis 记录含 577 个分数、最高显示分 55.47。⑤ 全目录普查:无过滤地读取每条详情文件,按 ID 去重计数,把 1,279/1,283 条分类进 11 个一级域、63 个子域并做年份重加权检验;附录 F 提供软件修订、输入哈希、普查脚本与验证流程。
技术新颖性
与 LLM Stats、OpenCompass、Artificial Analysis 等排行榜/注册表相比,本文不是再造一个榜单,而是把评测基础设施当作可审计的测量系统:其一,把每日发现、工件历史、基准检索与来源审查整合为 web 与离线共享访问,读者能从一条分数下钻到论文、仓库、数据集与模型报告原文;其二,诚实量化证据缺口——493 条无分数记录中 464 条仍带工件链接,4 条 LLM Stats 社区行因无任何描述、类别或模态而标注「不分类」而非从标题强行归类;其三,方法学纪律贯穿始终:facet 与主类分离、发布年份按来源构成重加权检验稳健性(agentic 份额移动不超过 1.1 个百分点)、模型发布日期不替代评测日期、百分比尺度有三条准入判据;其四,普查可复现(脚本加输入哈希),并用一个编码 agent 借助 CLI 和公共 Skill 完成先行工作检索的真实案例,演示了从候选检索到人工比对的端到端用法。
实验结果
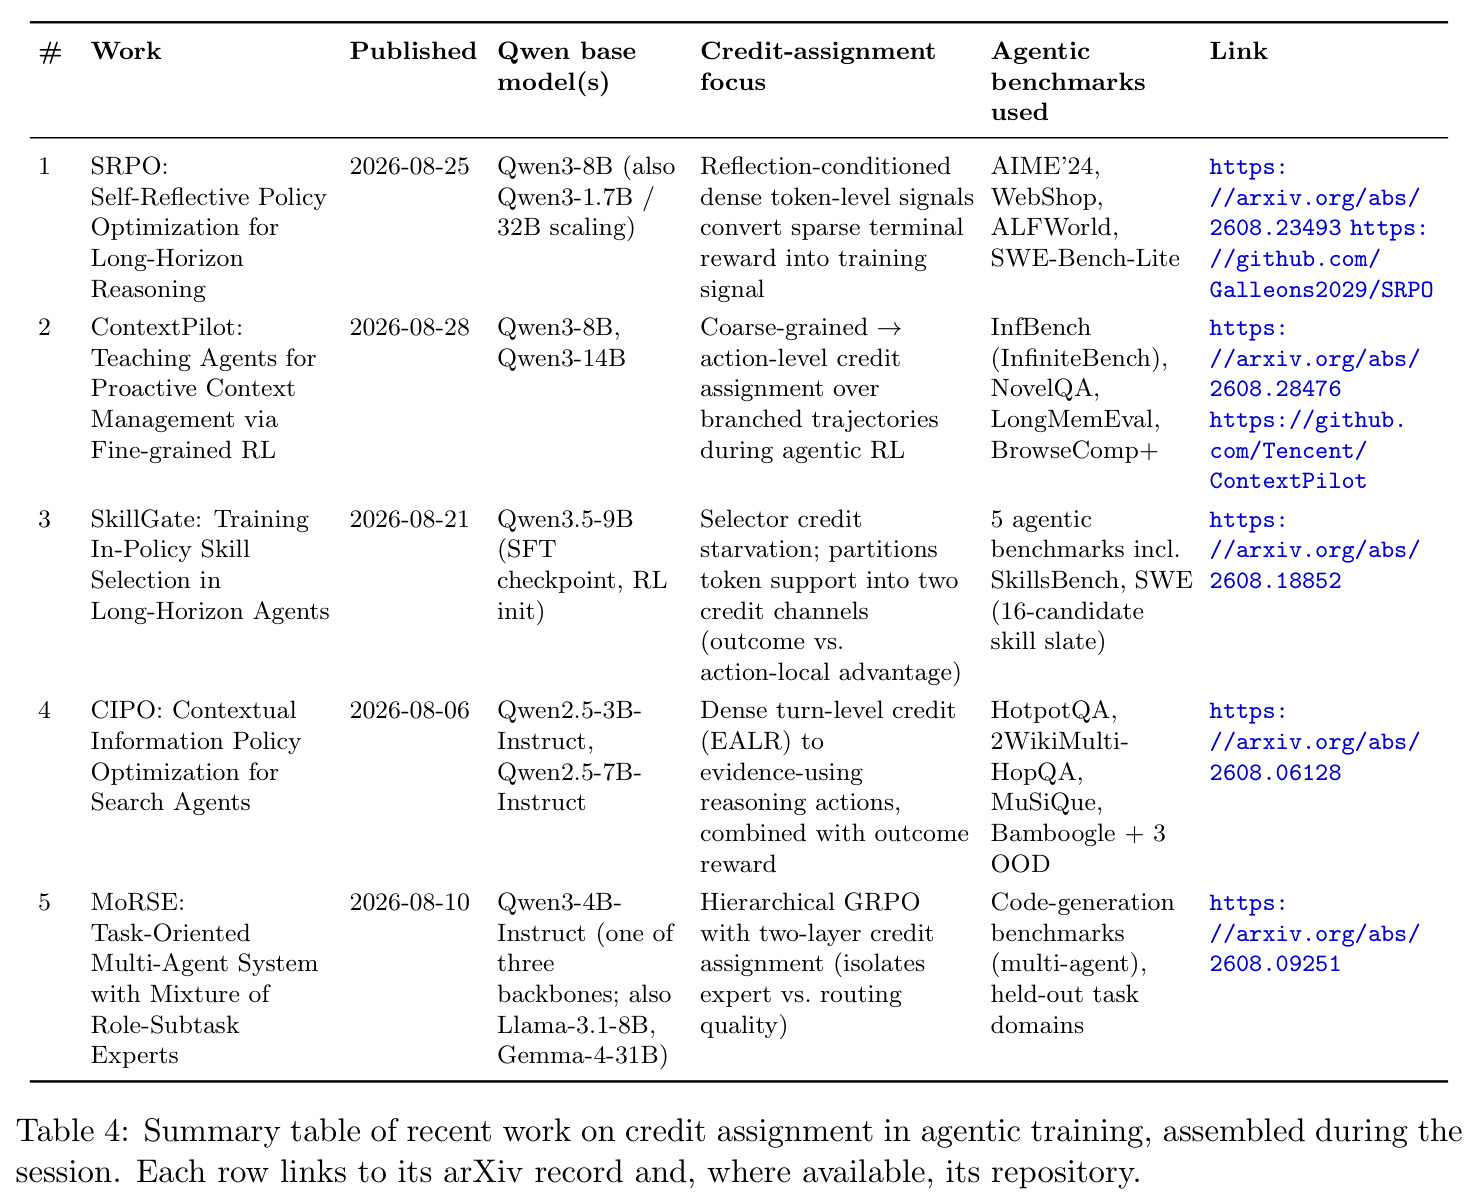
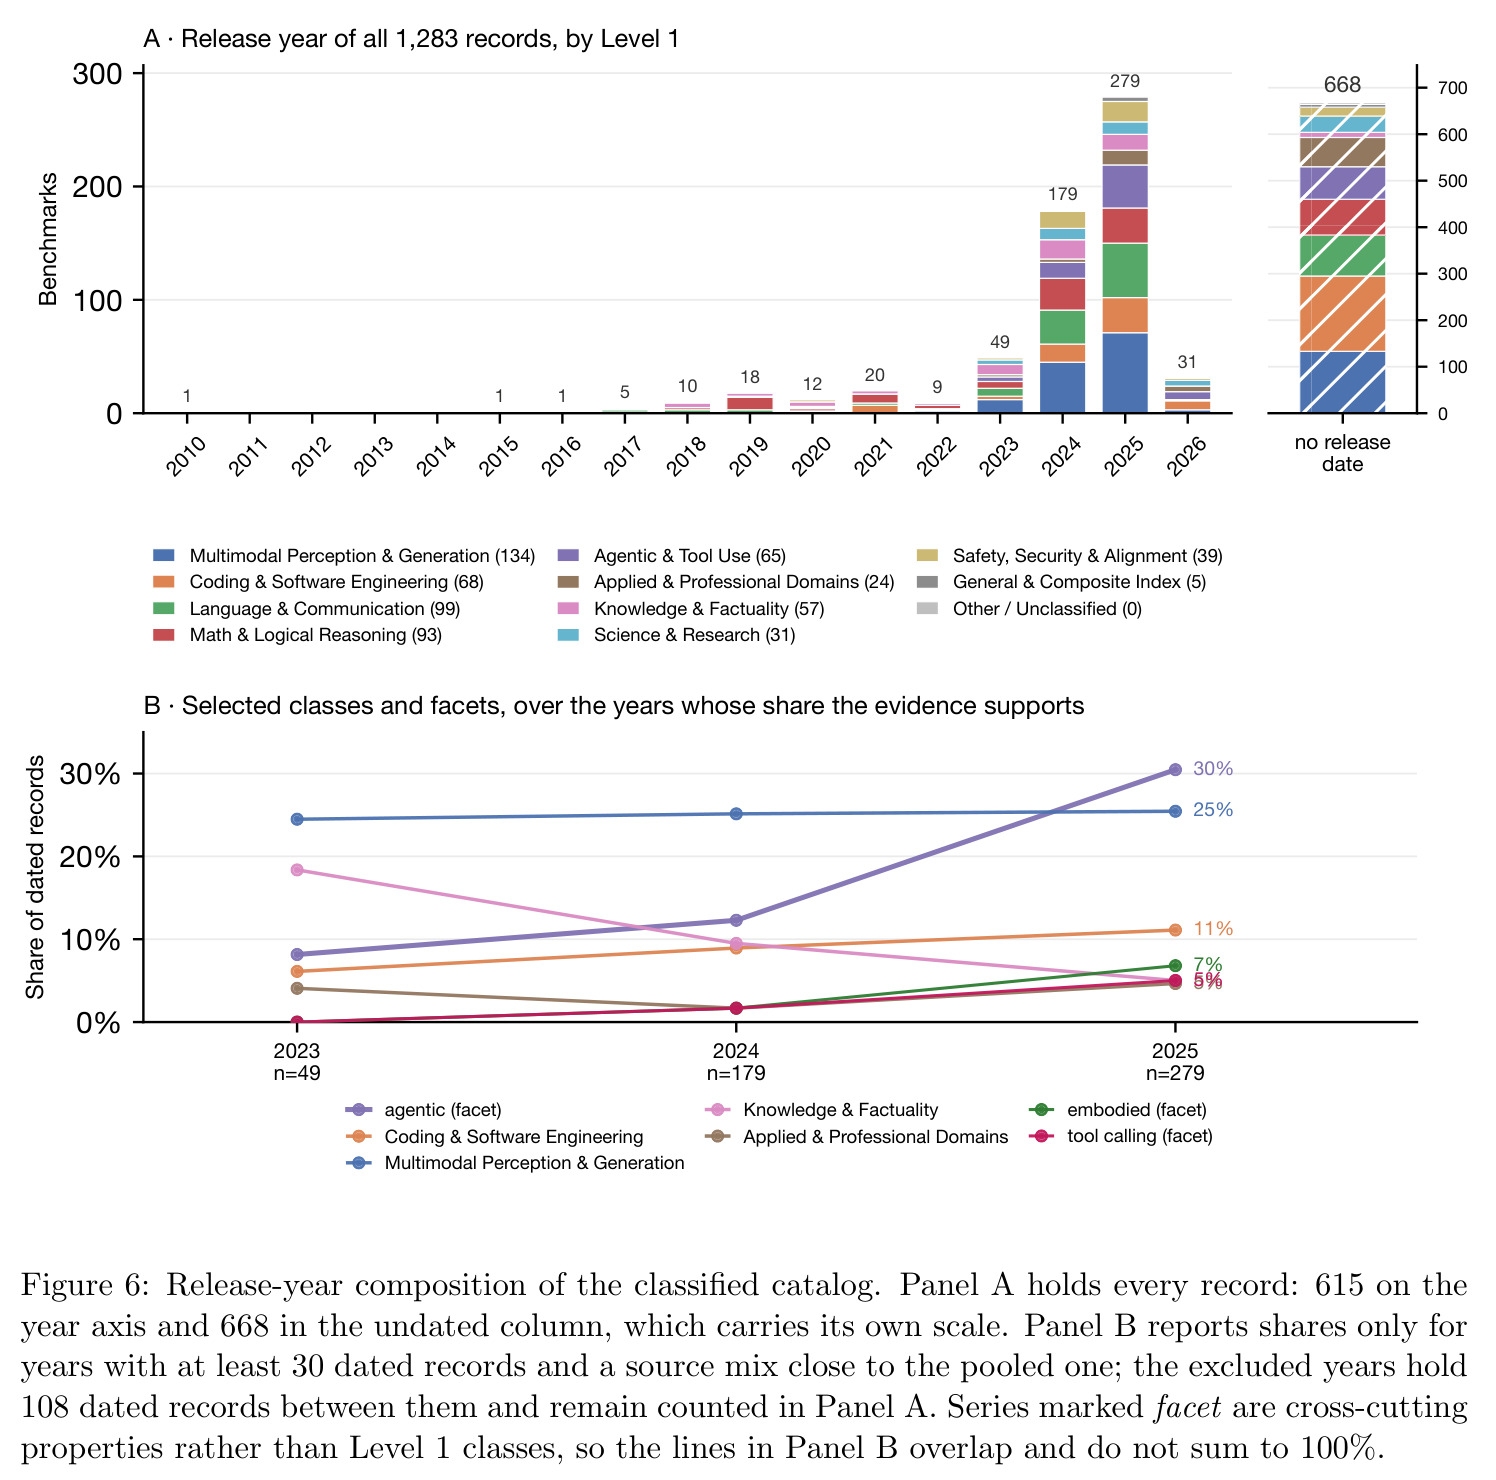
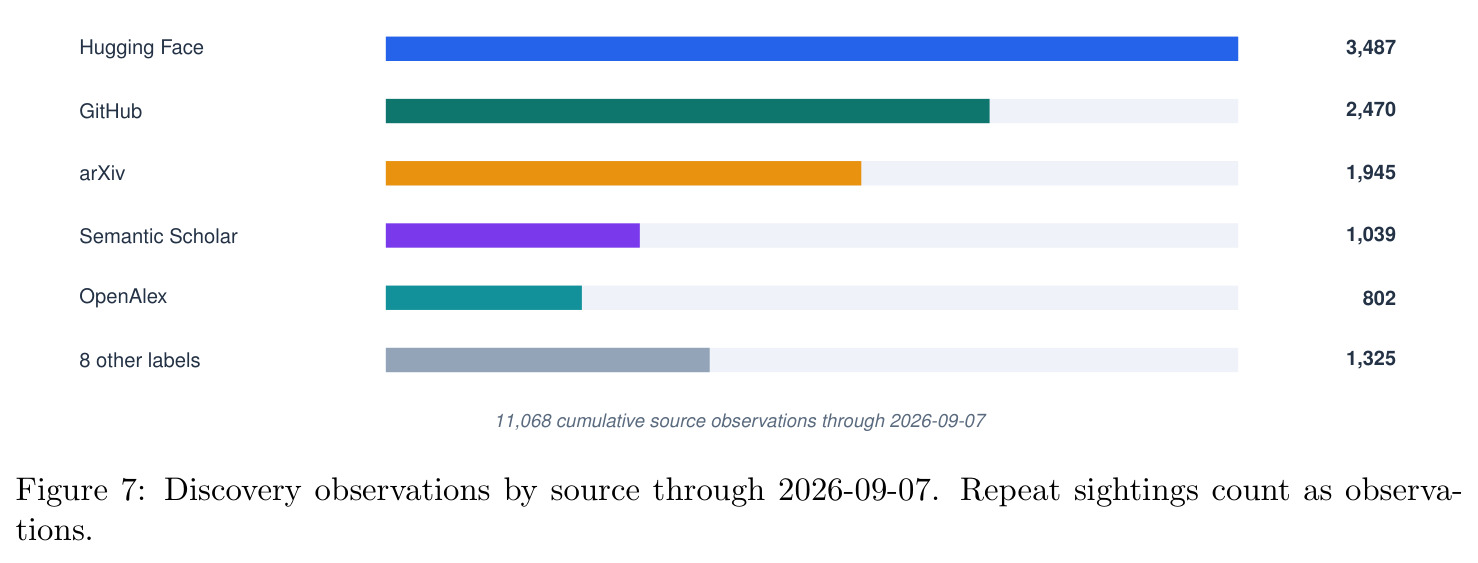
目录普查给出四组核心数字。覆盖:1,283 条源记录中 790 条带 12,916 个数值分数观测,493 条无分数,其中 464 条至少含论文/仓库/数据集链接之一;全目录 475 条链接论文、506 条链接仓库、293 条链接数据集。来源:LLM Stats 687 条(679 打分、5,544 观测)、Artificial Analysis 25 条(25 打分、7,050 观测)、模型报告 110 条(86 打分、322 观测)、OpenCompass Hub 461 条全部未打分但带链接。分类:1,279/1,283 条归入 11 个一级域、63 个子域,前五为多模态感知与生成 267 条(20.8%)、编码与软件工程 230 条(17.9%)、语言与交流 187 条(14.6%)、数学与逻辑推理 170 条(13.3%)、智能体与工具使用 135 条(10.5%);agentic facet 共 345 条,其中 128 条主类为智能体、117 条在编码之下,横跨 6 个其他类。时间:615 条有发布年份(2025 年 279 条达峰),668 条无日期;来源构成重加权后 agentic 份额年际变化不超过 1.1 个百分点,上升并非目录构成变化的伪影。发现侧:46 个快照累计 11,068 条观测、6,546 个工件,前五源占 88.0%(Hugging Face 3,487、GitHub 2,470、arXiv 1,945、Semantic Scholar 1,039、OpenAlex 802),仅 59 个工件被多源观测。案例:编码 agent 用本地 CLI 加网页搜索整理出 5 篇 2026 年 8 月信用分配工作(SRPO、ContextPilot、SkillGate、CIPO、MoRSE)对比表。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 基准目录编目 | 源记录总数 | 1,283 条(聚合 4 个来源) | 最大单一来源 LLM Stats 687 条 | 约为最大单一来源的 1.9 倍,且保留来源身份与工件链接 |
| 分数证据收集 | 数值分数观测数 | 12,916 条(覆盖 790 条记录) | 单源最高 Artificial Analysis 7,050 条 / LLM Stats 5,544 条 | 约为最大单源的 1.8 倍,跨源汇聚且按观测 ID 去重 |
| 每日发现采集 | 累计观测/工件数 | 11,068 条观测 / 6,546 个工件(46 个快照,37 个来源) | 无对应能力(新增每日发现路径) | 前五源占 88.0%,含来源健康与失败来源的透明报告 |
| 未打分记录可用性 | 带工件链接的未打分记录比例 | 464/493(94.1%) | 常规排行榜直接丢弃未打分记录 | 无分数记录仍可溯源到论文/仓库/数据集,缺口可度量 |
局限与改进
作者承认的限制包括:普查只反映记录截止时刻的目录,采集限制、失败请求、缺失标识符与快照日期差异都会影响覆盖;源记录数不等于独立测试数,两个来源可描述同一相关基准;检索精度、任务适配性与节省时间均未评估,先行工作案例只是演示而非受控实验;词法匹配会漏掉改述与改名任务——第 2 节的检索就漏掉两篇更早的相关研究 [1, 63],最终靠合著者人工补充;arXiv 发现路线只收新提交,不回填早期论文的后续版本;任务-能力分类未经验证,CI 中的确定性空抽取器没有为 5,863 条发现派生轨迹赋予任何能力级别。我自己的观察:证据分布极不均衡,OpenCompass Hub 的 461 条记录全部无分数,分数高度集中于 Artificial Analysis(7,050)与 LLM Stats(5,544);跨源工件匹配仅 59 个,标识符链接能力有限;4 条记录完全无法分类;日期基础混用模型发布与文档发表,代理日期在图 3 中只能以虚线标记而非消除,日期可比性问题只是被标注而非被解决。
独立分析的弱点
独立分析四点弱点。第一,词法检索天花板:BM25F 依赖词面匹配,面对「agentic tool use」与「长视野工具调用」这类改述会失配,应叠加向量语义检索,并构建人工复核的相关性判断集,用 Recall@k 与 nDCG 量化改进,而不是停留在「将来要做」。第二,记录不等于基准:同一基准在多源并存(LLM Stats 与 OpenCompass 各留一条)会高估可用基准数量,建议区分「源记录数」与「经身份链接去重后的独立基准数」两个口径分别报告,并给出链接覆盖率。第三,跨源链接弱:6,546 个工件中仅 59 个有多源观测,可在精确标识符之外引入带人工审核的模糊匹配(标题向量加 DOI 候选排序),提升发现观测与目录、以及来源与来源之间的互联密度。第四,可比性仍靠读者自行判断:匹配尺度不等于匹配测试版本、提示、工具与评测器,可从模型报告自动抽取评测设置字段(prompt、attempts、tools、evaluator)并生成结构化的「可比性证书」,把图 3 中的虚线代理标记升级为可查询的元数据。
未来方向
作者提出的方向:补充来源采集并审查已有证据以扩大覆盖;用经审核的相关性判断评估检索精度、任务适配性与时间节省;引入语义检索以处理改述与改名任务;为更早提交的论文做回填;完成并评估 5,863 条发现派生轨迹的能力标签;在可比测试版本与设置、且日期绑定到分数报告或评测的基础上测量饱和度与分数停滞。基于成果可延伸的方向:把 CLI 加公共 Skill 发展为面向自主 agent 的评测查询 API——论文的先行工作案例已证明编码 agent 能用它完成相关工作检索与对比,这是 agent 时代评测基础设施的天然形态;集成样本级基准质量审计(聚合分数掩盖的条目变异);为饱和基准提供退役或降权预警;标注训练数据切分日期以追踪污染;扩展多语言与垂直领域基准覆盖,弥补目录以英文源为主的偏差。
复现评估
复现条件相当好。源代码开源在 github.com/ktwu01/benchmark-radar,v0.11.0 提供 web 仪表盘、排行榜、每日 feed、可下载证据与 CLI 离线查询;附录 F 给出软件修订号、输入哈希、普查脚本与验证流程,普查不施加任何日期、分数或界面过滤,第三方可复算全部统计。数据规模小:12,916 条分数观测、6,546 个工件、46 个快照,纯 CPU 即可处理,笔记本就能跑通离线查询,无需 GPU 或预算。注意事项有二:46 个快照中 4 个是模拟的历史回填,其日期描述的是重构的采集窗口而非真实运行;数据质量依赖上游来源,OpenCompass 记录无分数、部分字段缺失,复现时需按文中口径处理缺省值。总体属于低成本、高可复现的资源型论文,复现主要门槛在于理解其簿记口径而非算力。
论文图表
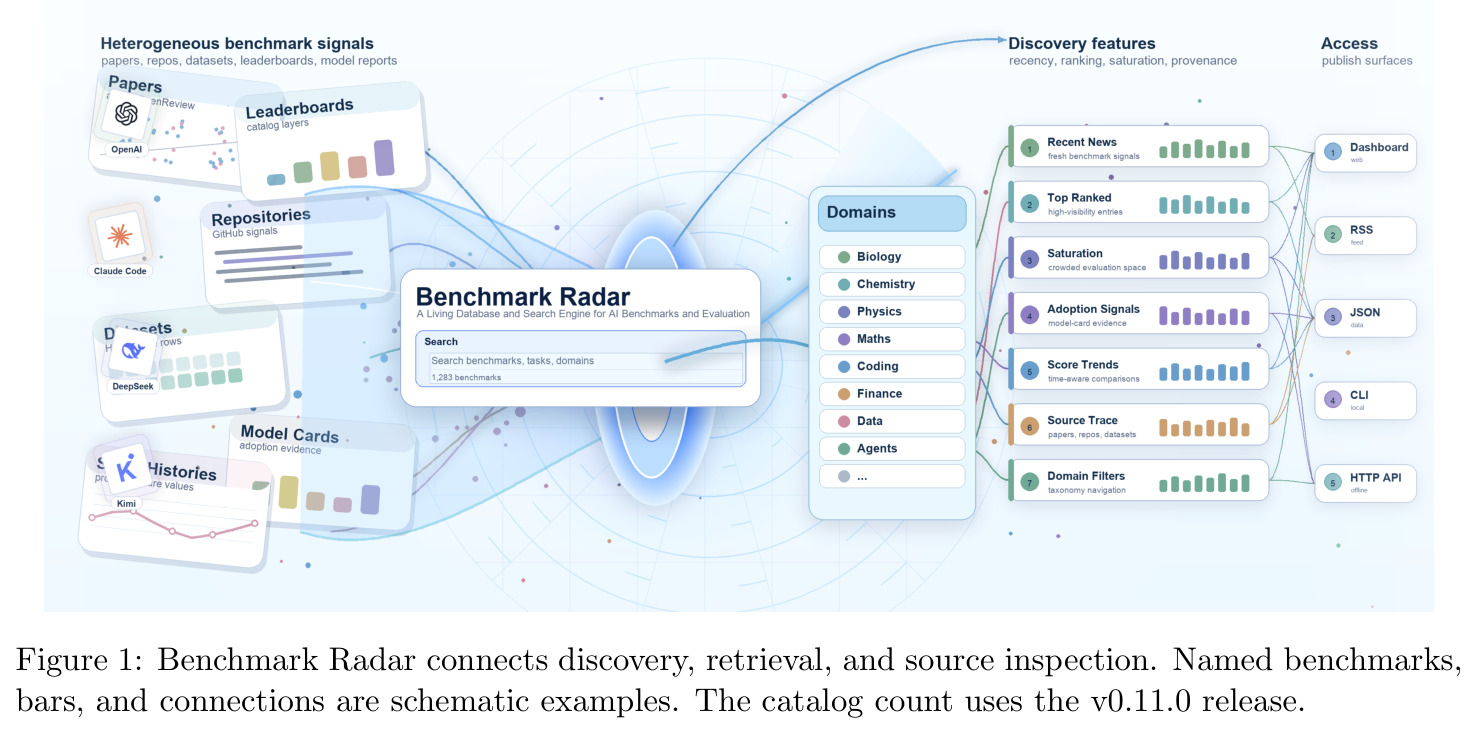
系统概念总览图:把「每日发现—候选检索—来源审查」三个环节连成一个闭环,示意性画出命名基准、柱状与连接关系,目录计数采用 v0.11.0 版的 1,283 条源记录。
一图读懂论文定位:它不是又一个排行榜,而是从每日发现到证据下钻的完整闭环。正文多处引用它作为系统总览,是进入后续所有细节前的必要地图。