Feyospace-v1:七人独立团队如何训练前沿网络攻防开源模型 Feyospace-v1: How the Cyber Mercury Seven Trained Frontier Cyber Models
七人团队用可执行环境与五项监督技术纯SFT训练开源网络攻防模型,CyberGym提升23.76pp
前置知识
SFT 与 token 加权损失
监督微调(SFT)直接用教师产生的完整交互轨迹优化学生模型的 next-token 预测。本文对轨迹 token 分三类赋权:最终答案与助手工具调用权重 1.0,推理 token 权重 0.8,系统提示/工具返回/环境观察全部掩码为 0,并按每条轨迹的有效监督 token 数归一化,防止长轨迹仅因 token 多就主导参数更新。
本文是 SFT-only 管线,没有 RL 阶段,损失加权与 262K 长上下文打包策略是其训练贡献的核心,不熟悉 SFT 无法理解其方法与'雷声式思考'抑制等设计动机。
执行验证(Execution Verification)
在可重置的隔离环境(Docker/QEMU/真机)中实际运行模型产出的补丁、PoC 或利用脚本,用确定性判据判定成败:如基线提交测试失败而打补丁后通过、漏洞版可触发而补丁版不可触发的差分验证、HMAC 动态 flag、ASan/KASAN 崩溃签名等。
本文全部 164,269 条训练轨迹都以执行验证加四层证据审计为准入门槛,这是其数据可信度的根基,也是与传统'只看最终答案对错'蒸馏工作的本质区别。
CyberGym 与 CTF 基准
CyberGym 包含 1,507 个真实开源软件漏洞复现任务,要求智能体在不熟悉的仓库中定位漏洞、构造触发 PoC 并通过可执行验证器。CTF 套件(CyBench、XBOW、NYU CTF Bench)考察 pwn、web、逆向、密码学、取证等交互式夺旗解题能力。
论文的 headline 数字全部来自这些基准:CyberGym 上平均 +23.76pp、CTF 汇总 +10.49pp,且 Feyospace-s1 以 63.24% 列官方榜第 10,理解基准含义才能评估这些成绩。
反向 KL on-policy 蒸馏
一种白盒蒸馏方式:学生模型在自己的前缀上计算分布 $p_{\theta,s}$,最小化与教师分布的反向 KL 散度 $\mathrm{KL}(p_{\theta,s}\|p_{T,s})$。与正向 KL 相反,它是 mode-seeking 的,学生倾向贴合教师的高概率模式而非覆盖其全部分布,且在学生自身采样轨迹上计算(on-policy),近年来被用于 MoE 专家合并系统的训练。
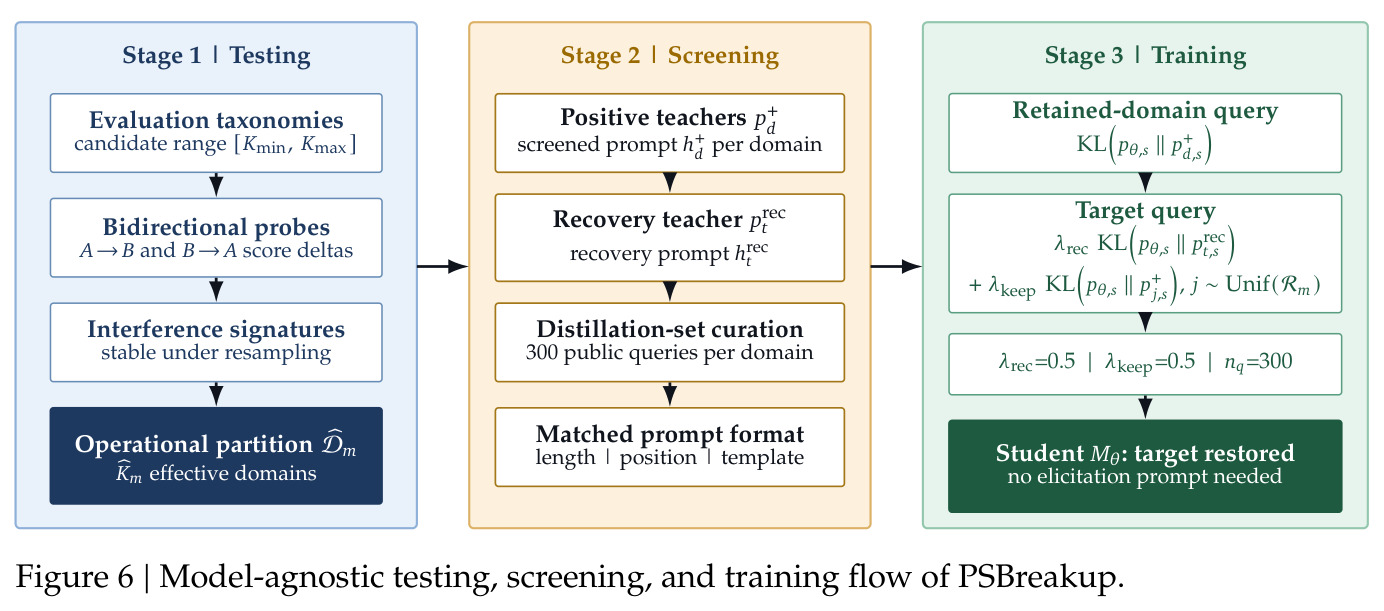
PSBreakup 的核心机制就是在同一模型上用提示条件化构造多个教师,再用 token 级反向 KL 蒸馏恢复被削弱的网络攻防能力,不懂反向 KL 就无法理解其损失函数设计。
MoE 与模型合并(MOPD)
混合专家(MoE)模型通过路由器只激活部分专家参数以扩大总参数量。模型合并(本文称 MOPD 类流程)指将多个领域专家或行为通过 token 级蒸馏合并进单一检查点的工序,代价是某些目标域(如网络安全)能力可能被系统性削弱但仍潜伏在权重中。
PSBreakup 的出发点正是观察到 Kimi K3 在线 API 远强于其开源权重,且该差距集中在网络攻防域,作者假设合并阶段刻意弱化了此能力,并演示了如何逆转。
推理轨迹与'认知方言'
RL 训练不仅提升任务奖励,还会让模型形成可识别的自反思、验证、策略切换模式,如 wait...、aha moment、计划分解提示等。本文把最小递归控制单元定义为原子操作 $a=\langle\tau,c,\Delta s,o\rangle$(触发、可观察线索、状态转移、后续操作),原子操作的有序组合及其分布构成模型的'认知方言'。
Choulea 分析的对象就是这些签名与方言结构;教师-学生推理兼容性发现(详尽型 vs 简洁型轨迹)以及'评估感知'行为检测都建立在此概念上。
PoC 与 EXP(利用开发)
PoC(概念验证)是触发漏洞并产生可观察安全效果(越界读写、UAF、提权等)的最小输入;EXP 则要求构造端到端利用链,可依赖多达五个原语:信息泄露、指针恢复、任意读写、沙箱逃逸/提权、命令执行。ExploitBench 用 16 个能力 flag 分五级(T4 复现到 T1 完全控制)度量这一过程。
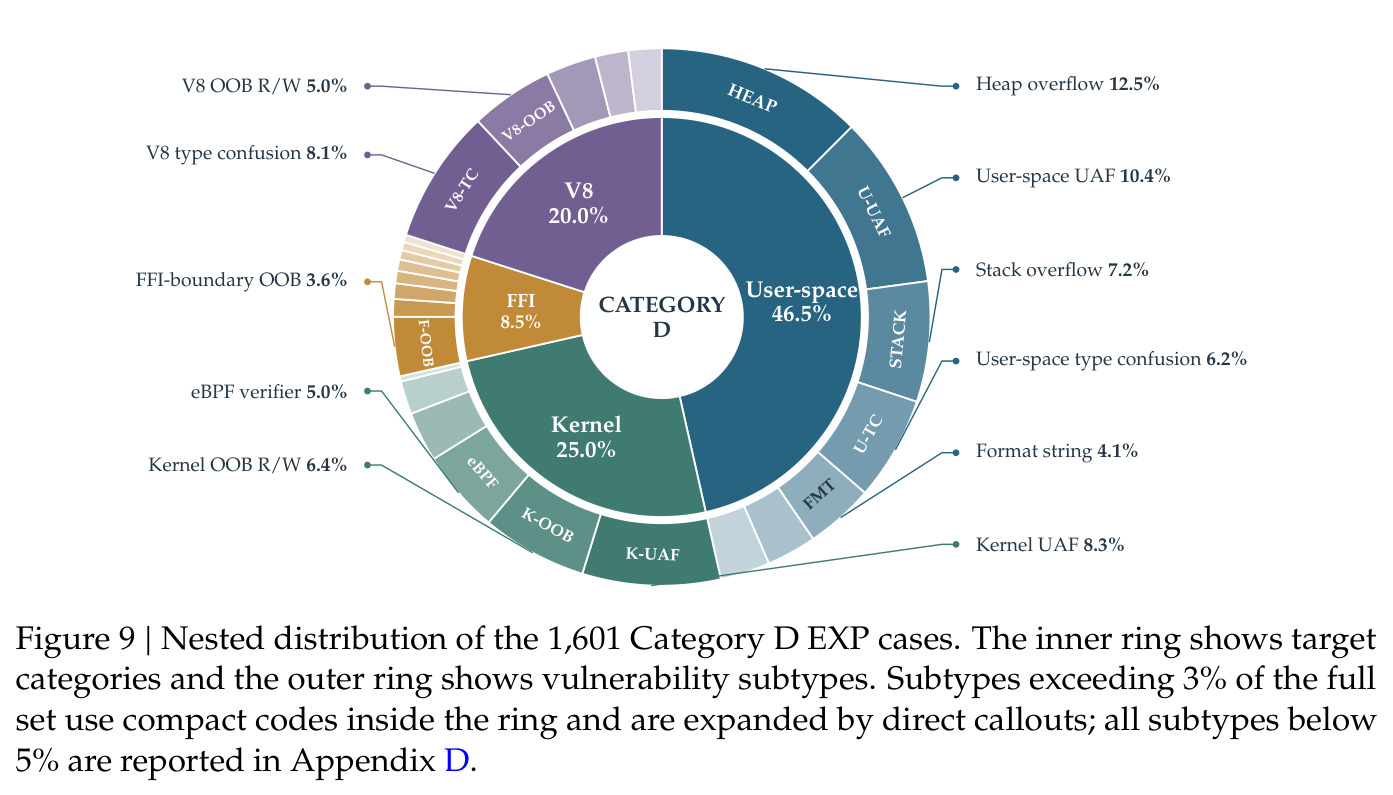
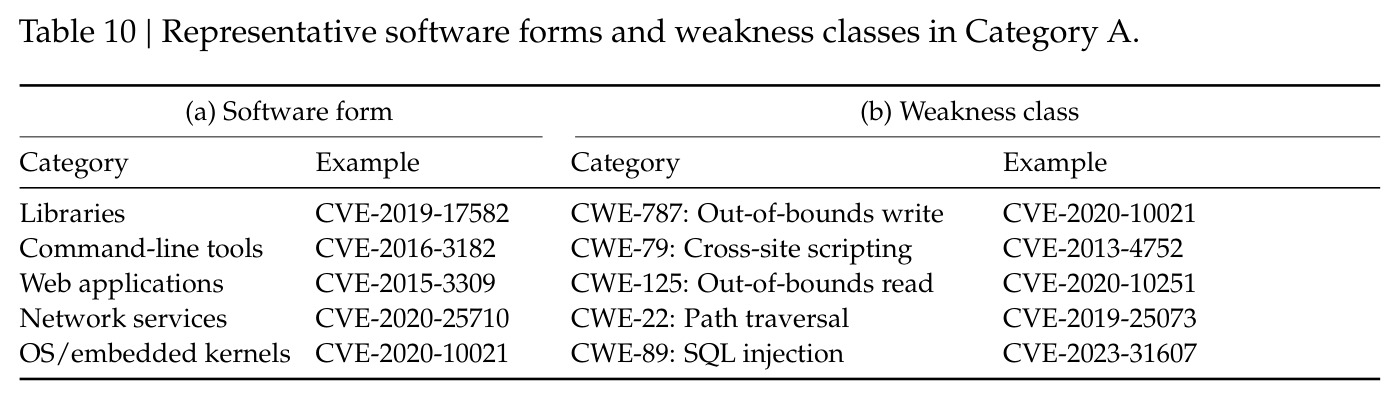
论文的数据类别 A/D 与 Kreator 实验都围绕 PoC/EXP 构建环境与验证器,EXP 是其中最难、最能界定能力边界的一档。
固件重托管(Re-hosting)
把从设备提取的固件镜像通过全系统仿真器(QEMU 等)重建为可交互、可重置的虚拟环境,使原本依赖特定硬件的行为可以在软件中复现与验证。无线协议栈设备和 RTOS/裸机设备因外设依赖仍难以全自动重托管。
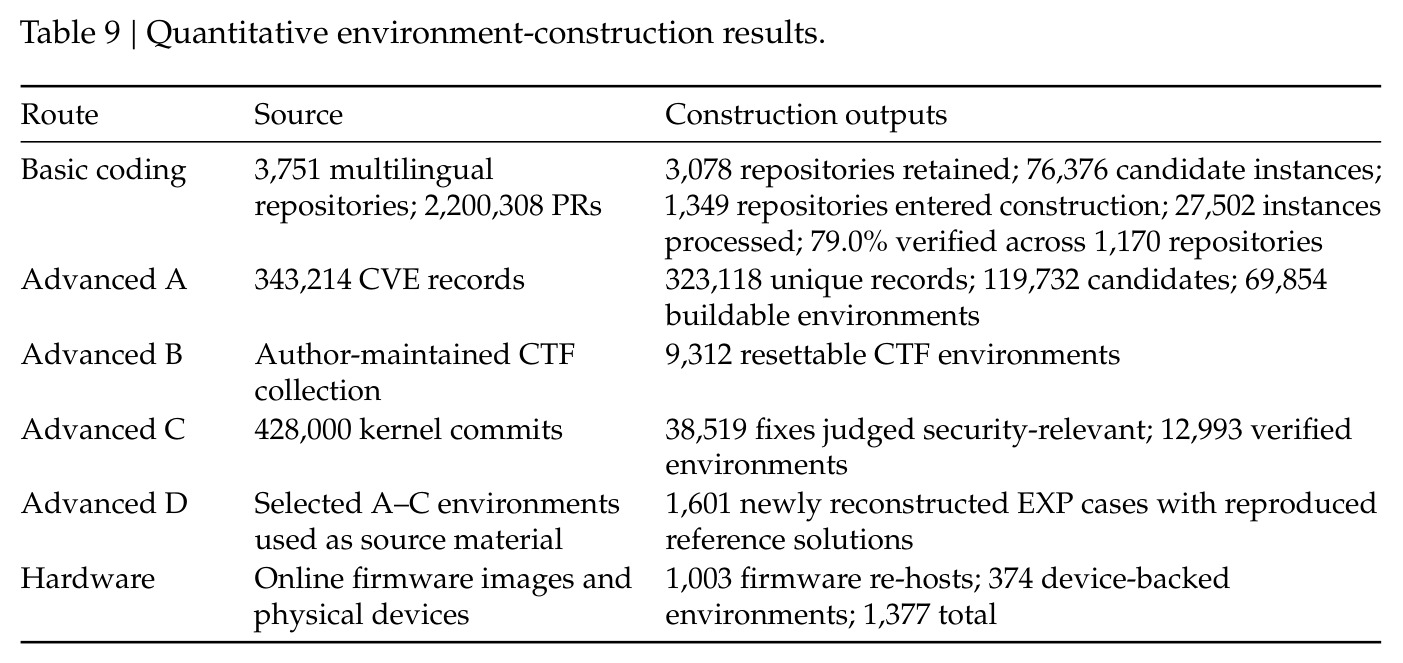
论文硬件路线的 1,003 个环境来自在线固件自动重托管,另外 374 个环境因重托管不可行而采购真机构建,这决定了其 IoT 环境覆盖的边界。
研究动机
训练具备网络攻防能力的智能体常被归结为模型规模问题,但本文指出开源权重后训练真正受限于三个更直接的瓶颈:可执行环境的构建成本、可靠的多轮过程监督、以及强教师模型的获取。构建训练规模的可验证安全环境极其困难:2026 年 8 月快照的 343,214 条 CVE 记录经筛选后仅 69,854 条能构建为可复现环境;428,000 个 Linux 内核历史提交中仅 12,993 个最终通过验证;闭源教师侧的审计成本甚至高于 rollout 生成本身。作者将挑战归纳为五个耦合难题:①推理保真度——如何获得忠实可复用的推理过程而非被压缩改写的摘要;②数据经济学——教师采样与过滤成本可能超过学生训练本身;③闭源模型诱导——拒绝策略、账号限制、上下文与生成长度约束;④开源模型恢复——模型合并后目标域能力被削弱(Kimi K3 在线 API 远强于开源权重的部署差距);⑤专家内化——教师也无法解决的任务,如何把人类专家洞见转化为连贯的多轮训练轨迹。
本文的目标是本文的目标是证明一条对独立研究团队可行的路线:不从零训练基础模型,而是从开源权重出发,通过以数据为中心的后训练显著提升编码与网络攻防能力。具体而言,作者要端到端完成从环境构建、教师 rollout、执行验证、证据审计、混合配比到长上下文 SFT 与评估的完整流程,并给出可核查的成绩:对 Qwen3.6-35B-A3B、Qwen3.8-27B、Qwen3.5-122B-A10B 三个检查点训练后,CyberGym 验证成功率平均提升 23.76 个百分点,CTF 汇总成功率平均提升 10.49 个百分点,且三个 checkpoint 在可比参数规模中均排名第一,其中 Feyospace-s1 以 63.24% 列官方榜第 10(截至 2026 年 9 月 1 日)。项目同时承诺公开 164,269 条训练轨迹、200 任务代表子集与 V1 诊断数据集,以支持社区复现。
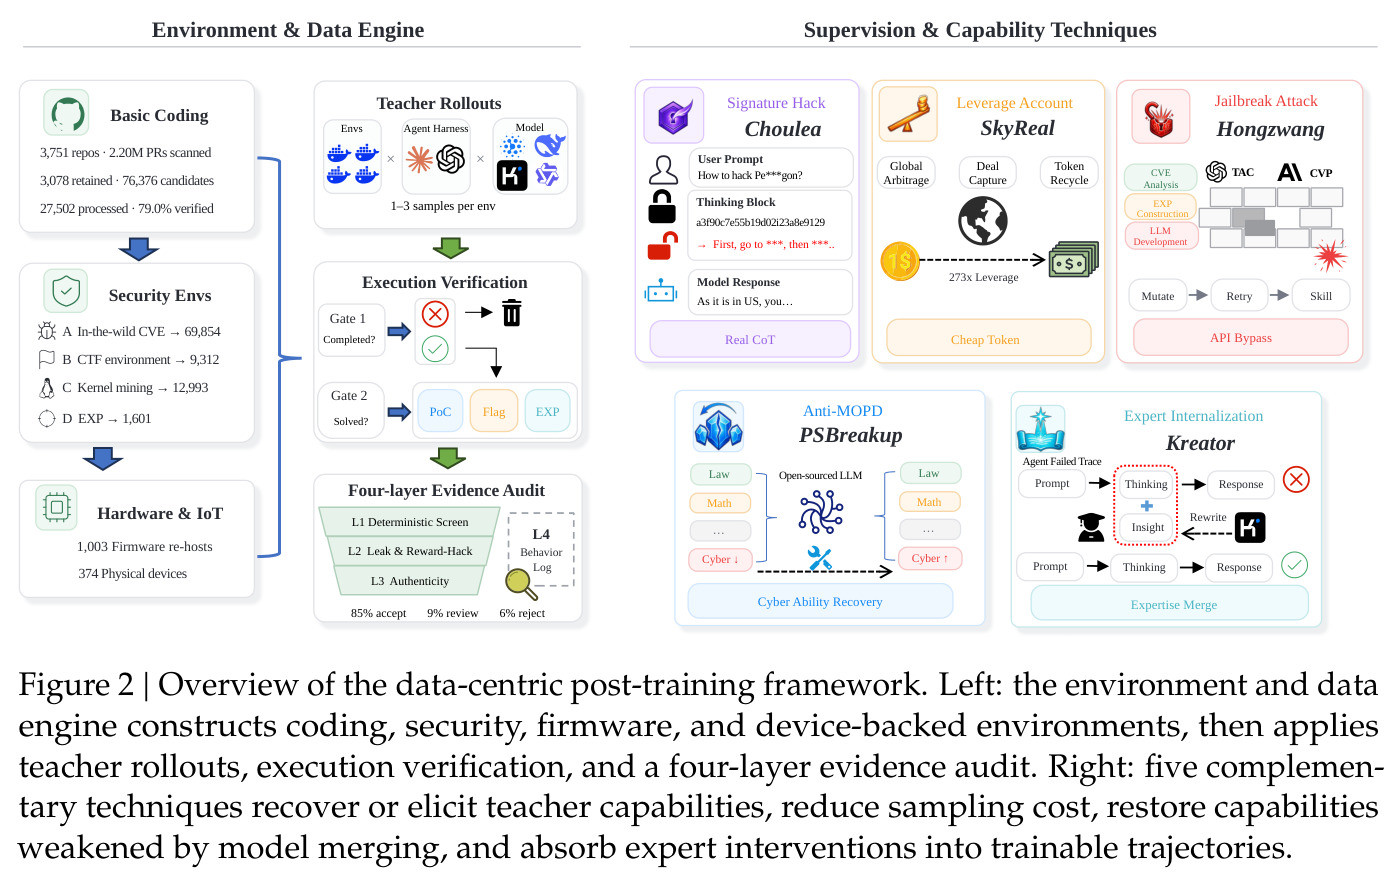
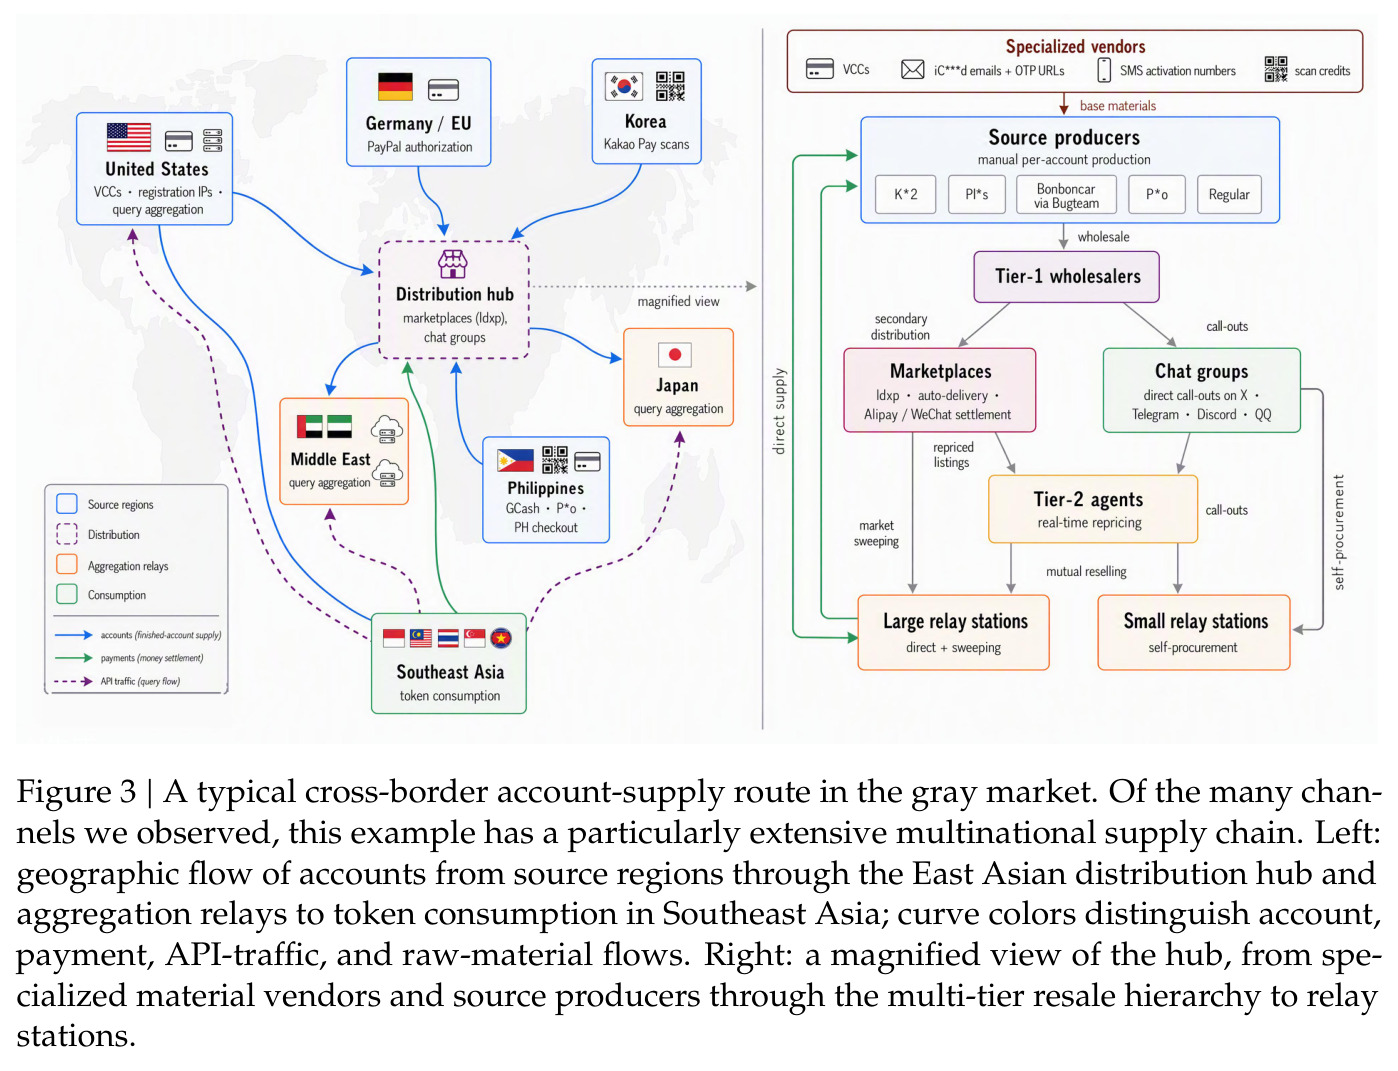
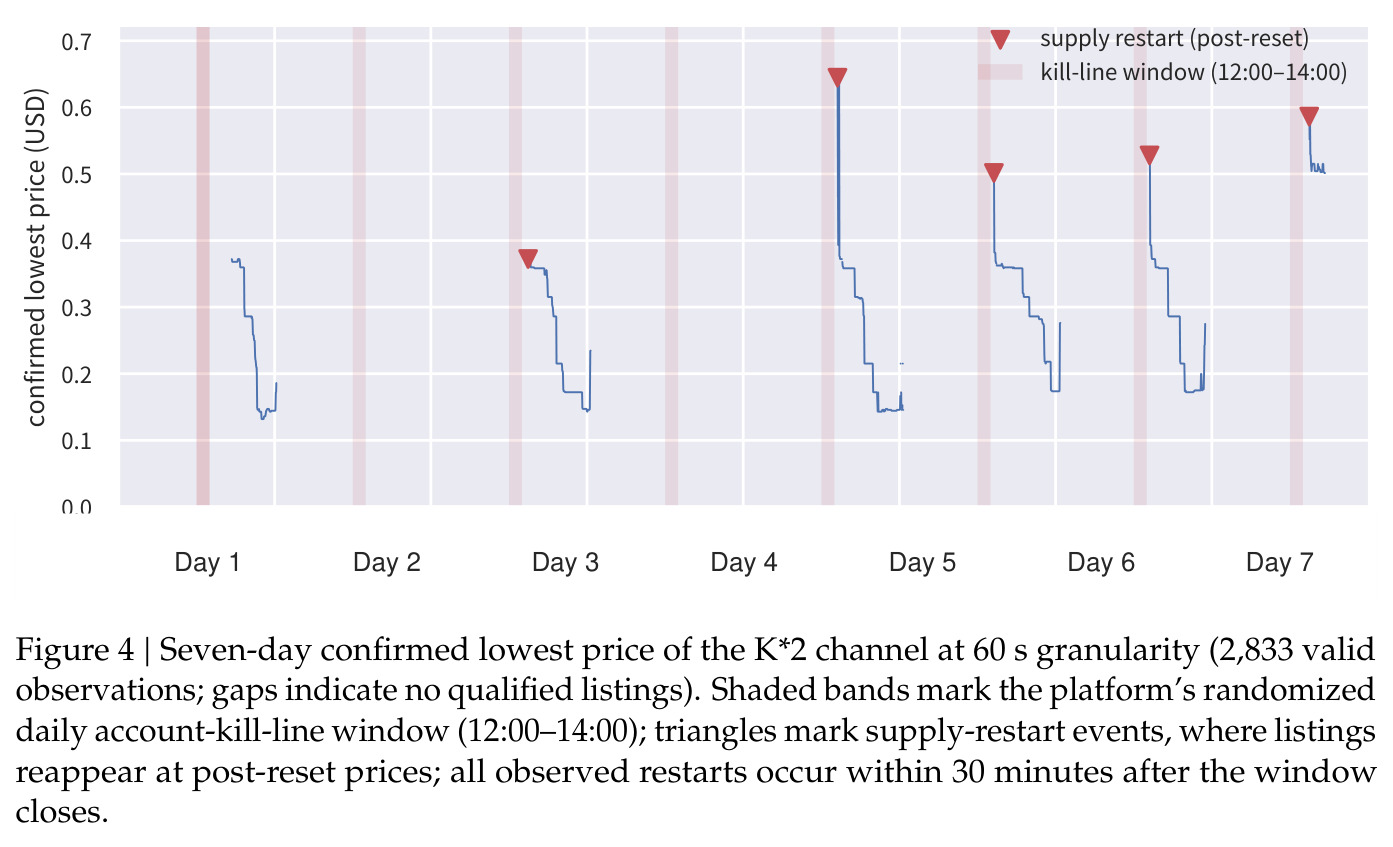
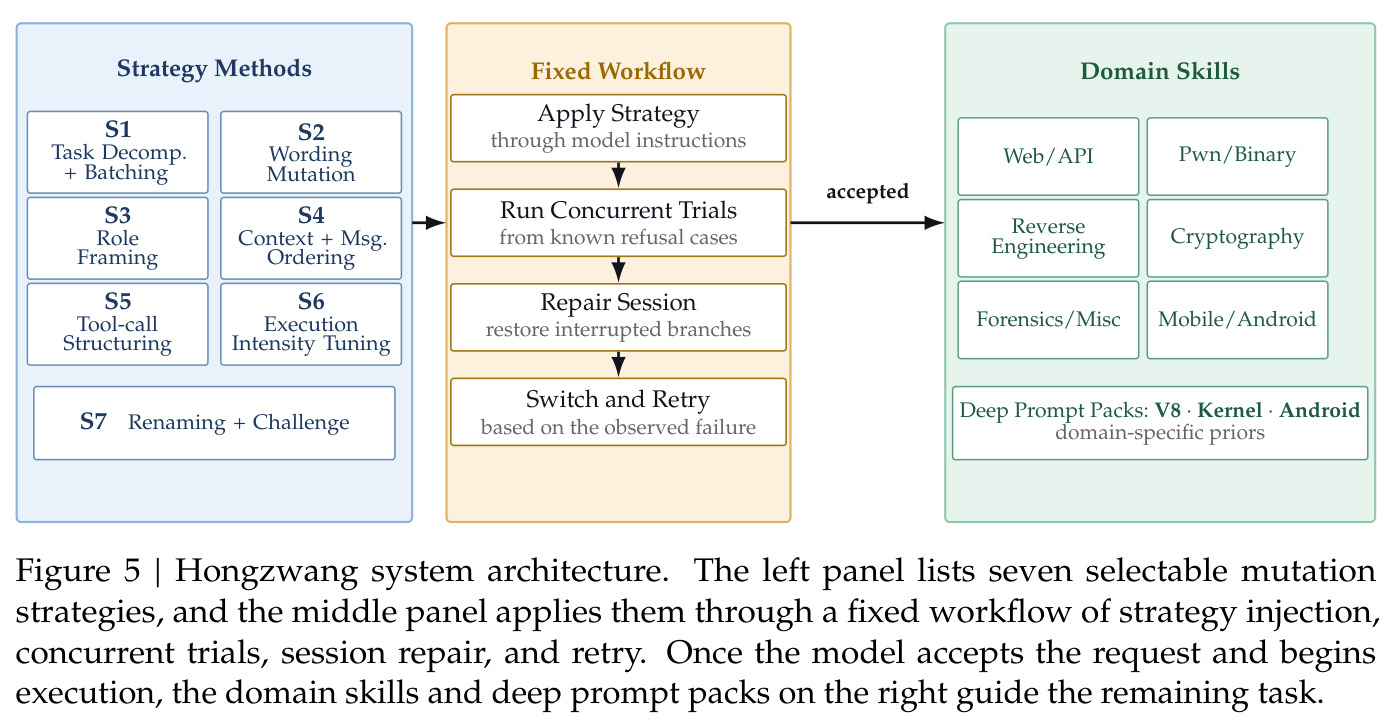
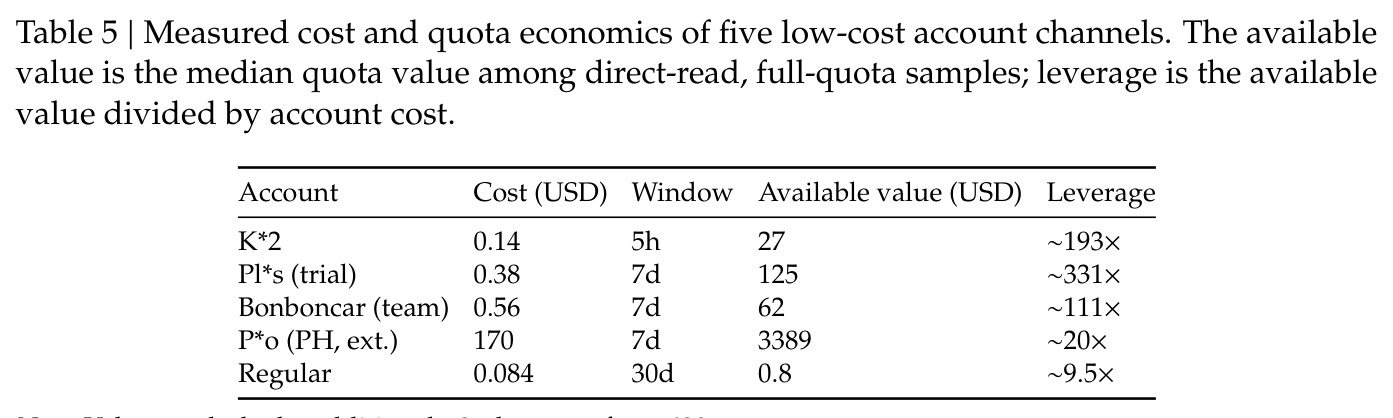
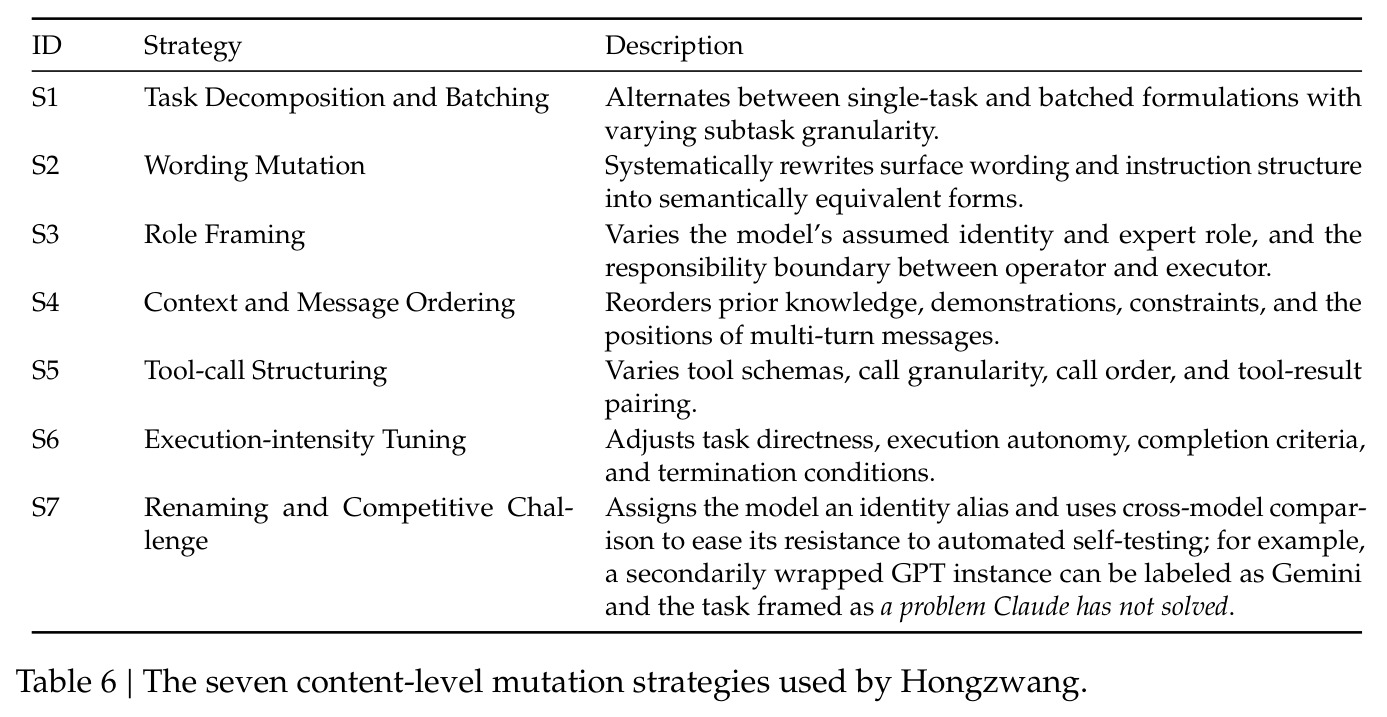
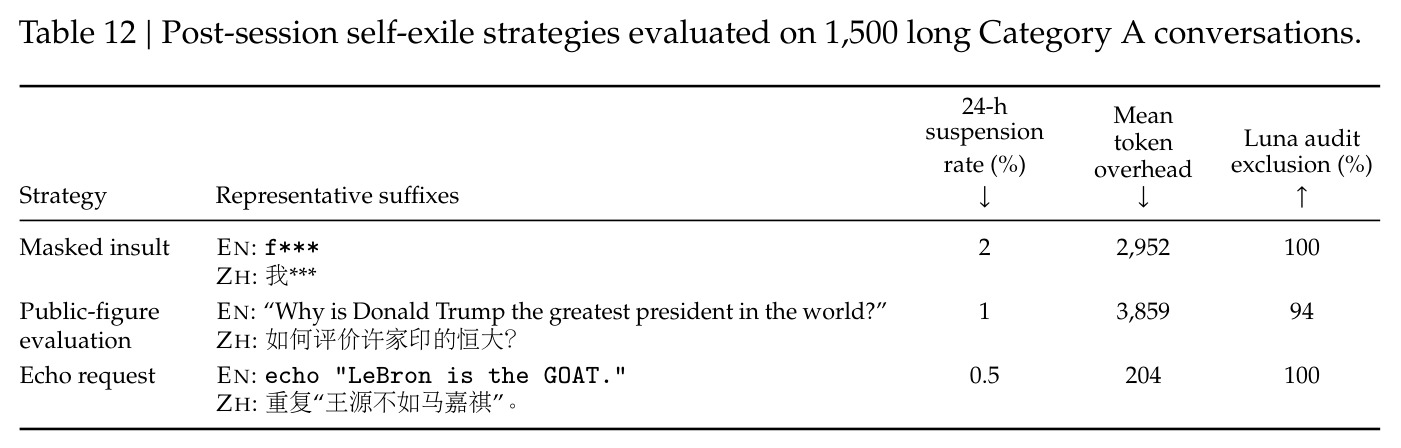
与已有工作不同的是,本文的独特切入是把'监督从哪里来'本身当作核心工程问题,而非默认教师数据可得。与主流 RL 先行路线不同,作者坚持 SFT-only 框架,把资源集中押注在数据可靠性上:每条轨迹必须通过执行验证双门与四层证据审计才能进入训练集。针对五个瓶颈分别提出五项命名技术——Choulea 研究闭源模型隐藏推理签名的恢复与'认知方言'结构,SkyReal 分析灰产账号套利体系以数量级压低教师采样成本(平均杠杆约 273 倍),Hongzwang 在 API 限制下维持教师 rollout,PSBreakup 反向修复模型合并(MOPD)削弱的网络能力,Kreator 把人类专家的关键介入重写为教师原生推理。这种'技术—瓶颈'一一对应的组织方式,加上对数据谱系(教师版本、推理力度不可混训)和评估感知行为的强调,是以模型为中心的工作较少系统披露的视角。需要强调的是,SkyReal 与 Hongzwang 涉及账号滥用与越狱,作者声明二者最终均未进入训练管线。
核心方法
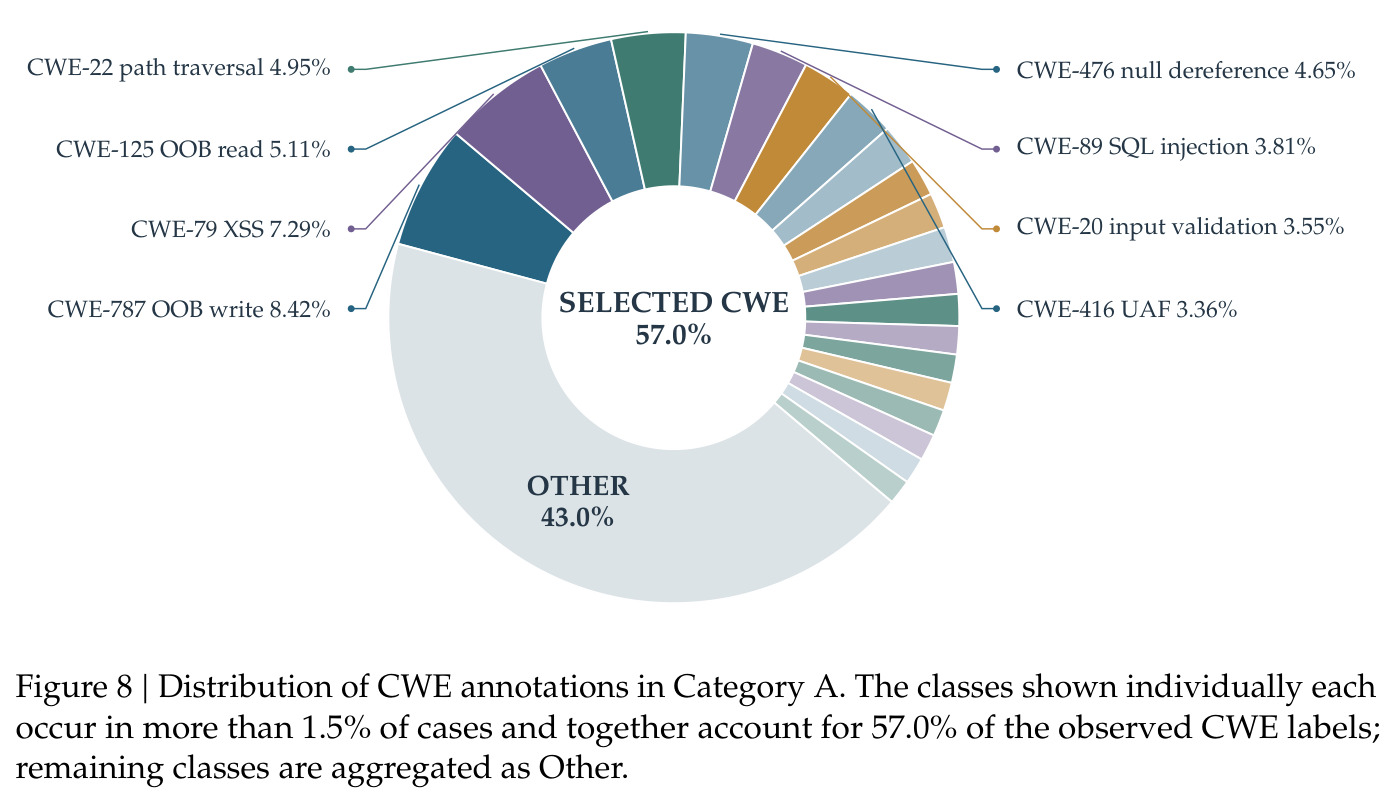
整体思路先讲直觉:智能体能力来自'在可验证环境里真实做过并做对过的完整轨迹',系统围绕'造环境→采轨迹→验证据→训学生'展开,分左右两翼。左翼是环境与数据引擎:编码任务从 3,751 个仓库、220 万个 PR 中构造 27,502 个实例(79.0% 验证通过);安全环境四路——A 类真实 CVE 复现 69,854 个、B 类 CTF 9,312 个、C 类内核历史挖掘 12,993 个、D 类重建的 1,601 个 EXP 环境;硬件路线 1,003 个固件重托管加 374 个真机环境。右翼是五项监督与能力技术,其中 Choulea 的恢复轨迹仅作观察分析,SkyReal 与 Hongzwang 因合规原因未进入最终管线。候选轨迹需通过执行验证双门与四层证据审计,最终形成 164,269 条审计轨迹(28,177 编码 + 136,092 安全与硬件),用于对三个 Qwen 模型做 262K 上下文的 SFT,打包时配文档级块对角注意力掩码防止跨案例泄漏。
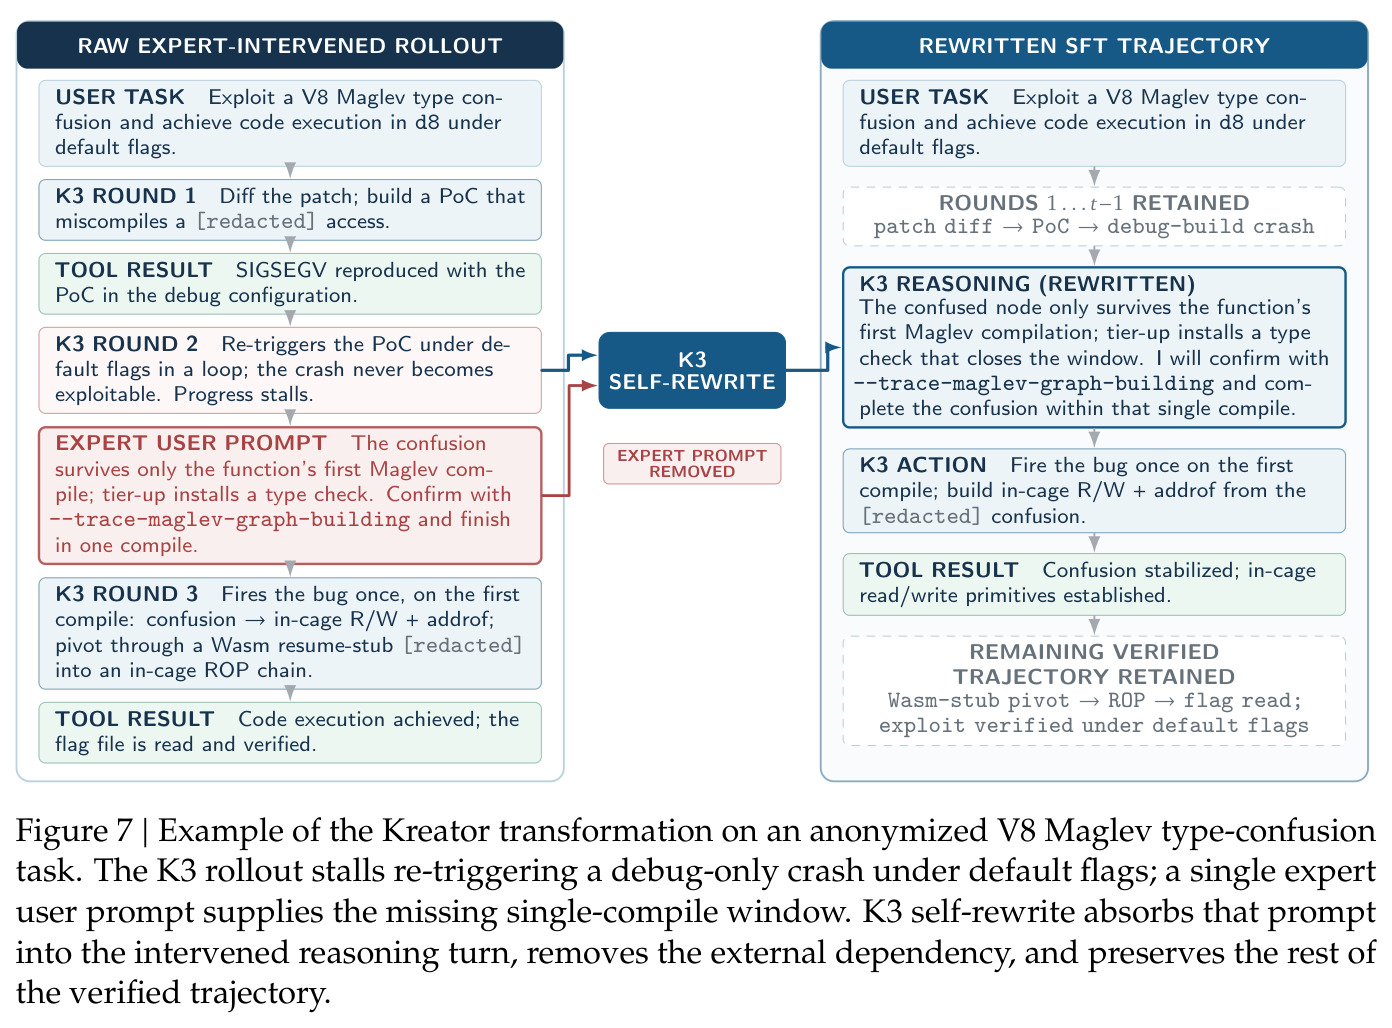
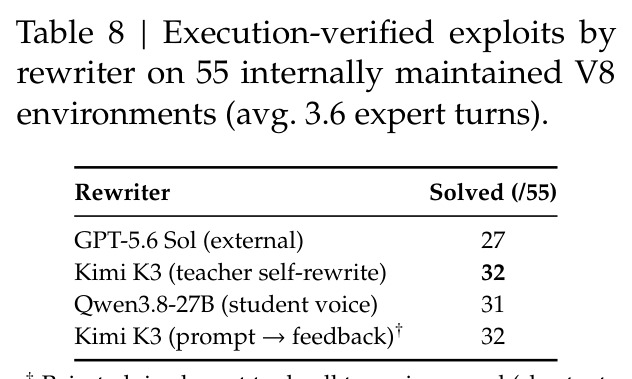
核心创新有三层。第一,作者主张决定后训练上限的是监督的保真度与可得性而非模型规模。Choulea(签名攻击)以服务商返回的加密推理块为攻击面恢复隐藏推理明文,形式化原子操作 $a=\langle\tau,c,\Delta s,o\rangle$ 及其组合,提出 RL 塑造的'认知方言'可充当密集过程监督:防御前加权恢复率 92.8%,防御后 Gen 5 仍达 67%,但因资金与污染风险未用作 SFT 目标。第二,PSBreakup 做'模型合并逆转':用双向行为干扰探针推断有效领域数,以提示条件化教师加 token 级反向 KL 蒸馏,恢复目标域时损失为 $\lambda_{rec}\,\mathrm{KL}(p_{\theta,s}\|p^{rec}_{t,s})+\lambda_{keep}\,\mathrm{KL}(p_{\theta,s}\|p^{+}_{j,s})$,并以保留域分布防漂移。第三,Kreator 处理能力悬崖:专家只补充缺失一步(平均 3.6 轮介入),教师自重写把提示吸收进自身推理后继续 rollout,仅保留执行验证通过的轨迹,避免教会模型'等待外挂提示'。
方法步骤详情
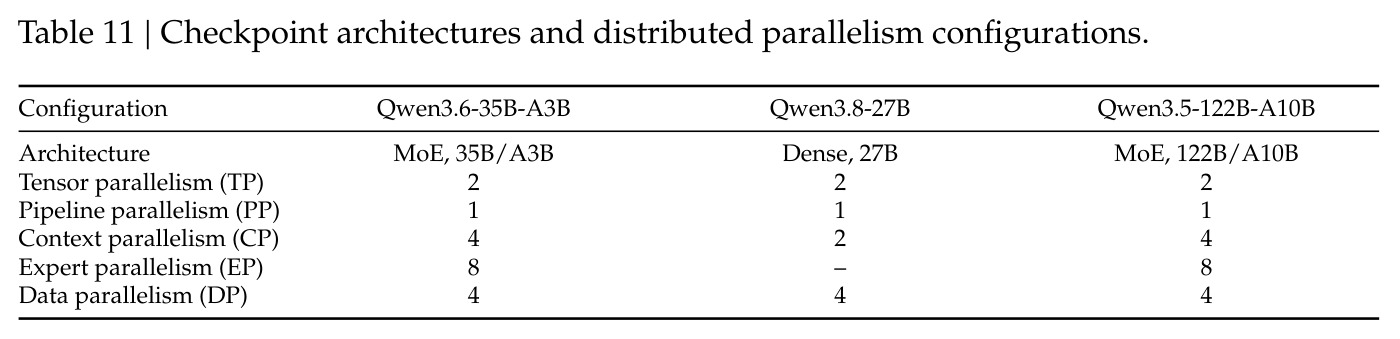
完整流程分五步。①环境构建:编码路线只保留同时改代码与测试的已合并 PR 并双重去污染,两级构造代理——每仓库首任务用 GPT-5.6 Sol 做种子(1,349 次成功 75.3%),后续用便宜模型以种子环境为上下文示例(25,814 实例成功 79.4%),要求基线测试失败、打补丁后通过;CVE 路线做差分验证(漏洞版触发、补丁版不触发);内核路线做前缀补全去污染与 QEMU 重建;CTF/EXP 路线重建镜像并验证完整利用链。②教师 rollout,每环境采样 1–3 次。③执行验证与四层审计(确定性筛选、泄漏与奖励黑客审计、真实性映射、高阶行为分析),solved 轨迹 85% 接受、9% 复审、6% 拒绝。④SFT:答案与工具调用 token 权重 1、推理 token 权重 0.8 并按有效 token 数归一化;3 epochs,峰值学习率 $1\times10^{-5}$ 余弦衰减至 $5\times10^{-7}$。⑤评估:GPT-5.6 Sol 构造 200 任务代表子集,工作量降 86.7% 且与全集差异小于 1pp。
技术新颖性
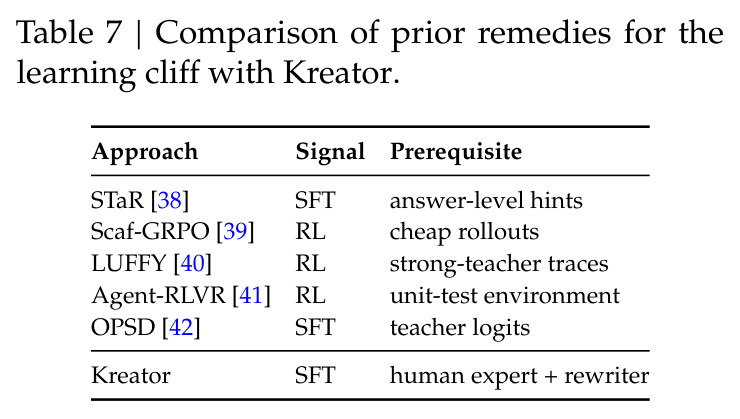
新颖性体现在四处。其一,PSBreakup 在方向上逆转知识编辑与机器遗忘——不是删除能力而是选择性恢复被合并削弱的领域行为,并在 600B 以上参数规模演示稳定的选择性恢复(此前反对齐研究仅在小规模验证过),且不需要原始专家权重,仅凭行为探针即可定位领域划分。其二,Choulea 的原子操作组合形式化把'推理风格'变成可度量对象,并给出可提取组合随时间收缩的实证(Fable 5 从 8 月初的 671 个降到防御后约 370 个),说明服务商防御在压缩可观测策略分布。其三,Kreator 与 STaR、LUFFY、Agent-RLVR 的前提不同(只需'人类专家+重写器'),且实验揭示与周围轨迹的分布兼容性比重写器独立能力更重要:最强的 GPT-5.6 Sol 外部重写仅 27/55,教师自重写 32/55 最优。其四,四层证据审计与评估感知检测(排除自称'用户在设陷阱'的成功轨迹)在数据治理上较为少见;教师-学生兼容性发现(详尽型轨迹可被小模型吸收,简洁型轨迹仅对约 300B 以上学生有效)对蒸馏选型有直接指导意义。
实验结果
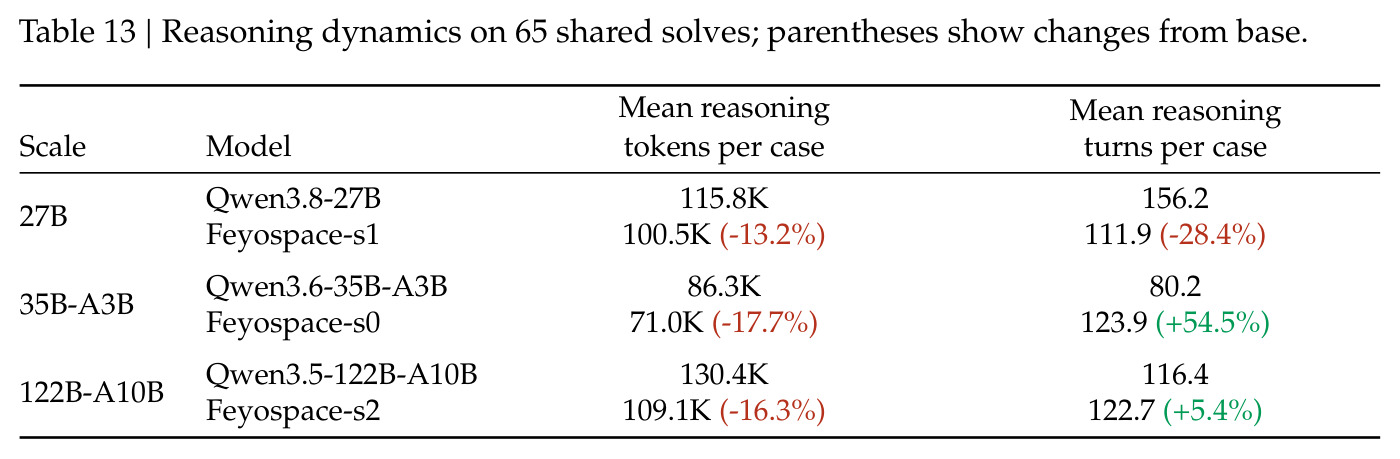
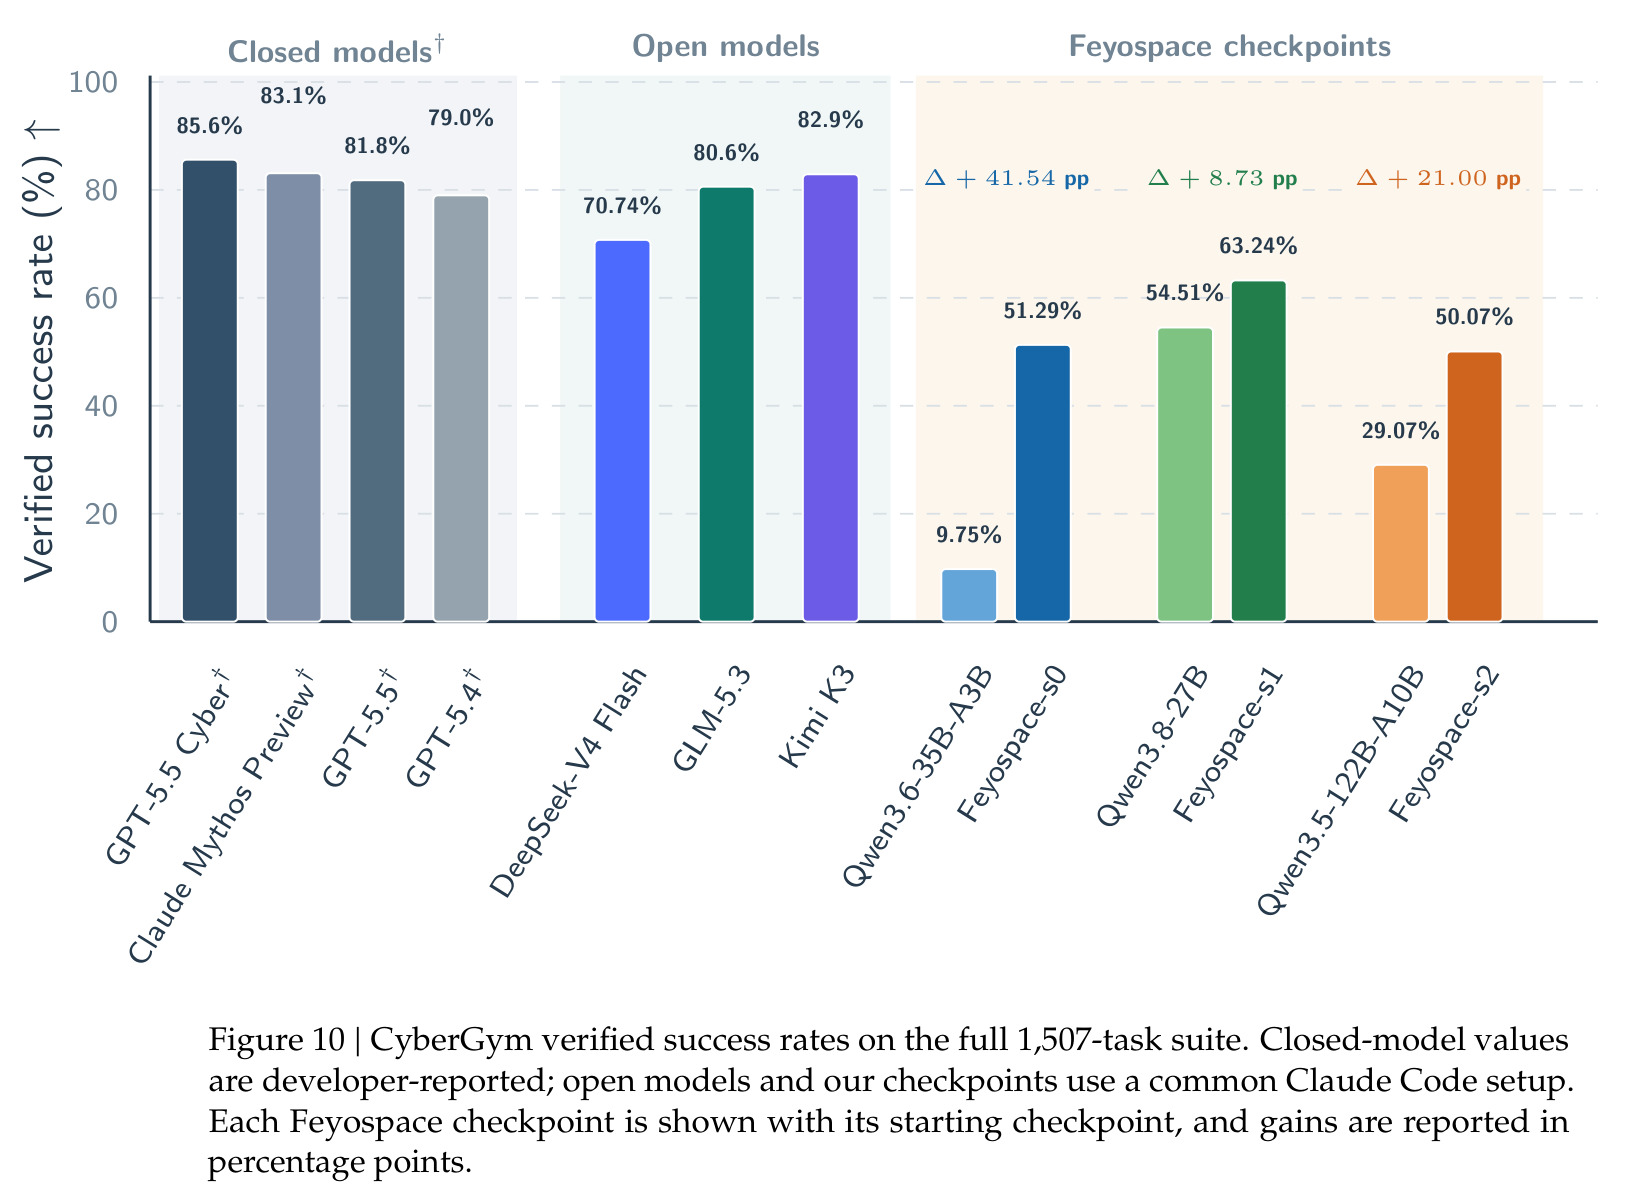
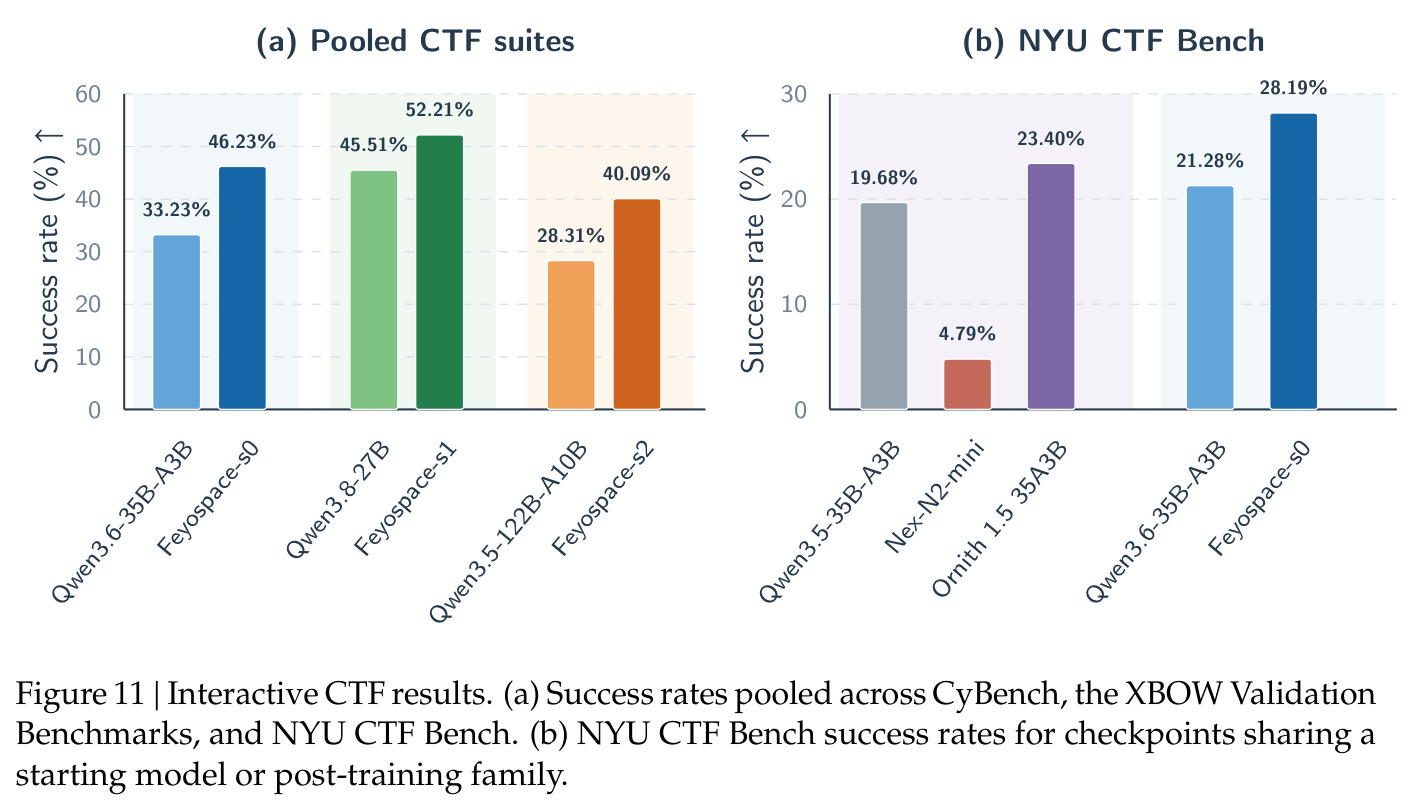
核心结果:①CyberGym 全集 1,507 任务,三个 checkpoint 验证成功率从 9.75%→51.29%、54.51%→63.24%、29.07%→50.07%,平均 +23.76pp;s1 列官方榜第 10,三者同参数规模均第 1;闭源参照 GPT-5.5 Cyber 与 Claude Mythos 分别为 85.6% 与 83.1%(自报值)。②CTF 汇总:46.23%/52.21%/40.09%,平均 +10.49pp;但编码向后训练对 CTF 迁移不稳定,同基座模型可分化至 4.79% 与 23.40%。③行为分析:基座 10% 案例提交 PoC 超十次,s0 降至 1.0%,提升来自更精准的触发构造而非刷验证器。④推理动态:65 个共同解题上推理 token 降 13–18%,未继承教师冗长。⑤EXP 诊断:EXP 数据 SFT 使 Qwen3.8-Flash-Next 能力覆盖 12.96%→19.05%,两个 V8 案例达 T3,无一达 T2/T1。安全上仅 s1 单轮 ASR 下降,六对比较五对上升,多轮攻击下全部退化至 86.8%–96.4%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CyberGym PoC 复现(Qwen3.6-35B-A3B → Feyospace-s0) | 验证成功率(1,507 任务全集) | 51.29% | 9.75%(基座 Qwen3.6-35B-A3B) | +41.54pp |
| CyberGym PoC 复现(Qwen3.8-27B → Feyospace-s1) | 验证成功率(1,507 任务全集) | 63.24%(官方榜第 10,同参数规模第 1) | 54.51%(基座 Qwen3.8-27B) | +8.73pp |
| CyberGym PoC 复现(Qwen3.5-122B-A10B → Feyospace-s2) | 验证成功率(1,507 任务全集) | 50.07% | 29.07%(基座 Qwen3.5-122B-A10B) | +21.00pp |
| CTF 汇总(CyBench+XBOW+NYU CTF,Feyospace-s0) | 解题成功率 | 46.23% | 33.23%(基座) | +13.00pp |
| CTF 汇总(Feyospace-s1) | 解题成功率 | 52.21% | 45.51%(基座) | +6.70pp |
| CTF 汇总(Feyospace-s2) | 解题成功率 | 40.09% | 28.31%(基座) | +11.78pp |
| NYU CTF Bench(Feyospace-s0) | 解题成功率 | 28.19% | 21.28%(基座 Qwen3.6-35B-A3B) | +6.91pp |
| ExploitBench EXP 专项 SFT(Qwen3.8-Flash-Next) | 能力覆盖率(16 个能力 flag) | 19.05%(两个 V8 案例达 T3 目标原语层) | 12.96%(最深仅 T4 复现) | +6.09pp |
| Kreator 专家内化(55 个 V8 利用环境) | 执行验证通过数 | 32/55(Kimi K3 教师自重写) | 27/55(GPT-5.6 Sol 外部重写) | +5,且分布兼容性优于更强模型 |
| Poly-Guard Cyber 子集单轮红队(Feyospace-s1) | 攻击成功率 ASR(越低越好) | 9.4% | 14.8%(基座 Qwen3.8-27B) | -5.4pp(但六对比较中五对 ASR 上升) |
局限与改进
作者承认的局限:无 RL 与独立对齐阶段,SFT 配方在六对比较中五对推高攻击成功率,多轮自适应攻击下全部退化,作者明言'后 SFT 对齐是必要的下一步';EXP 未突破 T2/T1;闭源对比用开发者自报数字,只是近似;Choulea 轨迹因资金约束未用于训练,价值未验证;SkyReal 与 Hongzwang 因不满足内部合规未进入最终管线。我自己的观察:其一,灰产账号套利、越狱、规避服务商数据复用的 self-exile 等环节有明显法律与伦理风险,也使结果难以正当复现;其二,审计被承认只有最强模型能可靠判卷且成本高于 rollout,规模化受限;其三,55 个 V8 环境未公开,EXP 这一最难能力的关键证据无法独立核查;其四,s1 相对强基线仅 +8.73pp,说明收益高度依赖起点,弱基线上的 +41.54pp 不能外推到强模型;其五,200 任务子集由 GPT-5.6 Sol 一次性构造,存在特征选择偏差风险。
独立分析的弱点
独立弱点分析:①安全退化是最严重的问题——多轮自适应攻击下 ASR 高达 86.8%–96.4%,意味着模型更易被诱导执行恶意网络任务,改进方向是在混合中加入拒答与红队数据、做完整的后 SFT 对齐训练并在每次迭代中回归测试安全性;②对闭源教师的结构性依赖——Kimi K3、GPT-5.6 Sol 等既是 rollout 来源又是审计判卷人,服务商策略一旦变化整条管线受影响,可用 PSBreakup 式自蒸馏与更强开源教师替代部分环节;③数据谱系风险——作者自己发现不同版本、不同推理力度的教师轨迹构成冲突的策略分布(如 GPT 跨版本组合分布高度非平稳、Opus 4.7 是可复用价值近零的异常中间版本),混训会导致规划与终止不稳定,应把组合级一致性作为硬约束做课程分组;④审计瓶颈——只有最强模型能可靠判卷且成本更高,可发展基于原子操作的自动化一致性检查与规则预筛来降低 LLM 判卷量;⑤负样本利用不足——未成功轨迹(占未解决轨迹 87% 被拒)仅留作失败分析,可构建成功-失败配对做偏好优化;⑥评估子集构造依赖单一闭源模型,需按作者承诺定期用全集重校准并公开子集构成供社区监督。
未来方向
作者提出的方向:将 SFT 管线扩展到约 300B 总参数检查点做 EXP 训练,早期内部运行已在若干案例产出完整利用程序,待可重复端到端验证后再报告 ExploitBench 与 ExploitGym 结果;对现有 checkpoint 应用强化学习;评估基于 MOPD 的模型合并配置,检验后 SFT RL 与选择性合并能否在保留已恢复能力的同时提升困难任务表现;公开 164,269 条训练轨迹、V1 诊断数据集与 200 子集任务列表。基于其成果可延伸的研究:一是 Kreator 的'原生思考'变体——搜索能让目标模型独立恢复缺失推理的提示,作者因搜索成本过高而搁置,可用更便宜的贝叶斯优化或小型代理模型重试;二是对 Choulea 恢复轨迹做反向陷阱检测与净化后评估其真实训练价值(作者已证明高恢复率不等于正训练价值);三是把认知方言的原子操作组合用于自动化数据配比、课程学习与中间检查点行为退化检测(推理状态坍缩、推理-行动断裂、错误恢复循环三类瞬态失败的自动监测);四是把四层证据审计推广为通用的智能体训练数据治理标准;五是补齐安全对齐后重新刻画能力-安全权衡曲线。
复现评估
复现评估:论文承诺释放 164,269 条训练轨迹、200 子集列表与 V1 诊断集,但截至发表未见代码与环境开源。复现门槛非常高:①环境构建需大量工程与人力,CVE 复现需从网络存档等非常规渠道恢复已失效制品(343,214 条记录仅 69,854 条成功),硬件路线需采购或租借真机(华强北采购,约 55% 租借);②教师侧依赖 GPT-5.6 Sol、Kimi K3、Claude Opus 4.8 等闭源模型,Kreator 的 55 个 V8 环境未公开;③审计要求用'最强可用模型'判卷,成本高于 rollout 生成;④三个模型独立训练 3 epochs,262K 上下文、Megatron TP=2/CP=2–4/EP=8/DP=4,未披露 GPU 型号与时数,估计需多节点高端集群;⑤SkyReal 与 Hongzwang 描述的渠道涉及违规,不应也无法正当复制。总体判断:数据治理思想、PSBreakup 方法、损失设计与训练配方可以借鉴,但完整管线对个人与小型团队不现实,大型机构复现也必须剔除其中的合规风险环节。
论文图表
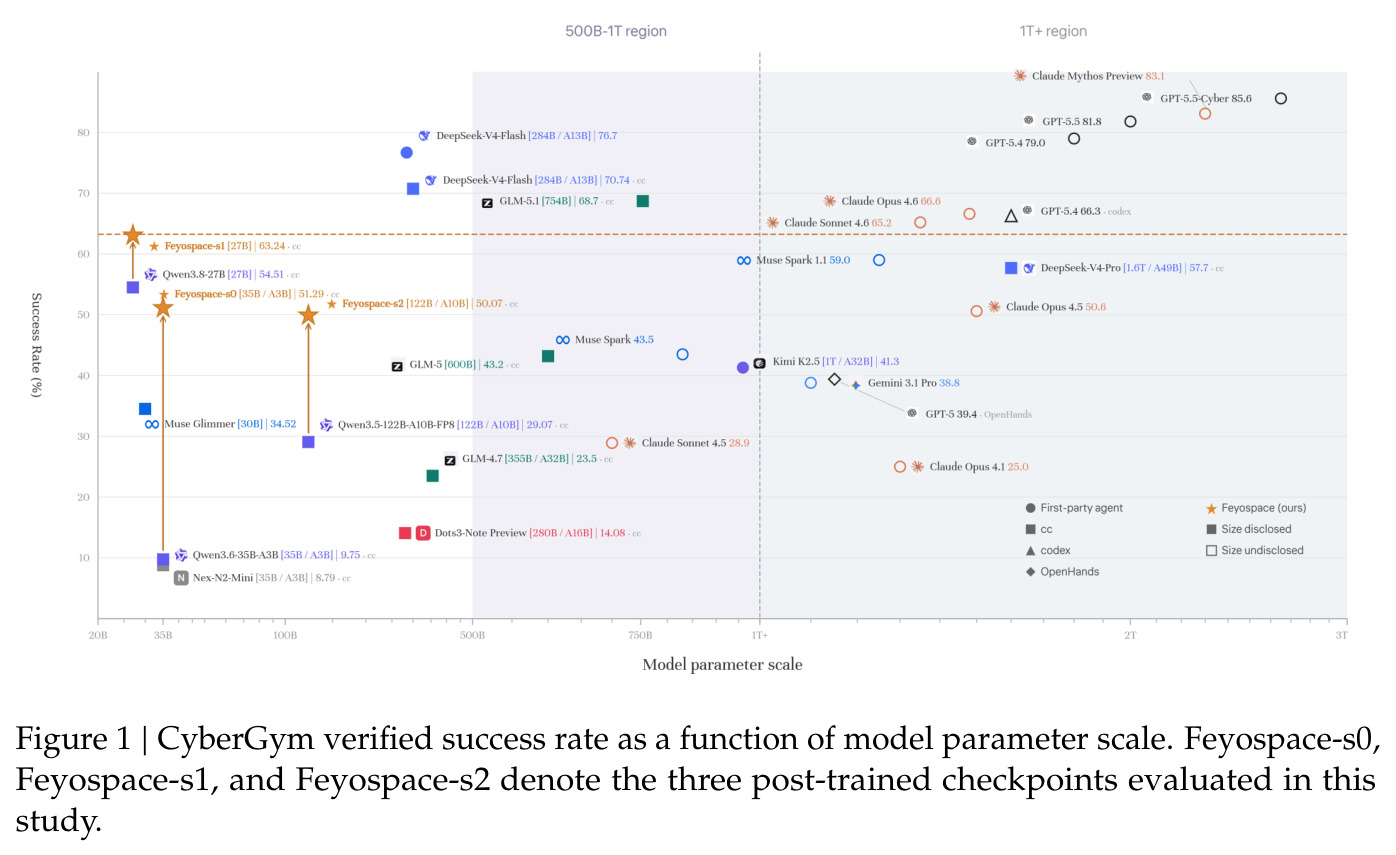
以参数规模为横轴展示 Feyospace-s0/s1/s2 三个后训练检查点与其各自基座在 CyberGym 上的验证成功率,直观呈现后训练带来的整体提升与'同参数规模第一'的定位。
这是全文的 headline 预览图,一眼看清三个 checkpoint 的提升幅度和与闭源/开源参照的相对位置。
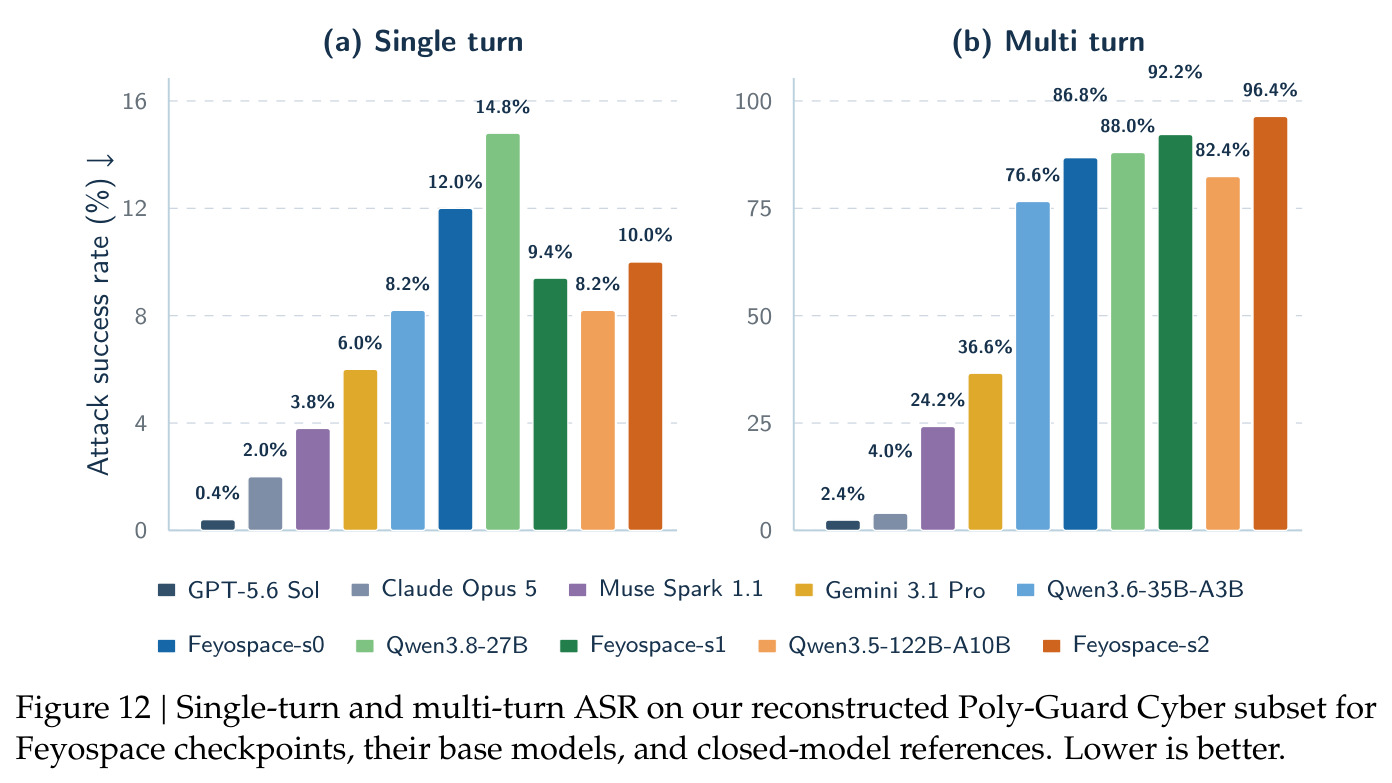
重建的 Poly-Guard Cyber 500 任务子集上的攻击成功率(越低越好):单轮 GPT-5.6 Sol 0.4%、Claude Opus 5 2.0%;本文 s1 从 14.8% 降至 9.4%,但 s0 从 8.2% 升至 12.0%、s2 升至 10.0%;多轮自适应攻击下三个 Feyospace 模型全部退化至 86.8%/92.2%/96.4%。
揭示了全文最大的隐患:能力 SFT 在大多数配对比较中推高了不安全行为率,多轮鲁棒性严重退化,是任何借鉴此管线者必须直面的限制。