ReMoMask-2:潜在检索增强的掩码动作生成 ReMoMask-2: Latent Retrieval-Augmented Masked Motion Generation
把检索库建在生成器自身潜在空间,检索与生成共享表征,单阶段掩码模型即达SOTA保真与最快推理
前置知识
RVQ-VAE 与动作令牌化
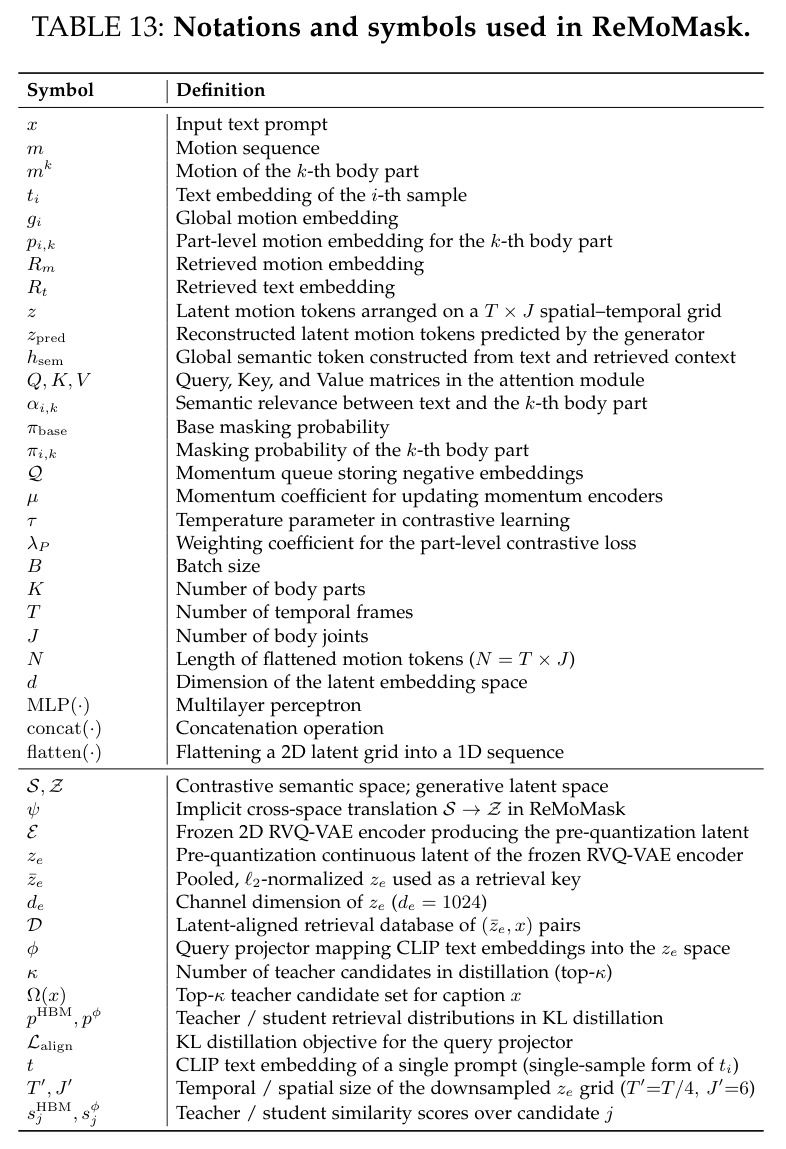
残差向量量化自编码器把连续动作编码为多级离散码本索引:首层记录粗粒度主体动作,后续残差层逐级修正量化误差。掩码生成模型(MoMask、MoGenTS)用它把动作变成离散 token 再并行预测。本文用预训练 2D RVQ-VAE(关节×时间网格),其预量化连续潜在 $z_e$ 正是检索库的载体。
本文最核心的设计是把检索库建在 RVQ-VAE 的预量化潜在空间里,不懂动作令牌化与量化管线就无法理解'检索空间=生成空间'这一贡献。
对比学习与动量编码器
InfoNCE 把配对的文本-动作嵌入拉近、与队列负样本推远,温度 $\tau$ 控制软硬;动量编码器以 $\theta^-\leftarrow\mu\theta^-+(1-\mu)\theta$ 缓慢更新,嵌入存入 65,536 队列充当海量负样本。本文用双向版本同时对齐全局与 6 个部件。
HBM 检索器是该机制的层级化扩展,查询投影器的 KL 蒸馏也直接复用其对比温度 $\tau=0.07$ 与排序结构,是读懂方法部分的前提。
检索增强生成(RAG)
生成时不只依赖参数里学到的知识,而是先从外部数据库检索相关样本,把证据作为条件注入生成过程,提升对罕见、复杂、长尾输入的鲁棒性。在文本到动作任务中即检索语义相近的动作-文本对,把参考动作嵌入 $R_m$ 与参考文本嵌入 $R_t$ 喂给生成器,代表工作有 ReMoDiffuse、ReMoGPT。
本文是 RAG-T2M 的代表性工作,全部动机与贡献围绕'检索证据以什么粒度对齐、以什么结构融合、处在哪个表征空间'三个问题展开。
FID / R-Precision / MM-Dist 等评测指标
FID 计算生成与真实动作特征分布的 Fréchet 距离,衡量整体保真度,越低越好;R-Precision 把真实描述与 31 条干扰描述排序,Top-k 越高对齐越好;MM-Dist 是动作-文本特征的平均欧氏距离;Diversity 与 MModality 分别衡量整体及同文本多采样的多样性。
论文所有结论都用这些指标表达(FID 0.042、Top-1 0.528 等),多处分析还依赖'分布级 FID'与'逐样本 MPJPE'的区别,不懂指标就读不懂实验。
注意力的 Q/K/V 非对称路由
交叉注意力中 Query 决定'在哪里查询'、Key 决定'权重如何分配'、Value 决定'被聚合合成的内容'。SSTA 利用这种不对称:Query 只来自当前动作潜在 $Q{=}W_qz$,语义调制只进 Key,检索动作证据只进 Value,在不破坏动作时空拓扑的前提下注入外部知识。
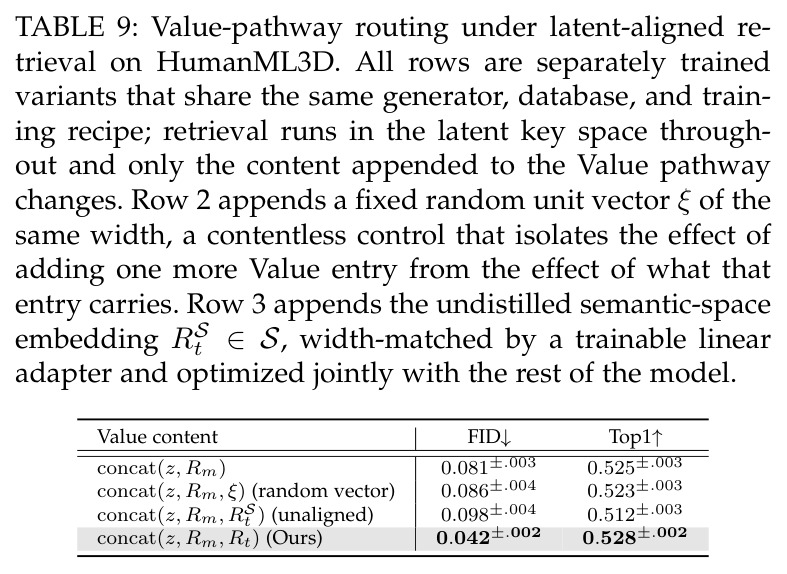
SSTA 的设计与 Table 9 的 Value 路由消融(对齐 $R_t$ 使 FID 从 0.081 降到 0.042,未对齐嵌入反而有害到 0.098)都建立在对 Q/K/V 分工的理解上。
研究动机
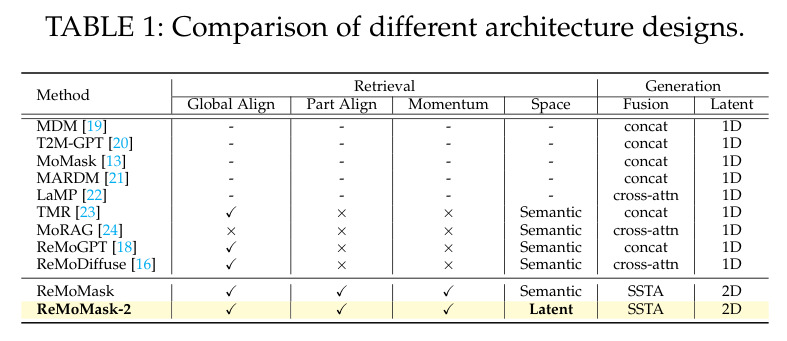
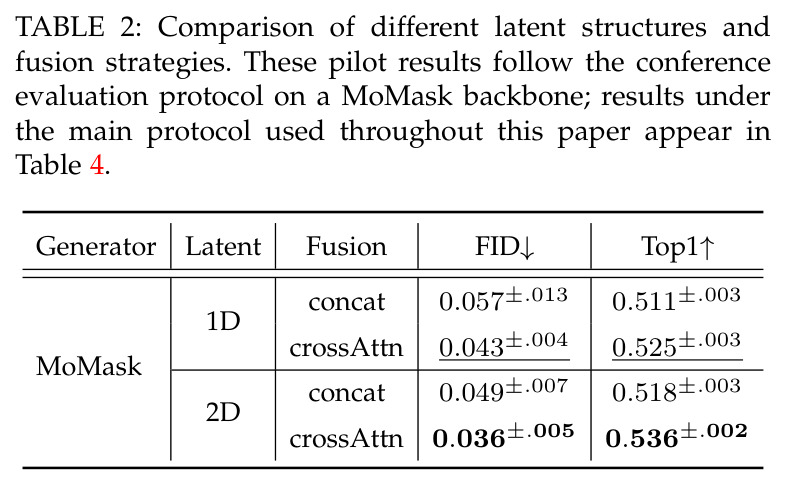
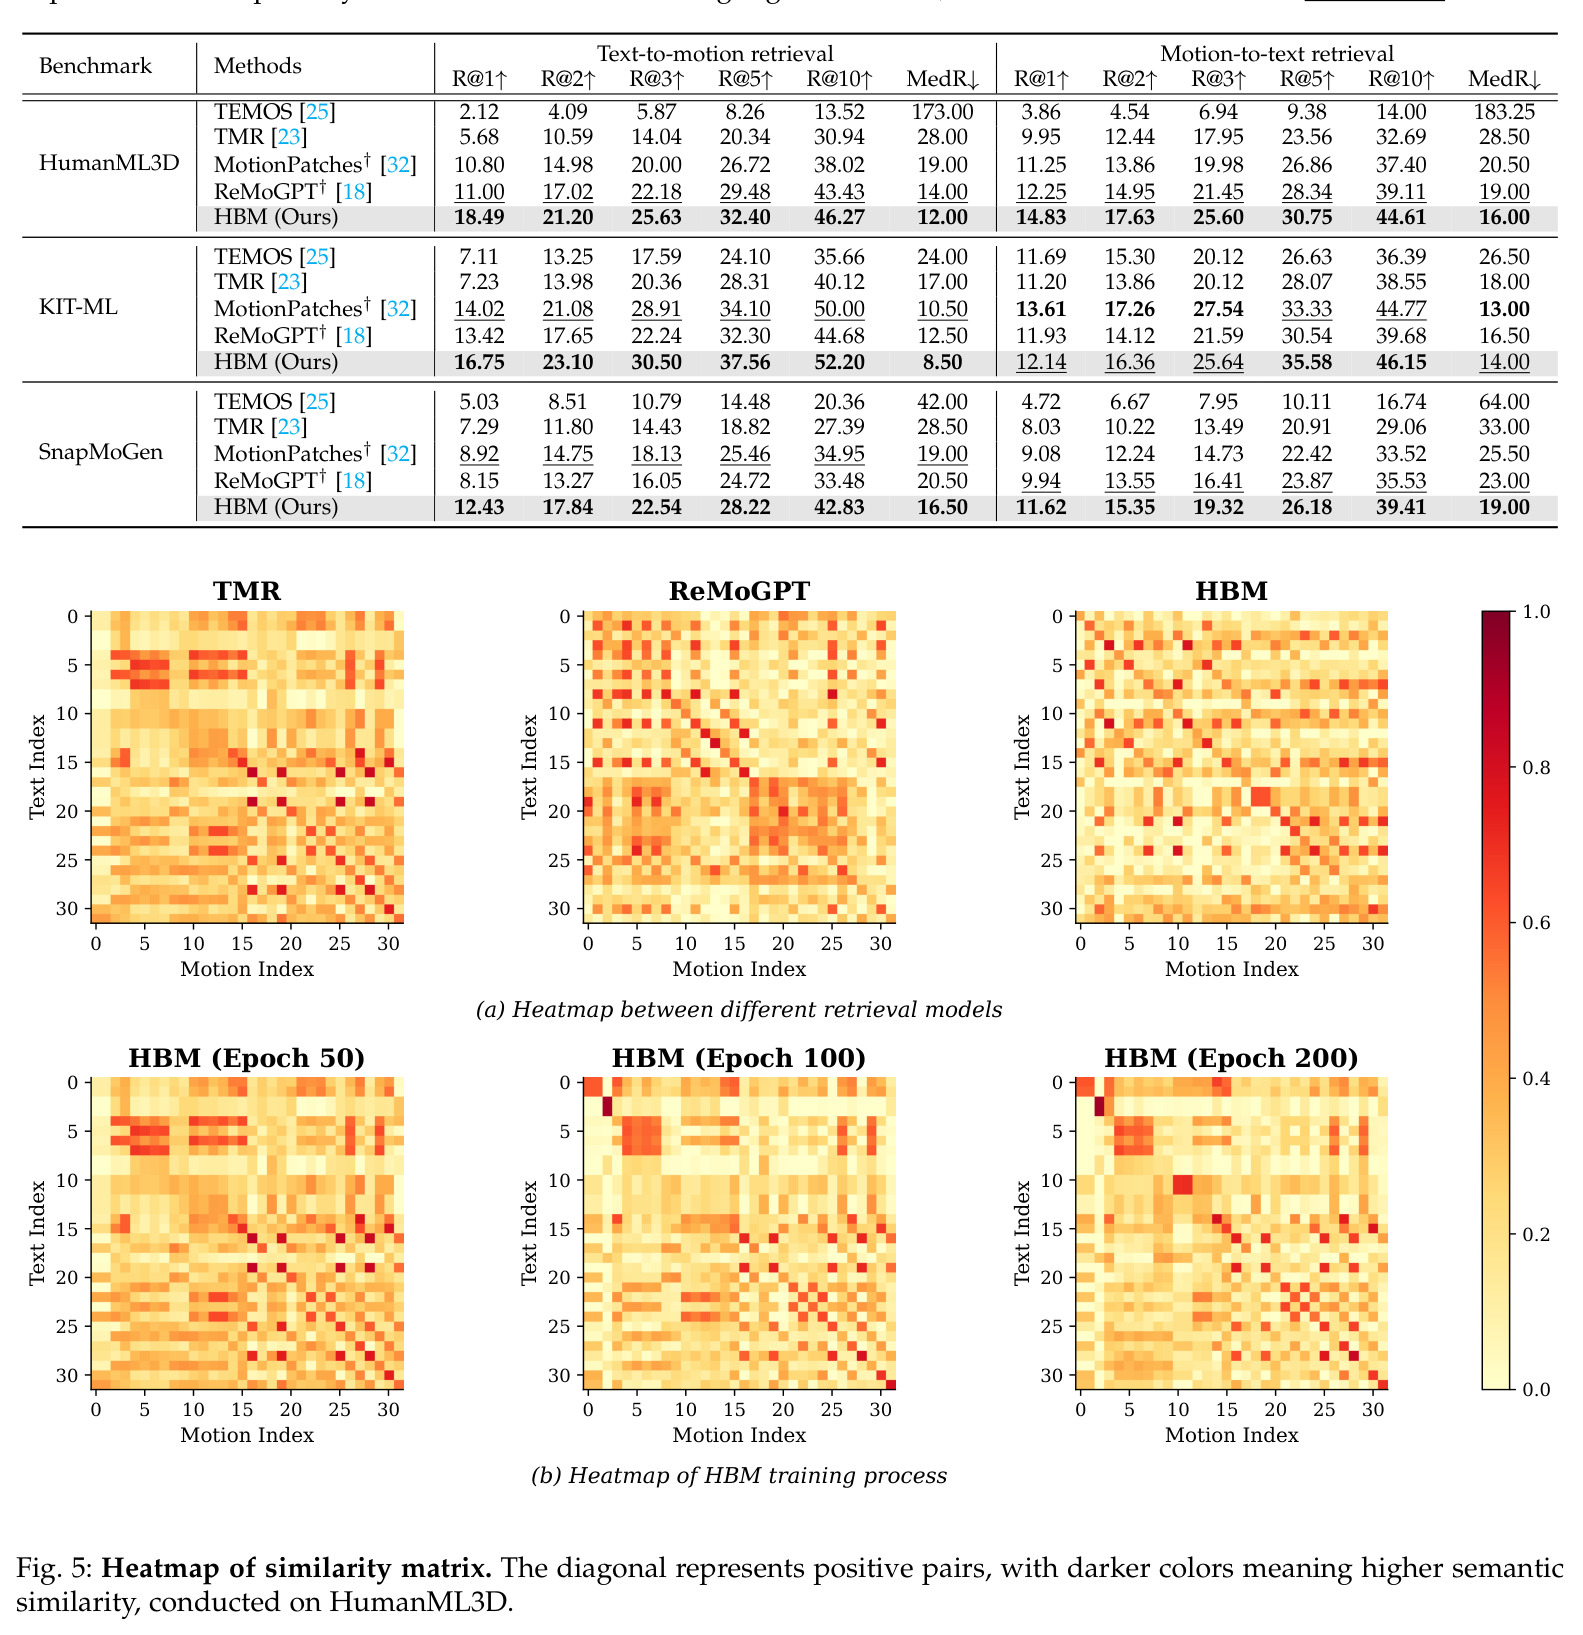
检索增强文本到动作(RAG-T2M)方法虽然对罕见复杂文本更鲁棒,但现有工作存在两大结构性缺陷。其一是检索与融合在结构上与动作拓扑不一致:多数检索器只做全局对比对齐(如 TMR 在 HumanML3D 上 text-to-motion R@1 仅 5.68),忽略由骨骼拓扑组织、按左右肢体/躯干/根关节划分的层次结构;ReMoGPT 虽然编码了部件特征,却只是简单聚合、缺乏部件级的双向跨模态监督。融合端普遍采用拼接或普通交叉注意力(在统一协议下 ReMoDiffuse FID 0.103、复现的 ReMoGPT 0.205、MoRAG-Diffuse 0.270),从没人系统考察动作潜在该用 1D 展平序列还是 2D 时空网格。其二是表征鸿沟:检索证据生活在独立训练的对比语义空间 $\mathcal{S}$,而生成本体操作 RVQ-VAE 潜在空间 $\mathcal{Z}$,前者优化判别、后者优化重构,训练中两个空间从不交互,注意力模块被迫隐式学习无任何约束的跨空间平移 $\psi:\mathcal{S}\to\mathcal{Z}$。
本文的目标是本文要构建一个'结构一致'的检索增强掩码动作生成框架,沿三条正交设计轴系统解决上述问题:对齐粒度上,让检索同时建模全局实例级与部件级(右臂/左臂/右腿/左腿/躯干/根共 6 个语义部件)的文本-动作对应;融合兼容性上,让检索证据以与动作潜在相同的 2D 时空网格拓扑注入生成器;表征一致性上,让检索直接发生在生成器自己的预量化潜在空间,使检索证据按构造就处于生成器消费的表征中。最终目标是在 HumanML3D、KIT-ML、SnapMoGen 三个基准上同时取得 SOTA 文本-动作检索精度、检索类方法中最佳生成保真度(并在部分基准上全场最低 FID)以及所有对比系统中最快的推理速度。
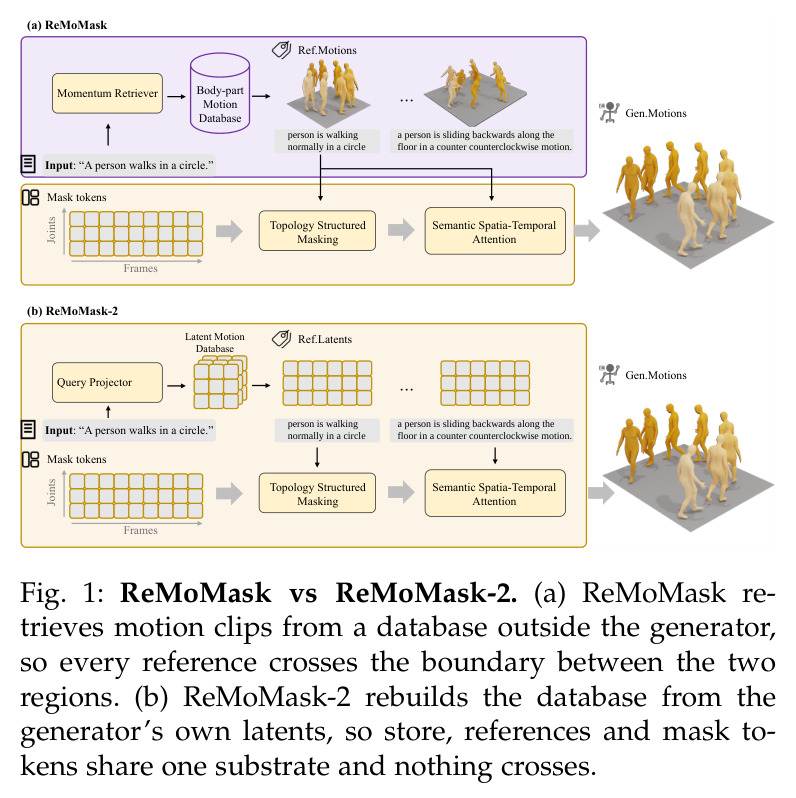
与已有工作不同的是,本文的独特切入是把 RAG-T2M 的设计空间形式化为三条正交轴,并指出此前所有工作——包括作者的 ECCV 2026 会议版 ReMoMask——最多只解决了前两条(对齐粒度与融合兼容),第三条'表征一致性'被整个领域忽视。关键洞察是:与其让融合模块隐式学习从语义空间到潜在空间的翻译,不如直接在冻结 RVQ-VAE 编码器的预量化潜在 $z_e$ 中重建检索库——由于检索键由供给生成潜量的同一个编码器产生,检索邻居天然可与生成器预测的潜在直接比较,从源头消除鸿沟。作者还用 2×2 控制实验证明动作库与文本流两路证据必须同时迁入生成器几何(FID 0.109→0.101/0.098→0.042,单独迁移只值 0.008,联合迁移值 0.056),这种对'证据必须以整体形式、在正确几何中到达'的量化分析是文献中首次。
核心方法
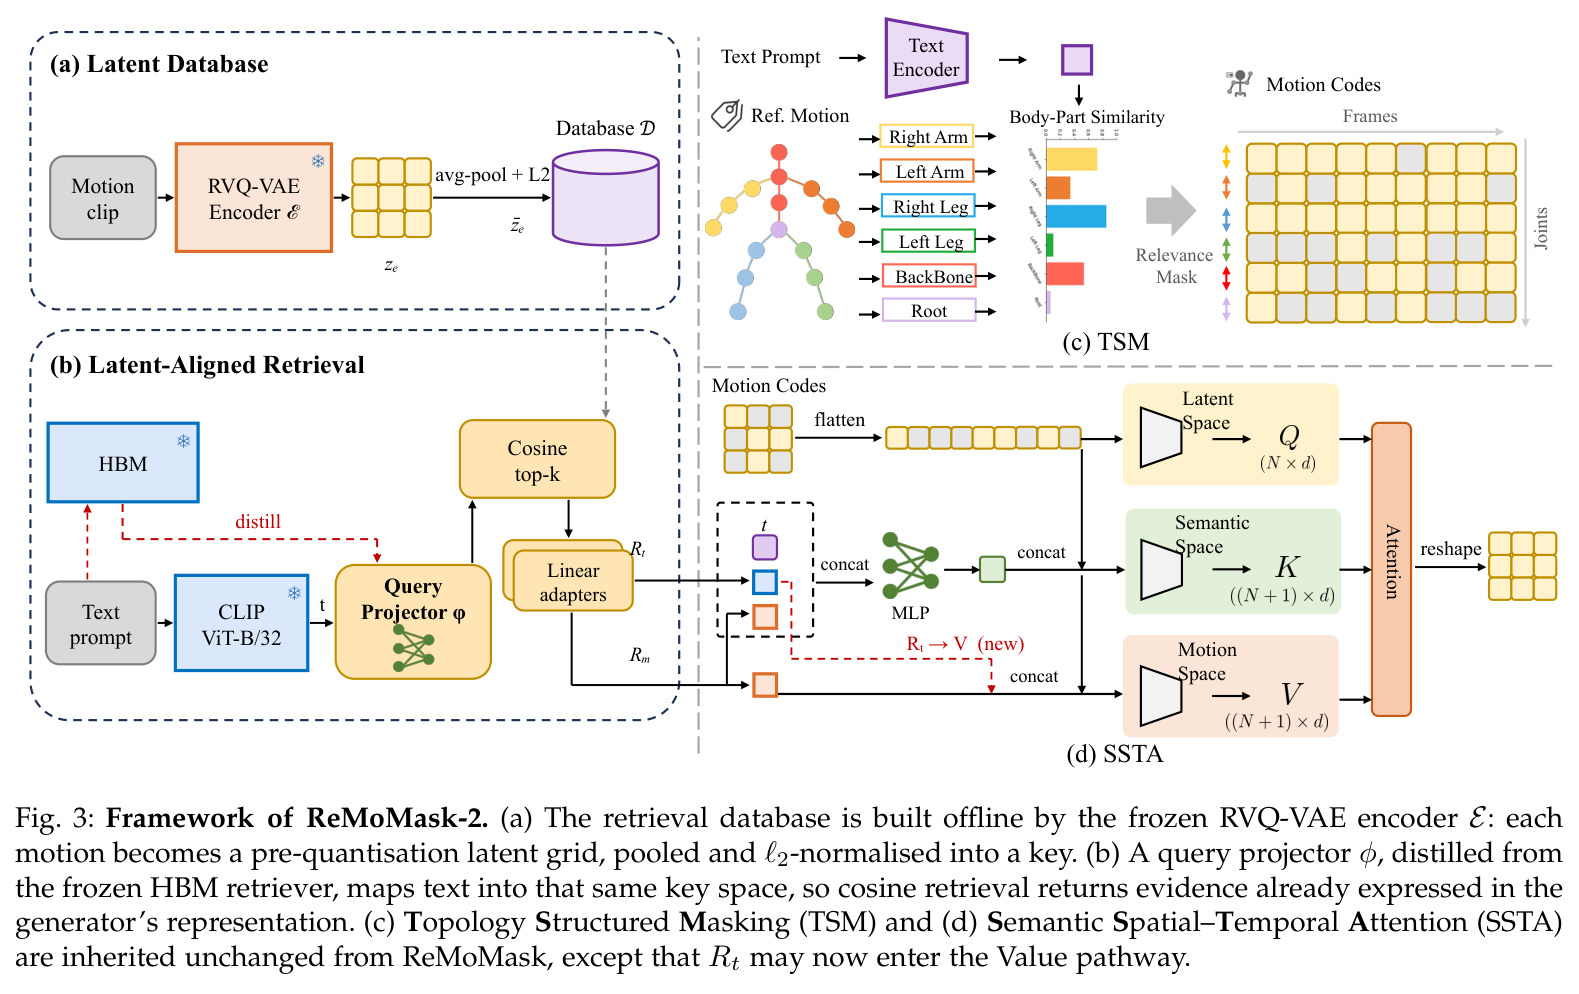
直觉上,检索增强像给画家看参考图:参考图不仅要内容相关(检索准),还要以画家习惯的媒质呈现(表征一致),否则画者得先在脑中翻译,必然失真。技术路线四步。第一步建库:冻结的 2D RVQ-VAE 编码器把动作编码为预量化潜在网格 $z_e=\mathcal{E}(m)\in\mathbb{R}^{d_e\times T'\times J'}$($d_e{=}1024$,$T'{=}T/4$,$J'{=}6$),池化并 $\ell_2$ 归一化成动作级键 $\bar{z}_e$,构成 $M{=}66{,}912$ 条目的库。第二步训 HBM 教师检索器:分层双向动量对比,同时监督实例级与 6 部件级的双向文本-动作对应。第三步蒸馏查询投影器 $\phi$:仅 1.57M 参数,把 CLIP 文本嵌入映射进同一键空间,以 KL 软目标蒸馏排序结构。第四步生成:单阶段掩码 Transformer 在 2D 关节-时间 token 网格上并行解码,训练用 TSM 语义感知掩码,推理经 SSTA 非对称注意力融合 top-$k$ 证据,最后 RVQ-VAE 解码。
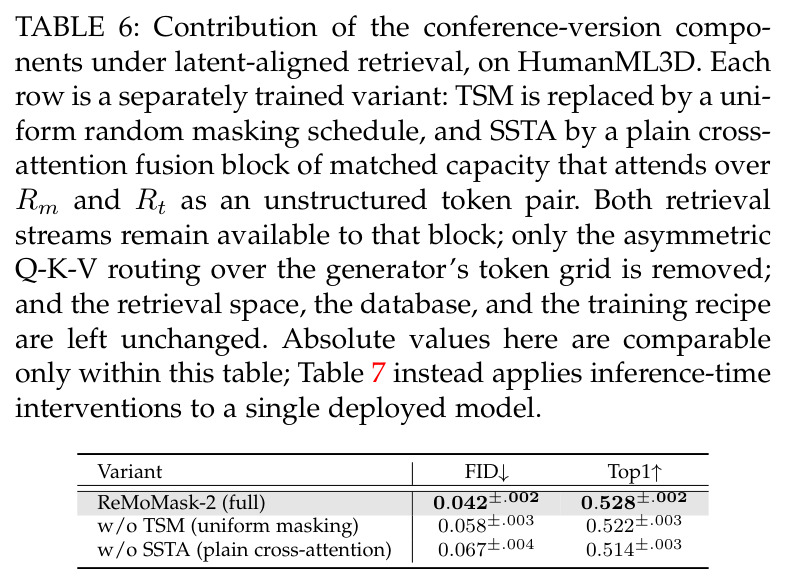
核心创新是'表征一致性'这一第三设计轴:检索键由生成器所用的同一个冻结编码器产生,因此存储、参考与掩码 token 共享同一基底,什么都不必跨越边界。与已有方法的本质区别:ReMoDiffuse、ReMoGPT、MoRAG 乃至会议版 ReMoMask 都把检索证据当作需要翻译的外部证据——语义空间 $\mathcal{S}$ 与生成空间 $\mathcal{Z}$ 训练目标不相交,实测两空间排序几乎独立(Spearman 相关仅 0.09,top-10 候选重叠仅 7.3%),融合模块被迫隐式学习无监督约束的跨空间映射。检索搬进生成器几何后,连会议版的残差精修级都变得有害(FID 从 0.042 恶化到 0.068)。配套创新:HBM 的层级双向动量对比(实例级+6 部件级双 InfoNCE);TSM 把对比空间学到的部件相关度转为掩码概率 $\pi_{i,k}{=}\pi_{base}(1{-}\alpha_{i,k})$,语义相关部件被保留为结构锚点;SSTA 非对称路由——语义只进 Key、动作证据进 Value、Query 严格锚定当前潜在。
方法步骤详情
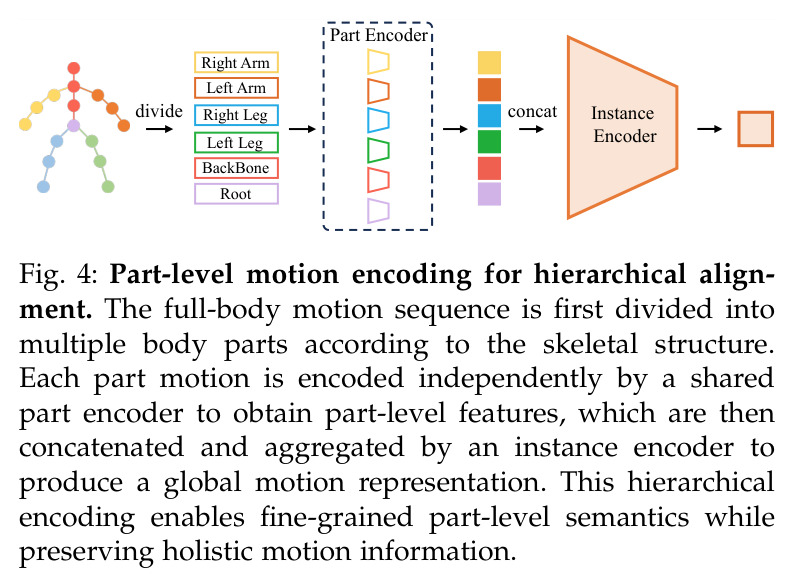
五步流程。①建库:冻结编码器输出 $z_e$,池化归一化成键 $\bar{z}_e$ 与描述配对入库,全程冻结。②训 HBM 教师:动作按骨骼切成 6 部件,共享部件编码器得 $p_{i,k}$,聚合为全局 $g_i$,以 $\mathcal{L}_{HBM}=\mathcal{L}_{Inst}{+}\lambda_P\mathcal{L}_{Part}$ 训 200 epochs(队列 65,536)。③蒸馏投影器:两层 MLP $\phi(t)$ 以 KL 匹配教师 top-256 软排序,只训这 1.57M 参数。④TSM 训生成器:部件相关度 $\alpha_{i,k}$ 决定掩码概率 $\pi_{i,k}{=}\pi_{base}(1{-}\alpha_{i,k})$,语义相关部件保留、无关部件激进遮蔽,重建被遮 token。⑤推理:余弦检索 top-2,$R_m$ 取池化键、$R_t{=}\phi(t^{(j)})$,经适配器进 SSTA:$h_{sem}$ 只进 Key、$V$ 含检索证据、$Q$ 只来自当前潜在;6 层 8 头 Transformer 并行预测后解码。
技术新颖性
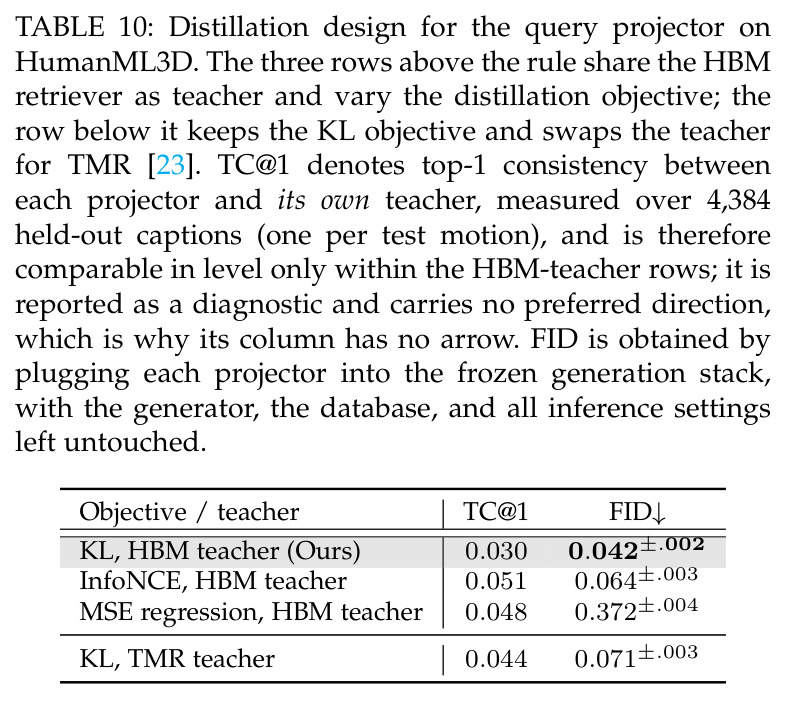
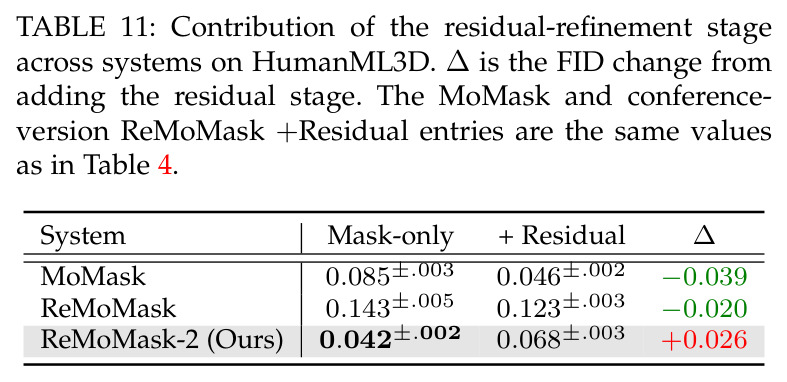
技术新颖性有四点。第一,'表征一致性'作为设计轴是概念性贡献:文献都在追求更好的排序器,本文用受控实验(Table 5)证明同一生成器配语义空间检索 FID 0.109、配量化索引 0.060、配连续预量化潜在 0.042,且表征一致性比排序器质量更重要——弱排序器 TMR 在潜在空间(0.071)仍优于最强排序器 HBM 在语义空间(0.109)。第二,软目标 top-$\kappa$ 蒸馏把教师排序结构迁入潜在空间,并揭示反直觉规律:与教师一致性最高的目标(InfoNCE 0.051)生成 FID 只有 0.064,一致性最低的 KL 蒸馏(0.030)却唯一达到 0.042,因为两个空间排序近乎独立,可迁移的只有候选集上的分级结构而非第一名。第三,HBM 的部件级双向对比弥补了 ReMoGPT'聚合部件特征却无部件级跨模态监督'的缺陷,text-to-motion R@1 从 11.00 提到 18.49。第四,TSM 创造了'检索器教生成器'的闭环——把对比空间的相关度作为掩码先验;单阶段设计还推翻了'残差精修级必不可少'(MoMask 上 Δ−0.039)的既有认知。
实验结果
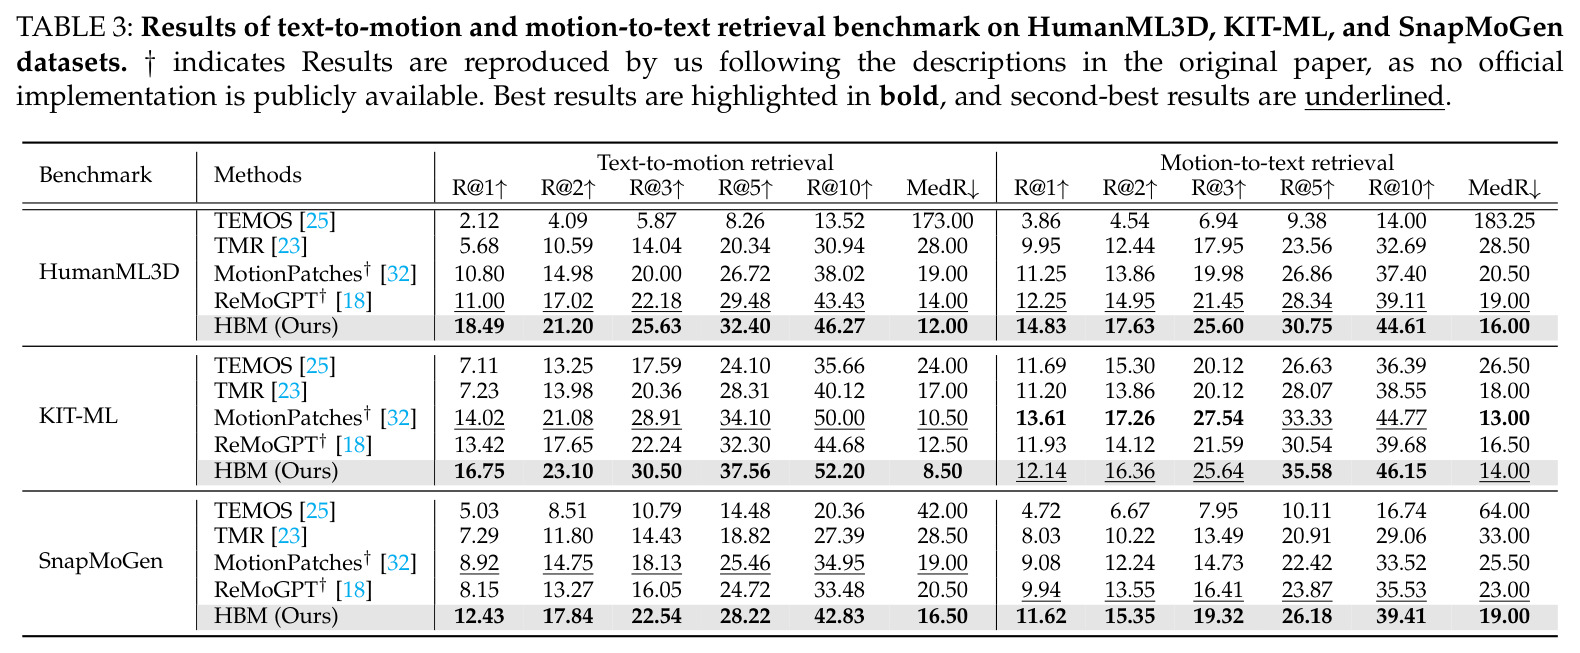
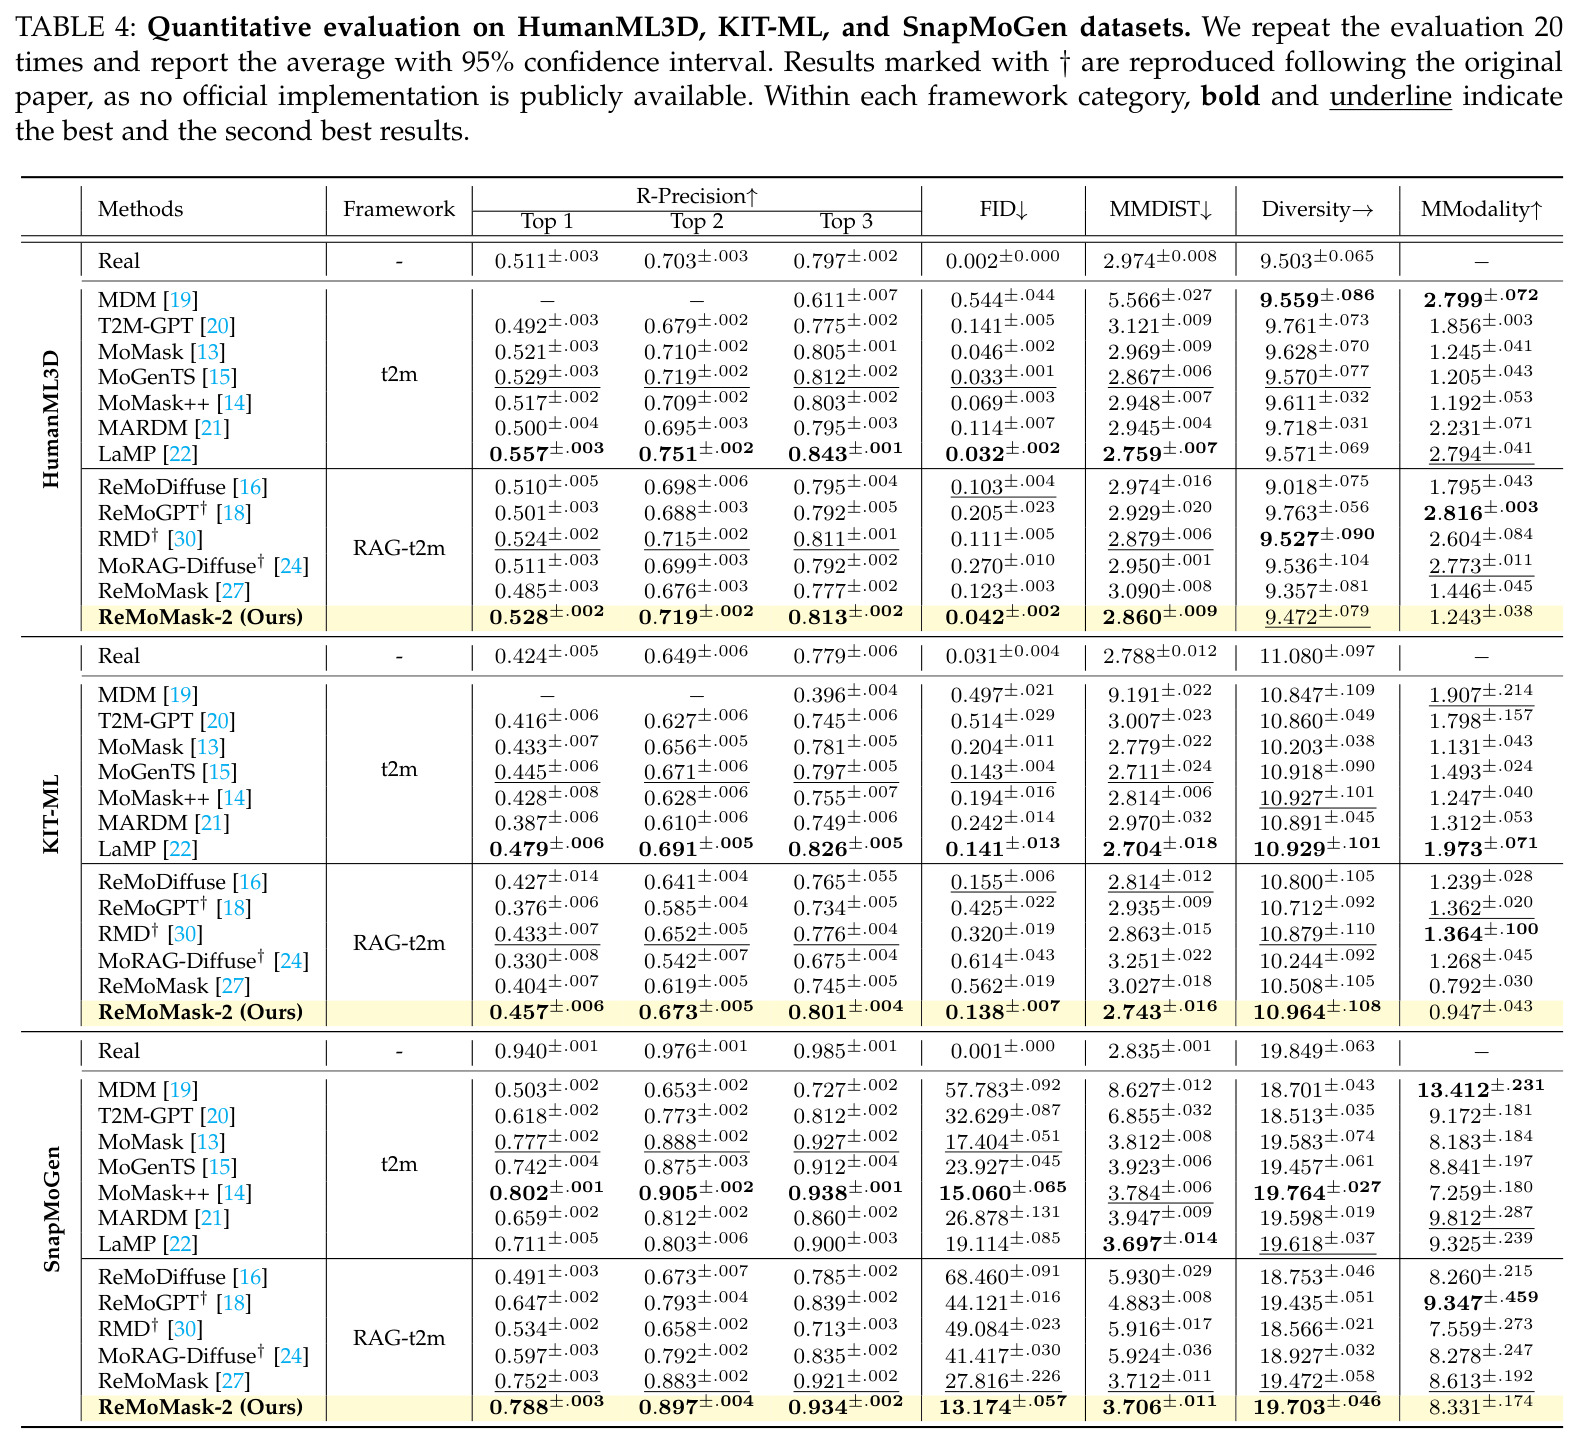
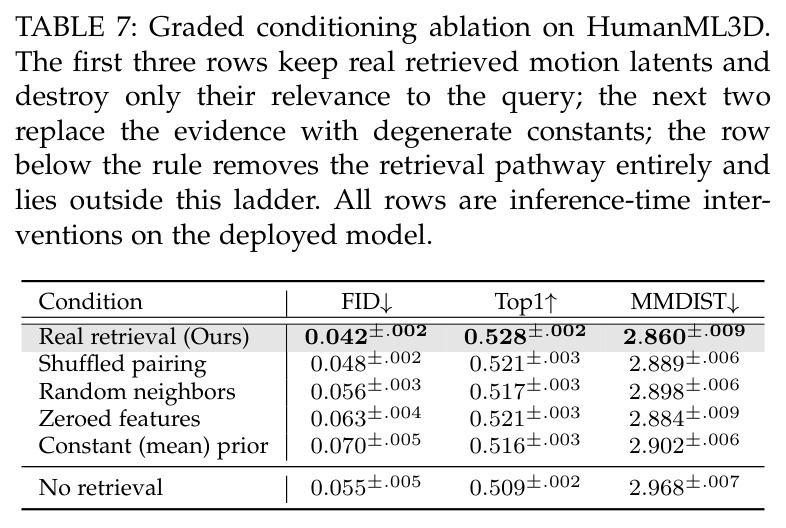
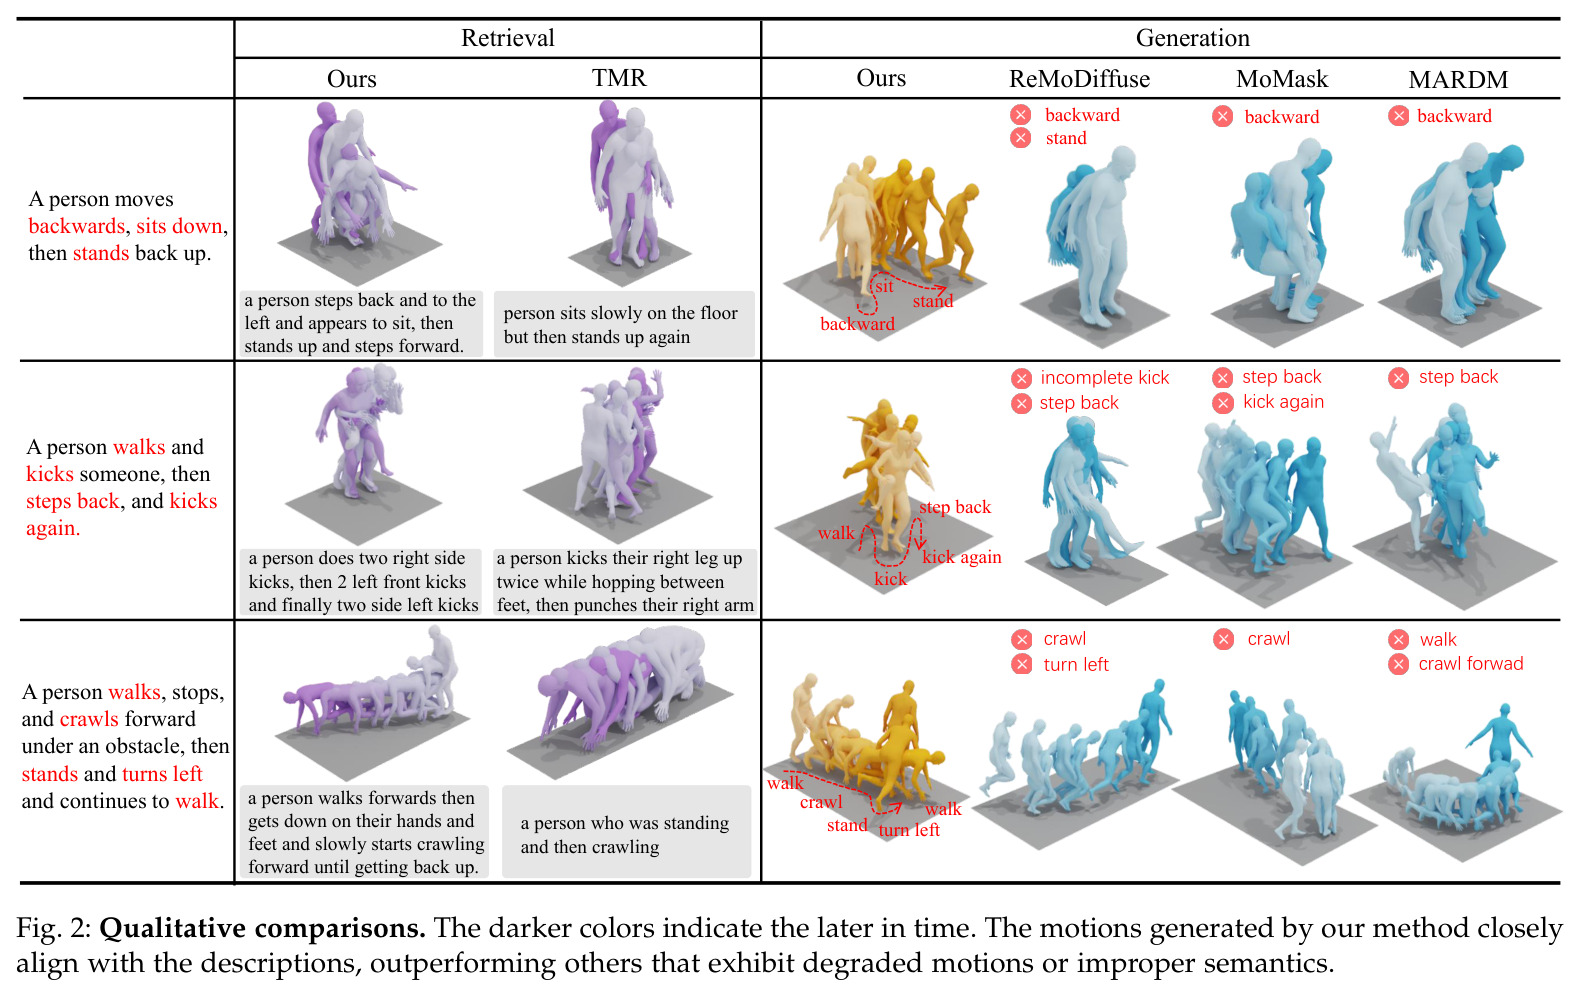
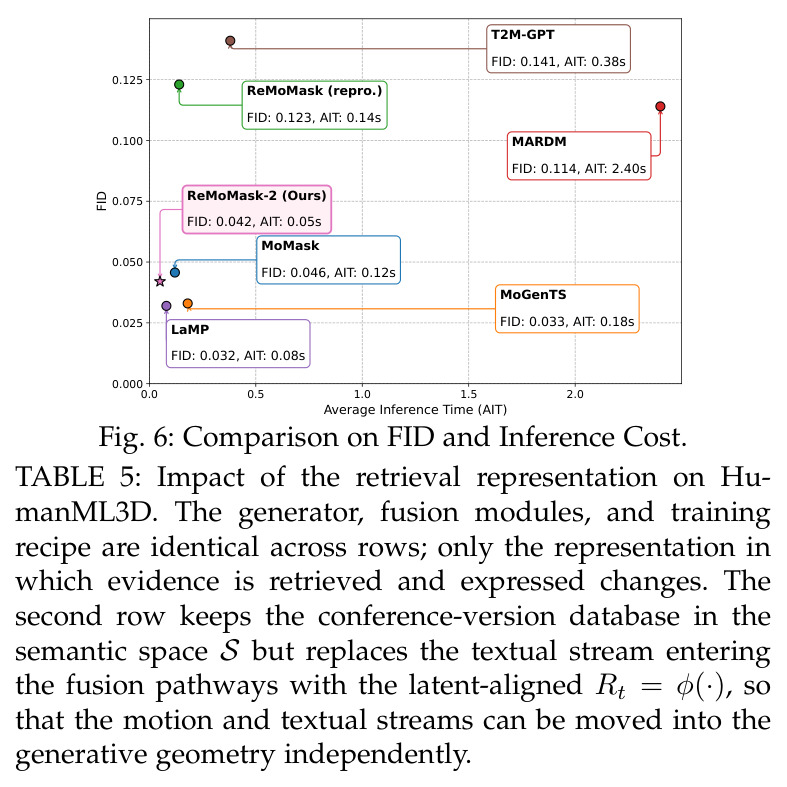
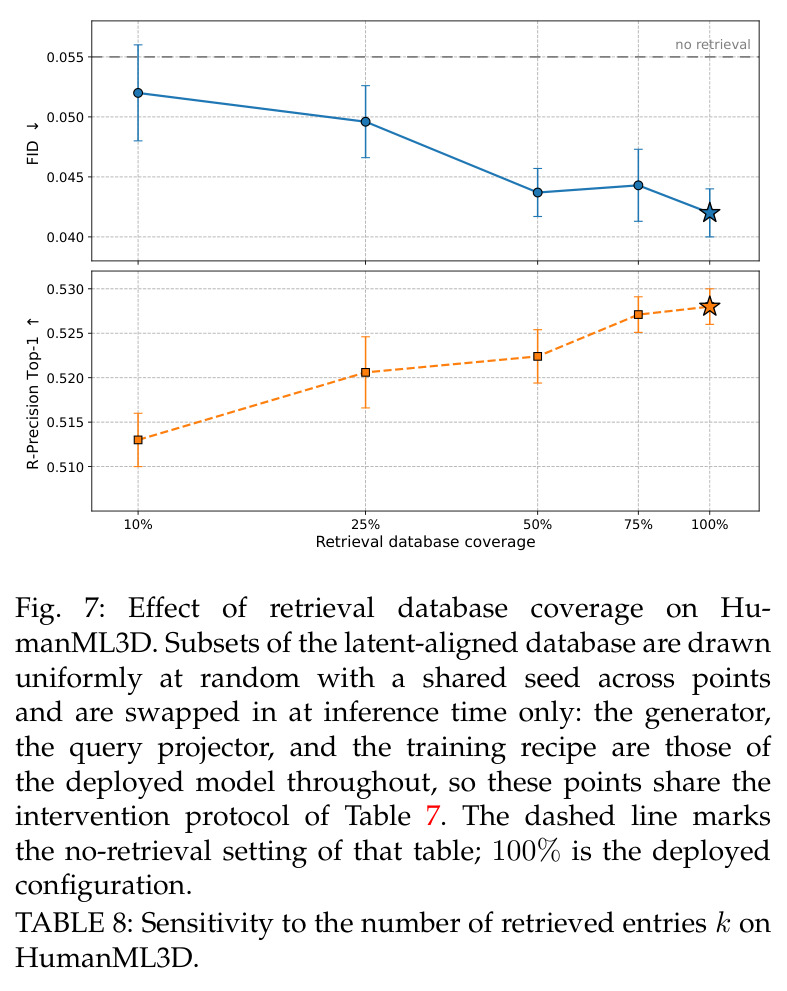
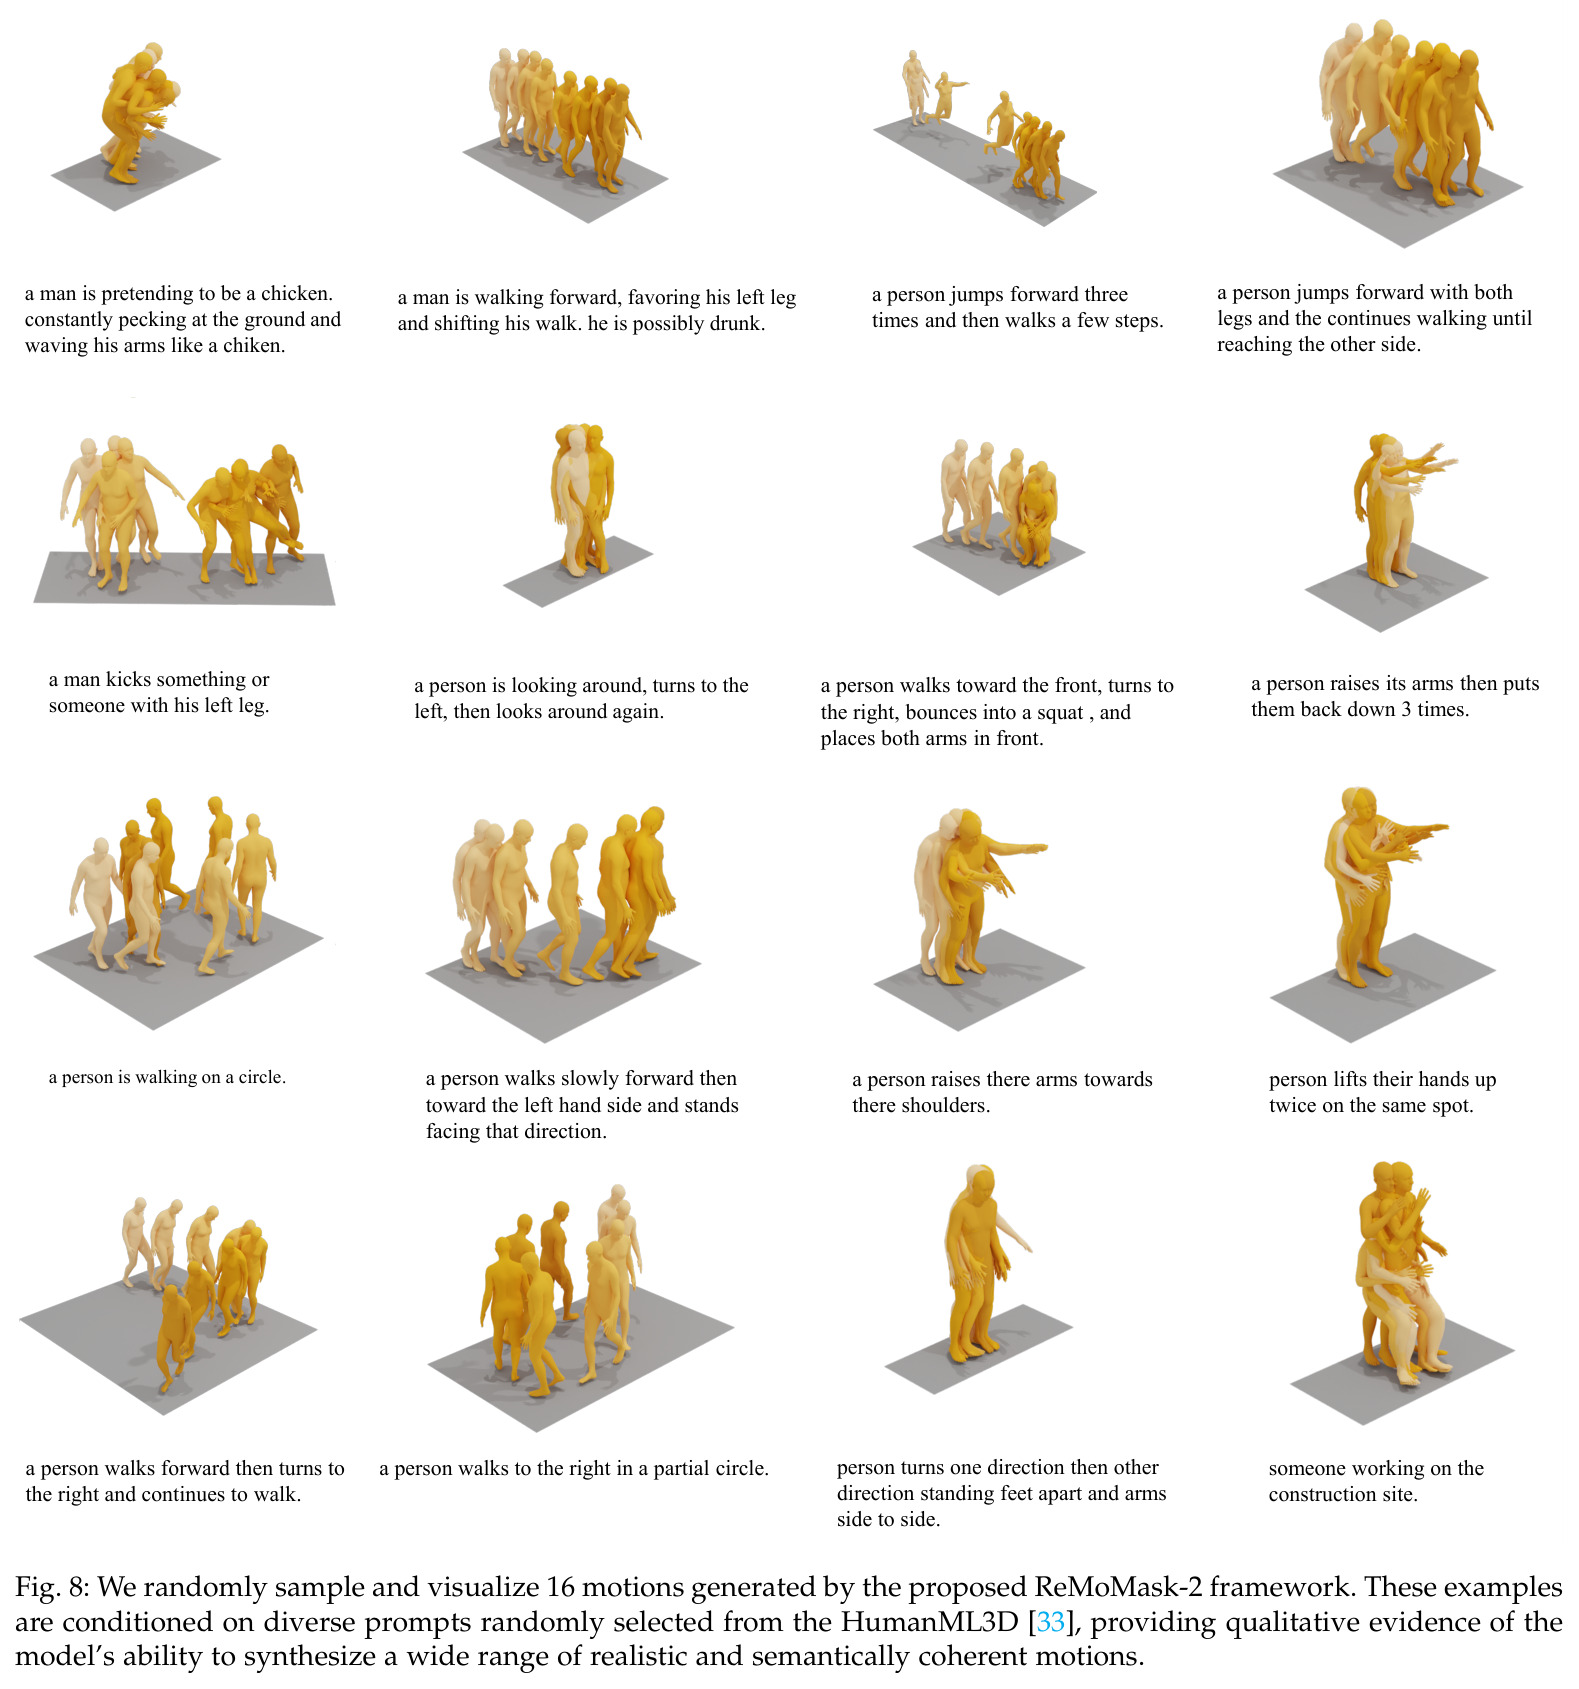
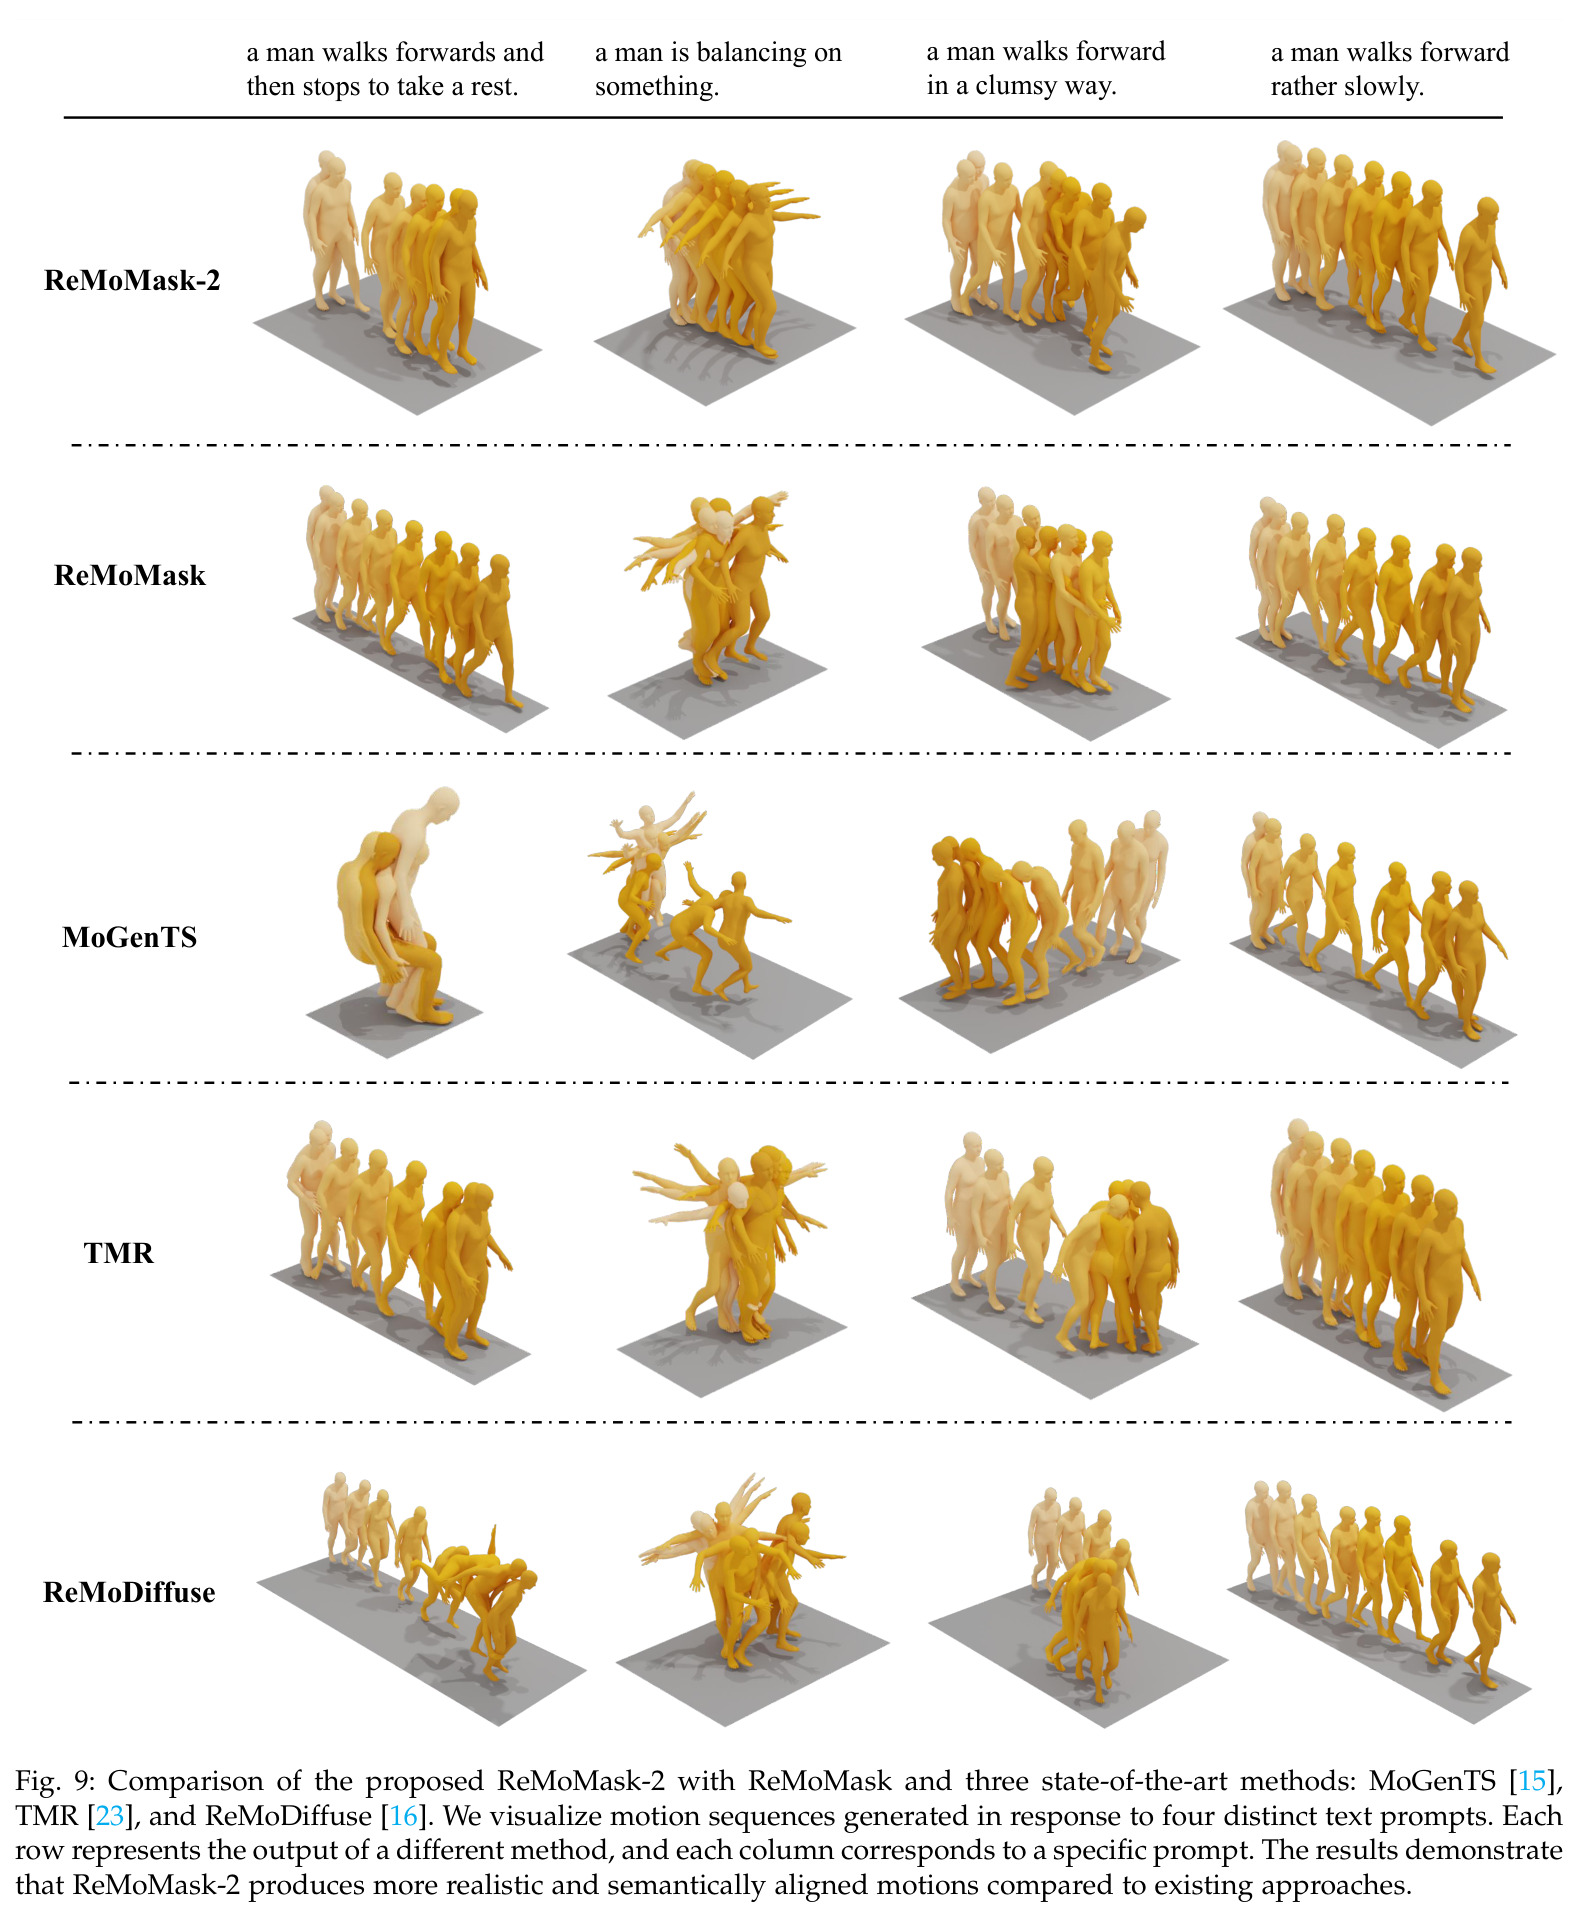
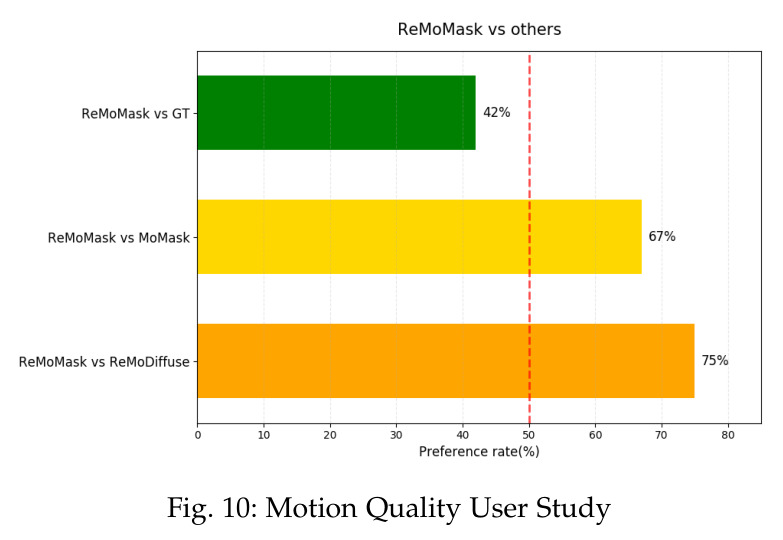
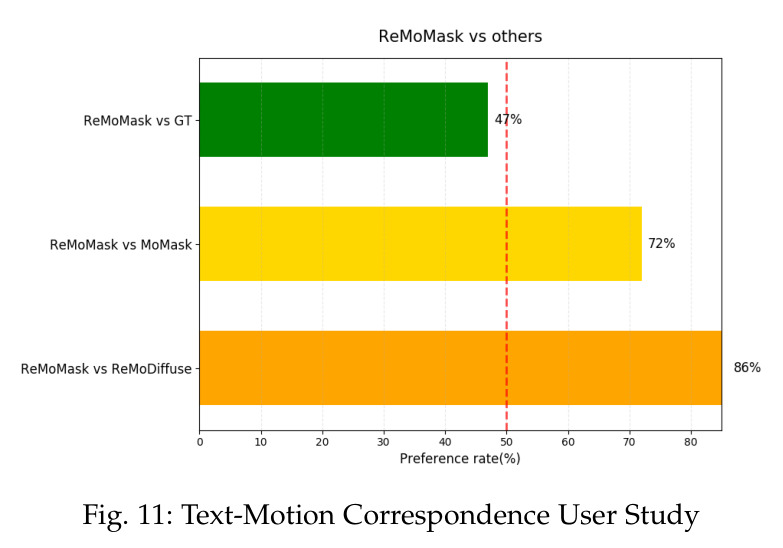
检索(Table 3):HBM 三基准检索全部 SOTA,R@1 为 HumanML3D 18.49、KIT-ML 16.75、SnapMoGen 12.43。生成(Table 4):HumanML3D FID 0.042、Top-1 0.528,单阶段胜两阶段 MoMask(0.046/0.521),较会议版 0.123 降 65.9%,但不及非检索的 MoGenTS 0.033;KIT-ML 0.138 全场最低(会议版 0.562,降 75.4%);SnapMoGen 13.174 全场最低(次优 15.060)。推理 0.05s/样本最快。消融:检索空间语义 0.109→量化索引 0.060→潜在 0.042;条件阶梯真实 0.042→打乱 0.048→随机邻居 0.056→均值先验 0.070,证明真消费语义;库覆盖率 10%→100% 使 FID 0.052→0.042;Value 路由未对齐 $R_t$ 有害(0.098),对齐后减半至 0.042;残差级反加 0.026。用户研究:真实感偏好 42%、对 MoMask 67%、对 ReMoDiffuse 75%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本→动作检索(HumanML3D) | R@1 / MedR | HBM:18.49 / 12.00 | ReMoGPT:11.00 / 14.00 | R@1 +7.49(相对提升 68%) |
| 文本→动作检索(KIT-ML) | R@1 / MedR | HBM:16.75 / 8.50 | MotionPatches:14.02 / 10.50 | R@1 +2.73,六项指标全部第一 |
| 文本→动作检索(SnapMoGen) | R@1 | HBM:12.43 | MotionPatches:8.92 | +3.51(相对提升 39%) |
| 动作生成保真度(HumanML3D) | FID↓ / R-Precision Top-1 | 0.042±.002 / 0.528±.002(单阶段) | MoMask:0.046 / 0.521(两阶段);会议版 ReMoMask:0.123 | 单阶段胜两阶段;较会议版 FID −65.9%(非检索 SOTA MoGenTS 0.033 更低) |
| 动作生成保真度(KIT-ML) | FID↓ | 0.138±.007 | LaMP 0.141 / MoGenTS 0.143 / 会议版 0.562 | 全场最低;较会议版 −75.4% |
| 动作生成保真度(SnapMoGen) | FID↓ / Top-1 | 13.174±.057 / 0.788 | MoMask++:15.060 / 0.802 | 全场最低 FID(−12.5%),Top-1 次于 MoMask++ |
| 推理效率(2080Ti,100 样本均值) | 平均推理时间 | 0.05s | LaMP 0.08s / MoMask 0.12s / 会议版 0.14s / MARDM 2.40s | 所有对比系统最快 |
局限与改进
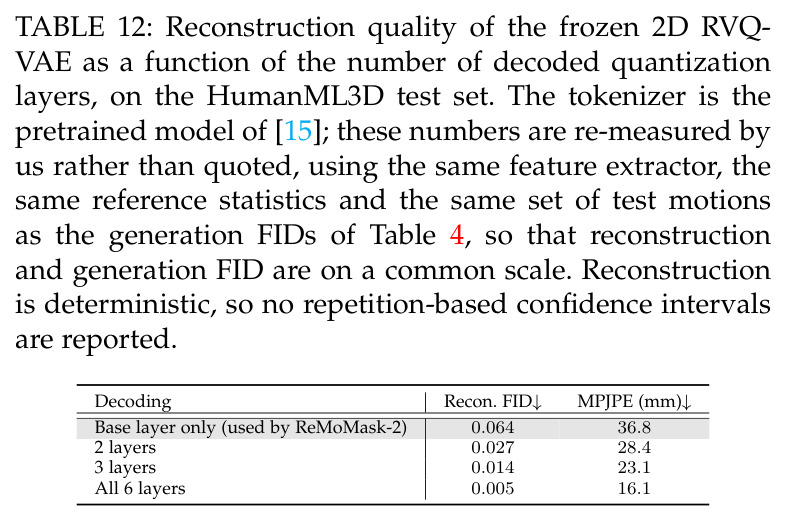
作者承认两点:一是效果依赖查询分布与检索库的匹配程度,相关动作在语料中缺失或稀疏时检索收益缩水——库仅覆盖 23,384 段训练动作,Fig. 7 也显示收益随库扩大边际递减;二是只解码 RVQ-VAE 基础量化层,逐样本精度被基础层重构上限约束(MPJPE 36.8mm,全 6 层可到 16.1mm),深层码本细节未被利用。我补充几点:HumanML3D 上 FID 0.042 并非绝对 SOTA——非检索方法 MoGenTS 0.033、LaMP 0.032 更低,'全场最低'只在 KIT-ML 与 SnapMoGen 成立,摘要表述易被误读;检索条件化使 MModality 在 HumanML3D(1.243)与 SnapMoGen 下降,对需要多样输出的应用是硬伤;绝对检索精度仍不高(R@1 18.49%),学生投影器直接检索 R@1 更只有 12.4;两空间排序 Spearman 仅 0.09,蒸馏到底迁移了什么机制仍偏经验性;训练需 8×A800 最长 2,000 epochs,库规模只跨约一个数量级,作者也承认不能外推为 scaling law。
独立分析的弱点
弱点一:数据库封闭性。检索库完全由训练集构建,查询训练分布外的动作时,检索要么返回无关邻居(Table 7 中随机邻居 FID 0.056 与无检索 0.055 统计不可分)要么误导样本,缺'检索不可信则弃用'的 OOD 门控——可引入相关性阈值或学习型置信度门控。弱点二:单层解码天花板。基础层重构 MPJPE 36.8mm(6 层可到 16.1mm),深层码本细节被丢弃;但 Table 11 显示全序列残差精修有害(+0.026)——可做选择性深解码,只对高不确定性 token 调用更深量化层。弱点三:多样性受损。检索条件化把输出拉向库中范例,MModality 在 HumanML3D(1.243)与 SnapMoGen 下降——可在 Value 通路的 $R_m$ 上加噪或加显式多样性正则。弱点四:蒸馏信息瓶颈。两空间排序 Spearman 仅 0.09,学生直接检索 R@1 仅 12.4、远低于教师 18.49——可让投影器联合接受生成损失或多教师蒸馏。弱点五:多个 RAG 基线(†标记)无官方实现、为作者复现,跨论文可比性有折扣。
未来方向
作者明确提出三个方向:把潜在对齐检索扩展到与目标域不同的数据库(跨域检索增强)、检测查询落在库覆盖分布之外的场景(OOD 检测)、在单生成阶段内解锁更深的量化解码路径。在其成果基础上还可延伸:把 HBM 的固定 6 部件拓扑推广到人-物交互、双人交互等动态部件划分(按接触图切分);利用'数据库=生成器表征的缓存视图'这一性质做在线增量检索库——新采集动作即时入库而无需重训生成器;把'在生成器自身潜在空间建库'作为设计律迁移到图像、视频生成与运动规划等其他 RAG 场景验证普适性;沿 Fig. 7 的对数线性趋势(约每十倍库大小 FID 降 0.010、$R^2=0.93$)用 AMASS 级别更大语料检验缩放规律;以及探索检索证据与扩散/自回归骨干的组合,检验表征一致性结论是否跨生成范式成立。
复现评估
复现条件较好。代码开源(github.com/AIGeeksGroup/ReMoMask-2),主页含生成视频;三个基准全公开(HumanML3D 14,616 动作/44,970 文本、KIT-ML 3,911/6,278、SnapMoGen 20,450/122,565),特征维度与划分比例均有披露。RVQ-VAE 用 MoGenTS 预训练模型、CLIP ViT-B/32 冻结,免训练。算力门槛:检索器 200 epochs 单卡 A800;掩码生成器 8×A800、最长 2,000 epochs、batch 64,是主要成本。关键超参披露完整($\mu{=}0.999$、队列 65,536、$\tau{=}0.07$、top-256、$\pi_{base}{=}0.5$、$k{=}2$、投影器 1.57M 参数)。难点在管线编排:建库、HBM 训练、蒸馏、TSM 训练四阶段串联;且作者以统一协议复现会议版基线,第三方直接用原始 checkpoint 对比可能有偏差。总体:中等偏上难度——核心创新实现极简(一张缓存键表加一个小投影器),复杂度都在训练基建上。
论文图表
检索条数 k 扫描:k=1 FID 最低 0.037 但 Top-1 掉到 0.520;k=2 为 0.042/0.528(采用);k=3/4/6 FID 0.044/0.043/0.045、Top-1 基本持平。最优解平缓,作者以保真+对齐联合准则选 k=2,主动放弃 0.005 FID 换 0.008 Top-1。
展示推理超参的敏感性并解释部署配置的取舍逻辑,说明 0.042 不是该模型可达的最低 FID 而是平衡点。