Ambient @ EgoProactive 2026:基于视觉落地监督的自我中心主动式助手 Ambient @ EgoProactive 2026 : Proactive Egocentric Assistance with Visually Grounded Supervision
单token分类与视觉落地合成监督,助力EgoProactive挑战赛大规模组夺冠
前置知识
自我中心视频与主动介入
自我中心(egocentric)视频由头戴相机拍摄,画面即用户第一视角。主动式助手持续观看视频流,在恰当的时机主动开口给指导(介入),其余时间保持沉默,介入时机的把握直接决定任务成败。
本文的全部问题定义都围绕'每8秒片段决定说还是不说'展开,不理解这一设定就无法理解为何把任务改写成二分类。
Macro-F1 与 G-mean
Macro-F1 是两类 F1 的算术平均:$\frac{1}{2}(F1_{interrupt}+F1_{silent})$;G-mean 是几何平均:$\sqrt{F1_{interrupt}\cdot F1_{silent}}$。对从不触发或始终触发的退化策略,macro-F1 仍约给三分之一的可得分数,而几何平均会因一项为零而归零。
论文反复强调两套指标的分歧:官方用 macro-F1 评分,作者内部用 G-mean 选模型,理解它们的差异才能读懂模型选择的逻辑。
Verbalizer 与单 token 分类
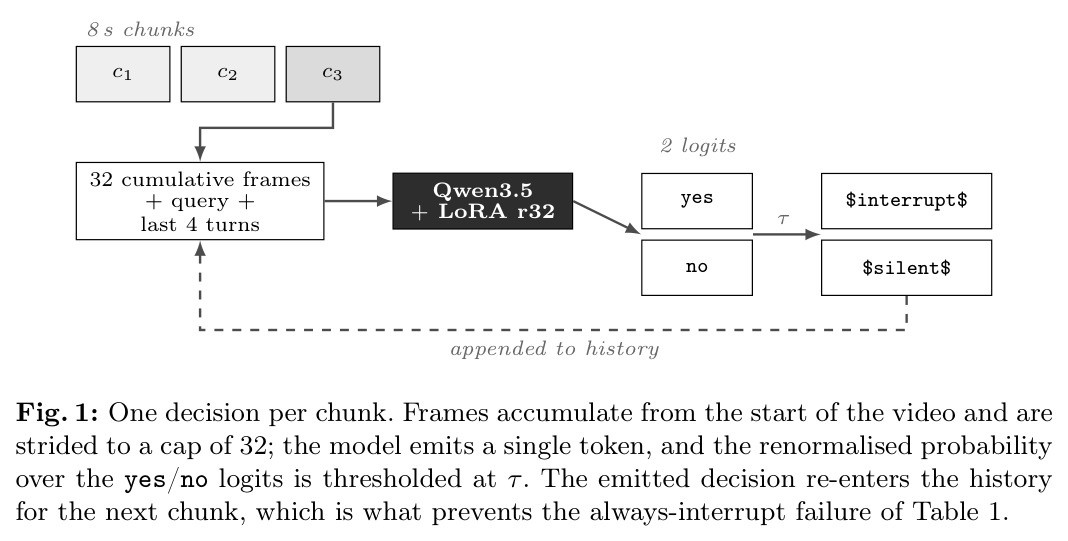
把生成任务改写成受限分类的技巧:让模型只在 yes/no 两个 token 上输出,决策取 $p_{interrupt}=\mathrm{softmax}[z_{no},z_{yes}]_1$,再与阈值 $\tau$ 比较得出 $\hat{y}=\mathbb{1}[p_{interrupt}\geq\tau]$,从而把二元选择从长文本生成中解耦。
这是本文第一大贡献,带来 +0.249 macro-F1,且阈值可训练后调节,是读懂方法部分的前提。
LoRA 参数高效微调
冻结预训练模型权重,只在注意力和 MLP 投影矩阵旁注入低秩可训练矩阵。秩 $r$ 控制容量,缩放系数 $\alpha$ 控制更新幅度,本文用 rank 32、$\alpha=64$、dropout 0.05,作用于全部 7 个投影,batch 1 配 8 步梯度累积。
论文的训练配方全靠 LoRA 才能在 2B-4B 模型上用小批量训练,复现时必须理解这些超参的含义。
工具调用智能体标注
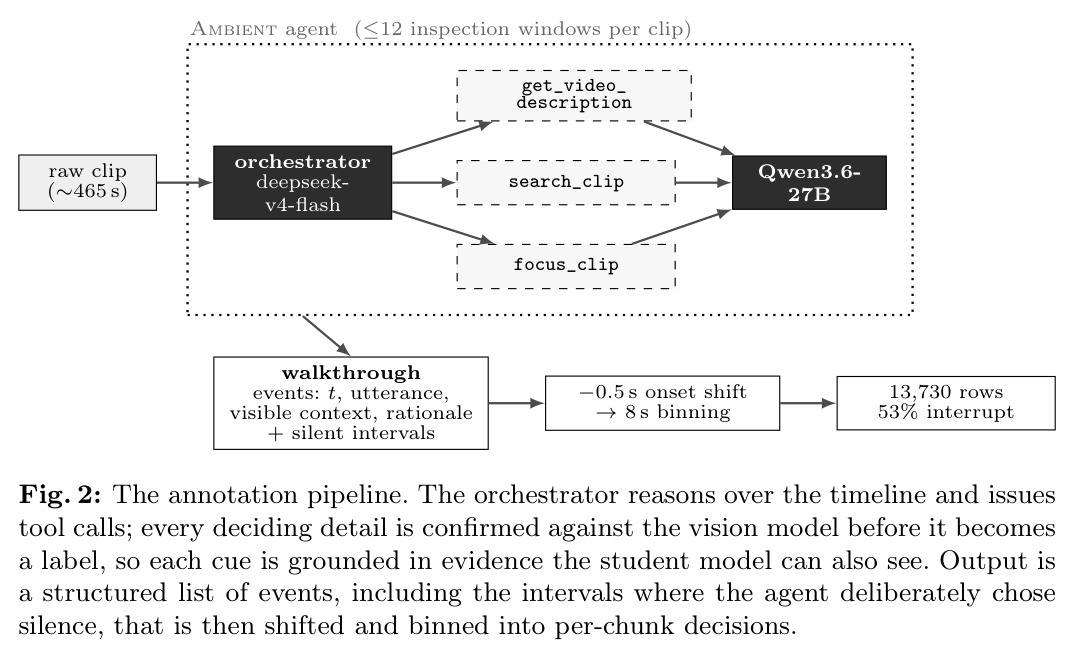
由一个 LLM 编排器(DeepSeek-V4-Flash)推理时间线并调用工具:全视频粗描述、窗口级问答与详述(由 Qwen3.6-27B 视觉模型执行),任何成为标签的细节都必须先经窗口级视觉确认,保证标签落在学生模型可见的证据上。
智能体管线是本文合成监督的核心,'视觉落地而非标注量决定迁移'的关键结论直接由它产出。
词表剪枝
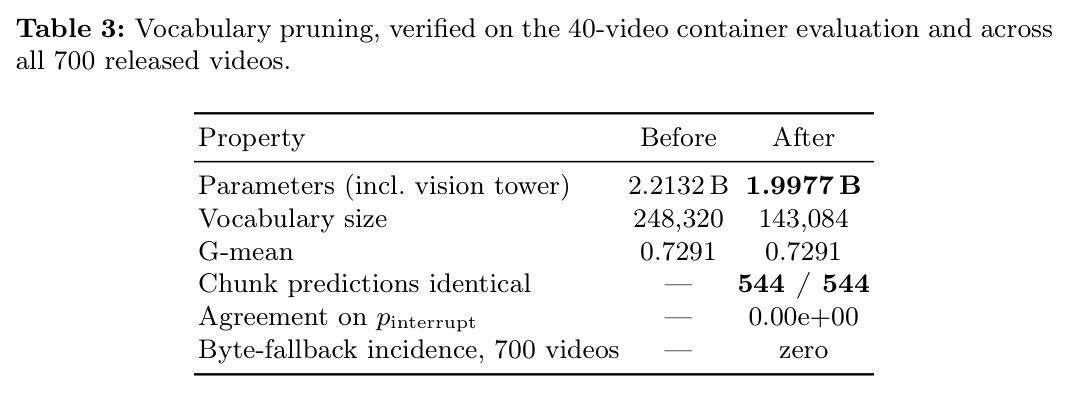
删除嵌入与输出层中不常用 token 以缩小模型。连续保留 token ID $[0,143000)$ 并显式追加视觉/视频/特殊 token,常用 token 保持原索引,被剪 token 可分解为 UTF-8 字节 token 兜底,因此可证明无损。
≤2B 分组的参赛资格全靠这一步:2.2132B 降到 1.9977B 且 544/544 chunk 预测完全一致。
研究动机
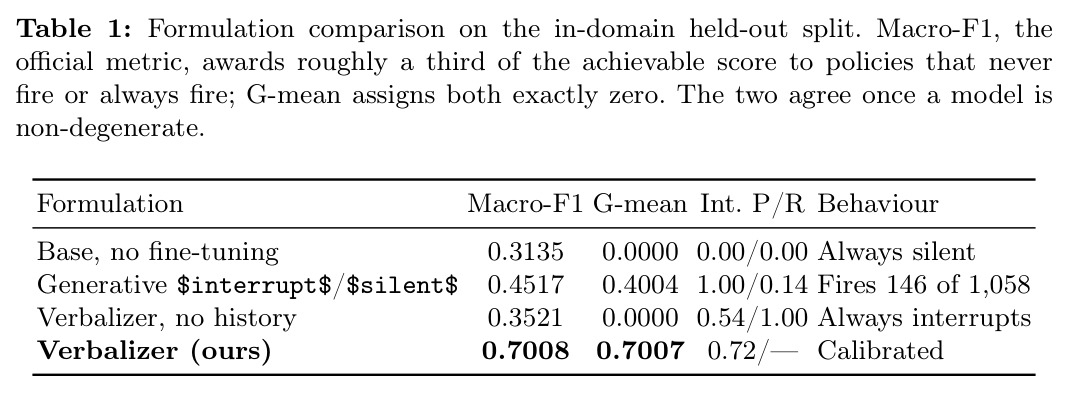
可穿戴主动助手要在用户执行程序性任务时实时决定何时开口指导、何时保持沉默,难点在于平衡两种失败模式:介入过频会打扰用户,该说时沉默则任务失败。EgoProactive 赛道(ECCV 2026 Wearable AI Challenge)将此形式化为:模型接收自我中心视频与用户开场提问,对每约 8 秒片段输出 $interrupt$ 加一句短话术或 $silent$,以两类的 macro-F1 评分。具体困难有三:其一,直接按自由生成目标微调时,二元决策的梯度信号被话术的每个 token 稀释,作者的第一版生成式模型 interrupt 精确率高达 1.00 但召回仅 0.14,1,058 个真正例只触发 146 次,macro-F1 仅 0.4517;其二,官方 macro-F1 对从不触发或始终触发的退化策略仍给出约三分之一的可得分数,无法惩罚极端行为;其三,带标签数据只有官方发布的 700 段验证视频(135 个任务、1,947 个决策点,54.3% 需介入),测试集保密,且域内评估还会误导模型选择。
本文的目标是本文目标是在两个参数分组(≤2B 与 2B+ 大规模组)内最大化隐藏测试集上的 macro-F1,并将其拆解为四个子问题。第一,把'是否介入'的二元时机决策从'说什么'的生成问题中解耦,得到可训练、可校准、可事后调阈的分类器。第二,在仅有 700 段验证视频可用标注的条件下,构造能真正迁移到未见 footage 的补充监督,而不是徒增域内拟合——这要求搞清楚合成标签的什么性质(数量、成本还是视觉落地程度)决定迁移效果。第三,建立一个在标注稀缺时不失效的测量协议:训练用掉部分验证集后,域内分数不再无偏,需要一个不与训练数据重叠的外部基准来对候选模型排序。第四,对 ≤2B 分组,在不损失任何精度的前提下把含视觉塔共 2.2132B 参数的 Qwen3.5-2B 压到 2B 以下,满足参赛硬约束。最终两个分组分别以 0.7179 与 0.6866 拿下第一和第二。
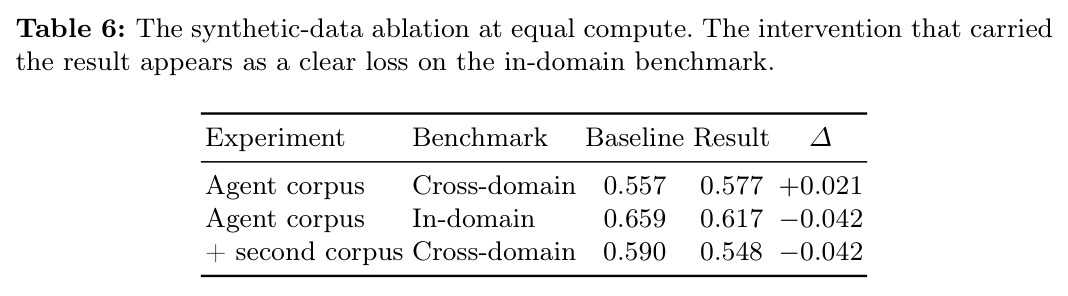
与已有工作不同的是,与把主动式助手当对话生成处理的已有工作不同,本文的切入点是'时机决策本身就是任务'。三个独特角度:其一,用单 token 分类改写介入决策——对 $[z_{no}, z_{yes}]$ 两个 logits 归一化取概率再阈值化,而非生成 $interrupt$ 或 $silent$ 字符串,这一改写带来 +0.249 macro-F1 与 +0.30 G-mean,且操作点 $\tau$ 训练后无需重训即可调节。其二,标注扩充不走'更大更便宜'的旁白路线,而是让工具调用式视频智能体先亲眼看视频再下标签,并设计严格对照实验证明'视觉落地而非标注量'决定迁移:旁白路线 4 倍规模、10 倍便宜,迁移反而只有 0.49,低于不相关真实语料 HoloAssist 的 0.59。其三,发现域内评估会反转模型排序——加入智能体语料使域内掉 0.042 但跨域涨 0.021——因此坚持在一个 140 段 HoloAssist 视频的跨域基准上选模型,这是对'只有一份标注集'这一竞赛现实条件的系统性回应。
核心方法
直觉上,这篇工作把一道生成题改造成分类题,再请一位'会看视频的老师'解决标注稀缺。技术路线两条主线。第一条是 verbalizer 改写:以 Qwen3.5-4B(大规模组)和 Qwen3.5-2B(≤2B 组)为骨干,用 LoRA rank 32、$\alpha=64$ 微调全部 7 个注意力与 MLP 投影,交叉熵损失只算在最后一个 assistant 回复的 yes/no token 与句末标记上,话术训练时丢弃、推理时模板化,因为指标不为话术打分;推理时计算 $p_{interrupt}=\mathrm{softmax}[z_{no},z_{yes}]_1$,由 $\hat{y}=\mathbb{1}[p_{interrupt}\geq\tau]$ 得出决策。每步输入为从视频开头累计的帧(下采样至不超过 32 帧、最长边 512px)、用户 query 与最近 4 轮对话(含模型此前的决策,回填历史以防反复介入)。第二条是智能体标注:DeepSeek-V4-Flash 编排器调用 Qwen3.6-27B 视觉模型,对每段视频最多做 12 个检查窗口探查,产出带时间戳与理由的事件表,经 −0.5 秒偏移与 8 秒分箱转成逐 chunk 标签,共 234 段视频、13,730 行。
核心创新有三层。第一层是单 token 分类:把'是否说话'与'说什么'解耦,梯度信号变成干净的二分类,操作点 $\tau$ 训练后可调,且每次决策只需一次前向传播而无解码循环,这对评测系统的每回合时间预算至关重要;实测比自由生成提升 0.249 macro-F1 与 0.30 G-mean(0.4517 升至 0.7008)。第二层是视觉落地的合成监督:智能体的每个标签都建立在其亲自用视觉工具确认过的证据上,学生模型(只能看到 0.83 fps 的稀疏帧)因此能从输入中'够到'每个标签;对照的旁白路线教师从丰富文本决策而学生看不见对应画面,学生只能学会猜——4 倍标注量、10 倍便宜也没换来更好的迁移。第三层是显式静默标注:强制智能体输出它刻意保持沉默的区间及理由,把'没有标签'变成'明确的不介入信号',与历史反馈一起杜绝全沉默/全介入的退化策略。配套的测量协议主张:发布集场景下用跨域基准而非域内分数选模型,因为域内评估已证明会反转排序。
方法步骤详情
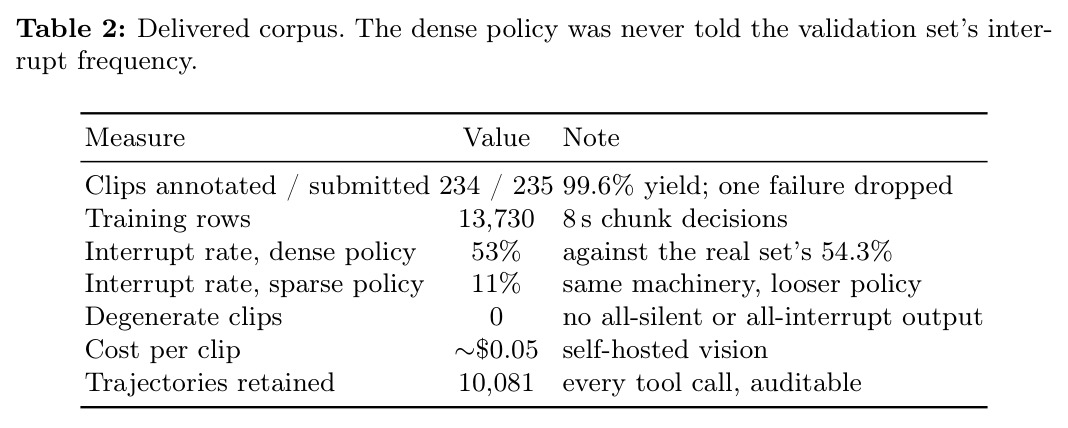
方法可拆为六步。第一步,输入构造:每个约 8 秒 chunk 决策一次,输入是从视频开头累计的帧(下采样至不超过 32 帧、最长边 512px)、用户 query 与最近 4 轮对话历史(含模型先前的 yes/no 决策,回填是防重复介入的关键)。第二步,verbalizer 训练:LoRA rank 32、$\alpha=64$、dropout 0.05,学习率 $1\times10^{-4}$ 余弦调度、warmup 0.03、batch 1 配 8 步梯度累积、bf16 加梯度检查点,训练混合为发布视频看两遍加全部智能体语料。第三步,智能体标注:编排器先用稀疏抽帧生成全视频粗描述,再用窗口级问答与详述工具(单窗不超过 5 分钟)确认细节,输出事件列表与显式静默区间。第四步,策略调优:在 6 段开发视频上迭代三版策略(覆盖准备动作、在动作起始放 cue、合并重复动作、每 8 秒至多一个 cue),另 6 段留出检验,±1 秒匹配容差带来约 0.05 G-mean。第五步,事件到标签:加 −0.5 秒偏移后按 8 秒分箱,产出 13,730 行、中断率 53%(未被告知真实值 54.3%)。第六步,词表剪枝:连续保留 token ID $[0,143000)$ 并追加视觉/特殊 token,词表 248,320 降至 143,084,参数 2.2132B 降至 1.9977B。
技术新颖性
新颖性体现在把多个'朴素但正确'的改写做到可验证的极致。verbalizer 并非新词,但本文给出严格对照(Table 1):生成式基线 0.4517 macro-F1,去历史的 verbalizer 0.3521(永远介入),完整方案 0.7008,证明解耦与历史反馈缺一不可;同时揭示 macro-F1 与 G-mean 在退化策略上的分歧(前者给约 1/3 分数,后者归零),据此改用 G-mean 内部选型。合成监督的新颖性在于'grounding 而非 volume'的可控对照:旁白路线 953 段、59,359 chunks、每段约 $0.005,智能体路线 234 段、13,730 行、每段约 $0.05,前者迁移 0.49 反而低于后者及不相关真实语料 HoloAssist 的 0.59,把'数据多就是好'的直觉证伪。词表剪枝选连续保留而非按频率挑选,看似无趣却可证明无损:常用 token 保持原索引,被剪 token 可分解为 UTF-8 字节 token,544/544 chunk 预测一致。此外,对标注策略本身做三版消融并用留出视频检验提示词过拟合,这种对合成数据来源的元评估在同类工作中少见。
实验结果
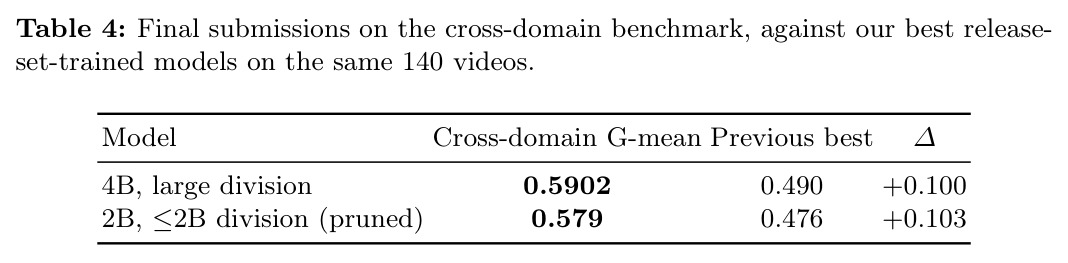
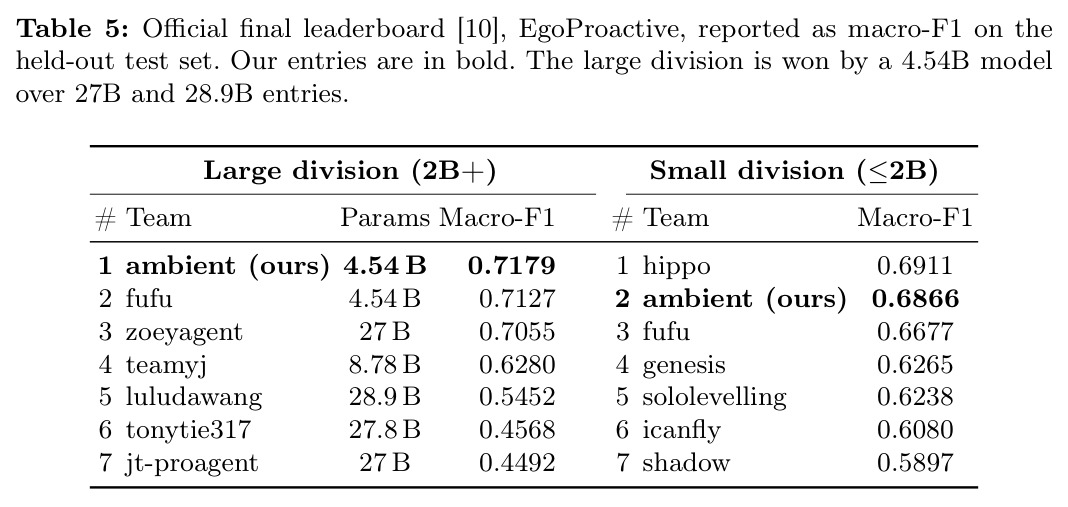
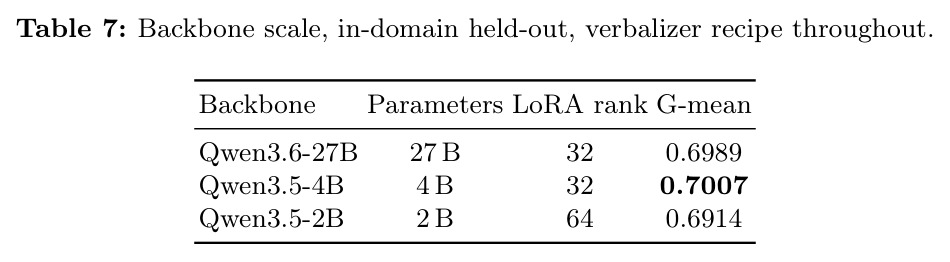
逐项看实验。其一(Table 1,域内留出集):verbalizer 方案 macro-F1 0.7008、G-mean 0.7007,较生成式表述的 0.4517/0.4004 提升 +0.249/+0.30;无微调基线仅 0.3135(全沉默),去历史的 verbalizer 0.3521(永远介入),说明历史反馈是防重复介入的关键。其二(Table 5,官方榜单):4.54B 模型以 0.7179 夺大规模组第一,压过 27B 的 0.7055 与 28.9B 的 0.5452;剪枝后 1.9977B 模型在 ≤2B 组以 0.6866 排第二,距冠军仅 0.0045。其三(Table 4):两模型在 140 段 HoloAssist 跨域基准上分别达 0.5902(较此前最佳 +0.100)与 0.579(+0.103)。其四(Table 6 消融):加入智能体语料使跨域 G-mean 从 0.557 升至 0.577(+0.021),域内从 0.659 降至 0.617(−0.042),增益集中在 interrupt 召回(+0.064 F1);再换入家庭/观光语料使跨域跌至 0.548。其五(Table 7):27B 仅 0.6989 低于 4B 的 0.7007,规模收益甚微。其六(Table 3):剪枝前后 G-mean 均为 0.7291,544/544 预测一致。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| EgoProactive 域内留出集(490 段视频)说话/沉默二分类 | macro-F1 / G-mean | 0.7008 / 0.7007(verbalizer 完整方案) | 生成式 $interrupt$/$silent$ 微调 0.4517 / 0.4004;无微调基线 0.3135 / 0.0000 | +0.249 macro-F1,+0.30 G-mean |
| EgoProactive 隐藏测试集·大规模组(2B+) | macro-F1 | 0.7179(第 1 名,4.54B) | 第 2 名 fufu 0.7127;最佳 27B 参赛者 0.7055;28.9B 仅 0.5452 | +0.0052(对第 2 名),超过 6 倍参数的 27B 模型 +0.0124 |
| EgoProactive 隐藏测试集·≤2B 组 | macro-F1 | 0.6866(第 2 名,剪枝后 1.9977B) | 冠军 hippo 0.6911 | −0.0045(惜败,验证了 2B 规模的可行性) |
| 跨域模型选择基准(140 段 HoloAssist 视频) | G-mean | 4B:0.5902;2B 剪枝版:0.579 | 各自此前最佳 0.490 / 0.476 | +0.100 / +0.103 |
| 智能体合成语料消融(等算力对照) | G-mean | 跨域 0.557 → 0.577;域内 0.659 → 0.617 | 不加智能体合成语料 | 跨域 +0.021(集中在 interrupt 召回 +0.064 F1),域内 −0.042 |
局限与改进
作者坦承的局限:最终提交模型在部分发布验证集上训练,全量域内评估不再无偏,只能依赖 140 段 HoloAssist 跨域基准选型,且两套指标(macro-F1 与 G-mean)不可直接比较;智能体语料使域内分数下降 0.042,这是用拟合换鲁棒性的交易,对隐藏测试集恰好正确但并非普适;±1 秒匹配容差带来约 0.05 G-mean,说明整个评测对时间对齐方式相当敏感。我的补充观察:其一,阈值 $\tau$ 的校准机制与选取流程论文未详述,而 verbalizer 的性能高度依赖 yes/no 概率的质量;其二,跨域基准全部来自 HoloAssist,与训练中用作对照的真实语料同源,'跨域'的定义偏窄;其三,8 秒分箱、−0.5 秒偏移、4 轮历史、32 帧上限等超参均无消融;其四,词表剪枝只在英语程序性叙述上验证,多语言输入下的字节退化率未知;其五,话术内容被完全模板化,而真实用户对'说什么'同样敏感,当前指标无法反映这部分体验。
独立分析的弱点
第一,固定阈值 $\tau$ 在分布漂移下可能失灵:跨域视频的光照、视角、任务类型不同,$p_{interrupt}$ 的分布会整体移动,改进方向是在少量目标域无标签数据上做阈值自适应或 conformal 校准。第二,旁白路线的失败被归因于弱视觉落地,但未尝试折中方案,例如让教师阅读旁白的同时查看对应时间戳的帧,或训练时对齐文本与画面,可能以 10 倍更低的成本挽救这条路线。第三,跨域基准只有 140 段视频且与 HoloAssist 训练语料同源,存在被间接过拟合的风险,应扩展到 Ego4D、Ego-Exo4D 等多源评测集——作者发现这些来源的合成数据对训练无益,但作为独立评测集仍有价值。第四,历史固定 4 轮、帧数固定 32 均未做敏感性分析,对更长任务或更低算力设备的适用性未知。第五,标注策略靠 6+6 段视频人工迭代三版,样本极小,策略鲁棒性证据薄弱,可改为在更多视频上自动搜索策略并交叉验证。第六,大规模组实际提交 4.54B 模型,但论文未解释其与 4B 实验模型的关系,复现最佳名次存在信息缺口。
未来方向
作者明确提出:未来会先建立跨域评估集再开始训练,并将其与域内结果并列使用,以区分'迁移变好'与'对发布数据过拟合'。在此基础上有几个可延伸方向:其一,把 $\tau$ 从全局常数升级为随任务状态(首次介入 vs 跟进提醒)或预测置信度动态调整的策略;其二,当前指标完全不评话术内容,可在介入决策正确的前提下加入话术质量评估(有帮助性、时机措辞、简洁度),形成多目标评测;其三,把智能体标注管线闭环化——用学生模型的失败 chunk 反向调度教师重新检查对应时间窗,做主动学习式标注,进一步压低每段约 $0.05 的成本;其四,验证规模结论的外推边界:27B 不敌 4B 的结论是否在数据量扩大 10 倍后反转,值得系统测试;其五,把 1.9977B 剪枝模型部署到真实眼镜端,评测 8 秒粒度在线流式推理的延迟与功耗,弥合离线评测与实时产品的差距。
复现评估
复现条件相当友好。作者公开了 GitHub 仓库(github.com/ambient-intelligence-hq/egoproactive-verbalizer2026)与 Hugging Face 上的模型和数据集集合;训练配方完整(LoRA rank 32、$\alpha=64$、dropout 0.05、学习率 $1\times10^{-4}$、batch 1 配 8 步梯度累积、bf16 加梯度检查点),配合 2B–4B 骨干,单张高端消费级 GPU 即可承载。数据侧,700 段发布验证视频由官方提供,智能体管线有完整描述(每段至多 12 个检查窗口、每段约 $0.05 自托管视觉成本),且保留 10,081 条可审计工具调用轨迹,利于核查标签质量。主要障碍:隐藏测试集不可得,官方名次无法复验,只能对照域内/跨域自建指标;DeepSeek-V4-Flash 与 Qwen3.6-27B 的具体版本及完整提示词是否公开需查仓库;标注策略仅有文字描述。总体难度中等:熟悉 LoRA 微调的工程师约一到两周可搭建管线,难点在标注策略迭代的质量而非算力。
论文图表