DataFlex-RL:RLVR 数据策略评估平台 DataFlex-RL: An Evaluation Platform for RLVR Data Policies
同一GRPO配方下,13种RLVR数据策略均无可复现增益
前置知识
RLVR(可验证奖励的强化学习)
用可自动判定的规则作为奖励信号来后训练语言模型,例如数学答案的 boxed 比对、Knights&Knaves 谜题的赋值检查、SciQ 选择题的字母精确匹配,替代人工偏好或奖励模型。奖励客观、无需训练验证器,但提示分布与验证器设计会直接影响训练分布的形状。
本文比较的所有数据策略都建立在 RLVR 训练循环之上,理解奖励如何产生、验证器如何工作,是理解各方法干预点的前提。
GRPO(组相对策略优化)
对同一提示采样 $K$ 条回答,用验证器打分,以组内平均奖励为基线构造相对优势,免去价值网络。本文固定 $K=5$、KL 系数 $10^{-3}$,标准损失作用于每个有效回答 token,这正是所有数据策略共享的外围配方。
GRPO 是全文锁定的训练配方,每个方法只在它的某个环节插入干预,不先理解 GRPO 流程就看不懂三个干预点的位置。
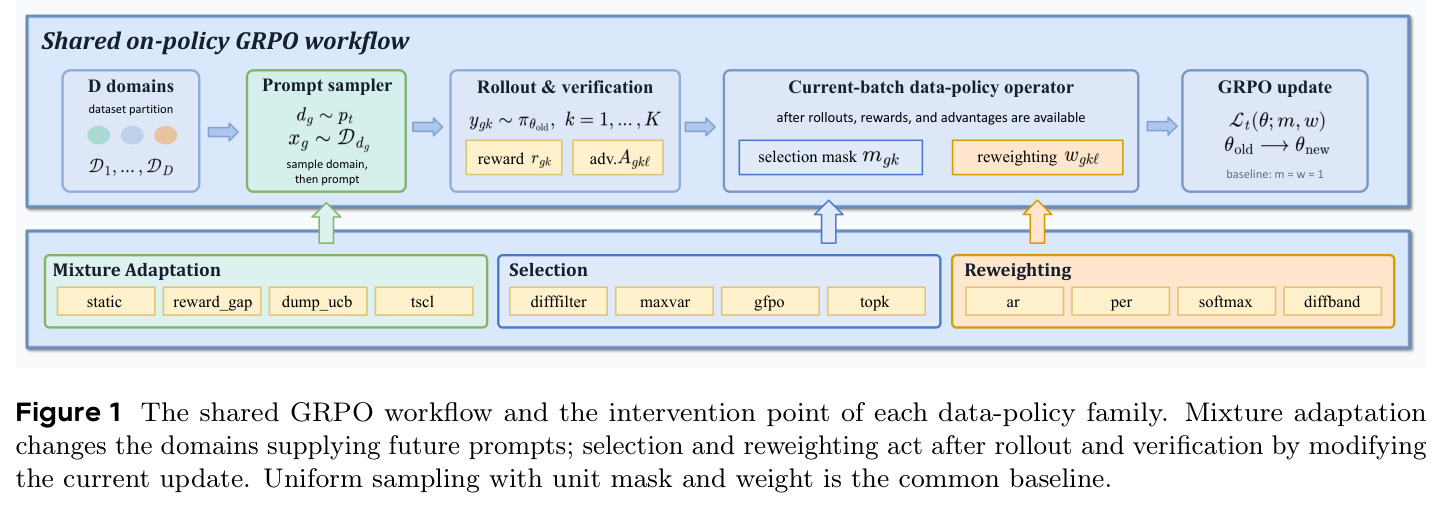
选择 / 重加权 / 混合适配三类干预
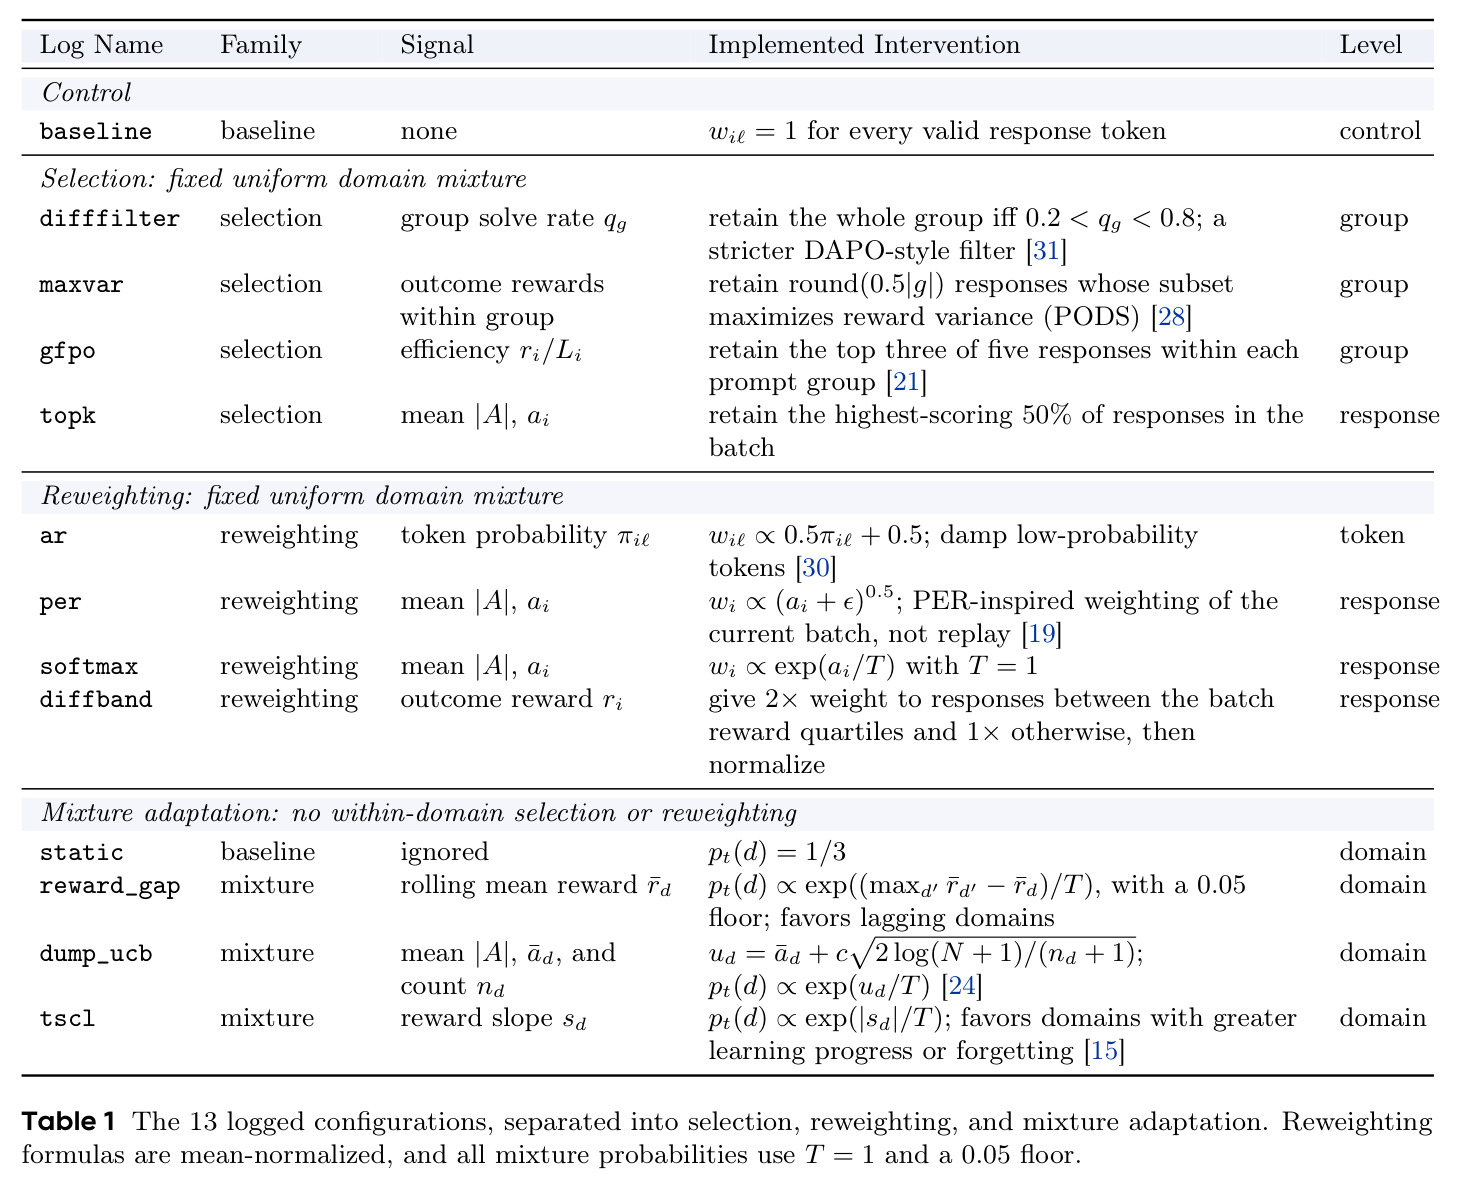
选择在 rollout 后用 0/1 掩码 $m_{gk}$ 决定哪些回答进入更新;重加权保留全部回答但改变损失权重 $w_{gk\ell}$;混合适配在下次采样前调整各领域提示分布 $p_t(d)$。均匀基线取 $m=w=1$、$p_t(d)=1/3$,这是全部对照的公共基线。
这是论文的核心分类法:把'方法改了什么'与'用什么信号'解耦,是理解实验设计与全部结论的钥匙。
配对 t 区间与统计显著性
对每个训练种子分别计算方法与基线在 12 基准 Overall 上的差值,再对 12 个种子的差值构造 95% 配对 t 区间;只有区间完全不含 0,才认为方法带来可复现的提升,否则视为与均匀采样无差异。
本文的主结论(所有配对区间都含零)完全依赖这种按种子配对的统计口径,不懂它就无法判断'无增益'的确切含义与边界。
基准汇总方式
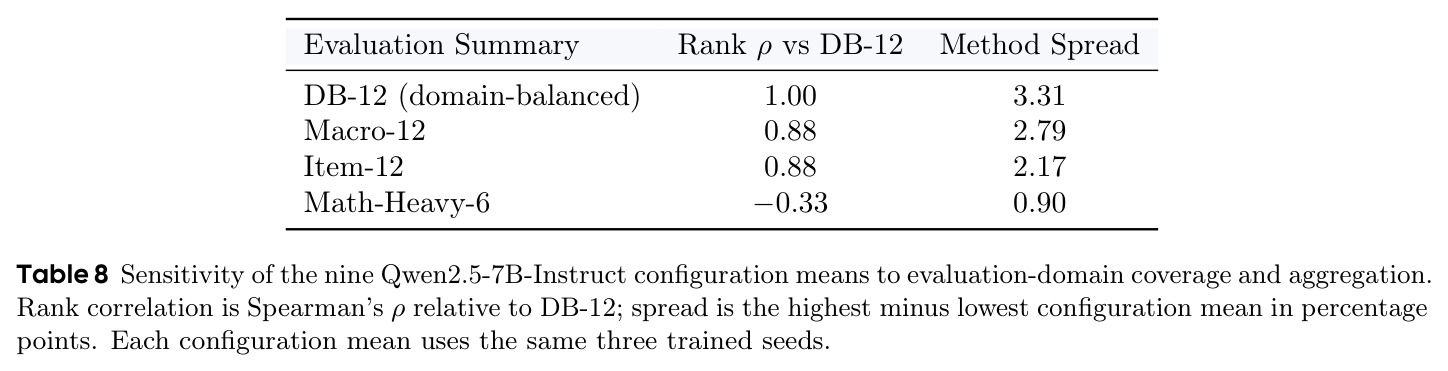
Overall 的计算方式:DB-12 先在数学/逻辑/科学三域内取平均、再对三域等权平均;Macro-12 对 12 个基准等权;Item-12 按评测集题量加权;Math-Heavy-6 只取 5 个数学基准加 GPQA-Diamond。不同汇总可能给出不同的方法排名。
评估敏感性是本文三大发现之一,只有理解汇总方式的差异,才能看懂 $\rho=-0.33$ 的负相关排名意味着什么。
研究动机
RLVR 后训练中涌现了一批'让训练聚焦于更有用数据'的策略:DAPO 用解出率过滤全对/全错的退化组,PODS 保留组内奖励方差最大的回答,GFPO 按每 token 奖励筛选,Advantage Reweighting 压低低概率 token 的权重,DUMP 与教师-学生课程则动态调整数学/逻辑/科学的采样比例。但这些方法往往作为整套 RLVR 配方的一个组件发表,同时改动了基座模型、提示模板、验证器、rollout 预算与优化设置,报告的增益无法区分究竟来自数据信号、干预方式还是外围训练栈。在线评估又叠加两重困难:提示的分数随策略学习而漂移,数据效用信号既噪声大又内生;训练种子间波动与小基准上的测量噪声可以与报告的方法差距相当甚至更大。评估汇总本身还是个自由度——省略一个领域就可能改变'最优方法'。
本文的目标是本文要回答一个被社区默认却从未被严格检验的问题:当外围 GRPO 配方完全固定时,现有 RLVR 数据策略相对均匀采样是否仍提供可复现的增益?为此作者构建 DataFlex-RL 评估平台:用同一条共享驱动程序完成 rollout、验证与 GRPO 优化,所有方法只在统一的三个干预点上注册;训练语料、验证器、优化器、rollout 预算与评估协议全部锁定;从训练到最终评估保持匹配种子;并以 12 个数学/逻辑/科学基准的域平衡 Overall 作为统一分数。实验矩阵共 591 次运行,其中主实验块在 Qwen2.5-7B-base 上以 12 个匹配种子完整对比 13 种配置,并在 Llama-3.1-8B-base、多个 Qwen 基座尺寸与替代基准汇总上做稳健性检查。
与已有工作不同的是,独特之处在于把 DataFlex 在监督 LLM 训练中的'选择–重加权–混合'抽象移植到在线 RL:先区分方法'改变了什么'(干预家族)与'依据什么改变'(信号,如组解出率 $q_g$、平均绝对优势 $a_{gk}$、token 概率 $\pi_{gk\ell}$、效率 $r_{gk}/L_{gk}$),再用同一信号构造不同干预做受控对照。例如 per、softmax、topk 都用 $a_{gk}$ 排序回答,前两者转成连续权重、topk 做硬选择,直接回答'同一信号用于重加权还是选择更有效'。配合 15000 条统一提示语料、固定的 verl+GRPO 训练、领域专属评估器与训练-评估对齐的校准冒烟测试,平台让未来新策略无需重建流水线即可在同协议下比较,这正是此前文献做不到的公平性。
核心方法
整体思路是'一条流水线,三个干预点'。基线训练步:从数学/逻辑/科学三域等比采样提示,每条提示生成 $K=5$ 条回答,验证奖励后对所有有效 token 应用标准 GRPO 损失。选择在 rollout 之后用掩码把部分回答的损失置零:$\mathcal{L}_{sel}=\frac{1}{GK}\sum_{g,k}\sum_\ell m_{gk}\,\ell^{GRPO}_{gk\ell}$, difffilter/maxvar/gfpo/topk 属此类;重加权保留全部回答但引入均值归一的权重 $w_{gk\ell}$,即把上式中的 $m_{gk}$ 换成 $w_{gk\ell}$,ar/per/softmax/diffband 属此类;混合适配在下一批 rollout 前调整域分布 $p_t(d)$,如 $p_t(d)\propto\exp((\max_{d'}\bar r_{d'}-\bar r_d)/T)$, static/reward_gap/dump_ucb/tscl 属此类。均匀基线取 $m=w=1$、$p_t(d)=1/3$。
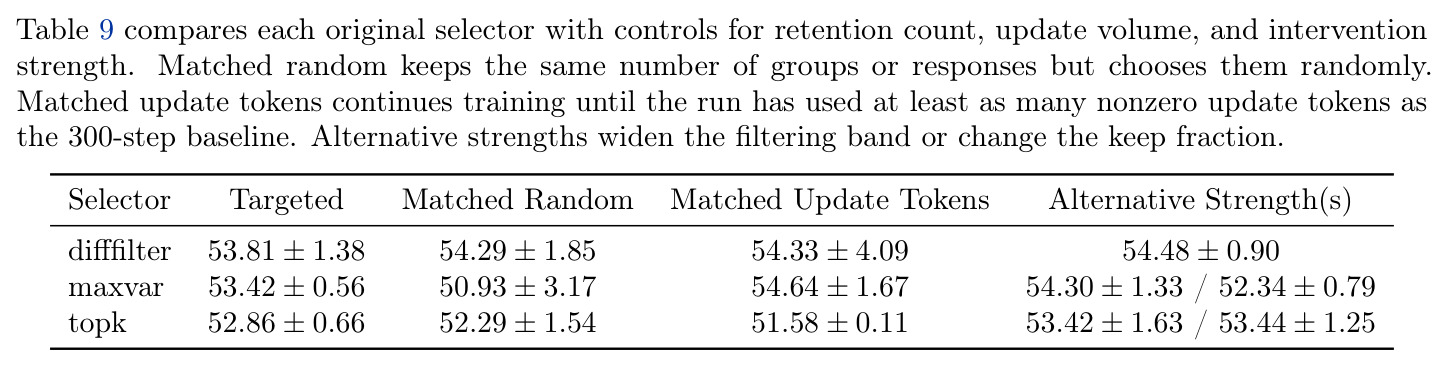
核心创新是把数据策略分解为'干预点 × 信号'的二维空间,并用共享栈与匹配种子把信号效应与干预效应分离。以往 DAPO、PODS、GFPO、Advantage Reweighting 等各自把信号与干预方式绑死在一起发布,增益无法归因;本文用一张表显式登记每个配置的家族、信号与算子。平台还澄清了算力语义:选择不做重归一化、可能减少参与更新的 token 数;重加权保持平均权重为 1;混合适配完全不改动单次更新、只改变未来提示来源——同一名义方法实际消费的优化 token 数不同,这本身就是混淆源,必须显式控制。附录的对照(匹配随机保留、匹配更新 token 数、替代过滤强度)进一步检验增益是否来自定向信号本身,结果显示三个选择器对三种对照的反应方向不一致。
方法步骤详情
步骤如下:(1) 语料构建:15000 条提示,数学(math_dapo+DeepScaler+GSM8K,boxed 答案验证)、逻辑(程序生成 Knights&Knaves 谜题+赋值检查)、科学(SciQ 选择题+字母精确匹配)各占 1/3,并审计与 12 基准无重合(无精确/归一化匹配,13-gram Jaccard 相似度不超过 0.5)。(2) 每次 campaign 前跑校准冒烟测试,在参考 checkpoint 上检查 boxed 与选择题解析的训练-评估对齐。(3) 训练:verl v0.5+,GRPO,每提示 5 条 rollout,KL 系数 $10^{-3}$,提示/回答上限 1024/8192 token,300 优化步、每 100 步存档,主矩阵用种子 1–12,breadth 网格用种子 1–3。(4) 评估:12 基准确定性解码,数学与 GPQA 允许 8192 输出 token,逻辑与 MMLU-Pro 用 4096。(5) 统计:Overall 先域内平均再三域等权,方法与基线按种子配对构造 95% t 区间。
技术新颖性
技术新颖性不在提出新算法,而在建成第一个对 RLVR 数据策略的受控比较平台:591 次运行的全矩阵(171 次 breadth 网格、108 次把三组对比从 3 扩到 12 种子、33 次机制与强度对照、108 次补全 Qwen-base 主矩阵、171 次规模与家族扫描)全部公开运行级记录。三项贡献中最扎实的是:(a) 13 配置 × 12 种子的完整对比给出'无可复现增益'的负结果及其置信区间;(b) 首次量化评估汇总敏感性——Math-Heavy-6 与 DB-12 的方法排名负相关 $\rho=-0.33$;(c) 训练-评估对齐校准流程发现了先前 Llama 评估把不支持的数学任务静默记 0 分、导致虚高 14–16 分的 bug,说明平台化审计本身就能修正文献中的错误结论。
实验结果
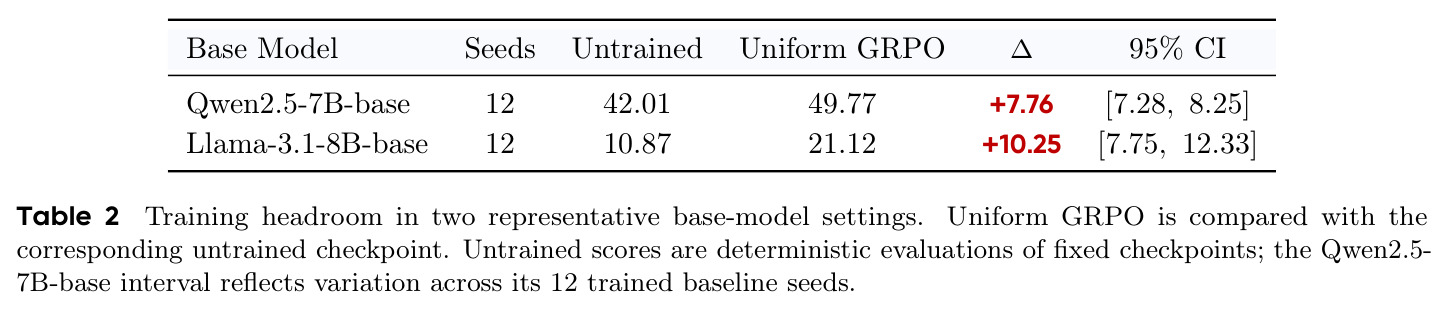
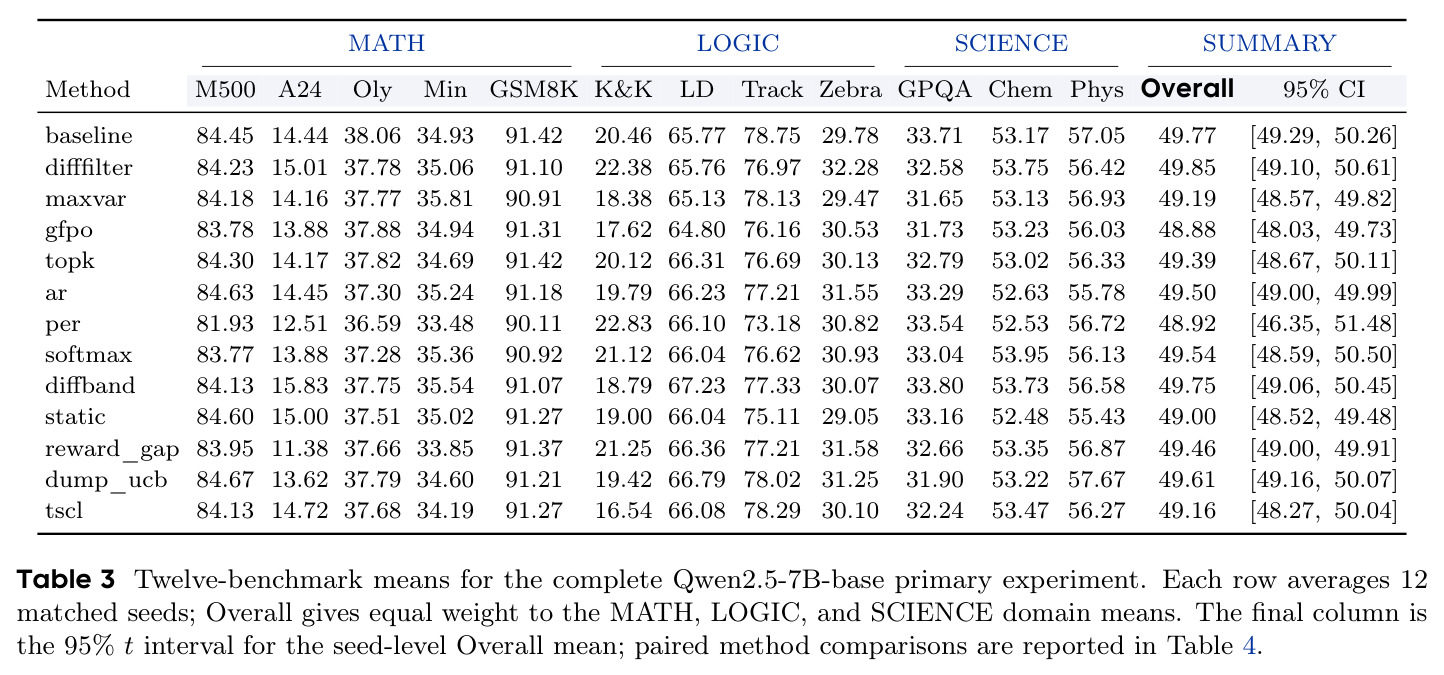
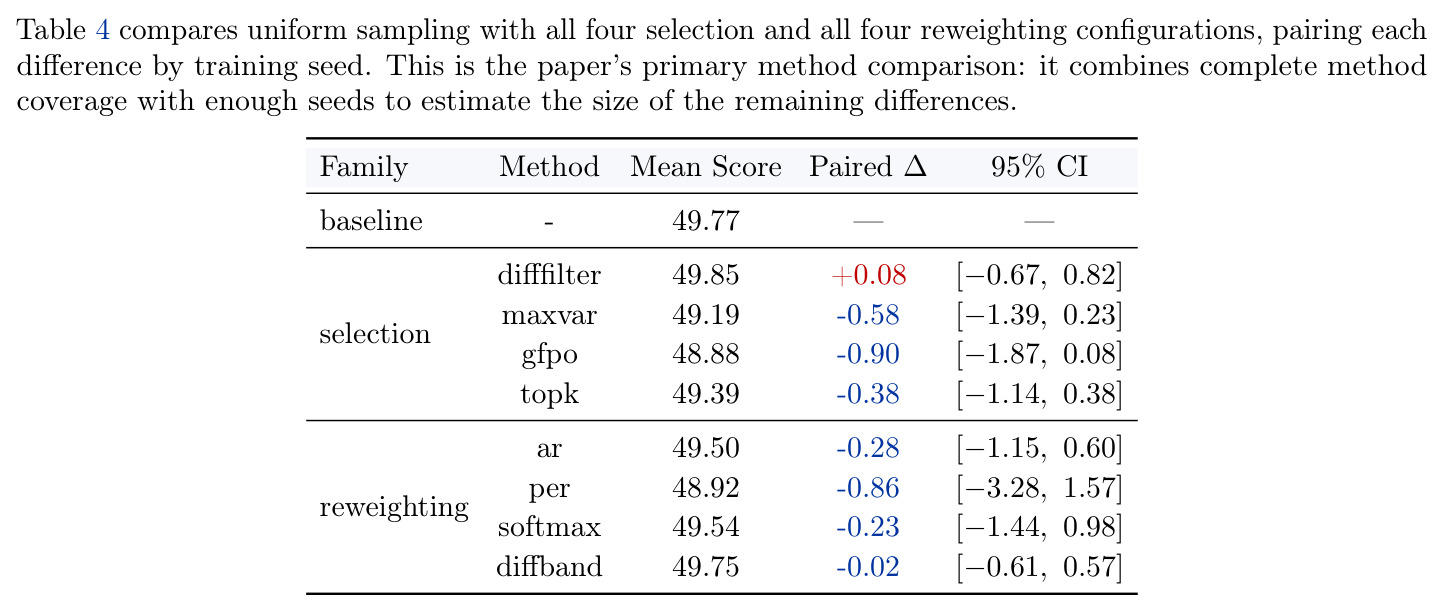
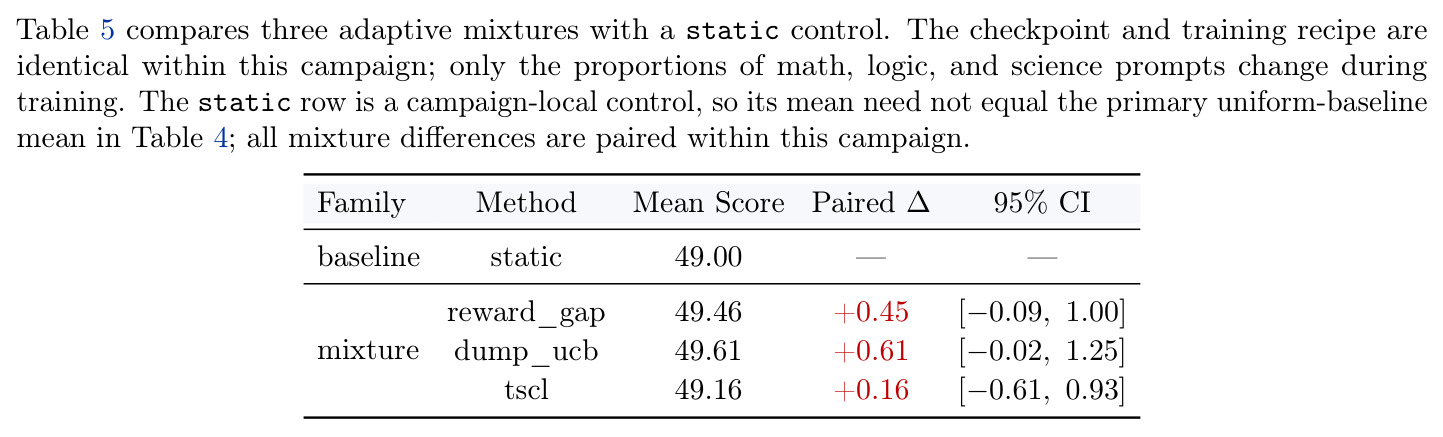
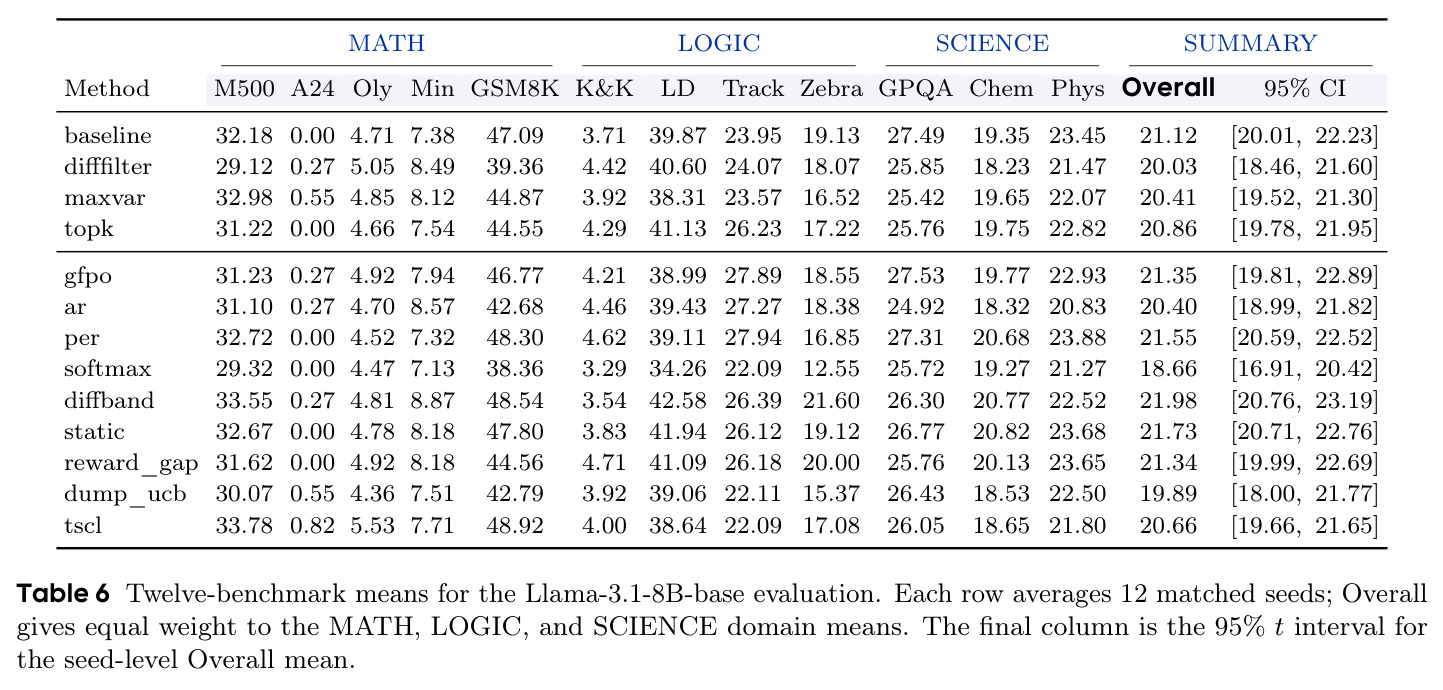
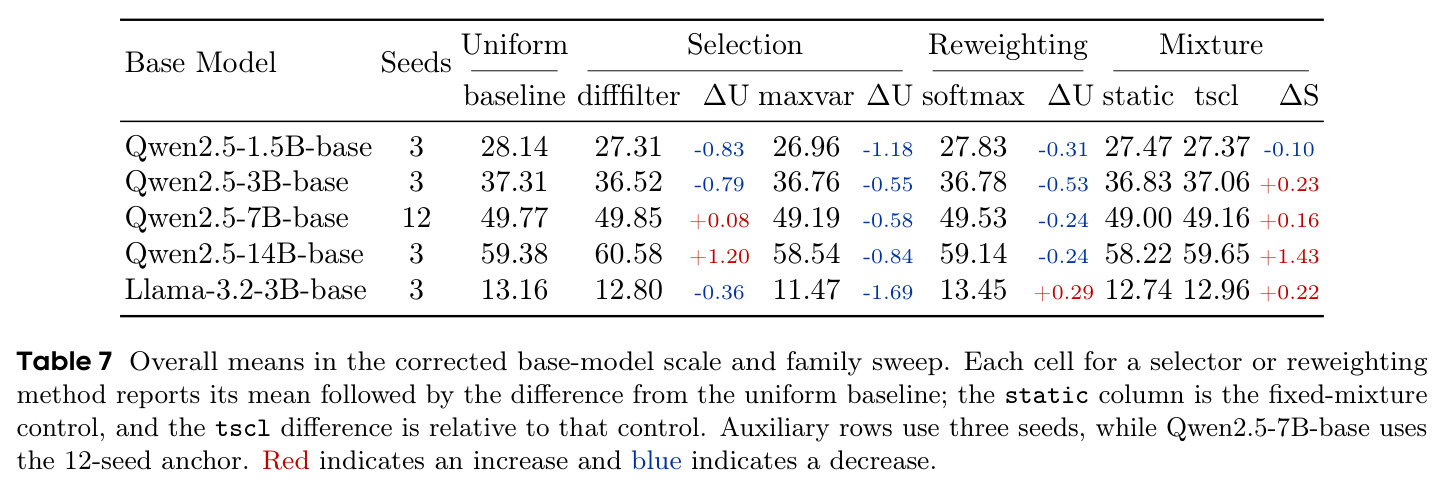
五大发现:(1) Qwen2.5-7B-base 主实验中,均匀 GRPO 把 Overall 从 42.01 提到 49.77(+7.76,CI [7.28, 8.25]);八个选择/重加权方法的配对差值区间全部含零(gfpo −0.90 至 difffilter +0.08),均值跨度仅 0.97 分。(2) 三个自适应混合点估计为正但不显著:reward_gap +0.45、dump_ucb +0.61、tscl +0.16,跨度 0.61 分。(3) Llama-3.1-8B-base 上 GRPO 增益 +10.25 [7.75, 12.33],三个选择器配对差 −1.09/−0.71/−0.26 均含零,九个扩展方法 18.66–21.98 无公认赢家。(4) 1.5B/3B/7B/14B 与 Llama-3.2-3B 扫描中差值符号随模型翻转,无单调优势。(5)Math-Heavy-6 与 DB-12 排名 $\rho=-0.33$、跨度 0.90 vs 3.31;保留 12 基准的 Macro-12/Item-12 相关 ρ=0.88,留一相关 0.78–0.98。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen2.5-7B-base:均匀 GRPO 训练(12 种子) | Overall(12 基准域平衡均值) | 49.77 | 未训练 checkpoint 42.01 | +7.76(95% CI [7.28, 8.25]) |
| Qwen2.5-7B-base:8 个选择/重加权方法 vs 均匀采样 | 配对 Δ Overall | −0.90 至 +0.08,区间均含零 | 均匀 GRPO 49.77 | 无可复现提升 |
| Qwen2.5-7B-base:3 个自适应混合 vs 固定等比 | 配对 Δ Overall | +0.16 至 +0.61,区间均含零 | static 等比混合 49.00 | 无可复现提升 |
| Llama-3.1-8B-base:均匀 GRPO(12 种子) | Overall | 21.12 | 未训练 10.87 | +10.25(95% CI [7.75, 12.33]) |
| 评估汇总敏感性(9 配置,Qwen2.5-7B-Instruct) | Spearman ρ(相对 DB-12)与方法跨度 | Math-Heavy-6:ρ=−0.33,跨度 0.90 | DB-12:ρ=1.00,跨度 3.31 | 省略逻辑域可翻转冠军方法 |
局限与改进
作者明确承认结论是有边界的:仅在 300 优化步、5 rollouts、15k 提示语料与所测模型家族内成立,不排除更长训练、其他超参或其他策略家族下出现增益,也不能证明方法彼此等价。我自己的观察:(1) 辅助规模行(1.5B/3B/14B、Llama-3.2-3B)只有 3 个种子,±1 分量级的差值很可能是噪声,作者也只敢描述方向;(2) 每提示仅 5 条 rollout 使优势信号非常粗糙,$K$ 更大时基于方差/优势的选择方法可能更有用;(3) per 的区间宽达 [−3.28, 1.57],部分方法方差本身过大,12 种子对它们可能仍不够;(4) 评估敏感性分析用的是 Qwen2.5-7B-Instruct 的 9 配置而非 base 主矩阵,外推到 base 训练只是间接证据;(5) 逻辑域几乎全部依赖程序生成的 Knights&Knaves 谜题,域内多样性有限。
独立分析的弱点
独立弱点分析:(1) 训练预算仅 300 步,课程类方法(tscl、reward_gap)通常要到训练后期才显现收益,短窗口可能系统性低估混合适配,应加中期检查点评估;(2) Overall 的三域等权是一种人为立场,虽然作者证明了保留全部 12 基准时各种汇总高度一致(ρ=0.88),但'域平衡'与真实应用的目标分布未必一致;(3) 等 rollout 预算比较对选择方法并不完全公平——它们实际减少了参与更新的 token 数,而附录中'匹配更新 token'对照只有 3 种子,说服力弱;(4) 语料难度分布固定,没有覆盖'提示难度自适应'类方法(按解出率动态调整难度),而这恰是当前社区热点;(5) 各方法超参固定(T=1、0.05 下限、topk 保留 50% 等),未做逐方法调参,可能低估各方法最佳版本的表现。改进方向:长训练+过程评估、按方法调参后再比较、更大 $K$、引入难度课程与主动提示选择。
未来方向
作者提出的方向:平台可直接接入新策略,在同协议下比较而无需重建流水线;扩展到更长训练、更多模型家族与更大规模。基于成果可延伸:(1) 把'匹配种子+配对区间'的统计协议推广为 RLVR 论文的标准评审要求,遏制单种子刷点;(2) 研究'信号在什么条件下才有效'——例如优势信号在训练早期与晚期的信息量变化,去噪后的信号(EMA、贝叶斯平滑)能否产生可复现增益;(3) 把评估敏感性分析推广为基准套件设计准则,自动检测会翻转排名的省略域;(4) 结合 gfpo 式效率指标(正确答案数/千字符从 0.461 提到 0.482、平均回答长度 1568→1497 字符)研究算力-精度权衡而非只看最终精度;(5) 探索难度课程与主动学习式提示选择,这是本文固定语料设计未覆盖的空间。
复现评估
复现条件良好:代码、原始运行记录与表格重建脚本均在 GitHub(github.com/haolpku/DataFlex-RL,results 目录含原始数字,另有代码文档站)。591 次运行的配置、训练日志与 12 基准分数全部关联公开,训练-评估对齐审计输出随工件发布,Llama 早期评估 bug 的修正过程也有记录。但算力门槛很高:主矩阵 13 配置 × 12 种子 × 300 步的 7B GRPO 训练,加上 591 次运行的 12 基准确定性评估,估计需要数十张 A100/H100 级 GPU 周至月级的预算,一般实验室难以整体复现;务实路径是复用平台跑少量配置,或只采用其评估协议与统计脚本。表格与区间的重建是纯 CPU 工作,直接消费运行级记录,容易独立验证。
论文图表