Srijika:复用 OpenType 布局的字体改样式系统,覆盖九种印度文字 Srijika: OpenType-Layout-Reusing Font Restyling for Nine Indic Scripts
复用模板字体OpenType布局,用扩散模型逐字形改样式,产出九种印度文字的可安装TTF
前置知识
OpenType 整形契约(cmap/GSUB/GPOS)
OpenType 字体不只是字形轮廓的集合:cmap 把码点映射到字形,GSUB 定义替换查找(连字 conjunct、半形式 half form、matra 变体等),GPOS 定义定位(锚点附着、字对调整)。文本渲染时整形引擎沿这些查找表把码点序列展开成字形 ID 序列并定位,因此一个"可用"的印度文字字体必须让整条替换闭包存在且一致——作者称之为与整形引擎的契约。
本文的核心主张是"布局复用而非布局学习":模板的 cmap/GSUB 原样保留、GPOS 按度量策略复用,输出在构造上就是合法字体。不理解这三张表,就无法理解为什么生成字形图像不等于生成字体,也无法理解验证与审计的意义。
潜在扩散模型与参考条件化
潜在扩散模型(LDM)在压缩的潜在空间上迭代去噪生成图像,训练目标是去噪得分;条件信息可通过通道拼接(如本文把模板字形栅格作为 conv_in 的内容通道)或 cross-attention(如本文把6张参考 tile 的池化风格嵌入注入)引入。本文生成器是 134M 参数的 UNet(132.9M UNet + 1.2M 风格投影),在 128×128 字形 tile 上做逐字形重绘。
论文的生成组件就是一个参考条件化的 LDM:内容来自模板字形、风格来自捐赠字体参考 tile。理解内容/风格两条条件通路,才能看懂后续六个负结果杠杆(骨架通道、多尺度 adapter 等)都在攻击哪条通路。
无分类器引导(Classifier-Free Guidance)
训练时以一定概率丢弃条件 token,使同一模型既能学习条件分布又能学习无条件分布;采样时用 $\epsilon = \epsilon_u + s(\epsilon_c - \epsilon_u)$ 外推条件方向,引导强度 $s$ 控制条件遵从度。本文采样用引导尺度 3–4.5、50 步,内容门的重试阶梯会沿引导阶梯升高或降低 $s$ 重试失败字形。
引导尺度是流水线里"重试阶梯"的旋钮:权重协调阶段对偏细字形升高引导、偏粗字形降低引导。不懂 CFG 就无法理解 serving 流水线如何在不重训模型的情况下修复缺陷字形。
CLIP-LoRA 检索
CLIP 是对齐图文的对比学习双塔;LoRA 在冻结权重旁注入低秩可训练矩阵做参数高效微调。本文 Lipika 用 CLIP-L 文/图塔并对图像塔做 LoRA 微调,在渲染的印度文字样本上以融合属性监督训练(foundry 元数据、EDT 实测笔画对比度、两轮 VLM 48属性标注),为约650个开源家族的每对(家族,脚本)建一个 L2 归一化嵌入索引。
开放词表风格控制完全委托给检索:prompt(如"warm rounded friendly")经 Lipika 检索出具体捐赠字体,取6张参考 tile 供扩散模型条件化。风格度量(gap closure)也复用其识别器骨干的嵌入,理解这点才能看懂论文对 same-model 度量的自我批判。
SSIM 与零样本门控
SSIM(结构相似性)从亮度、对比度、结构三方面比较两张图,取值 $[-1,1]$,越接近1越相似。本文每个脚本保留整个字体家族(绝不按字重拆分)作 held-out 测试集,模型用6张参考 tile 改样式模板字形,在被评分目标之外的单元清单上以 guidance 3 计算生成 tile 与真值 tile 的 SSIM,作为零样本门控分数。
零样本门控是贯穿全文的主指标(Table 2/3 的分数、script bars 回归机制、Modak 规则的 0.6541 vs 0.7622 对照都基于它),同时论文的重要发现之一恰是 SSIM 惩罚风格移动——模板拷贝在 50/56 个 face 上得分更高。
HarfBuzz 与 CoreText 整形引擎
HarfBuzz 是 Linux/Android/Chrome 使用的开源文本整形库,CoreText 是 Apple 的文本引擎:两者都执行 OpenType GSUB/GSUB 闭包展开,把 Unicode 串变成定位好的字形 ID 序列。若两个引擎对同一输入在两个字体上给出相同的 glyph-ID 序列,说明布局逻辑一致。
本文用双引擎交叉验证布局继承:66 个 TTF 在连字与 matra 密集探针串上,HarfBuzz 与 CoreText 给出的 glyph-ID 序列都与模板完全一致、无系统字体回退。这是"输出即字体"主张的核心证据,也是整形簇验证修复阶段的基础设施。
研究动机
超过8亿人使用婆罗米文字(仅印度2011年普查就有超十亿母语人口),但其排版生态只有拉丁文的一个零头:Google Fonts 托管1800多个拉丁家族,而 Odia 文字总共只有6个家族。差距是结构性的——一个可用的印度文字字体不是绘图练习,而是与整形引擎的契约:成百上千个连 conjunct、半形式、matra 变体必须通过 OpenType 替换全部存在且相互一致,闭包规模跨一个数量级(Mukta Mahee 的 Gurmukhi 闭包仅210个字形,Baloo Da 2 的 Bengali 闭包达1264个),每换一个新设计成本都要乘上这个系数。主流生成式方法的范式是"生成字形图像",但这到不了任何人能用的产物——一张字形的图不是字体。同时数据稀缺且有体裁偏斜:作者可汇集的开源语料约650个家族,每脚本家族数从 Devanagari 的250个跌到 Odia 的7个,而用户最想要的装饰/展示体裁在小型文字中几乎不存在。
本文的目标是给定一句自然语言风格描述(如"warm rounded friendly"),为九种婆罗米文字(Devanagari、Tamil、Bengali、Telugu、Kannada、Malayalam、Gujarati、Gurmukhi、Odia)各生成一个可直接安装的 OpenType 字体(TTF),要求输出在构造上就是合法字体:保留模板字体的字符映射与替换闭包,通过 OpenType Sanitizer 校验,且 HarfBuzz 与 CoreText 给出与模板一致的 glyph-ID 序列。系统最终交付66个字体(57个预设+9个开放词表 showcase),并配套检索式语言-字体接地(Lipika)、四级缺陷容忍验证流水线、覆盖全部80,915个字形与54,812个锚点的度量审计、冻结的双层基准,以及诚实的评测协议与负结果目录。
与已有工作不同的是,作者的核心反直觉决策是"永不从头生成字体":与其让模型学习布局逻辑,不如对专业工程化、整形完备的开源模板字体逐字形"改样式"——模板的 cmap 与 GSUB 原样复用,GPOS 在文档化的度量策略下复用,学习组件(134M 潜在扩散 UNet)只承担扩散模型擅长的局部视觉重绘,布局复用使改样式质量与布局逻辑解耦。风格不靠文本直接条件化生成,而由 Lipika 检索索引落地到约650个开源家族中的具体捐赠字体,保证风格必然可实现(它作为字体存在)且许可可审计。此外论文罕见地用约三分之一 GPU 预算换取负结果目录:六个失败的调节杠杆、目标函数污染的法证研究和数据边界分析,希望为同行省下相同的算力。
核心方法
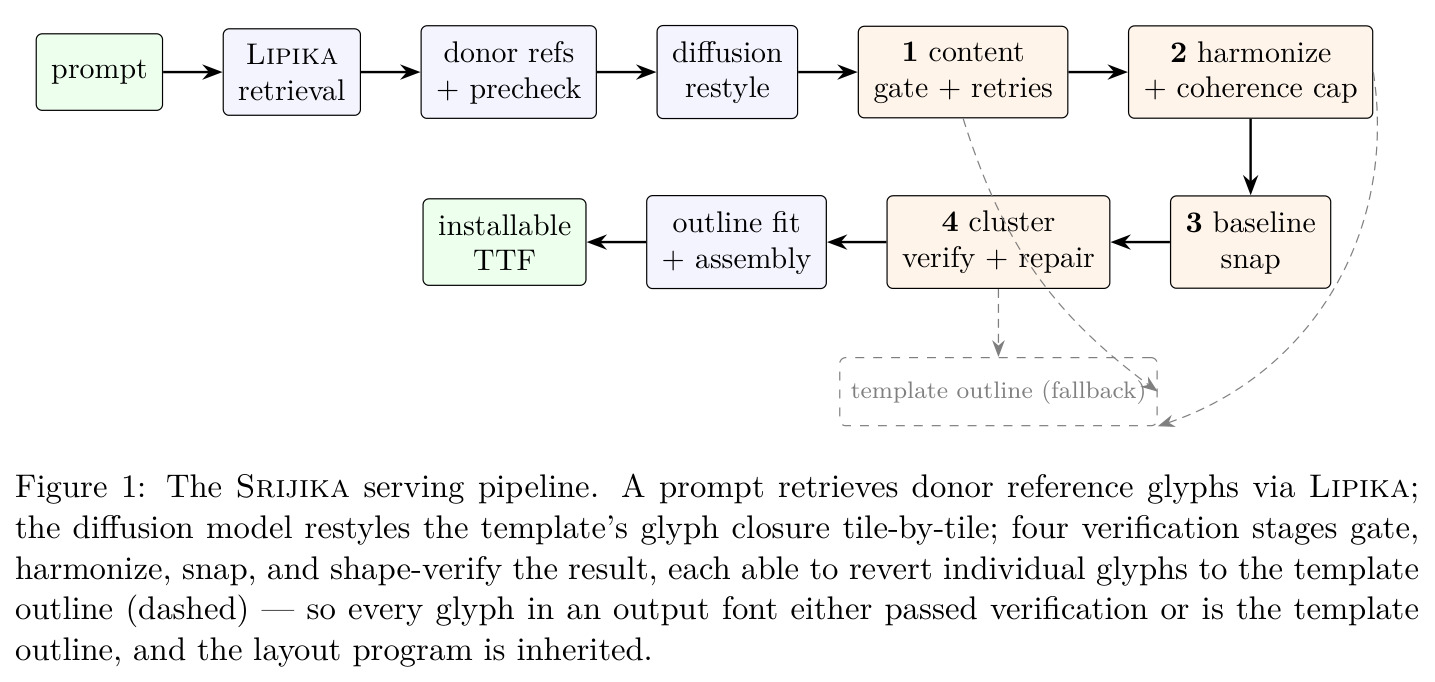
直觉是把开放式字体工程问题分解为"布局继承 + 逐字形图像翻译",并以"失败字形回退模板轮廓"作结构性保底。流程:自然语言 prompt 先经 Lipika 检索(对每对家族-脚本的 CLIP-LoRA 嵌入建 L2 归一化索引,语料约650个开源家族)选出捐赠字体,取其6张参考 tile;134M 参数的参考条件潜在扩散 UNet(132.9M UNet + 1.2M 风格投影)以模板字形栅格为 conv_in 内容通道,风格经冻结的 Lipika 识别器骨干池化嵌入的 cross-attention 注入,在 128×128 tile 上重绘(CFG 引导 3–4.5、50 步);生成 tile 依次通过内容门+重试阶梯、权重协调与一致性上限、基线吸附、整形簇验证修复四级关卡,任一关卡失败即回退模板轮廓;描摹回模板 glyf 表时执行度量策略(advance 只加不减、锚点随轮廓平移),最后 OFL 合规重命名并暴露 weight/counter/em-fill 三个参数化后轴。训练侧用 pair packs 与 warm-start graft(每脚本 20–48k 步)。
布局复用而非布局学习。模板字体的 cmap 与 GSUB 替换闭包原封不动,因此整形引擎对输出字体做出的字形选择决策与模板完全相同——这不是假设而是被验证的事实:66 个 TTF 在连字密集探针上经 HarfBuzz 与 CoreText 双引擎确认 glyph-ID 序列一致、无系统字体回退。每个输出字形要么通过验证,要么就是模板轮廓,构成结构性保底。这与 FUNIT、MX-Font、FontDiffuser、VecFontSDF、VecFusion 等先行工作的本质区别在于交付物:那些方法输出孤立栅格或矢量字形、把字体组装和印度文字最难的整形问题留在范围之外;Srijika 的交付物是可安装字体,连字、半形式、matra 变体等闭包问题被完全委派给模板字体已有的专业工程,生成失败的单个字形只损失视觉风格而不破坏字体合法性。
方法步骤详情
①模板选择:按闭包与 GSUB 完整性审计(Meera 1153、Baloo Da 2 1264 等)。②Lipika 检索:CLIP-L+LoRA 图像塔,融合属性监督训练(Spearman 0.50),prompt 检索出捐赠字体,出6张参考 tile。③扩散重绘:条件生成 $f_\theta(g_i, R)$ 逐字形产 tile。④内容门+重试阶梯:检索式批评家查字形身份,失败沿引导阶梯重试,不可恢复者回退模板。⑤权重协调:MAD 缩放 log ink-ratio 检测离群字重,方向感知重试,超车队中位1.35×回退;超25%被标记则判为风格本身并退位。⑥基线吸附:行剖面互相关消除抖动。⑦描摹回填:advance 只加不减,GPOS 锚点随轮廓平移。⑧整形簇验证修复:HarfBuzz 整形簇清单,不可读簇贪心回退至可读,簇准确率 0.981–1.000。⑨OFL 重命名+参数化后轴(weight/counter/em-fill)。训练用 warm-start graft:恢复通过检查点、拼新 pack,20–48k 步余弦重启(峰值 $2.3\times10^{-5}$)。
技术新颖性
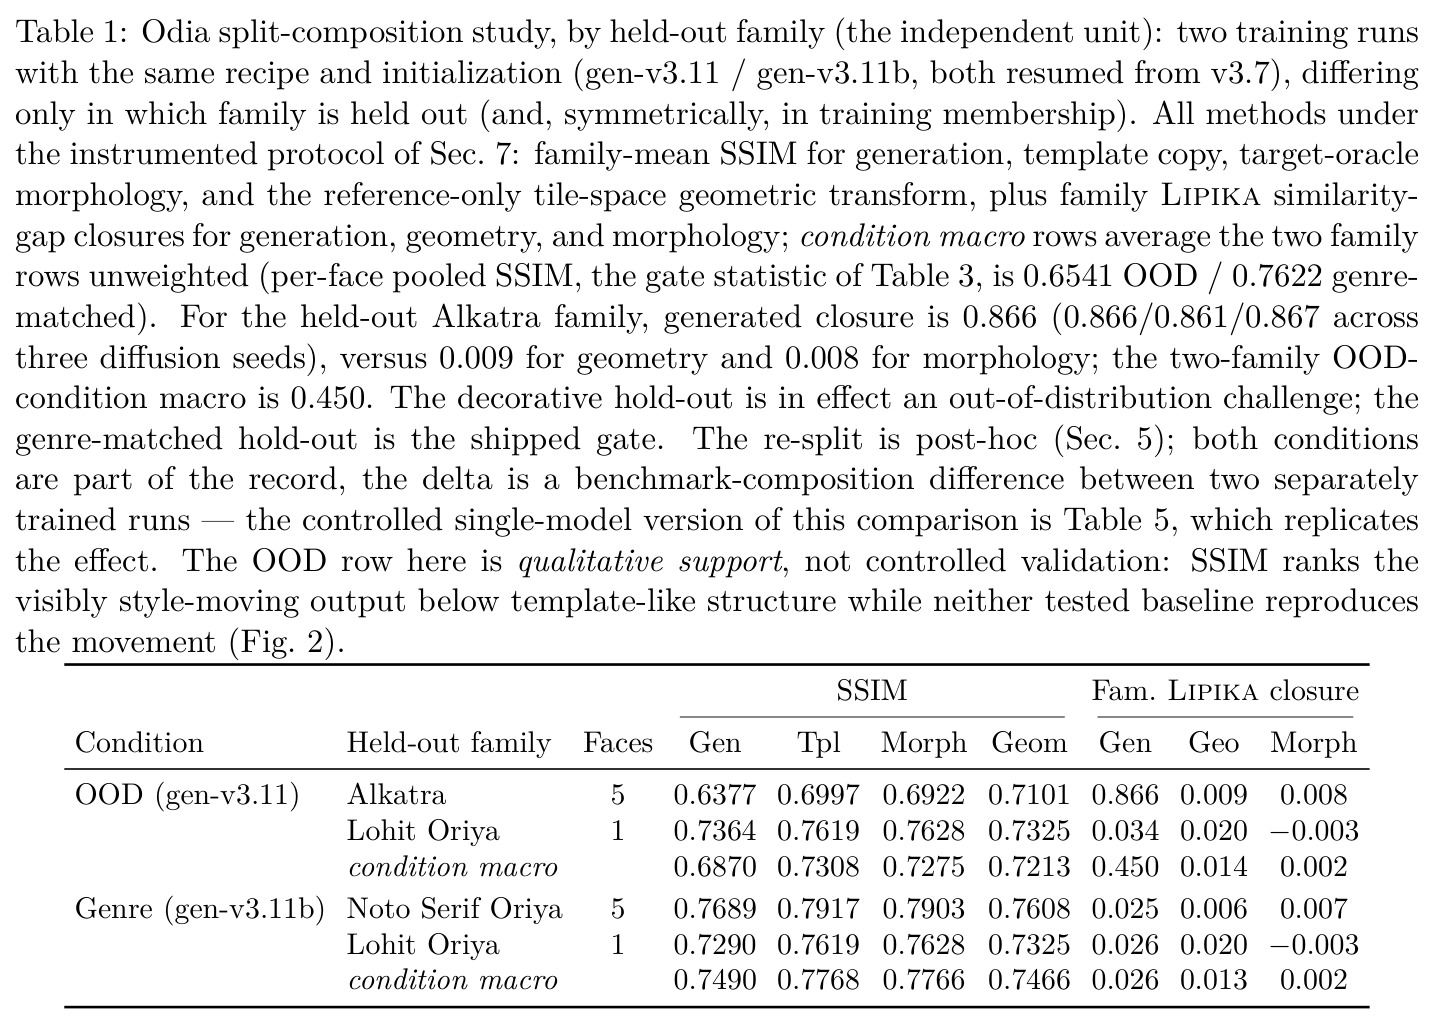
三点新颖性。其一,问题重构:把"生成字体"重构为"模板改样式+布局继承",使输出在构造上就是字体,这与所有 few-shot 字体生成(输出栅格)和原生矢量生成(输出孤立字形)都不同;逐 tile 换成原生矢量生成器也是兼容的升级路径。其二,检索式风格接地:Lipika 用每(家族,脚本)嵌入把开放词表 prompt 锚定到真实捐赠字体,弥补印度文字风格属性数据集缺失的空白,且风格天然可实现、许可可审计。其三,评测与负结果的方法论:Modak 规则(装饰体裁留在训练集)经 Odia 两轮对照(0.6541 vs 0.7622 SSIM,差异为基准构成而非模型改进)确立并固化为冻结双层基准 benchmark_v1;script bars 把每次训练变成跨九脚本的回归测试;目标函数污染研究给出即时 loss 指纹(清洁 0.0010 vs 污染 0.0066–0.0090);数据边界分析量化278个 Devanagari face 的墨密度分布(p50 0.366、p99 0.616、最大 0.732)。graft 稀释零和的观察与 per-script routing 也是可迁移经验。
实验结果
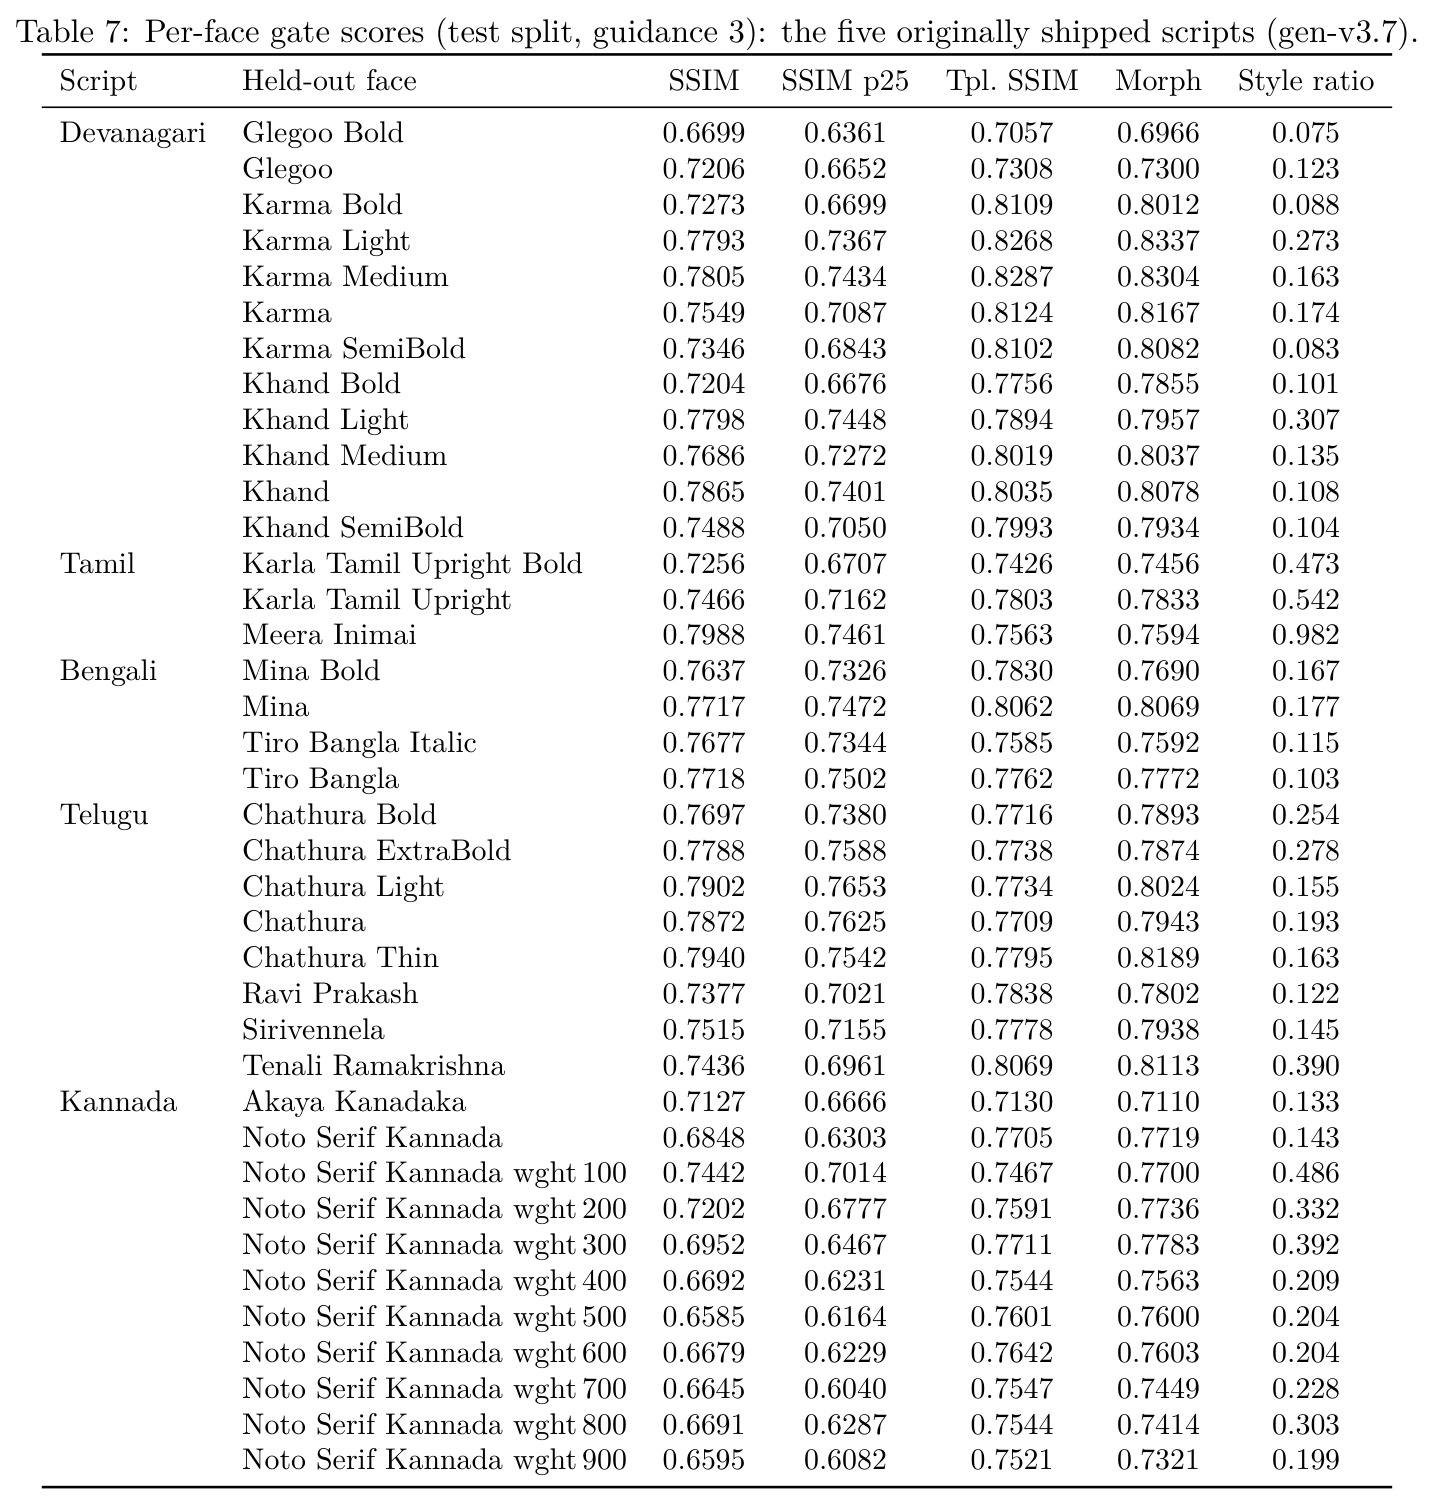
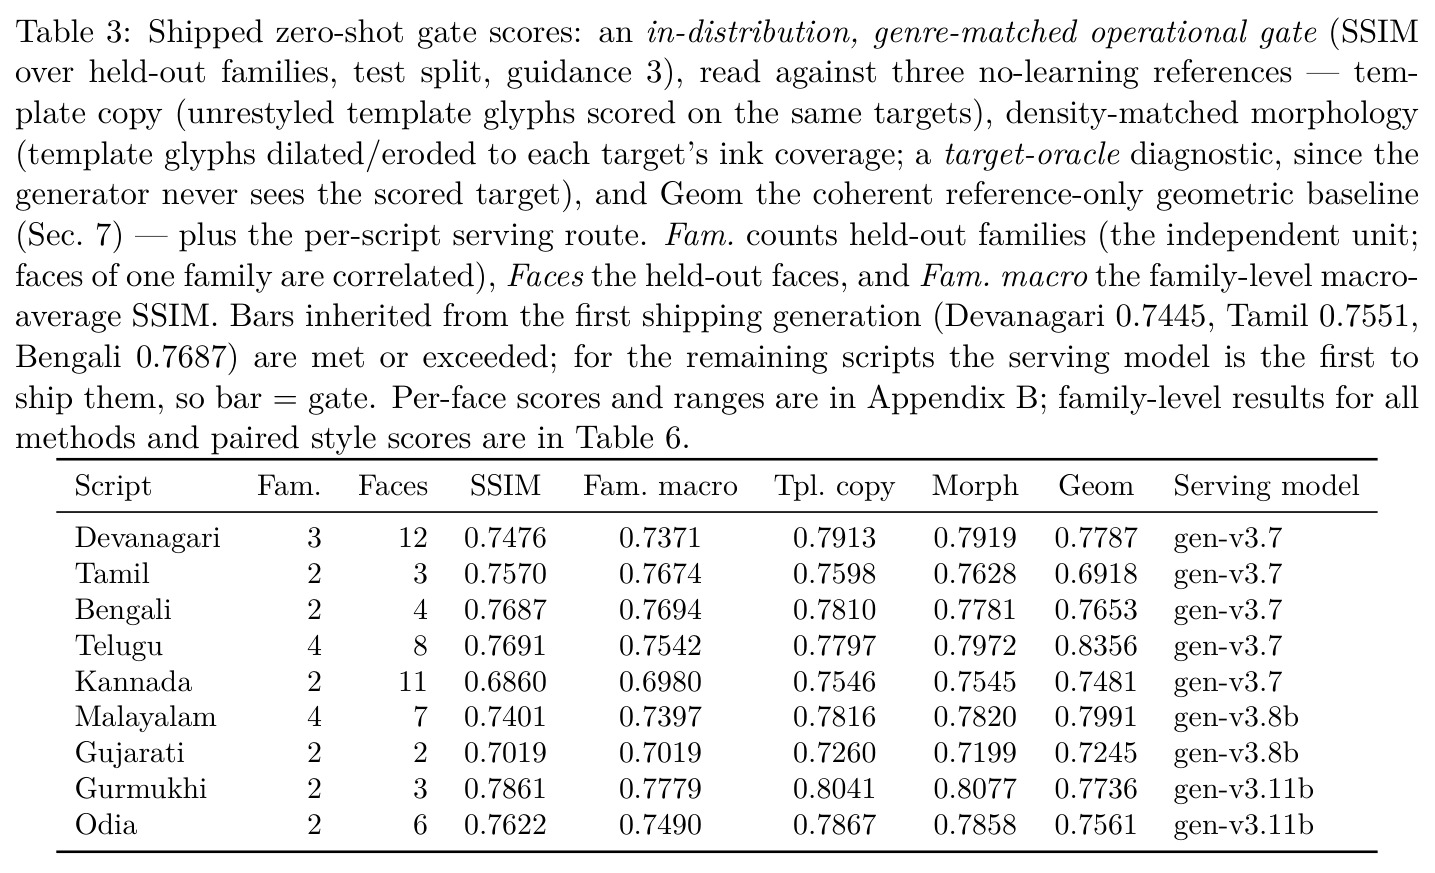
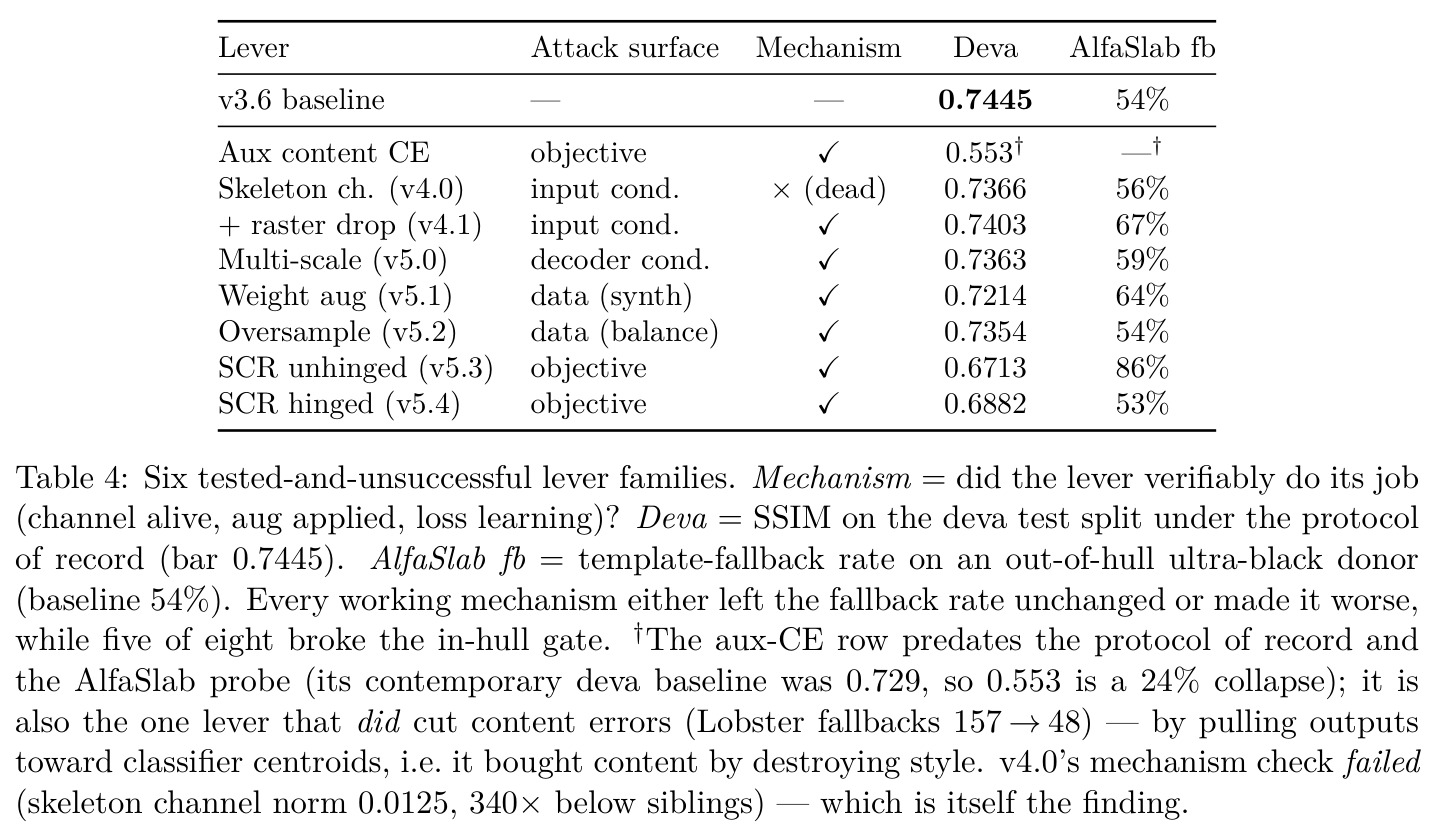
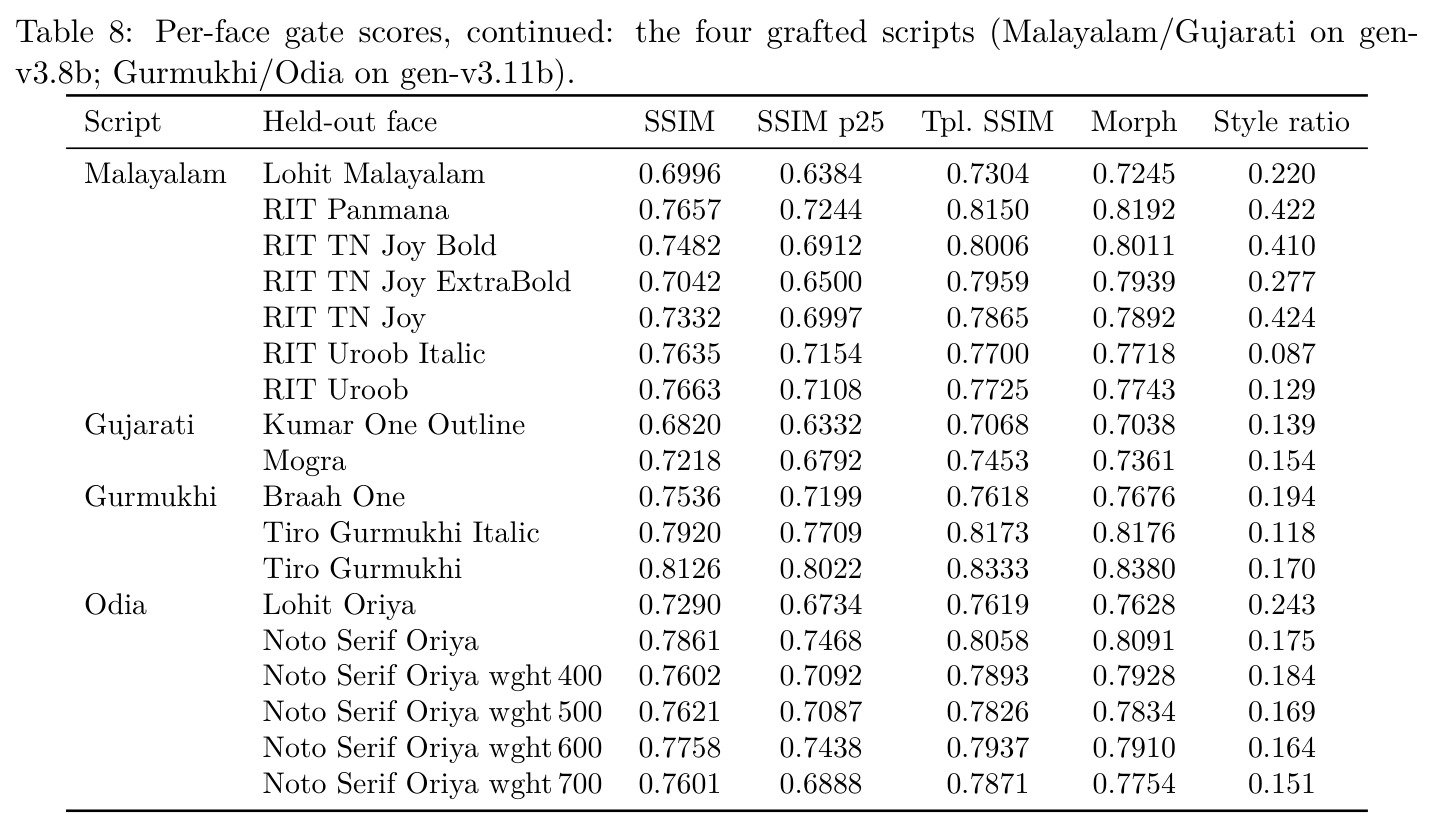
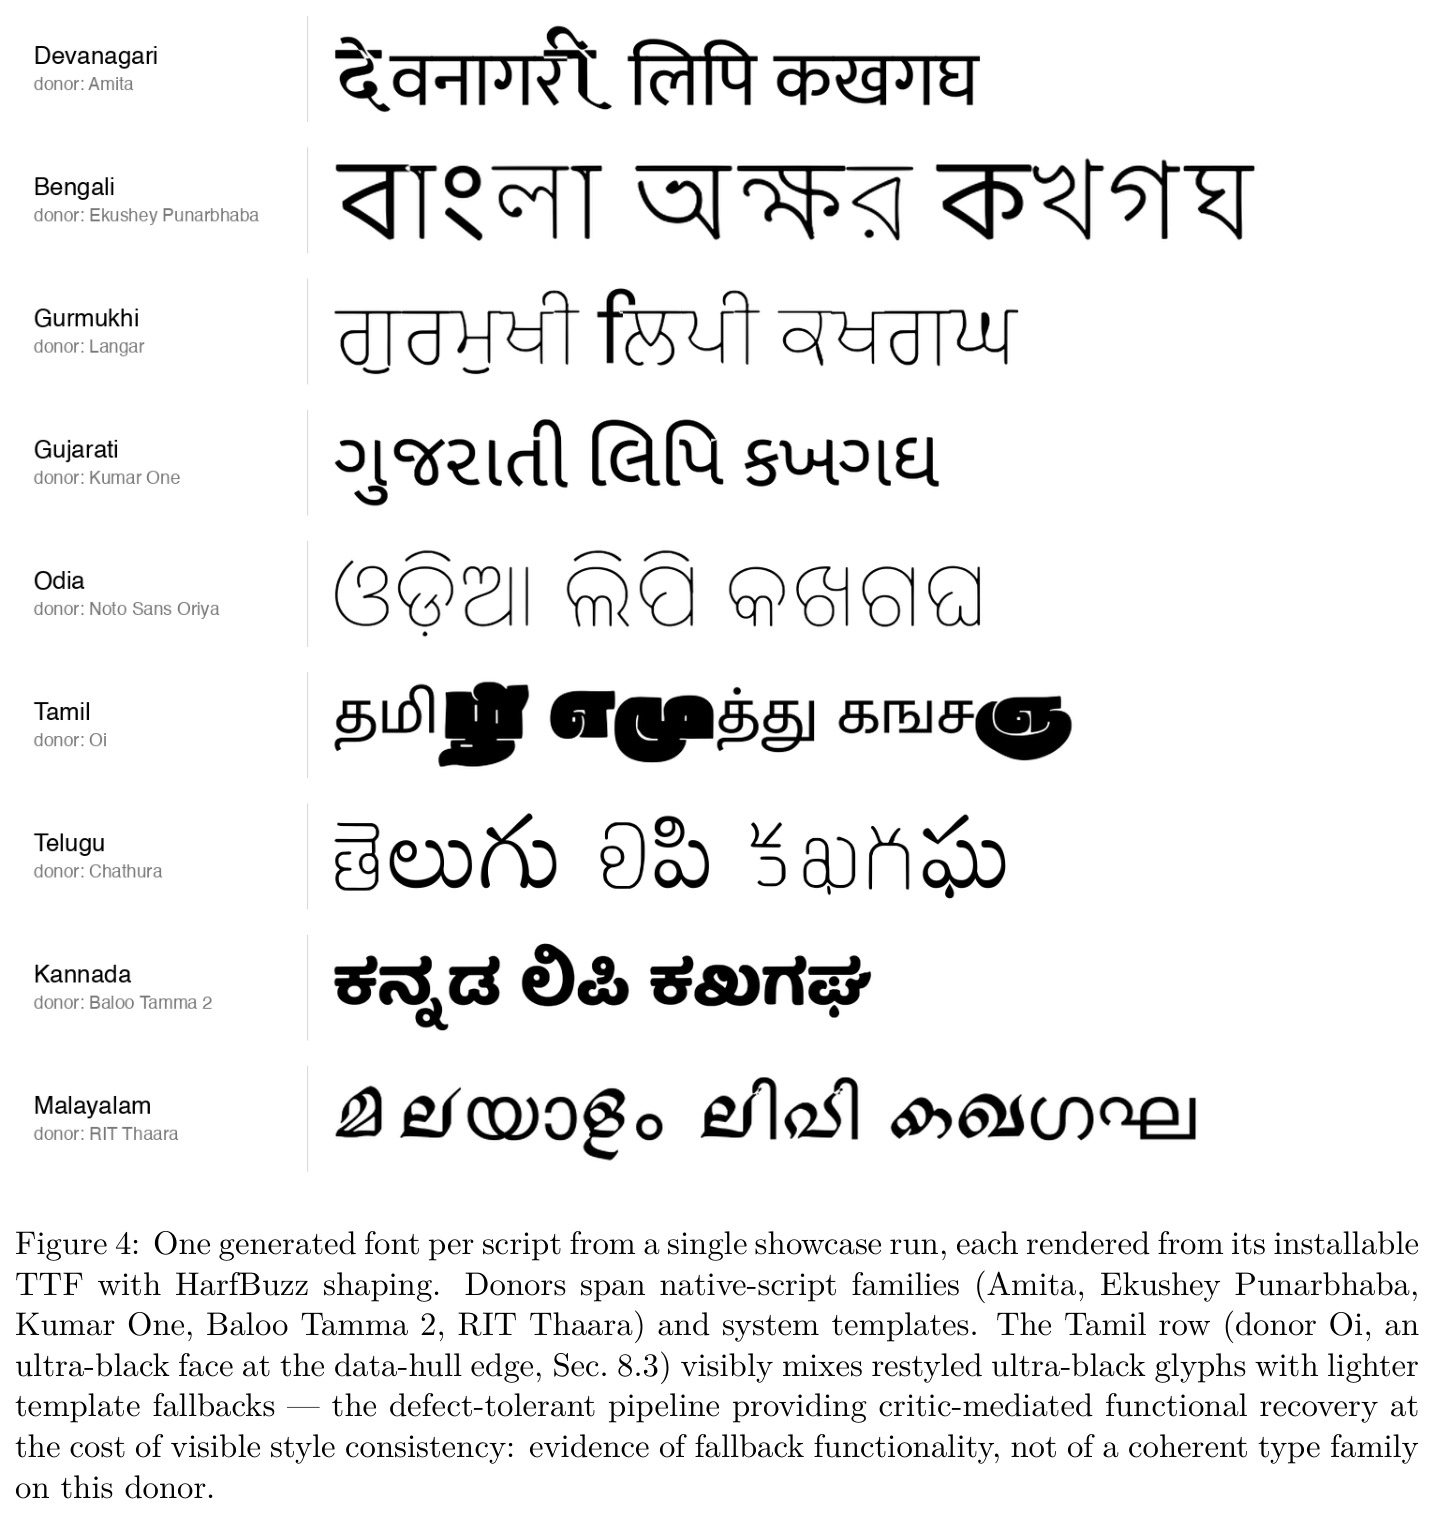
①结构验证:66 个 TTF 过 ots;审计 80,915 字形、54,812 锚点:50,066 个回退字形度量差为零,30,849 个接受字形 advance 增量 p50 0.045 em、p95 0.358 em 零收窄,锚点 $\Delta y \equiv 0$;尾部5.2% 渲染审计仅 4 例生成重叠。②门控:Gurmukhi 0.7861 最高、Kannada 0.6860 最低,但模板拷贝在 9 脚本、50/56 face 上超生成,形态学在 53/56 上超过,属回归测试。③风格:18/23 家族更近参考质心但中位 closure 仅 0.047;OOD Alkatra 0.866(受控复现 0.935/0.853),其余 7 个 OOD 家族中位 0.040。④几何基线 17/23 家族 SSIM 超生成但 closure 仅 0.006。⑤负结果:六杠杆机制全过但 AlfaSlab fallback 钉在 54%(辅助 CE 致 0.553)。⑥端到端:9 字体簇准确率 0.998–1.000、可读性 0.82–1.00,L4 12–136 分钟。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本风格迁移门控(held-out 家族重建) | SSIM(按脚本池化,guidance 3) | 九脚本 0.6860(Kannada)– 0.7861(Gurmukhi) | 模板拷贝 0.7260–0.8041;密度匹配形态学 0.7199–0.8077;几何基线 0.6918–0.8356 | 无正提升:模板拷贝在 50/56 face 上更高(作者如实定位该门为跨版本回归测试) |
| 风格移动(家族级 Lipika 相似度差距闭合) | gap closure(生成相对模板向参考质心闭合的比例) | 中位 0.047(IQR 0.016–0.133);OOD Alkatra 0.866–0.935 | 几何基线中位 0.006(最大 0.218);形态学中位 0.008 | 生成在 17/23 家族上优于几何基线,但 5 个家族为负(最小 −0.101) |
| 端到端 prompt→字体 showcase(9 个开放词表字体) | 整形簇准确率 / 可读性比例 | 0.998–1.000 / 0.82–1.00,单 L4 每 12–136 分钟 | 无受控基线;人类评估列为未来工作 | 证明流水线可用性,但输出质量尚未受控度量 |
| 负结果杠杆对比(内容保真/极端捐赠者) | deva 门控 SSIM / AlfaSlab fallback 率 | 最佳变体 0.7403 / 67%(v4.1 骨架+栅格dropout) | v3.6 基线 0.7445 / 54% | 八个变体无一同时改善两项,5/8 破坏门控,辅助 CE 致 0.553 崩溃 |
局限与改进
作者坦承的局限:所有基线均为无学习参照,未与 FontDiffuser/MX-Font 等学习型 few-shot 生成器对比;门控在 oracle 参考下只测重建,既不界定也不度量开放词表 prompt 质量;检索界面仅由 Spearman 0.50 验证,缺人类评估;Lipika 判别嵌入的训练语料(595家族)包含全部30个基准家族,风格度量是 same-model 内部指标(表征暴露未排除);字形局部风格迁移——由布局级特征承载的捐赠者身份(极端宽度、连笔、baseline dance)迁移弱(donor cosine 0.24–0.41,对比权重/对比度风格 0.61–0.99);墨密度超过训练面(最大 0.732)的捐赠者退化为模板为主的输出;重型展示捐赠者上输出是"功能字体"而非连贯字族(Tamil 行可见混风格)。我的补充观察:SSIM 门控系统性偏向与模板相近的正文设计、天然惩罚风格移动,指标与目标存在错位;每脚本单一模板限制布局尺度风格迁移;FontBakery 审计未在最后4个字形回退后重跑;per-script routing 多模型常驻的内存成本未量化报告。
独立分析的弱点
①评测统计功效不足:每脚本仅2–4个独立 held-out 家族,池化统计高估有效样本量,作者自认是无置信区间的描述性统计;改进方向是扩大家族数、报告家族级自举区间,并纳入学习型基线使"哪个杠杆起约束"的论断可证伪。②风格度量的循环性:Lipika 识别器的冻结特征既是生成器的风格编码器又是风格裁判,其训练语料(595家族)覆盖全部基准家族;改进方向是基准不相交重训 Lipika、引入独立风格嵌入与设计师标注的配对人类偏好研究。③数据边界证据薄弱:仅单一标量(墨密度)加两个拉丁探针捐赠者,AlfaSlab 0.757 仅略超 Modak 0.732,容量/批评家校准/tile 分辨率等替代解释未被排除;改进方向是密度分带多捐赠者研究绘制边界形状。④重型捐赠者输出风格不连贯且无 within-font coherence 统计;改进方向是报告字重离散度并做生成后全局协调。⑤per-script routing 以内存换回归安全;可对照 EWC、per-script adapter、MoE。⑥生成器与流水线代码未发布,当前只有检索端可复现。
未来方向
作者列出的方向:用基准不相交语料重训 Lipika 并以独立风格嵌入重评 closure;开展配对人类偏好研究(生成 vs 几何 vs 模板,非学习臂已就绪);在同一 pair packs 上训练 FontDiffuser/MX-Font/CF-Font/DG-Font 学习型基线;密度分带多捐赠者研究刻画数据边界;统一单模型路线(EWC 等持续学习正则、冻结共享骨干上的 per-script adapter、MoE 容量);补 hinting、把参数轴改为可变字体 delta;对1,369个仅经 GSUB 上下文可达的宽度变体做渲染审计;为每脚本建立结构多样的已审计模板库(宽体/窄体/高对比)并在改样式前匹配捐赠者,以恢复布局尺度风格迁移。我的延伸:"布局继承+局部重绘"公式可平移到阿拉伯文等连写文字;逐 tile 描摹可升级为原生矢量生成器(VecGlypher 类);检索可扩展为模板-捐赠者联合匹配;其配置 diff 纪律与污染 loss 指纹法证可直接推广到任何扩散微调项目的工程实践;负结果目录本身可做成可复用的实验协议模板。
复现评估
部分开源、部分承诺。已公开:Lipika 检索与识别代码(github.com/Loopdesk-AI/lipika)、识别器权重(huggingface.co/loopdesk-ai/lipika)及其评测集;arXiv 附属文件含冻结的 benchmark_v1 manifest(模板、参考选取规则、种子、指标、SHA-256)、逐 face 逐 seed 的全部方法评测 CSV(含每 face 六参考 tile 索引)、逐字形度量尾部清单及其渲染审计、66个字体的 SHA-256 manifest 及验证日志、人类评估协议草案。未包含:Srijika 生成器、serving 流水线与评测实现(含几何基线,承诺后续版本发布),以及字体文件本身(仅哈希)。算力门槛中等:单 H100 约 7 GPU 小时 graft 一个脚本,showcase 单 L4 每 12–136 分钟生成一个字体,受控的 gen-bench-v1 从零训 168k 步。综合评估:检索端与评测协议今天即可复现,生成端复现难度高,需等代码发布并重建多阶段流水线。
论文图表
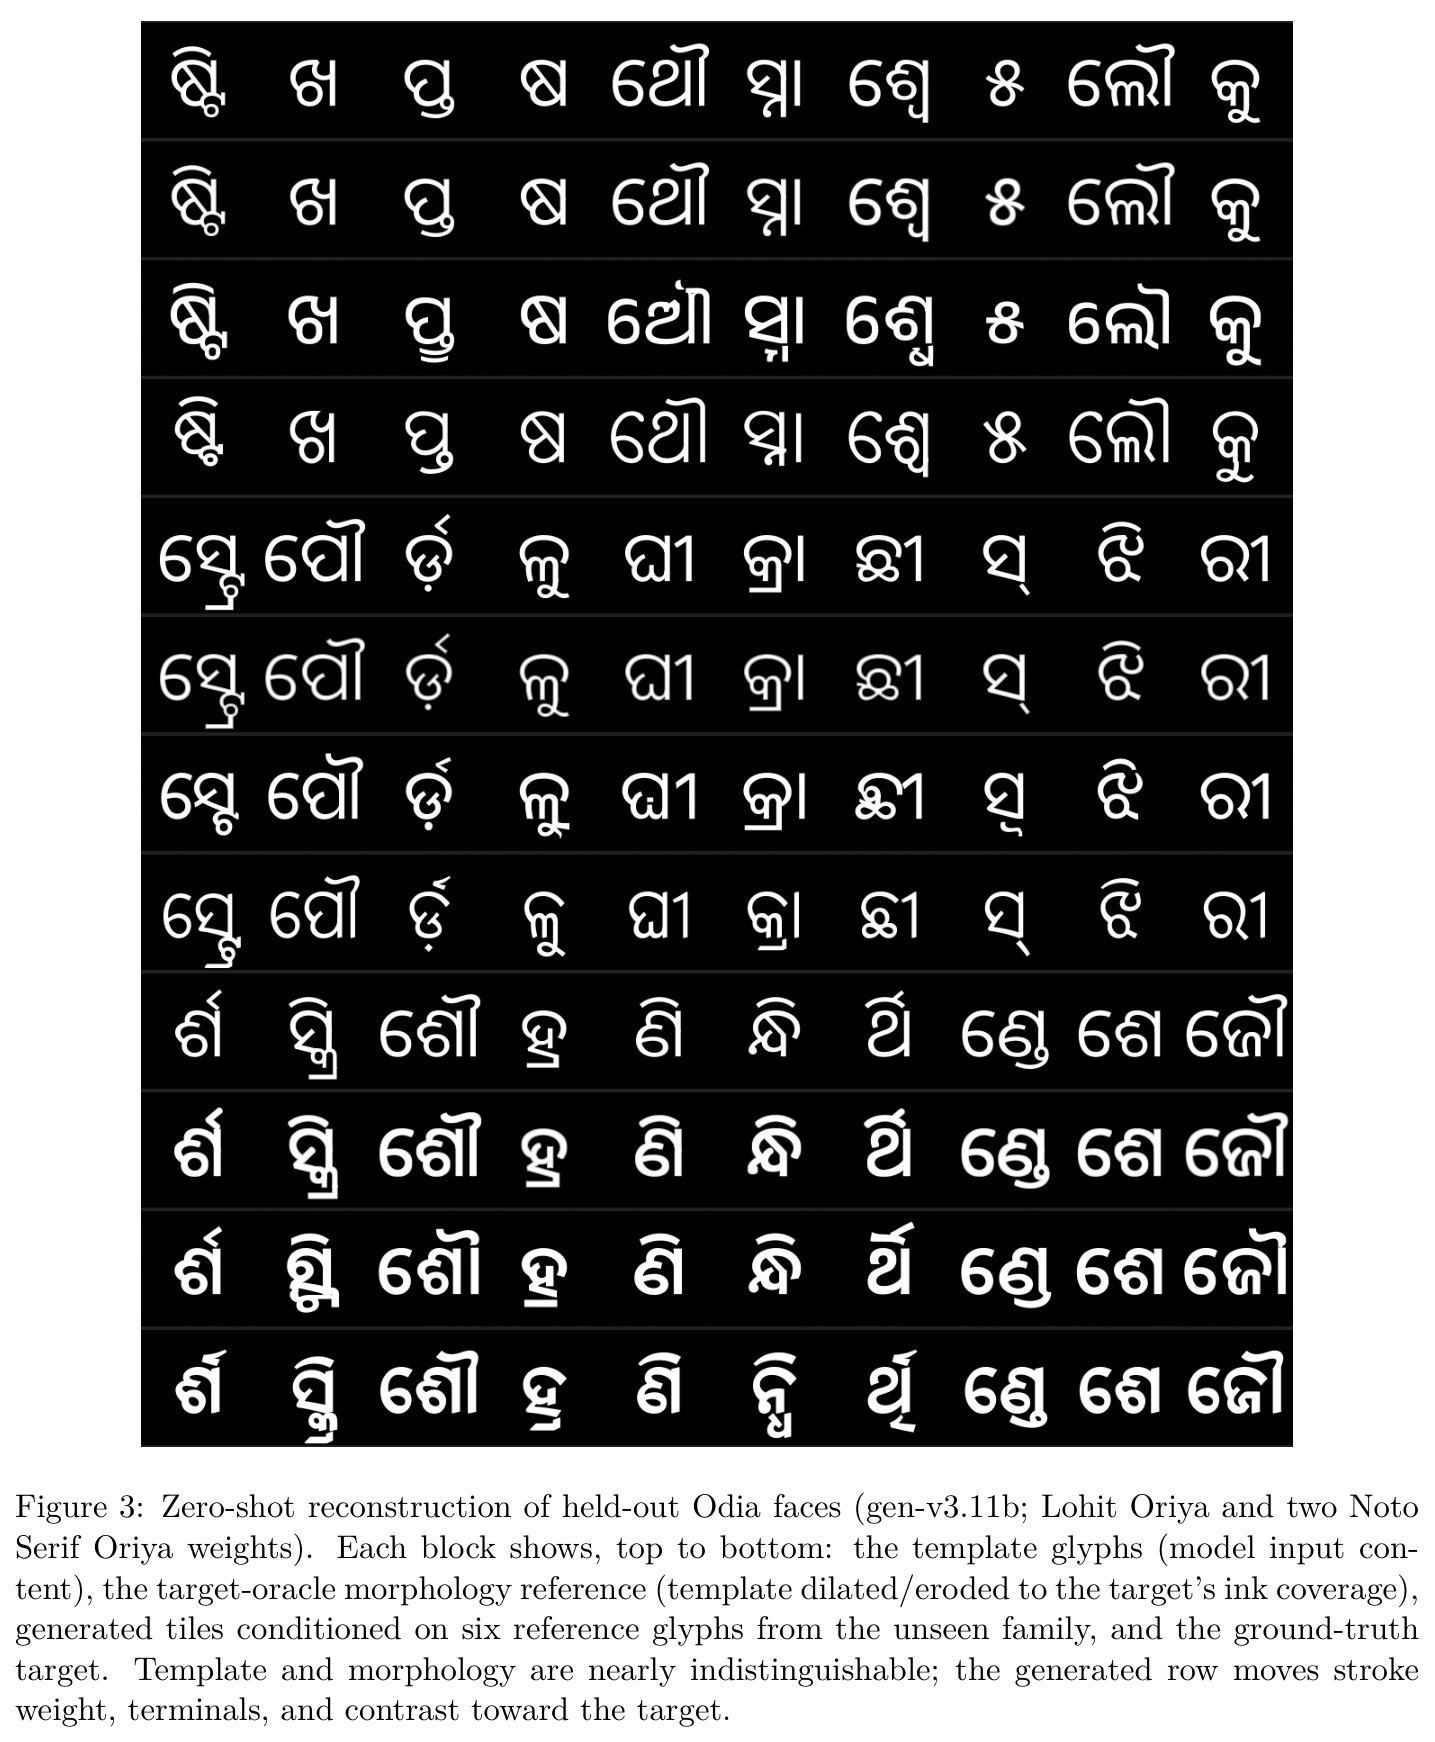
gen-v3.11 下 held-out Alkatra wght700 的对比行:模板、目标 oracle 形态学、仅参考的几何变换几乎不动,而生成的 tile 明显采用了捐赠者的重圆角风格(SSIM 反而更低);下半部分展示同一条件下组装字体的 HarfBuzz 整形样本——210/562 闭包字形通过内容门被改样式,其余回退模板,可见字重混杂。
直观解释了为什么 SSIM 门控会惩罚风格移动、以及 OOD 情形下流水线"诚实"的混合输出长什么样,是解读 Table 1 结论的关键视觉证据。
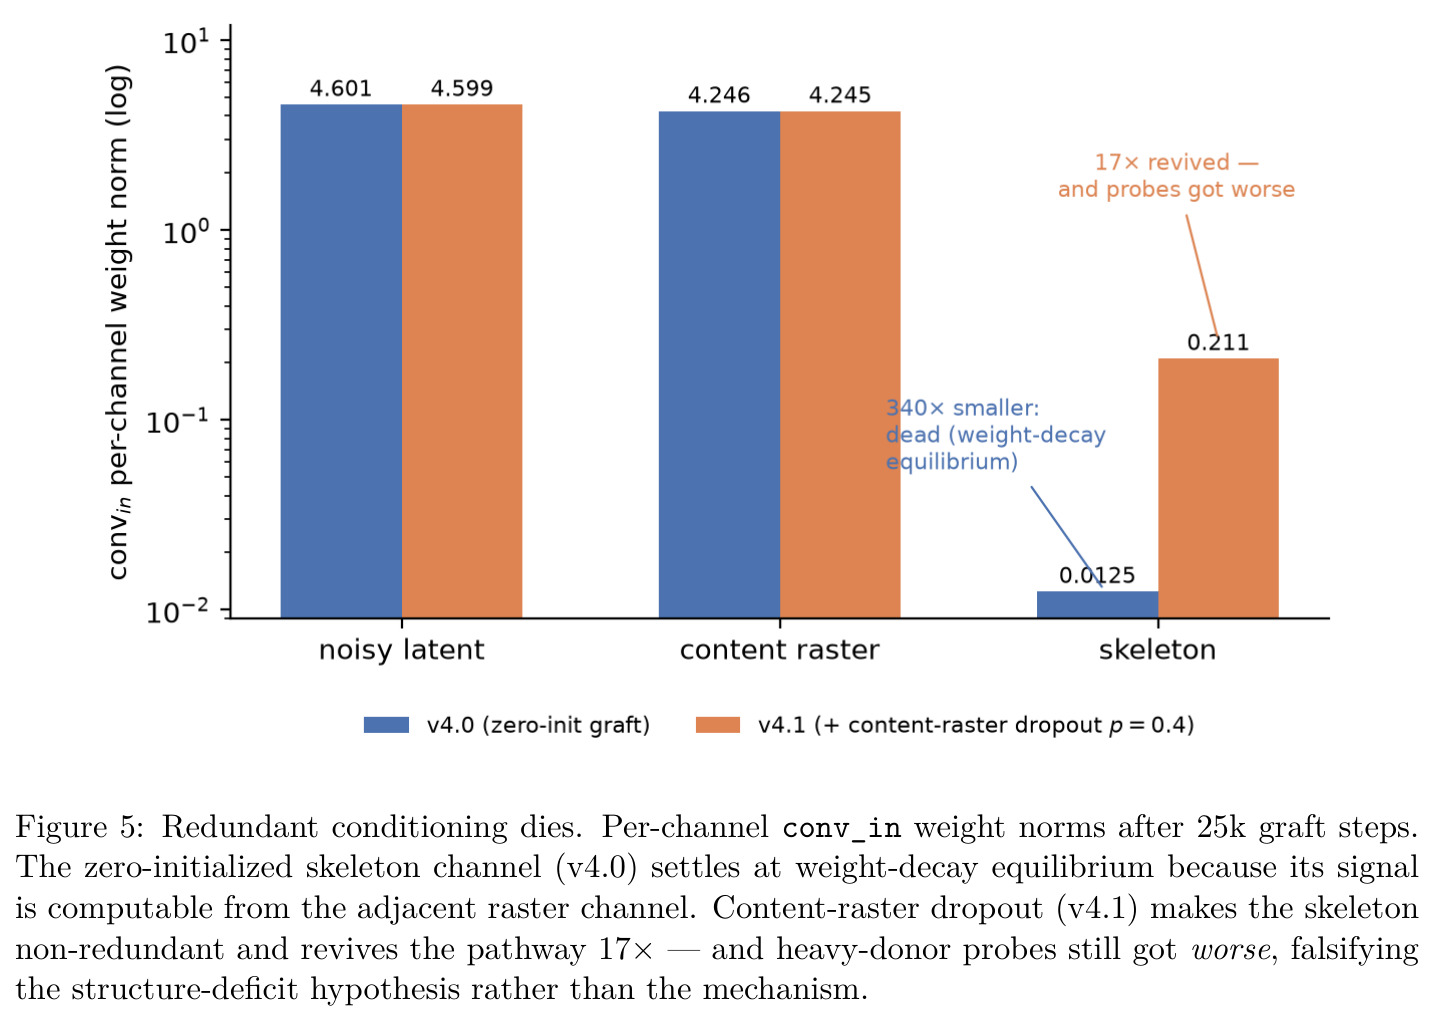
25k graft 步后 conv_in 各通道权重范数:零初始化的骨架通道(v4.0)因信号可由相邻栅格通道计算出而收敛到权重衰减平衡点(范数 0.0125 对栅格 4.25,340×差距);加入栅格 dropout(v4.1)使骨架不可省略、通路复活17×,但重型捐赠者探针反而更差,证伪了"结构缺失"假设而非机制。
负结果目录的方法论标本:机制检查通过但指标不改善,说明条件丰富度不是约束所在。
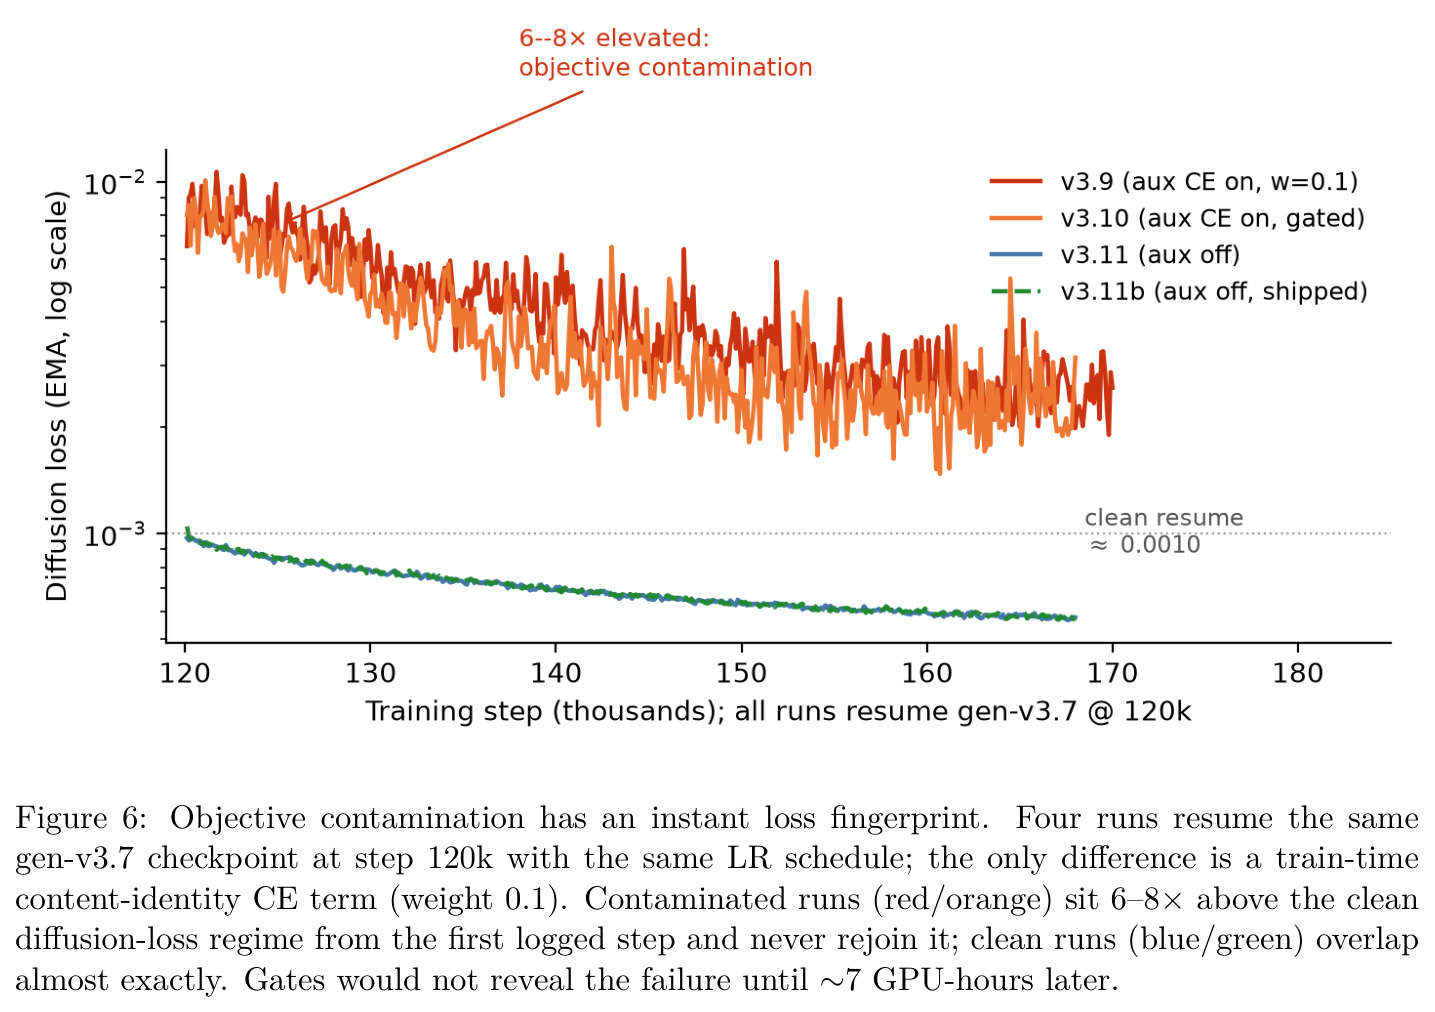
四个运行从同一 gen-v3.7 检查点在 120k 步以相同 LR 计划恢复,唯一差异是训练时内容同一性 CE 项(权重 0.1):污染运行(红/橙)从首个记录步起就高出清洁扩散损失区间6–8×(0.0066–0.0090 对 0.0010)且永不回归;干净运行(蓝/绿)几乎完全重叠,门控失败要到约7 GPU 小时后才显现。
给出可操作的工程教训:配置污染有即时的 loss 指纹,diff 配置比等门控结果便宜得多,是全文最实用的法证图。
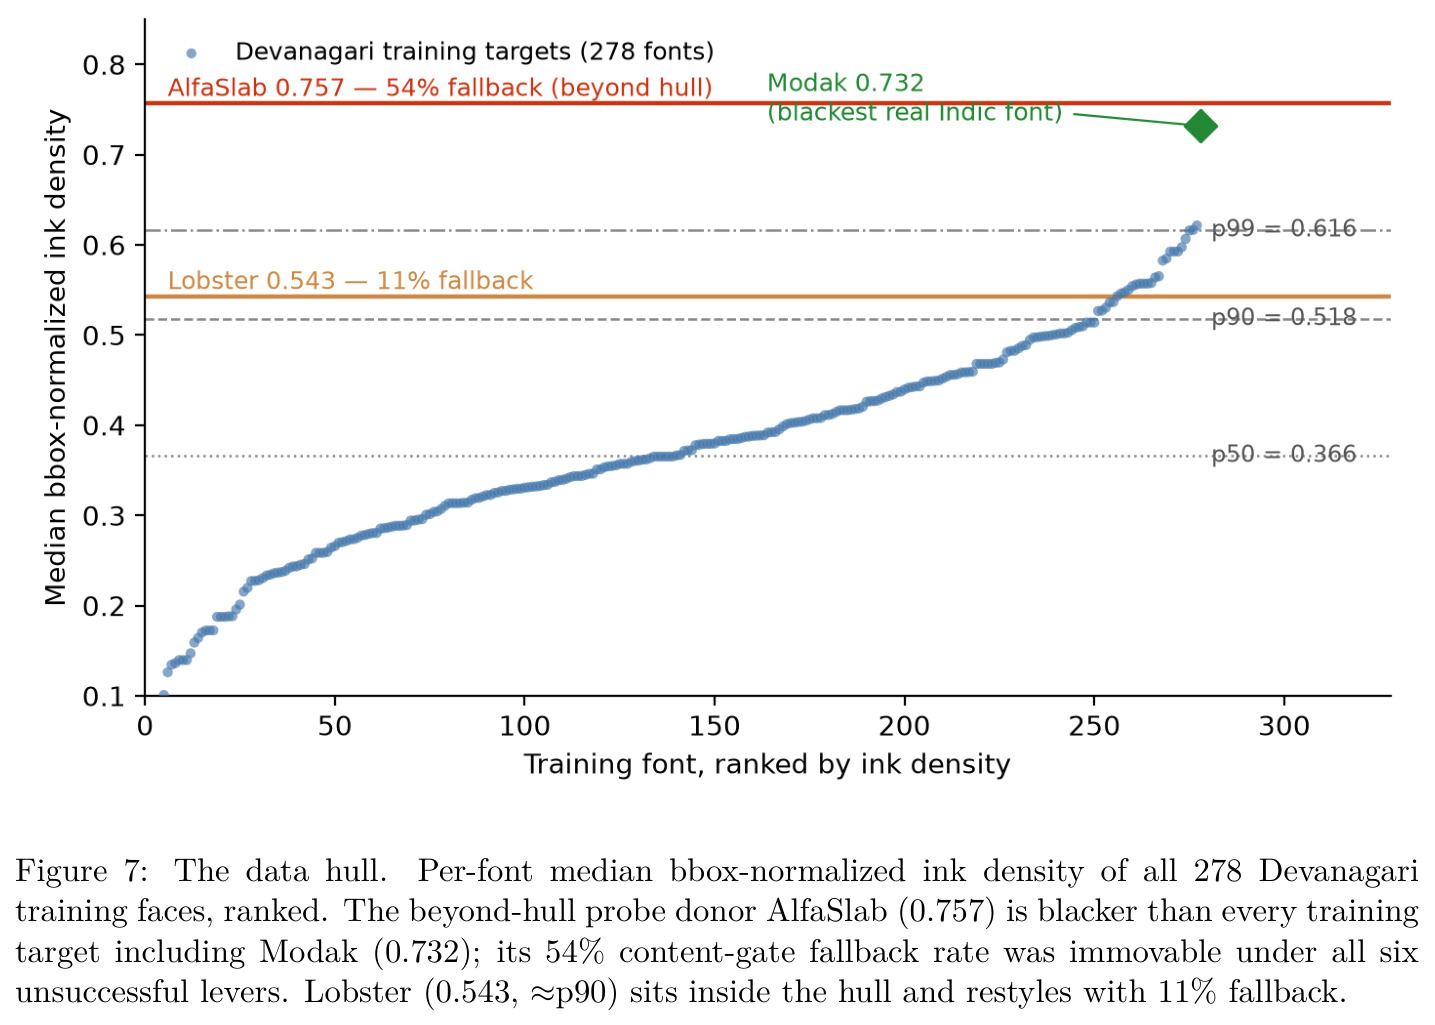
278 个 Devanagari 训练 face 的 bbox 归一化墨密度中位数排序分布:p50 0.366、p90 0.518、p99 0.616、最大 0.732(Modak);超界探针 AlfaSlab(0.757)比所有训练目标都黑,内容门 fallback 率 54% 在六个杠杆下纹丝不动;界内约 p90 的 Lobster(0.543)仅 11% fallback。
数据边界假设的核心证据图:把"超界捐赠者必然失败"的结论锚定在可测量的分布上,也支撑了 serving 端的捐赠者墨密度预检分带。
全部方法的家族级结果与配对风格分数:生成 tile 在 18/23 个 held-out 家族上比模板更接近参考质心,但中位 closure 0.047(8家族>0.10、3家族>0.25、1家族>0.5、5家族为负,最小 −0.101),几何基线中位 0.006 且无家族超 0.25;模板拷贝在 20/23 家族上保持更高 SSIM;大 closure 集中于 Karla Tamil Upright 0.40、Meera Inimai 0.98、RIT TN Joy 0.26;三种子下中位 0.047/0.054/0.047。
把"生成移动了风格但幅度通常很小"这一最清醒的量化结论落到家族粒度,是评估风格迁移真实水平时必须细读的表。