别丢掉Dropout:面向高效大语言模型训练与推理的层稀疏优化 Don't Drop Dropout: Optimizing Layer Sparsity for Efficient LLM Training and Inference
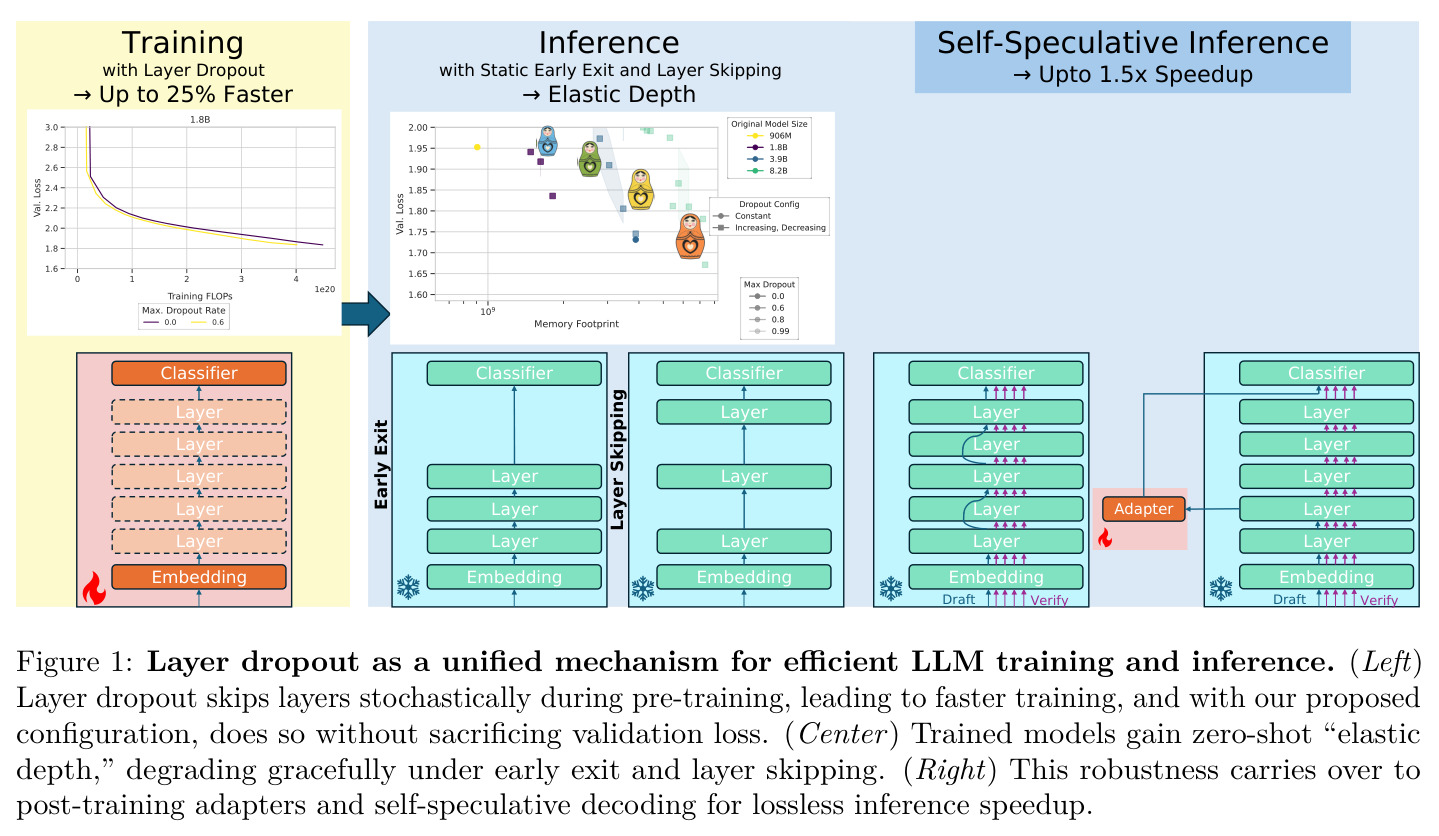
层间递增、时间递减的层Dropout配方可省25%训练FLOPs并解锁1.5×无损推理加速
前置知识
层Dropout(随机深度,Stochastic Depth)
训练时以概率 $p$ 随机跳过整个 Transformer 残差块,前向变为 $H_{\ell+1}=H_\ell+r^{train}Mf_\ell(H_\ell)$,$M\sim\mathrm{Bernoulli}(1-p)$。残差连接保证被跳层时恒等映射仍可传播。整块跳过属结构化稀疏,节省的 FLOPs 随丢弃率近似线性增长,可转化为真实加速,这与只置零激活、无法省计算的逐神经元 dropout 本质不同。
它是论文的研究对象本身:全文所有消融(粒度、深度分布、时间表)都在回答'该不该用、怎么配置层Dropout'。
计算最优与 TPP
TPP(tokens-per-parameter)指训练词元数与参数量之比。Chinchilla(Hoffmann et al., 2022)指出给定算力下约 20 TPP 为计算最优配比。本文所有消融都在每个模型规模 20 TPP 的预算下进行,保证不同配置在同等总算力下公平对比。
论文所有'省 FLOPs 但精度不掉'的结论都以 20 TPP 等预算对比为前提,不理解 TPP 就无法看懂实验设计。
超参数迁移(µP / CompleteP / Power Lines)
一套参数化规则:在小模型上调好的最优学习率 $\eta$、权重衰减 $\lambda$、批大小 $B$,可按解析公式缩放到更大宽度/深度/数据而保持最优。本文把层密度 $\rho=1-p$ 视为'有效深度'纳入该框架(残差块按 $\rho^{-1}$ 缩放),从而免去了为每个 dropout 率重新调参。
第 5 节的关键发现 $r^{train}=1/\rho$ 正是用坐标检查与迁移实验验证的,不懂该框架就看不懂这一核心贡献。
早期退出(Early Exit)
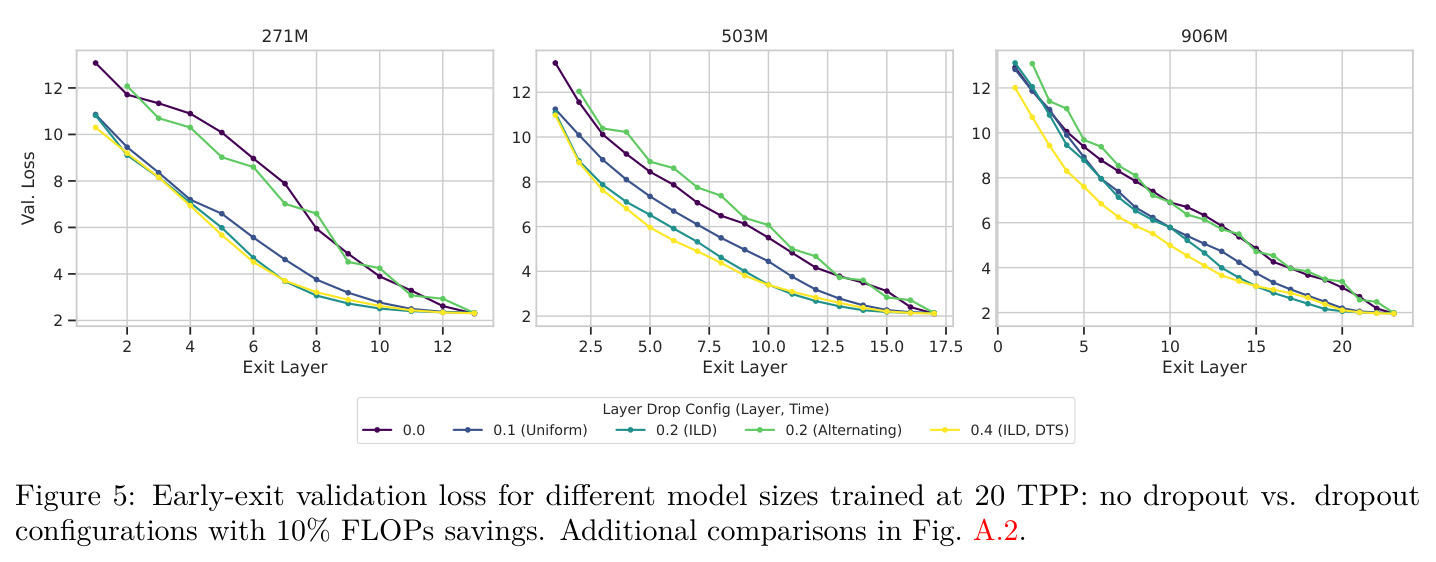
推理时只执行嵌入层、前 $\ell'$ 个 Transformer 层和输出层(unembedding)便直接预测,等价于静态跳过后面 $L-\ell'$ 层。层数减少意味着更低延迟与算力,但密集训练的模型即使只早退一层损失也会急剧恶化;经层Dropout 预训练的模型则能平滑退化。
早期退出是论文展示的三大零样本推理收益之一(Fig. 5、Fig. 7),是理解'深度弹性'的关键场景。
自推测解码(Self-Speculative Decoding / Draft & Verify)
推测解码用快的'草稿'模型先猜若干词元,再由大模型并行验证,保证输出无损。Draft & Verify 不引入外部小模型,而是从目标模型自身挑选一个层子集充当草稿器:子集要足够小以提速,又要足够准以维持词元接受率 $\alpha$。
论文 Table 4 与 Table 5 的推理加速全部来自该技术,而层Dropout 预训练直接决定能否搜到高质量的草稿层子集。
非嵌入 FLOPs 与训练期缩放因子 $r^{train}$
论文的 FLOPs 均指非嵌入计算量:被丢弃的块节省其 $p$ 比例计算,总节省率 $\bar{P}$ 为丢弃率在时间与深度上的均值。$r^{train}$ 是训练时对保留分支的缩放系数(各框架取 1 或 $1/\rho$ 不等),$r^{eval}=1$ 保证 $\mathbb{E}[H^{train}_{\ell+1}]=H^{eval}_{\ell+1}$。
'同 FLOPs 公平对比'与'缩放因子选择'是全文方法学的两条主线,贯穿所有实验。
研究动机
现代 LLM 预训练已基本抛弃 dropout:GPT-3 与 OPT 还保留 Vaswani 时代继承的设置,PaLM 仅在微调时使用,LLaMA 系列则不再提及;实证研究(Liu et al., 2025)表明单轮大数据训练下激活类 dropout 会损害精度。但预训练成本极高,time-to-accuracy 的小幅改进就能节省数百万美元,这促使作者重新审视一种特殊变体——层Dropout(随机深度):跳过整个 Transformer 块是结构化稀疏,训练 FLOPs 随丢弃率近似线性下降,可转化为真实加速,还让模型天然鲁棒于早退、跳层等推理优化。然而已有证据互相矛盾:BERT 时代多轮小语料下的 Progressive Layer Dropout 与 LayerDrop 报告正收益,而现代大规模单轮训练下的 LayerSkip 却报告明显退化;此前从没有工作量化过这种退化,更没有人缓解它——退化究竟是本质缺陷还是配置不当,一直悬而未决。
本文的目标是本文要系统回答:层Dropout 应否用于现代大规模 LLM 预训练?若用,如何配置才能在不损精度的前提下同时获得训练与部署收益?具体包括:(1)为每个丢弃率联合优化学习率 $\eta$、权重衰减 $\lambda$、批大小 $B$ 等优化器超参,建立稳定的缩放规则以避开'超参数彩票';(2)在固定 FLOPs 预算下确定最佳粒度(整层 vs 子层、按序列 vs 按批)、深度分布(均匀/递增 ILD/交替 ALD)与时间表(常值/递增 ITS/递减 DTS);(3)量化零样本推理收益(早期退出、中间层跳过)与后训练收益(退出适配器、自推测解码);(4)验证结论随模型与数据规模的扩展性。研究在 Cerebras CS-3 上共完成 2400 余次训练,覆盖 271M 至 8.2B 参数,消融实验最多 116B 词元,大规模运行达 160B 词元。
与已有工作不同的是,本文的切入是'首个统一且受控的大规模实验研究'。此前文献碎片化严重:各实现的缩放因子互相矛盾——原始 dropout 取 $r^{train}=1, r^{eval}=\rho$,首个随机深度论文取 $r^{train}=1, r^{eval}=p$,DINOv2 取 $1/\rho$ 与 1,fairseq 与 torchtune 两者都取 1,甚至需要翻源码才能分辨;也没有工作为层Dropout 联合调优优化器超参,整层与子层、按批与按序列、三种深度分布与三种时间表从未在等 FLOPs 下被系统比较。此外,在深度弹性推理的版图中,既有方法(Once-for-All、MatFormer、Nemotron-Elastic、路由式跳层等)都要修改架构、增加参数或辅助损失;本文证明仅靠预训练配方中的随机丢层即可获得同类能力,与现有训练栈正交、即插即用。
核心方法
直觉上,训练时随机跳层一方面直接省算力——被丢弃的块无需计算,节省量与平均丢弃率成正比;另一方面让模型适应'变浅的自己',推理时便可安全地早退或跳层。难点在于朴素应用会掉点,此前的大规模尝试(LayerSkip)正是因此失败。本文的技术路线分六步:(1)把层密度 $\rho=1-p$ 当作有效深度,依据 CompleteP 的'最大残差流更新'准则推出训练期缩放因子 $r^{train}=1/\rho$,并用坐标检查验证;(2)在 271M 小模型上做迁移测试,证明最优 $\eta$、$\lambda$、$B$ 跨丢弃率保持不变;(3)消融粒度:整层 vs 子层、按序列 vs 按批;(4)在等 FLOPs 下消融深度分布(Uniform/ILD/ALD)与时间表(Constant/ITS/DTS);(5)测量零样本与后训练推理收益;(6)扩展到高 TPP 与 1.8B/3.9B/8.2B 的 hero run。最终推荐配方为:层间递增(ILD)+ 时间递减(DTS)。
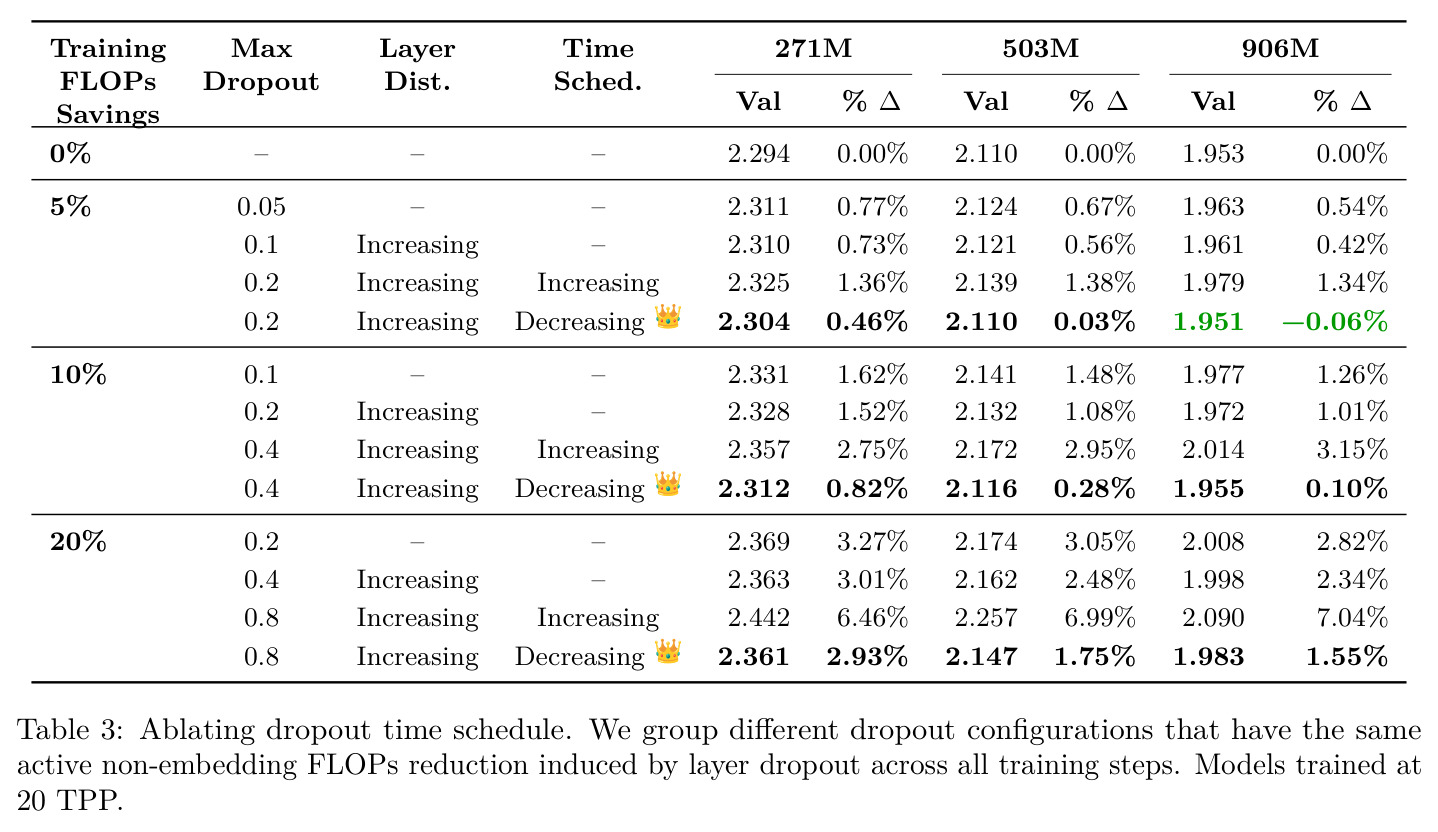
核心创新有两点。其一是'重定标'洞察:dropout 会改变网络的有效深度,而此前所有实现都忽略了这一相互作用——本文按'每个残差块的权重更新应贡献 $\Theta(1/L_{eff})$ 的特征移动'这一准则推导出 $r^{train}=1/\rho$,使坐标检查通过、最优超参数跨丢弃率可迁移(Fig. 3),从机理上解释并修复了先前文献观察到的精度退化。其二是'课程式训练'洞察:递减时间表(DTS)让训练初期以高噪声迫使模型在浅有效深度上探索(相当于随机版模型生长/课程学习,有效深度随训练平滑增长,3.9B 模型初始有效深度仅 $0.6L$),末期衰减到零让模型在完整深度上稳定收敛;配合深度方向递增的 ILD(浅层少丢、深层多丢),首次在 906M、5% FLOPs 节省下把验证损失做到 1.951,优于密集基线的 1.953(−0.06%)——即在更少算力下打败密集训练。
方法步骤详情
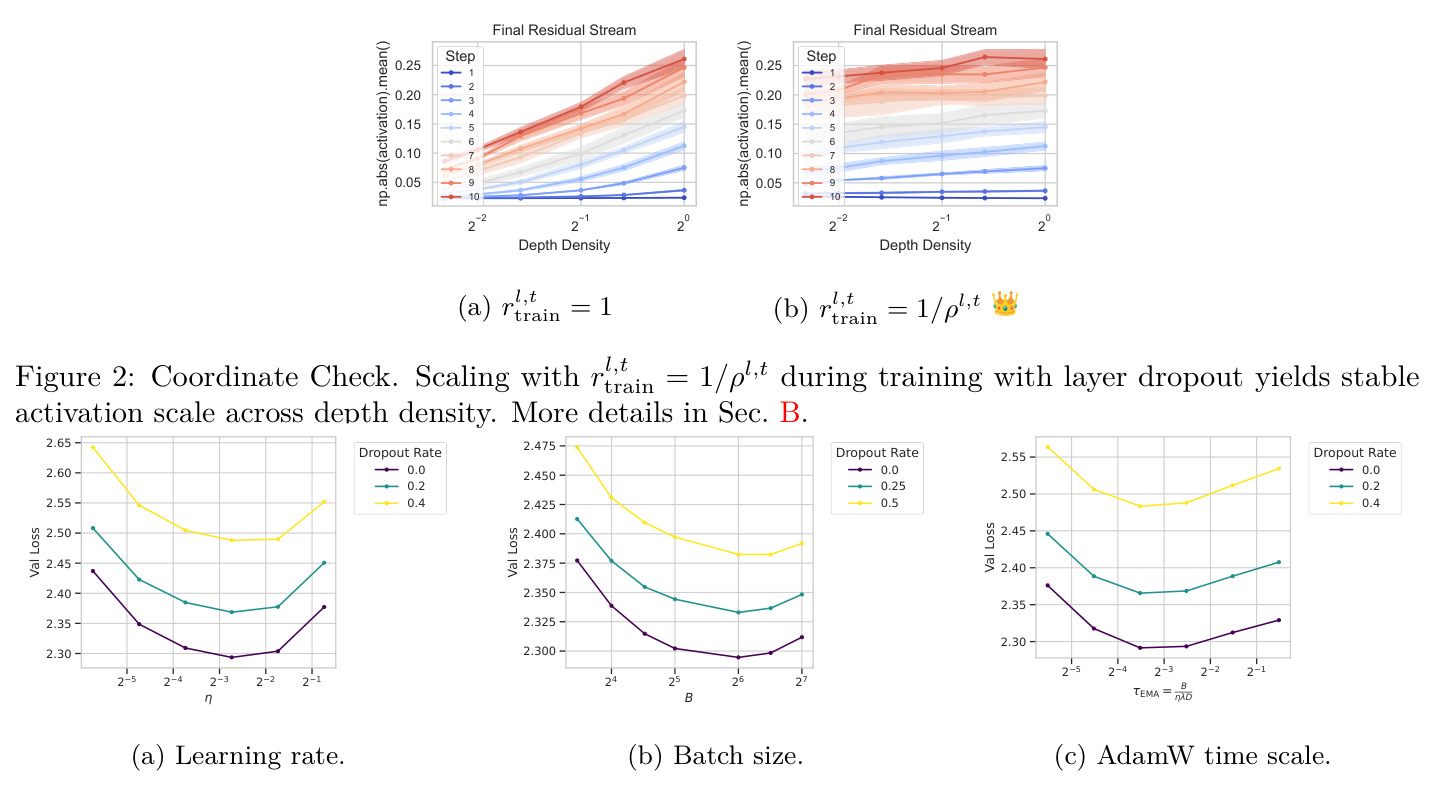
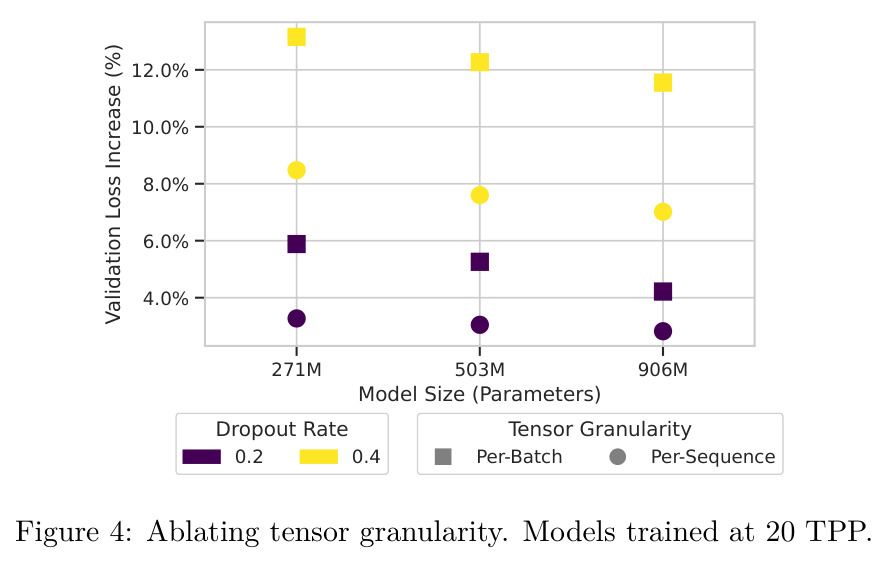
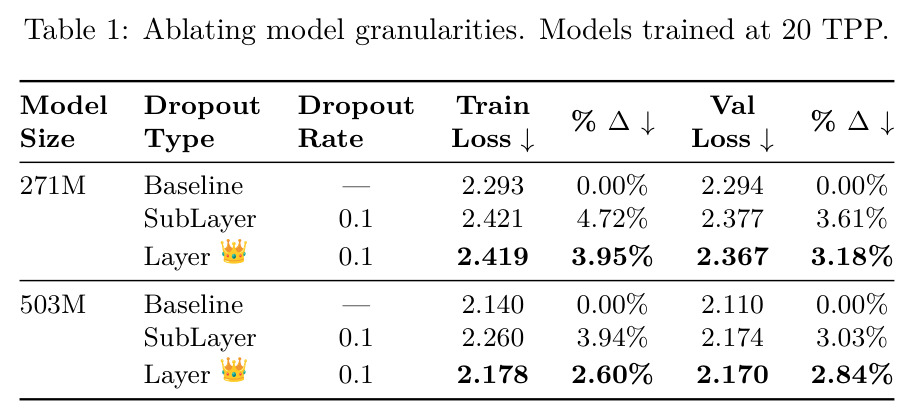
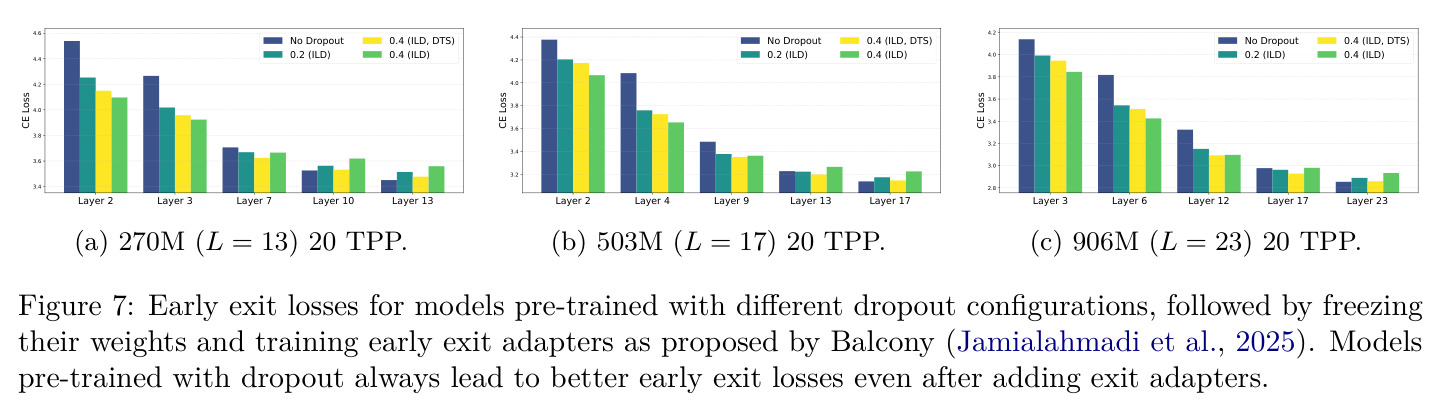
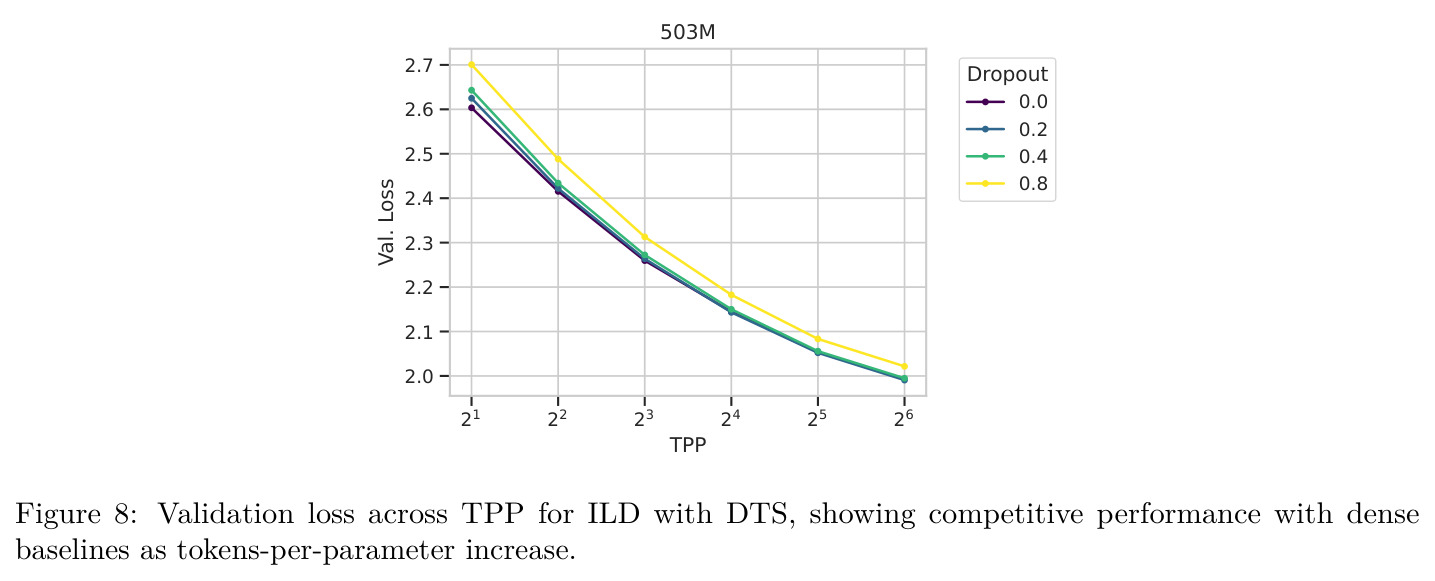
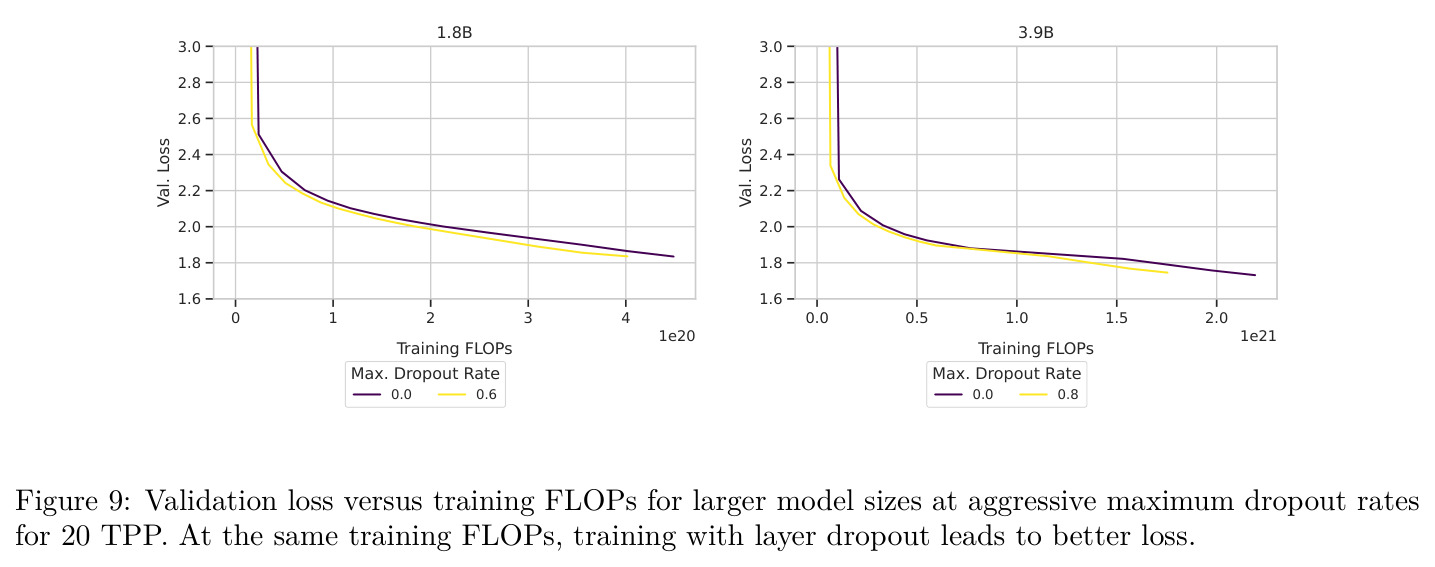
(1)形式化与高效实现:训练时 $H_{\ell+1,t}=H_{\ell,t}+r^{train}_{\ell,t}M_{\ell,t}f_\ell(H_{\ell,t})$,掩码按序列独立采样;实现上只对 $M[b]=1$ 的序列执行 $f_\ell$,直接省去该层 $p$ 比例计算;推理时 $r^{eval}=1$。(2)定标:40 层模型上做坐标检查,$r^{train}=1$ 时激活尺度随深度密度漂移、$1/\rho$ 时稳定(Fig. 2、A.1),据此采用 Table A.2 迁移规则。(3)粒度消融:整层 vs 子层(Table 1)、按序列 vs 按批(Fig. 4)。(4)分布与时间表消融:Uniform/ILD/ALD 按等平均丢弃率分组比较(Table 2),Constant/ITS/DTS 按等总节省 $\bar{P}$ 分组比较(Table 3),其中 ILD 为 $p_\ell=\frac{\ell}{L-1}p_{max}$,DTS 为 $p_t=(1-\frac{t}{T})p_\ell$。(5)推理评估:静态早退(Fig. 5/A.2)、中间层跳过(Fig. 6/A.3)、Balcony 框架 KL 自蒸馏退出适配器(Fig. 7)、Draft & Verify 自推测解码并以遗传算法/爬山/模拟退火搜索草稿层子集(Table 4)。(6)规模化:TPP 从 $2^1$ 扫到 $2^6$(Fig. 8),hero run 以 $p_{max}=0.6/0.8/0.99$ 训练 1.8B/3.9B/8.2B(Table 5、Fig. 9)。
技术新颖性
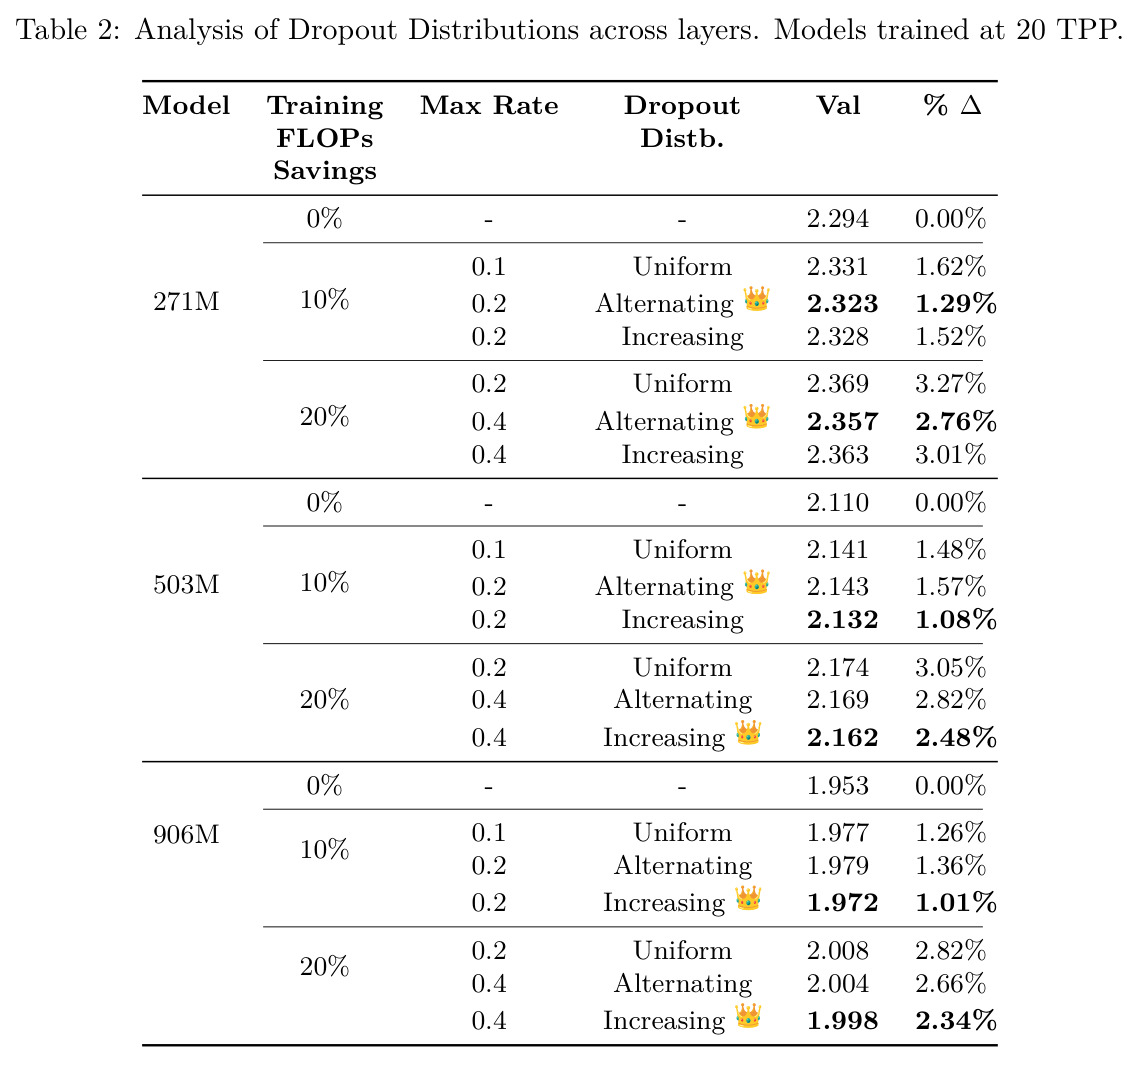
技术新颖性体现在五个'第一次':(1)第一次为层Dropout 联合优化优化器超参数并给出可迁移规则(Table A.2 中 dropout 以 $\rho^{-1}$ 进入残差缩放),此前论文连缩放因子都各写各的;(2)第一次在等 FLOPs 下系统比较层/子层、批/序列、Uniform/ILD/ALD、Constant/ITS/DTS 四个设计轴,并揭示它们之间不可忽略的交互(如 ITS 在高丢弃率下灾难性恶化 +6.5%以上,DTS 仅 +1.6%~2.9%);(3)第一次证明单 epoch 大规模场景下层Dropout 能以更少 FLOPs 追平乃至超越密集基线,推翻'dropout 在现代规模必然有害'的主流认知;(4)发现平均训练丢弃率可以预测零样本跳层/早退鲁棒性,把'训练配方'与'推理弹性'定量联系起来;(5)把激进丢弃率推到前所未有的 $p_{max}=0.99$(8.2B 模型),而此前工作大多停在 0.1–0.2。整条路线不改架构、不加参数、不加损失,工程侵入性极低。
实验结果
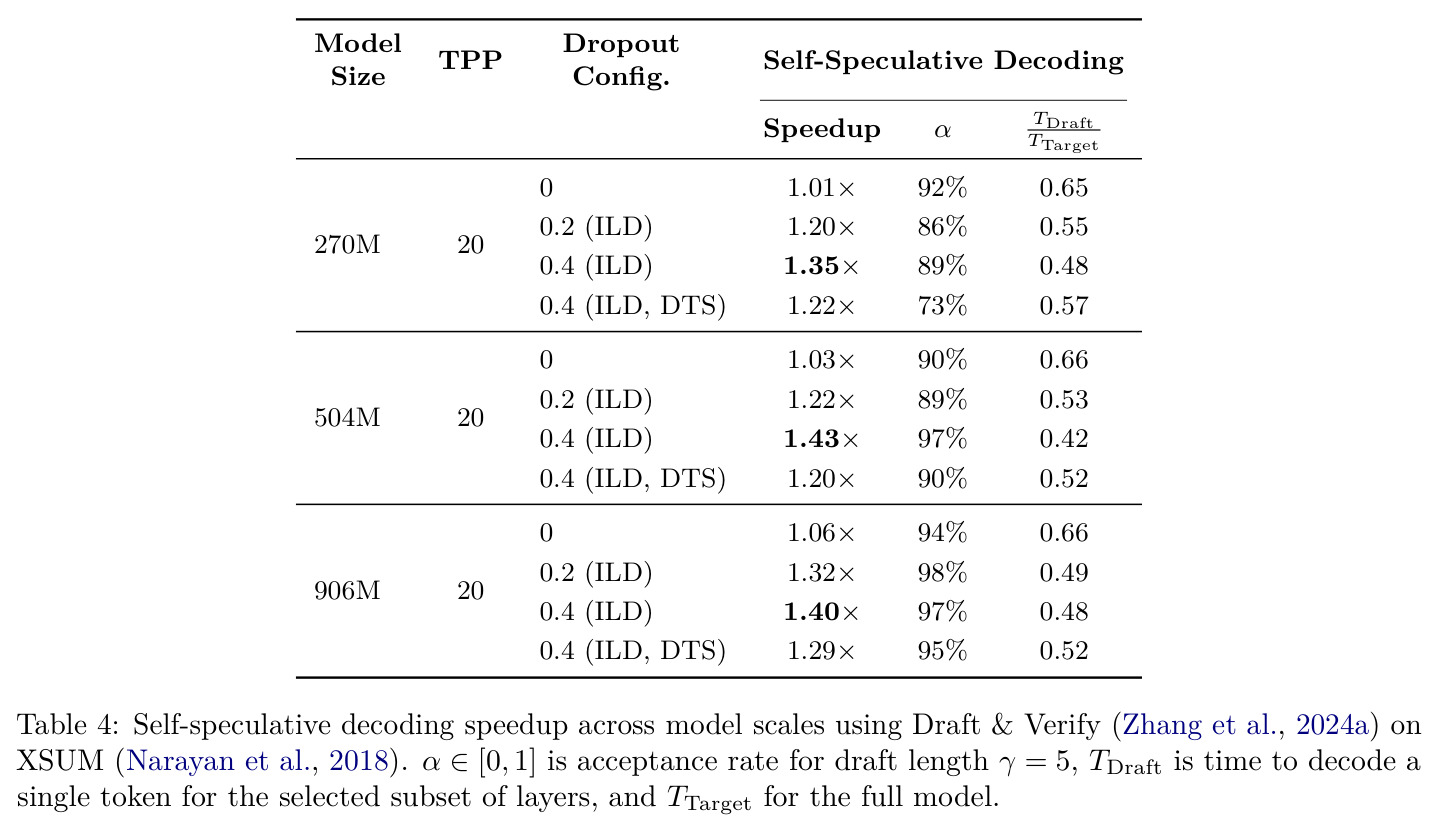
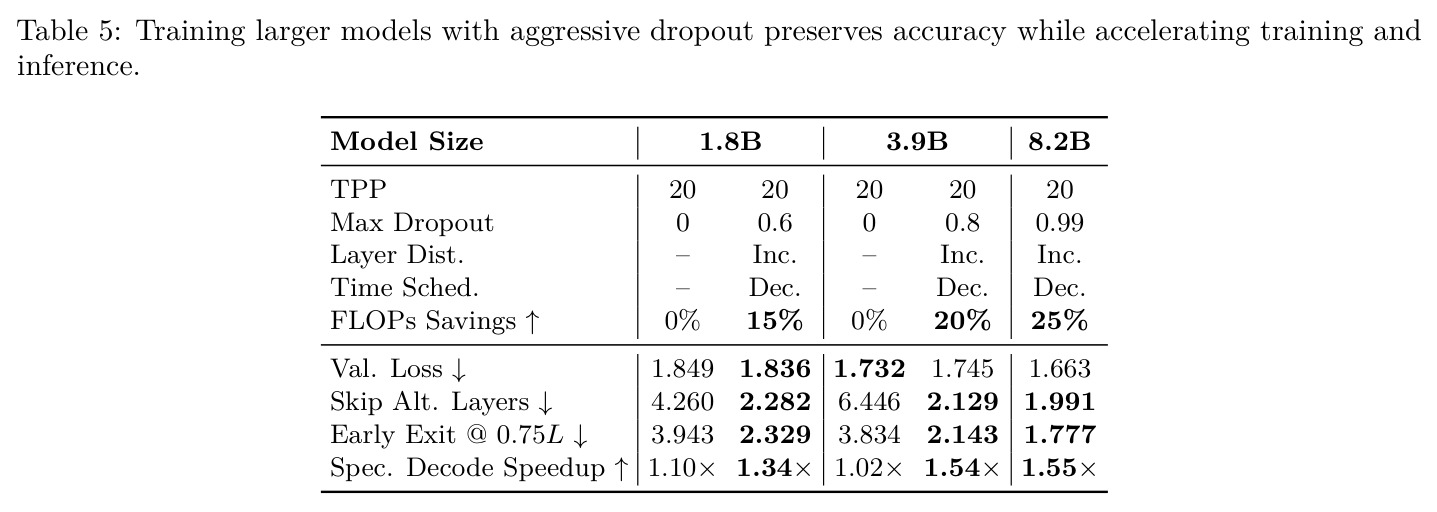
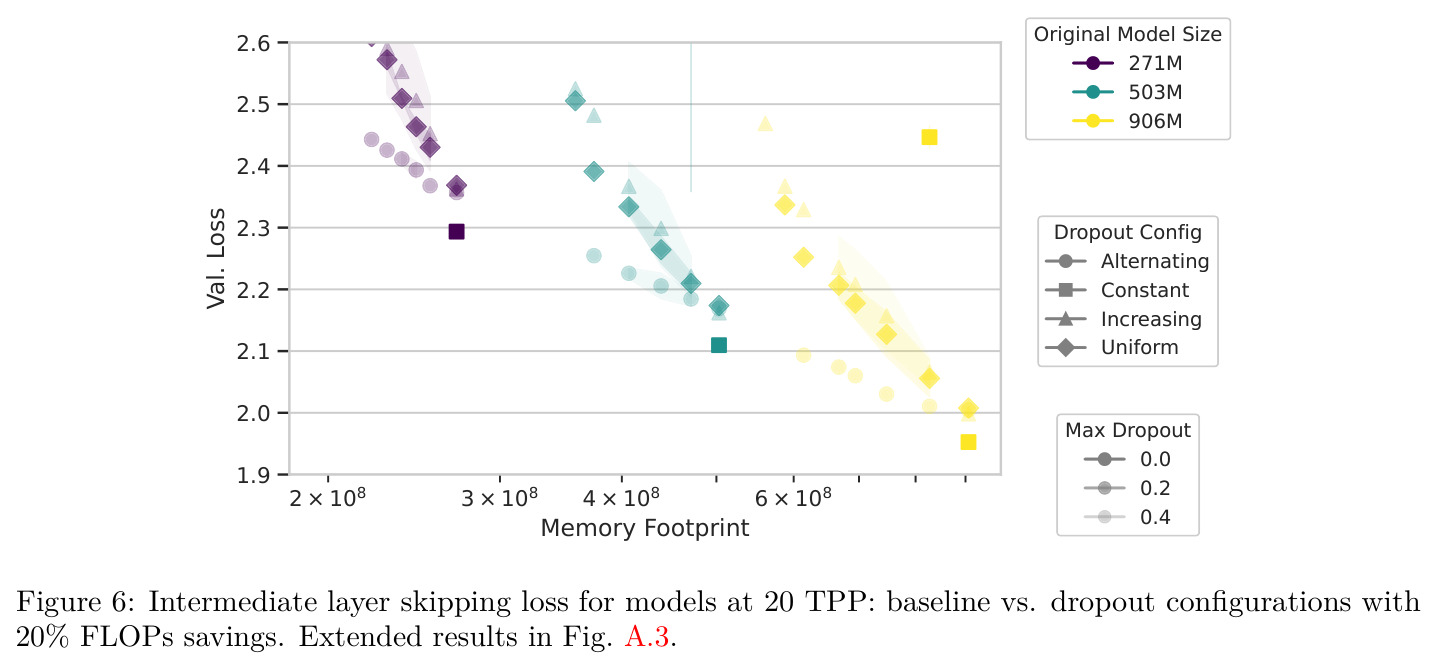
实验链条环环相扣。定标:$r^{train}=1/\rho$ 使最优 $\eta$、$\lambda$、$B$ 跨 0–0.4 丢弃率几乎不变(Fig. 3)。粒度:丢弃率 0.1 时整层优于子层(271M 验证损失 2.367 vs 2.377),按序列优于按批(Fig. 4)。深度分布:等 FLOPs 下非均匀胜均匀,906M、20% 节省时 ILD(+2.34%)优于 ALD(+2.66%)与均匀(+2.82%),但最小模型上 ALD 最优(Table 2)。时间表:DTS 全面胜出,906M、5% 节省时 ILD+DTS 损失 1.951 首次以更少 FLOPs 击败密集基线 1.953;ITS 在 20% 节省时恶化 +6.5%~7.0%,DTS 仅 +1.6%~2.9%(Table 3)。推理侧:所有早退点上 dropout 模型损失更低且递减表不牺牲弹性(Fig. 5);跳层场景 ALD 退化最平缓,密集基线立即崩坏(Fig. 6);叠加 Balcony 适配器后 dropout 预训练仍全面领先(Fig. 7)。自推测解码(Table 4):270M/504M/906M 从 1.01×/1.03×/1.06× 提至 1.35×/1.43×/1.40×。规模化:高 TPP 下退化稳定在约 0.5% 内(Fig. 8)。Hero run(Table 5):1.8B 以 $p_{max}=0.6$ 省 15% FLOPs 且损失 1.836 优于基线 1.849;3.9B 以 0.8 省 20%(1.745 vs 1.732);8.2B 以 0.99 省 25%;3.9B 跳隔层损失 2.129 vs 6.446、0.75L 早退 2.143 vs 3.834、自推测 1.54× vs 1.02×,8.2B 达 1.55×;下游任务基本持平(Table A.3)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 大规模预训练(1.8B,20 TPP) | 验证损失 / 训练FLOPs | 1.836($p_{max}=0.6$,ILD+DTS),训练 FLOPs 节省 15% | 1.849(密集基线,0% 节省) | 验证损失降低 0.7%,同时训练算力少用 15% |
| 大规模预训练(3.9B / 8.2B,20 TPP) | 验证损失 / 训练FLOPs | 3.9B:1.745($p_{max}=0.8$,省 20%);8.2B:1.663($p_{max}=0.99$,省 25%) | 3.9B:1.732(密集);8.2B 未报告密集对照 | 以 20%/25% 更少 FLOPs 保持与密集基线相当(+0.75%)的损失 |
| 自推测解码(XSUM,Draft & Verify,$\gamma=5$) | 解码加速比 | 906M:1.40×(0.4 ILD);3.9B:1.54×(0.8 ILD+DTS);8.2B:1.55×(0.99) | 密集模型:906M 1.06×;3.9B 1.02×;1.8B 1.10× | 相对密集基线提升约 32%–51%,密集大模型几乎无法从自推测中获益 |
| 零样本静态剪枝(跳过隔层推理) | 交叉熵损失 | 3.9B:2.129;1.8B:2.282 | 密集模型:3.9B 6.446;1.8B 4.260 | 损失分别下降约 67% 与 46%,模型可无损降级到更小规模档位 |
| 零样本早期退出 @ 0.75L | 交叉熵损失 | 3.9B:2.143;1.8B:2.329 | 密集模型:3.9B 3.834;1.8B 3.943 | 损失分别降低约 44% 与 41% |
| 小规模等 FLOPs 对比(906M,5% 节省,20 TPP) | 验证损失 | 1.951(ILD 0.2 + DTS) | 1.953(密集基线) | 首次以更少训练 FLOPs 超越密集基线(−0.06%) |
局限与改进
作者承认的局限包括:超参数迁移在极高丢弃率下失效($\eta$、$\lambda$ 需下调,Fig. 3 右端),且迁移规则主要在常值时间表下验证、尚未针对最优的 DTS 重新推导;只研究了 Transformer 块级粒度,未探索注意力头或神经元级;未与 Mixture-of-Depths 等学习式深度优化对比;未验证 MoE 或非 Transformer 架构;没有预测最优 $p_{max}$ 的缩放律;各类推理收益也未随 TPP 扫描量化。我的补充观察:所有收益均以 FLOPs 计,按序列丢弃只有在算力受限(大 batch、长上下文)时才能兑现为墙钟加速,且实验全部在 Cerebras CS-3 上完成,GPU 端到端收益未验证;小模型在 20% 节省下仍有约 +2.9% 的损失退化,小算力用户受益有限;ALD 利于跳层但早退很差、ILD 反之,配置必须在训练前锁定;自推测解码的草稿层组合搜索成本未报告;8.2B 缺少密集基线对照,且数据语料与代码均未公开。
独立分析的弱点
第一,墙钟收益存疑:按序列层Dropout 省 FLOPs 的前提是训练处于算力受限区,若批小、序列短,权重加载开销会吞噬收益,论文未给出任何 GPU 上的端到端吞吐数据。改进方向:报告跨硬件墙钟结果,或探索按设备/梯度累积步丢批的折中实现。第二,早退与跳层的最优分布不一致(ILD 利早退、ALD 利跳层),用户必须提前二选一。改进方向:训练时混合两种分布,或训练后用轻量持续预训练转换弹性类型。第三,激进丢弃率下超参需重调、迁移规则失效,8.2B + $p_{max}=0.99$ 的成功依赖人工搜索。改进方向:把 $\rho$ 显式纳入 µP 的深度缩放指数重新推导,或开发自动超参搜索。第四,自推测解码的草稿层子集搜索是组合优化,每模型搜索开销未量化,且 270M 的 0.4(ILD,DTS) 配置接受率仅 73%。改进方向:用训练期丢弃统计直接启发式选层,省去搜索。第五,下游任务无置信区间与多种子报告,小模型指标噪声大(Table A.3 中出现 0.5241 这类四位小数疑似修正值),结论稳健性存疑。
未来方向
作者提出的方向:把 DTS 最优时间表纳入超参迁移规则的重新推导;探索中训练、SFT 或继续预训练阶段的 dropout 时间表;测试注意力头/神经元等其他粒度能否引发类似结构弹性;与 Mixture-of-Depths 等路由式动态深度正面对比;扩展到 MoE 与非 Transformer 架构;建立预测最优 $p_{max}$ 的缩放律;量化推理收益随 TPP 的演化;实现动态早退(按词元的路由/启发式退出)。基于成果可延伸的方向:结论部分提出的'渐进容量课程'可推广到宽度、量化位宽、非结构化稀疏等其他维度,形成统一的'模型生长'训练框架;用训练期丢弃统计替代组合搜索来挑选自推测解码的草稿层;将层Dropout 与量化感知训练、剪枝微调组合,检验多条压缩轴的叠加效应;在开源模型与 GPU 栈上复现验证,检验配方跨硬件、跨数据的普适性。
复现评估
复现难度中等偏上。不利因素:论文未提及开源代码;全部预训练在 Cerebras CS-3 晶圆级系统上完成,外界无法获得同款硬件;数据仅描述为'多样化自然语言与代码语料',未给出精确配比;hero run(8.2B、160B 词元)算力远超学术实验室常规。有利因素:方法极易实现——PyTorch 中约二十行即可完成按序列丢层(保留分支乘 $1/\rho$);架构超参全部公开(Table A.1:271M 为 $d=640, L=13$,8.2B 为 $d=2688, L=52$,均用 ALiBi + squared ReLU + Llama3 词表,参照公开的 Celerity 模型);配方完整(ILD 公式 $p_\ell=\frac{\ell}{L-1}p_{max}$、DTS 公式 $p_t=(1-\frac{t}{T})p_\ell$、$r^{train}=1/\rho$、$r^{eval}=1$、Table A.2 迁移规则);核心结论出自 271M–906M、20 TPP 的小规模实验,研究组用数张 GPU 数周即可复现主表。建议路径:先在 271M 重现 Table 3 的 DTS 优势,再验证早退/跳层弹性与自推测加速。
论文图表
271M 模型上对学习率、批大小、AdamW 时标随丢弃率(0–0.4)的扫描热图:采用 $r^{train}=1/\rho$ 后,各超参的最优值跨丢弃率基本不变,证明超参数可迁移;极高丢弃率处 $\eta$、$\lambda$ 略有下降。
验证联合优化框架的基石——免去了为每个丢弃率重新调参的成本,是整个方法学可信度的核心支撑。
非均匀(递增 ILD)分布下的坐标检查:$r^{train}=1/\rho_{l,t}$ 时激活尺度在各深度密度下保持稳定。
证明 $1/\rho$ 定标不仅适用于均匀丢弃,也覆盖推荐的 ILD 配置,补全 Fig. 2 的证据链。
早退完整消融:(a) ILD 不同 $p_{max}$;(b) 同 $p_{max}=0.2$ 下 ILD/ITS/DTS/常值/ALD 对比——ALD 几乎无早退收益而其余均有,DTS 表现最佳;(c) 1.8B/3.9B/8.2B 激进配置的早退曲线。
补充正文 Fig. 5 未覆盖的配置对比与大规模结果,是早退结论的完整证据链。
跳层完整消融:(a)(b) ALD 下不同丢弃率的损失-显存曲线及放大图;(c) 同 $p_{max}=0.2$ 下各配置对比(ALD 优于 ILD);(d) 1.8B/3.9B/8.2B 大规模结果,8.2B 以 $p_{max}=0.99$ 训练后跳层损失仍保持约 2.0。
与 Fig. 6 互补,给出跳层弹性的完整数据支撑,包括 ALD 优于 ILD 的关键对比与大规模验证。
六个模型规模的架构参数:271M($d=640, L=13$)、504M($d=896, L=17$)、906M($d=1152, L=23$)、1.8B($d=1536, L=30$)、3.9B($d=2048, L=40$)、8.2B($d=2688, L=52$),含注意力头数、头维度与 FFN 倍率(8)。
复现实验与理解'深度弹性随层数增长'现象的基础信息。
完整超参数迁移规则表:宽度、深度、数据、层密度 $\rho$ 各维度的缩放公式,如残差块输出按 $m_L^{-1}\rho^{-1}$ 缩放、批大小按 $m_D^{0.4}$ 缩放、AdamW 时标按 TPP 缩放等;dropout($\rho$)作为本文新增维度被正式纳入参数化体系。
论文方法学的操作手册:是把小模型调参结论推广到任意模型规模与丢弃率的关键工具。
11 个下游任务(BBH、PIQA、SIQA、HellaSwag、WinoGrande、ARC-c/e、OBQA、Lambada、COPA、RACE)准确率:各规模 dropout 配置与密集基线基本持平,如 3.9B $p_{max}=0.8$ 时 BBH 0.270 vs 0.272、PIQA 0.668 vs 0.666、WinoGrande 0.563 vs 0.555。
证明验证损失的持平能传导到下游能力,是层Dropout 配方实用性的必要论证。