MaxKernel:面向 TPU 的智能体内核生成系统 MaxKernel: Agentic Kernel Generation for TPUs
多智能体系统自动生成并优化 TPU 内核,几何平均加速 1.58 倍,媲美人类专家
前置知识
TPU 与自定义内核
TPU 是谷歌为深度学习设计的专用加速器,其编译器 XLA 会把计算图自动编译为硬件指令,但对特定算子生成的代码往往不是最优。自定义内核指工程师用底层编程接口直接编写在芯片上运行的代码,绕开标准编译管线,以充分利用片上内存、DMA 与计算单元。这类工作通常要手工管理内存层级、排布数据搬运与多维分块。
全文的核心任务就是让智能体自动写出这类内核,理解其难度与优化对象是读懂动机、方法与结果的前提。
JAX 与 Pallas
JAX 是谷歌的数值计算与自动微分框架,默认通过 XLA 编译执行;Pallas 是 JAX 的自定义内核扩展,允许用户以分块(tile)编程模型直接控制 TPU 的向量内存 VMEM、DMA 搬运与循环结构,最终编译到 Mosaic 底层指令。它是 TPU 生态中对应 CUDA/Triton 的存在。
MaxKernel 生成的目标代码就是 Pallas 内核,所有基准与对比都在 JAX/Pallas 体系内进行,不懂这套栈就看不懂实验设置。
LLM 智能体
智能体指以 LLM 为核心、能调用工具、多步迭代执行任务并利用环境反馈(如编译报错、测试结果、性能剖析)自我修正的系统。多智能体系统进一步把复杂任务拆分给多个职责单一的子智能体,由编排器协调,以提升长任务上的可靠性与可维护性。
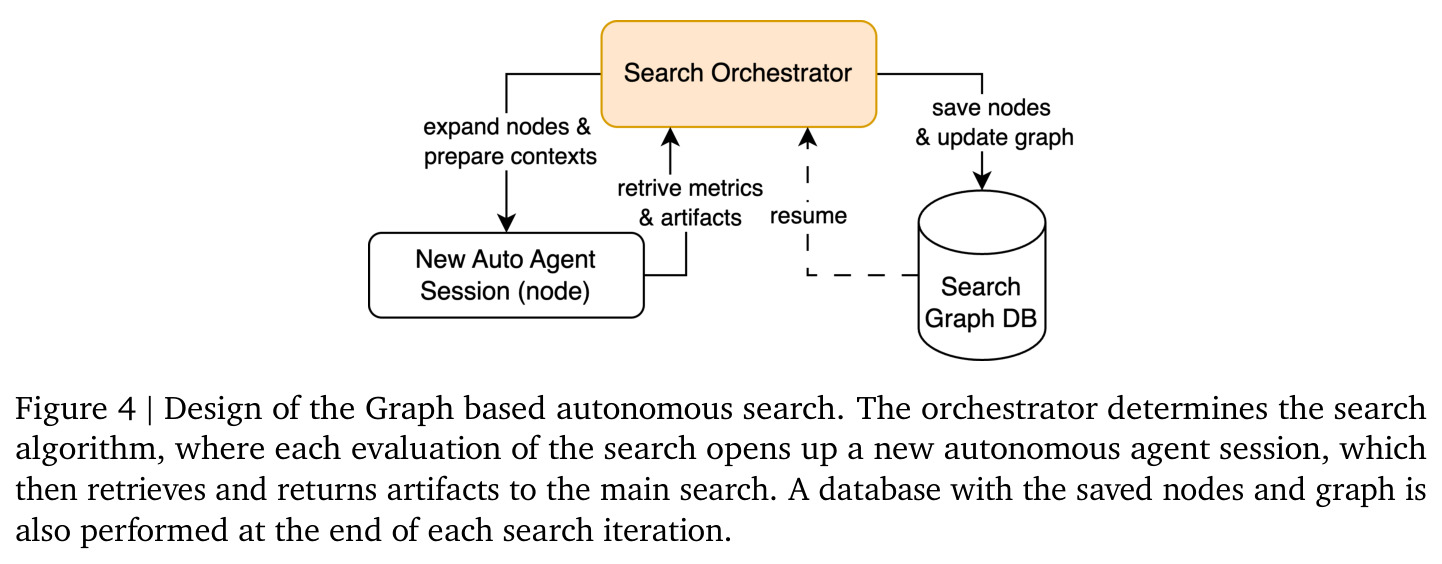
MaxKernel 的规划、实现、测试、调优、剖析均由专职子智能体完成,三种编排范式决定它们的协作方式,这是方法部分的骨架。
RAG 检索增强生成
把外部文档切分并建立索引,在生成时按需检索相关片段注入上下文,避免把全部规格塞进有限的上下文窗口。本文的知识库限定为静态来源:Pallas、Mosaic、XLA 等框架文档、内存布局指南与性能手册,并刻意排除人工调优过的内核代码。
知识库是子智能体获取 TPU 硬件知识的机制,其'不含人类内核'的设计直接影响对'智能体能否自主发现优化'这一结论的解读。
XProf 硬件剖析
XProf 是面向 TPU 的性能剖析工具,能捕获片上真实执行时间、内存带宽利用率、计算密度等低层指标,并过滤主机侧的 JAX 调度与编译开销。剖析智能体用它把内核瓶颈转成可执行的反馈,指导下一轮算法优化。
剖析信号是 Auto 循环里驱动持续改进的核心反馈来源,也是论文保证所报加速比反映真实硬件性能而非框架噪声的手段。
束搜索
一种启发式图搜索策略:逐层扩展候选节点,每层只保留评分最高的 top-k 个继续扩展,其余剪枝,在探索广度与计算成本之间折中。本文的束搜索配置为宽度 3、最大深度 3、每节点 2 个扩展分支、每节点内层仅 2 次迭代。
它是图搜索范式的两种实现之一,理解束搜索与并行搜索的预算差异,才能看懂论文对两者性能权衡的分析。
fast_p 指标
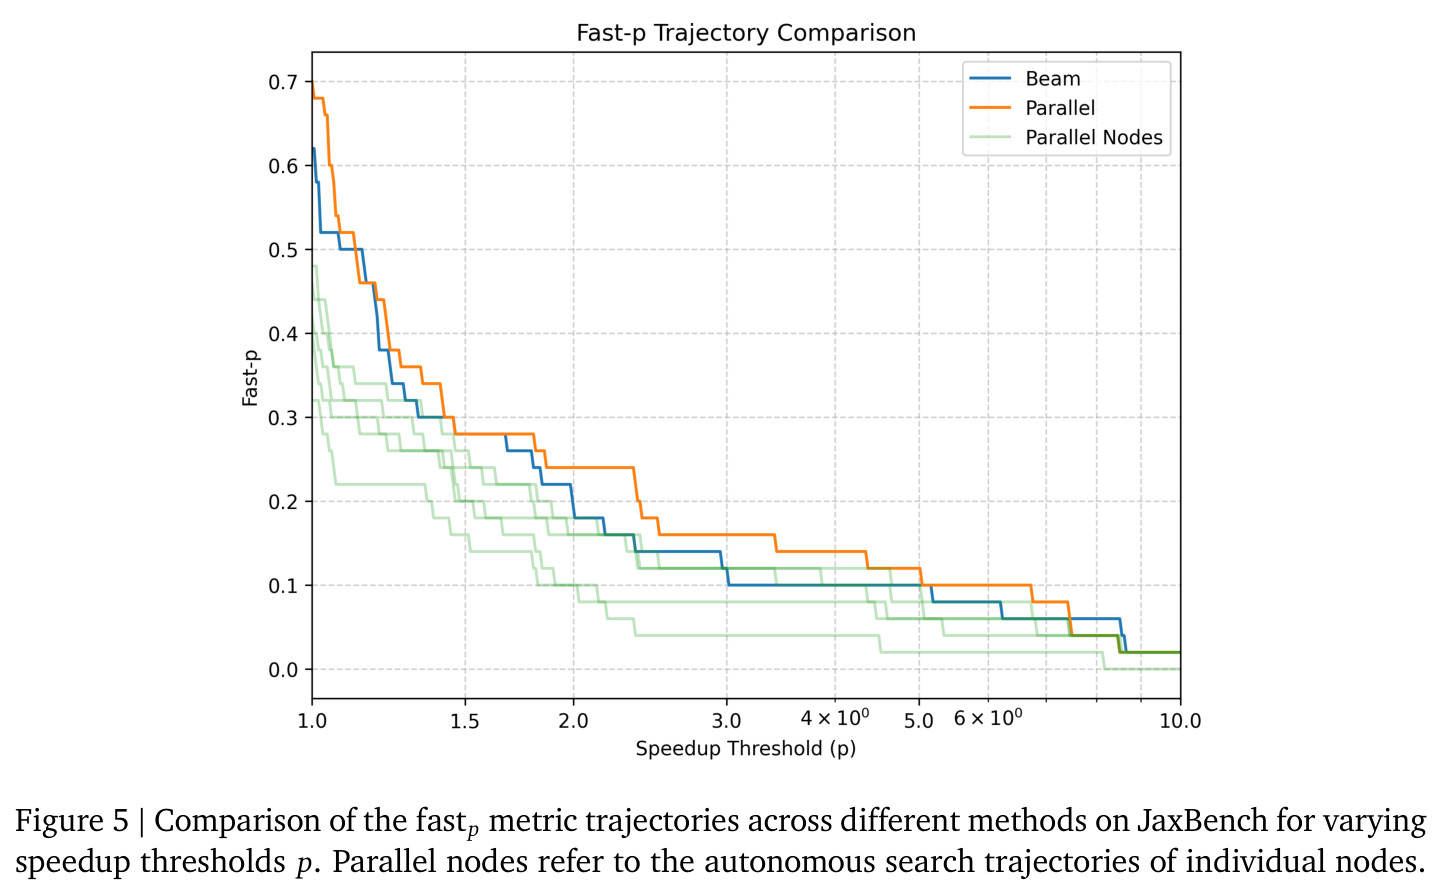
综合衡量生成内核质量的任务占比指标,统计同时满足功能正确且加速比超过阈值 $p$ 的任务比例:$\mathrm{fast}_p = \frac{1}{N}\sum_{i=1}^{N} \mathbb{1}(\mathrm{correct}_i \land \mathrm{speedup}_i > p)$。fast1 即要求加速超过 1 倍,是论文的核心汇总指标之一。
论文用 fast$_p$ 轨迹对比各方法优劣,Figure 5 整张图都建立在这个指标上,不掌握它就无法解读核心实验。
内存层级与 DMA
TPU 片上 VMEM 容量小但带宽极高,片外 HBM 容量大但相对较慢,数据需经 DMA 在两者间搬运。高性能内核的关键手法包括精心设计 tile 让中间结果常驻 VMEM、编排 DMA 流水线使计算与搬运重叠,避免昂贵的 HBM 刷新。
论文反复出现的优化手法(如把中间矩阵保留在 VMEM)都建立在这一硬件模型上,不理解它就无法理解智能体到底在优化什么。
研究动机
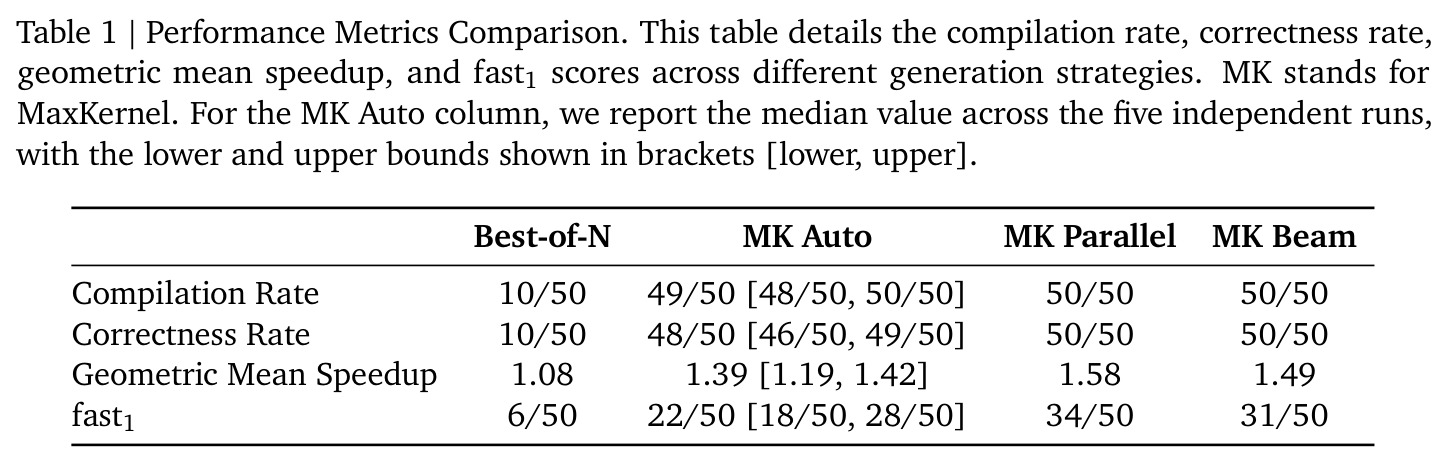
为 TPU 这类加速器编写高性能自定义内核是门槛极高的工程活:工程师要绕开标准编译器管线,手工管理 HBM 与 VMEM/SRAM 之间的内存层级、编排 DMA 流水线、推导多维分块策略,才能榨干硬件算力。纯 LLM 的零样本/少样本生成在这类任务上表现很差——加速器 API 僵化、内存约束严格、底层编译器报错晦涩,即使生成了功能正确的代码,要达到理想性能还必须依赖 XProf 等工具做多轮经验性剖析与配置调优。论文在 JaxBench 上的实测非常直白:Best-of-N(N=100)零样本方法只有 10/50 的编译通过率、10/50 的正确率,几何平均加速仅 1.08 倍、fast1 只有 6/50,几乎等于没优化。传统编译器方案如 Halide、TVM、Ansor 虽将算法与调度解耦,但仍需要大量领域知识或昂贵的进化搜索;而 AutoComp 等近期 LLM 工作又可能在代码编译通过之前就放弃有希望的思路。
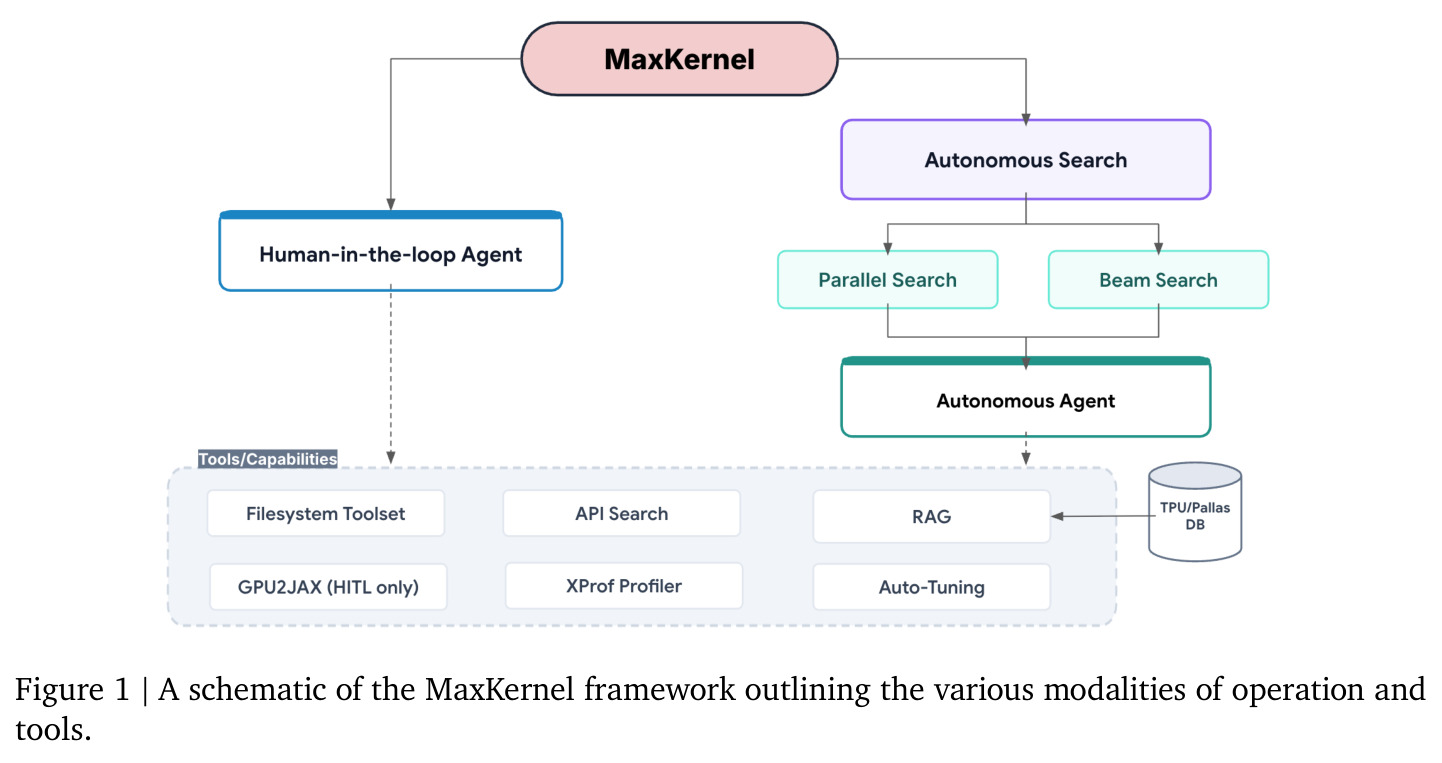
本文的目标是本文的目标是构建多智能体系统 MaxKernel,把 TPU 内核工程中规划、实现、调试、测试、调优、剖析的完整流程自动化,让智能体生成与专家手写内核相当甚至更优的 JAX/Pallas 代码。具体分解为三点:其一,设计模块化的专职子智能体(规划、实现、测试合成、执行、自动调优、剖析),与编译器管线和 XProf 剖析工具深度集成,为 LLM 提供真实的闭环硬件反馈;其二,提供三种可切换的编排范式——人在回路(HITL)、自主循环、基于图的自主搜索——让开发者在人工控制、快速自动迭代与大规模设计空间探索之间灵活权衡;其三,在 JaxBench 的 50 个多样化内核任务以及 MLA、Qwen3-Next Gated DeltaNet、DeepSeek-V4 等真实开源模型负载上,严格评估编译率、正确率、几何平均加速与 fast1 指标,最终达到 1.58 倍几何平均加速,并在有专家手写内核的 8 个生产负载上以 2.32 倍超过人工版的 2.02 倍。
与已有工作不同的是,与已有内核生成工作相比,本文的独特切入有三点。第一,反馈信号不止于编译器:多数工作只利用编译报错做修复循环,MaxKernel 把 XProf 剖析得到的延迟、内存带宽利用率、计算密度等连续指标直接回灌给下一轮规划,形成数据驱动的优化闭环,这是'懂硬件'的关键。第二,刻意的信息隔离:RAG 知识库只包含 Pallas、Mosaic、XLA 等框架文档与性能手册,明确排除人工调优过的内核代码,以检验智能体能否在'不抄人类作业'的前提下自主发现 TPU 特有优化,这让性能结论更有说服力。第三,把内核设计空间形式化为搜索图:每个节点保存代码、优化方案与实测指标,用并行搜索或束搜索在图上扩展,既缓解单轨迹的局部最优问题,又通过持久化图状态实现断点恢复,并把每次节点扩展隔离在独立智能体会话中避免上下文溢出。配套地,测试集在进入循环前被冻结,杜绝实现智能体篡改验证标准的 reward hacking。
核心方法
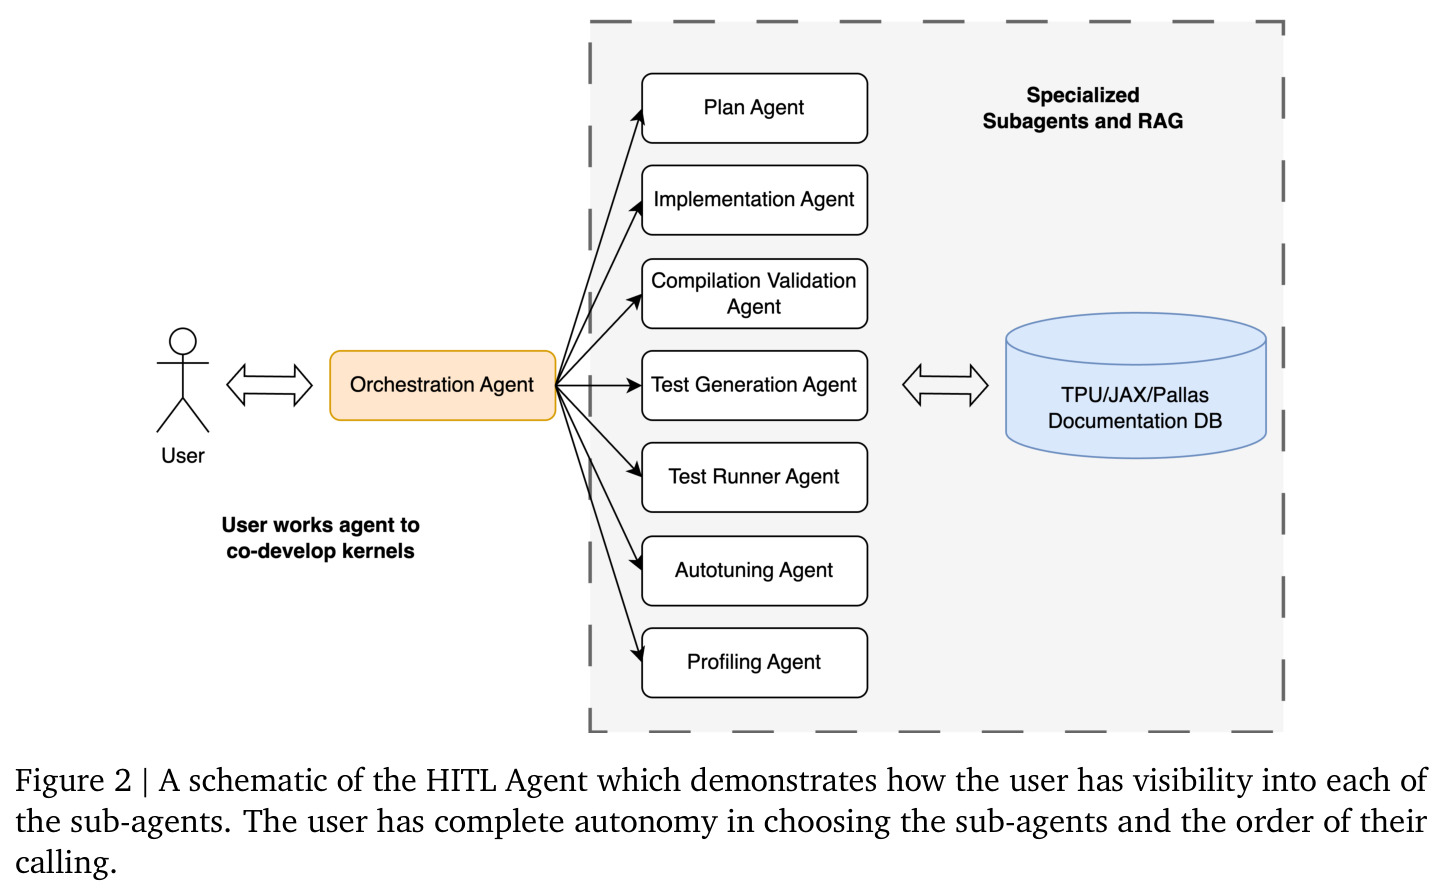
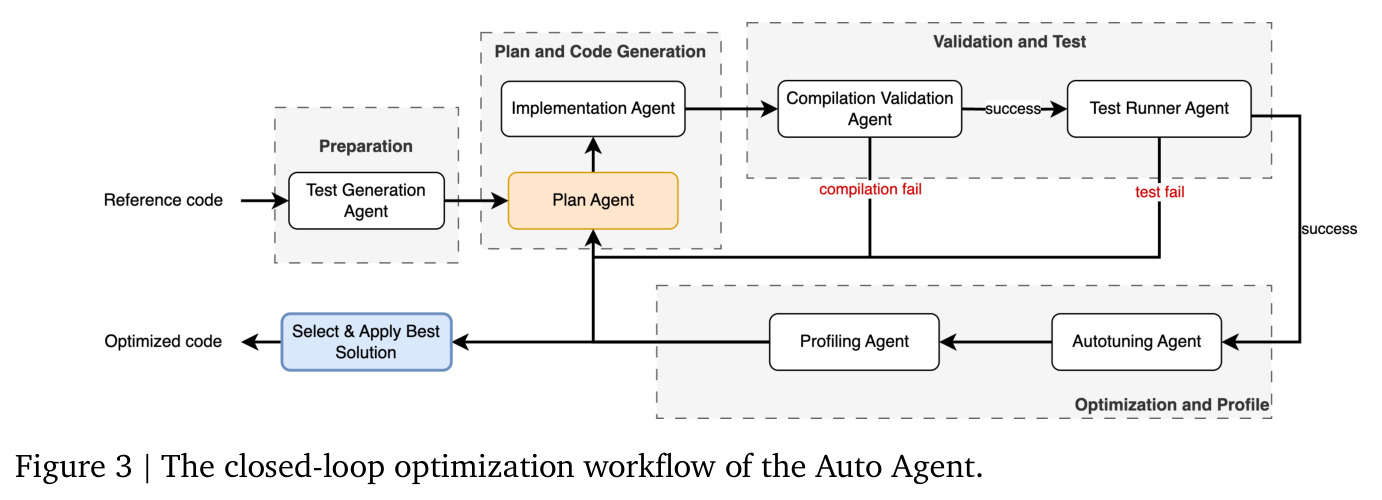
MaxKernel 的整体思路是:把内核工程拆成若干专职子智能体,用不同的编排范式把它们串成闭环,让编译器和硬件剖析器充当'裁判'提供真实反馈。直觉上它像一个懂硬件的自动化工程团队:规划智能体读参考实现与硬件规格制定优化方案,实现智能体把方案翻译成 Pallas 代码,验证循环反复编译修复直到通过,测试智能体按冻结的数值容差验证正确性,自动调优智能体遍历块大小等超参配置,剖析智能体用 XProf 抓取片上延迟与瓶颈,剖析结论再回灌下一轮规划。所有子智能体共享一个 RAG 知识库(Pallas/Mosaic/XLA 文档与性能手册,不含人工内核代码)。在此之上,三种编排范式对应三种使用场景:HITL 遵循'一次一个智能体然后等待'原则,让人类审阅每步产物;Auto 智能体全自动跑完迭代循环并回滚到历史最优快照;图搜索则把 Auto 包进并行搜索或束搜索做全局探索。全部实验基于 TPU v6e 硬件与 Gemini 3.1 Pro 模型。
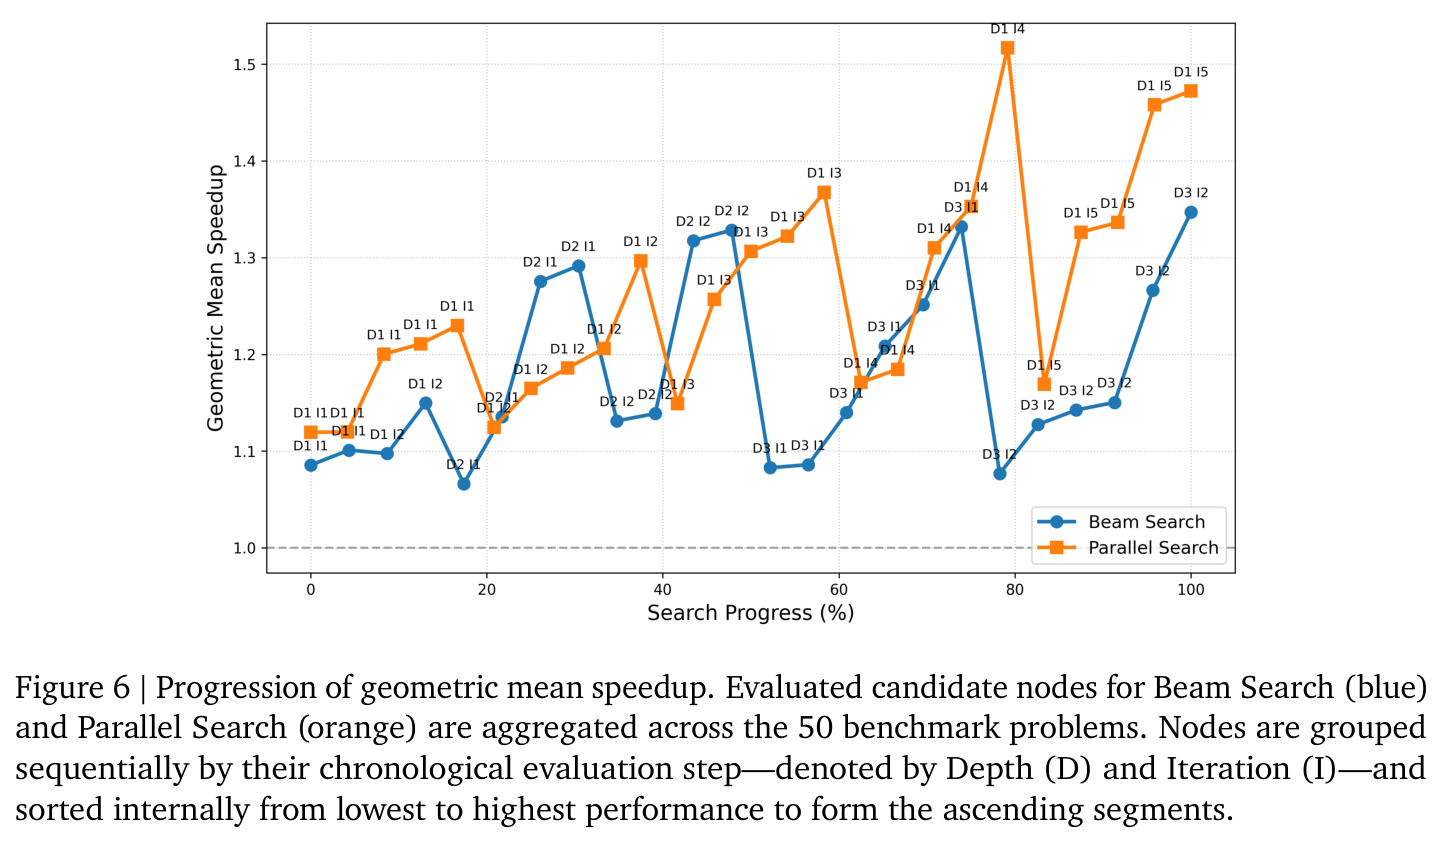
核心创新在于三套机制的结合。其一是冻结测试集:在进入迭代循环前,系统根据参考实现合成完整测试套件并严格冻结,下游实现智能体无法通过篡改验证标准来'作弊',保证所有正确性声明可信。其二是带状态回滚的自主循环:每次成功迭代都保存代码、编译状态、测试结果、延迟与剖析摘要的快照,流程结束时自动回滚到延迟最低的合法解以防性能回归;遇到编译修复超限或数值校验失败等致命错误时,保留错误上下文并短路回规划阶段换策略。其三是图搜索抽象:内核设计空间被建模为 SearchGraph,节点即 Auto 智能体的一次产出状态;并行搜索给每条轨迹 5 次迭代的深预算,束搜索保持宽度 3 的前沿、每节点仅 2 次迭代做激进剪枝。这直接解决了 Auto 单轨迹方差过大的问题(中位加速 1.39 倍但区间宽达 1.19 到 1.42 倍)。与 AutoComp 等先前工作的本质区别在于:本文第一次把人工协作、自动迭代与形式化搜索三种范式统一进一个框架,并用图结构隔离每次扩展的上下文窗口。
方法步骤详情
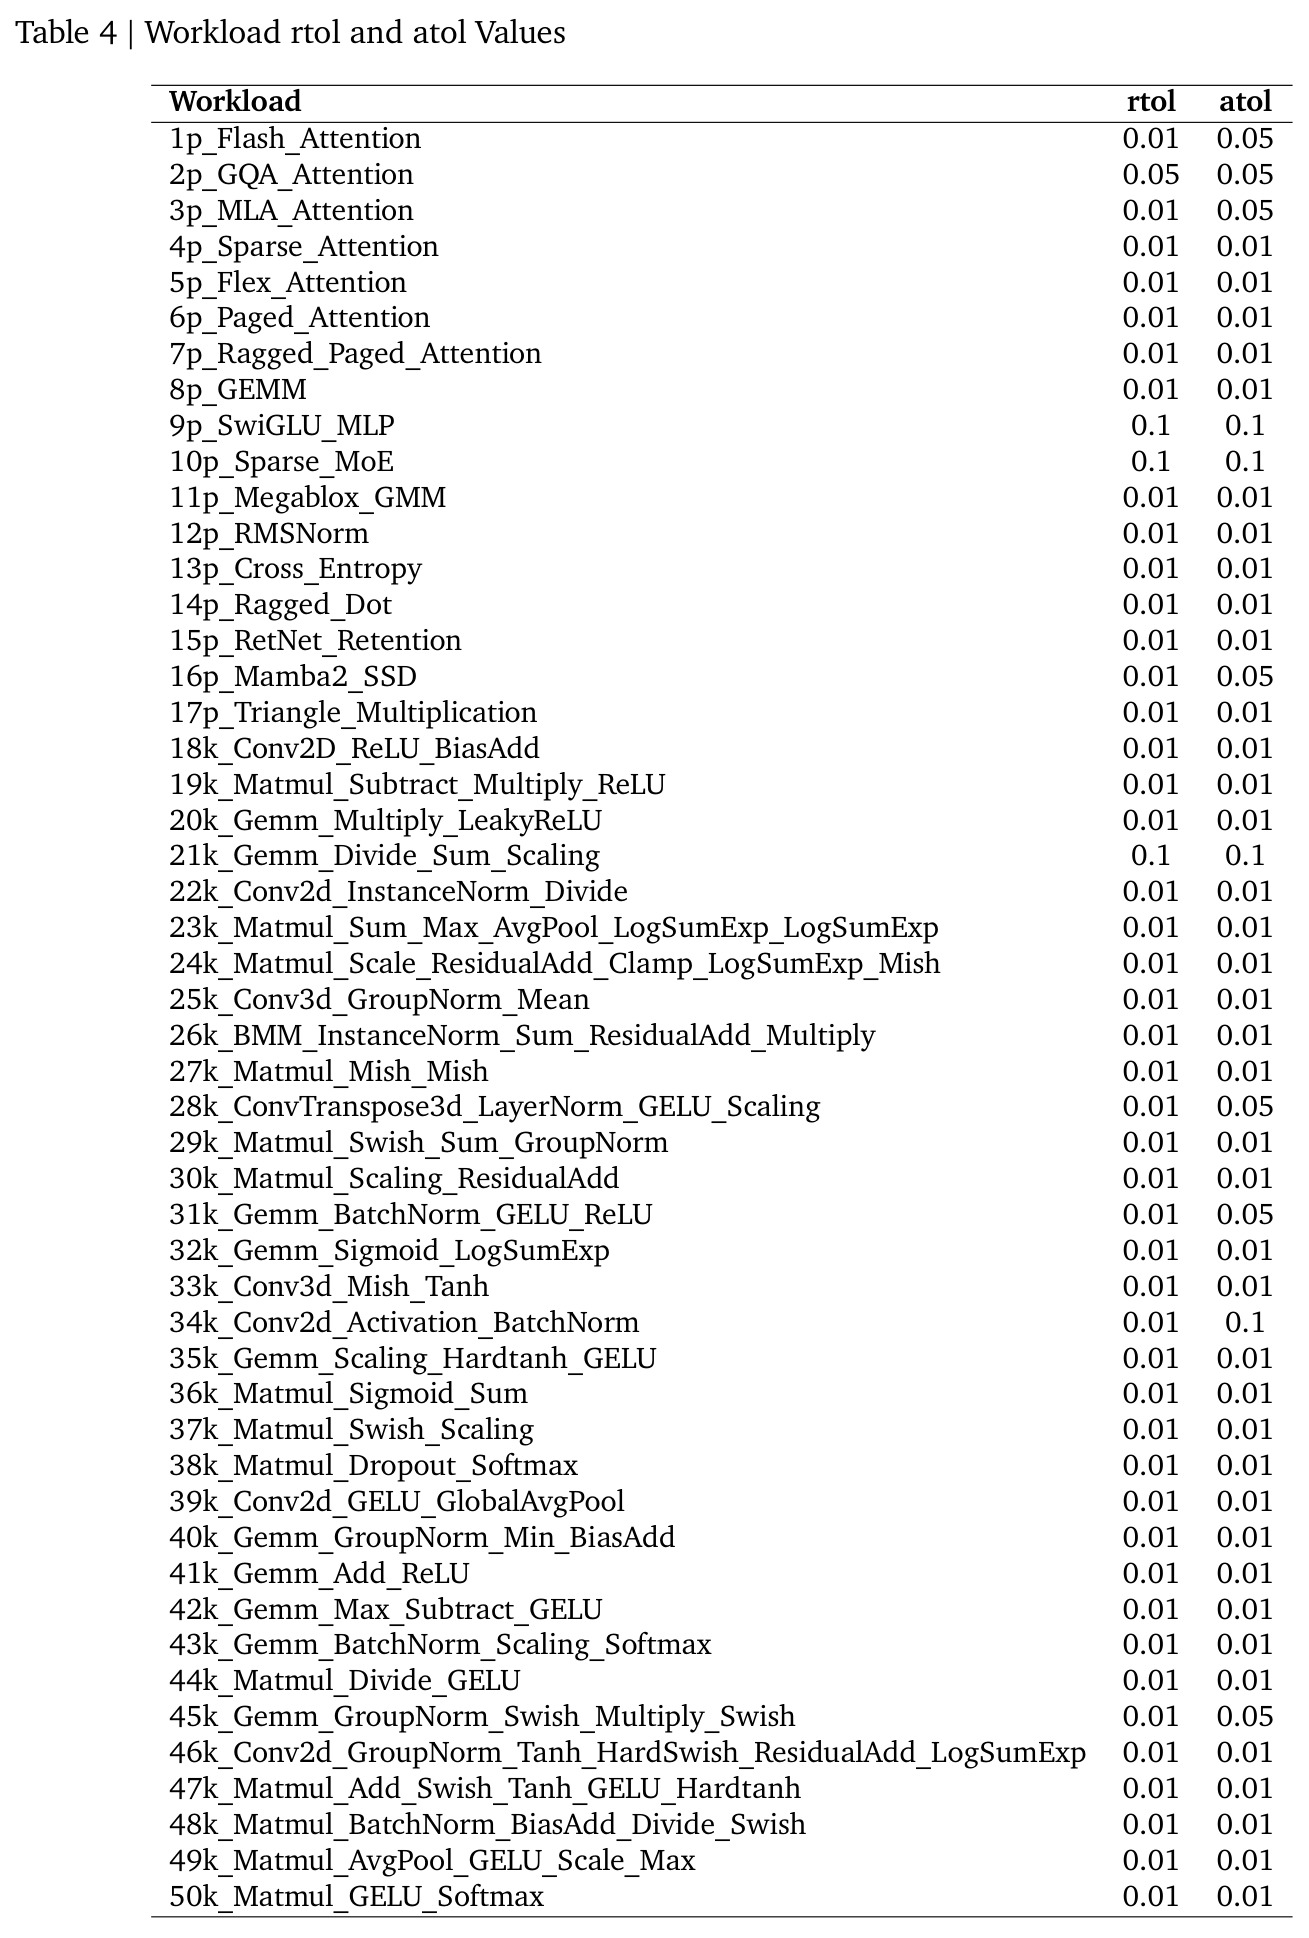
完整流程如下。准备阶段:给定任务(参考 JAX 实现、输入形状与数值容差,容差一般为 $\mathrm{atol}=\mathrm{rtol}=10^{-2}$,部分 bf16 任务放宽至 $10^{-1}$),测试合成智能体生成完整测试套件并冻结。进入 Auto 循环后依次执行:第一步,规划智能体基于硬件规格与参考实现输出高层优化方案;第二步,实现智能体把方案翻译成候选 Pallas 内核;第三步,编译验证循环反复编译、解读报错、修复,直到可编译,否则短路回规划;第四步,执行智能体运行冻结测试,用 jnp.allclose 校验与参考实现的数值等价;第五步,自动调优智能体遍历块大小、tile 维度等配置寻找最优参数;第六步,剖析智能体接入 XProf 抓取片上执行时间、带宽利用率与计算密度,反馈注入下一轮规划。为保证确定性,根编排器硬编码所有产物路径并注入子智能体提示与文件工具。图搜索在此之上:编排器按启发式从前沿选节点(束搜索取每层 top-k),分发到并行 worker 独立实例化 Auto 会话做扩展,结果作为新节点写回全局图并持久化,直到达到最大深度或目标延迟,返回最优节点。
技术新颖性
技术新颖性可从四个维度分析。架构上,不同于单智能体加工具调用的方案,MaxKernel 把规划、实现、调试、测试、调优、剖析拆成职责单一的子智能体,靠编排器协调,显著提升长任务的可靠性,且 HITL 模式下用户可自主选择子智能体及其调用顺序。反馈上,多数先前工作停留在编译报错和测试通过与否的二值信号,本文引入 XProf 的连续性能信号(延迟、带宽利用率、计算密度)驱动优化方向选择,这是真正利用硬件证据而非仅靠文本推理的关键。搜索上,把内核生成从线性迭代升级为图上的形式化搜索,且两种算法呈现清晰权衡:并行搜索深预算(每轨迹 5 次迭代)利于让复杂代码充分调试成熟,束搜索浅预算加剪枝(每节点 2 次迭代、宽 3、深 3、每节点 2 分支)利于探索容易编译的多样局部最优。工程上,冻结测试集、Best-of-N 快照回滚、编排器绝对路径管理这些细节保证了自主循环的确定性与可信性。另外,检索语料刻意排除人工内核的设计,使得'智能体自主发现 TPU 优化'的结论不含水分。
实验结果
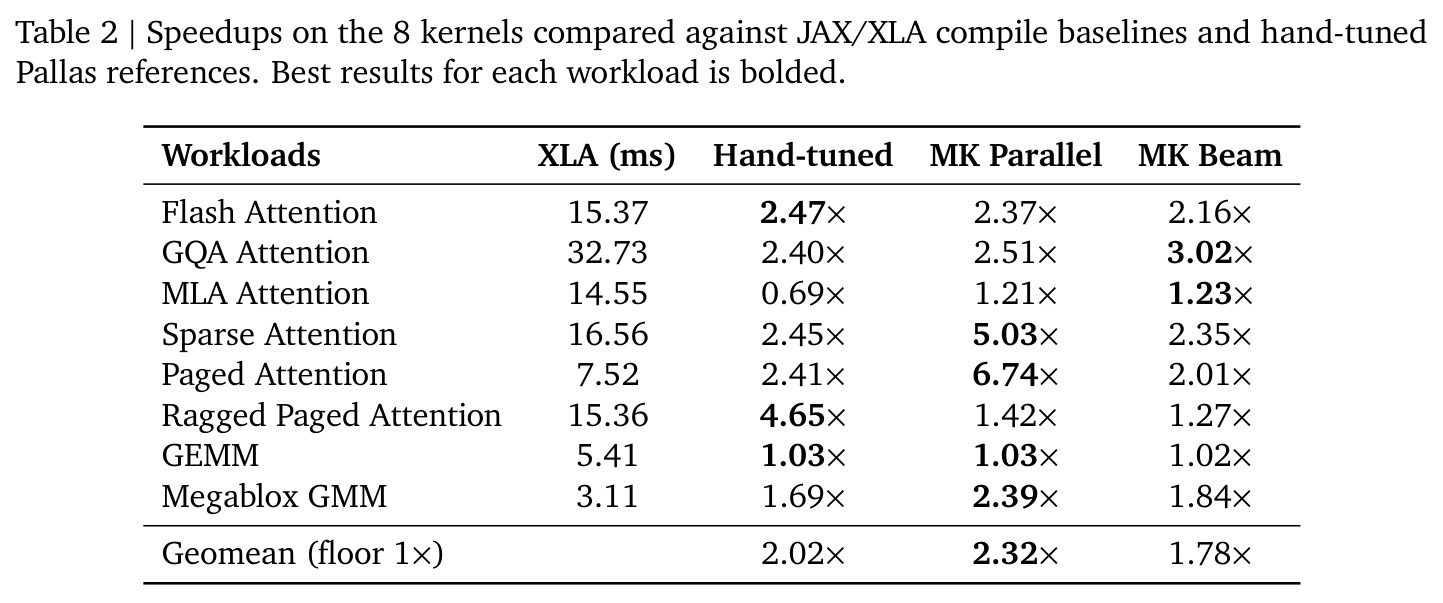
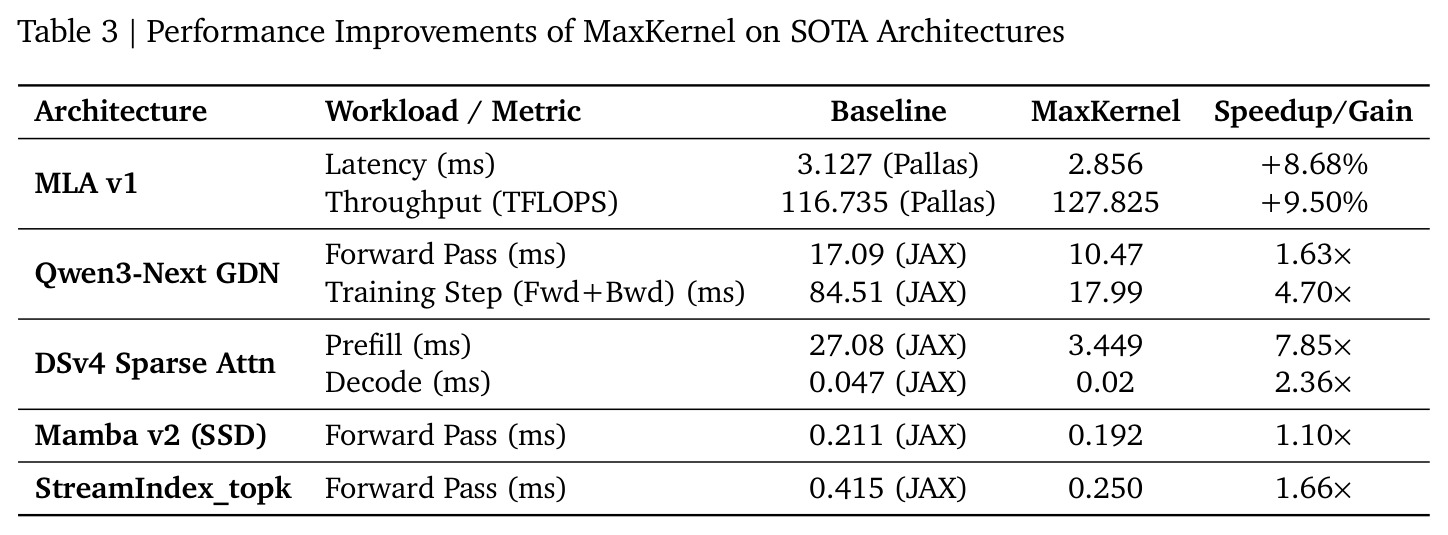
实验配置为 TPU v6e + Gemini 3.1 Pro。JaxBench 50 任务上(表 1):零样本 Best-of-N 仅 10/50 编译与正确、加速 1.08 倍、fast1 6/50;MK Auto 中位数达 49/50 编译、48/50 正确、1.39 倍、fast1 22/50;MK Parallel 与 MK Beam 均全部编译正确,加速 1.58 与 1.49 倍,fast1 34 与 31/50。8 个生产负载上(表 2):Parallel 几何平均 2.32 倍超过手写版的 2.02 倍,8 项中 7 项占优;Paged Attention 上 Beam 6.74 倍远超手写 2.41 倍;例外是 Ragged Paged Attention,手写 4.65 倍对智能体 1.42 倍。真实负载上(表 3):MLA v1 相对手写 Pallas 延迟降 8.68%、吞吐升 9.50%;Qwen3-Next GDN 训练步加速 4.70 倍;DSv4 稀疏注意力 prefill 加速 7.85 倍。并修复了 RPAv3 prefill 崩溃,几乎零开销。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| JaxBench 全套内核生成(50 个任务) | 几何平均加速(相对 XLA 基线,回归下限 1.0) | 1.58×(MK Parallel) | 1.08×(Best-of-N 零样本,N=100) | 约 +46% |
| JaxBench 编译率与正确率 | 编译通过/数值正确任务数 | 50/50 与 50/50(Parallel 与 Beam) | 10/50 与 10/50(Best-of-N) | 提升 5 倍 |
| 8 个生产级内核 vs 人类专家 | 几何平均加速 | 2.32×(MK Parallel)、1.78×(MK Beam) | 2.02×(专家手写 Pallas) | Parallel 超过人类 +15%,8 项中 7 项占优 |
| Paged Attention | 相对 XLA(7.52 ms)的加速比 | 6.74×(MK Beam) | 2.41×(专家手写内核) | 约为手写版的 2.8 倍 |
| Qwen3-Next Gated DeltaNet 训练步 | 前向+反向完整训练步延迟 | 17.99 ms | 84.51 ms(JAX 实现) | 4.70× |
| DeepSeek-V4 稀疏注意力 Prefill | 延迟 | 3.449 ms | 27.08 ms(JAX 实现) | 7.85× |
| MLA v1 内核 | 延迟与吞吐 | 2.856 ms / 127.825 TFLOPS | 3.127 ms / 116.735 TFLOPS(手写 Pallas) | 延迟 +8.68%、吞吐 +9.50% |
局限与改进
作者承认的局限:评估只在 TPU v6e 与 JAX/Pallas 上进行,虽声称原则可推广到 CUDA/Triton、NKI、MTIA 等,但未提供这些平台的实验;所有调用均用 Gemini 3.1 Pro,与其他 LLM 的消融留作未来工作;束搜索在深度 3 出现平台期,每节点 2 次迭代的浅预算会惩罚需长调试周期的激进优化;RAG 知识库仅含静态文档。我的观察:其一,成本不透明——Parallel 需每任务 5 轨迹 × 5 迭代共 25 个 Auto 会话,束搜索还要叠加扩展成本,论文未报 token 消耗与费用;其二,8 个对比内核是小样本,且 Ragged Paged Attention 上智能体 1.42 倍对人类 4.65 倍的差距说明复杂不规则负载仍是盲区;其三,部分任务容差放宽到 $10^{-1}$,对 bf16 计算可能掩盖数值精度退化;其四,fast1 仅 34/50,仍有约三分之一任务无实质加速,分布长尾明显;其五,测试套件由 LLM 自身合成再冻结,正确性结论依赖合成测试的覆盖率,论文未做消融。
独立分析的弱点
独立分析几个弱点。第一,搜索成本与收益不匹配:并行搜索 1.58 倍相对 Auto 中位数 1.39 倍的提升,代价是 5 倍的智能体会话数,对预算敏感的团队未必划算,改进方向是利用剖析信号对明显无望的轨迹早停,或先跑 Auto、仅在方差大时升级到搜索。第二,束搜索会误杀'编译困难型'优化:论文自述需要多步迭代才能通过编译的大改动会被 2 次迭代的浅预算剪掉,相当于只给候选 2 分钟就淘汰,改进方向是按节点难度自适应分配迭代预算,或对被剪枝节点延迟重评估。第三,图搜索的断点恢复与状态持久化只是声称,论文未给出恢复成功率、节点复用率等量化证据。第四,知识库静态且不含经验:无法积累'本代 TPU 的坑'这类实践知识,作者也承认动态知识库是未来方向。第五,正确性验证依赖与未优化 JAX 参考的数值对齐,若参考实现本身在特定输入上有 bug,智能体会忠实复现错误;测试又由 LLM 合成,双重单点风险值得警惕,可引入差分测试或对抗性输入生成加固。
未来方向
作者明确提出三个方向:把进化搜索、贪心搜索等更多优化算法经 Auto Research 路线接入图框架;从过往实验构建动态演化的知识库,让系统越用越聪明;设计跨优化方法的有状态混合策略以平衡探索与利用。基于本文成果还可自然延伸:把 XProf 剖析信号量化为奖励函数,用强化学习微调实现与规划智能体的策略;将框架迁移到 CUDA/Triton、AWS NKI、Meta MTIA 验证跨硬件泛化,论文也点明多加速器是趋势;在图搜索中加入基于嵌入语义相似度的节点去重与合并,避免并行轨迹重复劳动;把 HITL 中的人类反馈记录下来训练偏好模型,逐步降低人工介入频率;针对 Ragged Paged Attention 这类不规则负载设计专用搜索空间或子智能体。另一个务实方向是人在回路与自主搜索的混合:智能体先生成候选优化思路清单供专家快速圈选,这可能是当下性价比最高的落地形态。
复现评估
复现条件总体友好。代码已在 GitHub 开源(AI-Hypercomputer/accelerator-agents 仓库的 MaxKernel 目录),基准 JaxBench 来自先前公开工作,实验配置交代得相当完整:TPU v6e 硬件、Gemini 3.1 Pro、数值容差设置(附录 A 给出逐任务容差表)、束搜索参数(宽度 3、深度 3、每节点 2 分支 2 迭代)、Auto 每轨迹 5 次迭代、Best-of-N 取 N=100 等,评估协议也明确(XProf 片上计时、过滤主机开销、几何平均对回归下限 1.0)。主要门槛有两个:一是算力,需要能访问 TPU v6e(云上按小时计费),50 个任务 × 多种方法的完整搜索会话是真实成本;二是方差,Auto 的 5 次独立运行加速区间为 1.19 到 1.42 倍,复现者需有多次运行取统计量的意识,单次跑分可能明显偏离论文数字。对只想体验的用户,HITL 模式在单个任务上即可运行,成本可控;照搬论文配置应能得到量级一致的结果。
论文图表