FactoSR:分解4D属性的强化学习空间推理框架 Unfold The World: Factorize 4D Properties in Reinforcing Spatial Reasoning
把4D空间推理分解为平面、深度、时间三个可验证奖励,让VLM在RL中学会真正的空间思维。
前置知识
视觉语言模型(VLM)
以视觉编码器(如 ViT)提取图像/视频特征、与大语言模型骨干拼接的多模态模型,视觉 token 与文本 token 一起进入 Transformer 自回归生成回答,代表如 Qwen3-VL、InternVL。它们在海量图文对上训练后具备通用视觉问答能力,但主要学到的是 2D 平面外观模式。
本文全部工作构建在 VLM 之上:FactoSR 以 Qwen3-VL-8B-Instruct 为骨干,目标正是修复这类模型『平面化』的空间理解缺陷,不懂 VLM 的训练范式就无法理解为什么要用 SFT+RL 两阶段来改造它。
RLVR(可验证奖励的强化学习)
不训练神经网络奖励模型,而是依据可客观核验的规则(答案正确性、格式约束、几何一致性等)从 ground-truth 直接计算奖励,再用策略梯度算法优化模型。它避免了奖励模型被『钻空子』(reward hacking)的风险,训练管线更简单、成本更低。
FactoSR 的核心贡献就是为空间任务新设计了一套可验证奖励(XY/Z/T 三路几何约束),理解 RLVR 才能明白为什么『重投影一致』『深度排序正确』这类几何性质可以直接变成训练信号。
GRPO(组相对策略优化)
PPO 的简化变体:对同一问题采样 $G$ 个回答为一组,用组内奖励的均值和标准差归一化得到相对优势 $A_i=(r_i-\mathrm{mean})/\mathrm{std}$,无需训练价值网络,省显存且更新稳定,目标函数带 clip 裁剪与 KL 正则防止策略漂移过远。因 DeepSeek-R1 而广为使用。
FactoSR 的 RL 阶段采用改进版 GRPO(每个查询 rollout 8 个样本),所有因子化奖励最终都要通过 GRPO 的组内比较机制转化为策略更新,是理解训练如何进行的算法基础。
相机内外参与重投影
内参 $K$ 描述焦距、主点等像素几何;外参 $T$(camera-to-world)描述相机位姿。给定深度 $d$ 和像素 $\tilde{p}$,可反投影出 3D 点 $\mathbf{x}_1 = d_1 \mathbf{K}_1^{-1} \tilde{\mathbf{p}}_1$,再经 $\mathbf{X}=\mathbf{T}_1\tilde{\mathbf{x}}_1$、$\mathbf{x}_2=\mathbf{T}_2^{-1}\mathbf{X}$ 投到另一视角。这是多视图几何的基石操作。
XY 奖励完全建立在跨视角重投影一致性之上:只有理解重投影,才能明白『模型选的对应点必须在几何上可行且真正可见』这一约束如何被计算成奖励,以及遮挡门控 $M_2$ 的作用。
Kendall-τ 秩相关
衡量两组排序一致性的统计量:对 $n$ 个对象两两配对,预测序与真值序同向记为一致对 $N_c$,反向记为不一致对 $N_d$,$\tau = (N_c - N_d)/\binom{n}{2} \in [-1, 1]$。它只关心相对次序是否正确,完全不关心数值偏差多大。
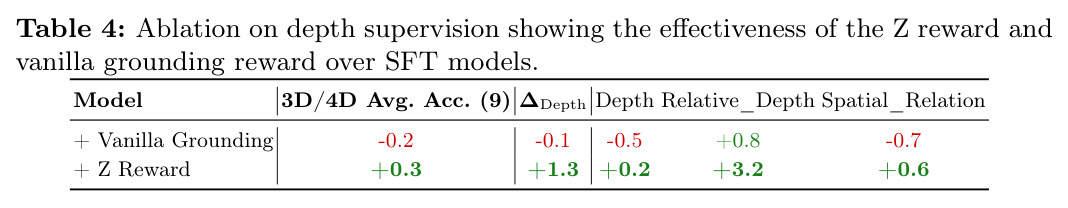
Z 奖励用 Kendall-τ 直接监督物体间的前后深度关系而非度量深度值,这是本文『深度排序比定位/回归更重要』这一关键设计决策的数学工具,Table 4 中 Relative Depth +3.2 的增益即源于此。
循环一致性(Cycle Consistency)
若一个变换过程可逆,则正向推理再接逆向推理应回到起点。在本文中表现为:正向问『相机如何从视图1运动到视图2』,反向问『如何从视图2回到视图1』,两个答案必须物理互逆——如正向『右转、后转』对应逆向『后转、左转』,否则说明模型没真正理解运动。
T 奖励就是用循环一致性强制模型真正理解自运动和时间因果,防止模型用静态外观线索蒙混过关;消融中 T 奖励带来时序组 ∆t +7.9 的最大单项增益,是三大奖励中最有效的一路。
研究动机
现有 VLM 在空间推理上本质是『扁平』的:它们在 2D 投影图像上训练,而真实世界是 3D 几何加时间连续的 4D 结构,这种维度失配使模型连基础空间问答都会犯错。主流补救方案有两类:一是合成大规模空间问答数据做 SFT(SpatialVLM、SpatialRGPT、VST、SenseNova-SI 等),二是引入额外空间 token 或 3D 表示(SpatialMLLM、VLM-3R、SpatialBot 等)。但前者受制于 3D 显式标注数据的稀缺,且难以迁移到动态 4D 场景;两类方法又大多依赖单视图问答——从 4D 场景中采样单帧学习静态 2D 模式,在动态空间推理中产生幻觉:不做几何对应、深度估计、时序一致性检查就启发式地『猜』答案。近期 RLVR 路线(SVQA-R1、SpatialThinker、SATORI-R1、Visionary-R1 等)泛化虽好,但沿用通用理解任务『只看最终答案对不对』的简单奖励,本质上仍是单视图学习,无法恢复被相机投影坍缩掉的空间与时间维度。
本文的目标是本文的目标是让 VLM 拥有跨维度的显式 4D 推理能力:把被相机投影折叠掉的空间(XY 平面、Z 深度)和时间(T)三个维度重新『展开』(Unfold The World),使模型回答空间问题时经历观察、定位、思考、验证的完整过程,而非表面模式匹配。具体路径是构建 FactoSR 学习套件:先做 FactoSR-SFT 注入空间感知先验(基础定位、对应、深度与结构化思维链),再用因子化可验证奖励做 FactoSR-RL 在线策略优化,把病态的『从 2D 投影恢复 4D 世界』问题转化为一系列具体可验的推理步骤,最终在 VSI-Bench、All-Angles-Bench 等 3D/4D 基准上达到开源最优(VSI 61.5%、All-Angles 55.4%),同时保住通用多模态能力。
与已有工作不同的是,本文的独特切入是『分而治之』:与其硬解一个在计算与算法上都不可行的统一 4D 单体目标,不如把它正交分解为三个几何子目标——平面对应(XY)、深度一致(Z)、时间可逆(T),每个都可直接从 ground-truth 几何自动验证。与已有空间 RLVR 只给一个『答案对错』标量奖励不同,本文每路奖励都精确对应一个被投影坍缩的物理维度,提供稠密且物理接地的训练信号;且框架不需要新架构、不需要额外 3D 教师网络或学习型奖励模型,只在奖励规则与数据管线上创新。另一个差异化判断是:RL 阶段继续优化定位 IoU 已无收益(Table 4 中通用 grounding 奖励反而使总体 -0.2),真正的瓶颈是 2D 观测下的相对深度推理和跨帧时序逻辑,因此 Z 用秩相关替代度量回归、T 用正逆问答循环替代单帧理解。
核心方法
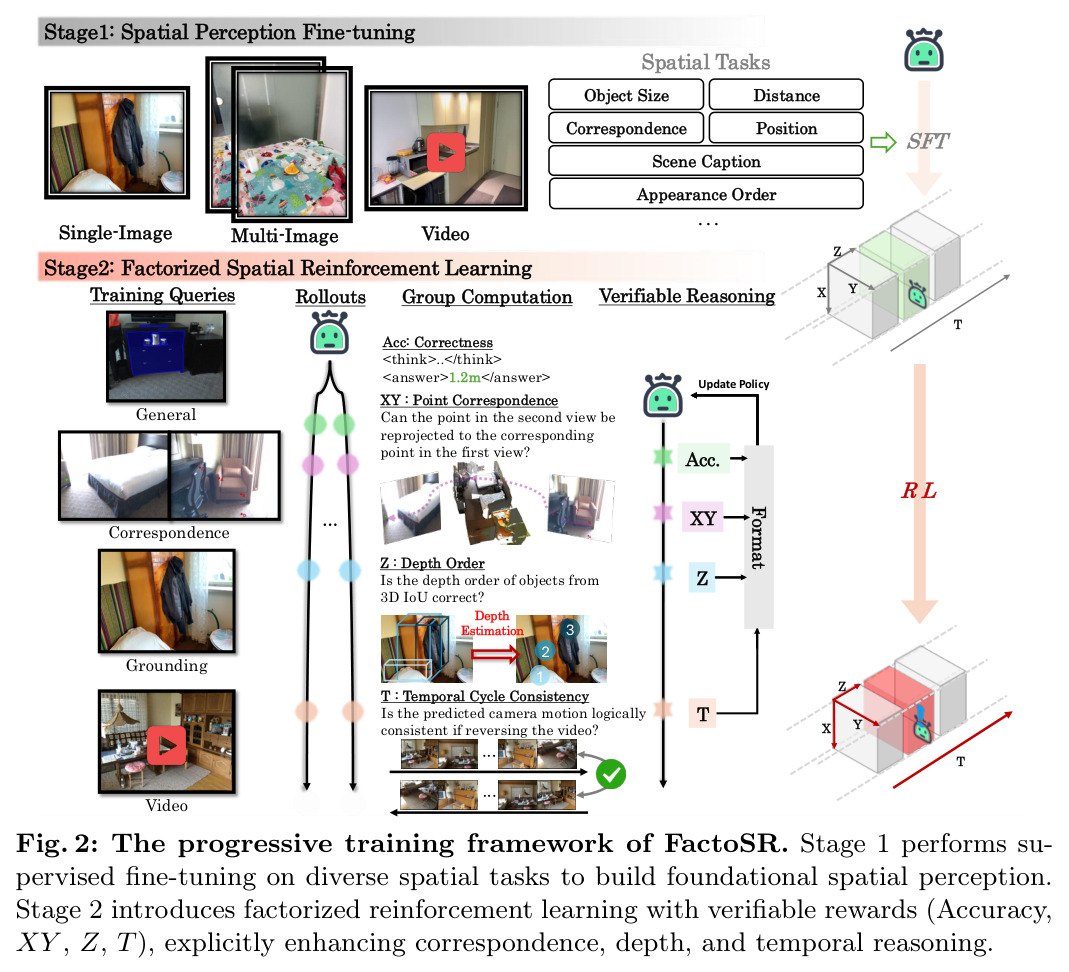
直觉上,要让模型学会『展开世界』:回答空间问题时显式补回被 2D 投影丢掉的三样东西——跨视角对应、深度次序、时间演化。技术路线是两阶段训练,骨干为 Qwen3-VL-8B-Instruct。Stage 1 空间感知微调:先在 8.2M 混合数据(LLaVA-OneVision 通用数据 5.1M、自建空间数据 1.6M、数学 737K)上做短答案 SFT 单个 epoch,用标准自回归损失 $\mathcal{L} = -\sum_{i=2}^{L} w_i \log p_\theta(y_i \mid V_{1:t}, Q_{st}, y_{1:i-1})$ 训练定位、对应、空间关系等基础能力(batch 128、序列长 8192、lr $5\times10^{-5}$、视觉编码器 $5\times10^{-6}$);再换用『Anchor-Transfer-Verify』结构化长思维链数据继续训练数百迭代做 CoT 冷启动(lr $10^{-5}$)。Stage 2 因子化强化学习:在 VeRL 框架中用改进版 GRPO(rollout size 8、温度 1.0、lr $10^{-6}$、batch 128),在 32K 验证集(81.2% 空间 + 18.8% 数学)上在线优化,奖励由格式、准确率、XY、Z、T 五部分加权组成。
核心创新是把不可解的 4D 单体目标因式分解为三个正交、可验证的奖励维度,与以往只奖励最终答案的 RLVR 有本质区别。XY 奖励监督跨视角点对应:参考像素 $\mathbf{p}_1$ 经 $\mathbf{x}_1 = d_1 \mathbf{K}_1^{-1} \tilde{\mathbf{p}}_1$ 反投影,再经 $\mathbf{X} = \mathbf{T}_1 \tilde{\mathbf{x}}_1$ 与 $\mathbf{x}_2 = \mathbf{T}_2^{-1} \mathbf{X}$ 重投影到视图2得目标 $\mathbf{p}_2^\star$,按归一化距离给软奖励 $r_{\mathrm{reproj}} = \exp(-d/\sigma) \cdot \mathbb{I}[d \le 3\sigma]$,并用深度一致性 $|\mathcal{D}_2(\mathbf{p}_2) - z_2^\star| \le \delta$ 构造可见性掩码 $M_2$ 门控,遮挡区猜测拿零奖励。Z 奖励不监督度量深度而是深度排序:预测 3D 框与真值框经 3D GIoU 代价的匈牙利匹配后,用 $\tau = (N_c - N_d)/\binom{n}{2}$ 度量前后序一致性,$R_Z = (\tau+1)/2$。T 奖励强制时间可逆:$\mathcal{R}_T = \mathcal{R}_{acc}(y, \hat{y}) \cdot \mathcal{R}_{acc}(y^{inv}, \hat{y}^{inv})$,正逆两个方向的相机运动推理必须同时正确。
方法步骤详情
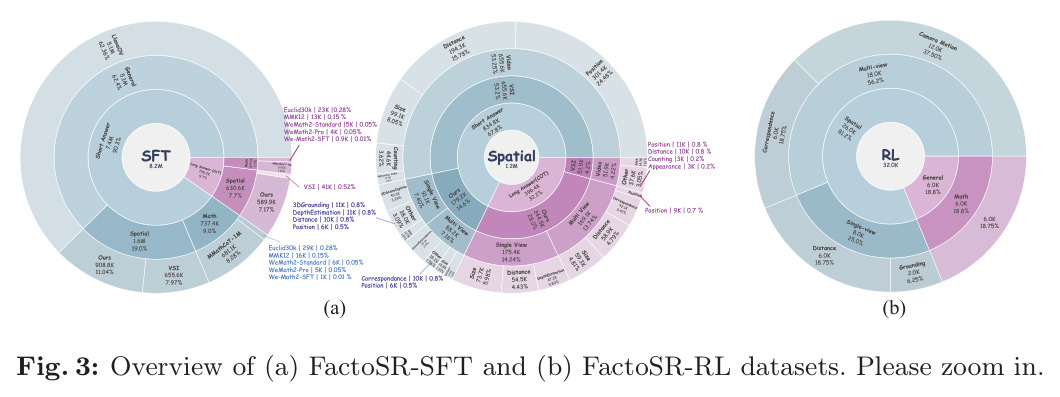
完整流程分四步。第一步(短数据 SFT):混合 8.2M 样本(短答案 7.4M 占 90.3%,长答案 795K 占 9.7%),单图、多图、视频统一输入,学习物体大小、距离、位置、对应、场景描述、出现顺序等空间感知任务,输入输出为图文对到简短答案,单 epoch 完成。第二步(CoT 冷启动):改用带 Anchor(锚定参考物与深度序)—Transfer(推演相机运动/视角变化的传递效应)—Verify(跨帧验证一致性)三段结构的跨帧对齐长思维链数据,模型输出结构化推理文本,训练数百迭代,为 RL 收敛铺路。第三步(RL 数据准备):构建 32K 验证集,涵盖多视图对应(给候选点集选几何可行点)、3D 目标检测(输出结构化 3D 框)、深度估计、相机相对运动(配正逆问答对)与通用多模态任务,每样本附带深度图、内外参、3D 框等可计算真值。第四步(因子化 RL):每个查询采样 8 个 rollout,计算 $R_{total} = \mathbb{I}[\mathcal{R}_{format}=1] \cdot (\lambda_{acc}\mathcal{R}_{acc} + \lambda_{XY}\mathcal{R}_{XY} + \lambda_Z \mathcal{R}_Z + \lambda_T \mathcal{R}_T)$,格式奖励作为开关门控所有强化信号,组内归一化优势后用 GRPO 更新策略。
技术新颖性
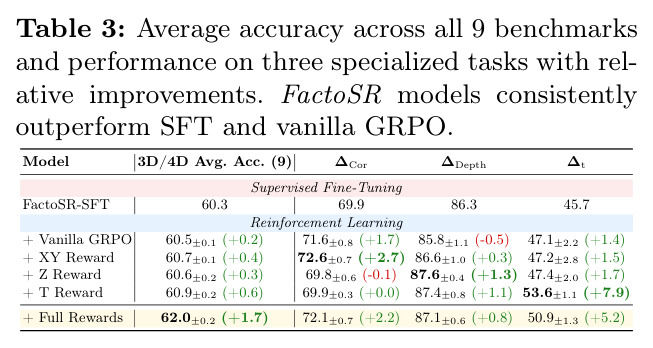
技术新颖性有三点。其一,奖励结构本身即贡献:以往空间 RLVR 只优化答案正确率或简单定位,本文首次把空间一致性沿『平面—深度—时间』三个正交维度显式建模为独立奖励,消融证明三者贡献互补——XY 主攻对应(∆Cor +2.7),Z 主攻深度(∆Depth +1.3,其中 Relative Depth +3.2),T 主攻时序(∆t +7.9),而通用 grounding 奖励反使整体下降 0.2。其二,Z 奖励设计反直觉:作者观察到 RL 阶段继续优化 IoU 定位已无收益,空间 VQA 的核心难点是 2D 观测下推断物体间相对深度,于是用秩相关替代度量回归,既规避深度绝对值噪声又直击推理需求,这是对『该奖励什么』的重新诊断而非堆料。其三,XY 奖励的可见性门控把多视图几何的遮挡关系编码进奖励:$3\sigma$ 硬截断抑制乱猜的虚假梯度,深度一致掩码杜绝把奖励给到几何上不可见的区域。整个框架不引入新架构与学习型奖励模型,全部信号可从真值自动验证,干净且可复用。
实验结果
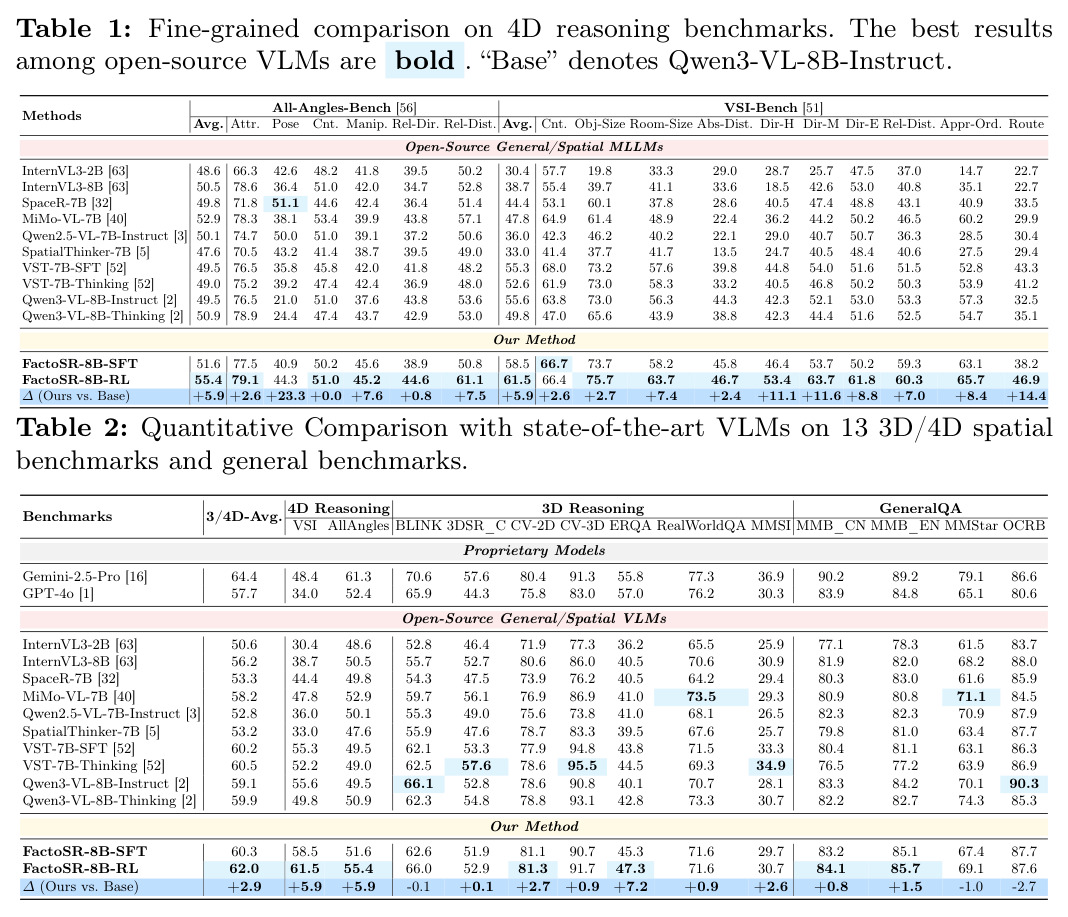
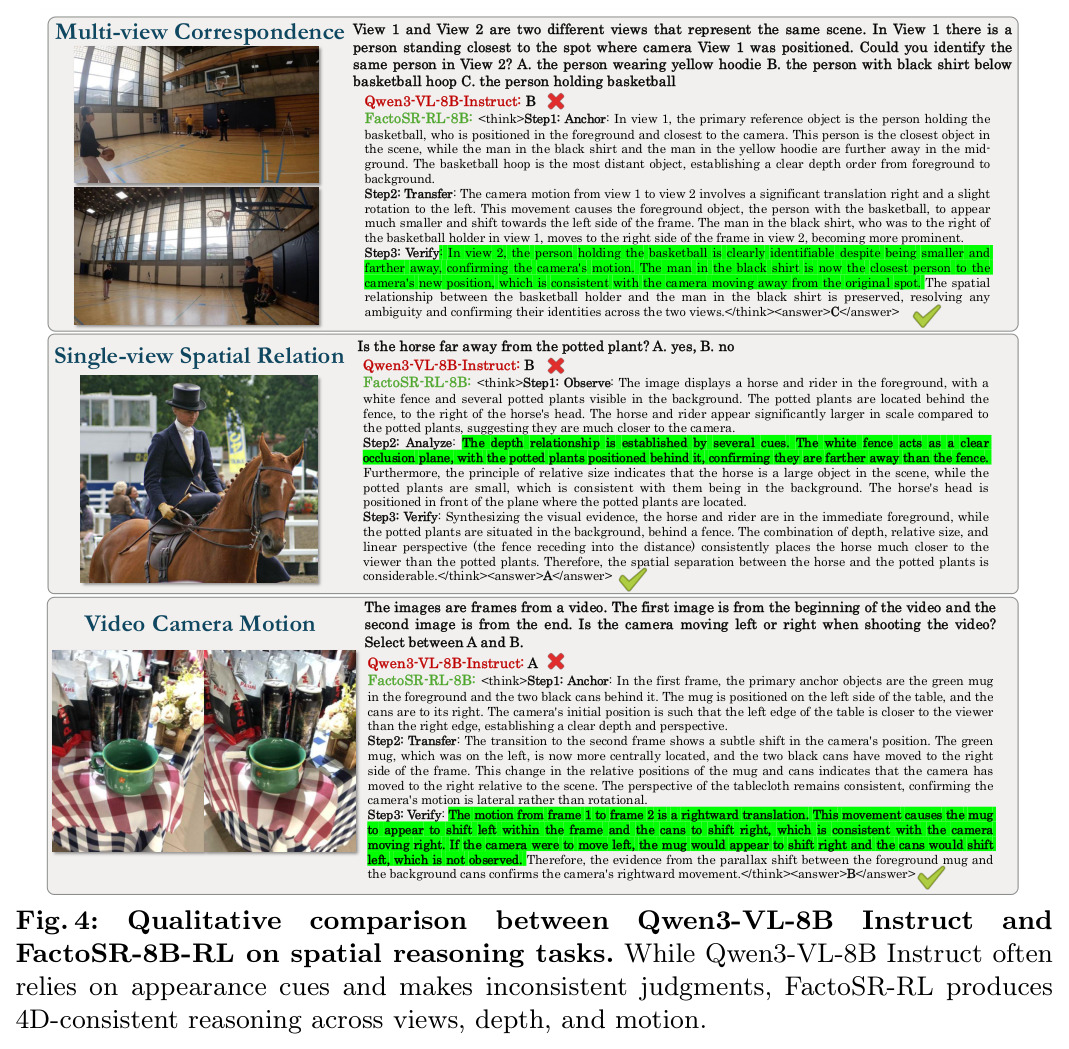
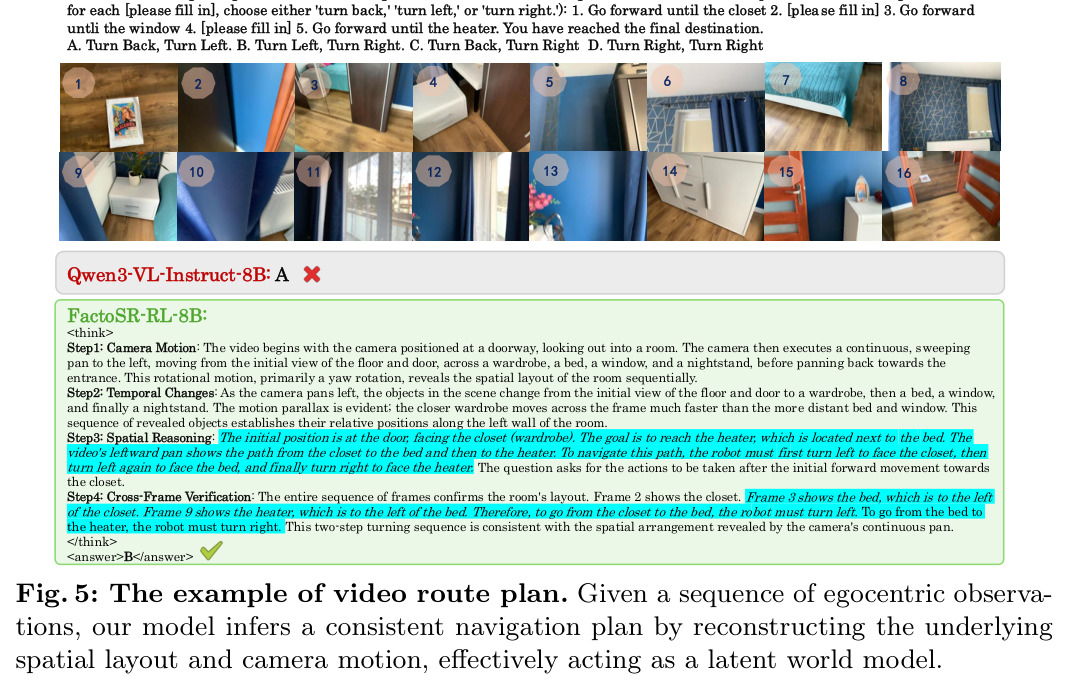
4D 推理(Table 1):FactoSR-8B-RL 在 VSI-Bench 达 61.5%(基座 Qwen3-VL-8B-Instruct 55.6%,+5.9;比最强开源基线 VST-7B-SFT 的 55.3 高 6.2),All-Angles-Bench 达 55.4%(基座 49.5%,+5.9;比最强开源 MiMo-VL-7B 的 52.9 高 2.5)。子任务几乎全面领先:All-Angles 的 Pose 从 21.0 暴涨 23.3 点至 44.3、Manip. +7.6、Rel-Dist. +7.5;VSI 的 Route +14.4(32.5→46.9)、Dir-M +11.6、Dir-H +11.1、Abs-Dist. +8.8。综合 13 项基准(Table 2):3D/4D 平均 62.0(基座 59.1,+2.9),超过 GPT-4o 的 57.7,仍逊于 Gemini-2.5-Pro 的 64.4;ERQA +7.2(40.1→47.3)、MMSI +2.6、CV-2D +2.7。通用能力基本无损:MMB_CN +0.8、MMB_EN +1.5,仅 MMStar -1.0、OCR-B -2.7 轻微回退。消融(Table 3):vanilla GRPO 仅 +0.2,说明通用 RL 信号不足;单加 XY/Z/T 各 +0.3~+0.6;全奖励 +1.7 至 62.0±0.2,验证三路奖励互补。Table 4 显示 Z 奖励使 Relative Depth +3.2,而通用 grounding 奖励整体 -0.2、Spatial Relation -0.7。Fig. 4/5 定性展示了模型学会 Anchor-Transfer-Verify 跨视角追踪、遮挡与层次推断深度、视差推断相机运动等行为。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VSI-Bench(4D 视频空间推理) | 准确率 | 61.5% | Qwen3-VL-8B-Instruct 55.6%(最强开源 VST-7B-SFT 55.3%) | +5.9 点(对基座) |
| All-Angles-Bench(多视角 4D 推理) | 准确率 | 55.4% | Qwen3-VL-8B-Instruct 49.5%(最强开源 MiMo-VL-7B 52.9%) | +5.9 点(对基座)/ +2.5(对最强开源) |
| 9 项 3D/4D 空间基准平均 | 平均准确率 | 62.0% | Qwen3-VL-8B-Instruct 59.1% | +2.9 点 |
| VSI-Bench 路线规划(Route) | 准确率 | 46.9% | 基座 32.5% | +14.4 点 |
| All-Angles 相机位姿(Pose) | 准确率 | 44.3% | 基座 21.0% | +23.3 点 |
| ERQA(具身推理) | 准确率 | 47.3% | 基座 40.1% | +7.2 点 |
局限与改进
作者文中对局限的显式讨论较少,但设计与结果里隐含多处。第一,三路因子化奖励都依赖几何真值(成对视角的深度图与相机内外参、3D 边界框、人工构造的正逆问答对),训练数据必须能重建这些量,真值缺失的开放互联网视频无法直接使用。第二,增益不均衡:T 奖励的 ∆t +7.9 很显著,但 XY 对总体 3D/4D 平均只贡献 +0.4、Z 仅 +0.3,权重 $\lambda$ 如何设定论文未详述,可能存在调参敏感性与奖励间梯度冲突。第三,通用能力有轻微回退(MMStar -1.0、OCR-B -2.7、BLINK -0.1),说明 RL 对非空间任务仍有挤压。第四,绝对性能仍有天花板:MMSI-Bench 仅 30.7%、3DSR 52.9%,距 Gemini-2.5-Pro(3D/4D 平均 64.4)尚差约 2.4 点。我自己的观察:Table 3 的 PDF 排版中单因子奖励的专项收益归因(如正文称 XY → ∆Cor +2.7,但表格数字顺序也可读成 vanilla GRPO 获得 ∆Cor +2.7)存在歧义,各奖励的独立贡献需要更干净的对照实验确认;且实验只在 8B 规模验证,因子化范式的规模律未探索。
独立分析的弱点
弱点一:奖励依赖昂贵真值。XY 需要成对视角的深度图+内外参,Z 需要 3D 框标注,T 需要构造的正逆问答,数据只能在合成或可重建场景(室内扫描、驾驶数据)上规模化,限制了向开放域视频扩展。改进方向:用前馈重建/深度基础模型(VGGT、Depth Anything 类)产出的伪真值替代 GT,或直接采用自监督跨视角一致性作为软奖励。弱点二:Z 奖励要求训练时输出结构化 3D 框再做匹配,而推理时回答 VQA 并不输出 3D 框,训练与推理行为脱节,能力迁移依赖隐式泛化;改进方向是把『先想象几何再回答』的框推理显式纳入思维链模板。弱点三:各奖励权重 $\lambda$ 与格式门控是静态超参,缺乏课程式调度,奖励间冲突(XY 要求忽略外观而 Acc 依赖外观线索)未被分析,可引入自适应加权或不确定性加权。弱点四:T 奖励的正逆构造隐含『相机运动可枚举为离散转向』的先验,对连续复杂运动(手持晃动、非刚性形变)场景的泛化存疑;且评测集中于 8B 模型与室内场景,跨规模、跨域(户外、航拍)验证缺失。
未来方向
作者方向:结论明确提出让模型『在 4D 世界中自由推理』并与潜在世界结构交互,Fig. 5 已展示模型像隐式世界模型一样做路线规划,暗示向真正的多模态世界模型演进。可延伸方向:其一,把因子化奖励推广到更多物理维度,如物体持久性、物理合理性(重力、碰撞、支撑关系)奖励,构成更完整的『世界一致性』目标;其二,与 3D/4D 基础模型联合,用伪标签奖励扩展到无标注网络视频,摆脱真值依赖,实现数据规模自由;其三,探索因子化范式在更大规模(30B+)与不同骨干上的规模律,检验分而治之的优势是否随模型能力增长而放大或缩小;其四,把 T 奖励的正逆循环从二元问答扩展到轨迹预测与动作序列规划,衔接机器人导航、自动驾驶等具身场景;其五,系统研究奖励间的干扰与协同,甚至用自动搜索优化奖励组合与调度课程。
复现评估
复现条件总体较好。代码已在 GitHub 开源(github.com/ZimaBlue-WAM/FactoSR),骨干为公开的 Qwen3-VL-8B-Instruct,RL 训练基于开源 VeRL 框架与改进版 GRPO,关键超参全部给出:SFT 阶段 batch 128、序列长 8192、lr $5\times10^{-5}$(视觉编码器 $5\times10^{-6}$)、单 epoch;CoT 冷启动 lr $10^{-5}$;RL 阶段 rollout 8、温度 1.0、lr $10^{-6}$、batch 128。数据构成在 Fig. 3 详细披露(SFT 8.2M:短答案 7.4M/长答案 795K,其中 LLaVA-OneVision 5.1M、空间 1.6M、数学 737K;RL 32K:空间 81.2% + 数学 18.8%)。主要变数是自建的 1.2M 空间数据与 32K RL 验证集是否完整发布,及其数据管线依赖的 3D 标注来源;若数据不开源,需自行基于 ScanNet/ARKitScenes 等可重建场景复刻。算力方面,8B 模型两阶段训练加 RL 在线采样(每组 8 个 rollout)估计需要数十张 A100/H100 级多机环境,普通实验室难以完整复现 RL 阶段,但 SFT+评测部分门槛较低。综合评估:代码与配方齐全、数据是关键变量,复现难度中等偏上。
论文图表
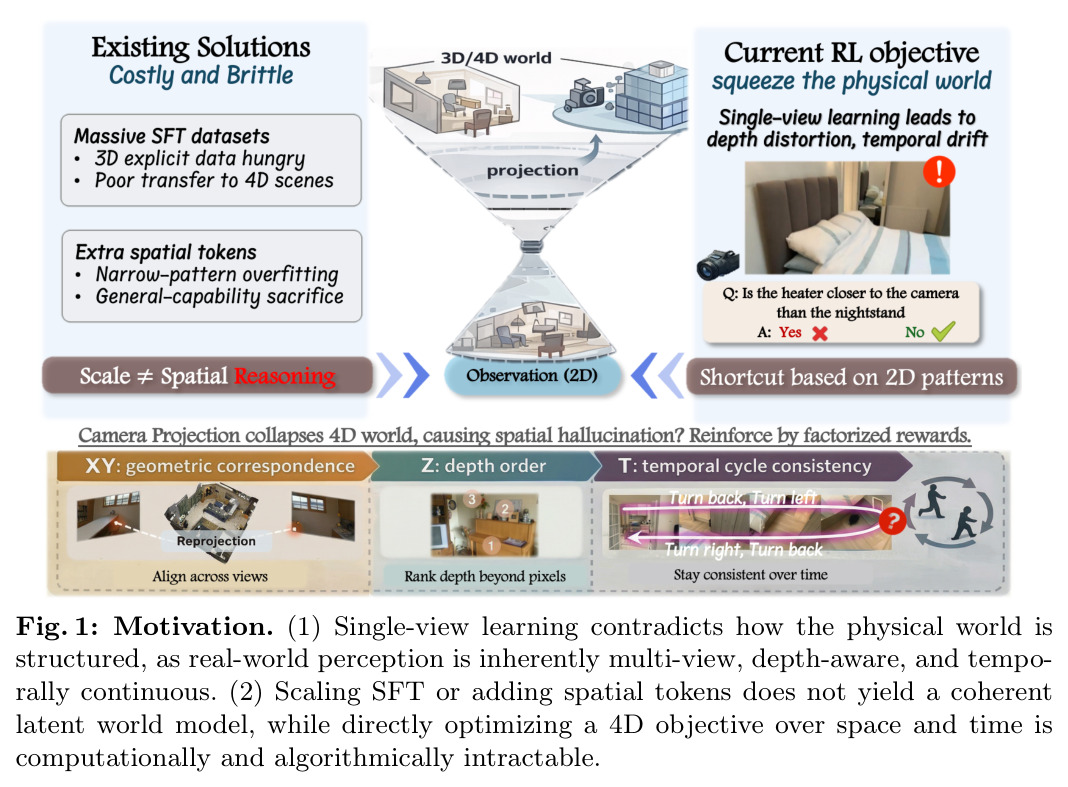
动机对比示意图:真实世界的感知天然是多视角、深度感知、时间连续的,而单视图学习把世界压成平面投影;另一侧说明单纯放大 SFT 数据或增加空间 token 无法形成连贯的潜在世界模型,而直接在空间+时间上优化统一 4D 目标在计算和算法上都不可行。
一图道出全文动机与『分而治之』的必要性:解释了为什么既不能靠数据堆料、也不能硬解单体 4D 目标,从而自然引出把目标因式分解为 XY/Z/T 三路的方案。
汇总与闭源(Gemini-2.5-Pro、GPT-4o)及开源模型在 VSI、All-Angles、BLINK、3DSRBench、CV-Bench 2D/3D、ERQA、RealWorldQA、MMSI 与 MMBench 中英文、MMStar、OCR-B 共 13 项空间+通用基准上的对比。FactoSR-8B-RL 3D/4D 平均 62.0(+2.9),超过 GPT-4o 的 57.7,仍低于 Gemini-2.5-Pro 的 64.4;ERQA +7.2、MMSI +2.6、CV-2D +2.7;通用基准 MMB_CN +0.8、MMB_EN +1.5,MMStar -1.0、OCR-B -2.7 轻微回退。
回答『空间增益是否以牺牲通用能力为代价』这一关键问题,并给出与闭源旗舰模型的水平定位,是评估方法实用性的重要参照。