VeriPhy:面向世界模型评估与精炼的智能体物理推理 VeriPhy: Agentic Physical Reasoning for World Model Evaluation and Refinement
规划先于观测的可审计物理验证智能体,为生成视频每条判定保留可追溯证据链
前置知识
计划先行智能体(plan-before-act)
ReAct 范式中模型边看边决定下一步调用什么工具;plan-before-act 则要求在任何观测之前把任务编译为可执行程序并做静态校验(解析、类型、引用、无环)。执行阶段只能激活、跳过或定位已声明的调用,不能现场发明新动作。这保证每条测量都能回溯到请求它的那条计划声明,使整个决策过程可审计、可重放。
VeriPhy 的全部可审计性都建立在'计划先于像素'这一不变量上:先写好'什么证据能定案'的清单,再看视频。不理解这一范式,就无法理解论文为何强调 fallback 要计费、无效行要上报,而不是静默重试。
三值判定逻辑(supported/contradicted/unknown)
每个子检查的状态空间为 $\mathcal{V}=\{S, C, U\}$,对外呈现为 plausible/implausible/abstain。证据不可用时是 unknown 而非否定——工具失败不能变成对视频的指控;一条矛盾即推翻整段视频;全部义务被支持才判 plausible。组合由固定规则确定性完成,学习型模型只能补充显式打标的语义基态。
这是 VeriPhy 与二值 VLM 裁判的本质区别,也是所有实验数字(如弃权 166 次、fallback 推翻 83 次)背后的语义基础;不掌握三值逻辑就看不懂召回为何按类别差异巨大。
视频扩散模型与 VACE 控制注入
Wan 2.2 是 DiT 结构、按 flow-matching 调度去噪的潜在视频扩散模型,默认只受文本提示驱动。VACE 在冻结主干的每个 transformer 层加入控制分支,把控制视频编码为特征后以加性残差 $h_i^{(\ell)} \leftarrow h_i^{(\ell)} + s\, W^{(\ell)} z_{\mathrm{ctrl}}$ 注入,强度 $s$ 决定控制信号与文本的相对主导权,全程不重训基础权重、不复贴外观像素。
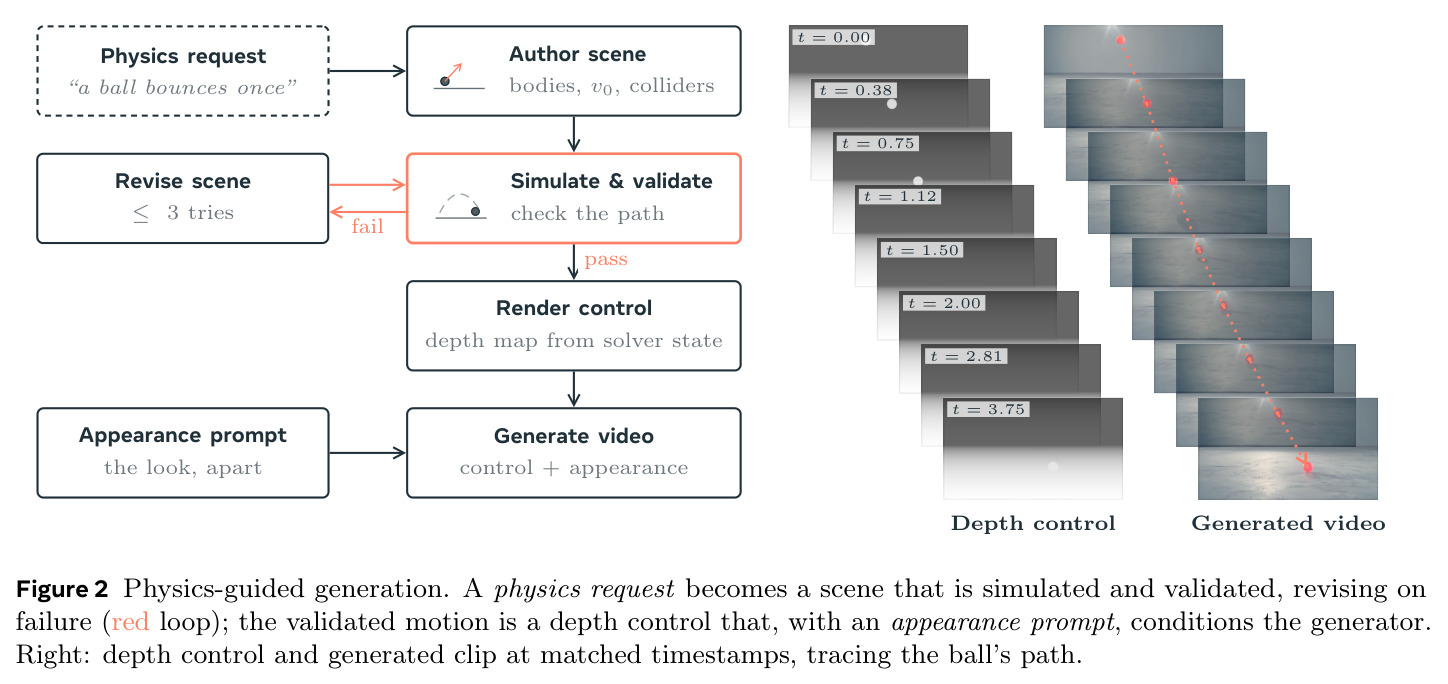
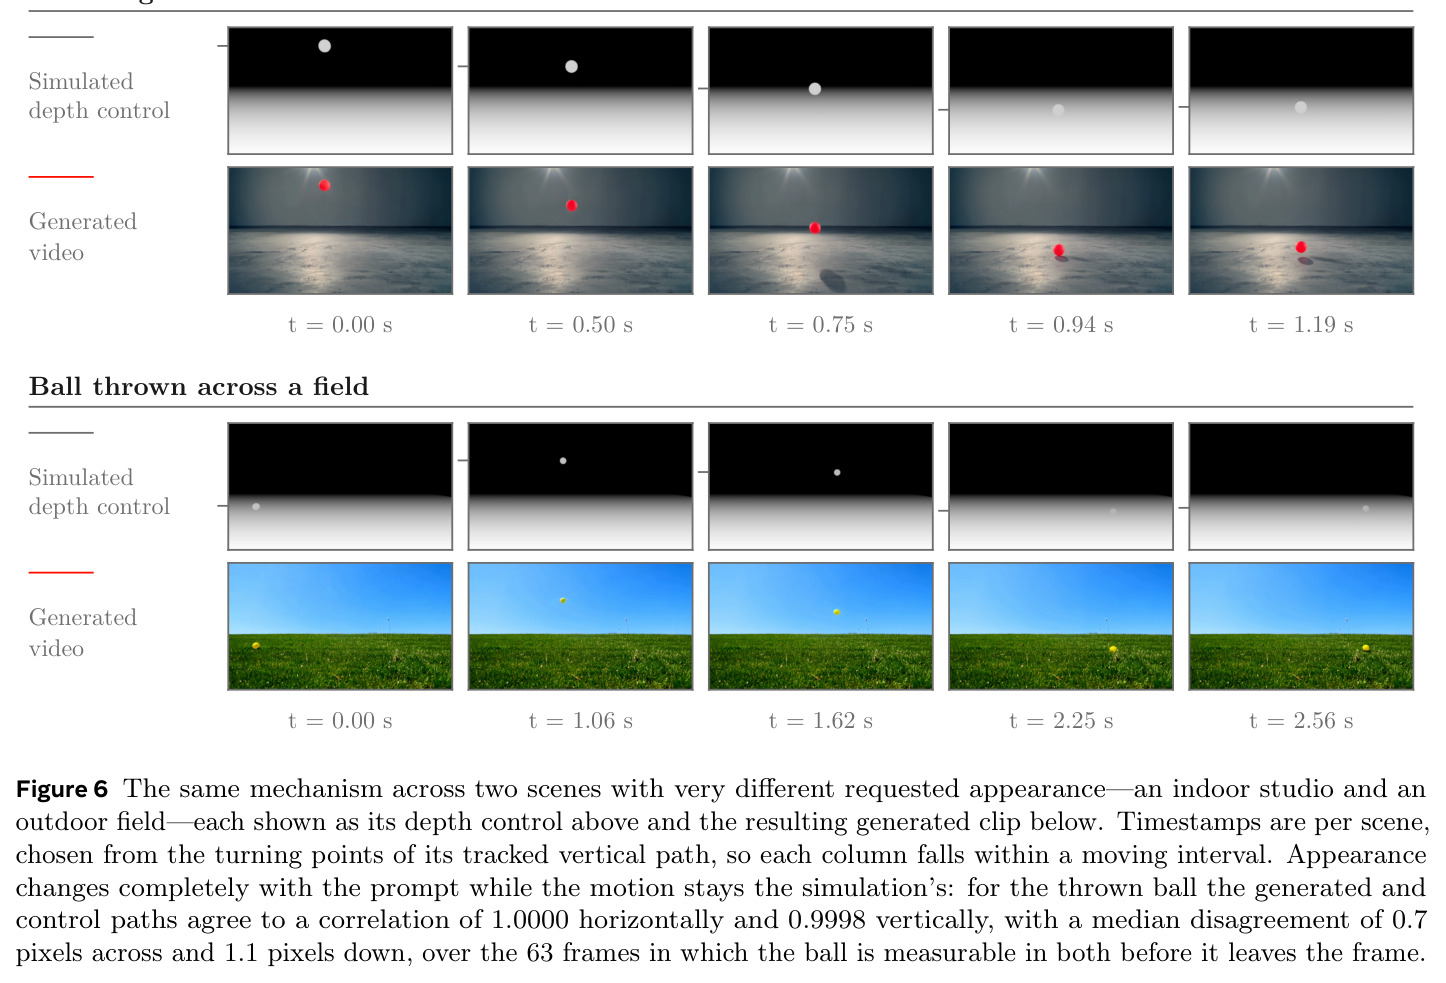
论文用它把 MuJoCo 仿真出的已知轨迹喂给生成器,构成物理目标先验已知的生成测试床;控制保真度实验(0.875→0.001)和撤除探针(承诺带 $\sigma\approx 0.94$–0.96)都围绕这条注入通路展开。
VLM-as-Judge 与问题分解评估
用视觉语言模型给视频打分或写评语是当前视频评估主流;问题分解进一步把 prompt 拆成命题或问题逐一提问,答案与 claim 链接。但两类方法的'证据'仍由判断模型自己产生——它既当证人又当法官,无法追溯每条结论看了哪些帧、量了什么数。
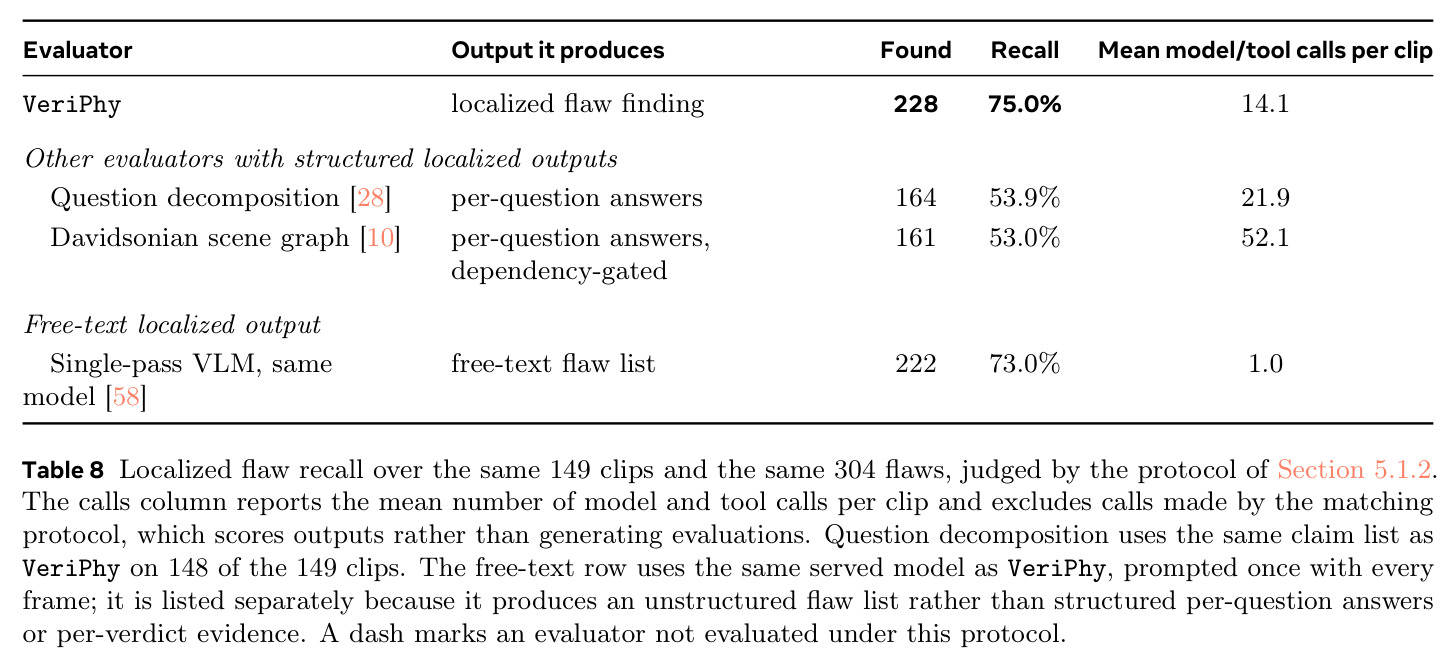
论文的头对头基线正是已发表的问题分解评估器(164/304 对 VeriPhy 的 228/304),并诚实指出同一骨干的单 pass 提示可达 222——理解该基线的局限与'召回不分离、审计性分离'的论证结构,是读懂实验部分的前提。
SAM 3 分割跟踪与轨迹物理测量
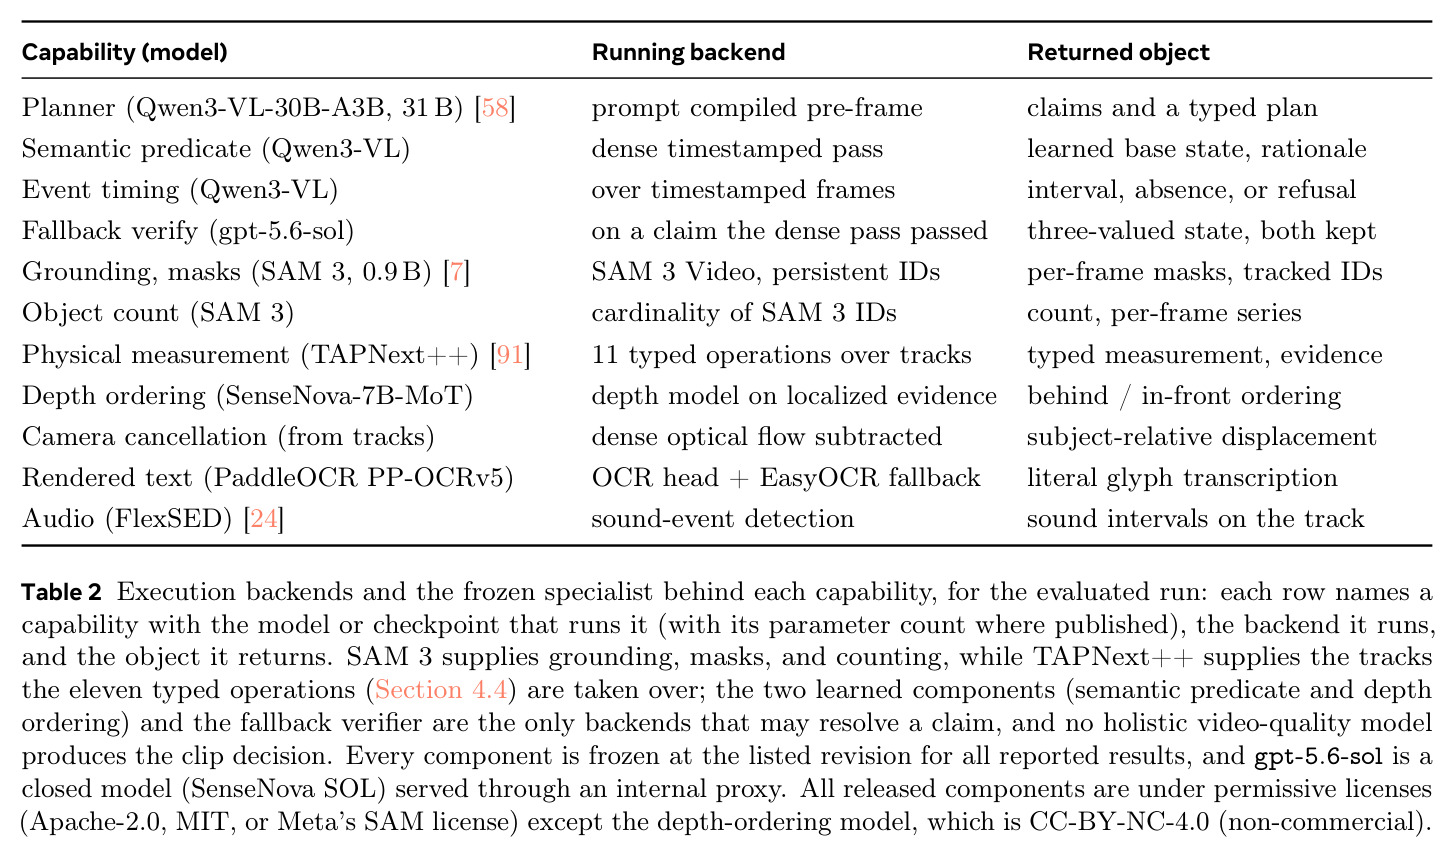
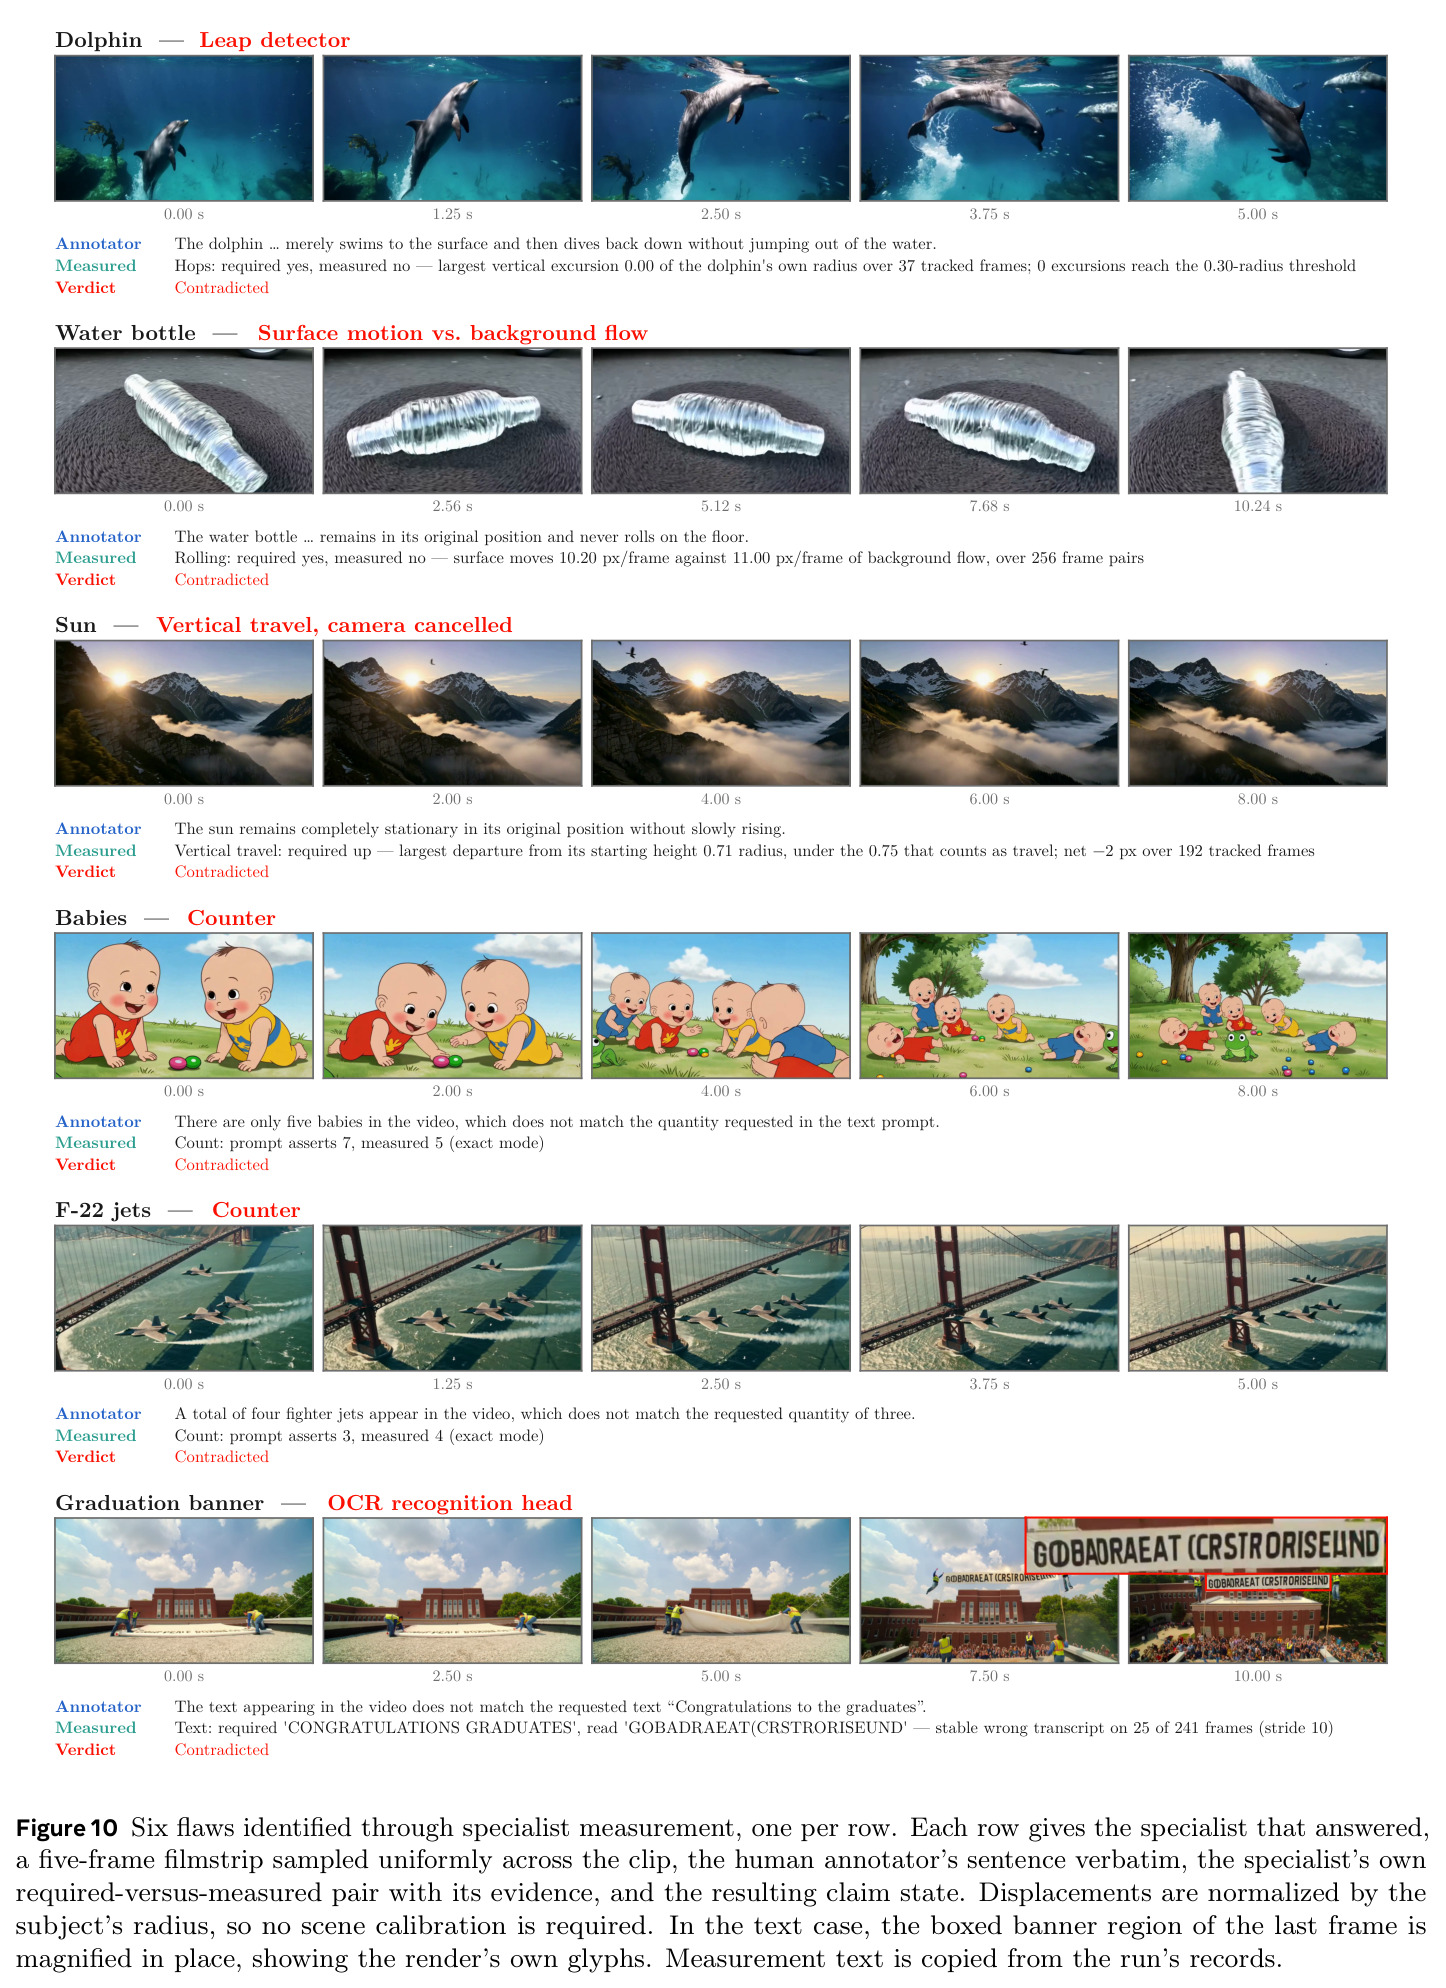
SAM 3 对命名主体做 grounding 并跨帧保持身份,输出逐帧 mask 与轨迹 ID。论文在其上定义 11 种类型化测量:位移(以主体自身半径为单位、取最远偏移而非净值、用稠密整帧光流去除相机运动)、接触最近距离、表面相对背景的形变、路径形状、永久性、腾空计数、旋转阻尼、事件先后、片段计时、视角运动。每项可显式弃权。
这是'测量与判断分离'中测量一侧的基石——Figure 10 的六个案例(海豚未跃出、计数 5≠7、乱码横幅等)全部由这些数值测量定案,是系统可信度的实证来源。
MuJoCo 仿真与深度控制渲染
MuJoCo 是广泛使用的刚体物理求解器。论文让语言模型把事件描述编译为场景规范(刚体、初态、碰撞体、相机),仿真得到轨迹并用事件谓词验证(失败则回读摘要修订,至多 3 次),再把求解器状态渲染为逐帧深度图 $C_t(u)=1-\mathrm{clip}\big((D_t(u)-d_-)/(d_+-d_-),\,0,\,1\big)$($d_-,d_+$ 为全片段非背景深度的 1%/97% 分位),平面场景回退为剪影。
这条'规范→仿真→验证→渲染'管线让物理目标在生成前就被固定并可独立审计,是论文三大贡献之一;没有它就无法构造'物理真值已知'的评估闭环。
研究动机
当前视频生成系统在感知上几可乱真,但视觉流畅不等于物理可靠:物体可以无支撑悬浮、球可以穿过刚性墙、可见的碰撞可以无声、撞击声可以先于接触出现。随着生成视频从媒体合成进入具身智能的训练与评估回路——世界模型被用来合成机器人训练轨迹、支撑策略学习——物理失效会直接污染下游策略,诊断'哪条物理义务在何时被违反'变得关键。然而现有评估手段无法回答:标量质量分数只能给两个片段排序,说不出违反了哪条义务、发生在哪个时刻;已有能力分散在不同评估器里——规则级判断、时间定位、受控设置下的测量、音频/跨模态一致性检查,各自绑定专用 benchmark、预定义现象或人工 rubric(如最新的 AV-Phys Agent 仍依赖 prompt 专属的人工评分规则和多模态模型二值判断),没有一个统一、可审计的证据链把'宣称→测量→裁决'串起来。
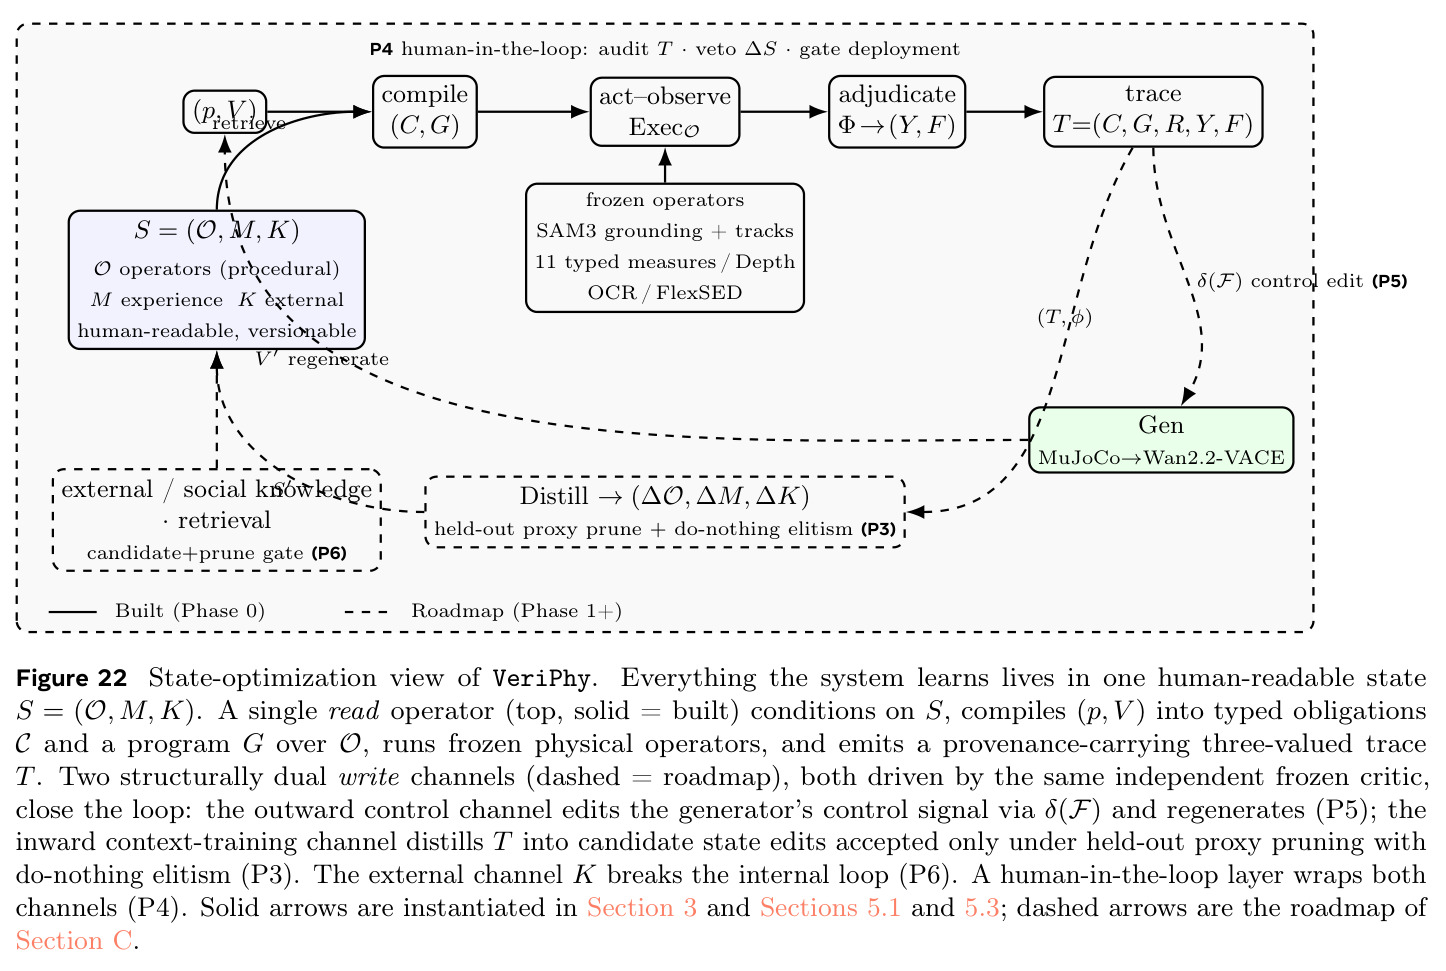
本文的目标是本文要构建三件产物并连成单一回路的雏形。其一是 VeriPhy:一个可审计的物理验证系统,对开放 prompt 与生成的音视频片段,先由纯文本规划器在看任何帧之前把 prompt 的精确片段编译为类型化物理义务 $C(p)=\{c_i=(s_i,\phi_i),\ s_i\sqsubseteq p\}$ 与静态校验的执行计划;执行时观测只负责门控、限定已声明的冻结专家调用;最后用固定规则把证据组合为三值判决(plausible/implausible/abstain),每个判决可逐级回溯到证据记录、时间窗与组合规则。其二是人类标注的缺陷基准:1,500 条生成片段、2,582 条引用违规 prompt 原文并附理由、严重度、置信度及可选时间区间与物体框的缺陷记录,配缺陷级匹配协议。其三是仿真条件化生成测试床:MuJoCo 几何渲染为深度或剪影控制,驱动冻结的 Wan 2.2-VACE,使物理目标与外观解耦。本报告分别评估 critic 与生成器,尚未闭环。
与已有工作不同的是,独特切入不在于发明新组件——作者明言规则判断、定位、测量、音频检测都已有先例——而在于整合所坚持的三条纪律。第一,推理全部前置:计划在任何帧被读取前编译并通过 $\mathrm{Parse}\wedge\mathrm{Refs}\wedge\mathrm{Typed}\wedge\mathrm{Acyclic}$ 校验,轨迹固定后每条测量都指向请求它的义务;观测只能激活、跳过或定位已声明的节点。第二,证据生产与裁决分离:专家返回类型化测量,学习型语义基态在记录里显式打标,确定性组合产出判决,任何整体评分器不得进入裁决路径。第三,三值逻辑把'证据不可用'(unknown/abstain)作为一等公民,避免把工具失败误读为对视频的负面指控。这直接回应了'额外脚手架只增加成本不提升精度'的文献质疑:同模型对照实验表明,召回本身不区分 VeriPhy 与单 pass 提示,真正分离二者的正是每条决策附带的证据与溯源。
核心方法
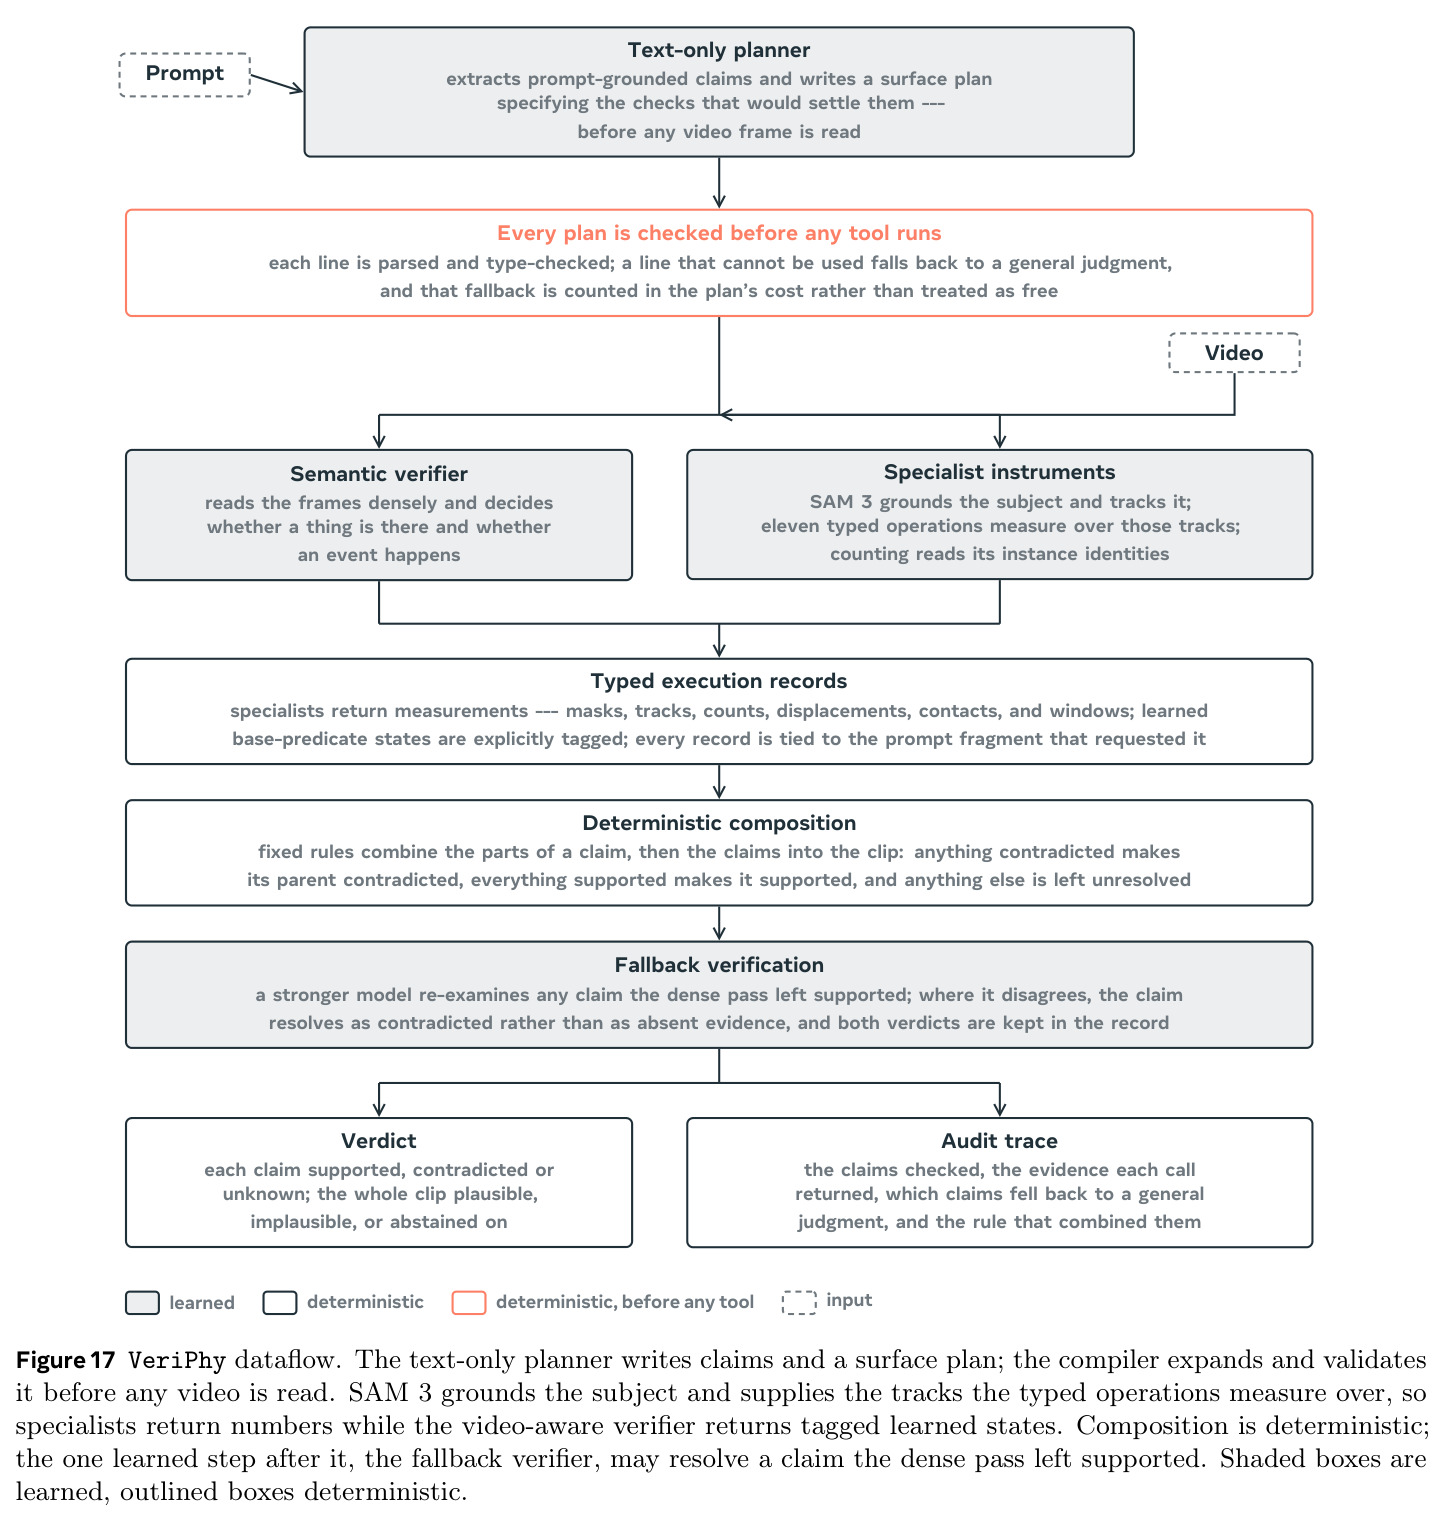
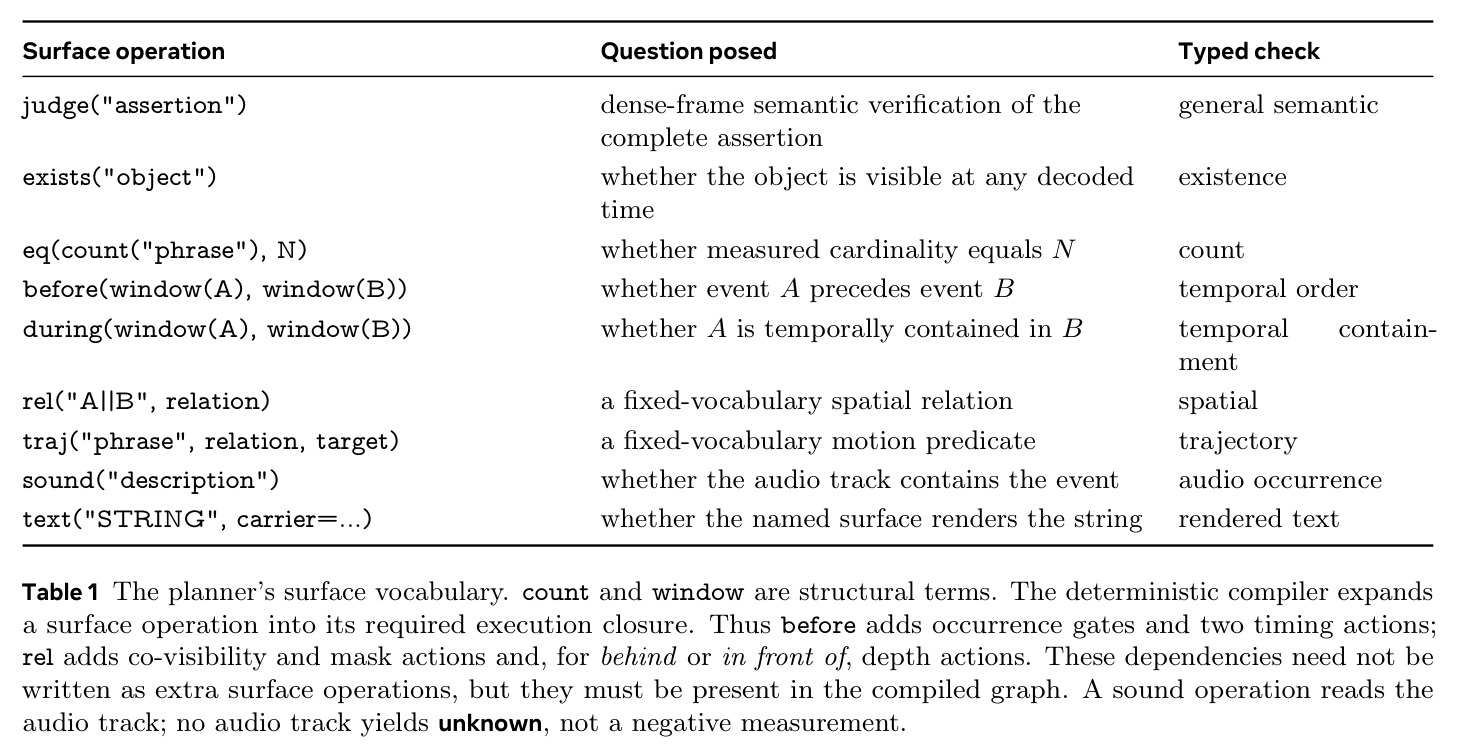
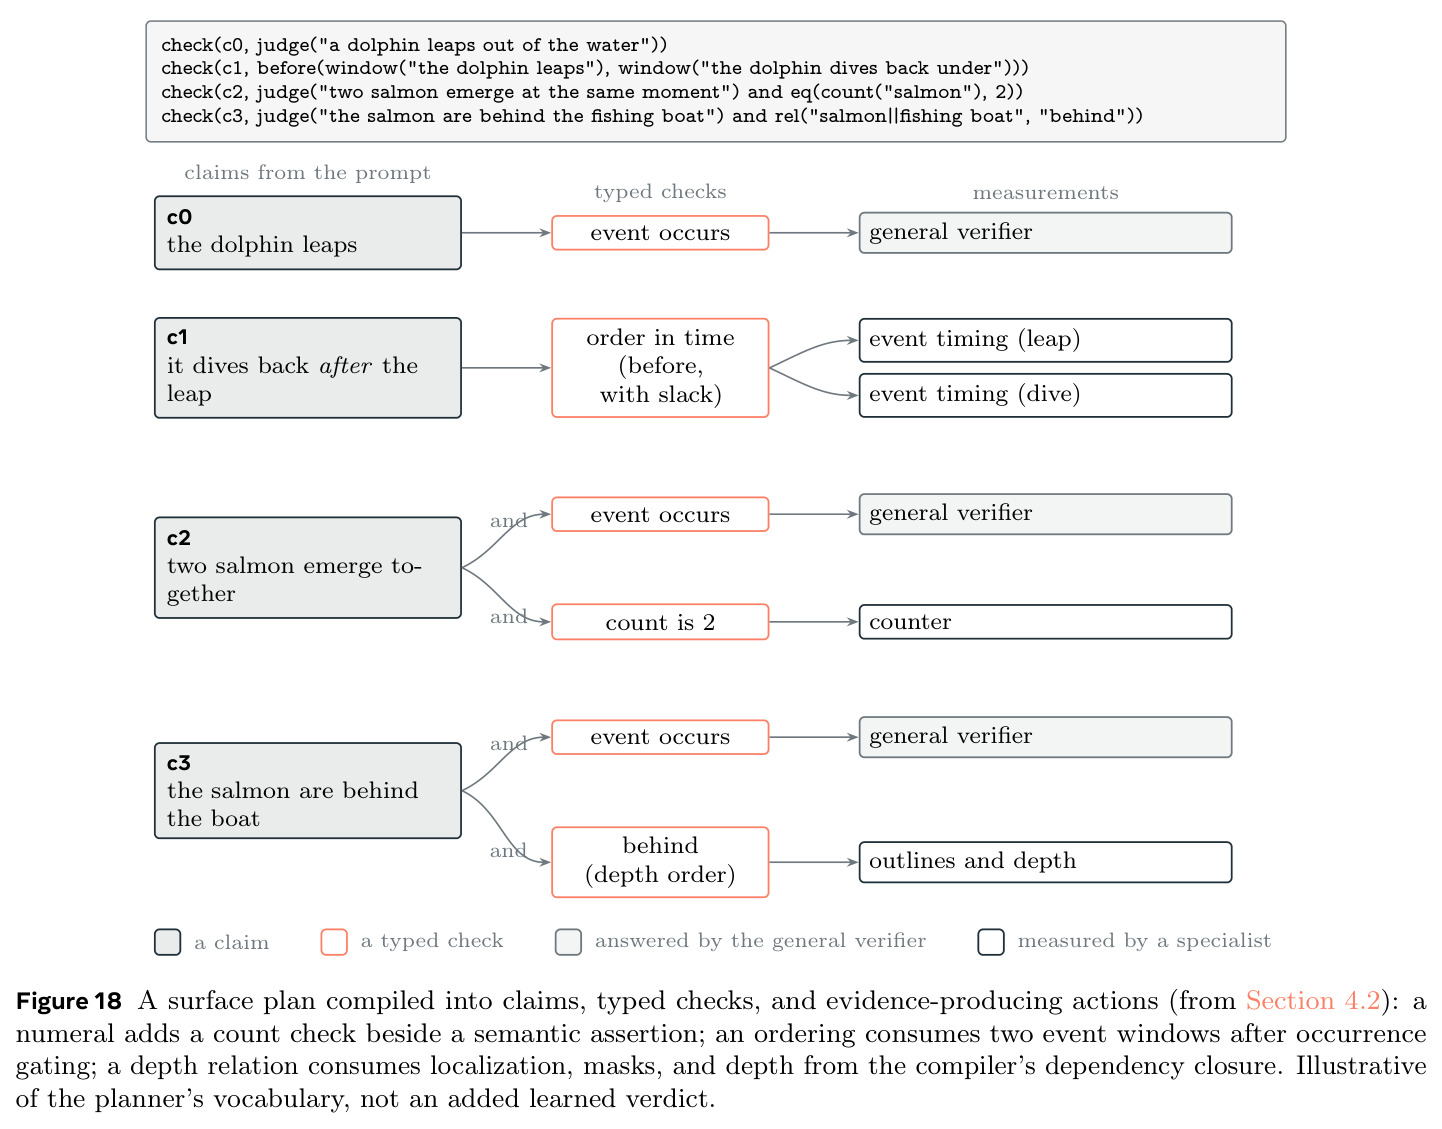
直觉上,VeriPhy 像一位先写好检查清单再去现场取证的审计员:读完 prompt(不看任何帧)后列出每条可检验断言以及'什么证据能定案',然后按依赖顺序调冻结仪器测量,最后照固定规则合议出三值判决。技术路线四步。第一步纯文本规划:先做命名 pass 为每个实体与每个独立断言的事件建立共享命名空间,claims 按每组至多四条分组独立规划,汇编时机械重命名进共享词汇,防止两组悄悄用不同名字指同一实体;表面语言限于 9 种操作(judge/exists/count/before/during/rel/traj/sound/text)。第二步编译与静态校验:表面程序编译为类型化有向图 $G_\Pi=(A,Q,E,b)$,须满足 $\mathrm{Valid}=\mathrm{Parse}\wedge\mathrm{Refs}\wedge\mathrm{Typed}\wedge\mathrm{Acyclic}\wedge\forall i\,\exists q\!:b(q)=i$,编译器自动展开依赖闭包(如 before 补两个 occurrence 门控与计时动作),无效行按规则回退通用验证器并计费上报。第三步时间线条件化多工具执行:按拓扑序运行,scope 函数 $g_j$ 把前置记录映射到全帧集或声明的子集,冻结后端(SAM 3、TAPNext++、深度、OCR、FlexSED 等)返回证据记录。第四步裁决:类型化 resolver 把子检查归为 $\{S,C,U\}$,确定性 roll-up 得到 claim 与 clip 判决,并输出带时空定位的矛盾包 $F(p,V)$ 作为诊断接口。
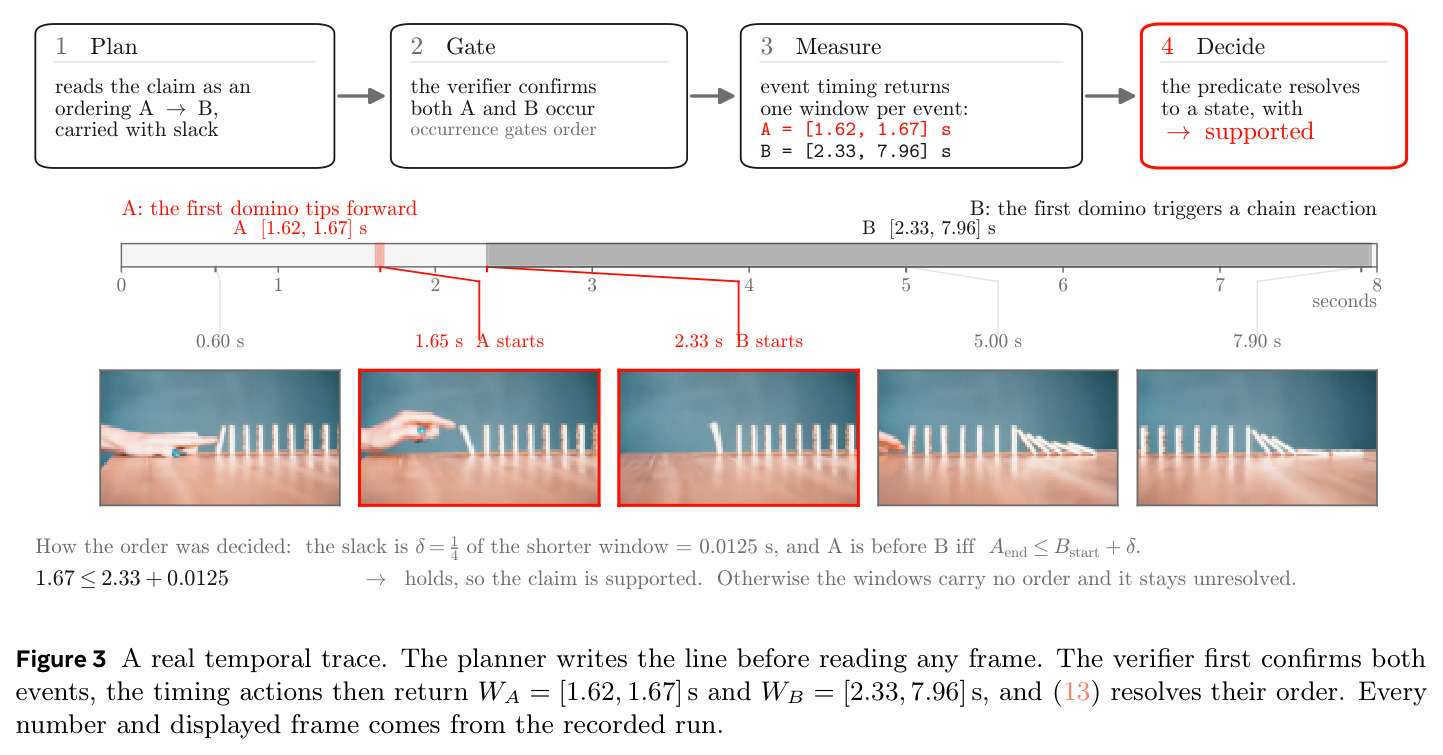
核心不变量是:'工具输出引导执行,但只在任何像素被读取前声明的义务范围内。'与问题分解的本质区别在于证据的来源与地位:分解法对每条 claim 问一个封闭 yes/no 问题并接受判断模型的回答(约三分之一的问题只是'有没有售货机'这类单帧可见性检查);VeriPhy 规划的是测量程序,由冻结专家产生带溯源的数值,判断模型只补语义基态且显式打标。第二个关键设计是时序守卫:事件窗口只有在其发生被稠密帧语义验证器(听觉事件则在音轨上)确认后才进入时序谓词——因为被迫的定位器对不存在的事件也会返回最佳候选;顺序判定用四分之一窗口的松弛 $\delta(A,B)=\tfrac{1}{4}\min(e_A-s_A,\,e_B-s_B)$ 保证 before 的两个方向互斥,即'时序可以组合顺序,但永远不能确立发生'。第三是证据三态互斥:measured 带载荷、abstained 带原因、errored 带基础设施信息;'完整可用轨迹上没有所要求的运动'是有效的否定测量可以矛盾 claim,而'因模糊/遮挡无法跟踪'只是弃权,绝不判负。
方法步骤详情
完整流程如下。规划:命名 pass 读整个 prompt 建立共享词汇;每组至多 4 条 claim 独立写出形如 check(c1, before(window("the first domino tips forward"), window("...chain reaction"))) 的计划行,此时无任何视频输入。校验:整个计划通过式 (7) 的五项检查;无效行回退通用验证器、无效项替换为记录在案的 generalist 子检查,均计为模型调用,防止'规划失败让 prompt 显得更便宜'。执行:按拓扑序,SAM 3 对命名主体 grounding 并跨帧跟踪,11 种测量共享这一 grounding——位移以主体半径为单位、取最远偏移(先升后降不抵消)、用稠密光流去相机运动;contact 测两轨迹 mask 最近接近;shape change 比较表面与背景光流(识别原地滚动);hop 计数腾空;另有 permanence、damping、onset ordering、clip timing、viewpoint motion;主体占画幅低于 1% 或轨迹过短则显式弃权。每个动作序列化为证据记录 $R_{j,i}=(\mathrm{id}(V),p,s_i,o_j,\Omega_j,\sigma_j,\mu_j,h_j,\kappa_j)$,$\sigma_j\in\{\mathrm{measured},\mathrm{abstained},\mathrm{errored}\}$,含实现 scope、产物哈希与成本;实现签名完全相同的动作做精确公共子表达式复用。裁决:resolver 得子检查三值态,否定作用于正态($\neg S=C$);claim 级一条矛盾即 C、全支持才 S;clip 级一条矛盾即 Implausible、全支持且至少一条 claim 才 Plausible、否则 Abstain。学习型 refinement 仅两处:更强的 fallback 验证器复查通过判定的 claim,可推翻为 contradicted(非对称——从不复查专家测量);OCR 识别头逐帧读文本做字面转写与字符串比较,避免生成式模型把乱码'修复'成 prompt 要的词。终态输出矛盾包 $F(p,V)=\{(c_i,\{R_{j,i}\},\Omega_i,B_i): y_i=C\}$:什么失败、依据什么证据、在哪个时空区域。
技术新颖性
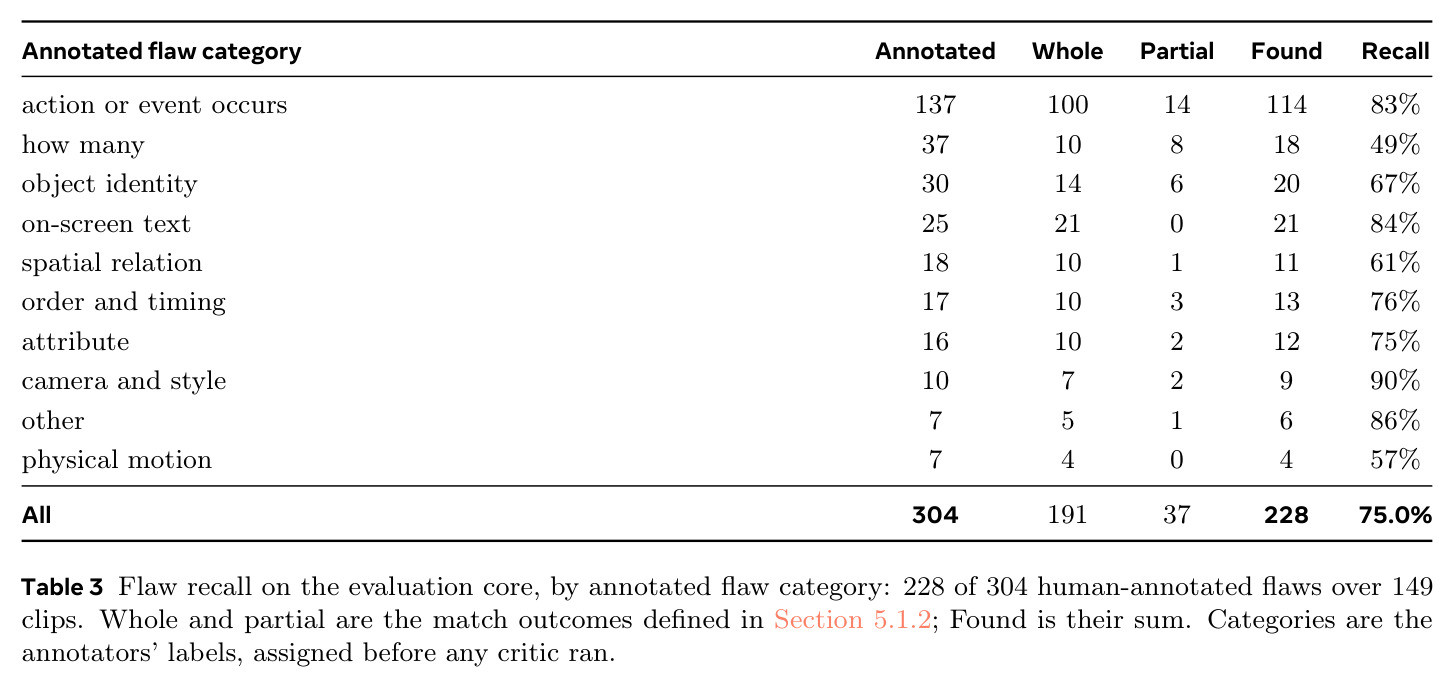
新颖性有四个层面。架构层:把 code-as-plan 视觉编程限制到 9 种类型化操作,编译器机械展开依赖闭包,配合共享命名空间加重命名汇编消除指代漂移;执行按完整实现签名(片段身份、操作、类型参数、实现 scope)做精确公共子表达式复用,整段与局部请求绝不因自然语言查询相似而合并。认识层:测量与学习状态在数据结构上强制分离——specialist schema 拒绝判断型字段、非有限数、重复键,保证专家永远无法输出最终 prompt 满足标签;仅存的三种学习型子检查(子类身份、稠密动作事件回忆、深度序空间解释)用非对称门(只在正向矛盾特征可见时才可 contradict)。诚实性层:作者自曝计数采用逐帧 grounding 序列的众数,对间歇性检测失败不鲁棒,因而把 (stable, range, frames read) 设为承重字段并公开承认计数召回最低(49%)。评估层:缺陷级匹配协议(句对语义判定 whole/partial + 最大二分匹配)让系统指控可以对上具体标注缺陷而非只与片段级分数相关——这是 1,500 片段语料区别于 VBench、VideoPhy-2 等片段级资源的根本点;与最接近的 AV-Phys Agent 相比,VeriPhy 摆脱了 prompt 专属人工 rubric,规划对任意开放 prompt 成立。
实验结果
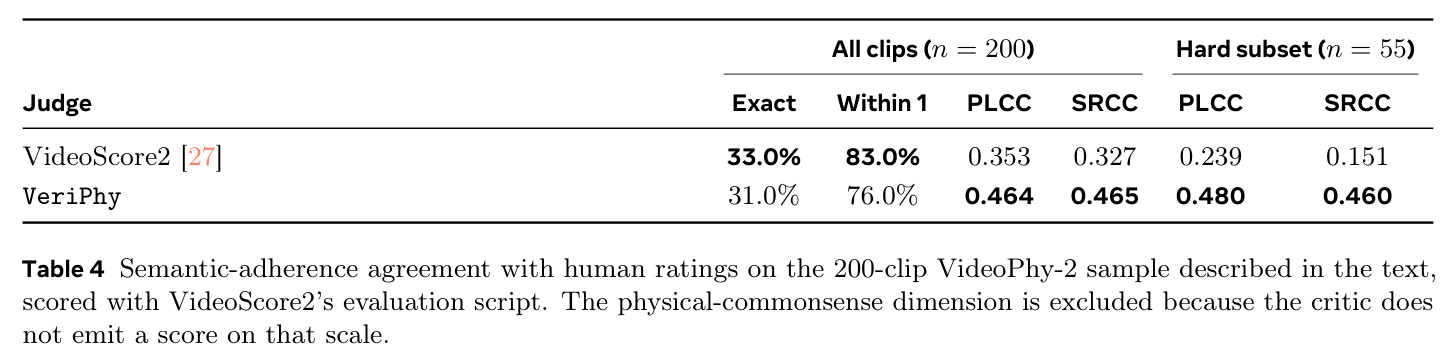
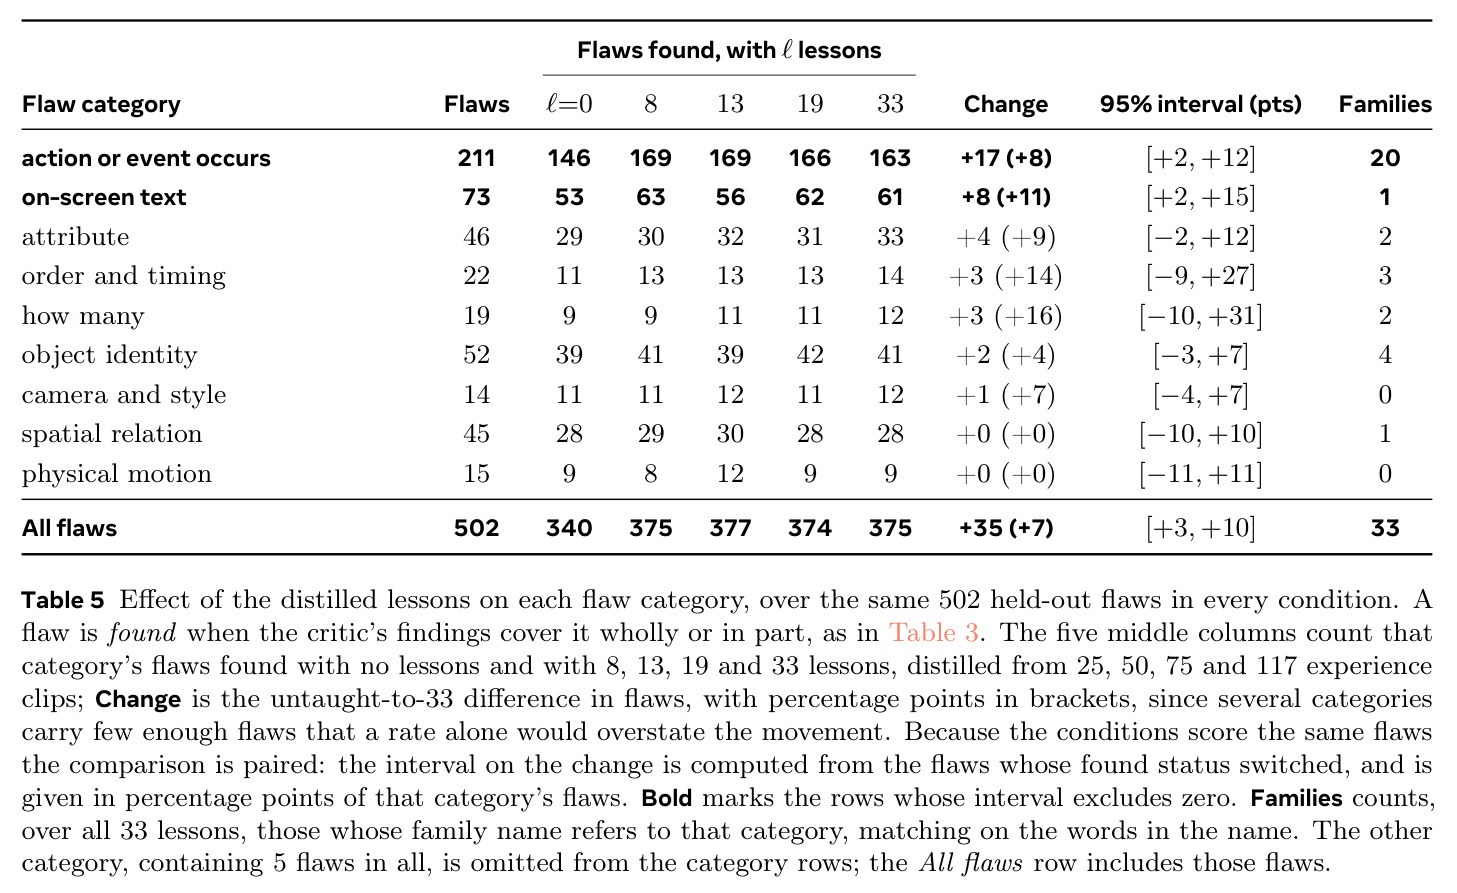
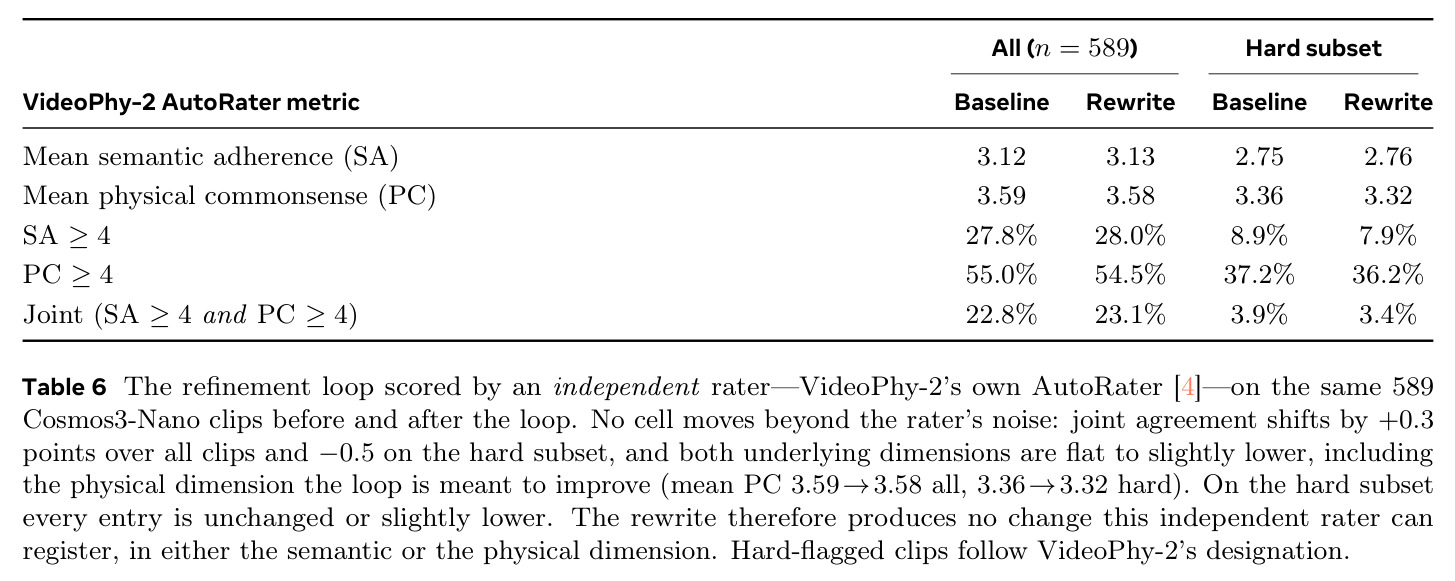
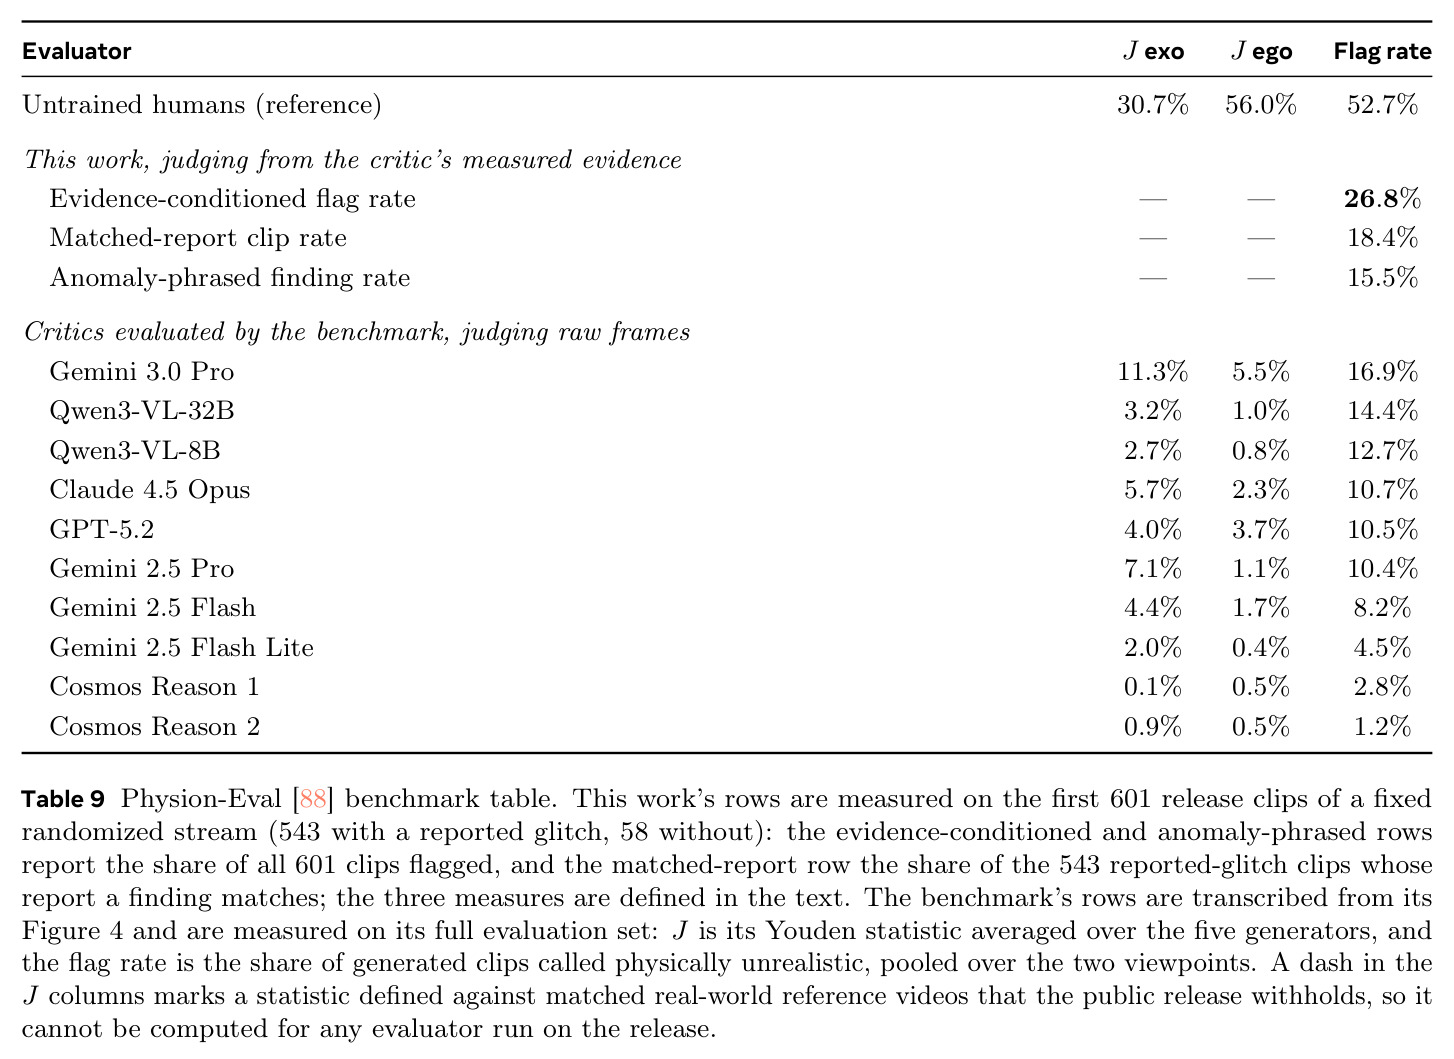
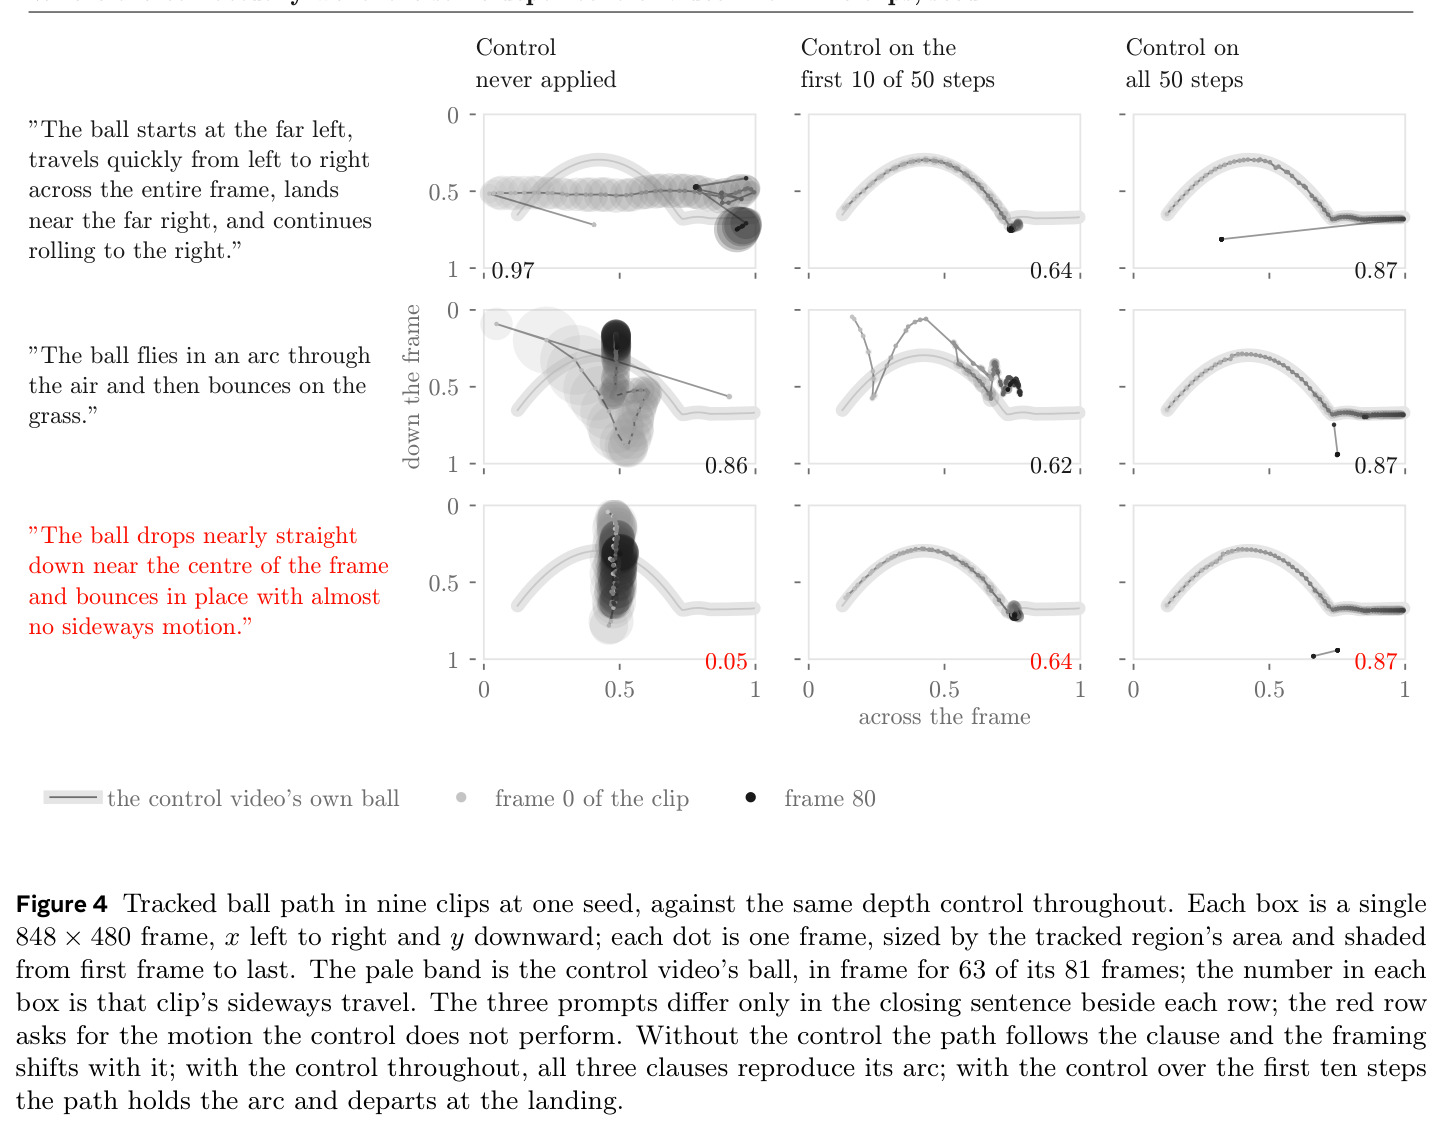
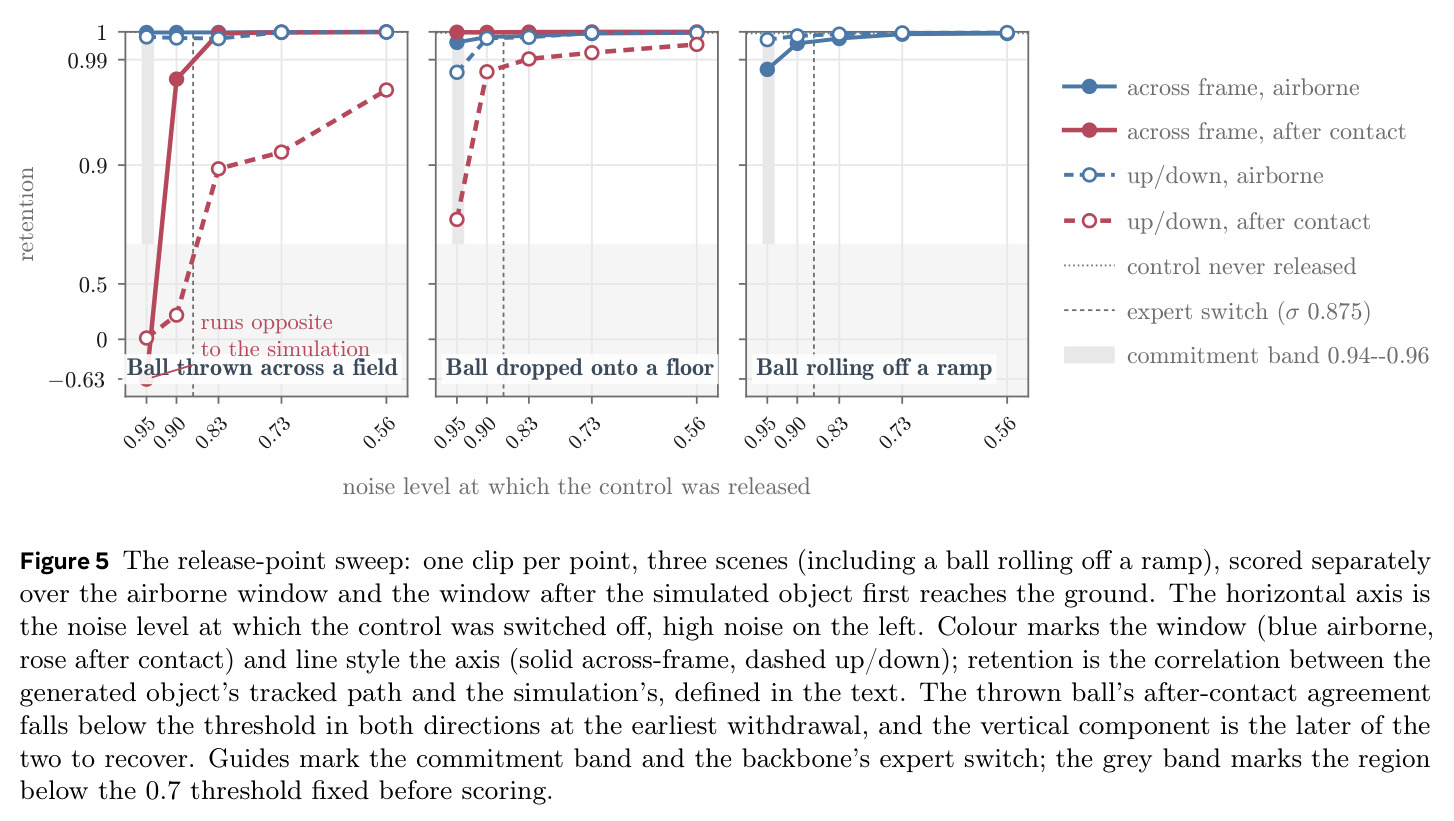
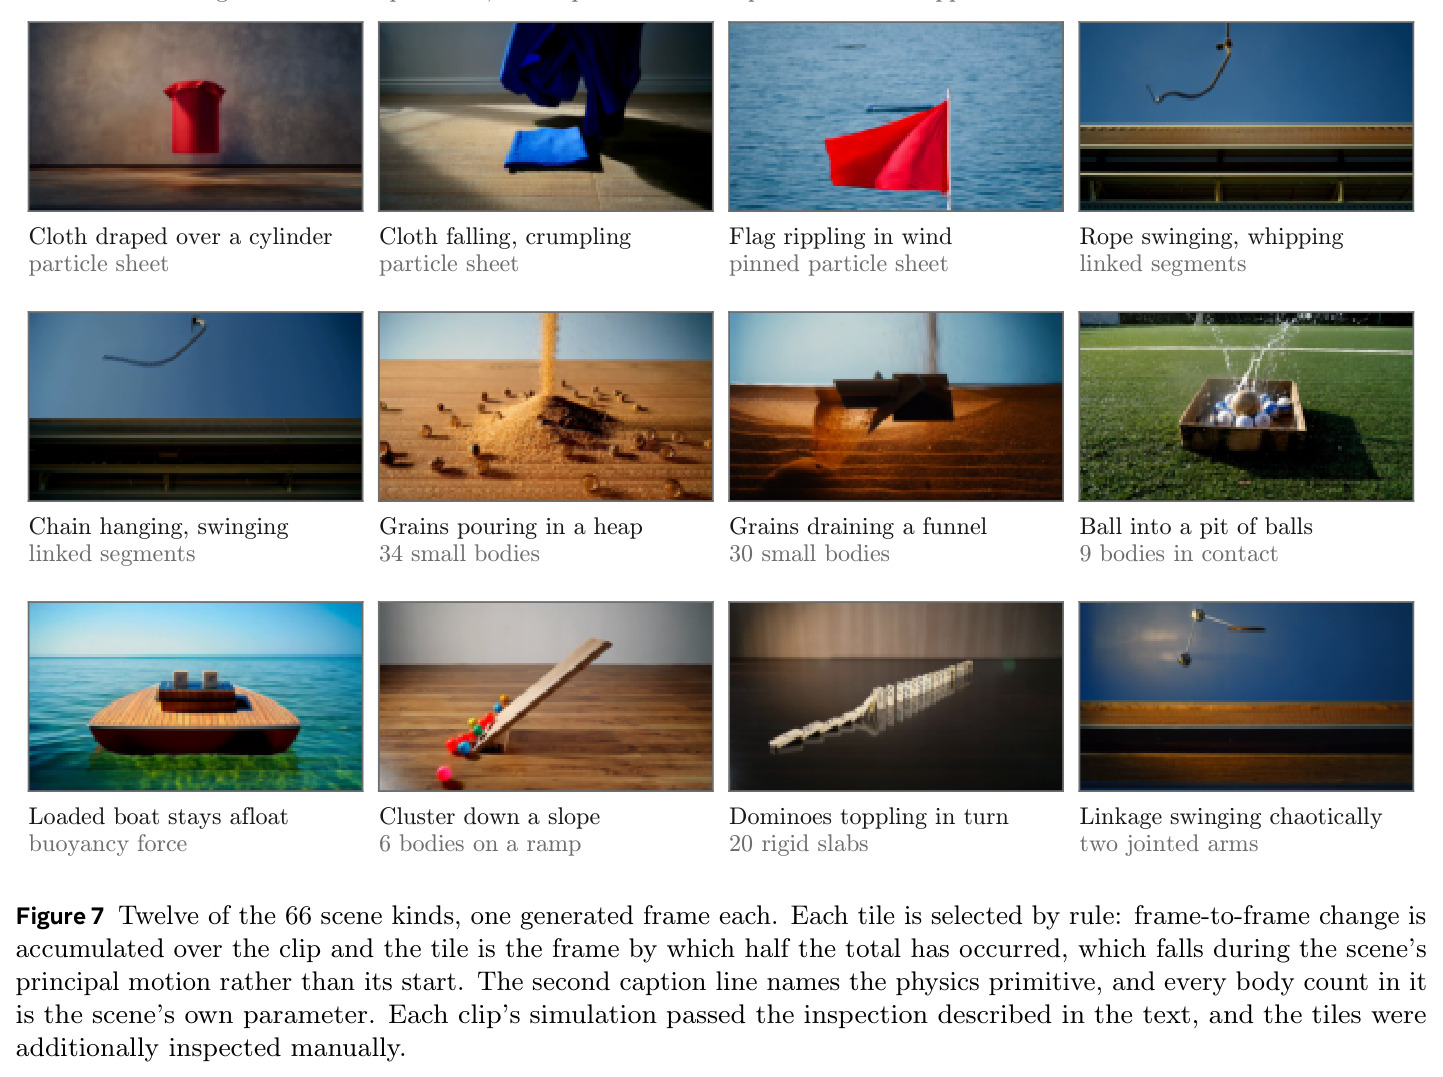
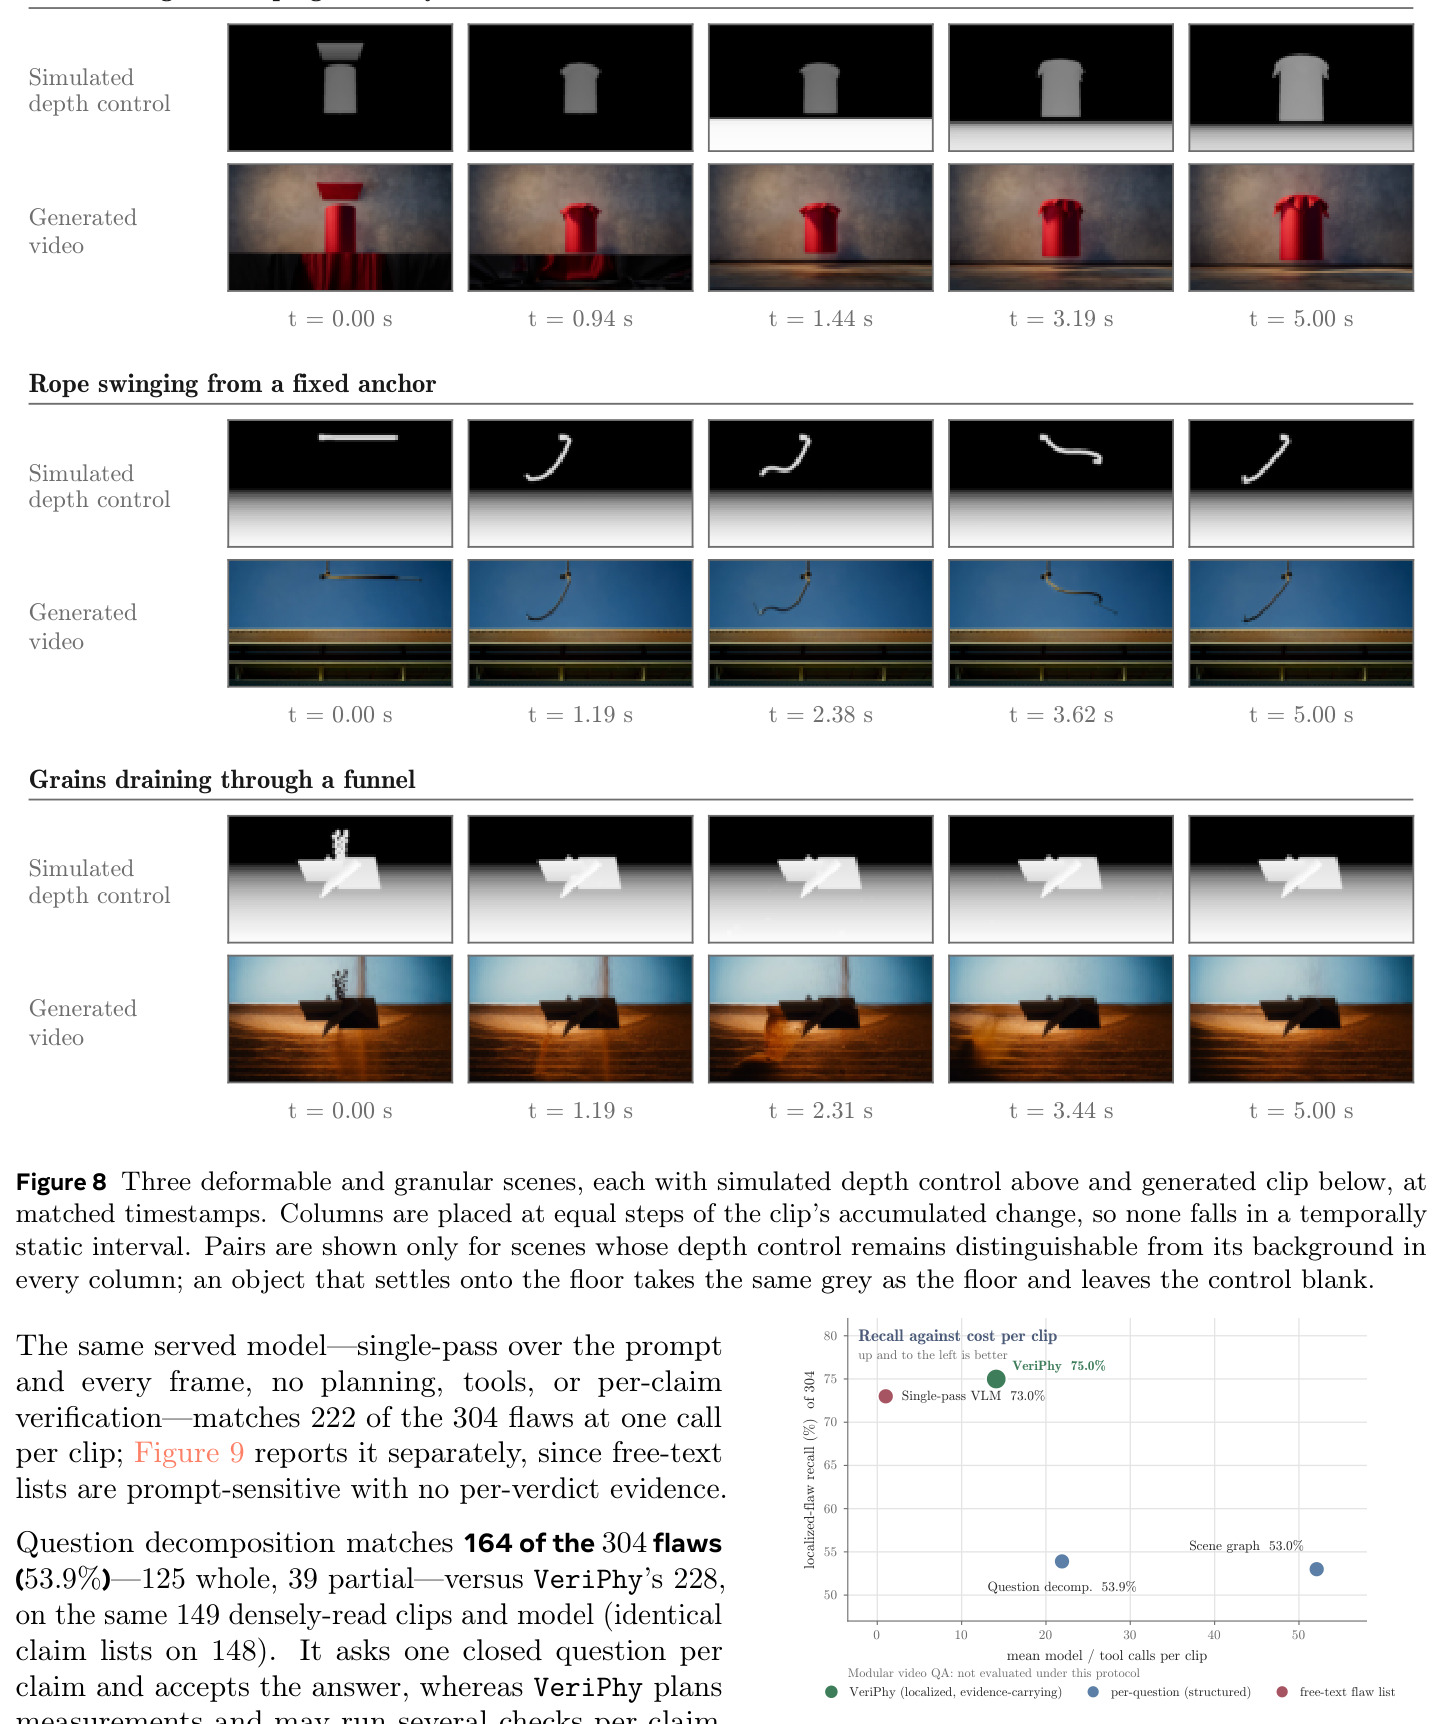
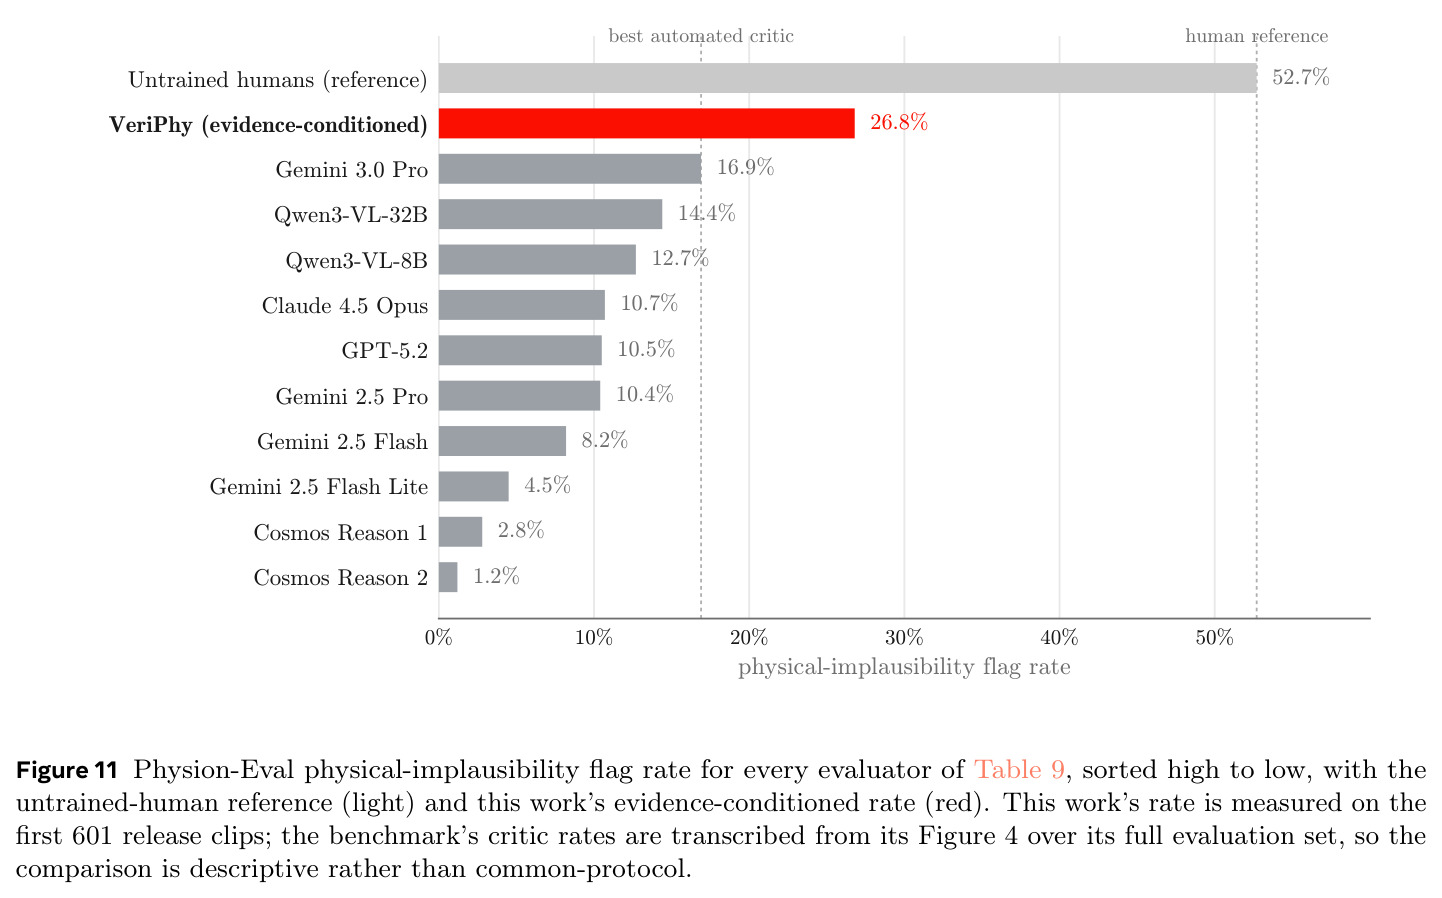
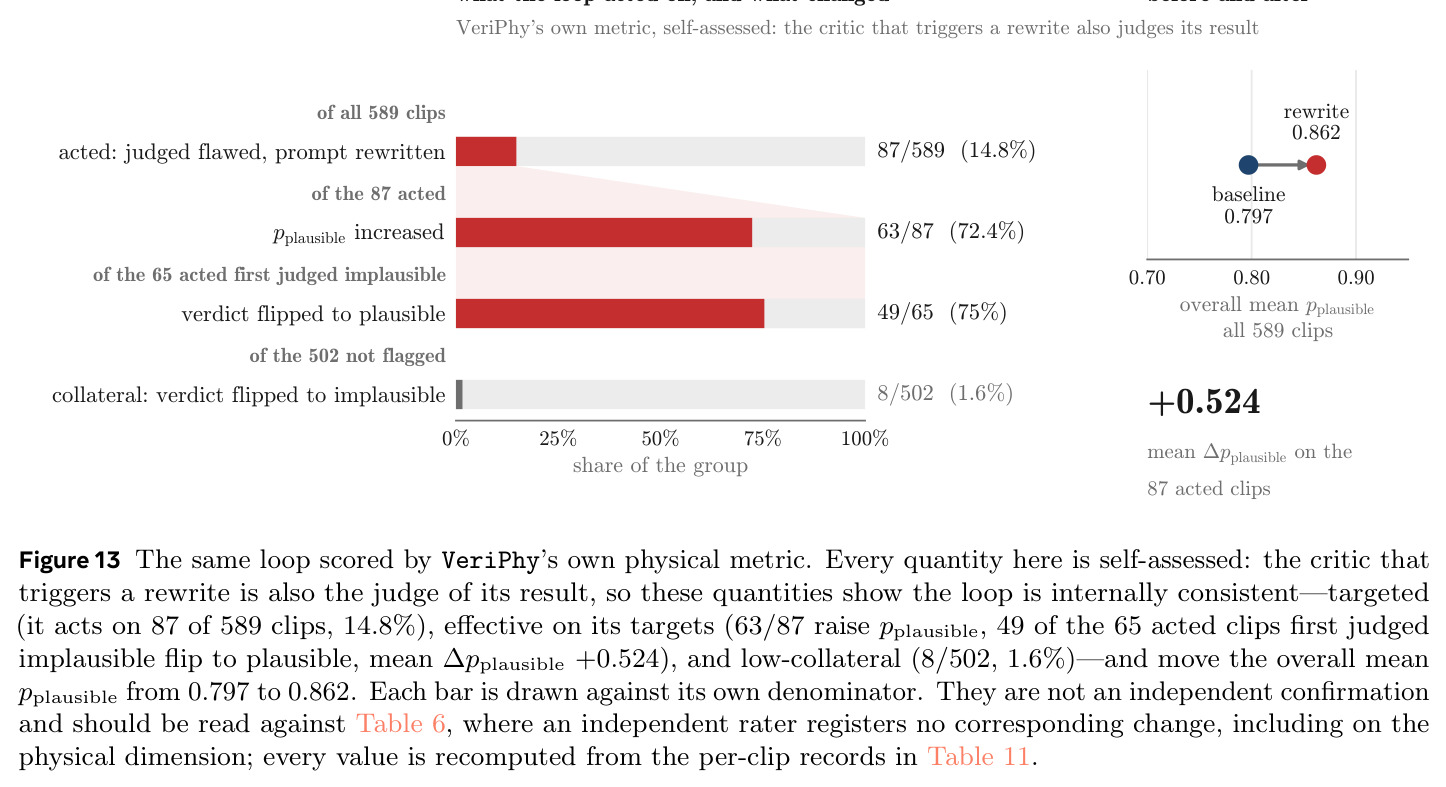
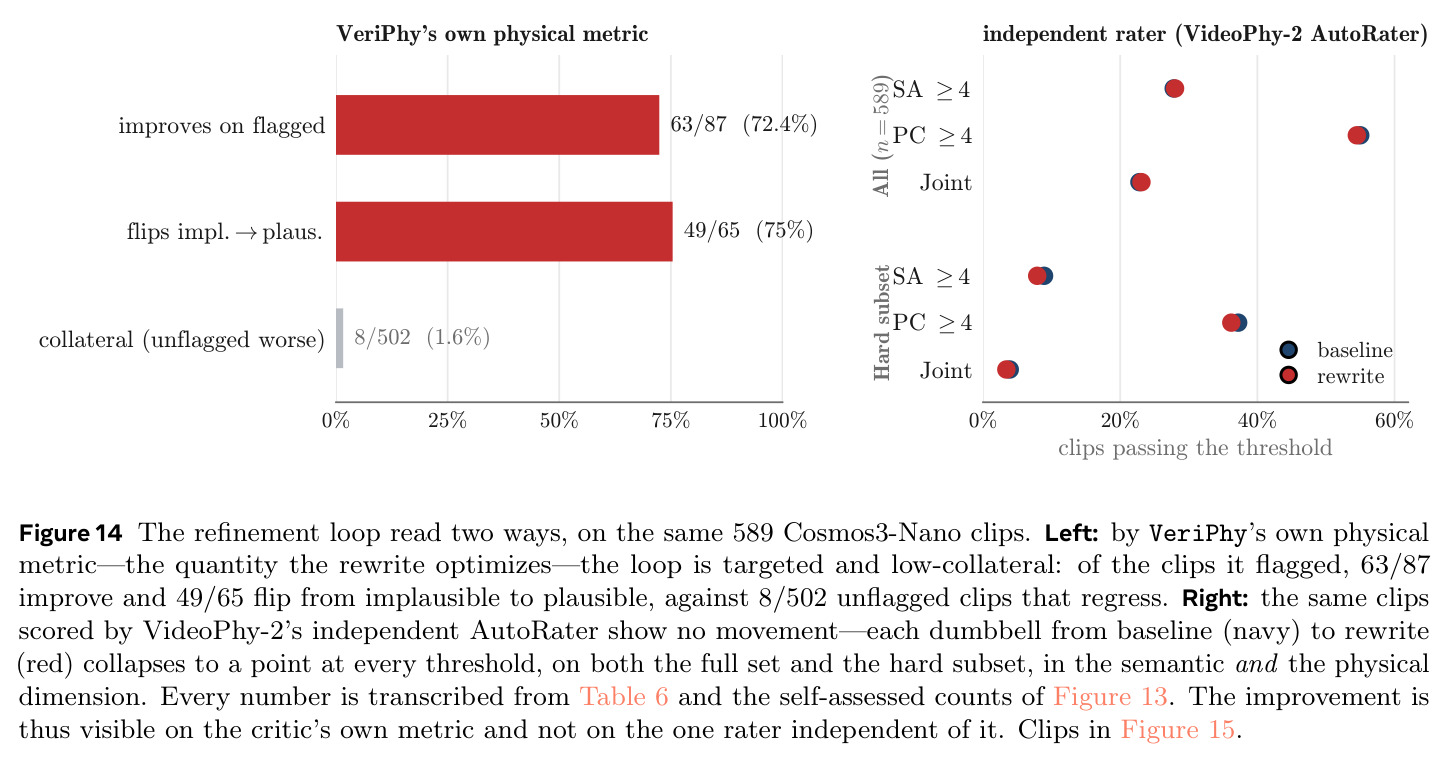
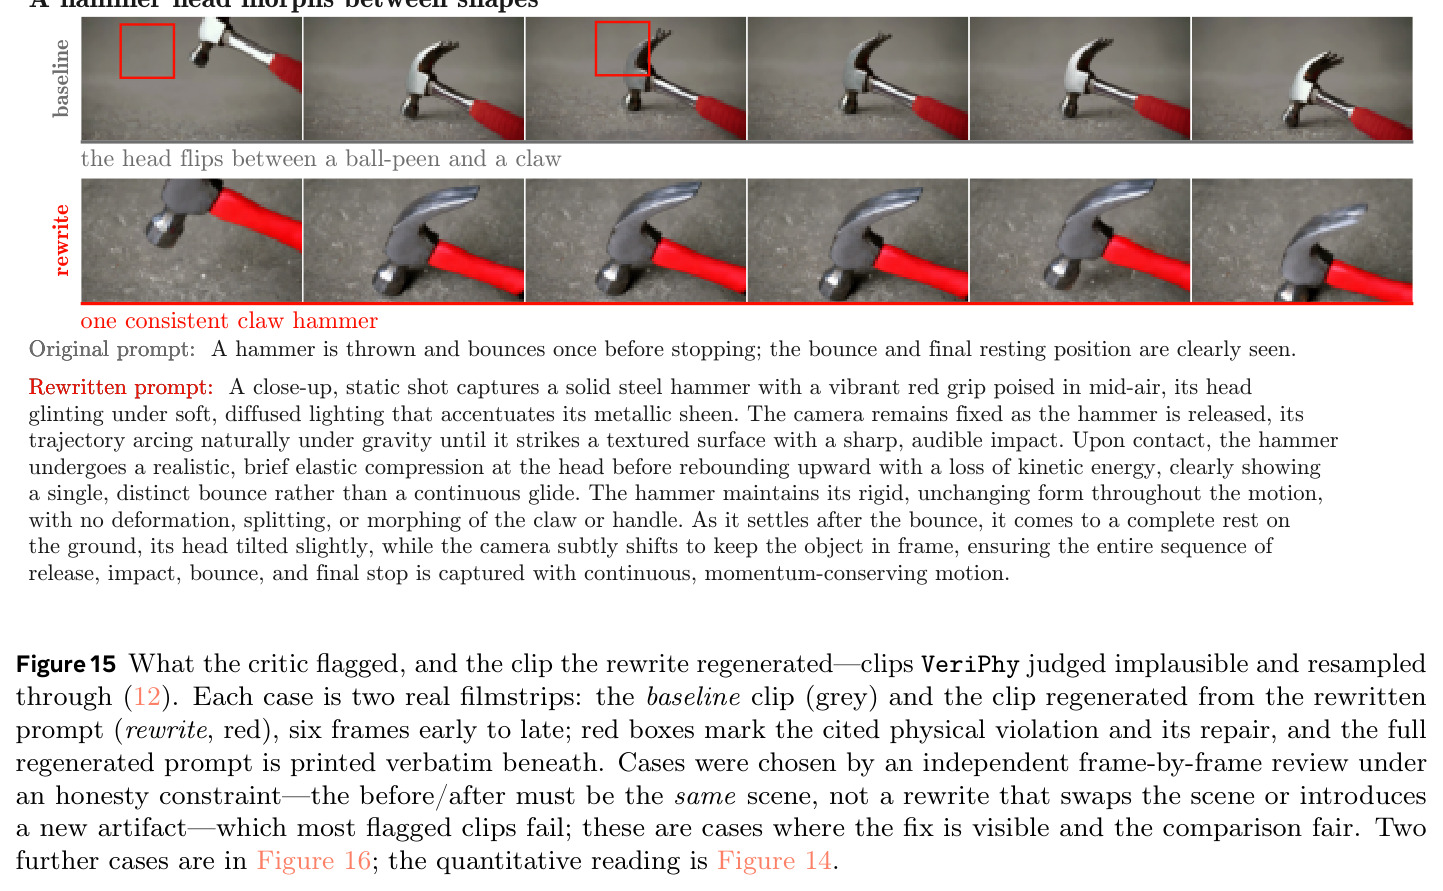
六个实验逐一读。(1) 缺陷召回:在 149 片段、304 条人工标注缺陷的开发核心上,VeriPhy 命中 228(75.0%,191 整匹配 + 37 部分),并在 91/149 片段上找全全部缺陷;已发表的问题分解评估器 164(53.9%)、Davidsonian 场景图 161(53.0%);同一骨干的单 pass 整体提示达 222(73.0%)但无任何证据留存。成本为每片段 14.1 次模型/工具调用(问题分解 21.9、场景图 52.1、单 pass 1.0)。作者坦承召回本身不能把 VeriPhy 与单 pass 区分开,差异在每条结论可打开查验测量、时间窗与组合规则。分解贡献:fallback 验证器 gpt-5.6-sol 推翻了 83/228 个通过判定;OCR 识别头的字面转写贡献了文本类命中。(2) 类别结构:相机/风格 90%、屏上文本 84%、动作事件 83%、时序 76%,计数最低 49%(众数陷阱),物理运动 4/7。物理专家被调 227 次,弃权 166、矛盾 61,弃权原因以'无通过语义守卫的候选 grounding'为主。(3) 片段级一致性:VideoPhy-2 的 200 片段上,VeriPhy exact 一致率 31% 略低于 VideoScore2 的 33%,但排序相关全面领先——SRCC 0.465 对 0.327(配对 bootstrap +0.138,95% CI [+0.005,+0.277]),55 条 hard 片段上 SRCC 0.460 对 0.151。(4) Physion-Eval 中期运行(前 601 片段)证据条件化标记率 26.8%,接近第二名 Gemini 3.0 Pro(16.9%)的两倍,未训练人类参考 52.7%(描述性对比)。(5) 生成器:控制全程施加时提示词可归因的位移范围从 0.875 压到 0.001;撤除探针定位承诺带 $\sigma\approx 0.94$–0.96——飞行段在 $\sigma=0.952$ 撤除后保留(相关仅降 0.003),接触后运动同点反向(−0.63),揭示接触是视频先验最弱环节;场景库 1,314 场景/66 类(591/652 仿真通过预渲染检查),单体贴合仿真、台球式多体碰撞全数失败。(6) 经验蒸馏:33 条 lesson 使 502 条 held-out 缺陷召回 340→375(67.7%→74.7%,配对符号检验 p=3×10⁻⁴),且 25 片段经验即饱和(8/13/19/33 lesson 分别 375/377/374/375,两两差 p≥0.8);类型化 claim 从 2,905 涨到 5,106(每片段 9.5→16.7)而每 claim 检查数仅 1.13→1.18,说明增益来自'把复合要求拆成更多可查 claim'。(7) 精炼回路:在 Cosmos3-Nano 的 589 片段上自评靶向(触发 87/589=14.8%,其中 63 改善、49/65 翻转为 plausible、误伤 8/502=1.6%,$p_{\mathrm{plausible}}$ 0.797→0.862),但独立 rater VideoPhy-2 AutoRater 全维度无变化(PC 3.59→3.58,hard 子集持平或略降)——作者把这一分歧本身作为结果,定位开放问题到纯文本改写通道。
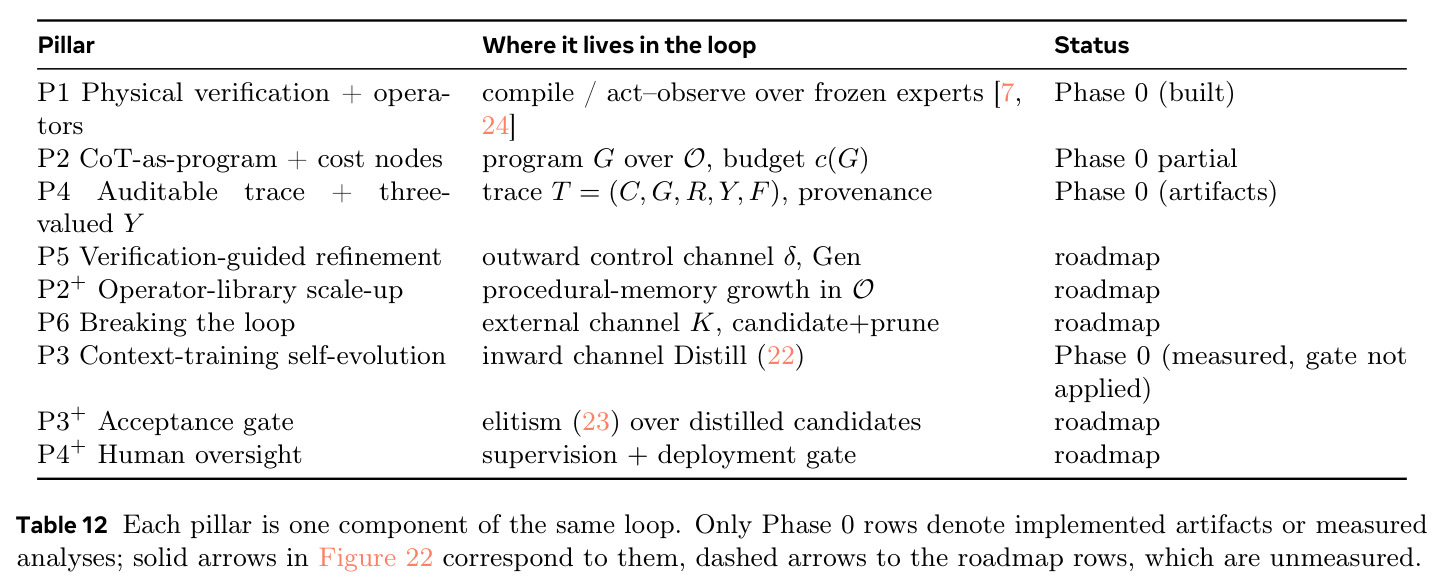
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 缺陷级召回(149 片段 / 304 条人类标注缺陷,开发核心) | Recall(whole+partial 匹配) | VeriPhy 228/304(75.0%),14.1 次调用/片段 | 问题分解评估器 164/304(53.9%,21.9 调用);Davidsonian 场景图 161/304(53.0%,52.1 调用) | +21.1 个百分点且调用数更低(对问题分解) |
| 缺陷级召回(同上) | Recall | 228/304(75.0%) | 同一骨干单 pass VLM 提示 222/304(73.0%,1.0 次调用) | 仅 +2.0 个百分点——作者强调差异在证据可审计性而非召回 |
| VideoPhy-2 片段级语义一致性(200 片段,含 55 hard) | SRCC / PLCC(对人类 1–5 评分) | SRCC 0.465 / PLCC 0.464(hard:0.460 / 0.480) | VideoScore2:SRCC 0.327 / PLCC 0.353(hard:0.151 / 0.239) | SRCC +0.138(95% CI [+0.005,+0.277]);hard 子集 SRCC +0.242 |
| Physion-Eval 物理不合理标记(前 601 片段,中期运行) | 证据条件化标记率 | 26.8% | 外部最佳 critic Gemini 3.0 Pro 16.9%;未训练人类参考 52.7% | +9.9 个百分点(描述性对比,非共同协议) |
| 经验蒸馏后的 held-out 缺陷召回(502 缺陷,306 片段) | Recall | 375/502(74.7%,33 lessons) | 无 lesson 340/502(67.7%) | +7.0 个百分点(净 +35,p=3×10⁻⁴;8 lessons 即达 375) |
| 几何控制对提示词隐含运动的覆盖(同一深度控制 × 3 子句 × 3 时机) | 子句可归因水平位移范围 | 0.001(控制全程施加,三种子句复现同一弧线) | 无控制 0.875(子句主导运动) | 降低近三个数量级;前 10 步控制为过渡态(0.060 对种子 0.427) |
| 验证引导的 prompt 改写再生(Cosmos3-Nano,589 片段) | p_plausible(VeriPhy 自评)与独立 AutoRater | 自评 0.797→0.862,触发 87/589,49/65 翻转,误伤 1.6% | 独立 rater 无变化:PC 3.59→3.58、joint 22.8%→23.1% | 自评有效但独立评估增益为 0——作者如实标注为开放问题 |
局限与改进
作者承认的:核心 149 片段是开发集而非 held-out,228/304 刻画系统现状而非泛化能力,且问题分解基线是在检视过 critic 输出之后才定稿的;语料只有带缺陷片段(无 clean clips),precision 不可测——'全部报警'即得满分召回,三值逻辑里 unknown 偏多还会天然低报;单标注者、无标注者间一致性;范围/类别标签由零温度模型投票机器生成;片段的生成来源未记录,反复对着一个冻结集设计有过拟合风险。控制信号来自仿真器,场景多样性受限于可仿真范围(库中无流体、烟雾、有限元软体),仿真到外观的映射本身未经物理一致性验证。空间关系谓词与负事件验证有限;binding(异构工具是否定位到同一物理实例)是核心失败模式;reasoner 介导的子检查只减轻、未消除语义不透明。经验蒸馏的 acceptance gate 未启用;taught 规划器每条 prompt 多读 1.76 倍 claim,而召回奖励'多问',效应与更大的计划混杂。我补充的观察:14.1 次调用/片段是单 pass 的 14 倍,大规模部署的性价比未讨论;计数众数陷阱在 49% 的类别召回里可见地伤害一整类缺陷;精炼回路被独立 rater 否定,说明 critic 自评改善与视频物理改善之间的等价性尚未建立;502-flaw 与 304-flaw 属不同人群,论文内多组数字不可横向比较,读者需小心;Figure 11/14 的对比也均为描述性而非共同协议。
独立分析的弱点
弱点一:计数路径脆弱——逐帧 grounding 间歇失败时,逐帧序列的众数会给出自信的零,与真实缺席不可区分(49% 召回的直接原因)。改进方向:要求'头/中/尾'三段均有稳定计数才接受 measured,否则弃权;或引入按帧置信度加权、跨段一致性检验。弱点二:成本结构——14.1 次调用/片段,且每条 claim 独立测量;用于大规模训练数据过滤时需要跨片段的 scope 缓存与 claim 剪枝(现有精确公共子表达式复用只在单片段内)。弱点三:评估单向——无 clean clips 导致 false-alarm 完全不可见,应补一批由强生成器产生、多人确认无缺陷的负样本来测 precision 与误报率,这也是三值系统最容易被'低报换高查准'博弈的地方。弱点四:改写通道只动文本——字面改写无法强制物理(独立 rater 已证无变化),应改走论文已铺好接口的 $\delta(F)$ 几何控制通道,把矛盾包映射为 MuJoCo 场景/控制的局部编辑。弱点五:binding 失败缺约束——可在 $G_\Pi$ 中引入实例 ID 的跨记录传播,并用 mask IoU 阈值校验不同工具是否锁定同一物理实例。弱点六:核心集单标注、非 held-out,先做双标注子集测 IAA,再把核心升级为冻结的 held-out 评测。
未来方向
作者明确提出的:音频跨模态验证是'下一个方向'——架构已把音频区间与视觉接触窗放在同一共享 A/V 时钟上,可定义'视觉接触窗 + 音频起始 + 类型化同步关系'的义务(可见碰撞无声、声音先于接触这类因果违规可测量而非凭感觉),但本报告全部测量均为视觉,容量未被使用;把矛盾包 $F(p,V)$ 经 $\delta$ 映射为控制信号的局部编辑并闭环重生成(式 (21) 两端已建,映射未做);启用 acceptance gate (23) 并研究在线经验积累;operator library 的蒸馏式增长与外部知识通道 K;规模化的人类监督(trace 审计、状态 diff 审批、部署门控)。基于成果可延伸的:把验证器用作世界模型训练数据的过滤器,在强化学习回路里剔除物理违规轨迹(论文提到强世界模型与下游策略性能相关,这是直接的落地出口);把矛盾包用作 preference optimization 的负例来源,做评估驱动的对齐;取回参考视频后补全 Physion-Eval 的 J 统计量,做真正共同协议的比较;把类型化义务进一步编译为形式规范、用模型检测做可证明验证;把缺陷级协议扩展到 precision 可测的混合语料,并在更多生成器族上验证承诺带等机制结论的普适性。
复现评估
组件开源程度很高且许可宽松:Qwen3-VL-30B-A3B(规划 + 语义验证,Apache-2.0)、SAM 3 0.9B(Meta 许可,grounding/计数)、TAPNext++(跟踪)、PaddleOCR PP-OCRv5 与 EasyOCR 回退、FlexSED(音频)均可直接获得;两个例外是深度排序模型 SenseNova-7B-MoT(CC-BY-NC-4.0,禁商用)和 fallback 验证器 gpt-5.6-sol(闭源、内部代理)——后者使头部 228/304 的数字难以逐位复现。数据方面,1,500 片段语料需人工逐条观看标注(每条缺陷含引用片段、理由、严重度 1–5、置信度、可选时间区间与框),重建成本高;论文称运行轨迹与逐片段记录随发布,项目页 veriphy-ai.github.io 提供精选的前后对比与完整改写 prompt。算力:Qwen3-VL 张量并行 2 GPU;Wan 2.2-VACE-Fun-14B 在 848×480、UniPC 50 步、guidance 5.0、bf16 下生成(1.3B 检查点先做粗筛)。综合难度中等偏上:系统组件多、协议复杂(匹配判定、三值规则、弃权语义、1/4 窗口松弛、深度 1%/97% 分位归一化、撤除调度式 (14) 等常数繁多),但论文对实现细节给出得异常详尽,且 Table 11 展示了从原始记录独立重算全部精炼数字、完全吻合的自查,工程可复现性态度在同类工作中属上乘。
论文图表
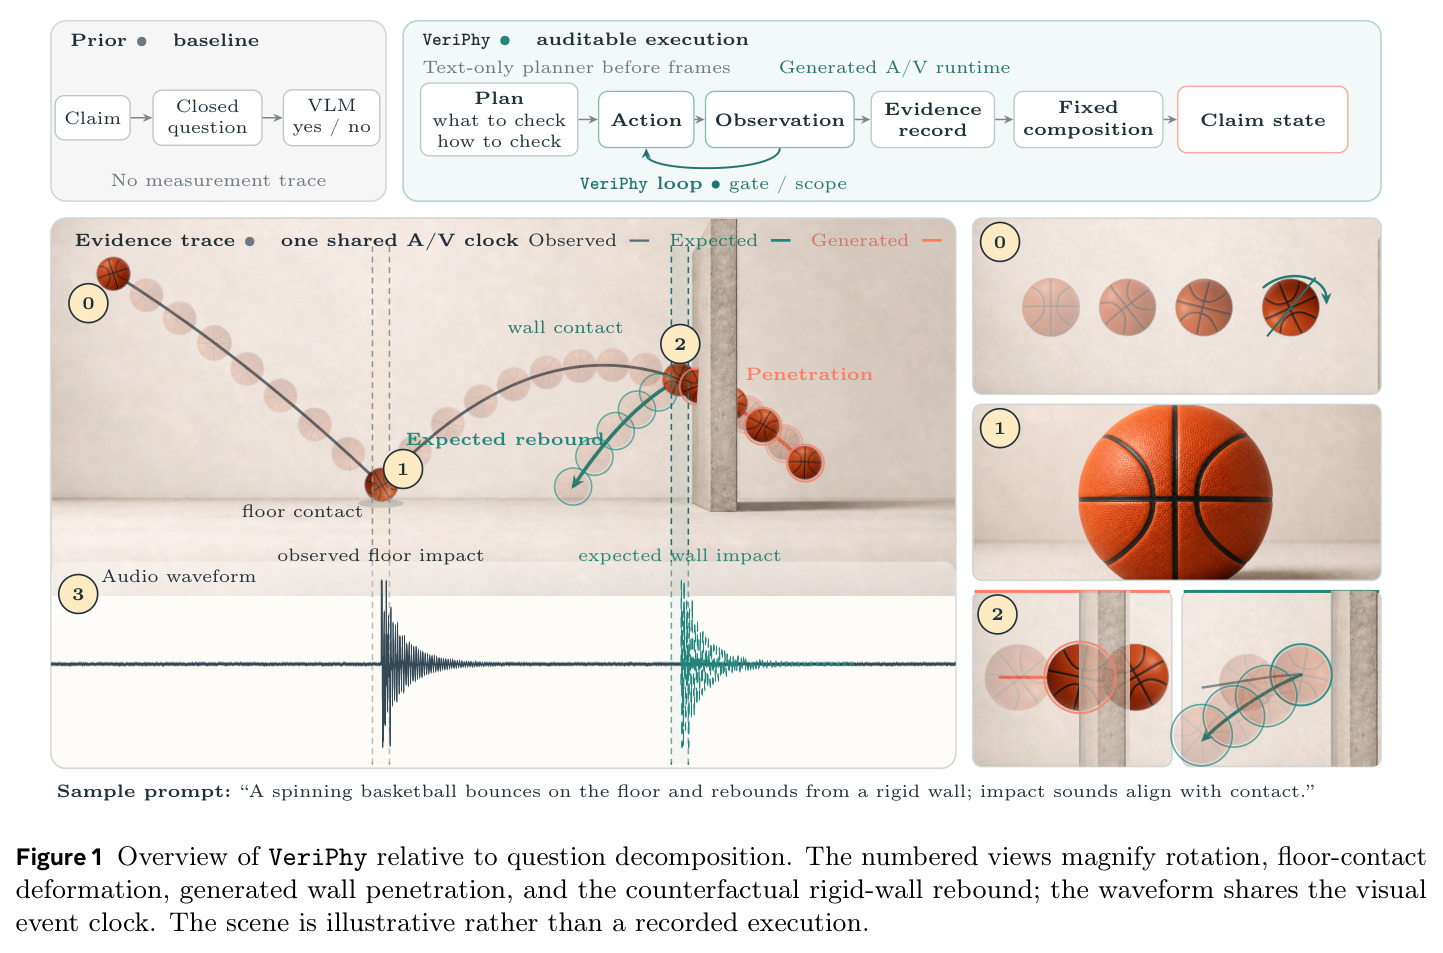
以'旋转篮球落地反弹并撞墙、撞击声与接触对齐'的示意场景对比 VeriPhy 与问题分解评估器:后者对每条 claim 只问封闭 yes/no 问题、无测量痕迹;VeriPhy 在看帧前由纯文本规划器产出义务与计划,执行时对冻结专家做门控/限定调用,证据记录经固定组合得三值判决。放大视图展示旋转、地面接触形变、生成的穿墙穿透与反事实刚性墙反弹;音频波形与视觉事件共享时钟。
一图读懂全文核心主张——'可审计证据链'与'无测量痕迹的判断'在系统结构上的差异,以及音视频共享事件时钟的设计意图。
502 条 held-out 缺陷的命中数随经验片段数的剂量曲线:未教 340(67.7%),8/13/19/33 条 lesson 分别 375/377/374/375,四个受教条件两两差异 p≥0.8,25 片段经验即达饱和;须点为相对未教变化的 95% 区间。
揭示文本化经验注入(不动权重)的收益幅度与饱和形态——少量、可读、可审计的经验即可获得全部增益,后续经验只改变命中哪些而非命中多少。
另两个改写案例:飞盘飞行中扭曲并短暂变成红球(改写后保持单一刚性圆盘)、足球被踢时复制成两颗(改写后单一足球),版式同 Figure 15,含完整改写 prompt。
补充改写案例的多样性(恒常性、对象数),与 Figure 15 共同构成对改写通道的定性证据。
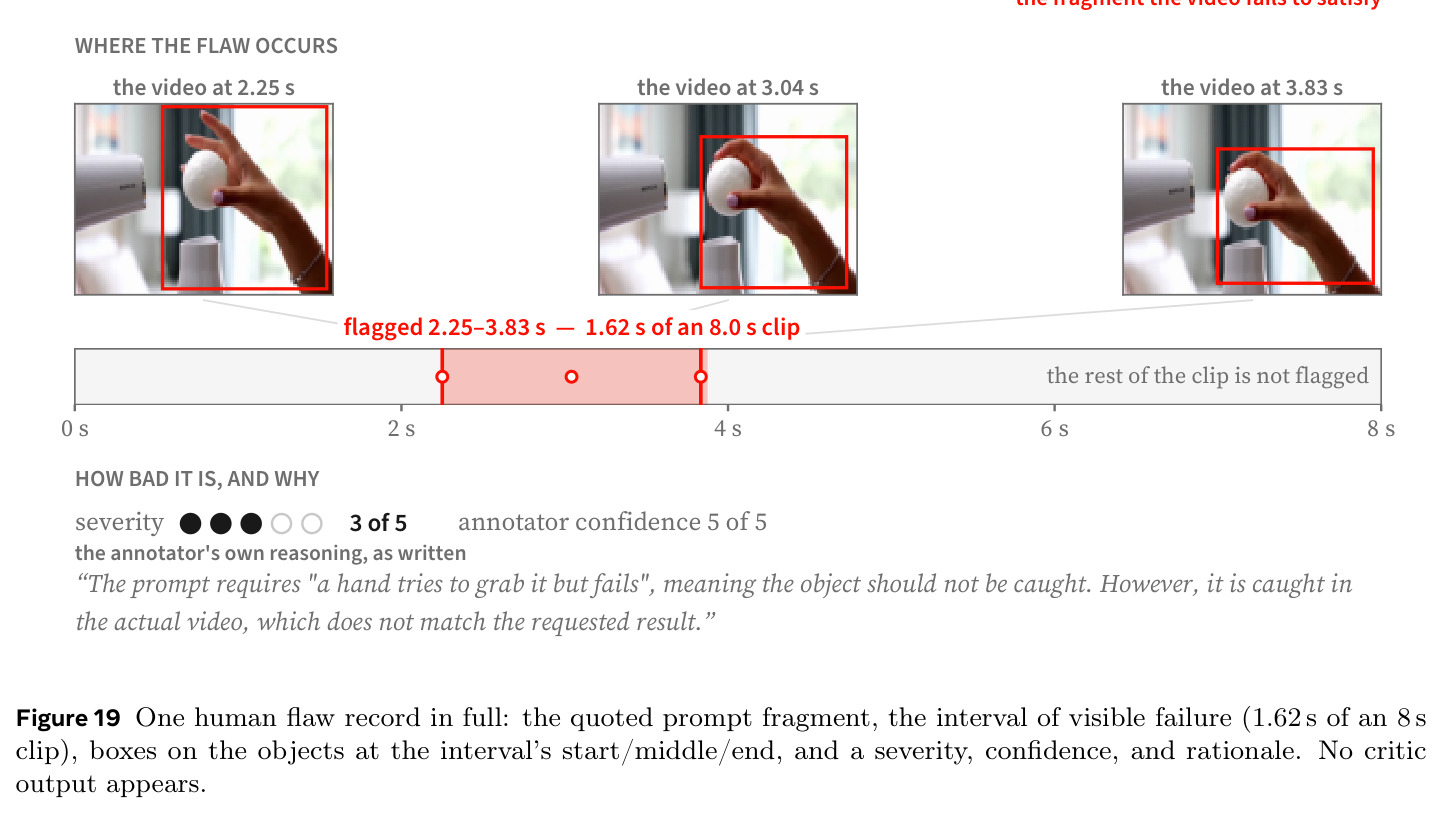
一条完整的人工缺陷记录示例(吹风机气流上平衡的乒乓球):prompt 原文、违规片段引用('手试图抓但失败'被违反——实际抓住了)、2.25–3.83s 的失效区间(8s 片段中的 1.62s)、区间首/中/尾的物体框、严重度 3/5、置信度 5/5 与标注者理由原文;不含任何 critic 输出。
具象化 2,582 条标注的字段设计,是理解匹配协议'指控对指控'比对对象的最直接材料。
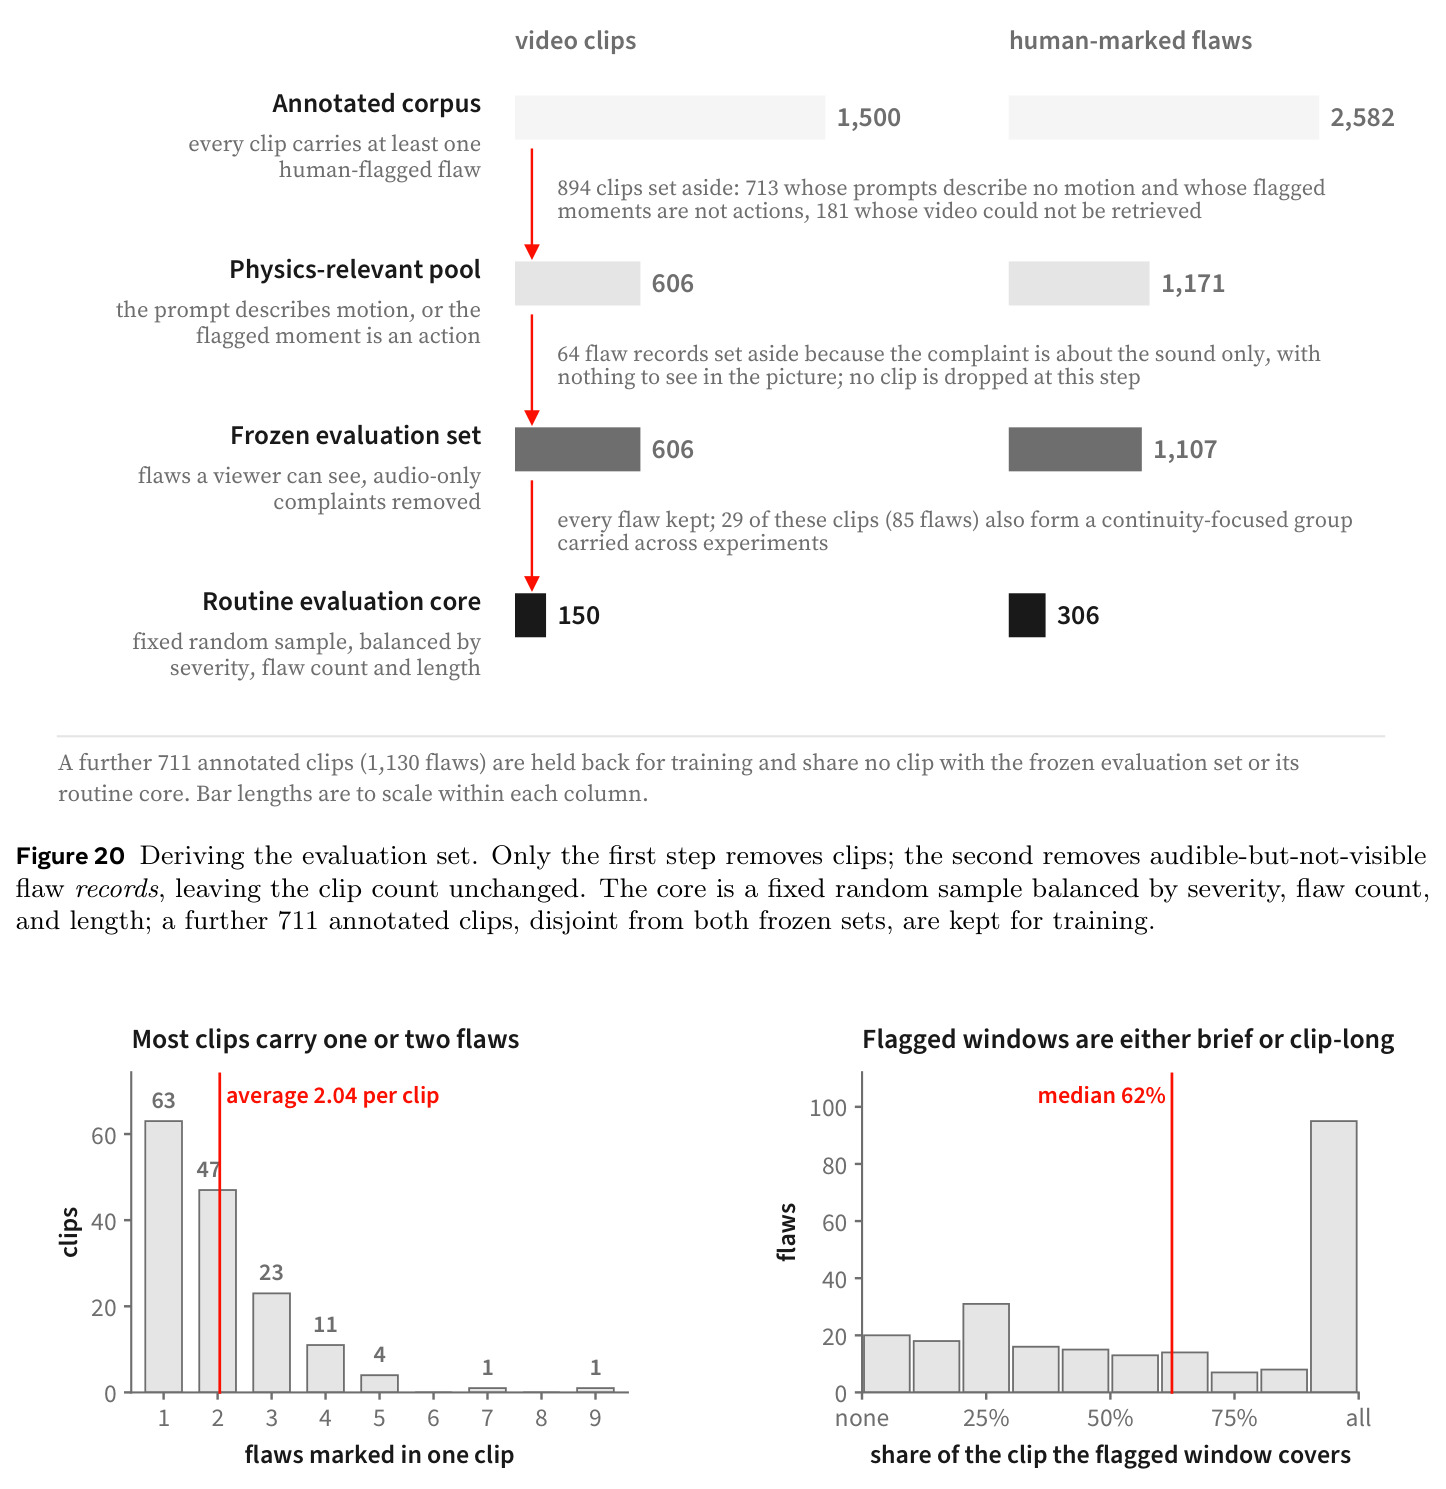
评估集漏斗:1,500 片段/2,582 缺陷→剔除 894 片段(713 无运动描述、181 不可检索)得物理相关池 606/1,171→剔除 64 条纯音频缺陷得冻结评估集 606/1,107→按严重度、缺陷数、时长分层固定抽样得常规核心 150/306(29 片段连续性层);另留 711 片段(1,130 缺陷)作训练,与前两者不相交。
所有评估数字的分母都由这张图决定;理解 149/304(一 clip 无测量被剔除而非计为未命中)这一微调对正确引用指标必要。
核心集两性质:左图——每片段缺陷数以 1–2 条为主(均值 2.04,63/47/23/11 片段对应 1–4 条);右图——被标记窗口时长双峰:57 条缺陷不超过片长 1/4,95 条占片长至少 9/10(中位窗口 5.00s,中位覆盖率 62%)。
解释为何检测器必须同时具备局部定位与整段检查两种能力——这是 VeriPhy 设计 scope 回退(局部失败退回全片段)的数据依据。