优化中的渗流动力学:方差级联与离散标度不变性 Percolation Dynamics in Optimization : Variance Cascades and Discrete Scale Invariance
把SGD训练建模为对称性诱导的渗流过程,参数坍缩表现为离散标度不变的方差尖峰级联
前置知识
随机梯度流(SGF)
把离散的 SGD 迭代 $\theta_{t+1}=\theta_t-\eta\nabla\mathcal{L}_{B_t}(\theta_t)$ 近似为连续时间的 Itô 随机微分方程 $d\theta_t=-\nabla\mathcal{L}(\theta_t)dt+\sqrt{\eta}\,\Sigma(\theta_t)dW_t$,其中 $W_t$ 是维纳过程,$\Sigma$ 是小批量梯度的位置相关噪声协方差。它把优化看作确定性漂移下降与随机扩散的持续竞争。
本文所有定理都建立在 SGF 这个连续模型上:困陷、生成元与上鞅分析均需在 SDE 语言下展开,离散 SGD 只在仿射不变集情形下与 SGF 保持一致(命题 2.3)。
不变集与随机吸引性
不变集 $A$ 是一旦进入便不会离开的参数子集,由架构对称性(如神经元置换)造成的平坦仿射子空间生成。随机吸引性(定义 2.4)指在 $A$ 的邻域内,确定性内向梯度漂移压过向外扩散,形式化为横向距离过程 $Y_t=\|\theta_t-\pi_A(\theta_t)\|_2^2$ 的生成元满足 $\mathcal{A}Y_t\le 0$,即使集内含鞍点或局部极大也能困住轨迹。
这是子网络轨迹被'绑定'进同一等价类的力学根源——渗流图的每条边都来自这种随机吸引性驱动的同步化。
渗流理论与序参量
渗流研究随机图中连通集团的形成:边以密度 $p$ 独立出现,当 $p$ 越过临界值 $p_c$ 时涌现贯穿系统的巨连通分量。序参量 $O(p)=|C_{max}(p)|/N$ 度量最大连通分量的相对规模;在经典 Erdős–Rényi 模型中,组件通过单边连接使 $O(p)$ 连续增长。
本文的核心论点是架构对称性使组件增长变成整块跳变而非单边连接,序参量的跳变与方差行为偏离经典图像,是全部理论与实验结论的载体。
Reeb 图
Reeb 图是拓扑数据分析中的商空间构造:沿某个函数把等价的水平集粘合,只保留连通分量的合并与分裂骨架。本文把 $K$ 个子网络的路径测度视为节点,将吸引子等价类投影到商空间 $\mathcal{R}=(S\times[0,\infty))/\sim_R$,拓扑合并对应入度>1 的顶点,分裂对应出度>1 的顶点。
它是从连续随机轨迹到离散渗流图之间的中间表示,'凝聚(∪)与碎裂(∅)'两类拓扑转变都在 Reeb 图上定义,随后才被时间重整化为渗流图。
离散标度不变性(DSI)
DSI 指观测量 $f(x)$ 仅在一组离散放大因子 $\lambda^{(n)}=n^\sigma$ 下保持自相似,是连续伸缩对称性破缺到离散子群($C_1\to nC_1$)的产物。本文表现为微观转变密度按几何级联逼近临界点:$\lim_{i\to\infty}(p_c-p_{ni})/(p_c-p_i)=1/\lambda(n)=n^{-\sigma}$。
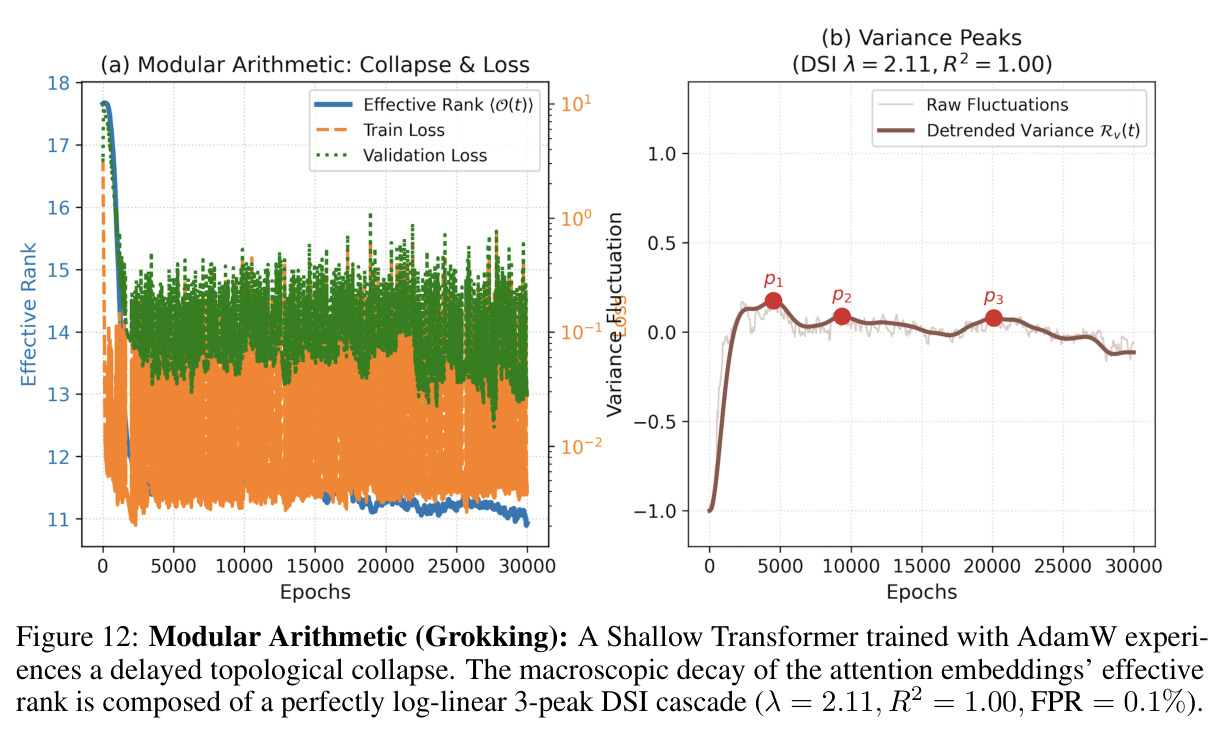
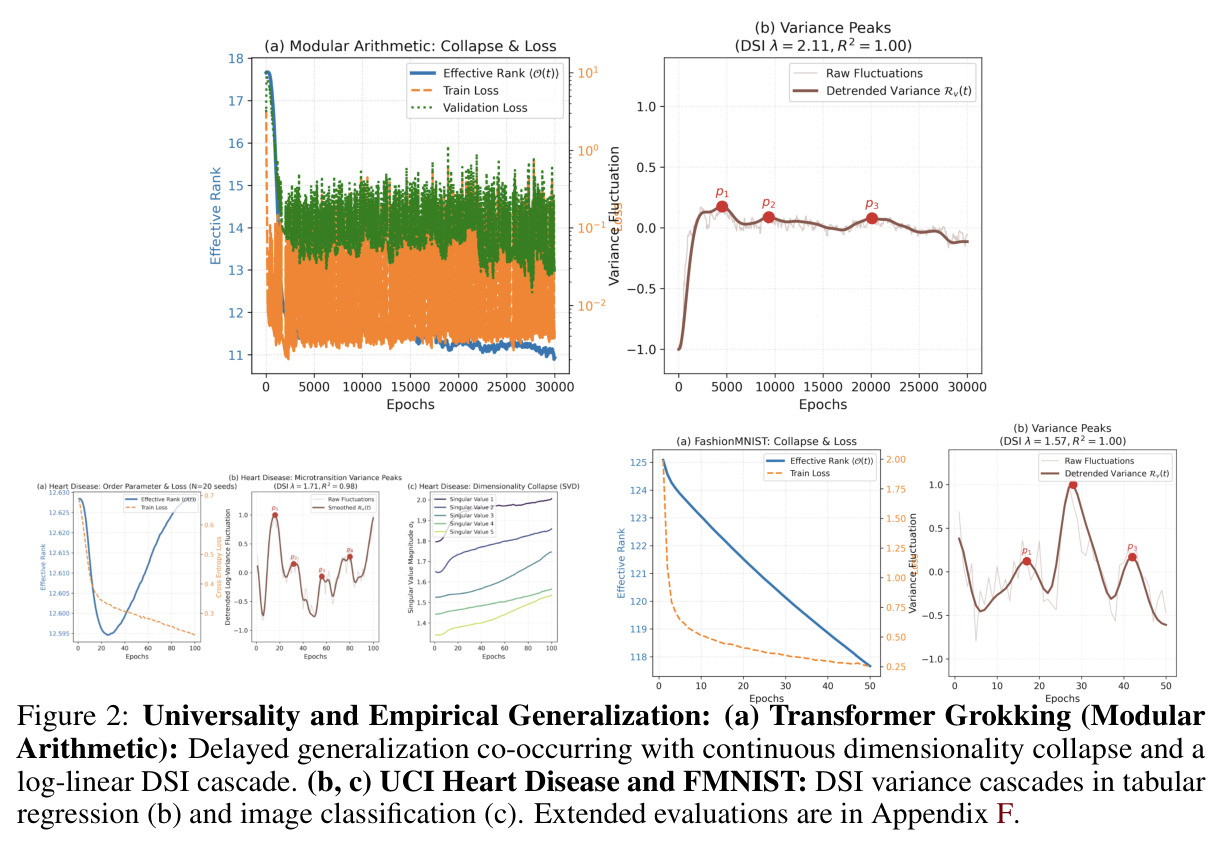
DSI 级联是本文最核心的可检验预测:实验通过相对方差尖峰在 log 时间轴上的等间隔(几何级数)排列来检测它,grokking 实验测得 $\lambda=2.11$。
Grokking(延迟泛化)
指网络先完美记忆训练集、测试准确率停留在随机水平,再经过数千个 epoch 后突然跃迁到完美泛化的现象,典型场景是小 Transformer 学习模运算(Power 等 2022)。它挑战了'优化平滑推进'的经典观点,暗示动力学拓扑结构中藏有关键信息。
论文把 grokking 作为高维真实场景的试金石:实测到 3 峰 DSI 级联紧邻性能尖峰出现,是把理论从玩具模型推向深度学习的桥梁。
上鞅与 Doob 极大不等式
上鞅是条件期望随时间不增的随机过程。Doob 极大不等式给出上鞅越过阈值的概率上界,例如轨迹逃逸 $\epsilon$-邻域的概率被 $1-\epsilon^{-1}E[Y_t^{(i)}|\mathcal{F}_t]$ 控制;当横向距离期望压到零时,逃逸概率随之消失。
它是困陷定理 3.3、概率性不逃逸推论 3.4 与等价类传递性(定理 3.6)的统一证明工具,理解'联合生存事件收敛到必然'必须掌握。
研究动机
深度学习系统不靠显式正则化也能获得强泛化,这被归因于训练中的隐式偏置:SGD 会把网络坍缩到行为如同更简单子网络的不变集上。但这种'转向'在时间上如何展开仍是黑箱。具体的异常场景包括:Transformer 在模运算任务上先完美记忆训练集、数千个 epoch 后才突然泛化的 grokking 现象(Power 等 2022);精确深度线性网络的阶段性相变(Saxe 等 2013);以及任务切换时的突变行为(Goodfellow 等 2013)。经典相变理论(如 Erdős–Rényi 随机图)假设组件通过独立的单边连接连续增长,无法解释这些离散、突变的训练动力学,导致我们缺乏机制性工具来预测和解释训练中的临界行为。
本文的目标是本文目标是为 SGD 及其自适应变体 Adam/AdamW 驱动的'拓扑坍缩'建立可证明、可测量的动力学模型。具体分三层:其一,把随机梯度流(SGF)在不变集附近的轨迹凝聚形式化为渗流过程,刻画架构对称性如何迫使子网络以离散的整块同时合并(而非逐边连接),并给出跳变在热力学极限 $N\to\infty$ 下是否存活的精确判据;其二,证明这种多体块合并会使跨种子相对方差 $R_v$ 在临界密度 $p_c$ 前发散,并诱导离散标度不变性(DSI)几何级联,从而给出全局坍缩临界点的可检验预测;其三,在显式重尾噪声模型下把困陷机制推广到 Adam/AdamW,并用玩具模型、UCI 表格数据、视觉基准与 Transformer grokking 验证级联结构真实出现。
与已有工作不同的是,已有工作要么只证明 SGD 最终收敛到低秩流形(Blanc 等 2020、Nacson 等 2022、Chen 等 2023)而不追踪瞬态路径;要么把渗流工具用于训练,但研究对象是 dropout 下的连通性(Devlin and Sanders 2025)或预测性能的突触不变量(Li 等 2022a),其边由随机删除或相关性驱动;凝缩(condensation)文献(Luo 等 2021)则聚焦初始化尺度而非对称性。本文的独特切入点是:把'参数轨迹'而非'权重'当作节点,把对称性诱导的吸引子等价 $\sim_A$ 当作瞬态边,先投影到连续 Reeb 图,再做时间尺度重整化得到边密度单调递增的渗流图。这一非平衡视角强调:微观布朗涨落不断打断并重建边,但在宏观尺度上积分掉涨落后,凝聚趋势单调推进边密度 $p$,使训练可被当作对称性驱动的非经典渗流相变来分析。
核心方法
整体直觉是:架构对称性(如神经元置换)在参数空间中制造平坦退化区域(不变集),SGF 中确定性漂移与噪声的竞争把轨迹困在其中,独立参数进入同一不变集后'融合'成等价类,参数空间拓扑随之折叠简化,宏观上表现为方差尖峰。技术路线分五步:(1) 把离散 SGD 近似为 Itô SDE $d\theta_t=-\nabla\mathcal{L}(\theta_t)dt+\sqrt{\eta}\,\Sigma(\theta_t)dW_t$;(2) 证明随机吸引性使横向距离 $Y_t$ 成为非负局部上鞅,轨迹概率性不逃逸;(3) 以吸引子等价 $\sim_A$ 为瞬态边,把子网络轨迹投影为 Reeb 图,刻画凝聚(∪)与碎裂(∅)两类拓扑转变;(4) 在快慢时间尺度分离 $\tau_{fast}\ll\tau_{slow}$ 下重整化为单调渗流图 $G_\tau$,跟踪序参量 $O(p)=|C_{max}(p)|/N$;(5) 用跨种子相对方差 $R_v(p)$ 定位微观转变,推导 DSI 几何级联,级联可外推预测临界密度 $p_c$。
核心创新是发现对称性从根本上改变渗流的连续性机制。经典 Erdős–Rényi 渗流中组件靠单边连接连续增长($C_1\to C_1+1$);本文证明神经元置换群 $S_n$ 在拓扑上限制边的形成:$n$ 条不可区分的路径测度必须同时绑定,产生 $n$ 体块合并,每次微观转变使序参量跳变 $\Delta O(p)=(n-1)i/N$。定理 4.4 给出该跳变是否为真实相变的精确判据:当合并组件在合并时刻已是宏观规模($i=\Theta(N)$)时,跳变在 $N\to\infty$ 下存活;当 $i=O(1)$ 时跳变消失,转变渐近连续(推论 C.18)。这种刚性多体增长把连续李群伸缩破缺为离散子群,进而强制产生 DSI:微观转变密度锁定在几何级联 $p_i=p_c-A_\sigma i^{-\sigma}$ 上,放大因子 $\lambda(n)=n^\sigma$(定理 4.7)。这一'对称性→块合并→跳变→DSI'的因果链是与所有先前工作的本质区别。
方法步骤详情
流程依次为。第一步:输入小批量更新 $\theta_{t+1}=\theta_t-\eta\nabla\mathcal{L}_{B_t}(\theta_t)$,分离全批梯度与零均值噪声,输出 SGF SDE 连续模型。第二步:由横向生成元 $\mathcal{A}Y_t^{(i)}\le 0$ 证明上鞅困陷(定理 3.3)与逃逸概率上界(推论 3.4)。第三步:定义吸引子等价 $\sim_A$(联合连接概率 $P_{link}^{(i,j)}(t)\to 1$),把 $K$ 个子网络聚成等价类(定理 3.6),投影为 Reeb 图并证明凝聚/碎裂两机制(定理 3.7)。第四步:在快慢尺度分离下重整化,积分掉微观布朗涨落,输出边密度单调递增的渗流图 $G_\tau$ 与序参量 $O(p)$。第五步:由 $S_n$ 块合并推得跳变 $(n-1)i/N$ 及存活判据 $i=\Theta(N)$(定理 4.4),证得 $R_v(p)\propto(\Delta O)^2$ 在 $p_c$ 前发散(定理 4.5),以及级联 $(p_c-p_{ni})/(p_c-p_i)\to n^{-\sigma}$(定理 4.7)。第六步:对 Adam/AdamW,在重尾噪声 $E|g_{t,i}|^p\le\sigma^p$ 下截断梯度,用 z 变换分析动量与二阶矩滤波器(记忆尺度 $\tau_1=1/(1-\beta_1)$、$\tau_2=1/(1-\beta_2)$),控制残差 $R_t$ 后证明条件困陷与同标度 DSI 级联(定理 5.4/5.5)。
技术新颖性
技术新颖性有四点。其一,'Reeb 图重整化为渗流图'(定理 4.3)是全新构造:先在连续路径空间用商空间捕捉等价类的并与分,再在宏观时间尺度积分掉瞬态涨落,得到边密度单调推进的渗流图——区别于直接对权重矩阵二值化或相关性阈值化的做法。其二,非 Erdős–Rényi 不连续性定理(4.4)给出跳变在热力学极限下存活的精确尺度条件 $i=\Theta(N)$,划清了有限尺寸伪影与真实相变的边界。其三,引入相对方差 $R_v(p)$ 作为实验探针:噪声会移动单条轨迹的转变阈值,单轨迹观测会掩盖临界点;而跨种子集合的 $R_v$ 在转变处以 $(\Delta O)^2$ 发散(定理 4.5,基于双峰共存论证),成为可操作、可自动化的峰检测器。其四,Adam 扩展并非简单套用:元素平方 $v_t$ 把容许对称群从一般正交 $Q$ 收窄到坐标置换 $P_\pi$;重尾噪声需截断处理,且 $\hat{V}(z)$ 不能由 $\hat{G}(z)^2$ 构造,必须经特征函数 $\Phi$ 求导获得——每一步都处理了自适应优化器的真实数学结构。
实验结果
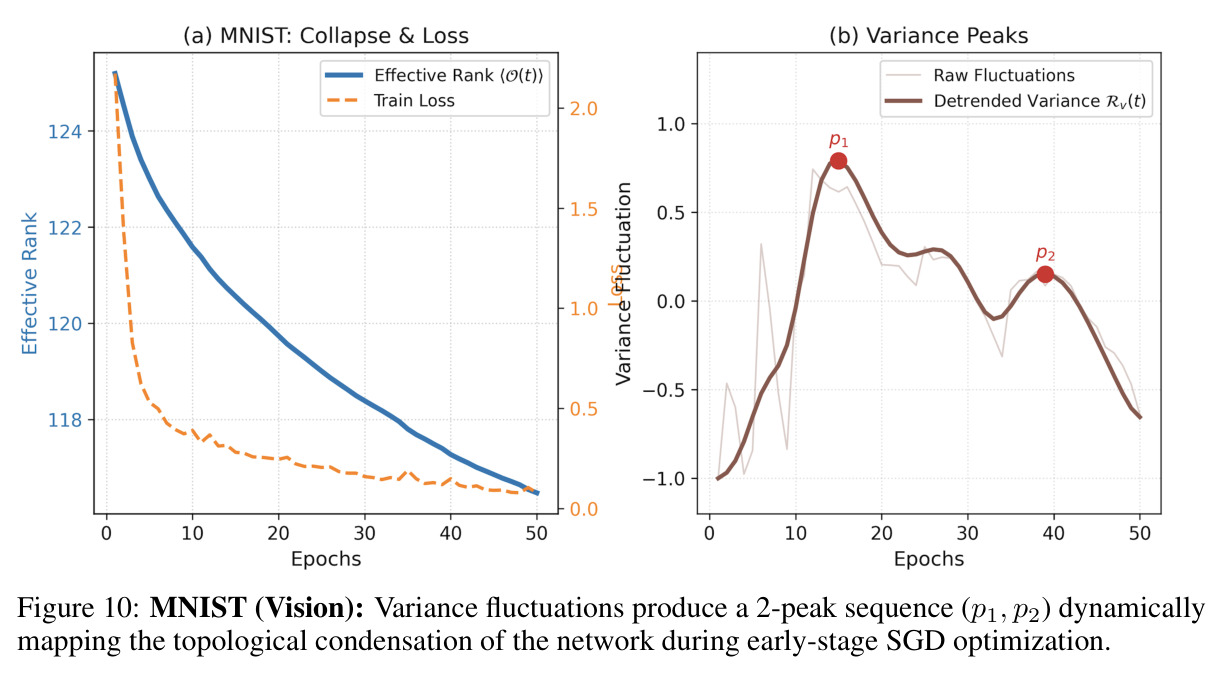
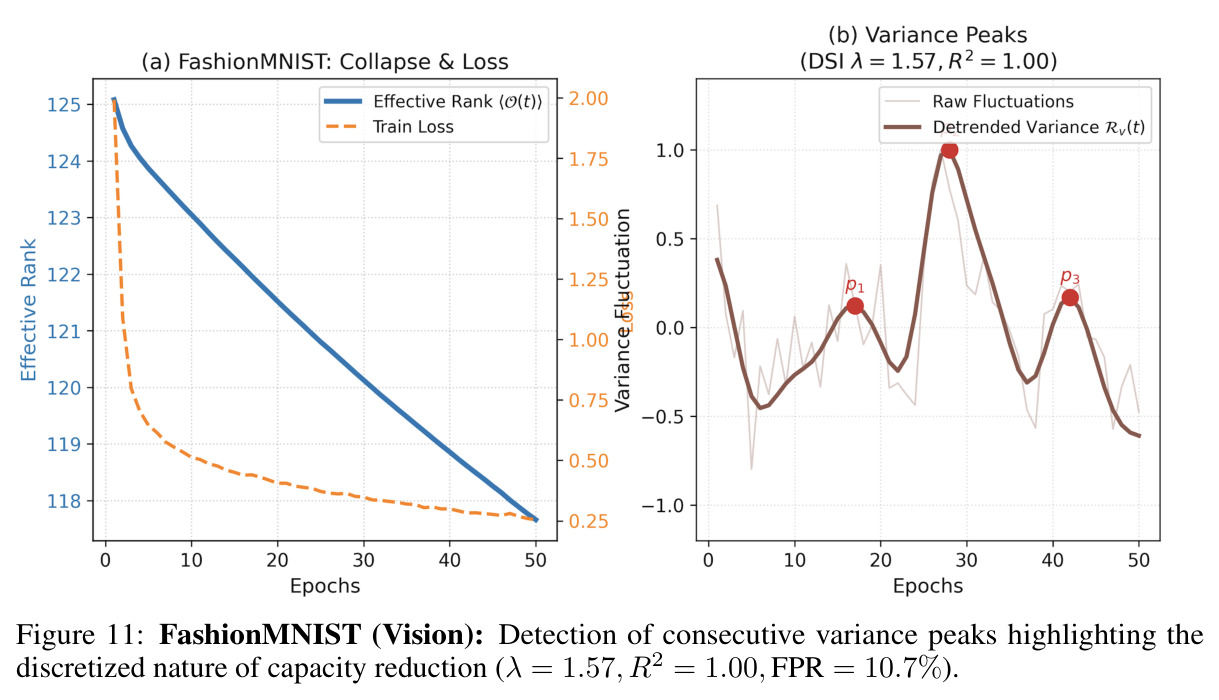
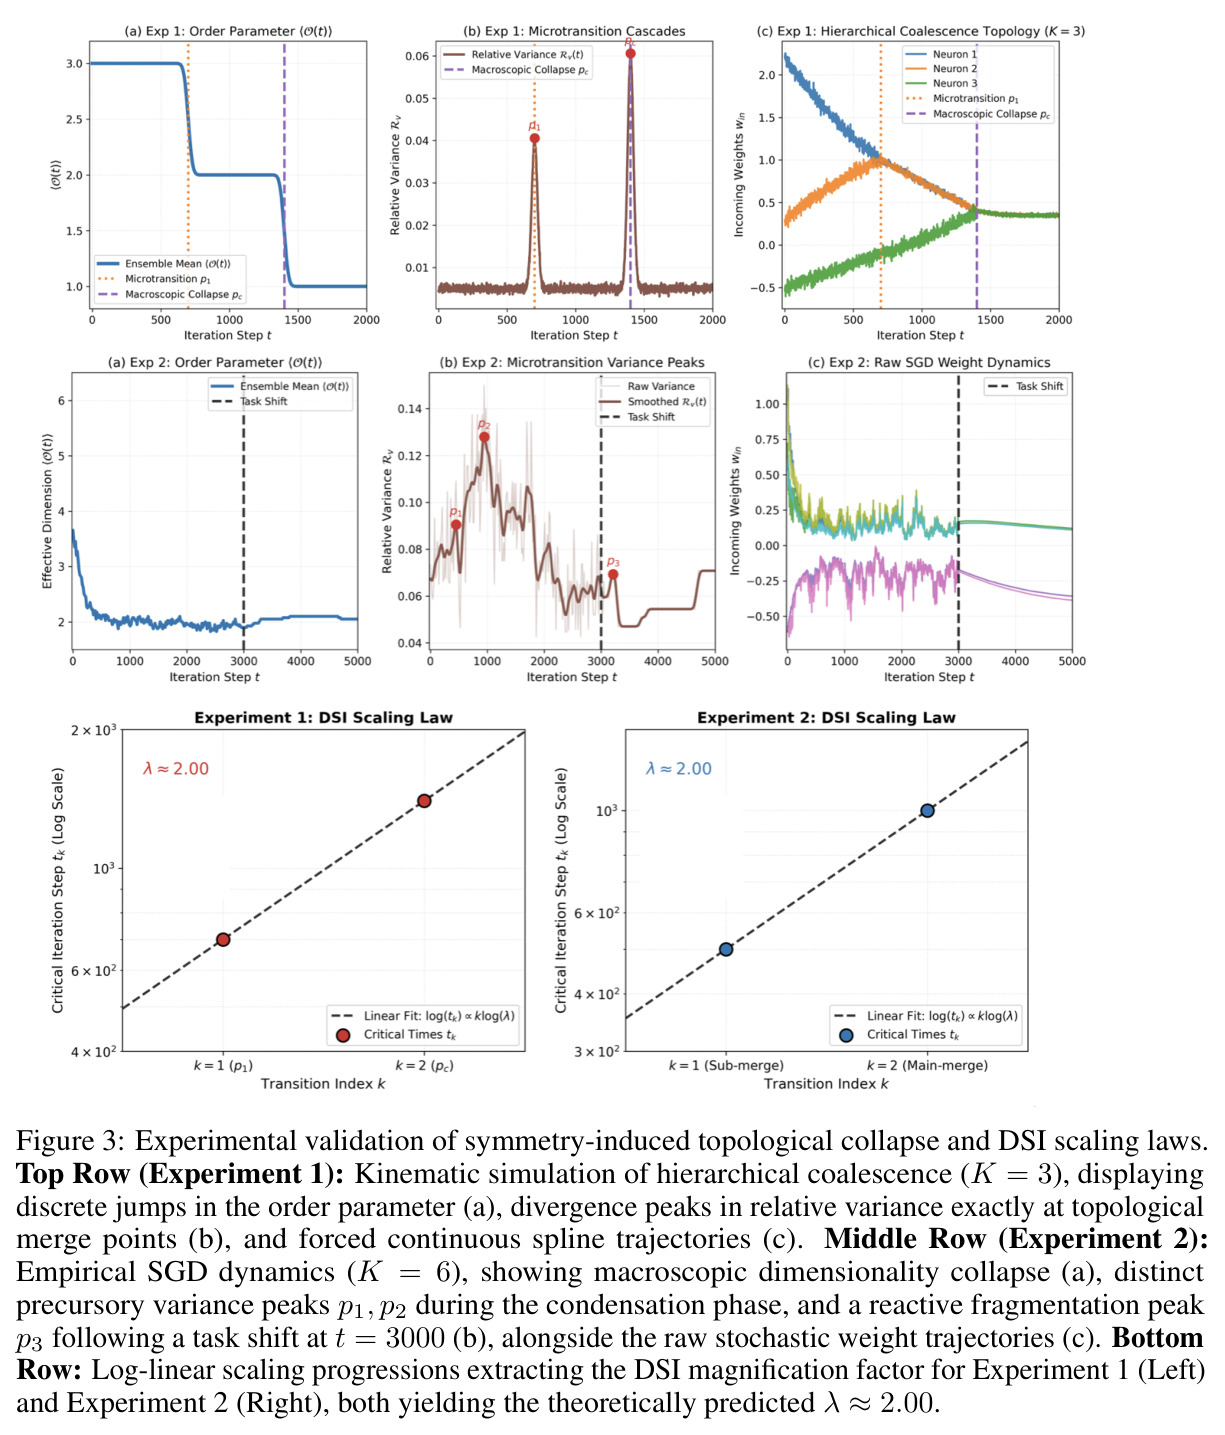
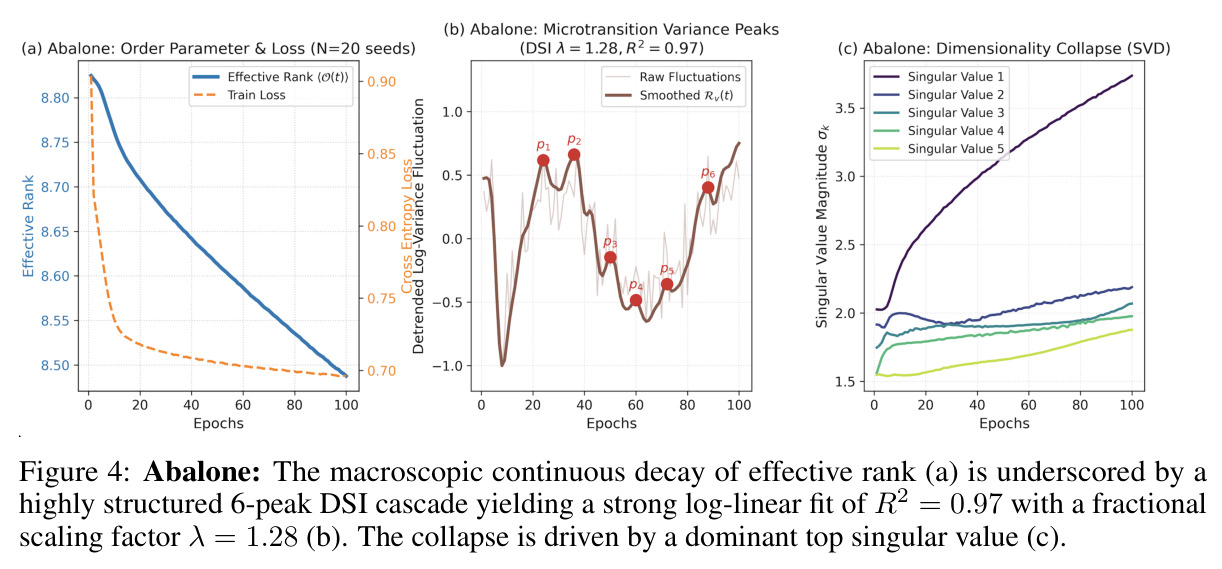
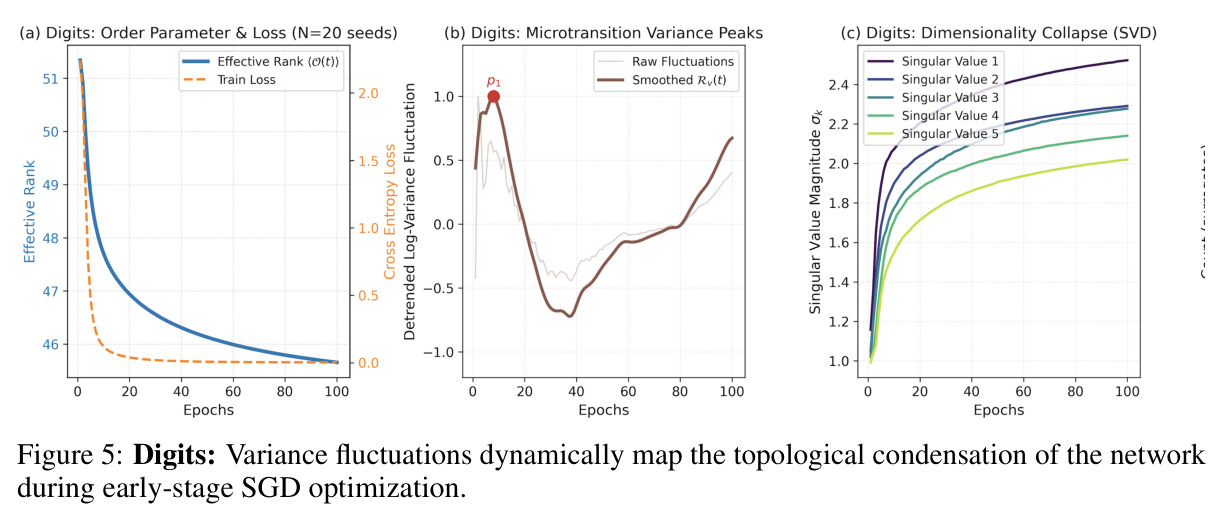
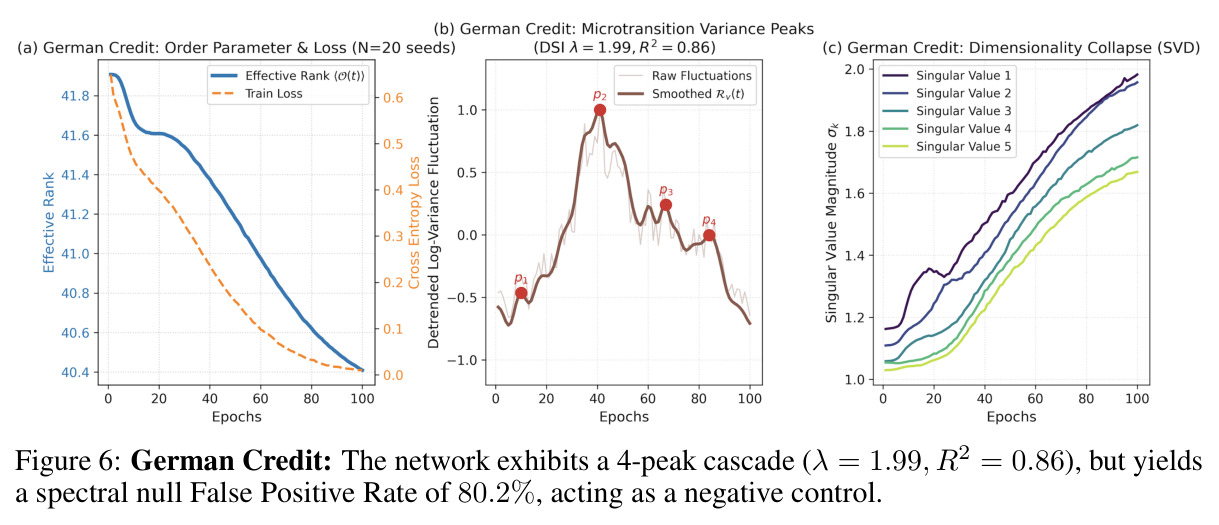
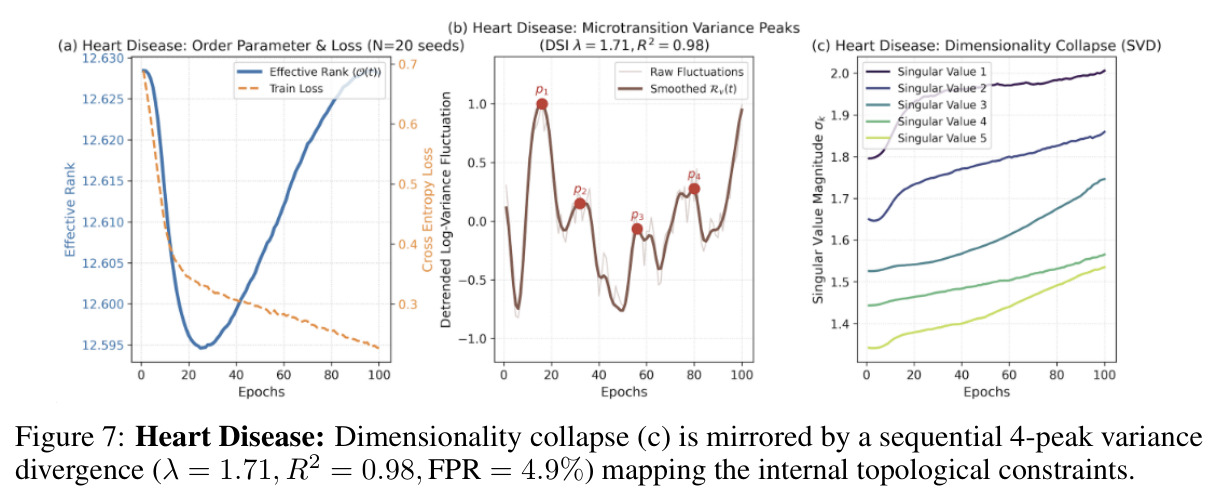
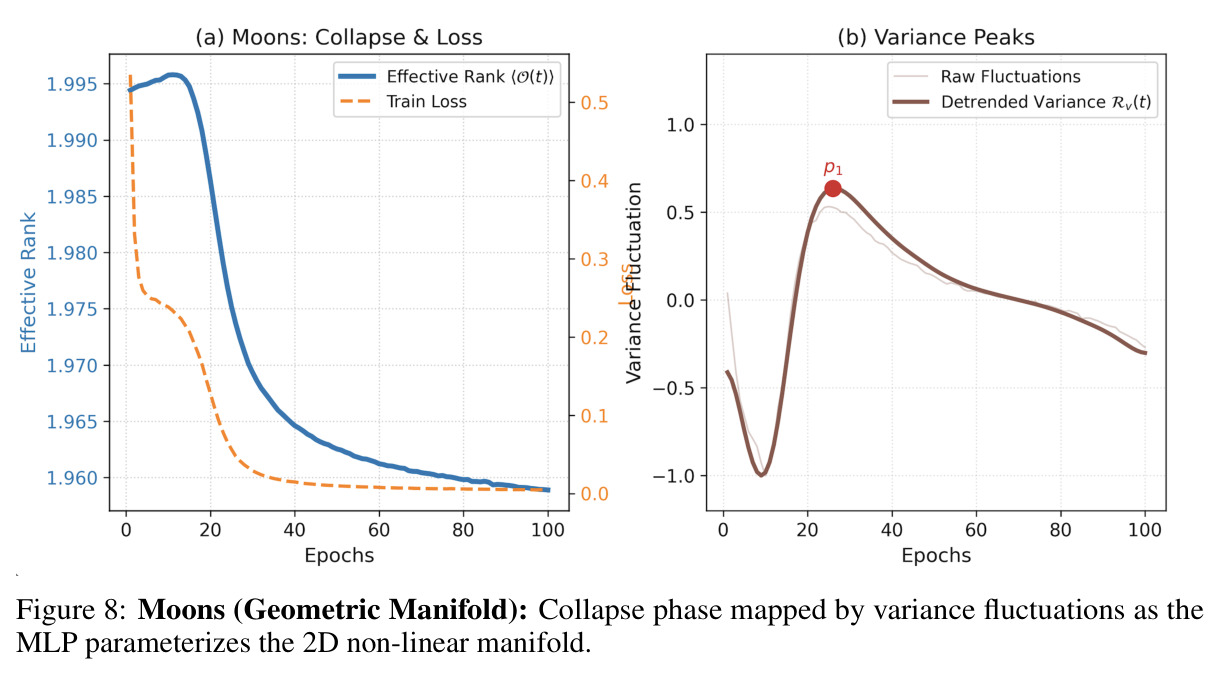
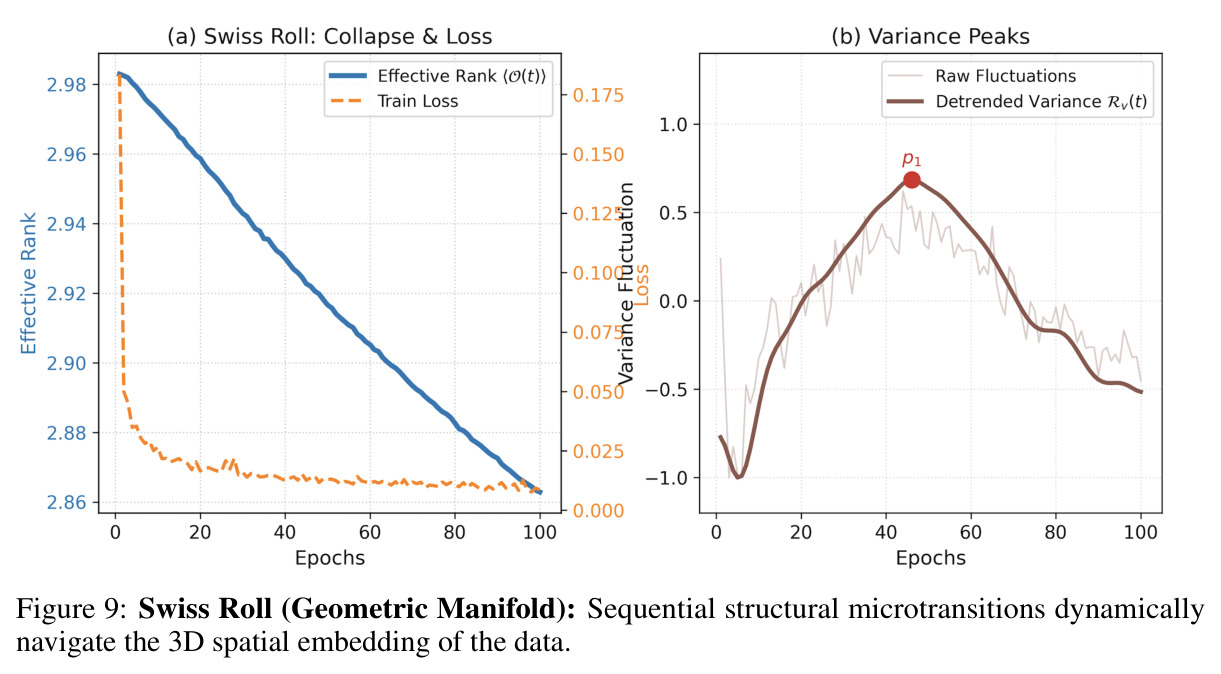
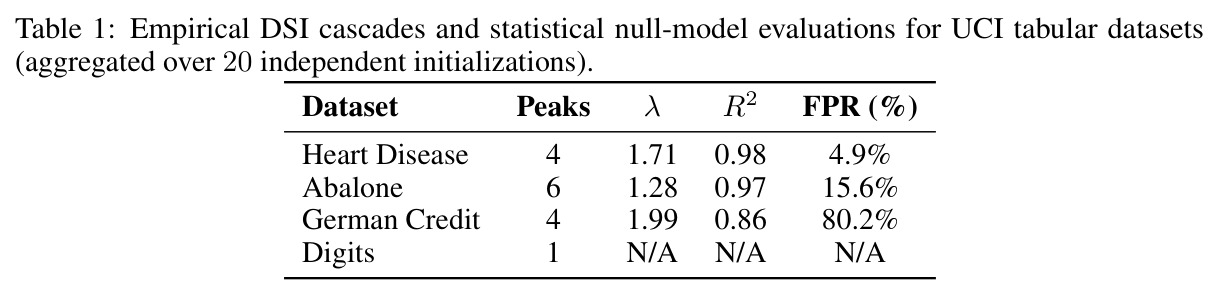
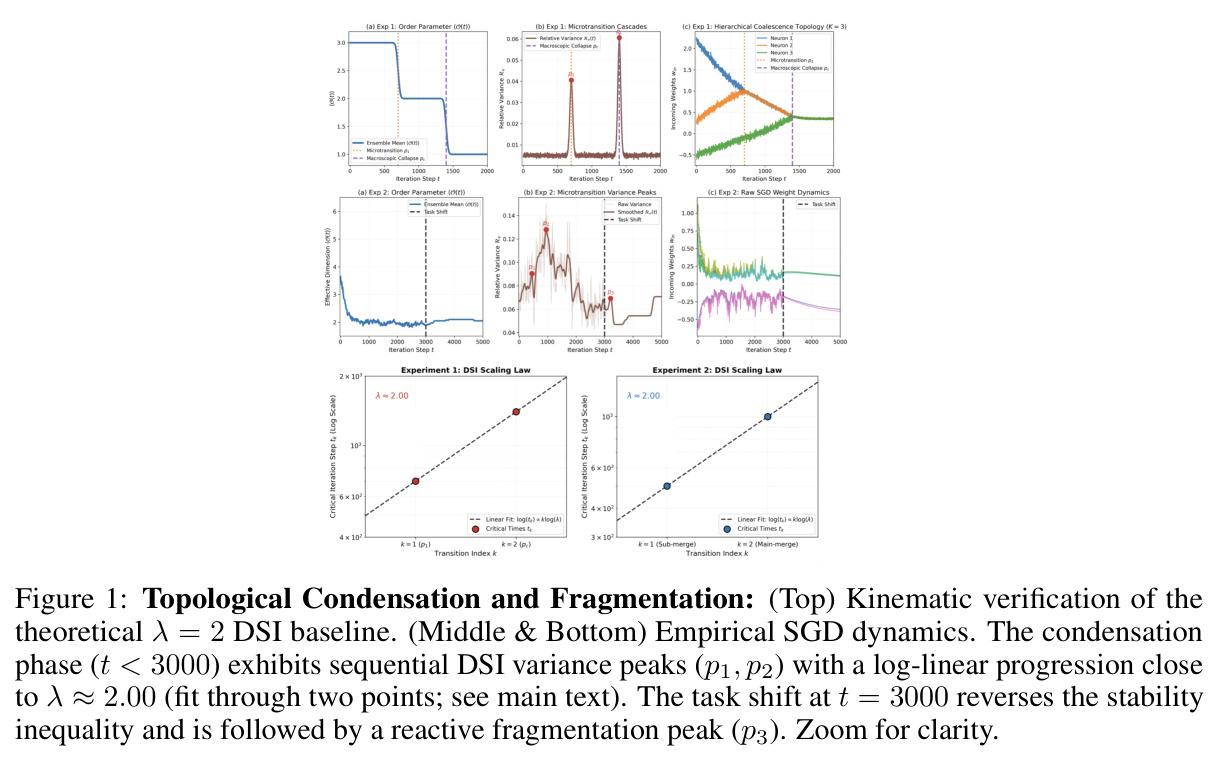
实验在三个层面验证理论。第一,受控玩具模型(改编自 Chen 等 2023):理论预测成对子网合并的放大因子 $\lambda=2$,受约束 $K=3$ 与无约束 $K=6$ 两种 SGD 配置都通过局部化 $R_v$ 发散定位方差峰,两点 log 线性拟合测得 $\lambda\approx 2.00$,与运动学基线精确一致;$t=3000$ 处注入任务切换逆转稳定性不等式,随后出现反应性碎裂峰 $p_3$,证实等价关系的可逆性(图 1)。第二,Transformer 模运算 grokking:延迟泛化与谱有效秩刻画的维度坍缩同时发生,性能尖峰前紧邻一个 3 峰 DSI 级联,拟合 $\lambda=2.11$,相位随机化谱零假设的假阳性率(FPR)仅 0.1%,作者明确不声称级联是转变的唯一驱动因素(图 2a)。第三,UCI 心脏病与 FMNIST 分类均出现 $R_v$ 方差尖峰级联,标度因子为分数值,与成对或更高阶合并一致(图 2b,c)。方法上,高维网络用谱有效秩(奇异值谱的指数化香农熵)替代距离聚类,且 $R_v$ 须跨种子集合计算以满足定理 4.5 的双峰共存要求。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 玩具模型子网合并(K=3 受约束 / K=6 无约束 SGD) | DSI 标度因子 λ(两点 log 线性拟合) | λ ≈ 2.00,通过 Rv 局部发散定位方差峰 p1、p2 | 理论预测 λ = 2(成对合并的运动学基线) | 与理论精确一致,且任务切换后反应性碎裂峰 p3 验证可逆性 |
| Transformer 模运算 grokking(延迟泛化) | 级联标度因子 λ 与相位随机化谱零假设 FPR | 3 峰 DSI 级联紧邻性能尖峰,λ = 2.11 | 相位随机化谱零假设(排除伪级联) | FPR = 0.1%,级联检测在统计上显著 |
| UCI 心脏病(表格分类)/ FMNIST(图像分类) | Rv 方差尖峰级联的存在性与标度因子 | 均出现 DSI 级联,标度因子为分数值 | 无外部性能基线,以相位随机化检验为对照 | 支持级联结构跨表格/视觉领域的普适性 |
局限与改进
作者承认的局限:其一,grokking 的 3 峰级联只是与性能尖峰同时发生,作者不声称它是转变的唯一驱动因素,因果链未确立;其二,跳变在热力学极限存活的判据要求合并组件宏观化($i=\Theta(N)$),实际网络宽度下不连续性是否持续留待检验(推论 C.18);其三,Adam/AdamW 定理是条件性的:依赖重尾噪声假设($p\in(1,2]$)、停止时间 $\tau^\epsilon_{blk}\wedge\tau_E$、非退化条件 $\hat{v}_i\ge v_{min}>0$ 与宏观块缩放 $n(N)/N\to c$,且目前只在 grokking 一个场景做了初步诊断检查,对大规模模型的系统研究仍是开放问题。我的补充观察:$R_v$ 需要多训练轨迹集合才能满足双峰共存要求,成本随模型规模放大;玩具模型的 $\lambda\approx 2.00$ 是两点拟合,统计强度有限、无误差报告;谱有效秩只是软维度坍缩的代理指标,与严格拓扑转变的对应依赖假设而非直接观测;级联能'预测' $p_c$ 的说法在真实训练中尚未被前瞻性检验。
独立分析的弱点
独立分析出的弱点及改进方向:(1) 跨种子估计 $R_v(p)$ 需要大量训练轨迹(每设置估计需数十个种子),成本随模型规模线性增长——可探索用单轨迹内的滑动窗口统计、或跨层/跨块聚合来近似集合方差;(2) 玩具实验的 $\lambda$ 由两个方差峰的 log 线性拟合得到,没有报告置信区间——应加密转变点采样并用多次重复给出误差棒;(3) 理论依赖块对角占优假设($\|\Sigma_{ij}\|_2\le\delta$)与快慢时间尺度分离,在残差连接、共享嵌入等强耦合架构中可能失效——可引入软耦合系数并在数值上扫描其临界值;(4) 重尾噪声指数 $p$ 取自注意力架构的经验文献(Zhang 等 2020),对 CNN/MLP 的适用性未单独验证——可对每层梯度分布做重尾拟合作为前置诊断再决定是否套用定理 5.4/5.5;(5) 凝聚/碎裂只在参数轨迹层面定义,缺乏与泛化指标的因果连接(尤其 grokking)——可在级联峰后干预(如注入/移除噪声)做因果实验,而非仅观察共现。
未来方向
作者提出的方向:在实际网络宽度下检验不连续性是否持续(推论 C.18);把框架推广到弯曲不变流形与极端超参数区域;利用 $R_v$ 方差尖峰指导学习率调度——尖峰预示即将到来的结构转变;作者还指出 DSI 级联与经验缩放定律相关联(注记 C.26),提示可直接从渗流模型推导新的缩放关系;以及对大规模模型上的 Adam 扩展做系统研究。基于本文成果可延伸的方向:把 DSI 级联做成早停或泛化预测的在线探针(监测 $R_v$ 尖峰序列的外推);将渗流序参量与 grokking 的表示学习度量(如傅里叶基稀疏度)联合建模,检验'级联→泛化'的因果链;在 MoE、权重共享等强对称架构上验证 $n$ 体合并阶数的可预测性;探索数据分布漂移下碎裂峰作为任务遗忘/灾难性干扰预警指标的实用性;以及用级联模型反推最优课程或噪声注入时刻。
复现评估
复现评估:论文正文与附录 E、F 提供了推导、基线与实验设置细节,但主文(v1)未明确给出开源代码链接,需要自行实现谱有效秩、$R_v$ 峰检测与 $\lambda$ 拟合流程。数据门槛低:UCI 心脏病与 FMNIST 是公开基准,模运算 grokking 是社区标准玩具任务,玩具模型改编自 Chen 等 2023 的可复现设置。算力方面:玩具模型($K=3$/$K=6$ 子网络)与表格模型单卡即可;Transformer grokking 通常单 GPU 数小时;主要开销在于 $R_v$ 需要多训练轨迹集合(估计每个设置需数十个种子)。综合判断:复现定性现象(级联出现、$\lambda\approx 2$、可逆性碎裂峰)为中等难度;精确复现 grokking 的 $\lambda=2.11$ 与 0.1% FPR 需要与作者一致的相位随机化谱检验流程,依赖附录细节,难度偏高;Adam 扩展部分还涉及附录 D 的停止时间诊断,复现成本最大。
论文图表