CRISP:悬崖感知、输入自适应的结构质量路由稀疏预填充 CRISP: Cliff-awaRe Input-adaptive Sparse Prefilling with Structural-Mass-Motivated Routing
用锚点结构质量替代JSD路由、用噪声底阈值替代累积覆盖率,修复稀疏预填充的O(n)噪声累积
前置知识
注意力汇聚
在自回归 Transformer 中,无论查询内容如何,相当一部分注意力质量都会稳定流向序列最开头的少数 token(通常是第一个 token / BOS),这些位置被称为架构性 sink。Xiao et al. (2024) 的 StreamingLLM 首次系统刻画了该现象:softmax 归一化迫使注意力总量为 1,当没有明显相关内容时,模型倾向于把质量“倒”进这些结构性位置。实测中单个 sink 块可吸收超过 90% 的注意力质量(本文 Figure 1 中 sink=0.93、0.91,附录 Table 1 显示 Llama 91.3%、Qwen 98.3% 的被测 head 的 top-1 质量块就落在 sink 或局部新近窗口上)。
CRISP 的两个核心设计——Cstruct 路由代理(只测 sink + 新近窗口的质量)和噪声底阈值(把首尾块设为必留锚点、用剩余块的平均质量当背景噪声)——全部建立在对 sink 行为的精确理解上;不理解 sink 就无法理解为什么路由决策可以“免费”地从注意力图结构中读出。
预填充阶段与稀疏注意力
LLM 推理分两阶段:预填充一次性并行处理整段输入 prompt,自注意力计算量为 $O(n^2 d)$,在超长上下文(128K–512K token)下成为主要延迟来源;解码阶段逐 token 生成,瓶颈在 KV cache 带宽。稀疏注意力把计算限制在索引集 $S$ 上:$A(Q,K,V,S)=\mathrm{Softmax}(QK^\top/\sqrt{d}+M_S)V$,其中掩码 $M_S$ 屏蔽 $S$ 之外的键。核心难题是选哪些块进 $S$:选少了丢精度,选多了省不了算力。
本文只针对预填充阶段的计算瓶颈做优化,所有延迟测量都是单张 H100 上的 attention-only 预填充时间;理解预填充与解码的区别,才能明白为什么方法设计成块级、一次性路由,以及为什么它可与解码期方法(如 Twilight)互补组合。
VS/PE 二分模式
MInference 和 FlexPrefill 观察到注意力 head 大致分两类:Vertical-Slash(VS)head 的注意力集中在少数固定列(vertical,如 sink 列)和斜对角线(slash,token 关注位置相近的 token)上,可以用极少的块高精度近似;Pooled-Estimation(PE)/扩散型 head 的质量大范围铺开,没有紧凑结构,适合用池化后的全局估计来近似。VS 路径精细选块,PE 路径粗粒度全局池化,路由器负责把每个 head 分到更合适的那条路径。
CRISP 全文围绕两个问题展开:怎么把 head 正确路由到 VS/PE(用 $C_{struct}$ 替代 JSD),以及 VS 路径上怎么选块(用 sink 感知噪声底阈值替代 $\gamma$-cumsum)。不理解这两条路径的分工就看不懂算法结构。
Jensen-Shannon 散度(JSD)
两个概率分布的对称相似性度量:$D_{JS}=\tfrac{1}{2}KL(\hat{a}\|m)+\tfrac{1}{2}KL(\bar{a}\|m)$,其中 $m=\tfrac{1}{2}(\hat{a}+\bar{a})$。FlexPrefill 用它比较“先池化再 softmax”的分布 $\bar{a}$ 与“先 softmax 再平均”的分布 $\hat{a}$:当查询们在相同键上达成一致(垂直结构)时两个分布接近,当各查询各看各的键(slash 结构)时分歧大;$D_{JS}\ge\tau$ 就路由到 VS。代价是要为每个 head 额外做一次池化矩阵乘($O(nd/b)$)和第二次 softmax,外加两趟 KL 计算。
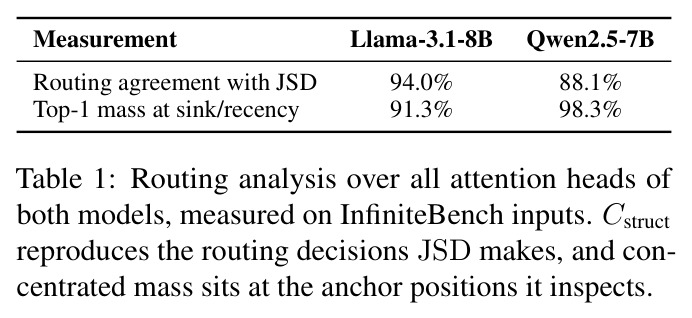
JSD 路由是本文要替换的对象。理解它测什么、为什么间接、开销在哪里,才能体会 $C_{struct}$ 以近零成本复现其 94.0%(Llama)/88.1%(Qwen)路由决策这一结果的价值。
累积覆盖率阈值(γ-cumsum)
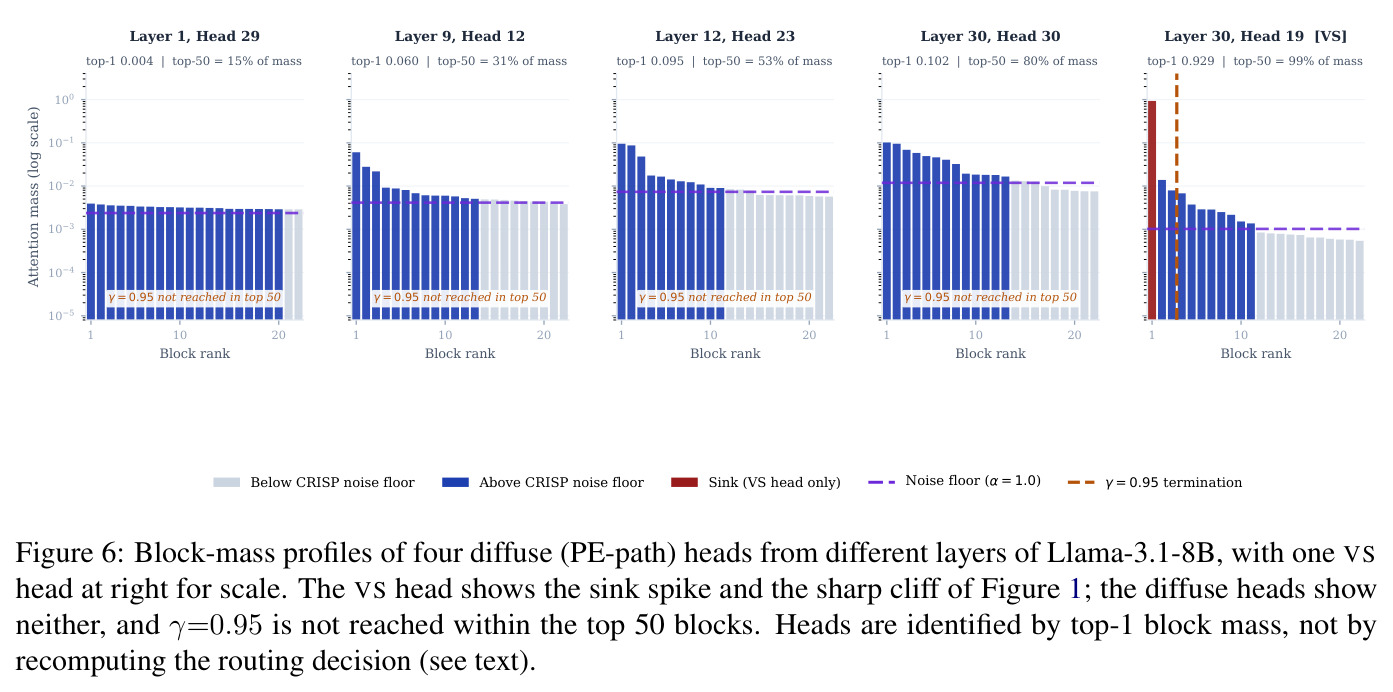
FlexPrefill 把索引选择形式化为对偶优化:在约束 $\sum_{j\in S}a_j\ge\gamma$(通常 $\gamma=0.95$)下最小化 $|S|$。实现上把块分数排序后累加,凑够 $\gamma$ 即停止。该准则隐含“所有注意力质量同等重要”的假设;当 sink 吸收了大部分质量时,它会在 sink 处提前终止(漏掉全部任务信号),或者越过信号区深入噪声区凑残余阈值(按本文证明会累积 $O(n)$ 个近零质量块),且调大 $\gamma$ 只会更深入噪声。
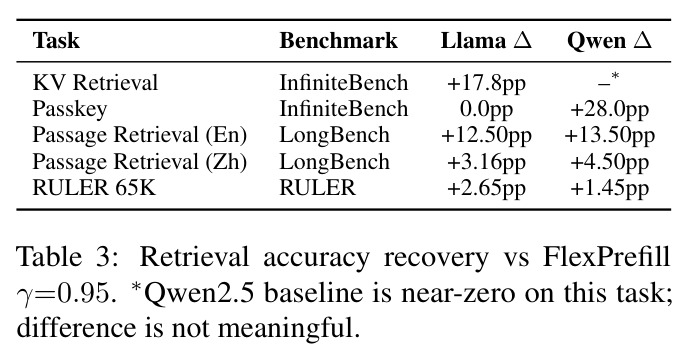
这是本文“质量悬崖”(mass cliff)分析的靶子,也是 VS 路径上 sink 感知 $\alpha$ 噪声底阈值要替代的对象;Table 3 里 +17.8/+28.0pp 的检索收益正是修复该准则的直接证据。
注意力熵与有效支撑集大小
查询 $i$ 的注意力熵为 $H(a_i)=-\sum_j a_{ij}\log a_{ij}$,head 熵取其均值。信息论中指数化熵 $e^{H(a)}$(Campbell, 1966)是分布有效支撑集大小的标准度量:$H\approx 0$ 时 $e^H\approx 1$,极少 token 即可达到覆盖率 $\gamma$;$H=\log n$ 时 $e^H=n$,需要约 $\gamma n$ 个 token。由此得到低熵 head → VS(少量结构块就够)、高熵 head → PE(需广覆盖)的路由二分法信息论解释。
论文附录 B 用这一关系为 VS/PE 二分法提供理论根基,也是“集中的 head 其质量必然落在结构可预测位置”这一 $C_{struct}$ 成立前提的来源;作者同时诚实指出这是当前带 sink 架构的经验规律而非 softmax 的普适性质。
FlashAttention
Dao 等人提出的精确注意力 IO 感知实现,通过分块计算和 SRAM 内在线 softmax 避免显式物化 $n\times n$ 注意力矩阵,是现代 LLM 推理的标准稠密注意力后端。本文所有加速比都以它为分母(“speedup vs FlashAttention”)。CRISP 在选中的块上计算的仍是精确 softmax 注意力,因此与 FlashAttention 式分块内核天然兼容。
它既是实验中的稠密精度上界,也是延迟参照系(512k 时 CRISP 达 5.17×–5.40× 加速);理解“CRISP 只改块选择逻辑、选完块后算精确注意力”才能正确解读这些加速数字的含义。
研究动机
长上下文 LLM 推理的预填充阶段中,自注意力计算量随序列长度 $n$ 二次增长($O(n^2 d)$),在 128K–512K 上下文时成为严重瓶颈。现有加速方案分两派:固定稀疏模式(Sparse Transformer、BigBird、Longformer)和离线画像(MInference),都无法适应输入相关的注意力结构变化——实验中 MInference 在 LongBench 上落后 FlexPrefill 5–8pp(Llama 41.40 vs 46.92),在长上下文 RULER 上崩溃(131k 处仅 62.50 vs 稠密 79.33)。SOTA 的 FlexPrefill 虽然实时路由,但有两个结构性缺陷:其一,JSD 是间接路由信号,需要为每个 head 额外做池化矩阵乘($O(nd/b)$)、第二次 softmax 和 KL 散度计算;其二,索引选择用累积覆盖率约束 $\sum_{j\in S}a_j\ge\gamma$,隐含假设所有质量同等重要,而实际上架构性 sink 可吸收超过 90% 的质量(Figure 1 实测 sink=0.93、0.91),导致两种失败:sink-only collapse(选择在 sink 内提前终止,8 个重要块完全没被访问)和残余噪声累积(为凑 γ 捡了 13 个近零噪声块,且按 $N_{garbage}=\gamma_{residual}\cdot n$ 随上下文线性增长)。
本文的目标是本文目标是设计一个保留动态稀疏注意力灵活性、但消除 FlexPrefill 两个原则性缺陷的免训练稀疏预填充方法。具体拆成四个子目标:(1) 给出 VS/PE 路由决策的结构性解释,证明 JSD 信号实际测量的东西可以从代理注意力图的结构中直接读出;(2) 用一个“免费”的结构质量代理 $C_{struct}$ 替代 JSD,在复现其路由决策(一致率 94.0%/88.1%)的同时消除池化矩阵乘和 KL 散度开销;(3) 形式化“质量悬崖”——softmax 造成 sink(>90% 质量)、任务信号、近零背景的三类硬边界——并从理论上证明累积覆盖率阈值在长上下文必然累积 $O(n)$ 噪声;(4) 用基于噪声底的 sink 感知阈值替代 γ,明确区分信号与架构噪声且无需经验校准,最终在 InfiniteBench/RULER/LongBench 上达到或超过稠密注意力精度,同时在 512k 上下文获得最高 5.30× 注意力加速。
与已有工作不同的是,独特切入角度在于:不是调参修补现有动态稀疏方法,而是先回答“路由信号到底测了什么”再动手替换。作者证明两件事:第一,在带 sink 的自回归 Transformer 中,低熵(集中型)head 的质量恰好落在结构可预测的位置——架构性 sink(前 128 token)和局部新近窗口(后 128 token)——因此判断一个 head 是否该走 VS 路径,不需要构造 JSD 那样的池化副本做分布比较,只需测量代理注意力图在锚点上的质量 $C_{struct}$,这是对路由成本的数量级削减而非工程微调;第二,softmax 归一化使背景 token 质量为 $\epsilon\approx 1/n$,凑残余阈值的垃圾块数 $N_{garbage}=\gamma_{residual}/\epsilon\approx\gamma_{residual}\cdot n$,从渐近意义上证明覆盖率式选择在超长上下文必然失效,且这种失效是“参数化不可修复”的——Table 2 中 γ=0.97 在 Llama InfiniteBench 反而降到 47.3 印证了这一点。作者自称是首个显式形式化质量悬崖、并证明累积覆盖准则渐近不适用的 工作。
核心方法
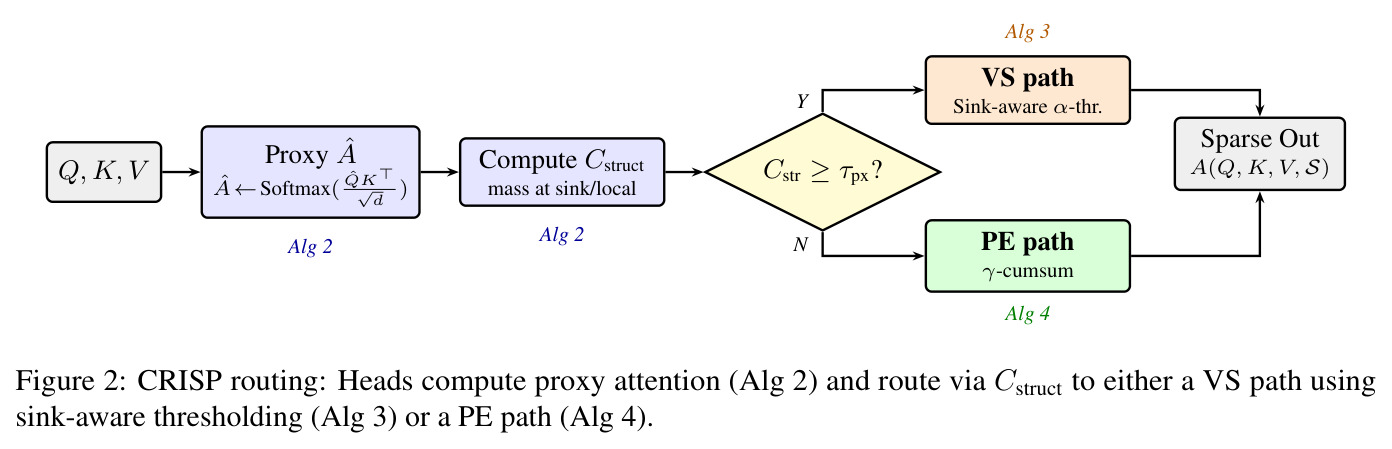
直觉:在带注意力汇聚的自回归 Transformer 里,VS head 的质量天然集中在两个结构稳定的位置——开头的架构性 sink 和末尾的局部新近窗口;head 是否“集中”可以从这两个锚点上的质量直接读出,而 VS head 的块选择也不该问“累积覆盖率到 γ 了吗”,该问“这个块的质量是否高于背景噪声平均水平”。技术路线分三步。第一步 PatSearch(Algorithm 2):与 FlexPrefill 相同,取最后 $b$ 个查询作代表子集 $\hat{Q}$,计算代理注意力 $\hat{A}=\mathrm{Softmax}(\hat{Q}K^\top/\sqrt{d})$;对每个 head 计算 $C_{struct}=\frac{1}{|\hat{Q}|}\sum_{i\in\hat{Q}}\sum_{j\in S_{anchor}}\hat{A}[i,j]$,其中 $S_{anchor}$ 是前 $w_{sink}=128$ token(sink)加后 $w_{local}=128$ token(新近窗口);若 $C_{struct}\ge\tau_{proxy}=0.2$ 路由到 VS,否则 PE。这一步只是对已算好的 $\hat{A}$ 的切片归约,复杂度 $O(w_{sink}+w_{local})$,与序列长度 $n$ 无关。第二步索引选择:VS 路径(Algorithm 3)用 sink 感知噪声底阈值选块,PE 路径(Algorithm 4)保留全局池化 + γ-cumsum(γ=0.95)。第三步:在选出的索引集 $S$ 上计算精确的掩码 softmax 注意力。整个过程免训练,按 head 独立路由。
核心创新点一:$C_{struct}$ 结构质量路由。FlexPrefill 用 JSD 间接测量“head 是否集中”,代价是每个 head 一次池化矩阵乘($O(nd/b)$)、第二次 softmax 和两趟 KL。CRISP 的洞察是:低熵 head 的质量恰好落在 sink + 新近窗口这两个固定锚点上(Table 1:Llama 91.3%、Qwen 98.3% 的被测 head 的 top-1 质量块就是锚点块),所以直接测锚点质量就能复现 JSD 的路由决策(一致率 94.0%/88.1%),成本降为对已计算好的 $\hat{A}$ 的常量时间切片归约。作者明确界定这是当前带 sink 架构的经验性质而非普适定理。核心创新点二:sink 感知噪声底阈值。形式化“质量悬崖”:softmax 制造 sink(可吸收 >90% 质量)、任务信号块、近零背景块的三类硬边界;推导背景块质量 $\epsilon = e^{-\Delta}/(k+(n-k)e^{-\Delta})\approx 1/n$($n\gg k e^{\Delta}$ 时),垃圾块数 $N_{garbage}=\gamma_{residual}/\epsilon\approx\gamma_{residual}\cdot n$,即 $O(n)$。CRISP 在 VS 路径改为选择所有质量超过 $\alpha\mu$ 的块($\mu$ 是非锚点块的平均背景质量),$\alpha=1.0$ 是免校准默认值(“高于平均背景即信号”),预算 $k$ 由任务复杂度自然涌现:集中型任务选得少,密集型任务选得多。
方法步骤详情
完整流程(Algorithm 1)。输入 $Q,K,V\in\mathbb{R}^{n\times d}$,统一配置 $\tau_{proxy}=0.2$、$\gamma=0.95$(仅 PE 路径)、$\alpha\in\{1.0,1.25\}$、块大小 $B=128$、每方向最小预算 $k_{min}=1024$ token(8 块,继承自 FlexPrefill)。第 1 步 PatSearch(Algorithm 2):取 $\hat{Q}=Q[-b:]$,计算 $\hat{A}=\mathrm{Softmax}(\hat{Q}K^\top/\sqrt{d})$;计算锚点质量 $C_{struct}=\frac{1}{|\hat{Q}|}\sum_i\sum_{j\in S_{anchor}}\hat{A}[i,j]$($S_{anchor}$=前 128 + 后 128 token);$C_{struct}\ge 0.2$ 则输出 VS,否则 PE。第 2 步 VS 索引(Algorithm 3):把 $\hat{A}$ 按列均值(垂直分数 $a_v$)和斜对角均值(斜向分数 $a_s$)分解,各自分块池化为 $p_d$;排除首尾两个必留块后计算噪声底 $\mu=\max(1-a_{first}-a_{last},\,0)/(N_b-2)$;每方向选所有 $p_d[j]>\alpha\mu$ 的块,数量 clip 到 $[k_{min},N_b]$;两方向索引取并集 $S_v\cup S_s\cup\{0,N_b-1\}$。第 3 步 PE 索引(Algorithm 4):对全部查询池化得 $\bar{A}$,softmax 后归一化展平,排序并按 $\gamma$-cumsum(0.95)取块。第 4 步:在 $S$ 上计算精确的 $A(Q,K,V,S)$ 输出。α=1.0 为推荐的高精度配置,α=1.25 为速度优先配置;所有组件免训练、即插即用。
技术新颖性
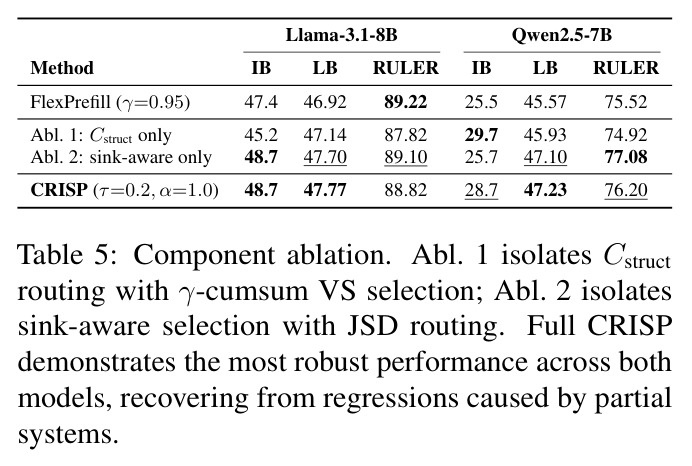
新颖性分析:(1) 与 FlexPrefill 的本质区别在路由信号的来源——JSD 是构造出来的间接统计量(比较池化估计与逐查询均值两个分布的散度),$C_{struct}$ 是直接读取注意力图固有结构的物理量;作者诚实地把它定位为“对当前带 sink 架构的经验规律的测量”而非熵的正式定义,并在附录 F 用块质量分布验证了 PE head 无悬崖、γ 在 top-50 块内都凑不够 0.95,从而论证 PE 路径保留 γ-cumsum 的合理性。(2) 与所有覆盖率式方法的区别在选择准则的参照系:γ 问“离固定覆盖目标还差多少”,噪声底 $\alpha\mu$ 问“这个块是否高于随输入自适应的背景水平”——sink 质量越大,$\mu$ 越小,阈值反而越灵敏,而 γ 在 sink 质量大时会提前哑火。(3) 理论贡献是把工程现象上升为渐近结论:证明累积阈值必然 $O(n)$ 噪声,并用 $e^{H(a)}$(有效支撑集)给出 VS/PE 二分法的信息论解释,填补了 Likhosherstov et al. (2021) 与 Zhang et al. (2025b) 之间“无正式二分法理论”的空白。(4) 工程上免训练、逐块精确 softmax、与 FlashAttention 兼容,且路由与预算两个修复正交——消融(Table 5)显示单独换路由(Abl.1)在 Llama 上反而 −2.2pp,因为把更多 head 暴露给了 γ-cumsum,两个组件必须配合才稳定。
实验结果
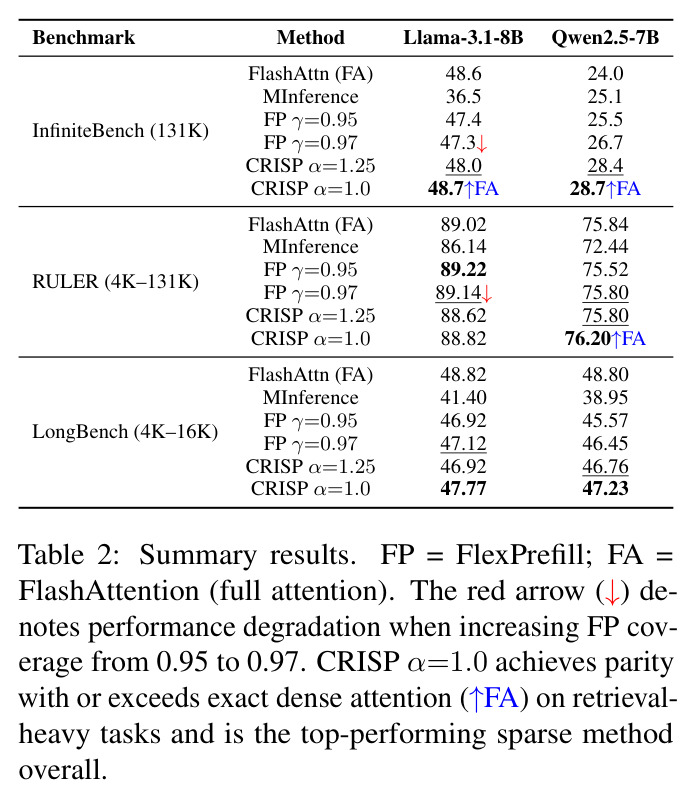
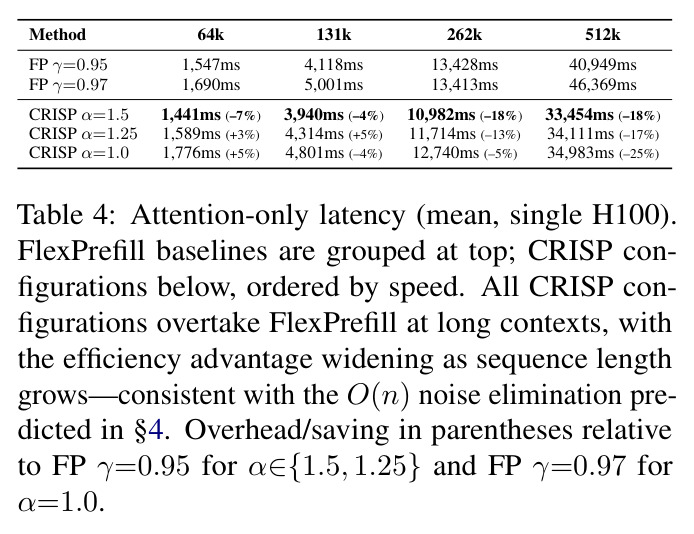
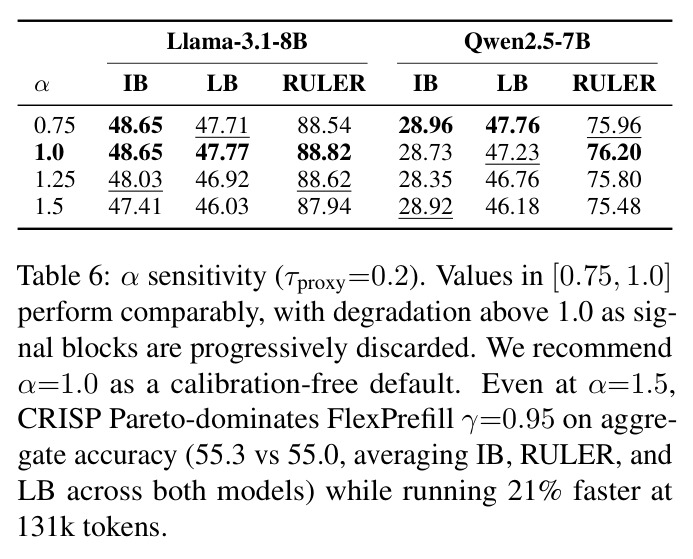
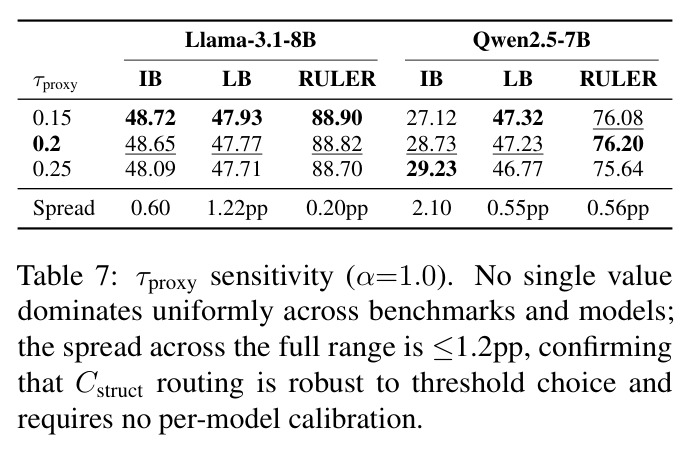
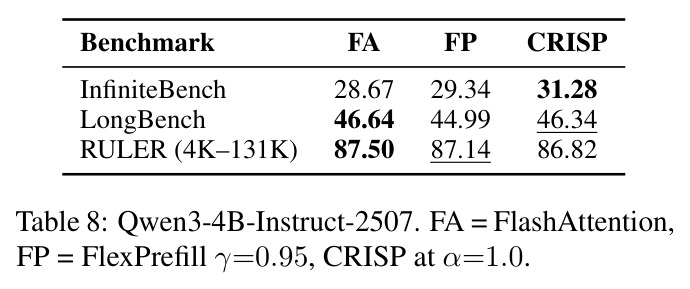
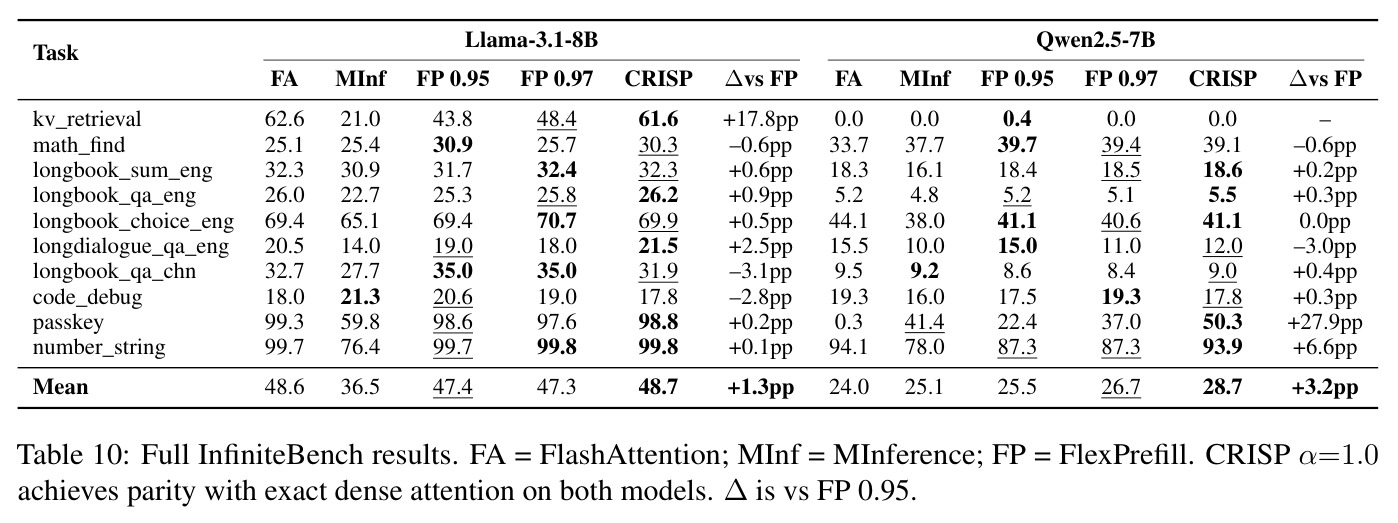
核心发现一:总体精度最强且达到稠密注意力水平(Table 2、10、11、12)。InfiniteBench 131K 上 CRISP α=1.0 与精确稠密注意力打平甚至反超(Llama 48.7 vs FA 48.6、MInference 36.5、FP 47.4;Qwen 28.7 vs FA 24.0、MInf 25.1、FP 25.5);LongBench 上 Llama 47.77(FA 48.82、FP 46.92、FP γ=0.97 47.12)、Qwen 47.23(FA 48.80、FP 45.57);RULER 上 Qwen 76.20 全面第一(FA 75.84、FP 75.52),Llama 88.82 略低于 FP 89.22(−0.40pp)。作者解释反超稠密是合理的:稠密注意力必须聚合包括 sink 噪声在内的所有 token,而 sink 感知选择得到更干净的信号表示。核心发现二:检索任务大幅恢复,实证 sink-only collapse(Table 3)。vs FP γ=0.95:Llama KV Retrieval +17.8pp(61.6 vs 43.8)、Qwen Passkey +28.0pp(50.3 vs 22.4,基线近乎崩塌)、英文段落检索 +12.50/+13.50pp、中文 +3.16/+4.50pp、RULER 65K +2.65/+1.45pp;这些收益无法靠调 γ 获得——FP γ=0.97 在多数基准持平或下降(Llama IB 47.3↓)且延迟暴增 13%。核心发现三:长上下文延迟优势随 $n$ 扩大(Table 4、Figure 4)。512k 时 FP γ=0.95 需 40,949ms、FP 0.97 需 46,369ms 且方差爆炸,CRISP α=1.0/1.25/1.5 分别 34,983/34,111/33,454ms,vs FlashAttention 达 5.17×/5.30×/5.40×(FP γ=0.95 仅 4.41×),CRISP 各配置在 131k 后全面超越对应 FlexPrefill。核心发现四:组件交互效应(Table 5)。单独 Cstruct 路由使 Llama IB 45.2(−2.2pp)、RULER 87.82(−1.4pp);单独 sink-aware 阈值已普遍有益(Qwen RULER 77.08);完整 CRISP 在两架构上最稳健。鲁棒性:α∈[0.75,1.0] 表现相当、超过 1.0 单调退化但 α=1.5 仍在聚合精度上 Pareto 支配 FP γ=0.95(55.3 vs 55.0)且快 21%;τ_proxy∈{0.15,0.25} 敏感性低;Qwen3-4B-Instruct-2507 上结论复现(IB 31.28 超 FA 28.67 共 +2.6pp,LongBench 46.34 仅差 FA 0.30pp)。
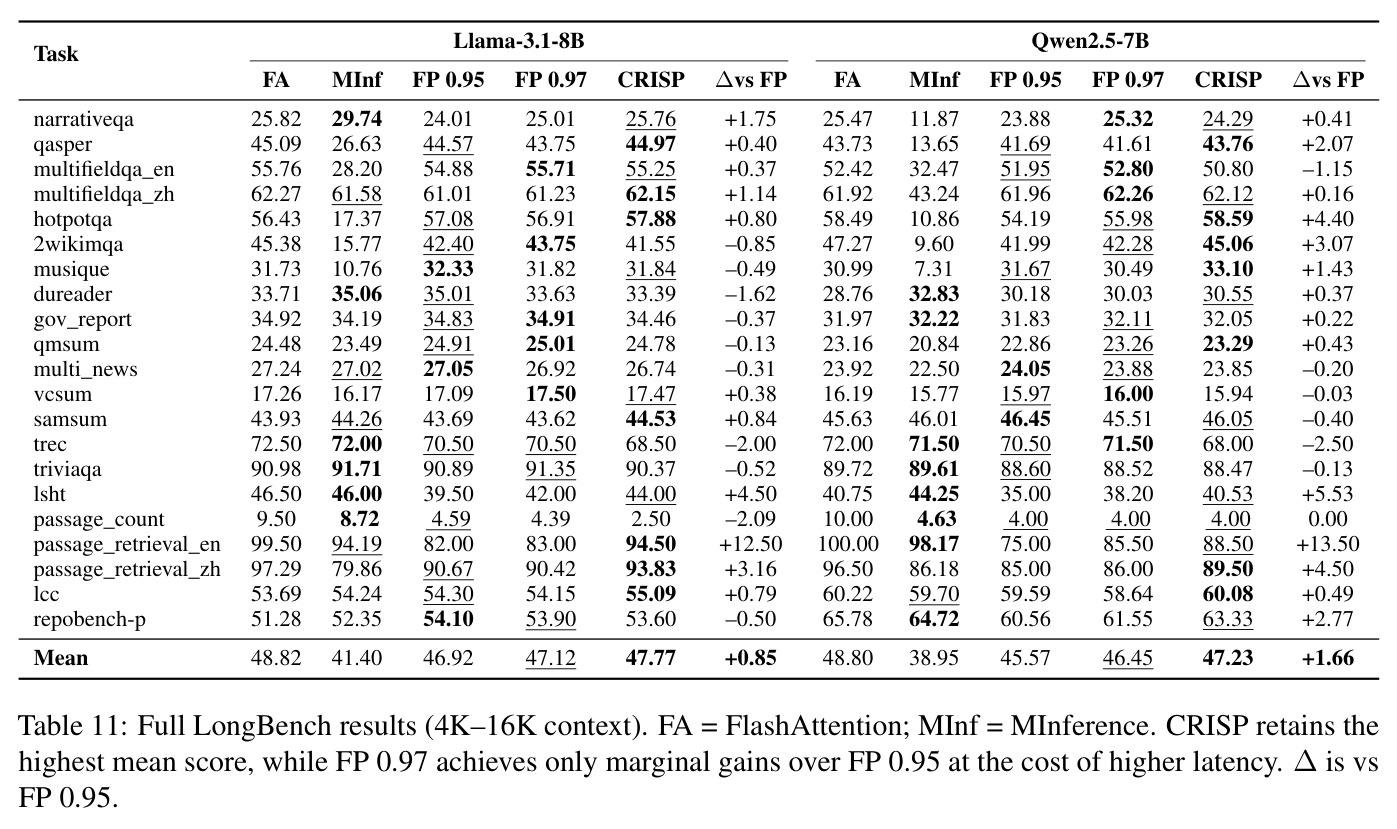
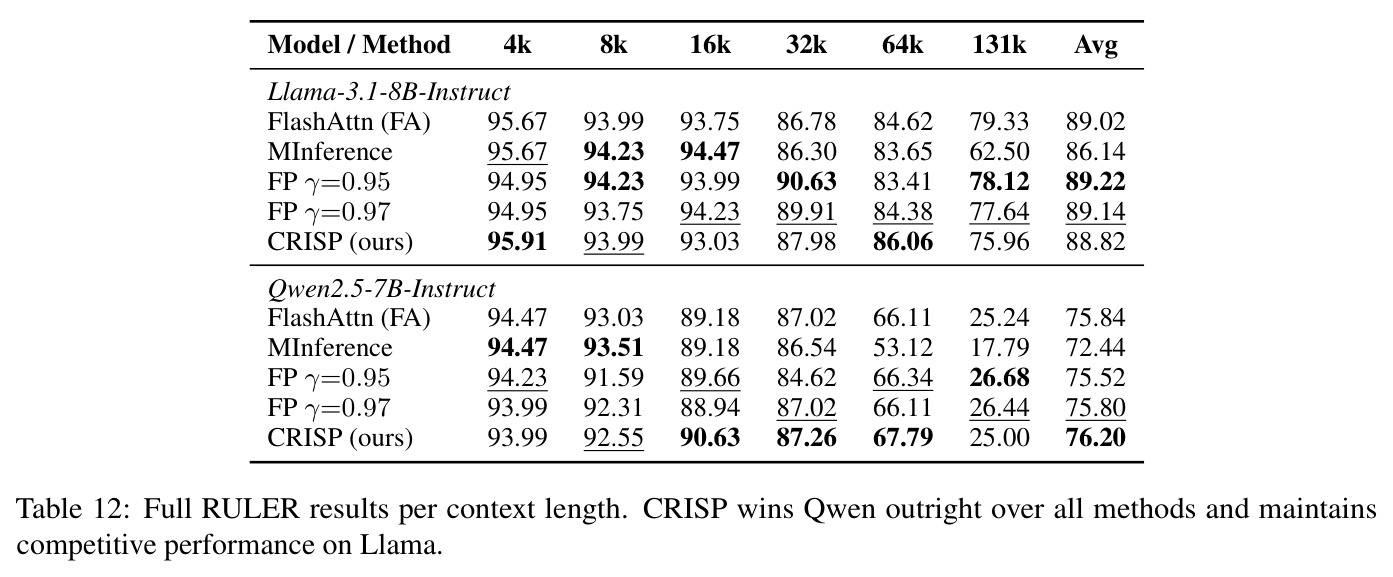
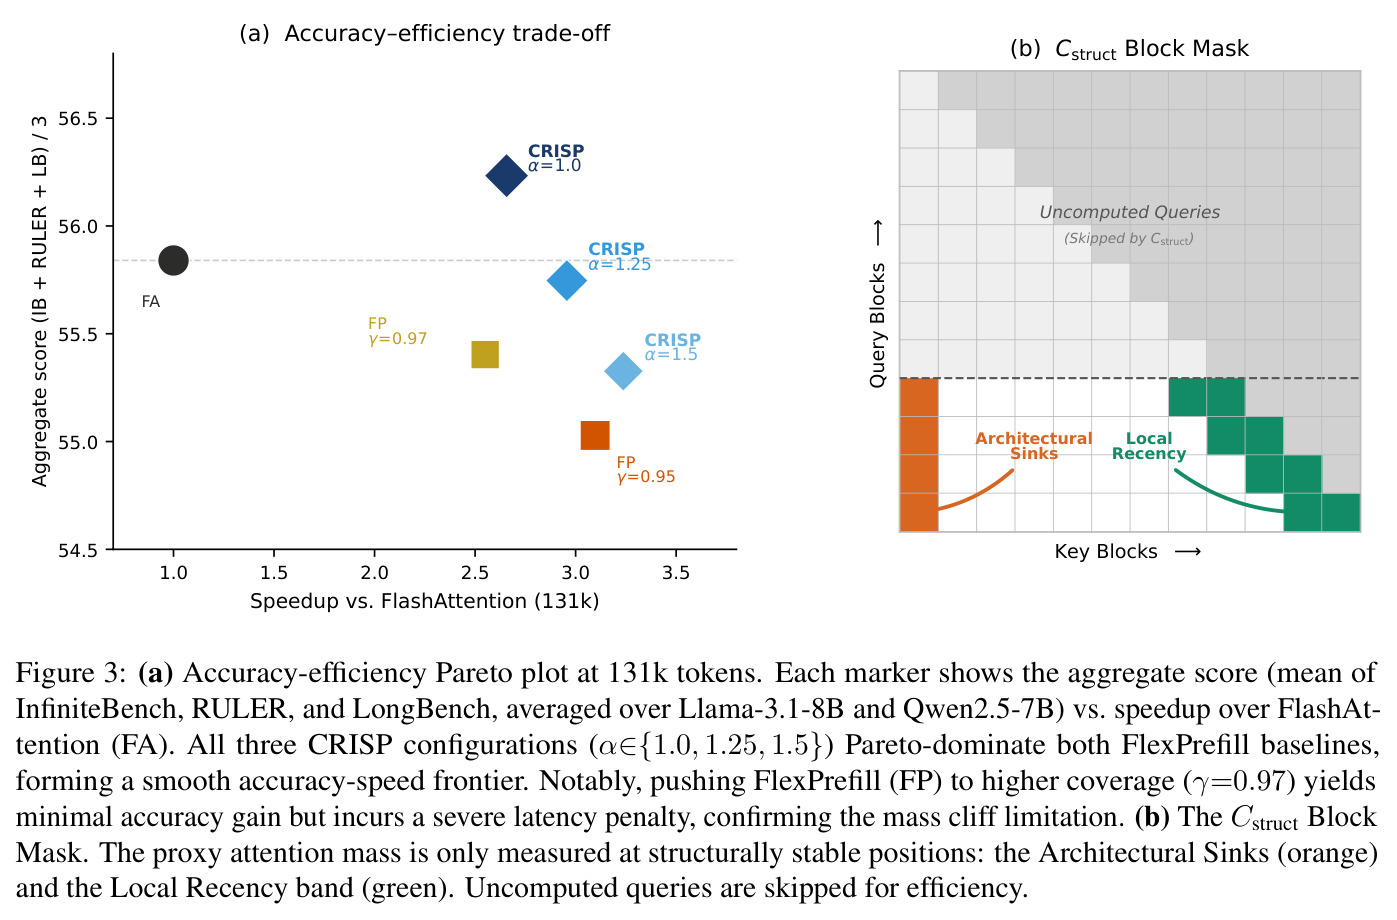
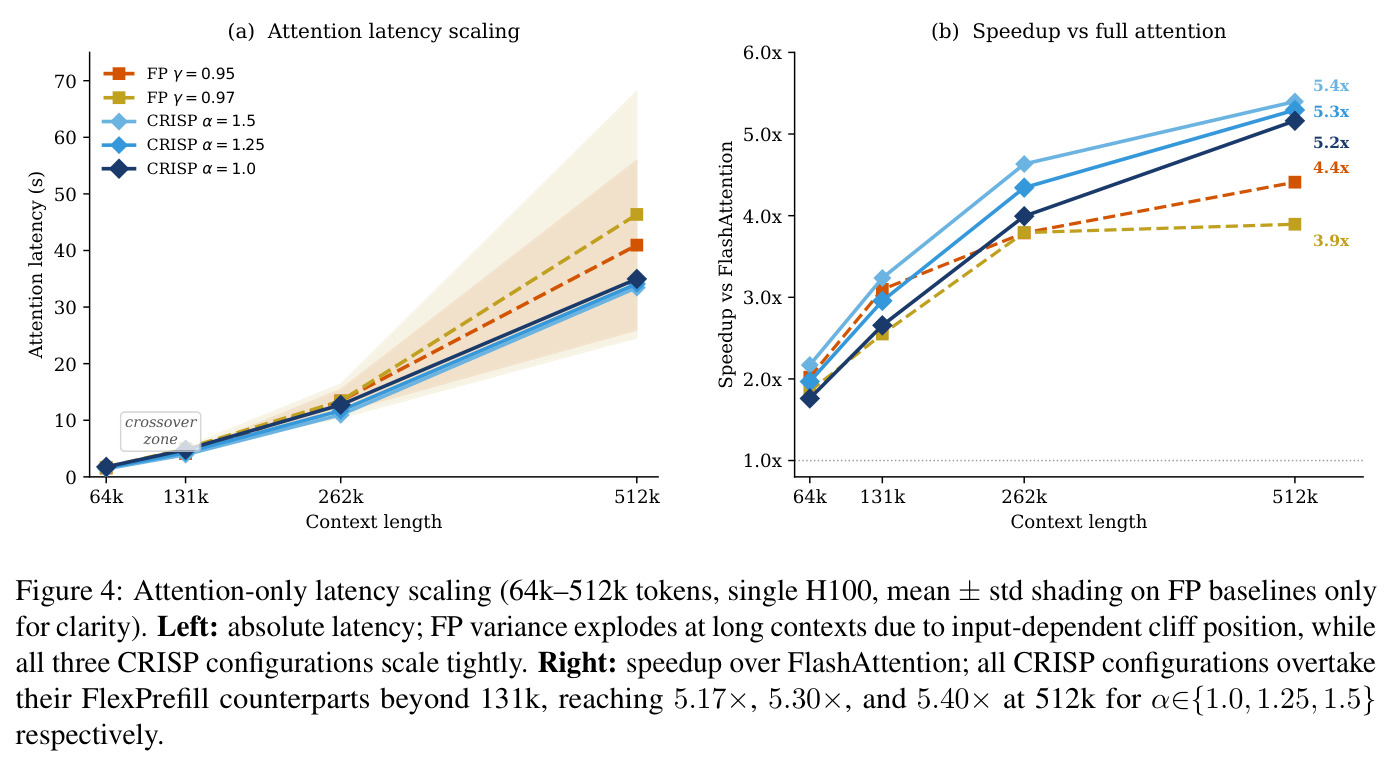
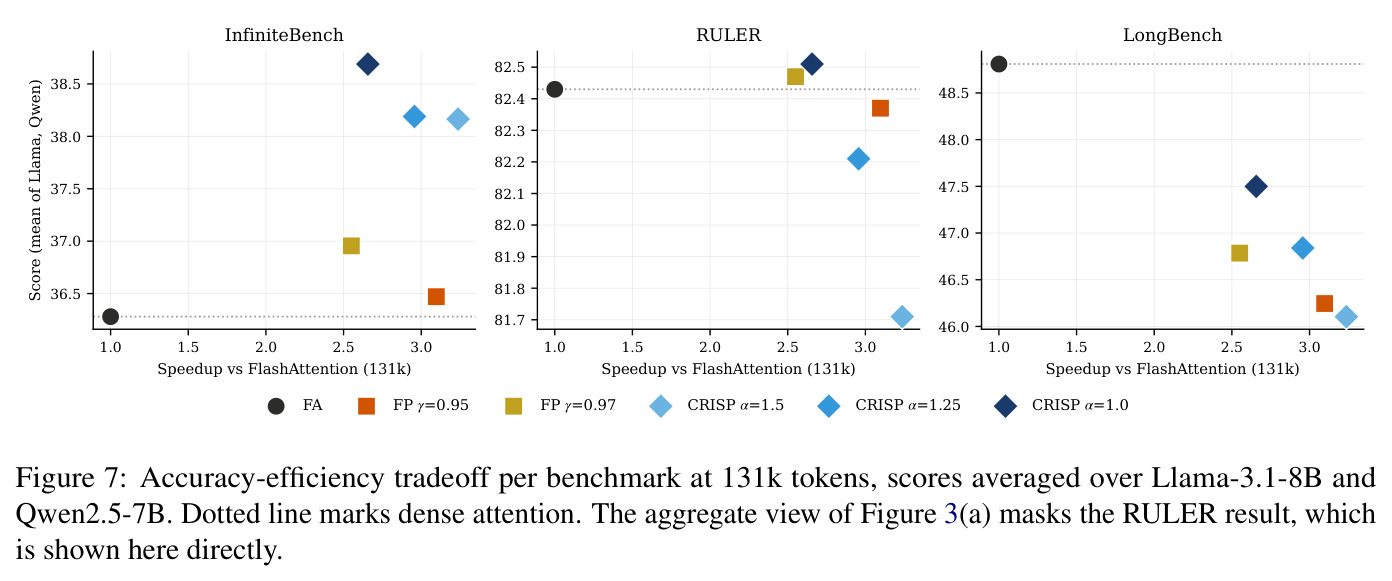
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| InfiniteBench 131K 综合(Llama-3.1-8B) | 任务均值 | 48.7(CRISP α=1.0) | FlashAttention 48.6;FlexPrefill γ=0.95 47.4;MInference 36.5 | +1.3pp vs FlexPrefill,反超稠密 +0.1pp |
| InfiniteBench 131K 综合(Qwen2.5-7B) | 任务均值 | 28.7(CRISP α=1.0) | FlashAttention 24.0;FlexPrefill γ=0.95 25.5;MInference 25.1 | +3.2pp vs FlexPrefill,反超稠密 +4.7pp |
| RULER 4K–131K(Qwen2.5-7B) | 均值 | 76.20 | FlexPrefill γ=0.95 75.52;FlashAttention 75.84;MInference 72.44 | +0.68pp vs FlexPrefill,全部方法第一 |
| LongBench 4K–16K(Llama-3.1-8B) | 均值 | 47.77 | FlexPrefill γ=0.95 46.92;FlexPrefill γ=0.97 47.12;MInference 41.40 | +0.85pp vs FlexPrefill,且超过更高覆盖的 γ=0.97 变体 |
| KV Retrieval(InfiniteBench,Llama) | 准确率 | 61.6 | FlexPrefill γ=0.95 43.8(FlashAttention 62.6) | +17.8pp(sink-only collapse 修复的直接证据) |
| Passkey(InfiniteBench,Qwen) | 准确率 | 50.3 | FlexPrefill γ=0.95 22.4(FlashAttention 0.3,Qwen 本身接近失效) | +27.9pp(论文口径 +28.0pp) |
| Passage Retrieval 英文(LongBench,Llama) | 准确率 | 94.5 | FlexPrefill γ=0.95 82.0(FlashAttention 99.5;MInference 94.19) | +12.5pp,基本追平稠密 |
| 预填充注意力延迟 @512k(单张 H100) | 毫秒 / vs FlashAttention 加速比 | CRISP α=1.25:34,111ms(5.30×);α=1.0:34,983ms(5.17×);α=1.5:33,454ms(5.40×) | FlexPrefill γ=0.95:40,949ms(4.41×);γ=0.97:46,369ms(3.90×) | 比 FlexPrefill 快 17–25%,加速比领先 0.8–1.5×,且方差随上下文增长保持平稳 |
局限与改进
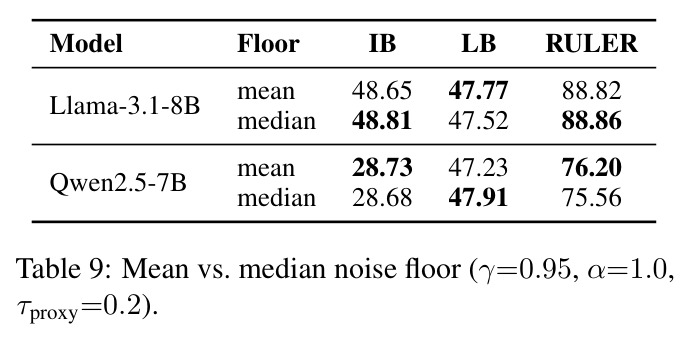
作者承认的局限:(1) 架构范围——$C_{struct}$ 是结构性测量而非正式的熵量,其有效依赖“低熵 head 质量落在 sink+新近窗口”这一经验规律;门控注意力等抑制 sink 的架构会打破该对应关系,且证据只覆盖 7–8B 的两个模型家族,外推边界未知。(2) 混合 head——继承 FlexPrefill 的二元 VS/PE 硬路由,混合结构的 head 被强制送上 VS 路径时,噪声底阈值可能丢弃不合模式的 token,概率软混合留作未来工作。(3) 规模与阶段——未验证 >8B 模型与既有基准之外的上下文长度;只处理预填充,解码期因果掩码下的动态质量悬崖刻画缺失。(4) PE 路径未改进,α 的动态调度未实现。我自己的观察:(5) Llama RULER −0.40pp 的回归暴露精度-覆盖权衡——RULER 的合成聚合任务需要覆盖中段注意力块,α=1.0 会把质量接近 $\mu$ 的临界块当噪声;Qwen(sink 分布较分散)上反而全面第一,说明效果强依赖架构的 sink 形态,跨模型方差真实存在。(6) 噪声底 $\mu$ 用均值,单个占优块会抬高阈值误伤弱信号(Table 9 显示中位数替代相差 ±0.7pp,无一方占优)。(7) 短上下文不划算:8K 时 CRISP(209.9ms)仍是稠密注意力的 4.1× 慢,交叉点在 8K–64k 之间,部署需按长度门控稀疏化。(8) 附录 F 自述块质量 dump 只覆盖单一模型单一输入,PE head 分布的跨输入变异性未验证,$C_{struct}$ 路由在分布外输入上的稳定性存疑。
独立分析的弱点
独立弱点分析:(1) 架构依赖是最大软肋——$C_{struct}$ 的指示性建立在“sink 存在”上,若未来主流模型通过门控注意力等手段消除 sink,锚点质量失去意义,路由退化为噪声;改进方向是为无 sink 架构设计在线估计的熵代理,或让锚点位置可学习/可校准。(2) 二元硬路由丢失信息——VS/PE 之间的混合 head 被迫二选一;可引入 per-head 置信度加权,或按 $C_{struct}$ 值对 VS/PE 输出做概率软混合,代价是需要更细的延迟-精度权衡分析。(3) 聚合任务欠选择——α=1.0 在 RULER 聚合类任务上把临界块当噪声(Llama −0.40pp);可按 head/任务复杂度动态调度 α,或用“边际质量增益”停止准则替代固定倍数阈值。(4) 均值噪声底的鲁棒性——块状噪声会抬高 $\mu$;可研究中位数/分位数底或两遍筛选(先粗后细),Table 9 表明两者差距不大但方向因基准而异,自适应选择底统计量值得一试。(5) 每层独立路由开销未优化——更大模型层数更多,跨层预算共享或分层缓存路由决策可进一步摊薄固定成本。(6) 与解码期稀疏(Twilight、H2O)组合的端到端流水线只有理论兼容性论证,缺乏系统实现与实测。
未来方向
作者提出的方向:(1) 无 sink 架构下的稀疏注意力——熵论证(附录 B)在原理上仍适用于 softmax 注意力,但需要全新的结构代理替代 $C_{struct}$,且现有对比方法同样未覆盖该 regime;(2) 软路由与混合 head 处理——概率混合或置信度加权决策;(3) 扩展到 >8B 模型与超越既有基准的上下文长度(Qwen3-4B 检查只是单点验证而非系统扫描);(4) 解码阶段的质量悬崖——在自回归生成和因果掩码下动态刻画悬崖位置,与预填充方法组合;(5) PE 路径改进与 α 动态调度,以缓解聚合任务的精度-覆盖权衡。基于本文成果可延伸的方向:(6) 把质量悬崖分析推广到多模态长上下文与 MoE 架构(不同专家可能有不同 sink 形态,路由器需要条件化);(7) 将噪声底阈值思想移植到解码期 KV cache 驱逐与 top-p 剪枝(与 Twilight 互补组合:CRISP 管预填充计算、Twilight 管解码带宽);(8) 在流式/分块预填充场景下在线估计 $\mu$,支持超长上下文的增量处理;(9) 理论上把 $\epsilon\approx 1/n$ 的分析从固定 pre-softmax gap $\Delta$ 推广到任意 logit 分布,给出更紧的噪声界和最优 α 的解析形式;(10) 结合 Nawrot et al. (2026) 的 isoCost 分析,按任务类型自适应分配层间/头间稀疏预算。
复现评估
复现评估:论文正文与附录未声明开源代码链接,但复现门槛中等偏低。有利因素:(1) 方法完全免训练,只需在推理期替换预填充注意力;(2) 全部超参数明确给出且经过敏感性分析——$\tau_{proxy}=0.2$、$\gamma=0.95$(仅 PE)、$\alpha=1.0$(推荐)/1.25(速度)、$B=128$、$w_{sink}=w_{local}=128$、$k_{min}=1024$ token/方向,且 α∈[0.75,1.0]、τ_proxy∈[0.15,0.25] 都不敏感,容错空间大;(3) CRISP 是 FlexPrefill 的插件式修改(Algorithm 5→2 换路由、Algorithm 6→3 换预算规则),FlexPrefill 与 MInference 均开源,可对齐实现;(4) 评测全部基于公开基准(InfiniteBench 截断至 131K、RULER 4K–131K、LongBench 4K–16K)与公开模型(Llama-3.1-8B-Instruct、Qwen2.5-7B-Instruct、Qwen3-4B-Instruct-2507);(5) 延迟协议清晰:单张 H100 80GB、attention-only 计时、64k–512k 四个刻度。成本与风险:512k 上下文的稠密基线实验需要 80GB 级 GPU(A100/H100);VS 斜向分数的精确实现细节依赖 FlexPrefill 原代码;块级稀疏注意力的 GPU kernel 需要一定系统工程量;附录 F 的块质量 dump 分析需要额外插桩但非必需。总体:算法逻辑一天可读懂,忠实复现约需一至两周(主要花在 kernel 与基准跑通),关键结论(检索恢复、延迟交叉点)最容易验证。
论文图表
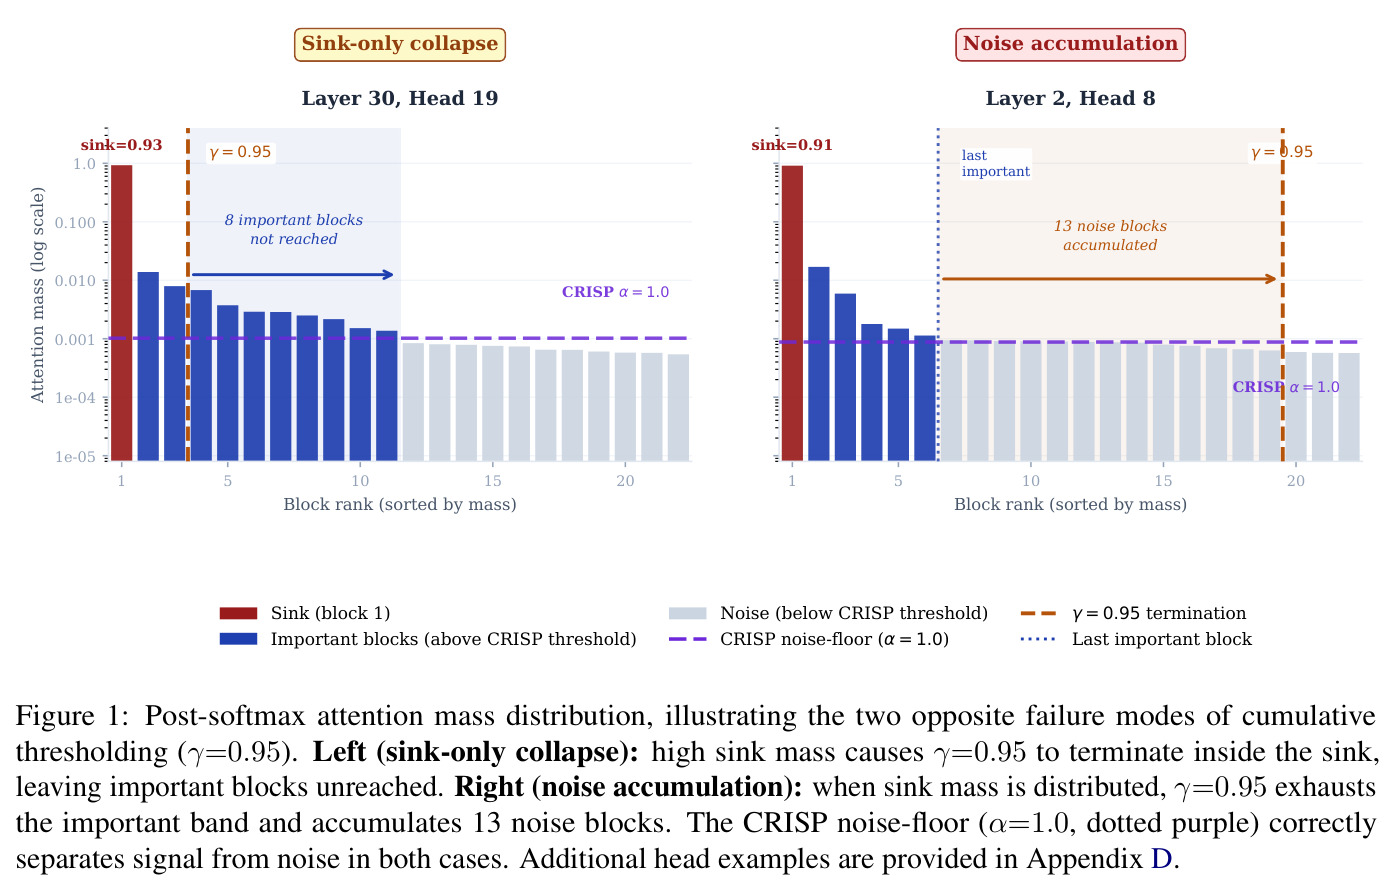
并排展示两个 Llama-3.1-8B 的 VS head 的块质量分布(按质量排序,log 纵轴)。左(Layer 30, Head 19,sink=0.93):γ=0.95 的累积阈值在 sink 块内部就提前终止,8 个重要块完全没被访问——sink-only collapse;右(Layer 2, Head 8,sink=0.91):sink 质量略低,阈值越过来的是噪声区,累积了 13 个近零质量噪声块——noise accumulation。两种情形下 CRISP 的噪声底(α=1.0,紫色虚线)都正确切分了信号与噪声。
这是全文核心概念“质量悬崖”的可视化定义,一图解释了为什么累积覆盖率阈值在结构上必然失败、以及两种失败模式的机理,是理解本文动机的钥匙。
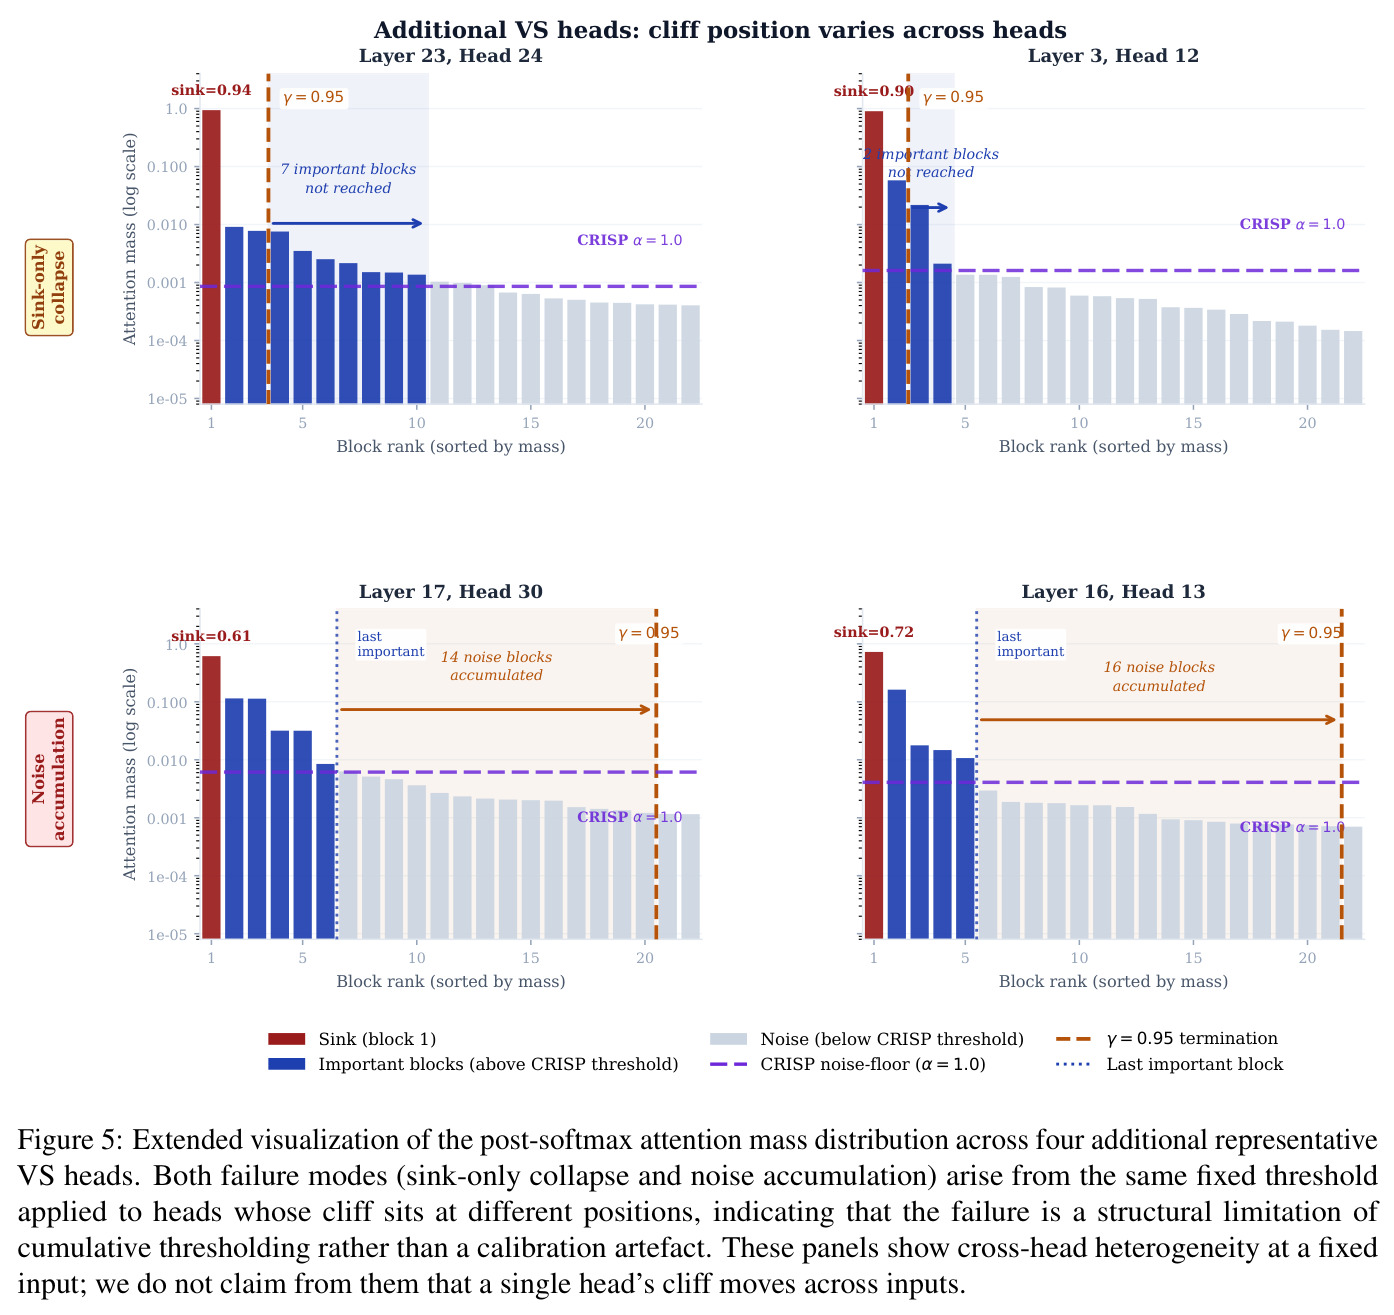
附录 D 中四个额外 VS head(Layer 23/24、3/12、17/30、16/13)的块质量分布。同一固定阈值 γ=0.95 在不同 head 上分别触发两种失败(sink=0.94 时不 reached;sink=0.61 时累积 14 个噪声块),而 CRISP 噪声底在所有 head 上都正确隔离信号,说明失败是累积阈值的结构性缺陷而非校准问题。
排除“个别 head 特例”的质疑,展示悬崖位置跨 head 异质性下的鲁棒修复,强化理论主张的普遍性。
总控算法:输入 $Q,K,V$ 与 $\tau_{proxy},\gamma,\alpha$;先 PatSearch 得到 (pattern, $\hat{A}$);若 pattern=VS 调 VSIndex(sink-aware,Algorithm 3),否则 PEIndex(GlobalAdaptive,Algorithm 4);最后返回 $A(Q,K,V,S)$。
方法的权威入口,定义了组件如何组装。
路由算法:取 $\hat{Q}=Q[-b:]$,计算 $\hat{A}=\mathrm{Softmax}(\hat{Q}K^\top/\sqrt{d})$;$C_{struct}=\frac{1}{b}\sum_i\sum_{j\in S_{vs}}\hat{A}[i,j]$;$C_{struct}\ge\tau_{proxy}$ 返回 VS 否则 PE,同时返回 $\hat{A}$ 供后续复用。
核心贡献 $C_{struct}$ 的精确定义与实现,展示其只是对已计算 $\hat{A}$ 的常量时间切片归约。
VS 路径索引选择:计算垂直分数 $a_v$(列均值)与斜向分数 $a_s$(对角均值)并分块池化;对每方向排除首尾必留块后计算噪声底 $r_d=\max(1-p_d[0]-p_d[N_b-1],0)$、$\mu_d=r_d/(N_b-2)$;选所有 $p_d[j]>\alpha\mu_d$ 的块,数量 clip 到 $[k_{min},N_b]$;返回 $S_v\cup S_s\cup\{0,N_b-1\}$。
γ-cumsum 的替代者,是把“质量悬崖”理论落地为可执行预算规则的核心代码。
PE 路径索引选择:对全部查询(不只 $\hat{Q}$)池化得 $\bar{A}$,softmax 后归一化展平,argsort 后按 γ-cumsum 取前 $K^*$ 个索引。CRISP 在此路径保留原设计,因为 PE head 无悬崖(Figure 6)。
说明方法非对称修改的边界:只改有理论缺陷的部分,避免无谓的风险。