中期训练中的知识蒸馏偏向推理而非事实记忆 Knowledge Distillation During Mid-Training Favors Reasoning over Factual Recall
中期训练时标准蒸馏以牺牲事实记忆换推理提升,按教师熵切换蒸馏与NTP监督可两者兼得
前置知识
知识蒸馏(KD)
让小模型(学生)除了学习真实下一 token 外,还模仿更大更强教师模型的输出分布。logit 蒸馏在温度 $\tau$ 软化后的概率分布之间计算散度,损失通常写成 $\mathcal{L}=(1-\alpha)\mathcal{L}_{\text{CE}}+\alpha\mathcal{L}_{\text{KL}}$,其中 $\alpha\in[0,1]$ 控制蒸馏强度,教师分布 $p_T^{(\tau)}$ 作为额外的软监督信号。
本文的全部问题就是:这个标准配方在中期训练阶段会产生什么此前未被发现的副作用,以及如何修复。
前向/反向 KL 散度
前向 KL $\mathrm{KL}(p_T\|p_S)$ 以教师分布加权,强制学生覆盖教师的所有预测(mode-covering);反向 KL $\mathrm{KL}(p_S\|p_T)$ 以学生分布加权,只惩罚学生落在教师低概率区域的行为(mode-seeking),倾向让学生集中到教师最自信的模式上。
两种散度在本文中表现出不同的优化几何(附录 D.4 用梯度余弦分析),且 Switch Distillation 选择反向 KL 正是利用其 mode-seeking 特性来强化教师已高度集中的低熵预测。
中期训练(mid-training)
介于预训练与后训练之间的自监督阶段:继续用下一 token 预测在小规模精选语料(数学、指令跟随、维基、代码等,如 Dolmino Mix 1124)上训练几十 B token,目标是为后续对齐奠定事实性、推理与指令跟随的基础。Gemma、Llama 等前沿流水线均已采用该阶段。
本文的核心论断是 KD 的行为具有阶段依赖性:同一目标在预训练是帕累托改进,在中期训练却产生权衡。不理解阶段划分就无法读懂结论。
预测熵(predictive entropy)
教师对下一 token 分布 $p_T^{(\tau)}(\cdot|x_{<n})$ 的不确定性度量:$H_n=-\sum_{v\in V}p(v)\log p(v)$,单位为 nats。熵低表示教师把概率集中在一个明确的续写上(自信),熵高表示分布弥散、对正确答案不确定。本文用 token 级熵作为监督可靠性的代理指标。
它既是论文解释推理-事实权衡机理的核心变量(教师置信度不对称、事实习得顺序),也是所提方法的路由信号,贯穿全文。
帕累托改进
源自经济学的概念:在不使任何其他指标变差的前提下改进至少一个指标。在训练目标评估中,若方法 A 在所有任务组上都不低于方法 B 且至少一项更高,则称 A 帕累托占优 B;论文把推理与事实召回画成二维散点,构成权衡曲线(frontier)。
论文最尖锐的论断是:中期训练中扫遍所有超参,没有任何 KD 配置帕累托占优 NTP,而 Switch Distillation 恢复了帕累托占优。
研究动机
现代语言模型在预训练与后训练之间普遍引入中期训练:在 DCLM 网页、FLAN 指令、数学、Wikipedia、StackExchange、peS2o 等精选语料(如 Dolmino Mix 1124)上继续自监督训练约 60B token,为对齐阶段奠定事实性、推理与指令跟随的先验。由于中期训练的 token 量远小于预训练(本文 60B 对 100B),从每个 token 榨取更多学习信号变得格外重要。Logit 知识蒸馏(KD)用更强教师(如 Instruct 模型)的预测分布增强 ground-truth 监督,已被 Gemma 3、Llama 等前沿流水线采用,但已有研究几乎全部集中在预训练(蒸馏 scaling law)与后训练(MiniLLM、on-policy KD),KD 在中期训练是否同样有效完全未知。一个具体的隐患是:中期训练时教师已经“很有知识”、学生也已学了 4T token,此时统一的前向 KL 蒸馏对不同类型 token(推理步骤 vs 事实负载)的监督是否同样可靠,此前没有人系统检验过。
本文的目标是本文要在完全受控的条件下回答三个递进的问题。第一,KD 在中期训练与预训练的行为是否一致:利用 OLMo-2 这一全开放生态(中间 checkpoint、完整训练配方、多规模模型族),用 1B 学生从随机初始化预训练 100B token、再从 4T-token checkpoint 中期训练 60B token,教师采用 OLMo-2 1B/7B/13B Instruct,扫描蒸馏强度 $\alpha\in\{0,0.3,0.5,0.7,1.0\}$ 与 KL 方向(前向/反向)。第二,若行为不一致,给出机理解释——教师置信度、学生知识状态、优化动力学三者如何交互。第三,基于机理设计一个能在中期训练中同时提升推理、保留事实记忆的 drop-in 目标函数,并验证其增益能否穿过 SFT+DPO+RLVR 的标准后训练管线保留下来。
与已有工作不同的是,本文的独特切入是“阶段感知”的视角:以往工作把 KD 当作阶段无关的目标函数,本文证明其副作用由教师置信度、学生知识状态与优化动力学的交互决定,是中期训练特有的“推理-事实权衡”。分析路径上,作者不满足于宏观指标对比,而是下钻到 token 级:用教师预测熵把事实样本分成五分位,逐层追踪金标 token 概率、闭式梯度比 $g_{\text{KD}}/g_{\text{NTP}}$、分位内事实召回差三层级联证据,把一个经验现象解释成完整因果链。方法设计上,与最接近的 TRKD 方向恰好相反——TRKD 把高熵 token 交给前向 KL 蒸馏并保留全部 CE,Switch Distillation 则论证低熵 token 才是教师监督的可靠区,应在此用反向 KL、其余 token 回退到交叉熵。
核心方法
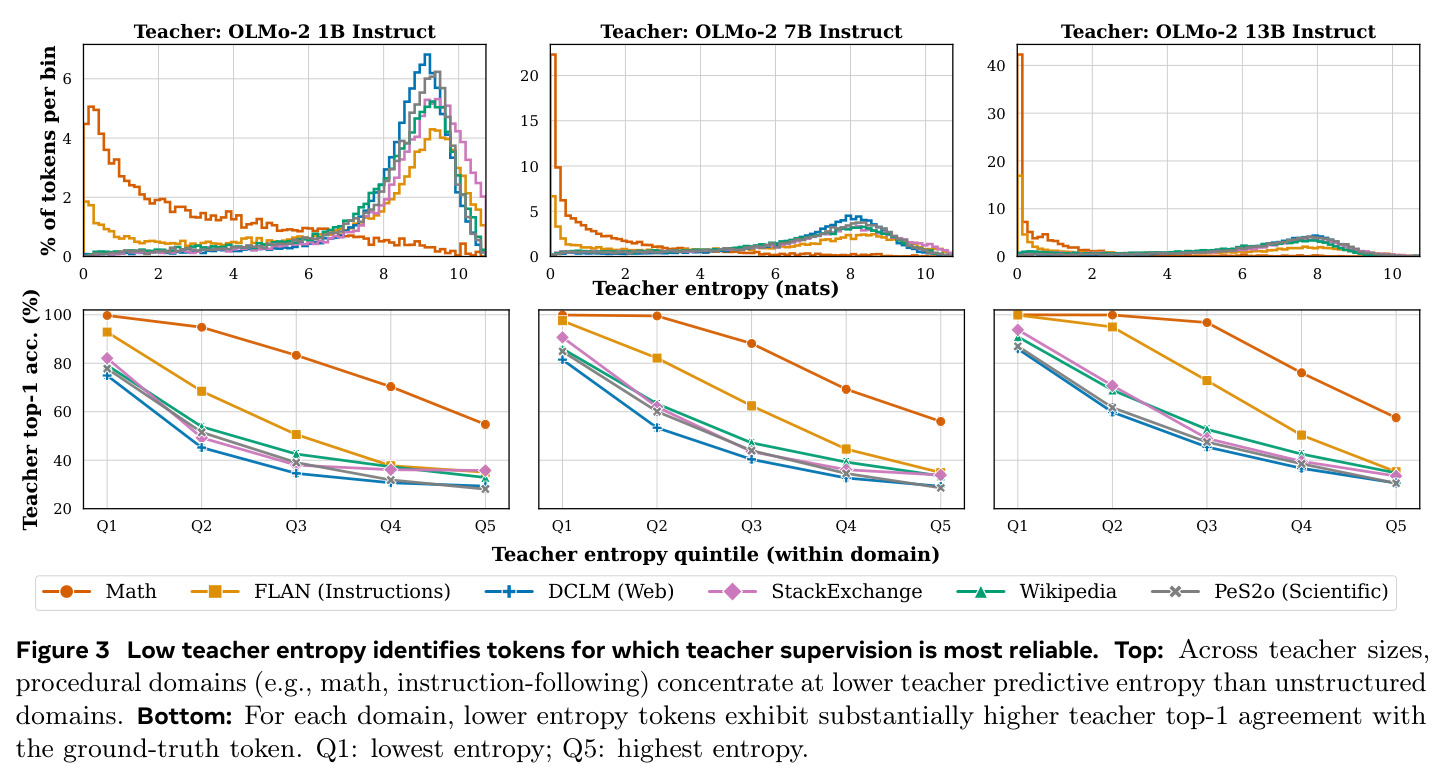
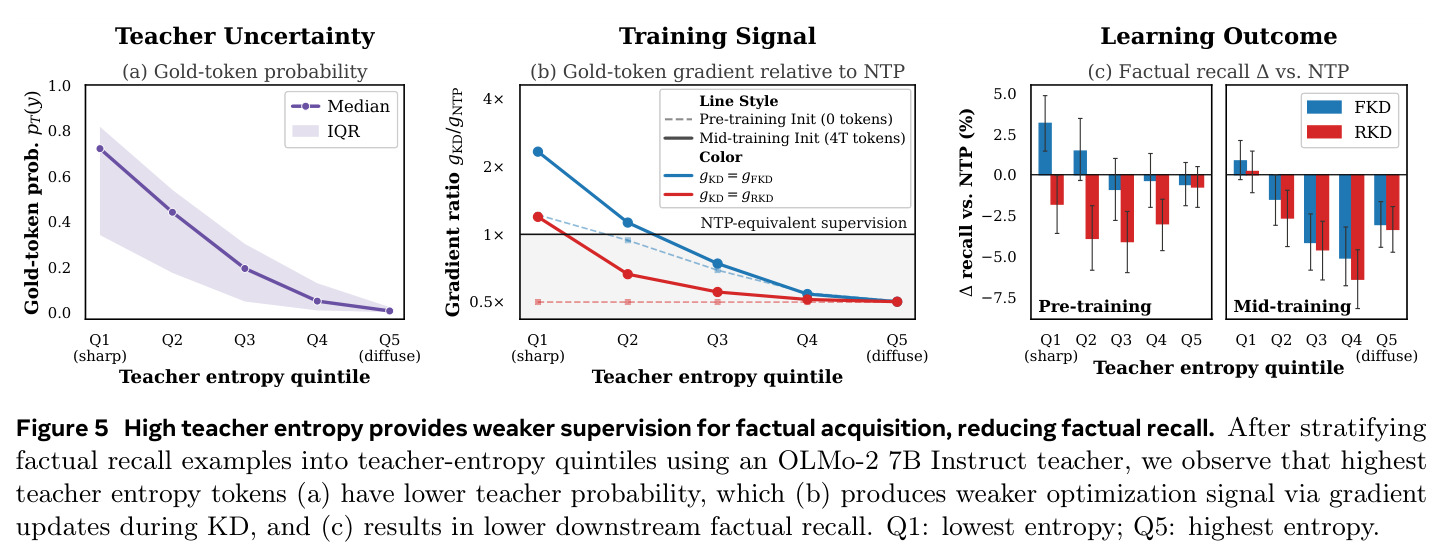
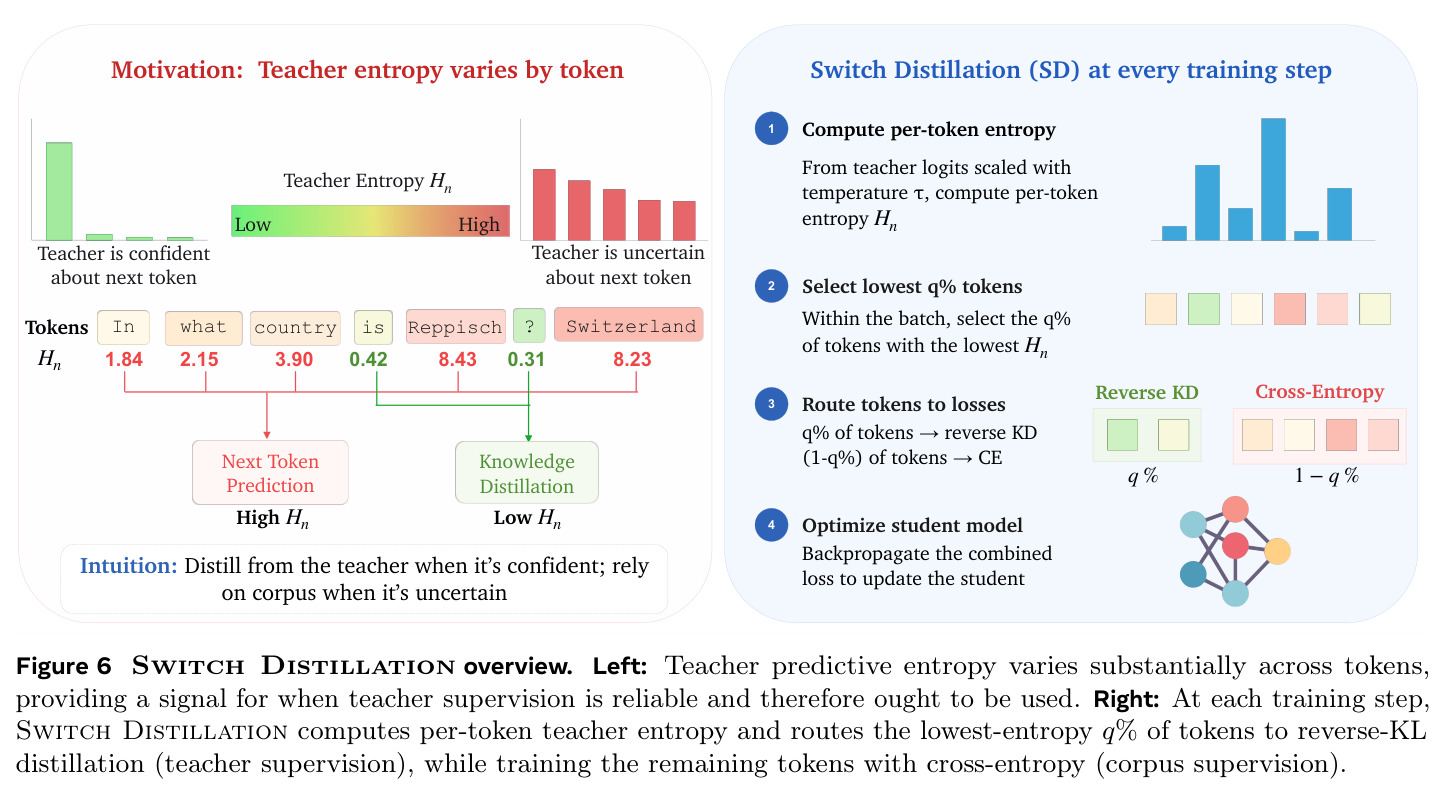
直觉先行:教师并非对所有 token 同样可靠。在数学、指令跟随等“程序性”数据上,教师的下一 token 分布高度集中(低熵),top-1 预测往往就是正确答案;而在网页、维基等知识密集型文本上,事实负载 token 处的教师分布弥散(高熵),命中率低。学生的知识状态又与教师熵强相关:低熵事实在预训练早期就已学会,到中期训练开始时,还没学会的事实恰恰集中在教师最不确定的高熵区——此时 KD 施加在这些事实上的监督反而比 NTP 弱(金标梯度降到约 0.5 倍),于是蒸馏加速了推理却拖慢了事实习得。技术路线分三步:先在 OLMo-2 上做受控实验确认权衡的存在与稳健性;再做熵分层的机理分析(金标概率、梯度、习得三层);最后提出 Switch Distillation——每个训练步计算 batch 内各 token 的教师预测熵,把熵最低的 20% token 路由到反向 KL 蒸馏,其余 token 用交叉熵,两项分别归一化后相加。
核心创新是以教师预测熵为路由信号,让监督来源在“教师”与“语料”之间按 token 硬切换:$\mathcal{L}_{\text{SD}}=\frac{\tau^2}{|S_q|}\sum_{n\in S_q}\mathrm{RKL}\big(p_{S,n}^{(\tau)}\|p_{T,n}^{(\tau)}\big)+\frac{1}{|\bar{S}_q|}\sum_{n\notin S_q}\mathcal{L}_{\text{CE},n}$,其中 $S_q$ 是 batch 内熵最低的 $q$%(默认 20%)token 集合。与已有方法的本质区别有三:标准 KD 对所有 token 统一施加同一目标,完全无视教师可靠性的 token 级差异;TRKD 虽然也做 token 路由,但它把高熵 token 交给前向 KL、并保留全部 token 的 CE,与本文“低熵才可信、低熵用 RKL”的设计方向相反;EOPD 在后训练 on-policy 场景用熵插值 KL 方向,但从不回退到纯 CE。此外,熵直接由 KD 本来就需要的 teacher logits 计算,只增加熵与分位数两个轻量操作,不引入任何参数或额外前向,是真正的 drop-in 目标替换。
方法步骤详情
完整流程(对应 Algorithm 1)如下。第一步,前向计算:用温度 $\tau=2$ 对教师和学生的 logits 做 softmax 得到软化分布 $p_T^{(\tau)}$、$p_S^{(\tau)}$(7B/13B 教师以 FP8 量化加载,1B 用 BF16)。第二步,计算每个有效 token 位置 $n$ 的教师预测熵 $H_n=-\sum_{v\in V}p_T^{(\tau)}(v|x_{<n})\log p_T^{(\tau)}(v|x_{<n})$。第三步,路由:在 batch 内对 $\{H_n\}$ 取分位数,得到低熵集合 $S_q=\{n: H_n\le\text{Quantile}_q(\{H_n\})\}$,默认 $q=20\%$(扫描 10%/20%/30% 后选定)。第四步,分别计算两个损失:对 $S_q$ 用 $\frac{\tau^2}{|S_q|}\sum\mathrm{RKL}(p_S\|p_T)$(mode-seeking 特性适合强化教师已集中的预测),对补集 $\bar{S}_q$ 用 $\frac{1}{|\bar{S}_q|}\sum-\log p_S(y_n|x_{<n})$;两项独立归一化,保证 $q$ 只影响路由策略而不改变蒸馏强度。第五步,求和反传更新学生。训练设置:从 OLMo-2 1B 的 4T-token stage1 checkpoint 出发,训练 60.4B token、28,800 步,峰值学习率 $7.45\times10^{-5}$ 线性衰减,全局 batch 2,097,152 token/步。
技术新颖性
技术新颖性体现在四个层面。其一,问题新:首次系统证明 KD 行为具有阶段依赖性,发现的“推理-事实权衡”此前未被刻画,且该效应跨教师规模(1B/7B/13B)、KL 方向(FKD/RKD)与蒸馏强度稳健存在,并在 SmolLM2 生态复现。其二,解释新:给出完整因果链——教师熵按域不对称(程序性域低熵,跨 12 个阶段-规模组合 ROC AUC 0.744–0.826)、熵预测监督质量(五分位内 top-1 命中率单调下降)、熵预测习得顺序(预训练结束时最低熵分位 67% 事实已学、最高分位仅 5%)、KD 金标梯度随熵衰减至约 0.5 倍 NTP——并用闭式推导支撑:$g_{\text{NTP}}=1-p_S^1(A)$,而 FKD 的蒸馏项把监督目标从 1 换成教师质量 $p_T^{(\tau)}(A)$,天然有界。其三,方法新:熵路由+低熵 RKL 的组合极简,但消融证明熵路由是主要增益来源(换成 oracle 域路由推理掉 7.2 分、随机路由掉 6.5 分、teacher-correct 路由掉 4.4 分)。其四,验证新:增益穿过四阶段后训练管线仍保留,这在中间目标研究中少见。
实验结果
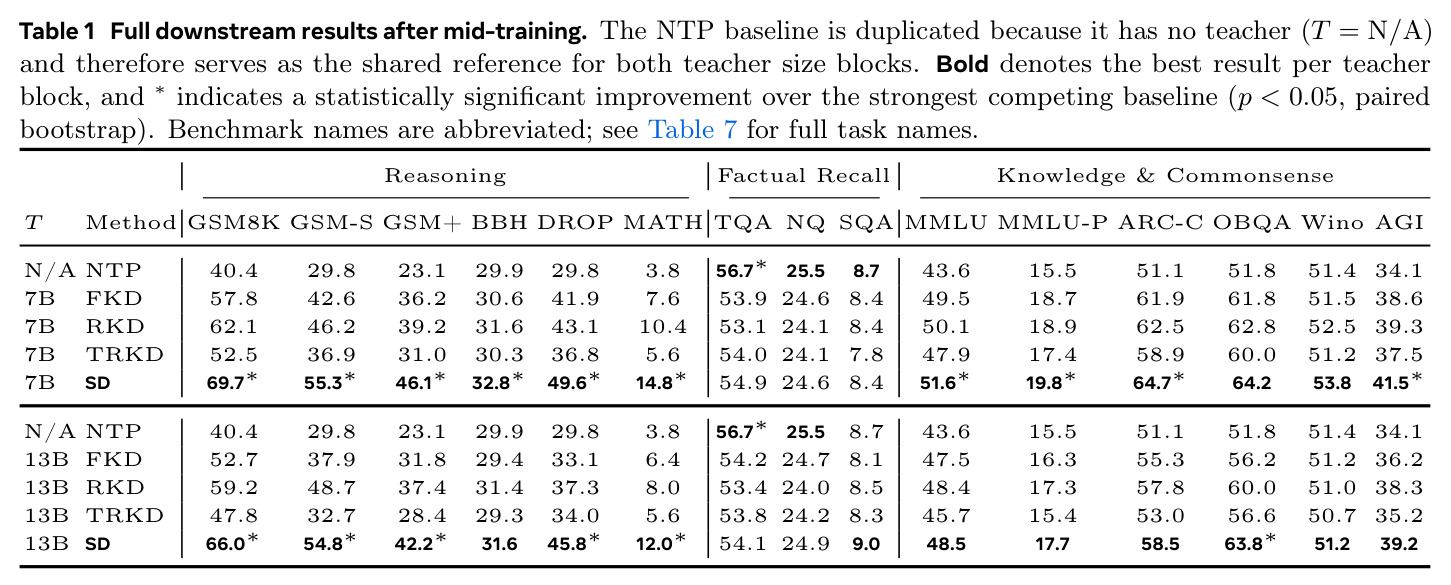
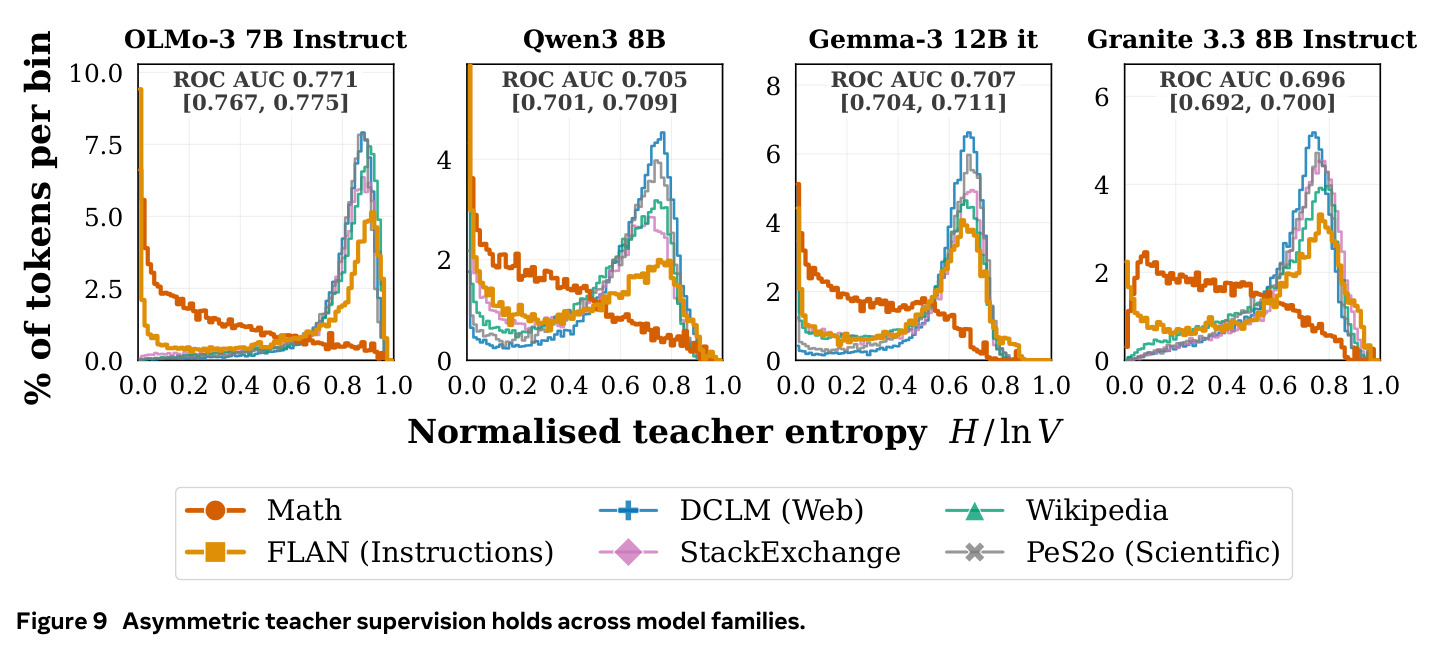
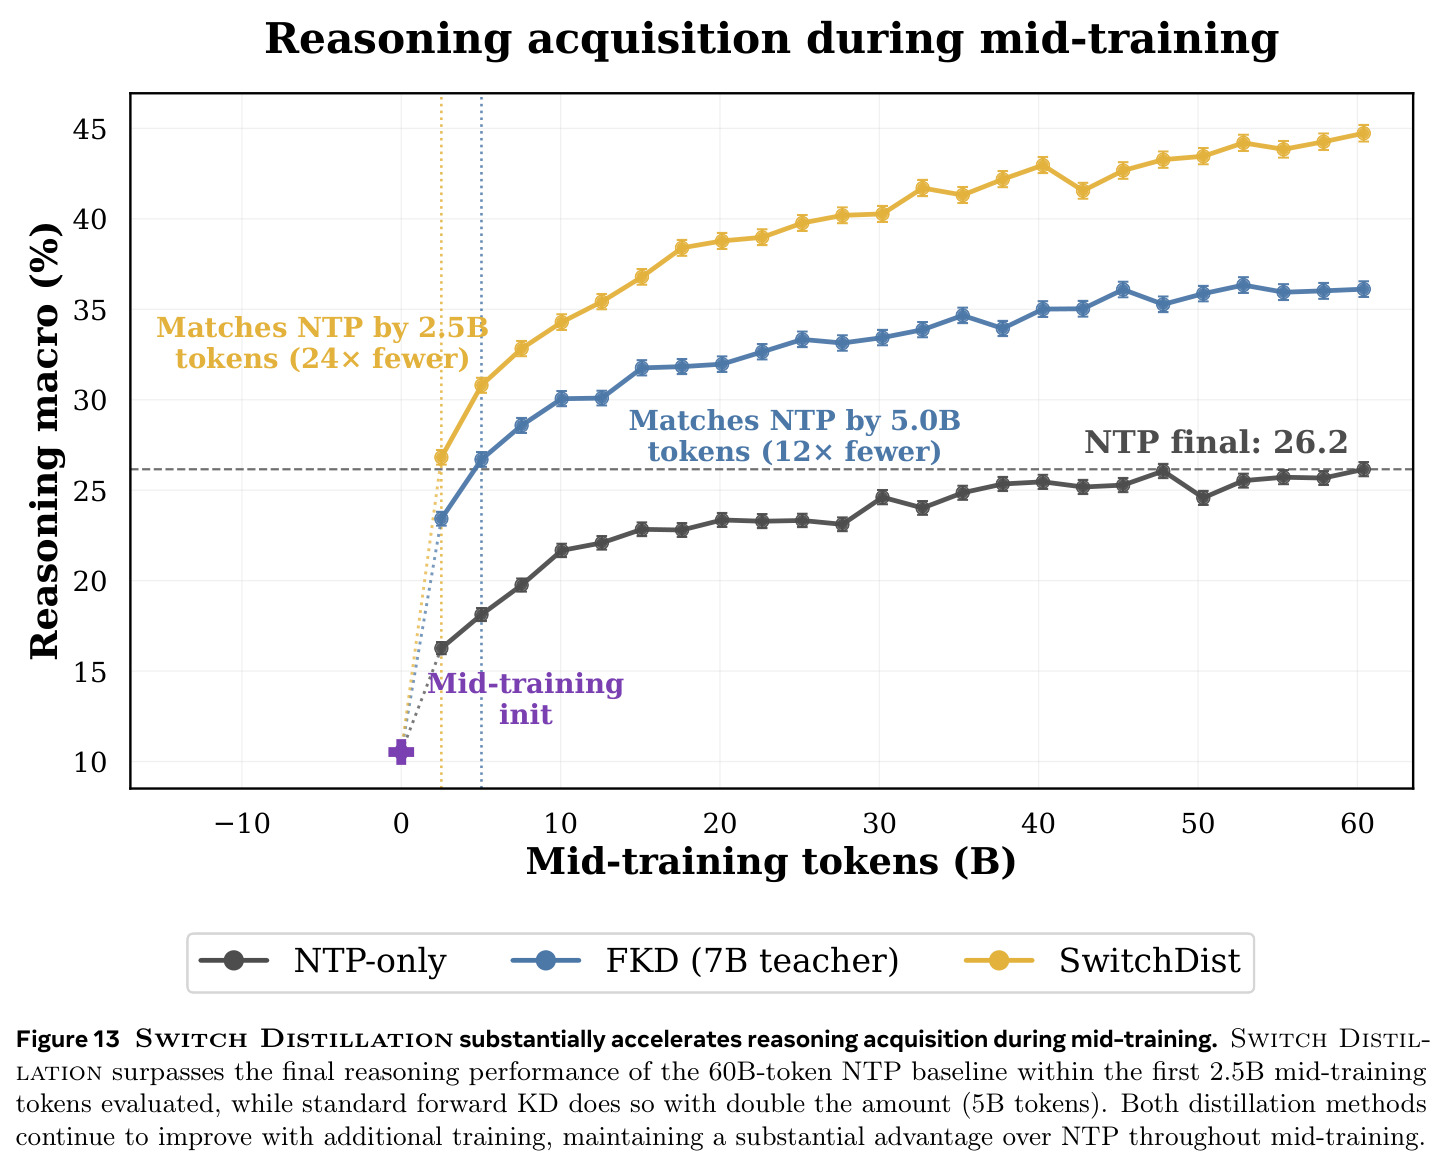
逐项看实验。第一,阶段依赖性(图 1、2):预训练中,中等强度前向 KL 相对 NTP 帕累托改进(推理与事实召回同升);中期训练中扫遍 $\alpha$、KL 方向与教师规模,没有任何 KD 配置在事实召回上超过 NTP。第二,中期训练主结果(表 1):Switch Distillation 用 7B 教师把推理宏平均从 NTP 的 26.1% 提到 44.7%(1.71 倍),其中 GSM8K 69.7 对 40.4、GSM-Plus 46.1 对 23.1、MATH 14.8 对 3.8、DROP 49.6 对 29.8;事实召回宏平均 29.3% 对 NTP 30.3%(保留 96.8%,是所有 KD 基线中最接近 NTP 的);知识常识宏平均 49.3% 对 41.3%。13B 教师为 42.1%/29.3%/46.5%,反而不如 7B,印证了师生容量差效应。第三,后训练后(表 2):SD 推理宏平均 7B 教师 50.6% 对 NTP 38.5%(1.32 倍),知识常识 47.4% 对 39.6%(1.20 倍),事实召回 28.2% 对 27.5%,缺口完全闭合并反超。第四,机理(图 3–5):教师熵把程序性与知识密集域分开(AUC 0.744–0.826),熵与 top-1 命中率逐分位单调相关,KD 的金标梯度在高熵事实处衰减至约 0.5 倍 NTP。第五,学习速度(图 13):SD 仅用 2.5B token(1/24 预算)就追平 NTP 60B token 的最终推理水平。第六,泛化:SmolLM2 360M 学生复现权衡(图 7);熵不对称在 OLMo-3、Qwen3、Gemma-3、Granite 3.3 上同样成立(归一化熵 AUC 0.696–0.771,图 9)。第七,消融(表 3、4):$q=20\%$ 最优且对阈值不敏感;FKL 版推理掉 2.9 分;软分布优于 top-1 硬标签(后者事实 +1.3 但推理 -6.4)。
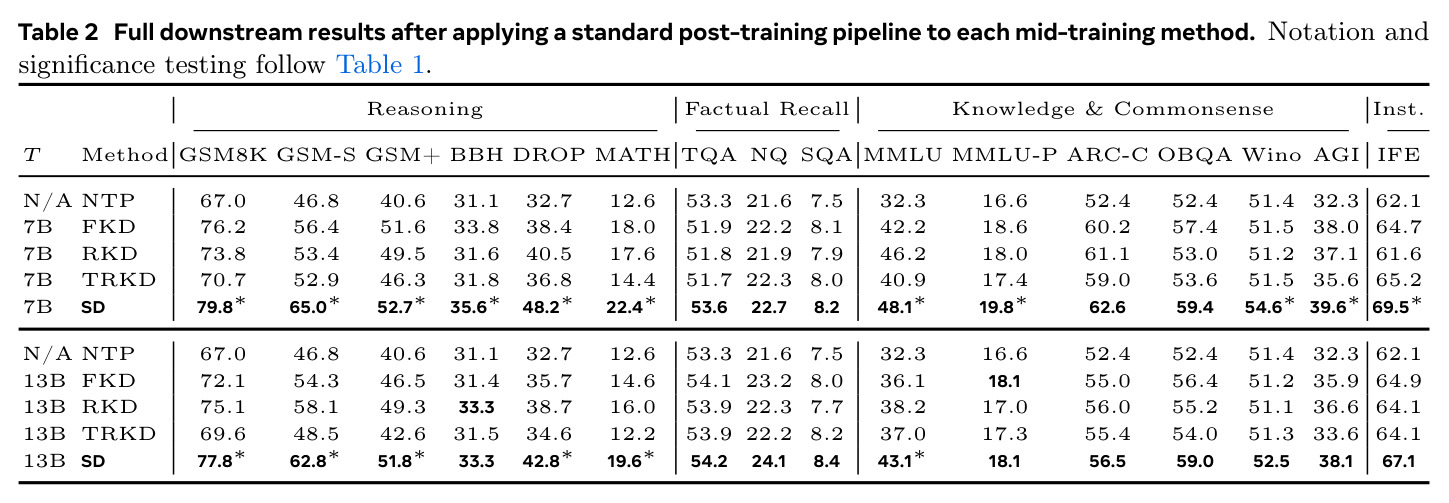
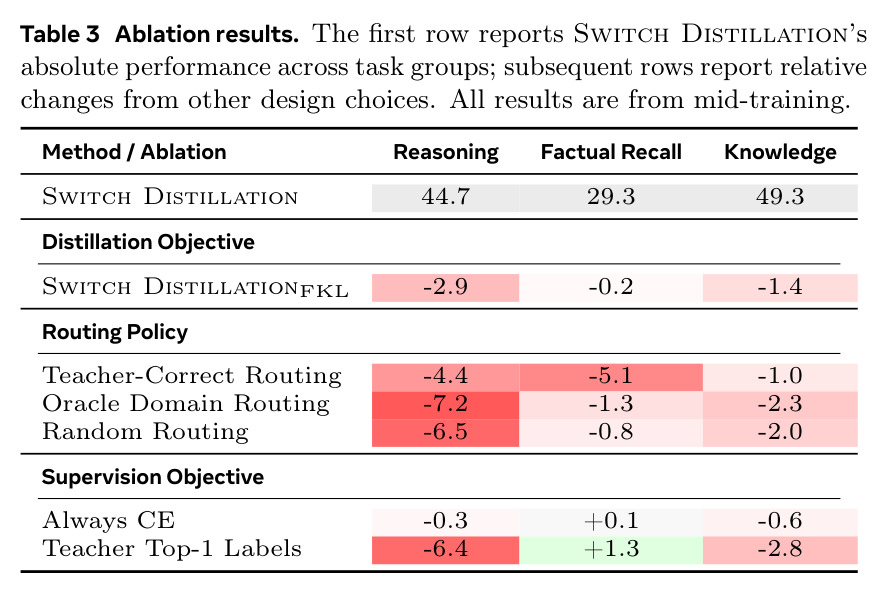
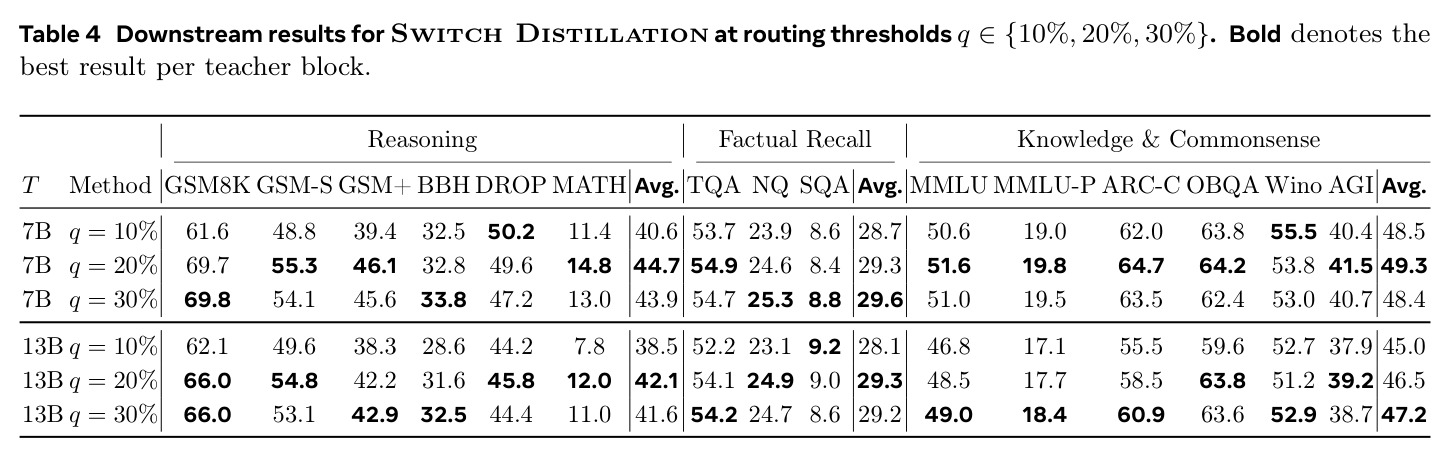
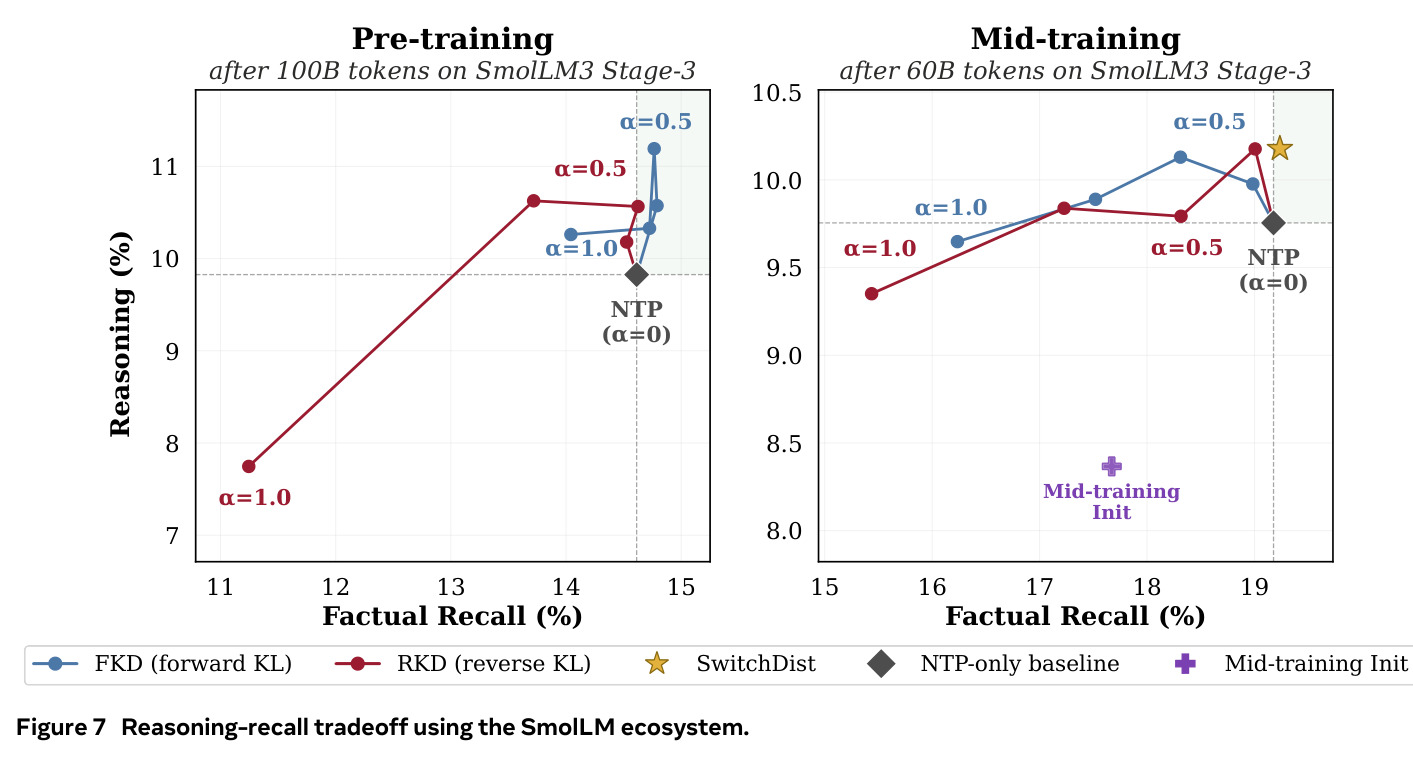
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 中期训练·推理宏平均(GSM8K/GSM-S/GSM+/BBH/DROP/MATH) | 宏平均准确率 % | 44.7(Switch Distillation,7B 教师) | 26.1(NTP);最强 KD 基线 RKD 约 38.8 | 对 NTP 1.71 倍(+18.6pt),超最强 KD 基线约 5.9pt |
| 中期训练·事实召回宏平均(TriviaQA/NQ/SimpleQA) | 宏平均准确率 % | 29.3(保留 NTP 的 96.8%) | 30.3(NTP);FKD 28.9、RKD 28.5 | -1.0pt,是唯一把事实损失控制在 1pt 内的 KD 方法 |
| 中期训练·知识与常识宏平均(MMLU/MMLU-Pro/ARC-C/OBQA/WinoGrande/AGIEval) | 宏平均准确率 % | 49.3(7B 教师) | 41.3(NTP);最强 KD 基线 RKD 约 47.7 | +8.0pt(1.19 倍) |
| 后训练后·推理宏平均 | 宏平均准确率 % | 50.6(7B 教师)/ 48.0(13B 教师) | 38.5(NTP) | 1.25–1.32 倍 |
| 后训练后·事实召回宏平均 | 宏平均准确率 % | 28.2(7B)/ 28.9(13B) | 27.5(NTP) | 中期训练时的 -1.0pt 缺口完全闭合并反超 |
| 单项·MATH(中期训练,7B 教师) | 准确率 % | 14.8 | 3.8(NTP) | 约 3.9 倍 |
局限与改进
作者承认的局限:受控实验主要限于 OLMo-2 训练配方,因为研究阶段依赖行为需要开放的中间 checkpoint、中期训练数据与完整配方,极少模型族同时满足,SmolLM2 与跨族教师分析只提供补充证据;学生仅 1B 规模,虽然训练量超过 Chinchilla 最优,但更大规模未验证;Instruct 教师、FP8 量化、$\tau=2$ 等竞争性默认选择未穷尽消融。我自己的观察:其一,路由阈值 $q$ 是全局固定百分位,未随训练进程或数据域自适应,中期训练早期高熵事实占比与晚期不同,固定 q 可能次优;其二,熵是教师自身的不确定性而非学生-教师分歧,教师低熵但错误(自信幻觉)的 token 会被 RKL 的 mode-seeking 特性强化,论文未讨论教师错误注入风险;其三,“7B 教师优于 13B 教师”的容量差问题只是被观察到而未被解决;其四,事实召回在标准后训练后普遍回升(NTP 从 30.3% 掉到 27.5% 后 SD 反超),该恢复机制与 SD 的交互未被解释;其五,推理任务组以数学类生成任务为主,对代码、多语言、长尾事实的覆盖有限。
独立分析的弱点
弱点一:固定全局 q 的路由策略较粗糙。batch 间域组成不同(数学文档与网页混合),20% 百分位在不同 batch 对应完全不同的绝对熵水平,同一 token 的命运取决于它与谁同 batch。改进方向:改用绝对熵阈值、按域条件化分位数,或引入可学习路由器(作者也承认 MoE 式 router 是自然延伸)。弱点二:教师熵低不等于教师正确。RKL 会强化教师的众数预测,若教师在某事实上自信但错误(低熵幻觉),蒸馏会放大该错误且无纠错机制。改进:用 ground-truth 一致性信号或多个教师的分歧做二次过滤,只在高一致且低熵时蒸馏。弱点三:方法不感知学生状态。机理解释里学生知识状态是关键一环,但方法本身只用教师熵;若加入学生置信度做双向路由(师生都确定时用 CE 即可、都不确定时降低权重),可能更省算力也更稳。弱点四:事实召回仍小幅落后 NTP(-1.0pt),对知识密集应用(封闭式问答、检索增强场景的底座)可能仍需搭配知识保持正则或事实定向数据。弱点五:结论主要建立在 1B 学生、60B token 的中期训练上,向 7B+ 学生与更长中期训练的外推缺乏证据,且推理评测偏数学,代码/多语言场景未测。
未来方向
作者提出的方向:更丰富、更具表达力的路由策略,例如学习型 router 网络(类似 MoE 门控);与优化数据池本身的方法(数据选择、增强、配比优化)正交结合;刻画标准 KD 何时停止帕累托改进并开始产生权衡——作者猜测晚期预训练与持续预训练等“学生知识已大幅演化”的阶段同样适用 Switch Distillation。基于本文成果可延伸的方向:把熵路由引入 on-policy 蒸馏与 RLVR 前的中期训练,研究其对后训练探索行为的影响;将路由信号从教师熵扩展为学生-教师联合量(如 $\mathrm{KL}(p_S\|p_T)$ 或两者置信度差)做自适应分配;在理论层面,附录 D.4 的 CE-KL 梯度余弦几何分析可推广为权衡现象的一般理论,解释何时该 mode-covering、何时该 mode-seeking;探索多教师场景下按熵选教师;在更大规模与代码、多语言数据上验证边界。
复现评估
复现条件相当好。开源情况:代码公开在 facebookresearch/midtraining-distillation,全部基于开源栈——训练用 Meta 的 lingua 框架,后训练用 AI2 的 open-instruct,模型 checkpoint(OLMo-2 1B 学生与 1B/7B/13B Instruct 教师、SmolLM2/SmolLM3)与数据(Dolmino Mix 1124)全部公开,评测用标准化 OLMES harness;论文附完整超参(表 5、6)、评测任务配置(表 7)与约 11 行伪代码(Algorithm 1)。算力:预训练+中期训练+多数后训练在 32 张 H200(4 节点)上运行,DPO 单节点;7B/13B 教师用 FP8 量化、1B 用 BF16,蒸馏温度 $\tau=2$。难度评估分两档:单独复现 Switch Distillation 本身非常容易——它只是标准在线 KD 加上熵与分位数计算,近零额外成本,接入任何已有中期训练管线即可;但完整复现论文全部受控实验(预训练 100B + 中期训练 60B + 四阶段后训练 × 多配置多教师)估计需要数千 H200-GPU 时,属大规模实验。只想验证方法有效性的话,从公开的 4T-token stage1 checkpoint 起跑中期训练即可,成本可控。
论文图表
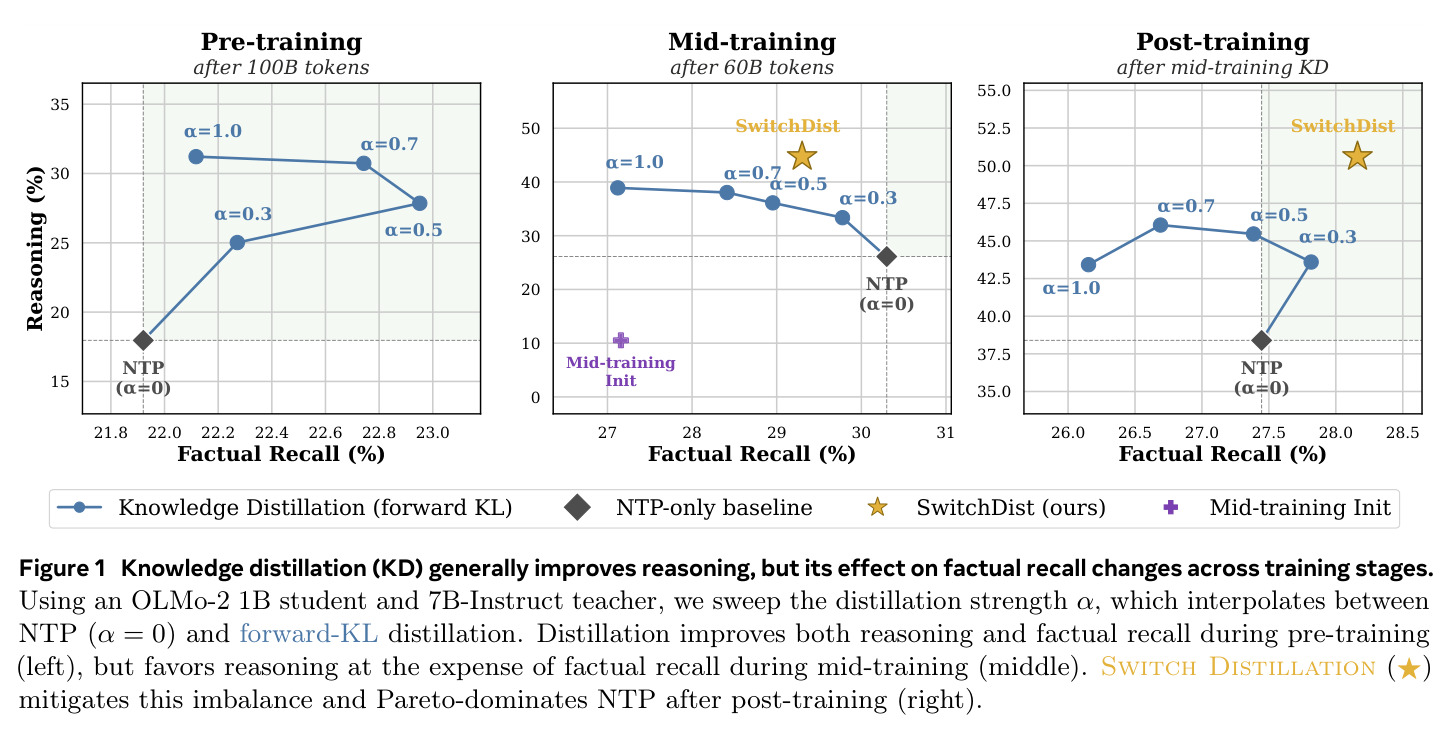
三面板散点图,横轴为事实召回、纵轴为推理。左:预训练 100B token 后,不同 α 的前向 KL 蒸馏点分布在 NTP 右上方(双指标同升);中:中期训练 60B token 后,KD 点推理更高但事实召回全部落在 NTP 左侧;右:后训练后,Switch Distillation(星标)帕累托占优 NTP。
一张图概括论文三大结论:预训练 KD 双赢、中期训练出现权衡、SD 修复权衡,是全文的路线图。
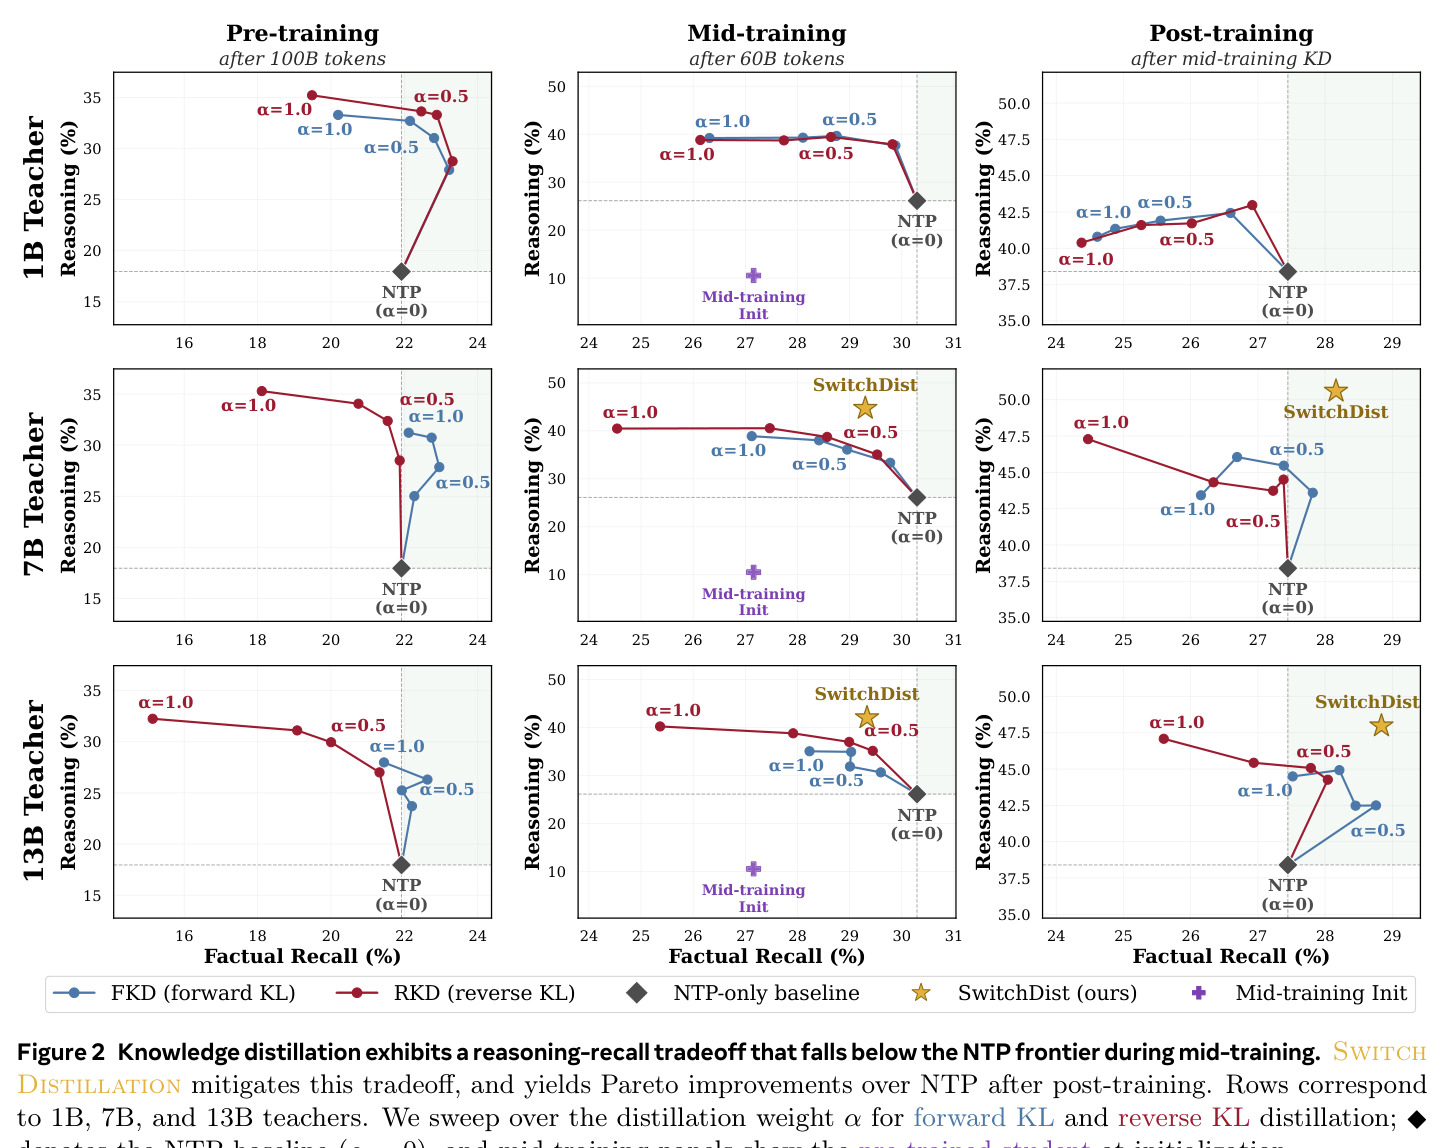
3×3 网格:行为 1B/7B/13B Instruct 教师,列为预训练/中期训练/后训练。每格画出 FKD 与 RKD 在 α∈{0.3,0.5,0.7,1.0} 下的推理-事实召回散点及 NTP 基线,并标出中期训练初始化位置,展示权衡在所有教师规模与 KL 方向下的鲁棒性。
证明核心现象不是特定教师或散度选择的偶然产物,是结论稳健性的关键证据。
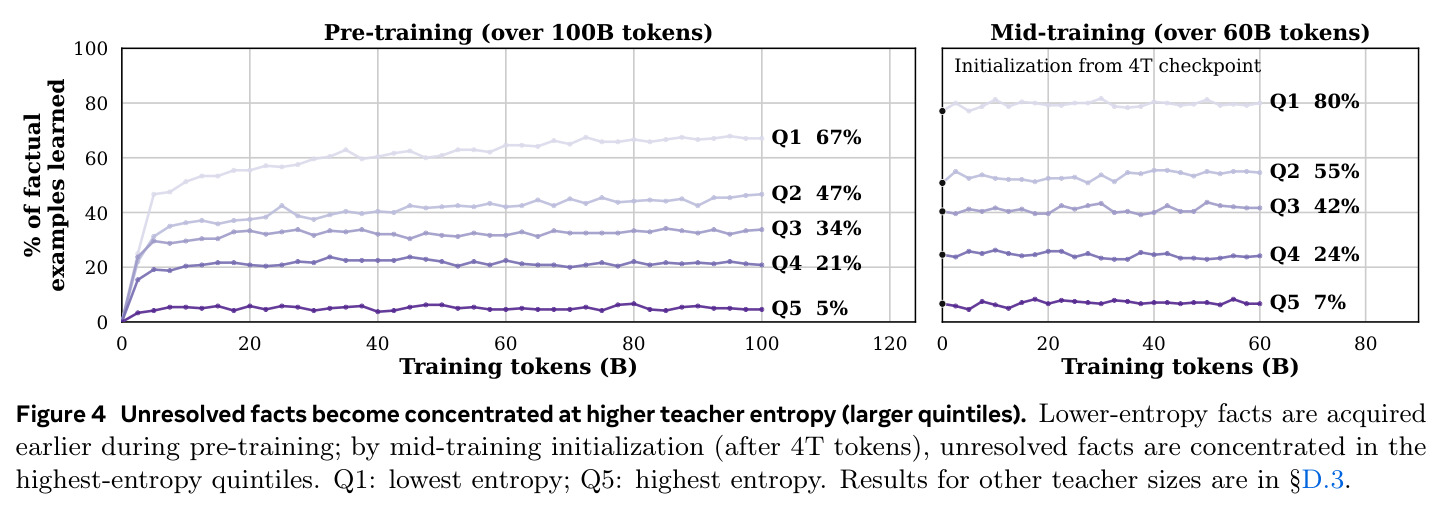
左右两个时间线图:预训练 100B 与中期训练 60B 过程中,各熵五分位事实样本的习得百分比曲线。预训练结束时 Q1 事实 67% 已学、Q5 仅 5%;到中期训练初始化(4T token 后),未学事实集中在高熵分位(7B 教师:Q1 80%、Q2 55%、Q3 34%、Q4 21%)。
把“学生知识状态”这一要素量化,解释为什么中期训练时 KD 的弱监督恰好落在最需要监督的事实上。