模仿学习能保持灵巧操作的时序鲁棒性吗:跨任务执行速度的专家-学习者对比 Does Imitation Learning Preserve Temporal Robustness in Dexterous Manipulation? An Expert-Learner Comparison Across Task Execution Speeds
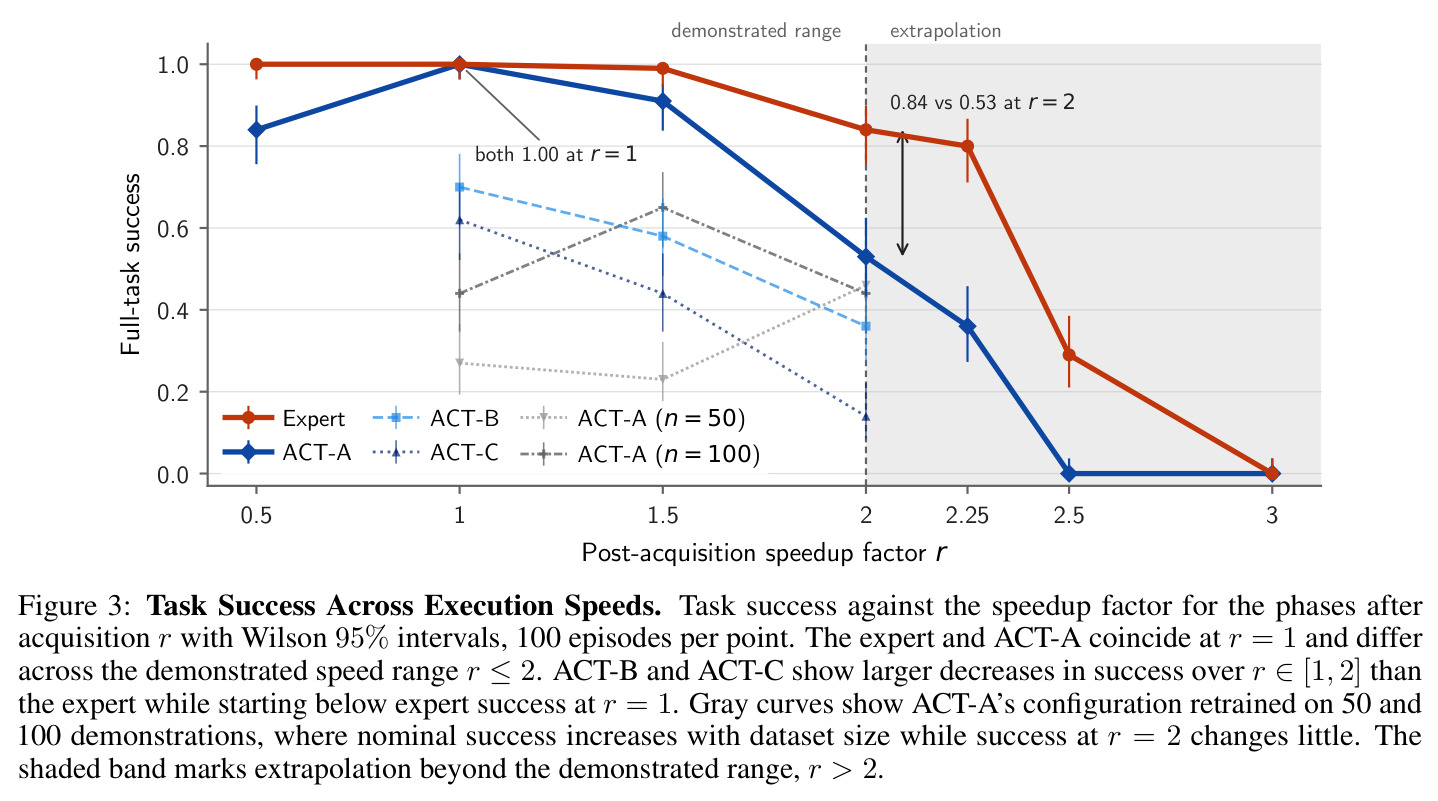
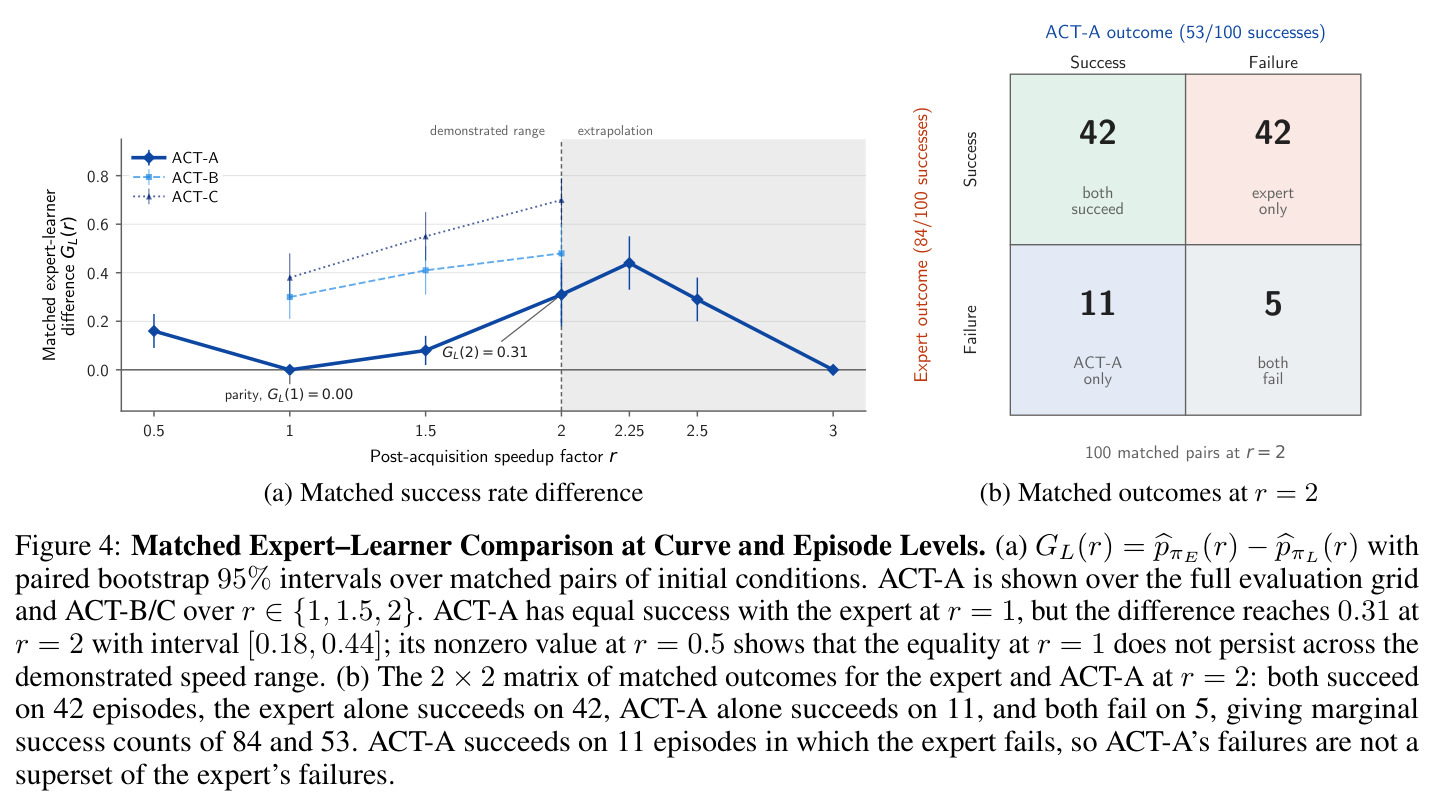
名义速度下同样100%成功的专家与ACT策略,在最大演示速度下成功率差距扩大到31个百分点
前置知识
模仿学习与行为克隆
模仿学习让策略直接从专家演示轨迹 $(o_t, u_t)$ 中学习映射 $u_t = \pi(o_t)$,绕开奖励函数设计;行为克隆把它化为监督回归,最小化 $\mathcal{L} = \mathbb{E}\|u_t - \pi_\theta(o_t)\|^2$。其固有难题是协变量偏移:训练只覆盖专家访问过的状态分布,学习者一旦偏离分布就缺乏纠错信号,DAgger 由此提出在学习者诱导的状态上继续聚合专家标注。
本文问的正是模仿策略在多大程度上保住了专家的某项性质(时序鲁棒性),理解训练分布与评估分布不匹配是理解所有结论的前提。
ACT(Action Chunking with Transformers)
ACT 用条件变分自编码器结构的 transformer 一次预测长为 $k$ 的动作块(本文 $k=100$,即 2 秒 @50Hz),推理时对重叠预测做时间集成再加权执行。动作块降低误差累积、使动作平滑,但把策略锁进多步承诺,指令更新频率远低于控制频率。
论文的头号学习者就是 ACT:ACT-A 与专家在名义速度同为 100% 成功,却在 $r=2$ 时掉到 53%,且作者承认没有消融 chunk 长度与时间集成,无法确定时间扩展预测是否为差距来源。
力封闭与 Ferrari–Canny 边际
力封闭指一组指尖接触在摩擦锥假设下能抵抗任意方向的外部 wrench;Ferrari–Canny 边际 $\varepsilon$ 用接触集可抵抗的 wrench 空间最小半径来量化抓取质量,$\varepsilon > 0$ 即有力封闭。本文用它给仿真中真实发生的接触打分,且只使用符号($\varepsilon \le 0$)做零拟合参数的检验。
除速度对比外的第二主结论由它支撑:全部 414 次无力封闭的获取都以任务失败告终,95% Wilson 上界仅 0.009。
相对运动交接实验
本文提出的诊断协议:让每个策略独立完成抓取,然后在交接瞬间锚定其手部位姿 $T^{W}_{H,\pi}(0)$,改用一个共享控制器按专家的相对手部运动 $\Delta T^{E}_{H}(s) = (T^{E}_{W,H}(0))^{-1} T^{E}_{W,H}(s)$ 驱动后续动作,即指令 $T^{d}_{W,H,\pi}(s) = T^{W}_{H,\pi}(0)\,\Delta T^{E}_{H}(s)$。
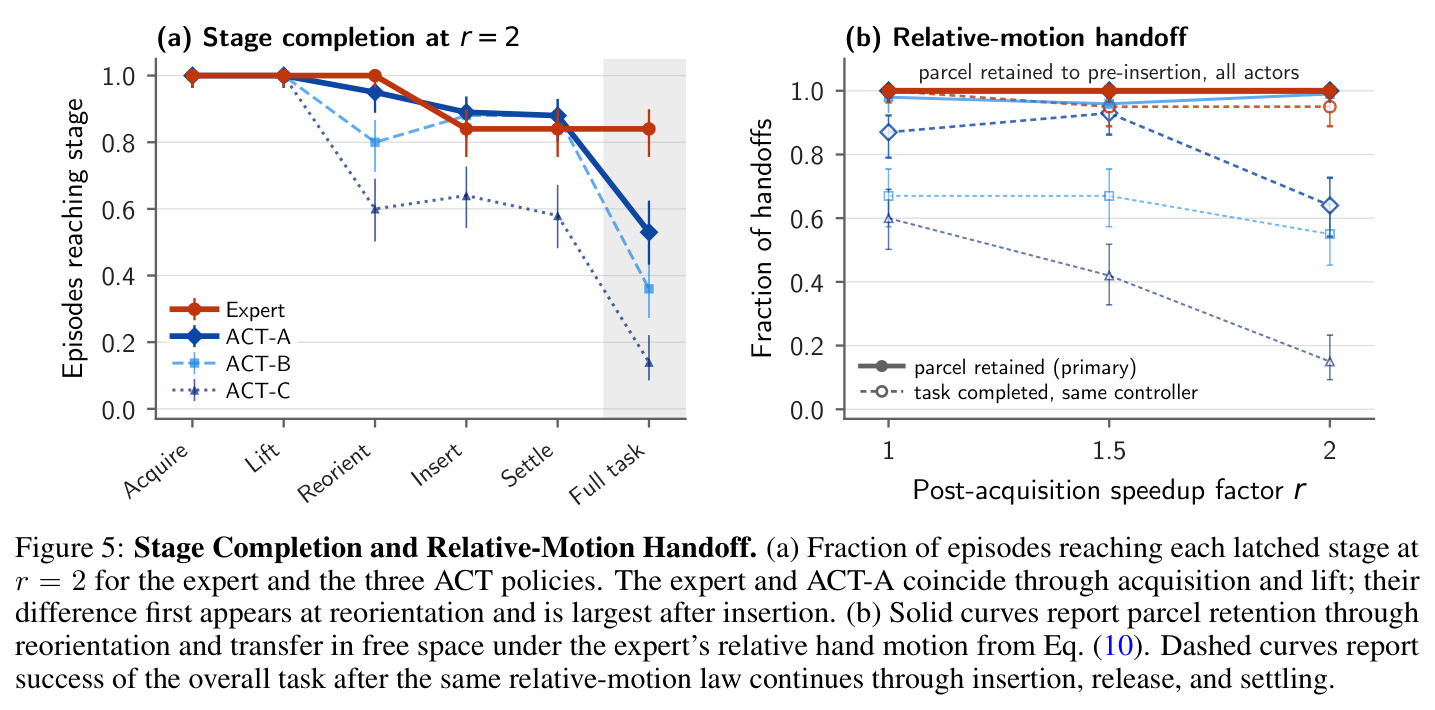
它把「抓得稳不稳」与「下游控制好不好」解耦:ACT-A 的 300 次抓取在共同运动下全部保住包裹,证明其失败不在自由空间保持,而在插入阶段。
执行速度因子与配对评估协议
加速因子 $r$ 只缩短操作阶段时长,$T_k(r) = T_k/r$($k \in \mathcal{M}$),任务几何、物理参数与成功判据全部不变;每个 $r$ 下所有策略共用同一组有序初始条件抽样 $\omega_1,\dots,\omega_N$,配对计算差值 $G_L(r) = \hat{p}_{\pi_E}(r) - \hat{p}_{\pi_L}(r)$,并用 20000 次配对 bootstrap 与 Wilson 95% 区间给出不确定性。
整篇论文的因果解释力都来自这个「同速度、同初始条件」的受控设计,没有它就无法区分速度敏感性与初始条件差异。
接触丰富操作与阶段谓词
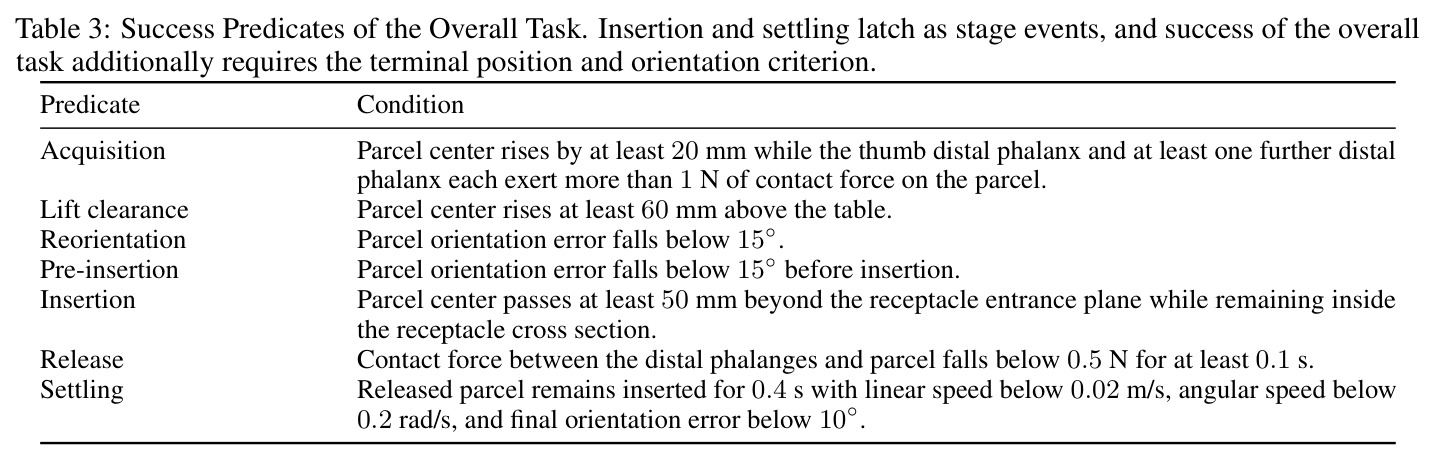
接触丰富操作指任务成败由大量瞬态接触力决定(抓取、插入、滑动),不能靠运动学捷径完成。本文把任务成功定义为一组有序谓词的合取:获取、抬升、重定向、插入、释放、稳定,其中插入与稳定作为阶段事件锁存,状态机据此记录每个 episode 最后完成的阶段与终端失败原因。
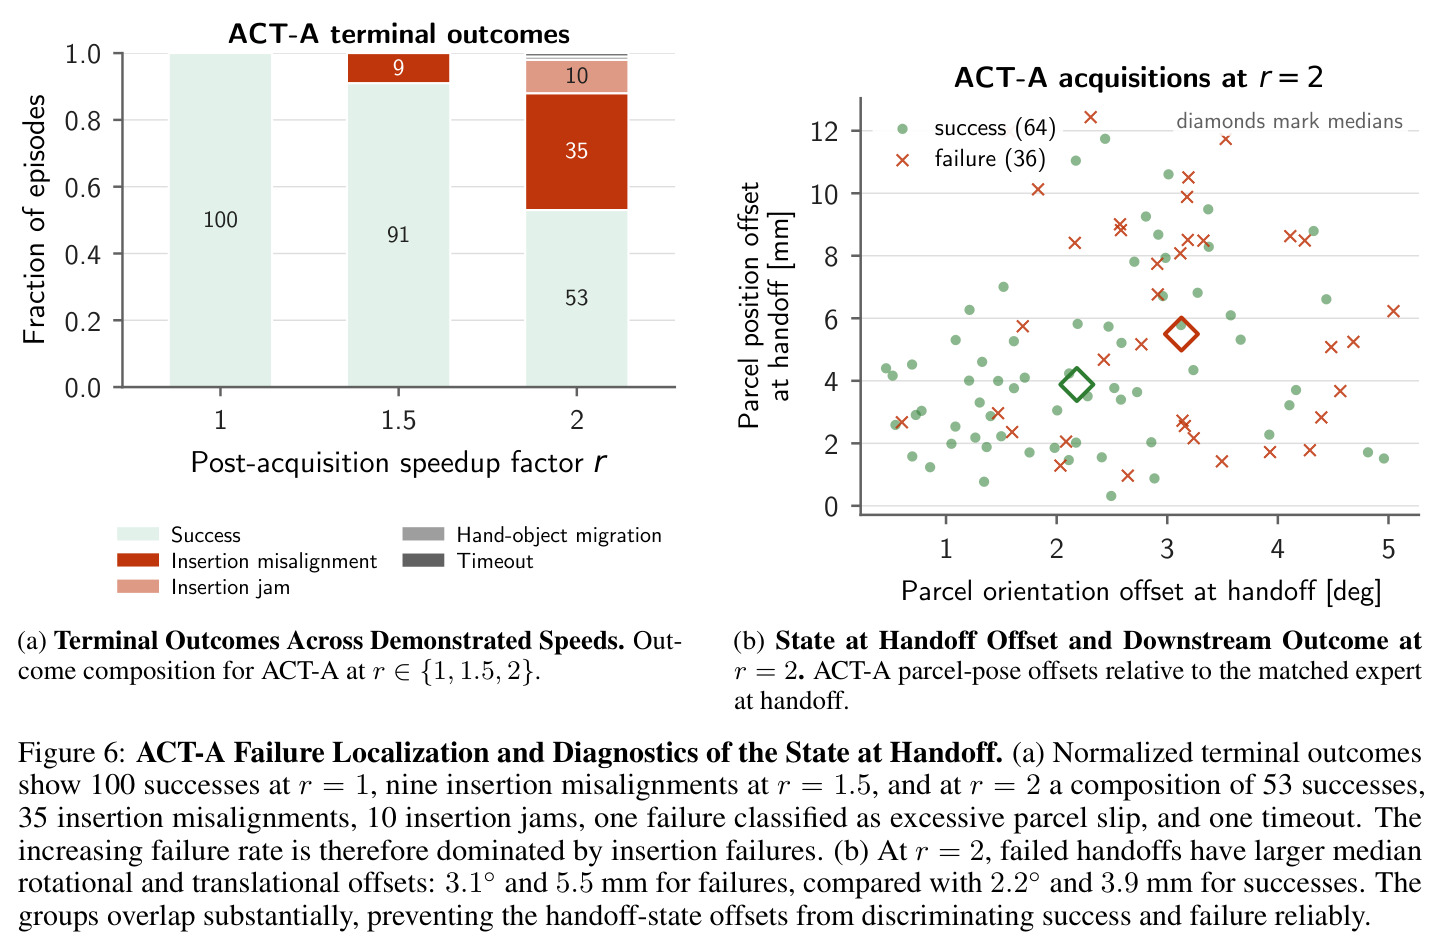
阶段级结果是定位失败环节的核心工具:ACT-A 在 $r=2$ 的 47 次失败中 35 次为插入错位,从而把专家-学习者差距精确定位到插入阶段。
研究动机
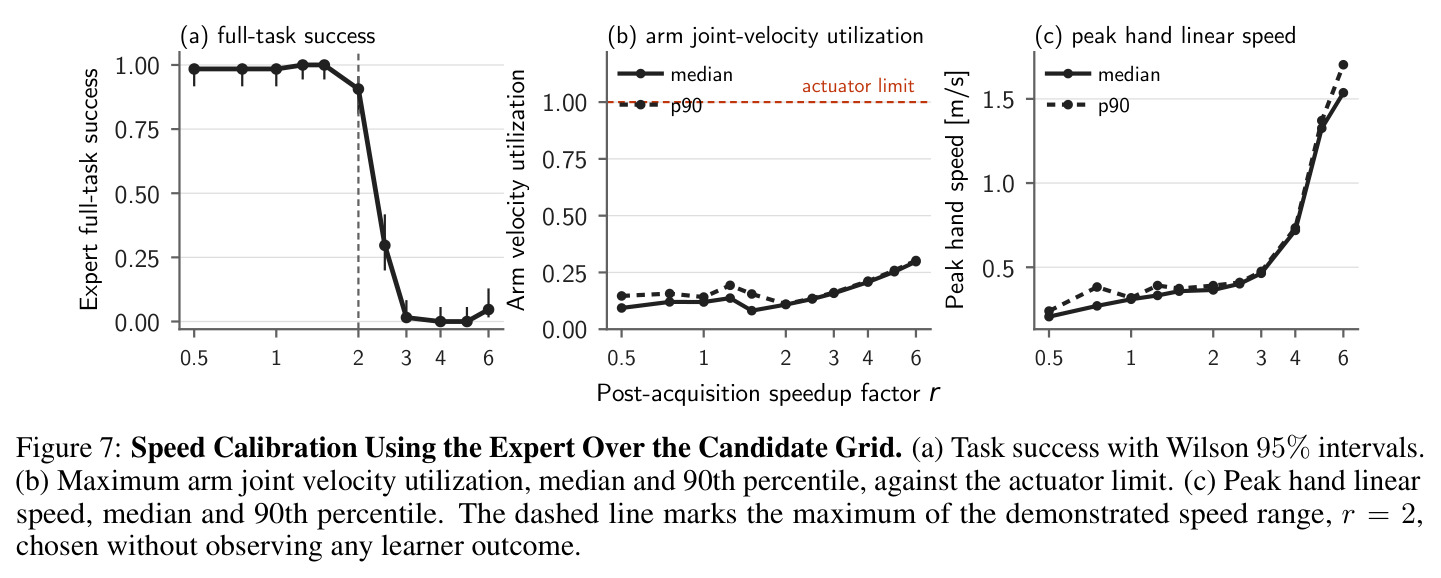
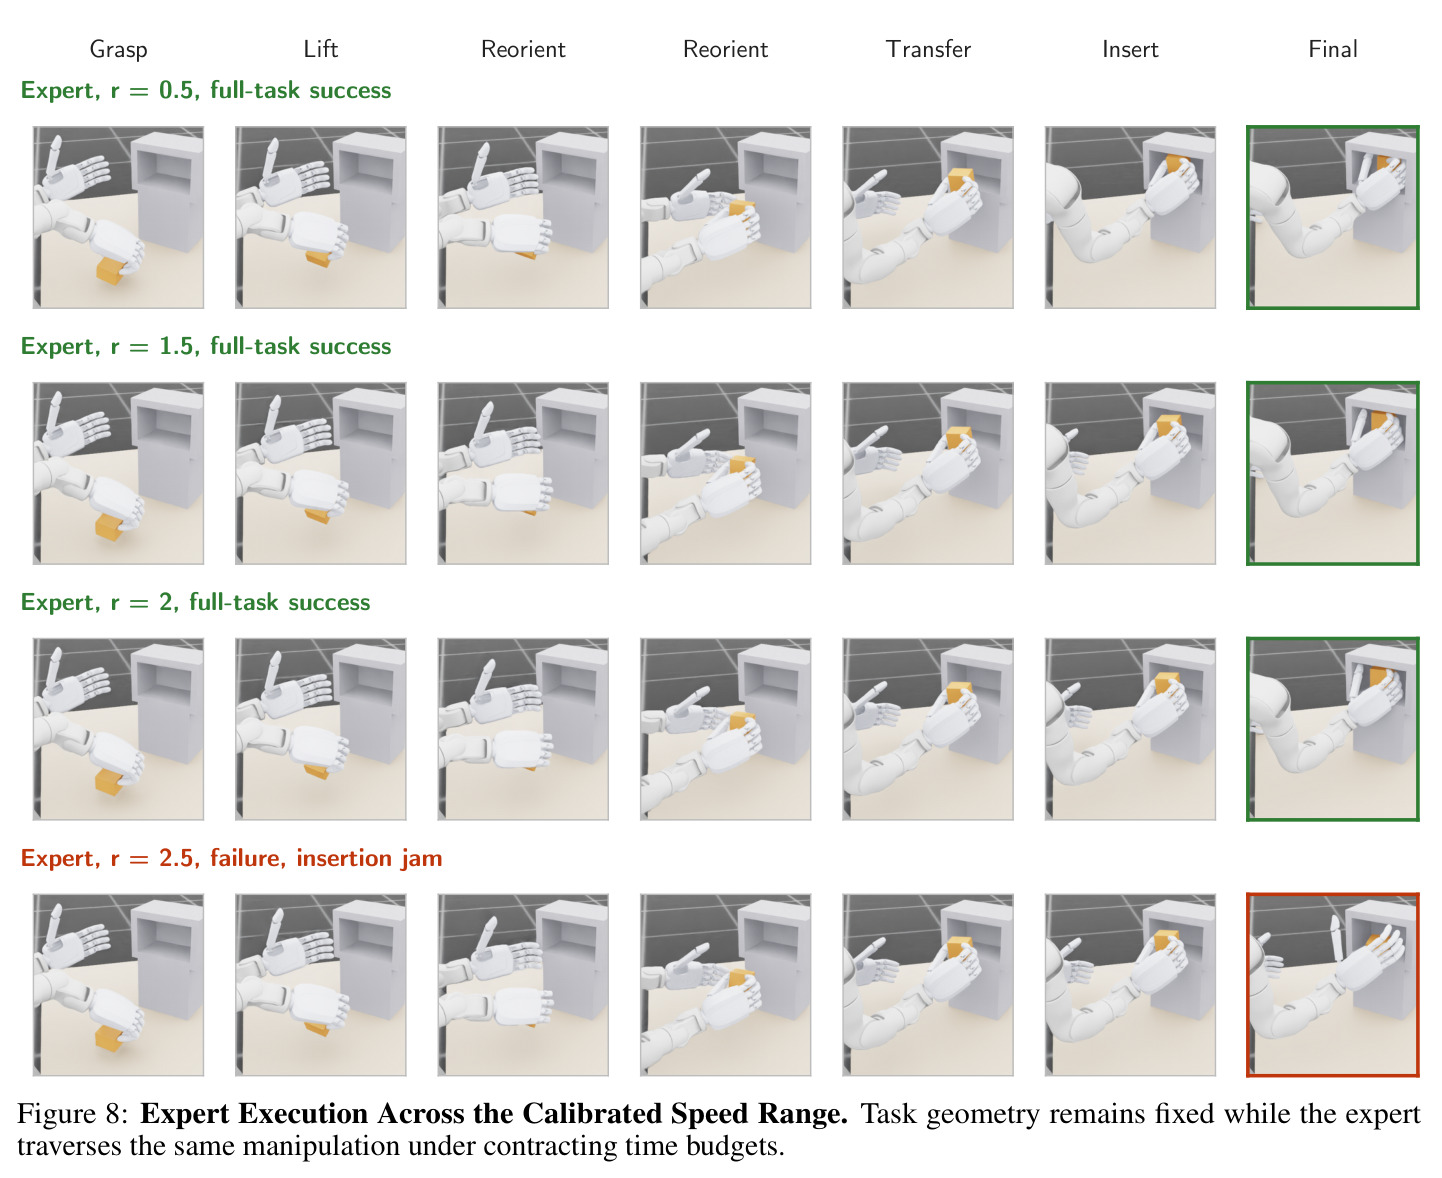
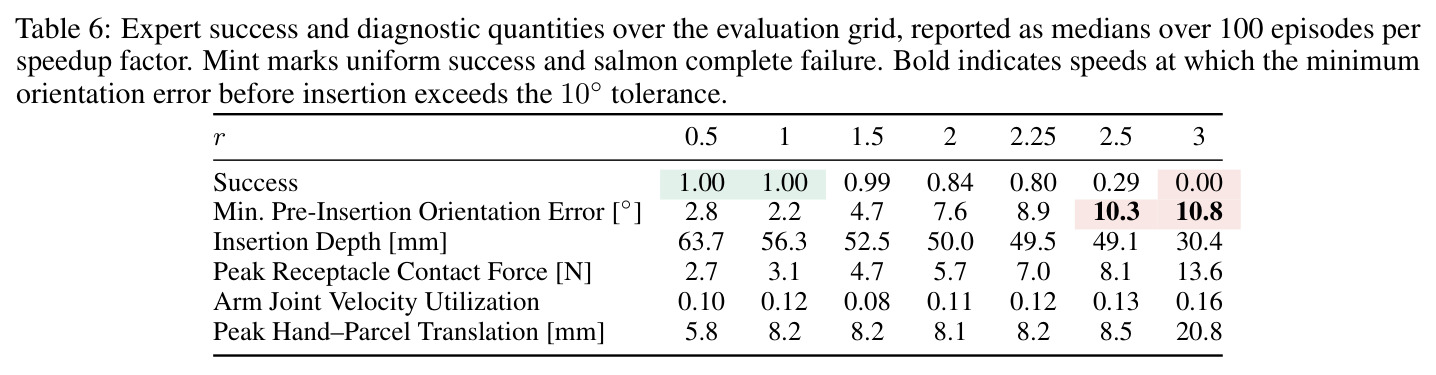
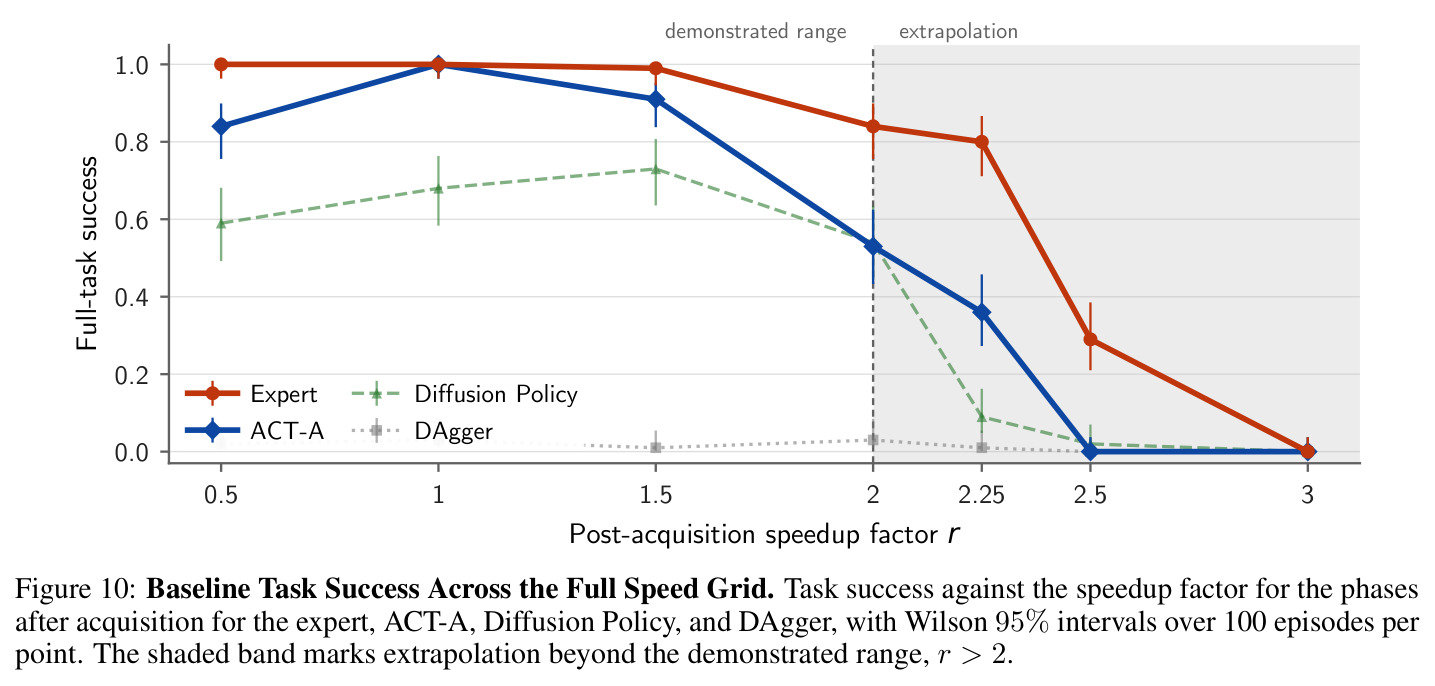
灵巧操作策略几乎只在名义速度下报告成功率,现有机器人学习基准把泛化压力放在任务、场景、物体或指令的变化上(如 PerAct、LIBERO 一类多任务基准,以及 Pumacay 等人的十四种环境扰动研究),执行速度极少作为受控变量出现。但在接触丰富的操作中,缩短执行时间会同时放大关节速度、加速度、跟踪需求与接触瞬态力:论文中专家在名义速度 $r=1$ 下插入前最小朝向误差仅 $2.2^\circ$,到 $r=2.5$ 升至 $10.3^\circ$、越过 $10^\circ$ 容差,成功率从 0.80 跌到 0.29。更麻烦的是,已有的加速方法如 DemoSpeedup(分段降采样演示训练)、SAIL(时间一致推理 + 延迟感知调度)、SpeedAug(强化学习适配)评估的都是「修改后的策略在超出演示范围的速度下」的表现,没有人回答一个更基本的问题:一个名义成功率与专家持平的模仿策略,在专家仍能应付的更慢或更快速度下,是否还和专家一样好?名义上的全对可能完全掩盖二者速度敏感性的差异。
本文的目标是论文要建立一个受控的专家-学习者对比框架:在同一任务、同一动作接口、同一成功判据、同一初始条件分布下,把执行速度因子 $r$ 作为唯一被操纵的变量,测出两条任务成功率曲线 $p_E(r)$ 与 $p_L(r)$,并用逐速度的配对差值 $G_L(r) = \hat{p}_{\pi_E}(r) - \hat{p}_{\pi_L}(r)$ 量化差距。具体目标有四个:(i) 形式化这一比较(问题设定、成功率估计与配对差异);(ii) 构建 ParcelStow 接触丰富操作基准,具备演示速度范围、统一动作接口与明确的评估速度网格;(iii) 实证比较脚本专家与三个不同初始化的 ACT、Diffusion Policy、DAgger 的成功率曲线;(iv) 在不改变总任务成功判据的前提下,用阶段结果、相对运动交接、手-包裹相对运动与力闭合边际等诊断手段定位并刻画策略失败。
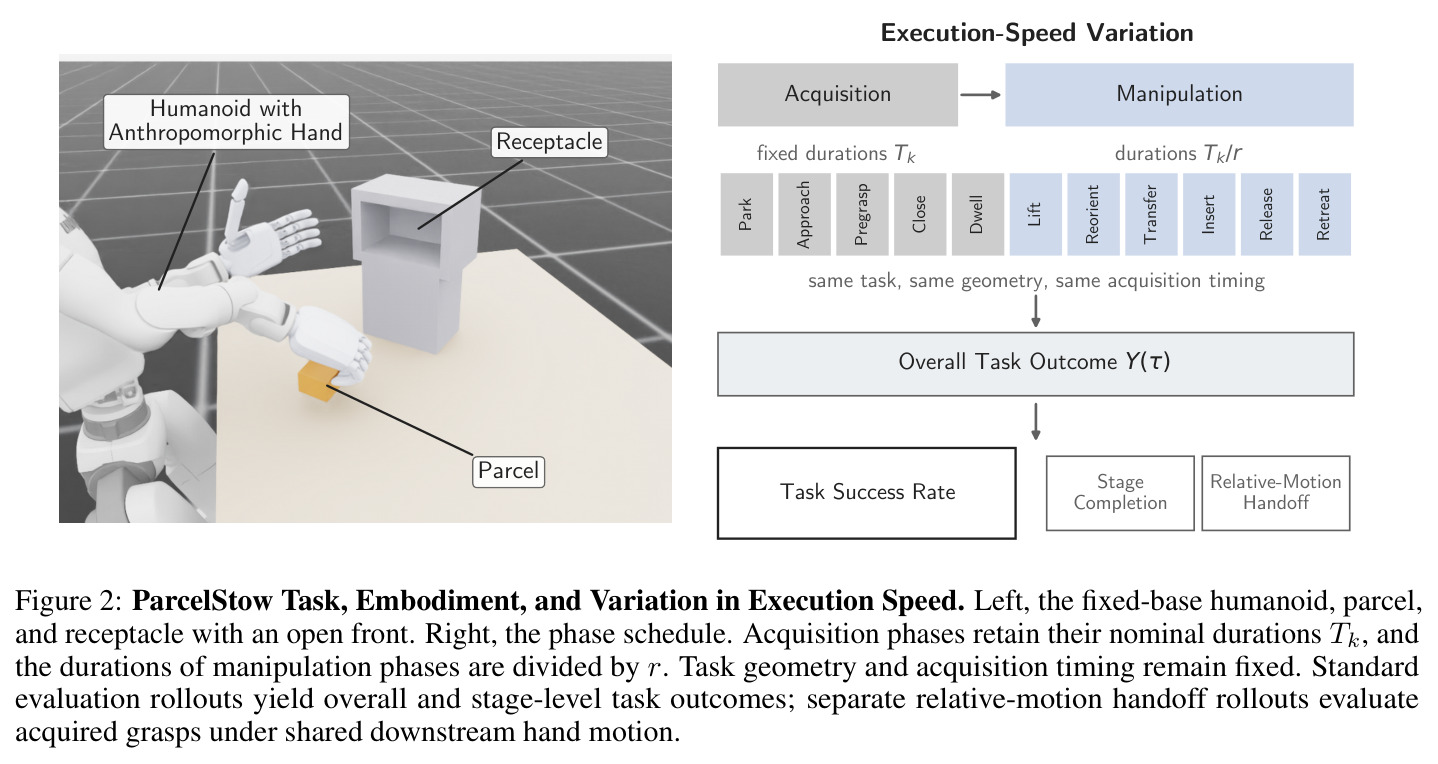
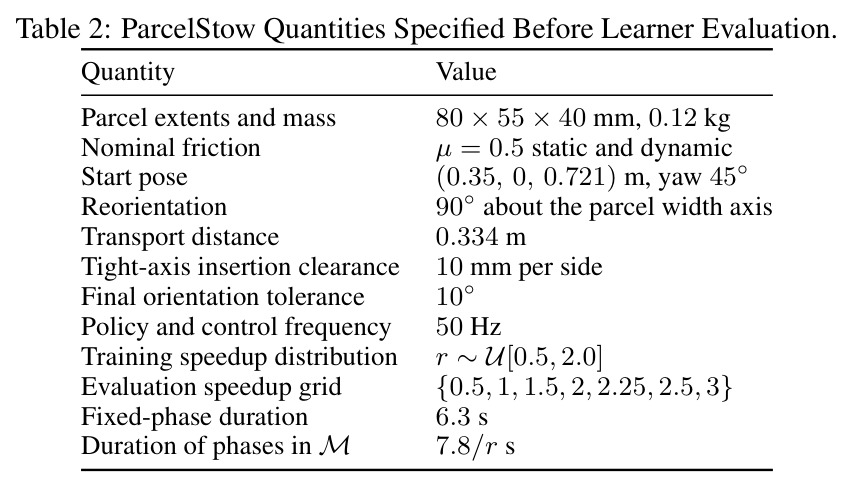
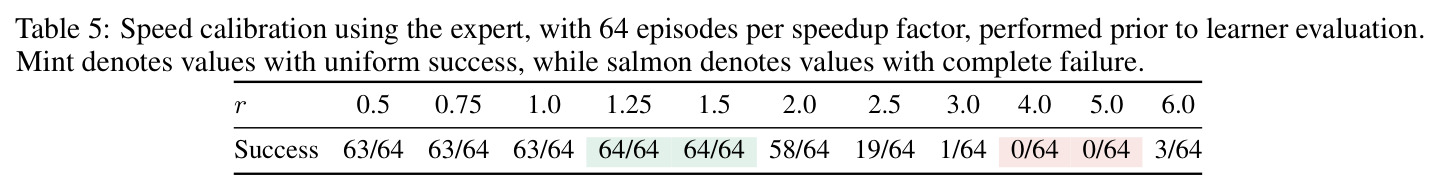
与已有工作不同的是,与以往工作的三点本质不同。其一,比较发生在演示速度分布的支撑内:$R_D = [0.5, 2]$ 由专家单独校准选定($r=2$ 时专家 58/64,$r=2.5$ 时 19/64),与任何学习者结果无关,而不是像 DemoSpeedup 等工作那样追求超速外推。其二,专家与学习者在每个速度使用完全相同的有序初始条件抽样,每个格子 100 个 episode 构成 100 对匹配样本,配对 bootstrap 让 31 个百分点的差距在统计上可检验(95% CI [0.18, 0.44])。其三,场景、几何、物理参数、成功谓词全部冻结,只缩短 $\mathcal{M}$ 中 8 个操作阶段的时长(固定阶段贡献 6.3 s,操作阶段贡献 $7.8/r$ s,周期从 14.1 s 缩到 10.2 s),因此成功率变化可以干净地归因于时间预算本身。这种「只动时间」的实验设计在操作基准里此前是缺失的。
核心方法
论文把任务建模为增广状态 $z_t = (x_t, \phi_t, u_{t-1}, r)$ 上的闭环过程,成功率 $p_\pi(r) = \Pr[Y(\tau(\pi, r, \omega)) = 1]$,$\omega \sim P_\Omega$ 为初始条件。载体任务 ParcelStow:Unitree G1 固定基座人形 + RealHand L6 拟人右手,把 $80 \times 55 \times 40$ mm、0.12 kg、摩擦 $\mu=0.5$ 的包裹抓起、抬离桌面、绕宽度轴转 $90^\circ$、平移 0.334 m 插入单侧间隙 10 mm 的容器;包裹全程为自由刚体,无焊接、无注入力。学习者观测 $\mathcal{O} \subset \mathbb{R}^{147}$(全身关节位置速度、上一动作、包裹位姿、指尖位置与接触力、阶段与 $r$),动作 $u_t \in \mathbb{R}^{16}$(腰 3 + 右臂腕 7 + 右手 6 驱动关节的归一化位置偏移),经 $q_{target} = q_{default} + 0.5\,u_t$ 由隐式 PD 在 50 Hz 执行,仿真 200 Hz。脚本专家读阶段与关节状态、用阻尼最小二乘差分逆运动学生成目标,不使用学习者观测,但共享同一 16 维动作通道与低层驱动。
核心创新是「匹配速度的专家-学习者配对比较」这一评估范式本身:不加速执行、不修改策略,而是先校准专家能胜任的速度范围 $R_D = [0.5, 2]$,再在演示范围内逐点对比两条成功率曲线。支撑对比的三件诊断工具是:(1) 阶段状态机,按有序谓词找出首个失败阶段,并把插入失败细分为错位与卡死(接触力 >2 N 持续 0.2 s 等);(2) 相对运动交接——保留每个策略自己抓出来的手形与位姿 $T^{W}_{H,\pi}(0)$,只把下游手部轨迹替换为专家的相对运动 $\Delta T^{E}_{H}(s)$,从而在共同下游运动下检验抓取的保持能力;(3) 零拟合参数的力闭合符号检验:用 Ferrari–Canny 边际 $\varepsilon$ 的符号 $\varepsilon \le 0$ 作为下游成功的候选必要条件,阈值物理定义为零,避免拟合阈值带来的过拟合。与已有工作的本质区别在于:别人改变任务或环境来测泛化,本文冻结一切只改时间,并把学习者直接与它的演示专家放在同一速度上对表。
方法步骤详情
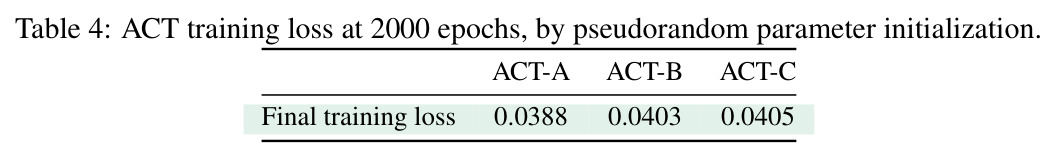
第一步,专家速度校准:每个候选 $r$ 跑 64 个 episode(1 cm 平面抖动),$r \le 2$ 保持 58/64 以上,$r=2.5$ 跌至 19/64、$r=3$ 仅 1/64,据此在看到任何学习者之前选定 $R_D = [0.5, 2]$ 与评估网格 $\{0.5, 1, 1.5, 2, 2.25, 2.5, 3\}$。第二步,采集 300 条专家演示,$r \sim \mathcal{U}[0.5, 2]$,包裹平面偏移 $\pm 10$ mm、关节偏移 $\pm 0.05$ rad,297 条成功者构成训练集。第三步,训练三个仅伪随机初始化不同的 ACT(chunk 长 100、4 编码 + 7 解码层、512 维、AdamW 学习率 $10^{-5}$、2000 epochs),另训 DAgger 与 Diffusion Policy。第四步,评估:每个「策略-速度」格子 100 episodes,共享评估种子得到 100 对匹配初始条件,报告 Wilson 95% CI,对差值做 20000 次配对 bootstrap。第五步,诊断:阶段完成度与终端失败原因、臂关节速度利用率 $U_{arm}$、峰值手-包裹相对平移与旋转、相对运动交接实验、以及获取/重定向/插入三时刻的 Ferrari–Canny 边际符号检验。
技术新颖性
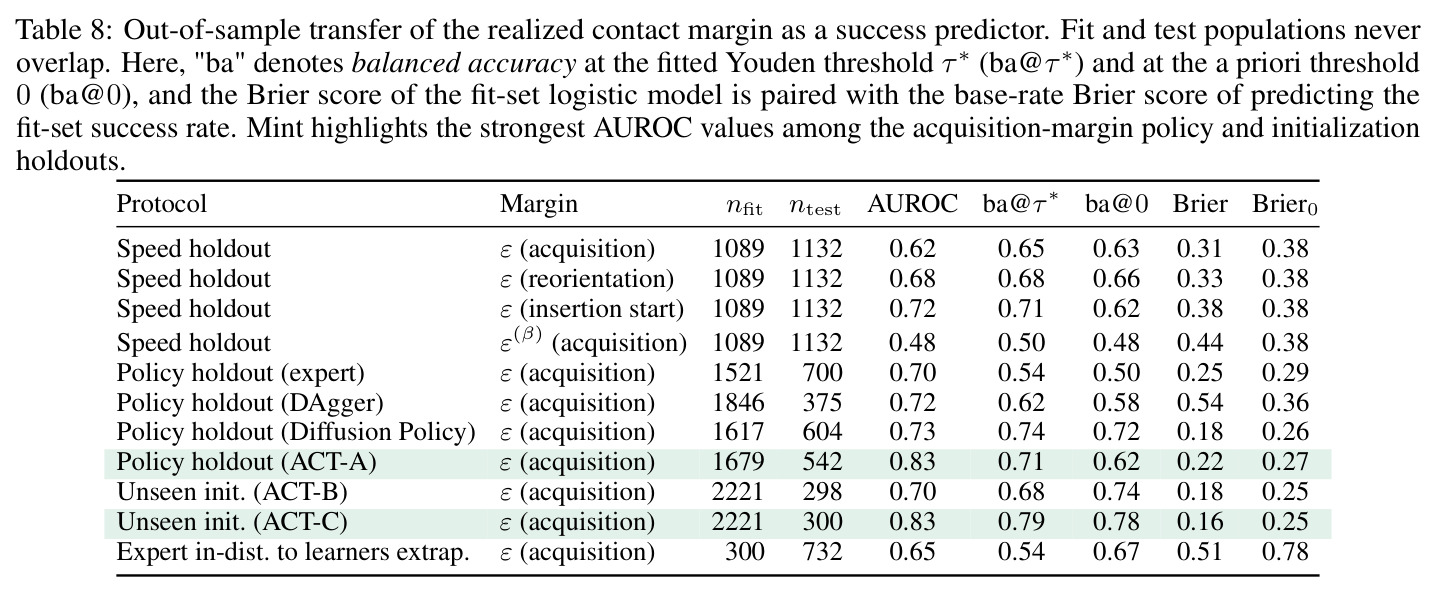
技术新颖性不在新算法而在新测量体系。(1) 把执行速度提为一等受控变量,并给出 $G_L(r)$ 这种逐速度、配对、带置信区间的差距度量,而非汇总成单一分数;它揭示出「$G_L(1)=0$ 不能外推到其他速度」这一被忽视的事实。(2) 相对运动交接用 SE(3) 锚定 $T^{W}_{H,\pi}(0)$,保留策略自己的抓取实现、只替换下游手部运动,这是把抓取质量与控制品质解耦的干净办法,此前加速类工作没有做过的对照。(3) 对力闭合坚持只做符号检验并在附录 I 用多个留出协议(速度留出、策略留出、初始化留出)展示连续边际 AUROC 仅 0.62–0.83、期望校准误差 0.31,明确反对把连续边际当排序器——这是对「抓取度量外推」问题的诚实处理。(4) 插入与稳定谓词锁存为阶段事件,允许「插入谓词已满足但释放后仍失败」这类细粒度归因。这些设计共同服务于一个定量结论:名义成功相等可以掩盖对执行速度的敏感性差异。
实验结果
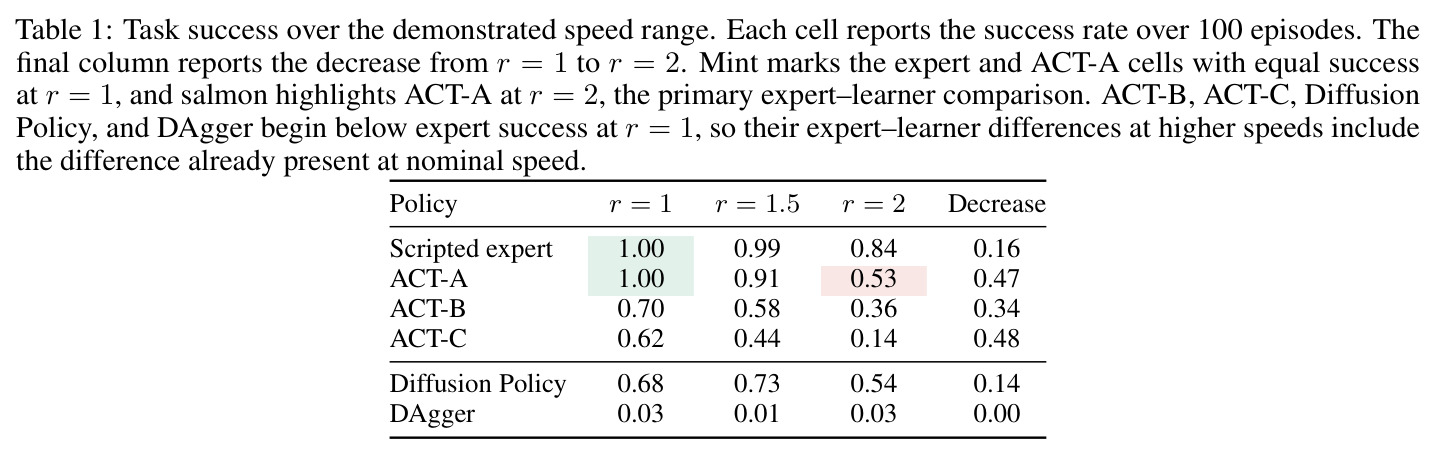
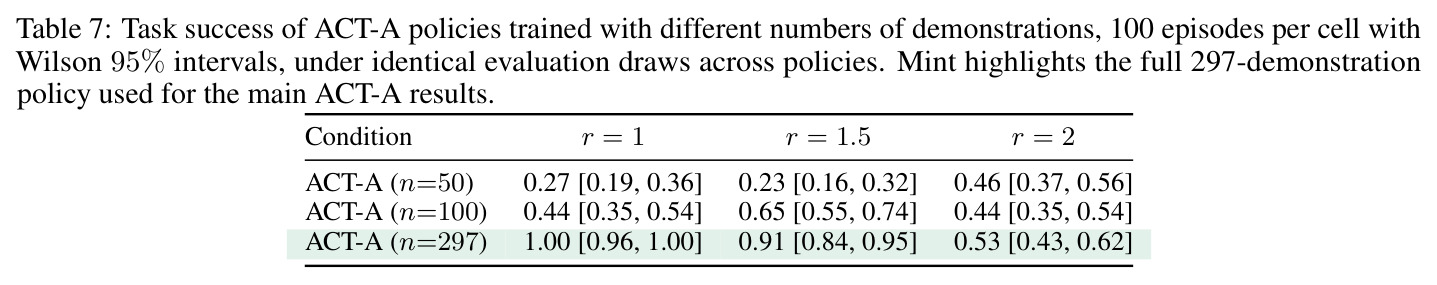
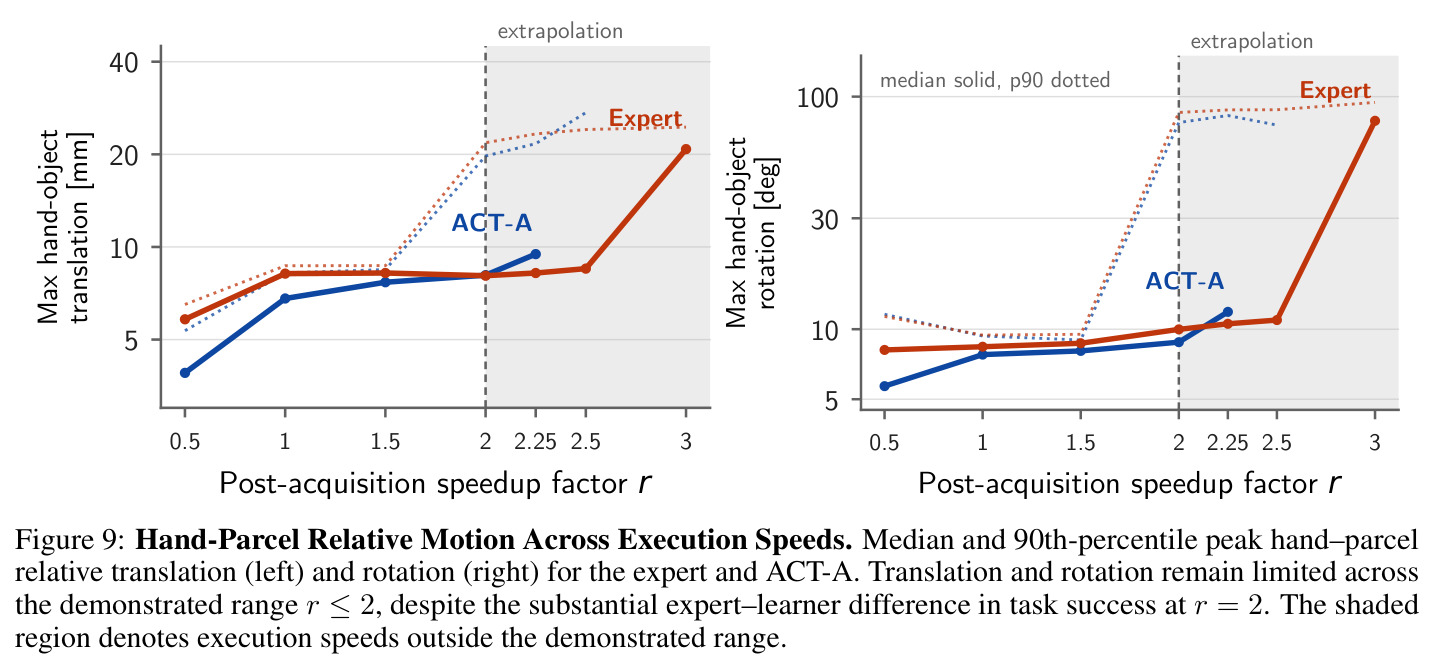
主实验(表 1、图 3):$r=1$ 时专家与 ACT-A 均 100/100;到最大演示速度 $r=2$,专家保持 0.84(Wilson CI [0.76, 0.90]),ACT-A 掉到 0.53([0.43, 0.62]),配对差 $G_L(2) = 0.31$(bootstrap 95% CI [0.18, 0.44]),降幅分别为 16 与 47 个百分点。ACT-B、ACT-C 名义成功率仅 0.70、0.62,降幅却达 0.34、0.48;Diffusion Policy 三点 0.68/0.73/0.54 非单调;DAgger 约 0.03,无法比较速度敏感性。$r=2$ 的 100 对匹配样本中 42 对双成功、42 对仅专家成功、11 对仅 ACT-A 成功、5 对双失败,失败集不嵌套。失败定位:ACT-A 在 $r=2$ 获取与抬升全成功、重定向 95、插入前 94,89 次满足插入谓词但仅 53 次完成全任务;47 次失败 = 35 次插入错位 + 10 次卡死 + 各 1 次滑移与超时,专家 16 次失败全是卡死。交接实验:300 次获取在共同相对运动下全部保持包裹,延续到任务结束则专家/ACT-A/ACT-B/ACT-C 分别 95/64/55/15 次成功。力闭合:414 次 $\varepsilon \le 0$ 的获取零成功(Wilson 上界 0.009),ACT-A/B/C 无力闭合获取占 8%/21%/34%。演示扩展:50/100/297 条演示名义成功率 0.27/0.44/1.00,但 $r=2$ 几乎不动(0.46/0.44/0.53)。专家外推区:插入前最小朝向误差 $2.2^\circ \to 10.3^\circ$ 越过 $10^\circ$ 容差,对应成功率 0.80→0.29,而臂速利用率 < 0.17,排除速度饱和。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ParcelStow 全任务成功率(最大演示速度 $r=2$,100 episodes,匹配初始条件) | 任务成功率(配对差值) | 专家 0.84 vs ACT-A 0.53,配对差 $G_L(2) = 0.31$ [0.18, 0.44] | 两者在名义速度 $r=1$ 均为 1.00(差距为 0) | 揭示名义点重合的成功曲线在演示范围内分叉 31 个百分点 |
| 成功率降幅($r: 1 \to 2$) | 百分点下降 | 专家仅降 0.16 | ACT-A 降 0.47、ACT-C 降 0.48、ACT-B 降 0.34 | ACT 系学习者的速度退化幅度约为专家的 2-3 倍 |
| 失败阶段定位(ACT-A,$r=2$,47 次失败) | 终端失败原因构成 | 35 次插入错位、10 次插入卡死、1 次过度滑移、1 次超时 | 专家 16 次失败全部为插入卡死 | 把差距精确定位到插入阶段,并排除获取与自由空间转移 |
| 无力闭合获取($\varepsilon \le 0$)的全任务成功率 | 成功率(Wilson 上界) | 0/414(上界 0.009);专家 700 次获取全部力封闭 | 有力闭合获取中相当比例可完成任务 | 确立力封闭为必要非充分条件,且符号检验零拟合参数 |
| 演示数量扩展(ACT-A 重训,$n = 50/100/297$) | 名义成功率 vs $r=2$ 成功率 | 名义 0.27/0.44/1.00;$r=2$ 时 0.46/0.44/0.53(区间重叠) | 专家 $r=2$ 为 0.84 | 加数据改善名义表现却不改善高速表现,提示问题不在数据量 |
局限与改进
作者承认的边界:单一任务、单一具身(G1 + L6)、状态观测、固定摩擦 $\mu = 0.5$ 的仿真,泛化到其他架构、任务、观测模态或真机未知;未消融 chunk 长度、时间集成与重规划频率,不能把差距归因于 ACT 的时间扩展预测;交接实验无法分离交接时刻状态误差与后续容器接触(失败组中位偏移 $3.1^\circ$/5.5 mm vs 成功组 $2.2^\circ$/3.9 mm,分布大幅重叠);连续力闭合边际不可靠(留出 AUROC 0.62–0.83,校准误差 0.31)。我的补充观察:其一,专家每 50 Hz 步生成新命令,ACT 一次提交 100 步 chunk,速度越快 chunk 覆盖的几何弧段越大,控制结构本身是混杂变量,「模仿学习不保时序鲁棒性」与「动作分块不保时序鲁棒性」无法区分;其二,$r$ 虽在观测中提供,但均匀训练分布不代表高速样本的学习信号充分;其三,插入错位的物理成因(跟踪滞后、手部驱动饱和、容器接触引导)仍是开放机制,缺乏力矩与接触力时间序列记录。
独立分析的弱点
第一个弱点是控制结构混杂:专家是逐命令 IK 跟踪器,ACT 是 100 步 chunk 加时间集成,比较混入「承诺时长」这一额外变量。改进方向:把专家参考重排成 100 步分段常值或集成版本,或让 ACT 以 chunk=1 运行做受控消融。第二个弱点是固定摩擦使力闭合结论偏乐观:$\varepsilon \le 0$ 的必要性依赖名义摩擦锥 $\mu = 0.5$,真实摩擦不确定时阈值会漂移;改进方向:把摩擦变化纳入 $P_\Omega$ 重测符号检验的稳健性,或在变摩擦下评估风险调整边际 $\varepsilon(\beta)$(固定摩擦下其 AUROC 仅 0.48)。第三个弱点是诊断未触及插入失败的力学:没有腕部六维力/力矩、接触力时间序列或手部关节饱和记录,35 次插入错位无法分解为跟踪滞后、抓取旋转漂移或容器引导失败;改进方向:补充这些记录并做相关性分析。第四个弱点是 DAgger(约 0.03)与 Diffusion Policy(非单调)的训练质量可疑,削弱「多个学习器都退化」的普遍性主张;改进方向:超参搜索后重下结论。
未来方向
作者提出的直接延伸:变化 chunk horizon、时间集成与重规划频率以检验 ACT 时间扩展预测这一未测机制;把评估扩展到其他架构(含相机观测的 VLA 如 $\pi_0$、GR00T N1)、其他任务与真实硬件。基于本文成果还可延伸:(1) 速度敏感性进训练——演示采集或数据增强时显式改写速度分布形状,或加入速度条件化正则,检验 $r=2$ 成功率能否随之提升(表 7 的负结果暗示单纯加数据不够);(2) 把力闭合符号检验升级为运行时安全门:检测到 $\varepsilon \le 0$ 即触发重抓,将事后诊断变为在线策略;(3) 把交接实验扩展为学习器之间的交叉交接矩阵,分离抓取质量、交接状态与下游控制三因素的贡献;(4) 对 $p_\pi(r)$ 与跟踪误差、接触瞬态的关系建模,从动力学角度解释为何插入是对速度最敏感的阶段(专家朝向误差 $2.2^\circ \to 10.3^\circ$ 随 $r$ 增长的现象值得解析刻画)。
复现评估
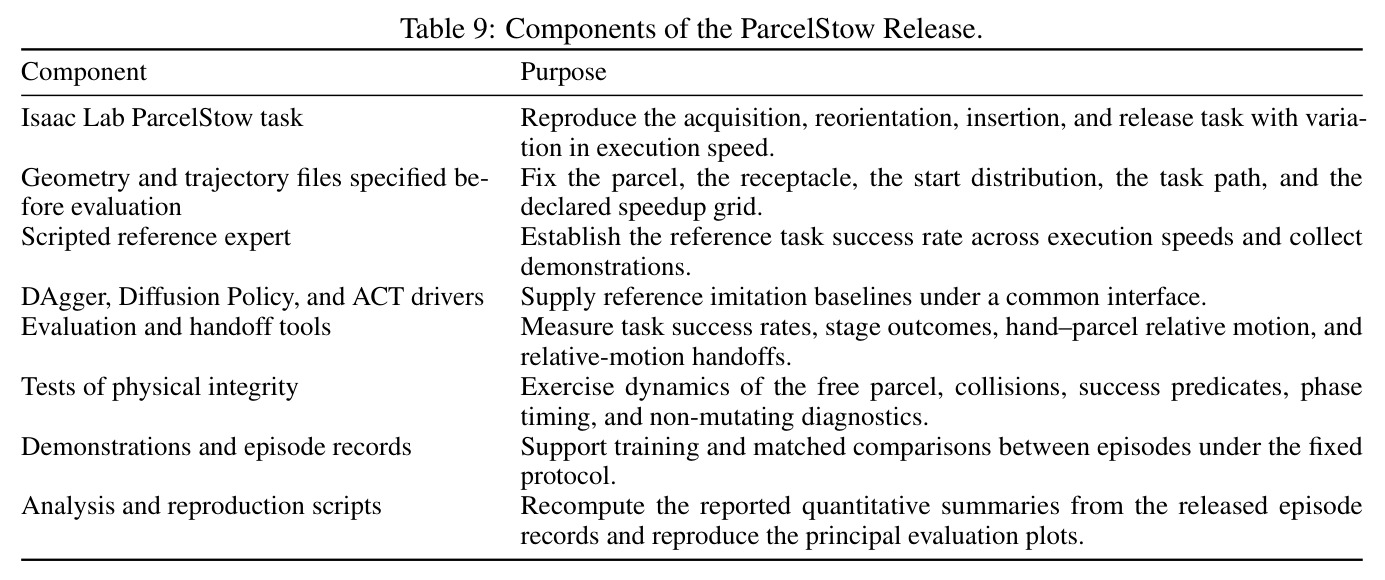
复现条件相当好:ParcelStow v1.0.0 已开源,发布包含 Isaac Lab 任务实现、评估前固定的几何与轨迹文件、脚本参考专家、DAgger/Diffusion Policy/ACT 参考驱动、评估与交接工具、物理完整性测试(验证包裹会掉落、无接触不能拖动、会与容器碰撞、插入谓词在可用体积外无法满足)、演示数据与全部 episode 记录,以及可重算论文全部量化汇总与主图的分析脚本(表 9)。统计协议完全确定:共享评估种子复现 100 对匹配初始条件,Wilson 区间与 20000 次配对 bootstrap 均可精确重放。算力需求主要是 Isaac Lab GPU 仿真(200 Hz 仿真、50 Hz 控制、4 倍 decimation)与三个 2000-epoch 的 ACT 训练,单张消费级 GPU 可承担大部分流程;难度集中在熟悉 Isaac Lab 与 G1 + L6 的关节配置。总体复现难度:中等,工程量在环境搭建与训练时长。
论文图表
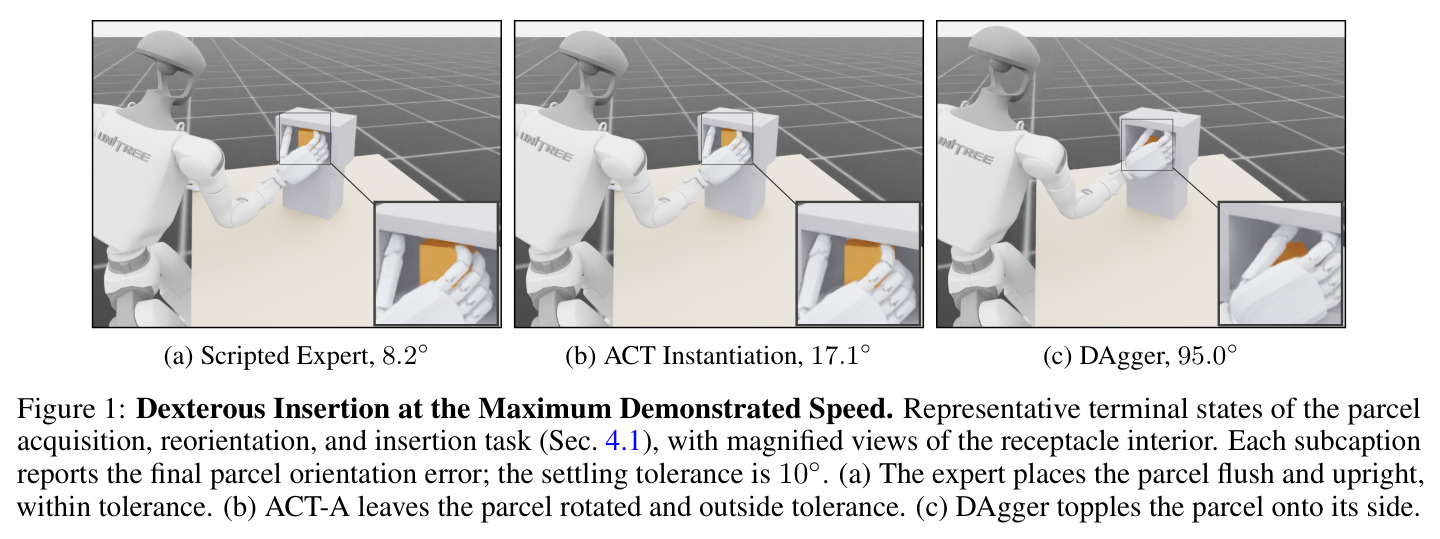
三个子图展示最大演示速度 $r=2$ 下的插入终态与容器内部放大视图:(a) 脚本专家终态朝向误差 $8.2^\circ$,在 $10^\circ$ 容差内、包裹平齐立直;(b) ACT-A 留下 $17.1^\circ$ 的旋转、超出容差;(c) DAgger 把包裹侧翻至 $95^\circ$。
一图点题:名义速度下都能成功的策略在高速下以完全不同的方式失败,直观呈现论文的核心现象「专家-学习者差距」。