基于Transformer变分自编码器学习稀疏决策树 Learning Sparse Decision Trees via Transformer Variational Auto-Encoders
TTVAE学出决策树连续隐空间,梯度上升联合优化预测精度与树稀疏度。
前置知识
决策树与贪心学习算法(CART)
决策树用if-else规则层级划分特征空间,每个内部节点测试“特征≤阈值”,叶子输出类别。CART、ID3、C4.5等经典算法自顶向下贪心选择使不纯度下降最大的分裂并递归分区。学习最优决策树是NP完全问题,贪心方法快但常次优;近优方法用数学规划、动态规划或分支定界逼近最优解,代价高昂。
本文的全部对比对象(CART、DL8.5、GOSDT、FLOW)和“性能-稀疏性”权衡都建立在这一背景上,需要理解为何贪心解稀疏性差、最优解计算太贵,才能体会TREVIS的定位。
变分自编码器(VAE)
生成模型:编码器把输入映射为隐变量分布参数 $\mu,\sigma$,经重参数化 $z=\mu+\sigma\odot\epsilon$ 采样,解码器从 $z$ 重建输入。训练最大化 $\beta$-ELBO,即重建项减去 $\beta$ 倍的KL散度,KL把隐空间拉向 $\mathcal{N}(0,I)$ 先验,使隐空间连续、可采样、可插值。KL退火与free bits用于防止后验坍缩。
TTVAE就是作用在“树的token序列”上的VAE,隐空间的平滑性与可导航性是整个梯度搜索方法的根基。
Transformer自注意力与位置编码
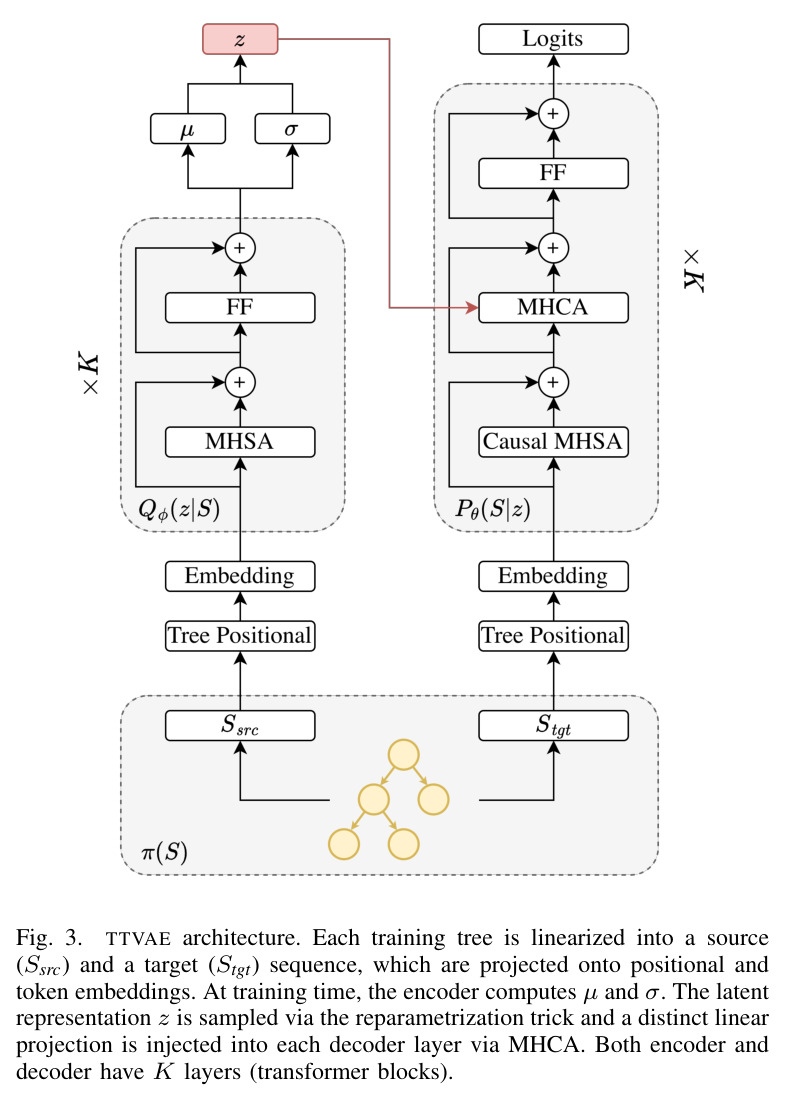
自注意力 $MHSA(S)=Concat(SA_1,\dots,SA_h)W^O$ 让序列每个位置加权聚合全局信息,但其对排列不变,需位置编码注入顺序信息。树位置编码把根到节点的路径编码为按几何级数缩放的one-hot分段向量,显式表达层级结构,而非只表达线性位置。
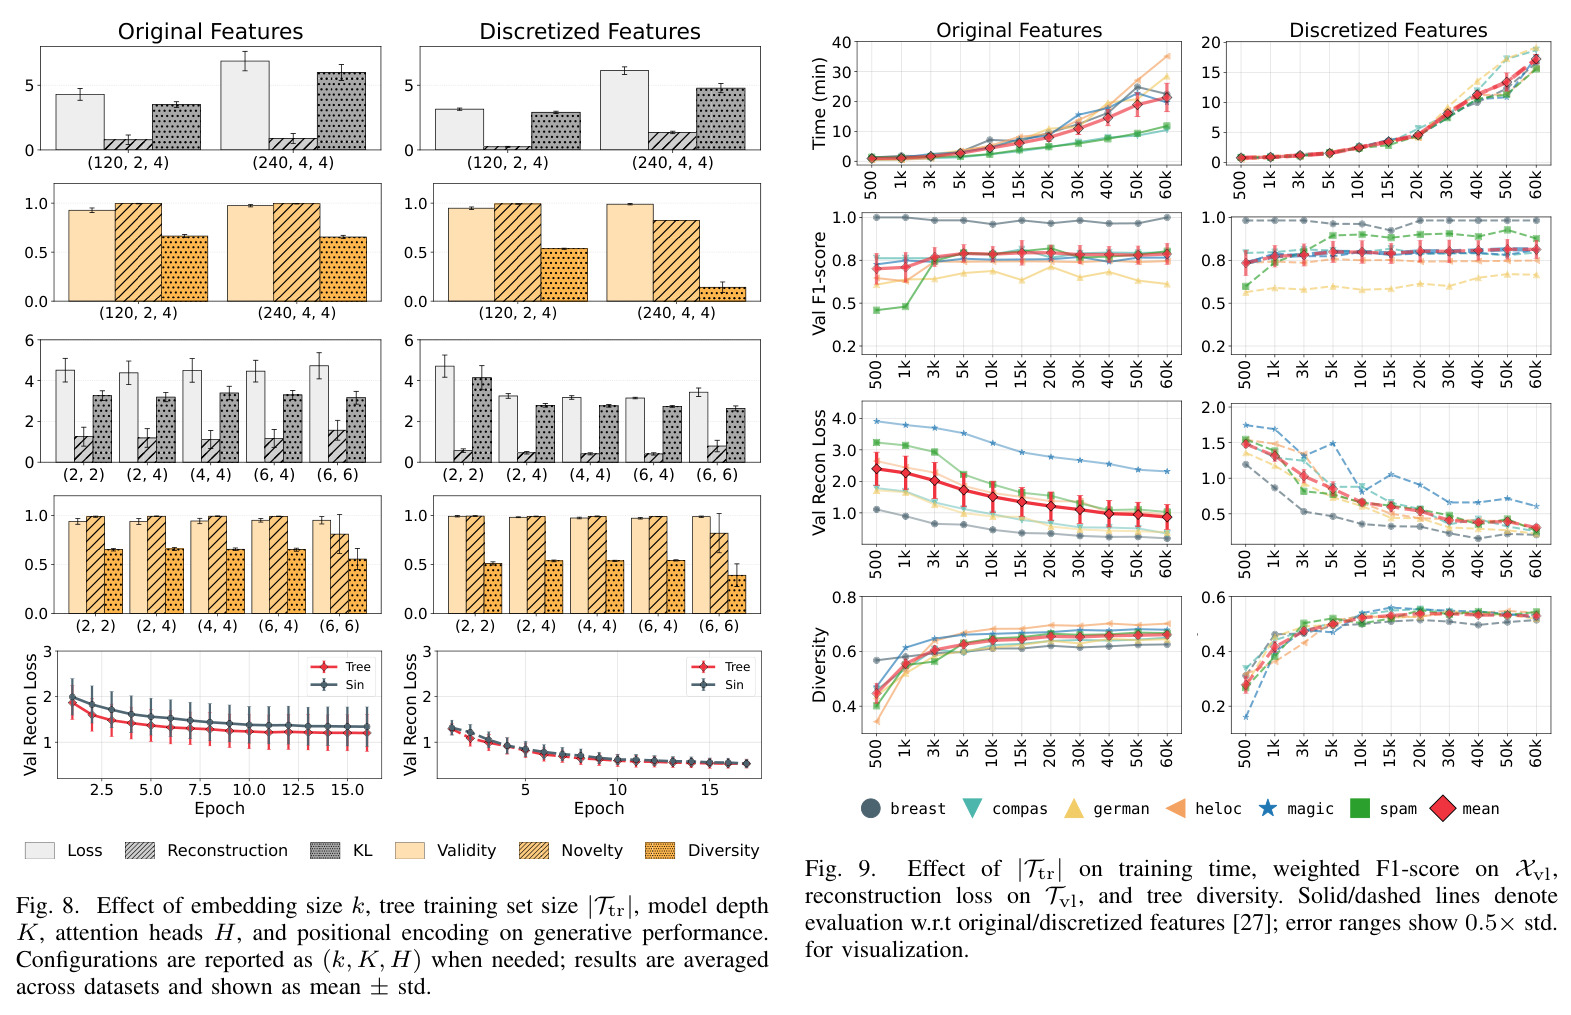
论文把决策树线性化为token序列后交给Transformer,全靠树位置编码保住树结构信息;敏感性分析证明它优于标准正弦编码,是方法成立的关键组件。
潜在空间优化(LSO)与代理模型
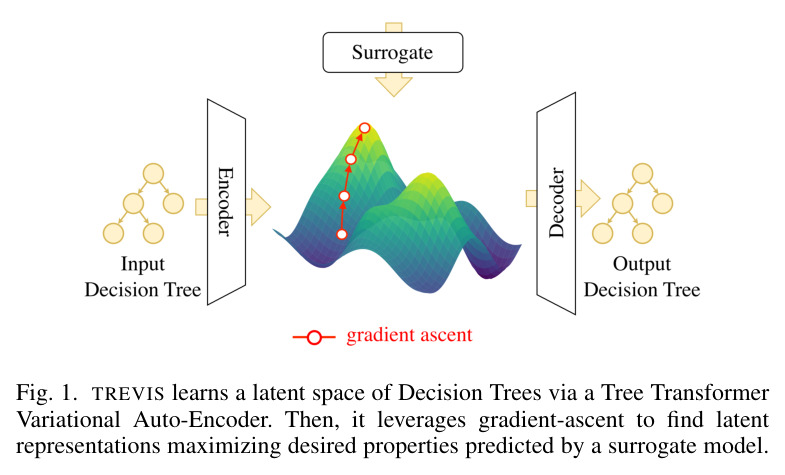
先用VAE把离散对象(分子、图、树)映射到连续隐空间,再训练代理模型 $g(z)\approx J(\mathrm{decode}(z))$ 逼近昂贵或不可导的真实目标,然后用梯度上升 $z\leftarrow z+\eta\nabla_z g(z)$ 或黑盒方法搜索最优隐表示。可微代理使梯度法可行,采样效率远高于遗传算法等黑盒搜索。
TREVIS正是用MLP代理拟合不可导的目标 $J_\lambda$,才把决策树搜索变成每候选仅需10步的梯度上升,这是本文与黑盒优化的本质区别。
加权F1与结构稀疏性
加权F1按类别样本数加权平均各类F1,是类别不平衡数据的常用分类指标;结构稀疏性以叶子数 $V(T)$(也可用深度、节点数)衡量,叶子越少模型越简洁、越可解释。文中目标 $J_\lambda(T)=A(T)-\lambda V(T)$ 用系数 $\lambda$ 显式权衡两者,$A$ 为训练集加权F1。
这是论文的优化目标与全部实验的评价维度,读懂结果表格必须知道F1列与叶子数列分别代表精度与可解释性。
研究动机
决策树是信贷风控、招聘、医疗等高风险场景中少有的天然可解释模型,但学习最优决策树是NP完全问题,离散搜索空间随特征数与样本数指数增长。主流算法CART、ID3、C4.5采用自顶向下贪心分裂,计算高效却常收敛到次优解;追求全局最优的数学规划与分支定界方法(GOSDT、DL8.5、MurTree、FLOW)成本高昂——在论文的18个基准数据集上,GOSDTlb平均需976.3秒,FLOW平均3437.4秒且在除iris外所有数据集上超出1小时时限。更关键的是,这些算法几乎只优化预测性能,忽视决策树可解释性真正依赖的结构稀疏性(深度、节点数、叶子数),DL8.5平均要长出19.39个叶子,模型往往过深过繁,削弱了可解释性这一核心卖点。
本文的目标是本文的目标是提出一个能针对复杂目标函数学习决策树的通用框架TREVIS,并在“预测性能—结构稀疏性”这一经典权衡上验证:在保持与近优算法相当的加权F1的同时显著减少叶子数。具体而言,作者希望把决策树的离散组合搜索空间转化为连续潜在空间,使任何可计算的目标 $J_\lambda(T)$ 都能通过可微代理模型进行基于梯度的优化;同时用Transformer VAE显式编码树结构,保证隐空间局部平滑、可导航,让梯度上升真正找到更优的树。最终在18个基准数据集上与CART、DL8.5、DL8.5lb、GOSDTlb、FLOW全面对比精度、稀疏度、训练时间与隐空间质量。
与已有工作不同的是,现有工作的空白在于:尚无人用显式建模树结构的生成模型为决策树构建连续隐空间。唯一的生成式先例(Guidotti等,AAAI 2024)把决策树编码为矩阵后做卷积,对树结构的表达能力不足,且依赖遗传算法做黑盒优化,采样效率低、需要大量昂贵的目标评估。分子设计领域的Junction Tree VAE、D-VAE虽验证了“结构化VAE+潜在空间优化”路线,但从未迁移到决策树学习。TREVIS的独特切入是三者结合:用深度优先线性化加树位置编码的Tree Transformer VAE(TTVAE)获得结构感知的60维隐空间,再用可微MLP代理拟合目标 $J_\lambda$,把搜索从黑盒遗传算法升级为梯度上升,兼顾表达力与采样效率。
核心方法
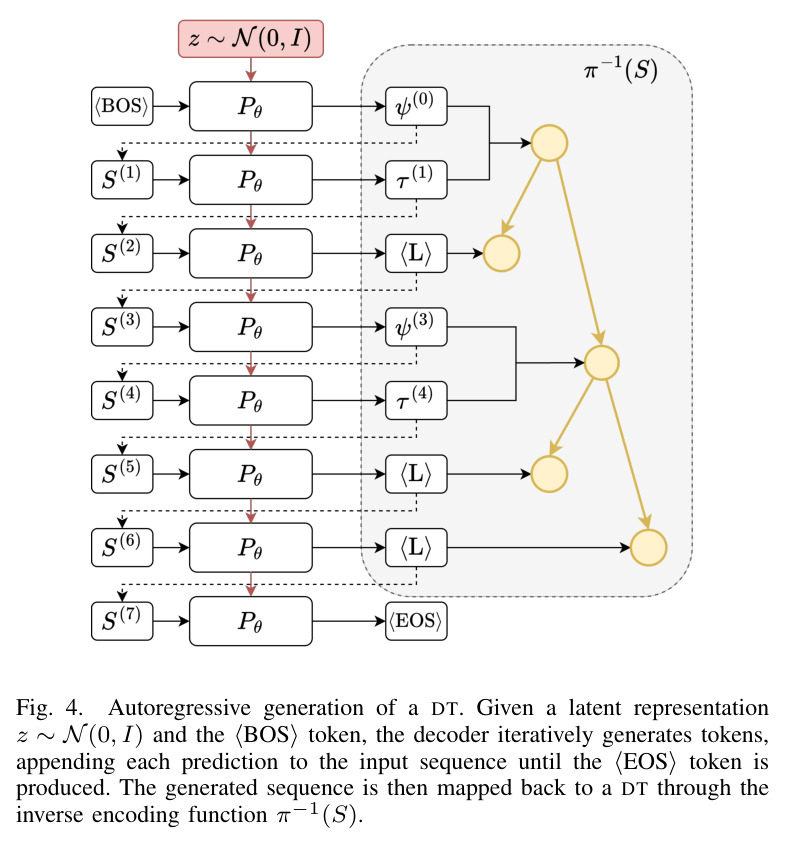
TREVIS的直觉是:与其在指数级的树空间里离散搜索,不如先学一张“决策树的连续地图”,再用梯度在地图上爬山。技术路线分四步。(1)构建训练树集:对 $(X_{tr},Y_{tr})$ 用随机分裂生成深度 $\gamma\in[1,5]$ 的20,000棵树,限制在可解释复杂度内。(2)训练TTVAE:把每棵树深度优先先序遍历线性化为token序列,用树位置编码注入结构信息;编码器输出 $\mu,\sigma$ 得到60维隐变量 $z$,解码器以因果注意力自回归重建序列,按 $\beta$-ELBO训练。(3)拟合代理模型:用MLP回归隐坐标到目标 $J_\lambda(T)=A(T;X_{tr},Y_{tr})-\lambda V(T)$,$A$ 为训练集加权F1,$V(T)$ 为叶子数。(4)梯度搜索:从 $\mathcal{N}(0,I)$ 采样 $n'=50{,}000$ 个隐向量,各执行10步 $z\leftarrow z+\eta\nabla_z g(z)$($\eta=10^{-3}$),只解码代理分前500的候选,用真实目标评估后按验证集F1选出最终树。
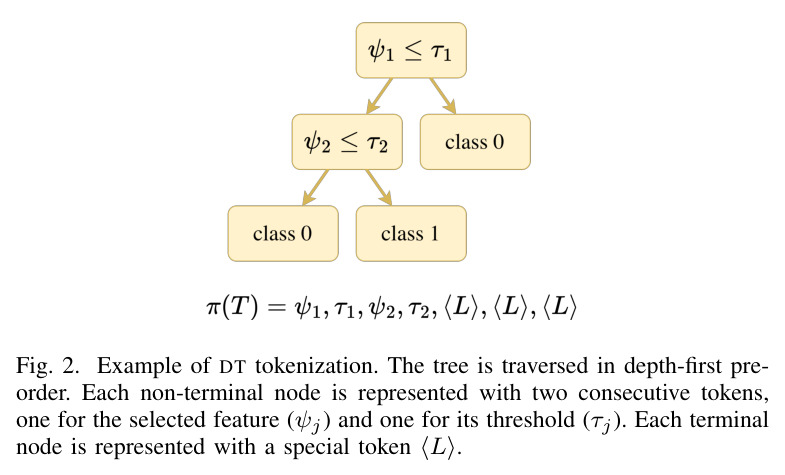
核心创新有两点。其一是面向决策树的结构感知生成建模:内部节点编码为(特征 $\psi_j$,阈值 $\tau_j$)两个连续token,叶子编码为特殊token $\langle L\rangle$;关键设计是阈值词表规范化——对排序后的特征取值 $v_j^{(1)}<\dots<v_j^{(n)}$,区间 $[v_j^{(l)},v_j^{(l+1)})$ 内任何阈值产生相同的数据划分,故只需取左端点 $v^{(l)}$ 并舍入到固定精度作为规范值,避免传统CART取中点导致的词表爆炸;叶子类别可由落入节点的多数类推断,无需显式预测。树结构通过Shiv & Quirk的树绝对位置编码(根到节点路径的one-hot分段按几何级数缩放)注入注意力。其二是把潜在空间优化引入决策树学习:不同于先前工作的卷积矩阵编码加遗传黑盒搜索,TREVIS用可微MLP代理 $g:\mathcal{Z}\to\mathbb{R}$ 逼近不可导的 $J_\lambda(P_\theta(z))$,使搜索变为样本高效的梯度上升,并配合KL退火与free bits防止后验坍缩。
方法步骤详情
流程对应Algorithm 1。第一步线性化:$\mathcal{S}=\{\pi(T)\}$,每棵树变为先序token序列,非终端节点贡献(特征,阈值)两个token,叶子贡献 $\langle L\rangle$。第二步训练TTVAE:编码器(K=2层、嵌入120维、2头)输出 $\mu,\sigma$,重参数化采样 $z$;解码器为因果掩码自回归模型,$z$ 经每层独立投影由交叉注意力注入;按 $\beta$-ELBO训练,$\beta$ 先为0再线性增加并配合free bits,最多50个epoch。第三步取训练树隐表示并计算目标值。第四步训练代理:128维tanh隐层MLP,MSE损失,学习率 $10^{-3}$、100个epoch。第五步从 $\mathcal{N}(0,I)$ 采样 $n'=50{,}000$ 个隐向量。第六步每个 $z$ 做10步梯度上升($\eta=10^{-3}$)。第七步只解码代理分前500的隐向量,对合法树计算真实目标,按验证集加权F1选出最优树;对 $\lambda\in\{0,\dots,0.01\}$ 六个取值各训一个代理重复。
技术新颖性
与三类方法的本质区别:对贪心/近优离散搜索(CART、DL8.5、GOSDT、FLOW),TREVIS根本改变了搜索范式——不枚举树,而是在学到的连续隐空间中移动;未来若要优化公平性、隐私、鲁棒性等新目标,只需替换代理模型的训练标签即可复用整条管线。对唯一的生成式前作,TREVIS用显式建模树结构的Transformer替换卷积矩阵编码,用梯度上升替换样本低效的遗传算法。对分子/图领域的LSO(JTVAE、D-VAE),这是首次把“结构化VAE+可微代理+梯度搜索”完整迁移到决策树。工程层面同样有新意:阈值左端点规范化大幅压缩词表;消融实验证明树位置编码优于正弦编码(原始特征空间验证重建损失更低);KL退火加free bits稳定训练。隐空间质量有量化证据:局部平滑性 $\rho=0.640$、三元组准确率TA=0.698,代理模型测试Pearson达0.753。
实验结果
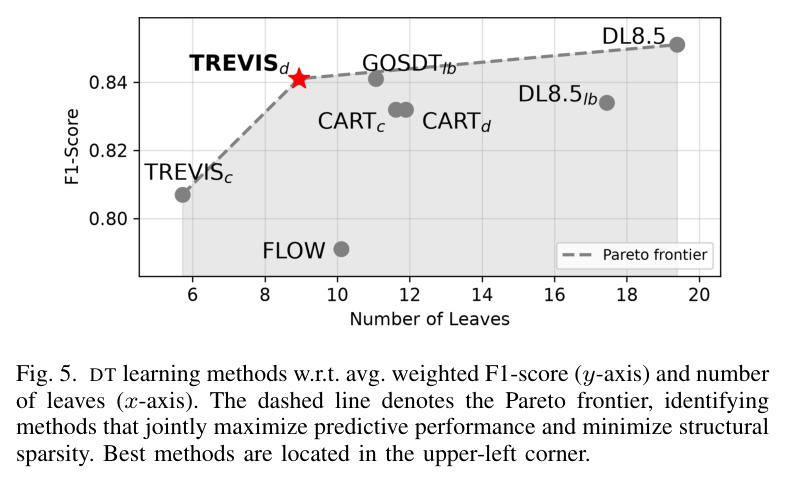
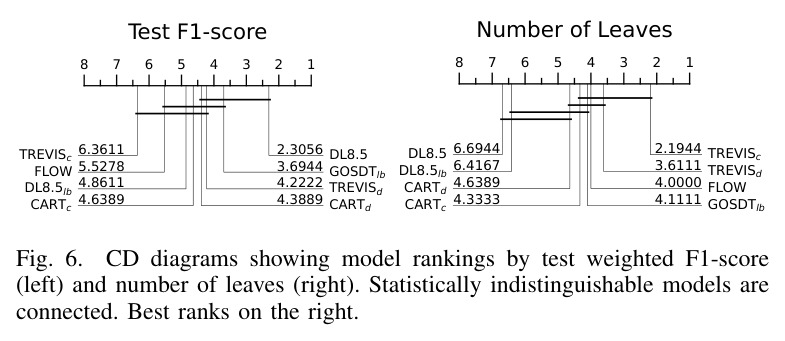
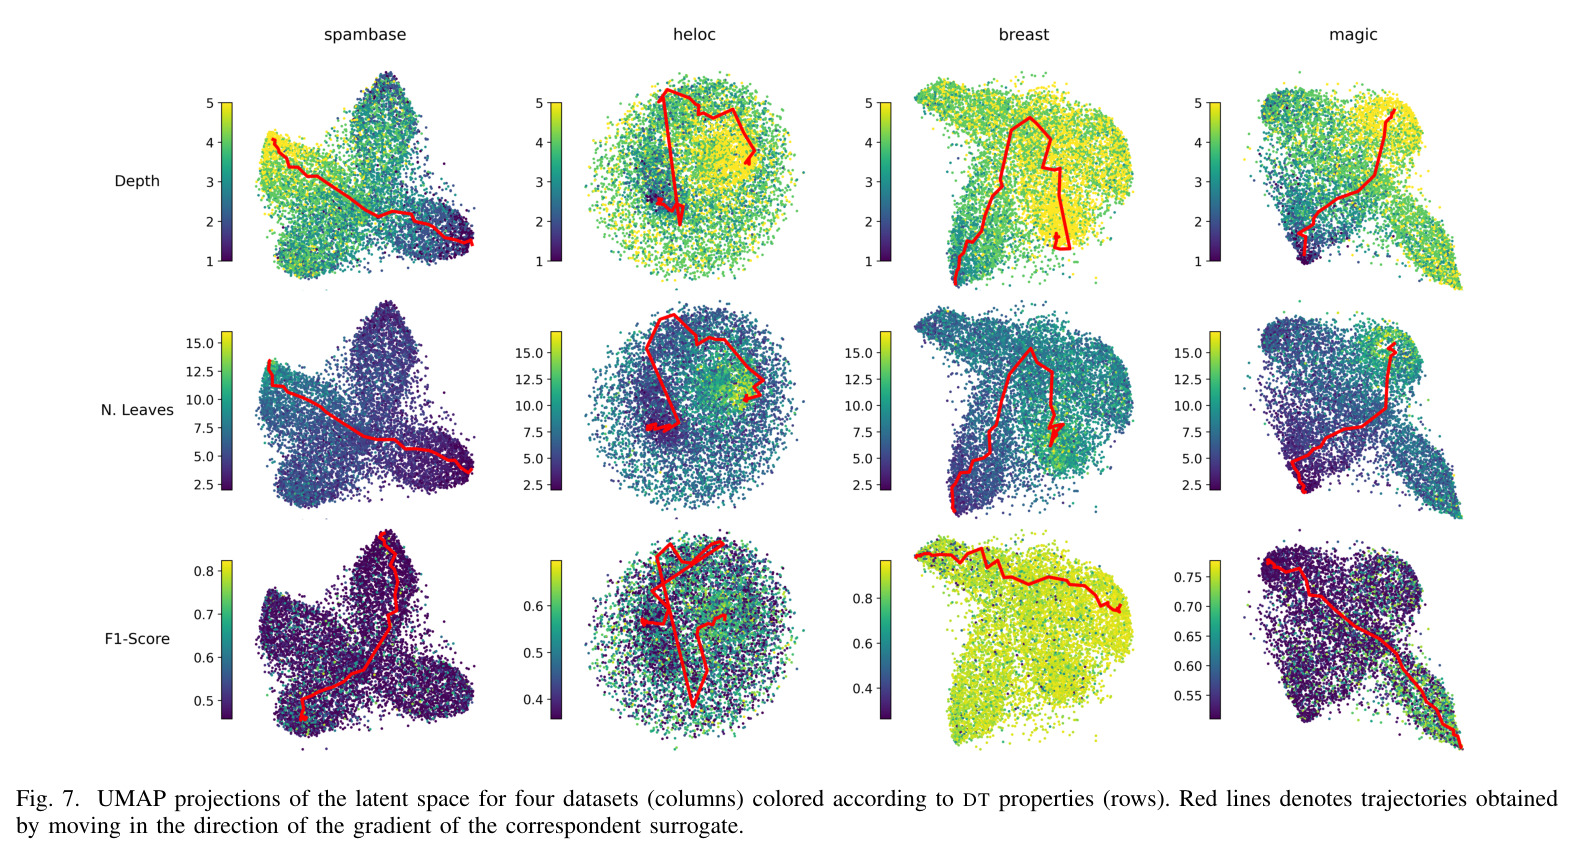
在18个基准数据集上(测试F1经200次bootstrap)验证。精度:TREVISd平均加权F1为0.841±0.085,全场第二,与GOSDTlb(0.841)持平,超DL8.5lb(0.834)和CARTd(0.832),仅低于DL8.5(0.851);TREVISc为0.807。稀疏度优势显著:TREVISd平均仅8.94个叶子(TREVISc最低至5.72),远少于FLOW的10.11、GOSDTlb的11.06、CARTd的11.89、DL8.5的19.39;如adult上TREVISd用4叶达F1 0.836,CARTd需14叶才到0.847。Nemenyi检验显示TREVISd与最优近优方法统计不可区分,稀疏度排名最佳。效率:TREVISd平均490.9秒(TTVAE 268.9+代理59.2+搜索162.8),约为GOSDTlb(976.3秒)一半、FLOW(3437.4秒)的1/7,但远慢于CART。隐空间分析给出机制解释:扰动幅度与编辑距离的Spearman相关 $\rho=0.640$、三元组准确率TA=0.698(均 $p<0.05$);UMAP轨迹显示结构性质比预测性能组织更好;代理测试Pearson 0.753、RMSE 0.027。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 18个基准数据集上的预测性能(离散特征版本) | 加权F1(18数据集平均,200次bootstrap) | TREVISd 0.841±0.085(TREVISc 0.807) | DL8.5 0.851 / GOSDTlb 0.841 / DL8.5lb 0.834 / CARTd 0.832 / FLOW 0.791 | 与GOSDTlb持平,比DL8.5lb和CARTd高约0.9个百分点,仅比DL8.5低1.0个百分点;Nemenyi检验下与最优近优方法统计不可区分 |
| 树结构稀疏度(越少越可解释) | 平均叶子数(18数据集平均) | TREVISd 8.94 / TREVISc 5.72(全场最少) | FLOW 10.11 / GOSDTlb 11.06 / CARTd 11.89 / DL8.5lb 17.44 / DL8.5 19.39 | TREVISd比GOSDTlb少约19%、比DL8.5少约54%;在精度第二的前提下稀疏度排名第一 |
| 训练效率 | 平均训练时间(秒,18数据集) | TREVISd 490.9秒(TTVAE 268.9+代理59.2+搜索162.8)/ TREVISc 622.6秒 | GOSDTlb 976.3秒 / FLOW 3437.4秒 / DL8.5lb 259.7秒 / CART 0.025秒 | 约为GOSDTlb的一半、FLOW的1/7;但比贪心CART慢约2万倍 |
| 隐空间质量验证 | 局部平滑性Spearman相关ρ / 三元组准确率TA | ρ=0.640±0.240,TA=0.698±0.105(6数据集,均p<0.05) | 无直接基线;代理模型测试Pearson 0.753、RMSE 0.027佐证搜索可靠性 | 扰动幅度与解码树编辑距离显著正相关,隐空间局部邻域在输出空间基本保持 |
局限与改进
作者承认三点局限:其一,预测性能这类性质在隐空间中组织较差(TA在magic上仅0.512),难以找到有效的性能提升方向;其二,管线含TTVAE训练、代理训练、梯度搜索多个阶段,平均8-10分钟,效率无法与CART(0.025秒)等贪心方法相比;其三,在原始连续特征空间上TREVIS明显较弱(F1 0.807低于CART的0.832),必须先做特征选择和离散化才能发挥优势(TREVISd 0.841)。我补充几点观察:18个数据集中17个是二分类,多分类仅iris和lrs,多分类泛化未充分验证;每个 $\lambda$ 都要单独训练一个代理(共6个),多目标扩展成本线性增长;搜索受限于预生成的随机树集所定义的词表(深度 $\gamma\le5$、候选分裂来自训练数据取值),理论上无法发现集合之外的新分裂;对比给近优方法设了1小时时限,FLOW超时使其平均成绩失真,跨方法效率对比需谨慎解读。
独立分析的弱点
第一,依赖离散化预处理削弱通用性:TREVISc在原始特征上F1仅0.807、比CARTc低2.5个百分点,说明受限词表的阈值表示丢失精细决策边界;可给阈值 $\tau$ 加连续回归头,或隐空间优化后做局部连续微调。第二,目标不可导必须训练代理,代理误差(Pearson 0.675-0.753)会误导搜索;可用高斯过程或深度集成代理并叠加不确定性采集函数,或基于真实评估在线更新代理。第三,每换一个 $\lambda$ 就重训一个代理(共6个),开销线性增长;可训练以 $\lambda$ 为条件的单一代理。第四,自回归解码可能产生非法序列,论文虽单独报告validity但未与主结果联动;可加入语法约束解码。第五,与CART缺少“精度-时间”帕累托讨论:算力受限时CART加剪枝可能够用,TREVIS价值区间应界定在中高算力、对可解释性有硬性要求的场景。第六,训练树集由随机分裂生成,如何更聪明地构造 $\mathcal{T}$(如Rashomon集采样)值得探索。
未来方向
作者提出的方向:把优化目标从性能-稀疏性扩展到公平性、隐私保护与鲁棒性等更复杂性质,管线天然支持,只需替换代理的训练标签;用TREVIS做决策树的反事实探索,在隐空间中寻找保持某些性质同时改进其他性质的相邻方向;研究近似同等最优的Rashomon集对TREVIS的影响,可能揭示性能与其他性质之间新的权衡。基于本文成果可延伸:利用学到的隐空间对树做插值与结构编辑(换子树、剪枝在隐空间中的对应操作),发展“树的潜在空间语义算术”;把TTVAE作为先验接入贝叶斯优化,用代理不确定性量化搜索置信度;将框架推广到回归树与树集成(随机森林、GBDT)的生成式压缩;探索跨数据集预训练共享TTVAE,降低新数据集上的训练成本;把多代理合并为条件化单代理后,可对精度-稀疏-公平做真正的多目标帕累托搜索。
复现评估
复现条件较好:代码与数据集来源已在GitHub开源(github.com/gfidone/TREVIS),18个数据集均为公开基准(adult、bank、HELOC、COMPAS等)。模型很小:TTVAE仅K=2层、嵌入维度120、2个注意力头、60维隐空间,训练最多50个epoch(早停patience 1);代理是128维单隐层MLP,100个epoch。但论文实验硬件为双路AMD EPYC 9754(128核)加一张NVIDIA H100 NVL,TTVAE训练平均268.9秒(离散版)、梯度搜索162.8秒,单数据集全流程约8-10分钟;还需生成20,000棵训练树并为6个 $\lambda$ 各训一个代理。普通单卡GPU(RTX 3090级别)应可复现,主要成本在18个数据集×2种特征表示×6个 $\lambda$ 的组合实验;GOSDTlb与FLOW基线需1小时时限,复现对比实验耗时较长。关键工程细节(树位置编码、KL退火调度、free bits、阈值左端点规范化)论文均已给出配置,加上开源代码,总体复现难度中等。
论文图表
训练树数量 $|\mathcal{T}_{tr}|$ 从500到60,000的影响:训练时间近线性增长;验证F1在最初几千棵后趋稳;重建损失持续下降但20,000后边际收益变小;多样性先快速上升后饱和。故主实验取 $|\mathcal{T}_{tr}|=20{,}000$。
给出训练树集构建的规模-质量权衡,是理解数据成本与复现该规模设置的关键依据。
18个基准数据集的画像:样本量从iris的150到elec的45,312;特征从原始4维(one-hot后9维)到90维;17个为二分类;类别不平衡如steel多数类占91.86%、lrs少数类仅0.38%;并给出GBDT参考F1(wine .991、contr .731)作为性能上界参照。
实验的“地图”:只有了解各数据集的规模、不平衡程度与难度,才能正确解读后续方法对比的绝对数值差异。
主结果表:18个数据集×8种方法(TREVISc/d、CARTc/d、DL8.5、DL8.5lb、GOSDTlb、FLOW)的加权F1与叶子数,含均值与标准差。均值显示TREVISd以F1 0.841(第二)配8.94叶;DL8.5精度0.851但需19.39叶;TREVISc叶子最少5.72但F1降至0.807。
论文所有核心结论的数据来源,逐数据集可查证“精度-稀疏权衡”主张,是最重要的一手证据表。
各方法平均训练时间:CARTc 0.025秒、CARTd 0.013秒、DL8.5 207.1秒、DL8.5lb 259.7秒、GOSDTlb 976.3秒、FLOW 3437.4秒;TREVISc 622.6秒、TREVISd 490.9秒,其中TTVAE训练268.9秒、代理训练59.2秒、梯度搜索162.8秒。
揭示方法的真实代价与效率定位——比最优类方法快一倍到七倍、但远慢于贪心法,帮助读者判断适用场景。
6个数据集(spam、german、heloc、breast、magic、compas)上的隐空间局部平滑性:扰动幅度 $\epsilon$ 与解码序列编辑距离的Spearman相关 $\rho$ 平均为0.640±0.240,三元组准确率TA($\alpha=2.0$,1000个三元组)平均0.698±0.105,所有p值低于0.05;breast上TA最高0.833,magic上最低0.512。
量化“隐空间平滑可导航”这一方法成立前提,是梯度上升能够找到更优树的统计学证据,连接方法与结果两部分。