像素文本表示学习的设计基础 On the Design Fundamentals of Pixel Text Representation Learning
系统消融出像素文本表示学习的四大设计原则,训练出SOTA原生分辨率视觉文本编码器
前置知识
对比学习与 InfoNCE 损失
一种表示学习范式:把配对样本(正例对,如图像与其文本描述)的嵌入向量拉近,把不配对样本(负例)推远。InfoNCE 损失 $\mathcal{L} = -\log \frac{\exp(\mathrm{sim}(u,v)/\tau)}{\sum_{k} \exp(\mathrm{sim}(u,v_k)/\tau)}$ 在 batch 内将每个正例对与其余所有样本对比,温度 $\tau$ 控制分布的锐度。本文使用全局 batch 32768、温度 $\tau = 0.03$,所有图文对与文-文对都在这一个目标下联合训练。
本文的全部训练信号(包括自然图文对和渲染文本对)都来自统一的对比目标,四大设计原则的消融结论也全部建立在对比训练之上,不理解 InfoNCE 就无法理解模型如何从像素中学到语义。
NaViT(原生分辨率 Vision Transformer)
传统 ViT 把任意输入图像强制缩放到固定网格(如 224×224)再切 patch;NaViT 支持任意分辨率与长宽比,按原始尺寸切 patch、处理可变数量的视觉 token(通过序列打包实现高效 batch)。本文的编码器从 Qwen2.5-VL 的 ViT 初始化,并接一个 2×2 池化层压缩相邻视觉 token。
RQ1 提出的空间代理原则之所以可行,前提是编码器在推理时能原生接收高分辨率变长输入而无需有损缩放,这正是 NaViT 提供的能力。
视觉捷径学习(shortcut learning)
指模型不去学习任务的本质语义,而是过拟合到表面的视觉属性(如固定字体、纯色背景、固定的文字位置)来完成匹配任务。当文本渲染模板固定时,模型可能靠记住某种字形外观的出现规律而非真正读懂内容来决策,一旦推理时视觉形态变化就性能崩塌。
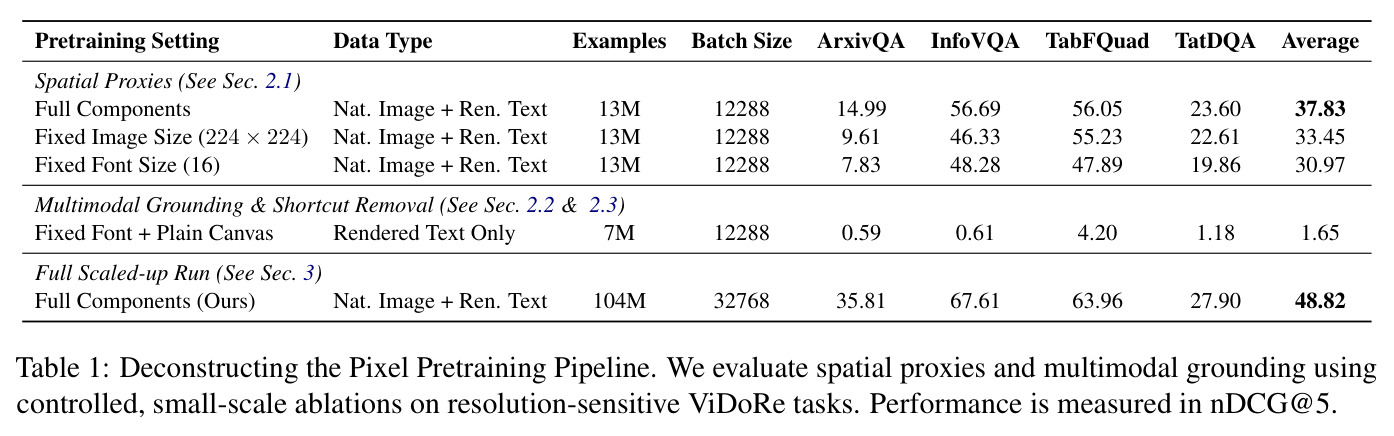
RQ3 与版面感知增强正是为了主动切断捷径;Table 1 中固定字体加纯色画布的设置导致文档检索近乎归零(平均 1.65 nDCG@5),就是捷径学习后果的直接证据。
Visual STS 与 ViDoRe 基准
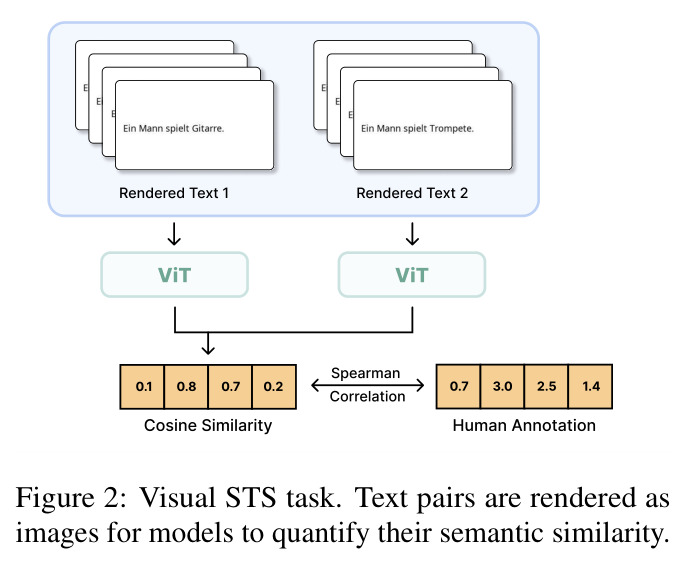
Visual STS 把 NLP 中的语义文本相似度任务整体渲染成图像,模型需从两张文本图像的嵌入余弦相似度恢复出人类标注的相似度,用 Spearman 相关系数评价;ViDoRe 是视觉文档检索基准,用自然语言查询检索 PDF/文档页面图像,指标为 nDCG@5,包含 ArxivQA、TabFQuAD、TatDQA、ShiftProject、AI 等子集。
论文所有主结果都在这两个基准上报告,且本文在 ViDoRe 上连文本查询也渲染成图像处理,理解任务形式与指标是读懂全部实验表格的前提。
双塔(dual-encoder)检索架构
CLIP/SigLIP 式结构:图像编码器与文本编码器各自独立编码,两个嵌入空间通过对比学习对齐,推理时文档可离线编码建库、查询点积检索,效率极高。弱点是文本塔与视觉塔的表示能力不对等,文本侧理解远强于视觉侧。
这是本文的对立面与参照系:PIXEL LINGUIST II 连查询文本都用视觉编码器处理(视觉-only),而基线享受专用文本编码器,这一先天不对等是理解 Table 4 公平性讨论与 24 分性能差的关键背景。
研究动机
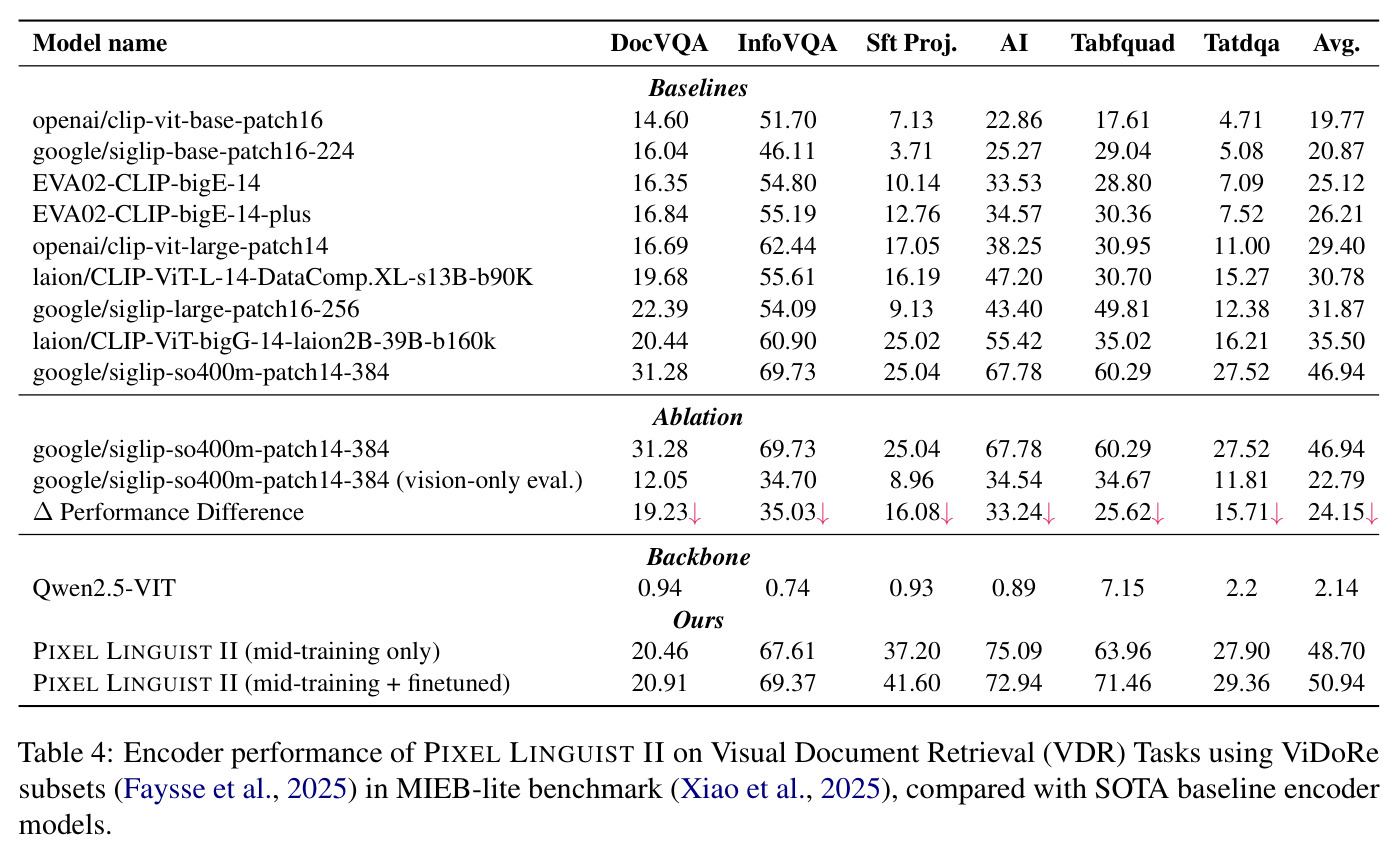
当前主流视觉-语言表示模型(CLIP、SigLIP、EVA-CLIP 等)采用双塔结构,在自然图像和简短描述的跨模态检索上表现出色,但在文本密集的视觉输入上表现不佳。文档、信息图和图表场景需要细粒度阅读、版面理解和文档级语义,而 CLIP 系模型在此类任务上严重不足:例如 ViDoRe 文档检索上,openai/clip-vit-base-patch16 平均仅 19.77 nDCG@5,即便最强的 SigLIP-so400m 也只有 46.94。像素级文本表示学习(把文字渲染成图像、用单一视觉编码器统一处理)提供了另一条路线,但现有工作(PIXEL、CLIPPO 等)存在四大耦合瓶颈:固定分辨率预训练无法应对推理时 4K 级高分辨率 PDF;固定模板渲染诱发视觉捷径学习;缺乏真实世界多模态锚定导致表示脆弱;多语言视觉文字理解近乎空白(多数基线在中文、俄语、韩语上接近随机水平)。此外 PIXEL 依赖重建目标、语义判别性不足,CLIPPO 缺乏文档处理必需的原生分辨率支持。这四个因素相互纠缠,此前从未被系统拆解。
本文的目标是本文的目标不是继续堆数据和参数,而是回答一个更根本的问题:学习泛化的视觉文本表示到底需要哪些不可或缺的设计要素?作者将其拆解为四个研究问题:RQ1——计算高效的低分辨率预训练如何在推理时泛化到高分辨率文档;RQ2——自然图文对提供的多模态锚定对文本中心任务是否必需;RQ3——渲染版面多样性如何影响表示质量、能否阻止捷径学习;RQ4——多语言像素空间语义需要什么样的训练课程。在回答这些问题的基础上,把验证过的结论整合成可扩展的训练配方,训练出 PIXEL LINGUIST II,目标是同时在英文、跨语言、多语言 Visual STS 和 ViDoRe 上取得 SOTA,作为 MLLM 视觉编码器时优于 Qwen2.5-ViT,并在高达 80% 的视觉 token 压缩下保持鲁棒,从而为光学上下文压缩等新范式铺路。
与已有工作不同的是,本文的独特之处在于受控消融优先于大规模训练的方法论。作者先用一个紧凑的 1300 万样本消融数据集(自然图像加渲染文本),在严格受控的设置下逐项剥离变量——自然图像的尺寸方差、渲染字体的大小方差、自然图文对、版面与背景多样性——把每个设计决策的边际贡献量化出来(Table 1、Table 2),再把验证过的原则放大到总计 2.8 亿样本的完整训练。这与 PIXEL/CLIPPO 等「直接给出完整方案」的工作形成鲜明对比:先解耦、再组合、后放大。另一个独特视角是把「空间尺度」当作可学习的代理变量:与其用昂贵的高分辨率画布预训练,不如通过自然图像的分辨率方差和渲染字体大小的方差,让小画布模型习得尺度概念并在推理时外推到高分辨率文档。此外,作者还在全量数据规模上复验了「多模态锚定无法靠规模绕过」(Figure 5),排除了「数据够多就行」这一常见反驳。
核心方法
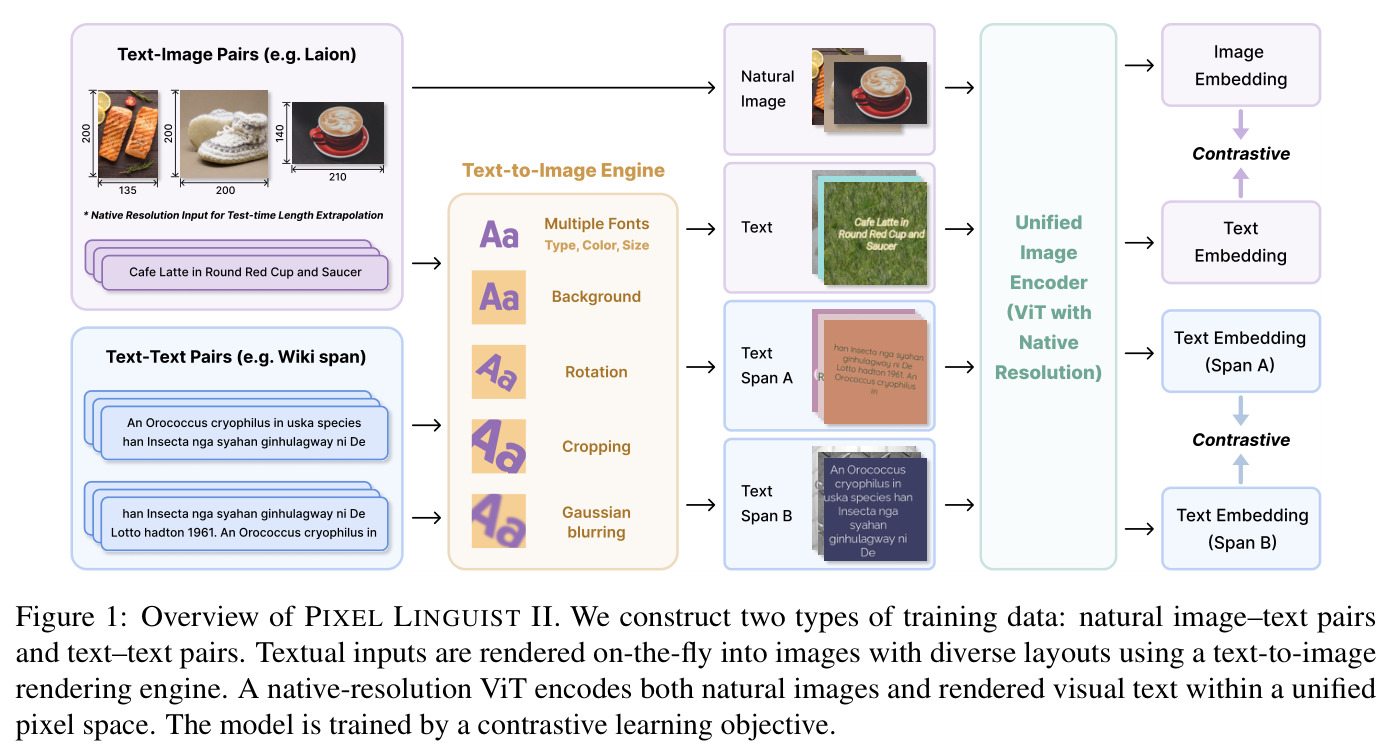
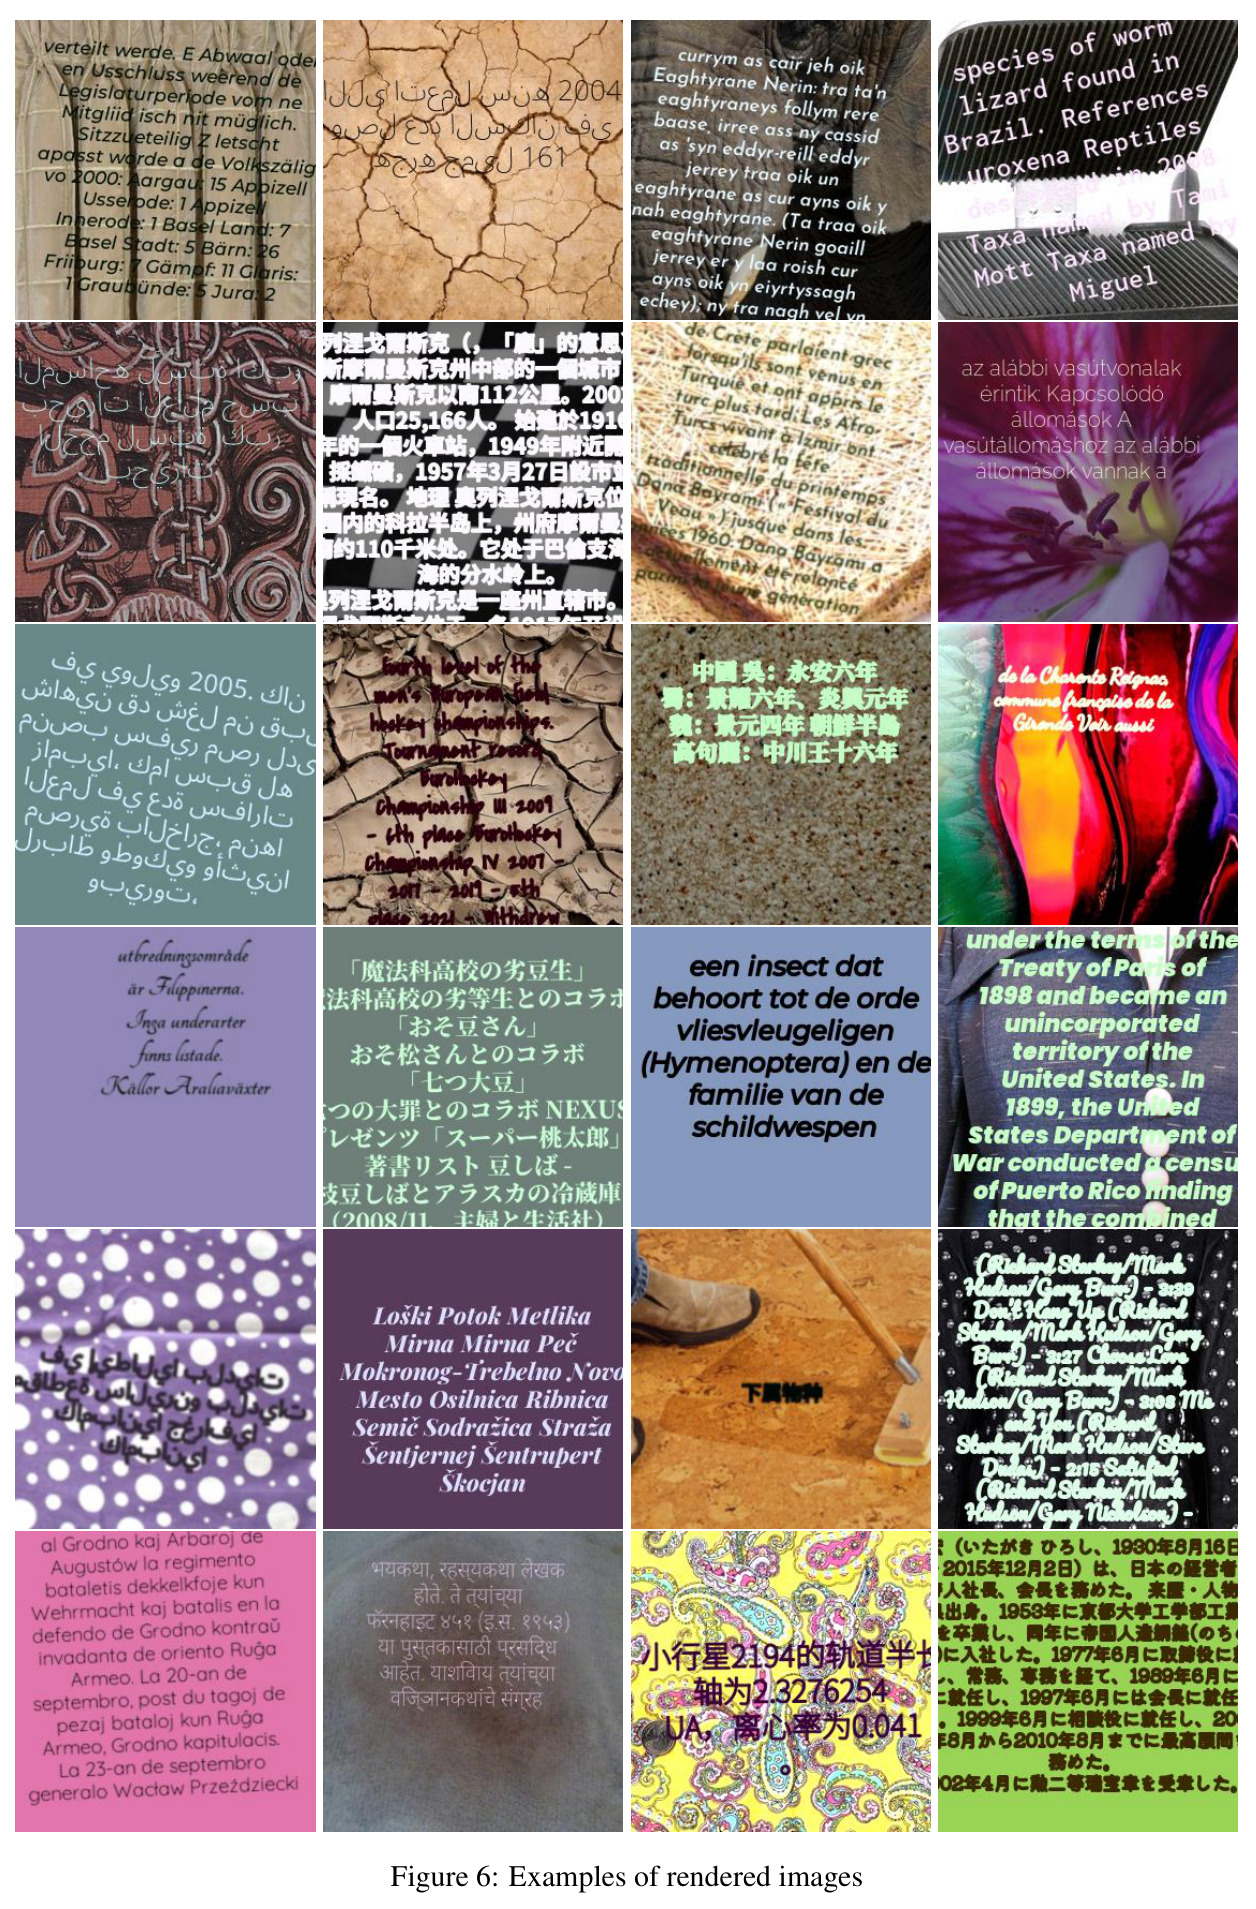
直觉上,让一个纯视觉编码器直接从像素读懂文字并输出语义向量,关键是让它「看得多姿多彩」(避免死记外观)同时「锚定于现实」(避免在合成空间中塌缩)。技术上 PIXEL LINGUIST II 是统一的像素空间框架,包含四个组件:(1)版面感知视觉增强——文本对在训练时动态渲染成图像,采样 393 种字体、数千种纹理背景、随机旋转与模糊,同一文本永远不会以相同视觉形态出现两次;(2)原生分辨率编码——采用 NaViT 架构(从 Qwen2.5-VL 的 ViT 初始化),支持任意分辨率与长宽比,配 2×2 池化压缩相邻 token;(3)统一对比锚定——2600 万 LAION-2B 自然图文对与渲染文本-文本对在单一 InfoNCE 目标 $\mathcal{L} = -\log \frac{\exp(\mathrm{sim}(u,v)/\tau)}{\sum_{k} \exp(\mathrm{sim}(u,v_k)/\tau)}$(温度 $\tau = 0.03$)下联合训练;(4)两阶段多语言课程——先在 6200 万多语言 Wikipedia 文档上做无监督对比预训练注入感知能力,再用 2600 万高质量语义对做语义中训练激活对齐。完整训练共见 2.8 亿样本,全局 batch 32768、64 张 GPU、DeepSpeed ZeRO 2 分布式训练。
核心创新是「空间代理」(spatial proxies)概念与锚定-防塌缩论证的组合。与 CLIP 类模型依赖文本编码器、与 PIXEL 依赖重建目标都不同,本文证明:只要训练中保留自然图像的分辨率方差和渲染字体的大小方差,模型就能习得「空间尺度」这一底层概念,使 224×224 小画布预训练的模型在推理时直接外推到高分辨率密集文档——消融显示去掉图像尺寸方差使 ViDoRe 平均 nDCG@5 从 37.83 跌至 33.45,固定字体再跌至 30.97,即方差本身就是免费的高分辨率泛化能力。同时论文以近乎归零的塌缩(纯渲染文本加固定模板下平均仅 1.65 nDCG@5)因果性地证明自然图文对是防止表示塌缩的必要正则化器,并用全量规模实验(Figure 5)证明该结论不随数据规模增大而失效——这与「文本为中心的任务可以不需要图像」的直觉相反。版面感知增强则从机制上切断捷径:强迫模型对同一语义的无数视觉实例不变,从而只能依赖语义结构。
方法步骤详情
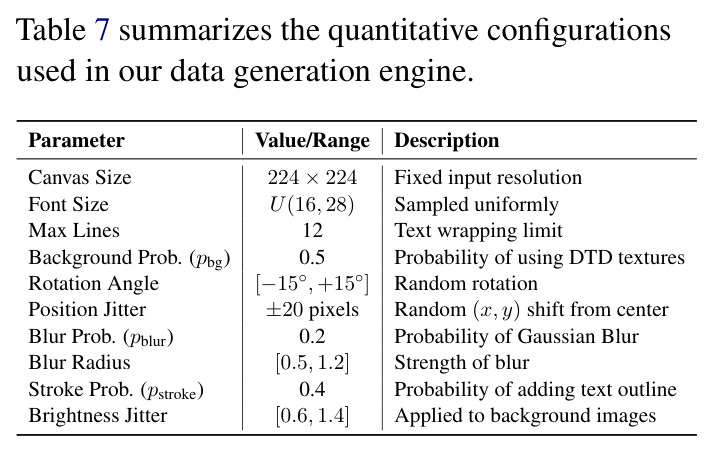
第一步,构建三类数据:多语言预训练语料(Text Corpus 1)为 6200 万多语言 Wikipedia 文档,每篇随机裁剪 25%–50% 内容两次构成无监督正样本对(Izacard 等的做法);高质量语义对(Text Corpus 2)为从文本嵌入模型训练集精选的 2600 万对;多模态锚定数据为从 LAION-2B 采样的 2600 万自然图文对。第二步,动态渲染:渲染引擎逐 epoch 把文本实时渲染成 224×224 画布图像,字号均匀采样 $U(16, 28)$、最多 12 行、以概率 0.5 叠加 DTD 数据集的 5000+ 种纹理背景、随机旋转 $[-15^\circ, +15^\circ]$、位置抖动 ±20 像素、高斯模糊(概率 0.2、半径 0.5–1.2)、亮度抖动 0.6–1.4、描边概率 0.4,确保语义不被固定视觉形态绑死。第三步,编码:NaViT 原生处理可变数量 patch token,2×2 池化压缩相邻 token 平衡语义与效率。第四步,两阶段训练:Stage 1 基础预训练 = Text Corpus 1(6200 万)+ 图文对(2600 万),跑 2 个 epoch;Stage 2 语义中训练 = Text Corpus 2(2600 万)+ 图文对(2600 万),跑 2 个 epoch,两阶段共见 2.8 亿样本;实现上用 DDP + DeepSpeed ZeRO 2,跨节点 all-gather 表示后计算 InfoNCE,全局 batch 32768(每卡 512、64 卡),温度 0.03。第五步(可选):英文任务用约 27 万条 AllNLI 数据微调,再涨约 5 个 Spearman 点。
技术新颖性
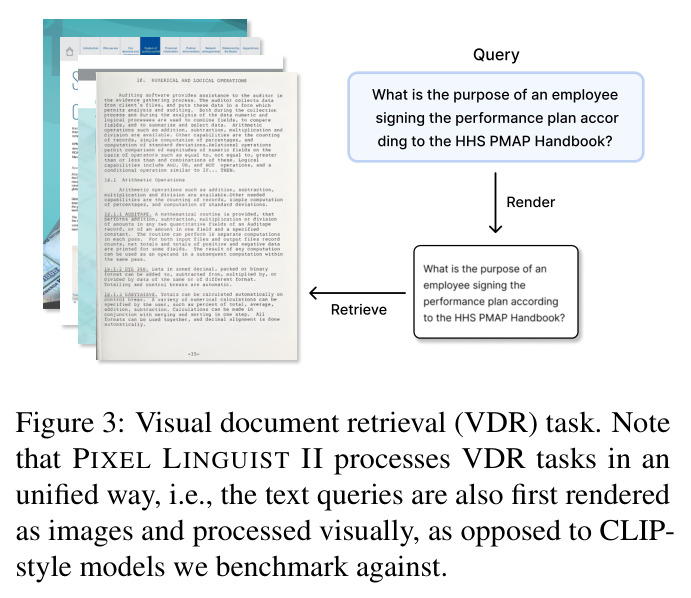
技术新颖性有四层。第一,方法论层面首次把像素文本表示学习拆成四个可分离的设计轴(分辨率、锚定、版面、课程)并给出受控证据,而不是像 PIXEL/CLIPPO 那样只给一个整体配方,使后续研究者能明确知道每个组件值多少分。第二,「空间代理」结论挑战了「文档理解必须高分辨率预训练」的惯例,证明小画布训练可以通过输入方差习得尺度概念并外推,为低成本文档编码器训练开辟新路径。第三,对自然图文对必要性的论证是因果性而非相关性:不只是性能下降,而是纯合成空间中的表示塌缩(1.65 nDCG@5),且用 13M 小规模与全量数据(Figure 5)双重复验,严密排除了「规模能解决一切」的备择解释。第四,工程上实现了完全视觉式的文档检索管线:连查询文本都渲染成图像(Figure 3),在没有文本编码器、先天不利的情况下仍超越享受双塔便利的 CLIP 系基线;并证明该训练配方天然产出高度致密的表示,支持 80% 视觉 token 压缩而不崩,直接对接光学上下文压缩这一新兴方向。
实验结果
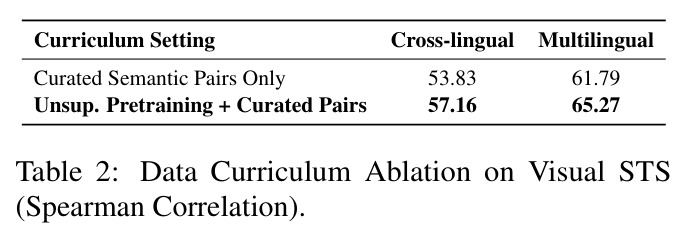
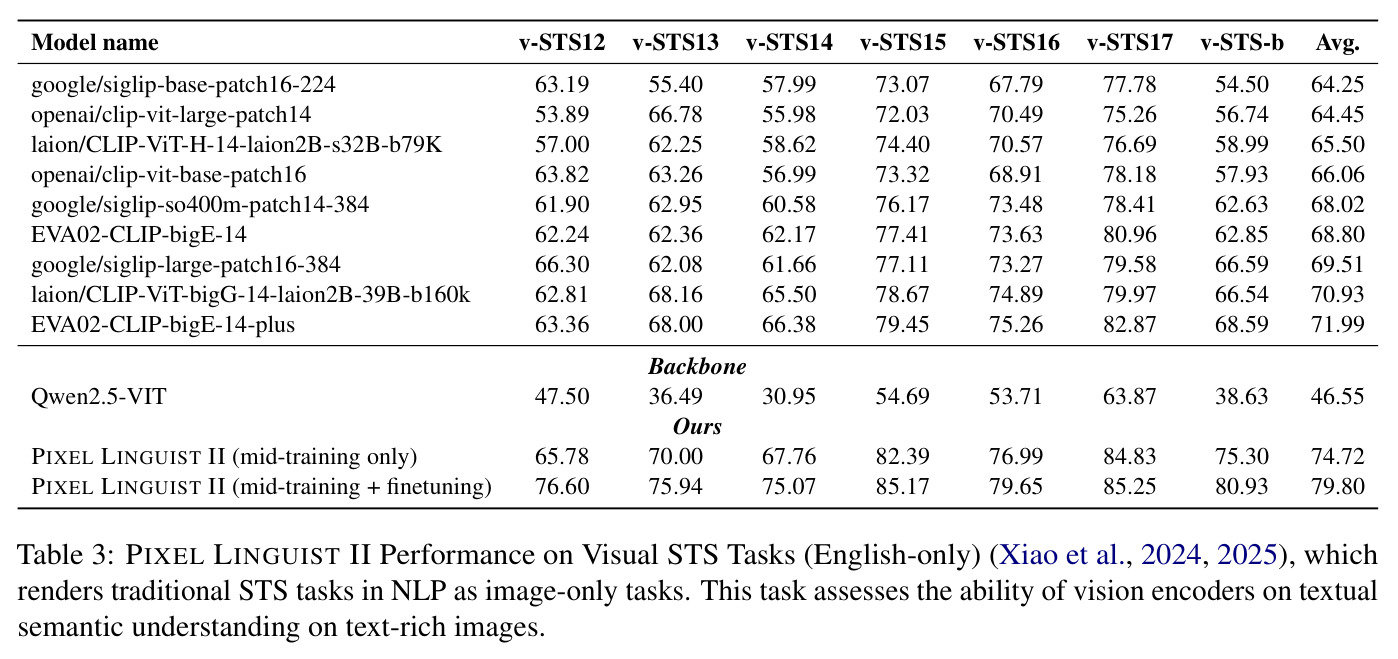
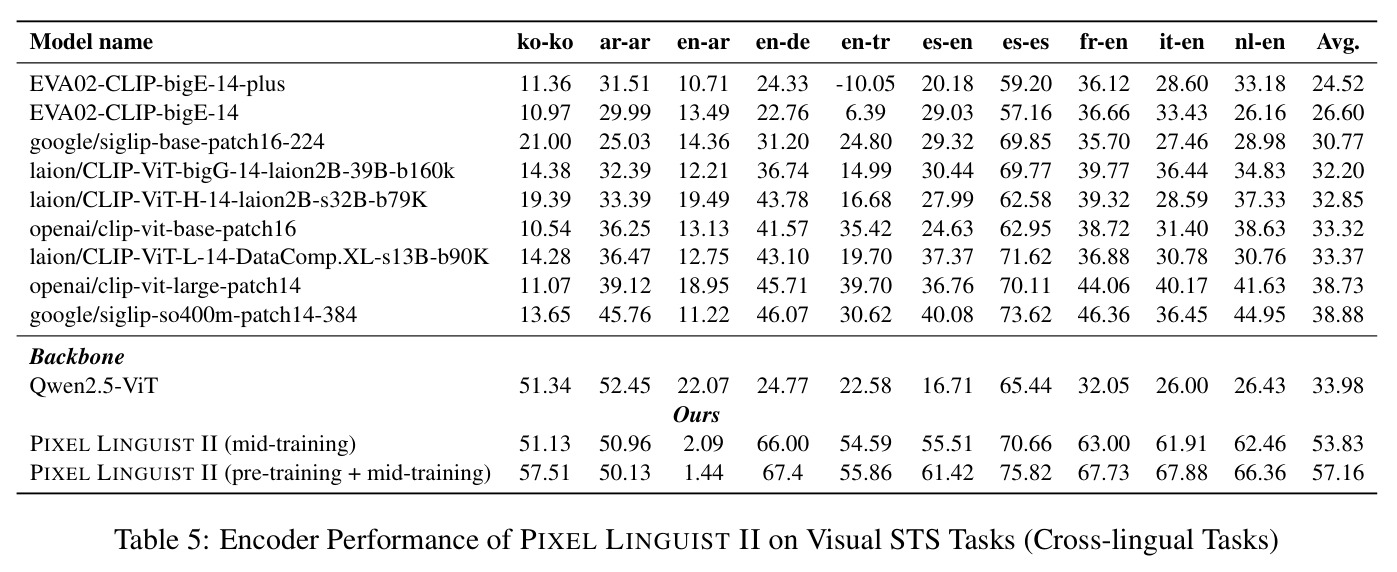
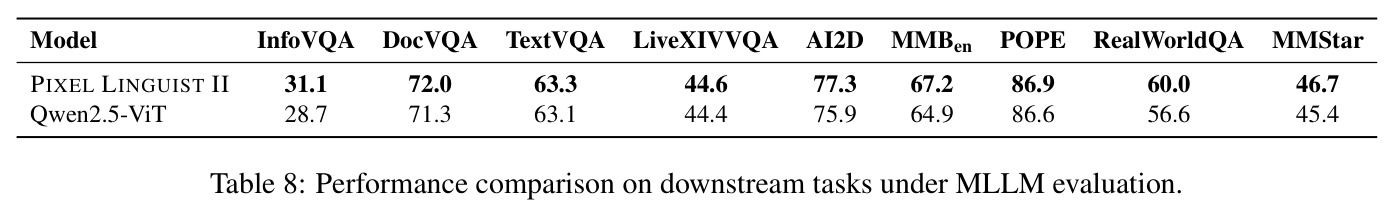
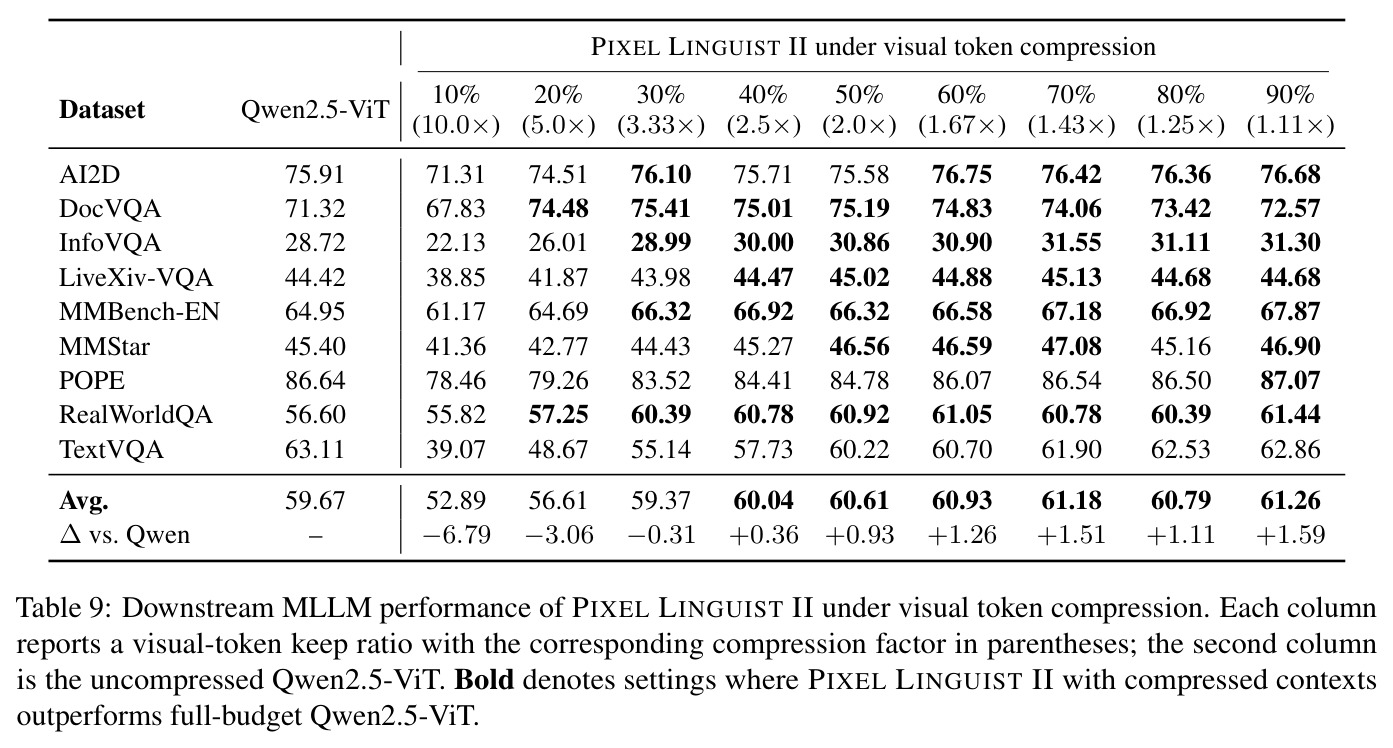
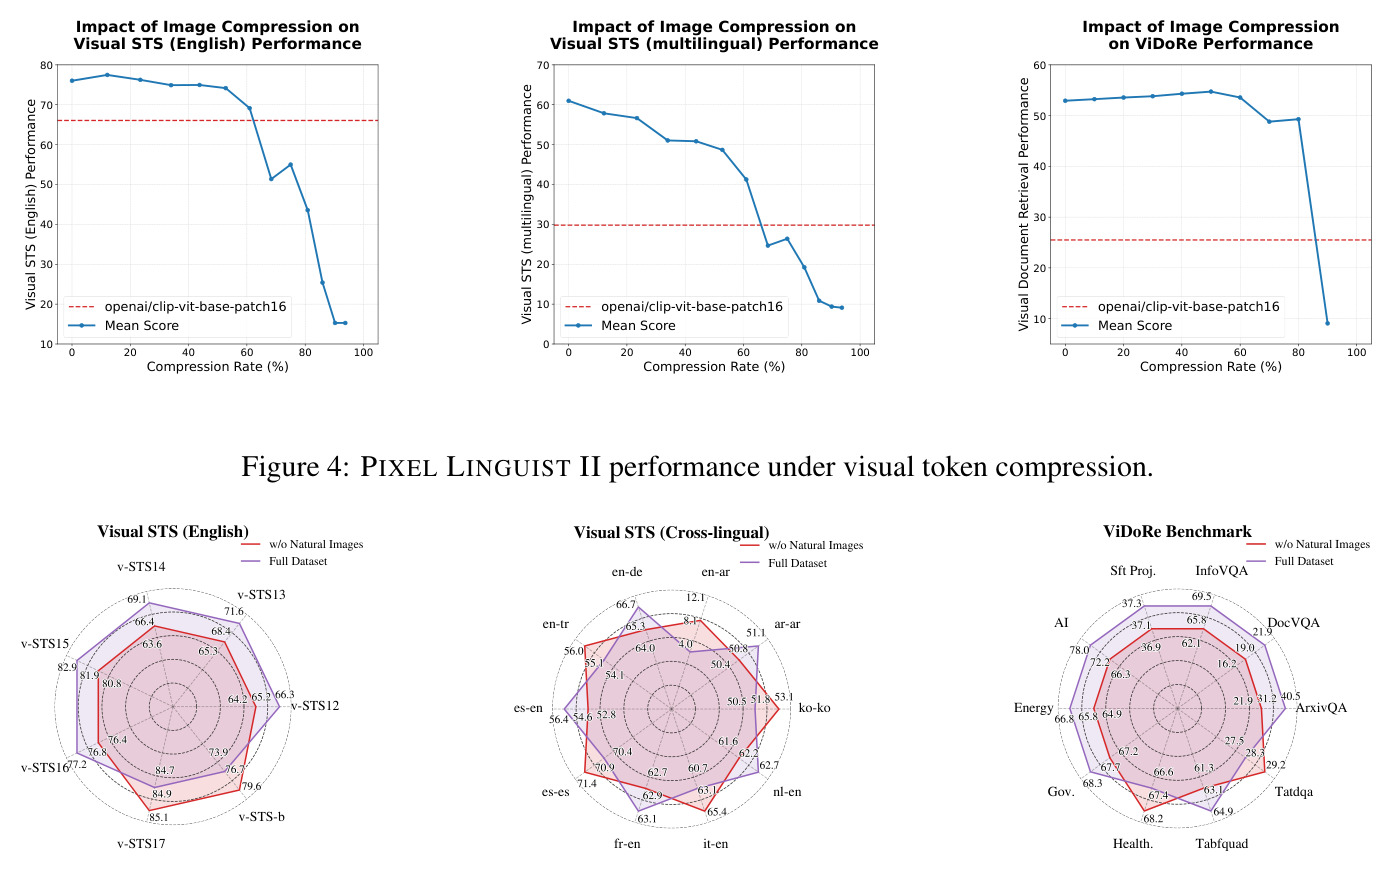
逐项看实验。受控消融(Table 1,13M 样本、batch 12288、ViDoRe 四个分辨率敏感子集的 nDCG@5 平均):全组件 37.83;固定图像尺寸 224×224 跌至 33.45;再固定字号 16 跌至 30.97;纯渲染文本+固定字号+纯色画布灾难性塌缩至 1.65——空间代理与多模态锚定缺一不可。课程消融(Table 2,Spearman):仅用精选语义对训练 cross-lingual 53.83 / multilingual 61.79,先做无监督多语言预训练再语义中训练提升到 57.16 / 65.27(各 +3.33 / +3.48)。英文 Visual STS(Table 3):仅中训练即达 74.72 平均,超过最强基线 EVA02-CLIP-bigE-14-plus 的 71.99,而本文参数量约为其 1/7、见过的训练样本约为其 1/87;加 AllNLI 微调后升至 79.80(如 v-STS-b 从 75.30 升到 80.93)。ViDoRe 文档检索(Table 4):中训练+微调平均 50.94 nDCG@5,对 SigLIP-so400m 的 46.94;AI 与 TabFQuAD 提升 5–12 分,ShiftProject 大涨 16.6 分;公平性消融显示把 SigLIP 强制进统一视觉管线(查询也渲染成图)后平均暴跌 24.15 分至 22.79,凸显本文视觉-only 设置下的鲁棒性。跨语言 Visual STS(Table 5):预训练+中训练平均 57.16,对最强基线 SigLIP-so400m 的 38.88,ko-ko 57.51、fr-en 67.73;多语言(Table 13)平均 65.27(微调后 67.91),对 SigLIP-large-384 的 45.35,此前基线近乎随机的俄语(62.18)和中文(63.04)上均达 60+。MLLM 下游(Table 8):换用本文编码器后 9 项任务对 Qwen2.5-ViT 平均相对提升 2.75%(RealWorldQA 60.0 vs 56.6、MMBench 67.2 vs 64.9)。压缩鲁棒性(Figure 4、Table 9):ViDoRe 上 80% token 压缩时仍优于未压缩 CLIP;MLLM 任务仅保留 40% token 时平均 60.04,已超全量 Qwen2.5-ViT 的 59.67,60% 保留时 60.93(+1.26);TextVQA 是对压缩最敏感的任务。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 英文 Visual STS(7 个子集) | Spearman 相关系数(平均) | 79.80(中训练+AllNLI 微调);仅中训练 74.72 | 71.99(EVA02-CLIP-bigE-14-plus,最强基线) | +7.81,且参数量约为基线 1/7、训练样本约 1/87 |
| ViDoRe 视觉文档检索(MIEB-lite 子集) | nDCG@5(平均) | 50.94(中训练+微调) | 46.94(SigLIP-so400m-patch14-384) | +4.00;其中 ShiftProject 子集 +16.6(41.60 vs 25.04) |
| ViDoRe(SigLIP 纯视觉公平对比) | nDCG@5(平均) | 48.70(仅中训练,纯视觉管线) | 22.79(SigLIP-so400m 强制纯视觉管线) | SigLIP 因统一视觉处理平均掉 24.15 分,本文视觉-only 几乎无损 |
| 跨语言 Visual STS(10 个语言对) | Spearman 相关系数(平均) | 57.16(预训练+中训练) | 38.88(SigLIP-so400m-patch14-384) | +18.28(约 15%+) |
| 多语言 Visual STS(9 种语言) | Spearman 相关系数(平均) | 67.91(微调后);未微调 65.27 | 45.35(SigLIP-large-patch16-384,最强基线) | +19.92(超过 16%) |
| MLLM 下游任务(9 项:VQA、AI2D、POPE 等) | 平均得分 | 60.04(仅保留 40% 视觉 token) | 59.67(全量 token 的 Qwen2.5-ViT) | 2.5 倍压缩下仍 +0.36;1.11 倍压缩下达 61.26(+1.59) |
局限与改进
作者承认的局限有三:一是训练数据规模小于依赖十亿级 LAION/DataComp 语料的 CLIP/SigLIP 基线,扩大自然图文对部分可能进一步改善视觉锚定;二是在图表密集的科学子集(如 ArxivQA)上竞争力较弱,暗示需要更多科学图、坐标图和图-题对作为预训练数据;三是渲染文本对虽提供可控的版面多样性,但无法覆盖真实世界文本图像的全部噪声模式(扫描件、模糊、遮挡、手写、低质量手机拍摄)。我的补充观察:跨语言 en-ar(英语-阿拉伯语)得分异常低(1.44–6.96),甚至低于多数基线的 10–20,而单语 ko-ko/ar-ar 均正常(50+),说明问题可能出在阿英语向混合渲染或跨语言对质量而非阿拉伯字形感知本身;ArxivQA 在 AllNLI 微调后不升反降(35.81→29.87),暗示该微调对科学图表类查询有副作用;渲染画布固定 224×224 且最多 12 行,单图承载文本量有限,长文档能力依赖推理时高分辨率外推而非训练时见过长文档;VDR 评估仅用 ViDoRe 子集(MIEB-lite 协议),未与 ColPali 等后期交互检索器在全量 ViDoRe 上直接对比。
独立分析的弱点
弱点一:跨语言 en-ar 几乎失效(Spearman 仅 1.44–3.59),而 ar-ar 单语正常(50+),高度怀疑是阿拉伯语(RTL 自右向左)与英语混排时的渲染方向处理、或正样本对本身的翻译质量问题;改进方向是审计渲染引擎的 bidi 文本处理,并补充高质量阿英跨语言对数据。弱点二:图表与科学图理解不足——ArxivQA 仅 29.87–35.81 且微调后下降 5.94 分,说明 AllNLI 微调分布与科学查询失配;改进方向是在中训练中加入 ChartQA 类图-题对,微调时采用混合回放(replay)防止灾难性遗忘。弱点三:渲染域与真实世界差距——参数表(Table 7)中没有透视变换、JPEG 压缩伪影、相机畸变等仿真,面对扫描件和拍照文档可能泛化不佳;改进方向是引入域随机化管线(透视、噪声、色偏、摩尔纹)。弱点四:单图 12 行文本上限限制了每张图的语义密度,超长上下文必须切成多图;改进方向是自适应版面(多栏密排、动态字号)或训练时混入部分更大画布。弱点五:视觉-only 检索在需要复杂推理的查询上可能仍不及 MLLM 驱动的生成式检索器,改进方向是为查询侧配一个轻量文本编码器做混合检索,同时保留像素统一管线的部署简洁性。
未来方向
作者明确提出的方向:把统一像素-文本训练配方(尤其是自然图文对部分)扩展到十亿级规模;引入更多样化的科学图、坐标图和图-题对作为预训练数据;让渲染数据覆盖扫描、手写、低质量拍摄等真实噪声。基于本文成果可自然延伸的方向:其一,光学上下文压缩——本文已证明 80% token 压缩下 ViDoRe 仍超未压缩 CLIP、MLLM 任务 2.5 倍压缩不掉分,可与 Glyph、DeepSeek-OCR 等视觉文本压缩范式结合,把长文本上下文压成极少量视觉 token 喂给 MLLM;其二,把「感知预训练→语义中训练」两阶段课程推广到其他低资源文字系统(天城文、藏文、缅文等),Table 6 的字体库已含部分 Noto 变体;其三,探索空间代理思想在视频帧分辨率课程或遥感多尺度影像上的迁移;其四,系统研究 NaViT 原生分辨率与 2×2 池化的最优压缩比,以及压缩感知的渲染策略(直接按目标 token 预算渲染);其五,将该编码器作为 MLLM 视觉塔做端到端联合训练,打造视觉文档智能体。
复现评估
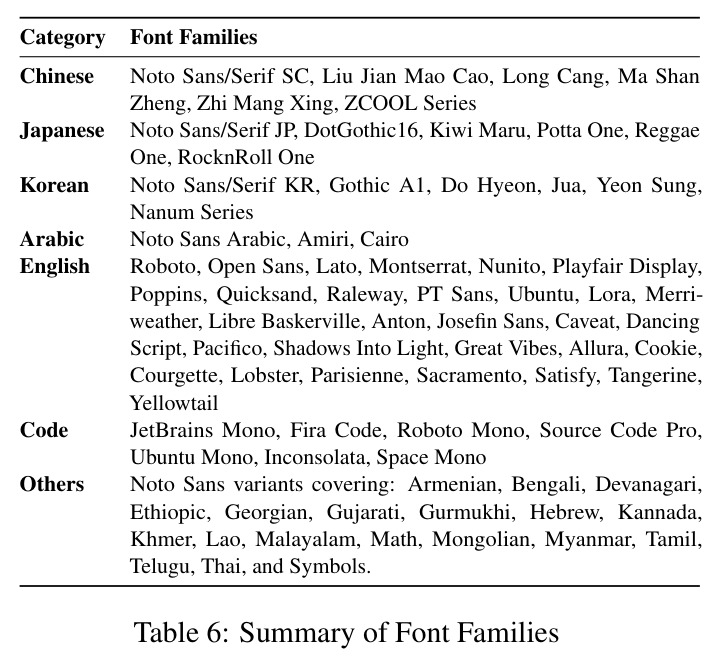
复现条件总体较好。代码与资源已开源(GitHub: Pixel-Linguist/Pixel-Linguist-II)。数据全部来自公开来源:多语言 Wikipedia(6200 万文档,裁剪构造正样本对的方法引 Izacard 等 2021)、LAION-2B(采样 2600 万图文对)、公开文本嵌入训练数据集(2600 万对)、AllNLI(27 万条);渲染引擎配置完整公开——Table 6 给出 393 种字体的语言分布清单(中、日、韩、阿拉伯、英文、代码字体等),Table 7 给出全部渲染超参数(画布 224×224、字号 $U(16,28)$、最多 12 行、DTD 纹理背景概率 0.5、旋转 $[-15^\circ,+15^\circ]$、位置抖动 ±20px、模糊概率 0.2 等)。算力门槛不低:全量训练用 64 张 GPU、全局 batch 32768、DeepSpeed ZeRO 2、共见 2.8 亿样本,属于中等规模工业级训练;但核心科学结论(四大设计原则)来自 13M 样本、batch 12288 的受控消融,学术实验室用少量节点即可复现。MLLM 评测基于 LMMs-Eval 框架,基座 Qwen2.5-7B-Instruct、LLaVA 式两阶段训练(Stage 1 仅训 projector、lr $2.0\times10^{-4}$;Stage 2 全量微调、lr $2.0\times10^{-5}$),配置详尽。总体难度中上:主要成本在多卡训练与渲染工程实现,而非数据获取。
论文图表
全量数据规模下,有/无 2600 万自然图文对训练的两个模型变体在英文 Visual STS、跨语言 Visual STS 与 ViDoRe 各子集上的对比:两者在合成渲染的 Visual STS 上表现接近,但无自然图像的变体在复杂 ViDoRe 基准上性能大幅下滑。
在数据规模上复验 RQ2 的结论:多模态锚定无法靠加大数据规模绕过,自然图文对在任何规模下都是文档理解鲁棒性的必要正则化器,堵住了「规模解决一切」的反驳。