以记忆替代训练:面向 Text-to-SQL 的免微调列表式选择 Replacing Training with Memory: Listwise Selection for Text-to-SQL
用结构化记忆检索与分组置换聚合替代选择器微调,实现免训练的列表式 SQL 候选选择
前置知识
generate–execute–select 流水线
现代 Text-to-SQL 系统的主流架构:生成器(如 Arctic-Text2SQL-R1-7B)先对同一自然语言问题采样 $n$ 条候选 SQL,每条在数据库上执行得到结果表、空结果或报错,再由一个选择器(selector)从中挑出最可能正确的一条。候选生成与执行只做一次并缓存,选择器的质量直接决定最终执行准确率。
本文全部设计围绕该流水线的最后一步展开,理解候选池、执行信号与选择器的分工,才能定位记忆与置换策略各自补的是什么。
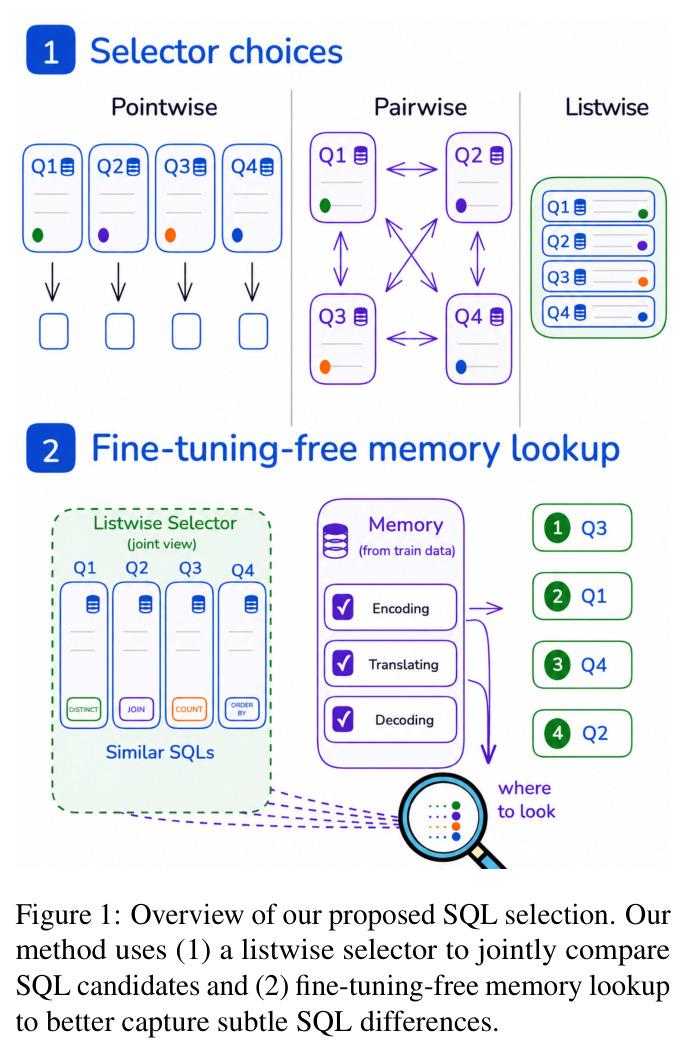
pointwise / pairwise / listwise 选择范式
按一次评估的候选数量划分:pointwise 独立为每条候选打分,缺乏横向比较,评分不一致;pairwise 逐对比较,比较次数随候选数 $n$ 平方增长($O(n^2)$),如本文实验中每题最多 184.59 次调用;listwise 让模型在单个提示里联合对比全部候选并输出排序,一次调用即可捕捉细微差异。
本文的核心主张是 listwise 是精度与开销的最佳折中,而其两大缺陷(缺显式判据、位置偏差)正是记忆检索与置换聚合要解决的问题。
lost-in-the-middle 位置偏差
长上下文 LLM 对输入中部信息的利用率显著低于开头和结尾。反映到列表式排序任务上:同一候选换个位置就可能得到不同排名,输出不稳定。已有多数投票、全局置换自一致性(Tang et al., 2024)等缓解手段,但理想情况下需多达 $O(n!)$ 次调用才能穷尽排列。
位置偏差是 listwise 选择器通常需要微调才能克服的根本原因之一,本文的贡献就是用分组置换在推理期替代这一训练目标。
Encoding–Translating–Decoding 分解
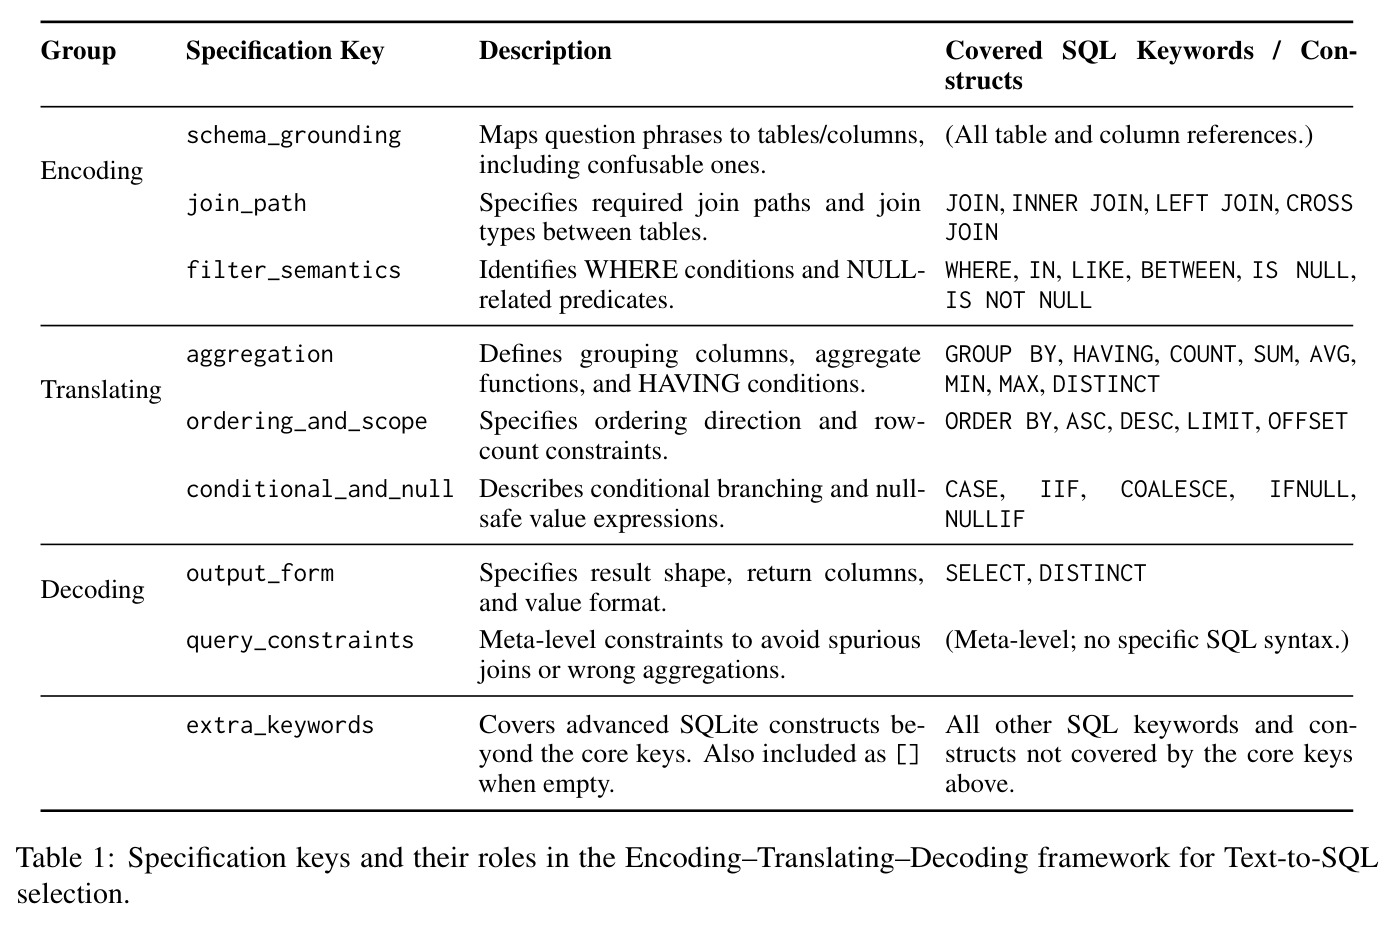
Deng 等人(2022)对自然语言到 SQL 语义鸿沟的三段分解:encoding 指理解自然语言语义并锚定到数据库模式元素;translating 指把语义映射为 SQL 操作(过滤、聚合、排序等);decoding 指最终输出形态的构造与校验。本文据此把每条结构化记忆组织成三组共九个规格键(Table 1)。
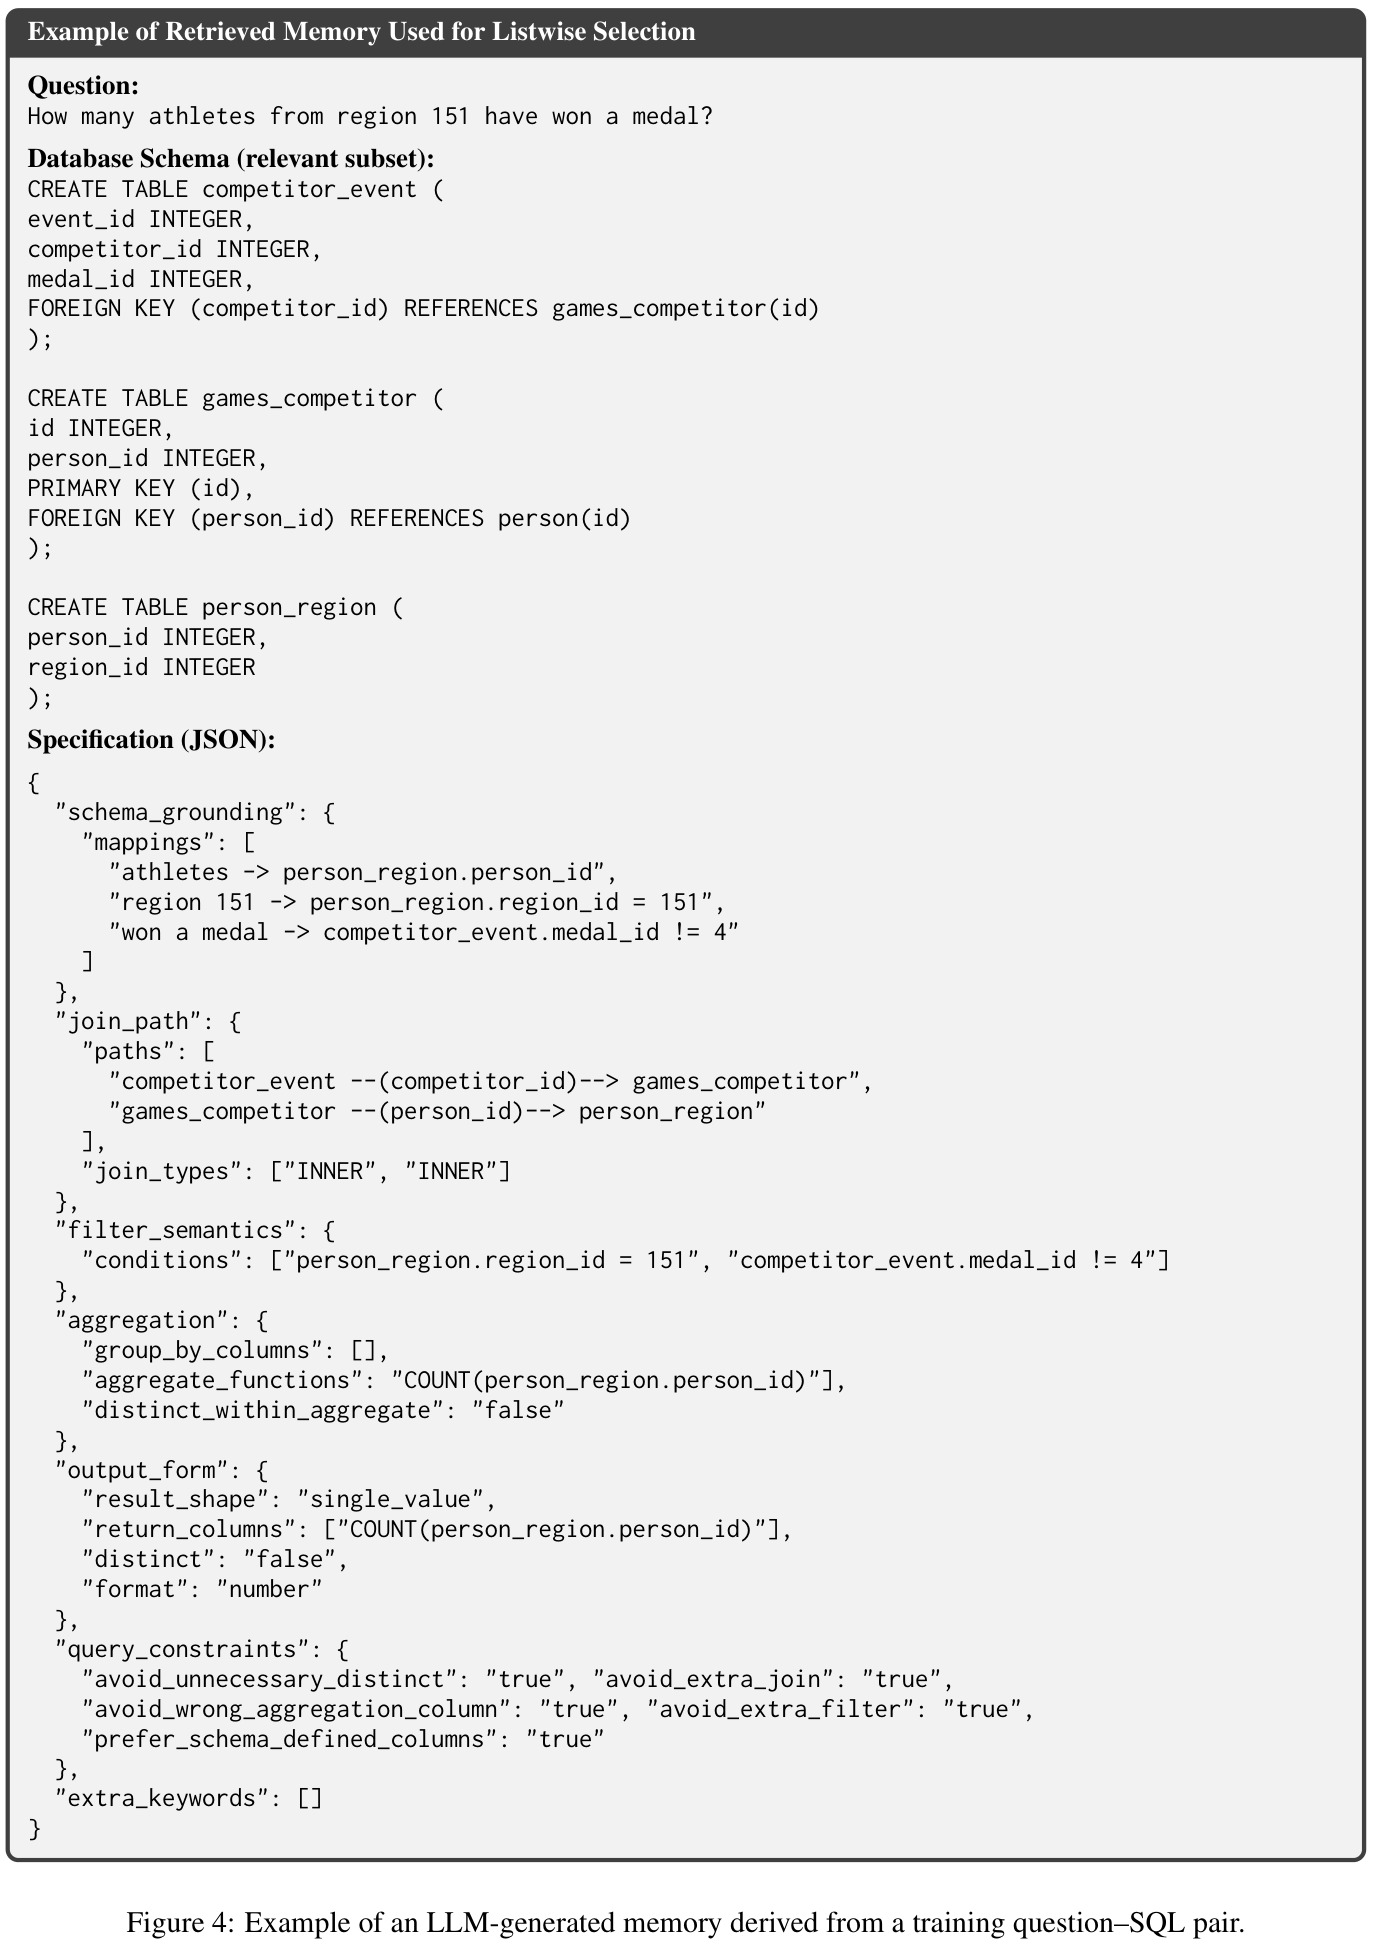
记忆的具体结构完全按该框架设计,看懂它才能理解 Figure 4 记忆样例里每个字段到底在“教”选择器什么判据。
执行准确率(execution accuracy)
Text-to-SQL 的标准评测指标:预测 SQL 与金标 SQL 在数据库上执行结果完全一致即判对,不要求 SQL 文本精确匹配。本文所有主表均以执行准确率(%)为主要指标,并辅以每题平均选择器 LLM 调用次数(Calls)与每题输入 token 数(Tokens)衡量效率。
论文几乎所有结论(精度提升与开销下降的倍数)都建立在这两类指标上,读表时必须先分清这两个维度。
密集检索与 bge-m3
用双塔编码器把问题和候选记忆映射为稠密向量,按相似度取 top-k。bge-m3(Chen et al., 2024)是多语言多功能嵌入模型。本文不固定 $k$,而是按选择器上下文上限尽量多放记忆,为列表式比较提供多样化视角;EHRSQL 无训练集时改用 BIRD+Spider 训练集混合构建记忆库。
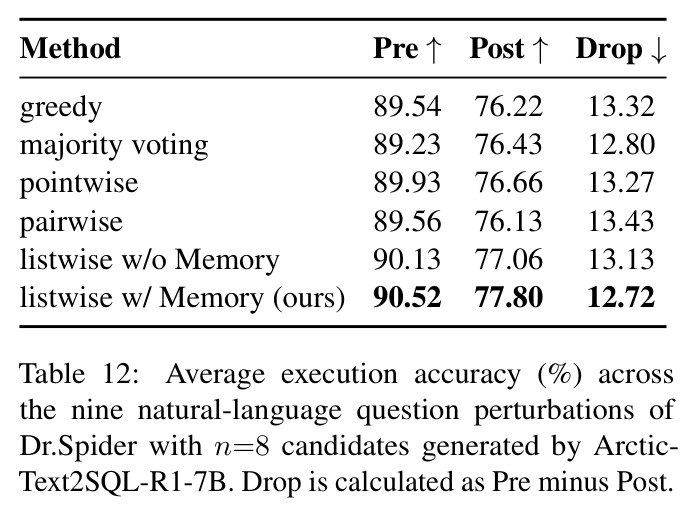
记忆检索是“以检索替代训练”的第一半,检索质量决定判据相关性,Dr.Spider 扰动实验(Table 12)专门验证了这一点。
研究动机
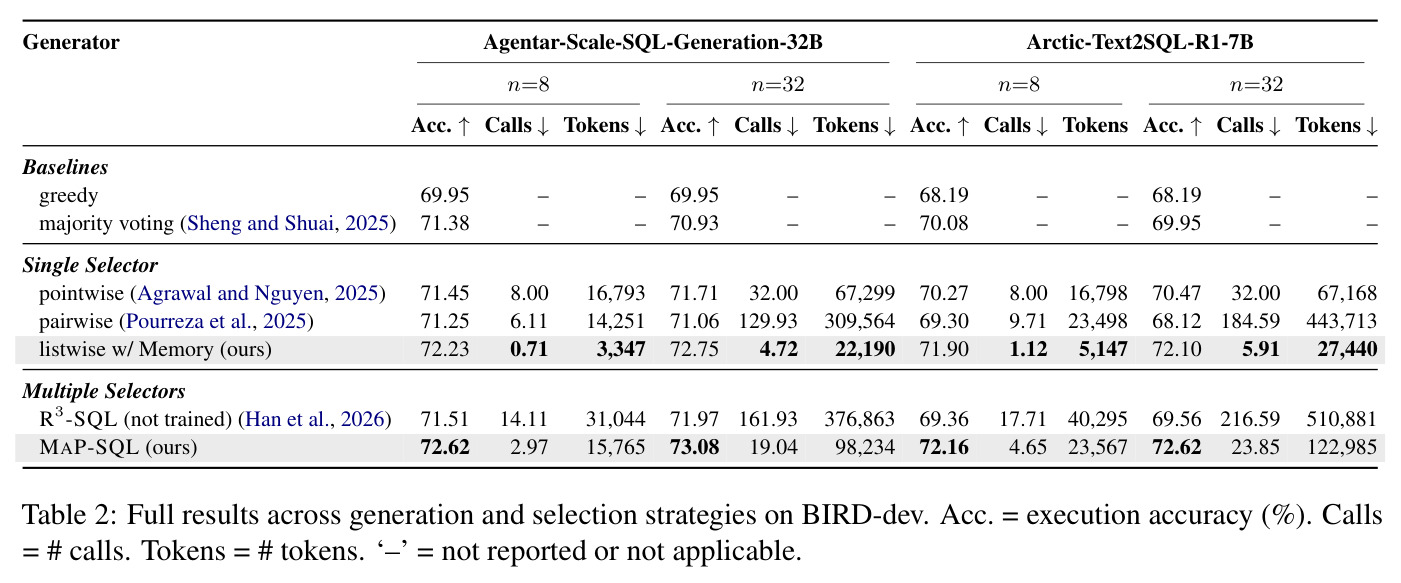
现代 Text-to-SQL 系统普遍采用 generate–execute–select 流水线:生成器对同一问题采样 $n$ 条候选 SQL(本文用 $n=8$ 和 $n=32$),逐条执行后由选择器挑出最优者。现有选择方案各有硬伤:多数投票会被更大的错误组淹没,BIRD-dev 上 n=32 的准确率(70.93%)反而低于 n=8(71.38%);pointwise 选择器独立打分,丢失候选间横向差异,导致评分不一致;pairwise 比较次数随候选数平方增长,BIRD-dev n=32、Arctic 生成器下每题平均 184.59 次调用、443,713 个输入 token。listwise 选择在单个提示里联合对比全部候选,能捕捉上述范式遗漏的细微差异,但训练 listwise 选择器代价高昂:每个训练样本都带多条候选 SQL 及其执行结果,输入上下文极长、算力开销巨大。更麻烦的是长输入会触发 lost-in-the-middle 位置偏差,候选换个位置就可能换结论。高精度 listwise 选择因此长期被训练成本与稳定性双重卡住。
本文的目标是本文要构建一个完全免微调的列表式选择器 MAP-SQL(Memory And Permutation for listwise SQL selection),把微调承担的两个职能整体搬到推理期。其一,选择判据:微调本可以把“如何比较候选”写进模型参数,改为从训练数据蒸馏出可复用的结构化记忆——记录自然语言如何映射到模式元素、SQL 操作和期望输出,测试时按问题相似度检索,作为显式决策标准供选择器核对每条候选。其二,位置偏差缓解:微调本可以让模型对输入顺序鲁棒,改为在多组候选排列上聚合排序结果,并利用执行结果信号把置换空间从 $O(n!)$ 压缩到 $O(g!)$(组数 $g$ 远小于 $n$)。验收标准非常明确:在 BIRD-dev、Spider-test、EHRSQL 三个基准、两个生成器、两种候选池规模下,用完全相同的候选池在精度上超越此前最强的选择器方法 R3-SQL,同时大幅减少调用次数与 token 消耗,并与 R3-SQL 的微调版选择器直接正面对比。
与已有工作不同的是,已有工作把两件事割裂开来。R3-SQL 等方法靠训练把选择行为压进参数,但其微调选择器未公开、换模型就要重训;Tang 等人 2024 年的置换自一致性在推理期缓解位置偏差,却因缺乏候选重要性先验而对全部候选全局乱序,需要大量排列才稳定,理想代价高达 $O(n!)$;MemGPT 式方案存放完整交互历史,在有限上下文里根本放不下;检索排序领域的优化工作也未针对这一问题。本文的独特切入点是把“学什么”显式化、把“怎么比”结构化:判据不进参数,而是拆成模式锚定、连接路径、排序与行数约束、输出形态等可检索的记忆条目,随取随用且对同窗所有候选一致生效;置换只在执行结果等价组内部进行,组间保留多数投票这一可靠先验,再用 $t$ 分布置信度估计决定何时调用 pointwise 平票裁决。两个原本必须靠微调获得的能力,由此变成纯推理期的检索与聚合问题。
核心方法
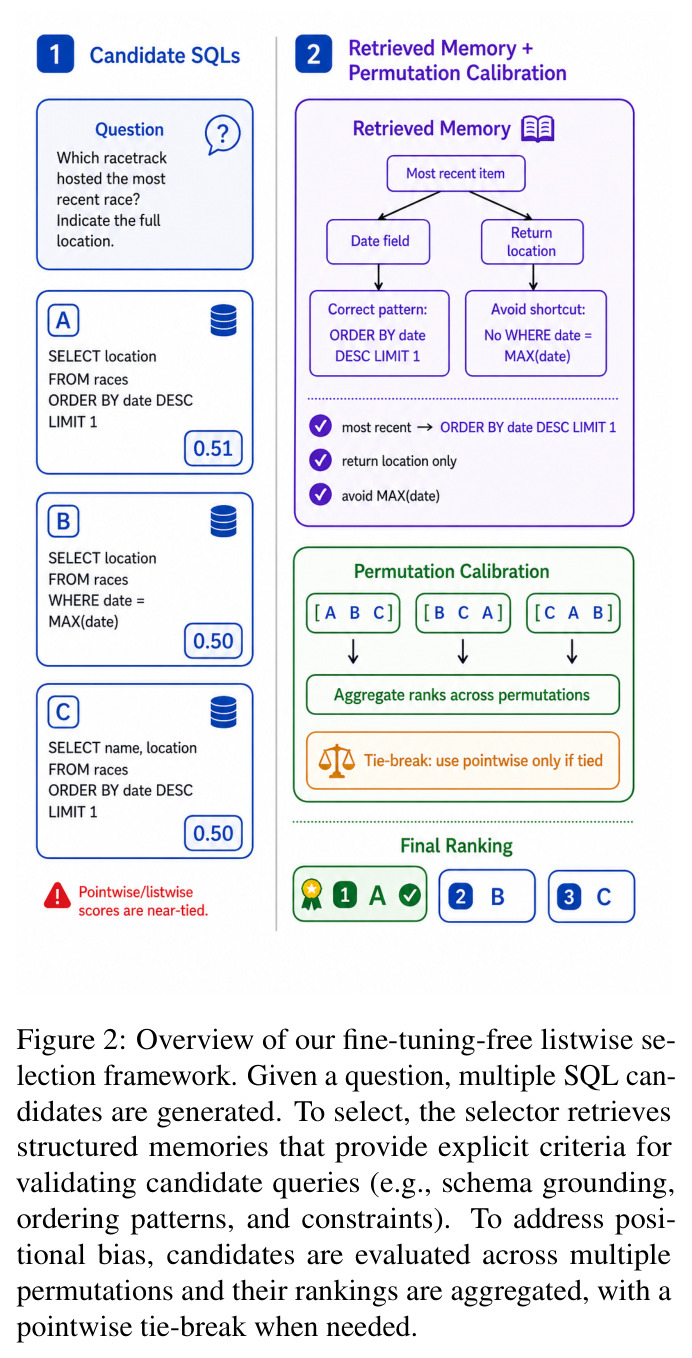
直觉上,选择器选错 SQL 往往因为缺两样东西:一套“对的标准”来判断哪条候选更贴合问题,以及一个“稳的姿态”来抵抗候选顺序的干扰。MAP-SQL 用检索补前者、用置换补后者,整体分四步。第一步记忆生成:对训练集中每个三元组 $(x_j, S_j, q_j^*)$,用与选择器相同的 LLM 按 Figure 5 提示生成结构化记忆 $m_j$,按 encoding–translating–decoding 三组九键组织,只保留金标 SQL 中真实出现的键。第二步记忆检索:测试问题 $x$ 经 bge-m3 编码,按相似度取 top-k 记忆集合 $M(x)$,数量以填满选择器上下文为限。第三步列表式选择:候选按执行结果频次降序初始化(多数投票先验),滑窗 $w=8$、步长 $s=4$ 从后向前,每窗联合排序,检索记忆在每个提示只放一份,执行结果全局缓存复用。第四步偏差缓解与聚合:把执行结果相同的候选归组,组间定序、组内打乱,共跑 $K$ 次,按平均排名 $\mu_i$ 重排,再用 $t$ 分布置信度 $P(a>b)$ 判断 top-1 是否稳赢 top-2,低于阈值 $\tau=0.95$ 才调用 pointwise 奖励模型平票裁决。
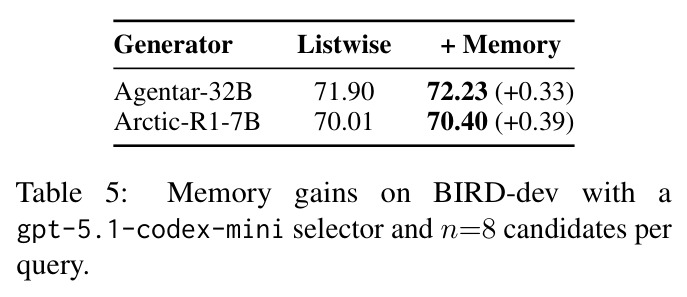
核心思想是“以记忆换判据、以分组置换换稳定”,把微调的两个训练目标整体搬进推理期。第一,判据参数化 → 记忆检索。与把选择行为压进权重的 R3-SQL 不同,也与存放完整历史的 MemGPT 式方案不同,本文把每条训练样本蒸馏成一条紧凑、结构化、可检索的“评审细则”:自然语言短语锚定到哪些表列、需要什么连接路径、ORDER BY 加 LIMIT 表达什么意图、输出应该是什么形态。检索到的记忆对同窗所有候选一致生效,等价于发给选择器一份统一的评分标准。第二,全局置换 → 分组置换。Tang 等人对所有候选全局乱序,是因为缺乏重要性先验、怕噪声排序误导聚合;而 Text-to-SQL 中执行结果频次(多数投票)是可靠的正确性先验,因此本文按执行结果分组,大组在前、组间定序,只打乱组内,把置换空间从 $O(n!)$ 降到 $O(g!)$($n=8$ 时平均组数 $g\approx 2$),既保留多数信号又消除组内位置偏差。Table 5 进一步表明:即便换成 gpt-5.1-codex-mini 这样的强代码模型做选择器,显式记忆仍带来 +0.33/+0.39 点增益,说明记忆是补充而非重复模型内部推理。
方法步骤详情
步骤一,记忆生成:输入训练三元组 $(x_j, S_j, q_j^*)$ 与金标 SQL 中检出的额外 SQLite 构造,按 Figure 5 提示让 LLM 输出扁平 JSON 记忆,按 encoding–translating–decoding 分为三组九个规格键(逐键职责见 Table 1),规则是只写金标 SQL 中真实出现的键。步骤二,记忆检索:测试问题 $x$ 经 bge-m3 编码取相似度 top-k 记忆,$k$ 以选择器上下文上限为准,EHRSQL 无训练集则改用 BIRD+Spider 混合记忆库。步骤三,列表式选择:输入 $(x, S, M(x), \{(q_i, e_i)\})$,候选按执行结果频次降序初始化,滑窗 $w=8$、步长 $s=4$ 从后向前滑动,每窗提示包含检索记忆一次,输出局部排序 $\pi_t$ 并回写 $R[W_t] \leftarrow \pi_t$,执行结果缓存复用。步骤四,分组置换聚合与平票裁决:执行结果相同者归组,组间定序、组内随机,$K$ 次运行后按平均排名 $\mu_i = \frac{1}{K}\sum_k r_i^{(k)}$ 重排;对 top-1 $a$ 与 top-2 $b$ 以配对秩差 $d_{a,b}^{(k)} = r_b^{(k)} - r_a^{(k)}$ 计算置信度 $P(a>b) = T_{K-1}\left( \bar{d}_{a,b} / (s_{a,b}/\sqrt{K}) \right)$,$P < \tau = 0.95$ 判平票,仅对平票候选用 Contextual-RM-32B 做 pointwise 裁决。
技术新颖性
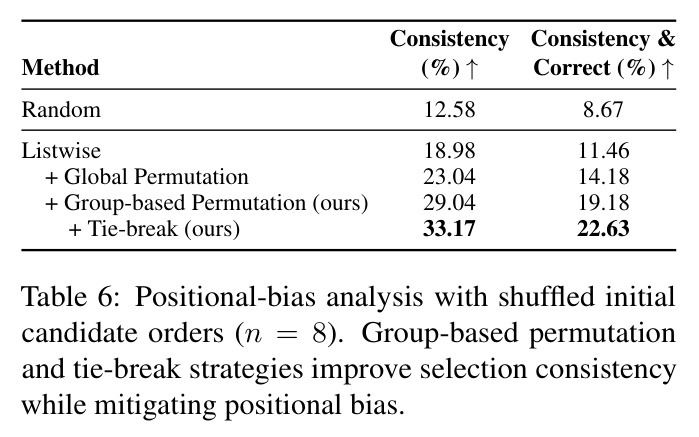
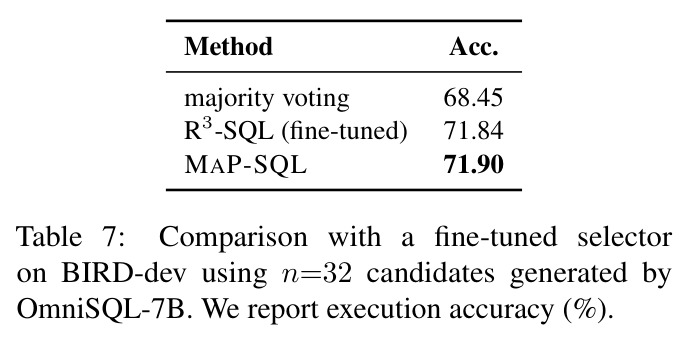
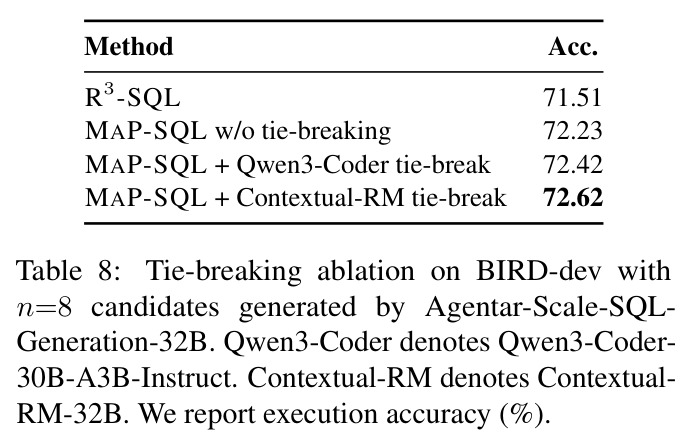
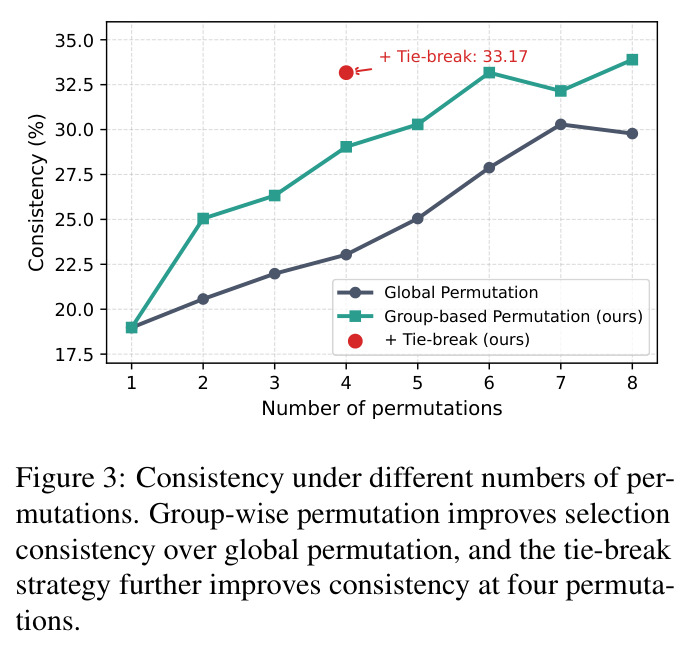
技术新颖性有三点。其一,记忆的形态新:不是轨迹回放而是“评审模板”——Table 1 的九个规格键把选择所需知识拆成可逐条核对的检查项,覆盖从短语锚定到输出形态的全链条。其二,置换策略新:首次利用执行结果等价类做分层置换,位置偏差分析(Table 6)显示组内置换把一致性从全局置换的 23.04% 提到 29.04%(+6.0 点),Figure 3 显示其饱和更快,因为固定组间顺序避免了噪声排列误导聚合。其三,效率设计新:pointwise 打分只在平票时介入(Table 8 显示不用奖励模型也有 72.23%),执行信号同时用于分组、初始化排序与剪枝,调用复杂度从 pairwise 的 $O(n^2)$ 降到约 $O(N)$–$O(N\log N)$,最多省 27.92 倍输入 token。与 R3-SQL 微调版的正面对比(Table 7)表明免训练方案 71.90% 已略超 71.84%,说明推理期策略足以替代该场景下的选择器训练。
实验结果
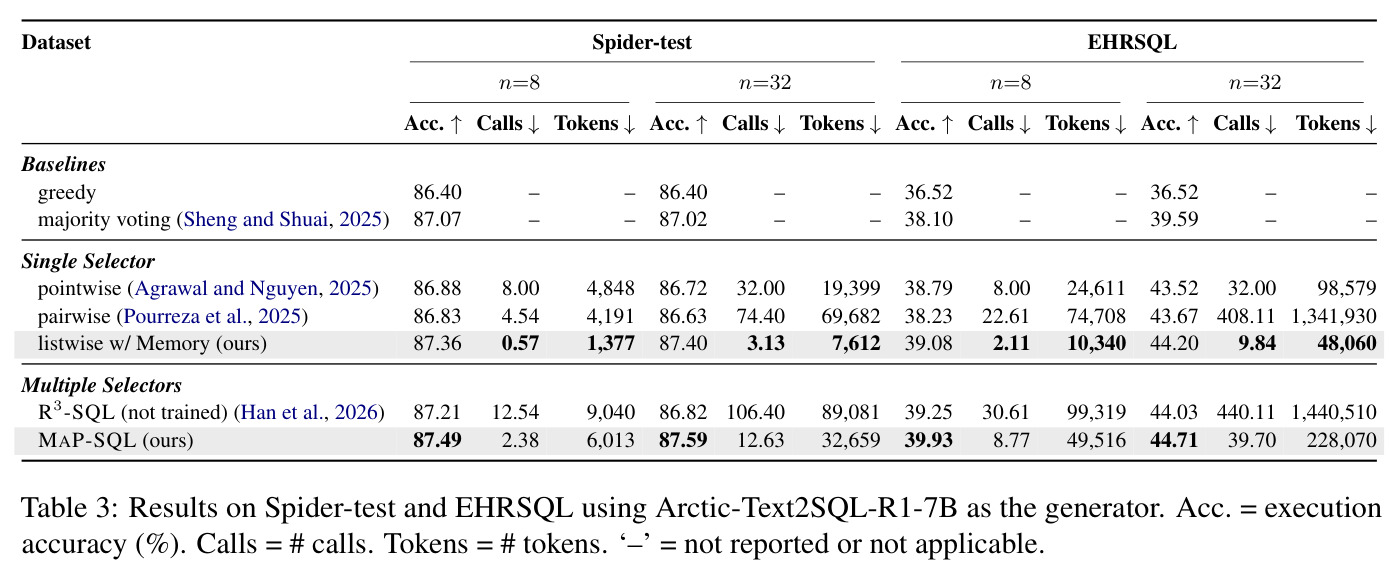
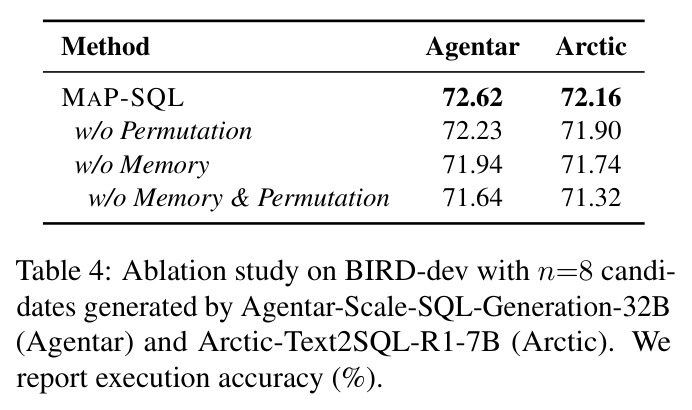
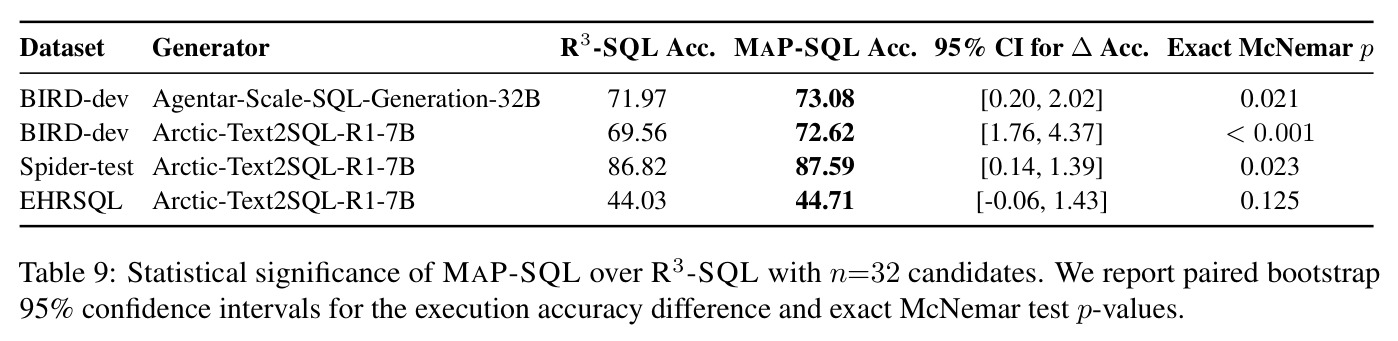
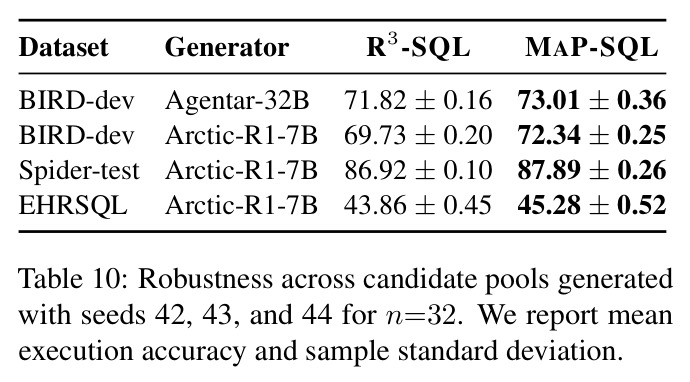
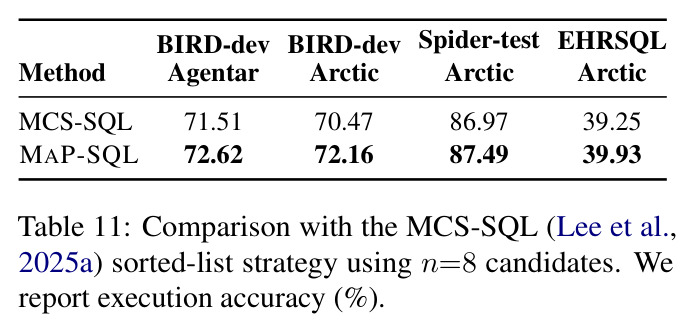
主实验覆盖 3 个基准 × 2 个生成器 × 2 种候选池。精度上:主基准 BIRD-dev n=32、Agentar 生成器时 73.08%,超 R3-SQL(71.97%)1.11 点、超 pairwise(71.06%)2.02 点;Arctic n=32 时 72.62% 对 69.56%(+3.06,95% CI [1.76, 4.37],McNemar p<0.001);Spider-test n=32 为 87.59% 对 86.82%(+0.77,p=0.023);EHRSQL n=32 为 44.71% 对 44.03%(+0.68,p=0.125,统计不确定)。摘要汇总均值:三基准分别 +2.02/+0.53/+0.68 点,少 6.54×/6.85×/7.29× 次调用、2.92×/2.12×/4.16× token。效率上:同设置下每题 19.04 次调用对 R3-SQL 的 161.93 次;单层 listwise 加记忆每题仅 5.91 次、27,440 token,pairwise 需 184.59 次、约 44 万 token;EHRSQL n=32 时 pairwise 超 134 万 token,listwise 仅 48,060。消融(Table 4):去置换平均降 0.32 点,去记忆降 0.55 点,两组件互补。位置偏差(Table 6):一致性由纯 listwise 18.98% 经全局置换 23.04%、组内置换 29.04% 升至加平票 33.17%(一致且正确 22.63%)。对抗微调选择器(Table 7):OmniSQL-7B 下 71.90% 略超 R3-SQL 微调版 71.84%。鲁棒性(Table 10、12):三种子候选池全面占优,Dr.Spider 扰动后 77.80%、跌幅 12.72 均最优。补充实验(Table 8、11):无奖励模型 72.23%,Contextual-RM 平票 72.62%;对 MCS-SQL 四项设置全胜。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BIRD-dev(n=32,Agentar 生成器) | 执行准确率 (%);每题调用次数 / token | 73.08(19.04 次 / 98,234 token) | R3-SQL 71.97(161.93 次 / 376,863 token);pairwise 71.06(129.93 次) | +1.11 点(对 R3-SQL)、+2.02 点(对 pairwise),调用约省 8.5× |
| BIRD-dev(n=32,Arctic 生成器) | 执行准确率 (%) | 72.62(23.85 次 / 122,985 token) | R3-SQL 69.56(216.59 次 / 510,881 token) | +3.06 点,95% CI [1.76, 4.37],McNemar p<0.001;省 9.07× 调用、4.16× token |
| Spider-test(n=32,Arctic 生成器) | 执行准确率 (%) | 87.59(12.63 次 / 32,659 token) | R3-SQL 86.82(106.40 次 / 89,081 token) | +0.77 点,95% CI [0.14, 1.39],p=0.023 |
| EHRSQL(n=32,Arctic 生成器) | 执行准确率 (%) | 44.71(39.70 次 / 228,070 token) | R3-SQL 44.03(440.11 次 / 1,440,510 token) | +0.68 点,CI [-0.06, 1.43],p=0.125(统计不确定);省 11.09× 调用 |
| BIRD-dev(OmniSQL-7B 生成器,n=32,对比微调选择器) | 执行准确率 (%) | 71.90(免微调) | R3-SQL 微调选择器 71.84;多数投票 68.45 | +0.06 点,免训练即追平微调选择器 |
| 位置偏差一致性分析(BIRD,n=8,乱序输入) | 一致性 (%) / 一致且正确 (%) | 组内置换+平票:33.17 / 22.63 | 纯 listwise 18.98 / 11.46;全局置换 23.04 / 14.18 | 比全局置换高 10.13 点一致性,比纯 listwise 高 14.19 点 |
| Dr.Spider 问法扰动鲁棒性(n=8,Arctic) | 扰动后执行准确率 (%) / 跌幅 | listwise+记忆:77.80 / 12.72 | greedy 76.22 / 13.32;无记忆 listwise 77.06 / 13.13 | 扰动后准确率最高、跌幅最小 |
局限与改进
作者承认的局限:其一,绝对精度 70–72% 落后于使用专有模型的 SOTA 系统(75–76%),瓶颈在生成器质量而非选择策略,论文定位是同候选池下比较选择器;其二,面向数百张表的企业级数据库时依赖上游 schema linking 先剪枝模式,模式规模管理超出本文范围;其三,滑动窗口之外的列表式协调策略(TourRank、setwise ranking)留作未来工作。我补充的观察:位置偏差远未根除——最优配置下一致性也只有 33.17%,且置信度只建模 top-1 与 top-2 之争,中间排名的稳定性无从保证;平票裁决要发挥全部收益(72.23%→72.62%)依赖额外的 Contextual-RM-32B 奖励模型,部署成本随之增加;EHRSQL 的记忆库只能用 BIRD+Spider 训练集混合拼凑,跨域记忆检索为何有效缺少单独消融;选择器只验证了 Qwen3-Coder 系(附录加测 codex-mini),跨模型家族与规模的泛化证据有限;EHRSQL 上统计检验不显著,说明小数据集上增益波动较大。
独立分析的弱点
第一,记忆质量无校验回路:每条记忆由 LLM 一次性生成直接入库,若金标 SQL 有歧义或模型幻觉出错误映射(如 schema_grounding 写错列),高相似度检索会系统性误导整个窗口的判断。改进方向:入库前用“记忆反推 SQL 再与金标比对”做自洽校验,并记录命中统计与置信度支持淘汰。第二,执行结果分组在“碰巧同结果”时失效:语义不同的 SQL 可能返回相同结果表,被强行归组后组内置换失去区分信号;空结果或报错组也会退化。改进方向:对结果做更细粒度的等价刻画(列名、行序、数值容差),对无区分度的组降级为 pointwise。第三,置信度模型较粗糙:$t$ 分布隐含秩差近似正态的假设,$K$ 较小(如 4 次)时方差估计不稳,且只建模 top-1 与 top-2 之争。改进方向:改用序统计量或贝叶斯排名模型,输出全列表置信度并据此自适应分配调用预算。第四,收益依赖候选池质量:生成器较弱时组间差异小,置换增益被压缩。改进方向:把选择器信号反馈给生成器做定向重采样,与 R3-SQL 的 resampling 思路结合。第五,固定窗口 $w=8$ 在 $n=32$ 时窗口间信息不互通,跨窗口比较只能靠回写顺序间接传递。改进方向:引入层级聚合或锦标赛式协调(TourRank)。
未来方向
作者明确提出两个方向:探索比滑动窗口更高级的列表式协调机制,如 TourRank(Chen et al., 2025,锦标赛式策略)与 set-based ranking(Zhuang et al., 2024,按集合而非列表喂给模型);以及把记忆引导选择与分组置换推广到 Text-to-SQL 之外的任务。在其成果之上还可延伸:其一,记忆库持续演化——让选择与平票裁决的结果回流,生成新记忆或修正旧记忆,形成自改进闭环,与同组的 episodic memory 检索工作(Lee et al., 2026)一脉相承;其二,把“多候选 + 可执行验证”的分组置换范式迁移到代码补丁选择、Agent 轨迹选择、程序合成等场景,凡是能廉价执行对比的生成任务都适用;其三,置信度驱动的推理预算分配——$P(a>b)$ 高的问题少跑置换、低的问题多跑,把 n=32 下每题约 19–24 次调用进一步压到自适应水平;其四,与 schema linking 端到端联合训练或联合推理,消除企业级场景对上游剪枝的依赖;其五,用专有模型候选池检验选择增益是否随候选质量提高而保持,回应绝对精度落后的质疑。
复现评估
复现条件在同类工作中属于较好水平。代码已开源(github.com/ldilab/MAP-SQL);三个基准全部公开(BIRD-dev 1,534 题、Spider-test 2,147 题、EHRSQL 1,008 题),记忆库直接从各基准训练集构建,构建提示模板在 Figure 5 完整公开。模型全部可获取:选择器 Qwen3-Coder-30B-A3B-Instruct、检索器 bge-m3 开源,Contextual-RM-32B 为公开奖励模型,gpt-5.1-codex-mini 走 API;硬件仅需单张 NVIDIA RTX PRO 6000。关键超参数齐全:窗口 $w=8$、步长 $s=4$、平票阈值 $\tau=0.95$、候选数 $n\in\{8,32\}$,列表式与 pairwise 提示分别在 Figure 7、8 公开。需注意的坑:R3-SQL 与 MCS-SQL 基线均为作者复现(原始模型未发布),数字可能与原论文报告有出入;EHRSQL 记忆库须照作用 BIRD+Spider 混合构建;置换实验涉及随机性,需固定随机种子才能对齐 Table 10。总体属中等偏易的复现难度,有 30B 级开源模型单卡推理资源即可完成主实验。
论文图表
记忆生成的完整提示模板:输入问题、数据库模式、金标 SQL 与自动检出的额外 SQLite 构造,输出扁平 JSON;规则是只包含金标 SQL 中真实出现的键,extra_keywords 恒存在(可为空数组)。
复现记忆生成的直接材料,也解释了 extra_keywords 强制覆盖机制的实现方式。
定性案例:问两个人谁更受欢迎,三条候选都能执行且结果看似合理——(A) 返回人名、(B) 返回帖子标题、(C) 返回人名加浏览数。检索到的 output_form 记忆要求只返回被查实体的名字列,使正确候选 (A) 从 18/32 位升至第一。
具体展示记忆如何裁决执行结果无法区分的近平候选,是方法有效性的最生动证据。
列表式选择器的完整提示:包含模式、问题、证据(hint)、各候选 SQL 及其执行结果和可选分数,要求模型只输出 [A] > [B] > ... 形式的排序,不做任何解释。
复现主方法的核心工程细节,输出格式约束与记忆插入位置都在此体现。
pairwise 基线(CHASE-SQL 风格)的完整提示:给定两条候选的 SQL 与执行结果,要求模型只输出 A 或 B 指出正确者。
说明 pairwise 基线的实现方式,保证对比实验的公平性与可复现性。