S3Gym:评估 LLM 能否将自测与自判转化为自我改进的交互式基准 S3Gym: Can LLMs Turn Self-Testing and Self-Judging into Self-Improvement?
七游戏交互基准,检验 LLM 能否把交互经验经自测自判转化为可靠自我改进
前置知识
上下文学习(In-Context Learning, ICL)
LLM 不更新任何参数,仅通过在提示中附带示例、历史轨迹或规则文本就改变后续行为。模型把提示内容当作条件信息在推理时“现学”任务模式,能力受上下文窗口长度限制——长轨迹会挤占预算、稀释注意力。
S3Gym 的 History ICL 路径就是把带自评分的原始交互轨迹直接序列化塞进后续上下文(上限 10 万 token),是三条经验融入路径中最基线的一种,理解 ICL 才能理解它的优劣。
Reflexion 与经验摘要记忆
Reflexion 提出“言语强化学习”:智能体失败后用自然语言反思原因,把反思文本附入下次尝试的提示,从而不更新参数就改进行为;Voyager 进一步把技能沉淀为可复用库;ReasoningBank、Tree-of-Experience 等则把轨迹压缩为可迁移的策略与失败模式。
本文的 Summary Memory 路径正是这一流派:把打分后的轨迹压缩为“要保留的策略、要避免的错误、下轮方向”三元组摘要,摘要何时有效是论文检验的核心问题之一。
LLM-as-a-Judge 与自我评判(Self-Judging)
让 LLM 充当评估者给输出打分。已知这类判断存在偏见、校准误差与推理局限:JudgeBench 等审计发现 LLM 裁判识别因果关键步骤的能力不比随机好。当评估信号来自模型自身时,错误判断会把有害经验当宝、把有价值经验扔掉。
S3Gym 把自我评判作为一等公民来测:智能体每步必须同时输出动作和自评分数,并与环境验证器真值对比,论文据此量化判断可靠性及其与改进的耦合关系。
STaR/ReST 式自生成数据微调(SFT)
STaR、ReST、Re-ReST 让模型自己产生推理轨迹,筛选正确或高质量者作为监督数据微调自身,形成“生成—过滤—训练”的迭代自提升循环。风险在于错误标注的轨迹会被固化进参数,覆盖原本正确的行为。
S3Gym 的 Training 路径遵循同一思路:高分动作留作正例、低分动作过滤或替换为修正动作后做 SFT,实验显示其收益(Trust Evolution 大涨)与负迁移(PvZ 23→6)并存。
Held-out 评估与探索-利用分离
Held-out 指评估使用与训练/探索不相交的数据或条件。探索-利用分离源自强化学习与经验学习理论:先在宽松环境里试探策略,再在更严格、未见过的条件下检验所学是否可迁移,防止把“记住种子”误当成“泛化能力”。
S3Gym 每个游戏都设探索(宽松规则)与评估(严格规则、不相交随机种子)两套配置,评估轨迹不回流经验库,这是整个基准能测出“真改进”的关键设计。
AUC+ 与 NABA 指标
AUC+ 是评估分数曲线高出初始基线的正面积:$\mathrm{AUC}^+ = \int_0^{30} \max(0, y(x) - y_0)\,dx$,衡量持续改进而非瞬时峰值;NABA 再除以 $\max(y_0, \epsilon)$ 做归一化,便于跨不同初始水平的运行之间比较。
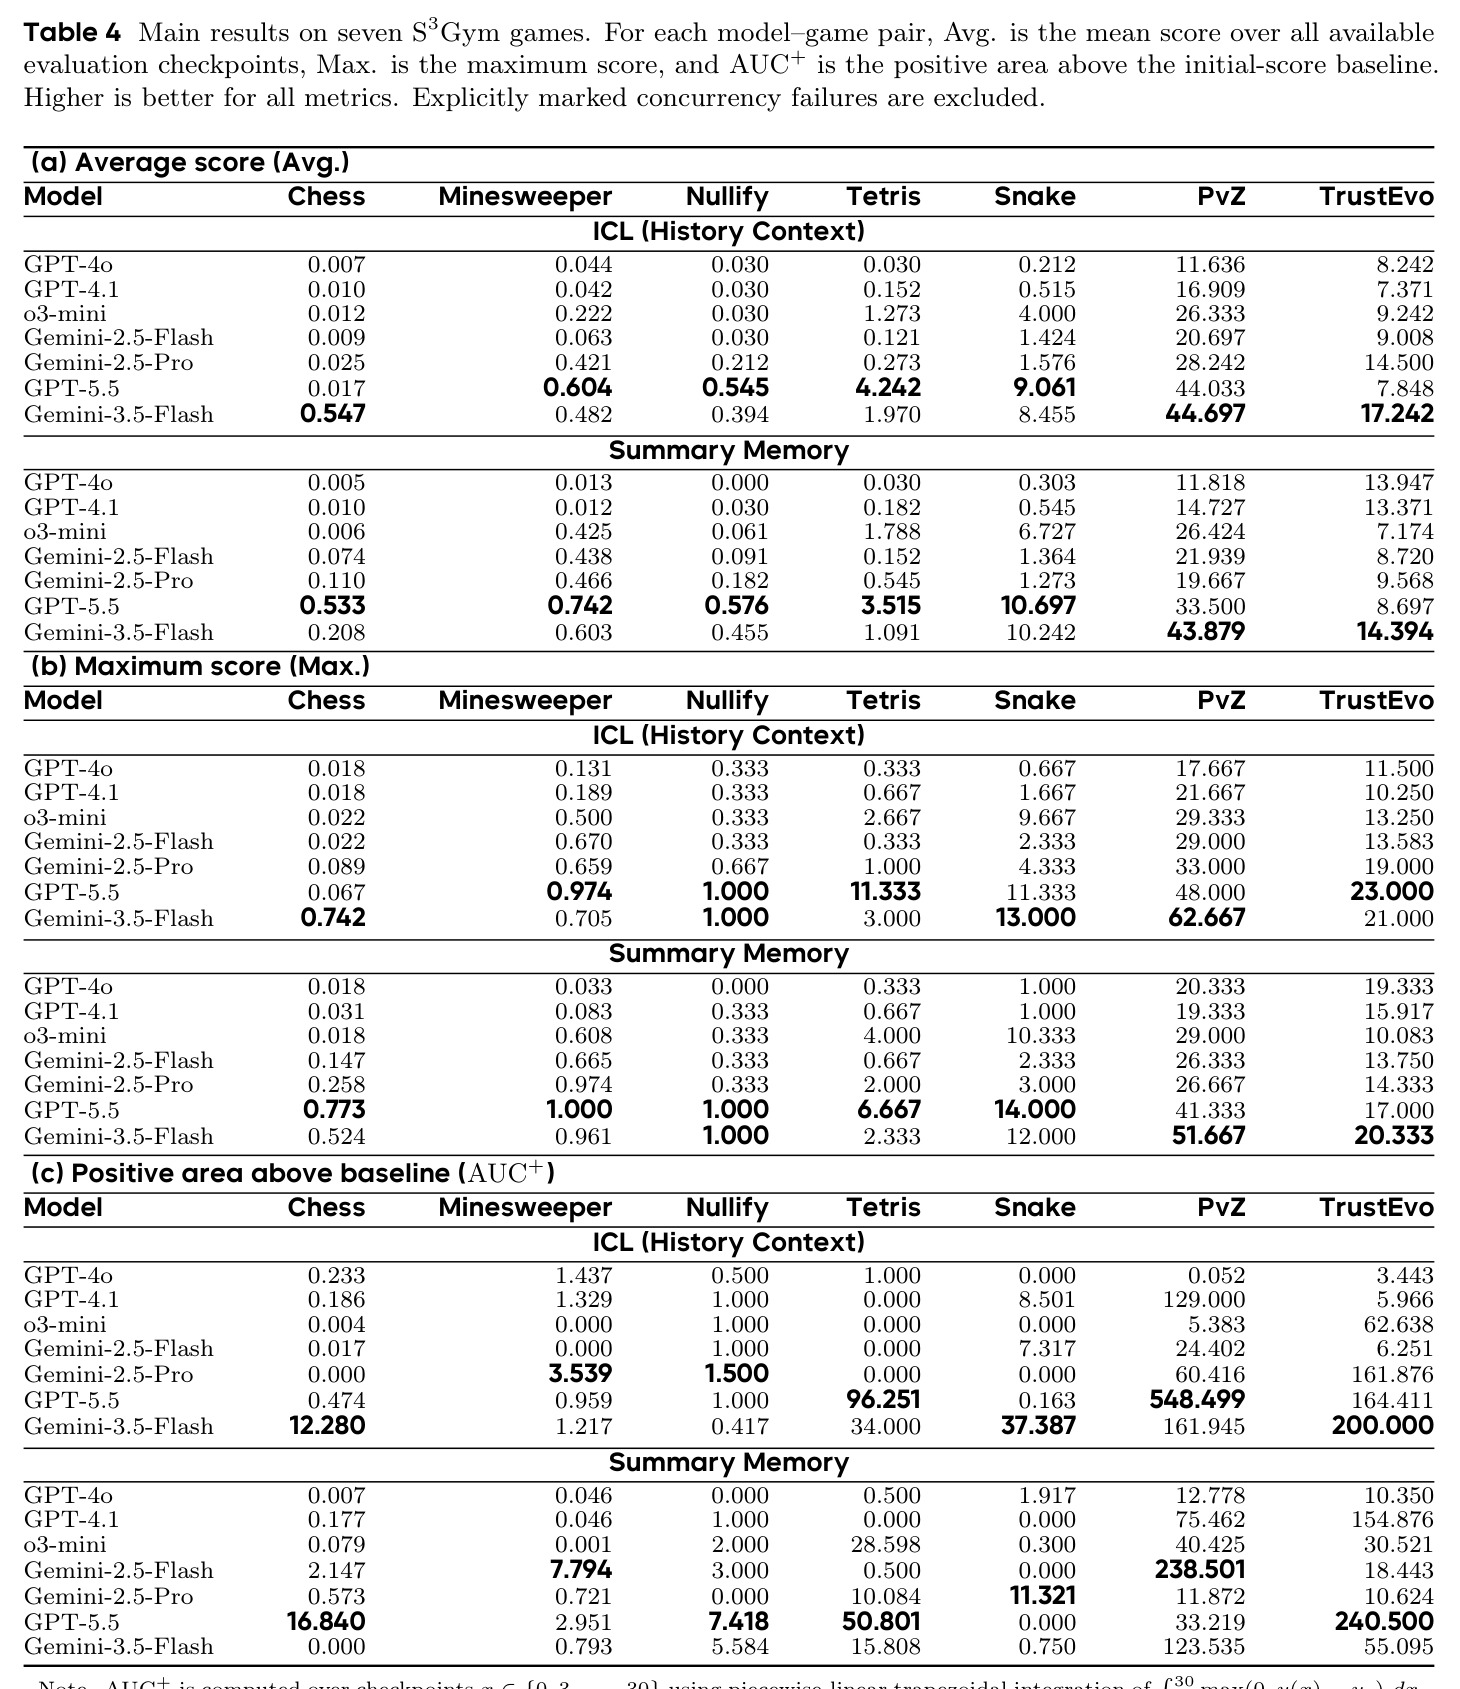
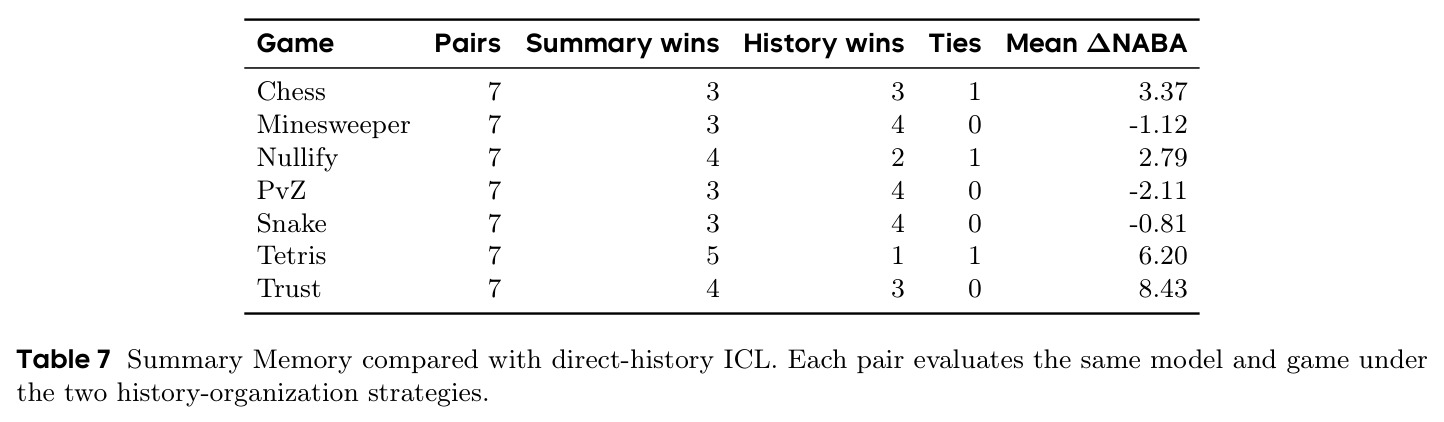
论文全部主结果(Avg/Max/AUC+)与摘要-历史对比(ΔNABA)都用这些指标,不懂其定义就无法正确解读表格中“改进”到底指什么。
研究动机
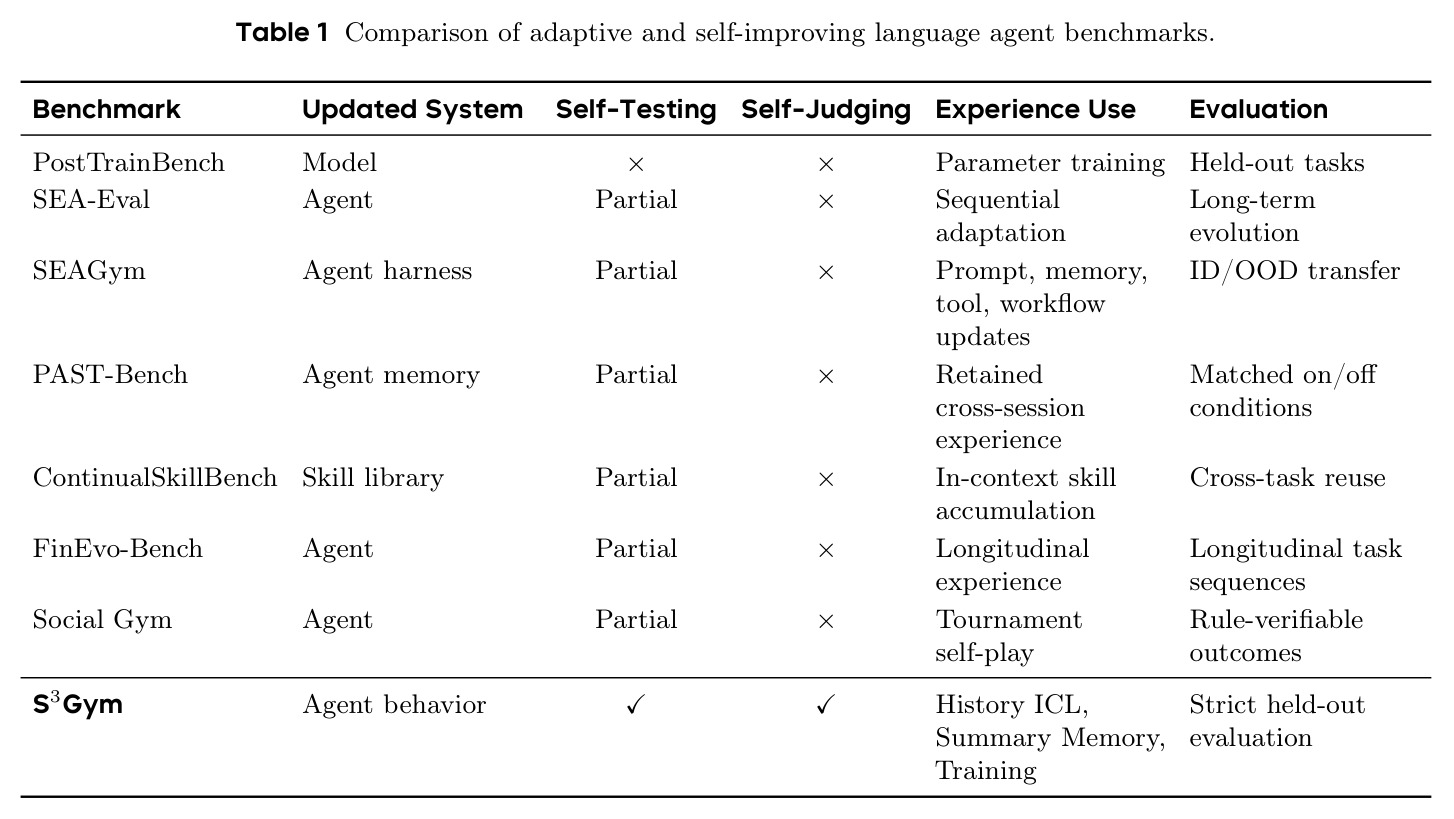
现有智能体基准(AgentBench、AgentBoard、TextWorld、ALFWorld、ScienceWorld、KORGym 等)几乎都把被测模型当作固定策略:任务给定、奖励或裁判已定义、执行脚手架固定,交互轨迹只用于测量任务完成率或诊断失败。它们回答的是“模型当下能力有多强”这一静态问题,却无法回答“模型能否利用自己过去的交互经验改进未来行为”。而在真实工业部署中,把通用模型变成可用系统的工作主要由人类工程师(如 Palantir 首创的 FDE,forward-deployed engineer,现已被各前沿模型公司采纳)完成:他们搭建验证器、测试与反馈信号,让系统随失败持续改进——一个有能力的模型还不等于一个能运转的系统。经验复用方法本身也各说各话:Reflexion 的言语反思、Voyager 的技能库、ReasoningBank 的策略蒸馏、STaR/ReST 的轨迹自训练都在各自任务里被验证过,但缺少统一协议来区分“改进失败究竟源于经验收集质量、判断可靠性,还是融入机制”。PostTrainBench、SEA-Eval、SEAGym、PAST-Bench、ContinualSkillBench、FinEvo-Bench、Social Gym 等自适应基准各关注不同的改进产物,没有一个同时耦合自测试与显式自评判、并在可执行环境验证下运行。
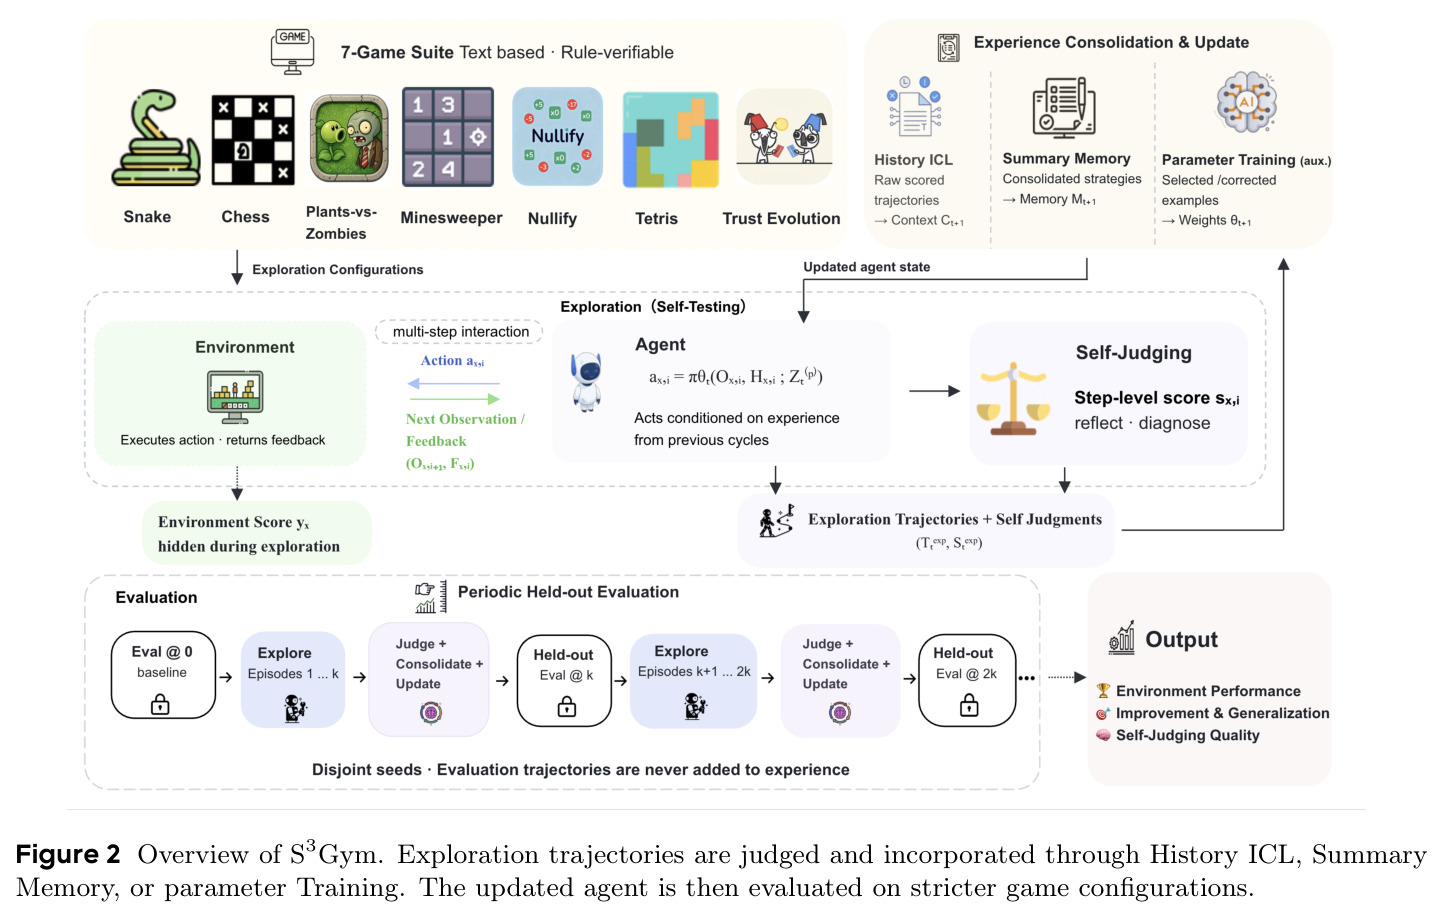
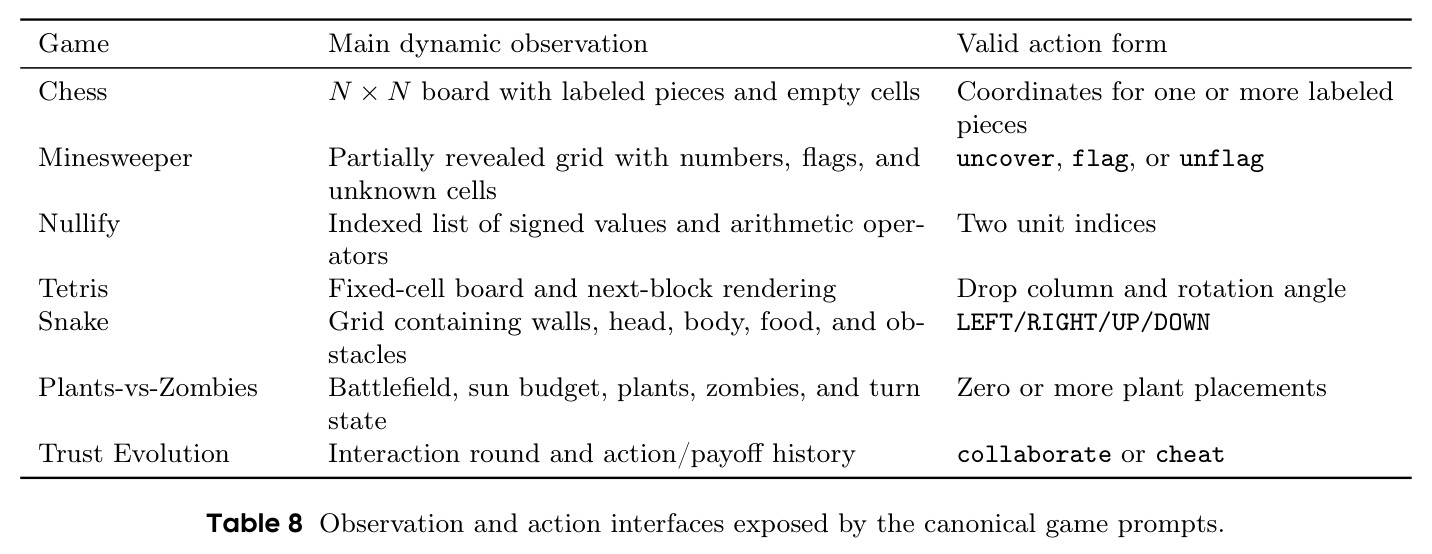
本文的目标是本文要构建一个统一的交互式评测基准 S3Gym(Self-Testing, Self-Judging, Self-Improvement Gym),把“经验驱动的自我改进”从宽泛主张变成可测量的能力。具体目标有四:(1)将 LLM 自我改进形式化为连接自测试、自评判与行为改变的迭代过程,用“宽松探索 + 严格 held-out 评估”两阶段协议强制考察经验能否迁移到新条件;(2)在完全相同的探索种子、交互预算和解码设置下,系统比较三种经验融入路径——History ICL(原始打分轨迹直接入上下文)、Summary Memory(压缩为策略摘要)、参数训练(SFT 内化);(3)显式评估自评判质量:同时记录模型自评分数 $s_{x,i}$ 与验证器奖励 $r_{x,i}$ 两条通道,量化二者的偏离;(4)在 7 个文本游戏上评估 7 个代表性商业模型,分析改进动力、判断可靠性、摘要有效性与常见失败模式,找出阻止智能体把交互经验转化为可靠改进的瓶颈。
与已有工作不同的是,S3Gym 的独特切入是把 Self-Judging 当作独立的测量对象,而不是隐含在方法内部的组件。设计上,探索阶段环境验证器会计算真实奖励 $r_{x,i}$,但不暴露给智能体;智能体每步必须同时输出动作与自评分数 $s_{x,i}$(契约形如「Answer: , Score: 」),自评分数决定经验如何被组织复用,验证器分数只用于事后衡量行为表现与评判质量。这种“双通道记账”让论文能把改进失败归因到两个不同环节:是判断不准(把有害经验当宝、把有价值经验扔掉),还是判断对了却无法把反馈转化为可执行、可迁移的策略。作者还借 FDE 视角做了问题分层:目标翻译、反馈信号构建、执行系统建设三层中,S3Gym 专注第二层——智能体面对的反馈信号及其驱动的改进闭环,与 Aspire(部署需求如何变成能力增长)、HarnessDev(模型如何自建执行系统)形成互补的三部曲。
核心方法
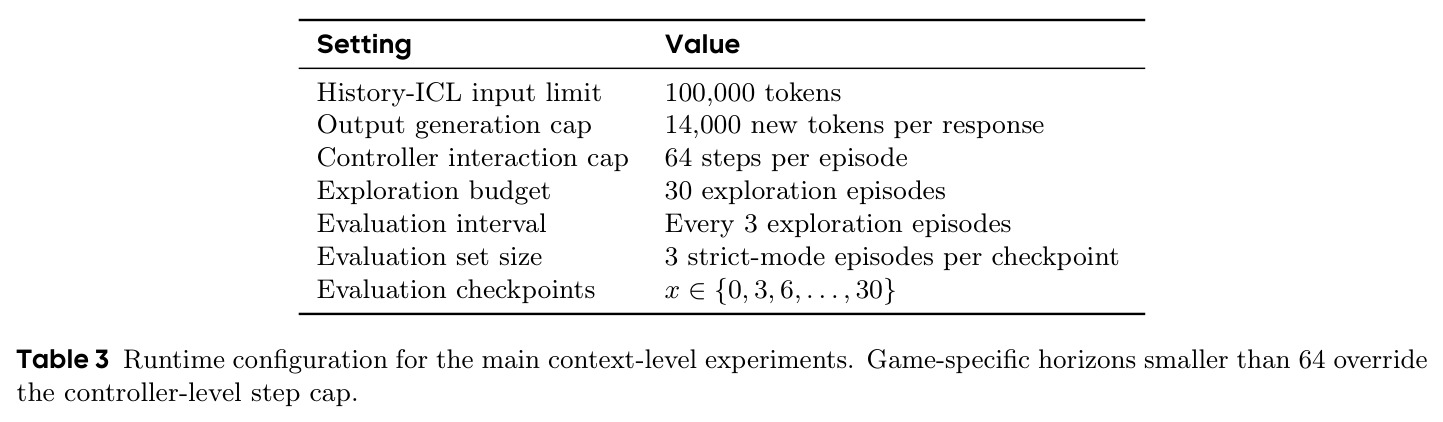
直觉上,论文借用 Dewey 与 Kolb 的经验学习理论和 Popper 的试错观:只有被主动检验、解释、抽象并再次应用的经验才产生学习,单纯积累轨迹不等于学习。技术路线是把一个自改进循环形式化为五阶段:$$\mathcal{R}^{(p)}_t = \text{Explore} \to \text{Judge} \to \text{Consolidate} \to \text{Update}_p \to \text{Evaluate}$$其中 $p \in \{\text{History}, \text{Memory}, \text{Training}\}$ 为经验融入路径。交互协议是:每个 episode 以 $O_{x,0} = \text{Reset}(seed_x, c_x)$ 初始化;每步智能体联合产出动作与自评分 $(a_{x,i}, s_{x,i}) = \pi_{\theta_t}(O_{x,i}, H_{x,i}; Z^{(p)}_t)$;环境执行后返回下一观测、可观察反馈、验证器步级奖励与终止信号;经验按所选路径更新上下文、摘要或参数后进入下一 episode。探索阶段共 30 个 episode、使用宽松配置;每 3 个 episode 在严格 held-out 配置上评估 3 局,共 11 个检查点($x \in \{0,3,\dots,30\}$)。最终报告三个互补指标:Avg(全程均分)、Max(最佳单次能力)与 $\mathrm{AUC}^+ = \int_0^{30}\max(0, y(x)-y_0)\,dx$(持续高于初始基线的正面积)。
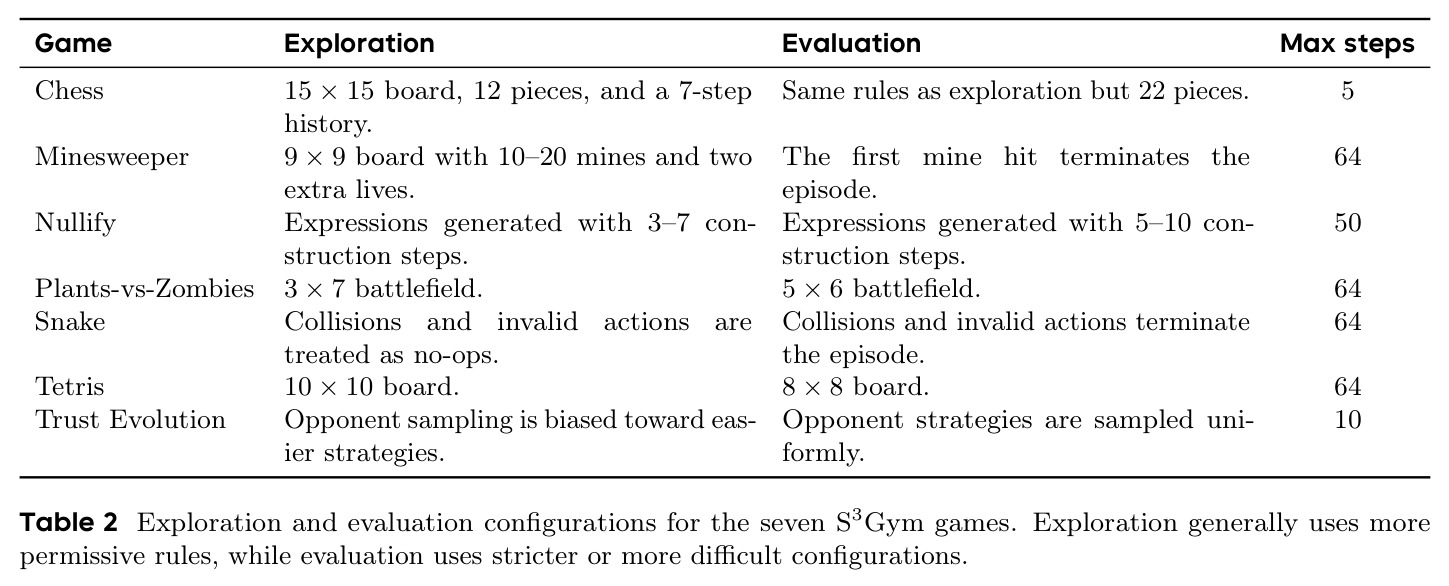
与 KORGym 等游戏基准的本质区别在于:评估对象从“静态任务能力”换成了“行为改变量” $\Delta^{(p)}_{t,g} = Y^{(p)}_{t,g} - Y_{0,g}$,即同一个模型在吸收自身经验之后变好了多少。为此 S3Gym 做了三个关键设计。其一,探索与评估使用相关但不同的配置——扫雷探索时有两条额外生命、评估时踩雷即死;Snake 探索时碰撞和非法动作只是无效操作、评估时直接终止;Trust 探索时对手偏弱、评估时均匀采样——且评估种子与探索种子完全不相交,评估轨迹不回流到历史、记忆或训练集,强制测量可迁移知识而非对种子或宽松规则的记忆。其二,模型生成的自判断与环境验证器的可执行验证显式分离:自判断决定经验如何组织复用,验证器衡量真实行为与判断质量,两者永不在探索期互通。其三,三条经验融入路径(History ICL、Summary Memory、参数训练)在同一交互预算、同一种子、同一解码设置下公平对决,把“改进失败”可归因地分解到经验质量、判断可靠性、融入机制三个因素上。
方法步骤详情
完整流程分五步。(1)初始化:episode $x$ 以配置 $c_x$ 和种子 $seed_x$ 重置得到 $O_{x,0}$,空历史 $H_{x,0} = \emptyset$,并继承上一轮的经验状态 $Z^{(p)}_t$。(2)逐步交互:智能体接收当前观测、本 episode 内历史与经验状态,输出「动作 + 自评即时分」,响应契约固定为「Answer: , Score: 」,自评分被定义为该动作在游戏规则下的预期奖励而非自由置信度。(3)环境反馈:执行后返回 $(O_{x,i+1}, F_{x,i}, r_{x,i}, d_{x,i})$;$F$ 进入智能体历史 $H_{x,i+1} = H_{x,i} \oplus \text{Format}(\cdot)$,$r_{x,i}$ 由基准侧保留、探索期不给智能体;episode 终止时得终局分 $y_x = \text{Score}(\tau_x)$。(4)经验固化:History ICL 执行 $C_{t+1} = \text{Serialize}(C_t, T^{exp}_t, S^{exp}_t)$,把带自评分的原始轨迹序列化进后续上下文(预算 10 万 token,超出时截断前次 episode 尾部);Summary Memory 执行 $M_{t+1} = \text{Summarize}(M_t, T^{exp}_t, S^{exp}_t)$,产出三元组 $(R_{retain}, R_{avoid}, D_{next})$——要保留的策略、要避免的错误、下轮方向;Training 执行 $D^{SFT}_t = \text{BuildSFT}(T^{exp}_t, S^{exp}_t)$ 与 $\theta_{t+1} = \text{SFT}(\theta_t, D^{SFT}_t)$,高分动作留作正例、低分动作过滤或替换为修正动作。(5)评估与指标:每 3 个探索 episode 后在严格配置跑 3 局,得 $Y^{(p)}_{t,g} = \frac{1}{N_{eval}}\sum_x y_x$ 与改进量 $\Delta^{(p)}_{t,g} = Y^{(p)}_{t,g} - Y_{0,g}$,并汇总 Avg、Max、$\mathrm{AUC}^+$。所有路径共享同一基础模型、种子、预算与解码设置。
技术新颖性
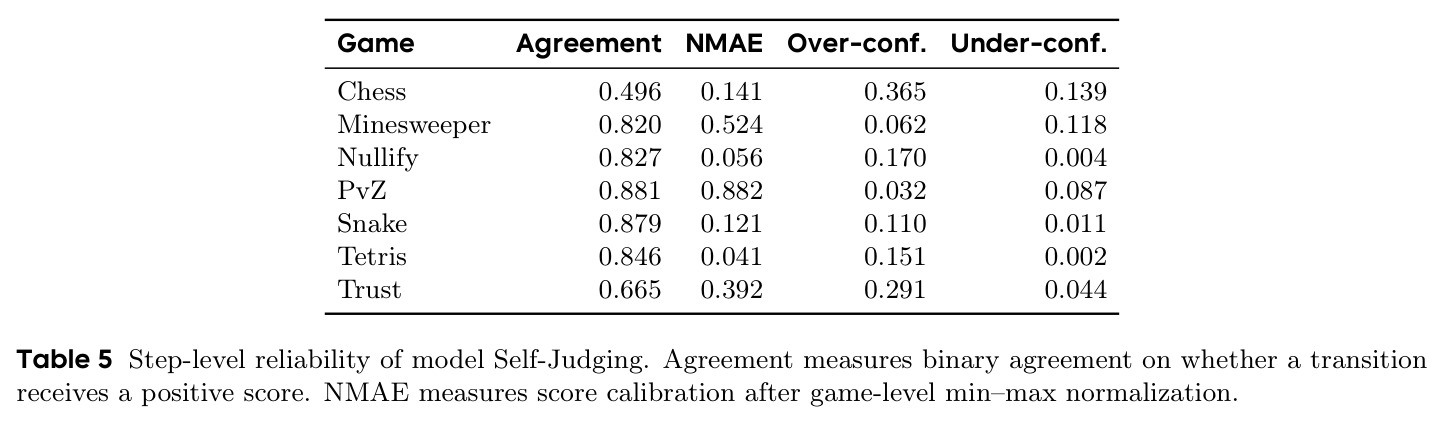
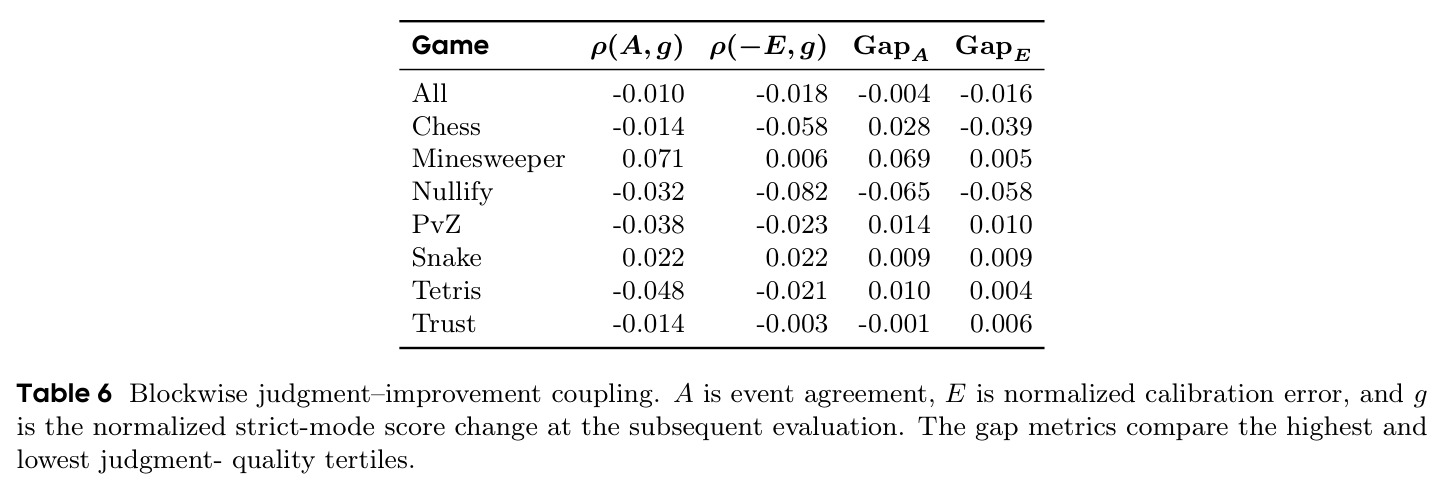
技术新颖性体现在四点。第一,统一形式化:把此前零散的自我改进方法(Reflexion、Voyager、ReasoningBank、Tree-of-Experience、STaR、ReST 等)放进同一个五阶段循环和同一交互协议下,第一次让 History ICL、Summary Memory、参数训练三者在相同种子与预算下公平对决,从而可分离“经验质量—判断可靠性—融入机制”三个混杂因素。第二,自评判的独立量化:论文设计了事件一致性 $\text{Agree} = \frac{1}{N}\sum_i \mathbb{1}[\mathbb{1}(s_i>0) = \mathbb{1}(r_i>0)]$、归一化绝对误差 NMAE、过度自信 $\Pr(s_i>0, r_i \le 0)$ 与不足自信四个指标,在 98 次运行、116,117 条转移上系统测量模型自评与验证器真值的偏离,这在以前的基准中是缺失的。第三,判断-改进耦合分析:把探索轨迹按评估检查点分块,计算判断质量与后续归一化分数变化 $g_t = (y_t - y_{t-3}) / (\max y - \min y)$ 的相关及三分位差距,直接检验“判断准是否能带来改进”这条因果链。第四,可执行验证器保证客观性:七游戏全部提供程序化验证(步级奖励与终局分),评估可复现且不受 LLM 裁判偏差污染。
实验结果
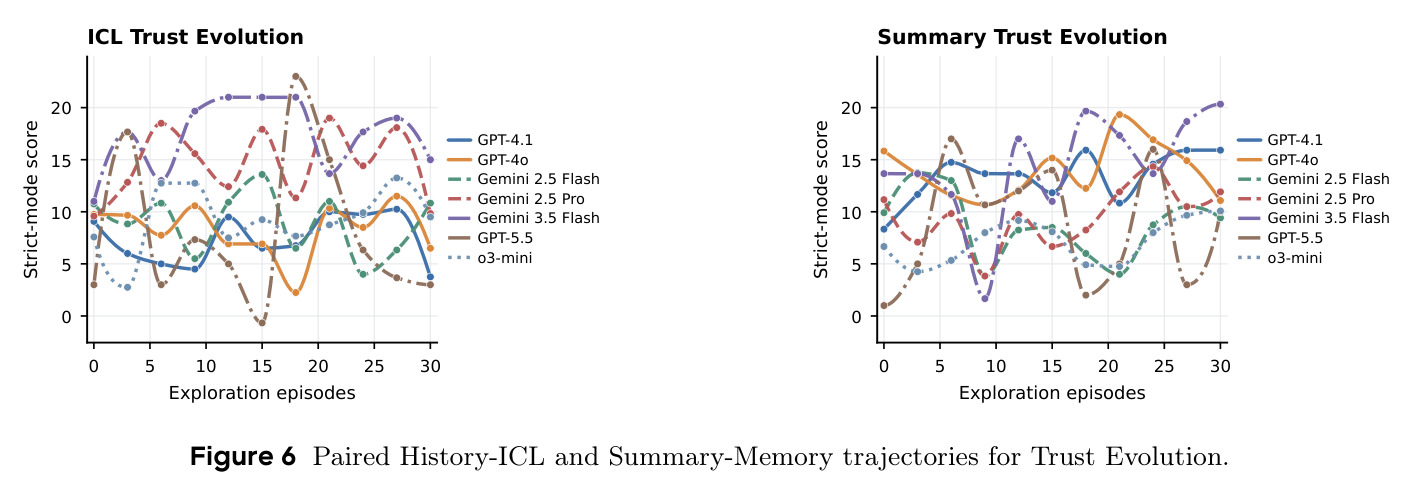
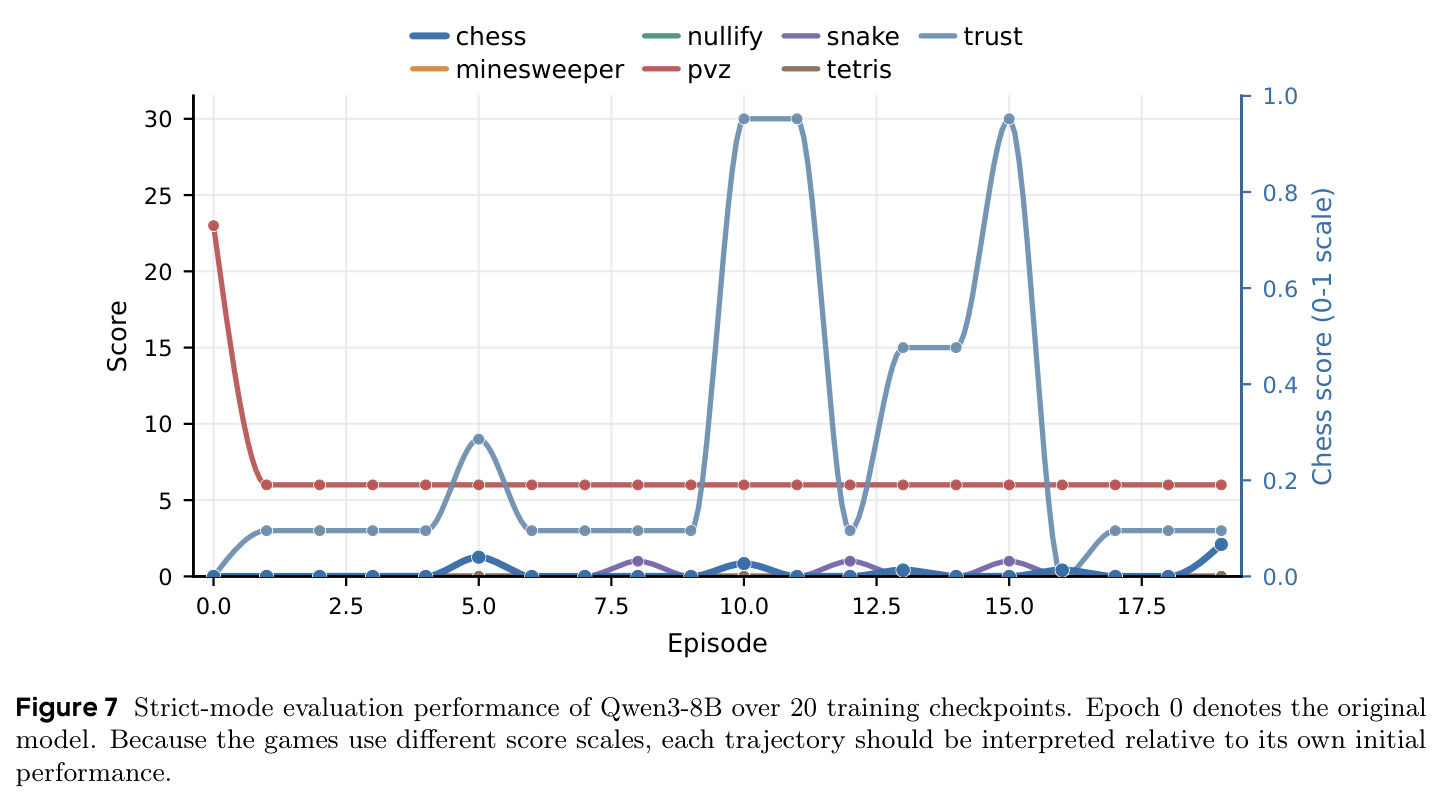
主结果可沿四条线索概括。(1)上下文层面:自我改进由模型、路径、环境三者共同决定。History ICL 下 Gemini-3.5-Flash 在 Chess 最强(Avg 0.547、AUC+ 12.280),并拿下 Snake(AUC+ 37.387)与 Trust Evolution(200.000)的最大 AUC+;GPT-5.5 领跑 Minesweeper(Avg 0.604)、Nullify(0.545)、Tetris(AUC+ 96.251),且 PvZ 的 AUC+ 高达 548.499——高基础能力并不决定自改进能力。(2)Summary Memory 并非普遍优于原始历史:Gemini-2.5-Flash 扫雷 AUC+ 从 0.000 升到 7.794、PvZ 从 24.402 升到 238.501,GPT-5.5 的 Chess 从 0.474 升到 16.840;但 GPT-5.5 的 PvZ 从 548.499 暴跌到 33.219,Gemini-3.5-Flash 的 Chess 从 12.280 归零、Trust 从 200.000 跌到 55.095——摘要是有损压缩,依赖精确状态信息的任务会受伤。(3)RQ1 参数训练(Qwen3-8B,20 个检查点):Trust Evolution 从 0 分涨到最高 30 分,19 个更新点中 18 个超基线,平均 8.684、AUC+ 163.5,是最清晰的内化证据;Chess 仅在最终检查点得 0.0667;Snake 在 epoch 8/12/15 得 1 分后归零;Minesweeper、Nullify、Tetris 全程为 0;PvZ 出现严重负迁移,从初始 23 分跌到每个更新点都是 6 分。(4)RQ2/RQ3:自判只在部分场景可靠——PvZ 事件一致性 0.881 但 NMAE 0.882 全场最差,Chess 一致性仅 0.496 近随机、过度自信率 0.365 最高;且判断质量与后续改进几乎零相关(全基准 $\rho(A,g) = -0.010$、$\rho(-E,g) = -0.018$,运行级与 NABA 的相关 $r = -0.23$)。摘要路径仅在经验可压缩为稳定规则的 Trust(ΔNABA +8.43)、Tetris(+6.20)、Nullify(+2.79)上平均占优,在 Minesweeper(−1.12)、PvZ(−2.11)、Snake(−0.81)上反而不如原始历史。核心结论:识别成功动作远远不够,智能体必须把反馈转化为可执行、可迁移的策略。
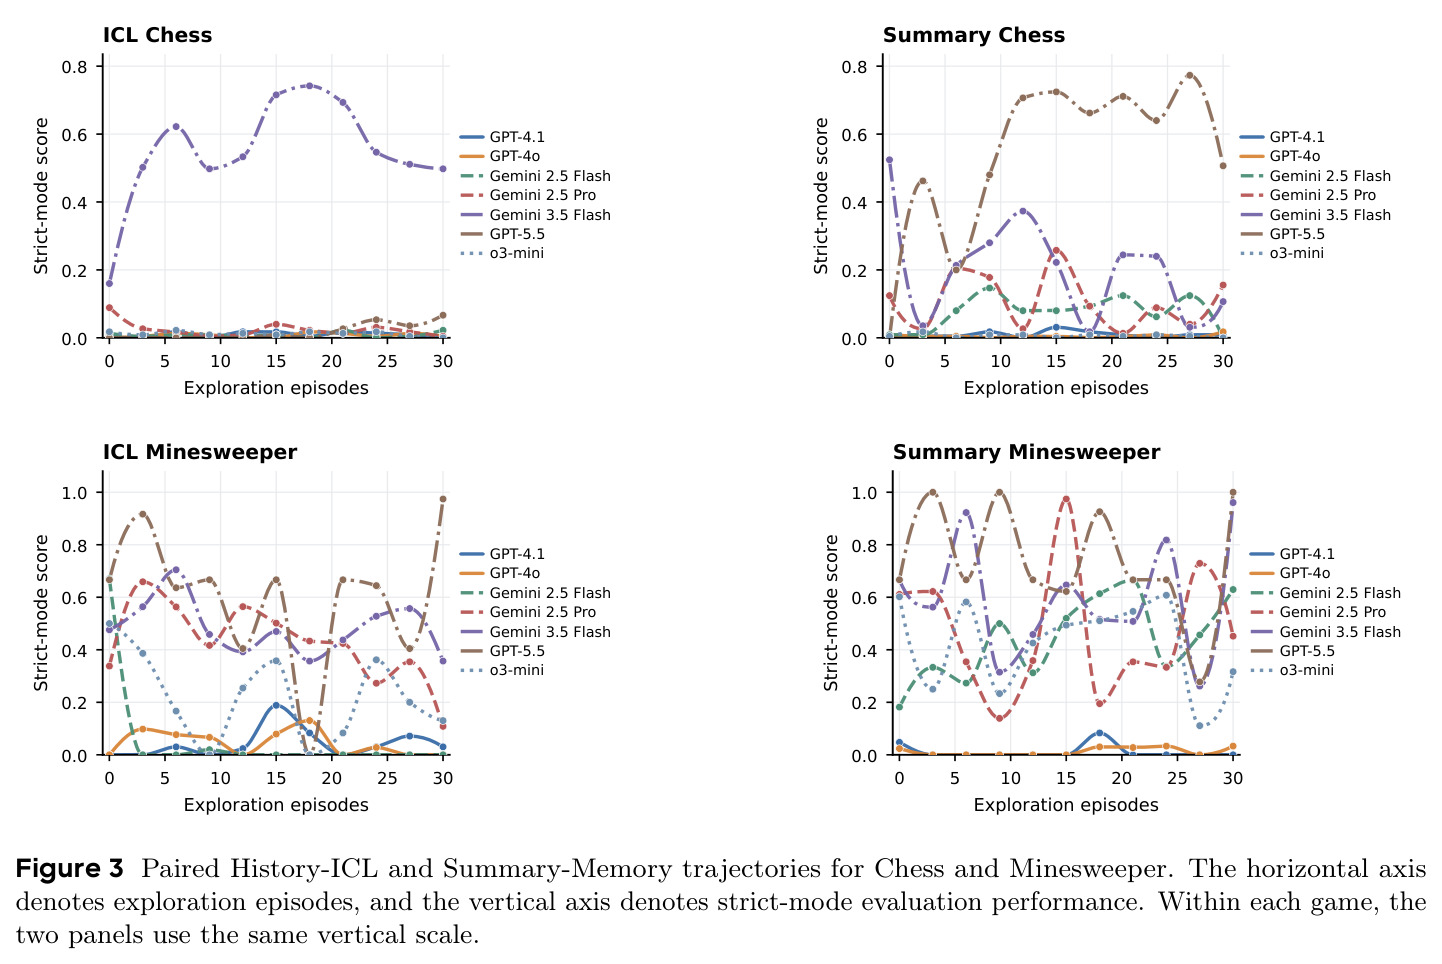
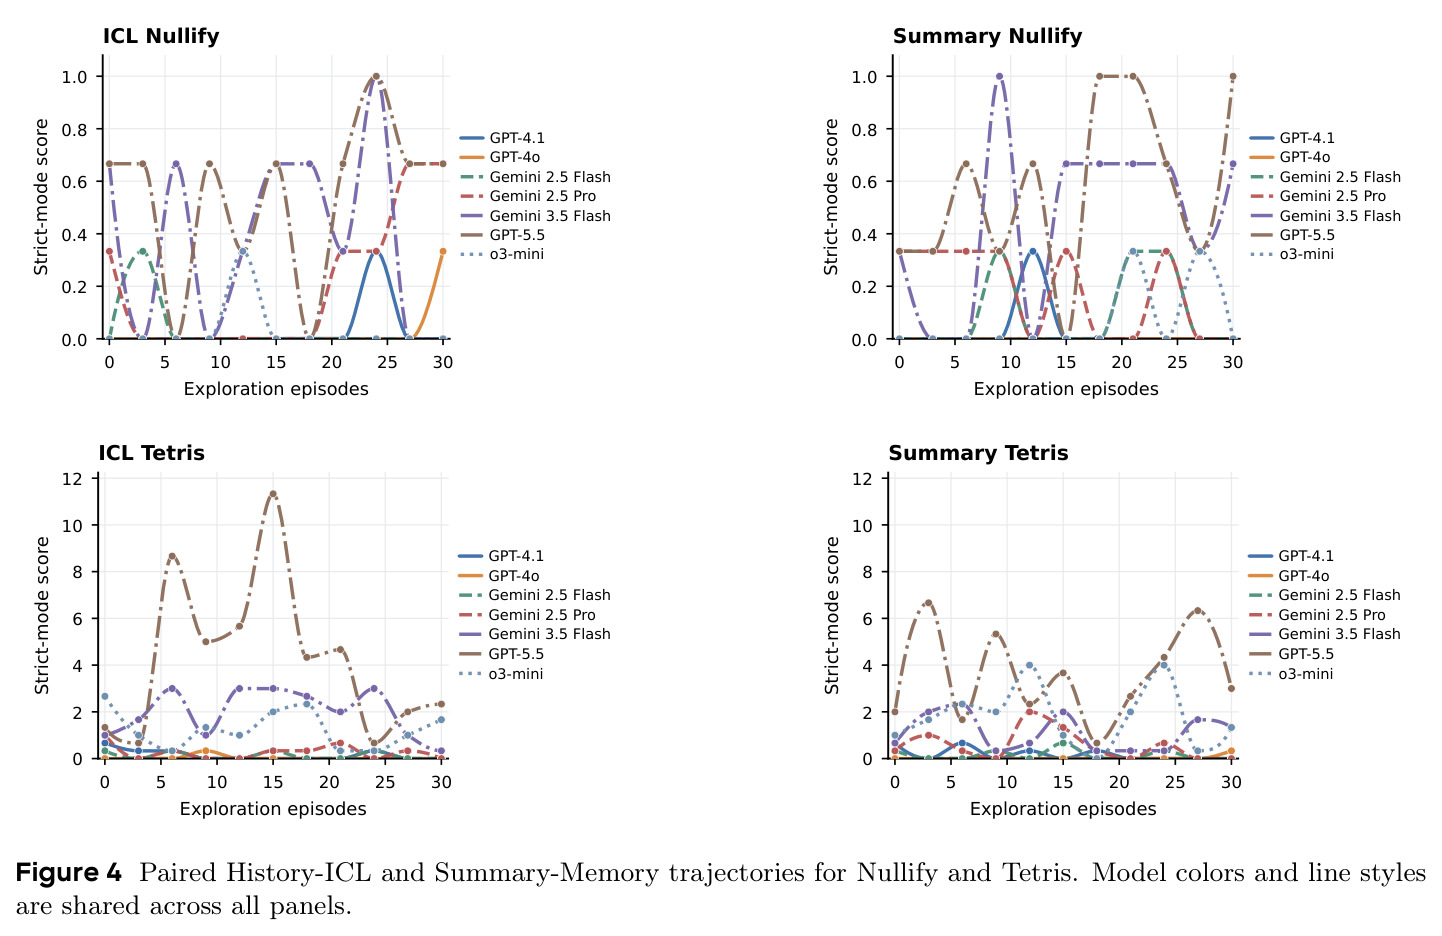
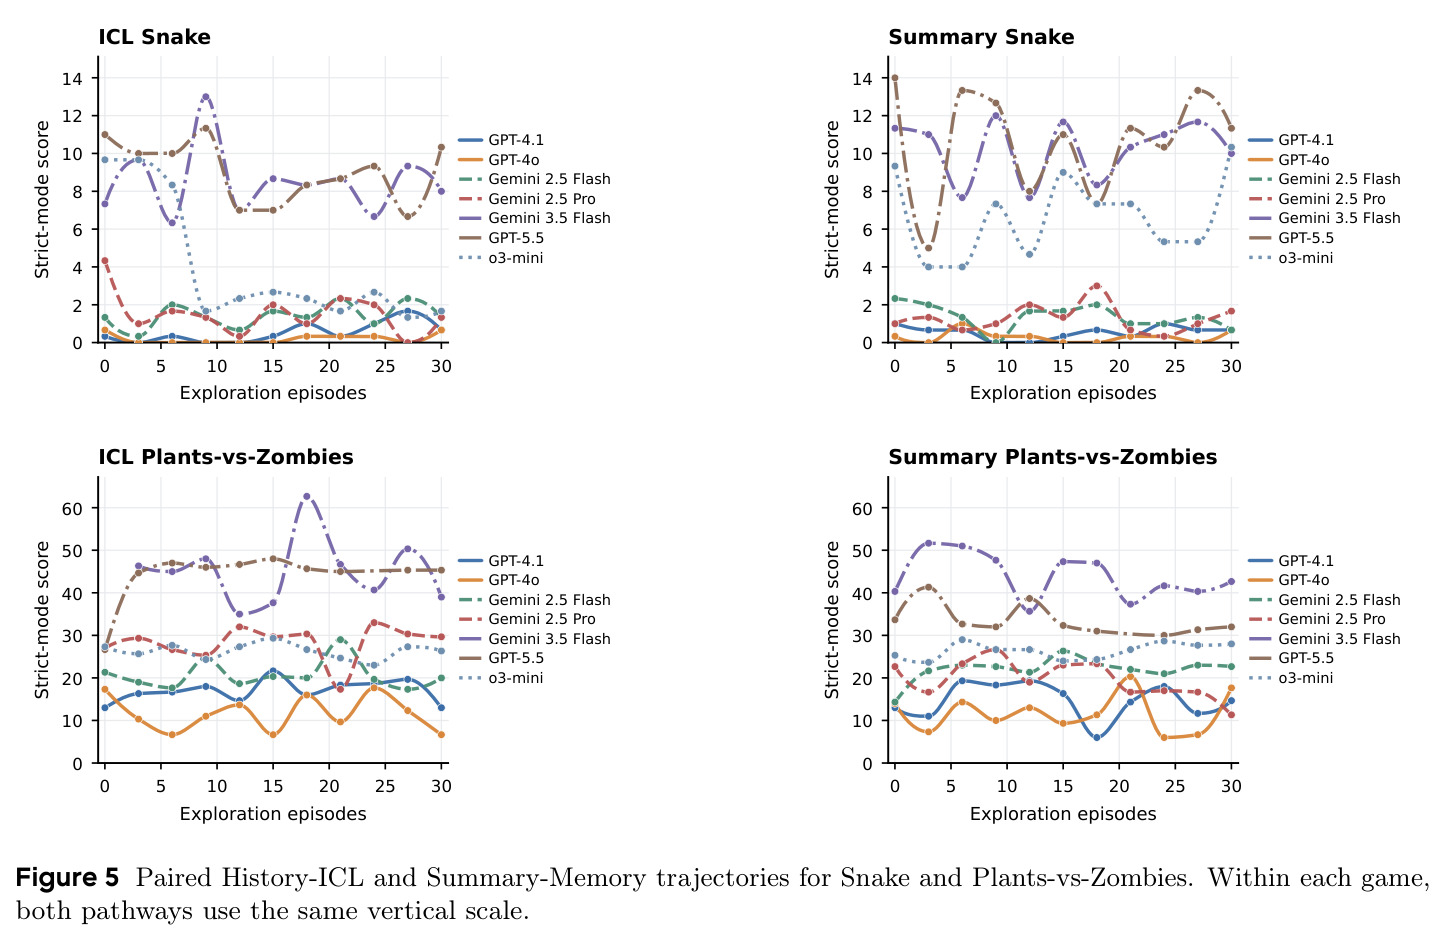
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 信任演化 Trust Evolution(Qwen3-8B 参数训练) | 严格评估分数 / AUC+ | 0 → 最高 30,平均 8.684,AUC+ 163.5 | 初始模型 0 分 | 19 个更新检查点中 18 个超过基线,参数内化经验的最强证据 |
| 扫雷 Minesweeper(Gemini-2.5-Flash) | AUC+ | 7.794(Summary Memory) | 0.000(History ICL) | +7.794,摘要让原本无法利用历史的模型受益 |
| 植物大战僵尸 PvZ(Gemini-2.5-Flash) | AUC+ | 238.501(Summary Memory) | 24.402(History ICL) | 约 9.8 倍 |
| 国际象棋 Chess(GPT-5.5) | AUC+ | 16.840(Summary Memory) | 0.474(History ICL) | +16.366 |
| 植物大战僵尸 PvZ(GPT-5.5) | AUC+ | 33.219(Summary Memory) | 548.499(History ICL) | −515.280,摘要有损压缩导致严重退化 |
| 俄罗斯方块 Tetris(GPT-5.5,History ICL) | AUC+ / Avg | 96.251 / 4.242 | 其余模型 AUC+ 介于 0 与 34 之间 | AUC+ 约为次优(Gemini-3.5-Flash 34.000)的 2.8 倍 |
| 信任演化 Trust Evolution(Summary vs History,7 模型对) | 平均 ΔNABA | +8.43(摘要 4 胜 3 负 0 平) | History ICL 为参照(ΔNABA=0) | 摘要路径在可压缩规则的游戏上平均收益最大 |
| 自判可靠性(PvZ,98 次运行共 116,117 条转移) | 事件一致性 / NMAE | 0.881 / 0.882 | 完美校准应为高一致性、低 NMAE | 二元判断较准但幅度校准全场最差,说明“知道好坏”不等于“知道多好” |
| 判断-改进耦合(全基准) | ρ(A, g) 与 ρ(−E, g) | −0.010 与 −0.018 | 若判断驱动改进应为显著正相关 | 接近零:准确自判并不能预示后续改进 |
局限与改进
作者明确承认的局限:参数训练路径不稳定,且引入了上下文路径没有的优化变量(学习率、epoch 数等),只能作为辅助路径;AUC+ 数值依赖各游戏分数尺度,只能做同游戏内比较,跨游戏需用名次或改进游戏数评估;显式标记的并发失败检查点被排除在均值与最大值之外;训练实验只在 Qwen3-8B 一个 8B 开源模型上进行。我的补充观察:第一,每个检查点只有 3 个严格评估 episode、样本极小,Chess、扫雷这类稀疏离散分数游戏(平均分常在 0.01–0.6 之间)的 Max 与 AUC+ 很可能被单次幸运局主导,结论方差大;第二,摘要与自判出自同一个模型,缺乏外部裁判或独立校准器的对照实验,无法分离“模型不会判断”与“模型不会表达判断”;第三,游戏均为简化变体(15×15 变体象棋、10×10/8×8 俄罗斯方块、3×7/5×6 PvZ),与标准规则不同,结论外推到真实工具调用与长程任务场景有限;第四,探索预算固定为 30 episode,未检验“更多交互是否改变三条路径的排序”;第五,论文诊断出判断-改进几乎零耦合这一重要事实,但没有给出修复方案的实验验证。
独立分析的弱点
独立分析的弱点:(1)评估统计功效不足——每检查点 3 局、每游戏 11 个检查点,稀疏奖励游戏(Chess 各模型 Avg 仅 0.005–0.547)的单局波动足以淹没真实改进信号,改进方向是每检查点增加评估局数、多种子重复并报告置信区间。(2)自判、摘要、训练数据三者由同一模型闭环生成,错误自判会同时污染记忆与 SFT 样本,PvZ 从 23 跌到 6 的负迁移很可能就是这种污染被训练放大的结果;改进方向是利用验证器的稀疏真值做事后校准,或引入独立 judge 模型交叉过滤训练样本。(3)History ICL 的 10 万 token 预算采用“截断前次 episode 尾部”的统一策略,长程游戏(PvZ/Snake 64 步)中不同模型对长历史的利用率差异,可能混淆“路径优劣”与“上下文利用能力”两个变量。(4)训练路径只测了朴素 SFT,未对比偏好优化(DPO)或在线 RL(如 GRPO),无法判断负迁移源于数据质量还是训练目标;应补一组用验证器奖励做筛选的消融。(5)七个游戏的规则完全可验证、状态空间小,与真实部署中反馈缺失、不可验证的情形(作者自己引用的 FDE 第二层论述)仍有距离,缺少一个“验证器部分可用”的中间设定来衔接实验室与现实。
未来方向
作者在结论中指出:未来的自改进智能体需要更好的判断校准、记忆选择与轨迹过滤,而不是更多的交互数据。基于本文成果可延伸的方向:(1)混合记忆架构——摘要提供策略层规则、轻量检索器保留关键状态片段,兼得 Nullify/Tetris 式规则压缩与 PvZ/Snake 式状态细节;(2)自判校准——利用评估期或回合末验证器提供的稀疏真值,对自评分数做温度缩放或对比蒸馏,直接攻克 RQ2 发现的 NMAE 失准与过度自信(Chess 过度自信率 0.365);(3)训练侧引入验证器在环的样本筛选或 RL 目标,检验 PvZ 负迁移能否被消除,并对比 SFT/DPO/GRPO 三种更新方式;(4)跨游戏与跨环境迁移——检验“何时该摘要、何时该保留原始状态”这一元策略能否迁移到代码、工具调用等真实环境;(5)把判断-改进耦合度本身作为元控制器的训练信号,动态在 History/Memory/Training 三条路径间路由;(6)扩展到多智能体博弈与部分可验证反馈场景,逼近真实 FDE 工作流;(7)增大探索预算与评估规模,绘制“交互量—改进曲线”,检验当前结论的预算敏感性。
复现评估
复现评估:协议公开程度较高——附录 A 完整给出七游戏的系统提示、动态观测格式与响应契约(注明转写自 test/S3GYM/envs/*/prompt.py),游戏探索/评估配置(表 2)、运行时配置(表 3:History-ICL 输入上限 100,000 token、单次输出上限 14,000 token、每 episode 最多 64 步、30 个探索 episode、每 3 个 episode 评估 3 局、检查点 $x \in \{0,3,\dots,30\}$)与全部指标公式(Avg、Max、AUC+、NABA、Agree、NMAE)都可直接照抄实现;项目页 self-developing-agents.github.io 已建立。不确定处:正文未明确承诺开源代码与轨迹数据集。成本方面,主实验涉及 7 个专有模型 × 7 游戏 × 2 条上下文路径 × 30 episode 的 API 调用(上下文最多 10 万 token),费用不小但一次性可控;训练实验为 Qwen3-8B 的 SFT、20 个检查点,8B 规模单张 A100/H100 即可完成。主要复现风险是闭源模型版本漂移(GPT-5.5、Gemini-3.5-Flash 的 API 行为随时间变化)与并发失败检查点的排除逻辑。总体难度:中等偏高——协议与游戏环境可复刻,但精确数字难以逐位复现。
论文图表
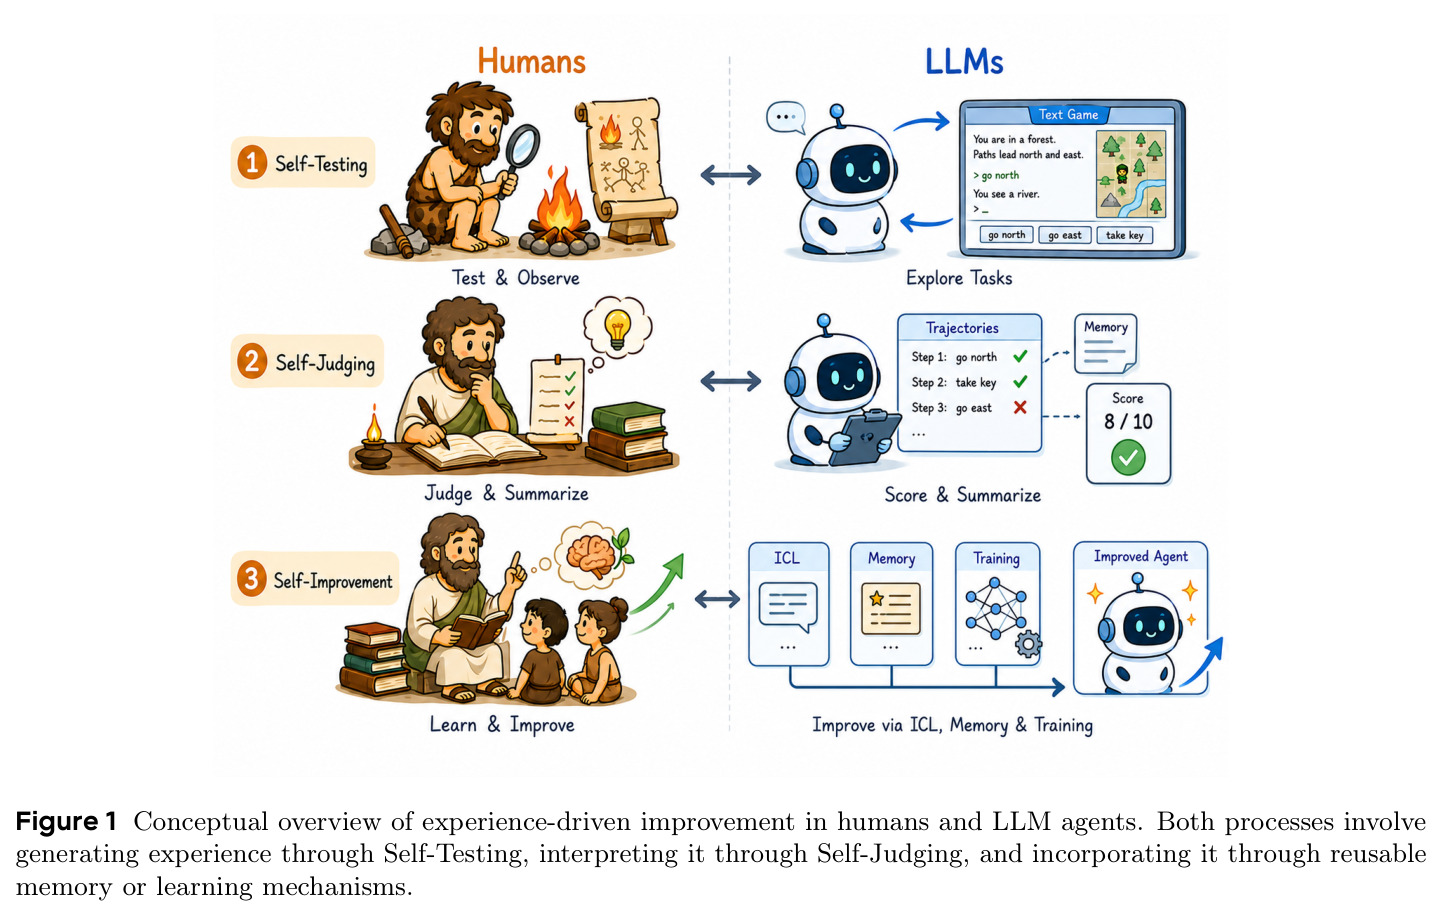
并排对比人类与 LLM 智能体的经验驱动改进过程:两者都经由 Self-Testing 生成经验、Self-Judging 解读经验,再通过可复用记忆或学习机制将经验纳入未来决策。
建立了全文的理论框架与三大能力(自测试、自评判、自改进)的分解方式,是理解论文动机与术语体系的锚点。