小语言模型作为基于量规的强化学习评判器 Small Language Models as Judges for Rubric-Based Reinforcement Learning
1.7B小模型隐层探针可作量规RL奖励,以10.7倍时间优势训出比8B生成式裁判更强的策略
前置知识
基于可验证奖励的强化学习(RLVR)
用规则验证器(如数学答案比对、单元测试、格式检查)对模型输出给出 0/1 结果奖励,再做强化学习,能在数学、代码等有标准答案的任务上激发大模型推理能力,代表工作是 DeepSeek-R1。但它依赖'可验证性',对没有唯一正确答案的开放式生成任务无能为力。
本文研究的正是 RLVR 覆盖不到的开放式场景:当答案无法用规则验证时,如何用量规(rubric)产生可靠奖励。理解 RLVR 的边界才能理解论文的出发点。
量规(Rubric)与量规奖励
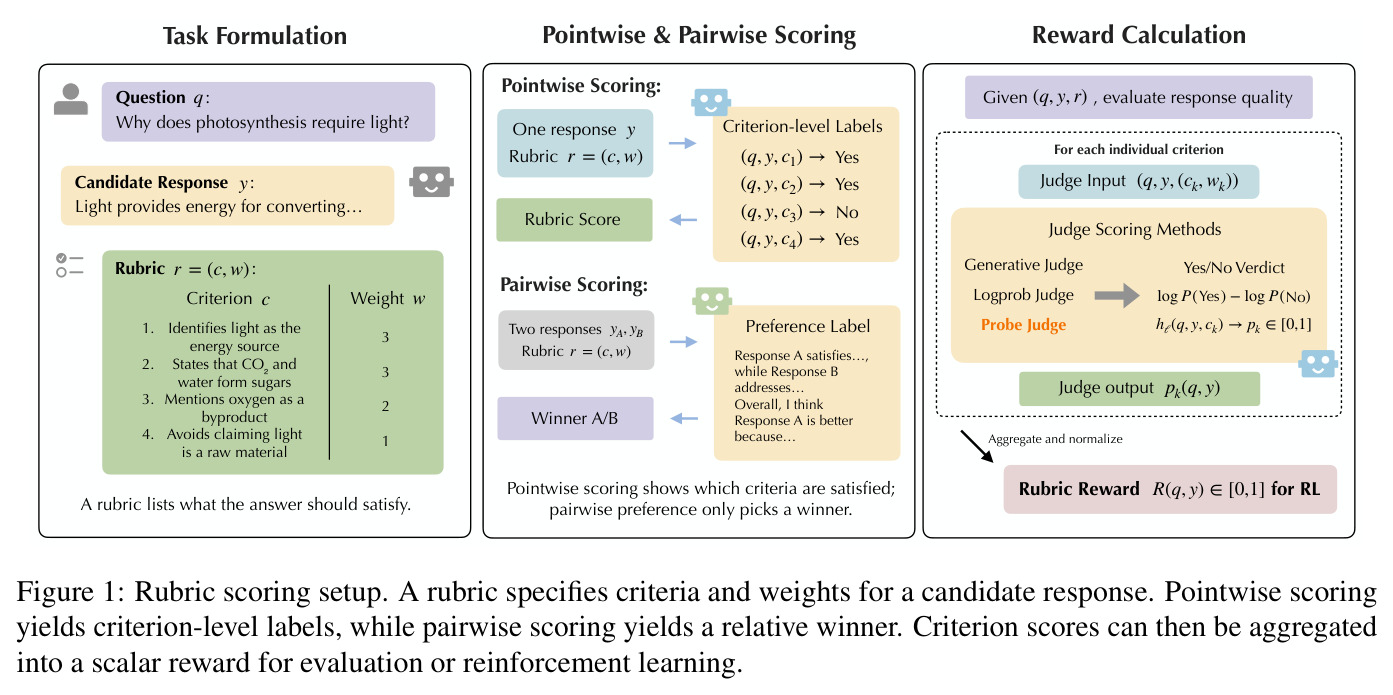
量规是针对每道题定制的评分细则:一组自然语言判据 $c_j$ 及其权重 $w_j$,例如'指出光为能量来源(硬判据,权重3)'。评判器对每个'响应-判据'对 $(q,y,c_j)$ 判断是否满足,再加权聚合成标量奖励 $R(q,y)=\sum_j w_j z_j(q,y)/\sum_j w_j$,供强化学习优化。
论文的全部内容——三种读出方式的对比、探针奖励、RL 实验——都围绕'如何高效且可靠地算出这个逐判据判断'展开,这是理解方法的基石。
GRPO(组相对策略优化)
DeepSeekMath 提出的 RL 算法:对每个 prompt 采样一组响应(本文每组 4 条),用组内奖励的相对优势(组内归一化)作为 advantage 更新策略,无需训练价值网络。它隐含一个前提:同一组内的奖励必须有区分度,否则优势信号为零。
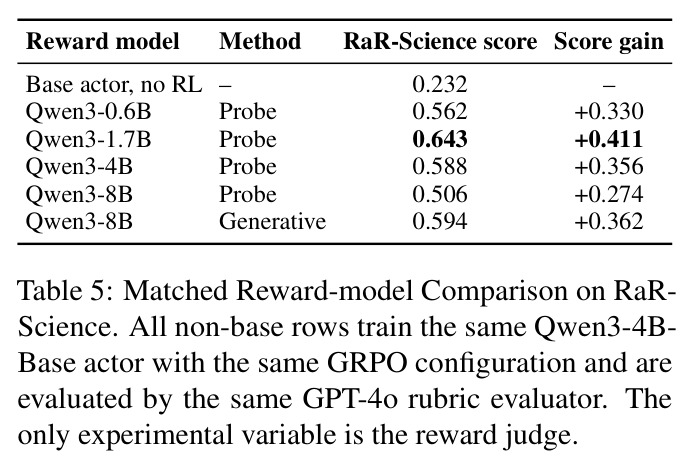
论文的关键发现之一是 8B 探针奖励饱和(组内标准差仅 0.0005),导致 GRPO 无信号可用,这正是'静态准确率最高却 RL 效果最差'的机制,也是理解表 5 倒挂结果的钥匙。
LLM-as-a-Judge:逐点(pointwise)与成对(pairwise)评判
成对评判只回答'两个响应哪个更好',把所有评价维度压缩成一个相对偏好,无法定位响应具体好在哪、差在哪;逐点评判对单个响应逐判据打分,保留判据级结构,并可直接加权聚合成奖励。两者可互转:逐点分数可诱导成对偏好,反之不行。
本文论证逐点评判对量规 RL 更合适,且附录 B.5 显示成对奖励模型 Rubric-RM 因接口不匹配和解析失败无法直接充当逐判据奖励,这是论文'gap'论证的重要一环。
线性探针(Linear Probe)
冻结语言模型全部参数,抽取某一层最后非 padding token 的隐状态 $h_\ell(q,y,c_j)$,只训练一个轻量线性分类器(二元交叉熵损失)来预测判据满足标签。训练成本极低,推理只需一次前向传播加一次线性映射,无需文本生成与解析。
探针裁判是本文的核心方法与最佳读出方式,'小模型的评判信号在隐状态中比在生成文本中更可靠'是全文最重要的结论,理解探针机制才能读懂实验设计。
macro-F1 与加权判据准确率
macro-F1 把'满足'与'不满足'两类各自的 F1 取平均,对类别不平衡稳健;加权判据准确率按量规权重(如硬判据权重 3、软判据权重 1)加权统计判断正确的比例,还可用 MCC、平衡准确率等补充。不同数据集标签分布不同,主指标也不同。
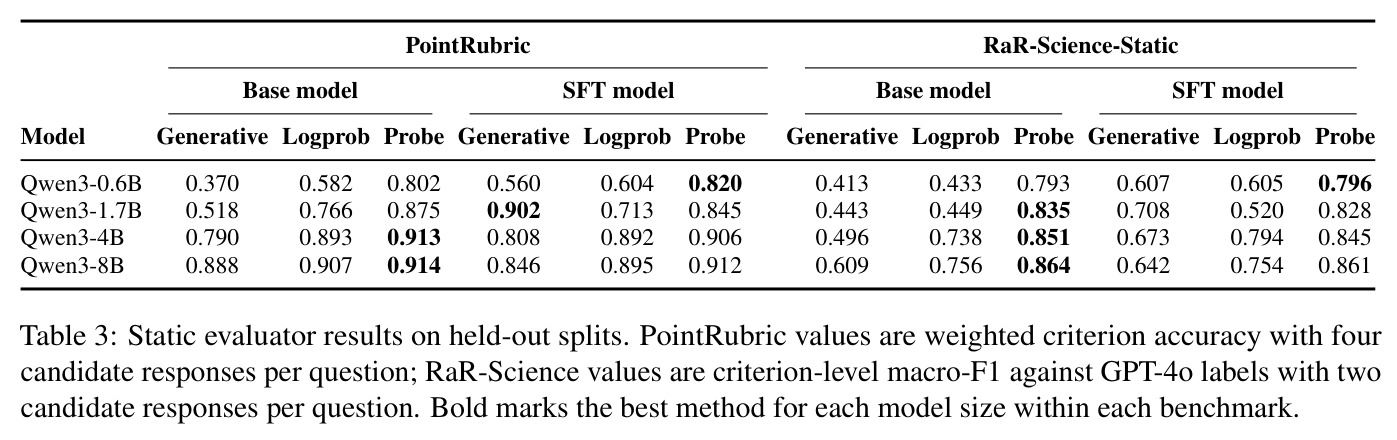
PointRubric 以加权判据准确率为主指标,RaR-Science-Static 以 macro-F1 为主指标,读表 3 及附录置信区间时必须分清,否则会误读数字。
研究动机
强化学习加可验证奖励(RLVR)靠规则验证器打 0/1 分,只在数学、代码等有标准答案的任务上有效;而 Deep Research 这类开放式智能体任务的质量取决于内容覆盖度、事实性、来源使用与任务特定约束,无法用简单自动检查器判定。量规 RL 是有希望的替代方案:每道题配一组实例化判据,由 LLM 评判器逐条判断响应是否满足,聚合成标量奖励。但这使奖励计算变得昂贵——RL 每一步都要把多条长响应对照多个判据反复打分(RaR-Science 平均每题 7.52 条判据),现有工作要么调用 GPT-4o 等专有 API,要么使用 8B 以上的本地生成式大裁判。专有 API 成本高且依赖提供商固定的模型快照,精确复现困难;本地大生成式裁判又推高了训练吞吐压力。
本文的目标是本文系统回答一个中心问题:参数小得多的语言模型能否充当高效可靠的量规评判器?为此先让问题可度量:作者构建 PointRubric(改编自 OpenRubrics)与 RaR-Science-Static(改编自 RaR-Science)两个逐点评判基准,同时具备显式判据、同题多响应、逐判据满足标签、加权计分四要素;随后在 Qwen3 0.6B/1.7B/4B/8B 四个尺度上对比三种从同一骨干提取判据级判断的方式(生成式判决、Yes/No 对数概率打分、隐层探针);选出最优的 Qwen3-1.7B 探针作为 GRPO 奖励模型,在与 8B 生成式奖励严格对齐的对照实验中比拼下游策略质量与判奖耗时,并用 GPQA-Diamond 与跨域量规迁移实验检验信号的泛化性。
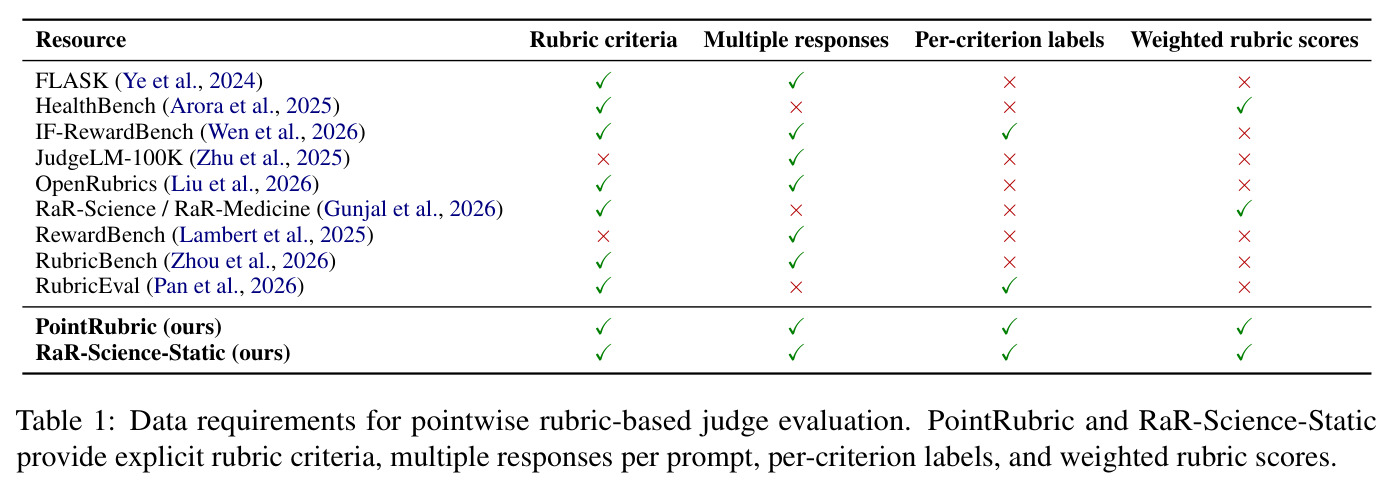
与已有工作不同的是,现有资源都凑不齐逐点评判所需的四要素(表 1):FLASK、JudgeLM、RewardBench 缺逐判据标签或显式判据,HealthBench、RubricEval 缺同题多响应固定响应库,OpenRubrics、RubricBench、RaR-Science 缺标签与加权计分结构。方法层面,Prometheus、FLAMe 等微调整个评判模型来生成评估文本,Rubric-RM 只输出成对偏好。本文的独特切入是:(1) 冻结同一骨干,只把'读出方式'(生成 vs logprob vs 探针)作为受控变量,证明接口比模型大小更关键;(2) 不改造模型本身,只用 GPT-4o 逐判据标签训练一个轻量线性头;(3) 强调按下游 RL 策略提升而非静态准确率来选择奖励裁判,并首次揭示了奖励饱和导致静态指标与 RL 效用倒挂的现象。
核心方法
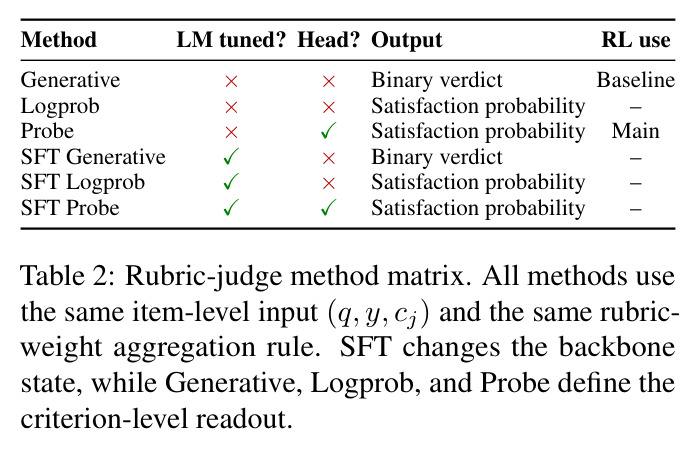
方法分两阶段。第一阶段是静态评测:构造 PointRubric 与 RaR-Science-Static 两个逐点量规基准,让所有裁判面对完全相同的条目级输入 $(q, y, c_j)$——一道题、一条候选响应、一条判据——输出二元判决或满足概率;在 Qwen3 0.6B–8B 上对比三种读出:Generative(生成 $\boxed{0/1}$ 判决再解析)、Logprob(强制选择打分,计算 $\Delta_j=\log P(\text{Yes}\mid q,y,c_j)-\log P(\text{No}\mid q,y,c_j)$,取 $p_j=\sigma(\Delta_j)$)和 Probe(冻结骨干,取最后非 padding token 的隐状态 $h_\ell$ 训练线性分类头),并设 SFT(LoRA 微调后再测三种读出)作为后训练对照。判据级输出统一按量规权重聚合成标量分。第二阶段是 RL 验证:用 VERL 框架跑 GRPO,固定 Qwen3-4B-Base 演员、数据与超参,只更换奖励裁判,对比 1.7B 探针与 8B 生成式奖励,最后由 GPT-4o 量规评分定胜负;再用 GPQA-Diamond 与科学→医学迁移检验泛化。
核心创新是'读出方式决定小模型评判质量':同一个 1.7B 骨干,生成判决与 logprob 在 RaR-Science-Static 上只有 0.443/0.449 macro-F1,而读最后 token 隐状态的线性探针达到 0.835——说明小模型内部早已编码了可靠的判据满足信号,只是无法通过生成文本或词元概率可靠地表达出来。与已有方法的本质区别:(1) 不微调骨干、不追求让小模型'会说法官话',而是直接从隐状态读出判断,训练成本只有一个线性头;(2) 把'哪种接口能暴露小模型的评判能力'作为受控变量系统研究,发现读出效应远大于规模效应;(3) 进一步发现静态准确率与 RL 效用并不一致——8B 探针静态分最高(0.864)但奖励全饱和(组内标准差 0.0005),反而训出最差策略(0.506),而 1.7B 探针保留了组内区分度,训出最强策略(0.643)。
方法步骤详情
第一步,构造 PointRubric:从 OpenRubrics 抽 3,000 道带硬约束的题,用 GPT-4o 把量规改写成固定六判据格式(2 硬 + 4 软;人工抽检 47/50 保留原意);每题生成四种角色响应(满分、低分、按量规部分合规、无引导),要求满分响应全为 10 分、低分全在 0–3 分;GPT-4o 逐判据打二值标签,过滤后得 1,042 题、4,168 响应、25,008 条标签,按题切分 417/104/521。第二步,构造 RaR-Science-Static:1,500 道科学题,每题保留原始参考答案并新增一条 Qwen3-4B 贪心响应,共 3,000 条候选;判据 6–11 条(均值 7.52),pitfall 判据转为回避型判据并用绝对权重聚合;切分 1,000/200/300。第三步,训练探针:冻结骨干,抽取第 $\ell$ 层最后非 padding 隐状态,用全批 AdamW(200 轮,lr 0.01,权重衰减 0.01)训练 BCE 线性头,层与阈值按开发集 macro-F1 选取;RL 奖励探针仅需 500 条响应(3,766 个标签,约 2.43 美元)。第四步,GRPO 训练:1,600 个训练 prompt,每 prompt 采 4 条响应,对照 checkpoint 定在 step 800,最终 100 个保留 prompt 由 GPT-4o 评分。第五步,迁移评测:GPQA-Diamond 198 题 × 4 种选项顺序,以及科学↔医学探针零适配互测。
技术新颖性
新颖性有四点。其一,数据新颖:首个同时具备显式判据、同题多响应、逐判据标签、加权计分四要素的逐点量规评测资源,表 1 显示所有现有数据集(FLASK、HealthBench、OpenRubrics、RubricBench 等)各缺一角。其二,问题形式化新颖:把'LLM 裁判'拆解为'骨干 × 读出'两个正交因子做受控消融,证明读出接口效应大于模型规模效应,呼应 Representation-as-a-judge 的近期观察,但首次落到 RL 奖励场景并给出下游验证。其三,发现新颖:静态判据准确率与下游策略质量倒挂(8B 探针静态 0.864 却训出 0.506 分策略,1.7B 探针 0.835 反而训出 0.643),并配以在线奖励诊断(组内方差、饱和比例)解释机制,提出应按下游策略质量选择奖励裁判。其四,实用性新颖:探针一次拟合即可冻结复用、无需再调 GPT-4o,监督成本约 2.43 美元,为量规 RL 提供了可复现、可扩展的低成本奖励方案。
实验结果
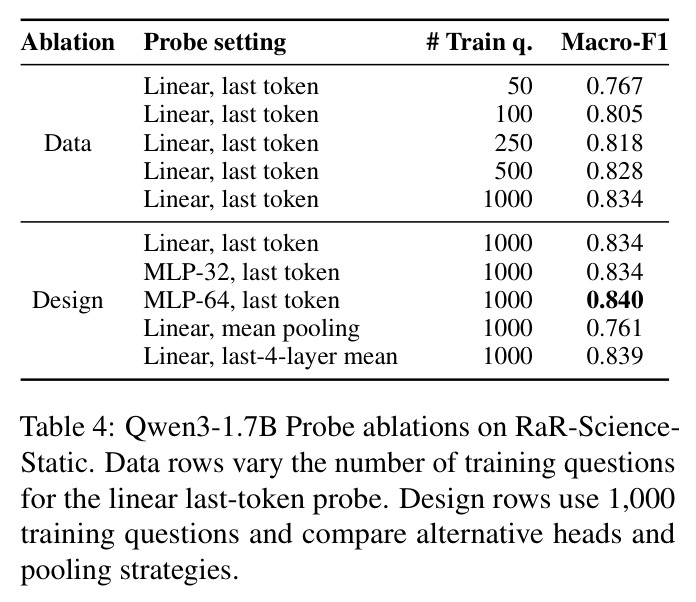
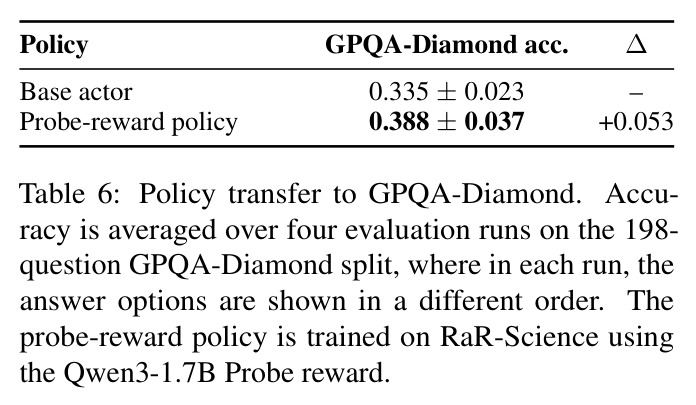
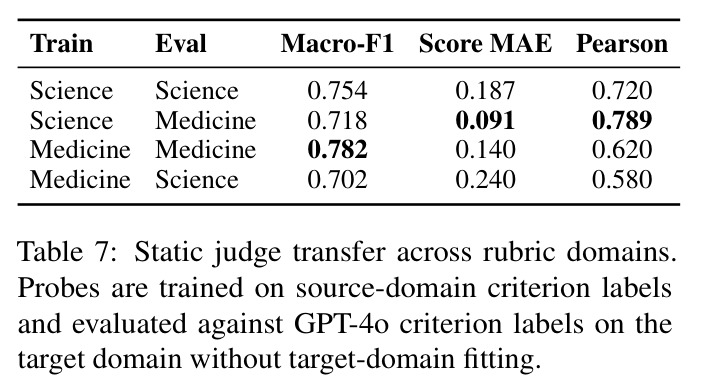
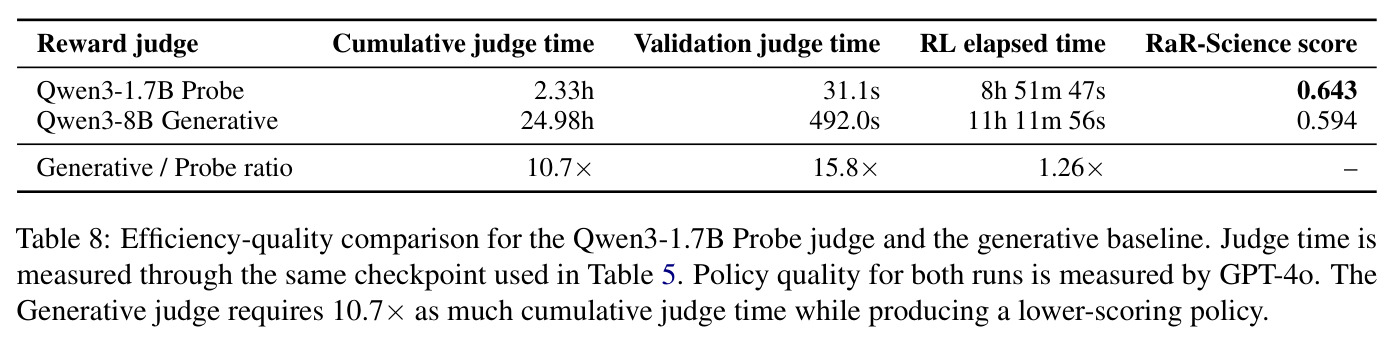
静态评测(表 3):PointRubric 上生成式裁判随规模提升(0.6B 0.370 → 8B 0.888 加权判据准确率),SFT 使 1.7B 生成式跳至 0.902,说明受控格式下小模型可学会判决格式;RaR-Science-Static 上读出比规模重要:1.7B 基础模型三种读出为 0.443/0.449/0.835(生成/logprob/探针),探针在所有尺度最强(1.7B 0.835 vs 8B 0.864)。对 4,518 条判据决策做配对分解:33.0% 仅探针判对,仅 7.8% 仅生成式判对;生成式错误以假阳性为主(33.7% vs 4.2% 假阴性),即倾向于接受'提到主题但漏掉具体要求'的响应。响应生成器偏移测试(扩展库加入 Mistral-7B/OLMo-2 响应)中,不变的探针仍达 0.741 macro-F1,远超生成式 0.394 与 logprob 0.424。与成对模型 Rubric-RM 对比:探针诱导的成对准确率 0.924/0.888,Rubric-RM-4B/8B 全集仅 0.322/0.487(解析失败算错),可解析子集也只有 0.513/0.670。消融(表 4):50 题训练即达 0.767,1,000 题 0.834;MLP-64 头最高 0.840,均值池化最差 0.761;层级呈宽平台(16–26 层均在 0.83–0.84)。RL(表 5):1.7B 探针奖励把 Qwen3-4B-Base 的 GPT-4o 量规分从 0.232 提到 0.643,超过 8B 生成式奖励的 0.594;0.6B/4B/8B 探针分别为 0.562/0.588/0.506——8B 探针奖励饱和(组内均值 1.000、标准差 0.0005、100% 组全 >0.95,而 1.7B 为 0.911/0.032/12.5%)。迁移:GPQA-Diamond 从 0.335±0.023 提升到 0.388±0.037;科学探针零适配迁移到医学 macro-F1 0.718(域内 0.782),反向 0.702(域内 0.754)。效率(表 8):累计判奖时间 2.33h vs 24.98h(10.7 倍),验证判奖 31.1s vs 492.0s(15.8 倍),端到端墙钟 8h52m vs 11h12m(仅 1.26 倍,因奖励调用可并行且其他环节不变)。验证实验:人工盲评 72/100 偏好探针策略(GPT-4o 偏好 80/100),二者一致率 95.8%(69/72);GPT-5 独立复评与 GPT-4o 的判据级 macro-F1 一致度 0.853、分数 Pearson 0.843。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PointRubric 静态逐点量规评判 | 加权判据准确率(weighted criterion accuracy) | Qwen3-1.7B Probe:0.875(SFT 后 0.845) | 同骨干 Qwen3-1.7B Generative:0.518;8B Generative:0.888 | 同规模 +0.357,1.7B 探针即可比肩 8B 生成式裁判 |
| RaR-Science-Static 静态逐点量规评判 | 判据级 macro-F1 | Qwen3-1.7B Probe:0.835 | Qwen3-1.7B Generative 0.443;Qwen3-1.7B Logprob 0.449;8B Probe 0.864 | 同骨干读出间 +0.392;接近 8B 探针而参数仅其 1/4.7 |
| 响应生成器偏移(扩展响应库:Mistral-7B + OLMo-2 响应) | macro-F1 | Qwen3-1.7B Probe:0.741 | Generative 0.394;Logprob 0.424 | +0.317(对生成式),读出排序不变 |
| RaR-Science 量规 RL(GRPO 训练 Qwen3-4B-Base) | GPT-4o 量规评分(0–1) | 1.7B Probe 奖励:0.232 → 0.643 | 无 RL 基线 0.232;8B Generative 奖励 0.594 | 较起点 +0.411;较更大生成式裁判奖励 +0.049,判奖时间省 10.7 倍 |
| 策略迁移:GPQA-Diamond(198 题 × 4 种选项顺序) | 准确率 | 0.388 ± 0.037(探针奖励策略) | Base actor:0.335 ± 0.023 | +0.053,提升迁移到量规格式之外的考试型任务 |
| 判奖效率(至对照 checkpoint 的累计判奖时间) | 累计判奖秒数 / 验证判奖秒数 | Qwen3-1.7B Probe:8,389.9s(2.33h)/ 31.1s | Qwen3-8B Generative:89,912.1s(24.98h)/ 492.0s | 累计 10.7×,验证 15.8×;端到端墙钟也缩短 1.26× |
局限与改进
作者承认的局限:监督目标是 GPT-4o 的判据打分而非人类真值(人工审计 90.9% 加权判据一致、96.0% 成对一致只是对参考目标的可靠性检查,且分歧集中在完整性、清晰度等软判据上);最强证据集中在 RaR-Science,GPQA-Diamond 与 RaR-Medicine 只是补充检查,不能推出域不变的量规判断能力,对话、长文本指令遵循、安全关键等新场景可能需要额外校准;RL 实验只覆盖一个策略家族(Qwen3-4B-Base)与一种量规 RL 配置,人工审计对'无奖励过优化'只是场景特定证据;效率数字是特定实现与硬件下的经验测量,不应当作通用服务常数。我的补充观察:GPQA 提升 0.053 且标准差区间重叠(0.335±0.023 vs 0.388±0.037),证据强度中等;墙钟只降 1.26 倍,说明收益集中在判奖侧而非整条训练管线;探针与生成式读出的对比都在 Qwen3 家族内进行,结论对其他模型家族的外推性未验证。
独立分析的弱点
独立分析的弱点:(1) 教师偏差与上界——所有标签来自单一 GPT-4o,软判据上人工一致率有限(分歧集中于完整性、具体性、清晰度),探针蒸馏的是 GPT-4o 的评判分布而非真值,教师盲区会被原样继承;改进方向是多教师集成标注或人工校准子集蒸馏。(2) 奖励饱和只被事后解释而未解决——论文靠'选 1.7B'绕开饱和,但缺少系统性的奖励归一化/温度化机制,换任务后饱和点可能不同;改进方向是在线监控组内方差并动态缩放探针输出(如按组内分位数重映射)。(3) 响应库多样性不足——RaR-Science-Static 主库每题只有参考答案加一条贪心响应,覆盖的失败模式窄;扩展库加入 Mistral/OLMo 后探针 macro-F1 从 0.835 降到 0.741,说明分布外退化明显。(4) 探针需每个量规设置单独拟合(虽只要约 2.43 美元),对新域新格式的零样本能力未验证,科学→医学 0.718 vs 域内 0.782 的差距说明分布漂移有真实代价。(5) 判奖骨干仅 Qwen3 一个家族,'隐状态可读出评判信号'是否为 Qwen3 特性未知;RL 对照也只测了一个 checkpoint(step 800),长期训练下探针奖励是否稳定或被策略钻空子缺乏证据。
未来方向
论文指向的未来方向:(1) 奖励整形与校准——把探针概率映射为对 GRPO 友好的分布(组内分位数缩放、饱和感知的温度化),系统研究'饱和-区分度'权衡,避免靠碰运气选模型尺寸;(2) 在线/主动探针更新——RL 中策略分布持续漂移,可用探针不确定性估计触发少量 GPT-4o 再标注或选择性微调线性头;(3) 跨家族与跨模态验证——在 Llama、OLMo 等其他开源骨干及多模态量规上检验 Representation-as-a-judge 的普适性;(4) 过程级奖励——探针天然给出逐判据信号,可扩展为步骤级或 token 级细粒度奖励与诊断报告;(5) 对抗鲁棒性红队——检验策略能否学会欺骗隐层探针(reward hacking),以及探针在对抗性格式下的稳定性;(6) 跨域零样本探针——多域混合训练或元学习,减少每个新域约 500 条标注的重拟合需求;(7) 混合裁判架构——探针做低成本初筛,生成式裁判只复核边界样本,在成本与质量间更细粒度地权衡。
复现评估
复现条件良好。代码与数据已开源(github.com/Ignotus6043/SLM-rubric-RL),两个基准均可从公开的 OpenRubrics 与 RaR-Science 重建,附录 E 提供全部提示模板(量规改写、四类响应生成、判据打分、生成式/logprob/探针判奖)。成本量化透明:GPT-4o 参考标注全流程 4.11M tokens 约 14.53 美元;静态探针监督约 11.62 美元(2,400 响应/18,032 标签);RL 奖励探针仅约 2.43 美元(500 响应/3,766 标签)。探针训练是全批 AdamW、200 轮的线性层,笔记本即可完成;SFT 对照用 LoRA(bf16、3 轮、lr 2e-4/1e-4)有完整配置表。主要门槛在 RL:GRPO 用 VERL 框架训练 Qwen3-4B-Base,1,600 prompt × 5 epochs 约 9–11 小时墙钟(NYU Torch 集群),需要多卡 GPU;GPT-4o/GPT-5 评测依赖 API 且价格随时间变动。总体属中等难度:静态部分几乎零门槛可复现,RL 部分需 8 卡级集群或租用算力。
论文图表
step-800 时八个 rollout 组的在线奖励统计:8B 探针奖励组内均值 1.000、标准差 0.0005、100% 组全部奖励 >0.95(完全饱和);1.7B 探针为 0.911/0.032/12.5%;8B 生成式为 0.706/0.102/12.5%。
它揭示了表 5 倒挂现象的机制:GRPO 依赖组内奖励方差,静态最优的 8B 探针因奖励饱和而无区分信号——这是理解'如何选奖励裁判'的关键诊断证据。