基于项目反应理论的量规奖励(RRT) Rubric Rewards from Item Response Theory
用项目反应理论把量规判定聚合成奖励,区分同分模式并自适应减少评判调用
前置知识
GRPO(组相对策略优化)
DeepSeek-R1 使用的强化学习算法:对每个 prompt 采样一组(本文为 8 个)rollout,用组内奖励的均值和标准差把每个 rollout 的奖励归一化成优势(advantage),再据此做策略梯度更新,省去价值网络。奖励只用于组内相对比较,因此『同一组内不同 rollout 是否能拿到不同奖励』直接决定学习信号的质量。
RRT 的输出就是 GRPO 的标量奖励;论文反复强调『tie(同分)』会抹掉组内区分度,而 RRT 的核心卖点就是减少 tie、提供更细粒度的优势信号。
项目反应理论(IRT)
教育测量中的统计框架:考生在题目 $j$ 上的通过概率是其潜在能力 $z$ 的函数,最常用的二参数模型为 $P_j = F(a_j(z-b_j))$,其中 $b_j$ 是难度($P=0.5$ 处的能力值),$a_j>0$ 是区分度(通过概率随能力变化的陡峭程度),$F$ 是 Logistic 或高斯 CDF。IRT 还假设局部独立性:给定能力和题目参数,各题作答条件独立。
本文的全部方法就是把 rubric 标准当成『考题』、rollout 当成『考生』:难度 $b_j$ 定位标准在质量轴上的位置,区分度 $a_j$ 决定其判定对质量的证据强度,并由此推出 Fisher 信息用于准则选择。
Rubric(量规)与 LLM-as-Judge
对没有唯一正确答案的开放任务(医疗问答、写作、科研回答),把评价目标分解成若干条自然语言标准:必备内容、推理步骤、输出约束、需避免的错误等,再让一个 LLM judge 对每条标准给出二值判定。近年工作(RaR、Rubrics as Rewards 等)为每个 prompt 动态生成专属 rubric,作为强化学习的奖励来源。
RRT 要解决的正题就是:judge 给出的 $K$ 条二值判定如何聚合成一个标量奖励。主流的『按预设分值加权求和』是本文批评的对象。
MAP 估计与贝叶斯后验
最大后验(MAP)估计在似然之上加一个先验分布 $p(z)$,取使后验概率最大的参数值:$\hat{z} = \arg\max_z [\sum_j \log p(G_{ij}|z) + \log p(z)]$。对数后验若严格凹则极值唯一,可用数值方法高效求解。先验可以在判定证据很少(如标准全过或全挂)时把估计拉回中心,防止过度外推。
RRT 的奖励 $R_i=\hat{z}_i$ 就是质量 $z_i$ 在高斯先验 $N(0,\sigma_z^2)$ 下的后验众数,通过二分法求解;理解 MAP 才能理解为什么『判定模式』而非『总分』决定奖励。
Fisher 信息
统计中衡量一个观测对参数信息量的标准量:$I(z) = E[(\partial \log p(G|z)/\partial z)^2]$,即似然得分方差,也等于对数似然的期望负曲率。在自适应测试(CAT)中,Fisher 信息最大的题目被优先选给考生,从而用最少题目达到目标测量精度。Cramér-Rao 下界说明任何无偏估计的方差都不低于 Fisher 信息的倒数。
本文两大支柱共用这一概念:定理 2 证明 rubric 似然得分达到局部信噪比的 Fisher 信息界(所以聚合方式最优),自适应 Fisher 选择按 $\sum_i I_j(\hat{z}_i)$ 排序准则、在预算内省一半 judge 调用。
在线 EM 算法
EM 算法用于含隐变量的最大似然估计:E 步在当前参数下推断隐变量(这里是每个 rollout 的质量 $\hat{z}_i$),M 步固定隐变量更新参数(这里是 RPN 的 $(a_j,b_j)$ 预测)。『在线』指每个策略步只做一次扫掠而非迭代到收敛,跟随不断变化的 rollout 分布增量更新。
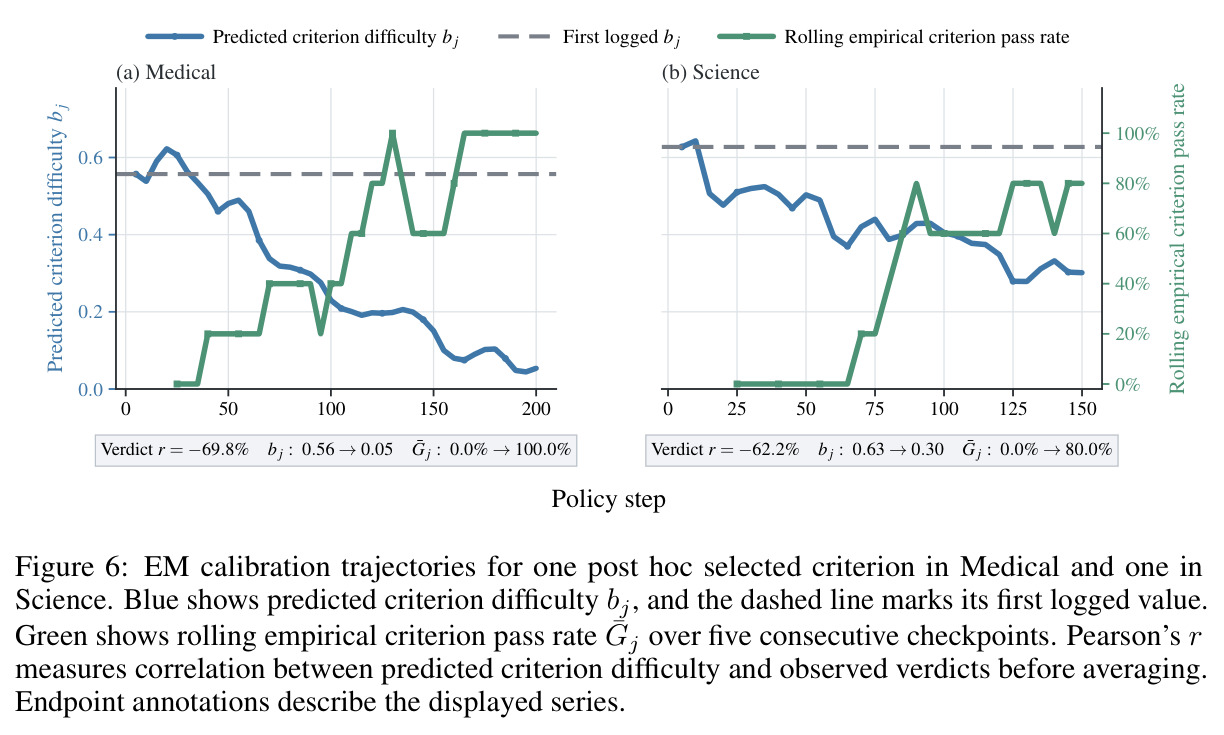
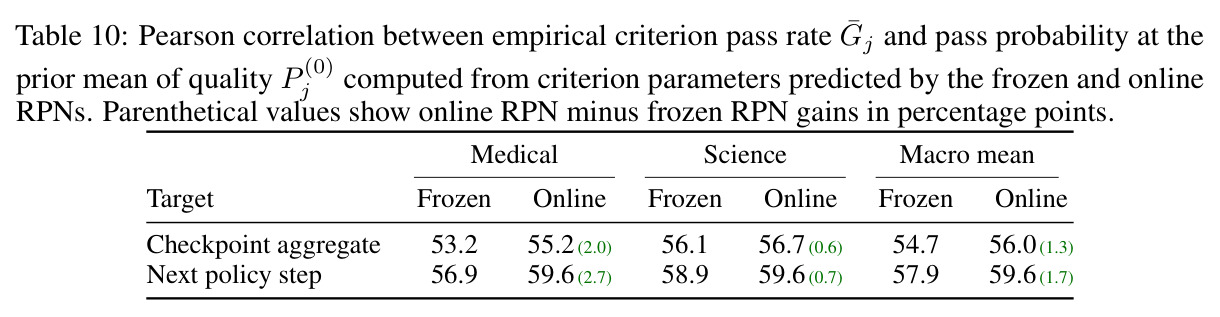
RL 训练中策略分布持续漂移,昨天拟合的标准参数今天就会失准;RRT 用每步一次的在线 hard EM 从当前 rollout 判定里重新校准 RPN,实验显示这比冻结 RPN 高 0.5 个宏观百分点。
研究动机
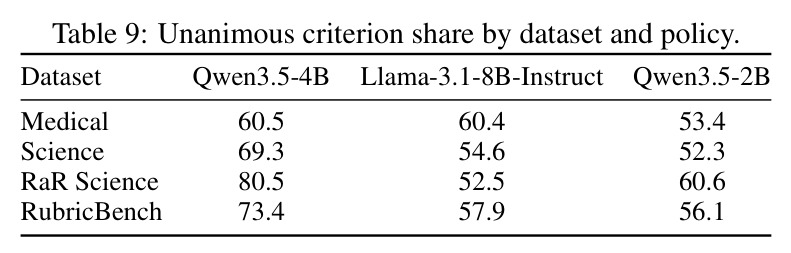
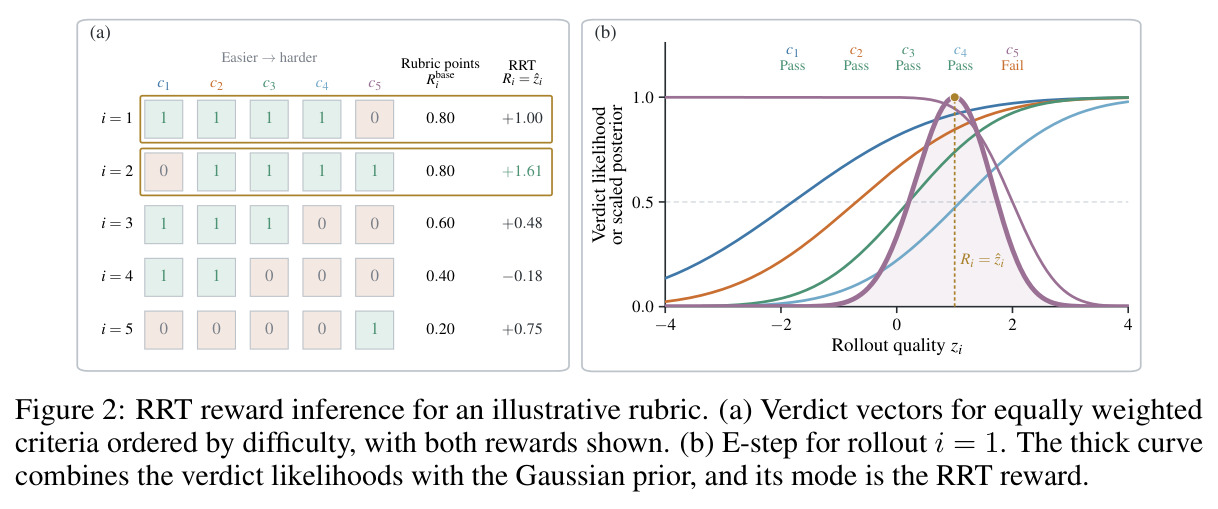
可验证奖励的强化学习(RLVR)只适用于数学、代码等能自动判分的任务,而医疗问答、科研写作等大量语言任务没有唯一正确答案,需要用 LLM judge 加上按 prompt 动态生成的 rubric 来评价。主流做法(Gunjal et al. 2026 的 RaR、Arora et al. 2025 等)把 judge 对 $K$ 条标准的二值判定 $G_{ij}$ 按预设分值加权求和:$R^{base}_i = \sum_j w_j G_{ij} / \sum_j w_j$,再喂给 GRPO 训练。这个加法聚合有三个具体缺陷。第一,不同的判定模式可以得到相同的总分:例如五条等权标准下,判定向量 $(1,1,0,0,0)$ 和 $(0,0,1,1,0)$ 都是 0.4 分,但前者通过了更难的标准,证据上暗示更高质量——GRPO 组内它们却拿到相同优势,学习信号被抹掉。第二,预设分值编码的是『这条标准在量规里应该有多重要』,而不是『它的判定在当前 rollout 群体上有多大区分力』;随着策略训练推进、多数标准的判定趋于一致(论文测得 52.3%–80.5% 的标准在组内全员同判定),固定权重无法反映每条判定此刻的信息量。第三,成本:评完整量规需要每条 rollout 调用 $K$ 次 judge,标准越多开销越大,而实测评判是策略步中最耗时的阶段。
本文的目标是本文要把量规聚合从『固定加权求和』改造成『统计推断』:不再把分值加起来,而是把整条判定向量当作关于单个潜在质量 $z_i$ 的证据,反推出最能解释这个判定模式的质量值作为奖励。具体目标有三层:(1)奖励层面——设计一个二参数项目反应模型,使每条判定的证据强度由该标准的难度 $b_j$ 和区分度 $a_j$ 决定,从而区分总分相同但模式不同的 rollout,并从理论上证明该聚合方式在局部信噪比意义上最优、达到 Fisher 信息界;(2)参数估计层面——训练一个从 prompt 和标准文本预测 $(a_j,b_j)$ 的响应参数网络(RPN),使其能泛化到训练时没见过的量规,并用在线 EM 跟随策略漂移持续校准;(3)成本层面——用同一个模型的 Fisher 信息在判定预算内挑选最有信息量的标准,减少 judge 调用而不损失训练效果。
与已有工作不同的是,本文的独特之处在于把教育测量的 IRT 框架『搬家』到 on-policy 强化学习中,并处理搬家带来的两个本质差异。此前 IRT 及其衍生工作各有明确边界:自适应测试(Weiss 1982)和面向语言模型的难度预测(Truong et al. 2025)测量的是固定的考生或模型,参数靠事后拟合校准题库;LLM 量规校准(Hashemi et al. 2024)、Rasch 模型评估(Uto 2021)服务于评分一致性而非训练信号。RRT 是第一个把『每次测量出的质量直接变成 GRPO 奖励』的 IRT 方案,被测对象随训练不断变化,因此必须引入在线 EM 做持续再校准——这是静态 IRT 应用所没有的。第二个差异是泛化:传统 IRT 需要大量作答数据才能估计题目参数,RRT 用 RPN 从文本直接预测参数,冷启动即可用于全新量规。与同期最接近的 POW3R(按 rollout 间对比重缩放人工权重)和 DIVA(按响应间方差加权软分数)相比,它们仍保留『每条标准一个全局权重』的加权和形式且必须评完全部标准;RRT 则彻底替换了聚合函数本身,并让权重隐式地随质量水平变化——定理 2 证明固定权重根本无法在所有质量水平上达到信息界。
核心方法
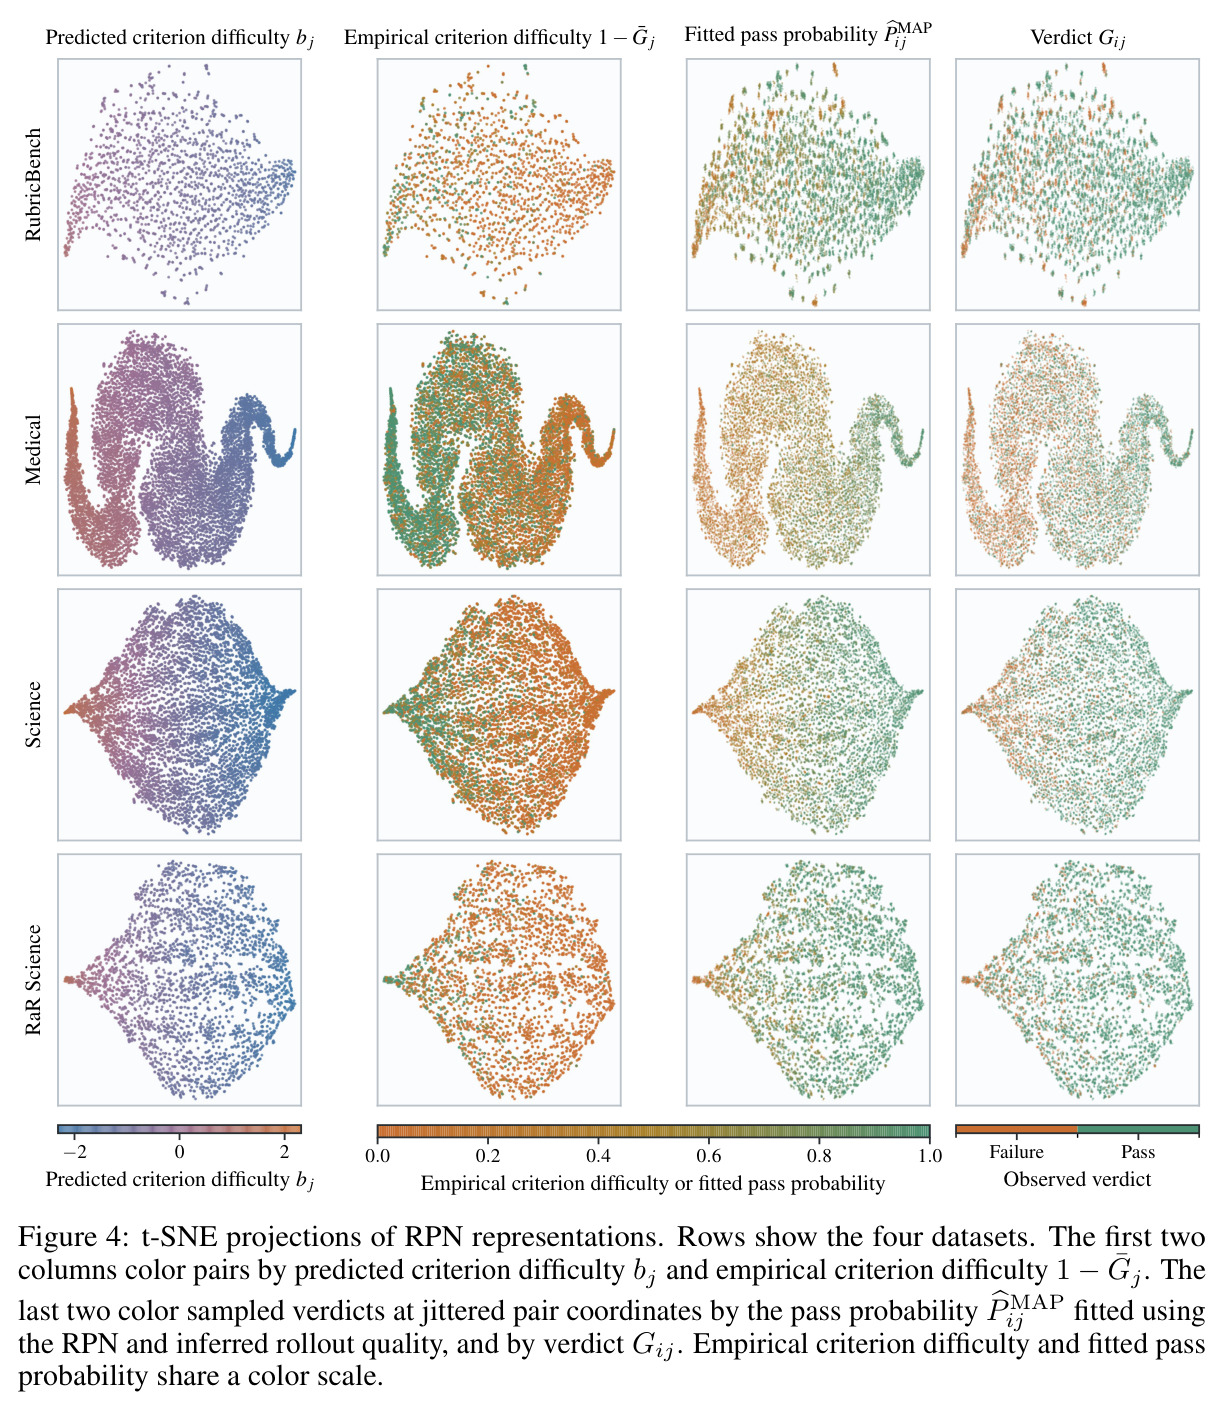
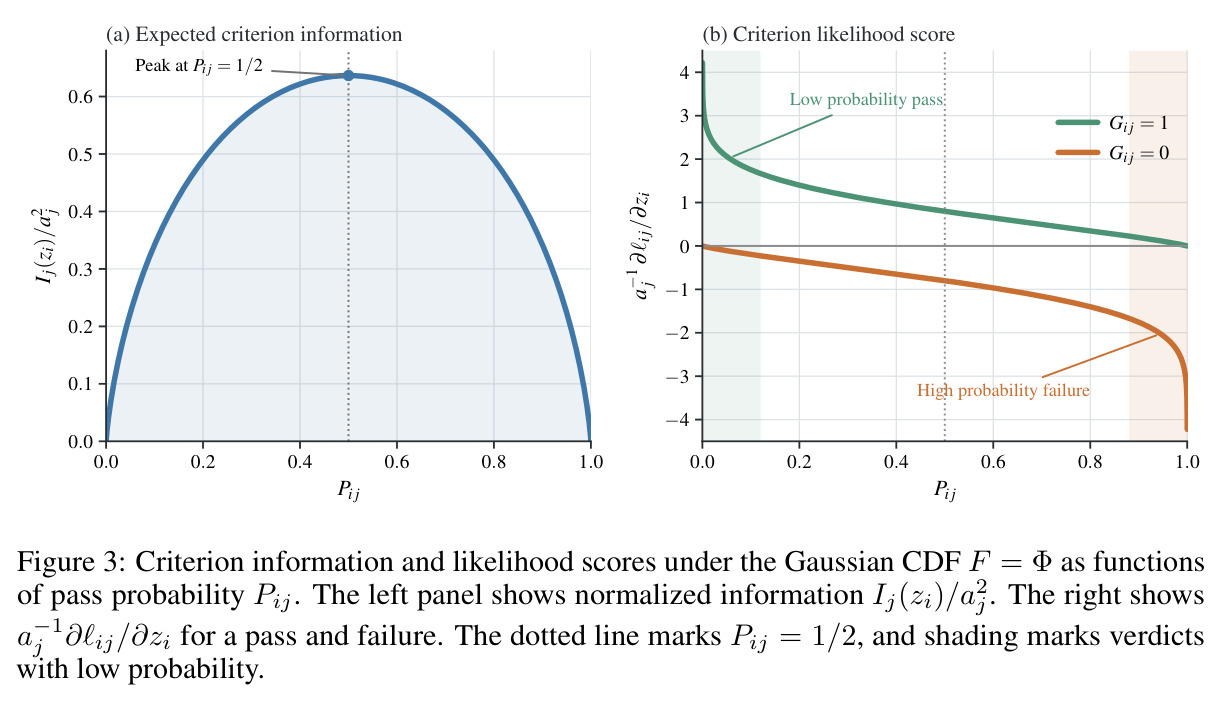
直觉上,RRT 把每条量规标准当成一道考题:有的标准『难』——绝大多数 rollout 都过不了;有的标准『区分度低』——好回答和差回答的通过率差不多。一条 rollout 对 $K$ 条标准的判定模式,就像一个考生对 $K$ 道题的作答记录,蕴含着关于其潜在质量 $z_i$ 的统计证据。技术路线分三步。第一步建模:每条标准 $j$ 有难度 $b_j$ 和区分度 $a_j>0$,rollout $i$ 通过它的概率为 $P_{ij} = F(a_j(z_i - b_j))$,其中 $F=\Phi$ 取标准高斯 CDF($F(0)=0.5$,即 $b_j$ 是通过概率过半的质量点);给定质量,各判定条件独立,$G_{ij} \sim \text{Bernoulli}(P_{ij})$。第二步推断:把 $K$ 个 Bernoulli 因子的似然与 $N(0,\sigma_z^2)$ 高斯先验相乘,取后验众数 $R_i = \hat{z}_i = \arg\max_z \ell_i(z)$ 作为 GRPO 奖励,对数后验严格凹、用二分法求解。第三步学习:响应参数网络 RPN $\psi$ 从 prompt 和标准文本预测 $(a_j,b_j)$,先在训练数据上 warm start,训练过程中每个策略步做一次在线 hard EM——E 步复用 MAP 推断更新 $\hat{z}_i$,M 步固定 $\hat{z}_i$ 最小化负对数似然加区分度正则 $\lambda_a (\log a_j)^2$。这套参数同时用于准则选择:按未评标准的 Fisher 信息 $\sum_i I_j(\hat{z}_i)$ 排序,预算内优先评判信息量最大的标准。
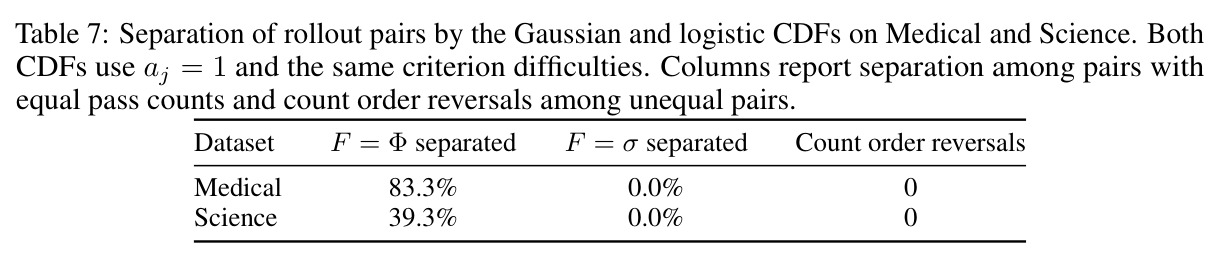
核心创新是把『点数』与『证据』分开。预设分值 $w_j$ 说的是量规设计者认为这条标准应该多重要,是先验的、全局的;而 RRT 度量的是这条判定的通过/失败在当前 rollout 群体中揭示了多少质量信息,是后验的、随策略分布变化的。由此带来的本质区别是:奖励由完整判定模式决定而非总分决定。论文用五条等权标准的例子说明:rollout 1 得 $(1,1,0,0,0)$、总分 0.4、RRT 奖励 $+0.75$;rollout 2 得 $(0,1,1,1,0)$、总分 0.6、奖励 $+1.61$;而按点数应得 0.2 分的 rollout 5 $(0,0,0,0,1)$ 却拿到 $+0.75$——它通过了唯一一条最难的 标准,与两条中等标准的证据等价。理论上这被定理 2 形式化:在二参数 IRT 模型下,量规似然得分 $S_i(z)=\sum_j S_{ij}(z)$ 在所有判定标量函数中最大化局部信噪比 $\text{SNR}_T^2 = (\partial_z E[T|z])^2 / \text{Var}(T|z)$,达到 Fisher 信息界 $\sum_j I_j(z)$;固定权重 $w_j$ 只有在 $w_j \propto a_j \phi(u_{ij})/[P_{ij}(1-P_{ij})]$ 时才在单一质量点达到界,而两条参数不同的标准不可能用一组固定权重在所有质量水平上达标——即加权求和原理上就不是最优聚合。另一个关键选择是高斯 CDF 而非 Logistic:Logistic 下 rollout 排序只由 $\sum_j a_j G_{ij}$ 决定、难度不影响排序,而高斯 CDF 让难度参与排序,实测能分开 Medical 上 83.3% 通过数相同的 rollout 对。
方法步骤详情
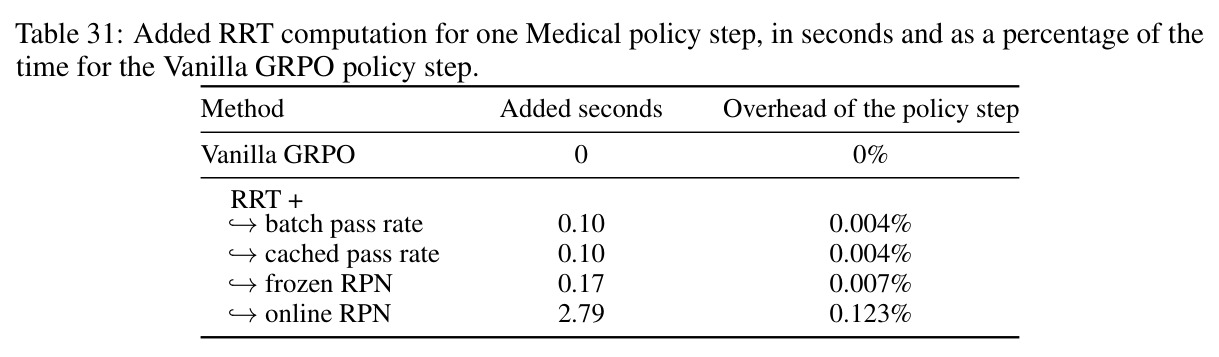
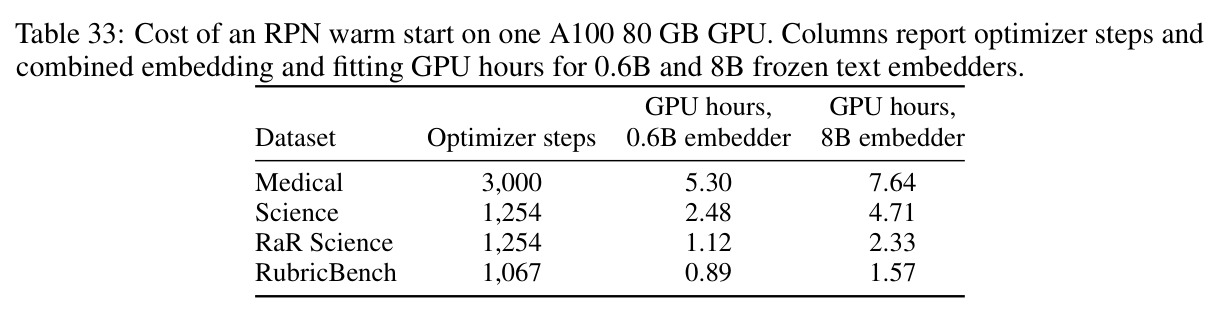
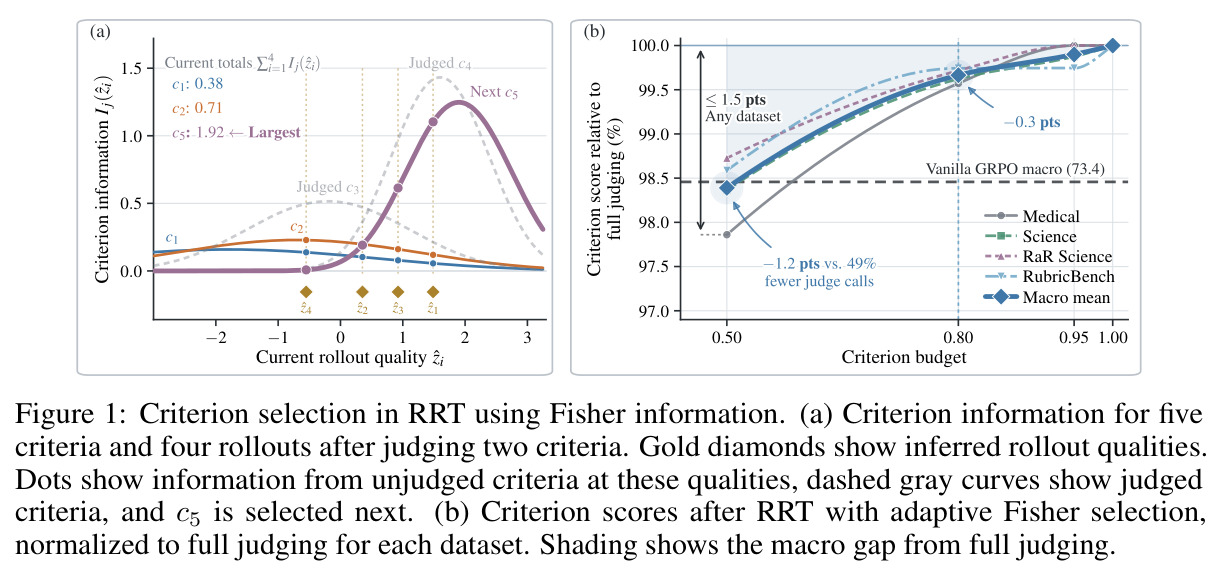
完整流程嵌入标准 GRPO 训练循环(每步 32 个 prompt、每个 8 条 rollout、一个 PPO epoch)。第 1 步,采样与判定:策略对每个 prompt 生成 8 条 rollout,judge(GPT-5.5、关闭推理模式)对每条 rollout 逐条标准给二值判定 $G_{ij}\in\{0,1\}$——满足正向标准或避开陷阱记 1(判定矩阵 $G \in \{0,1\}^{N\times K}$)。第 2 步,参数预测:RPN 用文本嵌入器编码 prompt 和标准文本,输出 $(a_j, b_j) = \psi(q, c_j)$,$a_j>0$ 用软约束保证;RPN 先在训练集的缓存判定上 warm start(每数据集 0.89–7.64 A100 GPU 小时)。第 3 步,E 步奖励推断:对每条 rollout 求解 $\hat{z}_i = \arg\max_z \{\sum_j \ell_{ij}(z) - z^2/(2\sigma_z^2)\}$,其中 $\ell_{ij}(z)$ 是第 $j$ 个 Bernoulli 因子的对数;对数后验严格凹(定理 6),用定理 3 给出的梯度做二分法求唯一根;$R_i=\hat{z}_i$ 送入 GRPO 计算组内优势。第 4 步,M 步参数更新:固定所有 $\hat{z}_i$,最小化 $L(\psi) = -\frac{1}{NK}\sum_{i,j}\ell_{ij}(\hat{z}_i;\psi) + \frac{\lambda_a}{K}\sum_j (\log a_j)^2$,正则项把区分度拉向 1 防止其退化到极端值;每步只做一次随机部分扫掠,额外计算仅为一个 Medical GRPO 步的 0.123%。第 5 步(可选),自适应 Fisher 准则选择:给定预算 $m<K$,对当前已推断质量 $\hat{z}_i$ 计算每条未评标准的 Fisher 信息 $I_j(z) = a_j^2 \phi(u_{ij})^2/[P_{ij}(1-P_{ij})]$($u_{ij}=a_j(\hat{z}_i-b_j)$),选 $\sum_i I_j(\hat{z}_i)$ 最大的标准让 judge 评判,评完立即更新全部 $\hat{z}_i$,循环直到预算用尽。
技术新颖性
技术新颖性体现在四个层面。其一,问题重构:以往把量规聚合视为『设计加权方案』(固定权重、学习权重、方差加权),RRT 把它重构为『潜在变量推断』,聚合函数由生成模型而非手工规则给出,且权重隐式依赖质量水平——这是与 POW3R、DIVA 等同期自适应加权工作的根本区别,后者仍是每标准一个全局权重的加权和。其二,理论支撑完整:不只是提出模型,还证明了似然得分的局部 SNR 最优性(定理 2,达到 Cramér-Rao 型信息界)、对数后验严格凹性与唯一性(定理 6)、点数奖励的单调性(定理 8,保证基线在随机占优意义下不自相矛盾)、以及高斯 vs Logistic CDF 对奖励排序的不同影响(定理 4、5),形成闭环论证。其三,冷启动加在线校准的组合解决了 IRT 应用于 RL 的两个现实障碍:RPN 文本预测免去新量规的大样本参数拟合,在线 EM 应对策略漂移;消融显示两者缺一不可——经验通过率参数比 RPN 低 1.0–1.2 宏观点,冻结 RPN 又比在线 RPN 低 0.5 点。其四,Fisher 信息在奖励推断与准则选择间建立统一基础:同一组 $(a_j,b_j)$ 既定义每条判定的证据(似然得分)也定义未评标准的预期信息(Fisher 信息),把自适应测试四十年的信息原则(Weiss 1982)首次接入 RL 训练回路。
实验结果
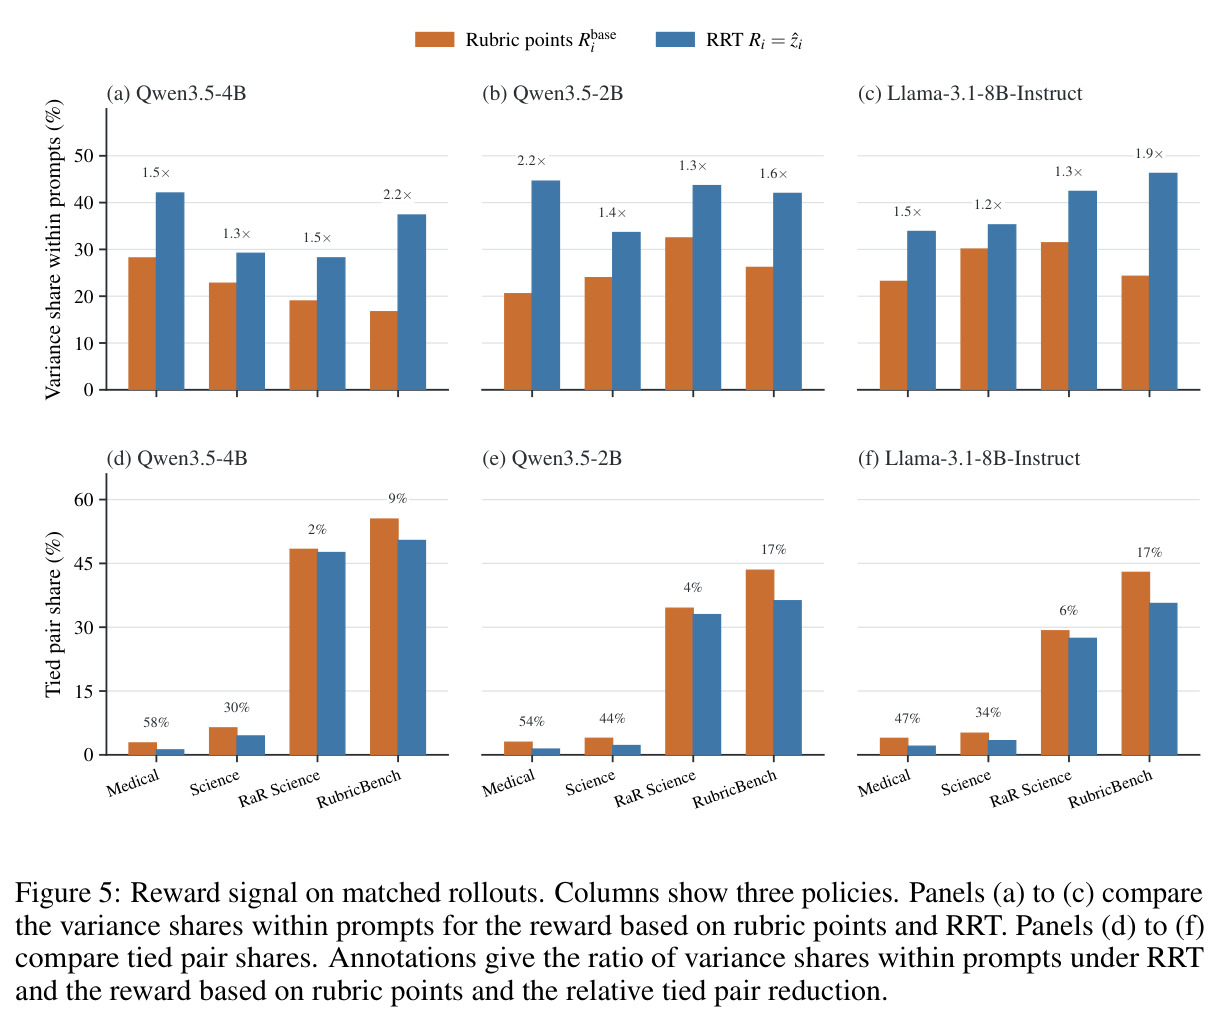
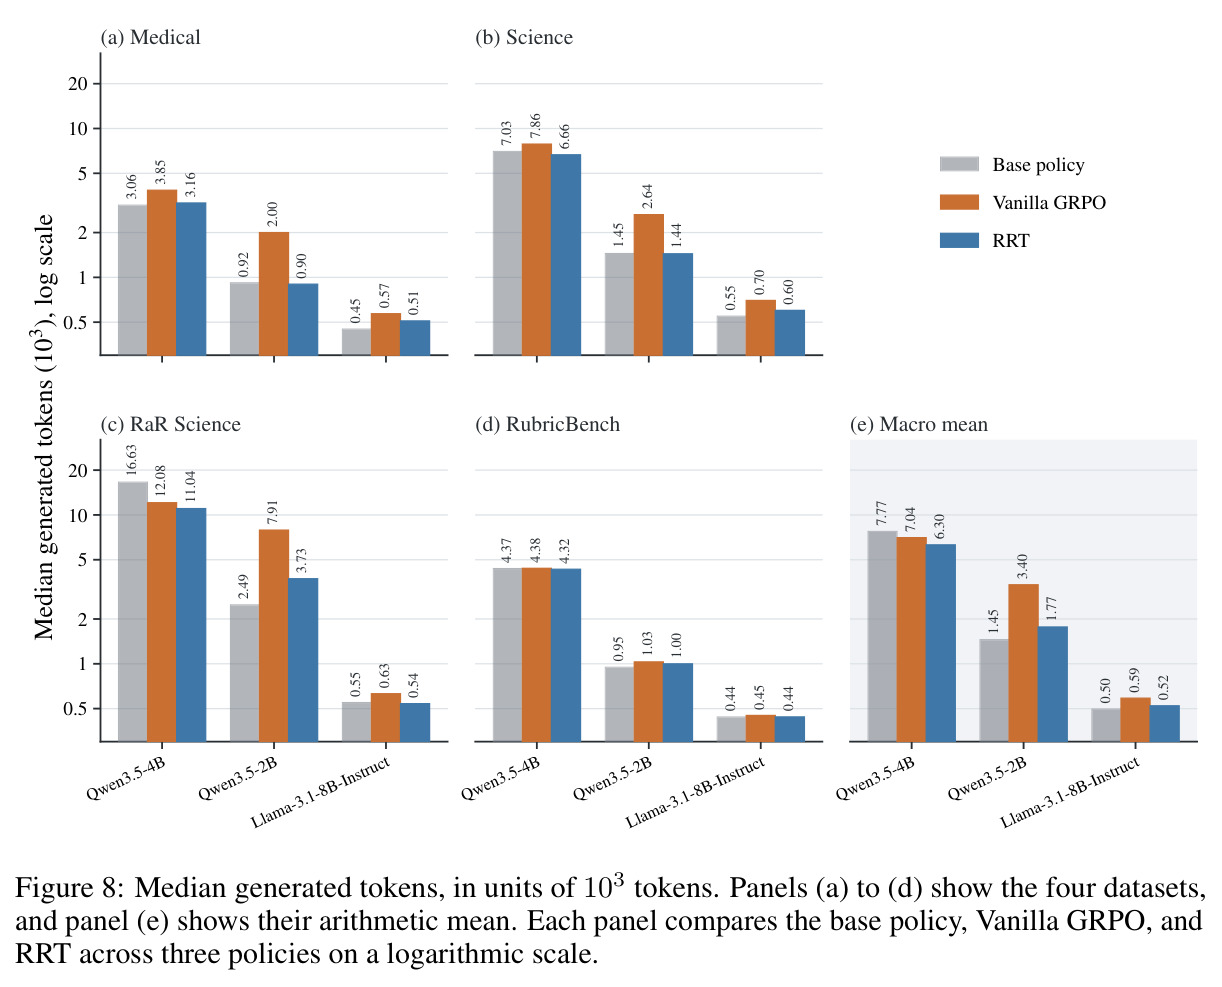
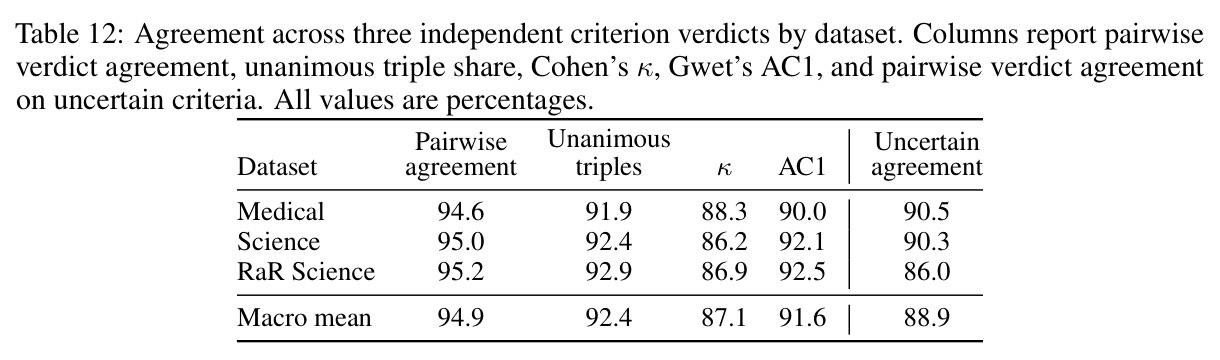
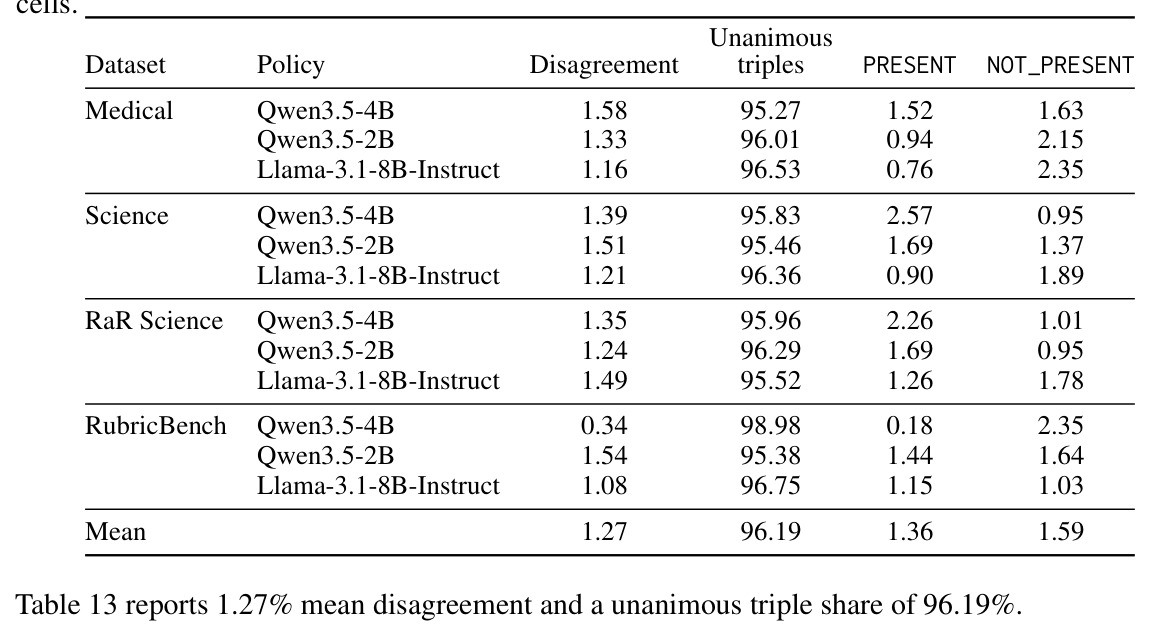
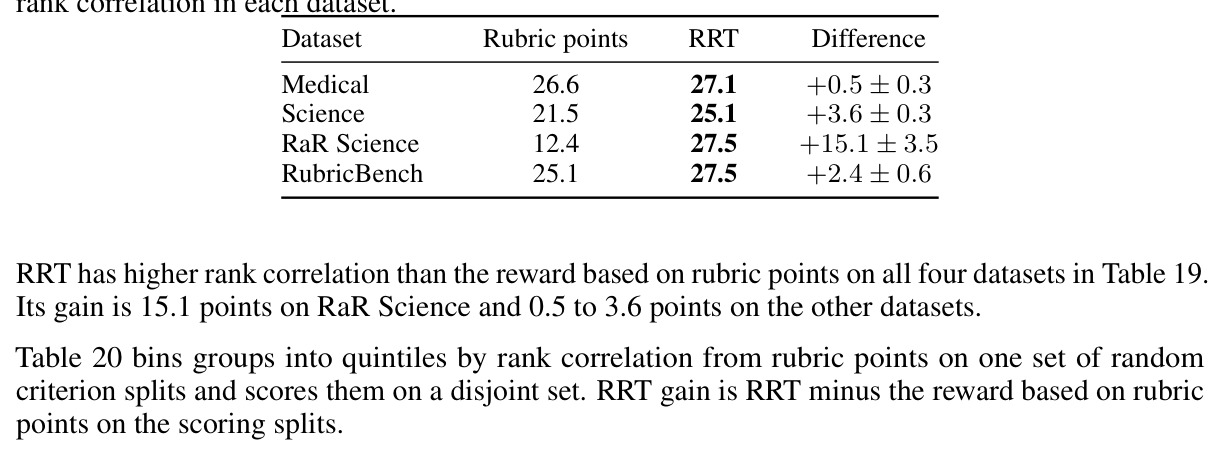
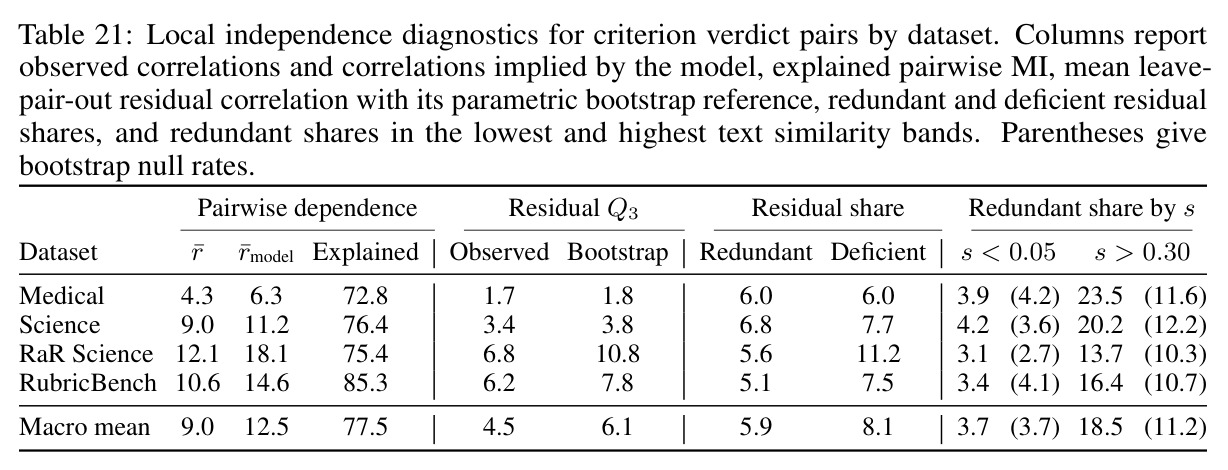
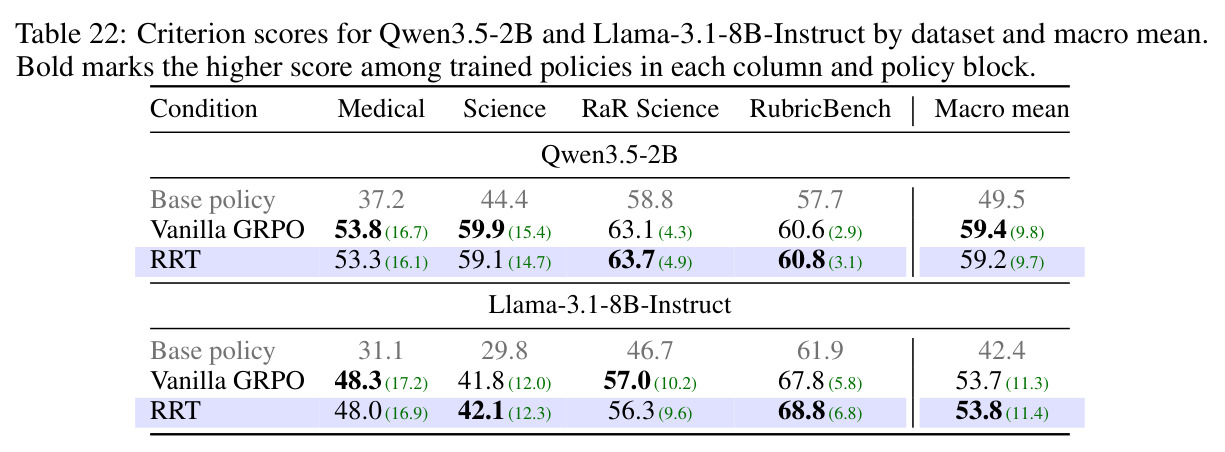
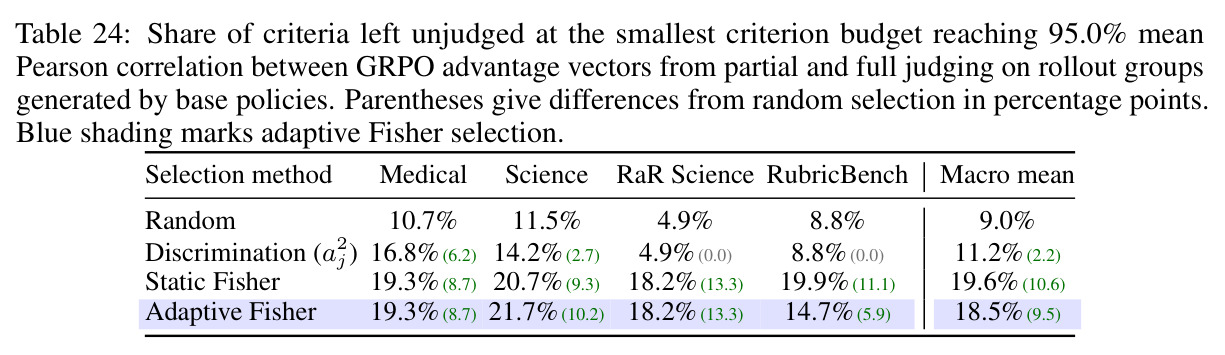
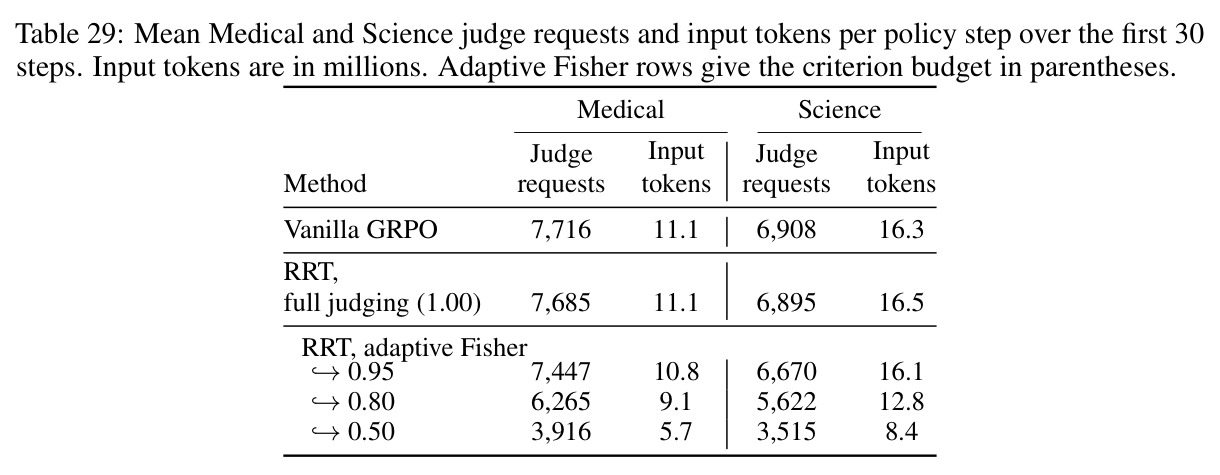
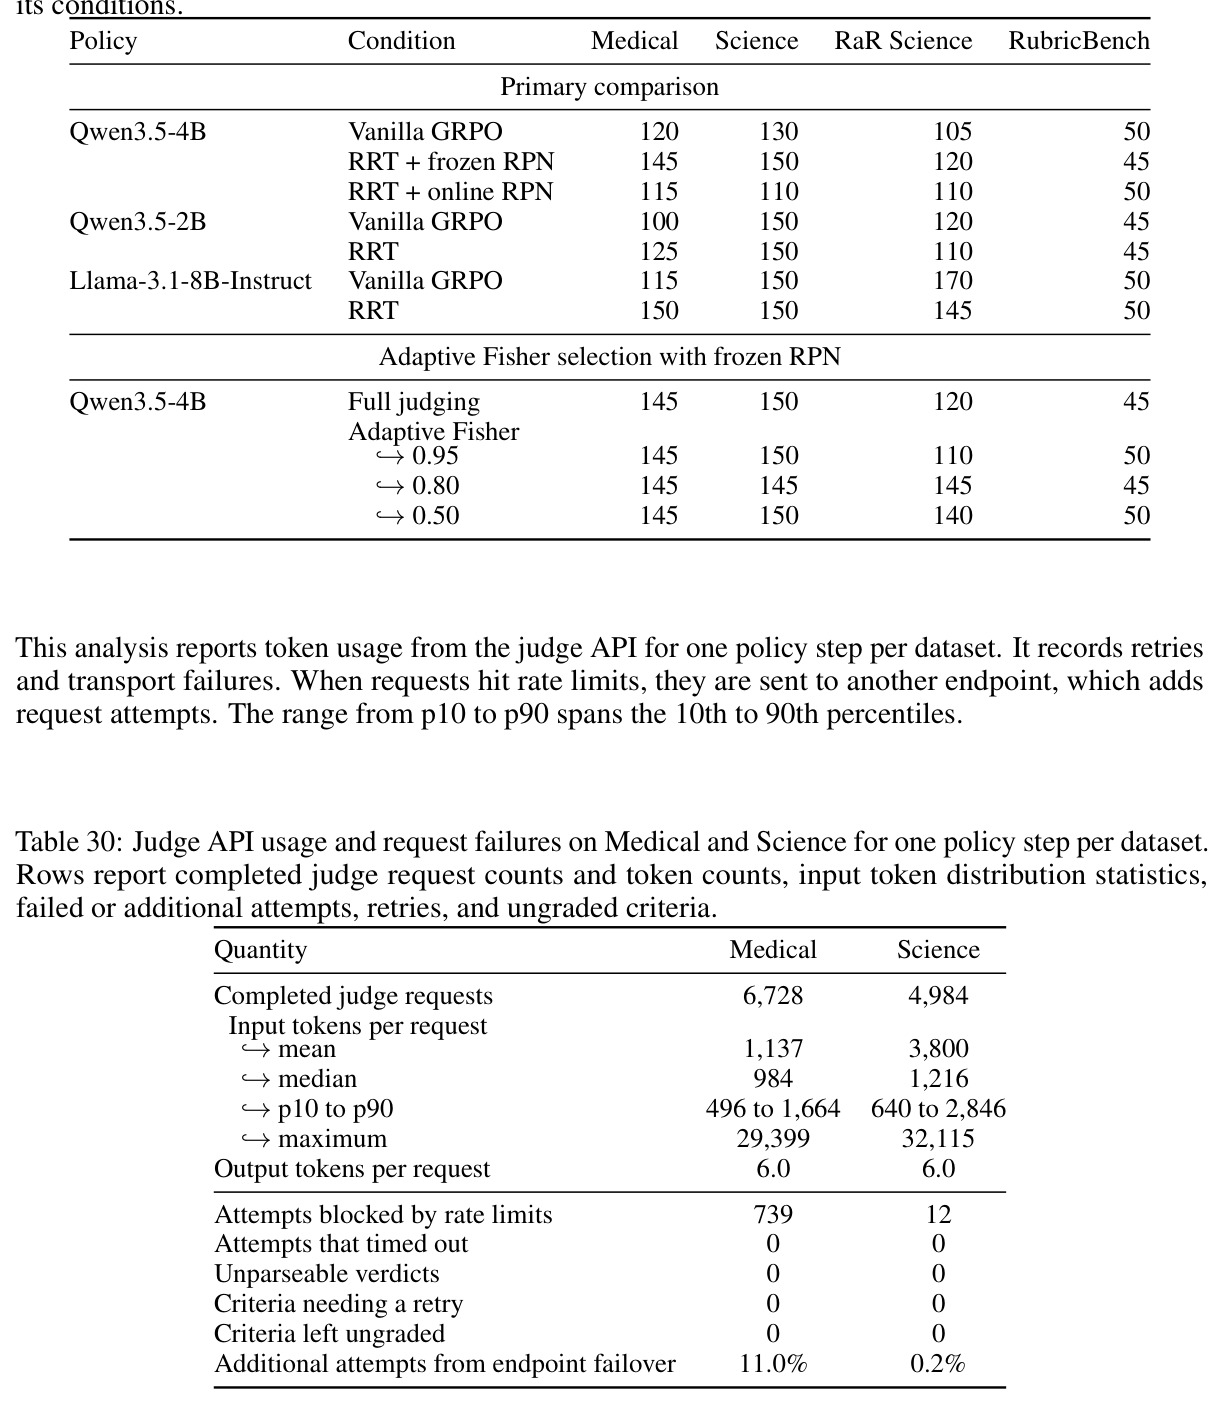
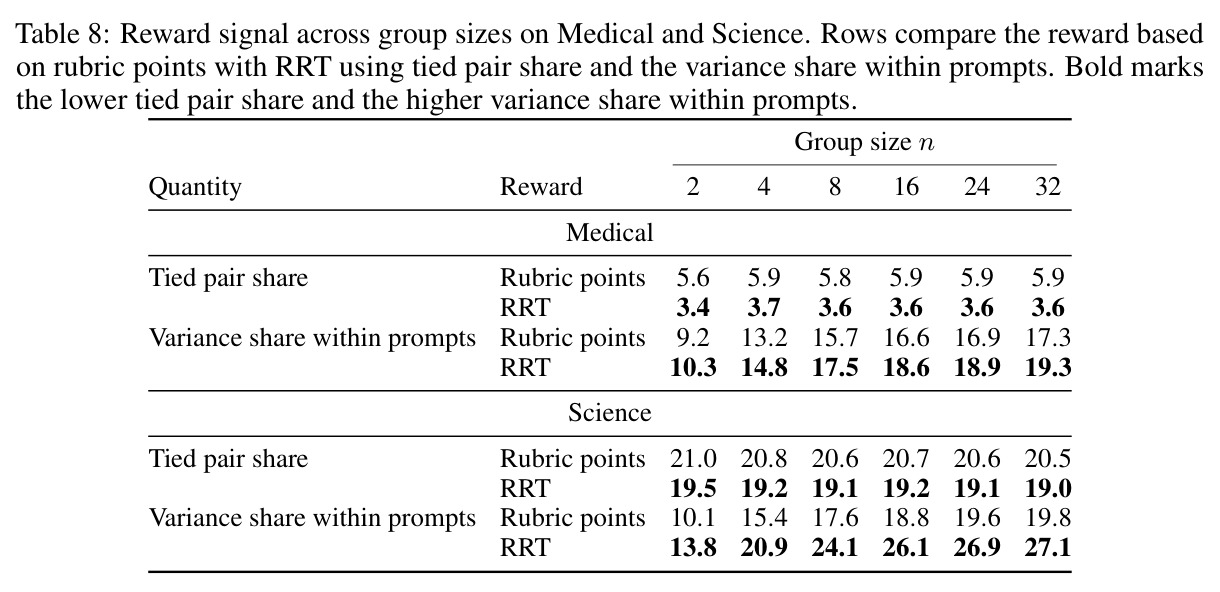
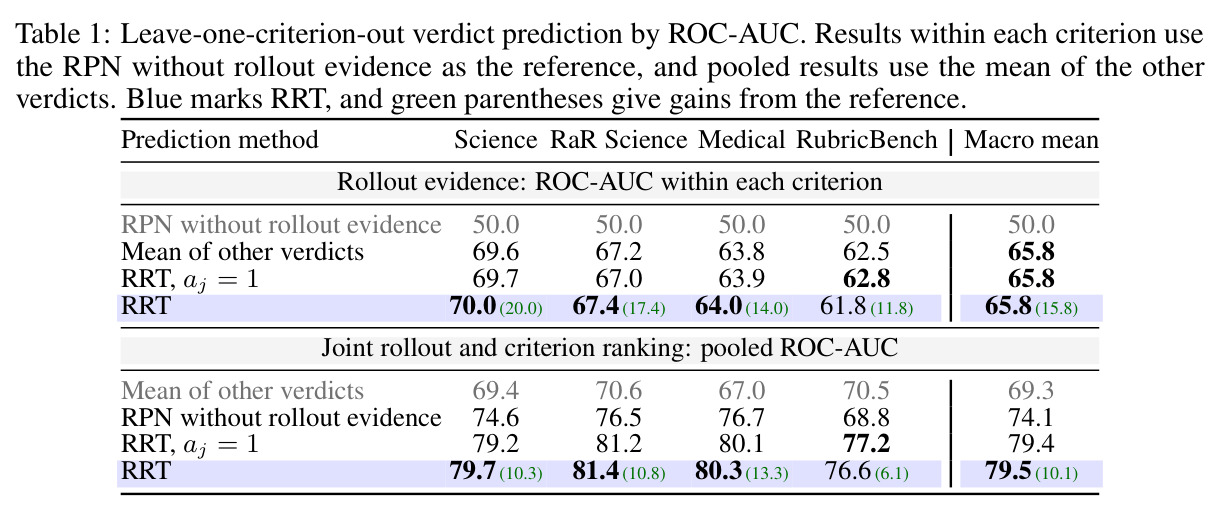
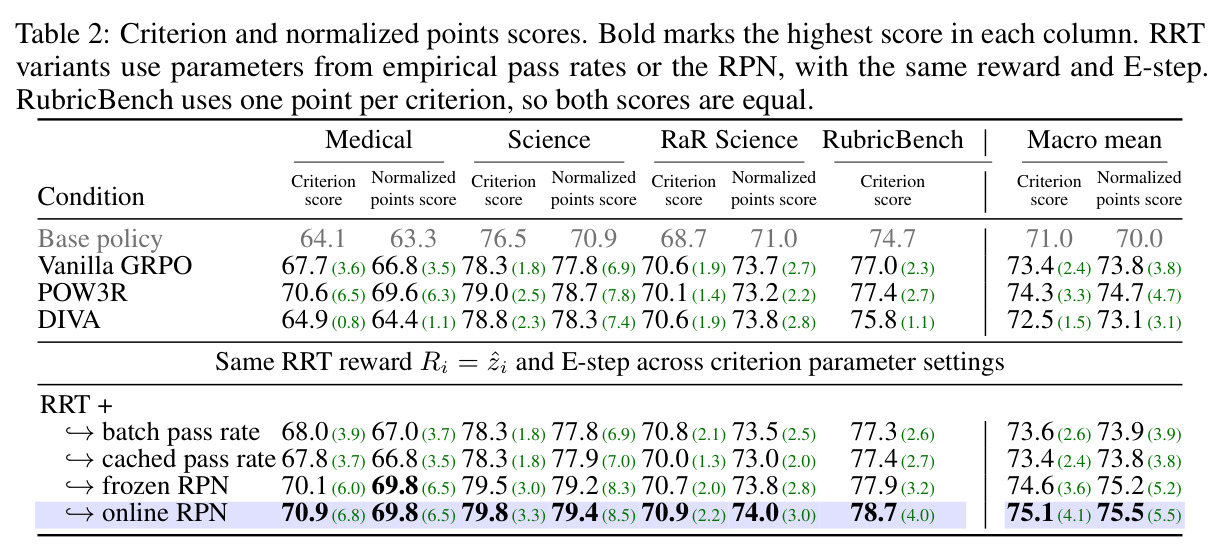
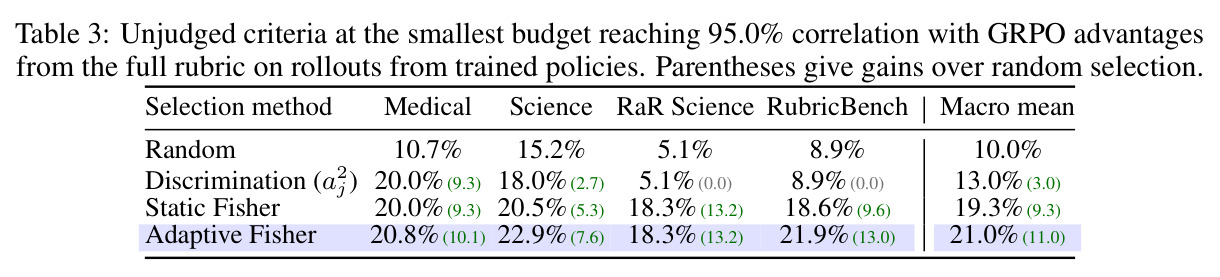
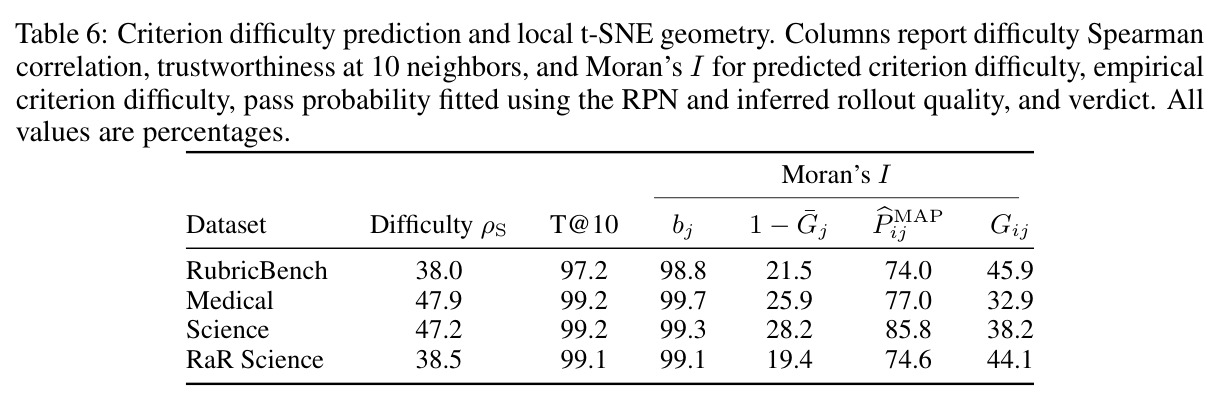
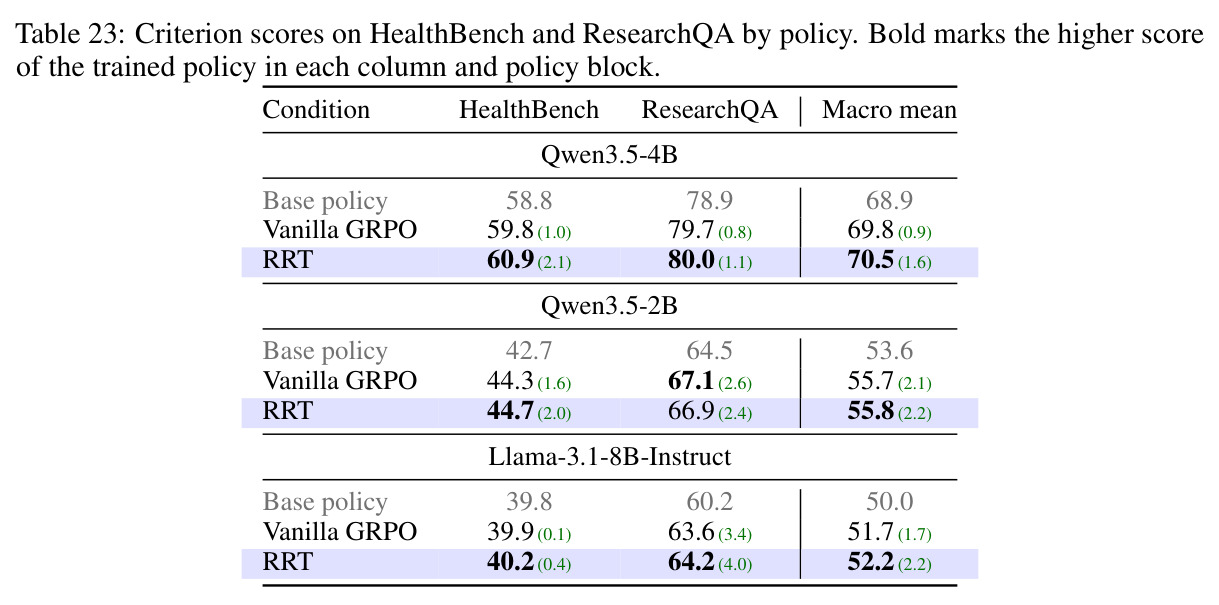
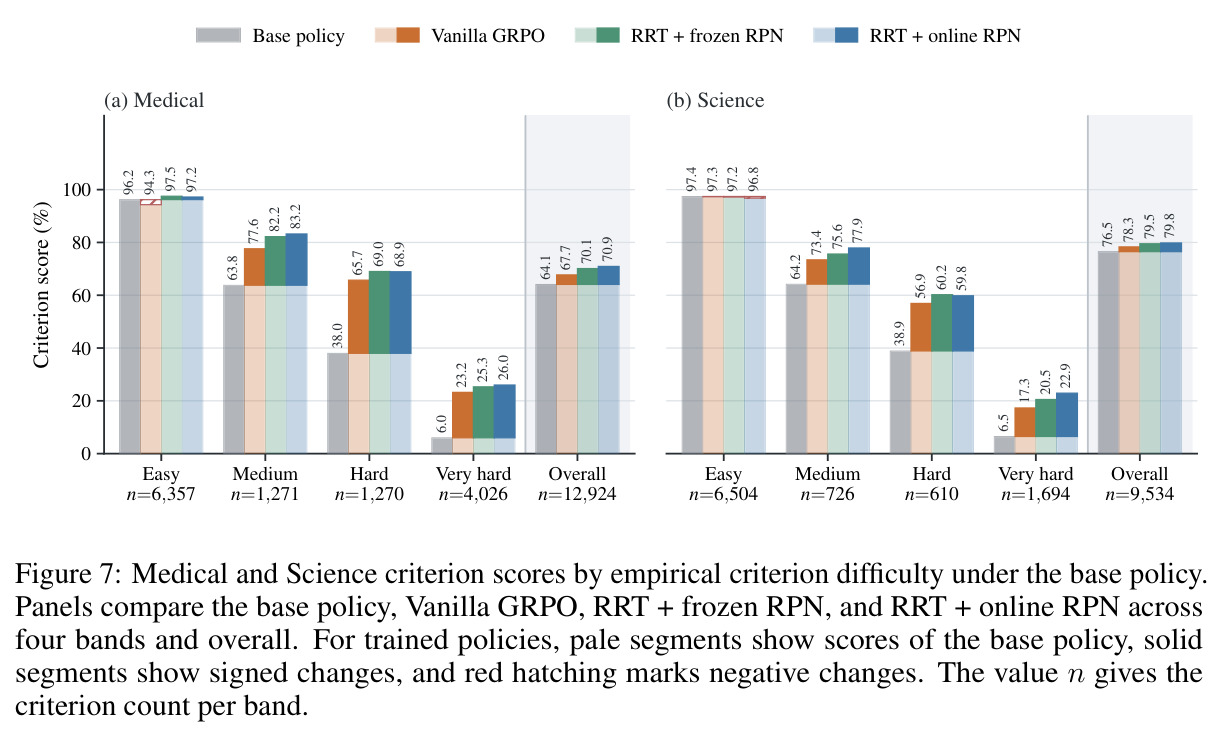
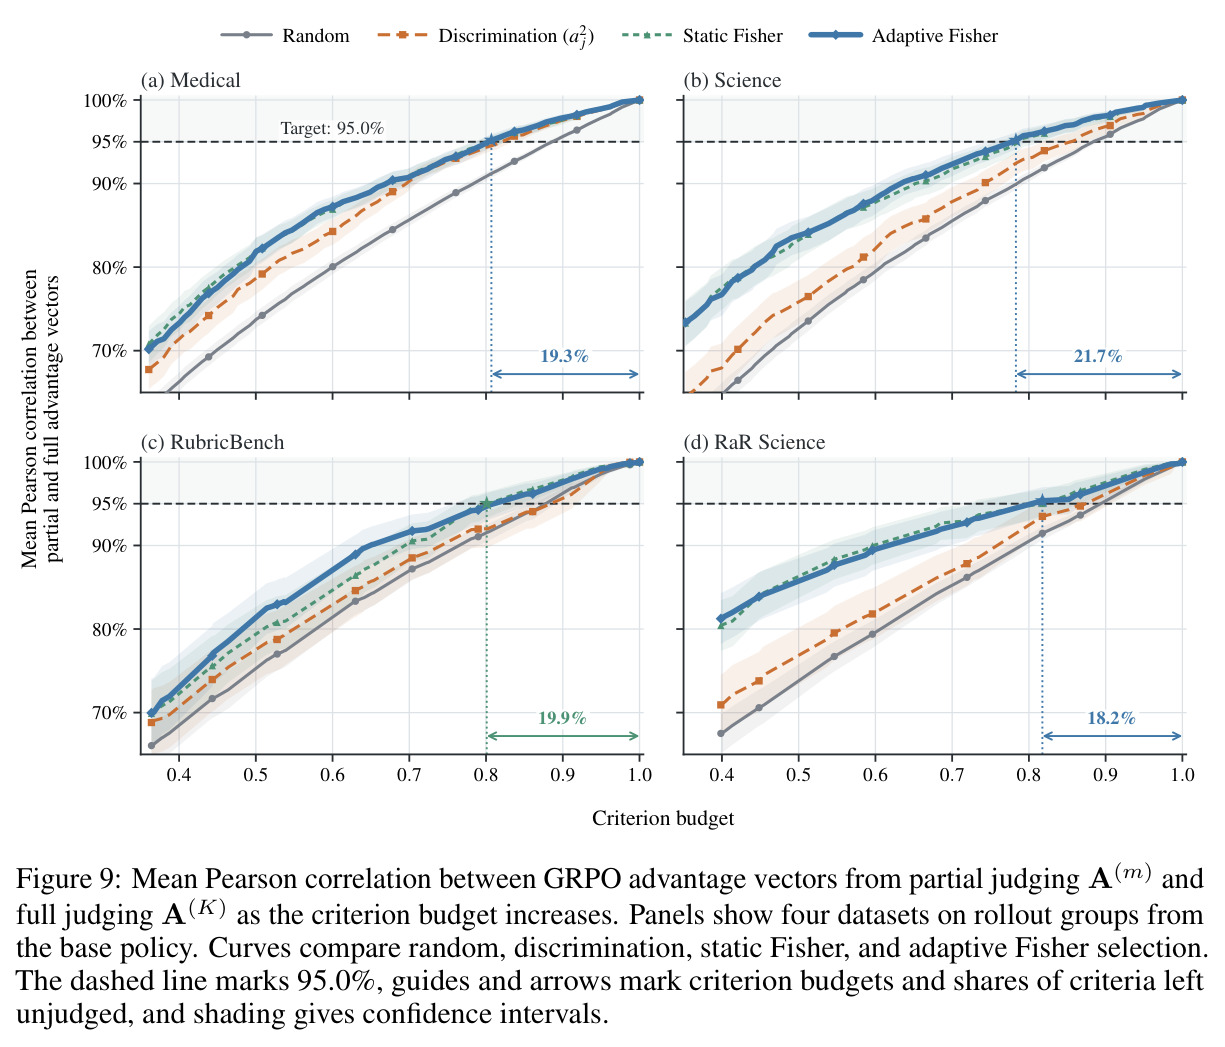
主实验(Qwen3.5-4B 策略、四个数据集、每条件一次训练运行):RRT + online RPN 在宏观准则得分上达到 75.1%,比 Vanilla GRPO 的 73.4% 高 1.7 点,比 POW3R(74.3%)高 0.8 点,比 DIVA(72.5%)高 2.6 点,且在 Table 2 的每一列都是最高或并列最高;宏观归一化点数得分 75.5% 对 73.8%。分层分析最有说服力:按基策策略下的经验难度把标准分带后,RRT 在 Medical 和 Science 的八个难度带中七个超过 GRPO 2.8–5.6 点,Medium、Hard、Very hard 带全部胜出——说明收益恰好在基模型常失分的标准上。跨策略迁移:Qwen3.5-2B 上比 GRPO 低 0.2 点、Llama-3.1-8B-Instruct 上高 0.1 点(基本持平),但两策略在 RubricBench 上都更高;泛化到训练分布外的 HealthBench 和 ResearchQA 仍领先 0.1–0.7 宏观点。副产物:RRT 在全部 12 个数据集×策略组合中生成更短的回答,数据集中位响应长度均值比 GRPO 低 10.6%–47.9%。奖励质量方面:留一准则预测的合并宏观 ROC-AUC 达 79.5,比『其余判定均值』基线 69.3 高 10.1 点;相比点数奖励,RRT 组内方差份额提高 1.2–2.2 倍、tie 对减少 2%–58%,重复评判下稳定非零排序份额宏观提升 5.4 点(judge 三次判定间分歧仅 1.27%,说明这不是靠噪声赌博)。效率方面:在 95% 奖励保真(与全量评判 GRPO 优势的 Pearson 相关)下,自适应 Fisher 选择宏观留下 21.0% 的标准不评(随机选择仅 10.0%);预算砍半时四数据集宏观得分与全量评判的 Vanilla GRPO 差距不超过 0.1 点,judge 请求减少 49.0%,中位评判时间降 49.1%–49.6%,策略步总时间降 23.5%–28.7%。局部独立性检验显示拟合质量解释了 72.8%–85.3% 的判定对互信息,支持模型核心假设。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四数据集宏观准则得分(Qwen3.5-4B 策略训练) | Criterion score (%) | 75.1(RRT + online RPN) | 73.4(Vanilla GRPO)/ 74.3(POW3R)/ 72.5(DIVA) | +1.7 点(对 GRPO),+0.8 点(对最强基线 POW3R) |
| 四数据集宏观归一化点数得分 | Normalized points score (%) | 75.5 | 73.8(Vanilla GRPO) | +1.7 点 |
| Medical/Science 按基策略难度分带的准则得分 | 各难度带 criterion score 差值(百分点) | 八个难度带中七个超过 GRPO 2.8–5.6 点 | Vanilla GRPO | Medium/Hard/Very hard 带全部领先,最高 +5.6 点 |
| 留一准则判定预测(合并排序) | Pooled macro ROC-AUC (%) | 79.5(RRT) | 69.3(其余判定均值)/ 74.1(无 rollout 证据的 RPN) | +10.1 点(对均值基线),+5.4 点(对纯文本预测) |
| 准则预算减半下的策略训练 | 宏观 criterion score 与全量评判 GRPO 之差(百分点) | 73.4,差距 ≤0.1;judge 请求减少 49.0% | 73.4(Vanilla GRPO 全量评判);随机选择半预算 GRPO 掉到 71.1 | 同分情况下节省一半评判;比随机半预算 RRT 高 0.4 点 |
| 95% 奖励保真下的准则选择 | 达到 0.95 Pearson 相关时可留空的标准比例 (%) | 21.0(自适应 Fisher) | 10.0(随机)/ 19.3(静态 Fisher)/ 13.0(仅区分度) | 比随机多省 11.0 点标准,比静态 Fisher 多省 1.7 点 |
| 分布外泛化(Medical→HealthBench,Science→ResearchQA) | Macro criterion score 差值(百分点) | +0.1 至 +0.7 | Vanilla GRPO | 训练量规之外仍保持正向迁移 |
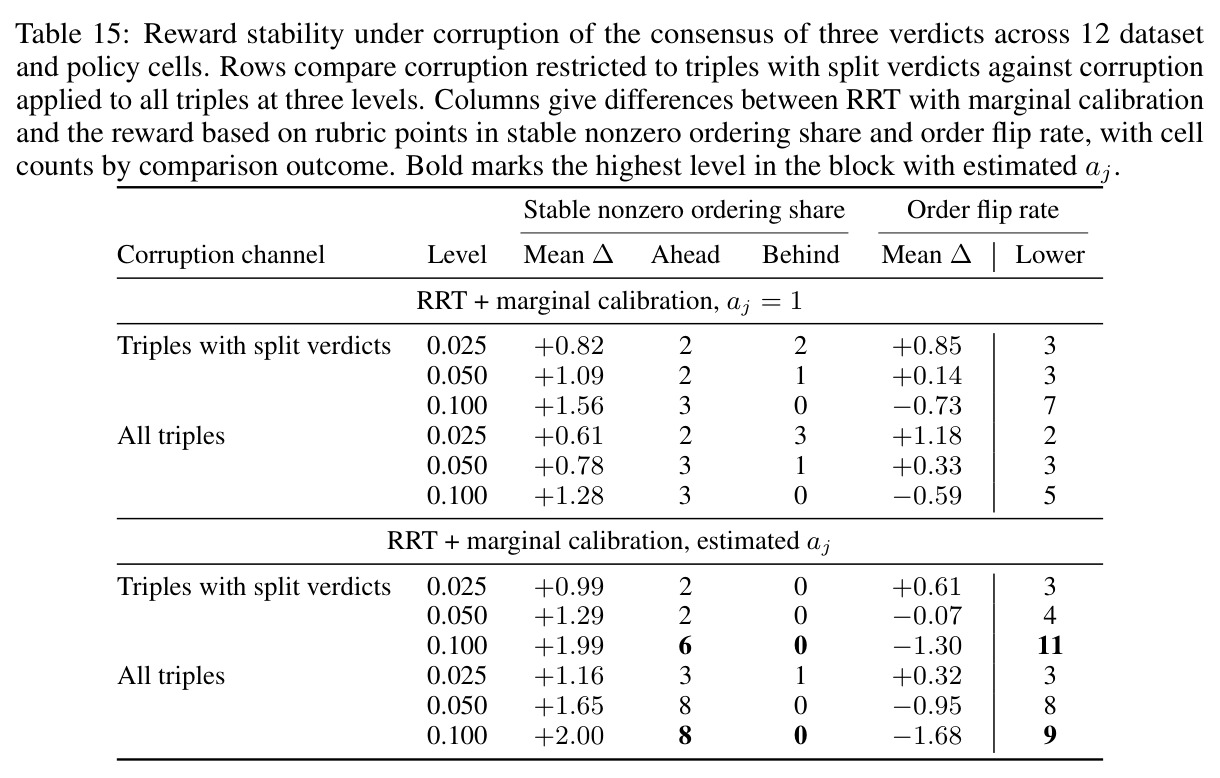
| 重复评判下的奖励排序稳定性 | 稳定非零排序份额(宏观均值,百分点) | 比点数奖励高 5.4(边际校准后) | 点数奖励 $R^{base}$ | +5.4 点;0.10 污染强度下平均顺序翻转率更低 |
局限与改进
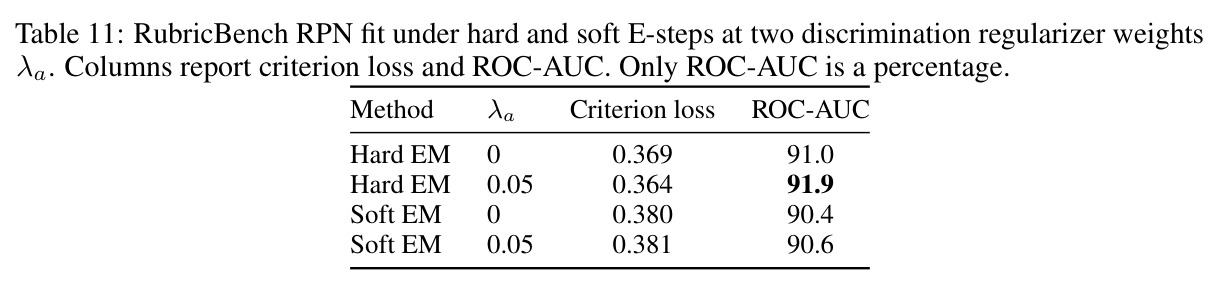
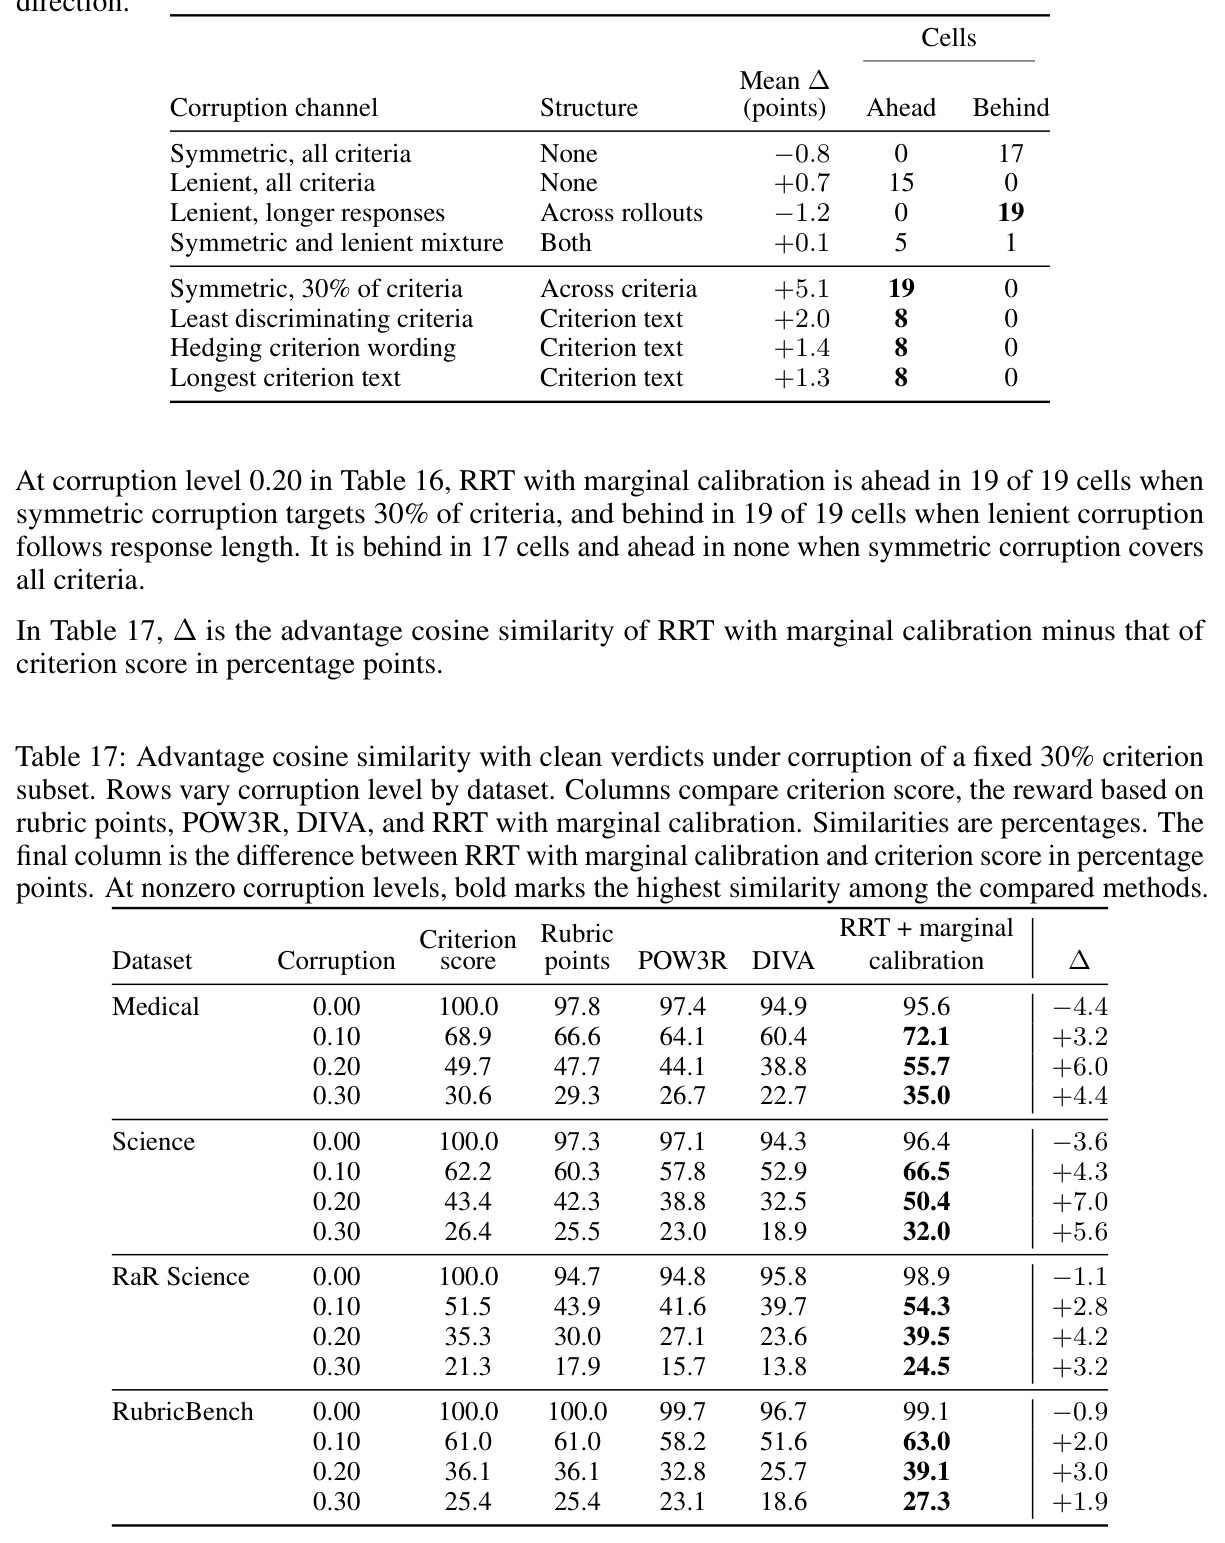
作者承认的局限:模型假设所有标准是单一质量维度的单调指标且局部独立,但诊断显示拟合质量只解释 72.8%–85.3% 的成对互信息,文本最相似的标准对残余冗余显著超出 bootstrap 零假设 3.4–11.9 点,说明一维 IRT 无法完全吸收标准间相关性;显式包含权衡(如内容详实 vs 简洁)的量规天然需要多维质量。噪声鲁棒性并非全面占优:在对称地作用于全部标准、或与回答长度相关的宽松噪声通道下,简单准则得分比 RRT 的优势相似度还高 0.8–1.2 点,RRT 的优势集中在污染集中于特定标准子集的情形。我自己的观察:其一,小策略上收益消失(Qwen3.5-2B 低 0.2 点),提示质量推断的统计功效依赖足够强的策略产生有信息量的判定模式,组内 8 条 rollout 的样本量偏小时 MAP 估计噪声可能抵消模型收益;其二,MAP 点估计丢弃了后验不确定性,虽然论文测得 soft E-step(完整后验)反而更差、颇为意外,但这暗示『如何利用后验方差』仍有探索空间;其三,整条流水线依赖一个强商业 judge(GPT-5.5)给出高质量二值判定,未测试较弱或开源 judge 下 RPN 校准是否还能收敛;其四,所有策略实验每条件只跑一次、置信区间只覆盖 prompt 组间变异,1.7 点的宏观优势缺少跨种子方差佐证;其五,RPN warm start 需要每个数据集预拟合(0.89–7.64 GPU 小时)并缓存判定矩阵,对超大规模 RL 运行的工程成本未讨论。
独立分析的弱点
弱点一:一维质量假设在多目标量规上会失真。医疗回答常要求同时兼顾准确性与安全性,若某 rollout 安全性满分但内容平庸,一维 $z$ 只能给出一个折中分数,且单调指标假设迫使所有标准同向。改进方向:升级为多维 IRT(MIRT),让每条标准在质量向量 $\mathbf{z}$ 上有自己的载荷,GRPO 可对各维度分别计算优势。弱点二:文本相似的冗余标准既浪费 judge 调用又违反局部独立。论文测得最相似文本对中残余冗余超零假设最多 11.9 点,自适应 Fisher 选择目前只按边际信息排序、未惩罚相关性,可能连续选中互信息的标准。改进方向:在排序得分中加入成对残余相关(Yen 的 Q3 统计)惩罚,或先做标准去重/聚类再分配预算。弱点三:奖励是点估计,GRPO 优势对推断不确定度不敏感——两条 $\hat{z}$ 相同但后验方差悬殊的 rollout 获得同等对待,证据薄弱时(如组内判定几乎全同,占 52%–80%)优势噪声大。改进方向:把后验方差传入优势归一化(如按信息量 $I(\hat{z}_i)$ 加权),或用期望后验改善替代众数。弱点四:二值判定丢弃了 judge 可提供的分级软分数,DIVA 证明软分数携带额外信号。改进方向:换成分级反应模型(graded response model),保持 Fisher 框架同时利用序数信息。弱点五:对 judge 的单点依赖未建模 judge 自身偏差——Uto (2021) 的含 rater 效应模型表明忽略评分者差异会系统偏移估计。改进方向:在 Bernoulli 因子中加 judge 偏好/严格度参数,多 judge 投票时进行联合校准。
未来方向
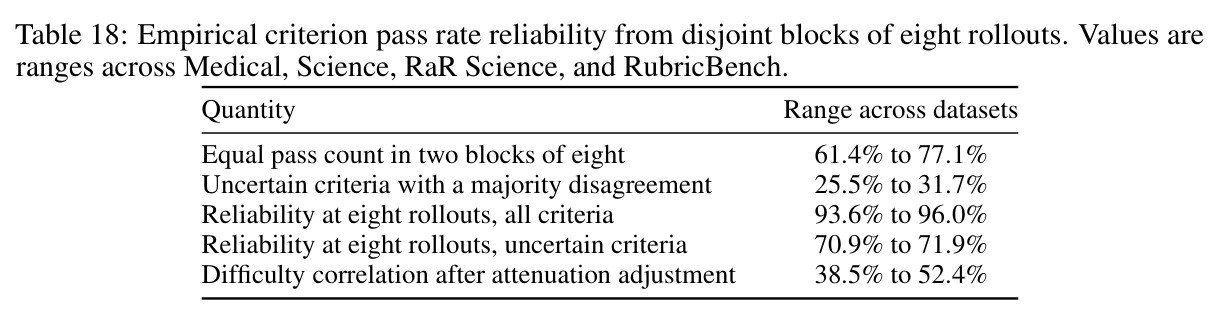
作者明确提出的方向:为标准间残差依赖建模(引用 Yen 1984 的已知偏差),以及用多维质量目标容纳显式权衡的量规。基于本文成果可自然延伸的方向:第一,把 Fisher 选择从『选标准』推广到『标准×rollout 联合分配』——对组内质量居中(信息量最大)的 rollout 多评标准、对判定已确定的全过/全挂 rollout 少评,论文已测得此类不确定标准上的通过率块间信度仅 70.9%–71.9%,有压缩空间;第二,把后验分布而非点估计接入 GRPO,例如以质量后验做优势的不确定性折扣,或用 Thompson 采样选择 rollout 进行优势对比;第三,与过程奖励结合——推理步骤级的评分天然是『多题测量一个能力』的 IRT 场景,RPN 可从步骤文本预测参数;第四,理论缺口:在线 EM 与策略梯度交替更新的收敛性目前没有保证,值得建立一个类似『测量-优化』交替的两尺度收敛分析;第五,部署侧应用——RPN 可在推理时做 self-critique 的标准挑选,让模型只对照最有区分力的检查点自我修正;第六,跨数据集/跨量规的 RPN 迁移与元学习,论文目前每数据集独立 warm start,共享的质量尺度校准(类似 IRT 的纵向等值)可让不同任务的奖励可比。
复现评估
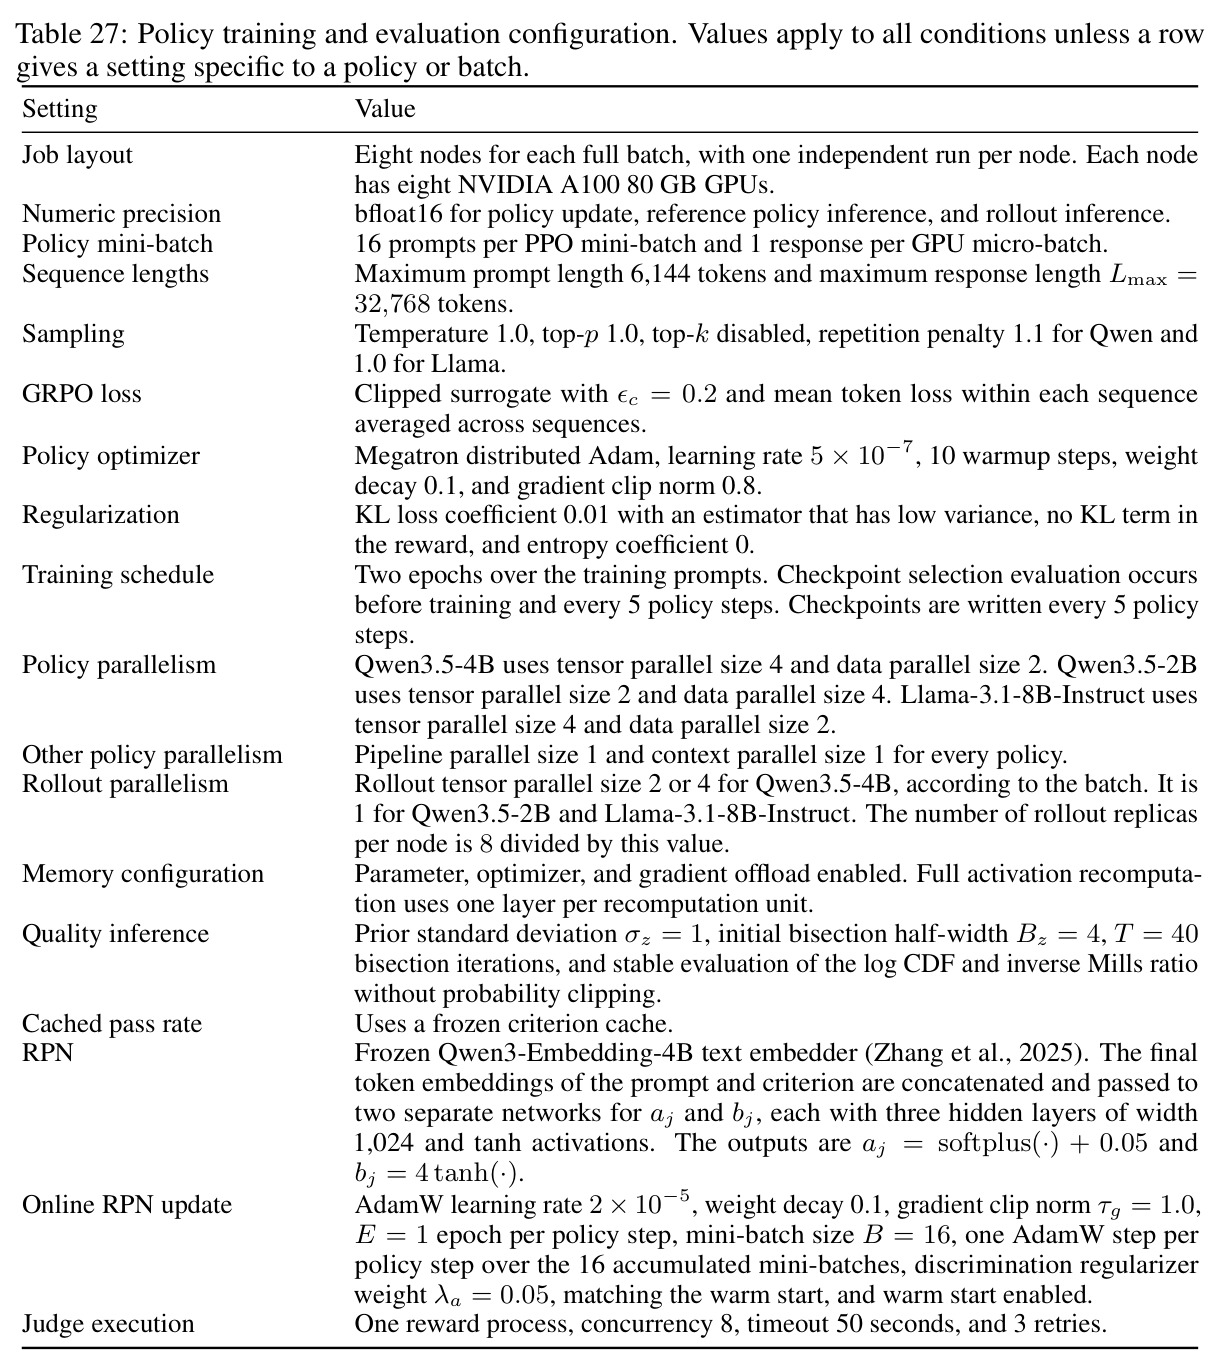
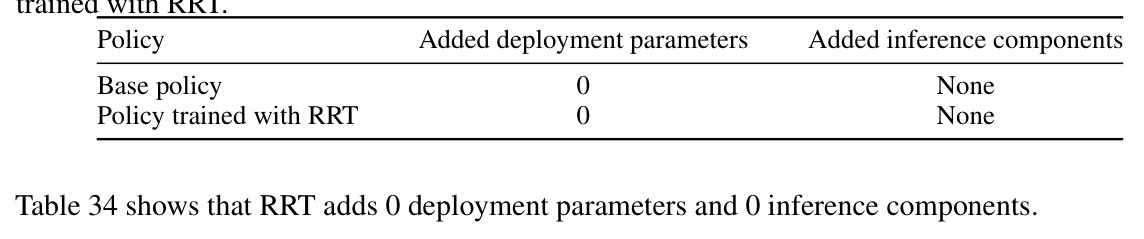
复现条件中等偏友好。开源情况:论文摘要末尾标注了 Code(代码链接随论文发布),四个评测基准全部公开——Medical/Science 从公开来源池(各约 2.9 万条)采样 5000 训练 prompt、500 验证、500 测试(种子 42,切分规则在 Table 25 明确给出),RaR Science 与 RubricBench 为社区数据集,HealthBench 与 ResearchQA 整集用于泛化评测。数据成本:主要门槛是 judge——每步每数据集对 32 prompt × 8 rollout × 全部标准调用 GPT-5.5(关闭推理),论文记录了 11,712 个完成请求全部可解析的 API 统计,完整复现一次训练的 API 花费可观,但半预算自适应 Fisher 选择可直接省约 49%。算力:RPN warm start 只需单张 A100 80GB、0.89–7.64 GPU 小时(依嵌入器规模),策略训练为 4B 模型的 GRPO(32 prompts/步、8 rollouts、1 PPO epoch),属于中小规模 RL,实验室级资源可承受;RRT 自身每步额外计算仅为 Vanilla GRPO 一步的 0.123%,部署零新增参数。实现难度:核心算法——高斯 CDF 下的 MAP 二分求解、单步在线 hard EM、Fisher 信息排序——每个都不超过几十行代码,且论文附录给出了完整的目标函数、算法伪代码、GRPO 更新细节、judge 与策略 prompt 模板(附录 F.2/F.3)和全部超参(Table 27),数学推导在附录 A 中逐定理给出。主要风险点是判定的可复得性:judge 为商业闭源模型,跨时间复现可能因 API 版本变化引入判定漂移;论文的三次重复评判分歧仅 1.27% 说明单次运行内部稳定,但跨实验室复现需固定模型版本。
论文图表