QCell:用于重叠实例分割的细胞查询重组与对齐 QCell: Recombining and Aligning Cell Queries for Overlapping Instance Segmentation
在MaskDINO上引入查询级分解重组与去噪查询对比对齐,实现显微镜重叠细胞的去重叠分割
前置知识
DETR 与查询式分割
DETR 将检测/分割建模为集合预测:一组可学习的内容查询(向量)经 Transformer 解码器的自注意力与交叉注意力后,各自输出一个实例的类别、框和掩码,并用匈牙利匹配实现一对一监督,掩码由查询向量与像素特征图做点积 $M_n = q_n^\top F$ 得到。
QCell 完全构建在 MaskDINO(DETR 家族)之上,所有新模块都作用于查询向量本身,不理解查询机制就无法理解分解与重组发生在哪里、损失如何施加。
去噪查询(DN Queries)
DN-DETR/DINO 的训练技巧:把真实框和标签加噪后作为额外查询送入解码器,让模型从噪声输入重建干净目标,从而加速收敛、稳定匹配。每个真实实例在 G 个去噪组中都保证有对应的 DN 查询表示 $d_n^g$。
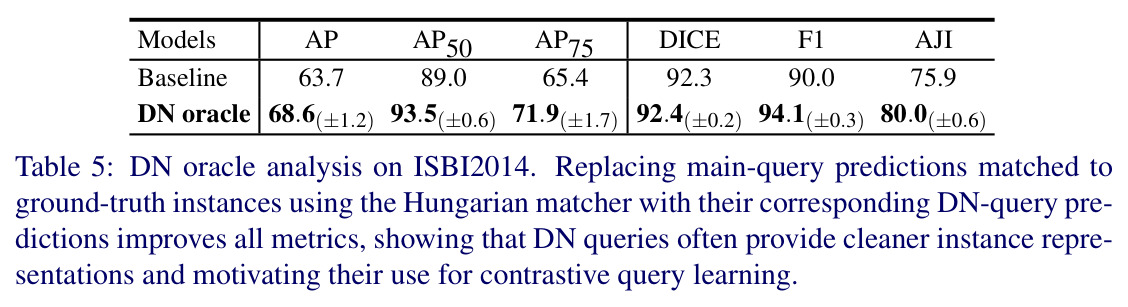
本文的核心巧思是把 DN 查询复用为对比学习的锚点:它们与匈牙利匹配质量无关、表示稳定。论文的 DN oracle 实验显示 DN 查询的预测比主查询还高 4.9 AP(68.6 vs 63.7),这是理解第 3.3 节的前提。
Amodal 实例分割
普通分割只预测可见区域,amodal 分割要求预测物体被遮挡或重叠后的完整轮廓。对半透明的显微细胞,被覆盖部分仍隐约可见但对比度弱,模型需要从混合视觉证据中推断每个细胞的完整形状,即所谓的非模态补全。
本文把每个查询分解为 amodal、可见、不可见三个子表示,正是围绕 amodal 建模展开的;理解这一任务设定才能明白三种子掩码各自的真值监督从哪里来。
InfoNCE 对比学习
对比学习通过拉近锚点与正样本、推远负样本塑造嵌入空间。InfoNCE 用温度参数 $\tau$ 缩放余弦相似度后算交叉熵:$\mathcal{L}=-\log\frac{\sum_{k^+}\exp(\hat{q}\cdot k^+/\tau)}{\sum_{k^+}\exp(\hat{q}\cdot k^+/\tau)+\sum_{k^-}\exp(\hat{q}\cdot k^-/\tau)}$,正负样本的选取决定学到什么不变性。
本文的实例判别损失就是 InfoNCE 的查询级版本,正样本是同一实例全部去噪组的 DN 投影、负样本是其他实例的 DN 投影,理解这一点才能看懂为何能分离重叠细胞的查询表示。
AP / AJI 等细胞分割指标
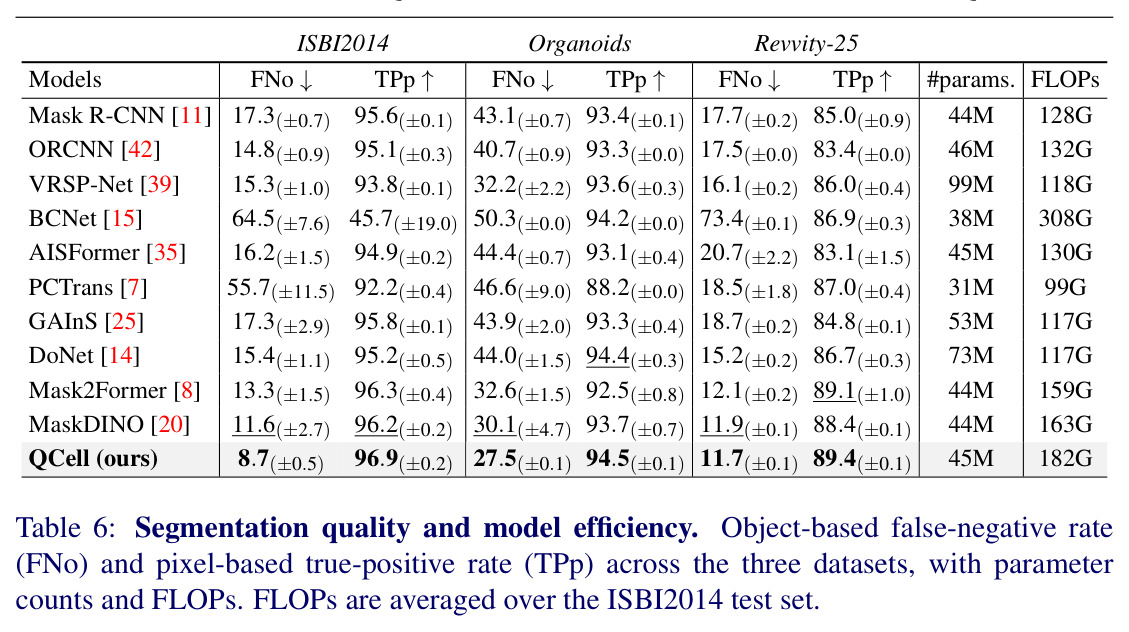
AP 基于掩码 IoU 与置信度排序综合衡量检测加分割质量,AP50/AP75 是不同 IoU 阈值下的变体;AJI(Aggregated Jaccard Index)把所有预测与真值掩码的交集/并集累加成全局 Jaccard,是细胞实例分割的常用指标;FNo 和 TPp 分别从对象级漏检率和像素级覆盖率刻画误差来源。
论文的核心论证是收益来自去重叠而非边界精化:AP/AJI/FNo 提升明显而 DICE 几乎持平。不懂这些指标的含义就无法理解这一关键对比论证。
研究动机
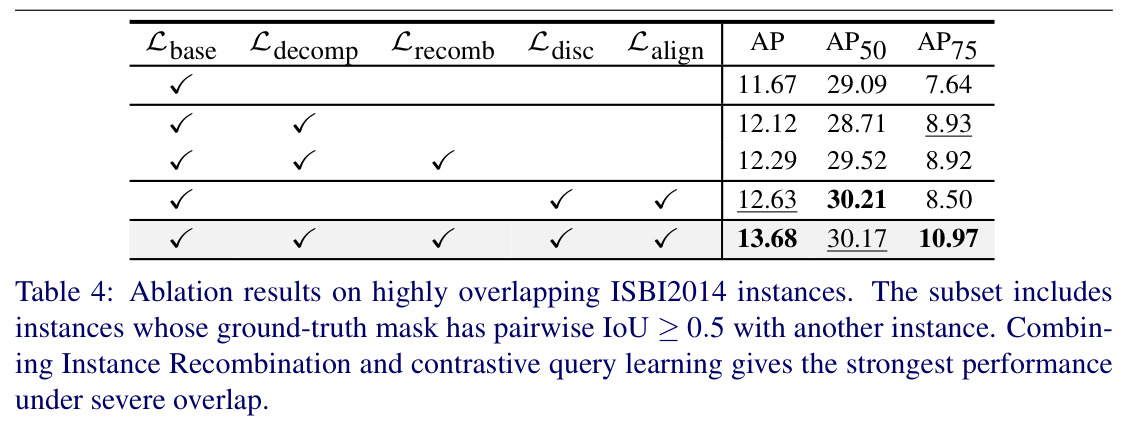
显微镜图像中的细胞经常成团重叠,且明场、相差、荧光等成像模态普遍是半透明的:被覆盖的细胞结构仍隐约可见,但边界微弱、视觉证据混杂,重叠区域同时包含多个实例的信号。这与自然图像遮挡不同——自然图像中被遮挡区域往往完全不可见。现有方法分三类且各有短板:DoNet、BCNet、AISFormer 等在 RoI 局部区域内做分解或层级建模,依赖上游检测质量,无法在全局场景中联合推理共享重叠区域的归属;C2F-Seg、ShapeFormer、ShapeMoE 等形状先验方法假设存在可学习的形状分布,但细胞形态极端多样,该假设难以成立;pix2gestalt、MC Diffusion 等生成式补全依赖上游可见掩码质量,误差会在流水线中传播。问题严重程度有量化证据:在 ISBI2014 的高重叠子集(真实掩码两两 IoU≥0.5 的实例)上,强基线 MaskDINO 的 AP 只有 11.67,AP75 仅 7.64,说明单掩码预测难以处理共享大量空间区域的实例。
本文的目标是本文的目标是构建一个能在全场景上下文中做去重叠(de-overlapping)的细胞实例分割模型,具体包含三个递进要求:其一,让每个实例的预测显式建模完整结构(amodal)、可见部分与被遮挡部分三者的关系,从而在重叠区域能推理出被覆盖的完整轮廓;其二,保证重叠共现细胞的查询表示在嵌入空间彼此远离,避免相邻细胞经自注意力后查询表示收敛坍缩;其三,提供更难的真实基准,为此作者构建了 Organoids 明场数据集——训练图最多 105 个实例、测试图平均 96 个、最多 223 个。最终目标是在 ISBI2014、Revvity-25、Organoids 三个基准上超越 MaskDINO、DoNet 等 SOTA,例如在 ISBI2014 细胞质分割上取得 +2 AP 以上的提升。
与已有工作不同的是,本文的独特切入角度有三点。第一,把 DoNet 的 decompose-and-recombine 原则从 RoI 图像空间搬到查询潜空间:不再依赖区域提议,而是直接分解查询向量本身,借助查询间全局注意力完成实例间通信,这使模型能在整图语境下推理重叠归属。第二,首次用去噪(DN)查询作为对比学习的稳定锚点:无论匈牙利匹配好坏,每个真值实例都保证有 G 个 DN 表示,且 DN oracle 分析(用 DN 预测替换主查询预测可将 AP 从 63.7 提到 68.6)证明其表示质量优于匹配查询。第三,把对比目标解耦为两个互补要求——实例判别(InfoNCE 学有区分度的特征)与余弦对齐(把负对推向正交,直接惩罚导致表示坍缩的高相似度),并配合新发布的 Organoids 高密度基准形成完整贡献。
核心方法
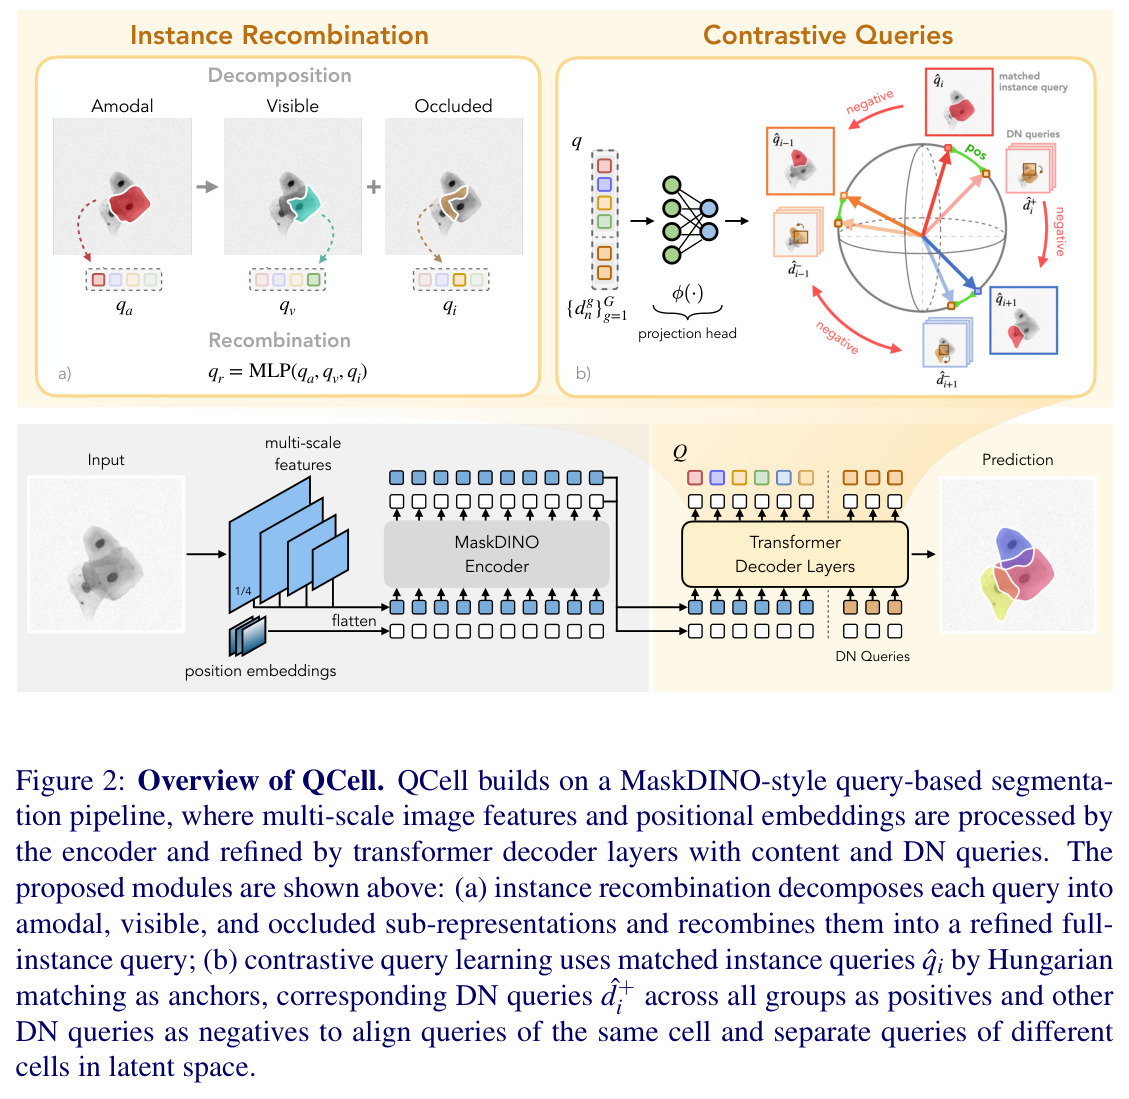
直觉上,半透明重叠的核心难点是判断某块混合证据属于哪个细胞。QCell 认为去重叠需要两件事:理解对象的可见/隐藏结构,并让相邻实例的表示互相区分。技术路线上,它在 MaskDINO 检测分割管线(ResNet-50-FPN 骨干提取多尺度特征,pixel decoder 输出 $F_l$ 与高分辨率像素嵌入 $F$,Transformer 解码器联合精炼内容查询与 DN 查询)之上加两个模块:(a) 实例重组模块——三个轻量 MLP 头把每个内容查询 $q$ 分解为 amodal $q_a$、可见 $q_v$、不可见 $q_i$ 三个子查询,各自与像素特征点积得到三个掩码,再用 MLP 重组为精炼查询 $q_r$,配合一致性正则保证三者几何相容;(b) 对比查询学习——用投影头 $\phi$ 把匹配查询与所有 DN 查询映射到对比空间,以同实例的 DN 投影为正样本、其他实例的 DN 投影为负样本,同时施加 InfoNCE 判别损失与余弦对齐损失。总损失为 $\mathcal{L}=\mathcal{L}_{base}+\lambda_{IR}\mathcal{L}_{IR}+\lambda_{disc}\mathcal{L}_{disc}+\lambda_{align}\mathcal{L}_{align}$,在每个解码器层计算后求和。
核心创新有二,且都与已有方法有本质区别。一是查询级实例分解重组:不同于 DoNet 在图像空间用双路径区域分割模块分解交集/补集,也不同于 AISFormer 在 RoI 内让 occluder/visible/amodal mask token 自注意力交互,QCell 直接在潜空间分解查询向量 $q_k=\mathrm{MLP}_k(q)$,三个子掩码 $M_k=q_k^\top F$,再重组 $q_r=\mathrm{MLP}(q_a,q_v,q_i)$,使完整对象推理发生在全局注意力之下;一致性正则 $\mathcal{L}_{CR}=\mathcal{L}_{bce}(M_r,\mathrm{sg}[\mathrm{XOR}(\sigma(M_v)>0.5,\sigma(M_i)>0.5)])$ 把重组掩码约束为可见与不可见预测的逻辑并,stop-gradient 让梯度只流经 $M_r$。二是 DN 引导的对比查询学习:不同于 CSPCL/MMCL 的类别级对比(细胞全属同一类别因而失效)、也不同于依赖时序对应的视频方法(CAVIS、MDQE),本文用去噪查询做免费且稳定的实例锚点,并把对比目标显式解耦为特征判别与几何分离(负对余弦平方惩罚推向正交),分别消融各贡献 +1.8 与 +2.5 AP。
方法步骤详情
完整流程如下。第 1 步,图像经 ResNet-50-FPN 得到多尺度特征 $\{F_l\}$ 与像素嵌入 $F$。第 2 步,解码器中 N 个内容查询(ISBI2014 和 Revvity-25 用 100,Organoids 用 300)与 G 组 DN 查询执行自注意力加多尺度可变形交叉注意力。第 3 步,分解头:每个内容查询过三个 MLP 得到 $q_a,q_v,q_i$,与 $F$ 点积得 $M_a,M_v,M_i$。第 4 步,分解监督:匈牙利匹配上的查询,其三个子掩码分别对真值 amodal/可见/不可见掩码计算 BCE 加 Dice 损失得到 $\mathcal{L}_{decomp}$。第 5 步,重组:$q_r=\mathrm{MLP}(q_a,q_v,q_i)$ 产生 $M_r$,对完整 amodal 真值算 $\mathcal{L}_{refined}$,加上一致性损失 $\mathcal{L}_{CR}$(二值 XOR 结果作固定伪标签);两者合成 $\mathcal{L}_{recomb}$,与 $\mathcal{L}_{decomp}$ 合为 $\mathcal{L}_{IR}$。第 6 步,对比学习:$\hat{q}_n=\phi(q_n)$、$\hat{d}_n^g=\phi(d_n^g)$,正样本集 $P_n$ 为同实例跨所有组的 DN 投影,负样本集为其他实例的全部 DN 投影,计算温度 $\tau=0.1$ 的 InfoNCE 判别损失与余弦对齐损失(正对 $\cos$ 距 1 的平方、负对 $\cos^2$ 推向正交),权重 $\lambda_{disc}=2.0$、$\lambda_{align}=5.0$。第 7 步,训练:AdamW,学习率 $10^{-4}$,权重衰减 0.05,骨干学习率乘 0.1,60k 迭代、batch size 2,50k/55k 时衰减 10 倍,按验证集选最优 checkpoint,报告 3 个随机种子平均。
技术新颖性
技术新颖性可从四个维度评估。(1) 分解粒度与位置:已有工作要么在图像空间分解区域(DoNet 的双路径模块)、要么在 RoI 内做 mask token 交互(AISFormer)、要么学形状先验(ShapeFormer/ShapeMoE),本文首次在查询潜空间做 amodal/可见/不可见三分解加 MLP 重组,并以一致性正则闭环,开销仅从 163G 增至 182G FLOPs。(2) 对比锚点的选择依据:论文用 DN oracle 实验量化论证 DN 查询表示质量更高(68.6±1.2 AP 对基线 63.7,AJI 80.0±0.6),为锚点选择给出因果性证据,而非经验性套用对比学习。(3) 损失几何设计:把 InfoNCE 的软判别与余弦对齐的硬几何约束(负对推到正交)结合,直接针对 DAC-DETR 指出的密集场景查询表示坍缩问题,消融显示两者互补(单独 65.5/66.2 AP,合并 67.0)。(4) 基准贡献:Organoids 数据集平均 96 实例/测试图、最多 223 个,比 ISBI2014 和 Revvity-25 密度高一个量级,填补了高密度重叠分割评测空白。
实验结果
核心发现逐一分析。(1) ISBI2014 细胞质分割:QCell 达到 65.9 AP、91.9 AP50、92.3 F1、78.6 AJI,相对 MaskDINO 基线(63.7 AP、90.0 F1、75.9 AJI)提升 +2.2 AP、+2.3 F1、+2.7 AJI,全面超过 DoNet(60.9 AP)与两阶段的 ORCNN(60.6 AP)。(2) Revvity-25(110 张 1080×1080 明场图、2937 个实例):52.9 AP、86.4 F1、73.6 AJI,AP 与 AJI 均为所有方法最佳(基线 52.3/73.5),但 F1 略低于 MaskDINO 的 87.1。(3) Organoids(最密集基准,平均 96 实例/测试图):51.0 AP、71.6 F1、63.2 AJI,三项均为最佳,且远超 Mask2Former(51.0 对 31.3/34.7 AP)。(4) 组件消融:基线 63.7 AP 加分解升至 65.1,再加重组与一致性正则达 66.6;对比损失单独用判别 65.5、单独用对齐 66.2,合并 67.0 AP 和 77.9 AJI;全模型 AP 65.9 略低于 67.0,但 F1 92.3、AJI 78.6、AP50 91.9 均为全场最佳。(5) 高重叠子集(两两 IoU≥0.5):AP 从 11.67 升至 13.68(+2.01),AP75 从 7.64 升至 10.97(+3.33)。(6) DN oracle:用 DN 查询替换匹配查询的预测,AP 达 68.6±1.2、AJI 80.0±0.6,证明 DN 表示质量更高。(7) 误差分析:QCell 的对象级漏检率 FNo 三数据集最低(ISBI2014 8.7 对基线 11.6;Organoids 27.5 对 30.1;Revvity-25 11.7),像素级 TPp 最高(96.9/94.5/89.4),代价仅 45M 参数与 182G FLOPs(基线 44M/163G)。
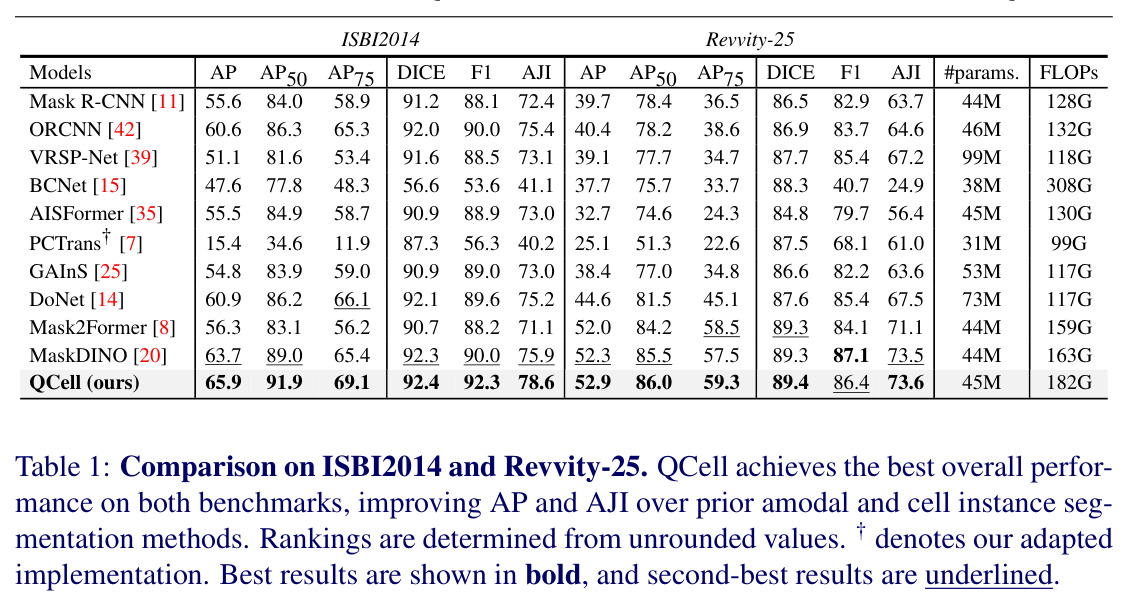
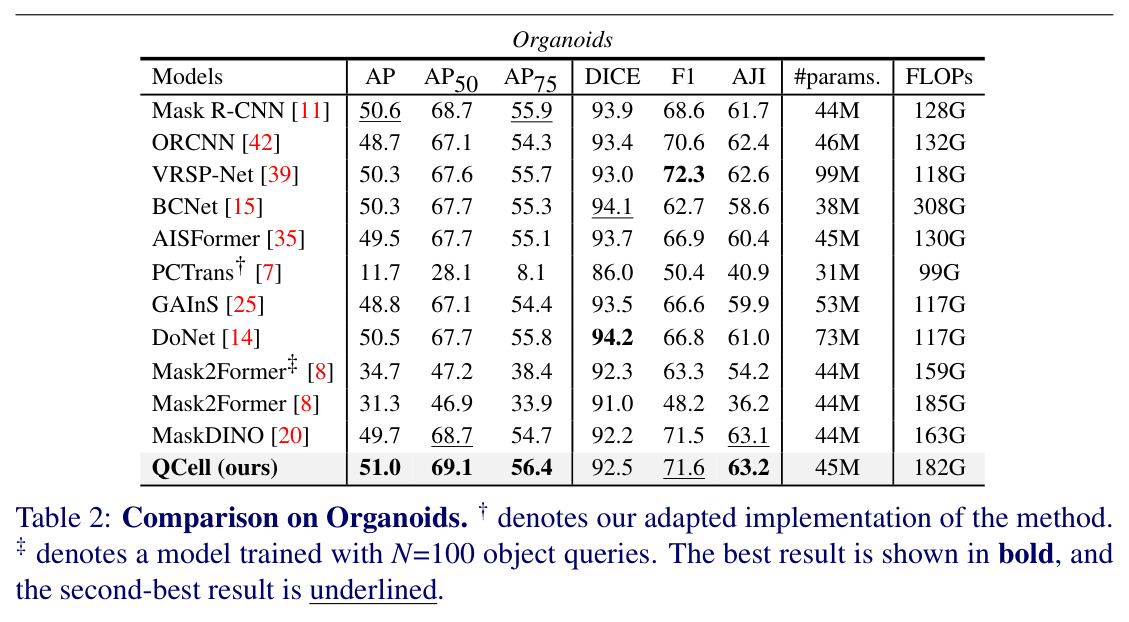
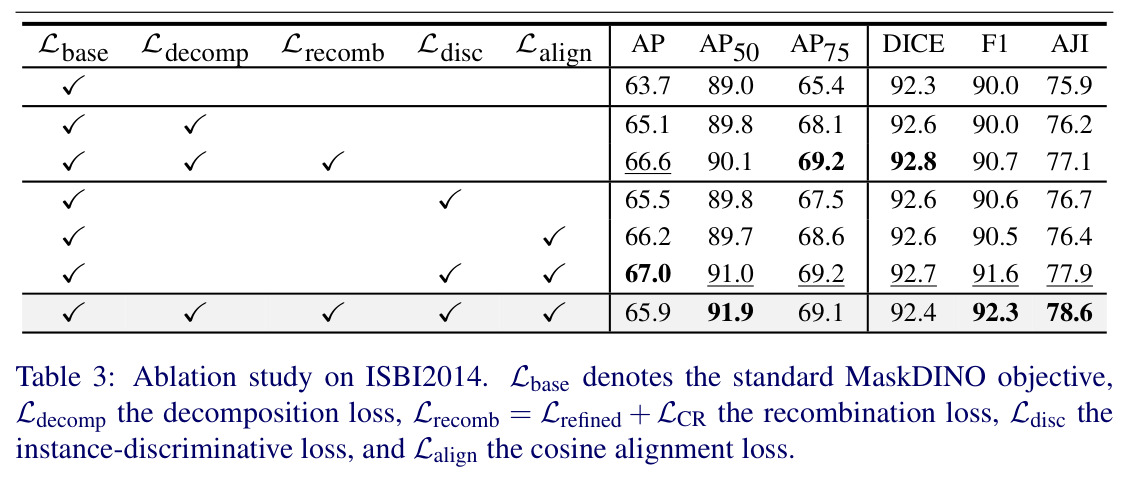
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ISBI2014 重叠细胞实例分割(细胞质) | AP / AP50 / F1 / AJI | 65.9 / 91.9 / 92.3 / 78.6 | 63.7 / 89.0 / 90.0 / 75.9 (MaskDINO) | +2.2 AP / +2.9 AP50 / +2.3 F1 / +2.7 AJI |
| Revvity-25 癌细胞实例分割(明场 1080×1080) | AP / AJI | 52.9 / 73.6 | 52.3 / 73.5 (MaskDINO) | +0.6 AP / +0.1 AJI |
| Organoids 高密度类器官实例分割(新基准) | AP / F1 / AJI | 51.0 / 71.6 / 63.2 | 49.7 / 71.5 / 63.1 (MaskDINO) | +1.3 AP / +0.1 F1 / +0.1 AJI |
| ISBI2014 高重叠子集(实例间 IoU≥0.5) | AP / AP75 | 13.68 / 10.97 | 11.67 / 7.64 (MaskDINO 基线损失) | +2.01 AP / +3.33 AP75 |
| ISBI2014 对象级漏检与像素覆盖 | FNo ↓ / TPp ↑ | 8.7 / 96.9 | 11.6 / 96.2 (MaskDINO) | FNo 降低 2.9 个百分点 |
局限与改进
作者承认的局限:重组模块重建的重度遮挡细胞掩码 IoU 可能只是中等水平,因此会限制 AP75 和阈值平均 AP——全模型 AP75 为 69.1,甚至略低于仅用重组模块的 69.2;三个数据集上 DICE 与基线几乎持平,说明收益主要来自去重叠而非边界精化;Revvity-25 上 F1(86.4)低于 MaskDINO(87.1)。我自己的观察:一致性正则的 XOR 伪标签依赖固定的 0.5 阈值二值化,在弱边界半透明区域并不稳健;对比学习的锚点虽是 DN 查询,但样本端仍是匈牙利匹配查询,DAC-DETR 指出的交叉注意力聚集风险并未根治;Organoids 数据集仅可按需索取而非完全公开,削弱了基准贡献的社区价值;方法面向 2D 半透明重叠,未建模嵌套遮挡的深度排序,对完全不透明物体的自然图像场景是否有效未经验证;所有训练在单张 H200(141GB 显存)上以 batch size 2 完成,训练配置对中小型实验室不够友好。
独立分析的弱点
独立分析的弱点及改进方向:(1) 一致性正则用 $\mathrm{XOR}(\sigma(M_v)>0.5,\sigma(M_i)>0.5)$ 的硬阈值二值伪标签,梯度只流经 $M_r$ 但目标本身噪声大,可改为软布尔代数的连续松弛(如 $\sigma_v+\sigma_i-\sigma_v\sigma_i$ 的软并集)避免阈值敏感;(2) 分解头需要 amodal/可见/不可见三套真值掩码,这类标注昂贵且稀缺,可探索从普通可见掩码出发自监督地合成可见/不可见配对训练数据;(3) 余弦对齐把所有负对硬性推向正交($\cos^2$ 惩罚),但嵌入维度有限而 Organoids 单图多达 223 个实例,强制两两正交可能超出容量,可引入 margin 或按重叠程度加权的软负样本;(4) FLOPs 从 163G 涨至 182G 且对比损失在每层解码器都计算,可只在高层或最后一层施加对比约束以降本;(5) Organoids 上 FNo 仍高达 27.5%,极端密集场景漏检依旧显著,可引入查询去冗余机制或对未匹配查询做二次匹配级联。这些弱点在不同场景的严重性不同:标注依赖在临床落地时最致命,嵌入容量问题则在最高密度数据集上最先暴露。
未来方向
未来研究方向:作者在结论中未列具体计划,但基于成果可延伸出多条路径。作者层面:代码已在 GitHub 开源(SlavkoPrytula/QCellarXiv),Organoids 数据集按需提供,最自然的延伸是把基准做成公开挑战赛。技术延伸:(1) 与 SAM 系分割基础模型结合(如 SAMBA、SAMEO),用大规模无标注显微图像把去重叠能力蒸馏进基础模型,缓解三套掩码标注的依赖;(2) 把 DN 锚点对比思想推广到时序视频或 3D 组织堆叠,DN 表示的跨帧一致性天然适配实例跟踪;(3) 显式建模遮挡深度排序(层序预测),当前 XOR 并集隐含假设可见与不可见部分无嵌套遮挡,处理多层堆叠细胞时会失效;(4) 把对比对齐从查询级下沉到像素级特征,直接缓解重叠区域的特征纠缠而非只分离查询向量;(5) 将 Organoids 扩展到多通道荧光共定位场景,验证跨模态泛化;(6) 输出重叠区域的归属不确定性图,服务下游形态计量与药物筛选的置信度评估。
复现评估
复现评估:代码已在 GitHub 开源(https://github.com/SlavkoPrytula/QCellarXiv),基于 Detectron2 实现,backbone 为 ImageNet 预训练的 ResNet-50-FPN。数据方面,ISBI2014(45 训练/90 验证/810 测试合成图加 16 张真实图)与 Revvity-25(110 张图、2937 个专家标注实例)公开可得,但 Organoids 仅可向作者申请,这是复现完整论文结果的最大数据障碍。超参完全披露:AdamW 学习率 $10^{-4}$、权重衰减 0.05、骨干学习率乘 0.1、60k 迭代、batch size 2、50k/55k 衰减 0.1、查询数 100(Organoids 300)、对比温度 $\tau=0.1$、全部损失权重给出,结果为 3 个随机种子平均并按验证集选 checkpoint,规范严谨。算力门槛是主要困难:所有实验在单张 NVIDIA H200(141GB HBM3e)完成,MaskDINO 级模型 batch 2 训练通常需要 24GB 以上显存,消费级显卡需要梯度累积或裁剪分辨率。基线均由作者按统一协议(遵循 DoNet)复现,对比公平。总体复现难度为中等:代码与超参齐全、两个基准公开,但数据申请流程与高端 GPU 需求是实际障碍。
论文图表
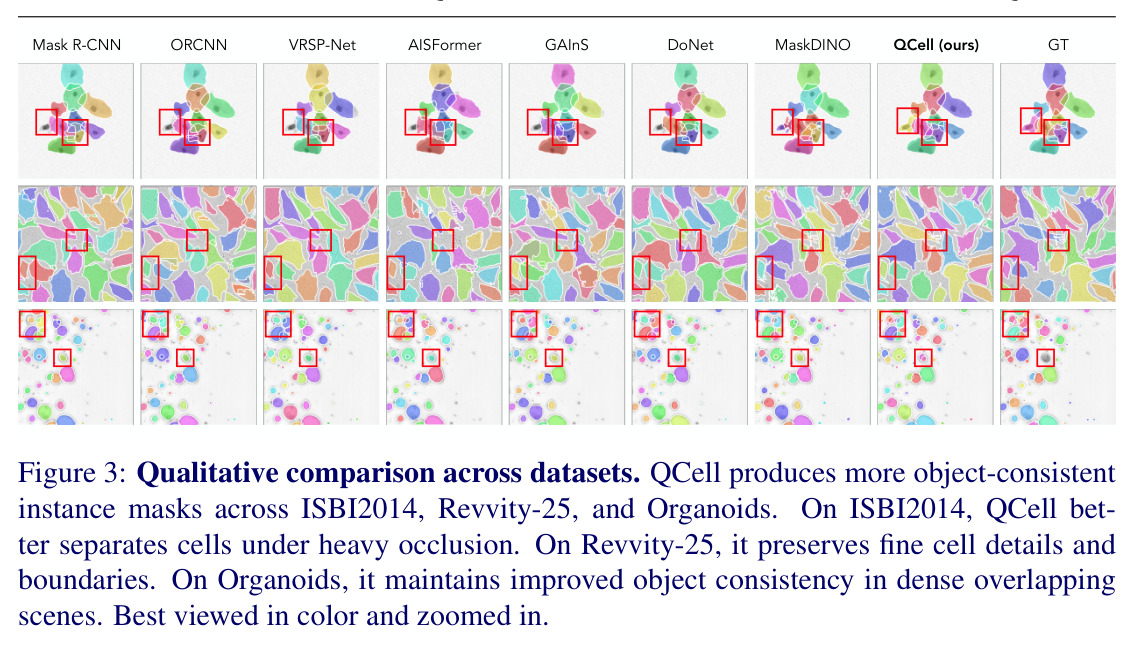
一排定性对比图,展示同一重叠细胞场景下 DoNet、MaskDINO 与 QCell(本文)的分割结果。可见 DoNet 和 MaskDINO 在半透明重叠区把相邻细胞粘连或漏掉被覆盖部分,而 QCell 保留了更完整的细胞轮廓并成功分离紧邻实例。
开篇第一图直观定义了'半透明重叠产生弱边界与模糊证据'这一核心问题,并预告了方法的效果,是理解论文动机和贡献的最快入口。