BoundInk:边界感知的在线手写生成 BoundInk: Boundary-Aware Online Handwriting Generation
把字符间边界变为显式生成目标,让AI手写的连笔、字距、词距更像真人
前置知识
在线手写生成(Online Handwriting Generation)
把手写表示为按时间排序的坐标点序列加上笔状态(落笔 PM、抬笔 PU),与只输出静态图像的离线生成相对。模型通常自回归地预测每一步的坐标增量和笔状态,输出端多用混合密度网络以刻画同一个字有多种写法的多模态分布。
这是论文的任务载体,所有符号定义、数据格式与评价指标都建立在这条在线轨迹加笔状态的表示之上。
混合密度网络(GMM/MDN 输出头)
用 $K$ 个二维高斯分布的加权和建模下一步位移 $(\Delta x_t, \Delta y_t)$ 的概率分布,权重 $\pi_{t,k}$、均值 $\boldsymbol{\mu}_{t,k}$、协方差 $\boldsymbol{\Sigma}_{t,k}$ 由解码器隐状态预测,训练时最小化掩码负对数似然 $\mathcal{L}_{\mathrm{mdn}}$。单点回归会把多种合理写法平均成模糊轨迹,混合分布则可保留多模态性。
BoundInk 的输出头是 $K=20$ 的 GMM,理解 $\mathcal{L}_{\mathrm{mdn}}$ 才能看懂它的训练目标与推理方式。
动态时间规整(DTW)
允许时间轴上非线性对齐两条序列、取最小累计欧氏距离的经典轨迹相似度指标。论文用按参考轨迹长度归一化的 $\mathrm{DTW}_{\mathrm{norm}}=\mathrm{DTW}_{\mathrm{raw}}/|\mathrm{GT}|$ 做全局几何比较,并指出整条轨迹足够接近不代表局部连笔和间距正确。
DTW 是本文的主要对比指标之一,同时论文论证了它的盲区,这正是提出 CSM 指标体系的直接动机。
连笔与 CursiveEOC 笔状态
英文草书中写完一个字符后不停笔、直接续写下一字称为连笔(cursive connection)。论文在传统 PM/PU/EOC 之外定义第四种笔状态 CursiveEOC:字符结束但笔未抬起,作为跨字符边界连笔延续的显式标签,由预处理轨迹流确定性地推导出来。
CursiveEOC 是本文的核心监督信号,F1_Cursive 指标就以它为正类,是理解边界感知训练和评测的钥匙。
Teacher forcing 与自回归误差累积
训练自回归模型时把真实历史序列(而非模型自身预测)作为输入,收敛更快但造成训练/推理分布不一致;推理阶段改为完全自回归,早期小错误会沿序列累积,长句生成时表现为垂直漂移等整体性畸变。
Bi-SWT 训练时 bigram 窗口用前驱字符的真实轨迹、推理时换成模型自己的预测,这一差异正是论文用 VDL 和附录漂移诊断反复处理的问题。
监督对比学习(SupCon)
对比学习的一种:同一标签(这里是同一写者或同一字符)的样本在嵌入空间中拉近、不同标签的推远,配合温度系数(本文 0.07)缩放相似度,能学到判别性强的风格表示。
BoundInk 的写者风格与字形风格记忆由 $\mathcal{L}_{\mathrm{style}}$ 中的监督/自监督对比损失训练,是写者一致性的来源。
课程学习(Curriculum Learning)
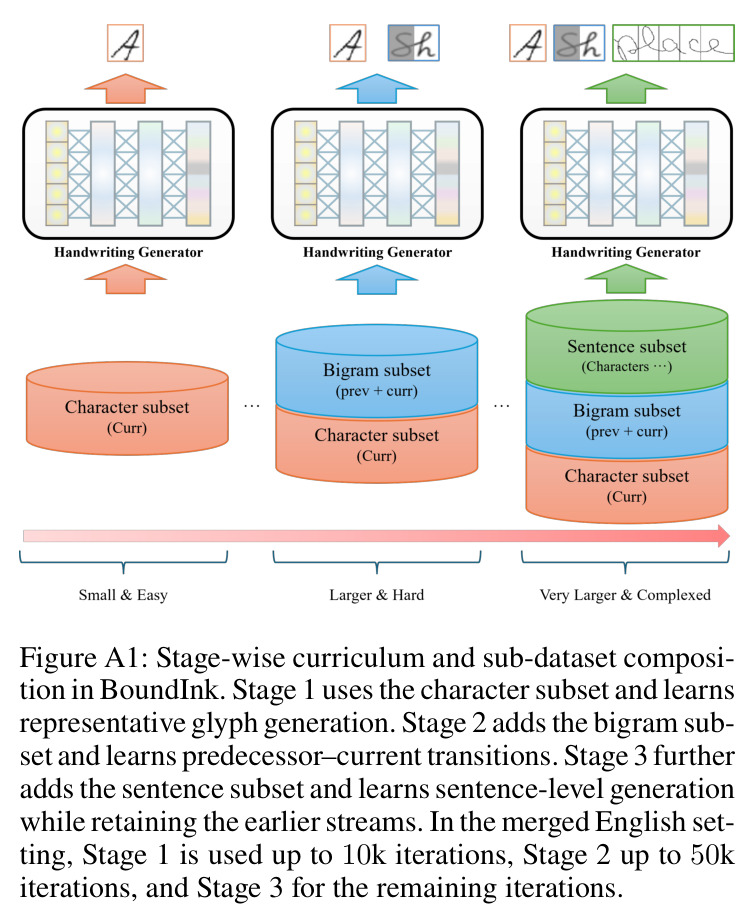
按任务难度安排训练顺序,从简单子任务(单字符字形)逐步过渡到复杂子任务(bigram 过渡、完整句子),各阶段监督信号累计而非替换,切换时加入 warmup 稳定优化。
三阶段课程(字形→bigram→句子)是 BoundInk 训练的关键设计,保证边界建模在长句生成成为主导之前先被学会。
研究动机
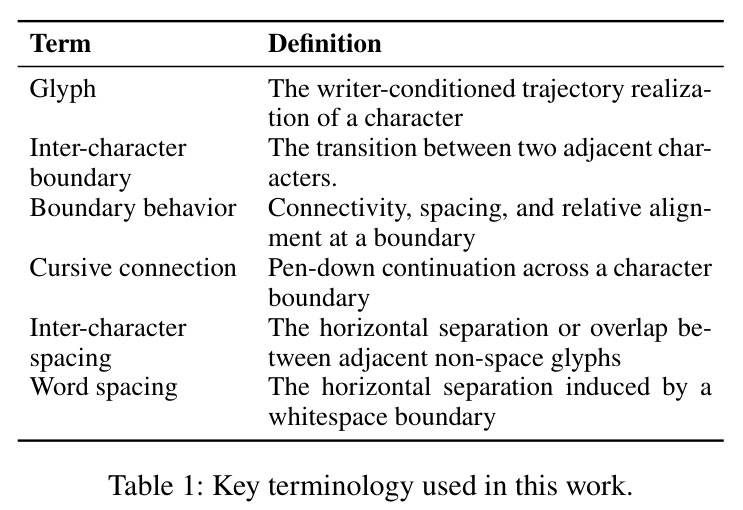
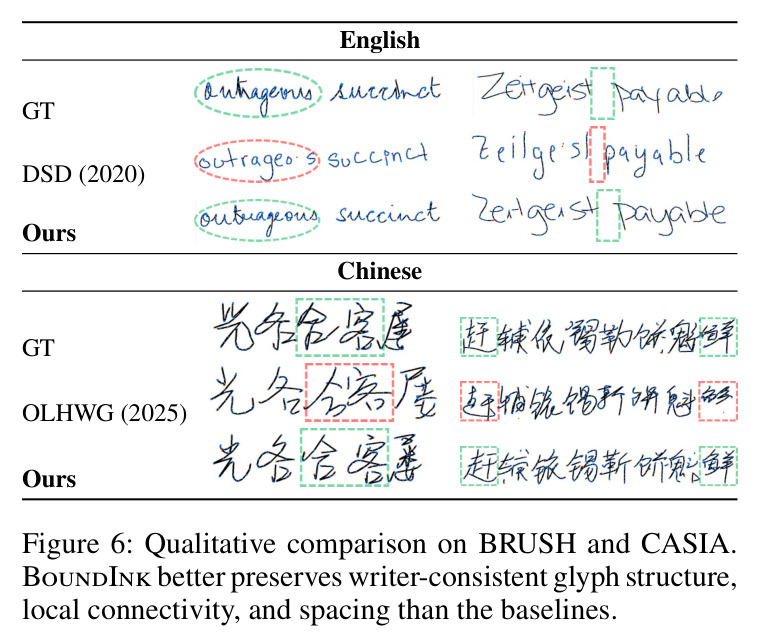
在线手写生成要求模型输出带时序的坐标序列和笔状态(落笔/抬笔),而非像离线生成那样只输出静态图像;句子级生成还必须还原笔画顺序、笔状态切换以及相邻字符之间的交互。现有方法(Graves 2013 的 RNN、DeepWriting、DSD、OLHWG、TrInk 等)几乎都依赖长程序列建模,把字符之间的衔接当成序列解码的副产物隐式学习。后果是:单个字符形状看似合理,但连笔断裂、字距僵硬且与写者无关、跨字符过渡风格不一致。论文在基准协议下量化了这些问题:DeepWriting 的连笔边界 $F1_{\mathrm{Cursive}}$ 只有 0.26、字距指标 KGS 仅 0.15;DSD 的 $F1_{\mathrm{Cursive}}$ 更低至 0.07。同时,常用指标归一化 DTW 只度量全局轨迹相似度,一条整体接近参考的轨迹仍可能连笔错误、间距失真,出现指标好看但观感很差的错位(附录 Figure A17 给出了 DTW 与边界质量排序相反的真实案例)。
本文的目标是本文目标是构建一个边界感知的写者条件化在线手写生成框架 BoundInk:把相邻字符间的过渡行为——跨字符连笔延续、字间水平间距(kerning)、相对对齐、词间距——从隐式副产物提升为显式生成与监督目标,同时完整保留写者特有的字形外观;并配套提出直接度量连笔连续性与字符间空间关系的评测体系 Connectivity and Spacing Metrics(CSM),使句子级边界质量可以被针对性评估。定量目标是在三个与基线严格匹配的协议下全面改进所有适用的边界指标并把归一化 DTW 降低 17.6–47.8%,再通过盲测人评验证连接性、间距与风格保真在感知层面的提升。
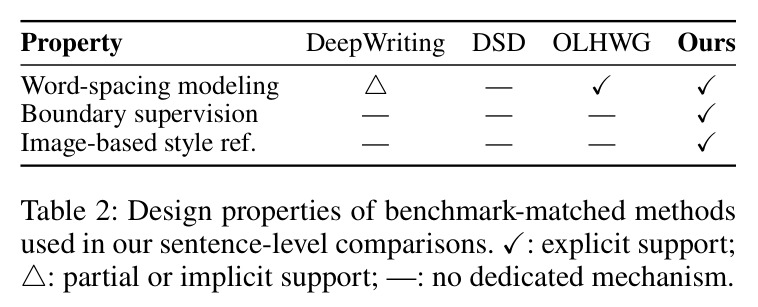
与已有工作不同的是,本文的独特切入角度有三点。第一,建模粒度:与其靠全句注意力隐式学边界,不如显式建模前驱字符–当前字符的 bigram 窗口——连笔与字距主要由相邻字符决定,bigram 窗口既捕捉主导边界信号又避免更大 n-gram 窗口的组合稀疏;更长程的句子信息则由单独的上下文记忆经门控融合注入,两条通路分工明确。第二,监督信号:把跨字符边界时笔未抬起定义为新的笔状态 CursiveEOC,直接监督连笔决策,这是所有对比方法都没有的机制(Table 2 中 Boundary supervision 一列只有本文为 ✓)。第三,评测与协议:提出写者层面宏平均的 CSM 四指标($F1_{\mathrm{Cursive}}$、CRE、KGS、SSS)补充 DTW 的盲区,并采用基准匹配成对比较——为每个基线在其原切分、预处理和指标实现下重训 BoundInk,避免跨协议不可比。
核心方法
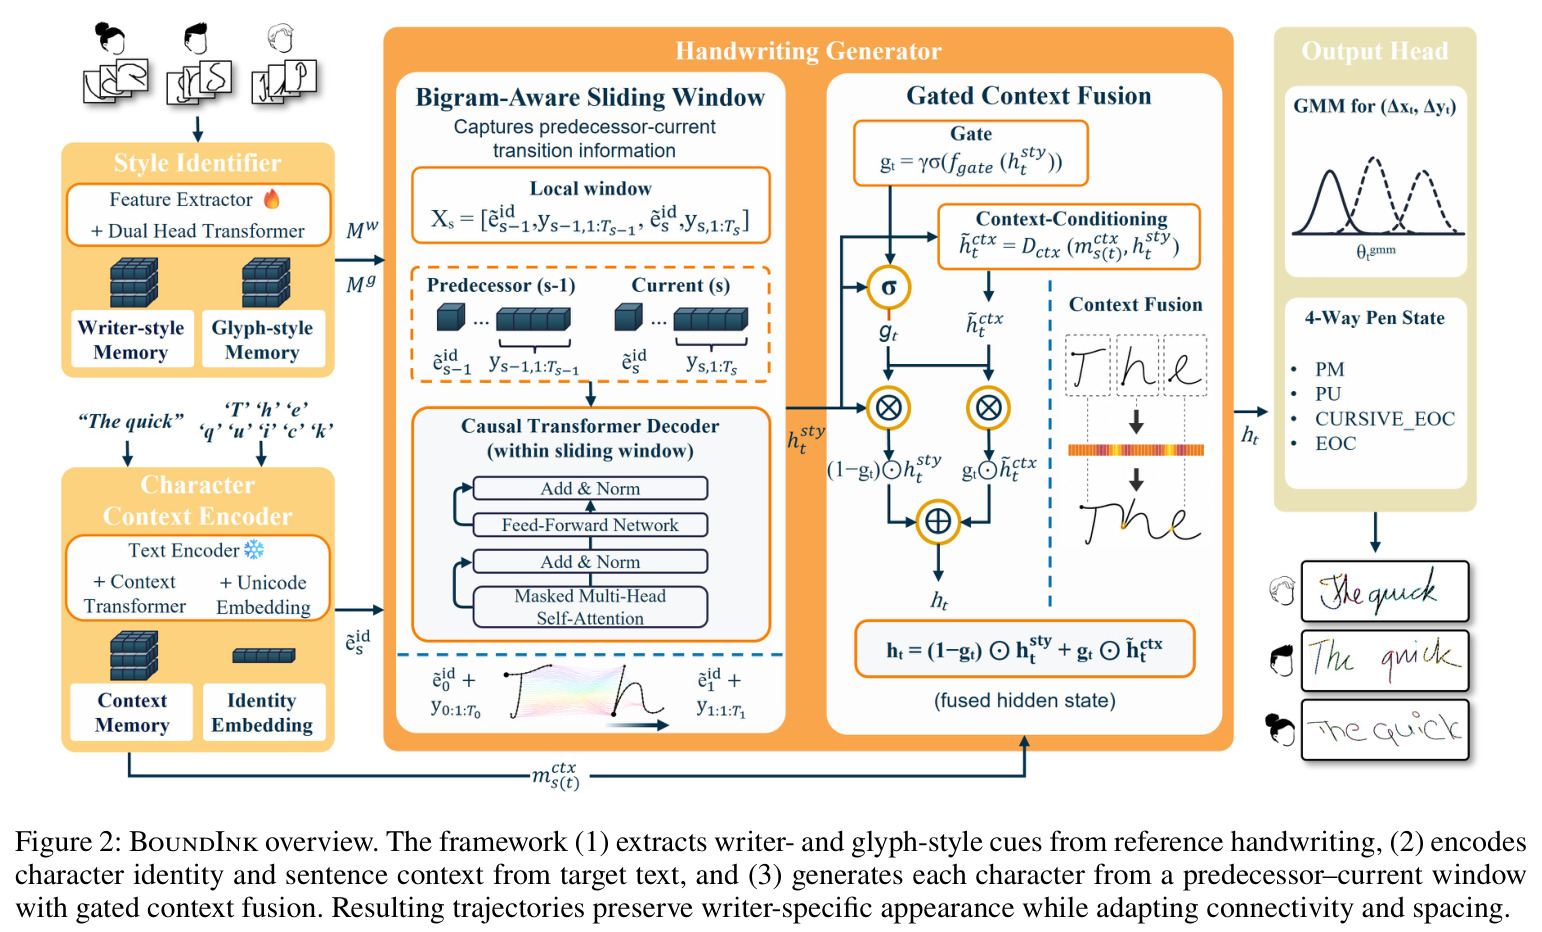
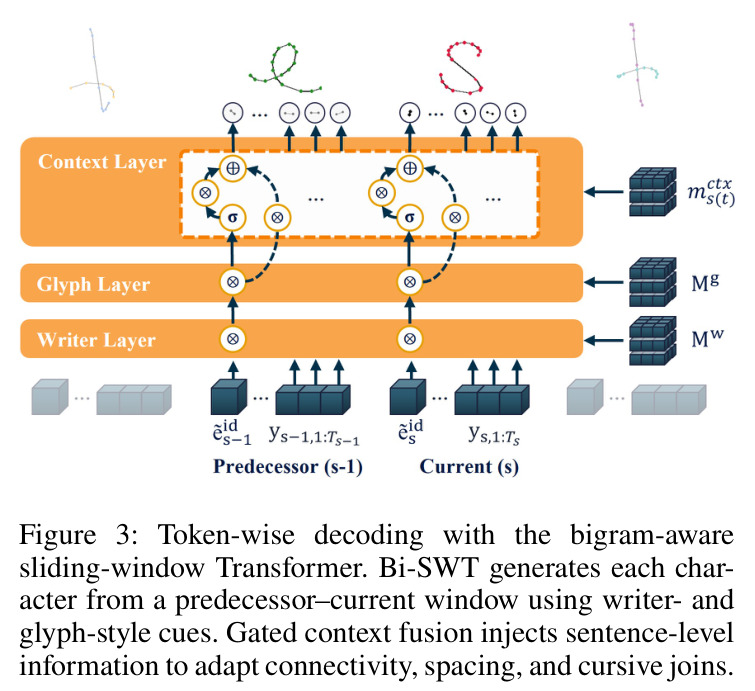
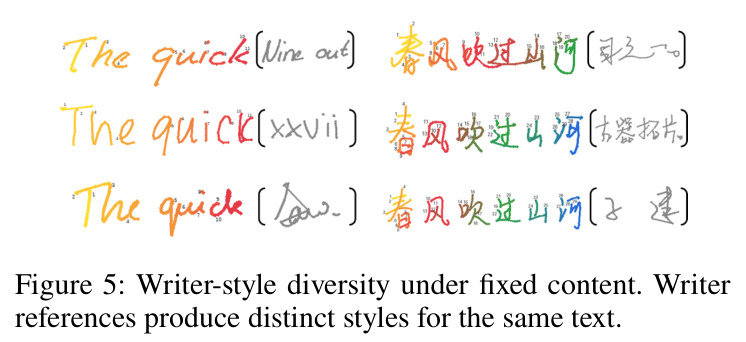
直觉上,写字时每个字长什么样由写者风格与该字的身份决定,而字与字怎么衔接由相邻字符和句子位置决定。BoundInk 据此把信息源拆成四路:写什么(字符身份)、学谁(全局写者风格)、这个字如何实现(字形级风格)、相邻字符如何交互(句子上下文+局部边界历史)。技术上分三块:(1) Style Identifier 用 ResNet18 从参考手写图像(遵循 SDT 的图像式风格参考协议,单通道二值图)编码 Writer-style memory 与 Glyph-style memory,ResNet18 与模型联合训练而文本骨干冻结;(2) Character Context Encoder 用冻结的 CANINE 文本编码器(可替换 ByT5)产生两个信号——对每个 Unicode 字符单独编码得到确定性身份锚点 $\mathbf{e}^{\mathrm{id}}(u)=f_{\mathrm{id}}(f_{\mathrm{text}}([u]))\in\mathbb{R}^D$(批内缓存复用),并加可学习码嵌入增强 $\tilde{\mathbf{e}}^{\mathrm{id}}(u)=\mathbf{e}^{\mathrm{id}}(u)+\alpha\mathbf{P}\phi(u)$ 以锐化大小写等离散身份;整句经轻量 Transformer 编码得到随位置变化的上下文记忆 $\mathbf{M}^{\mathrm{ctx}}=f_{\mathrm{ctx}}(\mathrm{TransEnc}_{\mathrm{ctx}}(\mathbf{W}_h f_{\mathrm{text}}(\mathbf{u})))$;(3) Bi-SWT 解码器(隐藏维 512、8 头注意力)在前后字符构成的 bigram 滑窗内用因果自注意力加 RoPE 自回归生成当前字符,每步输出 $K=20$ 分量的二维 GMM 参数与 4 类笔状态 logits(PM/PU/CursiveEOC/EOC);句子上下文按 token 经门控融合 $\mathbf{h}_t=(1-g_t)\mathbf{h}^{\mathrm{sty}}_t+g_t\tilde{\mathbf{h}}^{\mathrm{ctx}}_t$ 注入,门 $g_t=\gamma\,\sigma(f_{\mathrm{gate}}(\mathbf{h}^{\mathrm{sty}}_t))$ 被上限 $\gamma$ 截断,保证上下文只调节而不覆盖风格。
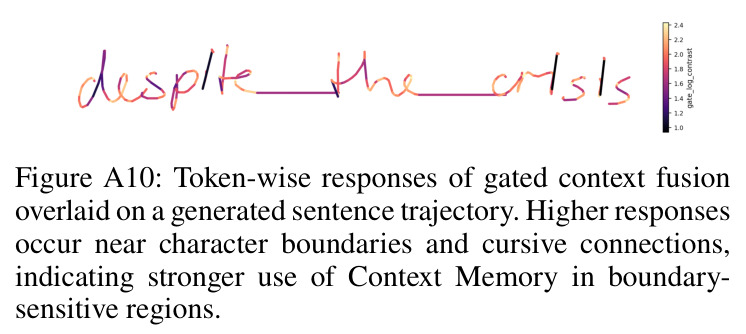
核心创新是把字符间边界当作一等公民的生成单元,而非长序列解码的副产品。Bi-SWT 解码器的输入窗口为 $\mathbf{X}_s=[\tilde{\mathbf{e}}^{\mathrm{id}}_{s-1},\mathbf{y}_{s-1,1:T_{s-1}},\tilde{\mathbf{e}}^{\mathrm{id}}_s,\mathbf{y}_{s,1:T_s}]$,即把前驱字符的轨迹(训练时取真实值、推理时取模型自己的预测)与当前字符身份嵌入拼成局部窗口再做因果自注意力。与已有方法的本质区别在于:DeepWriting/DSD 让全序列模型顺带学衔接、OLHWG 只建模布局与间距但不建模跨字符落笔延续,而 BoundInk 做了三件别人没做的事:(a) 显式把前驱轨迹作为条件输入;(b) 用 CursiveEOC 笔状态显式监督笔尖不抬、连写下一字的决策,配合类别权重 $[1.0,1.0,2.0,2.5]$ 强调两类边界事件;(c) 用 Vertical Drift Loss 在每个有效边界 $b=(s-1,s)$ 上惩罚前驱到当前的重心/顶部/底部垂直偏移误差 $\mathcal{L}_{\mathrm{vdl}}=\frac{1}{|\mathcal{B}|}\sum_b\sum_k w_k\|\hat{\delta}^k_b-\delta^k_b\|_2^2$($w_{\mathrm{cen}}=2.0, w_{\mathrm{top}}=w_{\mathrm{bot}}=1.0$),专门抑制增量坐标预测在长句中累积的垂直漂移。门控融合的 $\gamma$ 上限则保证上下文注入是受控增量,风格通路不被冲刷。
方法步骤详情
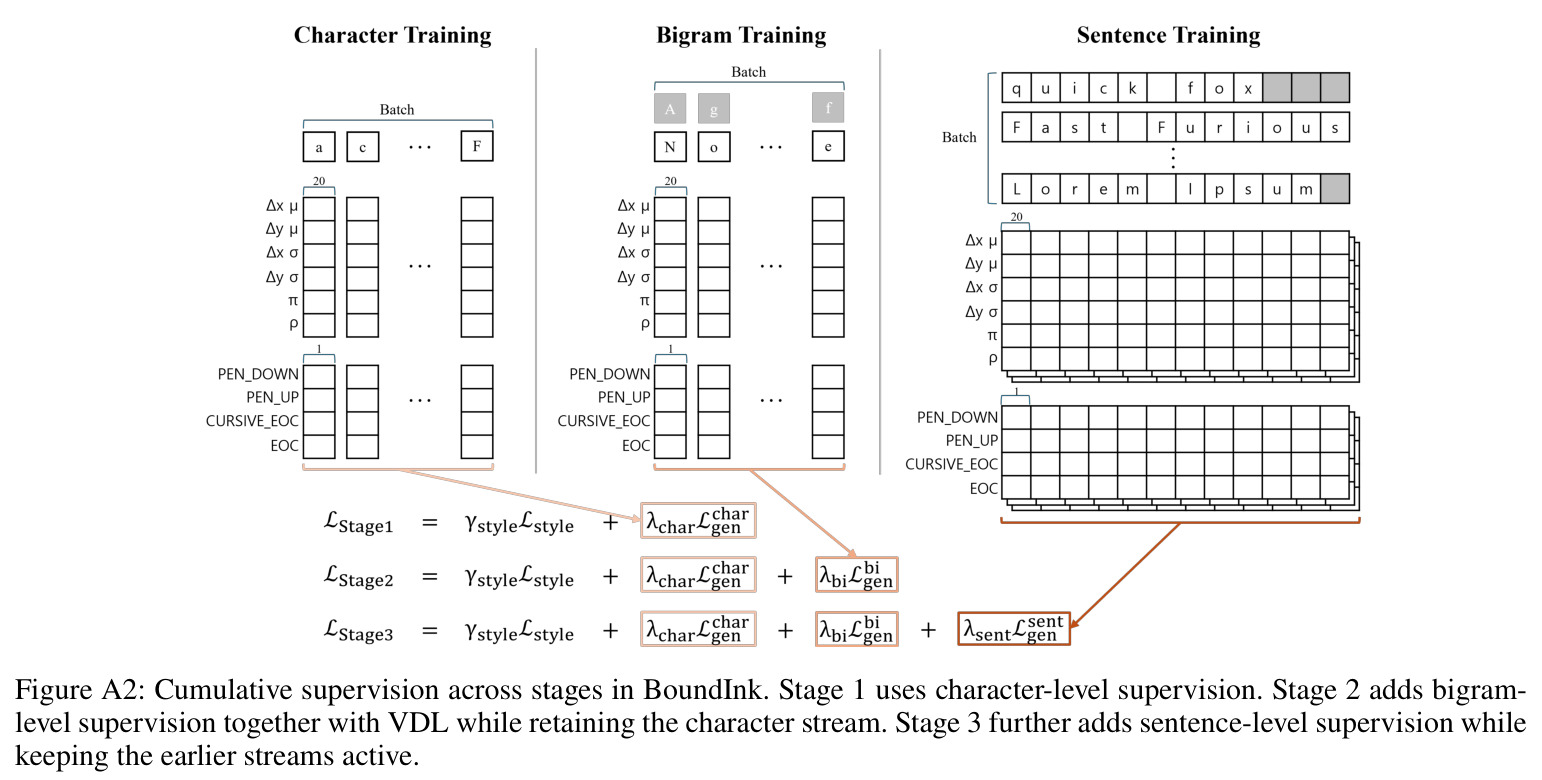
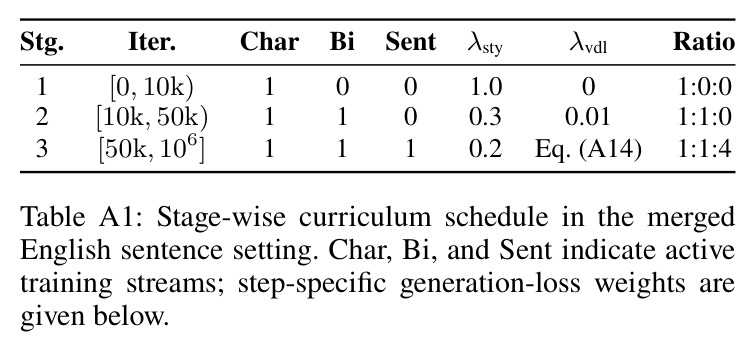
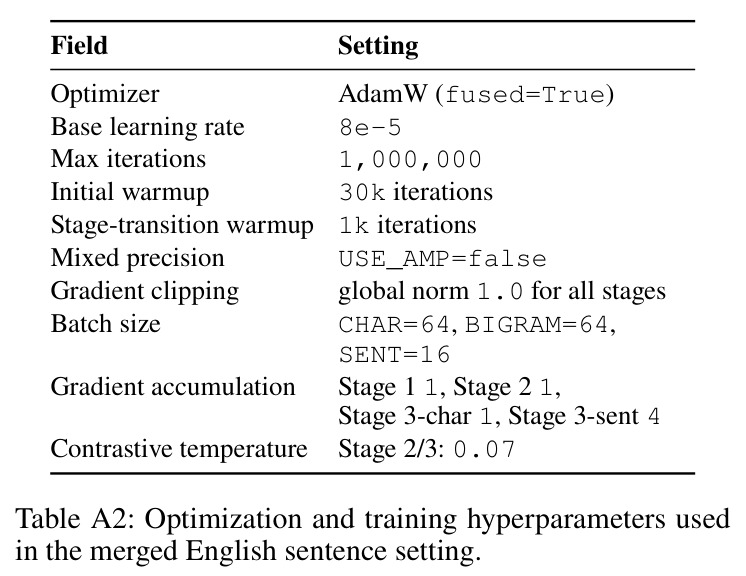
第一步,数据与预处理:合并 IAM-OnDB 与 BRUSH 构建英文合并集(写者不相交的 150 训练/20 测试写者),对 IAM 做最小二乘去斜(估角 $\theta=\arctan(m)$ 后旋转 $-\theta$)、按 Character Queries 复核字符切分、弧长重采样加弱 RDP 简化、保持纵横比的高度归一化 $h=1.0$,全程保留笔画端点以保护 PU/EOC/CursiveEOC 事件;中文协议用 CASIA-OLHWDB 2.0–2.2(写者 0–1019 训练、1020–1218 测试),并做 ±3 点容差的句子切分严格校验。第二步,三阶段课程:Stage 1(0–10k 迭代)只训字符流,比例 1:0:0;Stage 2(10k–50k)加入 bigram 流与 VDL,比例 1:1:0,$\lambda^{\mathrm{sty}}=0.3$、$\lambda^{\mathrm{vdl}}=0.01$;Stage 3(50k–1M)加入句子流,标称批比 1:1:4,句子级 VDL 在 60k–80k 线性预热至 1,$\lambda^{\mathrm{sty}}=0.2$;每次阶段切换加 1k 迭代 warmup。第三步,损失函数:序列损失 $\mathcal{L}_{\mathrm{seq}}=\mathcal{L}_{\mathrm{mdn}}+\lambda_{\mathrm{pen}}\mathcal{L}_{\mathrm{pen}}$($\lambda_{\mathrm{pen}}=1.5$),其中 $\mathcal{L}_{\mathrm{mdn}}=-\frac{1}{|\mathcal{V}|}\sum_{t}\log\sum_k \pi_{t,k}\mathcal{N}_2(\Delta\mathbf{y}_t;\boldsymbol{\mu}_{t,k},\boldsymbol{\Sigma}_{t,k})$,$\mathcal{L}_{\mathrm{pen}}$ 为 4 类笔状态掩码交叉熵;bigram 流额外加 VDL;再叠加写者监督对比与字形自监督对比的风格损失(温度 0.07),总目标 $\mathcal{L}^{(k)}_{\mathrm{total}}=\mathcal{L}^{(k)}_{\mathrm{gen}}+\lambda^{(k)}_{\mathrm{style}}\mathcal{L}_{\mathrm{style}}$。第四步,推理:完全自回归、无 teacher forcing,每样本生成一次,bigram 窗口中的 $\mathbf{y}_{s-1,\cdot}$ 换成模型自己的输出;GMM 参数用 softmax/exp/softplus+tanh 压缩,$\rho$ 夹在 $[-(1-10^{-5}),1-10^{-5}]$ 防数值不稳。优化用 fused AdamW、学习率 $8\times10^{-5}$、梯度裁剪 1.0、CHAR/BIGRAM 批 64、SENT 批 16,单张 H100 训练约 10 天。
技术新颖性
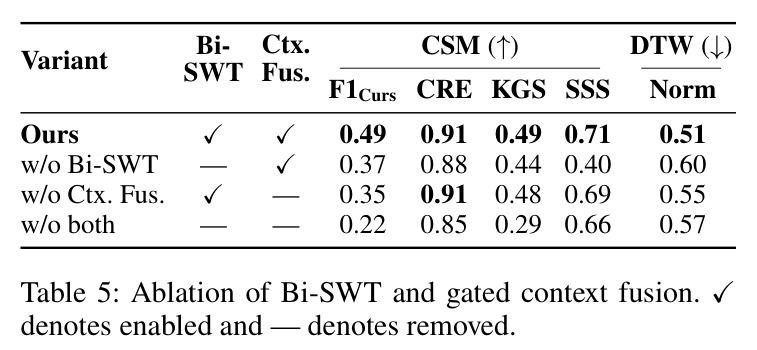
新颖性可从四个层面评估。表示层:四路信息解耦(身份/写者/字形/上下文)加单字符独立编码的身份锚点避免上下文泄漏;Figure A8 显示同字符嵌入平均相似度达 1.000、异字符 0.337(间隔 0.663),而上下文记忆同字符相似度 0.857 且随 token 顺序渐变,证明两条通路各司其职。机制层:bigram 滑窗解码与门控上下文融合是互相咬合的设计——消融显示去掉 Bi-SWT 后 SSS 从 0.71 跌至 0.40、$\mathrm{DTW}_{\mathrm{norm}}$ 从 0.51 升至 0.60,去掉门控融合后 $F1_{\mathrm{Cursive}}$ 从 0.49 跌至 0.35,二者互补缺一不可。监督层:CursiveEOC 是全新的显式连笔监督信号,VDL 是针对增量坐标漂移的几何正则,均无先例。评测层:CSM 四指标加写者宏平均加基准匹配成对协议,Figure A17 用三个案例证明 DTW 与 CSM 排序可以严重背离(如 DeepWriting 的 DTW 更低 0.153 vs 0.171,但 CSM 均值 0.300 vs 0.722),从方法论上论证了显式边界评测的必要性。
实验结果
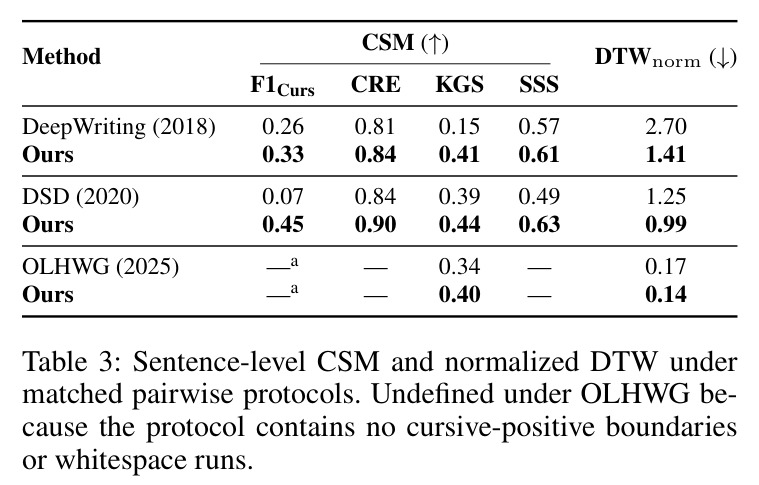
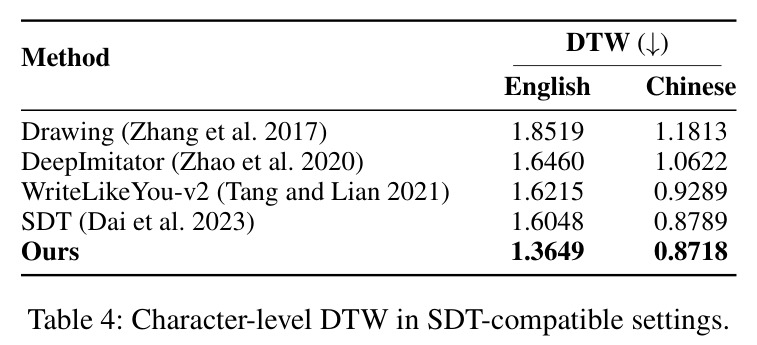
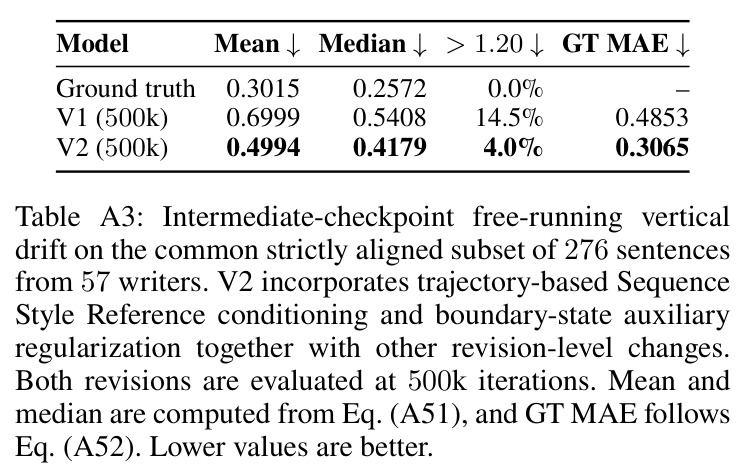
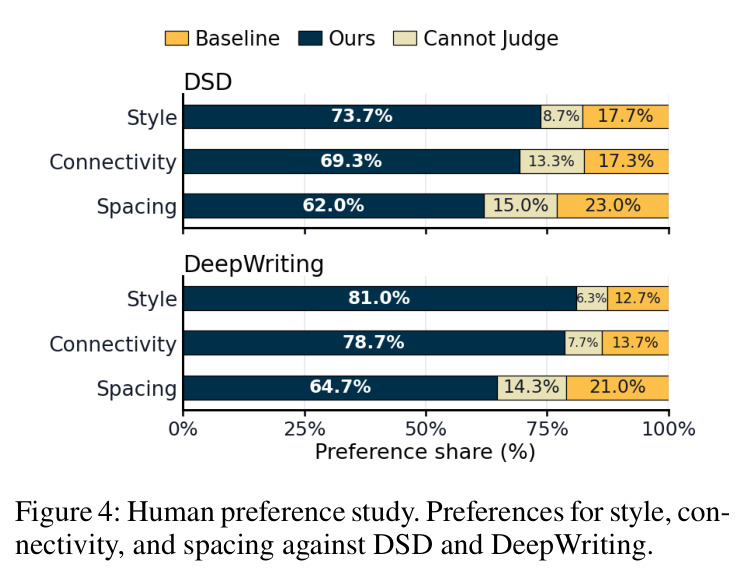
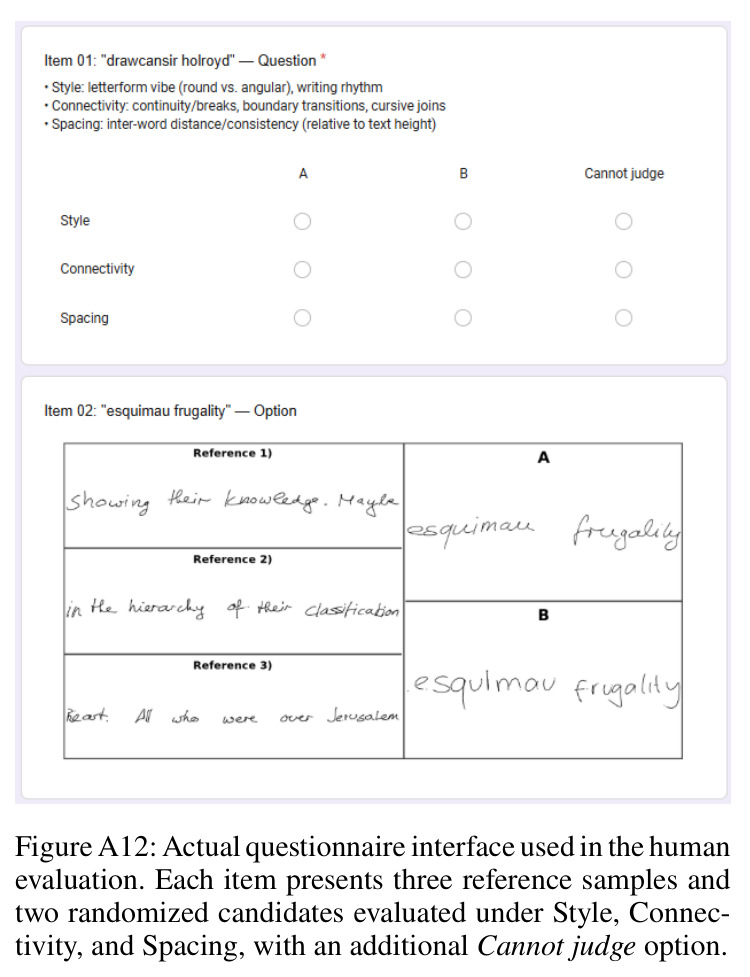
句子级生成(Table 3,三组基准匹配协议):在 DeepWriting 协议(IAM-expanded)上,BoundInk 把 $\mathrm{DTW}_{\mathrm{norm}}$ 从 2.70 降到 1.41(相对下降 47.8%),$F1_{\mathrm{Cursive}}$ 0.26→0.33、CRE 0.81→0.84、KGS 0.15→0.41、SSS 0.57→0.61;在 DSD 协议(BRUSH)上 DTW 1.25→0.99(20.8%),$F1_{\mathrm{Cursive}}$ 0.07→0.45、CRE 0.84→0.90、KGS 0.39→0.44、SSS 0.49→0.63;在 OLHWG 中文协议(CASIA-OLHWDB 2.0–2.2)上仅 KGS 与 DTW 有定义(该协议无连笔正样本与空白串),KGS 0.34→0.40、DTW 0.17→0.14(17.6%)。字符级生成(Table 4):SDT 兼容英文协议 DTW 从 SDT 的 1.6048 降到 1.3649,中文协议 0.8789→0.8718,说明句子级设计不损伤字形保真度(Elegantly Written 因是轨迹增强而非生成被排除)。消融(Table 5,合并英文集):完整模型 $F1_{\mathrm{Cursive}}$/CRE/KGS/SSS/DTW = 0.49/0.91/0.49/0.71/0.51;去掉 Bi-SWT 后为 0.37/0.88/0.44/0.40/0.60;去掉门控融合后 $F1_{\mathrm{Cursive}}$ 降至 0.35;两者都去掉则 0.22/0.85/0.29/0.66/0.57,说明局部解码管间距与几何稳定、句子上下文管连笔决策。CharID 码嵌入在字形级消融子集把平均 DTW 从 0.3464 降至 0.3328(相对 3.9%)。盲测人评(Figure 4):30 名参与者、1800 次判据级决策(有效 1604、弃权 10.9%),对 DSD 赢 615/789(78.0%),对 DeepWriting 赢 673/815(82.6%),风格/连接性/间距三项一致占优。OCR 与写者验证(Figure 7):对 DeepWriting,TrOCR-large/PyLaia-IAM 的 Top-1 从 35.8 升至 61.7、Top-5 68.3→81.7(GT 93.4/98.4);对 DSD,Top-1 6.0→69.0、Top-5 27.0→74.0(GT 98.5/99.5),证明边界改进没有牺牲内容可读性与写者特征。附录 D.1 的探索性 V2(序列风格参考+边界状态辅助任务)在 500k 检查点上把自由运行垂直漂移从 0.6999 降到 0.4994(28.7%)、GT 参照漂移 MAE 0.4853→0.3065(36.8%)、严重漂移(>1.20)句子占比 14.5%→4.0%,但这是修订级对比而非受控消融,且该检查点上 V2 的 DTW(2.6205)反而差于 V1(1.3152)。
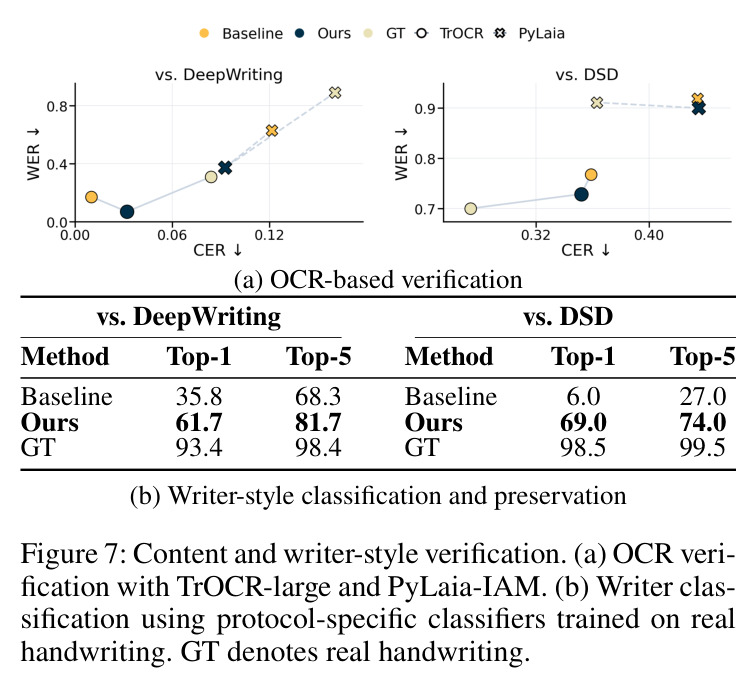
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 句子级生成(DeepWriting 协议,IAM-expanded) | 归一化 DTW(越低越好) | 1.41 | DeepWriting: 2.70 | 相对下降 47.8% |
| 句子级生成(DeepWriting 协议) | F1_Cursive | 0.33 | DeepWriting: 0.26 | +0.07 |
| 句子级生成(DeepWriting 协议) | KGS(字距相似度) | 0.41 | DeepWriting: 0.15 | +0.26 |
| 句子级生成(DSD 协议,BRUSH) | 归一化 DTW | 0.99 | DSD: 1.25 | 相对下降 20.8% |
| 句子级生成(DSD 协议) | F1_Cursive / SSS | 0.45 / 0.63 | DSD: 0.07 / 0.49 | +0.38 / +0.14 |
| 句子级生成(OLHWG 中文协议,CASIA-OLHWDB 2.0–2.2) | KGS / 归一化 DTW | 0.40 / 0.14 | OLHWG: 0.34 / 0.17 | +0.06 / 相对下降 17.6% |
| 字符级生成(SDT 兼容英文协议) | DTW | 1.3649 | SDT: 1.6048 | 相对下降约 15.0% |
| 字符级生成(SDT 兼容中文协议) | DTW | 0.8718 | SDT: 0.8789 | 相对下降约 0.8% |
| 盲测人评(对 DeepWriting,风格/连接性/间距) | 有效判据级偏好占比 | 82.6%(673/815) | DeepWriting: 17.4% | 压倒性偏好 |
| 盲测人评(对 DSD) | 有效判据级偏好占比 | 78.0%(615/789) | DSD: 22.1% | 压倒性偏好 |
| 写者分类验证(对 DSD) | Top-1 / Top-5 准确率 | 69.0 / 74.0 | DSD: 6.0 / 27.0 | +63.0 / +47.0(GT 98.5/99.5) |
| 写者分类验证(对 DeepWriting) | Top-1 / Top-5 准确率 | 61.7 / 81.7 | DeepWriting: 35.8 / 68.3 | +25.9 / +13.4(GT 93.4/98.4) |
局限与改进
作者承认的局限:(1) OLHWG 中文协议没有连笔正样本和空白串,CSM 大部分分量无定义,边界优势只能体现在 KGS 上;(2) 合并英文数据集只用于定性展示、人评与消融,不作定量基准,跨协议均需重训;(3) 附录 V2 是修订级对比,包含预处理、空格处理、损失配置、Stage 3 训练等多处联动改动,无法把垂直稳定性提升归因到单一组件,且只在 500k 中间检查点、276/588 条严格对齐句子上评估;(4) 人评规模有限:30 名韩国成年人、每协议 10 题、每个样本只生成一次。我的观察:(1) 边界监督强依赖可靠字符切分与边界标注——中文协议需要 ±3 点容差校验甚至整句丢弃,扩展到无标注或噪声数据困难;(2) 每个基线协议都要重训一次模型,单 H100 约 10 天、100 万迭代,缺乏统一模型,工程成本高;(3) 基线没有 CursiveEOC 时用距离阈值 $\tau_{\mathrm{conn}}$ 启发式反推连笔标签,可能系统性低估基线的连笔能力,对比存在偏置风险;(4) 完全自回归推理较慢且误差会累积(V2 的漂移诊断正暴露了这一点,且其 DTW 在同检查点恶化);(5) 实验只覆盖英文与中文,对阿拉伯文等强连笔文字体系未验证;(6) 论文正文未提供开源代码链接。
独立分析的弱点
弱点一:边界标签是硬前提。CursiveEOC 监督和 VDL 都要求每字符精确边界,数据切分有噪声(快速连写、字符重叠)时监督会失真,中文协议甚至要丢弃切分不齐的整句。改进方向:弱监督/自监督边界发现,或对边界标签建模不确定性(软标签、标签平滑、边界置信度加权损失)。弱点二:自回归加 $K=20$ GMM 头推理慢、长句误差累积,附录 V2 显示中间检查点仍有明显垂直漂移。改进:并行化或非自回归解码、扩散/流匹配轨迹生成器,或把 V2 的边界状态预测变成推理期自反馈信号。弱点三:跨协议需各自重训,缺乏一个协议无关的统一模型。改进:多协议联合训练加协议适配器,或把评测协议作为条件输入。弱点四:门控上限 $\gamma$ 全局固定,不适应不同写者连笔习惯差异;Figure A10 显示门值虽在边界处偏高但仍统一。改进:让 $\gamma$ 随写者风格或边界类型自适应。弱点五:KGS/SSS 基于水平边界框,重叠情形只用固定惩罚 $\rho=0.5$ 处理,对竖排文字或极端重叠粒度较粗。弱点六:风格参考只有静态图像,缺少写者的节奏与基线演进信息(作者自己的 V2 动机),应把序列参考升级为主模型的一等输入。
未来方向
作者提出的方向:(1) 引入可选的轨迹序列参考以更好捕捉写者特有的边界倾向(附录 V2 已给出原型,含 9 维边界状态表示与门控残差融合 $g_{\mathrm{seq}}=\gamma_{\mathrm{seq}}\sigma(a_{\mathrm{seq}})$、$\gamma_{\mathrm{seq}}=0.35$);(2) 推广到更广文字体系、未见字符组合以及参考稀缺或不匹配的场景;(3) 提升长序列解码效率与自回归误差累积的鲁棒性;(4) 建立同时评估内容、风格、边界质量、可靠性与效率的标准化基准。基于本文成果可延伸:(1) 对 V2 的序列参考和边界状态辅助任务在收敛检查点做受控消融,厘清各自贡献;(2) 把 CSM 发展成社区指标库,补充垂直对齐、倾斜一致性、笔画节奏等维度,并检查 CSM 与人评感知的相关性;(3) 与在线手写识别、签名验证联动,用 CSM 分析真实写者的边界统计特性;(4) 将显式边界建模用于墨迹编辑、手写动画与个性化输入法等下游任务;(5) 结合更强的多语言字符级文本编码器处理标点、数字与混排文本的语义感知间距。
复现评估
论文该版本未给出明确开源代码链接,但复现信息异常充分:附录提供了完整课程日程(Table A1:各阶段迭代区间、损失权重、批比 1:0:0→1:1:0→1:1:4)、优化超参(Table A2:fused AdamW、学习率 $8\times10^{-5}$、1M 迭代、30k 初始 warmup、1k 阶段切换 warmup、梯度裁剪 1.0、批大小 CHAR/BIGRAM=64 与 SENT=16)、VDL 权重与逐项数值算例($w_{\mathrm{cen}}=2.0$,示例边界损失 0.036255)、CSM 全部数学定义与人评问卷界面截图。数据集全部公开:IAM-OnDB、BRUSH、CASIA-OLHWDB 1.0–1.2 与 2.0–2.2、SDT 协议。算力门槛为单张 H100 约 10 天(1M 迭代),个人环境难以复现但机构可承受;主要工程难点在数据预处理管线(去斜、切分复核、重采样、弱 RDP、高度归一化 $h=1.0$)以及为每个基线协议分别重训。综合评估:有 H100 级算力与充分耐心即可复现,难度中偏高;若只想验证核心思想,可在合并英文集上训练消融规模的简化版本。
论文图表
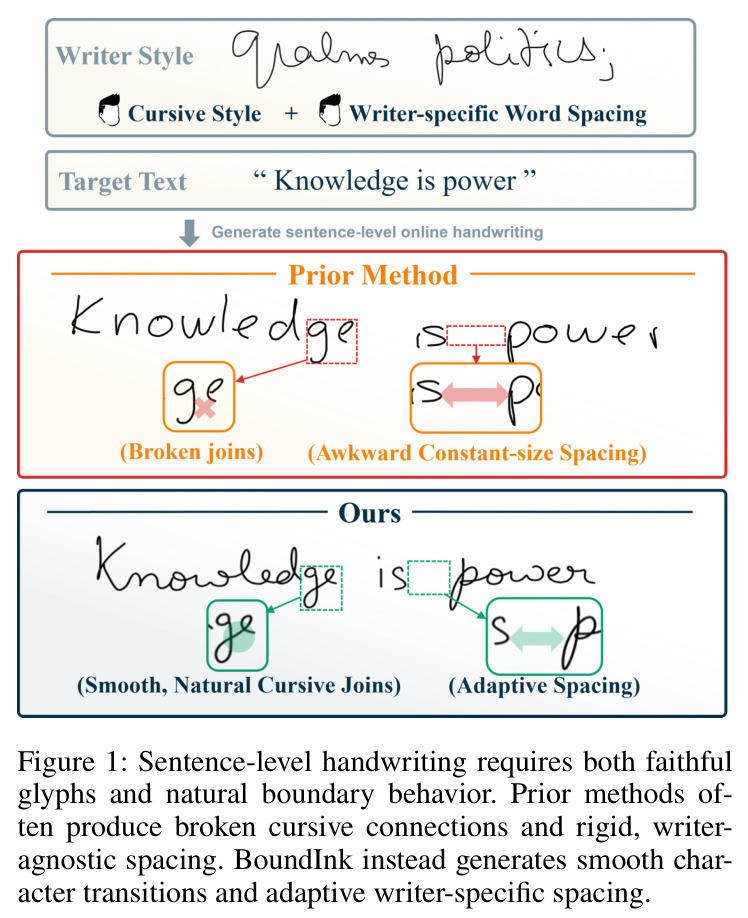
对比图:上方展示先前方法(DeepWriting、DSD 等)生成的句子,存在连笔断裂、字距僵硬且与写者无关的问题;下方是 BoundInk 的输出,字符过渡平滑、间距自适应写者习惯。
用一张图直观定义了论文要解决的核心问题——字形尚可但边界行为差,是理解全文动机的最快入口。
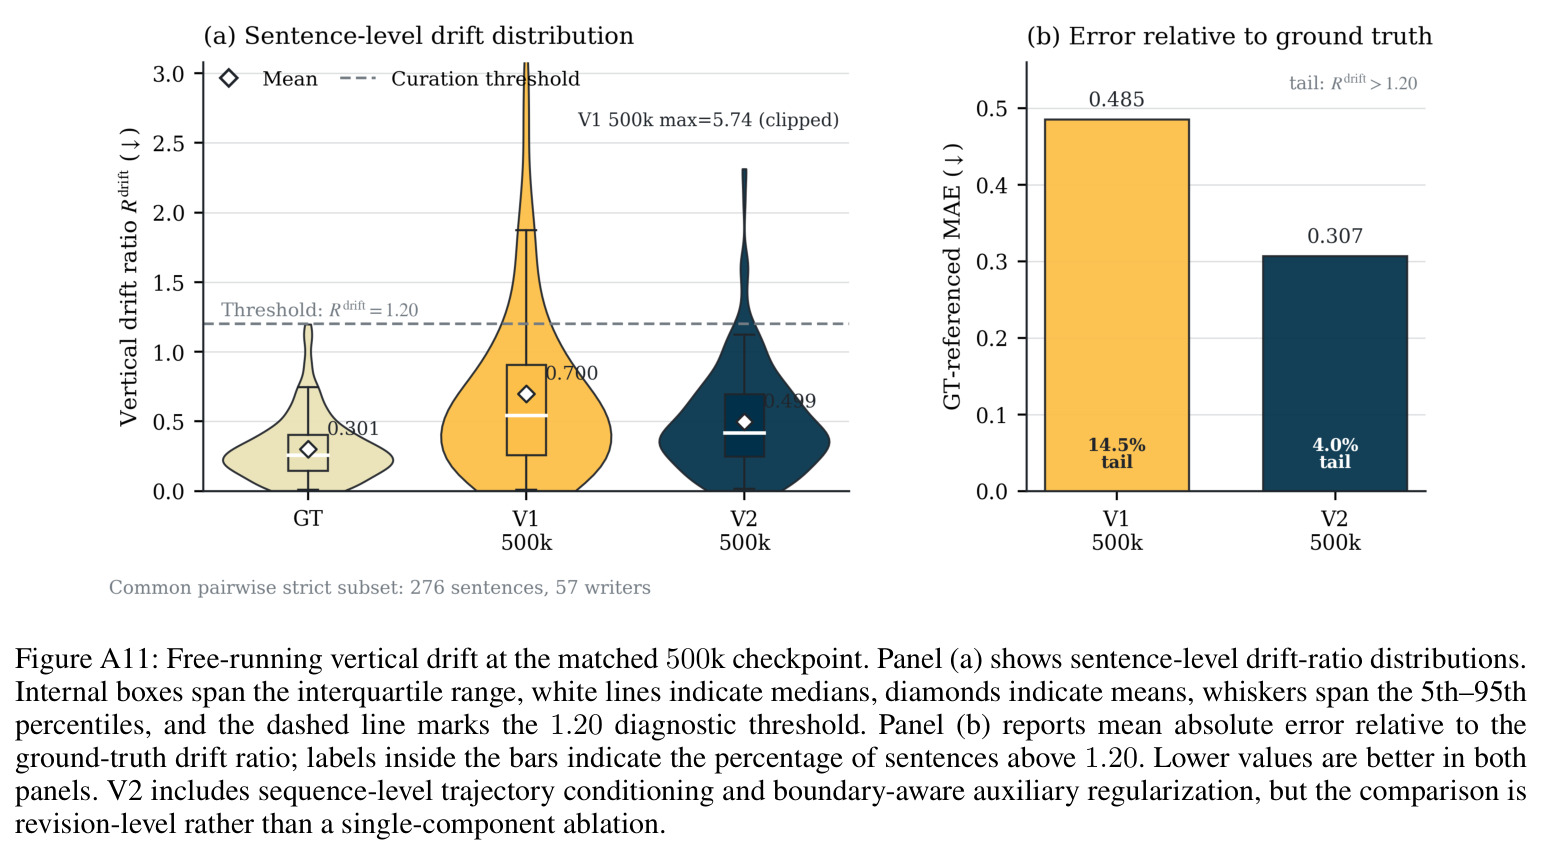
V1 与 V2 在 500k 检查点的句子级漂移比分布与 GT 参照误差:V2 均值 0.4994 vs V1 0.6999,严重漂移(>1.20)占比 4.0% vs 14.5%,但两者均高于 GT 的 0.3015。
揭示了自回归长句生成的残余弱点(垂直漂移),也示范了修订级对比的解读边界,对理解方法局限很重要。