预训练数据的词汇印记 The Lexical Imprint of Pre-training Data
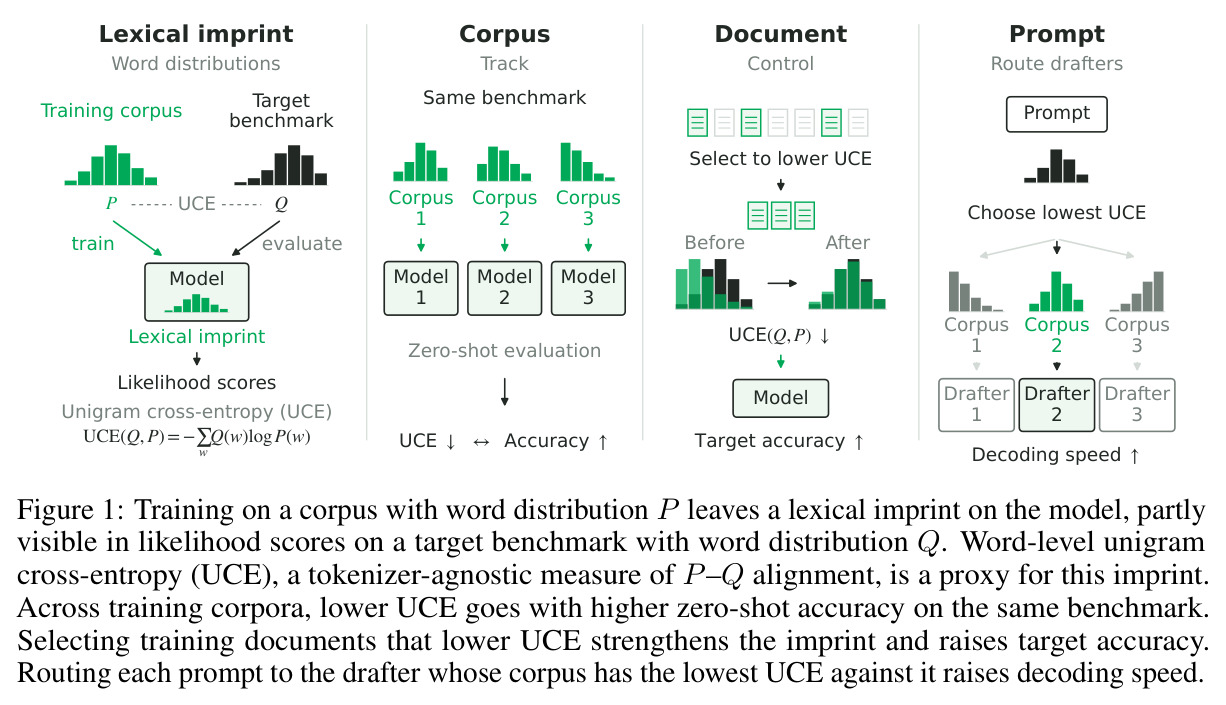
词级一元交叉熵(UCE)度量语料与基准的词汇对齐,可预测、控制并利用零样本行为
前置知识
交叉熵与 KL 散度
交叉熵 $H(Q,P)=-\sum_w Q(w)\log P(w)$ 衡量用分布 $P$ 编码真实分布 $Q$ 的平均代价,可分解为 $H(Q,P)=H(Q)+D_{KL}(Q\|P)$。对固定的 $Q$,$H(Q)$ 是常数,因此按交叉熵给多个候选 $P$ 排序等价于按 KL 散度排序。它是信息论中衡量两个概率分布差异的标准工具,只需词频计数即可估计。
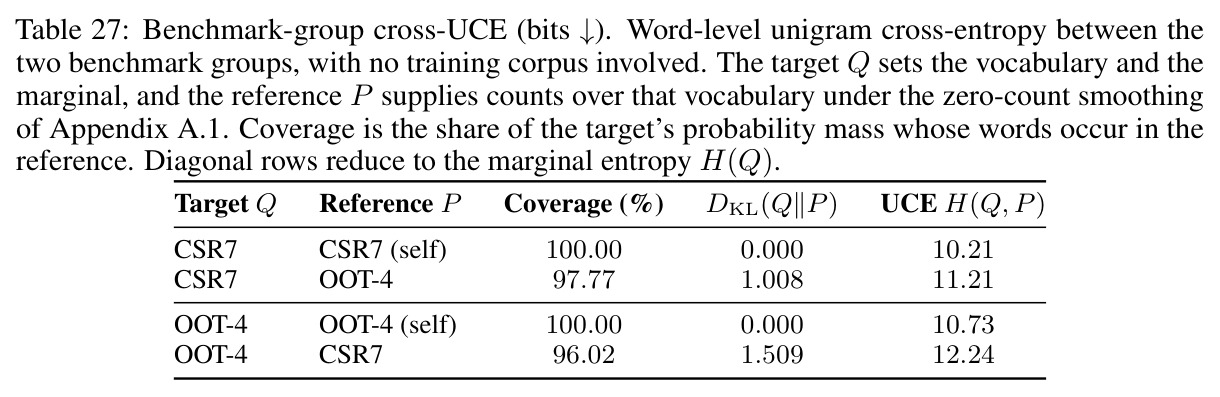
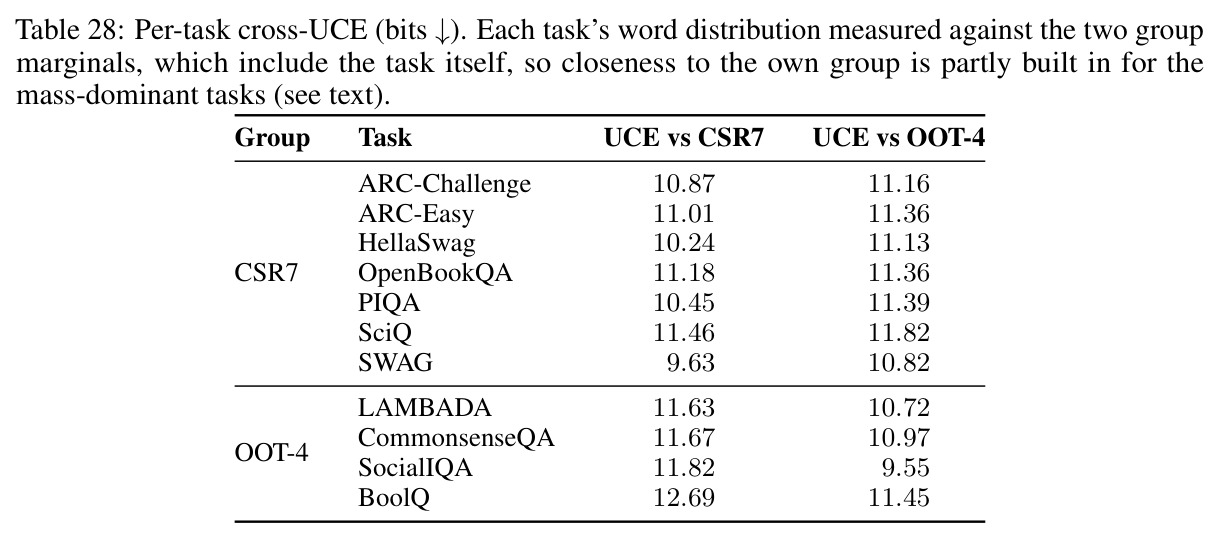
本文的核心度量 UCE 就是词级一元分布上的交叉熵。理解它的数值含义(单位为比特)、为何跨语料可比而跨基准不可比($H(Q)$ 随基准变化,11 个基准的 $H(Q)$ 跨度达 1.86 比特),都依赖这个分解。
零样本似然评估
不给任何示例、不做微调,把模型当作条件语言模型给候选答案打分,选条件似然最高者。lm-evaluation-harness 的多选评测即如此:将每个候选答案拼接到问题后计算语言建模损失,选损失最小的候选。分数完全由模型在基准文本上的似然决定。
论文的机制论证建立在这类评估的性质上:似然打分必然部分反映训练语料与基准文本的词分布对齐程度,这是"词汇印记"存在的直接原因,也是 UCE 能预测零样本准确率的机制基础。
n-gram 语言模型与压缩观
语言建模即压缩:最大化似然等价于最小化与训练数据经验分布的交叉熵。经典 n-gram 模型用条件计数近似数据分布,实证与理论工作表明神经语言模型在训练早期首先捕获低阶统计,n-gram 统计构成其表达能力的较紧下界,两者组合还能互相提升。一元分布是最粗但最稳健的低阶统计。
本文的工作假设是模型预测分布近似对齐语料统计,词级一元分布因此成为连接训练数据与零样本行为的低阶代理。没有这个直觉,就无法理解为什么一个只看词频的标量能预测基准表现。
DSIR 与数据选择
数据选择指在固定 token 预算下从大语料挑选子集以提升下游表现。DSIR(Xie et al., 2023)把每个文档映射为哈希到 10000 个桶的一元/二元 n-gram 特征,估计文档相对目标域的重要性权重,用 Gumbel top-K 重要性重采样选出目标数量的文档,是近年数据选择的标准基线。
UCE-filter 的主要对照就是忠实复现的 DSIR。理解其总分随文档变长而系统性下降的长度偏差(需约 3 亿文档才凑满 70B token,且在 LAMBADA 上掉分),才能读懂 Table 1/2 中 DSIR 为何增益更小。
投机解码
一种无损加速推理的方法:用小而快的 drafter 模型连续起草多个候选 token,再由大验证模型并行验证,被接受的 token 一起输出。平均接受长度 $\tau$ 越高、每 token 加速比越大。drafter 与目标模型的输出分布越匹配,接受率越高。
论文第 6 节把 UCE 用作路由信号:每个 prompt 被分配给训练语料与该 prompt 词分布 UCE 最低的 drafter。$\tau$ 与加速比是衡量这一应用是否成功的核心指标。
研究动机
现代语言模型的能力几乎完全由零样本基准(ARC、HellaSwag、MMLU 等)定义,但这些分数里有多少来自"训练语料恰好和考题用词相近",有多少来自真正的泛化,一直缺乏干净的量化答案。已有工作都是对成品 checkpoint 的事后分析:Razeghi 等发现条目级词频与 few-shot 数值推理准确率相关,Kandpal 等发现实体的长尾出现频率决定问答表现,Ruzzetti 等发现测试样本词汇流行度与成绩相关,Wu 等用 32 个预训练模型的 token 级困惑度在 89 个基准上预测性能。这些分析的共同缺陷是:语料身份与训练配方、模型规模、tokenizer、训练历史全部纠缠在一起,无法把"词汇对齐"这一个变量单独拎出来量化;而在受控的从零预训练设定下(同一配方、只变化语料),这种对齐信号在大规模上几乎没有被系统刻画过。
本文的目标是本文要回答一个明确的问题:预训练语料与基准目标之间的词分布对齐,能解释多少零样本基准准确率?并把这个答案做成可操作的东西。具体分三层目标:先在受控网格(4 个预训练语料 × 3 个模型规模 × 10 个基准,全部从零预训练、训练配方完全固定)里验证词级一元交叉熵 UCE 与零样本准确率的负相关是否普遍成立、是否跨随机子集稳定;再把 UCE 从"测量"升级为"干预",提出 UCE-filter 在固定 token 预算内人为提高文档级对齐,检验准确率是否按机制预测的那样只在目标任务上上升;最后在推理时"利用"这个信号,按 prompt 与各 drafter 训练语料之间的 UCE 做投机解码路由,看统计信号能否转化为实际吞吐收益。三个尺度共用同一个统计量,构成"观察—控制—利用"的完整证据链。
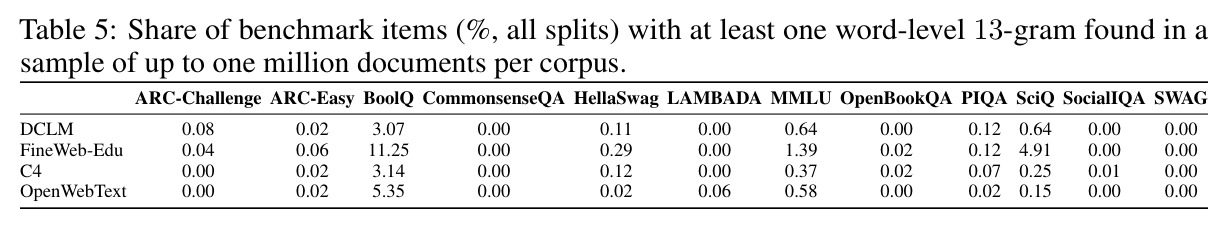
与已有工作不同的是,本文的独特切入是信息论式的极简代理:不做模型内部分析,而是把预训练语料和基准各自压缩成词级一元分布 $P$ 与 $Q$,用 $\mathrm{UCE}(Q,P)=-\sum_{w\in V_b}Q(w)\log P(w)=H(Q)+D_{KL}(Q\|P)$ 度量对齐。这个代理 tokenizer 无关(词是语料与基准共有的最小语义单位,避开子词分词的边界伪影)、模型无关(纯词频计数)、便宜到能在数十亿行语料上做行级评分。与前人工作的本质差异有三:(1) 用固定配方的从零预训练网格把语料身份从训练历史中剥离出来,而不是在 checkpoint 上做纠缠的相关分析;(2) 不止于描述,把同一个泛函 $D_{KL}(Q\|P)$ 依次用作语料排序信号、文档筛选目标、prompt 路由准则,完成从测量到控制再到部署的闭环;(3) 态度克制,明确把结论限定为"词汇印记"的下界代理,并用 13-gram 审计正面处理基准污染这个最显然的替代解释。
核心方法
直觉上,似然训练的最小化目标就是模型分布与训练语料经验分布之间的 KL 散度,而优化几何决定了模型首先学会词的边际分布(哪些词常见、常见到什么程度),句法、多词组合、事实共现等高阶条件结构是训练后期才部分学会的,尤其在长尾上残缺。因此基于似然的零样本打分天然携带语料-基准词分布对齐的痕迹,作者称之为"词汇印记"(lexical imprint)。技术路线分三步:先把两份文本都归约为词级一元分布——语料得到参考分布 $P$,基准得到目标分布 $Q$,定义 $\mathrm{UCE}(Q,P)=-\sum_{w\in V_b}Q(w)\log P(w)$;由于对固定基准 $H(Q)$ 是常数,UCE 排序等价于 $D_{KL}(Q\|P)$ 排序。然后(一)在 C4、DCLM、FineWeb-Edu、OpenWebText 四个语料上从零预训练 400M/1.33B/3.36B 三个规模的模型,做语料级观察;(二)把行级交叉熵增量做成 UCE-filter,干预文档级对齐;(三)在投机解码里按 prompt 级 UCE 给 drafter 路由。三步使用同一个公式,是对同一机制的渐近收紧的检验。
核心创新是"一个泛函,三个尺度"。已有词汇信号研究都在预训练 checkpoint 上做相关性分析,语料效应与训练历史纠缠;本文用受控从零预训练把 UCE-准确率关系隔离出来,再进一步把它变成可优化的目标函数。UCE-filter 的关键在行级更新的解析性:删掉一行文档 $r$ 只改变该行内出现的词的计数,所以 $\Delta H_r = H(Q, P_{\setminus r}) - H(Q,P)$ 可由行内稀疏计数与全局计数解析算出,一次线性扫描即可给数十亿行排序,丢弃使 $H(Q,P)$ 上升最多($\Delta H_r$ 最小)的行、保留其余。这与 DSIR 的哈希 n-gram 重要性重采样本质不同:不需要哈希近似、不引入采样噪声,直接优化与描述分析完全相同的交叉熵泛函,且没有 DSIR 那种随文档变长分数下降的长度偏差。prompt 级路由则第三次复用同一公式:预计算每个 drafter 语料的词分布后,对每个 prompt 只需一次稀疏点积即可算出 $\arg\min_k H(Q_x, P_d^{(k)})$,延迟可忽略。
方法步骤详情
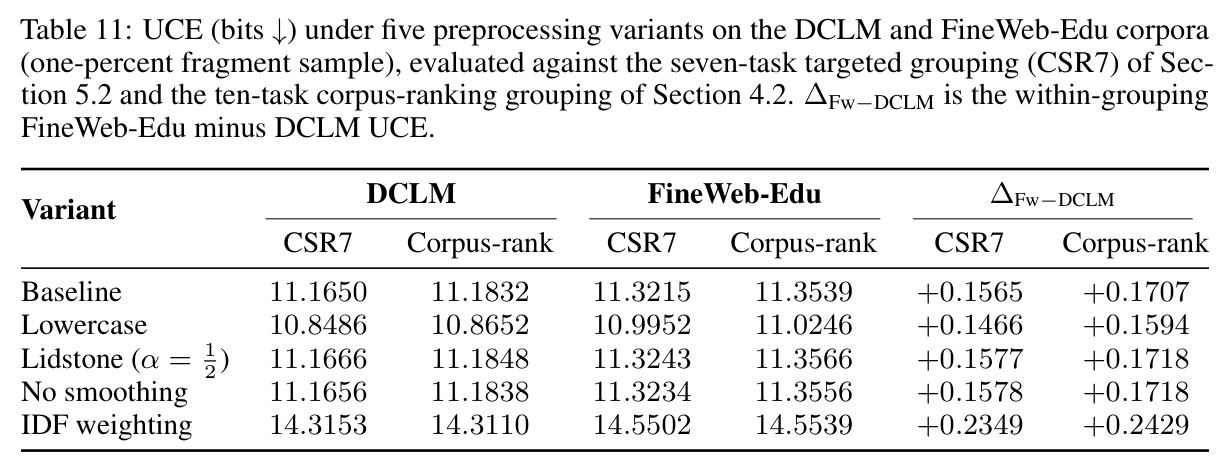
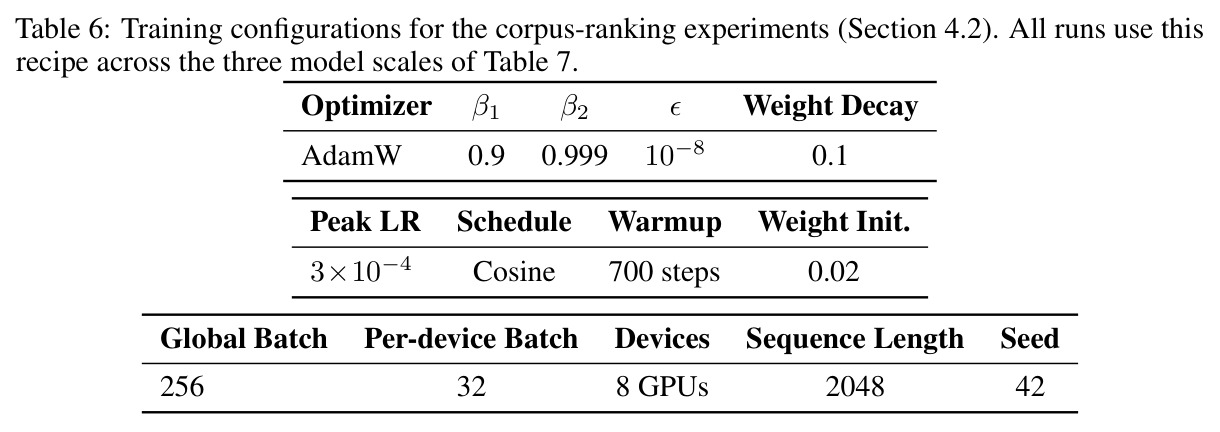
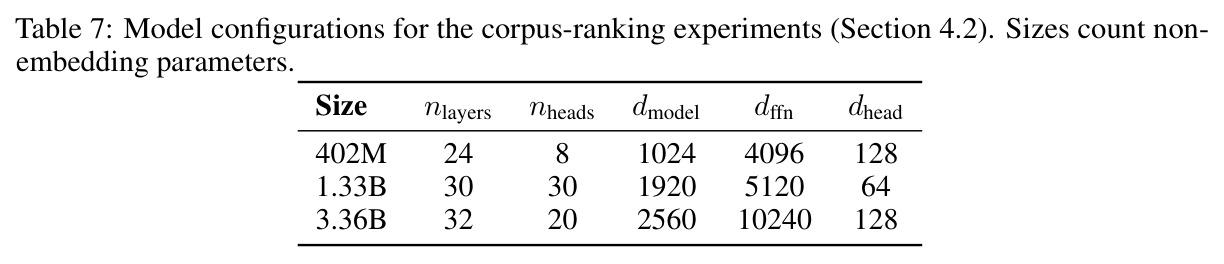
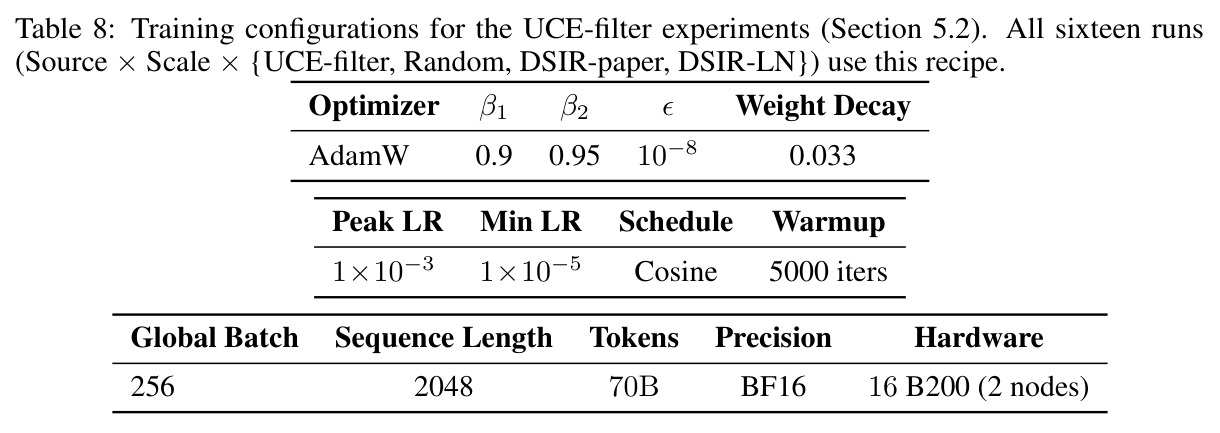
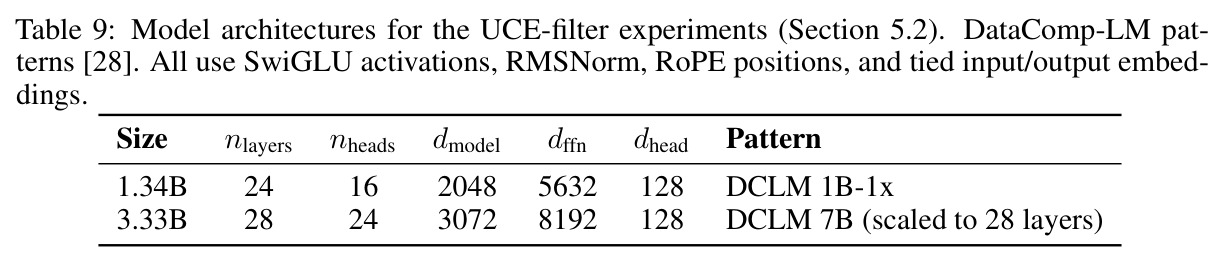
第一步,定义与计算 UCE:对文本做 Unicode NFKC 规范化、去标点、空白切词(保留大小写,因为专有名词的大小写携带分布信息),在基准词表 $V_b$ 上统计相对频率得到 $Q$ 与 $P$;对语料中未见的基准词做零计数平滑 $\tilde{P}(w)=\max\{c(w),1\}/(T+B)$($T$ 为语料总词数,$B$ 为未见词类型数),只给零计数加一以避免对数发散,单位为比特。第二步,语料级观察:从 C4、DCLM、FineWeb-Edu 各抽 8.5B/26B/60B token 的三个随机子集(OpenWebText 总量仅约 9B,只在 8.5B 规模评估),从零预训练 LLaMA 架构的 400M/1.33B/3.36B decoder-only Transformer(AdamW、cosine 学习率衰减、序列长 2048、全局 batch 256、GPT-2 tokenizer,各配对接近 Chinchilla 最优的 20 token/参数),在 10 个基准上做零样本似然评估,逐一比较 UCE 排序与准确率排序;另抽 16 个随机子集(C4/DCLM/FineWeb-Edu 各 5 个 + OpenWebText 1 个)检验稳定性。第三步,文档级干预:对每行文档解析计算 $\Delta H_r$,保留对 CSR7 七任务(ARC-Easy/Challenge、HellaSwag、SciQ、OpenBookQA、PIQA、SWAG)聚合目标分布对齐最高的 20% 行,构成 70B token 子集,与均匀随机采样和忠实复现的 DSIR 在 1.34B/3.33B × 3 训练种子下对比训练;再做 30B 参数模型 Stage-2 生产案例(用 UCE-filtered web 子集替换 2T token 生产混合的 web 组件,只训 200B token)。第四步,prompt 级路由:用 OpenThoughts-114k 训练 math/code/science 三个 SAM 架构专家 drafter 和一个等量混合的 generalist drafter,验证模型为 DeepSeek-R1-Distill-Llama-8B,每个 prompt $x$ 按 $k^\star=\arg\min_k H(Q_x, P_d^{(k)})$ 路由,在 AIME、LiveCodeBench、MMLU、MedQA 上测平均接受长度 $\tau$ 与每 token 加速比。
技术新颖性
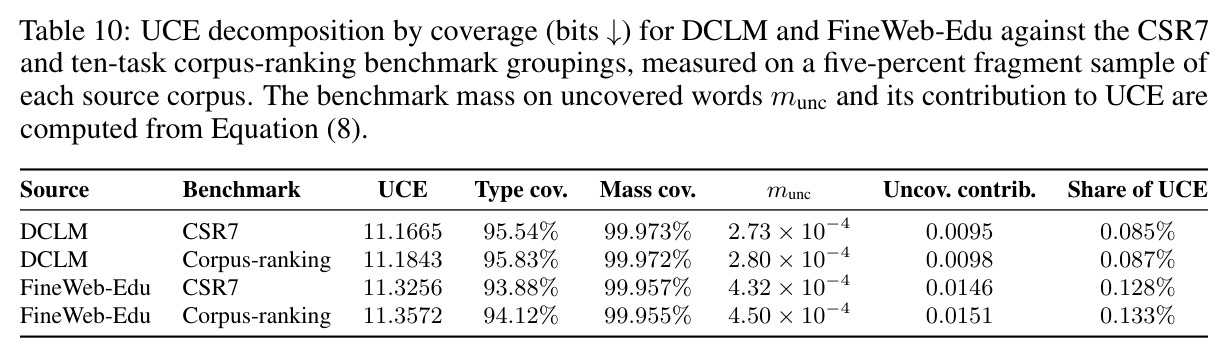
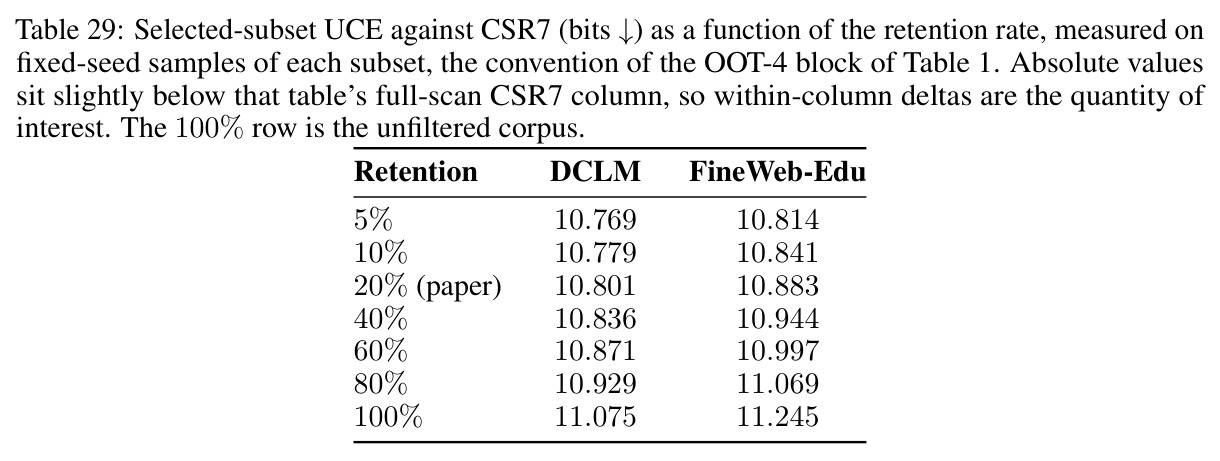
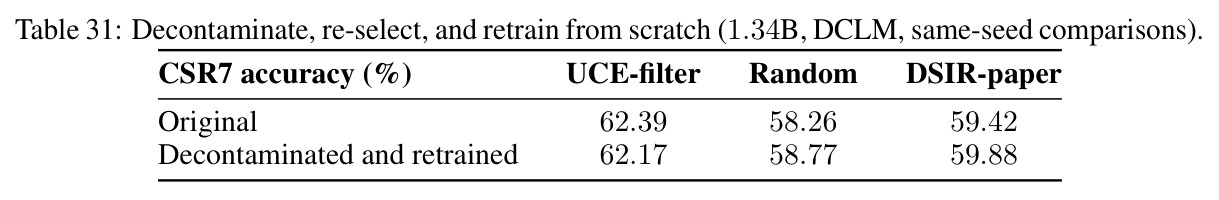
技术新颖性有三层。概念上,"lexical imprint" 把压缩观(似然训练即经验交叉熵最小化)与 n-gram 下界文献(神经语言模型早期首先捕获低阶统计)串成一个可检验命题:零样本似然评估部分反映语料-基准词分布对齐,并给出跨语料、跨文档、跨 prompt 的一致证据。方法上,UCE 是 tokenizer 无关、模型无关的单一信息论泛函;UCE-filter 的行级解析更新 $\Delta H_r$ 无需重估全局分布、两遍扫描、可按 CPU 核数线性并行扩展到数十亿行,与 Klakow 的 unigram 打分和 Moore-Lewis 交叉熵差分滤波一脉相承但更精确、更可扩展,并系统性地避免了 DSIR 的长度偏差(附录 E.2 证明 DSIR 总分对长文档偏低,需约 3 亿文档才能凑满 70B token 预算)。实验设计上,2×2(源语料×规模)× 3 种子的从零预训练网格把"选择提高对齐→对齐提高目标准确率"这条链在同一源语料内部验证,绕开跨语料比较时策展质量与体裁的混杂;再用 13-gram 审计在训练端(剔除 0.13% 的 DCLM 行后重选重训,同种子增益从 4.13pp 保留到 3.40pp)和评估端双向去污复验。把同一统计量第三次复用为推理时 drafter 路由信号,也属首次。
实验结果
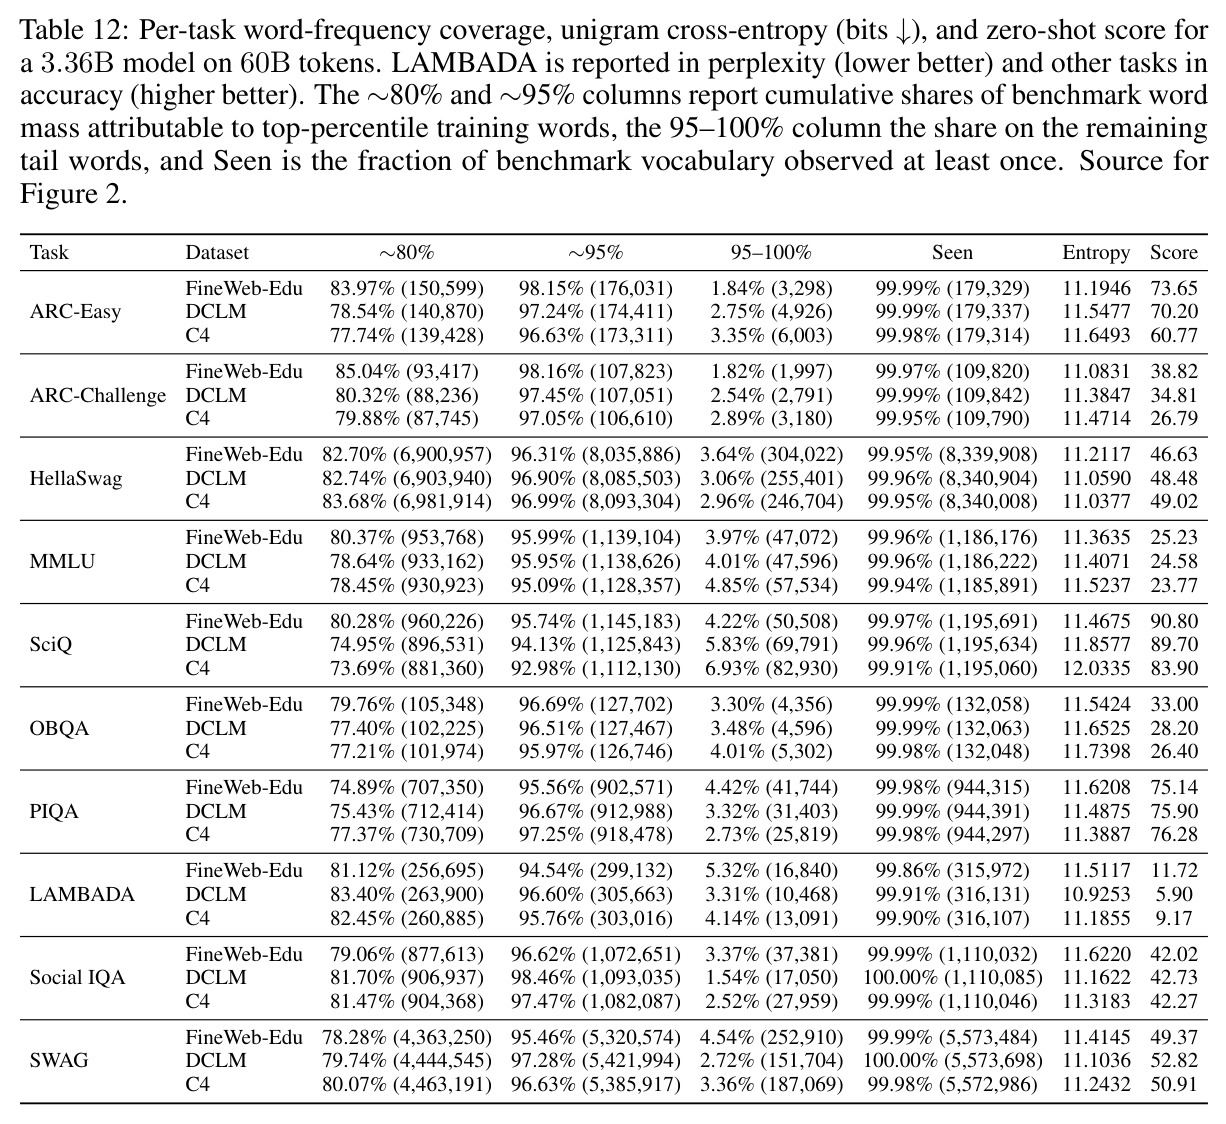
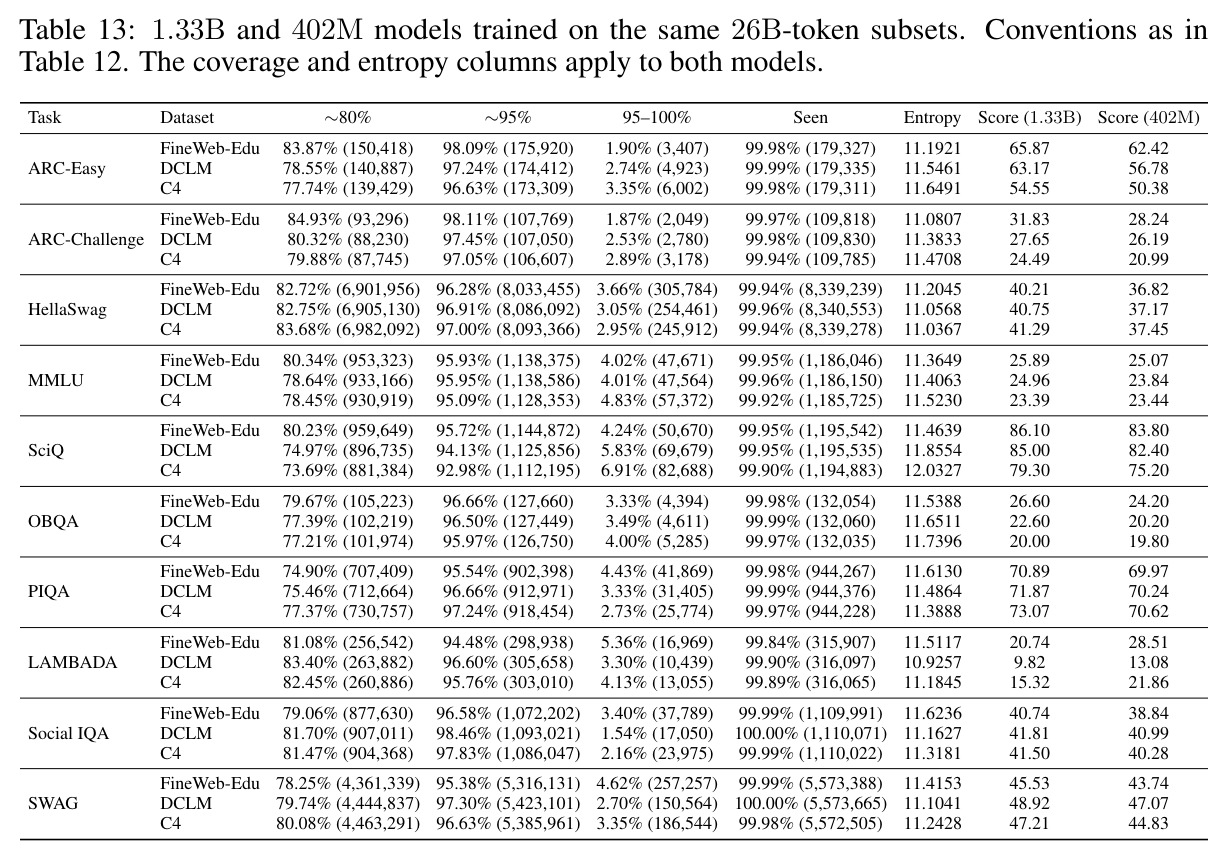
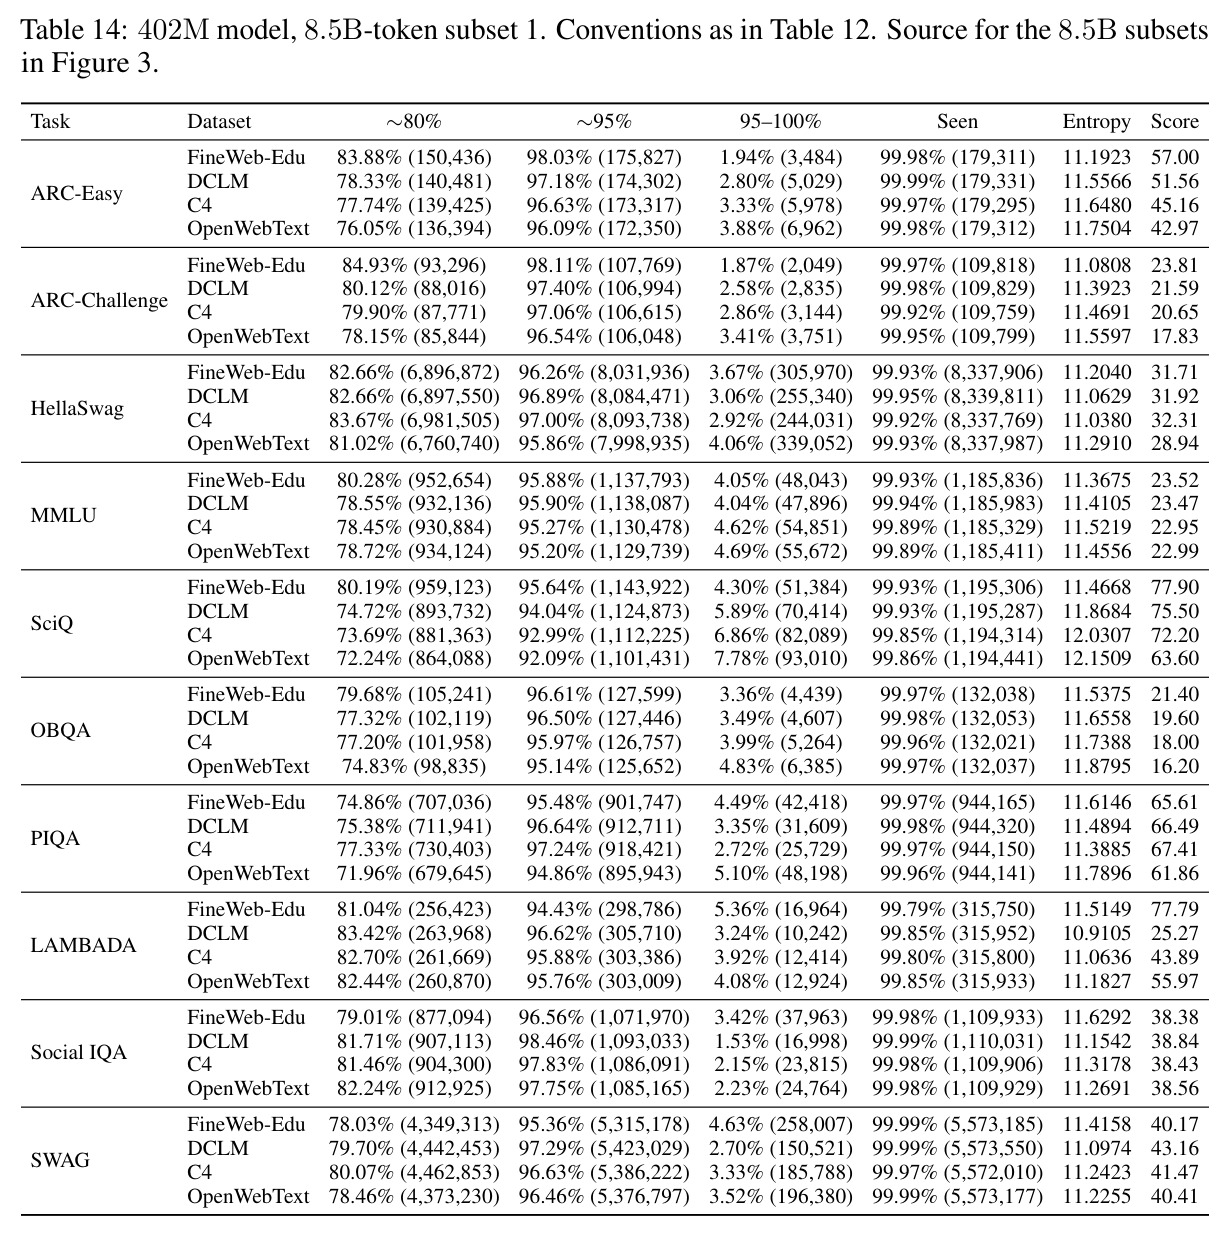
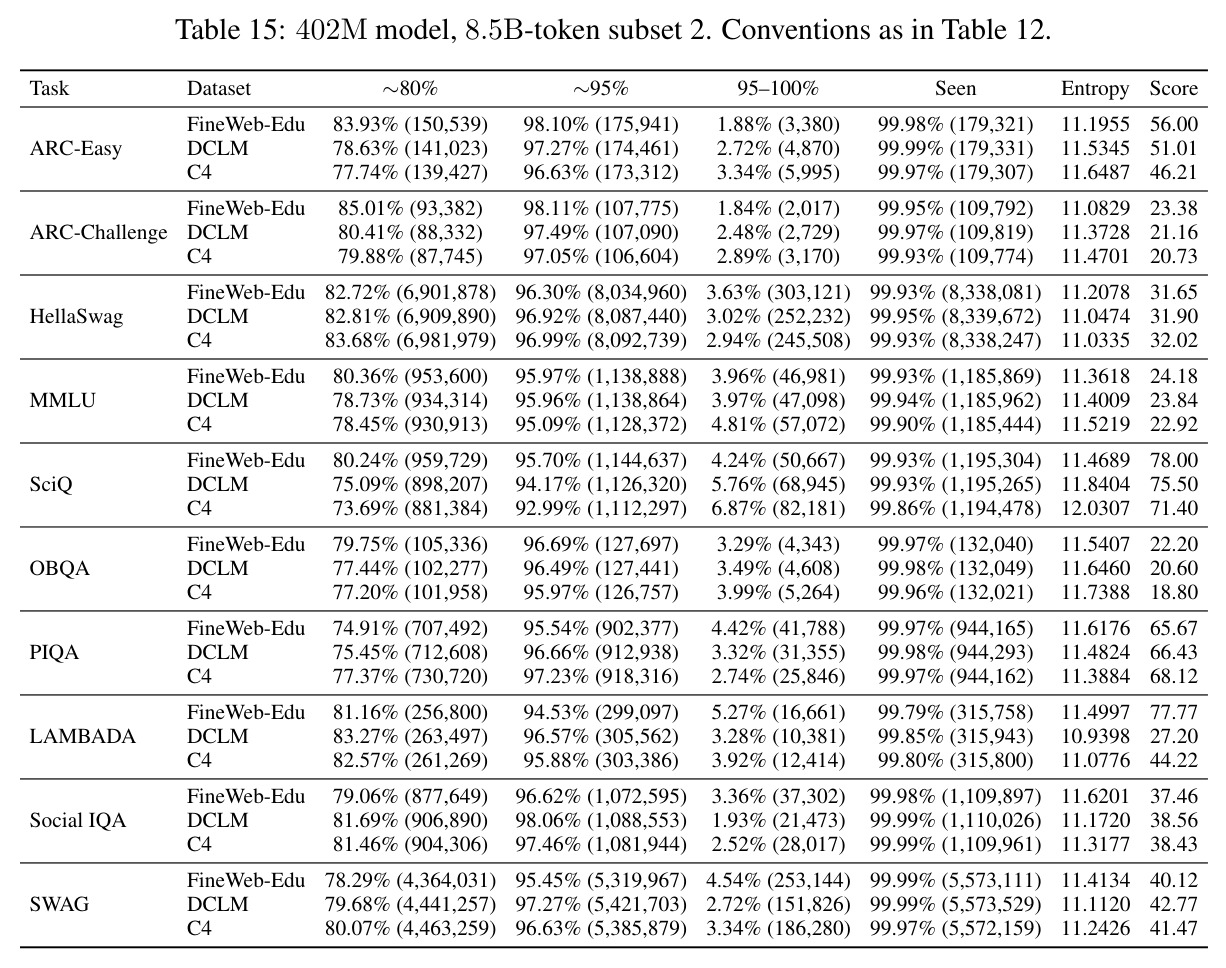
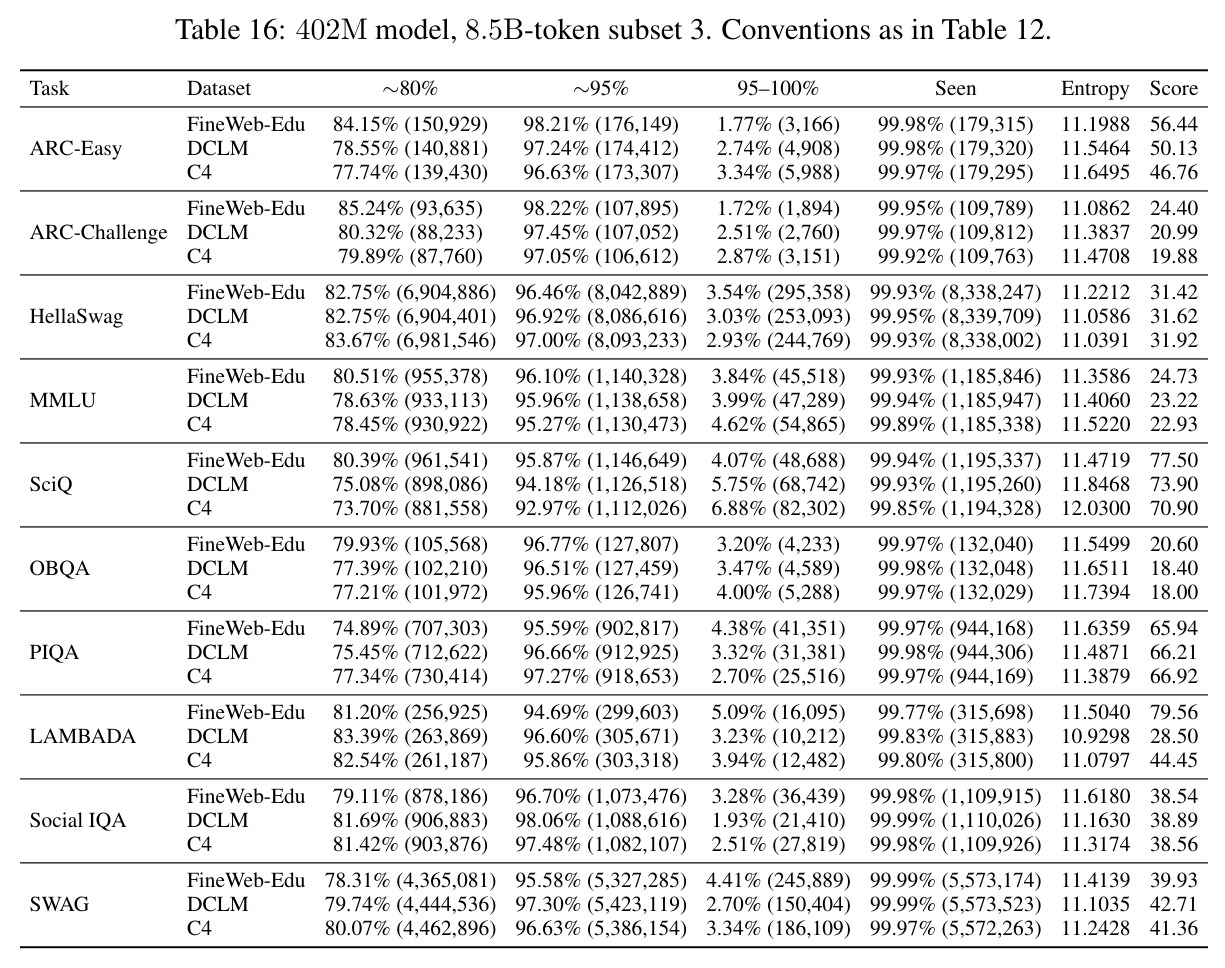
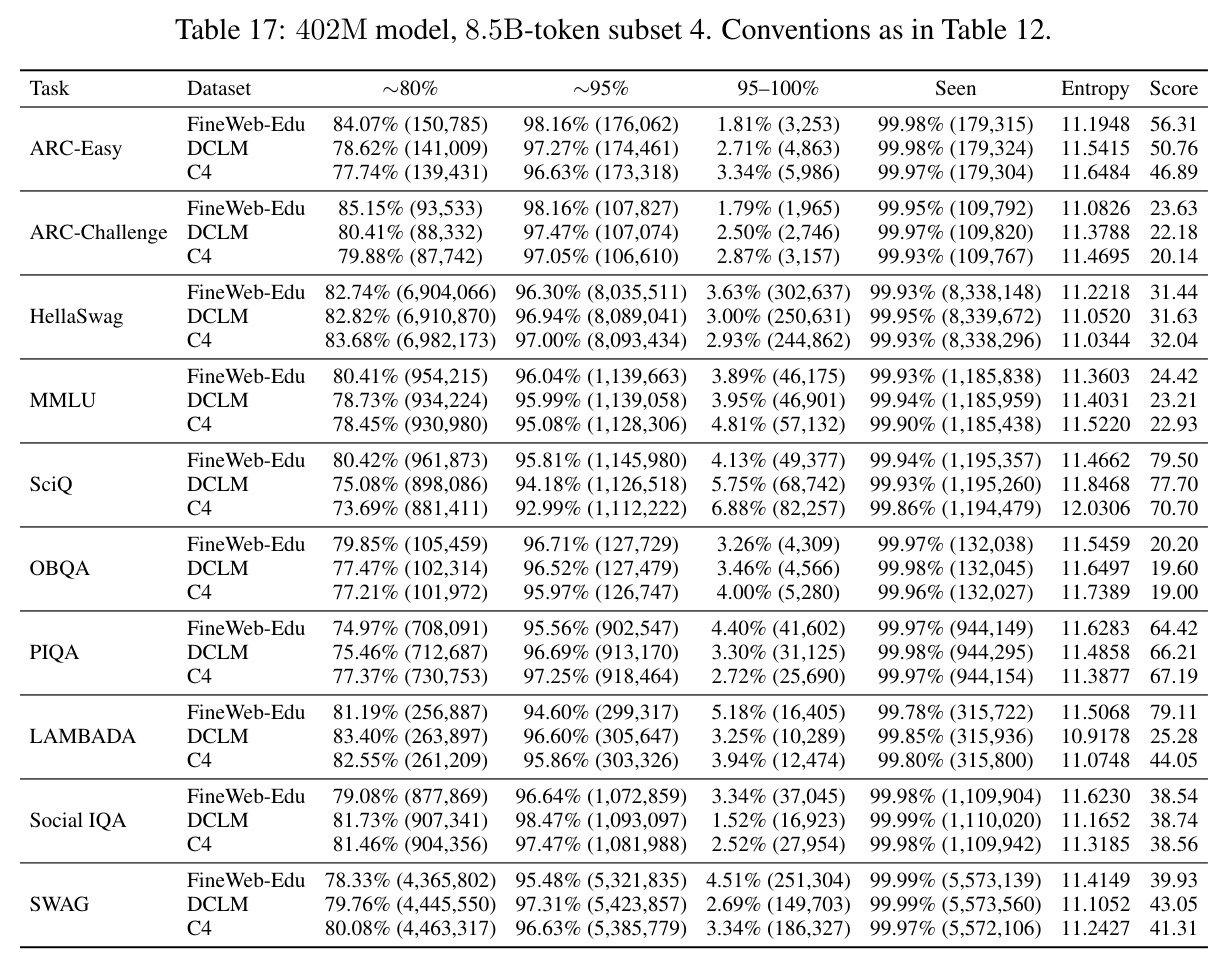
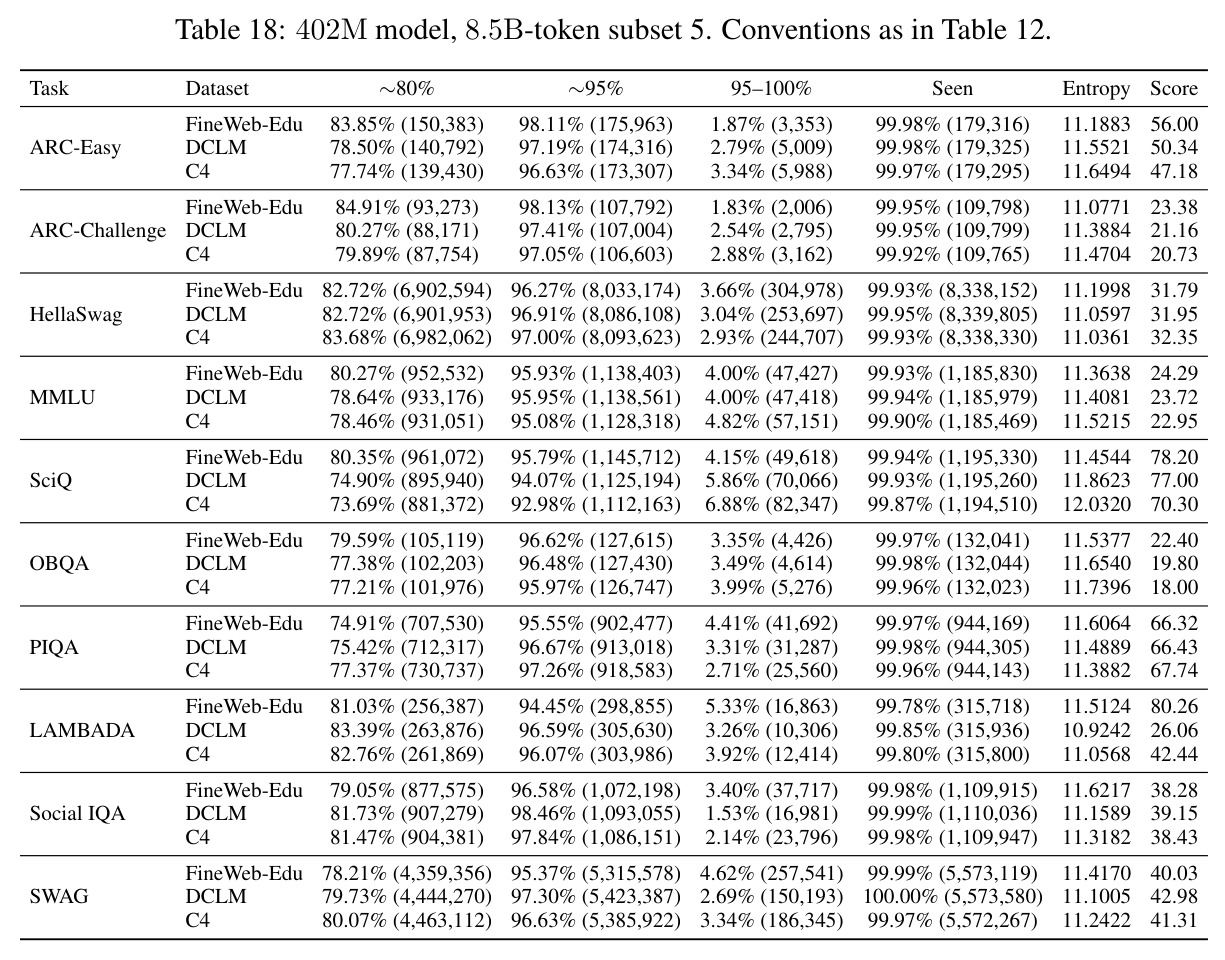
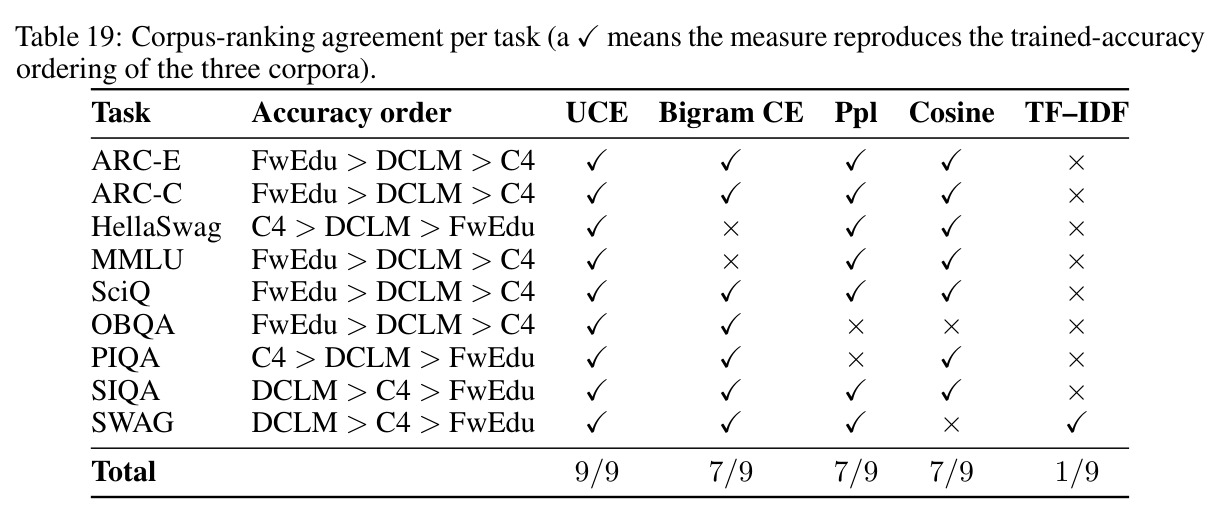
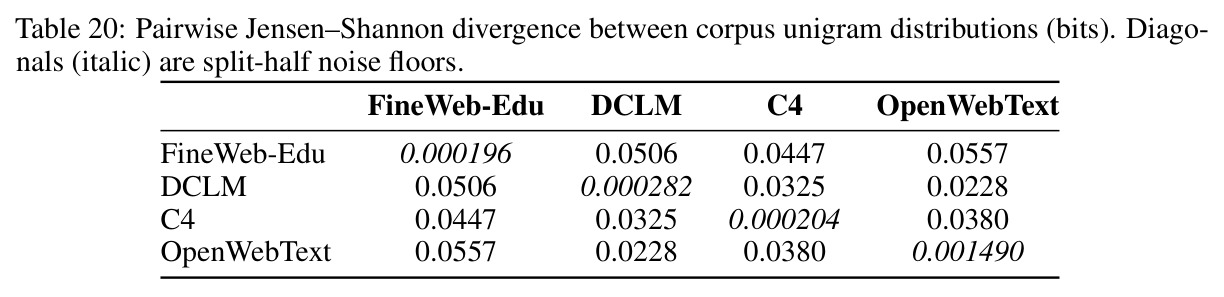
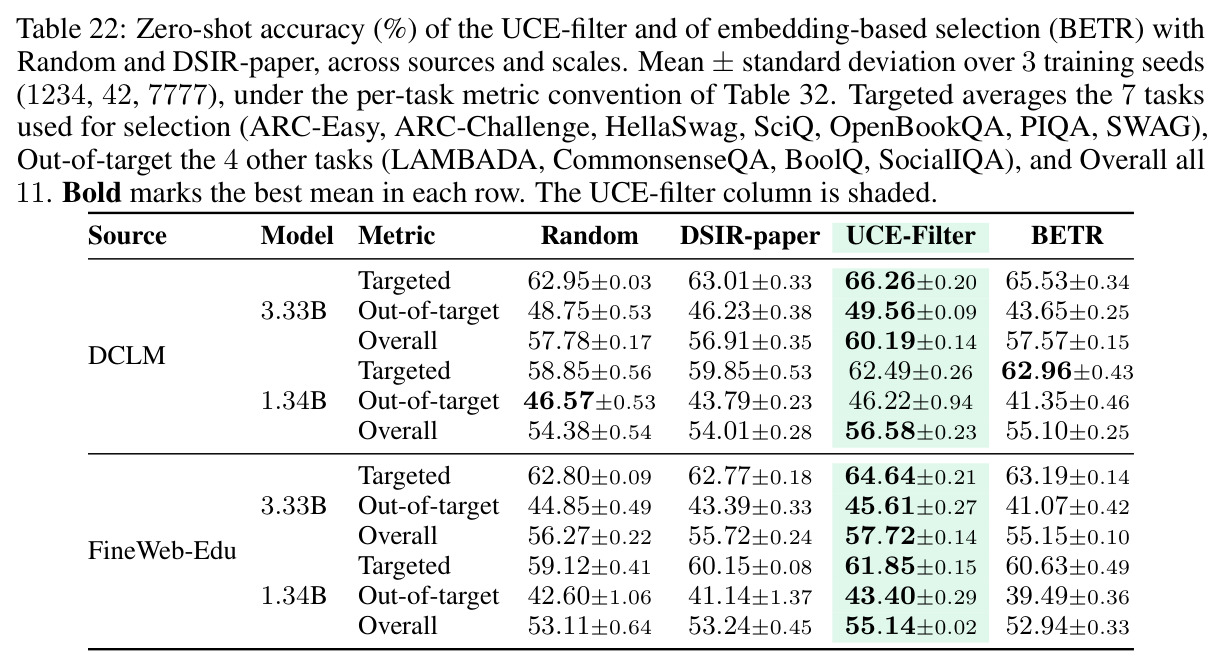
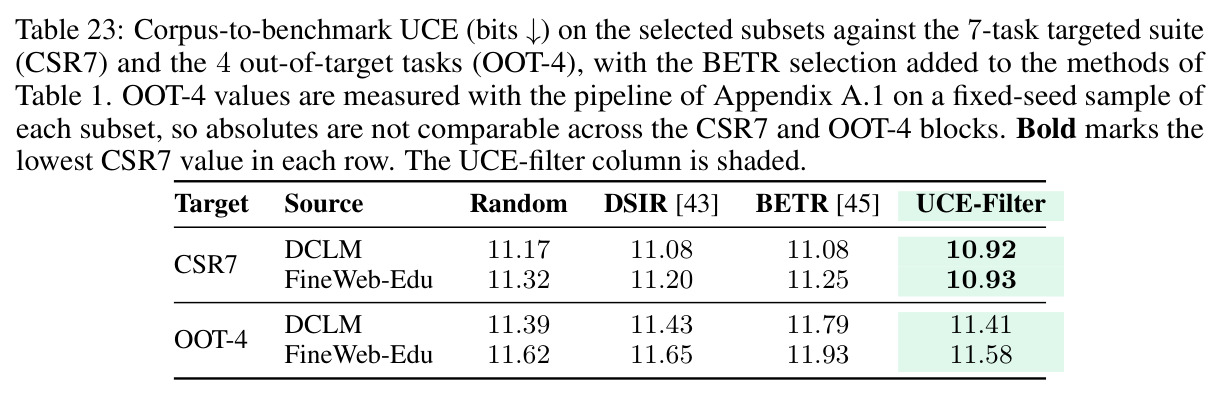
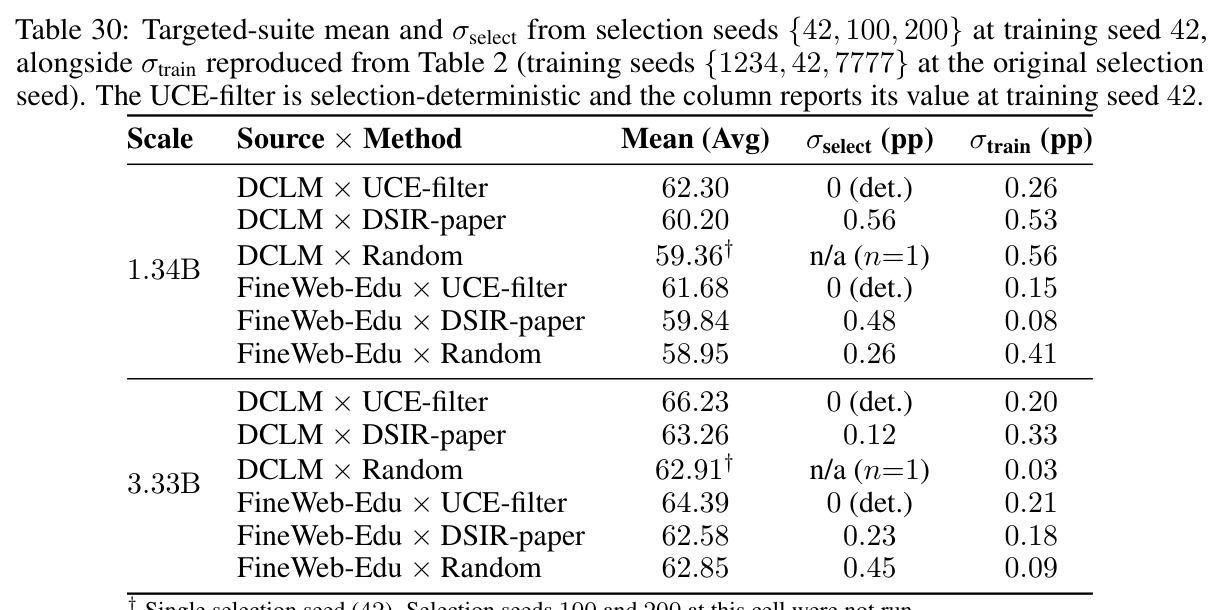
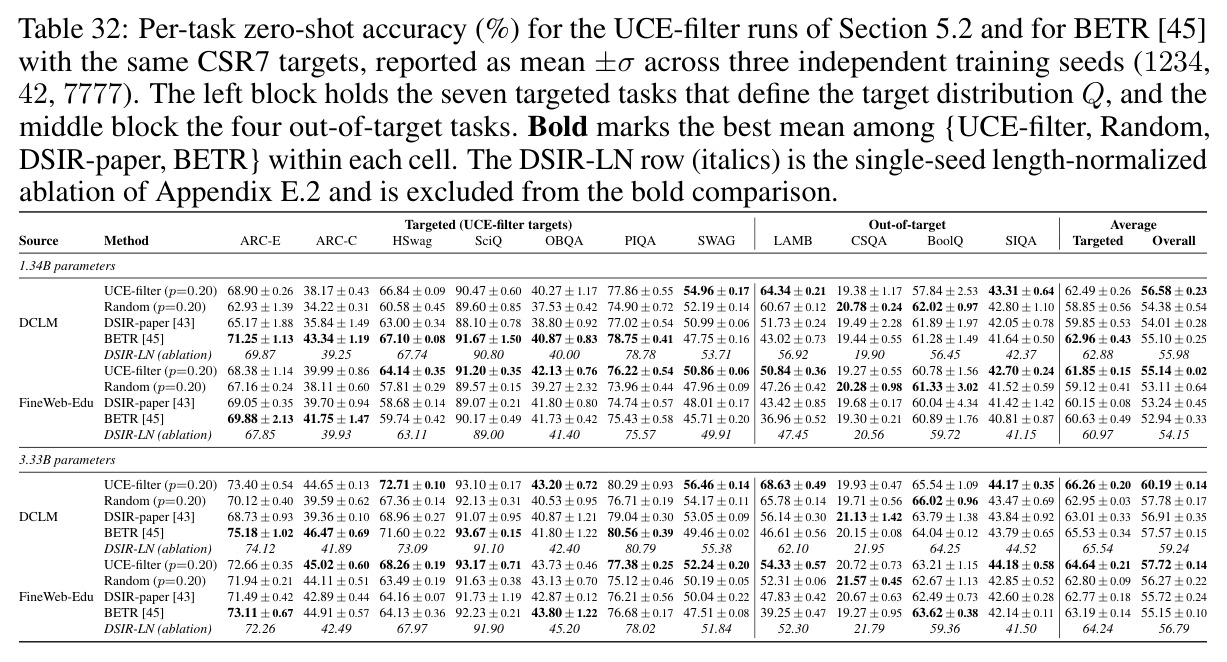
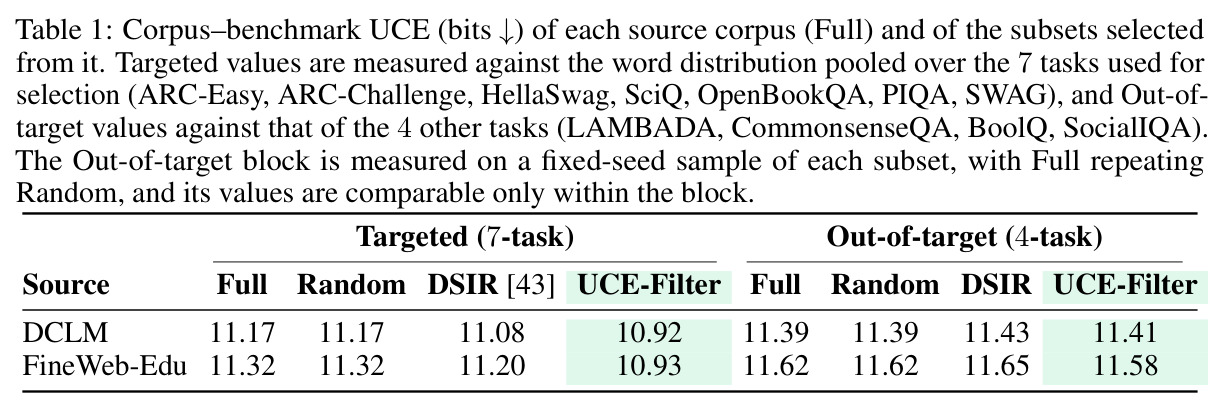
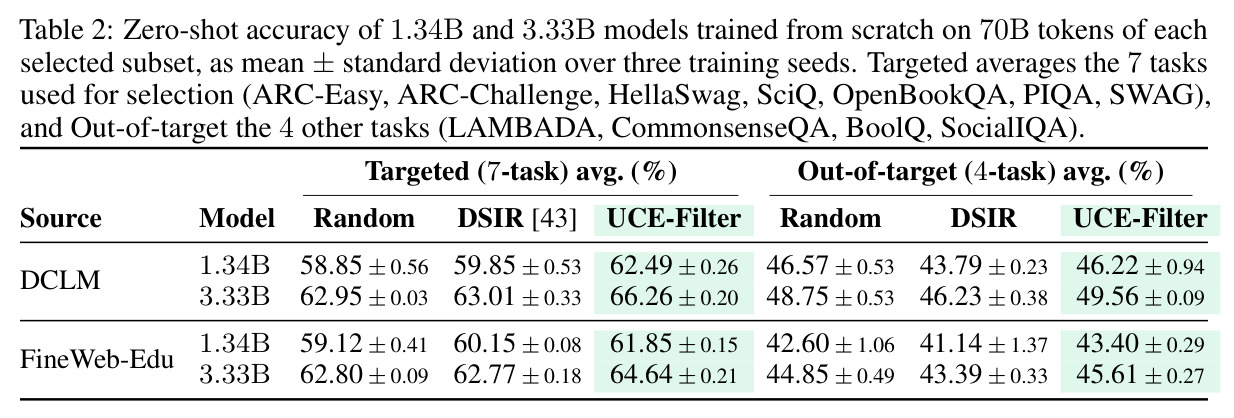
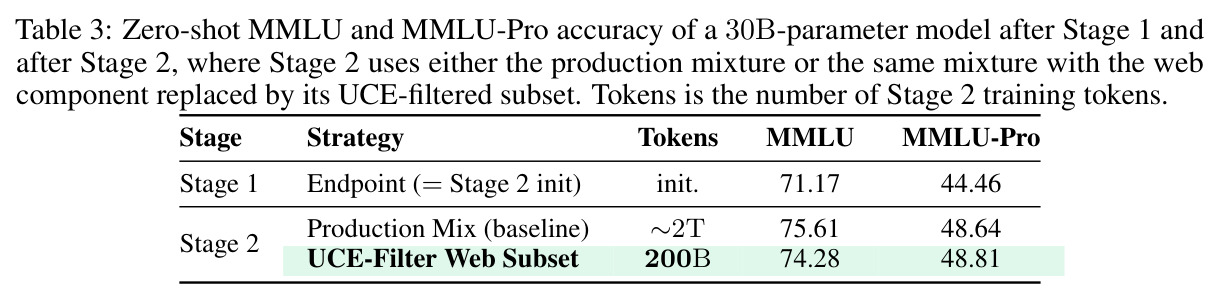
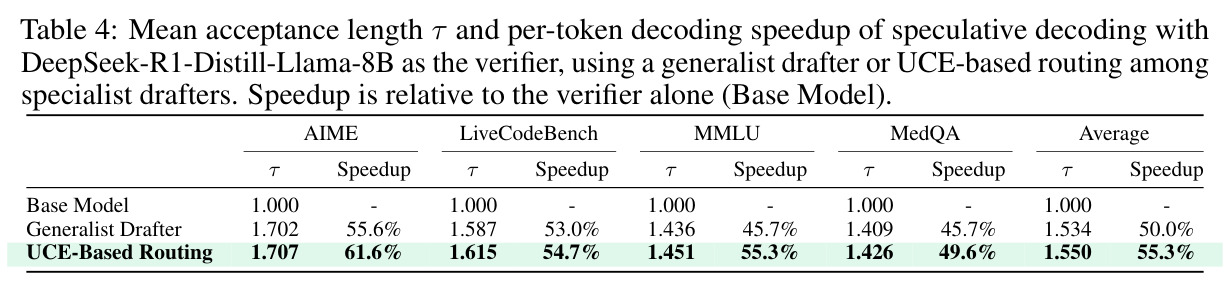
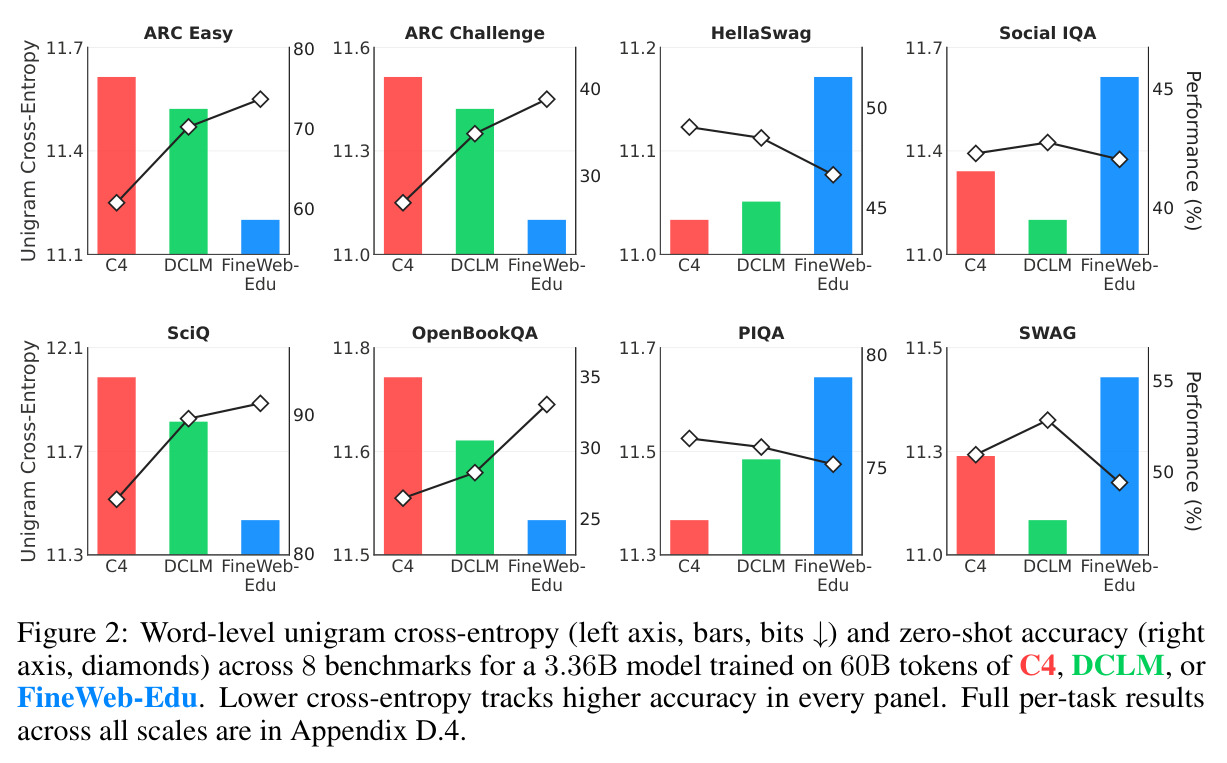
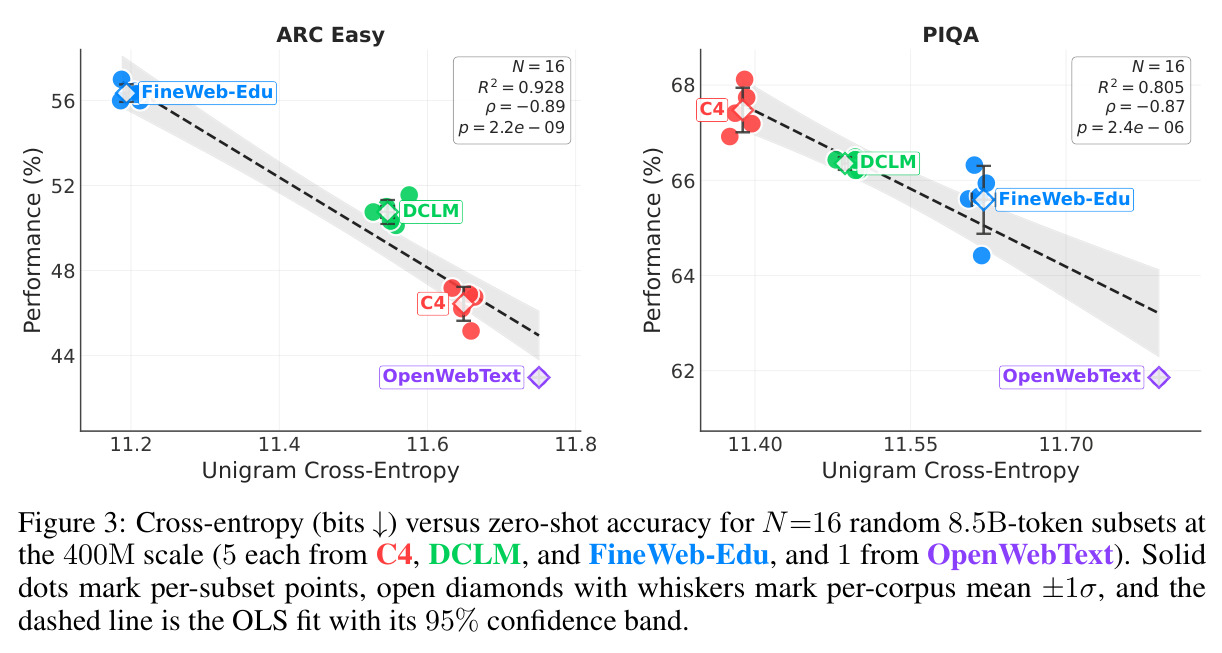
语料级观察(第 4 节):3.36B/60B token 下,UCE 在图 2 展示的全部 8 个基准上复现三语料的准确率排序——FineWeb-Edu 在知识型任务(ARC Easy/Challenge、SciQ、OpenBookQA)UCE 最低且准确率最高,DCLM 在 SocialIQA/SWAG 领先;而在 HellaSwag/PIQA 上 DCLM 与 FineWeb-Edu 的 UCE 高于 C4、准确率也落后,说明任务级词汇重叠比"数据质量声誉"更能解释表现;该逆相关在 10 基准 × 3 规模上全部成立。随机子集稳定性:16 个 8.5B 子集 × 400M 的实验中 UCE-准确率负相关稳健,ARC Easy $R^2=0.928$($p=2.2\times10^{-9}$),PIQA $R^2=0.805$($p=2.4\times10^{-6}$)。文档级干预(第 5 节):UCE-filter 把 DCLM 目标套件 UCE 从 11.17 降到 10.92(DSIR 仅到 11.08),FineWeb-Edu 从 11.32 降到 10.93(DSIR 11.20),且带外 UCE 几乎不变;目标套件准确率上,DCLM@3.33B 从 62.95%(随机)升到 66.26%(+3.31pp),DSIR 仅 63.01%;FineWeb-Edu@3.33B 从 62.80% 到 64.64%(+1.84pp);带外 OOT-4 上 UCE-filter 与随机持平(DCLM@3.33B 49.56 vs 48.75)而 DSIR 掉到 46.23,证明增益特异于目标而非普遍提升。30B 生产案例(第 5.3 节):200B token 的 UCE-filtered web 子集把 MMLU 从 71.17 提到 74.28、MMLU-Pro 从 44.46 提到 48.81(超过 2T token 生产混合的 48.64),以约 1/10 token 保留大部分 Stage-2 增益。Prompt 级路由(第 6 节):UCE 路由相对 generalist drafter 平均加速从 50.0% 提到 55.3%($\tau$ 从 1.534 到 1.550),四个基准全线提升,包括没有专家覆盖的 MMLU(45.7%→55.3%)与 MedQA(45.7%→49.6%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语料级排序(3.36B/60B token,8 个零样本基准) | UCE 排序与准确率排序的一致性 | UCE 在全部基准复现准确率排序;FineWeb-Edu/DCLM 在 6/8 基准 UCE 最低且准确率最高 | C4(上一代高质量语料) | 定性完全一致,且在 10 基准 × 3 规模上均成立 |
| 随机子集稳定性(400M/8.5B token,N=16) | UCE-准确率决定系数 $R^2$ | ARC Easy 0.928;PIQA 0.805 | —(相关性检验,无基线) | p 值分别为 2.2e-09 与 2.4e-06 |
| UCE-filter 数据选择(DCLM 3.33B,CSR7 目标套件) | 零样本准确率 (%) | 66.26 ± 0.20 | 随机 62.95 ± 0.03;DSIR 63.01 ± 0.33 | +3.31pp(对随机);带外 OOT-4 49.56 vs 随机 48.75,增益特异于目标 |
| UCE-filter 数据选择(FineWeb-Edu 3.33B,CSR7) | 零样本准确率 (%) | 64.64 ± 0.21 | 随机 62.80 ± 0.09;DSIR 62.77 ± 0.18 | +1.84pp(对随机) |
| 30B 模型 Stage-2 生产案例 | MMLU / MMLU-Pro (%) | 74.28 / 48.81(仅 200B token) | 生产混合 75.61 / 48.64(约 2T token);起点 71.17 / 44.46 | MMLU-Pro +0.17pp 且只用约 1/10 token;MMLU 差 1.33pp(保留大部分增益) |
| 投机解码 drafter 路由(验证器 DeepSeek-R1-Distill-Llama-8B) | 平均每 token 加速比 (%) | 55.3(UCE 路由,τ=1.550) | generalist drafter 50.0(τ=1.534) | +5.3pp,AIME/LiveCodeBench/MMLU/MedQA 四基准全线提升 |
局限与改进
作者明确承认的:UCE 只度量词边际分布,对句法、多 token 组合、事实共现全盲,最好理解为分布对齐的下界代理而非语料质量的充分刻画;它无法排序语法(BLiMP)、算术(MathQA)与非英语能力——附录 D.7 显示 Global-PIQA 上法语/西班牙语 UCE 更低(19.8/20.9 比特)但准确率(46/50)反而低于德语(UCE 22.5、58 分),跨语言场景信号反向;空白切词使它不直接适用于中文、日语等非分词文字和黏着语;跨语料比较只是关联性的,策展与体裁混杂;选择增益是"已知目标下的上界"而非对未见目标的零样本泛化($Q$ 由目标任务估计);13-gram 审计不排除 SciQ 与 MMLU 上 FineWeb-Edu 的贡献(其匹配率 4.91% 与 1.39% 均为四语料最高且分数也最高);去污后重训只覆盖 DCLM@1.34B;词汇印记是否穿过 SFT/RLHF 未检验。我的观察:真实应用场景往往没有目标任务文本可估计 $Q$,UCE-filter 更接近 oracle 上界而非即插即用的选择器;单一标量会把"任务重叠"与"策展质量"两个正交维度压扁(C4 在 HellaSwag/PIQA 上的反超即为例证);30B 案例是单点实验无种子重复;投机解码中 MMLU 加速跃升 9.6pp 的机制未被拆解,可能混入 drafter 对通用文本的一般匹配效应。
独立分析的弱点
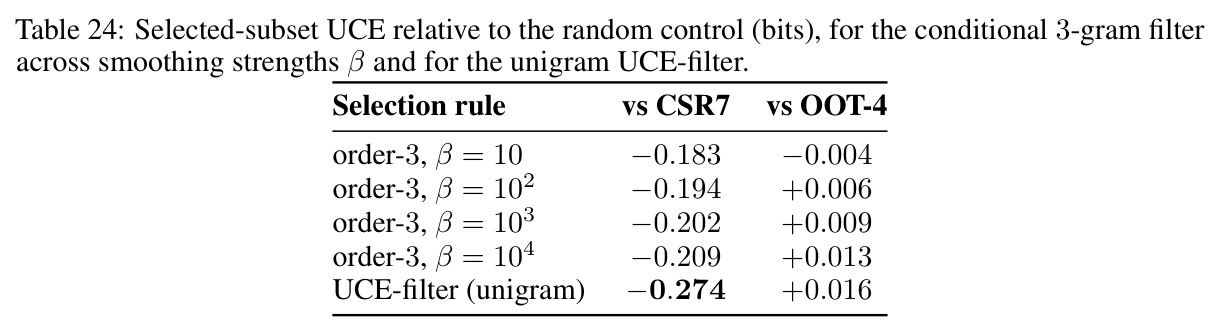
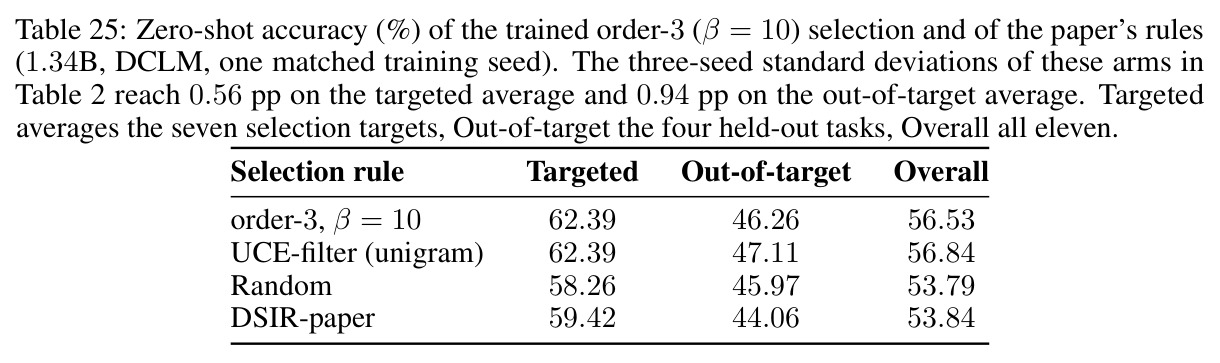
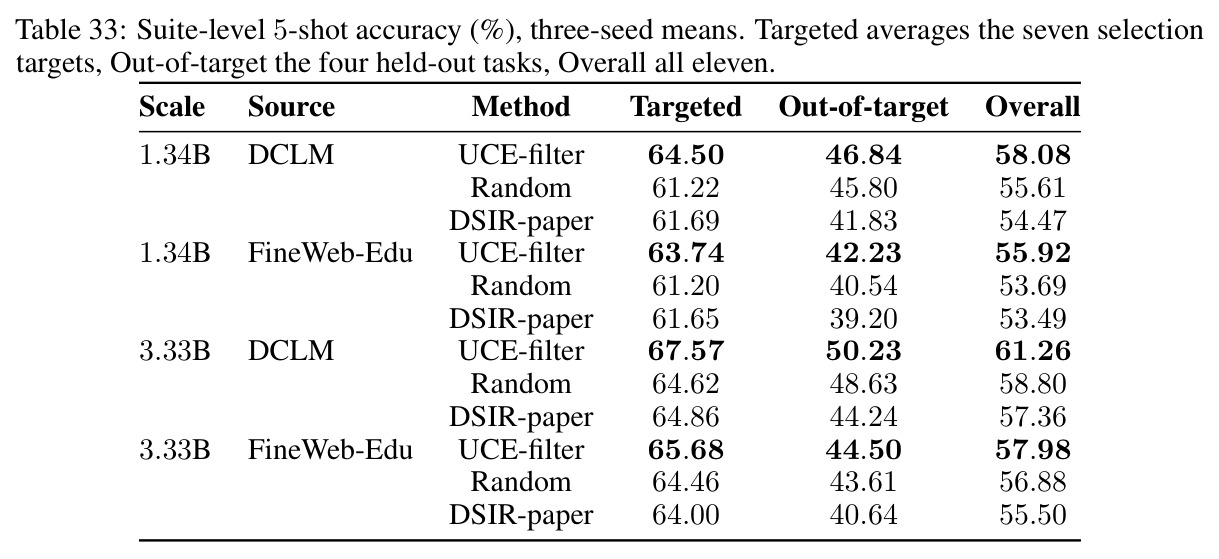
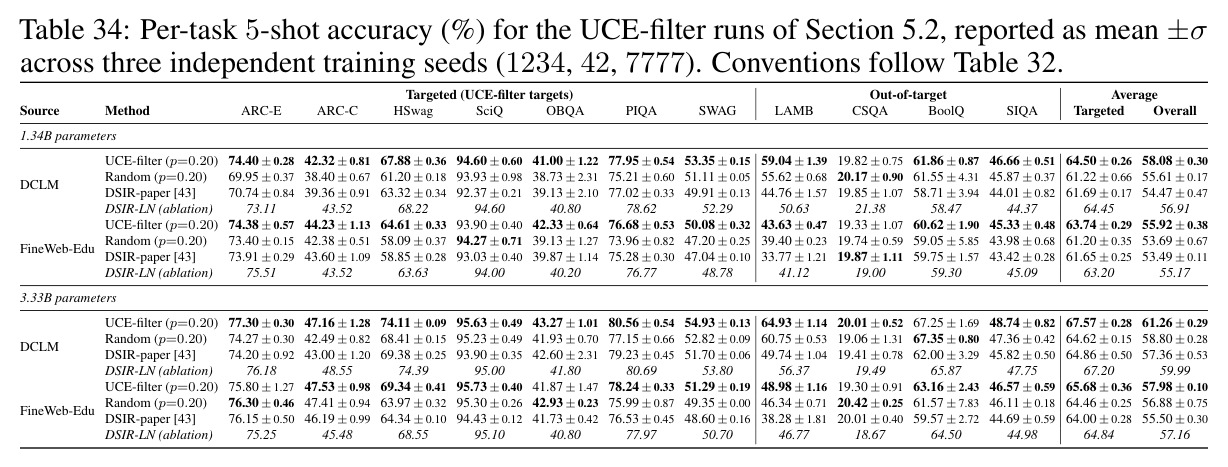
第一,依赖目标分布 $Q$:需要预先知道目标任务文本才能定义对齐,这限制了它在"无指定目标"场景的使用,也使选择增益只能解释为上界;改进方向是用任务簇聚类或多目标联合分布替代单点 $Q$,把 UCE-filter 推广为多域帕累托选择。第二,一元统计丢弃条件结构:对句法敏感任务与多 token 组合无解释力;可加入廉价的二阶修正,如词级 bigram 的截断估计或字符 n-gram 混合——作者在附录 E.4 试过条件 3-gram 变体但主结果未采用,说明其附加价值尚不确定。第三,跨语言失效:非分词语言需要替换单元(字或子词级一元分布)并重新验证理论。第四,只覆盖零样本似然评估:对生成式评估与 SFT/RLHF 后的行为是否保留印记未知;虽然附录 G.1 的 5-shot 检查给出正向信号(UCE-filter 在每个单元格的 Targeted 与带外均值都最高),但仍需针对新目标的控制实验。第五,保留 20% 意味着丢弃 80% 语料,长尾知识与多样性可能受损——30B 案例中 MMLU 低于生产混合 1.33pp 是直接证据;改进方向是与其他选择准则混合、按预算调保留率(附录有保留率扫描)或引入课程式分阶段对齐。
未来方向
作者提出的方向:设计 paraphrase 协议,检验观察到的关系在多大程度上依赖精确词汇实现而非语义等价;做词表分解,把 UCE 限制在基准特征词上以提升特异度;把词汇印记研究延伸到 SFT/RLHF——那些阶段的数据量、训练目标与度量方式都不同,需要专门的控制实验;构造同时变化预训练数据其他属性的实验设计,给出泛化的更一般解释。基于其成果可延伸的:用 UCE 做多目标任务混合的自动配比优化,把行级 $\Delta H$ 推广为对多个 $Q$ 的联合目标;把 prompt 级路由扩展为 drafter 池的在线自适应更新;用语料间成对 UCE 做模型谱系与训练数据归属的指纹分析;把 $\Delta H$ 用作课程学习信号,按对齐度排序训练数据;将 UCE 与 embedding 相似度选择器(如文中对比过的 BETR)融合,兼取词级对齐的精确性与语义对齐的泛化性;以及把 UCE 作为污染检测的补充信号,在概率质量层面而非精确匹配层面审计语料-评测接口。
复现评估
复现条件较好。代码已开源(github.com/penpaperkeycode/lexical-imprint),提供 UCE、UCE-filter、DSIR 基线与基准预处理管线的参考实现;Algorithm 1 给出完整伪代码,附录 A.1 给出切词、零计数平滑 $\tilde{P}(w)=\max\{c(w),1\}/(T+B)$ 等全部实现细节,附录 C 给出两套实验的完整训练配置(优化器、学习率调度、batch、序列长、精度)。所有数据公开:C4、DCLM、FineWeb-Edu、OpenWebText、OpenThoughts-114k 及 12 个基准;DSIR 用官方实现忠实复现。UCE 计算本身只需词频计数,CPU 上两遍扫描即可在数十亿行语料上并行完成,测量部分几乎零门槛。成本主要在从零预训练:语料级网格为 3 规模 × 4 语料 × 多子集(单次 400M/8.5B 运行约 8 卡即可),选择实验为 2×2×3 种子各 70B token,再加 30B Stage-2 案例与 drafter 训练,总计数百 GPU 天量级。综合评估:测量部分极易复现,干预部分对学术实验室需可观但可行的算力;30B 案例是工业设定,只能部分复现。
论文图表