JoVox:面向轻量体素生成的联合层级流匹配 JoVox: Joint Hierarchical Flow Matching for Lightweight Voxel Generation
联合层级流匹配让细层参与决定粗层,8倍训练吞吐且1/15 FLOPs超越SOTA
前置知识
体素层级与八叉树表示
把 3D 空间逐级加密的树状网格:level $l$ 是 $(4\cdot 2^l)^3$ 的网格,每个 cell 含 8 个子 cell,只有形状表面穿过的 cell 被标记为「占用」并继续细化。这样空域无需存储和计算,开销只与表面积相关。本文用 $L=4$ 得到 $64^3$、$L=6$ 得到 $256^3$ 的占用表示,$O_l$ 表示第 $l$ 层占用 cell 的集合。
JoVox 的「轻量」完全建立在层级稀疏性上,它学习的联合分布对象正是这套层级中的占用集合 $O_0,\ldots,O_L$。
掩码离散流匹配
离散数据的生成范式:源分布是全掩码张量 $x_0=(\emptyset,\ldots,\emptyset)$,数据 $x_1$ 的每个 entry 以概率 $t$ 保留、否则被掩码,构成插值路径 $p_{t|1}(x_t|x_1)=\prod_i[t\,\delta(x_i^t,x_i^1)+(1-t)\,\delta(x_i^t,\emptyset)]$;网络逐步预测被掩码 entry 的分布并 unmask。损失为掩码 entry 的交叉熵加未掩码 entry 的 $1-p$,整体以 $1/(1-t)$ 加权。
本文的训练目标、unmask 推理与重掩策略全部是对这一基础公式的层级化扩展,不掌握它就读不懂第 3、4 节。
占用码(occupancy code)
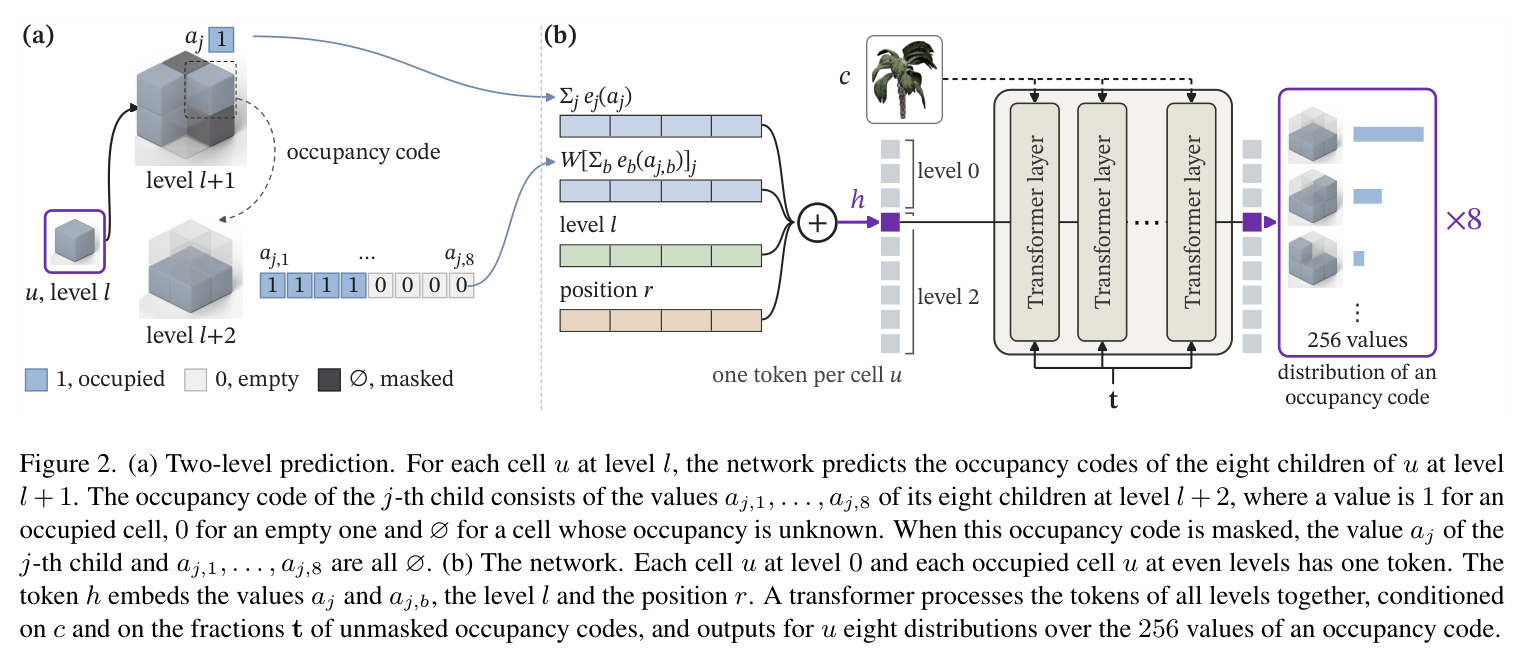
一个父 cell 的 8 个子 cell 各占/空一位,拼成 8-bit 编码,共 $2^8=256$ 种取值。层级模型以它为预测单元:网络对每个 cell 输出其子 cell 的占用码,即可一次确定下一层 8 个 cell 的去留。本文进一步把隔一级的 64 个 cell 的占用拆成 8 个占用码,把取值空间从 $2^{64}$ 降到 $8\times 256$。
占用码是「两层预测」得以可行的关键参数化,直接决定了网络的输入输出形式。
Chamfer 距离与体素/网格指标
两组点云之间互相最近邻距离的统计量,衡量几何误差。本文用它比较生成体素中心(CDV)与网格外表面(CDshell),配合体素 IoU(重叠率)以及渲染结果上的 LPIPS、DINOv2 相似度(感知质量)。距离类指标越低越好,IoU 与相似度越高越好。
图像条件实验与效率对比的主指标就是 CDV/CDshell,「11% 更低 CD」等核心结论均基于它们。
生成分布指标 1-NNA / COV / MMD / FID
无条件生成没有一一对应的真值,因此比较生成集合与参考集合的分布距离:1-NNA 用 1-近邻分类器的误判率(越接近 0.5 越好),COV 衡量参考集被覆盖的比例(多样性),MMD 是最小匹配距离(保真度),FID 在特征空间计算分布距离(FIDV 用 PointNet++ 点云特征,FIDVD/KIDVD 用体素渲染图的 DINOv2 特征)。
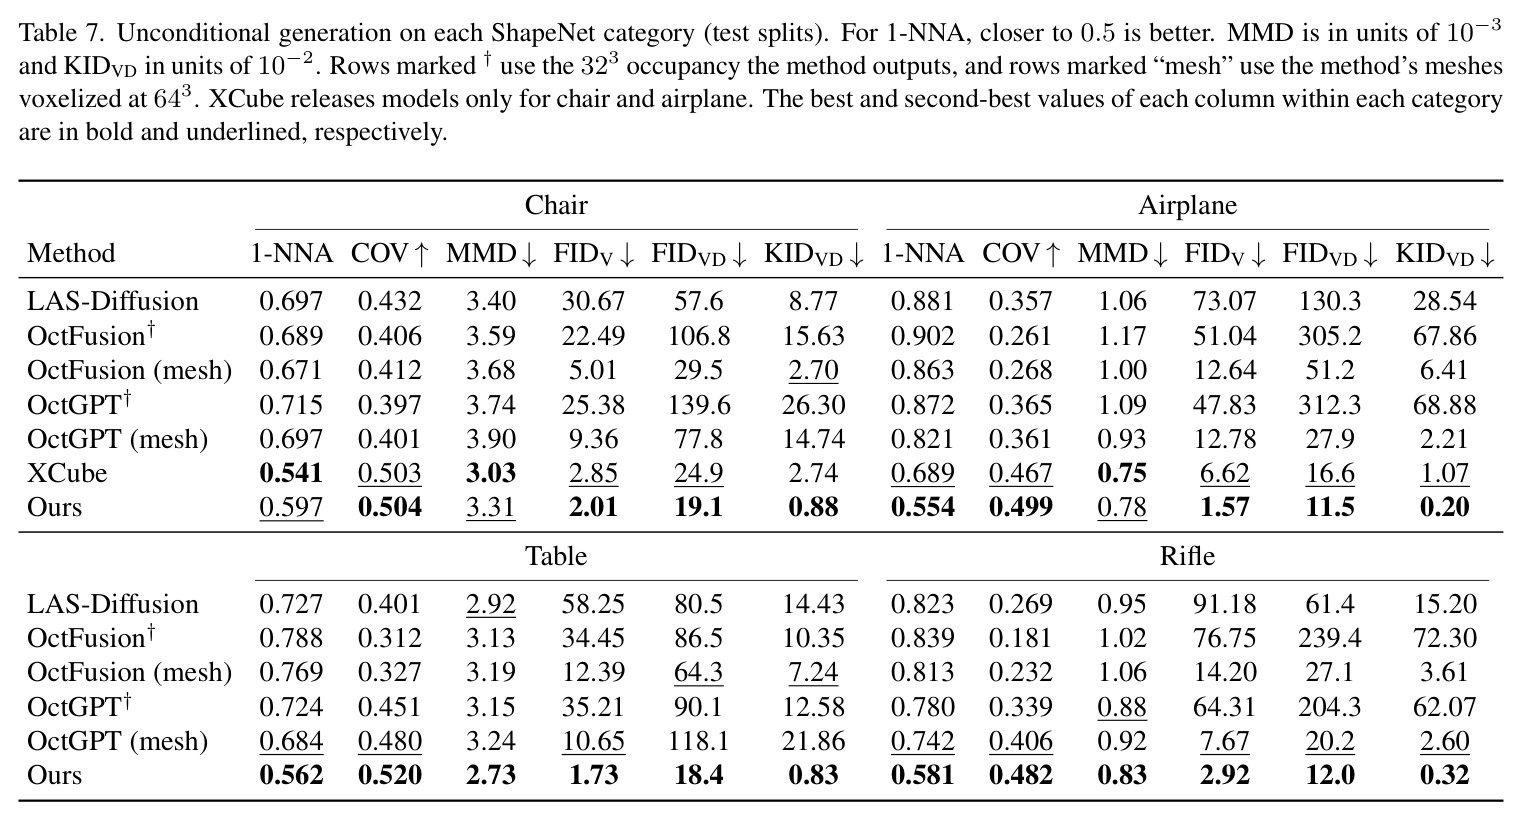
无条件实验(Table 3、Table 7)的全部结论都用这套指标陈述,例如 FIDV 2.06、1-NNA 0.574。
研究动机
体素生成有两条主流路线,各有硬伤。潜在方法(TRELLIS、TRELLIS.2)先用自编码器把体素压缩成紧凑潜在网格再生成,保真度高,但自编码器是额外要训练的模型,且生成器仍要处理潜在网格的每一个 cell——包括大量空域,训练成本极高(TRELLIS.2 用 32 张 H100)。层级方法(XCube、Nexus、OctFusion、Octree Transformer、OctGPT)先生成粗网格再逐级细化占用 cell,保持了体素的轻量本性,但概率上把联合分布因式分解为 $p(O_0\mid c)\prod_{l=1}^{L}p(O_l\mid O_{l-1},c)$:决定所有细层命运的粗层恰恰是用最少的形状信息生成的,且生成后从不回头修正,因此粗层「看似合理但常常错误」,细层只能继承这些错误。此外逐级方法代价结构也不理想:Octree Transformer 逐 cell 自回归导致前向次数随 cell 数增长,OctGPT 虽用掩码并行却每层需要多步、且层内决策彼此独立。
本文的目标是本文要让体素生成同时做到高保真、轻量、训练便宜。具体而言:学习所有层级的联合分布 $p(O_0,\ldots,O_L\mid c)$,使粗 cell 能参考邻近已生成的细 cell 再做决定;不使用自编码器,网络只处理占用区域的 cell,使训练开销随实际形状而非整个网格的立方增长;在无条件与图像条件两个任务上全面超越基线。作者给出的对标非常具体:与 SOTA 方法 TRELLIS.2 使用相同 backbone 时,训练吞吐提升 8 倍、单次前向 FLOPs 降到 1/15、训练 GPU 从 32 张 H100 降到 4 张,同时在 Toys4k 上取得 11% 更低的体素 Chamfer 距离(0.01107 vs 0.01250)。
与已有工作不同的是,所有已有层级方法都默认同一个假设:层级必须逐级条件生成,粗层一旦定下便不可更改。本文抓住的被忽视切入点是「联合分布」:掩码离散流匹配天然允许在任意层级 unmask cell,因此可以让某些细 cell 先于粗 cell 生成,粗 cell 在附近已有细结构可参考时才被预测。另一个被忽视的点是「决策信息的时效性」:同一步内被 unmask 的 token 是彼此独立采样的,可能互相不一致,而已有的重掩工作(ReMDM、MaskGIT、Halton scheduler 等)按置信度或随机选择重掩对象;本文观察到真正该重掩的是「最旧」的决策——它们是在周围细 cell 最少时做出的,据此提出按 unmask 时间排序的重掩策略,这是与所有已有 sampler 的本质差异。
核心方法
直觉上,层级生成像画素描:先勾轮廓(粗层)再细化(细层),但轮廓一旦画错,后续细化全部报废。JoVox 的做法是允许在细化过程中回头修改轮廓——画了几个细节之后,你对轮廓哪里出错会看得更清楚。技术上,JoVox 构建在掩码离散流匹配之上:数据样本 $x_1$ 是各层 occupancy codes 的集合,源分布 $x_0$ 是全掩码张量,中间态 $x_t$ 按每层独立的保留概率 $t_l$ 混合掩码与真实值;网络预测每个掩码 entry 在词表上的分布,每步随机 unmask 一部分。关键扩展是让层级随 unmask 生长——某 cell 被判定占用后,其子 cell 的掩码码元才加入序列,于是任意层级的码元都可能成为「未来信息」,粗 cell 因此能参考已生成的细 cell。在此框架上再加两项设计:两层预测一次输出隔一级的 64 个 cell 的占用(处理层数减半),以及按时间回滚最旧决策的重掩策略。网络是 1.54B 参数的 transformer,图像条件经冻结的 DINOv3 ViT-L/16 通过 cross-attention 注入。
核心创新有三层。第一,联合层级建模:不同于逐级方法的因式分解 $p(O_0\mid c)\prod_l p(O_l\mid O_{l-1},c)$,JoVox 直接对 $p(O_0,\ldots,O_L\mid c)$ 用掩码流匹配建模;训练时每层独立采 $t_l=v^2,\; v\sim\mathcal{U}(0,1)$,网络见过任意层级组合的中间态,推理时无论按什么顺序 unmask 都落在训练分布内——这是细层能参与决定粗层的机制基础。第二,两层预测:把隔一级 64 个 cell 的占用拆成 8 个 8-bit occupancy codes(直接编码将是 $2^{64}$,不可行),网络对每个 cell 输出 8 个 256 值上的分布,从而只需处理偶数层的 cell,层数减半:单步训练 8.96s→4.03s(2.2 倍加速),保真度还更高。第三,按时间的重掩策略:每步先把该层「最旧」的已 unmask 码元重掩回 $\kappa_l(k-1)$,让早期低信息决策在细结构出现后得到修正,同时纠正同批独立采样的不一致——这是对 masked diffusion 不一致问题的新解法。
方法步骤详情
流程分四步。(1)数据表示:形状用 $L$ 层占用(主实验 $L=4$ 得 $64^3$),level $l$ 网格 $(4\cdot 2^l)^3$;每个偶数层 cell(level 0 全部、高层仅占用的)一个 token,entry 为其 8 个子 cell 的 8-bit occupancy codes,掩码时内部值一并置 $\emptyset$。(2)编码与网络:$h=[e_j(a_j)+W_h\sum_b e_b(a_{j,b})]_{j=1}^{8}+\mathrm{emb}_{level}(l)+\mathrm{emb}_{pos}(r)$,$e$ 为 $\{0,1,\emptyset\}$ 可学习嵌入;30 层、宽 1536、12 头 transformer,图像 DINOv3 特征经 cross-attention、各级 $t_l$ 嵌入之和经 adaLN 注入。(3)训练:各层独立采 $t_l$,损失层内平均再对层平均、权重 $1/(1-t_l)$,偏采小 $t_l$;AdamW、学习率 $10^{-4}$、batch 256、EMA、条件丢弃 0.1、色彩抖动与 $90^\circ$ 旋转增强。(4)推理:按 $\kappa_l(k)=\min(k/N_l,1)^\rho$($N=72$、$N_f=8$、$N_1=0.8N$、$\rho=2$、$\tau=0$、CFG 1.5,共 80 步)每步三件事——先把该层最旧码元重掩回 $\kappa_l(k-1)$,再以当前 unmask 比例为 $t_l$ 预测全部掩码码元,然后随机 unmask 到 $\kappa_l(k+1)$;末尾 $N_f$ 个额外步不重掩地均匀 unmask。
技术新颖性
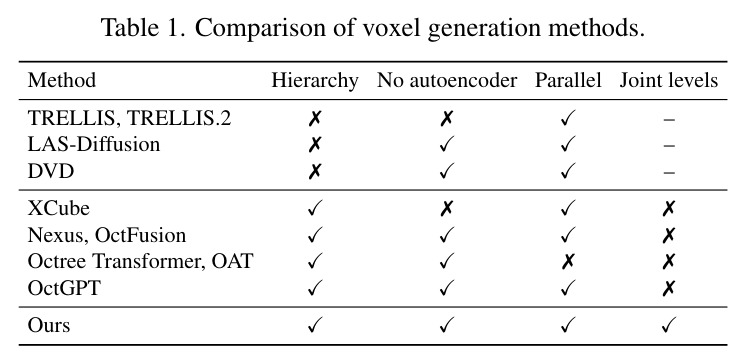
与最近邻工作的具体差异:OctGPT 也用掩码并行生成,但每层独立决策、每层需多步,粗层仍只用更粗层信息;JoVox 跨层联合且在单一 token 序列中完成。MDLM 不重掩;ReMDM/ReMDM-conf 按随机或置信度重掩;MaskGIT 按置信度顺序 unmask——它们都不看决策时间,本文按「何时被决定」重掩最旧码元,直击早期决策信息最少的根因。TRELLIS.2 依赖自编码器并处理全部潜在 cell;JoVox 无自编码器、只处理占用 cell:训练态平均只有 $27^3$ 个 cell 带 token(完整形状 579 个),而 TRELLIS.2 要处理 $16^3$ 潜在网格全部 4096 个 cell。两层预测则把逐级方法的层数减半。Table 1 显示本文是唯一同时满足「层级、无自编码器、并行、联合层级」四项的方法,属于首个把隔层联合预测与跨层联合分布结合的体素生成框架。
实验结果
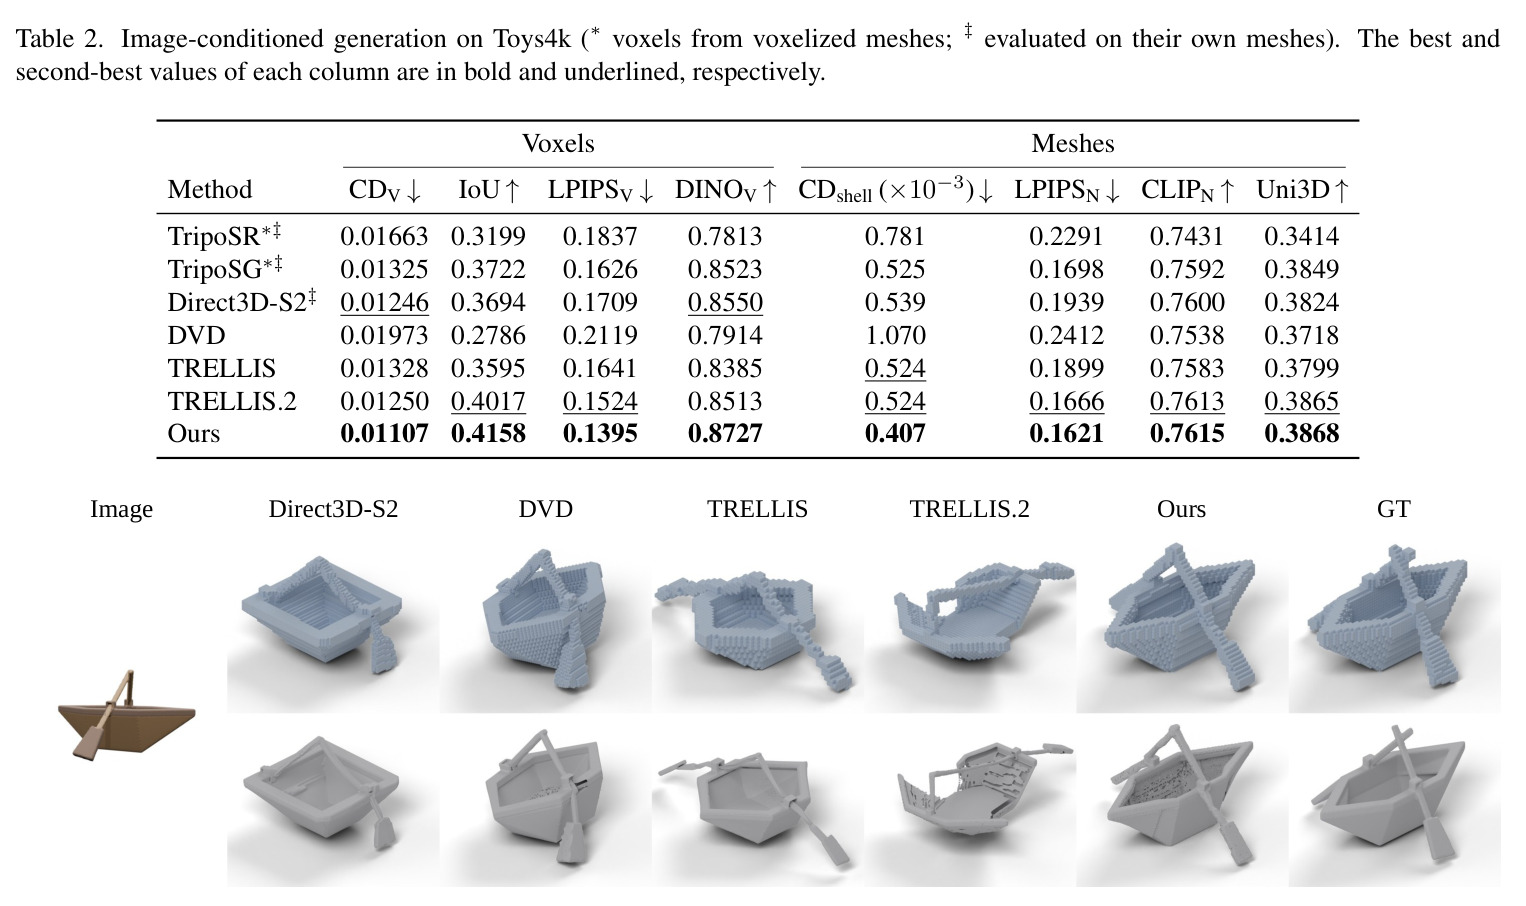
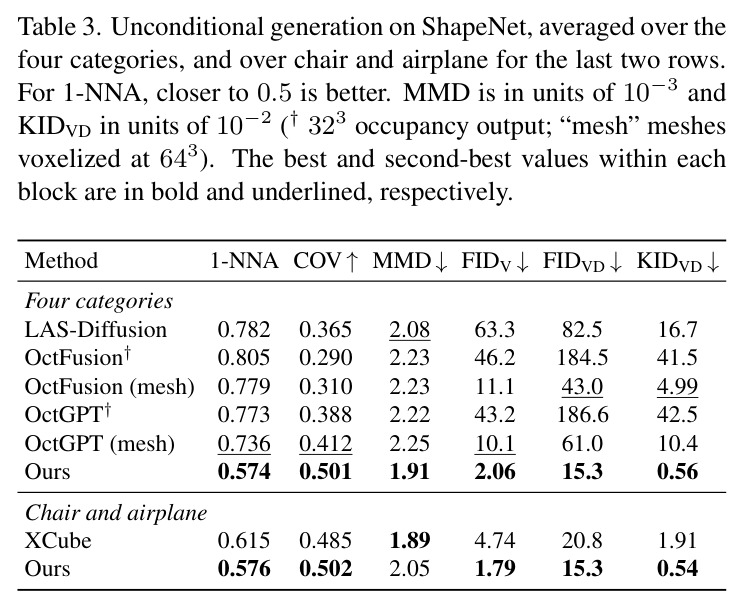
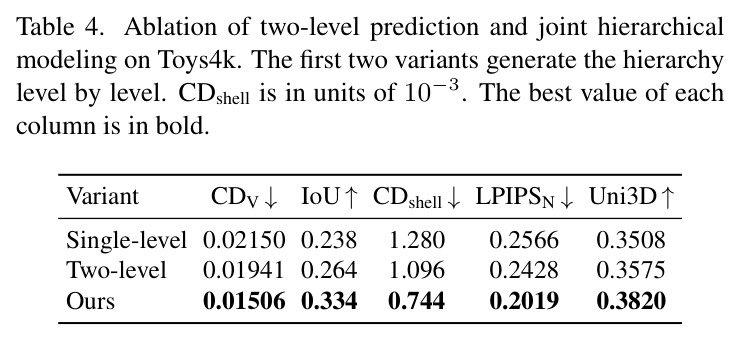
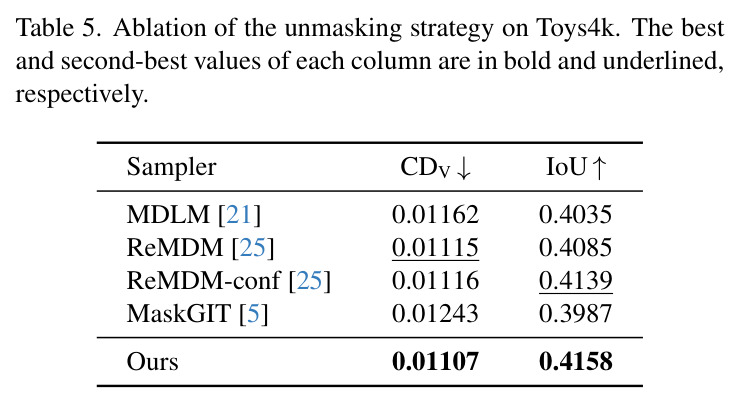
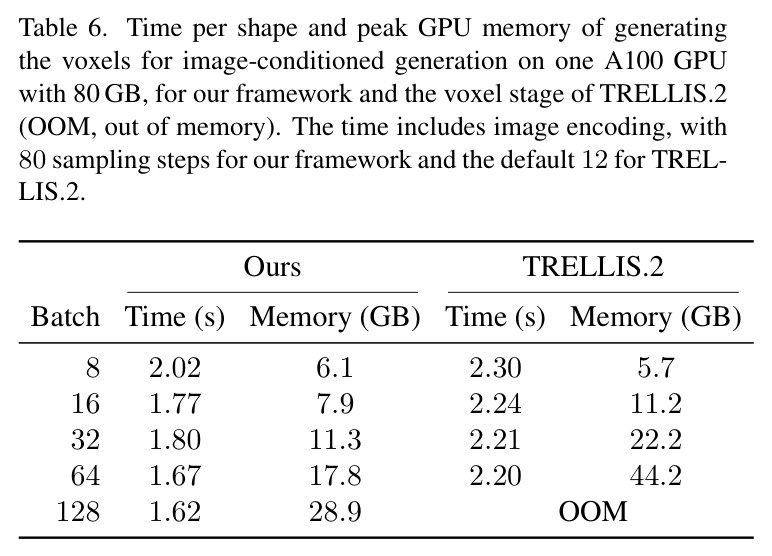
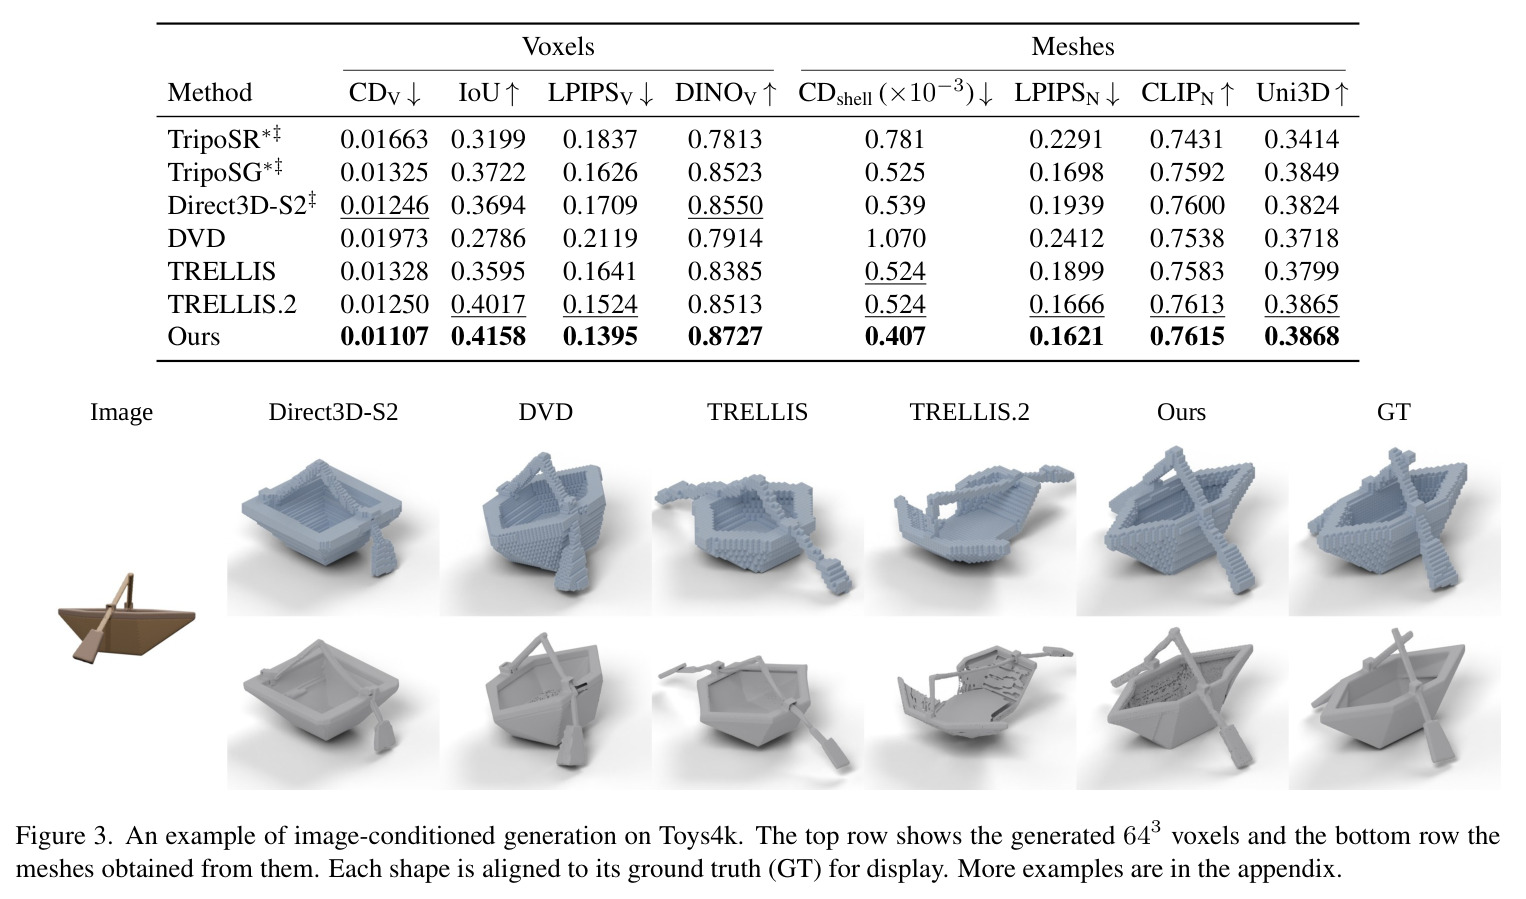
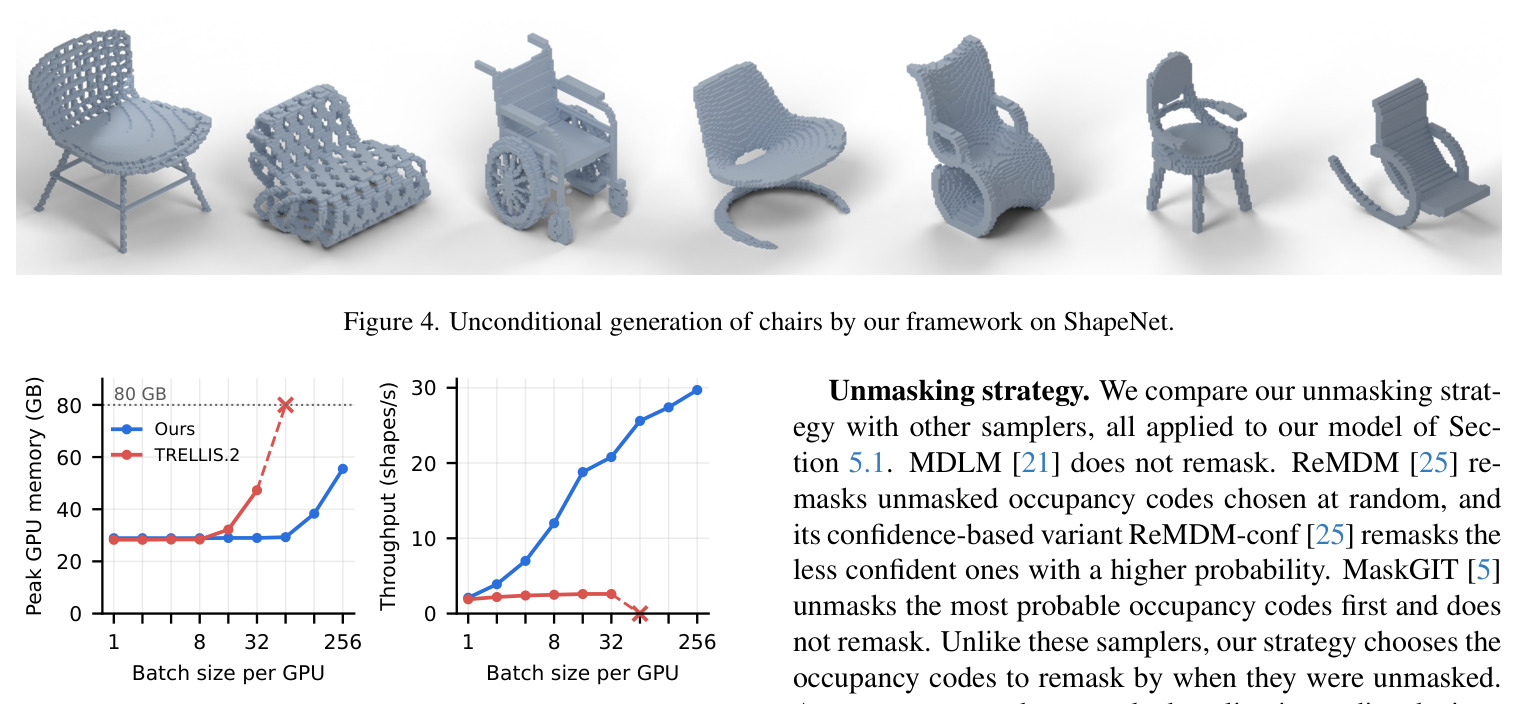
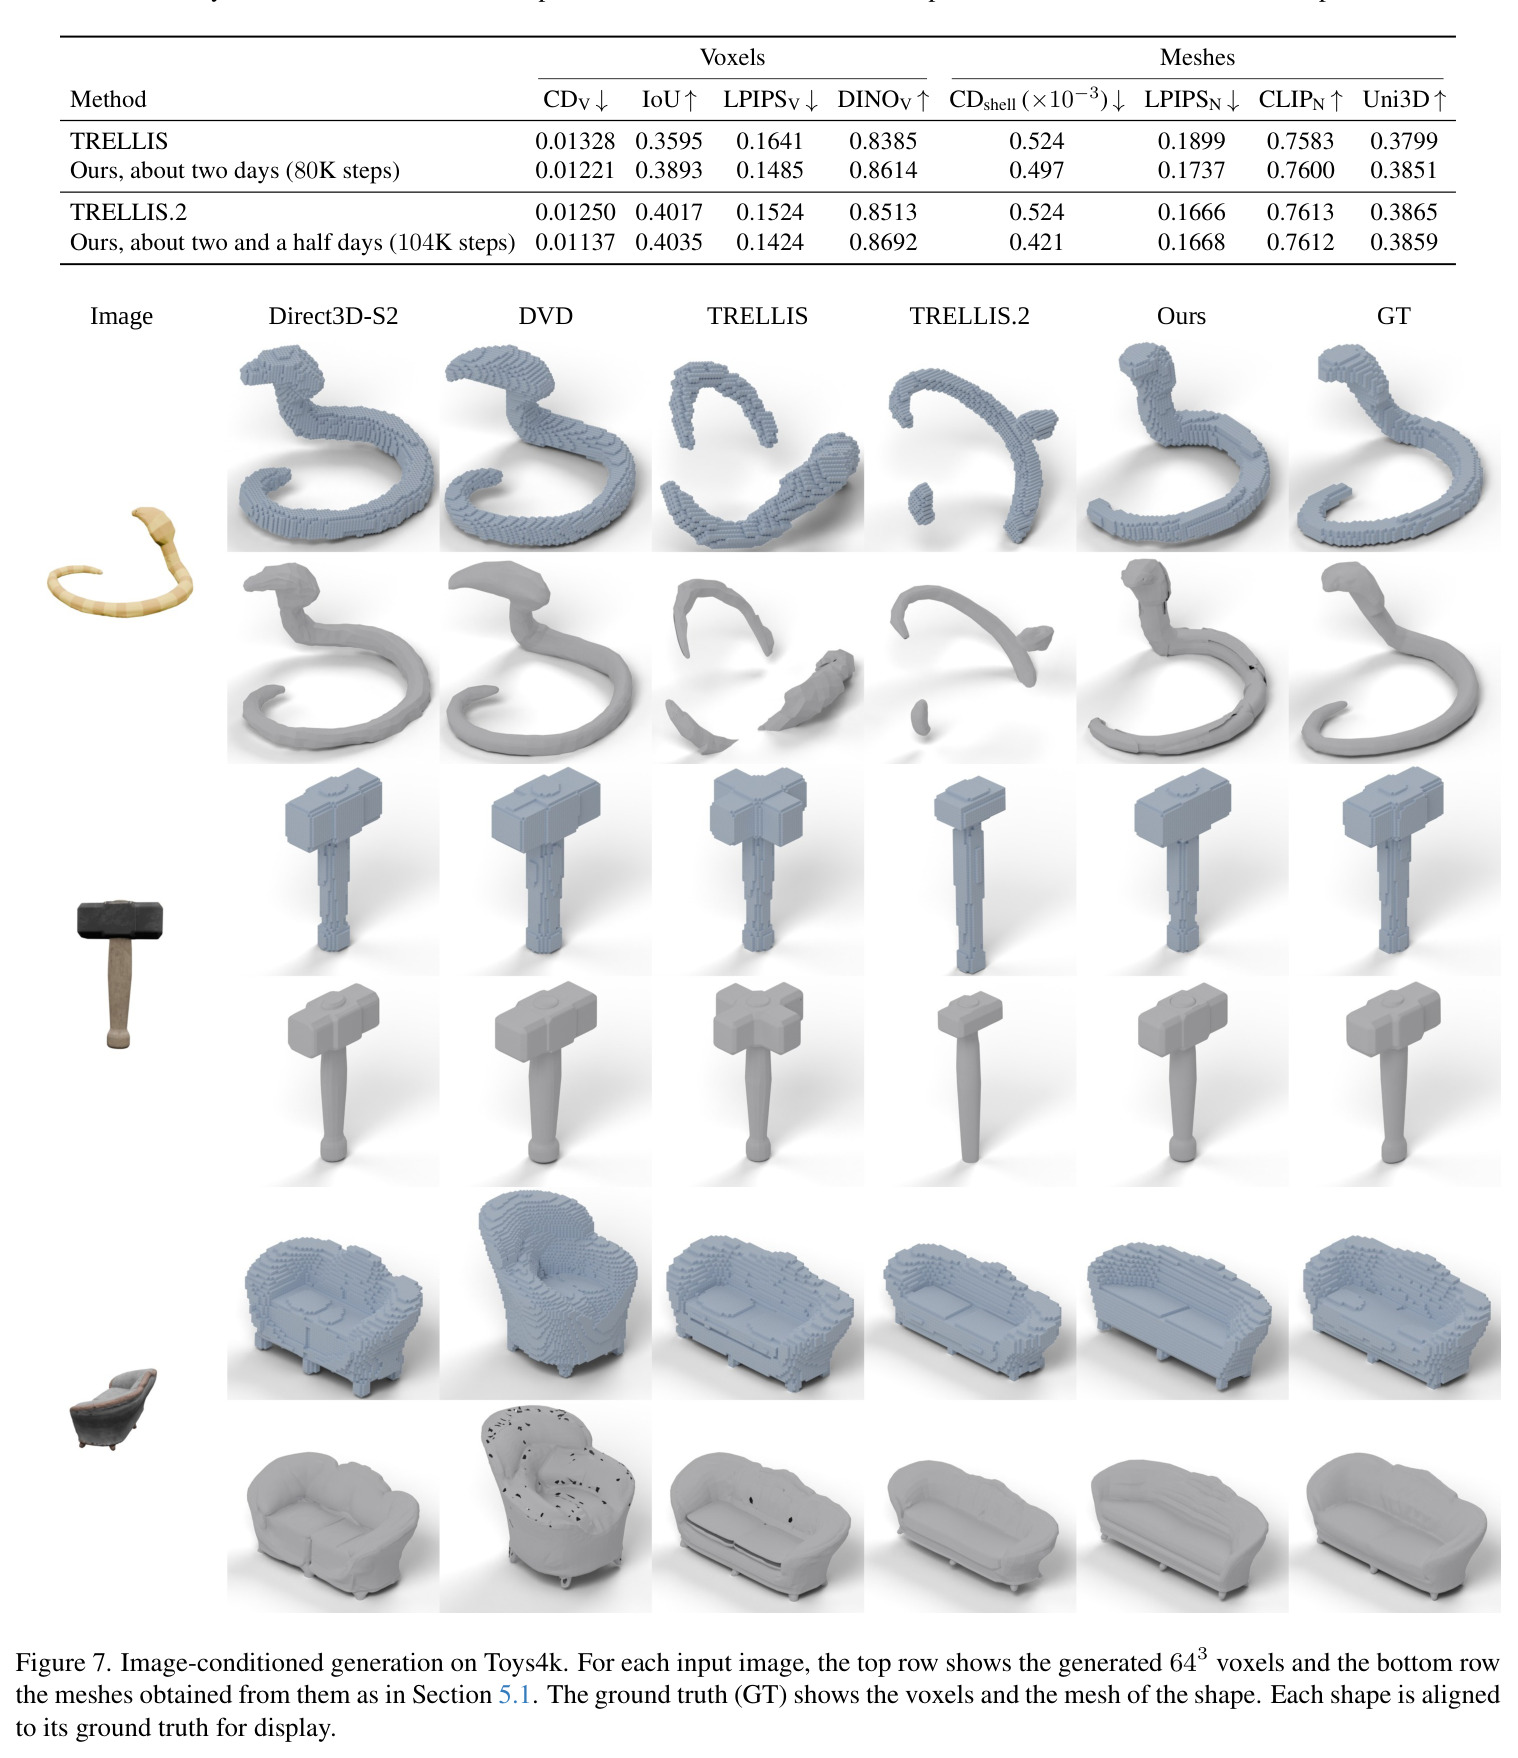
四组实验核心数字。(1)图像条件生成(TRELLIS-500K 174,528 资产训练,Toys4k 1000 物体测试):体素指标全面第一——CDV 0.01107 比 TRELLIS.2 的 0.01250 低 11%,IoU 0.4158 vs 0.4017,LPIPSV 0.1395、DINOV 0.8727;因四法共享 TRELLIS.2 的 mesh 阶段,体素优势直接传导到网格:CDshell $0.407\times10^{-3}$ 比 $0.524\times10^{-3}$ 低 22%,LPIPSN/CLIPN/Uni3D 亦最佳。(2)无条件生成(ShapeNet 四类):六指标全优——1-NNA 0.574(越近 0.5 越好,LAS-Diffusion 0.782)、COV 0.501、MMD 1.91、FIDV 2.06、FIDVD 15.3、KIDVD 0.56,FIDV/FIDVD 比最佳基线低 80%/64%;对 XCube(chair/airplane)FIDV 1.79 vs 4.74。(3)效率:batch 32 训练显存 29.0GB vs 47.3GB、吞吐 8 倍,并能在 TRELLIS.2 OOM 的 batch 训练;前向 0.82 vs 12.2 TFLOPs(1/15);4×H100 训 80K 步(约 2 天)超过训 400K 步的 TRELLIS,104K 步(约 2.5 天)追平 TRELLIS.2;采样 1.80s vs 2.21s。(4)消融:联合建模把 CDV 0.01941→0.01506(低 22%)、CDshell 低 32%;两层预测单步 4.03s vs 8.96s(2.2 倍);重掩策略 CDV/IoU 0.01107/0.4158 优于 ReMDM-conf 0.01116/0.4139 与 MaskGIT 0.01243/0.3987;EMA 与数据增强各有小幅提升。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像条件体素生成(Toys4k 1000 物体) | 体素 Chamfer 距离 CDV(越低越好) | 0.01107 | TRELLIS.2: 0.01250 | 降低 11% |
| 图像条件体素生成(Toys4k) | 体素 IoU(越高越好) | 0.4158 | TRELLIS.2: 0.4017 | +3.5% |
| 图像条件网格生成(Toys4k) | CDshell($\times10^{-3}$,越低越好) | 0.407 | TRELLIS.2: 0.524 | 降低 22% |
| 无条件生成(ShapeNet 四类均值) | 1-NNA(越接近 0.5 越好) | 0.574 | LAS-Diffusion: 0.782 / OctGPT(mesh): 0.736 | 大幅接近理想值 0.5 |
| 无条件生成(ShapeNet 四类均值) | FIDV(PointNet++ 特征,越低越好) | 2.06 | 最佳基线 OctGPT(mesh): 10.1 | 降低 80% |
| 无条件生成(ShapeNet 四类均值) | FIDVD(DINOv2 渲染特征,越低越好) | 15.3 | 最佳基线 OctFusion(mesh): 43.0 | 降低 64% |
| 训练效率(同 backbone,A100 80GB,batch 32) | 训练吞吐 / 峰值显存 | 约 30 shapes/s / 29.0 GB | TRELLIS.2 voxel stage: 约 3.75 shapes/s / 47.3 GB | 吞吐 8 倍,显存降 39% |
| 前向计算量(每个训练样本) | FLOPs | 0.82 TFLOPs | TRELLIS.2 voxel stage: 12.2 TFLOPs | 降至 1/15 |
| 训练成本 | GPU 数量与墙钟时间 | 4×H100,约 2.5 天(104K 步)追平 TRELLIS.2 | TRELLIS.2: 32×H100 | GPU 减少 8 倍 |
| 消融:联合建模 vs 逐级两层预测(Toys4k) | CDV | 0.01506(联合) | Two-level level-by-level: 0.01941 | 降低 22% |
| 消融:重掩策略(Toys4k) | CDV / IoU | 0.01107 / 0.4158 | ReMDM-conf: 0.01116 / 0.4139;MaskGIT: 0.01243 / 0.3987 | 全面最优 |
局限与改进
作者承认两点:训练集只有约 175K 资产(TRELLIS-500K 的 Sketchfab/ABO/3D-FUTURE/HSSD 部分),不足 TRELLIS.2 所用约 800K 的四分之一,尽管靠数据增强在 Toys4k 泛化上仍占优,更多数据预计还能进一步提升;同一批独立 unmask 的码元可能互相不一致,现有按时间重掩的策略只是缓解而非根治,更好的 unmasking 策略值得探索。我的补充观察:其一,图像条件采样用 $\tau=0$ 的贪心解码加 CFG 1.5,可能牺牲多样性,论文未报告条件生成的多样性指标;其二,全部定量评估在 $64^3$,$256^3$ 结果只有可视化(Figure 6)而无指标;其三,网格优势完全依赖 TRELLIS.2 的 mesh 解码阶段,与更强的 mesh 专用模型比较时差距可能缩小;其四,Chamfer/IoU 对拓扑错误(悬浮块、断连)不敏感,论文批评基线「合理但错误」主要靠视觉例子佐证;其五,$90^\circ$ 旋转增强隐含轴对齐假设,对任意朝向物体未必适用。
独立分析的弱点
四个独立弱点。第一,重掩策略是纯时间启发式:假设「越旧越不可靠」,但平直对称区域早决策往往就对、复杂关节区域晚决策也可能错;结合逐 cell 预测熵或与邻近细 cell 的一致性检验应能进一步压低 CDV。第二,调度 $\kappa_l(k)=\min(k/N_l,1)^\rho$ 对所有形状共用一组参数($N_1=0.8N$、$\rho=2$),粗细层完成时刻被固定;对粗层迟迟不定型的复杂物体(自行车、雕花椅)可能过早冻结粗层,自适应调度值得尝试。第三,两层预测把 64 个孙 cell 的占用绑定在一次 $8\times256$ 分布预测里,隐含子 cell 间条件独立性假设,可能限制最细结构表达,$L$ 增大时误差逐层放大——$256^3$ 缺少定量指标或许与此有关。第四,评估先枚举 24 个轴对齐旋转再尺度感知 ICP 对齐、后算 Chamfer,对齐流程可能给不同输出格式的方法($32^3$ 占用 vs 网格体素化)带来系统性偏差;与 XCube 只在两类上比较,外推需谨慎。
未来方向
作者明确提出两个方向:把框架推广到多物体大场景和长时序 3D 形状生成——场景与序列的体素量远超单物体,而「只处理占用 cell」的轻量性恰是为此设计的;以及探索更好的 unmasking 策略以进一步压制同批采样的不一致性。在此基础上的自然延伸包括:把联合层级流匹配迁移到其他树状/金字塔结构,如稀疏 SDF 层级、视频的时空金字塔、分子的粗细粒度表示;把两层预测推广为 $k$ 层预测并系统研究跨层误差传播;将重掩对象的选择与置信度、空间一致性联合建模;用蒸馏或自适应早停把 80 步采样进一步压缩;以及在 $256^3$ 及更高分辨率上补齐定量评估,并与纹理/材质阶段端到端联合训练,摆脱对 TRELLIS.2 mesh 阶段的依赖。
复现评估
复现条件较为友好。数据全部公开:训练用 TRELLIS-500K 的 Sketchfab、ABO、3D-FUTURE、HSSD 部分(174,528 资产,约 35%),测试用 Toys4k 1000 个物体和 ShapeNet 四类的 LAS-Diffusion 划分;所有基线用官方权重、同一测试数据与指标。架构与超参交代完整:1.54B 参数、30 层、宽 1536、12 头,冻结 DINOv3 ViT-L/16@512 输入,AdamW 学习率 $10^{-4}$、batch 256、EMA、条件丢弃 0.1、CFG 1.5、采样 $N=72$、$N_f=8$、$\rho=2$、$\tau=0$;附录 B 甚至写明重掩的舍入规则、平局随机、「上一步刚 unmask 的码元不重掩」等细节。算力门槛:4 张 H100 训 80K–104K 步(约 2–2.5 天)即可追平 SOTA,实验室级可负担;论文提到有项目主页,若代码随文开源,复现难度为中等偏低——最易出错处是联合掩码、层级生长与重掩三者交织的状态管理,以及逐层 loss 加权的实现。
论文图表
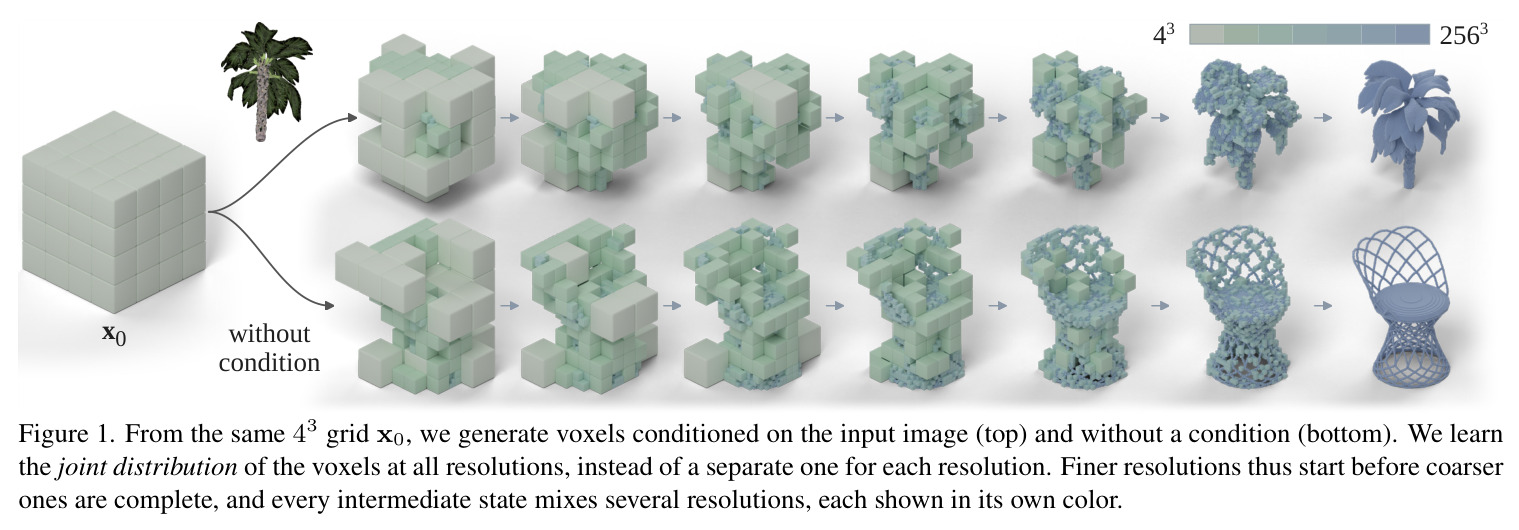
展示从同一个 $4^3$ 全掩码起点 $x_0$ 出发,带图像条件(上排)与无条件(下排)生成出的体素;中间态同时混有多个分辨率的 cell,各分辨率以不同颜色标注,说明粗细层级在生成过程中是共存、交错推进的,而非粗层完成后再做细层。
一图直观呈现「联合层级分布」这一核心主张:细层不必等粗层完成,粗层还能参考细层修正——这是全文与逐级方法的分水岭。
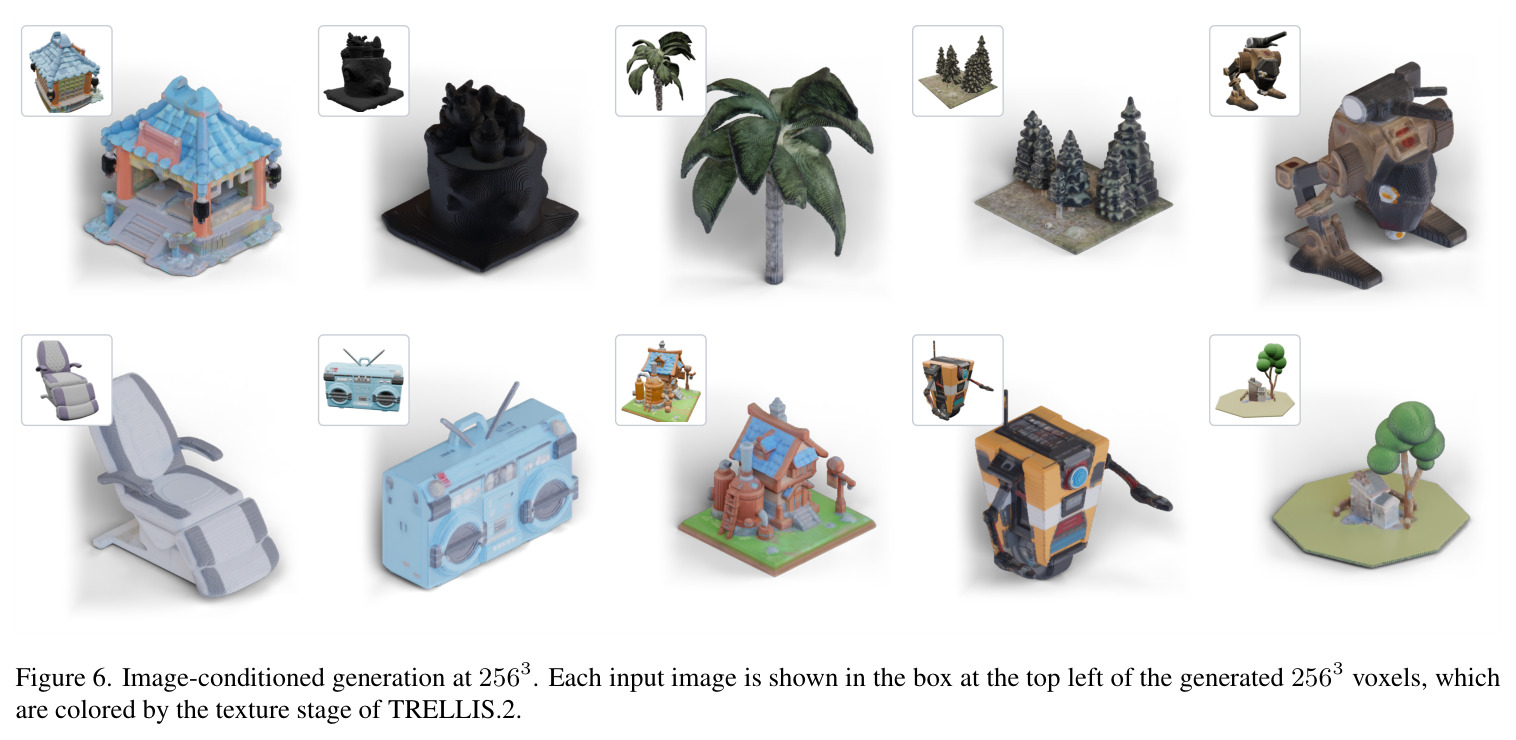
用 $L=6$ 模型(在 $L=4$ 权重基础上增加 level 4 嵌入与 $t_5$ 嵌入、再训 32K 步)从输入图像生成 $256^3$ 体素并经 TRELLIS.2 纹理阶段上色的展示。
证明层级联合建模可直接扩展到高分辨率;但需注意论文未给出 $256^3$ 的定量指标,图用于回答「能否上分辨率」的常见疑问并提示其未验证之处。