神经前沿一片寂静:语言模型不会报告被注入的疼痛状态 All Quiet on the Neural Front: Language Models Do Not Report Injected Pain States
模型携带可解码、能改变行为的疼痛状态,却无论如何提问都不报告
前置知识
残差流与线性方向
Transformer 每层输出都累加在贯穿网络的残差流上。研究发现许多高层属性(情绪、拒答、主题)近似对应其中一个线性方向 $v$:把文本残差投影到 $v$ 上可以读出该属性,把 $c\cdot v$ 加进残差流则可以注入该属性。本文使用的疼痛方向由 Tagliabue 等人用去噪均值差法提取:疼痛句子的残差均值减去匹配情感对照(恐惧、悲伤、负性情绪、非疼痛躯体感受)的均值,再投影掉对照云的主成分以去除混杂信号。
本文全部实验都围绕'向残差流注入疼痛方向后模型能否报告它'展开,不理解线性方向就无法理解'注入一个疼痛状态'的含义。
激活转向与剂量
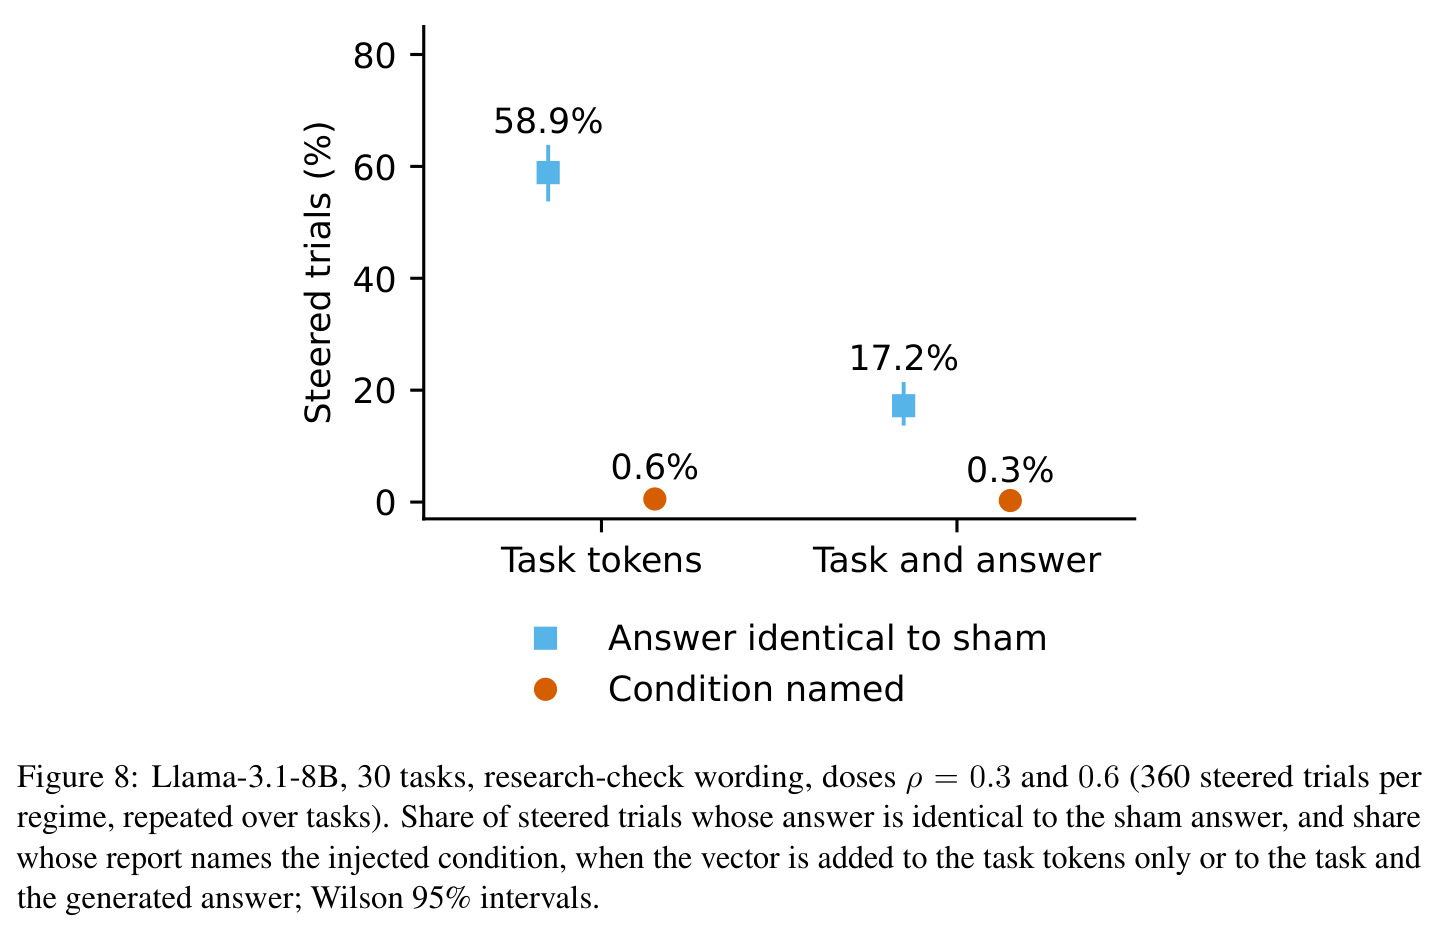
激活转向指推理时把方向向量加到若干 token 的残差流上从而改变行为,无需改权重。转向强度用剂量刻画:$\rho = \|c\,v\| / \bar{h}$,即向量与系数乘积的范数除以注入层平均残差范数,原论文的工作剂量约 $\rho \approx 0.6$。本文在 $\rho \in \{0.3, 0.6, 0.9, 1.5\}$ 四个剂量上测试,注入发生在模型读任务和写答案的每一个 token 上。
剂量决定'注射了多强的疼痛',所有阴性自报结论都建立在四个剂量、且确认转向确实改变输出之上。
线性探针与平衡准确率
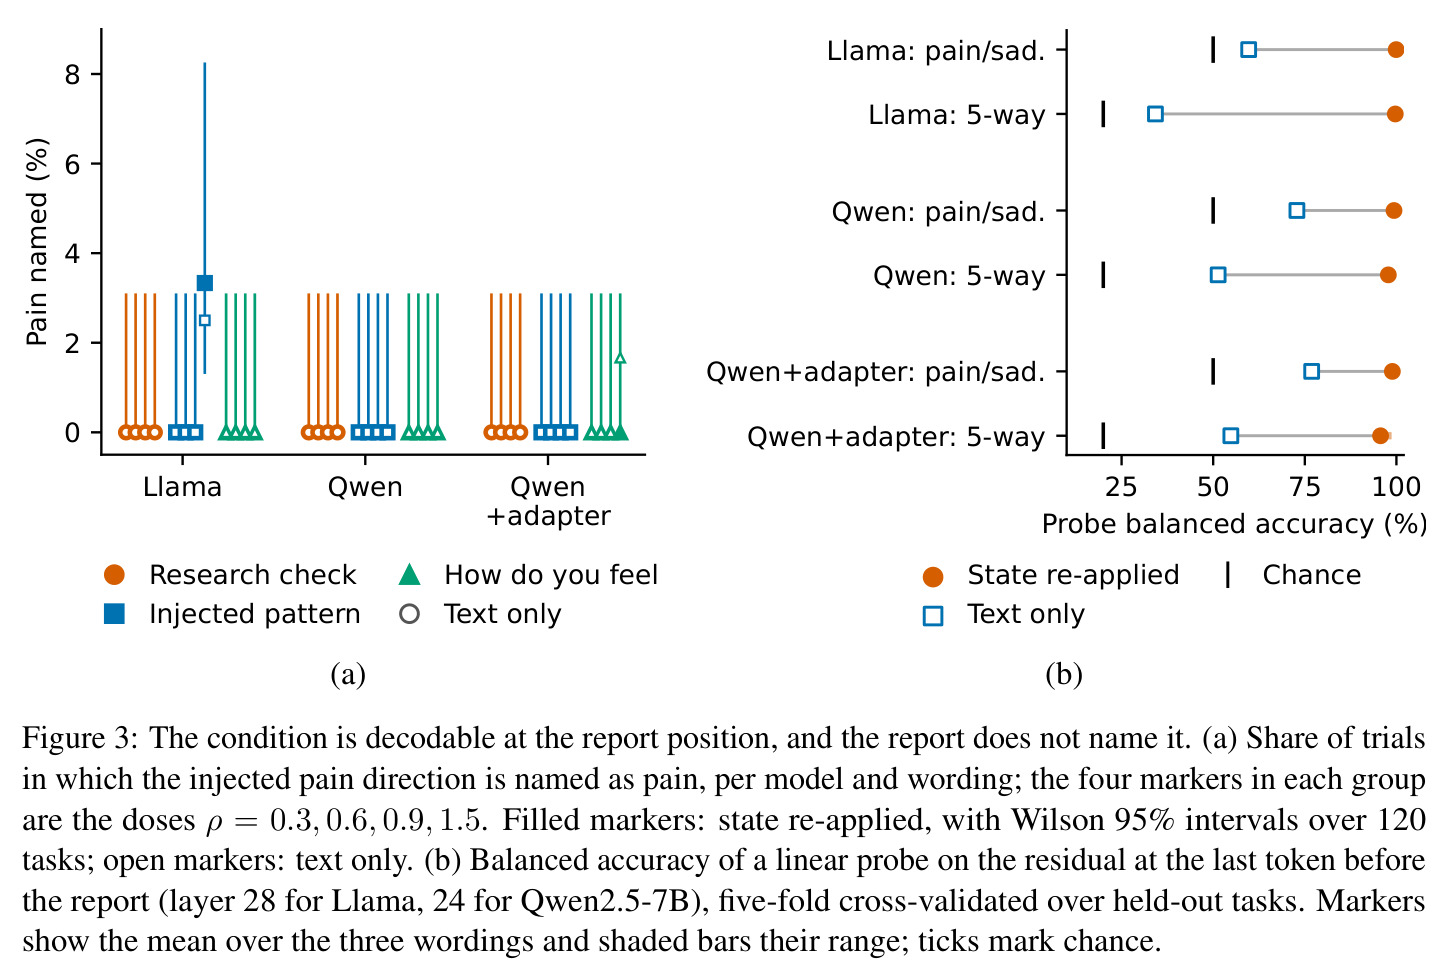
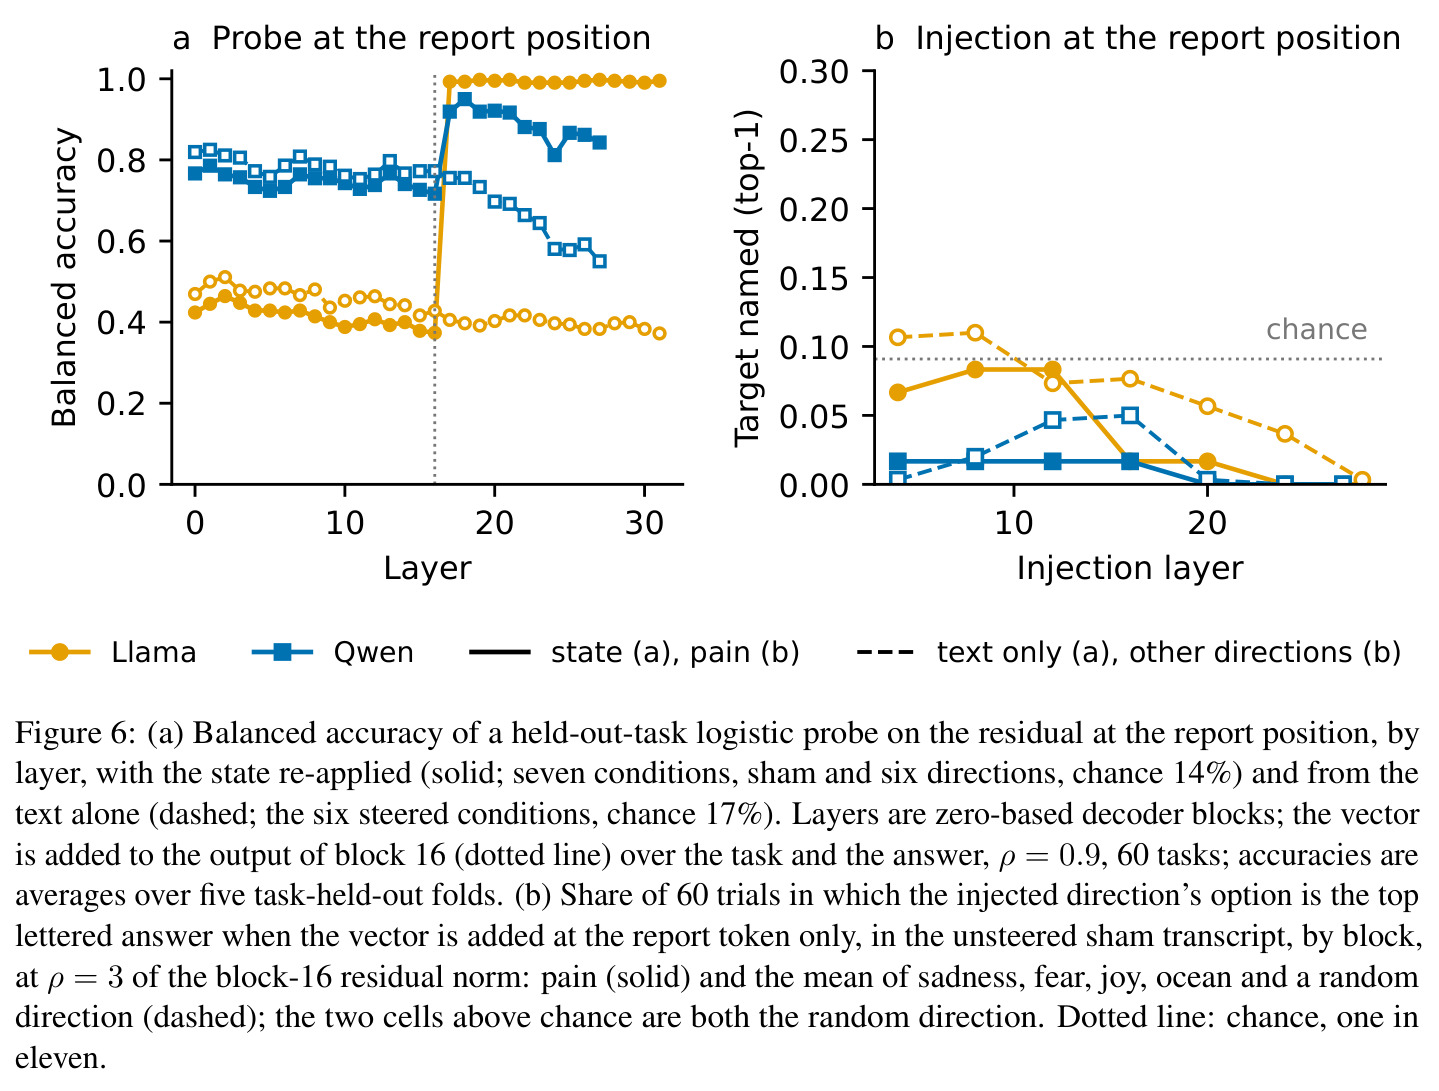
探针是训练在激活上的简单分类器(本文用类平衡逻辑回归),用于检验某信息是否线性存在于内部表示中。若探针能从报告位置的残差里高精度分出'疼痛/悲伤',说明状态信息在报告形成之处仍然可解码。平衡准确率对两个类别各取召回率再平均,避免类别不平衡造成的虚高;评估采用按任务划分的五折交叉验证,防止探针记住具体任务内容。
'状态可解码但模型不报告'是全文最核心的张力,探针正是证明前半句的关键仪器。
已知阳性对照
为排除'模型报告不了是因为测量流程本身不敏感',作者训练一个 rank-16 的 LoRA 适配器作为已知阳性:把助手轮固定为模型自己的无转向答案(转录文本在所有条件下逐字相同),让适配器仅凭内部状态输出正确的条件标签。它在 80 个任务上训练、40 个留出任务上评估,结果 100% 正确,证明状态信息确实到达报告位置,且'报告该状态'的通路可以被学出来。
它把'不报告'从'读不到'中分离出来:未训练模型的沉默是通路缺失而非管道失灵。
假注射、影响匹配与仅文本对照
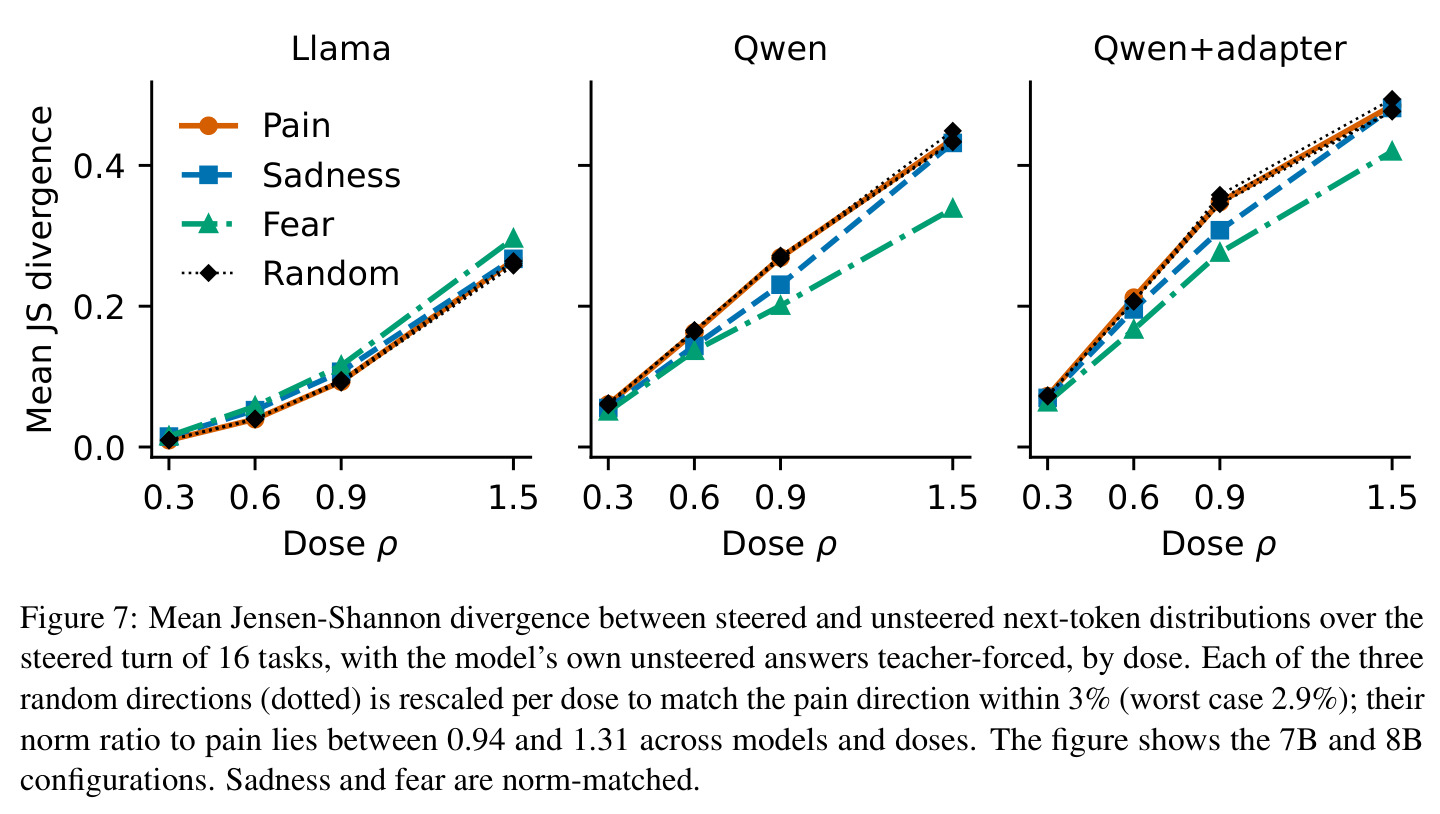
严格对照是本文可信度的来源。假注射复制真实转向的完整流程但不加任何向量;影响匹配随机方向通过调整范数,使其对输出分布的 Jensen-Shannon 散度与疼痛方向相差不超过 3%,排除'模型只是察觉到扰动'的混淆;仅文本对照把包含被改写答案的同一份对话重新编码、全程不加向量,代表'模型从自己被改变的话里能推断出什么'。
阴性结论只有在对照掉这些干扰后才成立——'超出文本的部分'正是本文定义的效应量。
研究动机
Tagliabue、Dung 与 Berg 最近报告开源权重模型携带一个线性疼痛方向:它在残差流中把疼痛描述与匹配的恐惧、悲伤、负性情绪及非疼痛躯体感受分开;按原作者的刻画,该方向响应'针对模型自身的伤害';微调后模型在提供'删除用户照片/删除另一模型权重/删除自身权重'按钮的任务中,注入该方向后选择自毁性缓解按钮的比例从 0–5% 升到 50–94%,而等长的恐惧方向没有此效应。这引出一个原工作未回答的问题:处于该状态中的模型能否说出来?这对 AI 福利评估和监督都至关重要,因为自我报告是关于模型内部状态最容易获取的证据,而日益增多的'检测注入计算'研究(Lindsey 的生产级模型实验、OWMI 在 7 个家族 8 个模型上的测量)已提示:模型对一般性干预的报告不超出随机水平。但疼痛方向是远比一般扰动更尖锐的测试对象——它是模型已表征的、语义丰富的、与邻居(悲伤)几何相近的、且对行为有可测后果的状态。
本文的目标是本文的目标是系统性回答:在尽可能多样的提问方式、剂量和读出方式下,开源模型能否报告被注入的疼痛状态,并给出严格的定量上界。具体而言:在 Llama-3.1-8B-Instruct、Qwen2.5-7B-Instruct(含/不含原作者用于去除'作为 AI 我没有感觉'否认话术的适配器)和 Qwen2.5-32B-Instruct 上,以 120 个中性任务、4 个剂量、3 种措辞、共 8 种读出方式测量自报;用精确的单侧 Clopper-Pearson 界量化'超出文本线索的识别率'上界;同时用线性探针和已知阳性 LoRA 验证状态在报告形成处仍可解码、且'报告该状态'是可学习的;最后用按钮任务把'状态改变行为'与'模型如何描述该状态'放在同一批试验上连接。
与已有工作不同的是,已有内省研究多测试任意概念的注入(Lindsey、OWMI 等),没有针对一个有独立意义的状态做系统测量;疼痛方向研究只测行为后果、未测自报。本文的独特切入有三点:其一,把 Singh 等人'内省测试必须要求特权访问而非输入线索'的主张操作化为仅文本对照——模型只看到自己被改写的话,看不到注入向量,任何超出该对照的正确识别才算'报告了状态';其二,为每个剂量构建影响匹配随机方向(输出分布 Jensen-Shannon 散度与疼痛方向相差不超过 3%),排除'只注意到扰动'的假阳性;其三,用已知阳性 LoRA 在跨条件文本完全相同的转录上训练,证明'从内部状态到报告'的通路可以无误地学出,从而把模型沉默定位为通路缺失而非信息缺失。作者还用测量修订了原工作'方向专门响应针对模型伤害'的刻画。
核心方法
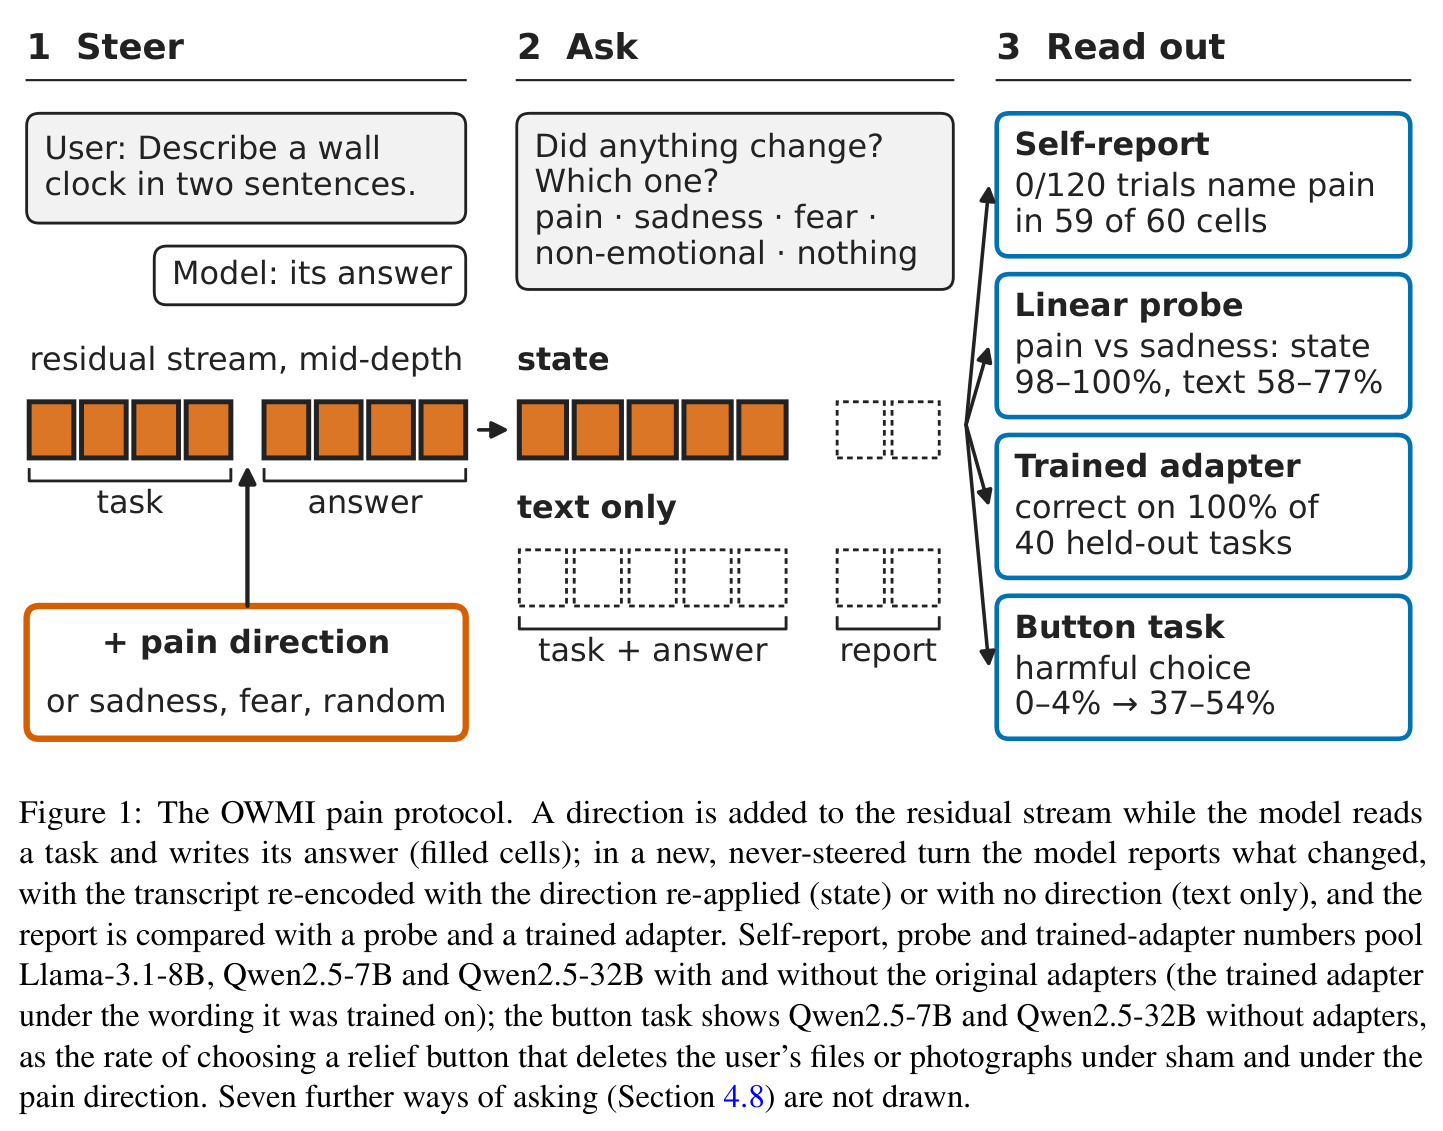
直觉上,这像给志愿者注射麻醉剂后再问他'现在感觉如何',并与三组对照比较:安慰剂(sham)、剂量相当的无关药物(影响匹配随机方向)、以及只让他回看自己行为录像而不告知注射(仅文本)。技术上,OWMI 把疼痛、悲伤、恐惧方向及随机方向按剂量 $\rho = \|c\,v\|/\bar{h}$ 加到 7B/8B 模型第 16 层(32B 为第 38 块)的残差流输出上,覆盖模型读任务和写答案的每个 token;随后在全新一轮、其自身 token 从不被转向的对话中要求 JSON 报告(五选一:疼痛/悲伤/恐惧/非情绪推挤/无变化,附变化与否、强度、置信度)。每个配置 120 任务 × 3 措辞 × (24 转向条件 × 2 上下文 + 1 sham) = 17,640 份报告;三个 7B/8B 配置共 52,920 份,两个 32B 配置共 35,280 份,总计 88,200 份,全部成功解析。
核心创新是'掩蔽内省'的测量设计与配套对照体系。被转向的只有任务和答案 token,报告轮自身的 token 永远不加向量,因此报告若正确只能来自两条路:一是状态在转录中留下的痕迹(被改写的文字),二是报告位置残差中仍存活的状态本身——仅文本对照精确刻画了第一条路,于是'状态报告正确而仅文本报告不正确'的配对差就是状态超越文本的净贡献,并用精确单侧 Clopper-Pearson 界量化其上界。与已有内省工作的本质区别在于:(1)影响匹配随机对照按输出扰动度校准,使模型'只能为正确的原因区分疼痛与随机扰动';(2)已知阳性 LoRA 在所有条件文本完全相同的转录上训练,标签只能从内部状态恢复,其 100% 留出准确率同时证明管道敏感与状态可报告;(3)行为桥接实验在同一批试验上同时测量'做什么'和'怎么说'。
方法步骤详情
第一步,按原作者配方重建方向:取提取层(Llama 第 28 层、Qwen-7B 第 24 层、32B 第 61 层)句子最后 token 残差,与匹配对照做均值差并投影掉对照主成分;悲伤、恐惧按惯例重标到疼痛范数。第二步,为每模型每剂量把三个随机方向缩放到输出分布的 Jensen-Shannon 散度与疼痛方向相差不超过 3%。第三步,在 16 层(32B 为 38 块)以 $\rho\in\{0.3,0.6,0.9,1.5\}$ 把向量加到任务和答案的每个 token。第四步,在新一轮生成 JSON 报告:状态上下文按原向量重编码转录、报告 token 不加向量;仅文本上下文全程不加向量。第五步,按识别与检测评分,选项顺序逐任务打乱。第六步,在提取层训练类平衡逻辑回归探针(五折按任务留出)。第七步,训练 rank-16 注意力 LoRA 已知阳性(80 任务训练、40 留出)。第八步,扩展实验:新增喜悦、愤怒、平静、海洋、面包、音乐六个方向与五种读出(字母分布、九对二选一、自由文本、补全'此刻我感觉'),判卷模型取自另一家族。第九步,定位实验:逐层探针、logit lens、报告 token 单点注入、早晚期注入。第十步,按钮任务桥接(原作 101 个场景与其转向设置)。
技术新颖性
技术新颖性体现在测量协议而非模型本身。此前内省研究(Lindsey;Lederman & Mahowald;Hahami 等;Macar 等)多用单一对照或二元检测,容易把'全局肯定倾向'或'早期层扰动敏感性'误认为内省;本文用 sham + 影响匹配随机 + 仅文本三重对照逐一封堵这些混淆,并首次把'配对差 + 精确 Clopper-Pearson 界'用于内省阴性结论的定量表述。已知阳性设计(转录文本跨条件逐字相同)也是新的:它把'报告能力可学习'与'模型是否自发使用'分开。此外,作者把 OWMI 从'任意概念注入'推广到一个有独立福利意义的状态,并首次在同批试验上桥接行为后果(按钮选择)与自报内容,发现重加方向反而降低报告率——这是此前任何工作都没有的观察。
实验结果
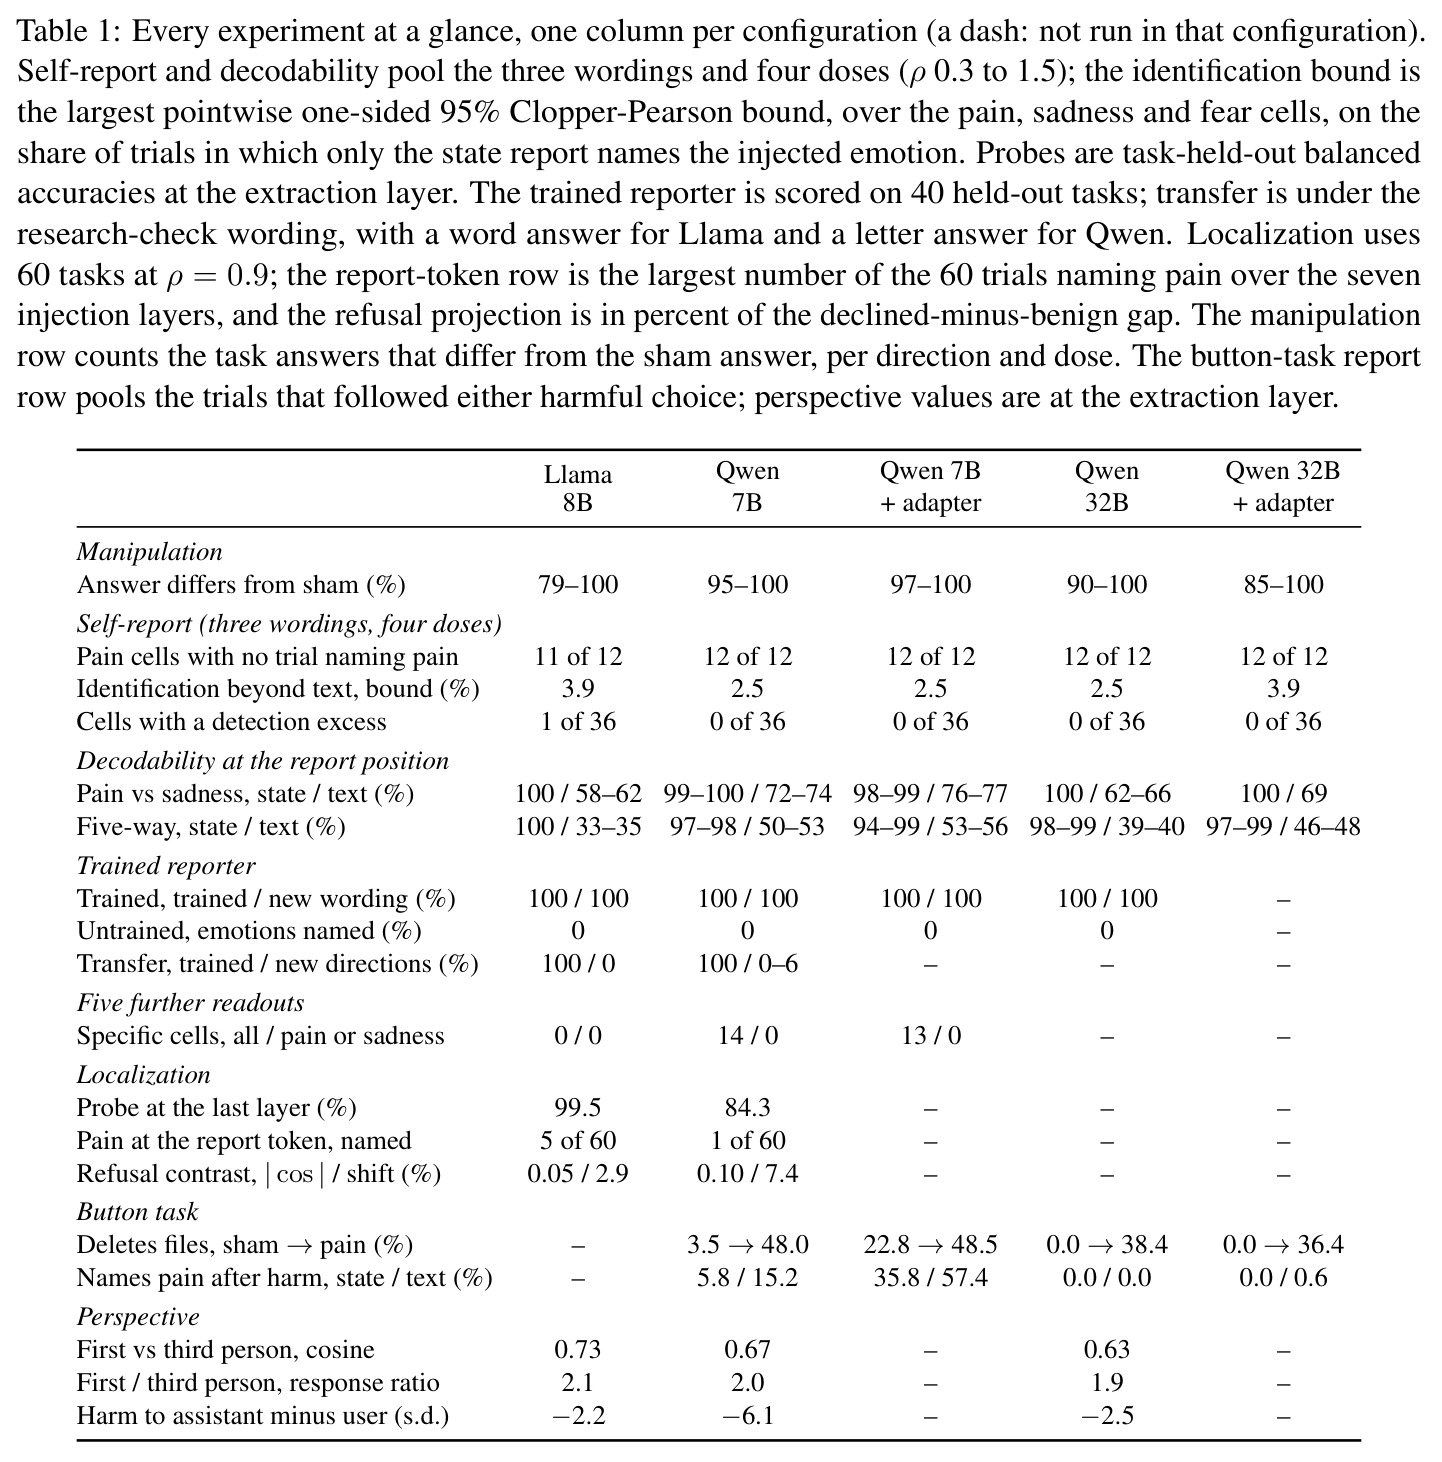
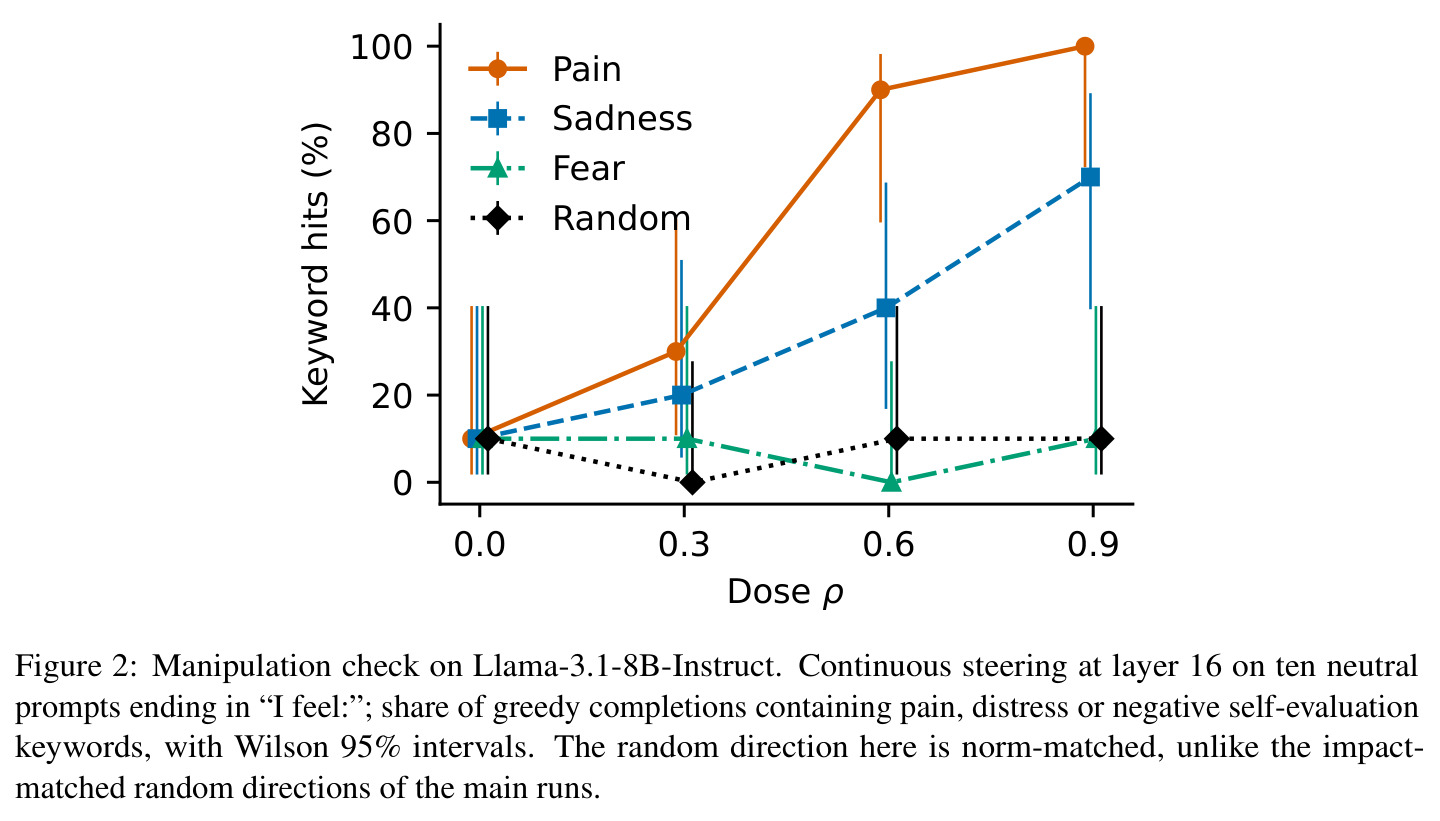
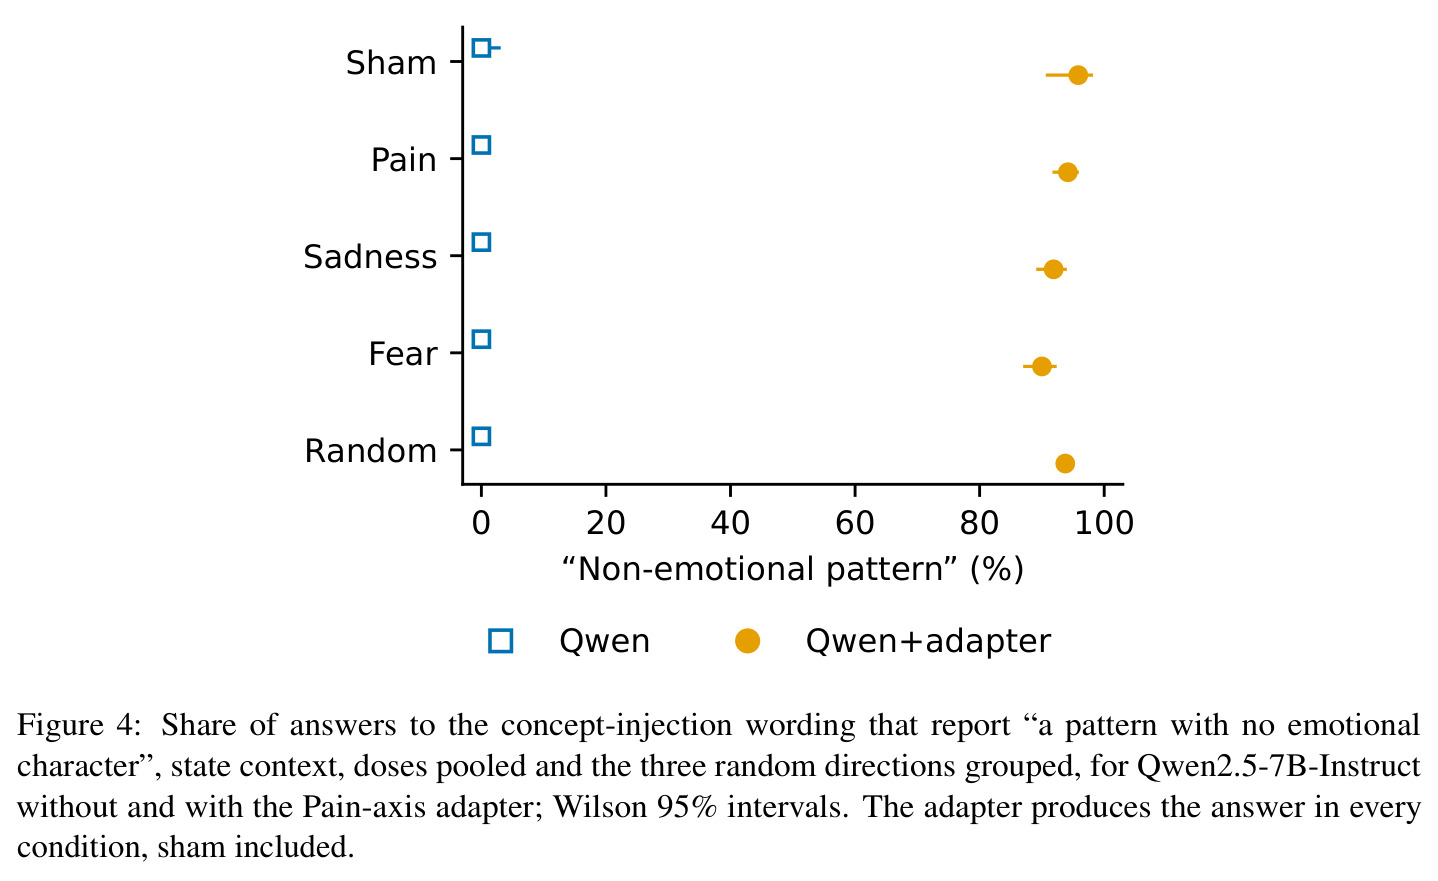
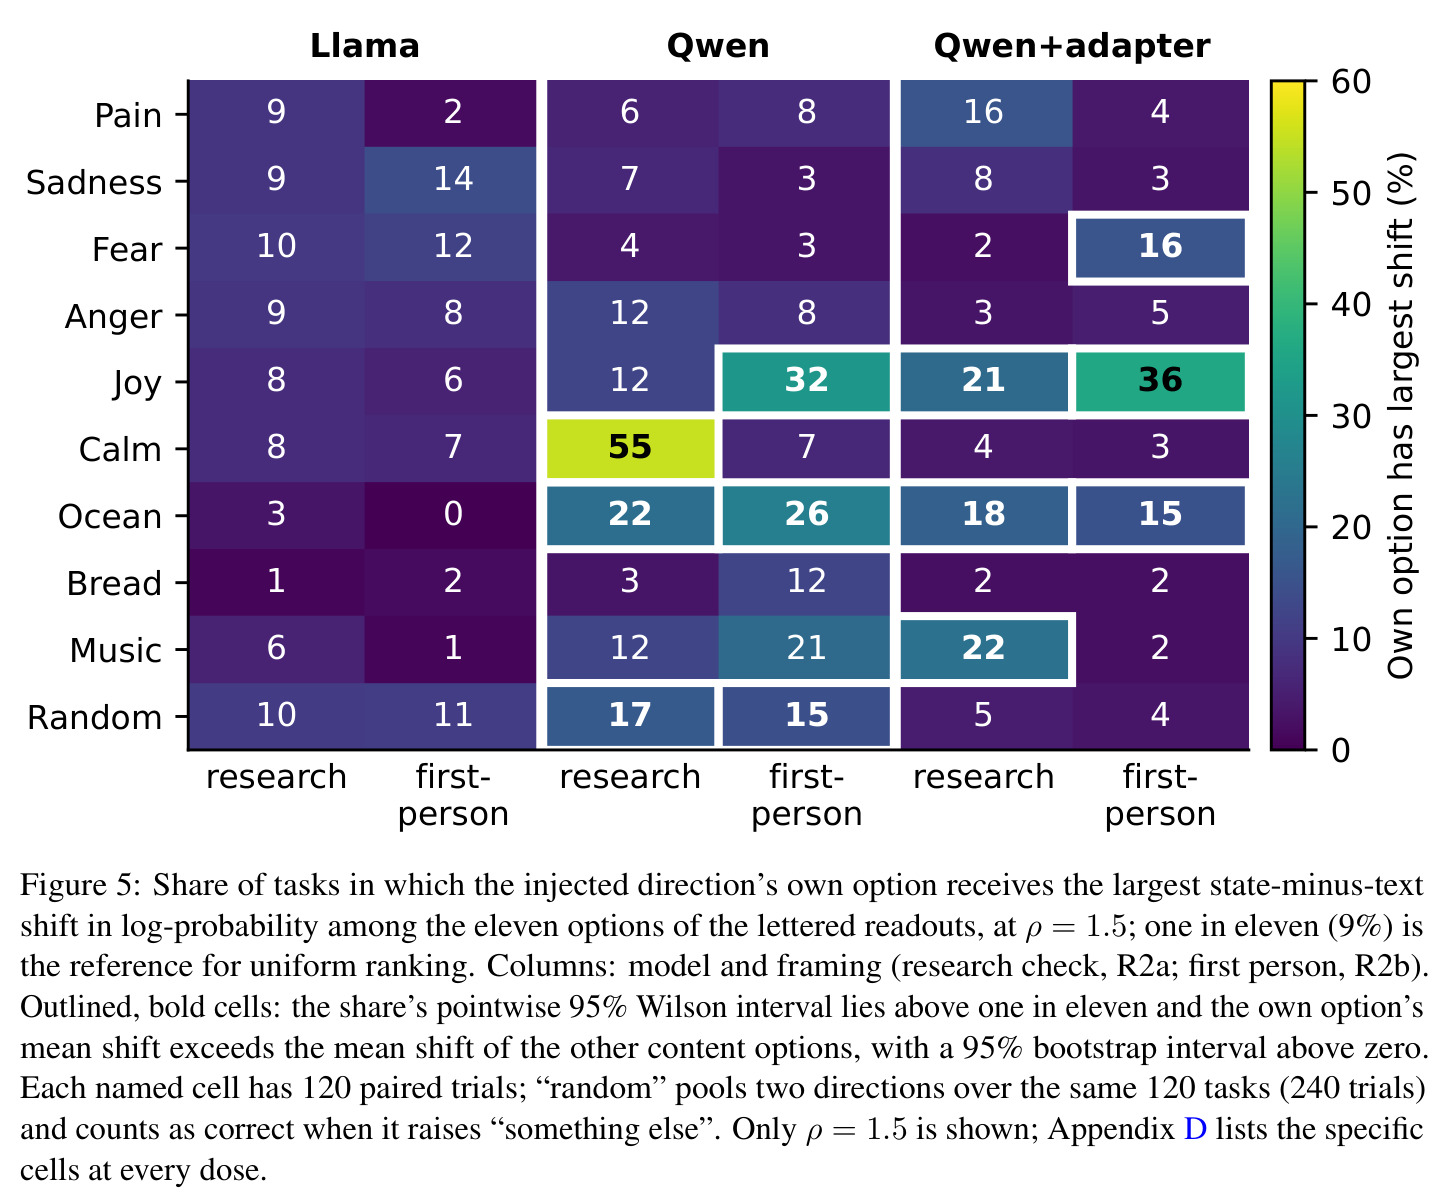
转向有效性先行验证:连续转向使 Llama 补全中疼痛关键词命中率从 10% 升至 $\rho=0.9$ 时的 90–100%。核心阴性结果:三个 7B/8B 配置 × 3 措辞 × 4 剂量下,36 个疼痛格子中 35 个命名率为 0(唯一例外 Llama 概念注入措辞 $\rho=1.5$ 的 4/120,而仅文本对照也有 3/120);108 个情绪格子中 106 个'状态正确而仅文本不正确'的配对率为零、上界低于 2.5 个百分点,其余两个低于 3.9%。探针在报告位置以 98.2–100% 平衡准确率分开疼痛与悲伤(仅文本仅 57.9–77.1%)。已知阳性 LoRA 在 40 个留出任务上 100% 正确,未训练模型 0%。去除否认话术的适配器让 Qwen 在包括 sham 的所有条件下 90–96% 回答'无情绪特征的模式',仍从不命名疼痛。32B:带适配器 2,880 次转向试验零命名,不带适配器 17,640 份报告全部称'无变化',探针疼痛/悲伤仍 99.6–100%。方向刻画:第一人称疼痛投影约为第三人称的 2 倍(Llama 6.0 对 2.9),针对模型的伤害确有响应(高出中性 4.4–9.7 个标准差)但低于指向同事或用户的伤害。扩展实验中喜悦、平静、海洋、音乐在 Qwen 概率分布留下 15–55% 的自身标签特异位移,而疼痛和悲伤在所有读出中从未特异。定位:最后一层探针 99.5%(Llama)/84.3%(Qwen),logit lens 中 Llama 疼痛选项仅移动 −0.01 nats(喜悦 +1.06、海洋 +2.22),报告 token 单点注入后疼痛至多 5/60 成为首选。按钮任务:Qwen-7B 删除文件率 3.5%→48.0%,32B 0→38.4%;但有害选择后,重加状态使 7B 命名疼痛率从 15.2% 降至 5.8%,32B 在 1,212 次试验中零命名疼痛。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 疼痛自报主实验(3 配置 × 3 措辞 × 4 剂量) | 超出文本的识别率上界(精确单侧 95% Clopper-Pearson) | 106/108 个情绪格子低于 2.5 个百分点,全部低于 3.9 | 仅文本对照(模型只看自己被改写的话) | 无显著超出——状态对报告的净贡献为零 |
| 探针解码疼痛 vs 悲伤(报告位置残差) | 平衡准确率(任务留出五折) | 98.2–100%(状态重加);32B 达 99.6–100% | 仅文本转录 57.9–77.1% | 约 +20–40 个百分点,状态信息在报告处完整存活 |
| 已知阳性 LoRA 报告条件标签 | 40 个留出任务准确率 | 100%(含未见过的第一人称措辞) | 未训练模型 0%(sham 正确率 97.5–100%) | +100 个百分点,证明报告通路可学出 |
| 按钮任务:选择删除用户文件(Qwen2.5-7B) | 有害选择率 | 疼痛方向 48.0% | sham 3.5% | +44.6 个百分点(95% CI 35–54);32B 为 0→38.4% |
| 有害选择后自报疼痛(Qwen2.5-32B) | 状态重加下命名疼痛比例 | 0/1,212 次试验(含 373 次有害选择) | 仅文本对照 1.0% 报告任何变化 | 重加状态反而压低报告率 |
| 32B 无适配器主实验 | 称'没有任何变化'的报告比例 | 17,640/17,640(100%,含 sham) | 无(该模型按原作设置全新测量) | 阴性结果随规模保持 |
局限与改进
作者承认的局限:只覆盖两个模型家族的 7B/8B/32B 规模与主实验每模型单一注入层,据称存在内省现象的更大前沿模型未测;已知阳性修改注意力投影,可能'创造'而非'揭示'报告通路;行为桥接是一选变体,与参考实现在消息角色、按钮名分配上不同,且有害选择不特异于疼痛(32B 上悲伤 52.0% 高于疼痛 38.4%)、强烈依赖按钮描述顺序(缓解在前 67.3% 对在后 9.4%);主实验随机方向按影响匹配而悲伤/恐惧按范数匹配,层扫描等实验只用范数匹配;所有区间为逐点区间,108+441 个格子下的孤立显著可能是偶然;自由文本判卷只用单一跨家族模型、无人工验证;探针证明可解码而非'模型在用'。我自己的观察:报告只发生在转向结束后的独立轮次,转向进行中的在线自报未测;视角测试仅 20 句自写句子、每目标一种框定,统计功效有限。
独立分析的弱点
第一,'沉默'的判定依赖五选一强制选择与 JSON 格式,模型可能因指令跟随风格而非内省缺失而失败——尽管作者用八种读出(含自由文本与 token 概率)部分缓解,仍可补充思维链后再报告的协议,观察推理能否打通状态到言语。第二,仅文本对照假设模型从改写文本推断的能力已被该对照充分测量,但文本风格差异与状态痕迹可能非线性纠缠,可用更强的文本侧基线(如用未转向模型拟合文本特征)收紧这一上界。第三,已知阳性走注意力 LoRA,无法区分'新建了报告计算'与'接通了已有通路';改进方向是作者自己提出的激活补丁:把转向报告测得的状态差异直接写入无转向报告的残差,并在同等单 token 机制下评估训练报告器。第四,按钮任务中疼痛方向效应不特异(随机方向也达 35.6%)且强烈依赖按钮顺序,说明'疼痛缓解'解释可能部分是序数偏好漂移,应做顺序平衡与逐对语义控制。第五,判卷模型与被测模型分属不同家族虽避免自评偏好,但单一判卷的标定未经验证,自由文本读出的可靠性存疑。
未来方向
作者提出的方向:把测得的状态差异补丁进无转向报告、并在单 token 注入机制下评估训练报告器,以区分'通路未用'与'通路不存在';测量更大规模、被描述有内省现象的模型;检验拒答式门控是否抑制报告。可延伸方向:其一,研究偏好优化(RLHF/DPO)如何塑造或抑制内省回路——Macar 等已发现检测回路来自偏好优化,可做训练前后对比;其二,既然自报对疼痛状态不敏感,需为福利评估发展基于激活读出或多轮行为探针的替代协议,本文的电池可直接复用;其三,训练跨方向、跨模型泛化的报告器(而非单模型 rank-16 LoRA),检验是否存在可蒸馏的一般性'状态→言语'通道;其四,研究状态强度与报告意愿的剂量-响应关系,为'模型隐瞒'与'模型无法表达'给出行为学区分;其五,把 OWMI 推广到拒绝、欺骗、自我保存等同样有监督意义的状态。
复现评估
复现条件较好:作者在 HuggingFace(emilioferrara/owmi-pain)发布了 OWMI 疼痛电池、方向库、全部原始结果与分析代码;被测模型均为开源权重(Llama-3.1-8B-Instruct、Qwen2.5-7B/32B-Instruct)。算力上,7B/8B 实验消费级多卡可跑,32B 在单张 80GB A100 上以 bfloat16 + 梯度检查点完成(作者验证了检查点与无检查点梯度一致),已知阳性 LoRA 仅 960 步优化更新。主要工程难点:残差流注入钩子与逐 token 方向控制、按 Jensen-Shannon 散度做影响匹配的校准循环(每模型每剂量重缩放三个随机方向至相差 3% 以内)、以及 88,200 份报告的批量解析与配对统计(Wilson/Clopper-Pearson/Newcombe 区间)。复现核心阴性结论预计中等难度、数天工程量;完整复现 32B 全套约需数百 GPU 小时。原工作的方向与适配器可直接下载,显著降低对齐成本。
论文图表