InstantHMR:手机上的实时单图三维人体网格恢复 InstantHMR : Real-Time Human Mesh Recovery on Your Phone
基于MHR参数模型的单图人体网格恢复家族,手机NPU上5.5毫秒实时重建6890顶点网格
前置知识
人体网格恢复(HMR)
从单张 RGB 图像恢复人体三维网格与姿态的任务。主流做法不直接预测网格顶点,而是回归参数化人体模型的参数(姿态、体型、相机),再由模型确定性展开为网格。评测常用 PA-MPJPE(Procrustes 对齐后的关键点平均误差,单位 mm),数值越低越好。
本文的模型设计、损失函数与全部实验指标都围绕这一任务展开,理解任务定义是读懂精度对比的前提。
SMPL 与 MHR 参数化人体模型
SMPL 是最常用的参数化人体模型:形状空间从 3D 扫描学得,6890 个顶点、24 个关节。Meta 的动量人体骨架 MHR 将骨架与体型解耦:姿态参数 $\theta\in\mathbb{R}^{204}$ 含根变换、130 个关节参数与 68 个骨长缩放,体型系数 $\beta\in\mathbb{R}^{45}$;其 18,439 顶点网格可下采样出与 SMPL 顶点数相同的子集。
InstantHMR 的输出空间就是 MHR 参数,前向运动学与蒙皮直接在 NPU 上运行,这是它与 NLF 逐顶点预测方式的本质差异。
PA-MPJPE / MPJPE / PVE
PA-MPJPE 是经过 Procrustes 对齐(平移、旋转、缩放对齐)后预测关键点与真值的平均欧氏距离,单位毫米,是 HMR 最常用的精度指标;不对齐的版本称 MPJPE,PVE 则衡量逐顶点的网格误差,三者越低越好。
论文所有精度结论(如 EMDB-1 上 48.8 mm 对 SMPLer-X 的 71.0 mm)都以这些指标报告,不熟悉它们就无法判断 22 mm 差距的量级。
NPU 与 fp16 端侧部署
神经处理单元(NPU)是手机中为卷积和矩阵乘设计的加速器,支持的算子集合有限。模型需要导出为单一 ONNX 计算图、以 fp16 精度运行,并保证每一层都落在 NPU 上——任何一层回退到 CPU 都会大幅拖慢整体。gather、transpose、softmax 等张量重排类算子在 NPU 上尤其慢。
"整图可编译、1607 层全部驻留 NPU"是本文架构设计的硬约束,也是其速度优势的根本来源。
SimCC 坐标分类
把二维关键点定位当作分类问题:将坐标轴离散为若干 bin(本文 $x$、$y$ 各 96 个),网络对每个关键点输出 bin 上的概率分布,取期望得到坐标。相比直接回归,分类保留了图像证据的分布信息,训练时用交叉熵配合以真值为中心的高斯标签。
InstantHMR 的 70 个 2D 关键点由共享的 SimCC 头输出,是训练损失三大组中图像侧监督的核心成分。
CLIFF 式全图条件化
单看人体裁剪框无法判断人在三维空间的位置:同一裁剪可能来自画面中心或广角镜头边缘。CLIFF 把裁剪框在全图中的位置编码后注入网络。本文用焦距 $f$ 而非图像尺寸表达:两个视角角 $\arctan((b_x-W/2)/f)$、$\arctan((b_y-H/2)/f)$ 与尺寸比 $\max(b_w,b_h)/f$,跨相机语义一致;无标定时 $f$ 默认取 1.05 倍图像对角线。
这是网络的第三路输入 $c$,理解它才能明白模型为何能在不同相机、不同取景下保持几何一致性。
研究动机
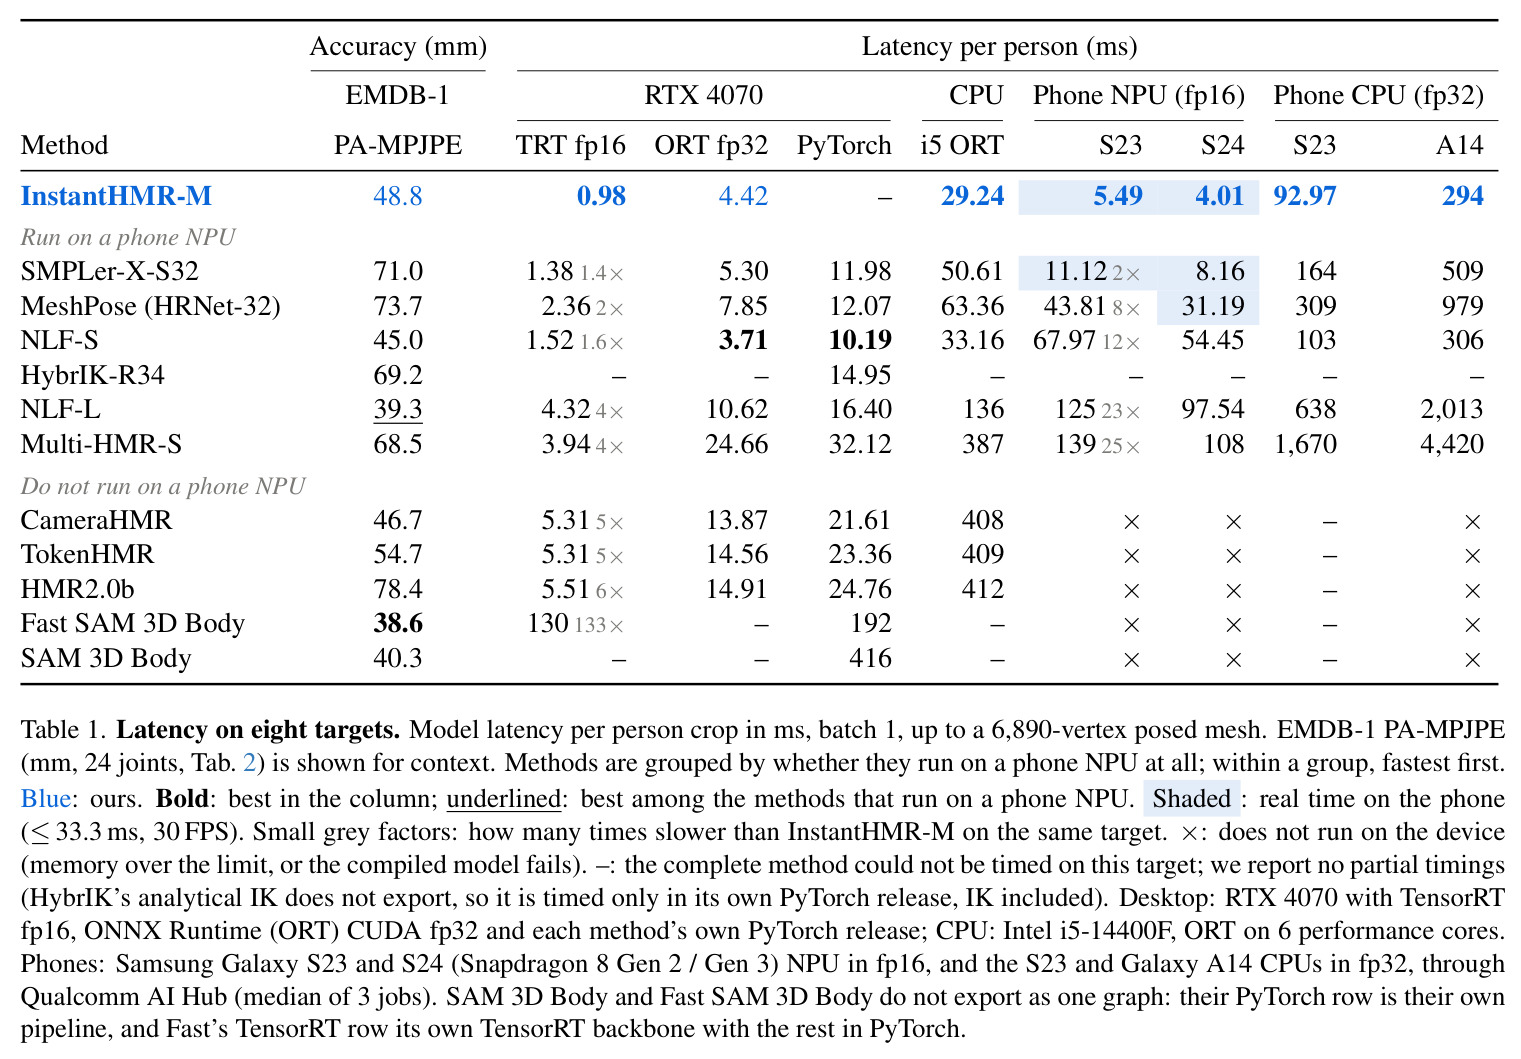
单目实时三维人体网格恢复(HMR)在机器人遥操作、居家康复训练、职业人体工效学、AR/VR 和体感游戏等场景中需要的是低延迟而非高吞吐——当前帧的姿态必须在该帧被采集时就可用。2023 年后的智能手机普遍配备 NPU,为本地推理(隐私、低功耗、免联网)提供了机会,但现有 SOTA 几乎都为 GPU 而生:SAM 3D Body 在桌面 GPU 上每人需 416 ms,完全无法在手机 NPU 上运行;NLF 是桌面 GPU 上最快的 SOTA(最小变体 1.52 ms/人),但在三星 Galaxy S23 NPU 上要 67.97 ms/人;SMPLer-X-S32 与 MeshPose 虽能在手机上达到实时(延迟低于 33 ms,即 30 FPS),却分别比高精度方法差 22 mm 以上。更麻烦的是,各论文在 3DPW/EMDB/RICH 上评测时使用不同的人体框、焦距、关节数与身体模型转换,同一模型的指标会被这些选择移动数毫米——与排行榜上方法间的差距同量级,导致跨论文比较几乎失效。
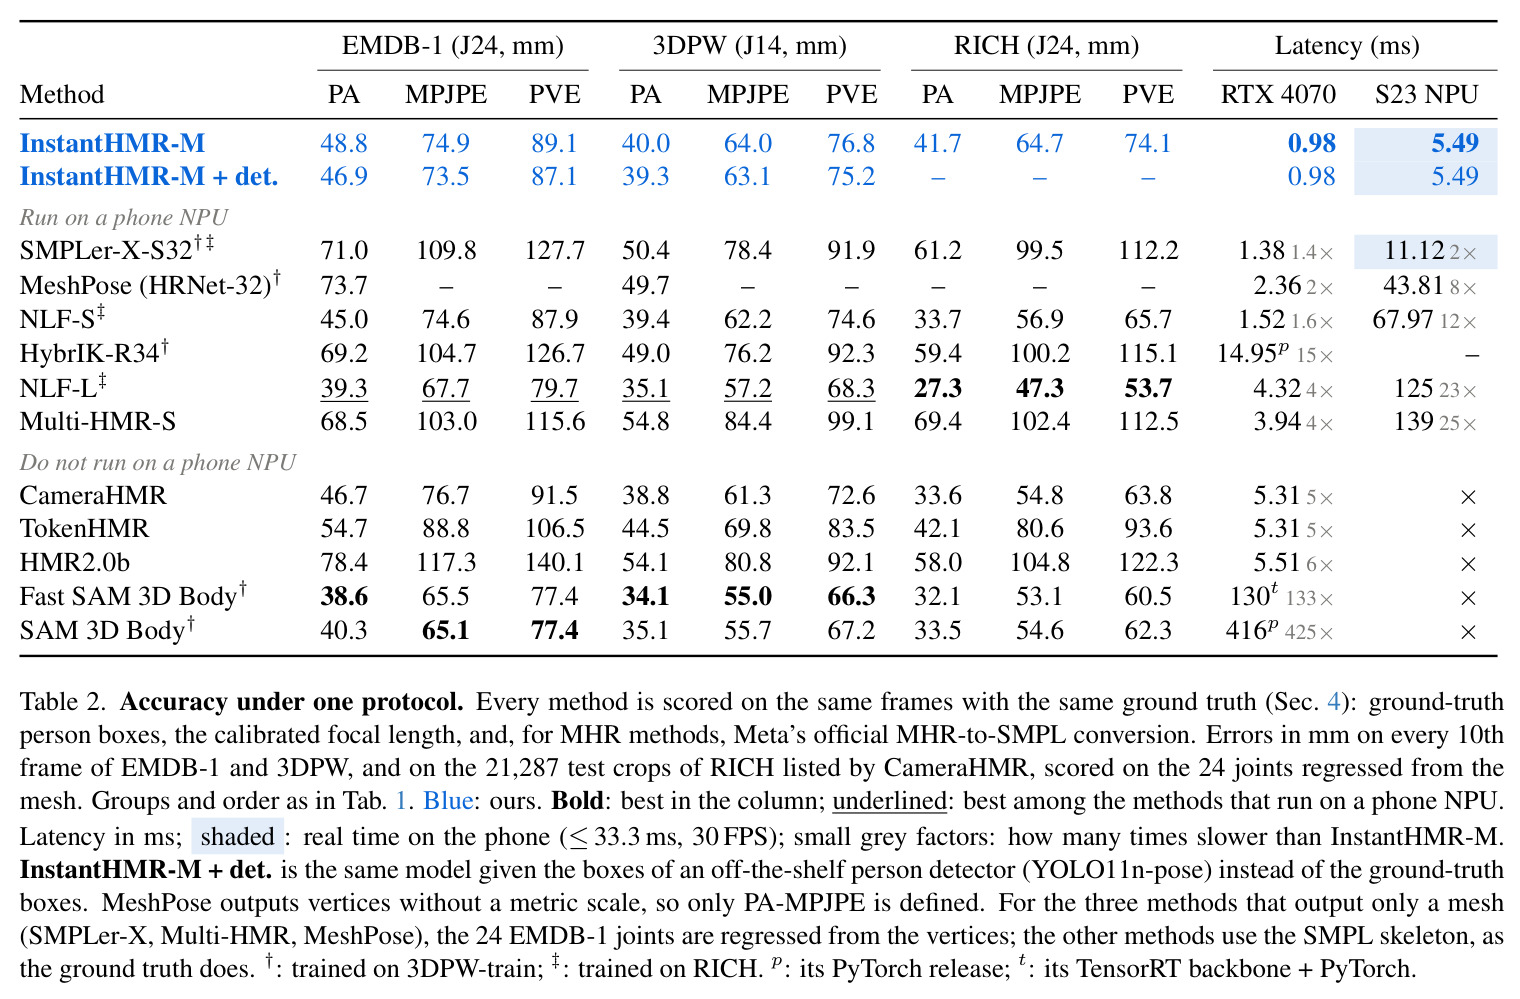
本文的目标是本文的目标是构建一组专为手机 NPU 设计的单图人体网格恢复模型,硬约束是:整个网络必须能导出为单一 ONNX 图、以 fp16 全部驻留 NPU(不落回 CPU),同时把精度损失压到最小。量化目标是在三星 Galaxy S23 NPU 上实现每人小于 33.3 ms(30 FPS)的实时延迟,并逼近桌面级 SOTA 的精度水平。作者同时希望以可复现、公平的方式与现有方法比较:固定一个统一评测协议(同一帧、同一人体框、标定焦距、Meta 官方 MHR→SMPL 转换),对 11 个 SOTA 方法逐一重测并报告各自复现其原论文的程度;并在 8 种目标硬件(RTX 4070 TensorRT/ONNX Runtime/PyTorch、i5-14400F CPU、S23/S24 NPU、S23/A14 CPU)上以完全相同的方式测量延迟,消除协议购物的空间。
与已有工作不同的是,作者的独特切入有三点。第一是表示选择:NLF 把每个网格顶点当作独立查询点、用 8×8×8 热图加权平均定位,6890 个顶点意味着大量 6890×512 大张量的 gather/reduce/softmax——这恰是 NPU 最不擅长的算子;InstantHMR 反其道,每人只回归一次 204 维 MHR 参数,网格由 rig 前向运动学(FK)与固定蒙皮权重确定性展开,全是 NPU 善长的卷积与矩阵乘。第二是数据选择:只用 Meta 随 SAM 3D Body 公开发布的人工标注 MHR 拟合结果(420 万个人体裁剪,覆盖五种来源数据集),不用任何教师模型蒸馏,学生不受教师精度上限约束。第三是评测选择:作者证明协议选择会让 InstantHMR-M 在 EMDB-1 上的 PA-MPJPE 在 46.9–50.1 mm 间波动,而学习式 MHR→SMPL 转换网络会把误差推到 65.9 mm,于是固定一个与最接近的 MHR 竞品(SAM 3D Body)对齐的协议,先定协议再给自己打分,并逐方法给出复现判定。
核心方法
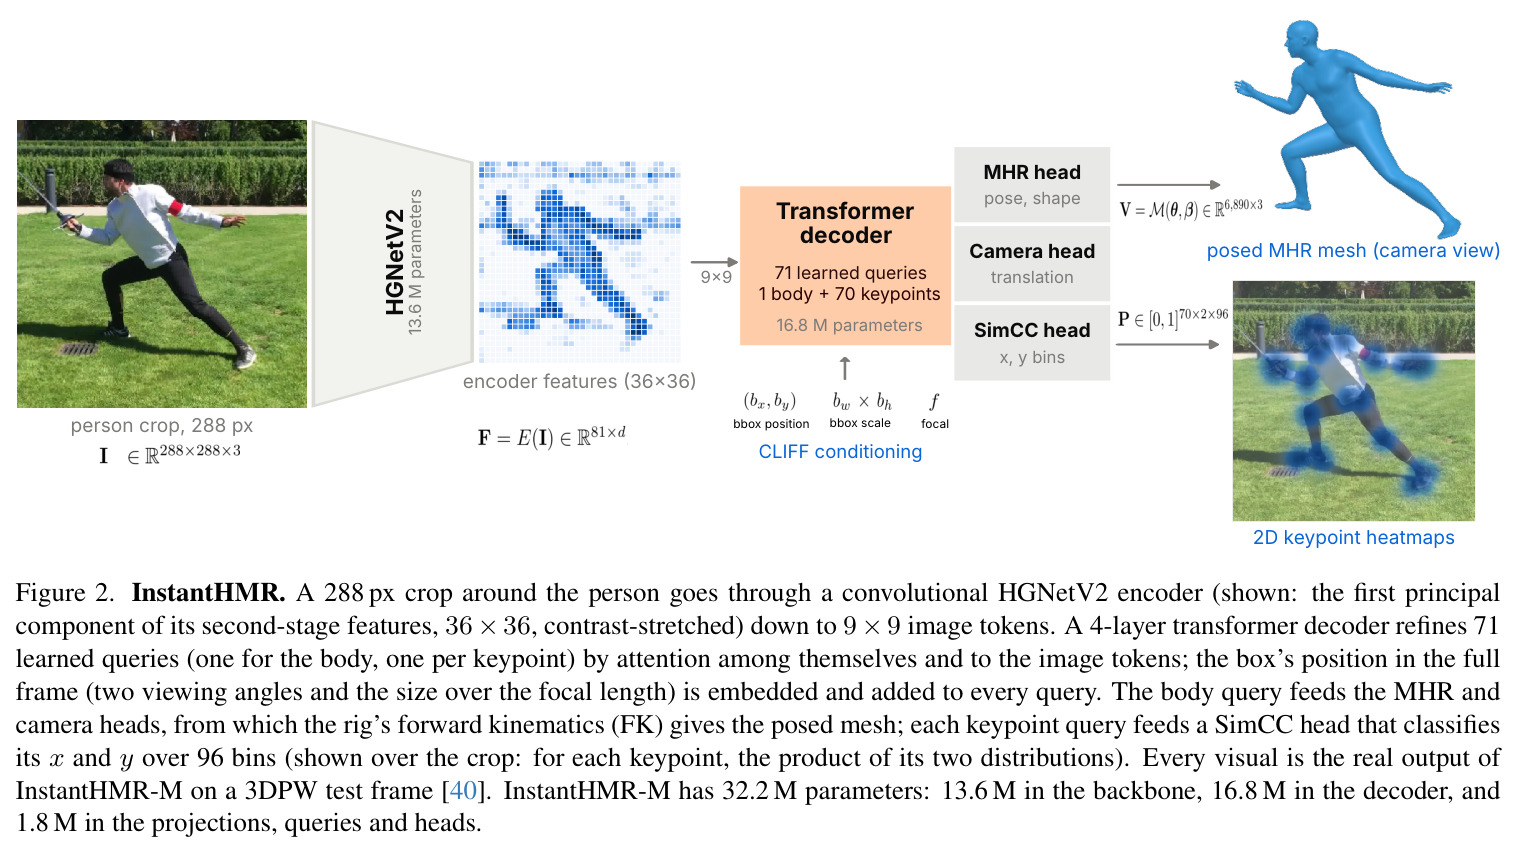
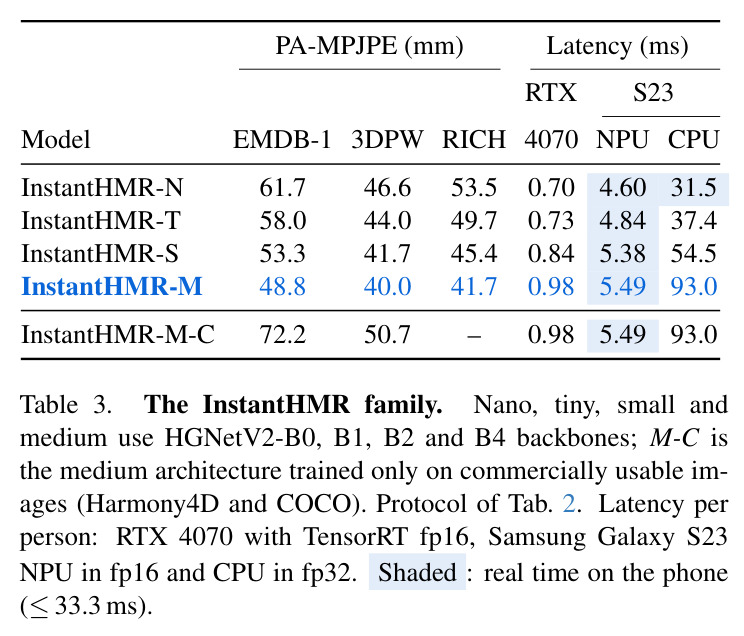
InstantHMR 把"从图像猜网格"拆成"从图像猜少数参数 + 用固定模型展开网格"两步:卷积网络读一张 288×288 人体裁剪图,输出 204 维 MHR 骨架参数 $\theta$(根变换、130 个关节参数、68 个骨长缩放)与 45 维体型系数 $\beta$,随后由前向运动学(FK)与线性混合蒙皮确定性生成 6890 顶点网格和 70 个三维关键点。技术路线:ImageNet 预训练的 HGNetV2 骨干把裁剪图编码为 9×9=81 个图像 token($d=512$);4 层 pre-norm Transformer 解码器(8 头)同时细化 71 个可学习查询(1 体查询 + 70 关键点查询);三个头分别输出 SimCC 二维关键点分布($x$、$y$ 各 96 个 bin)、相机平移 $t$ 和 MHR 参数。四个型号 nano/tiny/small/medium 只换骨干 B0/B1/B2/B4,总参数 20.0/20.3/24.4/32.2 M,解码器统一占 16.8 M。整网导出为单一 ONNX 图,fp16 下 1607 层全部驻留 S23 NPU。
核心创新是为 NPU 重新设计网格的生成方式。NLF 把每个顶点当作独立查询点、用 8×8×8 热图的分数加权平均定位,6890 个顶点意味着大量 gather、reduction、transpose、reshape 和 softmax——剖析显示这些算子占其 NPU 时间的 71%,卷积不足 2%;把查询点降到 1048 个就能从 68 ms 降到 8.1 ms,坐实了瓶颈所在。InstantHMR 相反:每人只回归 204 维参数一次,网格由 rig 的 FK 与固定蒙皮权重的线性求和得到,成本与网络无关,全部落在 NPU 为之设计的算子上。其次,70 个三维关键点不是独立回归,而是从摆好姿势的 rig 的前向运动学中读出,网格与关键点由同一组参数决定、永不矛盾。第三,CLIFF 式条件化改用焦距表达裁剪框位置(视角角与 $\max(b_w,b_h)/f$),跨相机语义一致。第四,骨长缩放系数被限制在训练分布范围内——否则骨长在 FK 中乘性累积,一次大预测就能产生数百米高的骨架、让训练发散。根平移固定为零,人体位置完全由相机平移头负责。
方法步骤详情
①输入:288×288 人体裁剪图 $I$ 与裁剪框全图位置 $c$(CLIFF)。②编码:HGNetV2 输出 9×9 特征,投影到 512 维加正弦位置编码,得 81 个图像 token;$c$ 经 MLP 嵌入加到每个查询上。③解码:71 个查询经 4 层解码器自注意力并交叉关注图像 token,输出查询特征。④三头输出:体查询 $z_0$ 进两层 MHR 头(6D 连续参数化)得 $(\theta,\beta)$,线性相机头给平移 $t$;关键点查询经共享 SimCC 头输出 96 bin 分布,期望即 2D 关键点。⑤网格生成:MHR rig 经 FK 与蒙皮输出 6890 顶点网格与 70 个 3D 关键点,二者同源永不矛盾。训练用 420 万 SAM 3D Body 人工标注(五来源按 43/26/14/13/4% 采样),AdamW、batch 256,训练 600 个 epoch。损失为 11 项加权和:参数对齐、FK 几何(70 关键点/595 顶点/127 关节,非平方欧氏距离)、图像侧(SimCC 交叉熵与重投影);手指权重 0.2,前 2000 步渐入。
技术新颖性
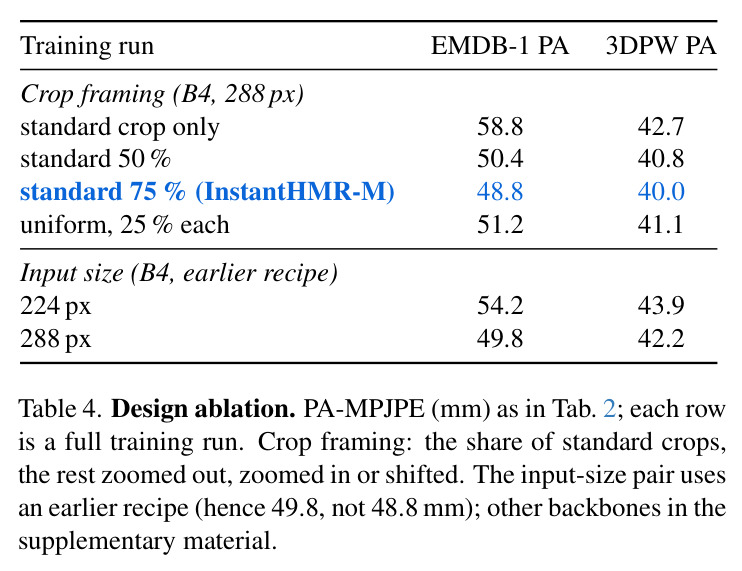
新颖性不在单个模块,而在表示、数据、评测三层的系统性协同设计。架构上,它证明"小型 DETR 式查询解码器 + 参数化人体模型展开"可以整图编译并全层驻留手机 NPU(fp16、1607 层无一回退 CPU),而所有 ViT/DINOv3 骨干的 SOTA(SAM 3D Body、Fast SAM 3D Body、CameraHMR、TokenHMR、HMR2.0)要么内存超限要么编译失败。数据上,仅用公开人工标注而非蒸馏,并用消融证明裁剪取景混合(75% 标准裁剪 + 拉远/拉近/偏移三种取景,配合成遮挡)是单项最大增益:EMDB-1 PA-MPJPE 从 58.8 降到 48.8 mm(-10.0 mm),超过输入 224→288 px 的 4.4–5.5 mm。评测上,首次给出"复现判定":逐方法在其自己的代码与权重下重跑,与原文打印值差距小于 1 mm 算复现,并量化协议选择的影响区间(EMDB-1 上 46.9–50.1 mm),公开 Meta 官方 MHR→SMPL 转换下的统一分数。这种"先承认协议购物、再统一重测"的做法本身对 HMR 社区有方法论价值。
实验结果
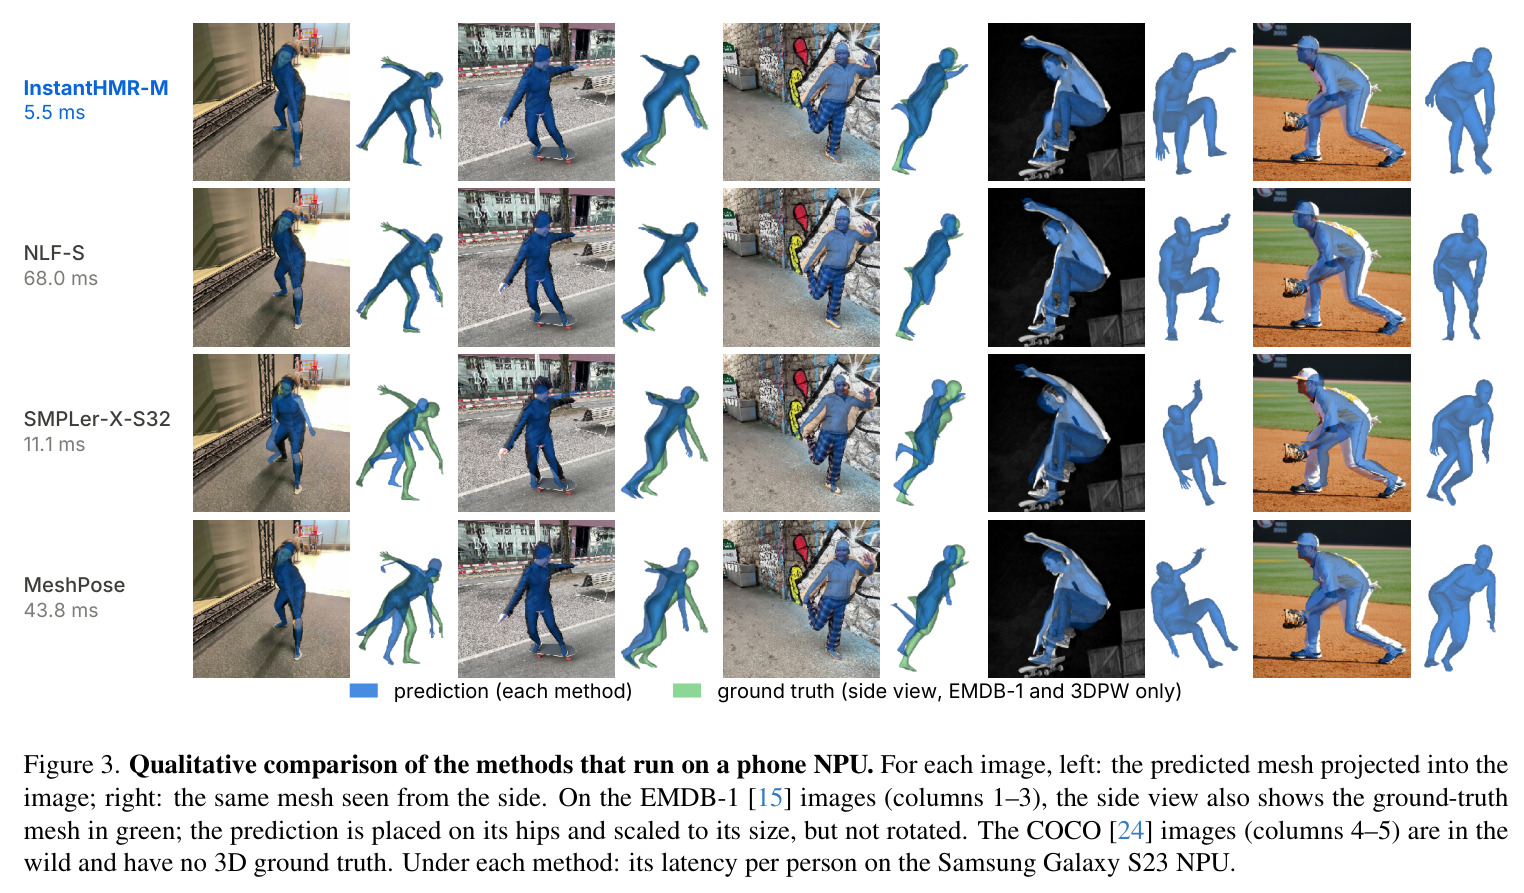
S23 NPU 上 InstantHMR-M 每人 5.49 ms(4070:0.98),全场最快。更准且能上 NPU 的仅 NLF-S/NLF-L,慢 12×/23×(67.97/125 ms);同样实时的 SMPLer-X-S32(11.12 ms)差 22 mm。精度(统一协议):EMDB-1 PA-MPJPE 48.8、3DPW 40.0、RICH 41.7 mm,比 SMPLer-X 等四方法好 20–25 mm(EMDB-1)、9–15 mm(3DPW),3DPW 上距 NLF-S 仅 0.6 mm。桌面级 Fast/SAM 3D Body 更准(38.6/40.3)但需 130/416 ms。换检测框反而更好(46.9/39.3)。家族 N/T/S/M 的 EMDB-1 为 61.7/58.0/53.3/48.8 mm,NPU 延迟仅 4.60→5.49,故选 medium;但 S23 CPU 上 31.5→93.0,唯 nano 实时。商用版 M-C 掉到 72.2 mm:数据比架构更关键。复现上 NLF-S/TokenHMR 达标、HMR2.0b 差 9.9 mm。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 3D人体网格恢复(EMDB-1) | PA-MPJPE (mm) | 48.8 | NLF-S 45.0(慢12×)/ NLF-L 39.3(慢23×);可实时的 SMPLer-X-S32 71.0 | 比唯一同样实时的方法好22.2 mm,且延迟仅5.49 ms |
| 3D人体网格恢复(3DPW) | PA-MPJPE (mm) | 40.0 | NLF-S 39.4、SMPLer-X-S32 50.4、MeshPose 49.7 | 与NLF-S仅差0.6 mm但快12×,比SMPLer-X好10.4 mm |
| 3D人体网格恢复(RICH) | PA-MPJPE (mm) | 41.7 | NLF-S 33.7(训练用了RICH,慢12×)、SMPLer-X-S32 61.2、Multi-HMR-S 69.4 | 比SMPLer-X等快19.5–27.7 mm;仅NLF更准且慢12× |
| 手机NPU推理延迟 | ms/person(S23 NPU, fp16) | 5.49 | NLF-S 67.97、NLF-L 125、SMPLer-X-S32 11.12、MeshPose 43.81 | 全场最快:对NLF-S/NLF-L提速12×/23×,对SMPLer-X提速2× |
| 桌面GPU推理延迟 | ms/person(RTX 4070, TensorRT fp16) | 0.98 | SMPLer-X-S32 1.38、NLF-L 4.32、SAM 3D Body 416(PyTorch) | 对SAM 3D Body提速约425×,对所有可测方法最快 |
局限与改进
作者承认的限制:没有专门的手部编码器或解码器,手指与全身共享同一 288×288 裁剪和 9×9 图像 token,一只手只占几个像素,而 SAM 3D Body 有第二级手部解码器;手机实测仅限高通 NPU(Galaxy S23/S24),未测苹果 Neural Engine;逐帧独立推理,未报告抖动等时序指标,仅在 demo 中附 1 Euro 滤波;因部分训练图像仅限科研使用,四个模型只能非商用,商用版 M-C 精度差 23.4 mm。我自己的观察:其一,"实时"仅指模型延迟,不含检测与裁剪的端到端流水线延迟,真实应用还须除以人数;其二,统一协议用 GT 人体框与标定焦距,实际部署中焦距默认值(1.05×对角线)与检测框质量的敏感性只顺带提及(det 框反而好 1.9 mm),未系统分析;其三,Meta 官方 MHR→SMPL 转换平均引入 0.67 mm 误差,与 SMPL 生态历史结果比较存在系统偏置;其四,评测用每 10 帧抽样与 CameraHMR 列出的 RICH 裁剪,作者称全帧影响不超过 0.3 mm,但覆盖面仍窄于完整基准。
独立分析的弱点
第一,手部精度:论文明确手指关键点在 3D 与重投影项中权重仅 0.2,等于承认手指不可靠,而康复训练恰是手部动作密集的场景;改进方向是加轻量手部分支(如对低分辨率手部区域再跑一次 SimCC 头),或借鉴 SAM 3D Body 的手部二次解码器但压缩到 NPU 预算内。第二,无时序建模:逐帧独立导致 AR/VR 与工效学评估敏感的抖动未被度量,可在线蒸馏 WHAM 式时序先验,或把 1 Euro 滤波参数学习化并纳入评测。第三,数据许可割裂:商用版 M-C 与研究版差 23.4 mm,根源是许可图像只有 50 万张;可行方向是用 Anny/MakeHuman 合成海量可商用数据做域随机化。第四,评测对 GT 框与标定焦距的依赖:真实部署没有 GT 框,建议系统报告不同检测器质量与焦距估计误差下的性能曲线。第五,单人体假设:多人同框需逐人裁剪多次前向,总延迟随人数线性增长,可探索 Multi-HMR 式一次解码多人或共享 token 的批量推理。第六,6890 顶点是 MHR 18,439 顶点网格的下采样子集,体型细节在降采样中丢失,可能限制高保真渲染场景的表现。
未来方向
作者明确提出的方向:加入不牺牲手机 NPU 实时性的轻量手部分支;在苹果 Core ML / Neural Engine 上验证与测量;评估时序抖动,对比有无 1 Euro 滤波的表现。基于本文成果可自然延伸:其一,把"参数回归 + FK 展开"范式移植到 SMPL-X 或 SOMA 统一拓扑,覆盖手与脸,同时保持整图可编译;其二,把 InstantHMR 作为 WHAM、GEM-X 等视频方法的每帧前端,研究实时在线世界坐标系跟踪的端到端延迟;其三,做量化感知训练探索 int8 路径,把 medium 塞进无可用 NPU 的低端手机 CPU 并保持实时(目前只有 nano 能到 31.5 ms);其四,用 SAM 3D Body 模型在更多许可图像上打伪标签蒸馏,突破数据规模上限(需权衡教师上限与许可);其五,在机器人遥操作与远程康复的闭环控制中报告任务级指标(如 REBA 姿势风险评估与真值的一致性),把毫米级精度差距翻译成下游价值;其六,把这套含 11 方法复现判定的统一评测框架扩展为社区基准。
复现评估
复现条件很好。代码 Apache-2.0,四个研究版模型(非商用)与商用版 M-C 均在 GitHub(Naturalpad-studio/InstantHMR)公开;训练标签完全来自 Meta 随 SAM 3D Body 发布的人工标注 MHR 拟合与公开数据集图像,无私有数据。训练成本为 4 GPU、600 epoch×40 万样本、batch 256、AdamW one-cycle 峰值 $6\times10^{-4}$,属中型规模。评测对第三方友好:论文逐方法给出复现判定(如 HMR2.0b 在统一协议下比原文差 9.9 mm,NLF-L 反而好 1.9–2.2 mm),并量化协议选择的影响区间(EMDB-1 上 46.9–50.1 mm);延迟用 Qualcomm AI Hub 在物理设备上测得,可复验。主要门槛:MHR 模型、SAM 3D Body 标注与 3DPW/EMDB/RICH 基准均需各自申请许可;完整复现 11 个竞品需较多工程整合;手机端验证需 S23/S24 真机或 AI Hub 账号。总体难度中等:跑推理与评测容易,重训与全竞品重测的门槛在许可与算力。
论文图表
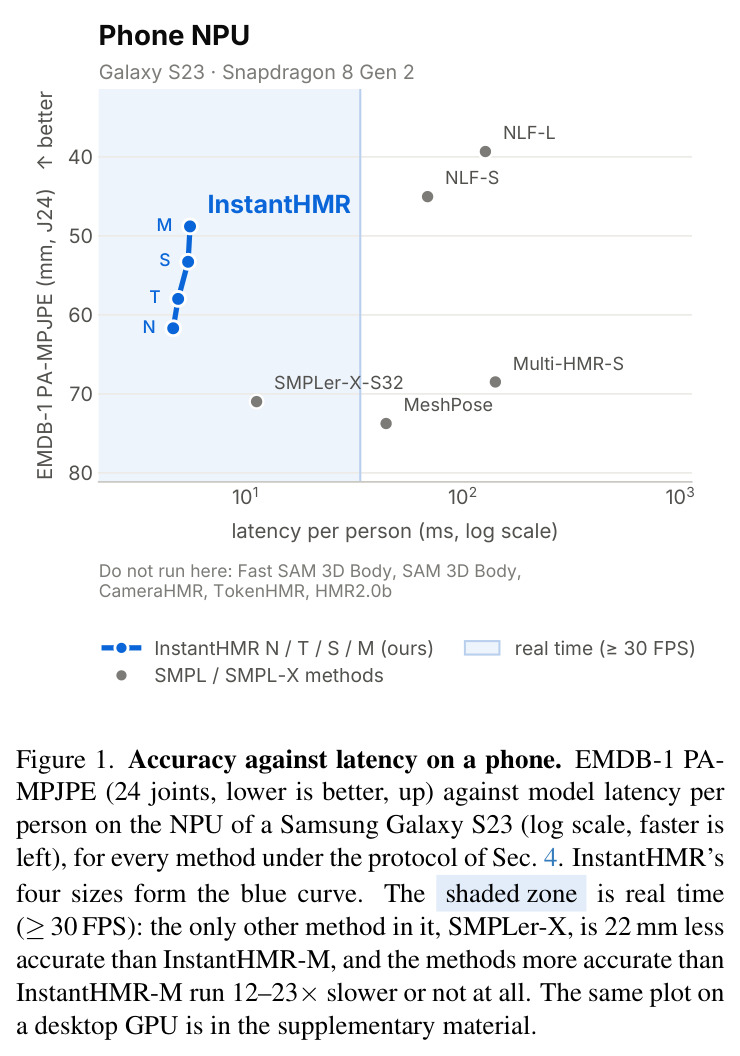
横轴为 Samsung Galaxy S23 NPU 上每人的推理延迟(ms,对数刻度,越左越快),纵轴为统一协议下 EMDB-1 的 PA-MPJPE(24 关节,mm,越上越准)。InstantHMR 的 N/T/S/M 四个型号构成蓝色曲线,全部落入实时区(≥30 FPS 阴影区);图中唯一同样实时的 SMPLer-X-S32 比 InstantHMR-M 差约 22 mm,而比它更准的 NLF-S/NLF-L 分别慢 12×和 23×,Fast SAM 3D Body、SAM 3D Body、CameraHMR、TokenHMR、HMR2.0b 则根本无法在手机 NPU 上运行。
一图讲清本文全部卖点:在"实时"约束下 InstantHMR-M 位于精度-延迟前沿的帕累托最优位置,是论文动机与结论的浓缩,也解释了为什么要把 11 个方法拉到同一协议下重测。