VFlash:基于闪光基元解码的快速精准视觉规划 VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding
利用视觉基元的已知结构并行解码整段坐标块,让物理AI的视觉规划更快更准
前置知识
推测解码(Speculative Decoding)
一种加速自回归大模型推理的技术:用一个轻量草稿模型快速猜出若干后续 token,再让目标模型在单次前向中并行验证。贪心验证只接受与目标输出一致的最长前缀并补上目标的修正 token,因此理论上不改变目标模型的输出分布。平均每 token 延迟可写为 $L = (T_{\text{draft}} + T_{\text{verify}})/\tau$,其中 $\tau$ 是每轮平均被接受的 token 数——$\tau$ 上不去,块再长也没用。
VFlash 的整套解码框架建立在推测解码之上,只有理解'草稿+验证+接受'这套机制,才能明白它究竟改动了哪一环。
块扩散草稿模型(DFlash)
DFlash 提出的草稿器架构:一个浅层非因果(双向注意力)Transformer,把目标模型若干层的特征拼接后投影,作为键值注入草稿层;给定起始 token 后在单次双向前向中同时预测块内所有掩码位置,把草稿成本从逐 token 的 $\gamma \cdot t_{\text{step}}$ 压缩为一次并行前向 $t_{\text{par}}$。但它仍依赖目标模型逐 token 验证来保持输出分布。
VFlash 直接沿用 DFlash 的五层草稿器架构,创新不在草稿器本身,而在训练目标与接受准则这两处。
视觉基元(Visual Primitive)
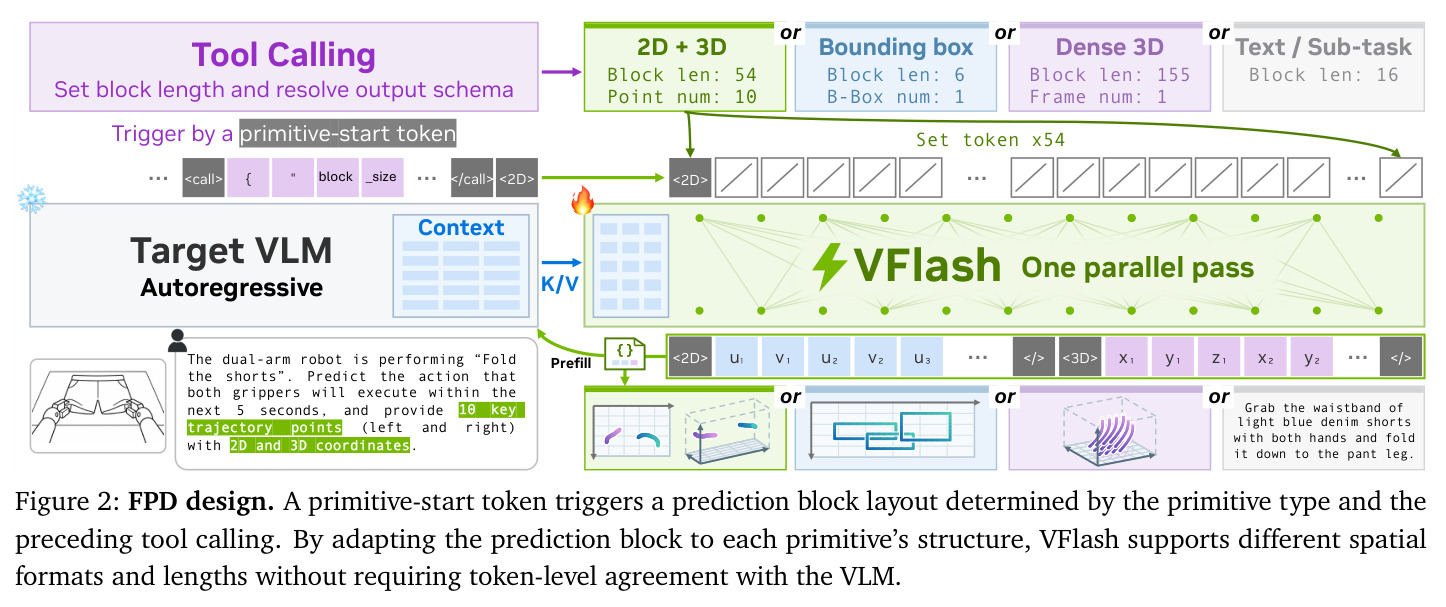
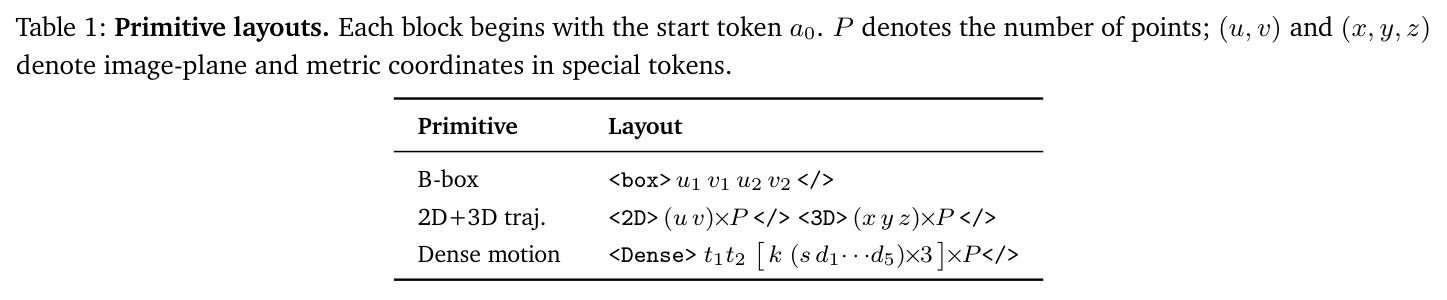
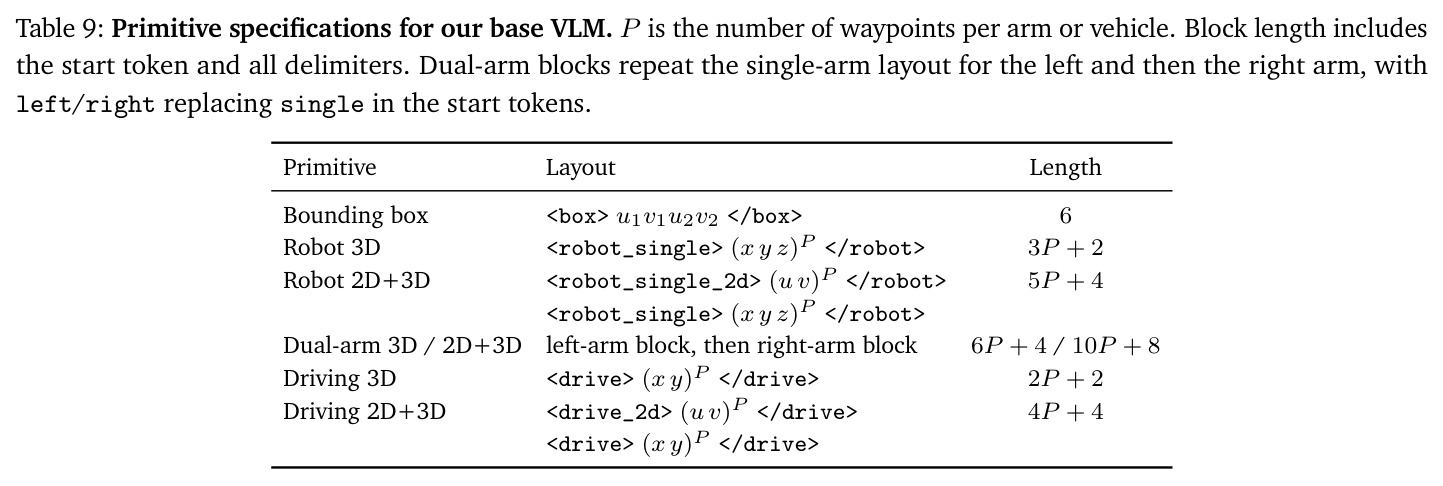
物理 AI 中结构化的空间输出:边界框、二维/三维轨迹点列、稠密点运动等。每个基元有确定的类型、维度和长度;一旦由工具调用声明这些属性,块的边界 token 与坐标槽位布局就完全已知,例如双臂 2D+3D 轨迹固定为 54 个 token 的 $\langle 2D\rangle(u v)^P\langle/2D\rangle\langle 3D\rangle(x y z)^P\langle/3D\rangle$ 块。
'基元结构在解码前已知'是全文所有并行化收益的来源,也是绕过逐 token 验证、直接整块接受的前提。
约束解码(Constrained Decoding)
推理时按位置把 logits 限制在合法词表内:分隔符位置只允许对应分隔符 token,坐标位置只允许数字 token;跨位置规则(框角点须满足 $u_1 < u_2$ 且 $v_1 < v_2$、越界标记 $\langle oof\rangle$ 成对出现)通过对已算出的 logits 做小型选择循环解决,不引入任何额外神经前向。
VFlash 用 schema 结构校验替代逐 token 验证,约束解码是把'结构有效'落到实现层面的具体手段。
KV 缓存与隐状态条件化
自回归模型为已生成序列缓存注意力键值(KV cache),新增 token 只需一次增量前向;下游动作模型(世界动作模型、DiT 策略、扩散驾驶头)通常通过交叉注意力读取 VLM 的隐藏状态作为条件。VFlash 让目标模型对整个已接受的基元做一次前向,一次性完成缓存更新、上下文特征提取和动作头所需隐状态的产出。
这解释了为什么接受几十 token 的基元只需一次目标前向,以及视觉规划如何被下游动作模型消费。
研究动机
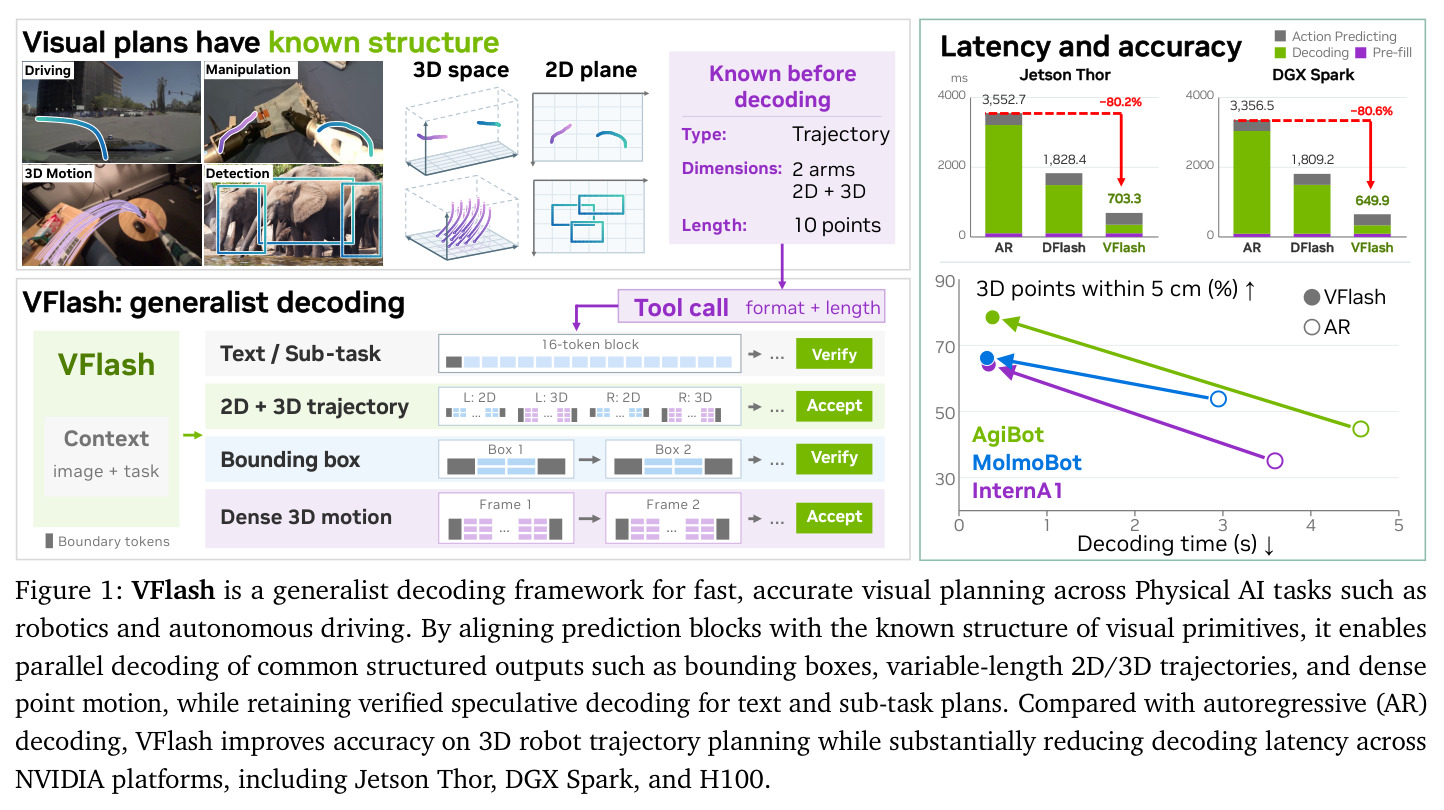
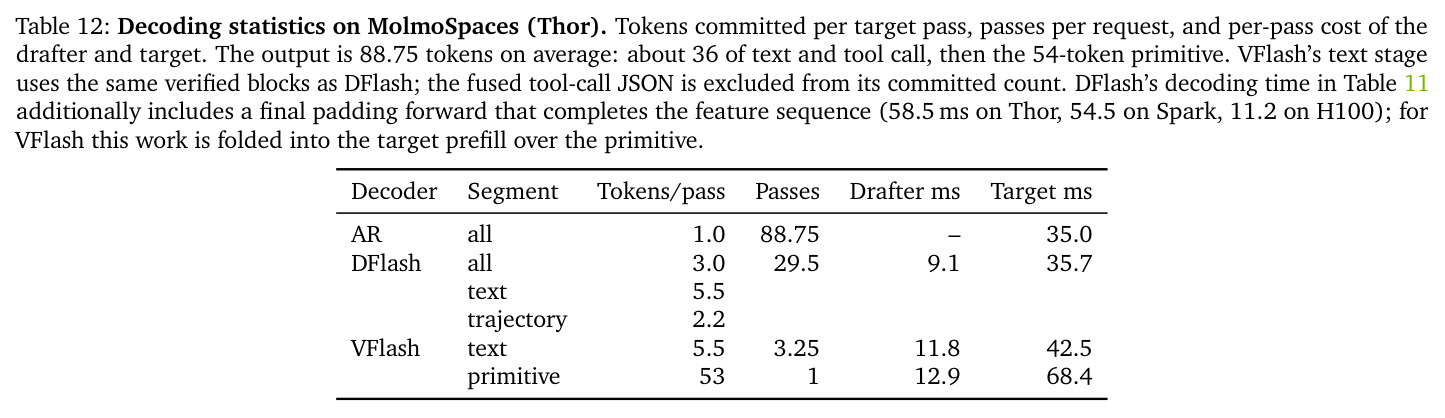
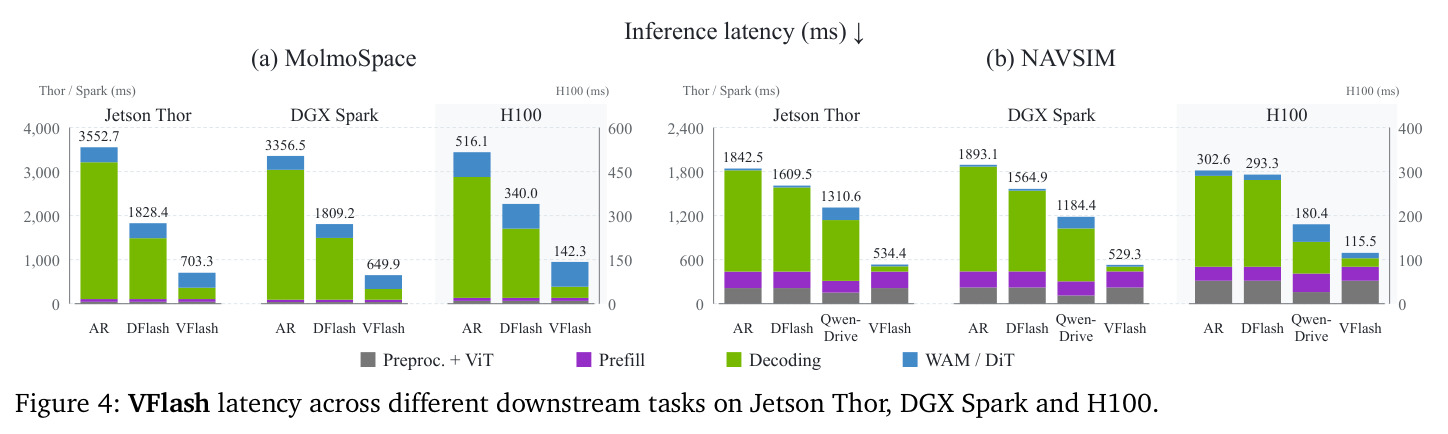
视觉-语言模型正成为机器人和自动驾驶系统的高层'大脑',但它们的规划输出——点、边界框、轨迹等视觉基元——仍由自回归解码逐 token 生成。空间细节越丰富,串行代价越高:NAVSIM 要求 4 秒 8 个路径点、Waymo 要求 5 秒 20 个,双臂机器人的 2D+3D 轨迹(每臂 10 点)序列化后长达 54 个 token,AR 需要约 53 次顺序前向。而在物理 AI 部署最常见的 batch size 为 1 的边缘场景下,这种串行性直接击穿延迟预算:论文在 Jetson Thor 上实测每次 4B VLM 前向需 35–39 ms,AR 解码占整个规划步延迟的 75–87%,MolmoSpaces 单步规划仅解码就耗时约 3.1 秒。已有加速方案也不理想:块扩散推测解码 DFlash 依赖逐 token 验证,实测它在轨迹段内每轮平均只接受 2.2 个 token——坐标哪怕只偏一个量化 bin、几何误差极小,也会因与目标的 token 不一致而被截断接受,整个解码时间只能砍半。
本文的目标是本文要让 VLM 以远少于 token 数的顺序前向次数生成完整视觉规划,同时提升而非牺牲空间精度,并在真实下游任务中验证规划质量。具体目标包括:用一个轻量草稿器在单次前向中预测整个基元(几十到上百个 token),布局随基元类型、维度和长度自适应,覆盖 6-token 的紧凑框到 84-token 的驾驶轨迹;对普通文本保留带目标验证的推测解码,对结构有效的视觉基元则整块直接接受、不做逐 token 一致性校验;在 2D/3D 轨迹、检测框、稠密点运动四类预测任务上系统性降低误差,在 MolmoSpaces 操作与 NAVSIM/Waymo 驾驶两条下游流水线中提升成功率,并把 Jetson Thor、DGX Spark 等边缘平台上的单步延迟降低约 80%。
与已有工作不同的是,既有工作的共同盲点是默认'无损'是金标准:Leviathan 等的经典推测解码、EAGLE、DFlash 都通过逐 token 验证严格保持目标模型输出分布;Spec-VLA 虽提出放宽接受,但仍逐个对照目标验证动作 token,每轮只提交 2.10–2.94 个 token;LocateAnything 实现了框的并行解码,却局限于定长 2D 基元。VFlash 抓住一个被忽视的事实:视觉输出的质量应当按照空间精度和对下游动作的有用性来评判,而不是按是否复现目标模型的 token 序列。据此它做了两个反向决策——草稿器直接在人工标注坐标上训练(而非拟合目标模型的续写分布),推理时对结构有效的基元整块接受。由此得到全文最有意思的观察:轻量扩散草稿器的空间精度竟能超过它的自回归目标模型,说明 AR 逐 token 解码并不是视觉输出的质量上限。
核心方法
直觉上,VFlash 把'逐字写一段话'变成'一次性填一张格式已知的表格'。请求视觉基元时,其类型、维度和长度由前置工具调用确定,例如 $\langle\text{tool\_call}\rangle\{\text{"name":"atomic\_decoding","arguments":\{"block\_size":54\}}\}\langle/\text{tool\_call}\rangle$ 加上起始 token 就锁定了每个位置的角色——哪些是分隔符、哪个是路径点、哪一位属于哪个坐标轴。既然表格格式已知,就不必一个格子一个格子串行填写。技术路线上,VFlash 以 DFlash 为底座:冻结的自回归目标 VLM(Qwen3-4B + 原生分辨率 MoonViT 编码器 + MLP 连接器)提供上下文特征 $H_\theta(x)$,一个 5 层、5.37 亿参数的非因果草稿器在单次双向前向中按 $q_\varphi(a_{1:B(s)-1} \mid H_\theta(x), a_0) = \prod_{j=1}^{B(s)-1} q_{\varphi,j}(a_j \mid H_\theta(x), a_0, \mathrm{MASK}_{B(s)-1})$ 联合预测整个块;推理时施加逐位置词表约束,通过 schema 校验(框额外叠加 LocateAnything 的空间置信守卫)的块整块接受,失败则保留前 $r$ 个槽位、其余由约束 AR 重生成。接受一个合法基元的成本是 $L_{\text{dir}} = (t_{\text{par}} + t_{\text{target}})/B(s)$,对 36–84 token 的基元远低于逐 token 的 $t_{\text{target}}$。普通文本仍走 16-token 带验证的 DFlash 路径,两条路径共享同一草稿器、目标模型和 KV 缓存。
核心创新是'边界对齐 + 位置对齐 + 直接接受'三件套,本质区别在于彻底抛弃了 token 级一致性这一约束。边界对齐决定'什么被一起预测':每个草稿块恰好覆盖一个完整基元,而非 DFlash 式的固定 16-token 窗口,避免把一个几何对象切碎到多个块里、草稿器看不到整体形状;位置对齐决定'每个位置预测什么':每个槽位在解码前就确定角色(路径点、坐标轴或分隔符),从而支持并行预测和逐位置约束。最关键的是接受准则的替换:把贪心验证中'接受到第一个不匹配为止'的 $\tau_{\text{ver}}$ 换成 $\tau_{\text{dir}}$——schema 有效即接受全部 $B(s)$ 个 token,完全不看目标模型是否同意。训练信号也随之改写:损失 $\mathcal{L}_{\text{prim}} = -\sum_{j=1}^{B(s)-1} w_j \log q_{\varphi,j}(a_j \mid H_\theta(x), a_0, \mathrm{MASK})$ 的标签 $a_j$ 来自人工标注坐标而非目标模型的续写,基元位置用均匀权重 $w_j$(文本路径才用 DFlash 的指数衰减权重)。正因优化目标从'复现目标 token 序列'变为'空间上更准',草稿器才能在轨迹预测上反超其 AR 目标——这是全文最具洞察力的发现。
方法步骤详情
训练分两阶段。第一阶段把基座 VLM(Qwen3-4B,36 层、宽度 2,560,配 MoonViT-SO-400M 原生分辨率编码器和两层 MLP)在任务数据上做完整的下一 token 监督微调,适配空间响应格式:图像坐标归一化到 0–1,000,3D 坐标在 $[-5,5]\times[-5,5]\times[0,10]$ 米内均匀量化为 1,001 个特殊 token(1 厘米分辨率),基元由 $\langle box\rangle$、$\langle 2D\rangle$、$\langle 3D\rangle$ 等类型化起止 token 定界;随后冻结目标。第二阶段训练草稿器:5 个全宽 Qwen3 层(32 查询头、8 KV 头、FFN 宽 9,728),共享目标的输入嵌入与输出投影;取目标第 1、9、17、25、33 层(零基)拼接为 12,800 维状态,投影到 2,560 维并 RMS 归一化后作为键值注入。每个标注基元贡献一个完整块,按式 (4) 做加权交叉熵:基元位置权重为 1、越界标签降权 0.1;另采样至多 512 个普通文本锚点,使一个草稿器同时服务文本验证路径与基元直通路径;打包注意力保证块间与样本间不泄漏标签。推理时(算法 1):先以 16 位置 DFlash 块解码文本并生成工具调用;一旦接受前缀出现基元起始 token,立即按声明的 schema 起草整个 $B(s)$ 长度的块——草稿器单次前向输出全部位置,分隔符固定、坐标位置限制在数字词表、框角点排序等跨位置规则在已算出的 logits 上解决;随后目标模型对整块做一次前向,更新 KV 缓存、提取动作头所需隐状态并产出下一 token。校验通过则整块提交;失败则回滚缓存、保留前 $r$ 个槽位(轨迹 $r=0$,框保留到第一个不确定坐标之前),其余由约束目标 AR 重生成。
技术新颖性
与最接近的工作逐项对比可以看清其位置:DFlash 用块扩散草稿加速但严格保持目标分布,VFlash 保留其草稿架构却替换了接受准则,并改用标注坐标训练;Medusa/EAGLE 等多 token 预测同样以 token 一致性为纲。LocateAnything 首次实现框的并行解码,但仅支持定长 2D 基元;VFlash 把'以结构为单位解码'推广到可变长度的 2D/3D 轨迹和稠密点运动,并统一处理两种坐标表示——专用特殊 token(1,001 个数字 token)与纯文本 tokenization(每个坐标用符号位加五个数字位的定宽网格、高位补 mask token,再渲染回目标文本格式),因此可以不加改动地接到 MolmoMotion 这类已发布模型上。Spec-VLA 的放宽验证仍需逐 token 对照目标,每轮提交 2.10–2.94 个 token,而 VFlash 在 MolmoSpaces 上实测每轮提交 53 个 token。从系统视角看,论文把 Kahneman 的 System-1 概念引入 VLM 视觉规划:快速、类型化、整体输出的几何预测。
实验结果
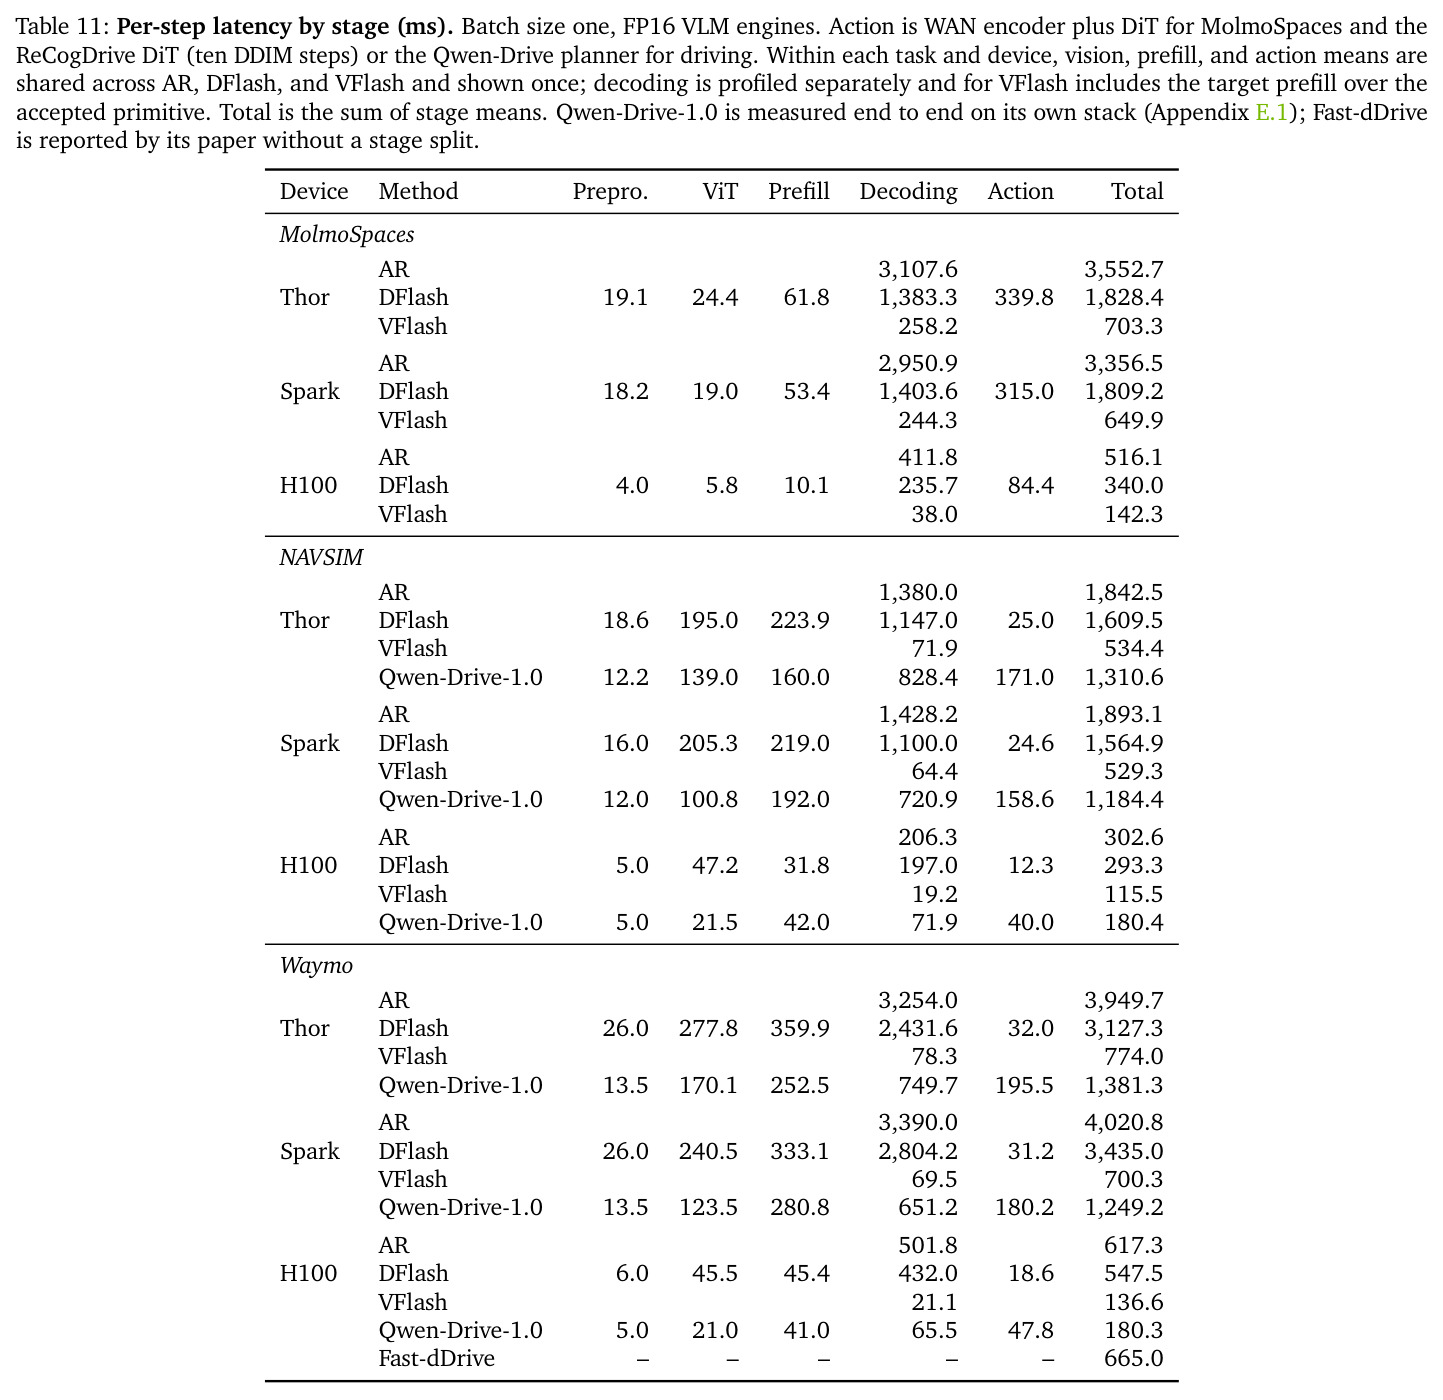
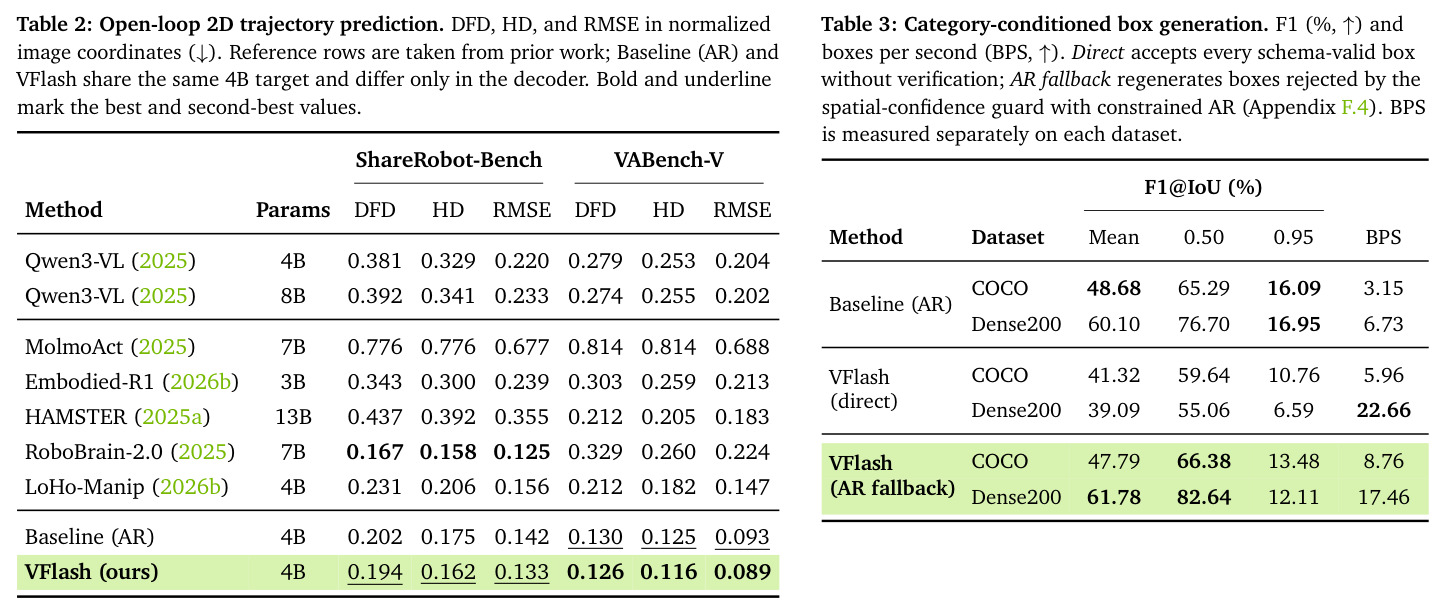
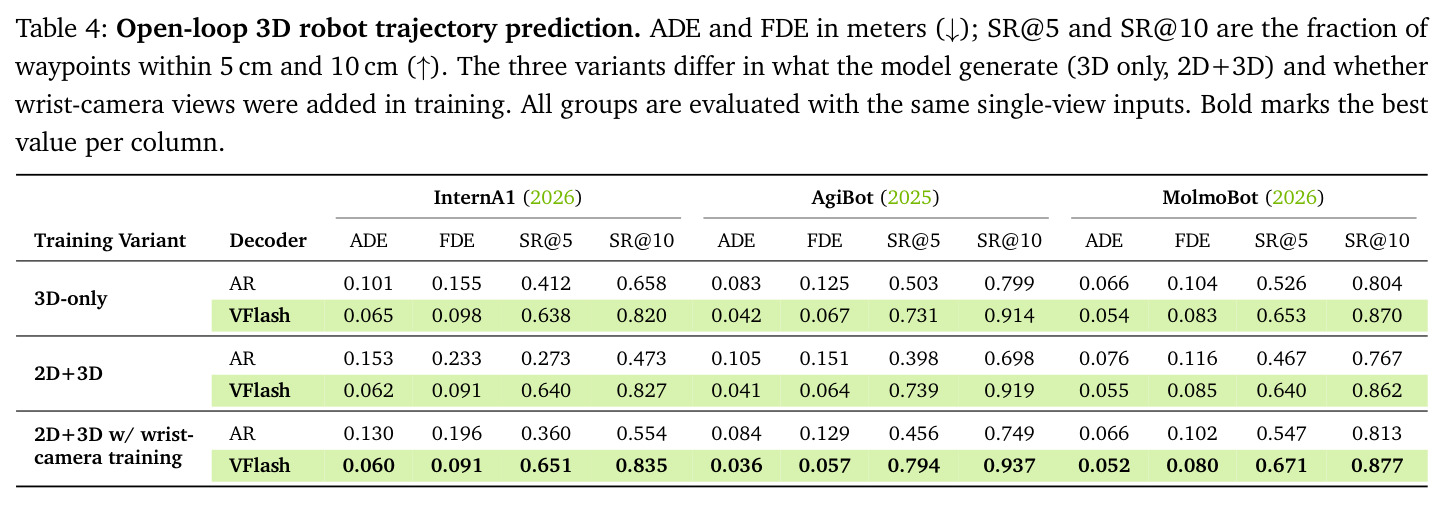
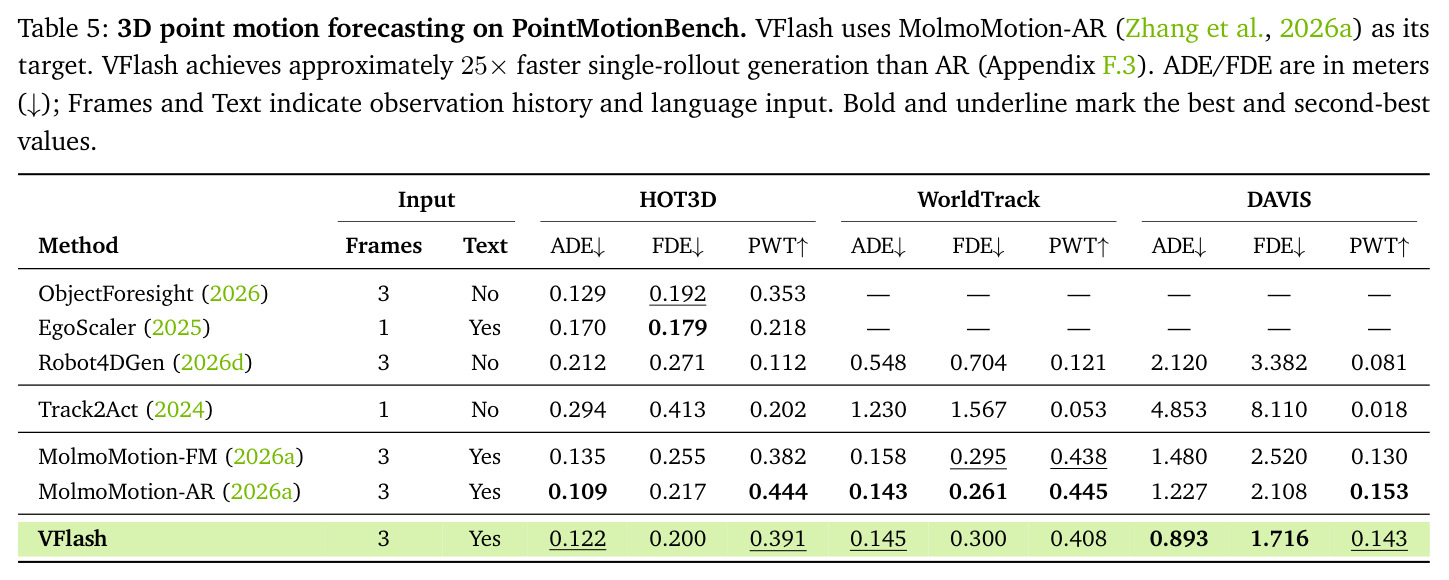
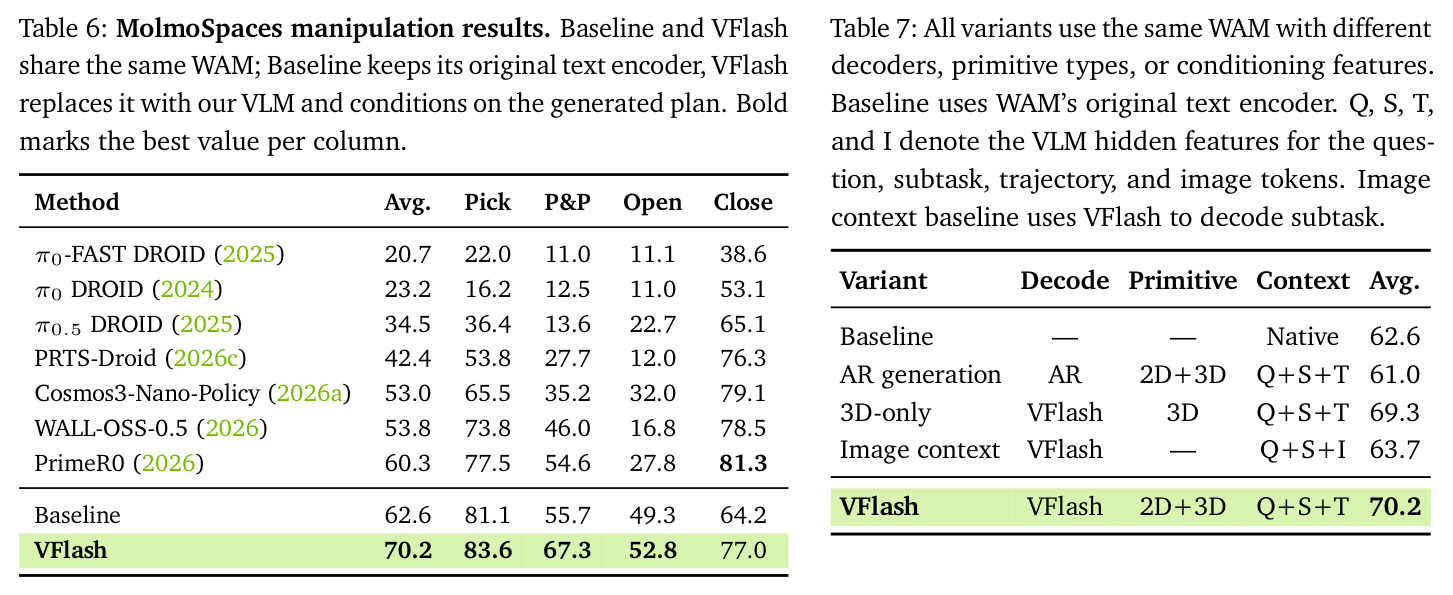
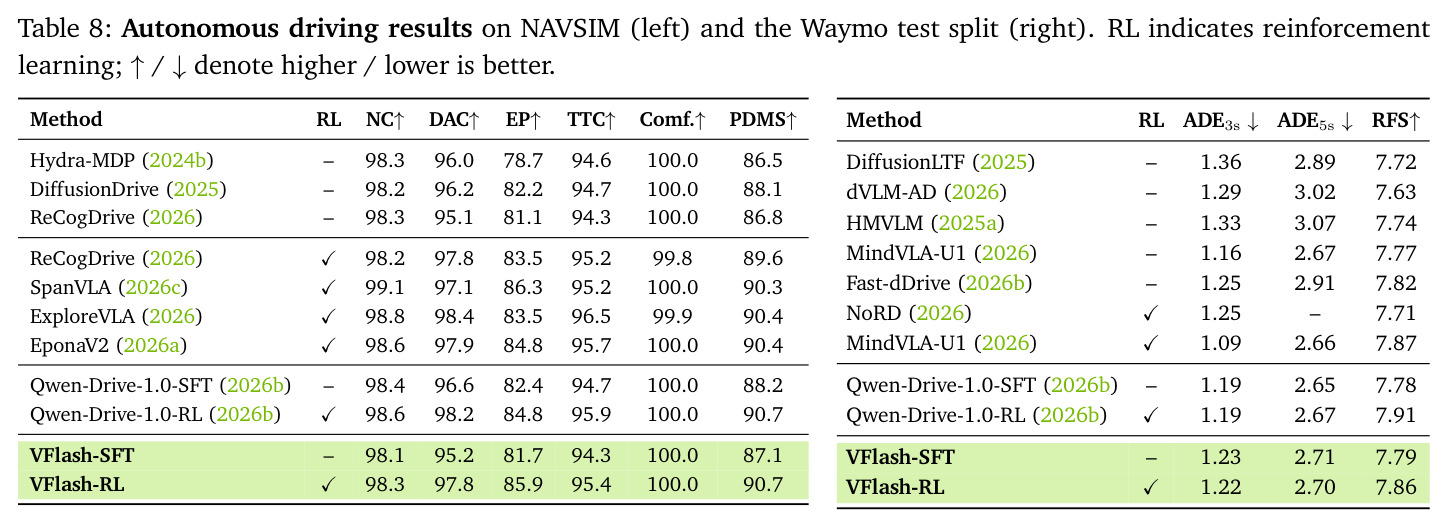
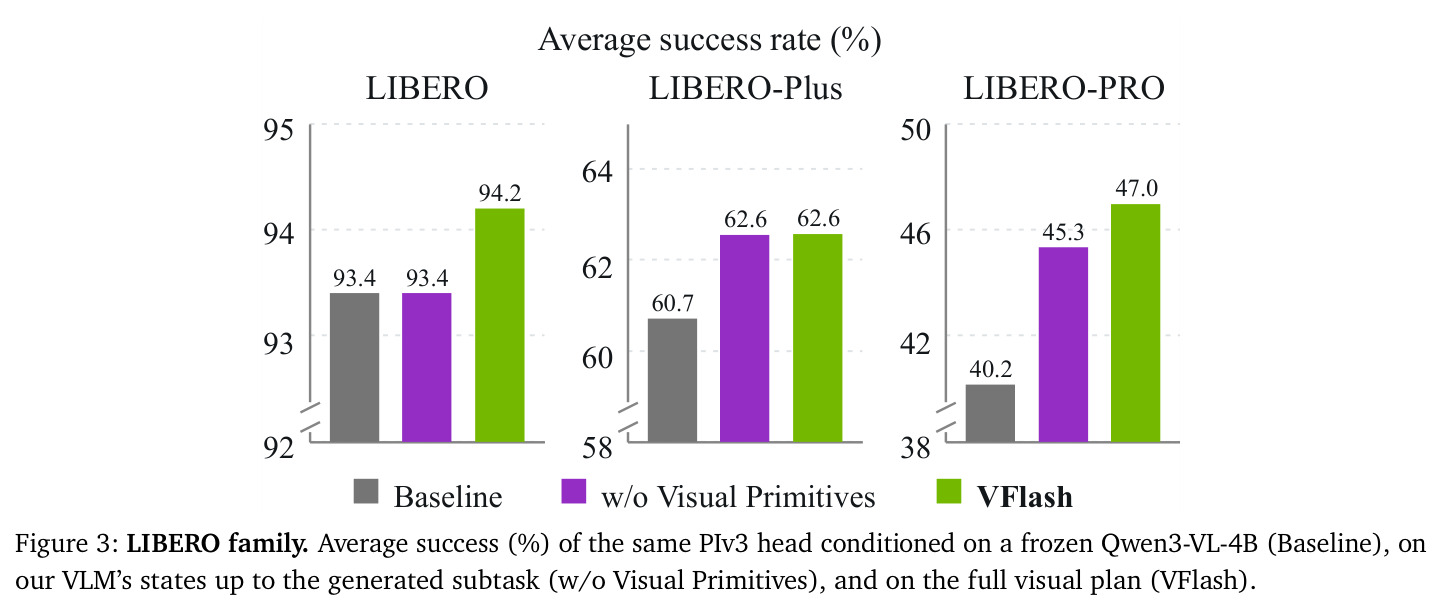
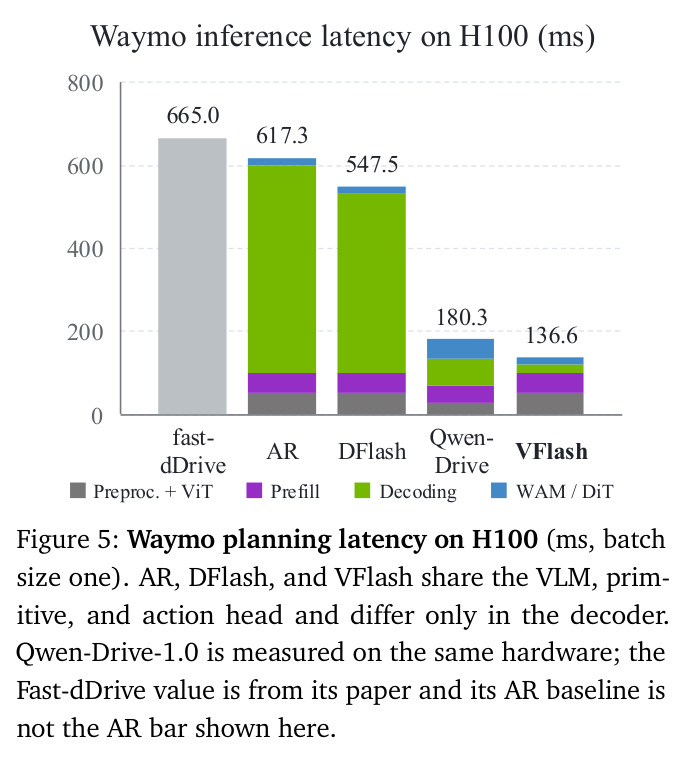
论文在四个预测任务和三个下游应用上做了系统实验。基座为同一 4B 具身 VLM(Qwen3-4B + MoonViT + MLP),AR 基线与 VFlash 共享目标模型、仅解码器不同,对比干净。其一,2D 轨迹预测(Table 2):在 ShareRobot-Bench 与 VABench-V 上,VFlash 把 AR 基线的全部六项误差再降 3–6%(DFD、RMSE)和约 7%(HD),如 ShareRobot-Bench 上 DFD 从 0.202 降至 0.194、HD 从 0.175 降至 0.162;相对此前最佳公开模型 LoHo-Manip,VABench-V 上各项误差砍掉约 40%。其二,3D 机器人轨迹(Table 4):在 InternA1/AgiBot/MolmoBot 三个数据集上全部四项指标、三种训练变体一致提升——3D-only 目标下 ADE 降 18–49%,2D+3D 下降 28–61%;AgiBot 的 5 厘米内路径点比例(SR@5)从 50.3% 升至 73.1%(3D-only)、从 39.8% 升至 73.9%(2D+3D);耐人寻味的是联合输出 2D+3D 时 AR 的 3D ADE 比 3D-only 恶化 15–51%,而 VFlash 因单次并行预测两段几乎无损,加入腕相机训练后 ADE 再降 3–12%。其三,检测框(Table 3):带 AR 回退的 VFlash 平均 F1 与 AR 持平(COCO 47.79 vs 48.68;Dense200 61.78 vs 60.10),IoU 0.50 档更高(Dense200 上 82.64 vs 76.70),IoU 0.95 更低(13.48 vs 16.09),解码快 2.6–2.8 倍(Dense200 每秒 17.46 个框 vs 6.73);完全去掉验证则 Dense200 平均 F1 跌到 39.09(约 −20 分)。其四,稠密 3D 点运动(Table 5):冻结 MolmoMotion-AR 只训草稿器,DAVIS 上 ADE/FDE 降 27%/19%(0.893/1.716 vs 1.227/2.108),HOT3D FDE 降 8%,单次 rollout 快约 25 倍(3.2–3.8 s vs 79.8–99.6 s)。下游:MolmoSpaces 操作(Table 6)用视觉规划条件化世界动作模型,平均成功率从 62.6% 升至 70.2%,超公开最佳 PrimeR0(60.3%)9.9 分,Pick & Place 与 Close 分别 +11.6/+12.8 分;Table 7 消融显示换 AR 生成的规划掉到 61.0%、用图像 token 替代轨迹 token 掉到 63.7%,证明增益确实来自规划内容。LIBERO 系列(Figure 3)增益随扰动加大:+0.8/+1.9/+6.8 分。驾驶(Table 8):冻结 VLM 下 NAVSIM PDMS 87.1(SFT)→90.7(RL,与 Qwen-Drive-1.0-RL 持平);Waymo RFS 7.79→7.86,距最佳 7.91 仅 0.05。吞吐(Figure 4/5、Table 11/12):MolmoSpaces 单步延迟 Thor 3,552.7→703.3 ms(−80.2%)、Spark 3,356.5→649.9 ms(−80.6%)、H100 516.1→142.3 ms;NAVSIM Thor 1,842.5→534.4 ms;Waymo H100 617.3→136.6 ms(4.5 倍)。关键统计(Table 12):AR 每次目标前向(35 ms)只产出 1 个 token,VFlash 一次草稿(12.9 ms)加一次目标前向(68.4 ms)产出 53 个 token,而 DFlash 在轨迹段内每轮只能提交 2.2 个 token。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 2D 轨迹预测(ShareRobot-Bench) | DFD / HD(归一化图像坐标,越低越好) | DFD 0.194 / HD 0.162 | 同 4B 目标模型 AR 解码:DFD 0.202 / HD 0.175 | 误差下降 4%–7% |
| 2D 轨迹预测(VABench-V) | DFD / RMSE(归一化,越低越好) | DFD 0.126 / RMSE 0.089 | AR:DFD 0.130 / RMSE 0.093;此前最佳公开模型 LoHo-Manip:DFD 0.212 / RMSE 0.147 | 对 AR 降 3–4%,对 LoHo-Manip 降约 40% |
| 3D 机器人轨迹(AgiBot,2D+3D + 腕相机训练) | ADE(米,越低越好)/ SR@5(%) | ADE 0.036 / SR@5 79.4% | AR:ADE 0.084 / SR@5 45.6% | ADE 降 57%,SR@5 +33.8 分 |
| 稠密 3D 点运动(PointMotionBench-DAVIS) | ADE / FDE(米,越低越好) | ADE 0.893 / FDE 1.716 | MolmoMotion-AR:ADE 1.227 / FDE 2.108 | ADE −27%、FDE −19%,单次 rollout 生成快约 25 倍 |
| 类别条件框生成(Dense200) | mean F1(%)/ 每秒框数 BPS | 61.78 / 17.46(带 AR 回退) | AR:60.10 / 6.73 | F1 持平略升,速度 2.6 倍 |
| MolmoSpaces 机器人操作 | 四套件平均成功率(%) | 70.2 | 同 WAM 原文本编码器 62.6;公开最佳 PrimeR0 60.3 | +7.6 分,超公开最佳 9.9 分 |
| NAVSIM 端到端驾驶 | PDMS(越高越好) | 90.7(RL) | Qwen-Drive-1.0-RL 90.7;ReCogDrive-RL 89.6 | 持平最佳;SFT 阶段 87.1 已超 ReCogDrive 的 86.8 |
| Waymo 端到端驾驶 | RFS(越高越好) | 7.86(RL) | Qwen-Drive-1.0-RL 7.91 | 差 0.05,接近最佳 |
| MolmoSpaces 规划延迟(Jetson Thor,batch size 1) | 单步端到端延迟(ms) | 703.3 | AR 3,552.7;DFlash 1,828.4 | 对 AR 降 80.2%,比 DFlash 快 2.6 倍 |
局限与改进
作者透明报告了几处短板:框生成在严格 IoU 0.95 下 F1 低于 AR(COCO 13.48 vs 16.09),说明直接接受的坐标在像素级精度上有折损;完全去掉验证守卫会让 Dense200 平均 F1 跌到 39.09(约 −20 分),直接接受并非处处'白拿';稠密点运动上 HOT3D/WorldTrack 的 ADE 仍落后 AR(0.122 vs 0.109、0.145 vs 0.143),WorldTrack FDE 反升 15%,三套件 PWT 低 7–12%——'更快也更准'并非普适;25 倍加速是单次 rollout 测量而非完整流水线端到端数字。我自己的观察:LIBERO 无扰动基线上规划增益仅 0.8 分,收益集中在分布偏移场景;操作与 LIBERO 实验每个配置只用一个训练种子和一个评测种子,70.2% vs 61.0% 的规划消融差未报告方差;Waymo 的 RL 奖励与 checkpoint 选择都在同 479 个验证场景上进行(作者也承认是 in-sample);驾驶 VLM 微调见过全部 navtrain,内部分割并非完全干净;3D 轨迹参考按弧长重采样、只评路径几何,不反映时间一致性;延迟数字绑定 TensorRT 栈与 batch size 1。
独立分析的弱点
第一,接受准则对轨迹坐标是'全有或全无':结构校验只查 schema 有效性,一旦无效就从第一个非法位置整块回退到约束 AR(轨迹 $r=0$ 即全部重生成),在分布外场景(罕见物体、严重遮挡)草稿器可能频繁失败,最坏情况下 VFlash 反而比纯 AR 更慢。改进方向是为轨迹坐标引入类似框的空间置信守卫的逐位置置信度,对低置信槽位做局部重生成而非整块回退。第二,1 厘米量化网格与 1,001 个特殊 token 是精度硬上限,精细装配等亚厘米任务不适用;且每新增一种基元类型都要手工设计布局模板并重训草稿器,泛化到未见 schema 的能力完全未验证。第三,稠密点运动的并行只到'帧内'——帧内点与坐标并行、帧间仍串行(最多 30 帧),长时域预测的加速比会随帧数稀释。第四,规划价值依赖下游动作模型能通过交叉注意力读取 VLM 隐状态,若动作模型采用其他接口(如无交叉注意力的策略网络),条件化方式需重新设计,通用性存疑。第五,所有延迟结论来自 TensorRT-Edge-LLM 定制栈上的 batch size 1 测量,在批处理服务或 PyTorch 生态下的收益未测,工程移植成本不低。
未来方向
作者明确提出的方向是:在固定延迟预算内从共享观测生成多个互补基元(例如同一场景同时产出轨迹、抓取点与未来运动预测),用规划多样性换取控制质量。顺着本文成果还可延伸:把'结构化直接接受'推广到更丰富的结构化输出(多智能体交互轨迹、关系谓词、符号化任务图),形成 VLM 的通用 System-1 解码层;深入研究草稿器与目标模型的知识互补机制——本文已证明草稿器可在空间精度上反超目标,进一步可用更大规模标注数据训练独立的空间专家草稿器;把驾驶实验中只作用于动作头的 RL(DiffGRPO)上移到视觉规划层面,让规划本身被任务奖励优化;以及在真机闭环(而非仿真暂停推理)中量化规划更新频率对成功率的影响。此外,框任务上 IoU 0.95 的精度损失提示值得研究'部分接受'策略,在速度与像素级精度间做更细粒度的权衡。
复现评估
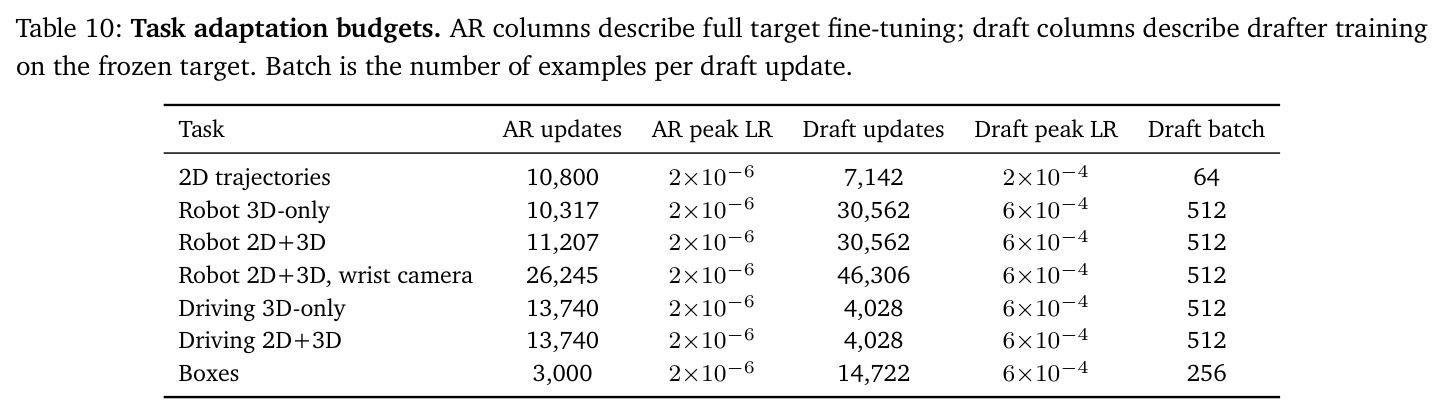
复现难度偏高。论文正文未给出可用的开源仓库或权重链接(首页仅占位 GitHub/项目页),可确认的公开组件包括:NVIDIA TensorRT-Edge-LLM 部署框架、基座 Qwen3-4B 与 Kimi 的 MoonViT 编码器、MolmoMotion-AR 目标模型,以及几乎全部评测数据(COCO、LIBERO 系列、NAVSIM、Waymo WOD-E2E、AgiBot、InternA1、MolmoBot、OXE、DROID、EgoDex 等均为公开数据)。训练开销不小:机器人轨迹目标全量微调约一至两个 pass、521 万–790 万加权样本,草稿器在 4–32 张 GPU 上训三个 pass;稠密运动草稿器用 32 张 H100 训 34,563 步;MolmoSpaces WAM 后训练用 32 GPU、10 万步、每个配置 5,120 万样本;延迟复现还需要 Jetson Thor 与 DGX Spark 硬件及 TensorRT 引擎构建经验。对多数团队,务实的路径是只复现'草稿器 + 标注坐标训练 + 直接接受'这一解码层思想并迁移到自己的 VLM,而非整体复刻整个流水线。
论文图表